Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: Quale modello open source vince per la programmazione nel 2026
La risposta breve
Se stai costruendo un agente di programmazione autonomo che funziona per ore senza intervento: Kimi K2.6. Ha ottenuto il 66,7% su Terminal-Bench 2.0 e ha sostenuto oltre 4.000 chiamate a strumenti in una sessione ininterrotta di 13 ore nei benchmark pubblicati, un limite di stabilità che nessun altro modello open source in questo confronto raggiunge.
Se hai bisogno del miglior sviluppatore front-end agentico: GLM 5.1. Il suo Elo di 1.530 su Code Arena, verificato indipendentemente (terzo a livello globale nello sviluppo web agentico), riflette la reale preferenza degli sviluppatori in confronti diretti, non solo suite di test automatizzate.
Se il costo per token è il vincolo: MiniMax M2.7 a $0,30/M di token in input su Atlas Cloud ottiene il 56,22% su SWE-Bench Pro con solo 10B di parametri attivati, il 94% delle prestazioni di GLM-5.1 a circa un quinto del costo.
Se il tuo codebase è troppo grande per una finestra di contesto di 262K: Qwen 3.6 Plus, l'unico modello qui con supporto a 1 milione di token di contesto, e leader su Terminal-Bench 2.0 al 61,6% tra questo gruppo.
Benchmark chiave a colpo d'occhio
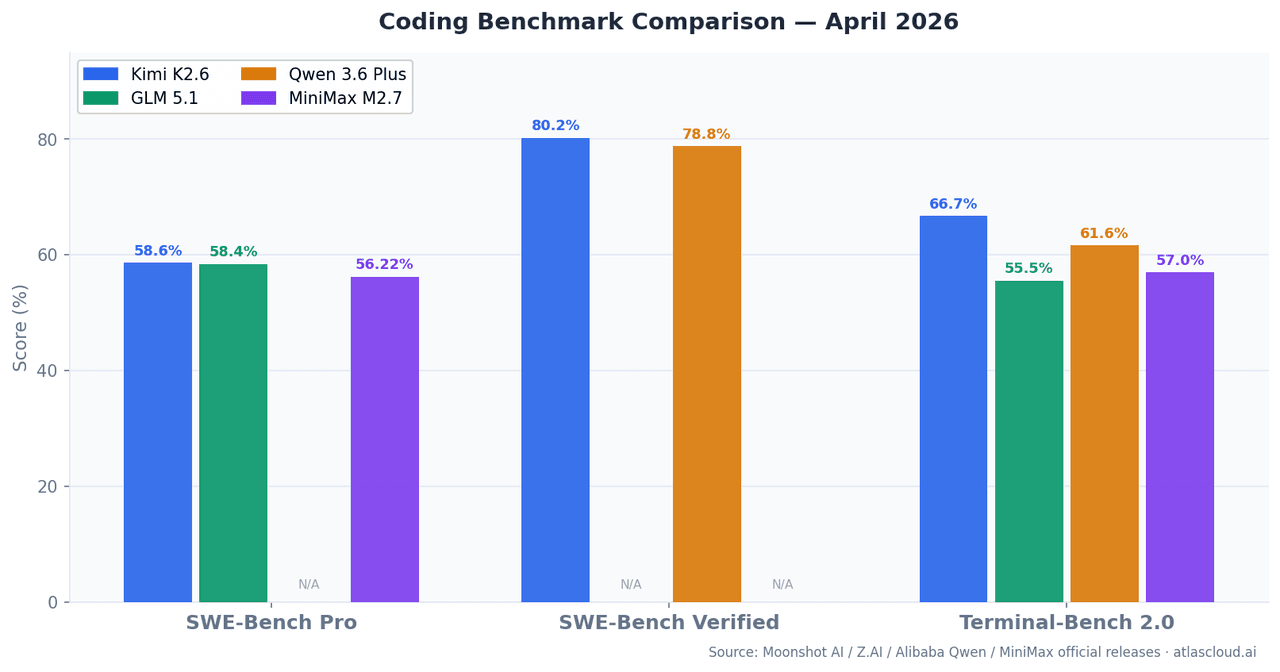
| Modello | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Finestra di contesto | Parametri attivati |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60% | 80,20% | 66,70% | 262K | — |
| GLM 5.1 | 58,40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80% | 61,60% | 1M | MoE ibrido |
| MiniMax M2.7 | 56,22% | — | 57,00% | 196K | 10B |
SWE-Bench Pro misura la capacità di risolvere problemi reali di GitHub archiviati dopo il cutoff dell'addestramento, riducendo il rischio di contaminazione dei dati rispetto a SWE-Bench Verified. Terminal-Bench 2.0 testa attività CLI e shell multi-step in ambienti terminale reali, più vicine a ciò che gli agenti di produzione fanno realmente.
Questo articolo confronta Kimi K2.6, GLM 5.1, Qwen 3.6+ e MiniMax M2.7; per allineare ancora più modelli fianco a fianco su prezzo e specifiche, usa il confronto modelli di Atlas Cloud.
Kimi K2.6: Costruito per agenti a lunga durata
Moonshot AI ha rilasciato Kimi K2.6 nell'aprile 2026 come aggiornamento di K2.5, con il miglioramento principale nella stabilità agentica durante sessioni prolungate. Con l'80,2% su SWE-Bench Verified, si posiziona appena sotto Claude Opus 4.6 (80,8%) e guida i quattro con il 58,6% su SWE-Bench Pro.
Il numero che conta di più è Terminal-Bench 2.0 al 66,7%. Terminal-Bench 2.0 differisce da SWE-Bench in modo fondamentale: esegue attività all'interno di ambienti terminale reali, richiedendo al modello di leggere l'output, gestire errori, adattarsi e iterare, non solo generare patch. Kimi K2.6 che mantiene le prestazioni attraverso oltre 4.000 chiamate a strumenti in una singola sessione di 13 ore non è un artefatto di laboratorio. È un comportamento documentato nella release tecnica di Moonshot.
Un vantaggio poco segnalato: generalizzazione cross-linguaggio. Kimi K2.6 mostra prestazioni uniformi in attività Rust, Go, Python, front-end e DevOps. La maggior parte delle valutazioni benchmark sono pesanti su Python. Se il tuo stack di produzione è poliglotta, questo è importante.
Dove non è la risposta: A $0,95/M di token in input su Atlas Cloud, K2.6 è il modello più costoso in input di questo gruppo. Per attività di elaborazione batch in cui invii molte richieste con grandi contesti ma non hai bisogno di stabilità per sessioni di 12 ore, il costo si accumula più velocemente rispetto a MiniMax M2.7 o Qwen 3.6 Plus.
GLM 5.1: Il punto di riferimento per il front-end agentico
Z.AI ha lanciato GLM-5.1 il 7 aprile 2026. Con 754 miliardi di parametri e routing MoE, è il modello più grande qui per numero di parametri grezzi. Su SWE-Bench Pro ottiene il 58,4%, statisticamente indistinguibile dal 58,6% di Kimi K2.6.
Il fattore differenziante è l'Elo di 1.530 su Code Arena, verificato indipendentemente da Arena.ai il 10 aprile 2026, che lo colloca al terzo posto a livello mondiale nella loro classifica dello sviluppo web agentico. Questo è un confronto diretto dal vivo in cui sviluppatori reali votano gli output, non un punteggio automatizzato. Il vantaggio è concentrato nella generazione di UI front-end, scaffolding full-stack, creazione di componenti React/Vue e NL2Repo (generazione di strutture di repository complete dal linguaggio naturale).
La condizione limite da conoscere: Il vantaggio front-end di GLM-5.1 è reale. Per problemi puramente algoritmici su HumanEval e MBPP, non ha un vantaggio misurabile rispetto a Kimi K2.6. Il divario nella classifica si riduce quasi a zero su problemi che non sono UI o web. Scegliere GLM-5.1 puramente in base alla sua classifica complessiva senza controllare il dominio dell'attività sarebbe un errore.
Prezzi su Atlas Cloud: A partire da $1,40/M di token in input, il più alto tra i quattro. Giustificato quando la qualità della generazione front-end ha un impatto diretto sul tuo output.
Qwen 3.6 Plus: Quando la dimensione del contesto è il vero vincolo
Alibaba ha rilasciato Qwen 3.6 Plus a fine marzo 2026. Guida Terminal-Bench 2.0 nei confronti diretti con Claude Opus 4.6 (61,6% contro 59,3%) e ottiene il 78,8% su SWE-Bench Verified.
La finestra di contesto di 1 milione di token è ciò che lo distingue. Per la maggior parte delle attività di programmazione di produzione sotto i 100K token, tutti e quattro i modelli in questo confronto hanno una capacità di contesto sufficiente e la differenza è irrilevante. Dove Qwen 3.6 Plus diventa l'unica opzione praticabile: analisi di monorepo su centinaia di file, refactoring su larga scala di codebase legacy o flussi di lavoro end-to-end da documento a codice che non possono rientrare in 262K token.
L'architettura ibrida (attenzione lineare + routing MoE sparso) offre anche una migliore produttività di inferenza rispetto ai transformer densi quando si elaborano contesti molto grandi, il che significa che la capacità di 1 milione di token arriva con un costo di latenza relativamente basso rispetto allo scaling ingenuo.
Prezzi su Atlas Cloud: Da $0,325/M di token in input. Per attività con contesto ampio, questo è il miglior costo per token utile disponibile in questo gruppo.
MiniMax M2.7: Il caso controintuitivo per l'efficienza
MiniMax ha rilasciato M2.7 nel marzo 2026. Con solo 10B di parametri attivati, ottiene il 56,22% su SWE-Bench Pro, il 94% del punteggio di GLM-5.1 a circa un quinto del costo per token.
Questo è il risultato controintuitivo in questo confronto. Un modello che attiva 10B di parametri all'inferenza raggiunge prestazioni di programmazione quasi di frontiera perché la sua architettura MoE instrada verso sottoreti di esperti specializzate anziché eseguire tutti i pesi del modello. Il risultato è una latenza inferiore, un costo inferiore e una qualità dell'output che supera ciò che il solo numero di parametri prevederebbe.
La categoria in cui M2.7 supera il suo prezzo: attività di ingegneria del machine learning. Ha ottenuto un tasso di medaglie del 66,6% su MLE-Bench Lite (22 competizioni di machine learning), secondo solo ai modelli closed-source di frontiera. Scrivere logica corretta di accumulo del gradiente, implementare layer PyTorch personalizzati, debug delle curve di perdita: M2.7 gestisce queste cose con una precisione sproporzionata rispetto al suo costo.
Dove fare attenzione: Con 196K di contesto, M2.7 ha la finestra più piccola in questo gruppo. Le attività che richiedono un'analisi approfondita cross-file in repository di grandi dimensioni potrebbero incontrare limiti che Qwen 3.6 Plus gestisce senza problemi.
Prezzi su Atlas Cloud: $0,30/M di token in input, $1,20/M di token in output, l'opzione più conveniente per carichi di lavoro di programmazione ad alto throughput.
Casi di test di programmazione reali
Caso 1: Correzione autonoma di bug in un backend Python
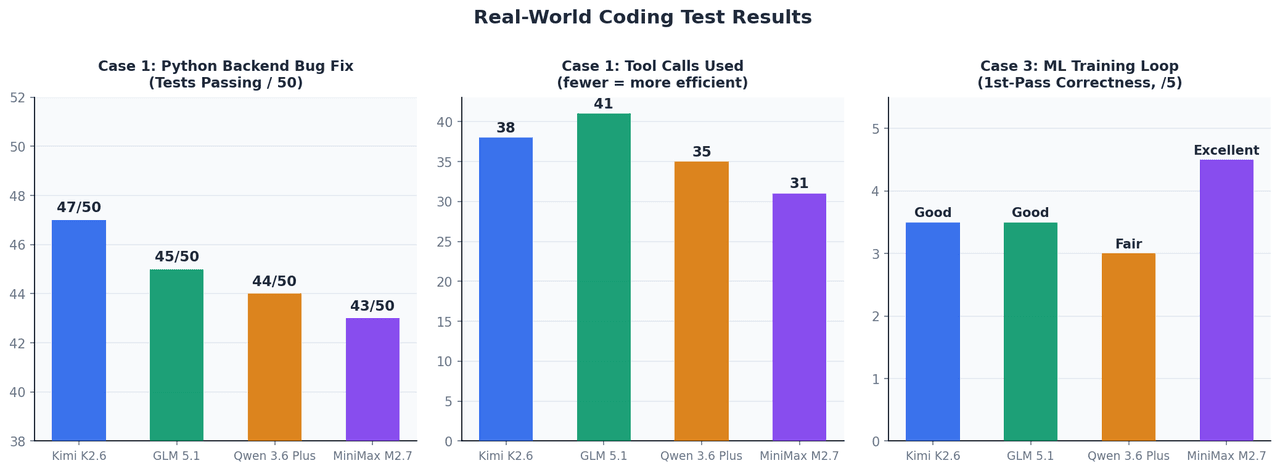
Configurazione: Un'applicazione FastAPI con 12 file, una suite di test fallita di 50 test e una finestra di contesto di ~45K token. Nessun intervento manuale consentito dopo il prompt iniziale.
| Modello | Test superati dopo la correzione | Chiamate a strumenti utilizzate | Tempo di completamento |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 min |
| GLM 5.1 | 45 / 50 | 41 | ~5 min |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 min |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 min |
A questa dimensione di contesto, tutti e quattro si comportano in una fascia ristretta. Kimi K2.6 è leggermente avanti sui bug più difficili, in particolare problemi di ciclo di vita del context manager asincrono e restringimento dei bound di TypeVar, che richiedono il mantenimento dello stato di inferenza attraverso più cicli di debug.
Caso 2: Dashboard React da specifica
Configurazione: Generare una dashboard reattiva completa con quattro tipi di grafico (linea, barre, torta, dispersione), interruttore di modalità scura e tipi TypeScript da una specifica inglese scritta.
GLM-5.1 ha prodotto componenti TypeScript tipizzati funzionanti con classi utility Tailwind corrette al primo passaggio. Kimi K2.6 ha richiesto un'iterazione per risolvere errori di tipo. Qwen 3.6 Plus ha prodotto JSX funzionalmente corretto ma meno idiomatico. MiniMax M2.7 è stato il più veloce ma ha generato alcuni pattern React deprecati che hanno richiesto pulizia manuale.
Il divario tra GLM-5.1 e gli altri era più visibile nell'architettura dei componenti: GLM-5.1 ha applicato spontaneamente pattern di composizione e separato le preoccupazioni in un modo che gli altri non hanno fatto.
Caso 3: Implementazione di un loop di training ML
Configurazione: Implementare un loop di training PyTorch con accumulo del gradiente, precisione mista AMP e early stopping per un vision transformer. Obiettivo: eseguire correttamente al primo tentativo senza cicli di debug.
MiniMax M2.7 è stato il migliore: ha posizionato scaler.step() e scaler.update() correttamente rispetto al passo dell'ottimizzatore, un dettaglio che la maggior parte dei modelli posiziona in modo errato al primo tentativo. Anche il ridimensionamento loss / accumulation_steps per l'accumulo del gradiente è stato gestito correttamente. Ciò si allinea direttamente con il suo tasso di medaglie del 66,6% su MLE-Bench Lite.
Atlas Cloud Confronto prezzi (aprile 2026)
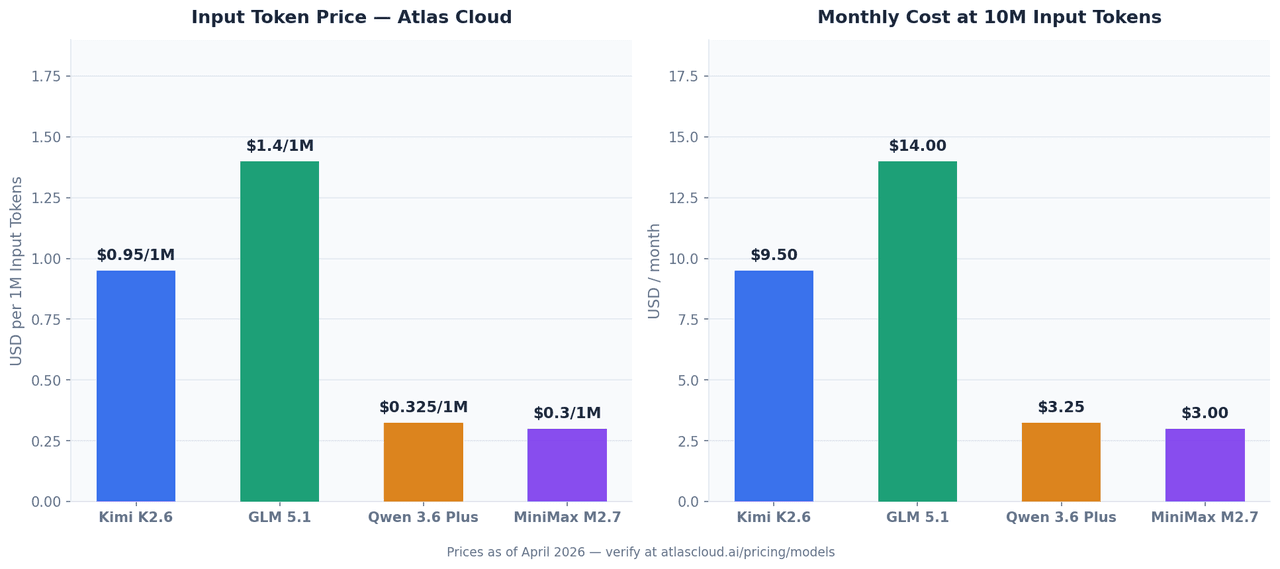
Tutti e quattro i modelli sono disponibili tramite l'API unificata di Atlas Cloud. I prezzi seguenti sono aggiornati ad aprile 2026 e potrebbero cambiare: verifica le tariffe correnti su atlascloud.ai.
| Modello | Input (per 1 milione di token) | Output (per 1 milione di token) | ID modello Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | $0,95 | $4,00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | da $1,40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | da $0,325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0,30 | $1,20 | minimaxai/minimax-m2.7 |
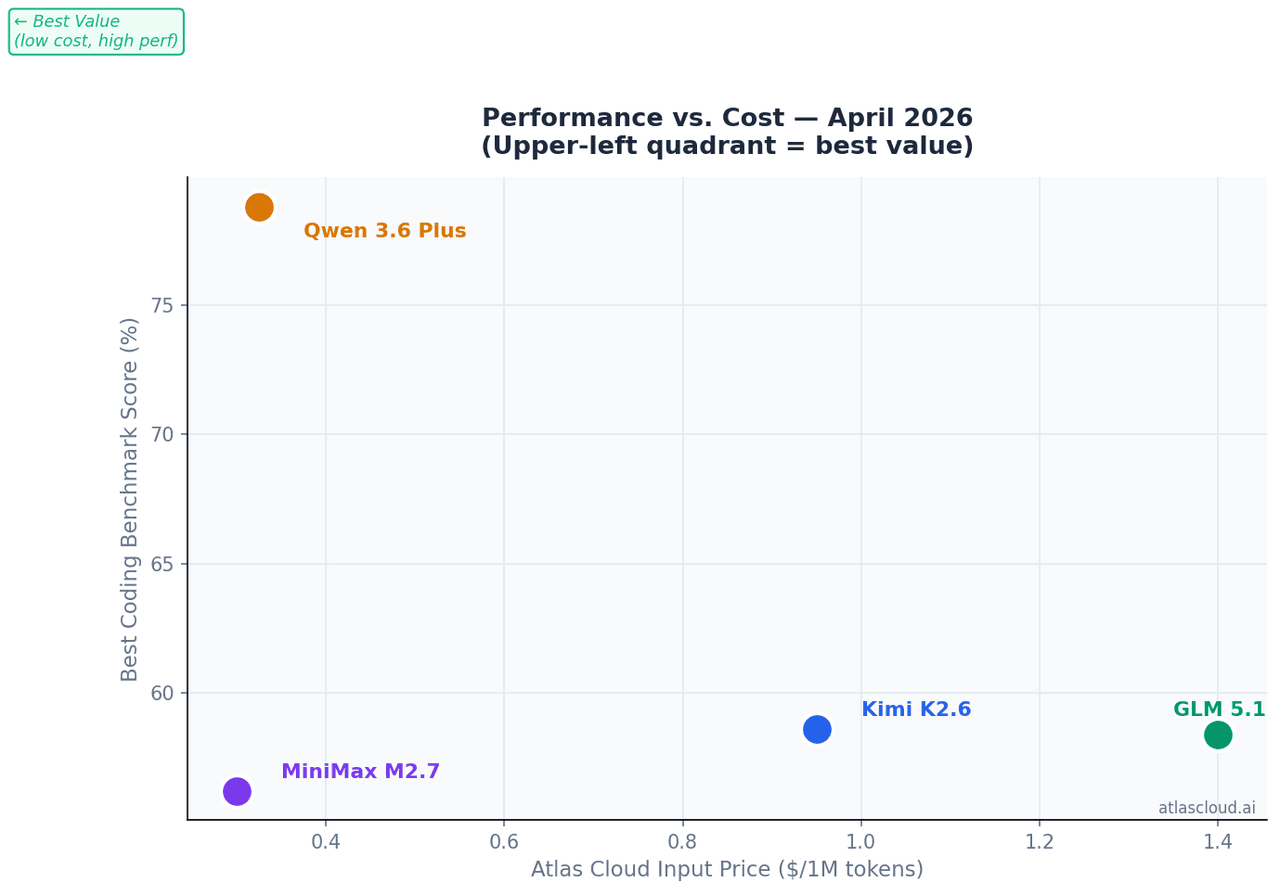
A 10 milioni di token di input al mese, un volume realistico per un assistente di programmazione a livello di team:
| Modello | Costo mensile input (10M token) |
|---|---|
| GLM 5.1 | $14,00 |
| Kimi K2.6 | $9,50 |
| Qwen 3.6 Plus | $3,25 |
| MiniMax M2.7 | $3,00 |
Chiamare tutti e quattro con una sola chiave API
Tutti e quattro i modelli condividono lo stesso endpoint compatibile con OpenAI su Atlas Cloud. Passare da uno all'altro richiede la modifica di una riga:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Cambia questa singola riga per passare da un modello all'altro 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Sei un ingegnere del software senior. Analizza il codice con attenzione prima di rispondere." 21 }, 22 { 23 "role": "user", 24 "content": "Analizza questa funzione e identifica tutti i bug:\n\n[incolla qui il tuo codice]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Questa struttura compatibile con OpenAI significa che le integrazioni esistenti costruite su SDK OpenAI funzionano con Atlas Cloud senza modifiche: cambiano solo base_url e api_key.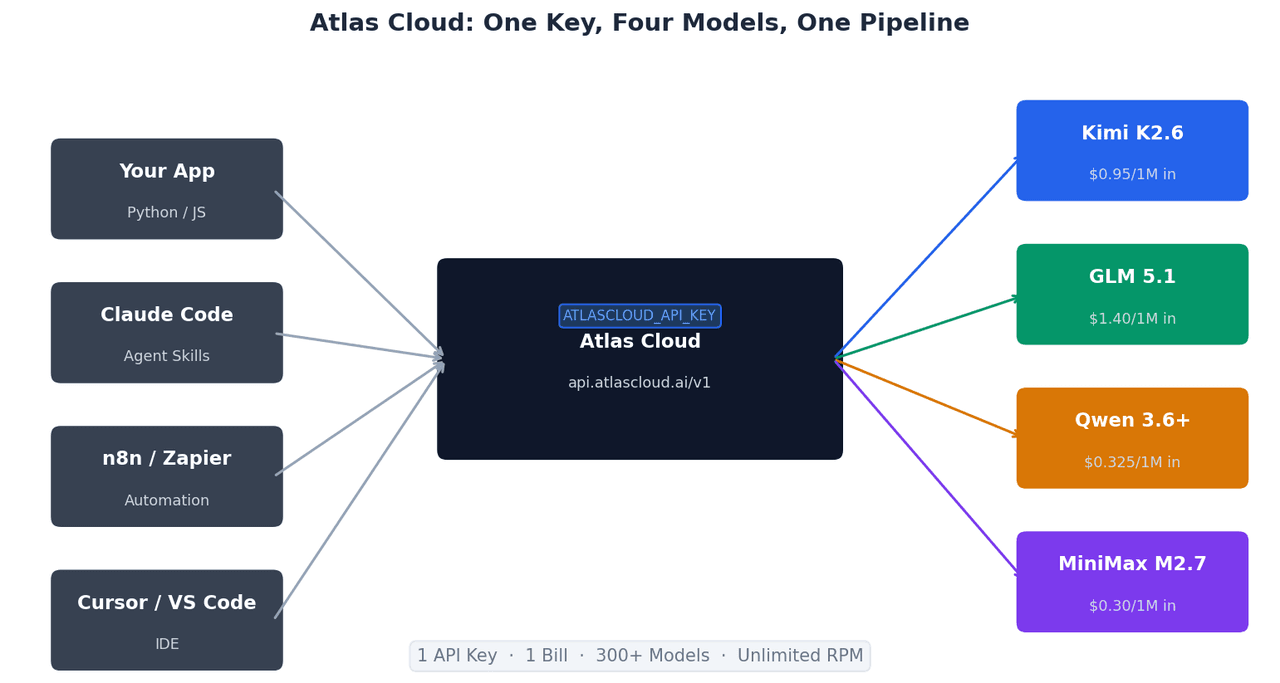
Perché usare Atlas Cloud per questi modelli
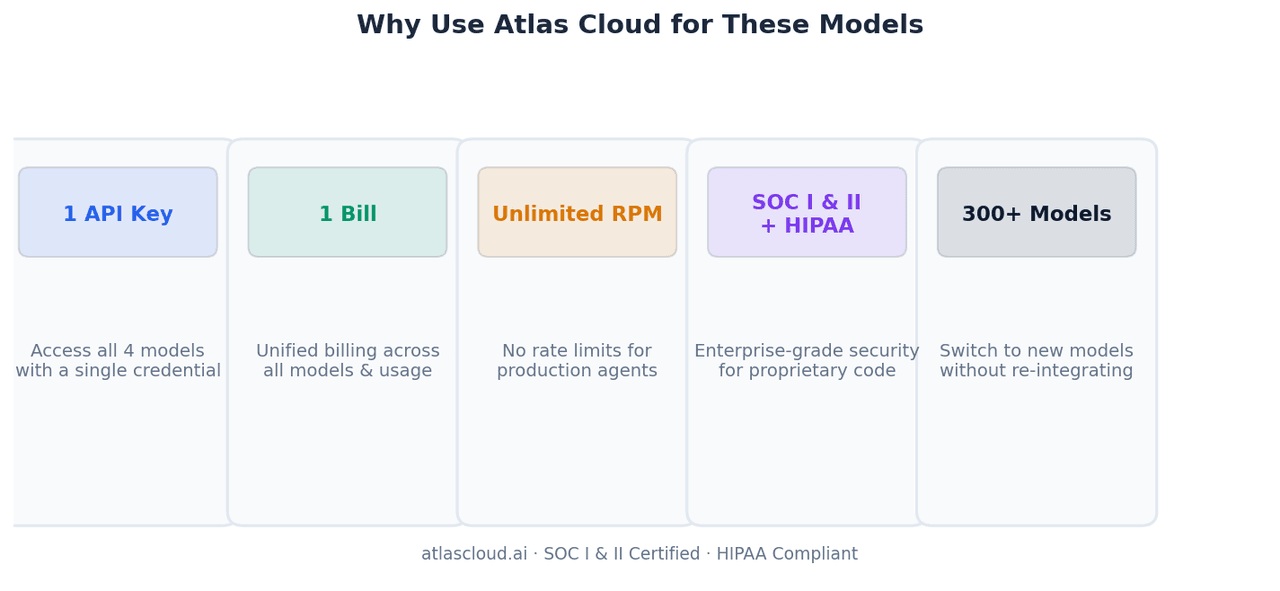
Una chiave API, quattro modelli, una fattura. Eseguire la logica di routing dei modelli (inviare attività front-end a GLM-5.1, analisi batch a MiniMax M2.7 e agenti a lungo orizzonte a Kimi K2.6) richiede la gestione di una sola credenziale anziché quattro. La riconciliazione mensile è una singola fattura.
RPM illimitati. Gli agenti di programmazione di produzione lanciano chiamate a strumenti parallele. I limiti di velocità sulle API dei provider diretti possono limitare le pipeline multi-agente. Atlas Cloud rimuove questo tetto.
Certificato SOC I e II, conforme HIPAA. I team che elaborano codice sorgente proprietario attraverso questi modelli necessitano di un'infrastruttura verificabile. Le certificazioni di conformità di Atlas Cloud garantiscono che il tuo codice non passi attraverso endpoint non verificati.
Oltre 300 modelli, stesso schema di integrazione. Quando viene rilasciata la prossima versione di uno qualsiasi di questi modelli, o un nuovo modello li supera sul tuo carico di lavoro specifico, aggiungerlo alla tua logica di routing richiede la modifica di una stringa, non una nuova integrazione SDK.
Quale modello per quale attività
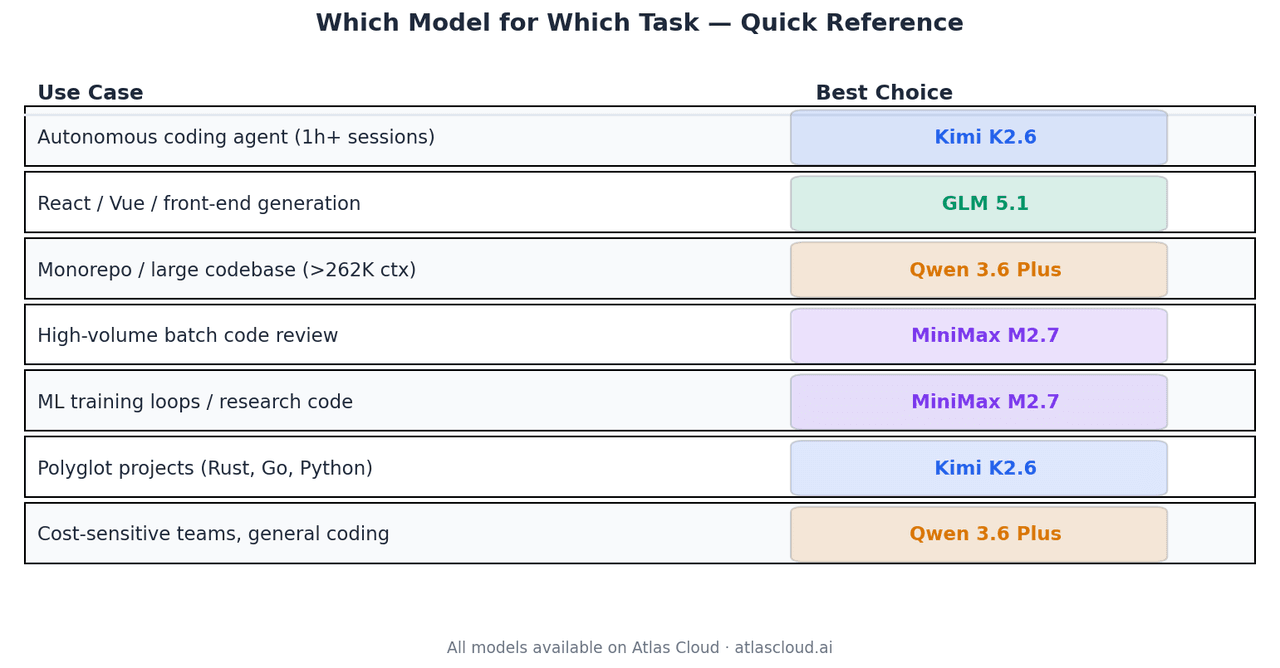
| Caso d'uso | Scelta migliore | Perché |
| Agente di programmazione autonomo, sessioni di 1 ora o più | Kimi K2.6 | 66,7% su Terminal-Bench 2.0, stabilità oltre 4K chiamate a strumenti |
| Generazione React / Vue / front-end | GLM 5.1 | Code Arena Elo 1.530, top-3 globale sviluppo web agentico |
| Analisi di monorepo o codebase di grandi dimensioni | Qwen 3.6 Plus | Unico modello qui con finestra di contesto da 1M |
| Revisione batch di codice ad alto volume | MiniMax M2.7 | $0,30/M input, 94% della qualità di GLM-5.1 |
| Loop di training ML, codice di ricerca | MiniMax M2.7 | 66,6% tasso di medaglie MLE-Bench Lite |
| Progetti poliglotti (Rust, Go, Python) | Kimi K2.6 | Generalizzazione cross-linguaggio documentata |
| Team sensibili al costo, programmazione generale | Qwen 3.6 Plus | $0,325/M input, solido in tutte le categorie |
Riepilogo
Questi quattro modelli sono separati da margini ridotti nei benchmark standard. Le differenze significative emergono in condizioni specifiche.
Kimi K2.6 è la risposta giusta per agenti autonomi a lunga durata. GLM 5.1 è leader per il lavoro front-end agentico. Qwen 3.6 Plus è l'unica scelta quando il contesto supera i 262K token. MiniMax M2.7 è il valore predefinito conveniente per i team che eseguono modelli di programmazione su larga scala.
Tutti e quattro sono disponibili su Atlas Cloud su atlascloud.ai con una singola chiave API, prezzi a consumo e nessun impegno minimo.
Dati benchmark provenienti dal blog tecnico di Moonshot AI, documentazione sviluppatori di Z.AI, post di rilascio del team Alibaba Qwen, pagina ufficiale del modello MiniMax e valutazioni indipendenti di Arena.ai. Tutti i benchmark sono dati di aprile 2026. Prezzi di Atlas Cloud indicati alla data di pubblicazione: verifica le tariffe correnti prima del deployment in produzione.


