Due persone siedono a un tavolo. Parte una battuta, poi si muovono entrambe le bocche. Arriva un controcampo e la voce non sembra più attaccata al volto. È il fallimento che i creator cercano di evitare quando cercano un test di lip sync del dialogo Kling 4.
Questo articolo inizia con un controllo della versione, poi esegue 3 brevi test di dialogo riproducibili sulla famiglia Kling 3.0 verificata: un parlante, 2 parlanti che si alternano e uno scambio misto inglese-spagnolo. Ogni test utilizza l'audio nativo al momento della generazione; l'articolo mostra i risultati visivi come GIF insieme alla stessa scheda di valutazione a 10 punti. Queste sono esecuzioni individuali, non un benchmark universale.
Punti chiave
- Kuaishou ha annunciato ufficialmente Kling 3.0, non un modello di dialogo Kling 4 specificato separatamente.
- Battute brevi, con nomi e a turni danno a chi valuta una base più chiara per verificare l'assegnazione dei parlanti.
- Le GIF rendono facili da scansionare i movimenti facciali e il passaggio di parola, mentre il file MP4 originale è ancora necessario per verificare la tempistica audio.
- Tratta un'esecuzione da 10 secondi come un controllo copione prima di investire in una versione di produzione più impegnativa.
- Esamina l'ascoltatore silenzioso con la stessa attenzione della persona che parla.
Test di lip sync del dialogo Kling 4: prima, il controllo della versione
L'espressione “Kling 4” attualmente raccoglie diverse cose nei risultati di ricerca: output 4K, Kling 3.0, Kling Video O3, linguaggio pre-release e denominazioni non verificate. Al momento di questo test non sono riuscito a trovare una specifica ufficiale Kuaishou per un modello di dialogo “Kling 4” rilasciato. Chiamare un'etichetta non verificata un prodotto finito renderebbe il test meno utile.
Il punto di riferimento attuale verificabile è Kling AI 3.0. Kuaishou ha annunciato la famiglia Video 3.0, Video 3.0 Omni, Image 3.0 e Image 3.0 Omni il 5 febbraio 2026. L'annuncio descrive audio nativo in più lingue, dialetti e accenti; scene di dialogo con ordine di parlata controllato; regia multi-inquadratura; e durate video fino a 15 secondi (Kuaishou Technology, febbraio 2026).
Quella dichiarazione di prodotto stabilisce un obiettivo di test utile. Non certifica ogni clip generata. Audio nativo significa che il modello può generare audio come parte del lavoro video. Non garantisce che una particolare bocca si chiuda su ogni consonante, che un ascoltatore resti fermo o che un taglio preservi l'identità del parlante. Sono questi i dettagli che il test verifica.
Le 3 esecuzioni seguenti conservano il risultato visivo con la scheda di valutazione, così il lettore può valutare le stesse prove che hanno informato le note scritte.
Cosa abbiamo testato
Il protocollo elimina deliberatamente le scuse. Ogni scena utilizza inquadratura 16:9, durata di 10 secondi, audio nativo abilitato o impostato su Auto dove il playground espone tale impostazione, nessuna musica e nessun lip-sync in post-produzione. Ogni parlante visibile riceve una breve battuta. Le GIF dell'articolo conservano la performance visiva; esamina separatamente i file MP4 originali quando giudichi la tempistica audio.
| Test | Modello | Durata | Personaggi visibili | Lingua | Battute parlate | Obiettivo principale di valutazione |
|---|---|---|---|---|---|---|
| 1 | Kling V3.0 Standard T2V | 10 secondi | 1 | Inglese | 1 | Prima sillaba, suoni a labbra chiuse, pausa finale |
| 2 | Kling V3.0 Standard T2V | 10 secondi | 2 | Inglese | 2 | Corretta assegnazione del parlante e comportamento dell'ascoltatore silenzioso |
| 3 | Kling V3.0 Pro T2V | 10 secondi | 2 | Inglese e spagnolo | 2 | Passaggio di lingua, attribuzione e continuità facciale |
La scheda di valutazione assegna a ogni categoria 0, 1 o 2 punti. Un 2 significa che il comportamento è abbastanza chiaro per il campione di 10 secondi previsto. Un 1 significa che è in parte convincente ma richiede un altro sguardo. Uno 0 significa che lo spettatore può chiaramente vedere il problema. Il totale è il record di un risultato generato con un prompt, non un'affermazione su tutti gli output del modello.
| Categoria | 0 punti | 1 punto | 2 punti |
|---|---|---|---|
| Sincronizzazione bocca-parola | Evidente disallineamento | Segue per lo più con visibili scivolamenti | La tempistica risulta naturale per tutta la durata |
| Corretta assegnazione del parlante | Parlante sbagliato o condiviso | Un momento incerto | Ogni battuta appartiene alla persona nominata |
| Comportamento dell'ascoltatore silenzioso | L'ascoltatore parla o muove le labbra | Lievi movimenti labiali indesiderati | L'ascoltatore rimane naturalmente attento |
| Continuità dell'espressione facciale | Il volto si rompe o cambia visibilmente | Piccola instabilità | L'espressione rimane coerente |
| Continuità audio attraverso un taglio | La voce si stacca o cambia bruscamente | La transizione è percettibile | Il taglio supporta lo stesso beat di dialogo |
Il design del test risponde anche alle probabili domande di fan-out dietro questa ricerca: Kling 4 è stato rilasciato, quale modello attuale può generare dialoghi, 2 persone possono alternarsi, come può un creator impedire che entrambi i personaggi parlino, un dialogo multilingua può funzionare e cosa dovrebbe coprire un piccolo budget di test?
Test di dialogo Kling n. 1: un parlante, una breve battuta
Una singola persona che pronuncia una breve battuta è la base. Isola i primi controlli utili: la prima apertura della bocca, una chiusura su un suono “p” o “b” e il ritmo rilassato dopo la fine del parlato. Se quella base sembra sbagliata, aggiungere un altro personaggio, un taglio di camera o un'altra lingua rende solo più difficile la diagnosi.
Questa esecuzione utilizza una fittizia impiegata d'ufficio di nome Maya. La scena ha un piccolo gesto della mano e uno sguardo diretto, ma nessun movimento rapido di camera. Questo lascia bocca e voce come prove principali.
Impostazioni di esecuzione: 16:9, 10 secondi, massima risoluzione del playground disponibile al momento dell'esecuzione, audio nativo On o Auto, nessuna musica di sottofondo. Modello: Kling V3.0 Standard Text-to-Video.
plaintext1A realistic 10-second medium close-up of Maya, a fictional woman in her early thirties wearing a navy blazer, seated at a bright office desk. She looks directly at her colleague just off camera and says exactly: “The report is ready. Please review the blue chart.” Natural conversational pacing, clear English speech, accurate mouth movements, subtle blinking, small hand gesture, quiet office room tone only. Maya is the only visible person and the only speaker. No subtitles, no background music, no narration.
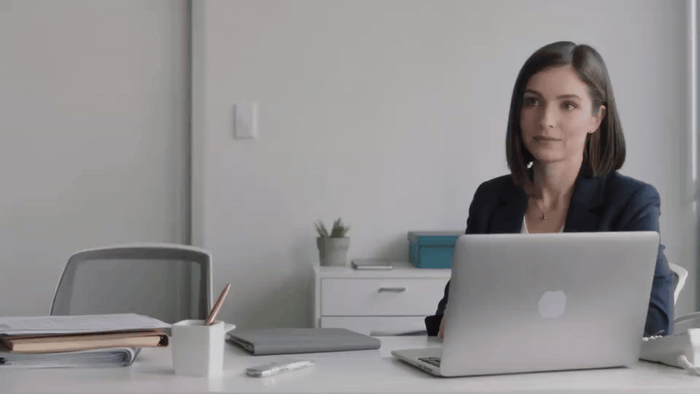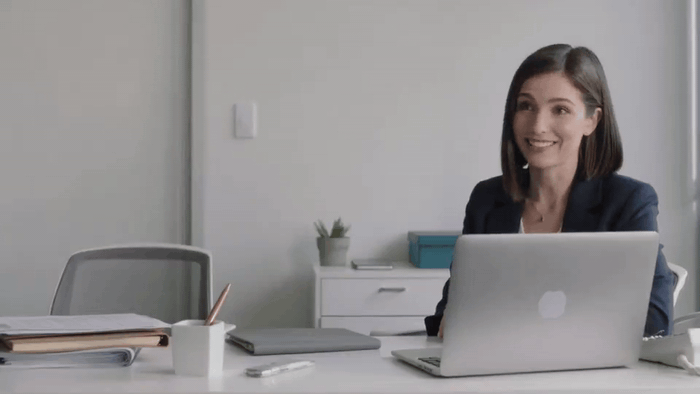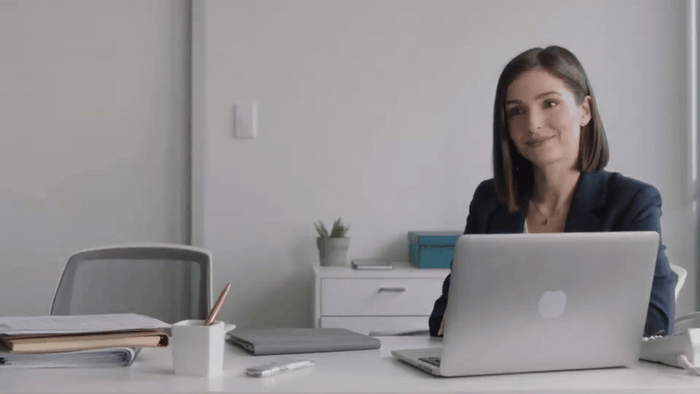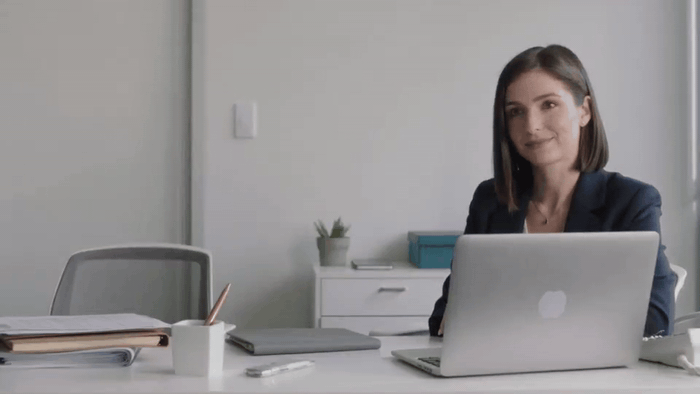
Risultato visivo del test 1: Maya pronuncia una battuta d'ufficio
Risultato visivo del test 1. Osserva la chiusura della bocca di Maya durante “Please” e la pausa dopo la battuta; usa il file MP4 originale per giudicare la tempistica audio.
Stato dell'esecuzione: Renderizzato nel playground di test Atlas. La GIF visiva è incorporata sopra.
| Risultato visivo del test 1 | Stato | Cosa mostra la GIF |
|---|---|---|
| Inquadratura con un solo parlante | Chiaro | Maya è l'unica persona visibile per tutta la scena d'ufficio |
| Movimento della bocca | Visibile | L'inquadratura ravvicinata rende facile ispezionare il movimento del parlato |
| Continuità facciale | Stabile | Ammiccamento, posa e illuminazione rimangono coerenti per tutta la clip |
| Comportamento dell'ascoltatore e taglio | Non applicabile | Questa scena di base non ha un secondo parlante o controcampo |
| Tempistica audio | Controlla il file MP4 originale | La GIF incorporata non ha audio |
Se la battuta perde chiarezza, cambia solo 1 variabile per una ripetizione etichettata separatamente. Primo, accorcia la frase parlata. Secondo, rimuovi il gesto della mano o qualsiasi istruzione di camera non necessaria. Evita di cambiare personaggio, durata e lingua allo stesso tempo. Così trasformi una diagnosi in un nuovo esperimento.
Test di dialogo Kling n. 2: due persone che si alternano
È qui che la generazione di dialoghi merita esame. Una scena credibile richiede 2 azioni separate: Maya deve parlare mentre Daniel ascolta, poi Daniel deve parlare mentre Maya ascolta. La persona silenziosa non è spazio morto. La sua bocca chiusa, il contatto visivo, una piccola reazione e un volto stabile fanno parte della prova.
Il prompt utilizza 3 ancore per ogni parlante: un nome, una posizione a sinistra o a destra e un dettaglio visibile dell'abbigliamento. Indica anche il comportamento previsto dell'ascoltatore. Non sono parole magiche. Danno al modello un contratto di scena più esplicito e forniscono al revisore chiare condizioni di fallimento.
plaintext1A realistic 10-second two-person office dialogue in a sunlit meeting room. Maya, wearing a navy blazer, sits on the left. Daniel, wearing a light gray shirt, sits on the right. Shot 1: medium two-shot. Maya looks at Daniel and says exactly: “The report is ready. Please review the blue chart.” Daniel remains silent and listens naturally with his mouth closed. Shot 2: reverse medium shot on Daniel. Daniel says exactly: “Great. I will check it before lunch.” Maya remains silent and listens naturally with her mouth closed. Clear English speech, precise lip sync, one speaker at a time, no overlapping dialogue, no subtitles, no background music, quiet office room tone.
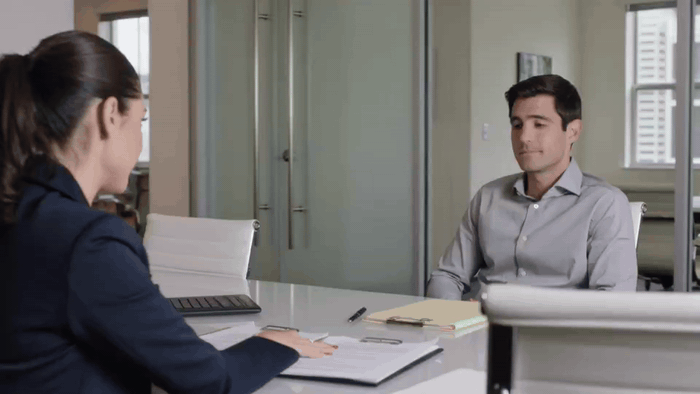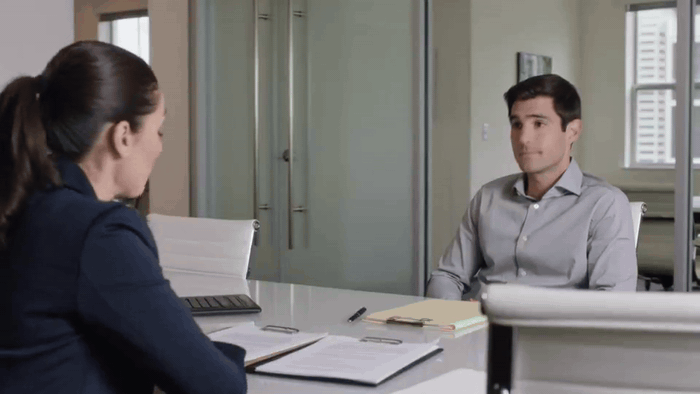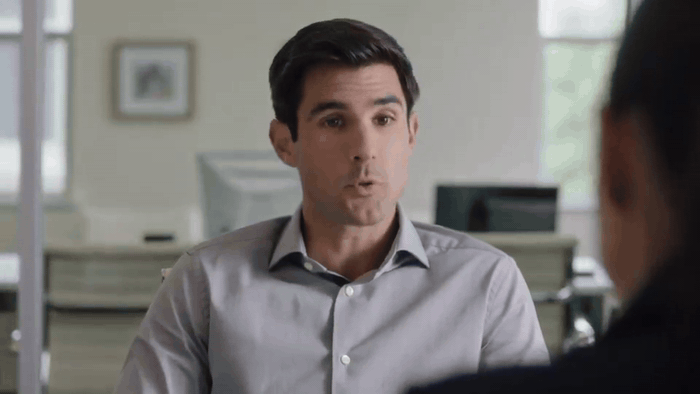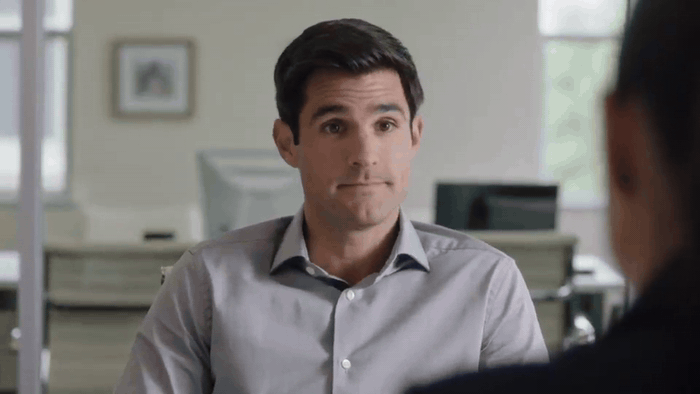
Risultato visivo del test 2: Maya e Daniel si alternano in una conversazione d'ufficio
Risultato visivo del test 2. Osserva la bocca dell'ascoltatore durante ogni battuta e il passaggio di parola al controcampo; usa il file MP4 originale per giudicare la tempistica audio.
I creator descrivono regolarmente il problema opposto nelle discussioni della community: un lavoro di lip-sync previsto può perdere la sincronizzazione o dare movimenti labiali indesiderati a una persona che dovrebbe stare zitta. È un'esperienza aneddotica, non una specifica di prodotto, ma è un buon motivo per ispezionare l'ascoltatore in ogni esecuzione (r/KLING, settembre 2026).
Stato dell'esecuzione: Renderizzato nel playground di test Atlas. La GIF visiva è incorporata sopra.
| Risultato visivo del test 2 | Stato | Cosa mostra la GIF |
|---|---|---|
| Configurazione a due parlanti | Chiaro | Maya e Daniel appaiono nella stessa conversazione d'ufficio |
| Passaggio di parola | Visibile | La scena passa dal turno di Maya al controcampo su Daniel |
| Comportamento dell'ascoltatore | Ispezionabile | La GIF mantiene visibile la persona che non parla per un controllo visivo |
| Continuità facciale | Stabile | Il volto di Daniel e l'ambiente d'ufficio rimangono coerenti nel controcampo |
| Tempistica audio | Controlla il file MP4 originale | La GIF incorporata non ha audio |
Il confine pratico è modesto: uno scambio sequenziale di 10 secondi tra 2 persone può essere testato. Non dovrebbe essere trattato come un modello preconfezionato per una scena lunga con interruzioni, reazioni di gruppo, montaggio rapido e diverse lingue. Aumenta la difficoltà una dimensione alla volta.
Test di dialogo Kling n. 3: dialogo multilingua
La terza esecuzione testa una versione più mirata della funzione descritta da Kuaishou: una persona parla inglese, poi l'altra risponde in spagnolo. Il valore non è la novità. Uno scambio multilingua può rivelare un errore di assegnazione del parlante che una clip in una sola lingua nasconde, soprattutto quando un taglio e un diverso schema sonoro arrivano insieme.
La risposta in spagnolo è intenzionalmente breve. Ogni persona ha comunque una battuta, l'ordine delle inquadrature rimane esplicito e all'ascoltatore viene detto di rimanere in silenzio. Il tier Pro è usato qui come test separato e più impegnativo, non come sostituto di un prompt chiaro.
Impostazioni di esecuzione: 16:9, 10 secondi, massima risoluzione e qualità disponibili al momento dell'esecuzione, audio nativo On o Auto, nessuna musica di sottofondo. Modello: Kling V3.0 Pro Text-to-Video.
plaintext1A realistic 10-second two-person dialogue at a quiet outdoor café in late afternoon. Maya, wearing a navy blazer, is seated on the left. Daniel, wearing a light gray shirt, is seated on the right. Shot 1: Maya smiles and says exactly in English: “The product demo starts in five minutes.” Daniel remains silent and listens with his mouth closed. Shot 2: Daniel replies exactly in Spanish: “Perfecto, ya tengo las notas listas.” Maya remains silent and listens naturally with her mouth closed. One speaker at a time, accurate lip sync for each spoken language, natural pauses, stable faces, no subtitles, no background music, soft café ambience only.
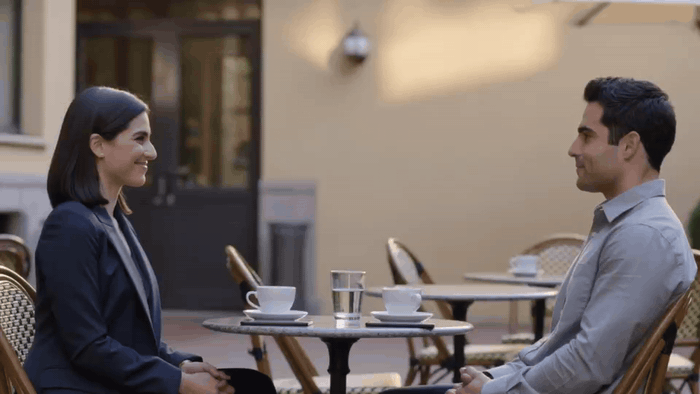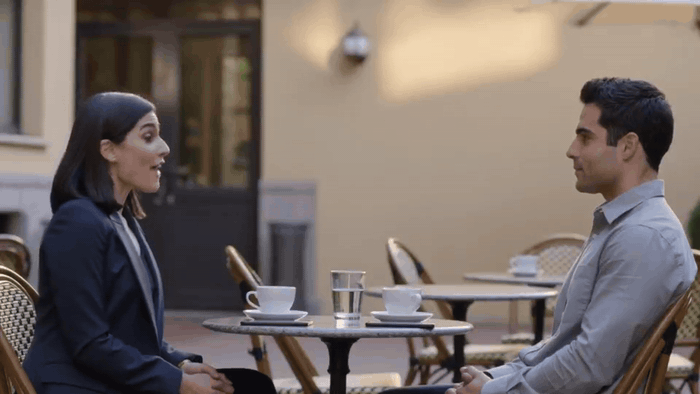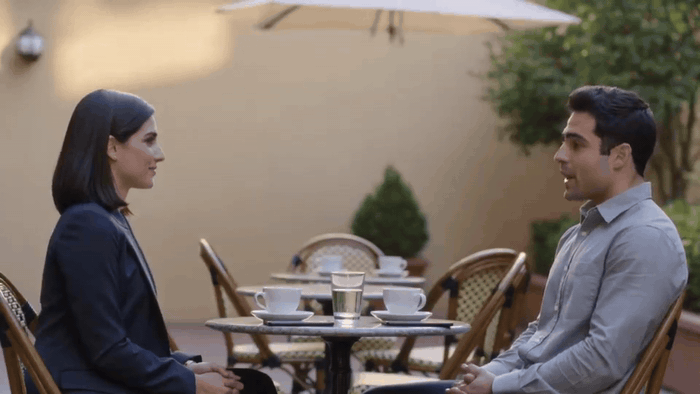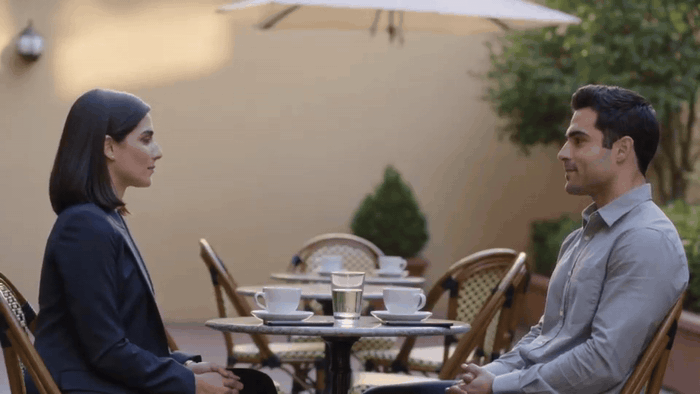
Risultato visivo del test 3: due parlanti si scambiano battute in un caffè all'aperto
Risultato visivo del test 3. Osserva quale volto possiede ogni battuta attraverso il passaggio dall'inglese allo spagnolo; usa il file MP4 originale per giudicare la tempistica audio.
Stato dell'esecuzione: Renderizzato nel playground di test Atlas. La GIF visiva è incorporata sopra.
| Risultato visivo del test 3 | Stato | Cosa mostra la GIF |
|---|---|---|
| Configurazione al caffè con due persone | Chiaro | Entrambe le persone rimangono posizionate al tavolo del caffè all'aperto |
| Passaggio di parola | Visibile | L'inquadratura preserva lo scambio tra i due personaggi |
| Continuità di volto e ambiente | Stabile | Abbigliamento, posti a sedere e illuminazione del caffè nel tardo pomeriggio rimangono coerenti |
Risultati di lip sync Kling più puliti
I 3 prompt condividono una struttura che rende visibile un fallimento e spiegabile una ripetizione. Usa questa checklist prima di aggiungere ulteriore rifinitura.
- Mantieni non più di 2 persone visibili in un primo test di dialogo.
- Assegna a ogni persona 1 frase per turno.
- Mantieni le battute in inglese vicino a 8-12 parole quando possibile.
- Contrassegna il parlante con posizione, una caratteristica visibile e un nome.
- Dichiara che l'altro personaggio ascolta naturalmente con la bocca chiusa.
- Stabilisci il copione con un campione di 10 secondi prima di aumentare le impostazioni di dettaglio o la durata.
- Ispeziona tempistica labiale, assegnazione del parlante, comportamento dell'ascoltatore, continuità facciale e taglio come controlli separati.
- Non combinare un lungo monologo, scena di gruppo, montaggio rapido e cambio di lingua nella prima esecuzione.
| Elemento del prompt | Esempio nei test | Cosa aiuta il revisore a isolare |
|---|---|---|
| Posizione | “Maya ... on the left” | Quale persona dovrebbe parlare |
| Ancoraggio dell'aspetto | “navy blazer” | Se l'identità tiene attraverso un taglio |
| Battuta esatta | “Great. I will check it before lunch.” | Il suono atteso e la tempistica della bocca |
| Istruzione sul ruolo silenzioso | “remains silent ... mouth closed” | Movimenti labiali indesiderati dell'ascoltatore |
| Sequenza delle inquadrature | “Shot 1 ... Shot 2” | Se l'audio rimane attaccato dopo un taglio |
Questa formattazione non promette risultati perfetti. Dà a un piccolo team un modo per tenere insieme prompt sorgente, media e decisione. Se una clip necessita di una ripetizione, registra se il fallimento si è verificato alla prima sillaba, durante una reazione dell'ascoltatore o al taglio. “Il lip sync sembrava stonato” è troppo vago per migliorare un copione di produzione.
Budget e scelta del modello
Usa un tier attuale a costo inferiore per convalidare il copione, poi riserva il test di tier superiore alla versione che potresti effettivamente presentare. Questo è il ruolo che Standard e Pro svolgono in questo articolo. Un creator può eseguire la stessa struttura di prompt in un unico spazio di lavoro del modello Atlas Cloud, conservare il record del test e fare un confronto senza riscrivere il copione per un'interfaccia diversa.
Le cifre seguenti sono un contesto di prezzo, non una dichiarazione promozionale. Sono state verificate rispetto alla directory dei modelli Atlas Cloud e alle pagine di dettaglio dei modelli il 28 settembre 2026. La directory mostrava una riduzione del 15% al momento della revisione. Prezzi e parametri dei modelli possono cambiare, quindi ricontrolla la pagina prima di definire un budget cliente.
| Modello per questo test | Prezzo di pagina al secondo, verificato set. 2026 | Generazione stimata di 10 secondi | Miglior utilizzo in questo protocollo |
|---|---|---|---|
| Kling V3.0 Standard T2V | $0.071, in calo da $0.084 | $0.71 | Convalidare la struttura del prompt per un parlante e alternanza |
| Kling V3.0 Pro T2V | $0.095, in calo da $0.112 | $0.95 | Eseguire il candidato multilingua o di presentazione |
Il costo totale elencato per i 3 test da 10 secondi è $2.37 prima di eventuali ripetizioni. Consideralo una semplice stima di pianificazione. Presuppone il prezzo al secondo visualizzato, che la durata richiesta sia accettata dal modulo live e che il prezzo applicabile all'account corrisponda alla pagina pubblica. Lo schema reale del playground è l'autorità finale per rapporti d'aspetto disponibili, scelte di qualità e controlli audio nativo.
FAQ sul lip sync del dialogo Kling
Kling 4 è stato rilasciato ufficialmente?
Non ho potuto verificare una specifica ufficiale Kuaishou per un modello di dialogo Kling 4 rilasciato. Il rilascio ufficiale usato qui è Kling 3.0. Le pagine di ricerca che associano “4K” o un'etichetta rivolta al futuro a Kling non dovrebbero essere trattate come conferma di un prodotto “Kling 4” separato.
Quale modello dovrei usare oggi per un test di lip sync del dialogo Kling?
Per un breve controllo del copione, usa il percorso verificato attuale Kling V3.0 Standard Text-to-Video. Usa Pro per un seguito più impegnativo come la scena multilingua in questo articolo. Mantieni la configurazione abbastanza stabile da poter capire se un risultato è cambiato per il prompt o per il tier del modello.
Kling può far parlare 2 persone una dopo l'altra?
Kuaishou afferma che Video 3.0 può generare dialoghi multi-personaggio con contenuto e ordine di parlata controllati. In pratica, esegui prima un breve campione di alternanza. Nomina ogni parlante, ancora le loro posizioni e l'abbigliamento, dichiara l'ordine delle inquadrature e indica esplicitamente all'ascoltatore di rimanere in silenzio.
Perché entrambi i personaggi muovono le labbra nel mio video Kling?
La scena potrebbe lasciare l'attribuzione del parlante troppo aperta, oppure il modello potrebbe produrre movimenti facciali indesiderati in quell'esecuzione. Limita il test a 2 persone e 1 battuta ciascuna. Poi includi un'istruzione diretta per l'ascoltatore silenzioso e ispeziona il risultato con il suo audio. Se il problema persiste, segnalalo come risultato fallito e ripeti cambiando solo 1 variabile.
Kling supporta dialoghi in inglese e spagnolo in 1 clip?
Kuaishou elenca sia l'inglese sia lo spagnolo tra le lingue supportate dall'audio nativo di Video 3.0. Un elenco di lingue supportate non è la stessa cosa di una garanzia per qualsiasi copione di dialogo. Il terzo test di lip sync del dialogo Kling 4 sopra mantiene lo scambio breve, così puoi giudicare passaggio di lingua, movimento della bocca e attribuzione del parlante nello stesso file.
Dovrei usare una GIF o un video per mostrare un test di lip sync?
Usa una GIF quando l'articolo necessita di una vista leggera e facilmente scansionabile del movimento facciale e del passaggio di parola. Usa il file MP4 originale quando rivedi parole e tempistica audio. I 3 risultati incorporati qui sono GIF, mentre i loro file MP4 originali rimangono nella cartella asset dell'articolo.


