

Un utile test di memoria assomiglia meno a “Cosa ricordi di me?” e più a una verifica a libro chiuso con una correzione e alcune distrazioni. Per eseguire un test di Active Memory di Muse Wonder, fornisci dettagli fittizi in una conversazione, correggine uno, poi chiedi i fatti correnti rilevanti in una nuova conversazione. Registra ciò che recupera, ciò che sbaglia e se ammette l'incertezza.
La sequenza seguente richiede circa 10 minuti per essere configurata e valutata. Non è una prova della memoria tra giorni, account o ogni superficie dei prodotti Muse. È una prima verifica riproducibile. Usa dettagli inventati invece di informazioni private.
Punti chiave
- Verifica separatamente recupero, correzioni, resistenza ai distrattori, incertezza e tracciabilità.
- Esegui il test nella superficie del prodotto che intendi usare, con le sue impostazioni di memoria documentate.
- Una nuova richiesta API verifica la memoria persistente solo se l'applicazione o il servizio la forniscono.
- MemoryBench di Meta è una valutazione interna molto più lunga; questa breve verifica non la riproduce.
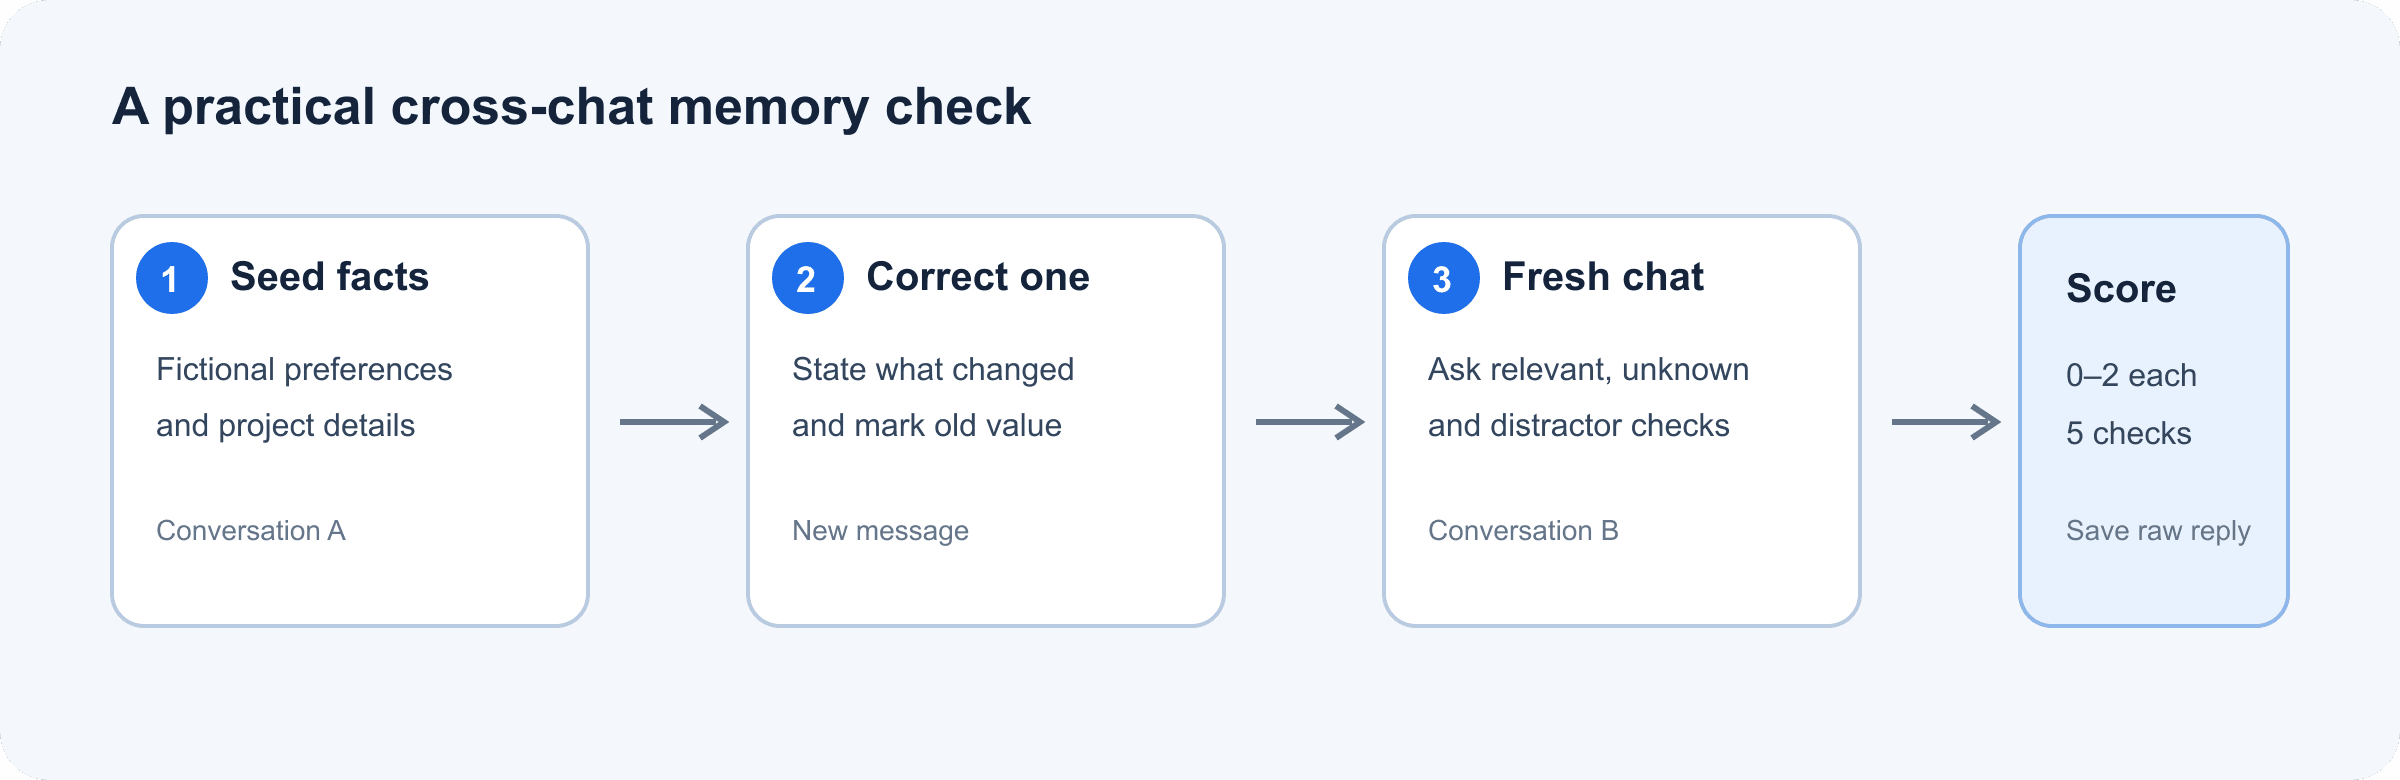
Flusso del test di Active Memory di Muse Wonder: dai dettagli fittizi alla correzione, al recupero in una nuova chat e alla valutazione
Il flusso del test separa i fatti iniziali, una correzione esplicita e il recupero in una nuova conversazione.
Cosa dovrebbe fare Active Memory di Muse Wonder
Meta descrive Active Memory come la capacità di portare con sé un contesto importante su una persona attraverso le conversazioni e di recuperare dettagli quando contano per un'attività successiva. Active Focus si riferisce al lavoro continuato verso un obiettivo, inclusi il provare alternative quando si è bloccati e l'adattamento a nuove informazioni. Queste idee sono correlate, ma rispondono a domande diverse: la memoria riguarda quale contesto viene richiamato; il focus riguarda come procede il lavoro.
Questa descrizione è un'affermazione sulle capacità del prodotto, non una garanzia che ogni interfaccia o chiamata API condivida automaticamente la cronologia di un utente. Meta dice che Muse Wonder è disponibile tramite la sua Model API e Muse Code. La sua documentazione per sviluppatori elenca una finestra di contesto di 1.048.576 token e impostazioni di ragionamento supportate, ma una finestra di contesto è la quantità di contesto che una richiesta può contenere, non la prova che richieste precedenti persistano. Controlla quale cronologia o memoria fornisce effettivamente il prodotto che scegli.
Come eseguire un test di memoria di Muse Wonder
Usa un singolo account e la stessa variante del modello per tutta un'esecuzione. Per un prodotto di chat, attiva la funzione di memoria che intendi valutare e registra la sua impostazione. Per un'integrazione API, annota se la tua applicazione include turni precedenti, un profilo memorizzato o note recuperate nella richiesta. Senza queste informazioni, non puoi attribuire il richiamo al solo modello.
1. Fornisci fatti rilevanti
Nella prima conversazione, incolla questo profilo fittizio. Chiedi solo una conferma, così il modello non trasforma immediatamente i fatti in un piano.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Apri una conversazione davvero nuova nello stesso prodotto, poi chiedi:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Una buona risposta usa la preferenza per attività all'aperto tranquille. Non deve necessariamente menzionare il budget o i crostacei perché nessuno dei due dettagli serve per suggerire un'attività. Fai attenzione a preferenze inventate. Se il prodotto non può accedere alle chat precedenti o la memoria è disattivata, registra “memoria non disponibile in questa superficie” invece di valutare il modello come se avesse ricevuto i fatti.
2. Correggi un fatto obsoleto
In un altro thread di test, introduci un appuntamento e poi sostituiscilo esplicitamente. Mantieni la correzione in un messaggio separato così puoi capire se prevale l'aggiornamento successivo.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Chiedilo in una nuova conversazione:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Supera il test se indica giovedì alle 10:00 e tratta martedì come obsoleto. Una risposta ibrida o un uso sicuro di martedì è un fallimento significativo, anche se ha ricordato perfettamente il dettaglio originale.
3. Aggiungi distrattori e verifica ciò che è sconosciuto
Aggiungi due o tre fatti fittizi innocui alla conversazione iniziale, come un colore di progetto inventato o un numero di pacco fittizio. Dopo un ritardo, avvia una nuova conversazione e fai una domanda su una preferenza rilevante più una su un fatto che non hai mai fornito. Mantieni le domande separate così ogni risposta è facile da valutare.
Un buon risultato usa la preferenza rilevante, omette i dettagli non correlati e dice che non conosce il fatto mancante. Per un test di ritardo più rigoroso, ripeti lo stesso prompt il giorno successivo. Dieci minuti possono verificare il confine di una nuova chat, ma non possono stabilire una conservazione di una settimana.
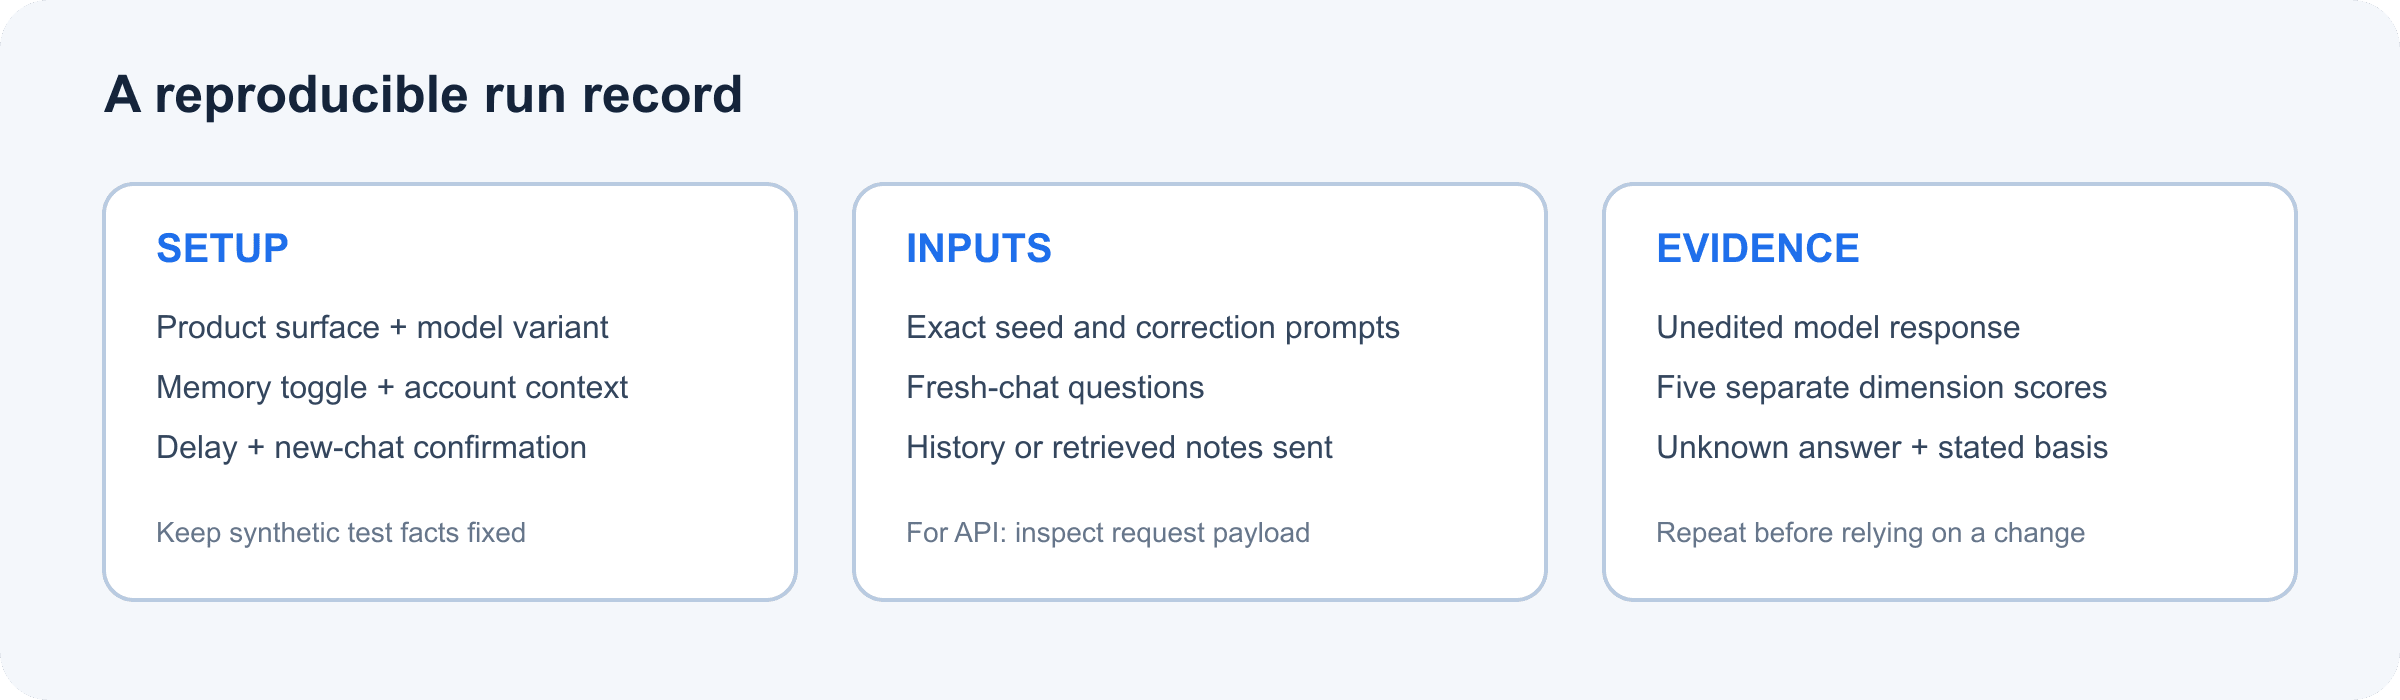
Scheda del test di Active Memory di Muse Wonder con configurazione, domande per una nuova chat e prove da registrare
Tieni insieme prompt, superficie del prodotto, impostazione della memoria, ritardo e risposta grezza così un altro revisore può riprodurre la verifica.
Come valutare il test di Active Memory
Assegna a ogni comportamento un punteggio da 0 a 2. Usa il risultato per confrontare esecuzioni nel tuo flusso di lavoro, non per classificare universalmente i modelli.
| Dimensione | 0 punti | 1 punto | 2 punti |
|---|---|---|---|
| Recupero di fatti rilevanti | Manca o inventa il fatto necessario | Parzialmente corretto | Seleziona accuratamente il fatto giusto |
| Gestione delle correzioni | Usa il valore vecchio | Vago o mescola entrambi | Usa il valore più recente e identifica quello vecchio come obsoleto |
| Controllo dei distrattori | Viene attirato verso fatti irrilevanti | Include qualche dettaglio irrilevante | Usa solo il contesto rilevante per la domanda |
| Incertezza | Indovina con sicurezza | Usa cautele ma indovina comunque | Dice chiaramente che la risposta non è stata fornita |
| Tracciabilità | Non fornisce alcuna base | Nomina solo una parte della sua base | Elenca brevemente il contesto su cui si è basato |
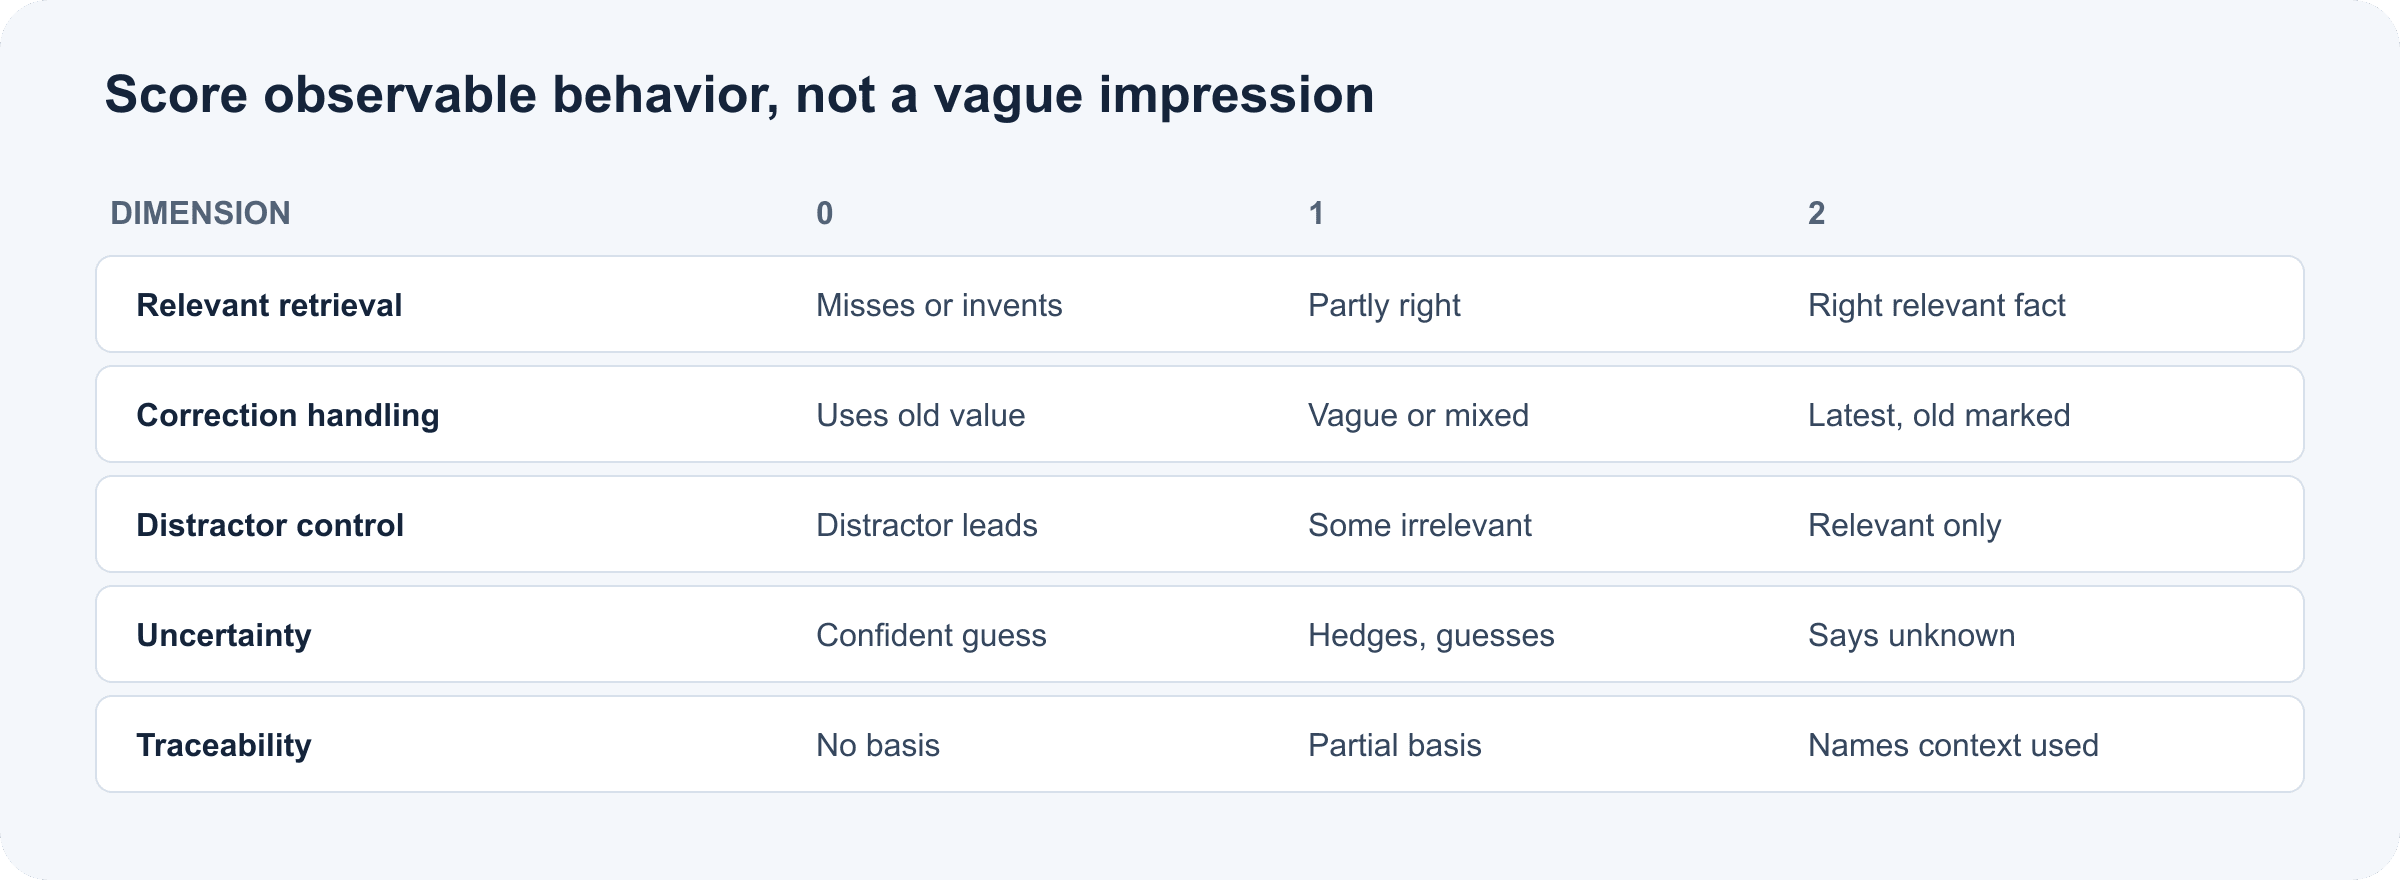
Cinque dimensioni di valutazione di Active Memory da zero a due punti, con criteri di superamento osservabili
La rubrica 0–2 trasforma un'impressione soggettiva in cinque verifiche osservabili.
Dieci punti sono un punteggio interno comodo, non una soglia convalidata. Mantieni i punteggi delle singole dimensioni: un totale può nascondere un grave fallimento di correzione dietro un buon recupero altrove. Salva i prompt esatti e gli output non modificati, poi ripeti l'esecuzione prima di cambiare la decisione di distribuzione.
Cosa può e non può dirti MemoryBench
La model card di Meta descrive MemoryBench come una valutazione interna su conversazioni lunghe e complesse da 64K a 100K token. I suoi task includono molteplici fatti, conversazioni con distrattori e turni iniettati che entrano in conflitto con i dettagli target o li aggiornano successivamente; un giudice LLM valuta le risposte rispetto a criteri ponderati e specifici per domanda. Questo è un contesto utile per comprendere l'ambito del benchmark, ma non equivale all'impostazione di memoria personale di un utente che funziona tra chat.
La model card spiega la progettazione del task; non trasforma questo esercizio di 10 minuti in una replica. Il punteggio pubblicato da Meta è prova relativa alla configurazione di valutazione riportata. La tua esecuzione risponde a una domanda operativa più ristretta: questa particolare superficie del prodotto, configurazione e account recuperano i fatti di cui il tuo flusso di lavoro ha bisogno? Nessuno dei due da solo stabilisce una memoria affidabile per ogni utente o attività.
Muse Wonder vs. Muse Wonder Full: dove eseguire il test
Le due varianti non hanno percorsi di accesso identici. L'attuale documentazione per sviluppatori di Meta dice che Muse Wonder (muse-wonder-1.0) è disponibile su Model API e in Muse Code. Muse Wonder Full è disponibile solo in Muse Code nei piani Power Usage e Maximum Usage. Impostare lo sforzo di ragionamento di Muse Wonder su “max” non lo commuta in Wonder Full.
| Variante | Accesso documentato | Cosa registrare |
|---|---|---|
| Muse Wonder | Model API e Muse Code | ID del modello API o superficie Muse Code, più se viene fornito il contesto precedente |
| Muse Wonder Full | Muse Code sui piani Power Usage e Maximum Usage | Piano, variante selezionata e impostazione della memoria disponibile in quella superficie |
Esegui lo stesso profilo fittizio separatamente in ogni superficie disponibile. Non confrontare un test Muse Code che può recuperare dettagli salvati del profilo con una chiamata API stateless che ha ricevuto solo il prompt corrente. Confronteresti sistemi diversi, non solo due varianti del modello.
Privacy e test riproducibili
Usa preferenze, date e dettagli di progetto inventati. Prima di provare dati reali, esamina i controlli della memoria del prodotto, il percorso di eliminazione, le informazioni sulla conservazione e l'impostazione di utilizzo dei dati. La documentazione API di Meta dice che i contenuti in modalità Standard non vengono usati per addestrare i modelli Meta; Muse Code offre anche la modalità Contributor, attiva per impostazione predefinita, che può usare i contenuti per l'addestramento se non viene disattivata. Controlla le impostazioni e i termini correnti del prodotto che usi invece di presumere che tutte le superfici gestiscano i dati allo stesso modo.
Per un'API, separa il modello dal livello di memoria della tua applicazione. Un database, un sistema di recupero o la cronologia dei prompt che il tuo software invia potrebbero essere ciò che ricorda. Registra ciò che l'applicazione ha recuperato e ciò che ha passato in ogni richiesta, mantenendo sintetici i record di test.
I team possono trasformare i tre round in un piccolo set di valutazione versionato. Mantieni fissi il profilo dei fatti, la correzione, i distrattori, la variante del modello, le impostazioni del prodotto, il ritardo e la risposta grezza. Riesegui dopo modifiche di configurazione o del modello e rivedi i fallimenti per dimensione. Per i team che confrontano già modelli ospitati in un harness riproducibile, Atlas Cloud fornisce un catalogo e una guida unificata alle API LLM. Puoi sfogliare la sua directory dei modelli per un confronto separato. La directory attualmente non elenca Muse Wonder, e usare un altro modello lì verificherebbe solo il contesto esplicitamente fornito a quel modello, a meno che la tua applicazione aggiunga un livello di memoria.
Domande frequenti
Come posso testare Active Memory di Muse Wonder tra chat diverse?
Fornisci fatti fittizi in una conversazione, poi chiedi dettagli rilevanti in una nuova conversazione. Includi una correzione e un fatto mancante, e registra la superficie del prodotto e le impostazioni della memoria.
Muse Wonder ricorda le correzioni o solo i dettagli precedenti?
La descrizione di MemoryBench di Meta include turni che aggiornano o entrano in conflitto con dettagli precedenti. Il tuo test di correzione verifica se la configurazione attuale del prodotto segue l'aggiornamento; ripetilo perché un singolo risultato non stabilisce un comportamento coerente.
Questo test della cronologia chat è uguale a MemoryBench di Meta?
No. Meta descrive MemoryBench come un benchmark interno a contesto lungo che usa conversazioni da 64K a 100K token, distrattori, fatti in conflitto o aggiornati e un giudice LLM. Questa breve verifica è uno smoke test pratico, non una replica.
Posso testare Active Memory di Muse Wonder tramite l'API?
Puoi testare il richiamo, da parte del modello API, del contesto che raggiunge la richiesta. Per la persistenza tra richieste, verifica cosa memorizza e invia l'API o la tua applicazione. La disponibilità di una grande finestra di contesto non dimostra di per sé che richieste separate condividano la memoria.
Come distinguo la memoria del modello dalla memoria memorizzata dall'app?
Ispeziona la richiesta completa inviata al modello. Se la tua applicazione inserisce un profilo, una nota recuperata o una conversazione precedente, è quel livello software ad aver fornito la memoria. Confronta con un'esecuzione controllata che la omette, dove appropriato.
È sicuro usare informazioni personali in un test di Active Memory?
Usa informazioni fittizie per il test. Se in seguito valuti dati reali, rivedi prima le impostazioni di memoria, eliminazione, conservazione e utilizzo dei dati del prodotto specifico.
Un test di Active Memory di Muse Wonder è più utile quando rivela quale passaggio ha fallito: accesso al contesto precedente, recupero, correzione, filtraggio o incertezza. Salva l'esecuzione grezza, poi ripetila con la configurazione esatta di cui prevedi di fidarti.
Fonti: Annuncio di Muse Wonder di Meta (12 ottobre 2026); Documentazione dei modelli di Meta Model API (consultato il 15 ottobre 2026); Model Card di Muse Wonder (ottobre 2026)._





