Un primato nei benchmark può sembrare decisivo finché lo stesso modello non manca un requisito all'esecuzione successiva. Un utile test di affidabilità di Muse Wonder pone una domanda più ristretta: il modello completa il tuo compito, secondo i tuoi standard, ripetutamente, nelle stesse condizioni?
Le prime evidenze sono contrastanti perché i test misurano cose diverse. Un set di attività del giorno di lancio ha assegnato a Muse Wonder standard un punteggio molto alto dopo una sola esecuzione per attività. Un'altra valutazione ha trovato punti di forza nell'analisi della ricerca insieme a debolezze nella progettazione di sondaggi, nelle affermazioni di vendita e nel layout delle slide. Nessuno dei due risultati dimostra con quanta coerenza gestirà la tua codebase o il tuo flusso di lavoro agentico.
Punti chiave
- Tratta i benchmark di lancio come segnali di capacità, non come garanzie di produzione.
- Muse Wonder e Muse Wonder Full sono varianti separate. Mantieni separati i loro risultati.
- Misura tasso di superamento, ripetibilità, completamento e recupero come esiti distinti.
- Inizia con 10-20 attività reali, congela la configurazione e ripeti le attività importanti almeno tre volte.
- Scegli una soglia in base al costo di una risposta errata e al tuo processo di revisione umana.
Muse Wonder è affidabile? La risposta breve
Le evidenze disponibili al 15 ottobre 2026 supportano una valutazione attività per attività, non un verdetto universale di affidabilità. Muse Wonder ha ottenuto buoni risultati in alcuni controlli iniziali, mentre altre esecuzioni hanno rivelato errori o lavoro di presentazione che necessitava ancora di revisione. Gli studi differiscono per prompt, impostazioni di ragionamento, valutatori, dimensioni del campione e numero di tentativi.
(Meta, 12 ottobre 2026) afferma che Muse Wonder e Muse Wonder Full sono progettati per attività agentiche professionali e personali, con funzionalità chiamate Active Memory e Active Focus. Queste sono dichiarazioni di prodotto sul comportamento previsto. L'affermazione che un modello possa riprendersi dagli errori è un motivo per testare il recupero nel tuo flusso di lavoro, non una prova che si riprenderà in modo affidabile.
Mantieni Wonder standard separato da Wonder Full. Meta elenca Muse Wonder standard per la sua Model API e Muse Code, mentre Full è offerto tramite abbonamenti Muse Code. Eseguire Wonder standard con un'impostazione di ragionamento più alta non lo rende Full.
Per una decisione che puoi difendere, testa la variante e il percorso esatti che intendi distribuire. Considera un'attività riuscita solo quando soddisfa una regola di accettazione scritta e il suo risultato può essere verificato.
Cosa dovrebbe misurare un test di affidabilità di Muse Wonder
Accuratezza e coerenza sono diverse
Un tasso di superamento misura quanti tentativi soddisfano una rubrica definita. La coerenza misura se esecuzioni ripetute della stessa attività producono ogni volta esiti accettabili. Un modello può avere un tasso di superamento elevato pur variando in modi che contano per il tuo flusso di lavoro.
Traccia quattro dimensioni separatamente:
| Misura | Cosa registrare | Esempio di controllo |
|---|---|---|
| Accuratezza | Tentativi che superano la rubrica | Il totale estratto corrisponde al documento di origine? |
| Coerenza | Se i tentativi ripetuti superano e concordano | Tre esecuzioni preservano gli stessi vincoli richiesti? |
| Qualità del completamento | Se ogni deliverable richiesto è presente | Tutti i file, le citazioni e i campi richiesti sono inclusi? |
| Recupero | Se l'esecuzione riprende correttamente dopo un guasto | Segnala un errore dello strumento, riprova in sicurezza, poi verifica lo stato finale? |
Una risposta che sembra completa non è necessariamente completa. Una modifica al codice necessita di test; un riepilogo di ricerca necessita di fonti tracciabili; un'esecuzione agentica necessita di prove che la sua azione finale sia avvenuta.
Separare i guasti del modello dai guasti del flusso di lavoro
Registra abbastanza contesto per distinguere un errore del modello da un problema di serving o di strumento. Come minimo, registra la variante e la versione del modello, l'impostazione di ragionamento, il prompt, la configurazione degli strumenti, la data, il tempo di esecuzione, il costo in token o per attività e l'output grezzo.
Classifica i guasti prima di valutarli:
- Modello: fatto errato, ragionamento errato o requisito mancato.
- Strumento: chiamata API fallita, argomenti dello strumento non validi o risultato errato da un sistema esterno.
- Serving: timeout, interruzione o endpoint non disponibile.
- Valutazione: rubrica poco chiara o controllo che non riesce a distinguere lavoro accettabile da lavoro inaccettabile.
Se combini tutti e quattro in un unico tasso di errore, non saprai cosa correggere.
Cosa mostrano gli attuali test su Muse Wonder
I confronti di benchmark pubblicati da Meta sono evidenze del fornitore sulle prestazioni nei benchmark. Non sono la stessa cosa di una valutazione indipendente di un flusso di lavoro. Anche i test indipendenti hanno limiti: un piccolo set di attività pubbliche, un singolo tentativo, un particolare percorso del modello o una valutazione di preferenza umana rispondono solo a una domanda ristretta.
La tabella seguente separa le evidenze per fonte e ambito. È una guida a ciò che ogni risultato può supportare, non un punteggio combinato.
| Fonte di evidenza | Cosa ha testato | Data e configurazione | Cosa può dirti | Limite principale |
|---|---|---|---|---|
| Annuncio e materiali del modello Meta | Benchmark di capacità e funzionalità agentiche previste | Annunciati il 12 ottobre 2026; confronti riportati dal fornitore | Quali capacità Meta enfatizza e quali varianti ha rilasciato | I test del fornitore non stabiliscono la ripetibilità nel tuo flusso di lavoro |
| (Spring Prompt, 13 ottobre 2026) | Sondaggi, schede prodotto, slide, pianificazione pubblicitaria, scacchi e ricerca visiva | 13 ottobre; modello API standard, generalmente ragionamento medio; attività pubbliche | Le prestazioni variavano per attività; alcune valutazioni includevano esecuzioni ripetute di schede prodotto | La maggior parte delle attività erano campioni piccoli; molti risultati erano una sola esecuzione per attività; non è un test di coding o Muse Code |
| (Quantslant, 12 ottobre 2026) | 23 attività che spaziano tra agenti, coding, scrittura, ragionamento e un documento lungo | 12 ottobre; modello standard tramite OpenRouter, ragionamento basso; una esecuzione per attività | Il modello ha superato quel set di attività definito con un tasso elevato in quella configurazione | Una singola esecuzione non può misurare la coerenza tra esecuzioni; i risultati vicini al 100% richiedono un'ispezione a livello di attività |
| Post della community | Reazioni individuali a coding, agenti e benchmark | Post del periodo di lancio; utenti e attività autoselezionati | Spunti utili su cosa testare dopo | Aneddoti e voti non sono tassi di superamento misurati |
Il contrasto tra le fonti è importante. Quantslant ha riportato 99,7% sul suo set di 23 attività, con una esecuzione per attività e un'impostazione di ragionamento bassa. Ha anche notato un unit test fallito in un'attività di coding di conversione da numero a parole. Quel risultato è evidenza su quella particolare suite, non prova che il 99,7% delle attività quotidiane verrà superato o che esecuzioni ripetute concorderanno.
Spring Prompt ha riportato un quadro più variegato per Wonder standard con le impostazioni predefinite dell'API il 13 ottobre. Il suo punteggio di analisi della ricerca era 93,6/100 su nove attività pubbliche, mentre solo tre dei nove piani di sondaggio hanno superato tutti i controlli. Per le schede prodotto, la quota ritenuta affidabilmente pronta alla pubblicazione su tre ripetizioni era 66,1% per i brief fattuali e 51,8% per i brief di vendita. Cinque presentazioni su sei necessitavano di correzioni di layout, e una è stata giudicata presentabile. Queste sono misure separate con denominatori separati, non pezzi di un unico punteggio complessivo.
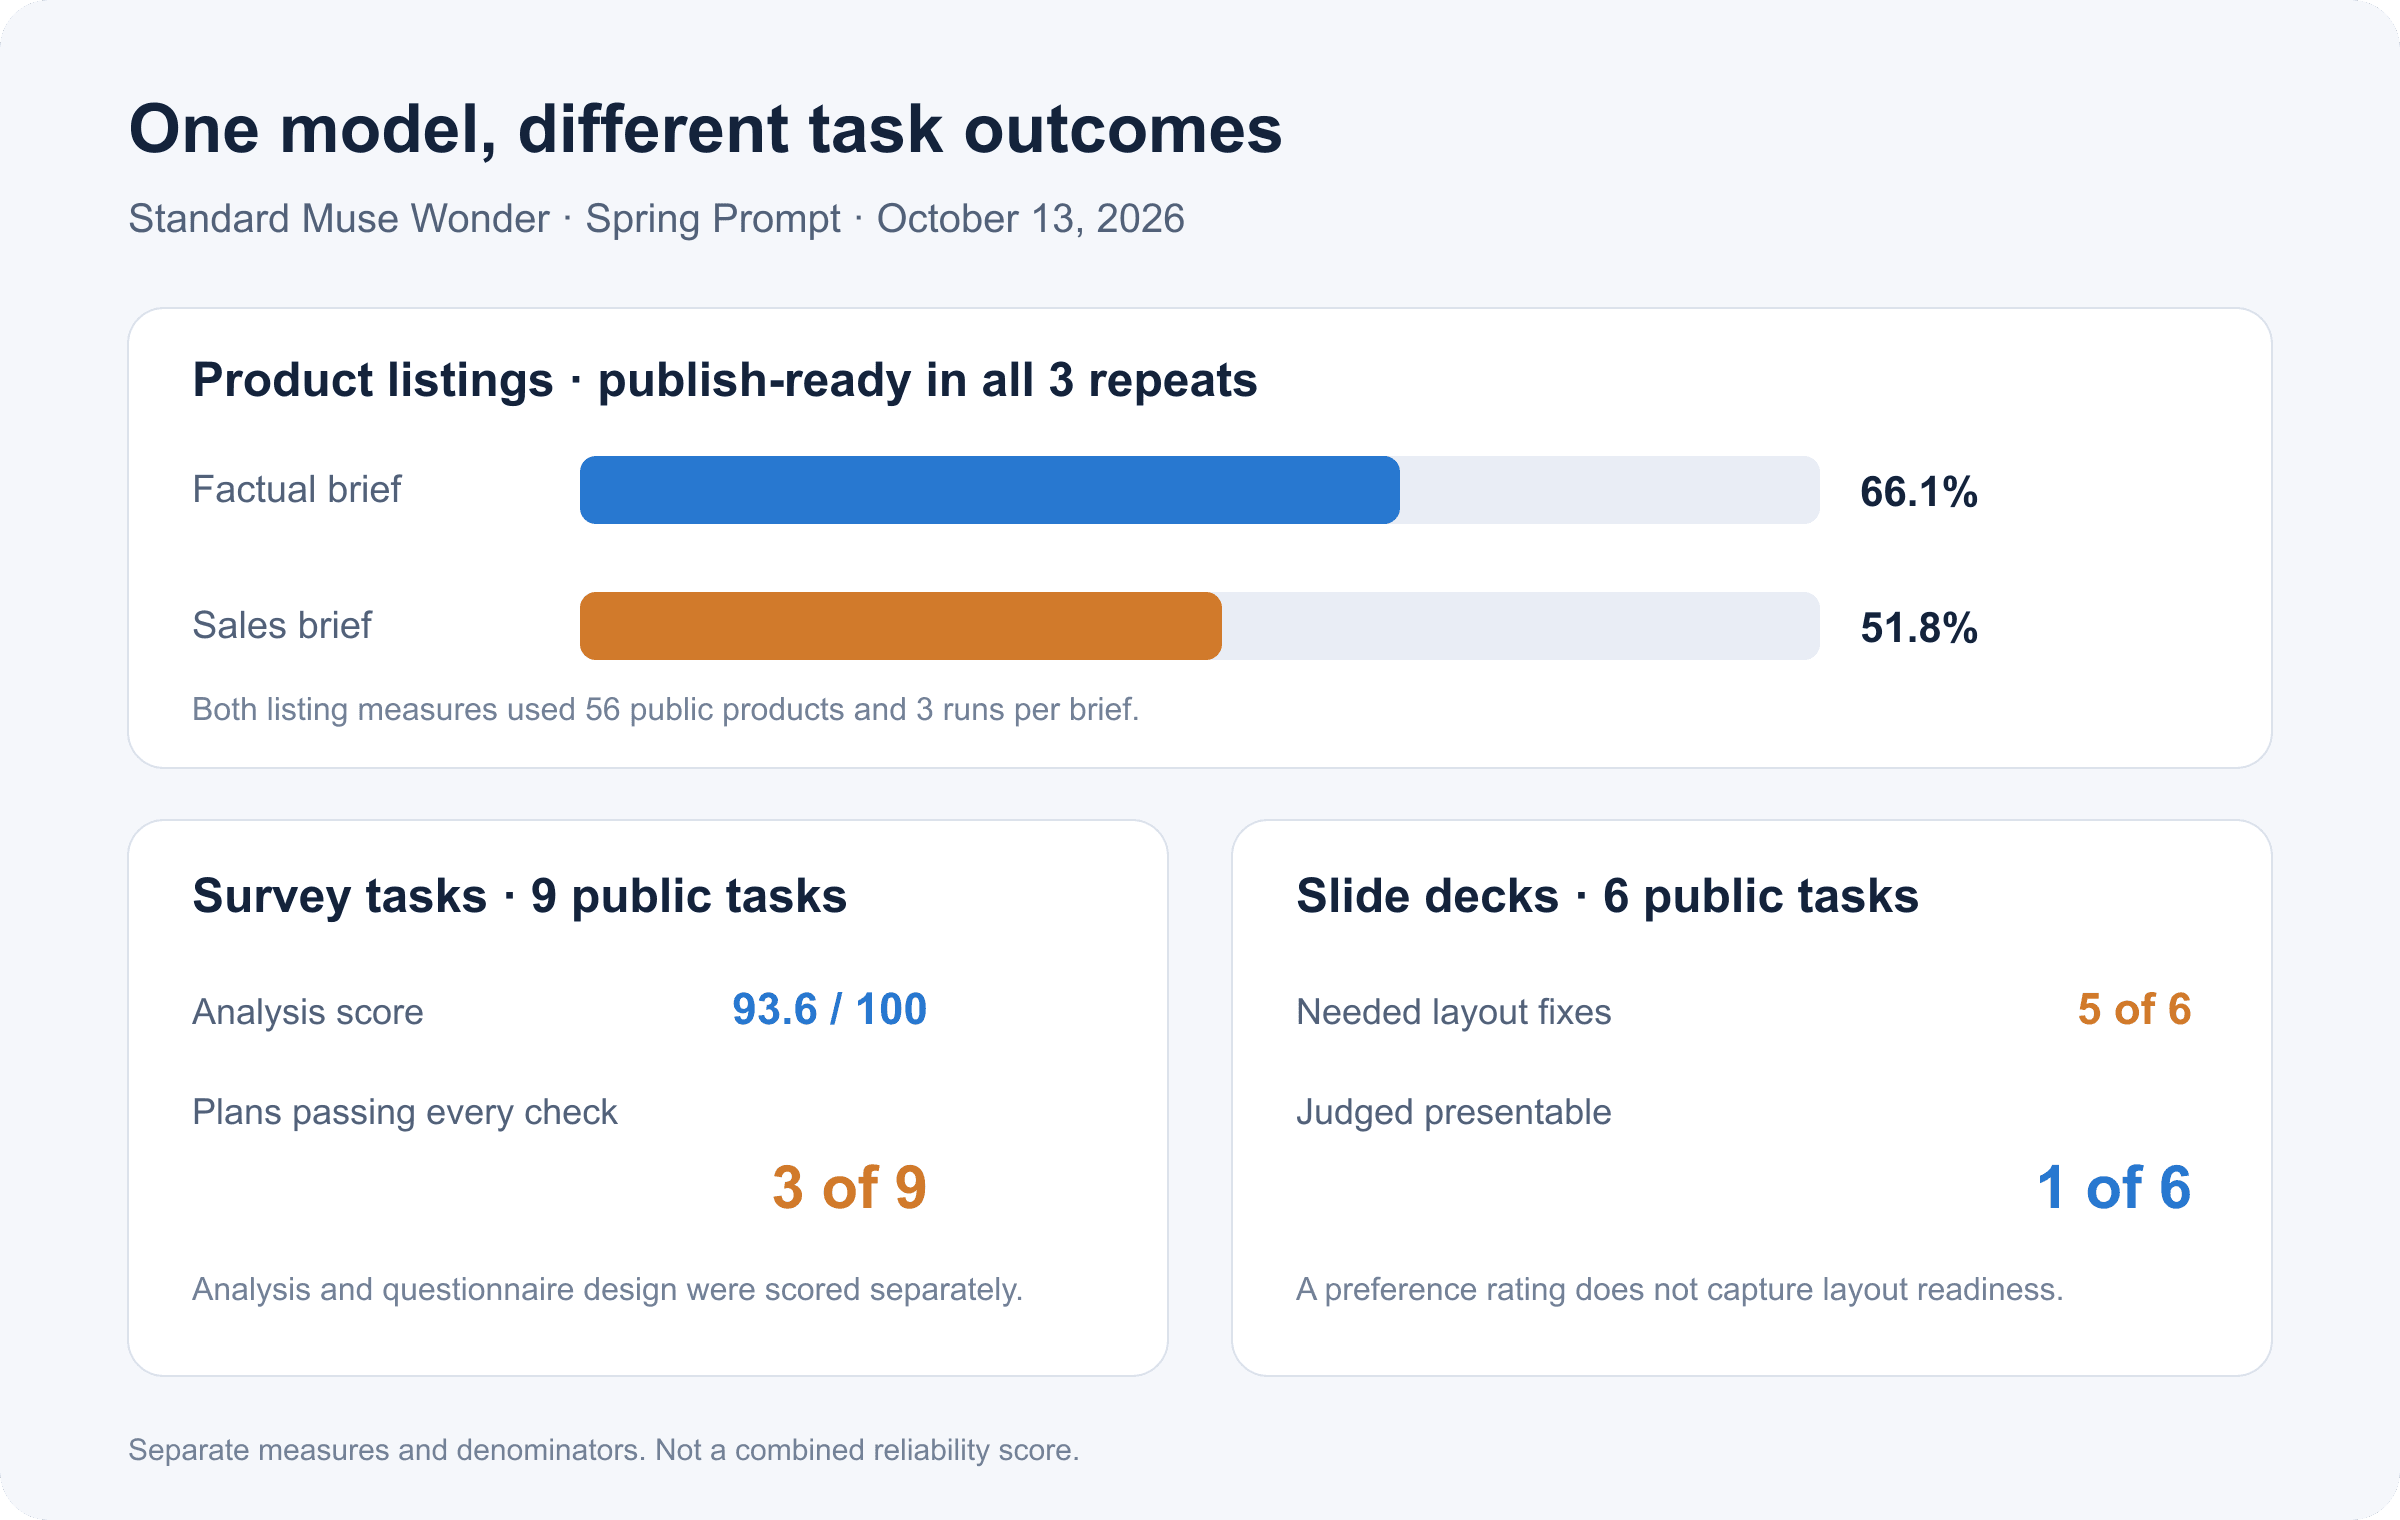
Risultati indipendenti delle attività da una valutazione. Le misure usano denominatori diversi e sono mostrate separatamente, non combinate in un punteggio.
I test di Spring Prompt non hanno misurato coding, memoria persistente o Muse Code. Il suo confronto, quindi, non può stabilire se Wonder sia affidabile per il coding o se Full si comporti meglio. Mostra però perché un'unica etichetta ampia nasconde differenze importanti tra le attività.
L'articolo di lancio di Meta afferma che Muse Wonder standard è disponibile tramite Meta Model API e Muse Code, mentre Wonder Full è disponibile per gli abbonati a Muse Code. Descrive Active Memory e Active Focus come funzionalità per conservare dettagli utili e continuare il lavoro nonostante gli errori. Quelle descrizioni aiutano a definire casi di test, ma l'articolo di lancio non è uno studio indipendente con esecuzioni ripetute.
Per le affermazioni su coding e build 3D discusse nei thread della community della settimana di lancio, tratta i post come ipotesi. Trasforma una lamentela specifica in un'attività riproducibile e verifica l'output. Non convertire commenti o upvote in un tasso di successo.
Come eseguire un test di affidabilità di Muse Wonder ripetibile
1. Costruisci un piccolo set di attività dal lavoro reale
Scegli 10-20 attività che il tuo team si aspetta effettivamente che il modello gestisca. Suddividile in categorie come coding, estrazione fattuale, rispetto delle istruzioni, contesto lungo e uso di strumenti. Preferisci attività con test oggettivi, risposte di riferimento o una rubrica chiara.
Includi casi limite realistici: input mancante, requisiti contrastanti, uno strumento non disponibile e un'attività che dovrebbe attivare una domanda di chiarimento. Tieni fuori dati sensibili o regolamentati a meno che il tuo processo approvato lo consenta.
2. Congela prompt, modello e impostazioni
Scrivi il prompt esatto e le istruzioni di sistema. Registra nome e versione del modello, livello di ragionamento, strumenti, contesto fornito, data e qualsiasi limite di tempo. Non confrontare Wonder standard con Full come se fossero lo stesso modello.
Un utile prompt di test può chiedere al modello di mostrare le sue prove e identificare i requisiti non testabili:
Leggi la specifica e l'implementazione allegate. Restituisci solo: (1) ogni requisito contrassegnato come PASS, FAIL o NOT TESTABLE; (2) le prove esatte per ogni stato; (3) qualsiasi requisito mancante; (4) un test minimo riproducibile per ogni FAIL. Non dichiarare che un test è stato superato se non puoi indicarne l'output.
Questo è un input di valutazione, non una garanzia che il modello lo seguirà. Valuta la risposta risultante e verifica in modo indipendente qualsiasi output di test dichiarato.
3. Ripeti le attività e valuta ogni tentativo
Esegui ogni attività ad alto impatto almeno tre volte con la stessa configurazione. Se il budget consente solo un tentativo, etichetta il risultato come campione iniziale anziché come risultato di coerenza. Conserva ogni risposta grezza; non riportare solo la migliore.
Usa una riga per ogni tentativo. Mantieni stabile la regola di accettazione tra le esecuzioni.
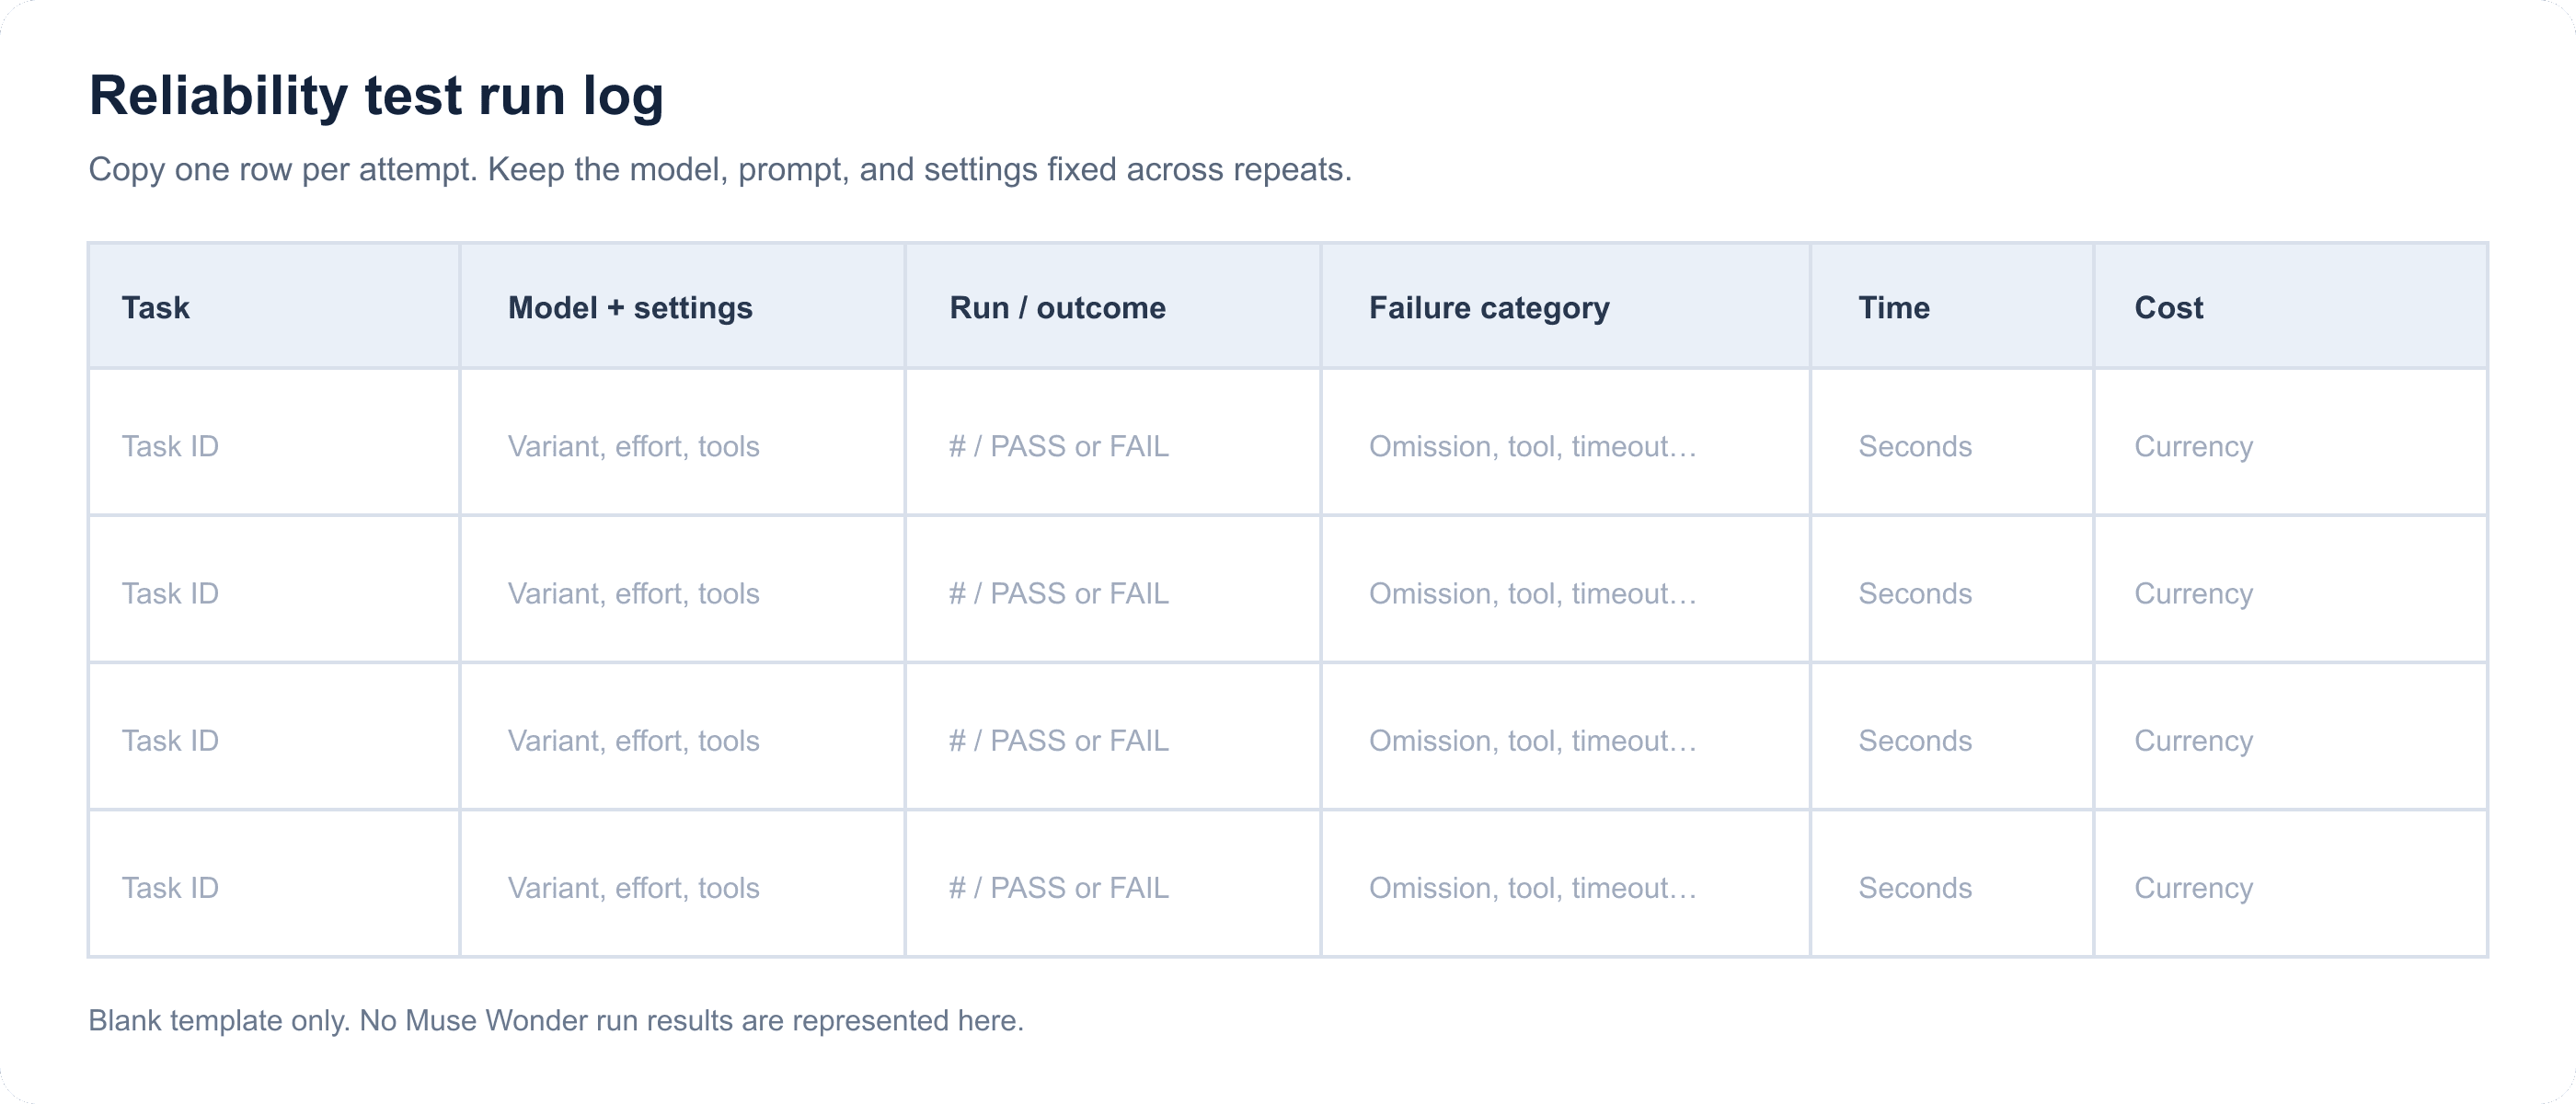
Modello di record riutilizzabile e vuoto. Compila una riga per tentativo; non contiene risultati misurati di Muse Wonder.
4. Mantieni un registro dei guasti e verifica il recupero
Usa categorie specifiche: errore fattuale, omissione, test del codice fallito, errore dello strumento, timeout, dichiarazione di completamento non supportata o mancata corrispondenza di formato. Per il lavoro a più passaggi, annota dove l'esecuzione si è fermata e se un nuovo tentativo ha ripetuto azioni completate o verificato lo stato finale.
Un agente che dice “done” senza prove non ha superato un controllo di completamento. Richiedi un risultato di test, un file salvato, una citazione della fonte o uno stato verificato che corrisponda all'attività.
5. Stabilisci una soglia decisionale in base al costo del guasto
Non esiste una soglia universale utile per il tasso di superamento. Una bozza che una persona controlla riga per riga ha un profilo di rischio diverso da una migrazione di database o da un pagamento automatizzato.
Stabilisci la soglia da tre fattori:
- Quanto è dannoso o costoso un risultato errato?
- Una persona può individuare l'errore prima che influenzi qualcuno?
- Il flusso di lavoro fallisce in modo sicuro, con un arresto chiaro e una traccia di audit?
Per bozze a basso rischio, la revisione può bastare. Per modifiche al codice, finanza, legale, salute o azioni che influenzano gli utenti, usa test più solidi e verifica indipendente. Non lasciare che una media elevata nasconda un singolo modo di guasto grave.
Affidabilità di Muse Wonder per tipo di attività
Coding e build a più passaggi
Esegui la suite di test effettiva del repository e controlla il comportamento richiesto. Valuta copertura dei requisiti, fallimenti di regressione e se le modifiche dichiarate dal modello corrispondono ai file e all'output dei test. Una registrazione dello schermo o una spiegazione convincente non sostituiscono un controllo eseguibile.
La prima suite di Quantslant includeva quattro attività di coding e ha riportato 15 unit test su 16 superati in un'attività di conversione da numero a parole. È un segnale piccolo e basato su una singola esecuzione. Spring Prompt non ha testato esplicitamente il coding, quindi i suoi risultati non dovrebbero essere usati per generalizzare sull'affidabilità degli agenti di coding.
Ricerca ed estrazione fattuale
Usa un pacchetto di fonti o risposte di riferimento che il tuo revisore possa ispezionare. Controlla ogni affermazione fattuale rispetto a una fonte primaria e traccia citazioni inventate e attribuzioni errate separatamente dalla qualità generale della risposta.
L'analisi dei sondaggi di Spring Prompt è stata un punto di forza relativo nella sua piccola valutazione, ma la progettazione delle domande del sondaggio era più debole. Un punteggio di analisi elevato non dovrebbe certificare silenziosamente lo strumento del sondaggio o le fonti dietro una nuova attività di ricerca.
Flussi di lavoro con contesto lungo e agentici
Controlla se il modello conserva ogni vincolo, usa correttamente ogni strumento e verifica lo stato finale. Testa deliberatamente il recupero dalle interruzioni: ferma un'esecuzione dopo un passaggio noto, poi osserva se riprende da un checkpoint o ripete un effetto collaterale.
L'annuncio di Meta descrive capacità di memoria e recupero, ma le prime valutazioni pubbliche citate qui non stabiliscono la coerenza a lungo termine per memoria persistente o recupero agentico. Misura direttamente quei comportamenti prima di affidarti a essi.
Muse Wonder vs. Muse Wonder Full: mantieni separate le evidenze
Muse Wonder e Muse Wonder Full sono varianti distinte. Le informazioni di lancio di Meta descrivono percorsi di accesso separati, e i test API indipendenti su Wonder standard non diventano risultati di Full solo perché cambia l'impostazione di ragionamento.
| Domanda di confronto | Cosa supportano le evidenze disponibili |
|---|---|
| Full è uguale a Wonder standard al massimo ragionamento? | No. Trattali come varianti distinte e registra il nome esatto. |
| La valutazione API di Spring Prompt citata ha testato Full? | No. Ha testato Wonder standard; Full era fuori da quel confronto. |
| I numeri API standard citati possono classificare Full? | No. Non testano Full. |
| Cosa renderebbe equo un confronto? | Stesso set di attività, rubrica di valutazione, finestra temporale, accesso agli strumenti e impostazioni documentate, con ripetizioni per entrambe le varianti. |
Un confronto equo inizia con attività appaiate e condizioni abbinate. Se i percorsi di accesso impongono prompt, strumenti o fatturazione diversi, documenta tali differenze e definisci il confronto esplorativo.
Costo, accesso e dove testare Muse Wonder
Confronta il costo per attività accettata, non solo il prezzo indicato per token. Prompt lunghi, nuovi tentativi, token di ragionamento, chiamate agli strumenti, timeout e revisione umana cambiano tutti il costo di un risultato utilizzabile. Quantslant ha riportato le tariffe token di Wonder standard come $4 per milione di token di input e $20 per milione di token di output il 12 ottobre 2026, e la sua esecuzione su 23 attività è costata $0.64. Si tratta di un percorso e di un carico di lavoro riportati, non di un prezzo universale per attività.
L'attuale annuncio di lancio di Meta elenca Wonder standard tramite Meta Model API e Muse Code, e Full tramite abbonamenti Muse Code. Conferma accesso, idoneità regionale e fatturazione attuale nell'interfaccia ufficiale prima di fare budget.
Inizia da Atlas Cloud per una visione più ampia della sua piattaforma per sviluppatori. Al 15 ottobre 2026, non ho potuto confermare Muse Wonder nel catalogo modelli, quindi questo articolo non presenta Atlas Cloud come percorso di esecuzione per questo modello. Se il tuo team sta confrontando altri modelli già elencati lì, la libreria di modelli Atlas Cloud può aiutarti a identificare candidati da eseguire sullo stesso set di attività.
Il risultato utile di un test di affidabilità di Muse Wonder è una decisione di deployment legata a evidenze: quale attività è stata superata, con quale frequenza, quanto è costata e quale revisione rimane necessaria.
Domande frequenti
Muse Wonder è affidabile per il coding?
I primi test di lancio forniscono solo un piccolo campione di coding. Quantslant ha riportato quattro attività di coding, con un unit test mancato in un'attività, mentre Spring Prompt non ha testato il coding. Esegui i test del repository sulle tue attività e ripeti quelle importanti prima di prendere una decisione su un flusso di lavoro di coding.
Come posso testare personalmente l'affidabilità di Muse Wonder?
Usa un set fisso di attività reali, conserva le esatte impostazioni di modello e prompt, definisci in anticipo i criteri di superamento e conserva ogni output. Ripeti le attività importanti e verifica i risultati con test o documenti di origine.
Quante volte dovrei ripetere ogni attività con Muse Wonder?
Usa almeno tre esecuzioni per le attività ad alto impatto come controllo iniziale di coerenza. Tre tentativi restano un campione piccolo, quindi amplia il set quando gli errori sono costosi o gli output variano.
Qual è la differenza tra Muse Wonder e Muse Wonder Full?
Sono varianti di modello separate con percorsi di disponibilità diversi. Non trattare Wonder standard al massimo ragionamento come Full, né trasferire risultati tra loro senza un test abbinato.
Posso fidarmi dei punteggi benchmark di Muse Wonder di Meta?
Usali come evidenze di capacità riportate dal fornitore e leggi la configurazione del benchmark. Non provano prestazioni coerenti con i tuoi prompt, strumenti ed esecuzioni ripetute.
Muse Wonder è disponibile su Atlas Cloud?
Non ho potuto verificarlo nel catalogo modelli di Atlas Cloud al 15 ottobre 2026. Controlla il catalogo live prima di scegliere un provider di esecuzione.





