

Una voce può sembrare che qualcuno stia trattenendo le lacrime mentre il volto animato resta neutro. Con OmniHuman 2.0 emotional voice and facial expression matching, il primo intervento spesso è ascoltare con più attenzione, non aggiungere altri aggettivi. L'audio porta già parole, tempi ed enfasi vocale; un breve prompt dovrebbe dirigere la performance visibile che supporta quei segnali.
Questa guida offre ai creator un metodo ripetibile per preparare un ritratto e una traccia, scrivere un prompt mirato e rivedere il risultato per individuare discrepanze significative. Copre parlato e canto, separando le informazioni documentate dalle indicazioni di terze parti e dalle dichiarazioni di prodotto non verificate.
Punti chiave
- Considera l'audio come fondamento della performance e dirigì solo azioni visibili, inquadratura e dettagli di scena.
- Segna i momenti emotivi prima di scrivere il prompt, poi controlla quegli stessi momenti con l'audio disattivato e attivo.
- Cambia una variabile per tentativo; un prompt non può risolvere ogni problema dell'audio di origine o della generazione.
Come OmniHuman 2.0 collega audio, espressione facciale e movimento
Un modo utile per pensare a un modello di ritratto guidato dall'audio è assegnare a ogni input un compito. L'immagine fissa il soggetto visibile. La registrazione fornisce il parlato o il canto, inclusi tempi e interpretazione. Una direzione testuale opzionale può descrivere la performance o la scena. Il comportamento e i controlli esatti possono variare in base all'implementazione del prodotto, quindi non trattare la ricerca generale su OmniHuman o le istruzioni di uno studio di terze parti come specifiche ufficiali di OmniHuman 2.0.
La ricerca originale su OmniHuman-1 descrive l'animazione umana condizionata da combinazioni di immagine, testo, audio e posa. Quel paper stabilisce l'inquadramento più ampio della famiglia di ricerca, non l'interfaccia, i limiti o la qualità esatti di OmniHuman 2.0 (ICCV 2025, paper OmniHuman-1).
| Input | Contributo probabile | Cosa puoi preparare |
|---|---|---|
| Ritratto di riferimento | Aspetto del soggetto e posa iniziale | Scegli un volto chiaro e un'inquadratura adatta al movimento previsto |
| Audio parlato o cantato | Parole, cadenza, pause, energia vocale | Usa una traccia pulita con un'interpretazione intenzionale e taglia i silenzi irrilevanti |
| Prompt di direzione opzionale | Azioni visibili, inquadratura, scena o segnali di umore | Fornisci alcune indicazioni concrete che concordino con la registrazione |
La sincronizzazione labiale e la performance emotiva sono correlate, ma non sono lo stesso controllo di qualità. Una bocca può seguire le sillabe mentre occhi, testa o gesto risultano sbagliati per la battuta. Allo stesso modo, un volto può sembrare espressivo mentre i tempi si discostano dalla voce. Controlla entrambi.
Le guide di terze parti su OmniHuman 2.0 descrivono un flusso di lavoro immagine più audio con direzione testuale opzionale, ma quelle pagine non sono documentazione tecnica BytePlus. La documentazione Atlas accessibile al pubblico copre il suo modello Avatar Omni Human 1.5, non OmniHuman 2.0. L'ipotesi di lavoro più sicura è quindi pratica più che assoluta: lascia che l'audio suggerisca di cosa ha bisogno la performance e usa il prompt per richiedere scelte visibili che puoi ispezionare.
Scegli un ritratto e una traccia audio che rendano leggibile l'emozione
Un modello non può agire su segnali difficili da vedere o sentire. Inizia con input che gli diano un compito equo e semplice, poi mantienili fissi mentre provi la formulazione del prompt.
| Input di partenza | Perché può aiutare | Complicazione da tenere d'occhio |
|---|---|---|
| Un volto nitido e non ostruito con luce uniforme | Rende i tratti del volto facili da leggere | Ombre forti, capelli, mani o oggetti possono coprire aree chiave |
| Posa iniziale neutra o lievemente espressiva | Lascia spazio alla performance per cambiare | Un'espressione fissa marcata può entrare in conflitto con un umore vocale diverso |
| Una voce chiara in primo piano | Rende parlato e pause più facili da seguire | Musica, rumore ambientale o voci sovrapposte possono mascherare i segnali |
| Frasi deliberate con pause udibili | Ti dà momenti da associare ad azioni visibili | Un'interpretazione piatta può offrire meno cambi emotivi chiari |
| Un brano con voce in primo piano e frasi distinte | Rende parole cantate e dinamiche più facili da identificare | I passaggi strumentali forniscono meno segnali vocali per il movimento della bocca |
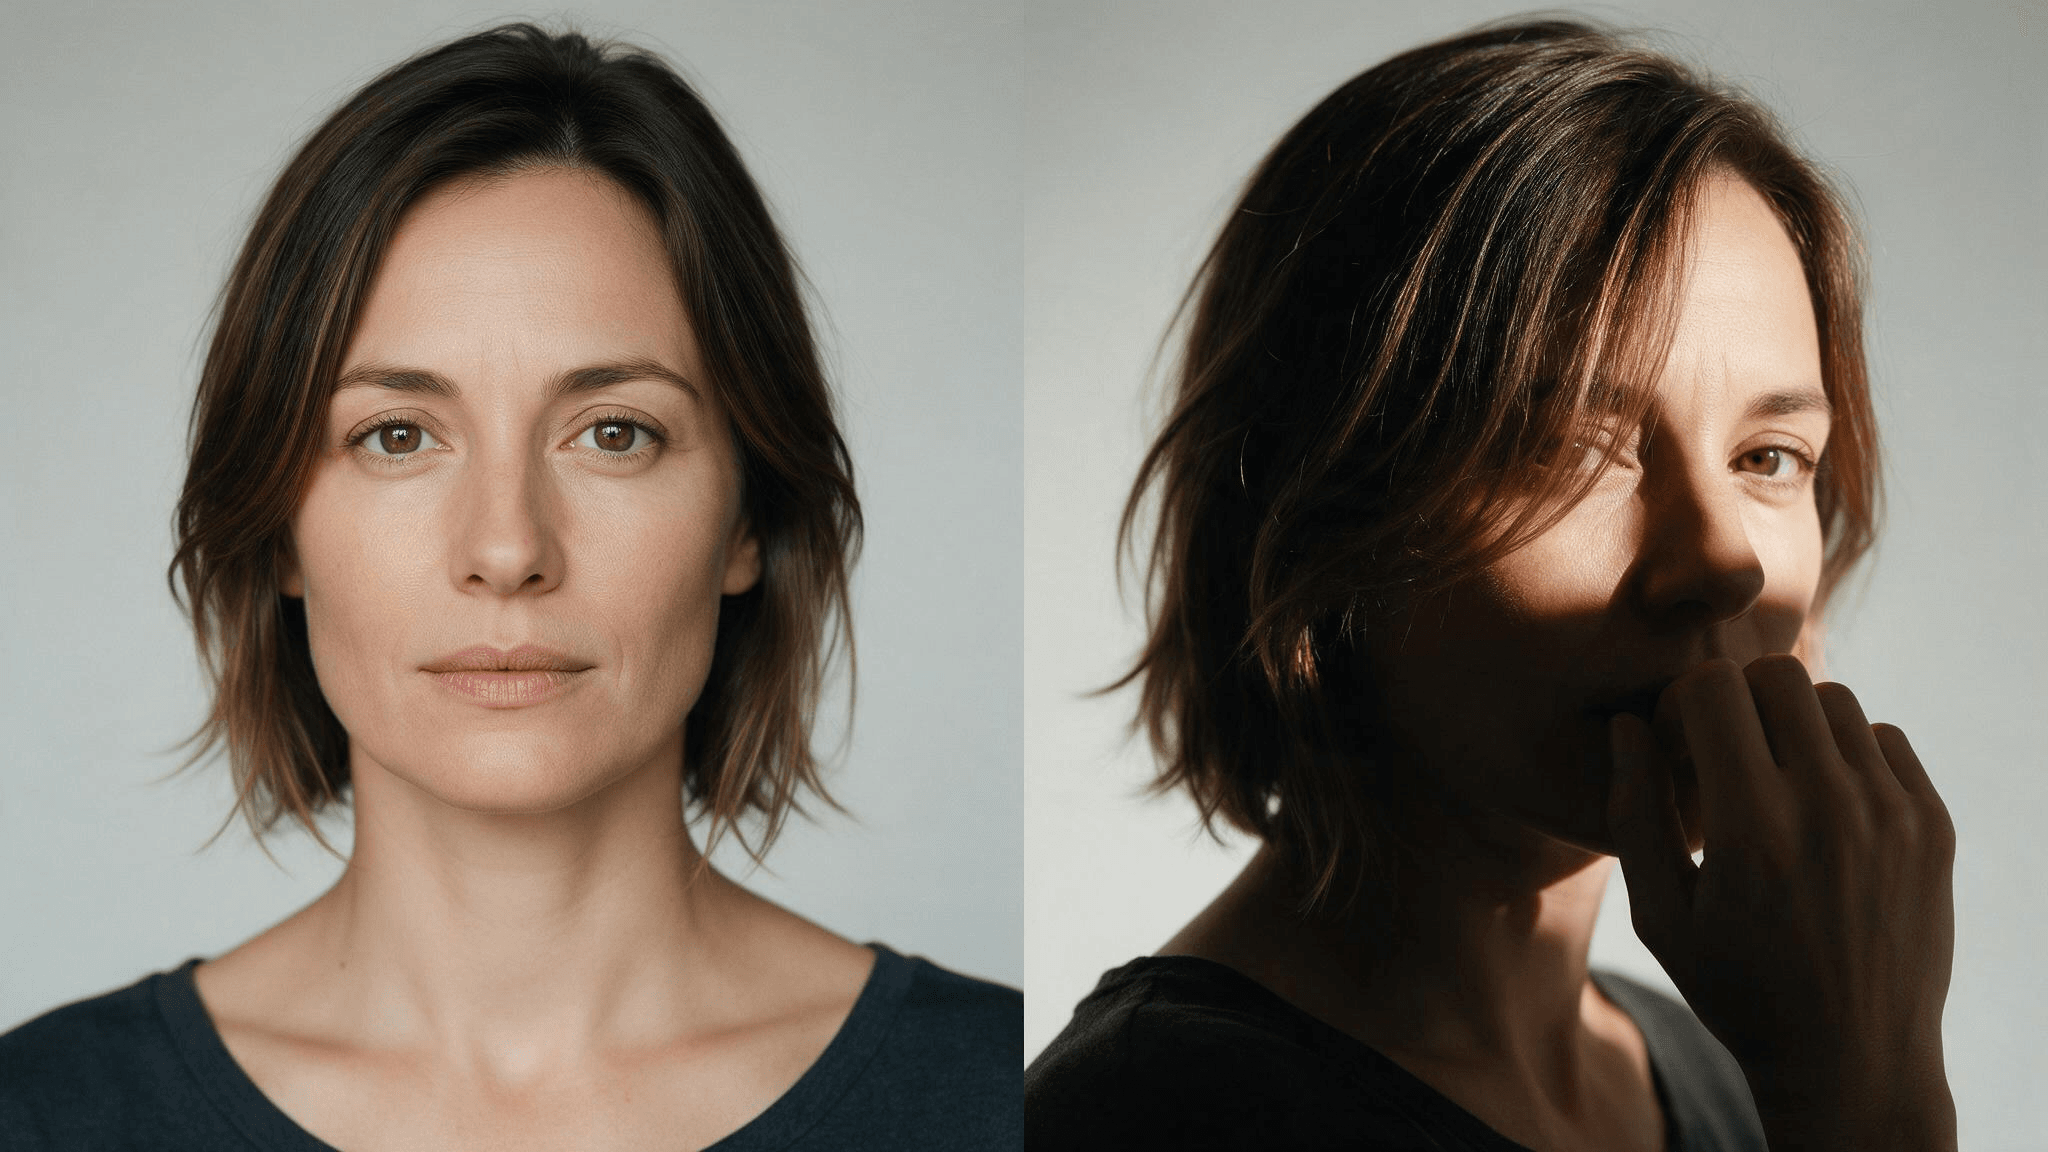 Confronto illustrativo di ritratti: la vista chiara e frontale rende i segnali facciali più facili da ispezionare rispetto alla vista in ombra e parzialmente oscurata. Non è un confronto tra output di modelli.
Questi sono controlli di produzione, non garanzie. Un buon input può comunque produrre un risultato debole, e un ritratto visivamente espressivo non garantisce un'animazione coerente. Per un primo test, usa un ritratto, una breve sezione audio e un singolo prompt. Evita di cambiare insieme ritaglio, registrazione e direzione; altrimenti non saprai quale modifica ha aiutato.
Per il canto, ascolta i finali di frase, le note tenute e i cambi di intensità. Il prompt può dirigere un'inclinazione della testa o un movimento della mano attorno a un beat musicale, ma non dovrebbe ripetere il testo che è già nella registrazione. Per il dialogo parlato, segna pause e parole enfatizzate. Un prompt che chiede un grande cambiamento di umore durante una frase calma e continua può creare una performance che sembra imposta.
Un framework di prompt per far corrispondere voce ed espressione facciale
Mantieni la direzione abbastanza breve da poterla valutare. Una struttura pratica è:
Inquadratura + parlante e interpretazione + emozione coerente con la traccia + una o due azioni visibili + direzione di camera opzionale.
Ad esempio, se un parlante suona caloroso e composto, potresti scrivere:
Primo piano medio statico. La donna parla calorosamente alla camera, iniziando composta e lasciando apparire un piccolo sorriso sull'ultima battuta. Fa un cenno delicato dopo la pausa. Mantieni l'inquadratura stabile.
Questo è un prompt illustrativo, non un'esecuzione OmniHuman 2.0 documentata. La sua caratteristica utile è che ogni istruzione corrisponde a qualcosa di visibile: l'inquadratura resta stabile, l'espressione cambia verso la fine e il cenno ha un segnale. Puoi confrontare il risultato con la traccia invece di giudicare una richiesta generica come “sii emotivo”.
Una guida di terze parti sui prompt consiglia una direzione concisa in linguaggio naturale e di far corrispondere l'emozione richiesta alla voce. Trattala come un'euristica pratica, non come una garanzia o una regola ufficiale del prodotto (guida ai prompt KreatorFlow).
Prima di usare un prompt, controllalo rispetto alla registrazione:
- Se la voce è quieta e trattenuta, richiedi un'espressione sottile invece di un sorriso ampio.
- Se l'interpretazione diventa più sicura, colloca il cambiamento visibile dopo il cambiamento udibile.
- Se la registrazione contiene una risata, una pausa o un sospiro, decidi se il volto deve restare fermo, reagire o muoversi in quel punto.
- Se il ritratto di partenza mostra già l'espressione desiderata, evita di descriverla di nuovo a meno che tu non voglia che l'espressione cambi.
Usa parole temporali come “prima”, “poi” e “infine” solo quando l'audio ha momenti chiari. Evita di accumulare istruzioni contrastanti come “inquadratura statica” e “camera orbitante”, oppure “calmo” e “furioso”. Un prompt è una direzione per una performance esistente, non una traccia vocale sostitutiva.
Tre schemi di prompt per parlato, cambi emotivi e canto
Scegli lo schema più piccolo che si adatta al tuo audio. Questi esempi sono modelli da adattare, non dichiarazioni verificate sui risultati.
Spiegazione calma
Primo piano medio stabile. Il parlante spiega il punto con calma, con un'espressione composta e un piccolo gesto di enfasi. Mantieni la camera ferma.
Usalo quando la traccia è misurata e coerente. Un gesto può rendere visibile l'enfasi senza trasformare una spiegazione lineare in una performance teatrale.
Un cambiamento di emozione
Primo piano statico. Il parlante inizia serio, poi si addolcisce in un piccolo sorriso dopo la pausa prima della frase finale. Mantieni il movimento trattenuto.
Usalo solo quando la registrazione contiene una pausa o un cambiamento udibile che supporta il passaggio. Se non c'è un segnale, la transizione può sembrare arbitraria.
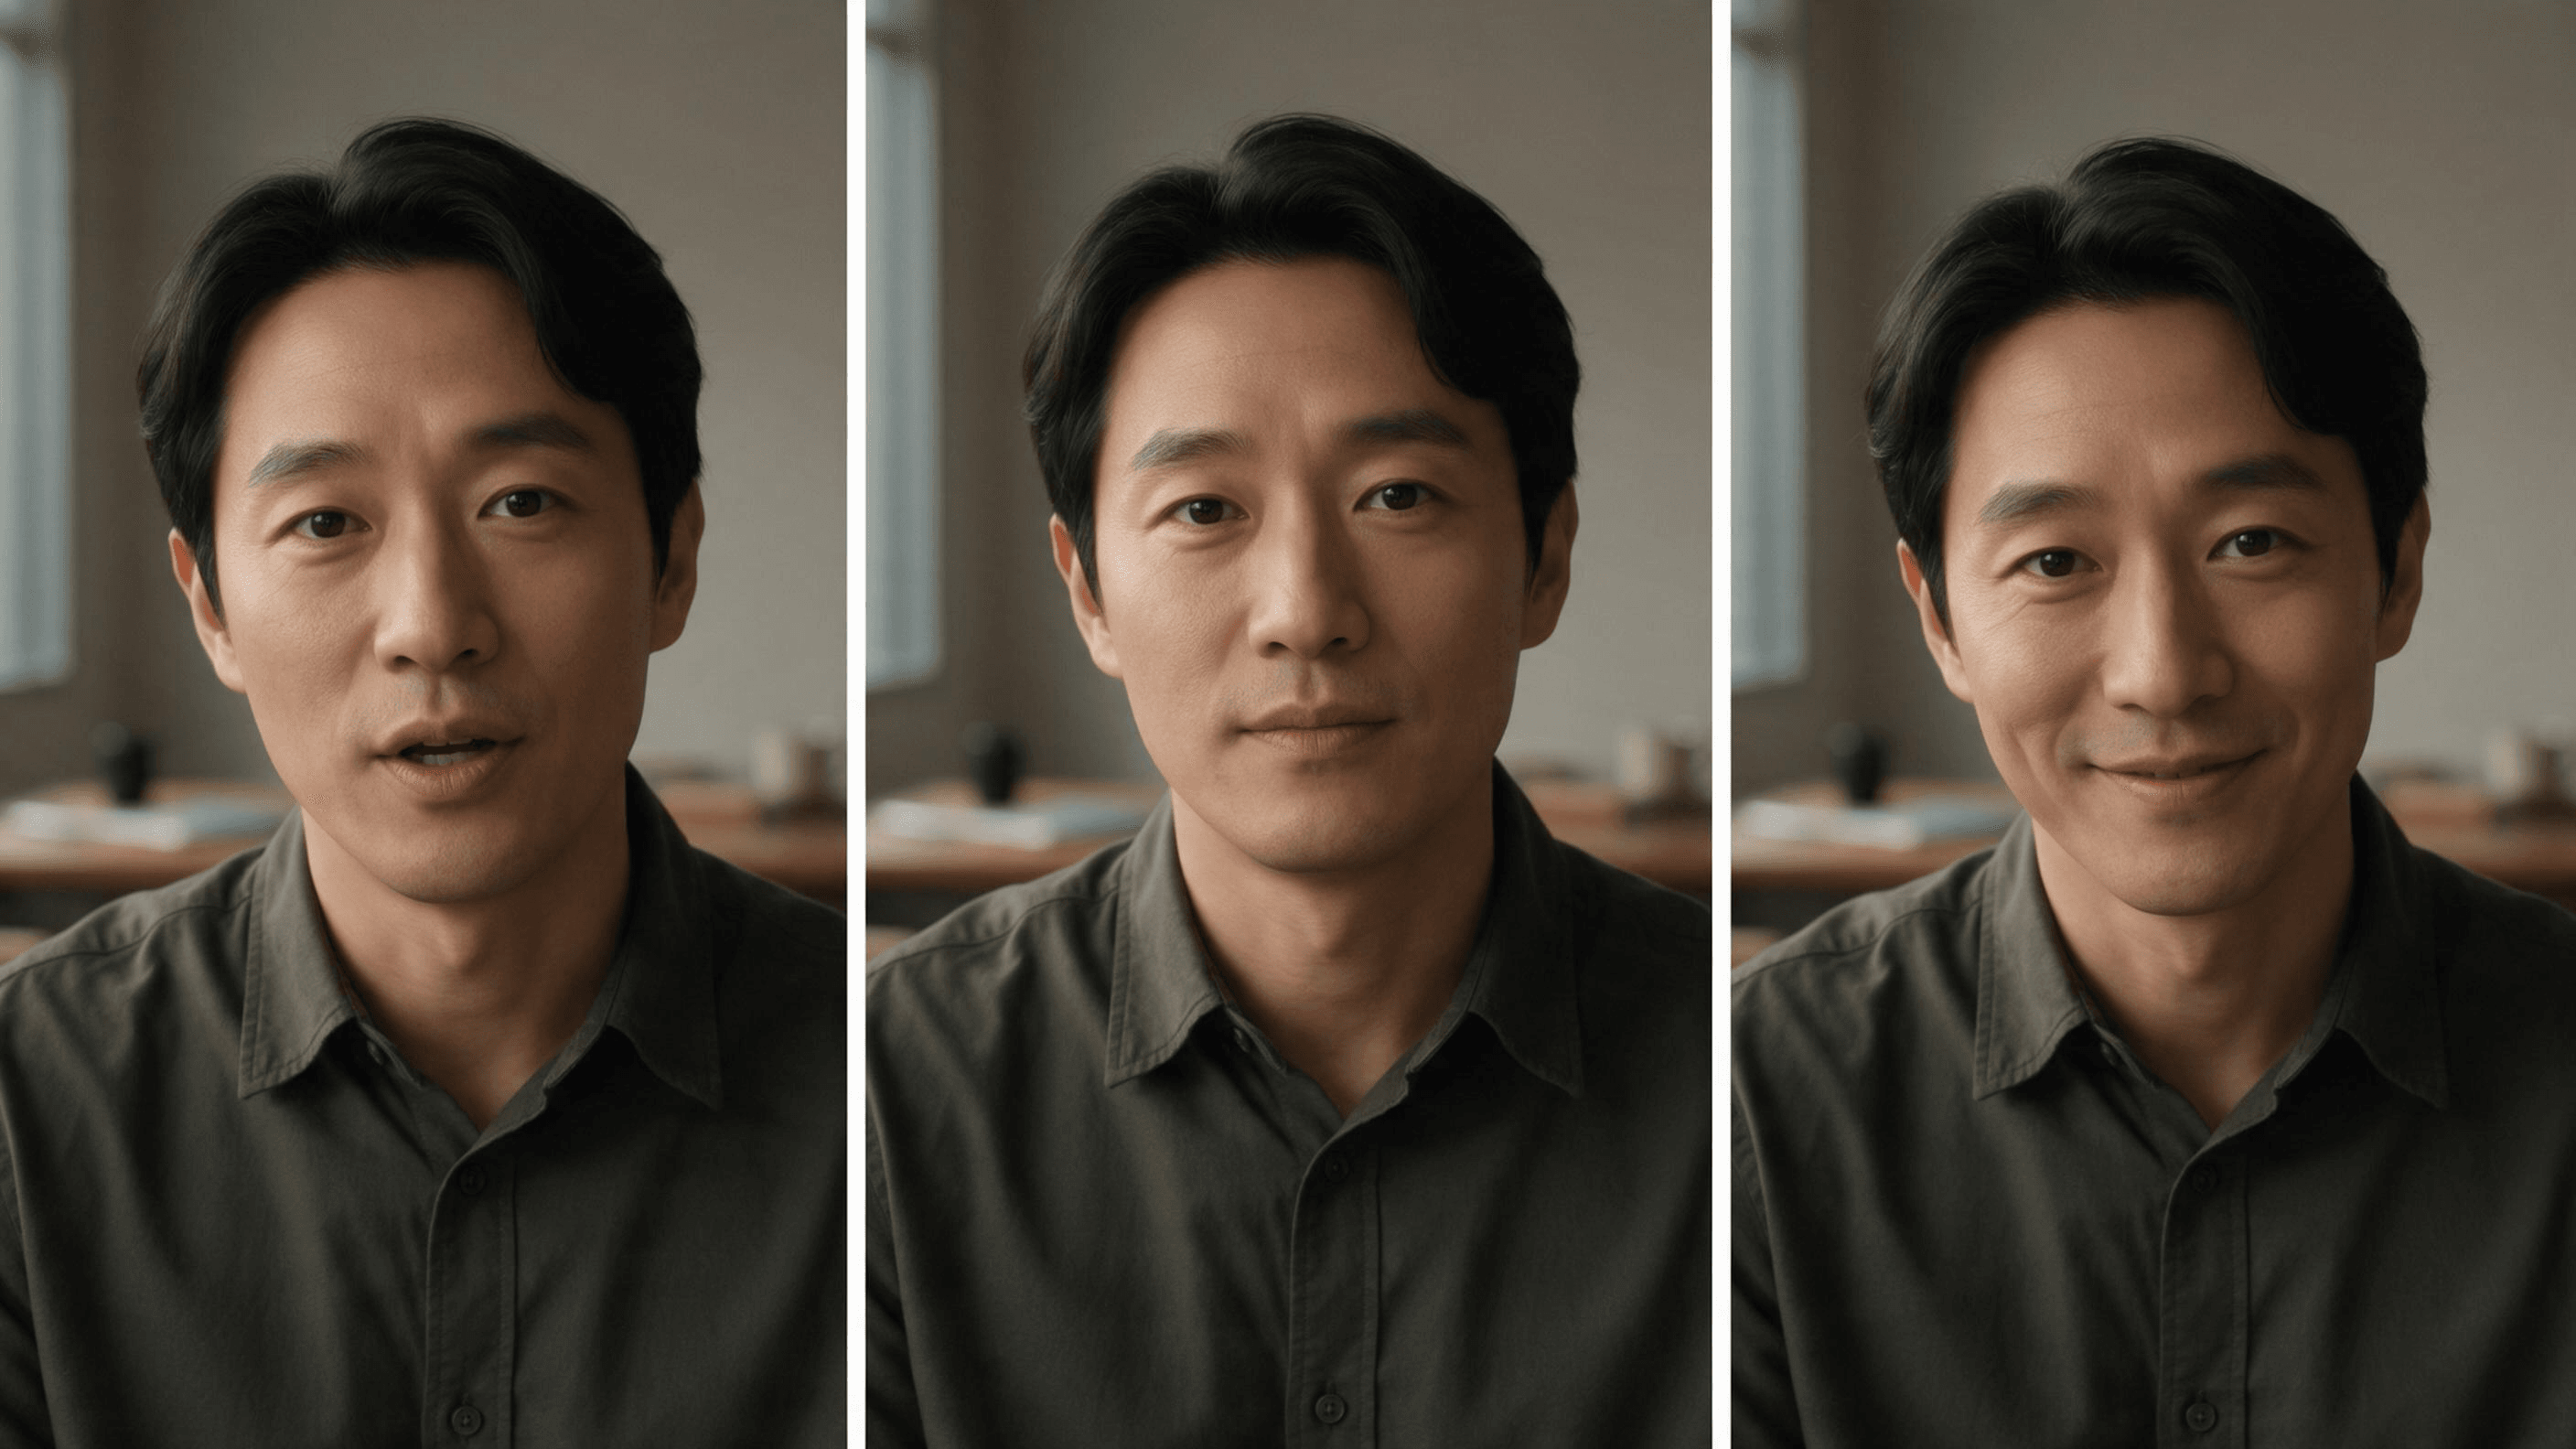 Storyboard concettuale per il prompt del parlato: interpretazione seria, una pausa, poi un sorriso trattenuto. Questi sono momenti facciali pianificati, non fotogrammi di una generazione OmniHuman 2.0.
Canto
Primo piano medio. La cantante si esibisce con un'espressione concentrata, chiude brevemente gli occhi sulla nota tenuta, poi abbassa il mento mentre la frase finisce. Mantieni l'inquadratura stabile.
Dirigi la performance attorno agli eventi musicali invece di ripetere il testo. Il prompt può suggerire un'azione visibile; la traccia fornita resta la fonte delle parole cantate e dei tempi.
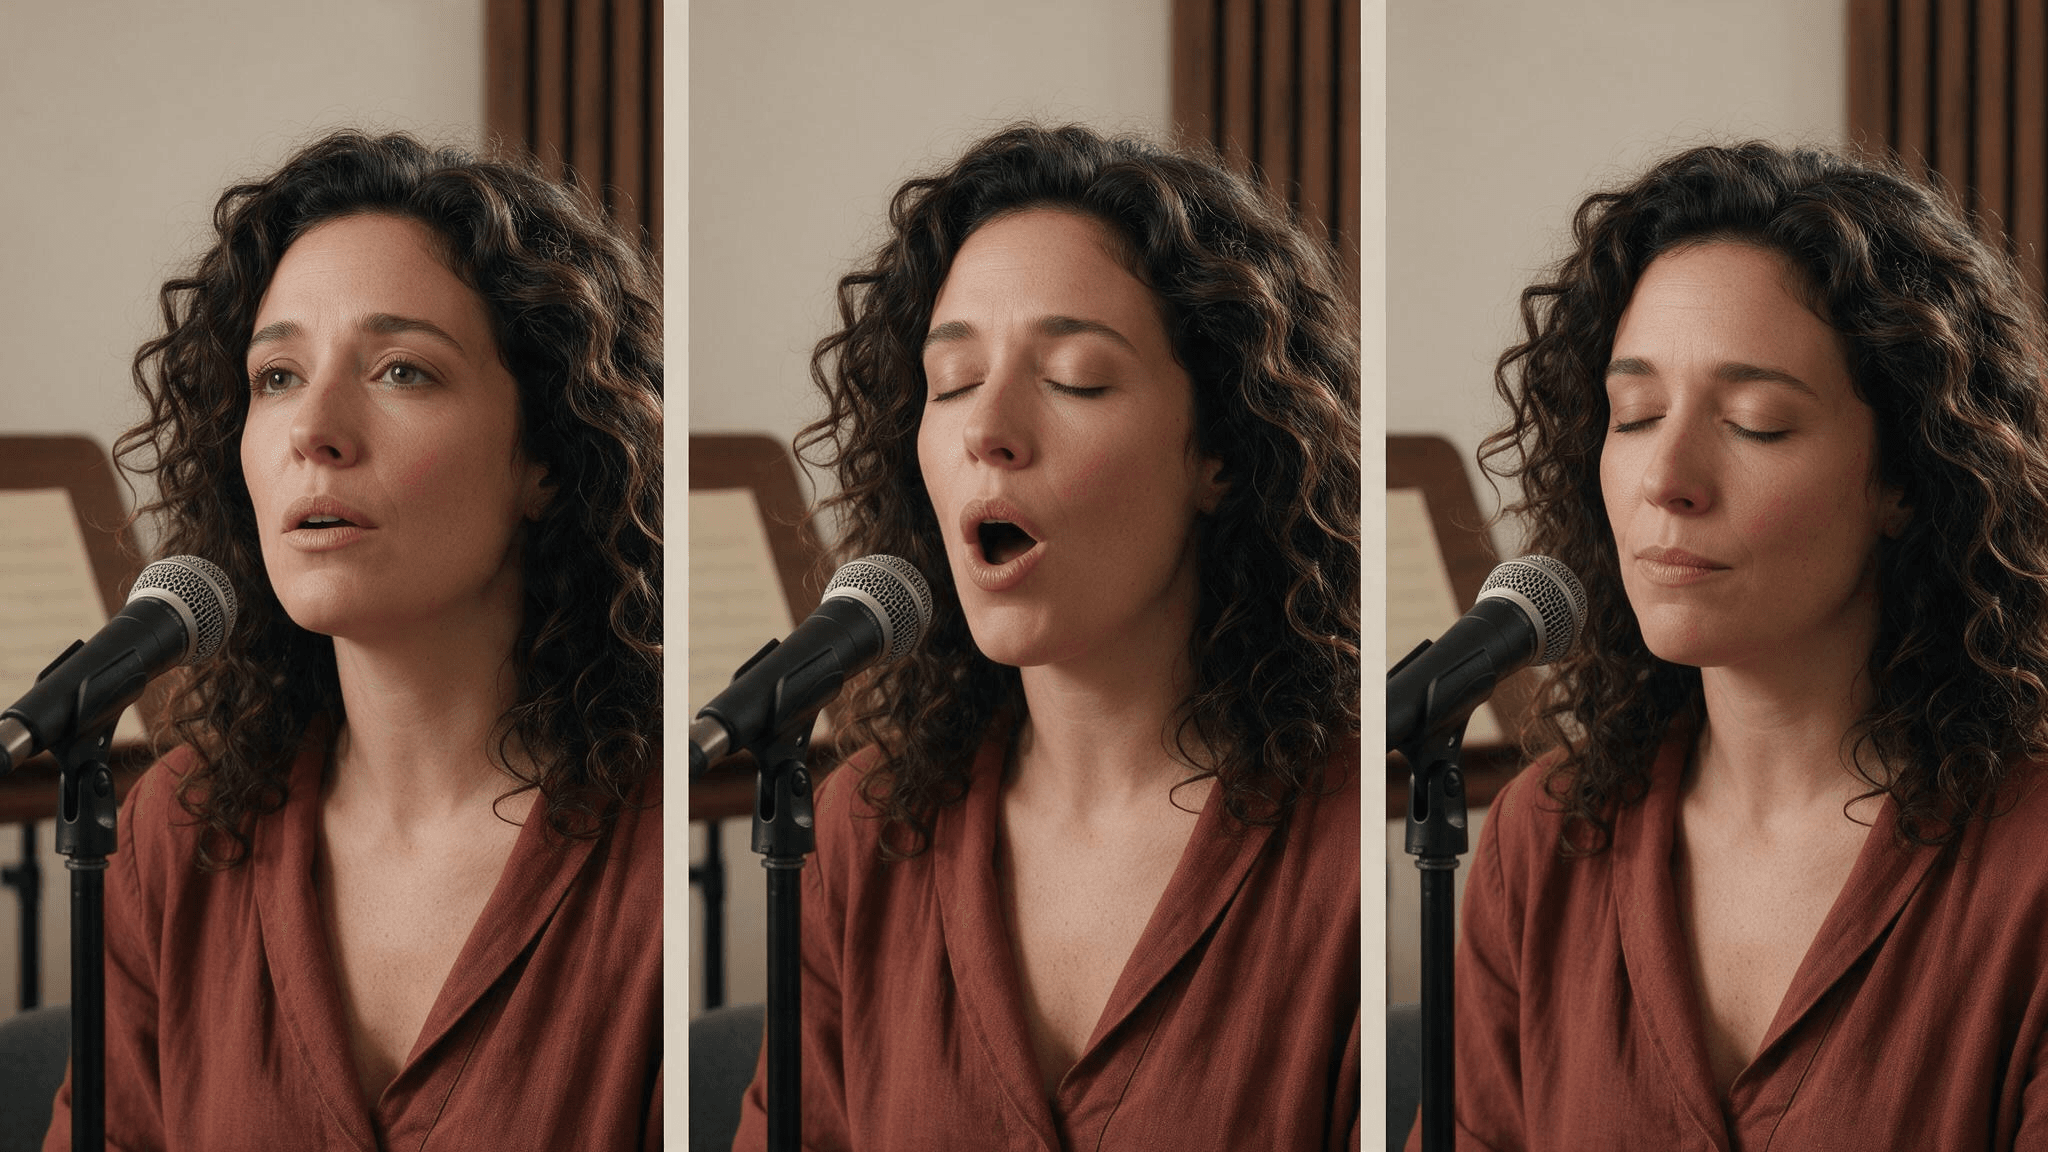 Storyboard concettuale per il prompt del canto: inizia la frase, tieni una nota, poi si stabilizza alla fine. Le immagini statiche non dimostrano la sincronizzazione audio.
Confronta “sii emotivo e cinematografico” con “parla calorosamente, poi sorridi dopo la pausa”. Il primo lascia emozione, tempi e azione visibile aperti all'interpretazione. Il secondo ti dà un momento specifico da ispezionare. Se il risultato manca quel momento, hai un prossimo test mirato: sposta il segnale, addolcisci l'espressione o scegli un montaggio audio diverso.
Un controllo in tre passaggi per l'allineamento voce-volto
Un metodo di revisione rapido può rivelare se il problema risiede nell'audio, nella direzione visiva o nel risultato generato. Usa gli stessi timestamp in tutti e tre i passaggi.
Il loop silenzioso qui sotto ti permette di ispezionare la parte visibile di una performance parlata: movimento della bocca, sguardo e cambiamenti facciali. Usa la clip originale con audio per il controllo voce-volto.
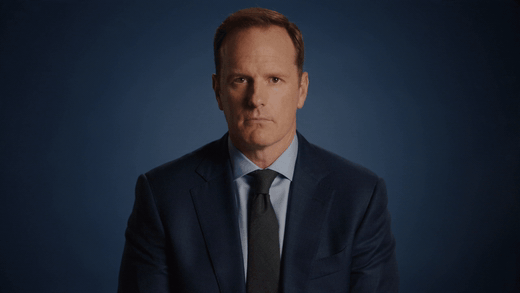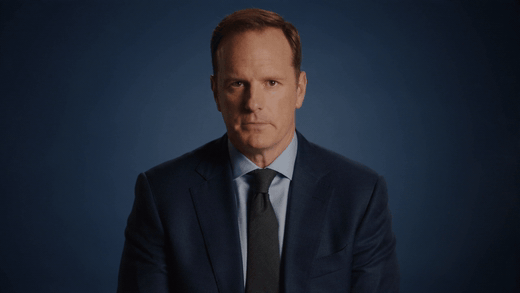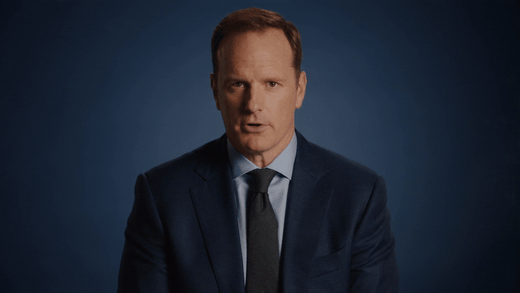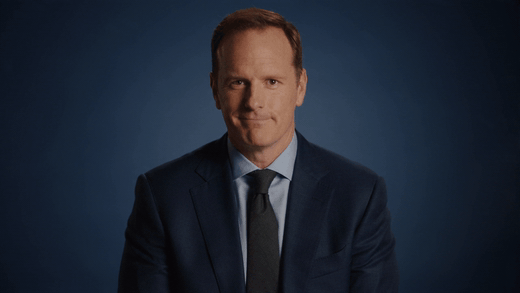
GIF silenziosa convertita dal video avatar fornito. Mostra movimento visibile ma non può stabilire da sola la sincronizzazione audio o la performance di OmniHuman 2.0.
- Ascolta senza guardare. Segna cambi emotivi, pause, enfasi, risate, sussurri e finali di frase. Annota cosa un ascoltatore potrebbe inferire solo dalla voce.
- Guarda senza audio. A quei timestamp, nota volto, sguardo, movimento della testa e gesti. Registra ciò che la performance sembra comunicare senza audio.
- Riproducili insieme. Segnala solo le discrepanze che cambiano il significato o distraggono dalla battuta. Un piccolo sorriso sotto una frase angosciata può contare; un lieve battito di ciglia di solito no.
Una tabella di revisione trasforma quelle osservazioni in una singola prossima azione:
| Tempo | Segnale vocale | Segnale visibile | Corrisponde? | Prossimo test minimo |
|---|---|---|---|---|
| 00:04 | Frase quieta e tesa | Sorriso ampio | No | Riduci l'intensità del sorriso richiesta |
| 00:09 | Pausa prima di una frase rassicurante | Il volto resta fermo | Forse | Aggiungi un cenno sottile dopo la pausa |
| 00:13 | Risata nella registrazione | L'espressione resta seria | No | Controlla se il montaggio audio preserva chiaramente la risata |
Le voci sopra sono esempi ipotetici di come usare la tabella, non osservazioni tratte da un'esecuzione del modello. Le tue note di revisione dovrebbero riferirsi alla tua clip. Cambia una cosa alla volta: rivedi il prompt, modifica il montaggio audio o prova un ritratto diverso. Poi ripeti gli stessi controlli negli stessi momenti.
Se la discrepanza persiste nonostante un segnale chiaro e una direzione mirata, trattala come un limite di generazione per quel risultato. Più aggettivi possono aggiungere rumore senza risolvere il problema di tempistica o performance. Decidi se vale la pena testare un altro input o flusso di lavoro, oppure se il risultato è già adatto al contesto previsto.
Risolvi espressioni piatte o non corrispondenti
Usa il sintomo per scegliere un prossimo passo controllato. Queste sono ipotesi generali di risoluzione dei problemi, non dichiarazioni verificate su difetti di OmniHuman 2.0.
| Cosa noti | Possibile causa | Un prossimo test |
|---|---|---|
| Il volto appare neutro per tutta la clip | La voce ha poco contrasto, oppure la direzione non ha segnali visibili | Usa un passaggio audio più espressivo o chiedi un'azione concreta su un beat chiaro |
| Il volto sovrarecita una battuta sottile | Il prompt chiede un'emozione più forte di quella supportata dalla traccia | Rimuovi azioni extra e abbassa l'intensità emotiva |
| La bocca sembra fuori tempo | La registrazione ha rumore, voci sovrapposte, lunghi silenzi o tagli difficili | Prova un montaggio più pulito con tempi più stretti prima di riscrivere il prompt |
| Un ascoltatore sembra parlare in un'immagine di gruppo | I ruoli di parlante e ascoltatore possono essere ambigui nel flusso di lavoro testato | Identifica ogni persona in base alla posizione e specifica chi parla, se l'interfaccia lo supporta |
| Identità o dettagli fini cambiano durante il movimento | L'inquadratura di origine o il movimento richiesto possono rendere la coerenza più difficile da giudicare | Semplifica il movimento e confronta un risultato più breve e più stabile |
Non dare per scontato che un problema audio si risolva solo con il prompt. Controlla prima se le parole sono chiare e se silenzi o montaggi interrompono il ritmo. Se questi sono a posto, semplifica la direzione visibile. Un nuovo tentativo mirato ti dà prove migliori che riscrivere ogni input contemporaneamente.
OmniHuman 2.0 è disponibile su Atlas Cloud?
Le attuali pagine pubbliche dei modelli di Atlas Cloud elencano Avatar Omni Human 1.5 e documentano i suoi input immagine, audio e prompt opzionale. Non ho trovato OmniHuman 2.0 nell'elenco dei modelli Atlas durante questo controllo. Ciò significa che il modello 2.0 esatto non dovrebbe essere presentato come eseguibile tramite Atlas Cloud.
Se vuoi esplorare un'attività correlata di avatar guidato dall'audio su Atlas, consulta la pagina del modello Avatar Omni Human 1.5 e i suoi input documentati. I documenti specificano un'immagine di riferimento, un URL audio e un prompt opzionale; descrivono audio fino a 60 secondi e consigliano 15 secondi o meno per la migliore qualità. Questi sono dettagli della v1.5, non specifiche di OmniHuman 2.0. Controlla il catalogo attuale dei modelli Atlas per disponibilità e prezzi aggiornati prima di scegliere un flusso di lavoro. Non ho potuto confermare un prezzo pubblico attuale per questo modello durante la ricerca, quindi questo articolo non ne cita uno.
Verifica diritti e contesto prima di pubblicare
Prima di condividere una persona animata, conferma di avere il permesso di usare il ritratto e la voce per lo scopo previsto. Verifica anche i diritti su musica, somiglianza, voce e distribuzione per il contesto specifico. I requisiti possono variare in base al materiale di origine e all'uso; questa checklist è una guida pratica, non una conclusione legale.
Etichetta i media sintetici o modificati quando gli spettatori potrebbero ragionevolmente scambiarli per filmati documentari o per una dichiarazione attuale di una persona reale. Conserva note di progetto sui file di origine e sulle modifiche, soprattutto per lavori per clienti o campagne. Una performance tecnicamente allineata necessita comunque di un contesto di pubblicazione responsabile.
Per OmniHuman 2.0 emotional voice and facial expression matching, il prossimo passo utile è un test controllato: scegli un ritratto chiaro, segna i momenti emotivi dell'audio, scrivi una breve direzione e rivedi gli stessi timestamp con audio disattivato e attivo. Se stai considerando un'opzione ospitata su Atlas, verifica prima il modello esatto e il prezzo attuale.
Domande frequenti
OmniHuman 2.0 genera la voce?
Il flusso di lavoro descritto da guide di terze parti parte da audio fornito e anima un ritratto su di esso. Non dare per scontato che il modello generi una voce a meno che l'interfaccia specifica del prodotto documenti tale capacità.
OmniHuman 2.0 può animare il canto oltre al parlato?
Le guide di terze parti su OmniHuman 2.0 descrivono sia l'uso di audio parlato sia di audio cantato. Per un test di canto, usa una sezione con voce in primo piano e frasi chiare, poi dirigi azioni visibili attorno a una nota tenuta o alla fine di una frase.
Il prompt dovrebbe ripetere il dialogo o il testo della canzone?
Di solito no. La registrazione fornisce già le parole. Usa il prompt per la direzione visibile, come espressione, gesto, inquadratura o un segnale di scena, ed evita di aggiungere parole che entrano in conflitto con la traccia.
Cosa dovrei cambiare per primo se l'espressione sembra sbagliata?
Usa il controllo in tre passaggi per individuare la discrepanza. Se l'audio stesso non è chiaro o è emotivamente piatto, prova prima un montaggio audio. Se il segnale è chiaro ma il volto lo manca, semplifica e riallinea i tempi di una direzione del prompt.
OmniHuman 2.0 è su Atlas Cloud?
Non ho trovato OmniHuman 2.0 nel catalogo pubblico dei modelli di Atlas Cloud durante questa ricerca. Atlas documenta Avatar Omni Human 1.5 come opzione correlata; verifica l'elenco attuale prima di sceglierlo.





