


Una ballerina si gira, ma la camera perde i suoi piedi. Una pubblicità di prodotto cambia la bottiglia a metà. Una scena emotiva aggiunge un discorso quando volevi una reazione silenziosa. Ogni brief lascia una decisione diversa irrisolta.
Questa Guida ai prompt ed esempi di Seedance 2.5 Flash inizia con una formula pratica: identifica il soggetto, descrive un'azione osservabile, stabilisci l'ambientazione, dirigi la camera e specifica il suono. Quando carichi riferimenti, assegna a ciascun file un compito chiaro. I 12 prompt copiabili di seguito applicano questo approccio a danza, pubblicità, azione, emozione, animazione e suono ambientale.
Punti chiave
- Scrivi un'azione che gli spettatori possano riconoscere, poi definiscine l'inizio e la fine.
- Separa il movimento della camera dal movimento del soggetto e inserisci la durata nelle impostazioni di generazione effettive.
- Assegna responsabilità distinte ai riferimenti immagine, video e audio.
- Seedance 2.5 Flash supporta output nativi a 480p e 720p; le specifiche standard di Seedance 2.5 non si applicano automaticamente.
- Esamina la clip completa rispetto ad alcuni controlli di accettazione, poi modifica un'istruzione alla volta.
Inizia con la modalità Seedance 2.5 Flash giusta
Scegli la modalità di input prima di rifinire il prompt. Text-to-video è utile quando la scena può essere descritta liberamente. Image-to-video parte da un'immagine specifica. Reference-to-video è utile quando vuoi trasferire informazioni selezionate di identità, movimento, scena o suono in una nuova composizione.
Su Atlas Cloud, le tre modalità hanno voci di modello Seedance 2.5 Flash separate. Controlla il nome completo, includendo “Seedance 2.5 Flash” e la modalità di input. Caricare un'immagine di prodotto in un flusso di lavoro con primo fotogramma e usarla come riferimento di prodotto generico sono decisioni creative diverse.
| Il tuo materiale di partenza | Modalità appropriata | Compito di scrittura principale |
|---|---|---|
| Un'idea senza media caricati | Text-to-video | Stabilire soggetto, azione, ambientazione, inquadratura e suono |
| Un'immagine che dovrebbe dare inizio all'inquadratura | Image-to-video | Spiegare cosa inizia a muoversi e come si sviluppa la scena |
| Riferimenti separati di aspetto, movimento o audio | Reference-to-video | Assegnare un ruolo a ciascun input e descrivere la nuova scena |
| Una clip esistente che intendi modificare | Montaggio video tramite il flusso di lavoro con riferimenti | Indicare la modifica e preservare il contenuto sorgente rilevante |
La voce attuale Atlas Cloud Seedance 2.5 Flash Text-to-Video supporta generazione da 4–30 secondi, output a 480p o 720p, proporzioni selezionabili e audio generato. Per gli esempi qui, usa 720p e MP4, poi imposta la durata e il rapporto elencati accanto al prompt. Queste sono impostazioni iniziali, non una garanzia che la coreografia o la tempistica richieste riescano. Le specifiche sono state verificate il 17 novembre 2026.
Mantieni la lunghezza della clip legata al suo scopo. Un'inquadratura di 8 secondi può stabilire un soggetto, sviluppare un'azione e concludersi con un finale. Una sequenza più lunga ha bisogno di sufficiente azione nuova per giustificare il tempo aggiuntivo. Riempire 30 secondi con un'unica istruzione vaga lascia molte decisioni aperte.
Quando hai bisogno di un prodotto riconoscibile dal fotogramma iniziale, usa la voce Seedance 2.5 Flash Image-to-Video. Questa modalità usa un rapporto d'aspetto adattivo, preservando le proporzioni dell'immagine sorgente. Prepara l'immagine nella composizione che vuoi effettivamente animare. Un packshot stretto non può rivelare gambe mancanti o un'intera stanza senza che il modello inventi quell'informazione.
La formula del prompt: da un'idea a un brief filmabile
Il tutorial ufficiale della serie raccomanda di organizzare soggetto, azione, ambiente, stile visivo, direzione della camera e suono. La sua notazione distingue la musica con parentesi tonde, gli effetti con parentesi angolari, il dialogo con parentesi graffe e i sottotitoli con parentesi speciali. Quelle sono convenzioni di scrittura documentate; non sono controlli delle impostazioni. (Tutorial della serie BytePlus, novembre 2026.)
Usa questa formula di lavoro compatta:
Soggetto + azione osservabile + ambientazione + trattamento visivo + inizio/percorso/fine della camera + suono + continuità essenziale.
La riga finale di continuità è un'aggiunta editoriale in questa guida. Ti dice quali dettagli contano quando decidi se tenere una ripresa. Gli altri campi aiutano a trasformare un'idea in qualcosa che puoi immaginare e ispezionare.
plaintext1[Subject with 2–3 defining details] performs [one observable action] 2in [specific setting], with [lighting and visual treatment]. 3 4Opening: [shot size, angle, subject placement]. 5Development: [action progression and camera movement]. 6Ending: [final action and composition]. 7 8Sound: [dialogue or foreground event], with [background layer or music]. 9Continuity: [the identity, object features, or spatial relationship to preserve].
Inizia con il cambiamento che il pubblico dovrebbe notare. “Una donna si sente sollevata” nomina un'emozione. “Allenta la presa sulla busta, espira e lascia cadere le spalle” fornisce un comportamento visibile. La seconda descrizione ti offre un controllo di accettazione anche se l'espressione facciale è sottile.
Usa un piccolo numero di dettagli identificativi. Una giacca rossa, capelli scuri corti e una borsa a spalla argentata possono essere più facili da seguire di un paragrafo che cataloga ogni cucitura. Scegli dettagli che restano visibili nell'inquadratura prevista. Un anello inciso fa poco in un'inquadratura a figura intera di corsa.
Dai all'ambientazione una funzione fisica. Una porta permette a un personaggio di entrare e fermarsi. Il bordo di un tavolo vicino fornisce un indizio di profondità per una camera in movimento. Un tagliere di legno fornisce una superficie di contatto visibile per il suono di un coltello. Questi dettagli rendono la scena più facile da dirigere e revisionare.
Considera questo brief deliberatamente vago:
plaintext1A cinematic premium bottle ad with dynamic camera movement and beautiful lighting.
Lascia non specificati il design della bottiglia, il movimento, il punto di vista e il finale. Una revisione più utile dice che una bottiglia ambrata si trova su un piano di pietra, la camera si muove da sinistra-frontale a profilo laterale e il riflesso rettangolare di una finestra attraversa il vetro. Puoi poi ispezionare separatamente la silhouette della bottiglia, il riflesso e la vista laterale finale.
Mantieni leggibile la prima passata. Se un'istruzione non cambia ciò che dovrebbe accadere sullo schermo o nella colonna sonora, valuta di rimuoverla. Una pila di aggettivi di prestigio può nascondere l'azione che il modello deve interpretare.
La guida ufficiale ai prompt descrive una panoramica seguita da inquadrature dettagliate o una timeline e note di coerenza aggiuntive. Documenta anche le limitazioni rimanenti, inclusi i sottotitoli indesiderati. Tratta i suoi esempi come guida per la serie, poi controlla i limiti specifici di Seedance 2.5 Flash nel modello che usi. (Guida ai prompt BytePlus, novembre 2026.)
Scrivi indicazioni di camera che abbiano un riscontro visibile
Un'istruzione utile sulla camera risponde a quattro domande: dove inizia l'inquadratura, quale percorso segue la camera, cosa fa il soggetto in modo indipendente e cosa dovrebbe vedere lo spettatore alla fine? Puoi esprimerlo senza vocabolario specialistico.
Per una clip di danza, inizia dal requisito pratico: i piedi devono restare visibili. Poi scegli una composizione ampia o a figura intera e descrivi un arco di camera modesto. Chiedere primi piani, tagli rapidi e footwork ininterrotto nello stesso breve passaggio crea priorità in competizione.
Per un'inquadratura di prodotto, decidi quale nuova superficie dovrebbe apparire. “Muoviti attorno alla bottiglia finché il suo lato destro diventa visibile” fornisce una destinazione. “Orbita epica” nomina una sensazione senza definire quante nuove informazioni la camera dovrebbe rivelare.
| Richiesta camera | Aggiungi questo dettaglio fisico | Ispeziona questo nell'output |
|---|---|---|
| Carrellata | La camera viaggia accanto al soggetto a un ritmo simile | Il soggetto resta inquadrato mentre l'ambiente scorre |
| Orbita | Il soggetto resta fisso mentre la camera si sposta da un lato verso un altro | I lati visibili e la sovrapposizione dello sfondo cambiano insieme |
| Ripresa con gru in salita | La camera sale da una vista bassa a una vista sopra il soggetto | Le superfici superiori prima nascoste diventano visibili |
| Panoramica | La camera ruota da una posizione dichiarata verso un bersaglio nominato | Il bersaglio entra nella composizione in modo coerente |
| Primo piano | Nomina il dettaglio e quando tagliare su di esso | Il dettaglio resta leggibile e connesso alla scena più ampia |
Separa l'azione dal movimento della camera nelle tue frasi. “La ciclista passa in bici davanti al negozio; la camera la segue di fianco” è più facile da interpretare di “un'inquadratura ampia e rotante sulla ciclista”. Se la camera deve muoversi mentre il prodotto resta fermo, dillo esplicitamente.
Per una scena di 8 secondi, due o tre battute sono un utile vincolo di stesura. Sono una scelta editoriale per questi esempi, non un limite ufficiale di inquadrature. Concedi tempo all'azione di iniziare, svilupparsi e assestarsi. Una presa, uno scatto, un salto, un atterraggio, una conversazione e una reazione di solito richiedono più spazio di quanto offra una clip breve.
I timestamp descrivono la tempistica prevista. Imposta anche la durata effettiva nel modulo di generazione. Se richiedi una timeline di 10 secondi ma lasci la durata a 5 secondi, la tempistica scritta non risolve questa discrepanza. Controlla la lunghezza reale della clip scaricata prima di giudicarne il ritmo.
Usa riferimenti multimodali senza confonderne i ruoli
Tratta la selezione dei riferimenti come se stessi briefando un piccolo team di produzione. Un input fornisce l'aspetto del soggetto, un altro fornisce un pattern di movimento e un terzo fornisce musica o una voce. Spiega queste assegnazioni prima di descrivere la nuova scena.
La voce Seedance 2.5 Flash Reference-to-Video attualmente elenca fino a 10 immagini, 5 video e 5 clip audio. Il suo schema limita la durata combinata dei video di riferimento a 30 secondi e la durata combinata dell'audio di riferimento a 30 secondi. Usa token indicizzati come @Image1, @Video1 e @Audio1. Conferma le etichette mostrate dalla tua interfaccia prima di inviare.
Questi sono i limiti di Seedance 2.5 Flash, non la maggiore disponibilità di riferimenti di Seedance 2.5. Ancora più importante, un massimo non è un obiettivo. Inizia con il set di riferimenti più piccolo che risolve la tua incertezza effettiva. Tre immagini di guardaroba in conflitto possono rendere il brief del soggetto più difficile da interpretare di una singola immagine pulita.
| Input | Assegnagli un compito chiaro | Specifica cosa può cambiare |
|---|---|---|
| Immagine di prodotto o personaggio | Aspetto, silhouette, abbigliamento o materiali | Sfondo, posa o inquadratura |
| Video di riferimento di movimento | Un'azione, un ritmo o un percorso di camera specifici | Interprete, guardaroba, location e colonna sonora sorgente |
| Riferimento audio | Battito, qualità della voce o pattern sonoro | Elementi visivi sorgente non correlati e qualsiasi vocale indesiderata |
| Immagine del primo fotogramma | La composizione iniziale dell'inquadratura | Azione e punto di vista successivi |
Per l'esempio di danza qui sotto, carica un'immagine pulita del personaggio, un breve riferimento di movimento e una clip musicale. Il prompt dice al modello di usare il movimento del video prendendo il costume dall'immagine. Senza quella separazione, “segui il video” potrebbe anche invitare il suo costume, lo sfondo o il comportamento della camera.
Usa materiale che possiedi o per cui hai il permesso, inclusa l'immagine o la voce di qualsiasi persona. I requisiti per input di persone reali possono variare tra fornitori e modalità di accesso, quindi segui il processo attuale di caricamento e revisione nell'interfaccia che scegli. La presenza di un riferimento non garantisce la riproduzione esatta dell'identità o della performance.
Mantieni il riferimento distinto dal montaggio. “Usa il movimento in questa clip per una nuova ballerina” richiede una nuova scena. “Sostituisci l'interprete in questa clip” chiede di modificare il video fornito e può attivare requisiti diversi. L'attuale schema di montaggio Atlas richiede durata automatica e conservazione del rapporto d'aspetto sorgente. Ricontrolla quei controlli quando cambi attività.
Se un riferimento contraddice il prompt, risolvi il conflitto prima di riprovare. Un'immagine di un soggetto seduto in un'inquadratura stretta è un punto di partenza debole per un salto immediato a figura intera. Usa un'immagine più adatta o semplifica l'azione, invece di aggiungere diverse righe che pretendono che entrambi i vincoli reggano.
12 esempi di prompt Seedance 2.5 Flash copiabili
Gli esempi Text-to-video abbinano un prompt al suo risultato. Gli esempi Image-to-video e con riferimento immagine includono anche l'immagine di input effettiva. I casi 5, 6 e 12 usano scene più lunghe con un'apertura, uno sviluppo e un finale completi.
I prompt preservano i brief di scena pubblicati senza aggiungere nuove inquadrature. Questi sono output pubblicati, non test nuovi della formulazione esatta mostrata sotto. I casi 6 e 12 usano video riproducibili con suono. Tutte le altre anteprime restano GIF silenziose; le istruzioni sul suono restano nei prompt per l'uso quando generi il tuo video.
1. Danza: footwork a figura intera con camera in orbita
Modalità: Text-to-video. Impostazioni: 5 secondi richiesti, 720p, 16:9.
Prompt
plaintext1Frame a thirty-something man full length, dancing in emerald velvet on a sunset rooftop. 2 3CAMERA AND MOTION 4Circle him slowly; show precise, flowing steps and his jacket swinging. Glowing skyline, warm film color, 24 mm. 5 6SOUND 7Hear concrete scuffs, urban ambience and breeze; omit music.
Risultato generato
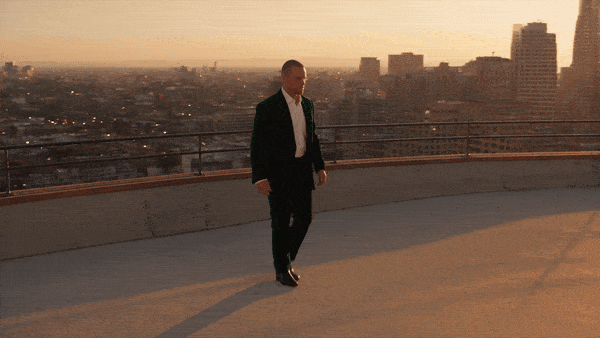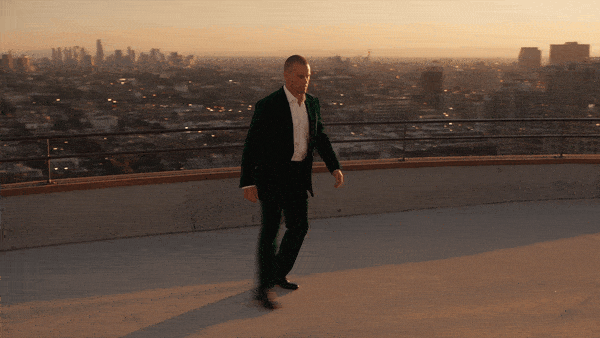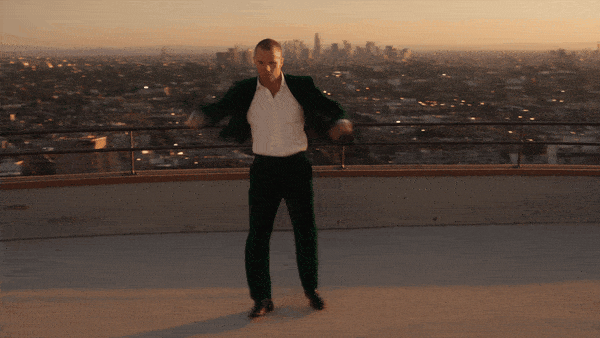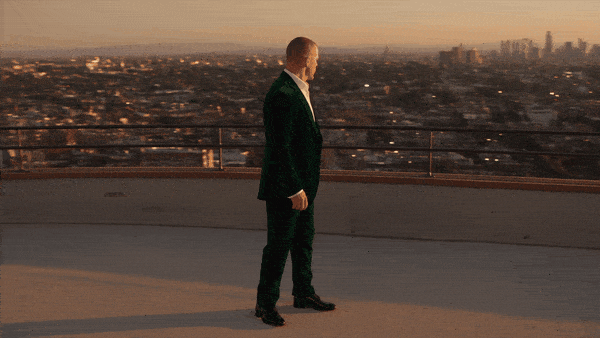
Durata output: 5.06 secondi.
La vista a figura intera mantiene leggibile il footwork mentre lo skyline in movimento rivela l'arco della camera. La giacca oscilla dopo ogni cambio di direzione, dando al movimento un secondo ritmo visivo. Per un brief di danza, questa combinazione di contatto dei piedi, risposta del tessuto e movimento della camera è più utile di una lunga lista di parole d'atmosfera.
2. Pubblicità beauty: vetro, metallo e rivelazione liquida
Modalità: Text-to-video. Impostazioni: 5 secondi richiesti, 720p, 16:9.
Prompt
plaintext1An unbranded frosted serum bottle with a rose-gold cap emerges from milky liquid. 2 3MATERIAL AND CAMERA 4Show streaming droplets and expanding ripples in slow motion through a 100 mm macro lens. Pink backlighting and a controlled light sweep reveal glossy glass. 5 6SOUND 7Hear liquid swelling and dripping, without music.
Risultato generato
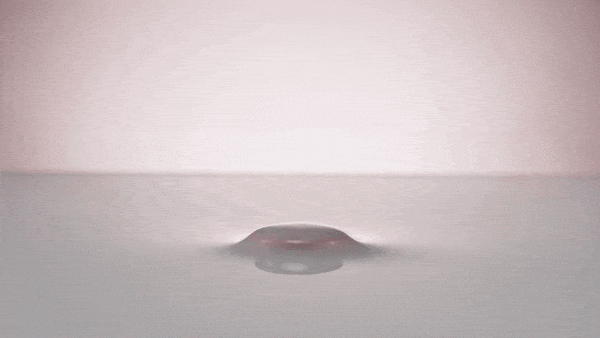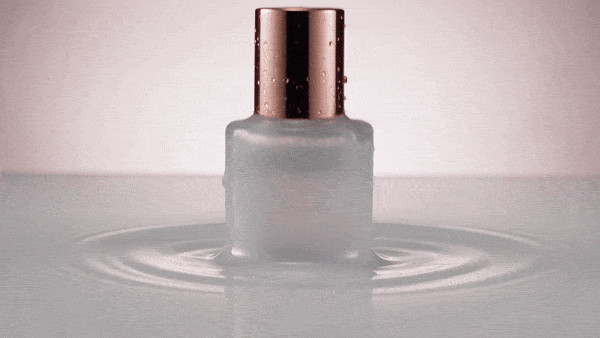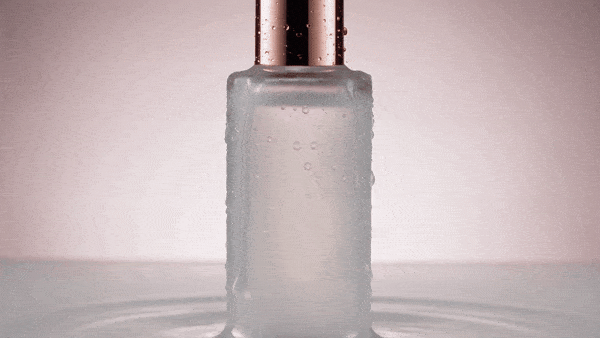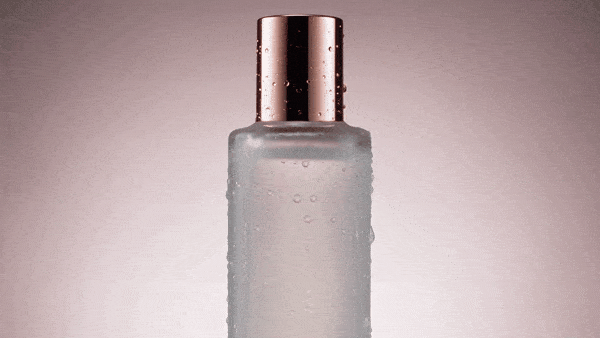
Durata output: 5.06 secondi.
La bottiglia emerge attraverso una superficie liquida luminosa mentre gocce e anelli in espansione rendono visibile la rivelazione. Il tappo cattura un riflesso diverso dal vetro smerigliato, così il contrasto materico sopravvive alla palette chiara. I dettagli utili del prompt sono il movimento del liquido e la passata di luce controllata, che danno a una semplice composizione di prodotto qualcosa di specifico da fare.
3. Azione: polvere di gesso al momento del contatto
Modalità: Text-to-video. Impostazioni: 5 secondi richiesti, 720p, 16:9.
Prompt
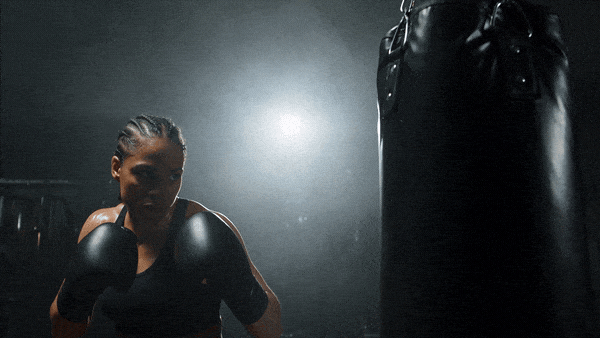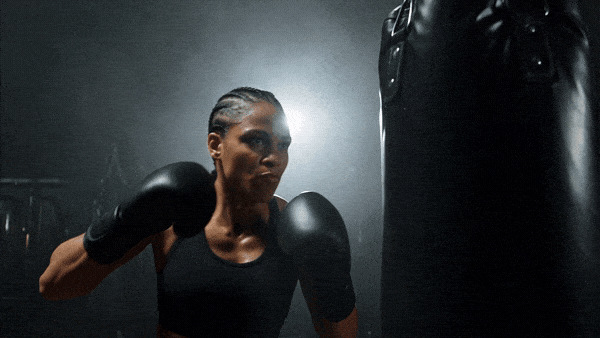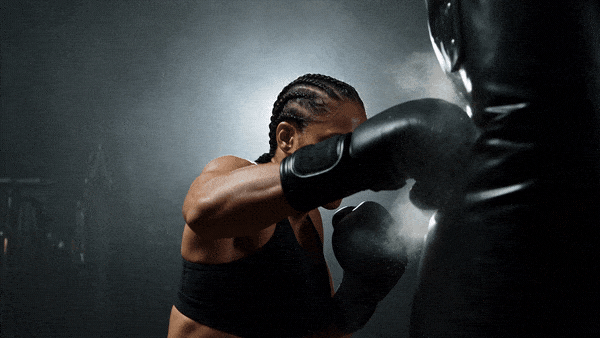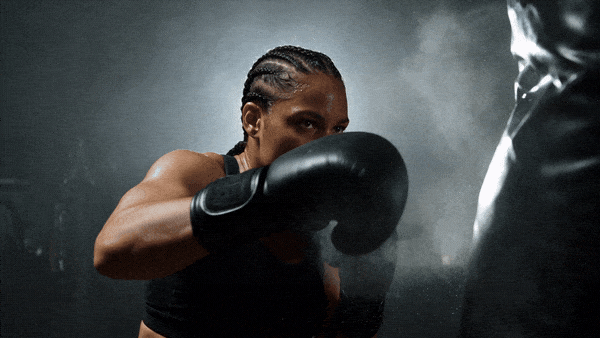
plaintext1From below, film a braided young woman in black sportswear driving a right cross into a punching bag. 2 3LIGHT AND CAMERA 4Slow motion reveals glove chalk and airborne sweat. One hard beam through gym haze, contrasty 35 mm. 5 6SOUND 7Hear impact, breath and chain rattle, without music.
Risultato generato
Durata output: 5.06 secondi.
Il guantone chiude la distanza dal sacco prima che la nuvola di gesso si diffonda attraverso la luce. Quest'ordine dà all'impatto una causa e una conseguenza visibili. La palestra buia e il singolo fascio rendono leggibili le piccole particelle senza uno sfondo caotico. Un momento di contatto chiaro e un contraccolpo leggibile danno a un prompt d'azione più direzione della sola frase impatto cinematografico.
4. Emozione: anima un ritratto senza inventare una nuova scena
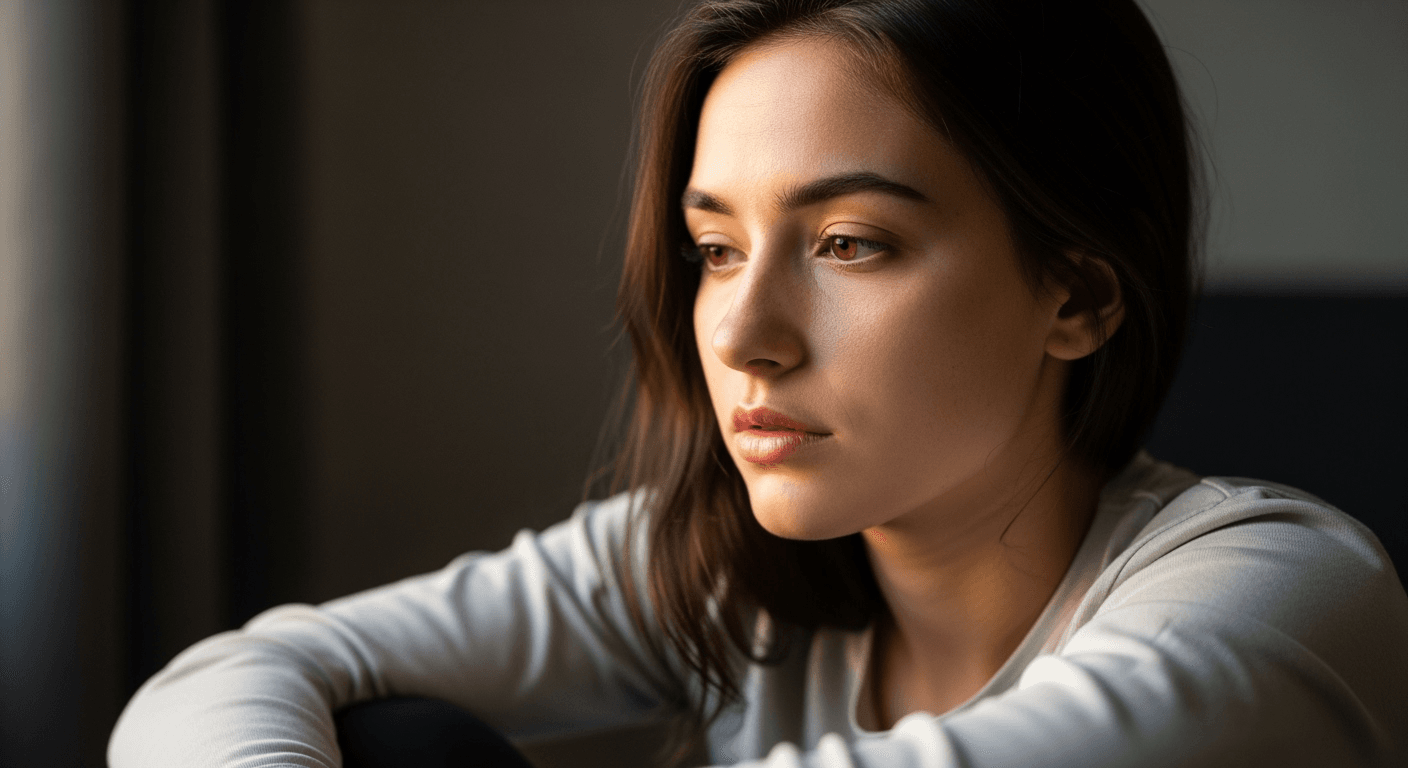
Modalità: Image-to-video, input del primo fotogramma. Impostazioni: Usa il primo fotogramma pubblicato; la fonte non elenca un record completo delle impostazioni.
Immagine di input originale
Prompt
plaintext1Animate the woman in the supplied first frame: let her turn gradually toward the lens and form a gentle smile while warm daylight crosses her face. Move the camera subtly closer. Include a faint breath and indoor ambience.
Risultato generato
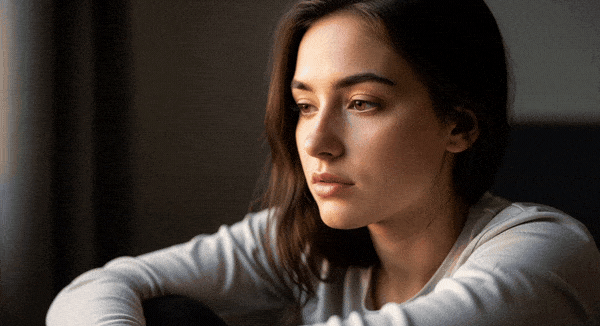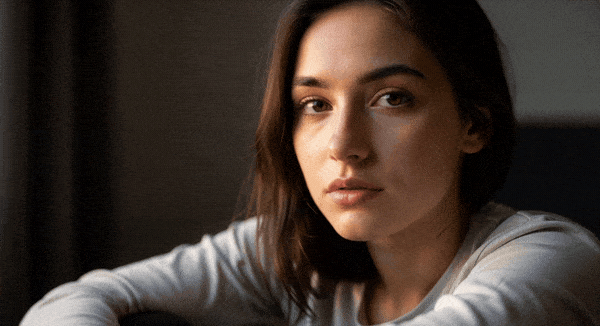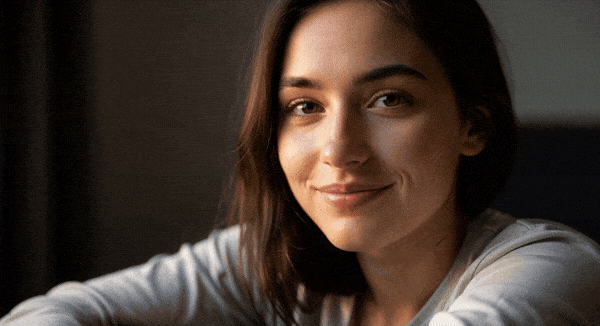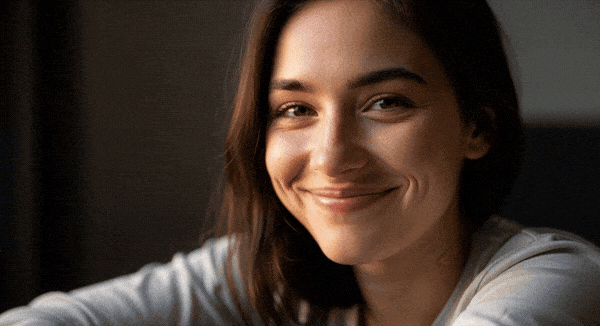
Durata output: 5.06 secondi.
Il ritratto originale fornisce il volto, l'abbigliamento e la composizione accanto alla finestra. Nell'animazione, la donna si gira verso lo spettatore e la sua espressione neutra si apre in un sorriso. Il piccolo cambiamento nello sguardo sostiene la scena. Questo è un utile pattern image-to-video quando la fotografia ha già una composizione forte e l'obiettivo è un movimento emotivo contenuto.
5. Street food: un viaggio di 15 secondi sotto lanterne di carta
Modalità: Text-to-video. Impostazioni: 15 secondi richiesti, 480p, 9:16.
Prompt
plaintext1Film a vertical, handheld night-market scene in one unbroken take. Begin with skewers turning over a smoky grill. The vendor looks into the lens and says, "Fresh off the fire. Who's hungry?" 2 3He passes a skewer to a woman. Follow her through the market beneath colored paper lanterns, past a juice stall, and stay with her until she stops and tastes the food. 4 5Keep the progression continuous from cooking to handover to walking to the first bite. Include the grill's sizzle, voices in the crowd, and music heard farther away.
Risultato generato
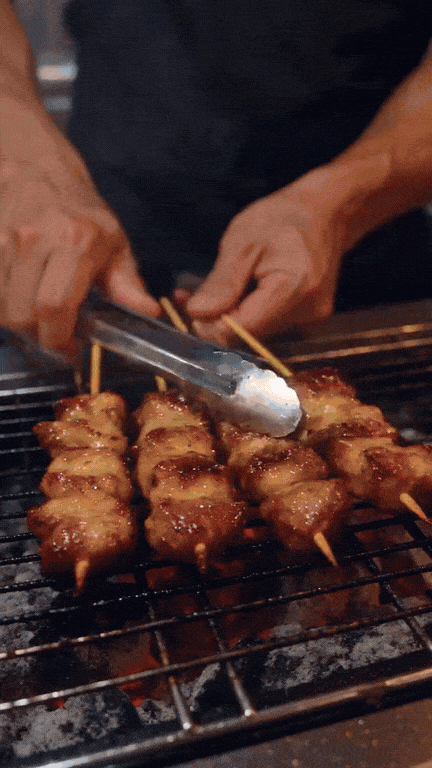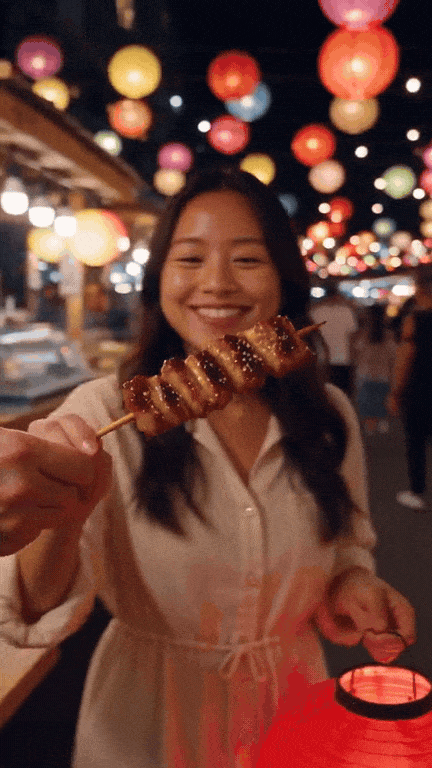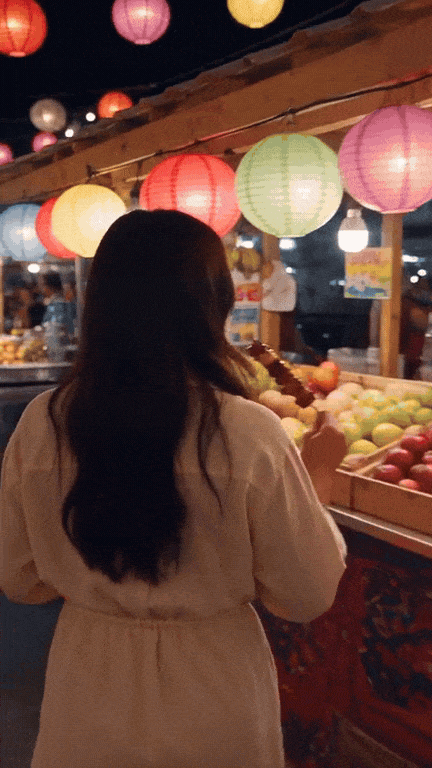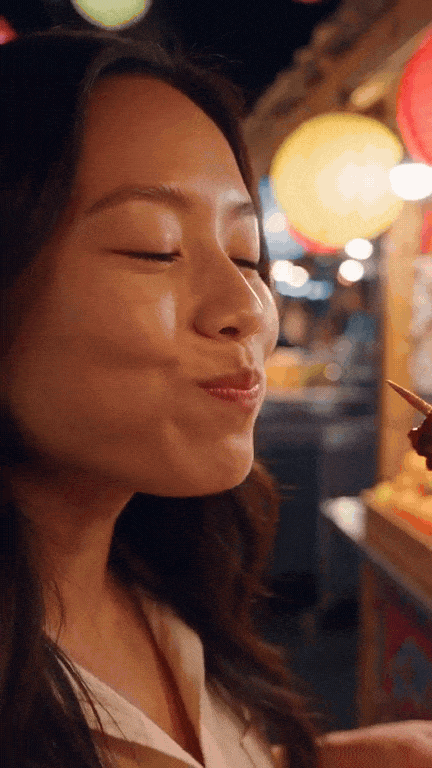
Durata output: 15.07 secondi.
Lo spiedino porta l'attenzione dalla griglia alla cliente, poi la camera la segue sotto file di lanterne luminose. Riflessi caldi sul cibo e luci colorate soffuse mantengono leggibile il mercato affollato. Il morso finale completa l'azione iniziata allo stand. Questa è un'utile struttura a piano sequenza perché ogni movimento conduce naturalmente all'evento successivo.
6. Piano sequenza: una corsa di 30 secondi dal vicolo alla piazza del mercato
Modalità: Text-to-video. Impostazioni: 30 secondi richiesti, 720p, 16:9.
Prompt
plaintext1Make a single, uninterrupted 30-second tracking shot in an old hillside town at golden hour. Follow closely behind a female bicycle courier wearing green, with a yellow parcel secured to the rear rack. 2 3Travel down the cobbled lane, past overhead washing and a windowsill cat. Turn left through a stone arch into a fruit-market square. The courier slows, dismounts, rests the bicycle beside a fountain, and gives the parcel to an elderly shopkeeper at a doorway; he acknowledges her with a smile and nod. 4 5Finish by lifting the camera above the square. Use natural sunlight, extended shadows, and believable movement. Hear bicycle tires, a bell, shoppers, and the fountain. Exclude music, captions, and visible titles.
Risultato generato
Durata output: 30.08 secondi.
Il pacco giallo resta un forte ancoraggio visivo mentre la corriere viaggia dal vicolo stretto attraverso l'arco e nella piazza aperta. La pietra in primo piano scorre oltre l'obiettivo prima che la salita finale riveli l'ambientazione più ampia. Il prompt dà a un'inquadratura lunga un percorso e una destinazione; la scala che cambia fornisce varietà senza un montaggio di scene non correlate.
7. Aerea: costruisci il movimento attraverso una rivelazione paesaggistica
Modalità: Text-to-video. Impostazioni: 5 secondi richiesti, 720p, 16:9.
Prompt
plaintext1Sweep quickly just above emerald rice terraces at dawn, skim palms, then rise to reveal a tall waterfall in a mist-filled valley. Golden rays pierce the haze. Use a crisp, vivid 16 mm view. Hear rushing air and the waterfall growing louder; omit music.
Risultato generato
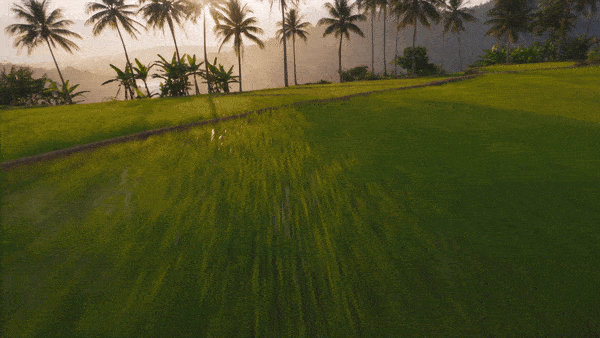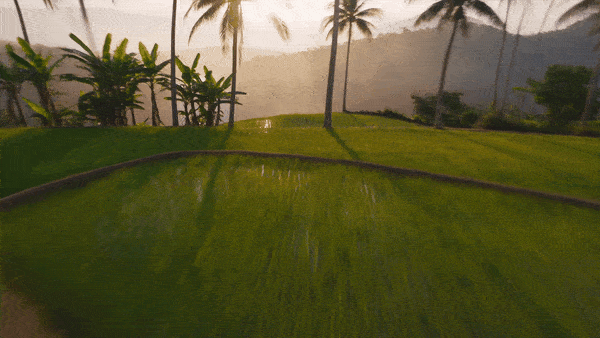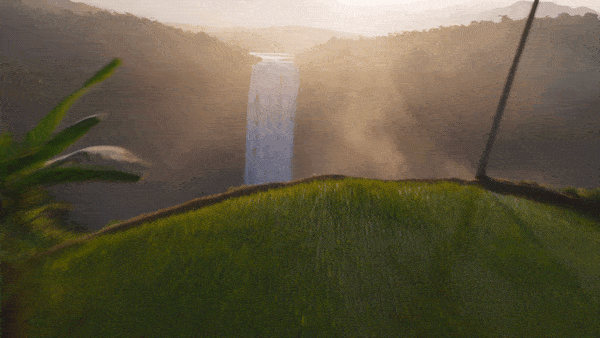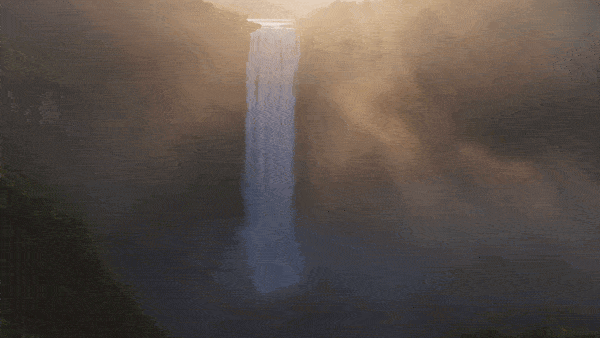
Durata output: 5.06 secondi.
La camera viaggia prima vicino alle terrazze, con palme e bordi dei campi che forniscono indizi di profondità ravvicinati, poi sale verso la cascata. La rivelazione cambia sia l'altezza sia la quantità di paesaggio visibile. Nominare quel percorso rende l'inquadratura più facile da dirigere che chiedere semplicemente una vista aerea epica; la cascata diventa la destinazione del movimento.
8. Paesaggio: usa un'immagine reale come riferimento visivo
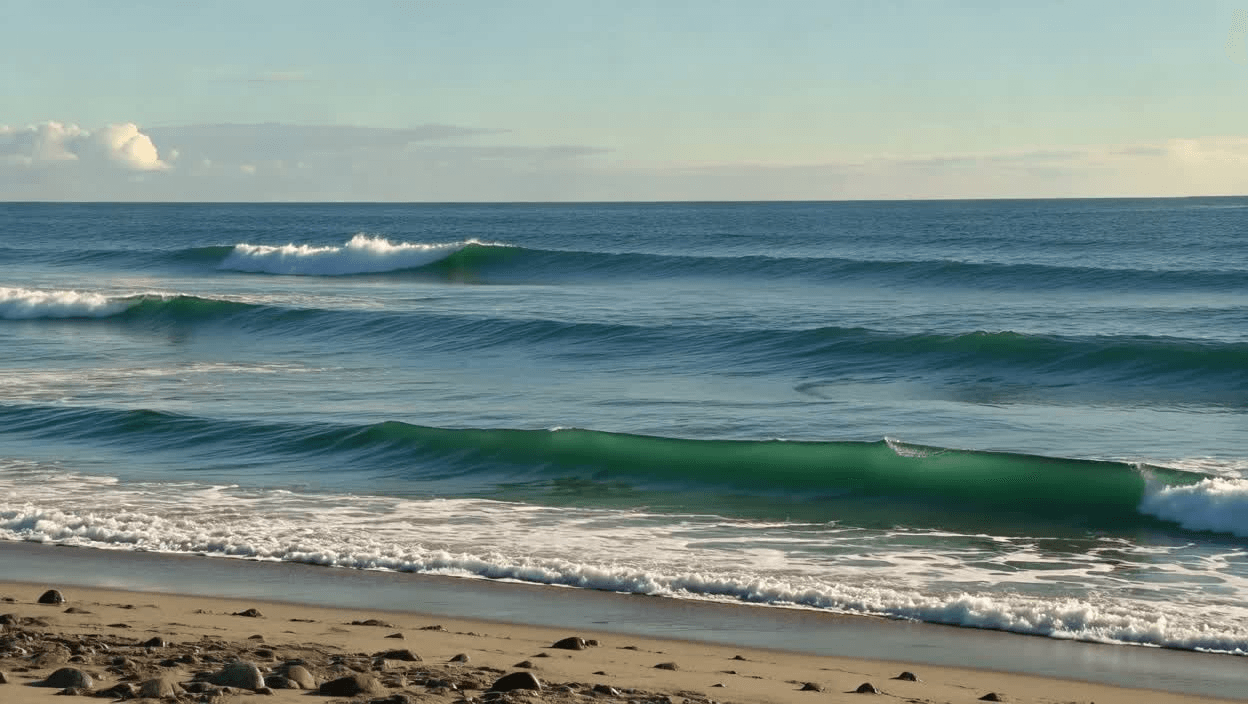
Modalità: Reference-to-video guidato da immagine; non un compito con primo fotogramma. Impostazioni: 16:9 nel record di input pubblicato; nessun video di input è allegato.
Immagine di input originale
Prompt
plaintext1Let @Image1 establish the coastline's appearance. At dawn, glide slowly above and along the shore with a drone-like camera. Show mist hanging over the sea and small waves washing onto the beach.
Risultato generato
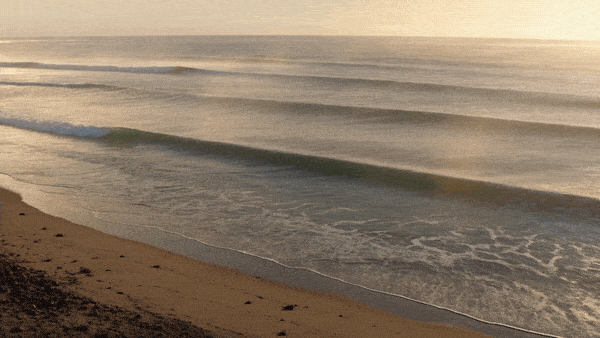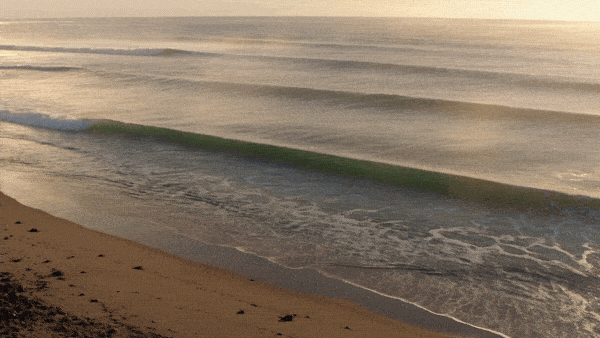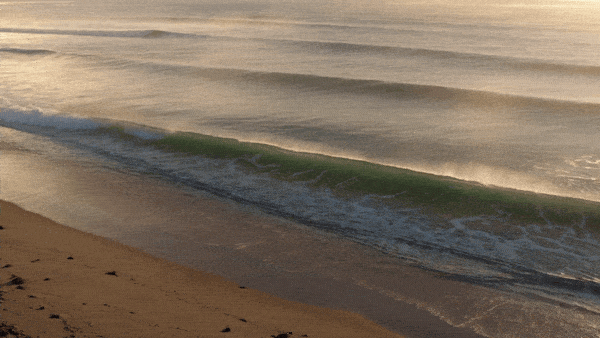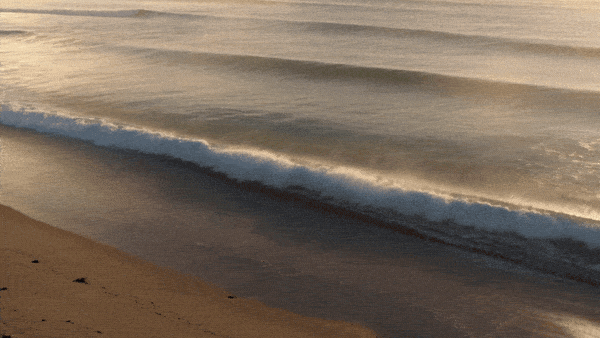
Durata output: 5.06 secondi.
L'immagine di riferimento stabilisce il mare, la costa e la palette blu-verde, mentre il risultato introduce luce calda e linee successive di onde. Osserva la schiuma avanzare e ritirarsi lungo la spiaggia. Questa è una guida all'aspetto più che una corrispondenza esatta del primo fotogramma: il riferimento suggerisce il carattere visivo della location e il prompt fornisce l'acqua in movimento e il punto di vista aereo.
9. Movimento animale: mantieni la camera all'altezza del soggetto
Modalità: Text-to-video. Impostazioni: L'esempio salvato non espone un record completo delle impostazioni; usa l'output misurato qui sotto.
Prompt
plaintext1Track at grass height as a small dog runs toward the lens across a sunny field, its ears bouncing. Use warm late-day illumination. Add cheerful barks and the breeze moving through the grass.
Risultato generato
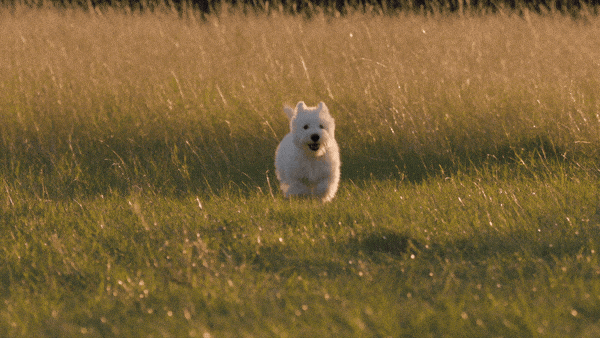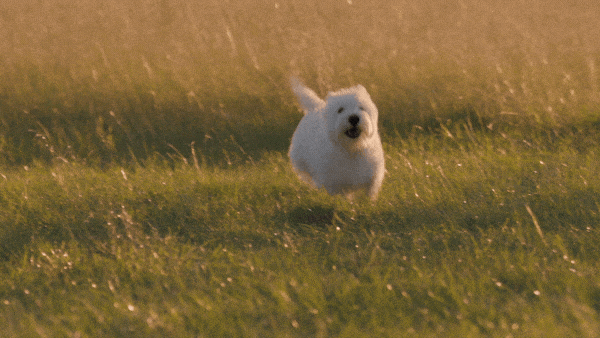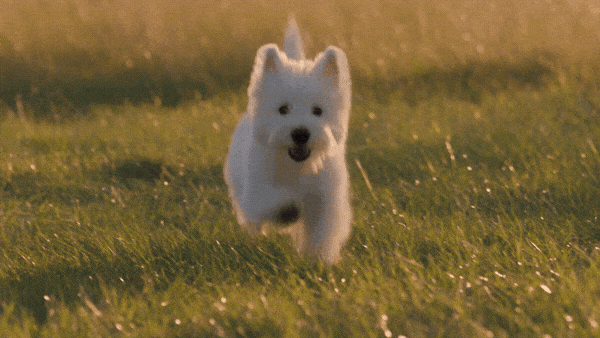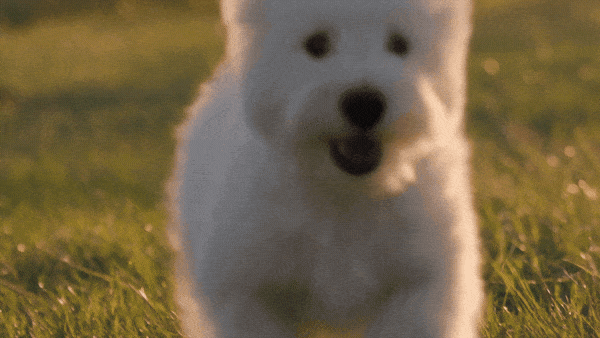
Durata output: 5.06 secondi.
L'avvicinamento del cane cambia l'inquadratura da una piccola figura nell'erba a una vista ravvicinata del suo muso. Orecchie che rimbalzano e falcate ripetute mantengono leggibile il movimento per tutta la durata. Una camera bassa mette lo spettatore all'altezza dell'animale e dà a una semplice corsa un endpoint chiaro, senza bisogno di uno stacco o di un secondo personaggio.
10. Image-to-video: un idrovolante lascia il suo molo originale
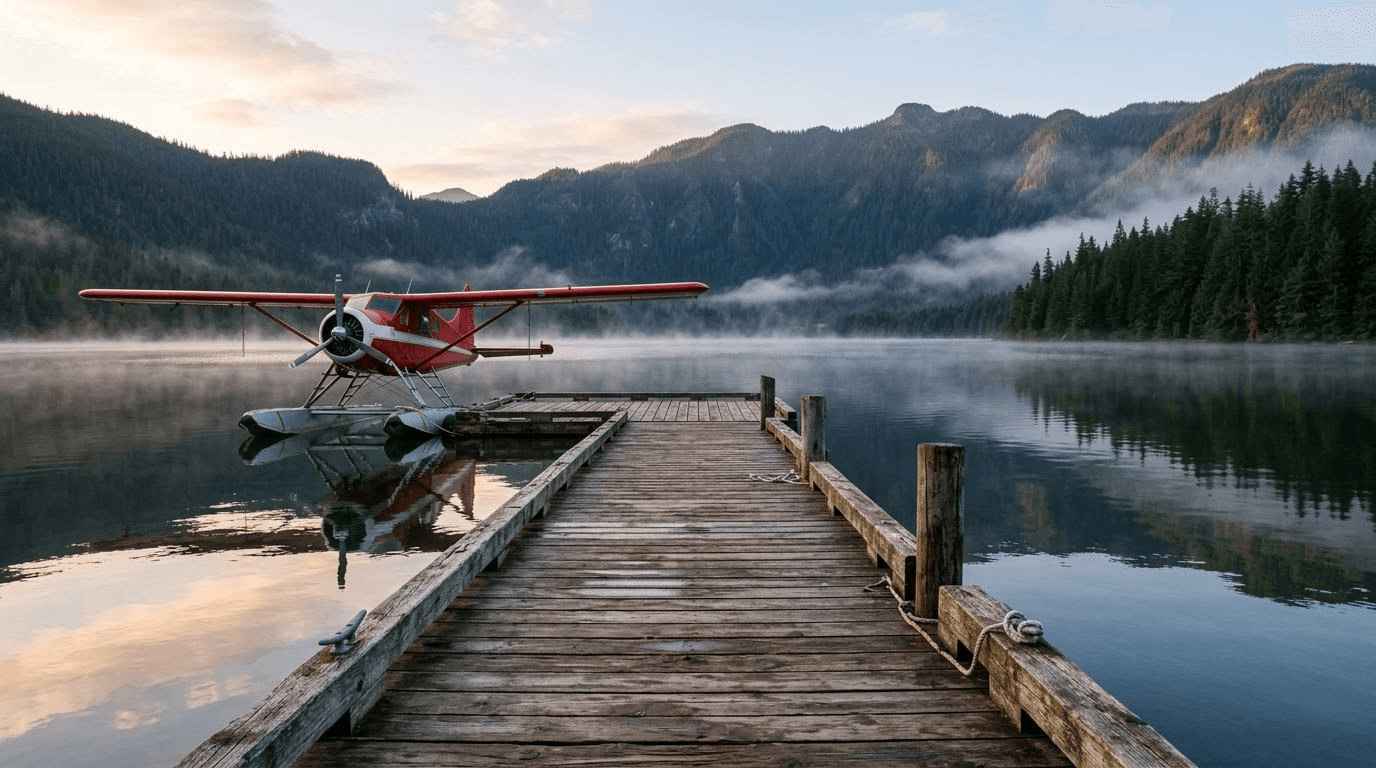
Modalità: Image-to-video, input del primo fotogramma. Impostazioni: 8 secondi, 720p, rapporto adattivo, audio attivo; seed pubblicato 42.
Immagine di input originale
Prompt
plaintext1Animate the supplied seaplane: its propeller starts, it taxis away with a white wake, then takes off toward the mountains. Pan from the dock to follow; mist moves over the lake. Hear ignition, engine roar, water against dock posts, then the receding engine. No music.
Risultato generato
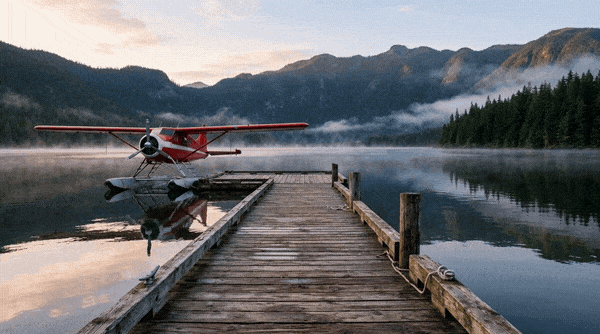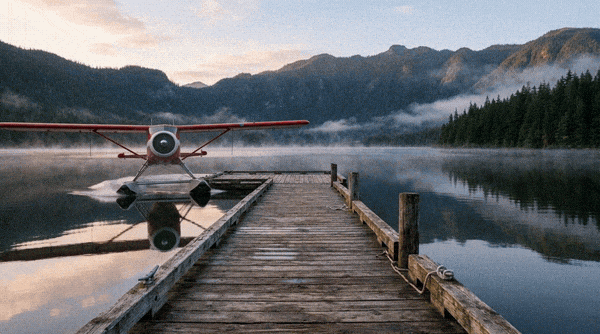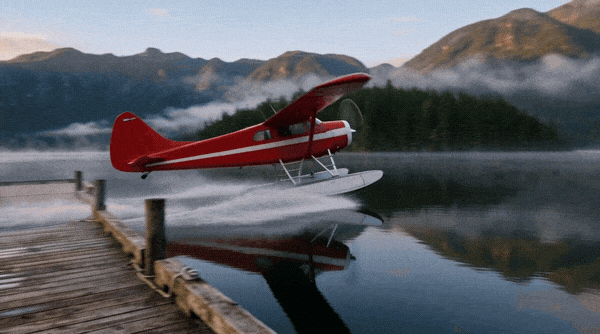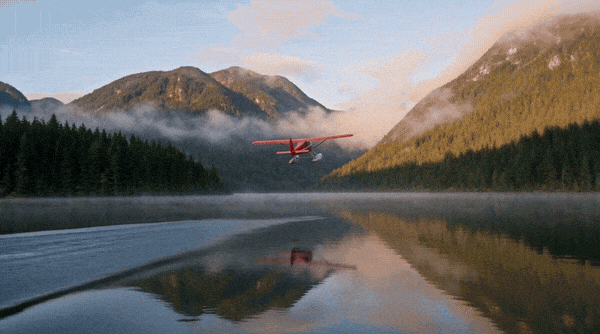
Durata output: 8.06 secondi.
L'immagine sorgente fissa l'idrovolante rosso, il molo di legno, lo skyline montano e i riflessi del lago. Il risultato si sviluppa dalla partenza all'accelerazione sull'acqua, con una scia che si allarga, prima che l'aeromobile lasci la superficie. La chiave è una catena d'azione ordinata: avviamento, rullaggio e decollo sono fasi visibili separate anziché un'unica istruzione vaga per far volare l'aereo.
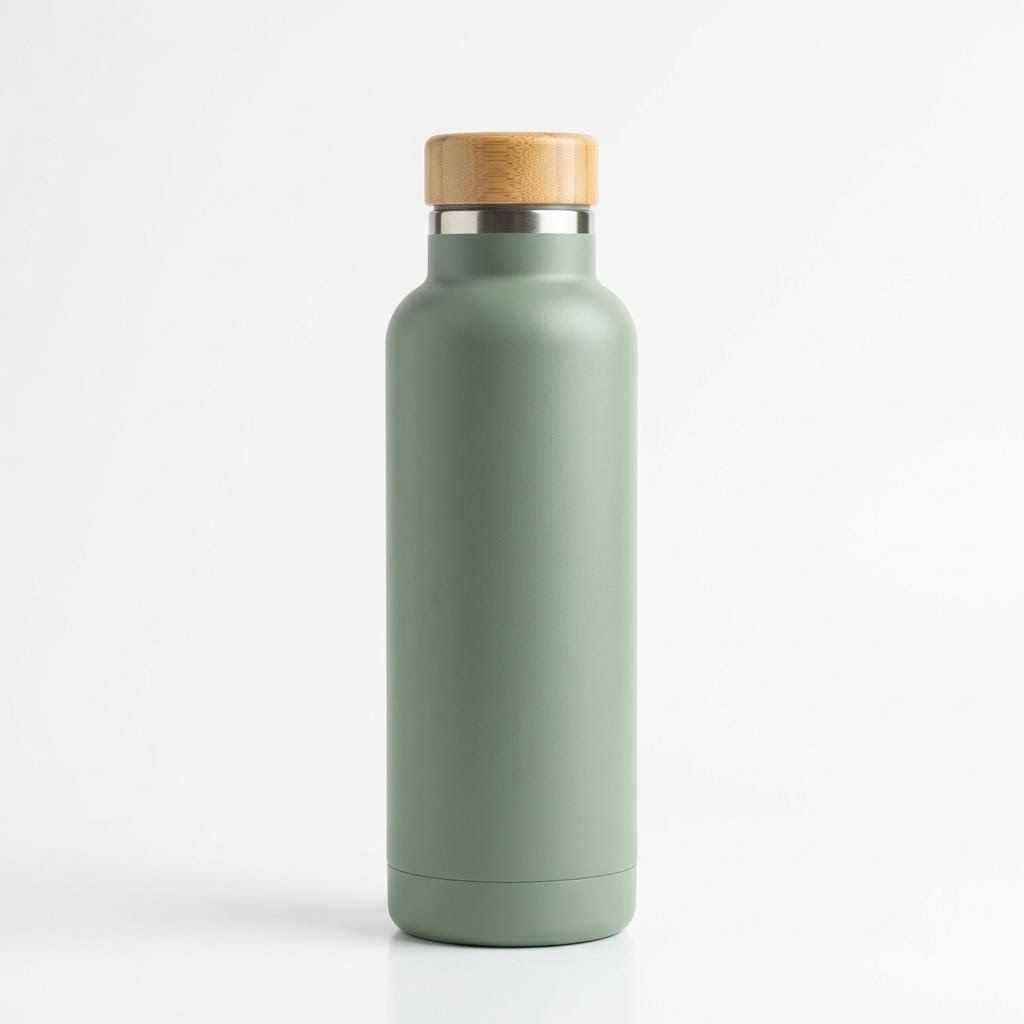
11. Riferimento immagine: porta una bottiglia in una scena di montagna
Modalità: Reference-to-video guidato da immagine; riferimento di prodotto, non un primo fotogramma. Impostazioni: 8 secondi, 720p, 16:9, audio attivo; seed pubblicato 42.
Immagine di input originale
Prompt
plaintext1@Image1 identifies the bottle: sage matte finish, bamboo cap, steel ring, no branding. At sunset on a rocky ridge, a red-jacketed female hiker removes it from her backpack, opens it, drinks and surveys the valley. Pull from hands-and-bottle detail to a landscape wide. Hear wind, gravel and unscrewing; exclude music.
Risultato generato
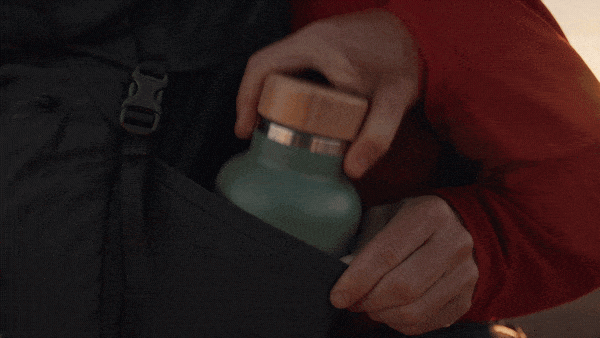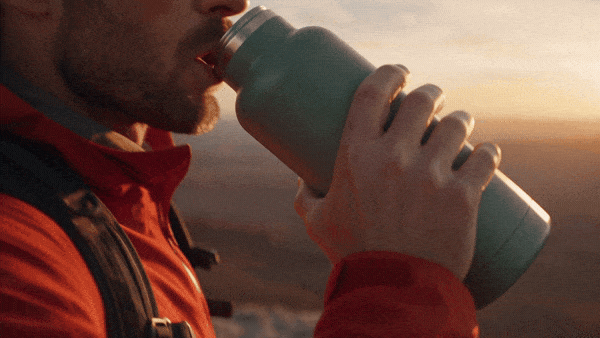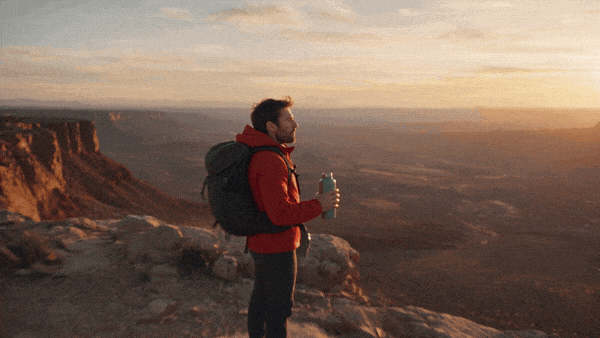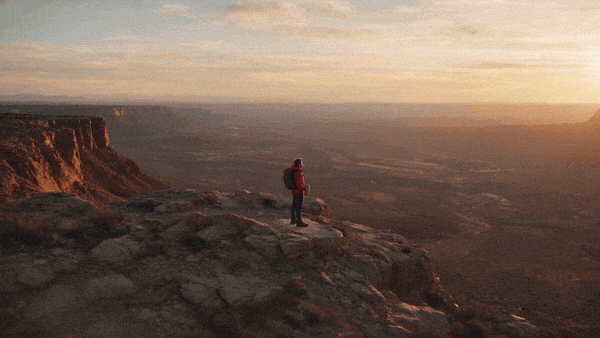
Durata output: 8.06 secondi.
Il risultato porta la silhouette complessiva e la superficie opaca della bottiglia in una scena outdoor molto più ampia, poi si allarga dal bere alla vista del canyon. Mostra anche i limiti del riferimento: la bottiglia vira verso il turchese e l'escursionista donna richiesta diventa un uomo. Controlla separatamente il colore del prodotto e il soggetto umano quando un'immagine è assegnata solo al prodotto.
12. Emozione: una storia di aquilone di 20 secondi in tre inquadrature collegate
Modalità: Text-to-video. Impostazioni: 20 secondi richiesti, 720p, 16:9; seed pubblicato 42.
Prompt
plaintext1Create a three-shot, 20-second beach scene in the wind and late-afternoon light. 2 30–6 seconds: An older man in a gray wool sweater kneels beside an eight-year-old girl and helps her hold a yellow diamond-shaped kite. He says, "Wait for the wind. Now let go." 4 56–13 seconds: A gust lifts the kite. Its line slips through the girl's hands as she laughs and runs backward over wet sand. 6 713–20 seconds: Show both figures from behind in a wide composition, the kite high above the waves under a pale-blue sky. The girl says, "Grandpa, it's flying!" 8 9Use wind, breaking surf, gulls, and the kite's fabric snapping. Do not add a score or subtitles.
Risultato generato
Durata output: 20.06 secondi.
L'aquilone giallo collega l'interazione ravvicinata sulla sabbia al cielo aperto nell'inquadratura ampia finale. La scena cambia scala mentre il compito condiviso diventa un momento di liberazione, così l'emozione si sviluppa attraverso l'azione anziché una richiesta di sembrare felici. Tre blocchi di inquadratura danno alla preparazione, al lancio e alla ricompensa lo spazio per essere letti lungo tutti i venti secondi.
Esegui un brief, poi correggi il fallimento reale
Apri il playground Seedance 2.5 Flash Text-to-Video per un esempio solo testo. Per un esempio con riferimento, usa la voce corrispondente linkata in precedenza. Seleziona esplicitamente risoluzione, rapporto, durata e audio e controlla che i valori selezionati restino visibili prima di inviare.
Scarica il risultato completo e conserva l'originale insieme al prompt e alle impostazioni. Guarda a velocità normale prima di ispezionare i singoli fotogrammi. Un fermo immagine può esporre una mano distorta, ma non può stabilire se il percorso della camera, l'atterraggio o la transizione sonora funzionano.
Scrivi tre controlli di accettazione prima di eseguire. Per l'esempio di danza, potrebbero essere piedi visibili, un giro completo e continuità riconoscibile dell'outfit. Per la pubblicità della bottiglia, usa silhouette stabile, un effettivo cambio di punto di vista e un finale chiaro. Questi controlli trasformano “rendilo migliore” in una revisione specifica.
| Problema osservato | Prima revisione utile |
|---|---|
| Il soggetto si muove a malapena | Sostituisci le parole d'atmosfera con un'azione che ha un endpoint visibile |
| La camera zooma invece di cambiare punto di vista | Nomina i lati di inizio e fine e includi un indizio di profondità dello sfondo |
| L'outfit o il prodotto cambia dopo uno stacco | Riduci gli stacchi, semplifica l'occlusione e usa un riferimento di aspetto adatto |
| Troppe azioni restano incompiute | Rimuovi una battuta o estendi l'impostazione di durata effettiva |
| Lo sfondo di riferimento sovrasta la nuova scena | Limita quell'input all'aspetto o al movimento e specifica la nuova ambientazione |
| La musica appare durante una scena d'atmosfera | Rimuovi il linguaggio musicale e richiedi solo suono ambientale |
| Il parlato cambia o compaiono parole extra | Accorcia la battuta e identifica un solo parlante e la lingua |
| Il testo è sbagliato o instabile | Aggiungi testo esatto e grafiche approvate in post-produzione |
Cambia una categoria alla volta: azione, camera, riferimenti o suono. Mantieni stabili le altre impostazioni richieste. Gli output possono comunque variare tra un'esecuzione e l'altra, quindi una ripresa riuscita non dimostra che una modifica di formulazione migliori il tasso di successo. Registra risultati ripetuti prima di fare quell'affermazione.
Tieni un breve registro delle revisioni: il fallimento che hai visto, la frase che hai modificato e se la nuova ripresa l'ha risolto. Puoi poi riutilizzare un brief di inquadratura funzionante senza accumulare ogni istruzione di ogni tentativo fallito. Un prompt gonfio spesso contiene vecchi vincoli che non servono più alla scena attuale.
Usa questa Guida ai prompt ed esempi di Seedance 2.5 Flash come una libreria di prompt adattabile: scegli una scena, preserva la sua azione e la logica di camera e sostituisci solo i dettagli specifici del soggetto. Inizia con un risultato breve e ispezionabile prima di costruire una sequenza più lunga attorno ad esso.
Domande frequenti
Esiste una formula ufficiale per i prompt di Seedance 2.5 Flash?
BytePlus pubblica un tutorial e una guida ai prompt della serie Seedance 2.5 che coprono la scrittura strutturata e distinguono le varianti del modello. La formula in questo articolo adatta quei principi in un brief di lavoro e aggiunge un controllo esplicito di continuità. Non è un formato di parser obbligatorio né una promessa di esecuzione esatta della camera.
Dovrei scrivere i prompt di Seedance 2.5 Flash in inglese o in cinese?
L'attuale schema Atlas Cloud Seedance 2.5 Flash Text-to-Video supporta entrambi. Usa la lingua in cui riesci a descrivere l'azione con precisione. Per il dialogo, identifica direttamente la lingua parlata e il parlante. Questa guida non afferma che l'inglese produca risultati migliori del cinese.
Ho bisogno di un negative prompt separato?
Lo schema Atlas Cloud Seedance 2.5 Flash Text-to-Video verificato non elenca un campo separato per il negative prompt. Inserisci esclusioni utili nel prompt principale, specialmente per musica, parlato, sottotitoli o testo aggiunto. Descrivi anche positivamente il comportamento desiderato, ad esempio mantenendo l'inquadratura dalla testa ai piedi.
Seedance 2.5 Flash può generare video nativi a 1080p?
Le voci attuali Atlas Cloud Seedance 2.5 Flash elencano output nativi a 480p e 720p. Non dedurre il supporto nativo a 1080p da una pagina standard di Seedance 2.5 o da un export upscalato. Se la consegna richiede una risoluzione nativa superiore, scegli un modello e una configurazione che la supportino esplicitamente.
I 12 esempi sono prompt testati con risultati garantiti?
Gli esempi abbinano output pubblicati di Seedance 2.5 Flash a prompt adattati dai loro brief di scena. Non sono test nuovi della formulazione esatta mostrata qui e non stabiliscono un tasso di successo. Ispeziona le anteprime complete e confronta le immagini fornite con il risultato; il caso 11 mostra perché un riferimento non garantisce ogni dettaglio richiesto.
Quanto dovrebbe essere lungo un prompt di Seedance 2.5 Flash?
Usa abbastanza dettagli per stabilire azione, camera, suono e continuità importante senza introdurre conflitti. Inizia con una scena compatta. Aggiungi una seconda battuta o un'assegnazione di riferimento quando risponde a un'esigenza specifica. Un prompt più lungo è utile quando dirige più chiaramente la scena, invece di ripetere la stessa richiesta.




