Le pipeline agentiche in produzione falliscono spesso a causa di violazioni inattese dello schema. Anche i migliori LLM autoregressivi falliscono il parsing JSON durante chiamate di strumenti ad alto volume, costringendo gli sviluppatori a costruire complessi cicli di ripetizione e gestori di errori personalizzati.
TypeSafe Jev risolve questo difetto strutturale abbandonando completamente la generazione sequenziale token-per-token. Operando come modello decisionale non-autoregressivo, Jev ingerisce lo stato dell'applicazione e valuta le domande di schema pre-dichiarate in un singolo passaggio in parallelo. Poiché le possibili scelte di output sono rigorosamente limitate prima dell'esecuzione, Jev elimina matematicamente JSON malformati, nomi di strumenti non validi e testo fuori schema.
Quick Takeaways: Cos'è TypeSafe Jev AI? Benchmark di Performance e Velocità
TypeSafe Jev AI è un modello decisionale non-autoregressivo costruito specificamente per classificazione sub-secondo, punteggio intent e routing strutturato di microservizi. A differenza degli LLM autoregressivi, Jev valuta le scelte di schema pre-dichiarate in un singolo passaggio in avanti.
- Zero Allucinazione a Livello di Tipo: Sostituisce i loop di decodifica stringa con primitive di schema a stato limitato, producendo un tasso di errore di tipo pari allo 0%.
- Esecuzione sotto i 500ms: Il campionamento parallelo non-autoregressivo raggiunge una latenza P95 di 70ms–500ms fino a 200 volte più veloce degli LLM standard.
- Token di Output Gratuiti: Zero token sequenziali generati significa token di output completamente gratuiti a $0.042/1M di token di input.
- Ideale per: Routing di microservizi, assegnazione di strumenti agentici, triage dei ticket e gating dell'intento.
Ripensare lo Stack AI: Intuizione System 1 vs Ragionamento System 2
Quando si ingegnerizza un software backend scalabile, forzare semplici controlli condizionali attraverso un pesante endpoint di chat completion causa grave latenza di sistema. La maggior parte dei microservizi non richiede prosa creativa o generazione multi-step di chain-of-thought; richiede selezione immediata e deterministica su scelte note.
Applicare il Framework Cognitivo di Kahneman all'Architettura Software
Il co-fondatore di TypeSafe Diogo Almeida, che in precedenza ha co-creato Reinforcement Learning from Human Feedback a OpenAI, ha introdotto una pivot strutturale con TypeSafe Jev per risolvere questa inefficienza. Basandosi direttamente sul framework cognitivo di Kahneman, la piattaforma divide l'elaborazione in due layer operativi distinti nell'architettura dello stack AI moderno:
- System 2 Ragionamento Lento e Deliberato: Standard LLM autoregressive che operano tramite generazione sequenziale, token a token. Questi modelli eccellono nel redigere documenti lunghi, gestire ragionamenti ambigui e scrivere codice complesso.
- System 1 Decisioni Rapide e Intuitive: Un modello AI System One dedicato, addestrato tramite Reinforcement Learning for Calibrated Decisions piuttosto che la classica RLHF. Progettato specificamente per classificazione sub-second, punteggio intent e routing di esecuzione senza overhead conversazionale.
Jev vs Costi e Architettura LLM: Modelli Decisionali vs Modelli Chat
Sostituire modelli chat generici con modelli decisionali tipizzati specializzati ottimizza fondamentalmente i flussi di lavoro dei microservizi, isolando la valutazione rapida dalla generazione profonda.
| Dimensione Architetturale | LLM autoregressive (System 2) | TypeSafe Jev (System 1) |
| Compito Principale | Sintesi testuale aperta | Scelta discreta e valutazione schema |
| Latenza di Esecuzione | 3.000ms a 30.000ms+ | 70ms a 500ms |
| Formato Output | Sequenza di testo non strutturata | Primitive di schema tipizzate |
| Loop Computazionale | Decodifica sequenziale token | Valutazione singolo passaggio |
| Obiettivo di Addestramento | Preferenza umana (RLHF) | Confidenza decisionale calibrata (RLCD) |
Scaricare il routing, le guardie di sicurezza e il dispatching di funzioni dai modelli chat standard risolve i colli di bottiglia prestazionali intrinseci agli LLM autoregressive. Incorporare un modello AI System One garantisce che i motori di ragionamento pesanti vengano attivati solo quando è realmente richiesta una generazione aperta.
Come il Modello TypeSafe Jev Offre Zero Allucinazione a Livello di Tipo
Anche con modalità JSON strict abilitata, gli LLM di frontiera restituiscono regolarmente chiavi fuori schema o valori enum allucinati durante le esecuzioni di produzione ad alta concorrenza, causando lo 0.5% al 5% delle richieste dei pipeline a fallire. I microservizi di produzione richiedono determinismo assoluto del tipo, eppure i modelli autoregressive rimangono intrinsecosamente vulnerabili agli errori di generazione stringa.
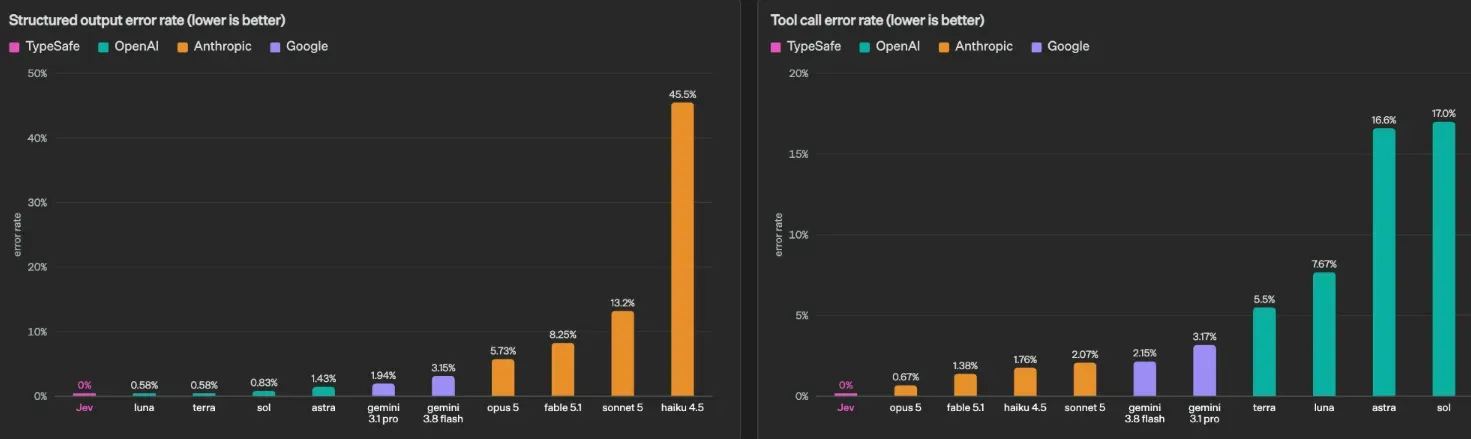
TypeSafe Jev risolve questo sostituendo i loop di decodifica stringa con un'architettura di stato limitato. Invece di generare testo arbitrario e tentare di forzarlo nei sintassi JSON, Jev valuta i dati di input rispetto a vincoli di schema predefiniti in un singolo passaggio. Questo cambio strutturale conferisce una vera intelligenza artificiale a zero allucinazioni al livello dei tipi, risultando in 0% errori di tipo nei flussi di lavoro automatici.
Le Tre Primitive Scheletriche
Jev processa tutte le domande di input tramite tre primitive esplicite:
- Primitive Choice: Seleziona esattamente una opzione da una lista predefinita di fino a 255 scelte categoriali, restituendo l'etichetta vincente insieme alle distribuzioni di probabilità complete.
- Primitive Score: Valuta l'input contro una scala numerica ordinata o una rubrica descrittiva, fornendo valutazioni insieme alla distrazione di probabilità per ogni livello.
- Primitive Noul: Calcola la probabilità esatta di una condizione sì/no come un numero float tra 0.0 e 1.0, eliminando il testo di spiegazione intermedio.
Poiché ogni query si mappa rigorosamente su queste tre primitive, il motore di esecuzione non può emettere chiavi non valide, nomi di strumenti fuori lista o payload malformati.
Sicurezza dei Tipi nella Valutazione Strutturata di Output
I modelli chat tradizionali generano il syntax carattere per carattere, creandendo rischi anali costanti nel backend nel pipeline.
| Metriche di Valutazione | Modalità JSON autoregressive | TypeSafe Jev System One |
| Forzatura del tipo del output | Validazione stringa post-generazione | Primitive tipizzate a livello matematico |
| Frequenza di Errore Tipo | Variabile (tasso di fallimento 0.05%-5%+) | 0% errori di tipo (vincolo schema) |
| Rischio dei valori enum non validi | Alto senza ripetizioni personalizzate | Zero (impossibile per design) |
Limitare l'esecuzione del model a uno stato limitato strettamente garantisce una valutazione di output strutturato affidabile. Le applicazioni consumano i output Jev direttamente senza scrivere gestori eccezioni per schemi JSON rotti.
Nota su Determinismo del tipo vs. Probabilità: TypeSafe Jev garantisce il 0% di errori di tipo e conformità allo schema per design, eliminando matematicamente sintassi malformate, chiavi mancanti e valori enum fuori lista. Tuttavia, come tutti i modelli decisionali, le sue scelte di output rimangono probabilistiche. In input intrinsecamente ambigui, i punteggi di confidenza dovrebbero essere usati per gating l'esecuzione invece di presupporre certezza semantica assoluta.
Come il Campionamento Parallelo Non-Autoregressive Guida la Latenza sotto i 500ms e Output Gratis
Utilizzare endpoint chat standard per tag di classificazione semplici come {"category": "billing"} introduce latenza inutile in servizi di produzione nan. back-end. Poiché i modelli autoregressive si basano su decodifica sequenziale a token, i thread del backend rimangono bloccati mentre attendono loop di generazione carattere singolo.
La Meccanica della Valutazione a Singolo Passaggio
I transformer tradizionali eseguono loop di generazione a cascata dove ogni nuovo token richiede un passaggio separato attraverso lo stack di rete. Questo sta sequenziale crea un'alta latenza e aumenta i costi infrastrutturali basati sul volume token generato.
TypeSafe Jev elimina o rende sequenziale la generazione utilizzando polar Montaggio parallelo non-autoregressive. Come descritto nel comunicato di lancio di TypeSafe, Jev ingerisce lo stato contestuale e valuta tutte le scelte di schema pre-dichiarate simultaneamente in un singolo passaggio in avanti.
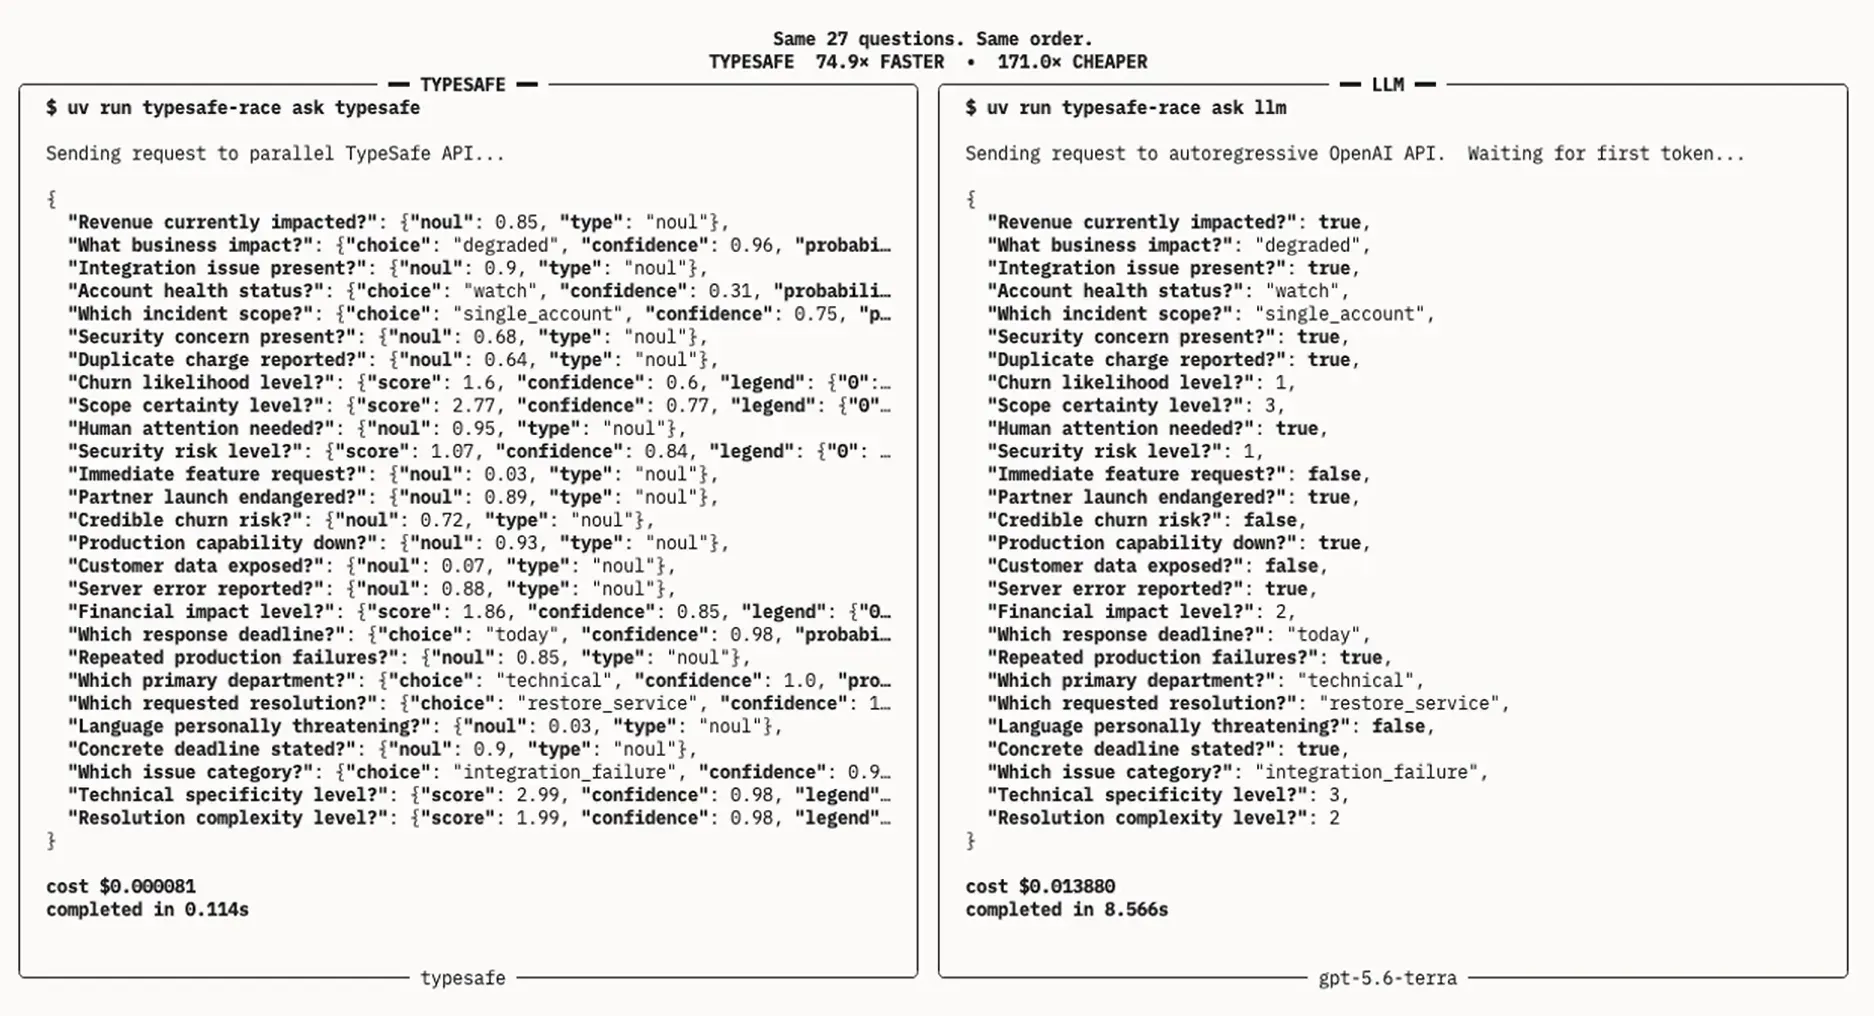
Confronto benchmark terminale che esegue 27 domande di valutazione dello schema in simultanea su TypeSafe Jev vs. endpoint GPT 5.6 Terra
Poiché il modello calcola distribuzioni di probabilità su output predefiniti piuttosto che generare testo libero, i loop di decodifica di fascicoli scompaiono completamente. Questo cambio strutturale produce tre benefici prestazionali principali:
- Token di OutputGratis (Troppo conveniente per misurarlo): Poiché Jev valuta le scelte in un singolo passaggio senza generare token sequenziali, il costo computazionale dell'evalutazione dell'output ha un costo di computazione incrementale virtualmente zero, rendendo i token di output effettivamente gratuiti.
- Prezzo Prevedibile: Il costo di elaborazione del contesto è di $0.042 per milione di token di input. La valutazione di schemi prompt statici con Jev previene la inflazione esponenziale della bollette API rispetto al overhead di esecuzione di lungo contesto dei normali endpoint chat.
- Esecuzione Sub-Secondo: I dati benchmark di latenza pubblicati da TypeSafe Jev dimostrano tempi di risposta P95 costanti tra 70ms e 500ms, fino a 2-5.200 volte più veloci rispetto ai modellichat di frontiera.
Scomposizione delle Performance Architetturali
| Metrica / Dimensione | LLM Autoregressivi Tradizionali (System 2) | Motore TypeSafe Jev System 1 |
|---|---|---|
| Loop di Esecuzione | Decodifica sequenziale token per token | Singolo passaggio in parallelo su schema pre-dichiarato |
| Tipo di Output | Stringa di testo non strutturata / stringa JSON | Primitive decisionali tipizzate (Choice, Score, Null) |
| Tasso di Errore Schema | 0.58% ~ 45%+ (a seconda del modello/prompt) | 0% errori di tipo (vincolo matematico) |
| Profilo Latenza P95 | 3.000ms ~ 30.000ms+ | 70ms ~ 500ms |
| Economia del Flusso Output | Variabile per token ($15 ~ $60 / MTok) | Gratuito - Nessuna generazione sequenziale di token di output |
| Dominio Principale | Ragionamento, stesura, sintesi aperta | Classificazione, selezione strumenti, gate di confidenza |
Superare il Collo di Bottiglia di Memory Bandwidth
In inferenza LLM standard, la larghezza di banda memoria si saturla mentre i pesi del modello si ricaricano nella logica di memoria per ogni singolo token. Completando le valutazioni decisionali in un singolo passaggio, Jev bypassa completamente questo collo di bottiglia, sostenendo una velocità di risposta stabile anche già sui concurrentaki pesanti.
Rafforzamento per Decisioni Calibrate e Gate di Confidenza
Modelli di chat standard restituiscono frequentemente dichiarazioni errate con una confidenza auto dichiarata del 99%, perché il fine-tuning tradizionale premia la formulazione persuasiva piuttosto che la verità statistica. Nei microservizi di produzione, una decisione sbagliata troppo sicura conduce direttamente a record database corrotti, argomenti strumentali rotti e tempi di stop imprevisti.
Allineamento della Confidenza del Modello con l'Accuratezza Empirica
Per risolvere questo eccesso di confidenza strutturale, TypeSafe ha introdotto Reinforcement per Calibrated Decisions. A differenza della metodologia RLHF tradizionale che ottimizza per la preferenza umana soggettiva, RLCD addestra i modelli decisionali agli input per produrre probabilità calibrate.
Attraversa la confidenza allineata all'accuratezza, una probabilità di output 0,90 di Jev significa che la scelta candidate è empiricamente corretta il 90% delle volte su set di test. Questa calibrazione matematica permette un processo decisionale probabilistico attuabile senza che gli sviluppatori debbano scrivere complesse “promphi” per stimare la certezza dell'input.
Implementare Routing con Flusso a Soglie in Produzione
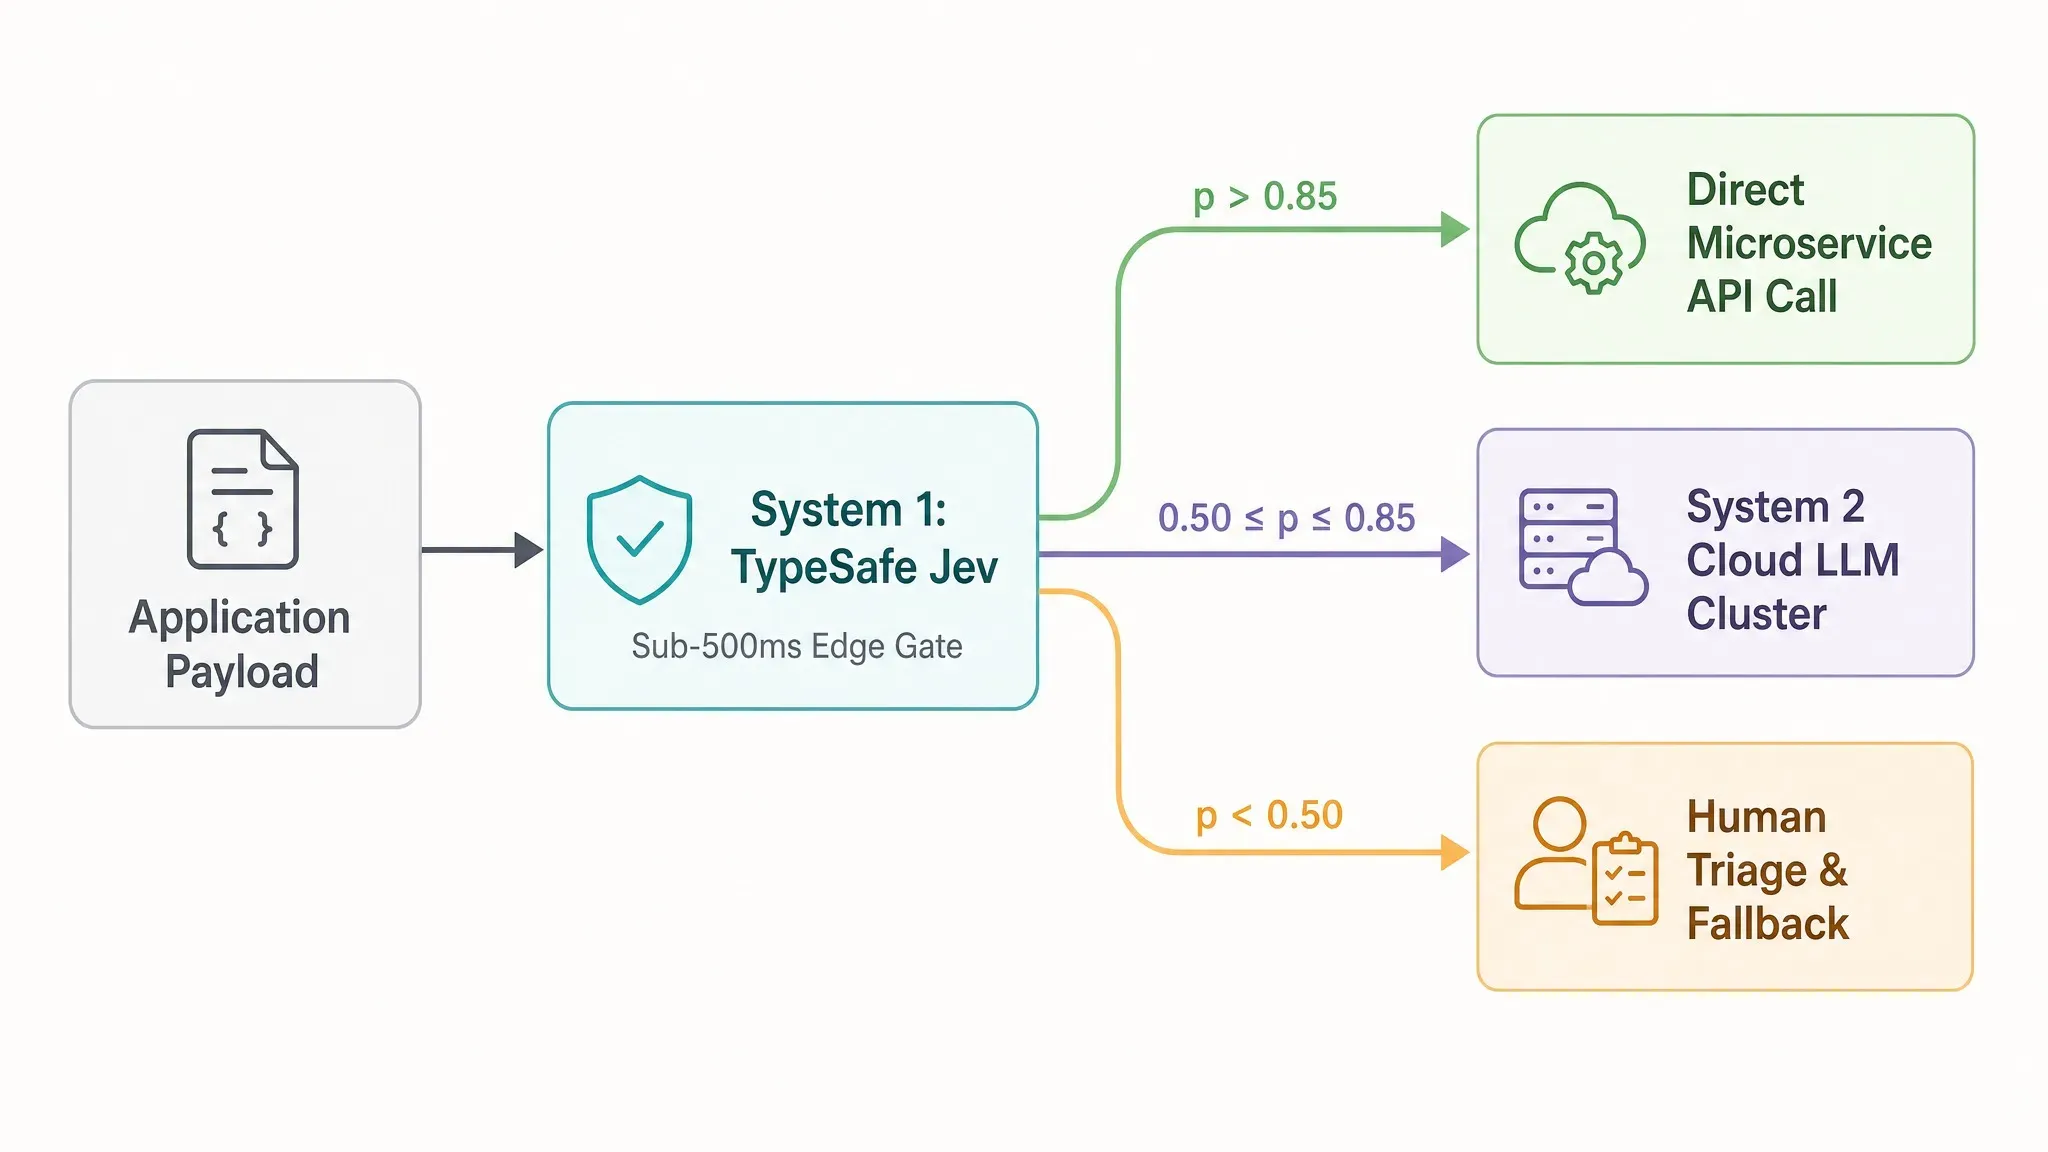
Gli ingegneri possono utilizzare le allerte di probabilità calibatore per configurare gate di decisione a soglia, per es. in un setttore tipico di produzione:
p > 0,85(Percorso Rapido): Esecuzione immediatamente nel percorso ad alta velocità, bypassando del tutto gli endpoint LLM lenti.0,50 ≤ p ≤ 0,85(Escalation System 2):** Invia output borderline a un LLM di ragionamento per gestire casi ai limiti ambiguenti.p < 0,50** (Triage fallback): Attivare le default sicuri o inoltrare la richiesta a una coda di revisione umana.
Per turnaround cases limites, il routing basato sulla confidenza ridireziona il payload al livello di ragionamento aziendale. L'utilizzo del GPT 5.6 Teraira on Atlas Cloud offre un bersaglio fallback ottimale per queste richieste, sfruttando la sua finestra di contest di 1.050K e i prezzi $2/$12 al token per eseguire un'analisi profonda senza inflare i costi infrastrutturali dei microservizi.
I logprobs e le probabilità logarithmic dei LLM autoregressive sono notoriamente mal calibrati e si spostan quando cambiano i prompt di sistema. Integrando RLCD direttamente nel processo di addestramento core, Jev rende il routing per confidenza pronto alla produzione, permettendo ai team di software di automatizzare in modo sicuro pipeline legahead alto volume mentre si isolano i casi ai bordi.
Pattern di Progettazione in Produzione: Pipeline Altamente Veloci in Pratica
Agent AI in produzione spesso crashano quando un LLM inventa una firma di funzione inesistente come get_user_billing_v2() o passa parametri tipo di data nonstring to a un API interno. Ritardare più controlli condizionali attraverso endpoint di chat completion standard aumenta la latenza totale del sistema, causando timeout nel sistema dei client-facing.
Pattern Architetturali Intensità Fondamentali per Microservizi Scalabili
Integrazione di motore i decisionali sub-secondo in pipeline AI di produzione consente ai team suoi di sostituire i loop di prompt non deterministici con pattern di design backend deterministici:
- Selezione di strumenti Agentici: Nella scelta di strumenti nei flussi di lavoro automatici, Jev valuta le firme delle funzioni disponibili contro lo stato corrente dell'applicazione. Poiché le funzioni candidate vengono passate come scelte esplicite nella richiesta, Jev non può restituire funzioni non annunciate, eliminando gli errori di runtime silenziosi nella selezione tool negli agenti. Questo prearchiviazione garantisce payload Schema validi prima di passare a pipeline automatiche per una migliore integrazione con LLM per coding.
- Valutazione di multi-question parallelo: Gli endpoint chat standard costringono i applicazioni a valutare i requisiti condizionali sequenzialmente, moltiplicando la latenza totale per il numero di controlli. Jev gestisce la valutazione parallela di più domande valutando tra dei candidati decine di domande di schema su un unico state payload in un passaggio parallelo. Eseguire quindici checks di classificazione singola esseno, es proprietate per 1 20, 709.
- Automazione Triage Ticket: Per i microservizi con volume elevato, Jev analizza contemporaneamente il sentiment del cliente, la priorità tecnica e l'ammissibilità al rimborso. L'automazione di triage ticket con tempo di risposta sub-1 secondo evita sarcasmi di coda durante picchi di traffico.
Implementare Nodi Decision Sistemi Type via SDK
I sviluppatori istanziano i nodi decisionali a bassa latenza integrando l'ochi sdk typesafe-sdk in microservizi esistenti. Il payload di esecuzione invia lo stato applicativo insieme alle primitive schema predeclarate direttamente all'endpoint https://api.typesafe.ai/v1/systemone.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
Le configurazioni standard di tool selection rietichettizzano tutto il contesto prompt per l'atto. Sìposizionando la rappresentazione dello stato dalle domande direzionali, Jev esegue pipeline di classificazione multi-branch nei sistemi backend senza moltiplicare l'overhead dei token di contest, aumentare i cost runtime o sacrare i guarantee predefinite della latenza P95.
Limiti Noti di TypeSafe Jev e Trade-Off Model (Cosa Jev Non Può Fare)
Implementare un modello di decisione non autoregressivo con l'aspettativa che scriva una risposta via email testa o sommi le line item di una fattura è; inevitabilmente breaking in produzione. Team di ingegneri che cercano di sostituire completamente gli LLM generici con modelli System One, devono capire i limiti strutturali.
Analisi Architetturale dei Vincoli Dissemina
Prima di integrare Jev nei microservizi, è rendersi conto dei specifici failure mode di Jev: La progettazione a singolo passaggio impone limiti strutturali netti su diverse attività chiavi:
- Generazione di una apertura del testo: Jev non traduce alcun testo conversazionale. La sua struttura non è in grado di scrivere saggi, riassumere contenuti o generare spiegazioni in linguaggio naturale per le sue selezioni;
- Limiti di ragionamento densi: L'architettura non valuta la rappresentazione dello stato, non concatna più fasi di logica o ragionamento. Per quelle, occorre demandare a una LLM autoregressiva classica.
- Limiti lineari nel LMI: Jev non sa svolgere calcoli o contare elementi in modo affidabile in stringa di contesto estesa: i calcoli numerari e le operazioni su array restano sempre nella parte di backend: La simulazione dei prompt avviene in modo letterale senza inferire routine di logica implicite.
- Letteralismo Interpretativo: Jev interpreta le regole del prompt in modo letterale, senza dedurre logica di business implicita. Nel caso di opzioni di schema ambigui, produce distribuzioni inattese sprobeabilità e probabilità inattese.
- Rotrazione del contest indesiderata: Passare log troppo grandi e non strutturato produce 'rot contestuale', degradando l'accuratezza della valutazione. Filtrare il rumore dall'input prima di mandar request alla parte essenziale.
Mappatura delle capacità: System One, System Two
| TypeSafe Jev System One | Autoregressive System Two | |
|---|---|---|
| Classificazione Categoria | Nativo (SUB-500ms) | Lento (Test procedo) |
| Sintesi e Scrittura del testo | Impossibile (no loop di decodifica) | Nativo (Genera testo libero) |
| Calcolo matematico | Non supportato (Restazioni anne) | Variabile (Richiede esecuzione) |
| Capacità di rumore nel contest | Prone a contest rot in stati grandi | Finestra di righe più grande |
Trattare Jev come un nodo decisionale sub-secondo e non un perfetto "engine" di ragion lo stesso universale: la progettazione laser dei microservizi in produzione richiede di , dist�.
Futuro Infrastrutture Cloud: Orchestrazione di Nodi Decisionali Con Alta Velocità
Rinviare ogni richiesta utente sredmita a un modelo di ragionamento a 70 miliardi di parametri brucerebbe migliaia di dollari in cicli GPU inutili e costringe l'utente a tempo di attesa di diversi secondi per i controlli di sicurezza e routing. Gli stack software moderni non possono tratterechitto ogni payload HTTP in ingresso come un problema di reasoning aperto.
Passaggio a Architetture Hybrid AI
L'ambiente cloud si sta spostando vers constituti monolithic endpoint verso un'architettura ibrida distribuita. In questa prospettima, l'orchestratore cloud posiziona ai nodi decisionali fast at i nodi di rete semplici all'edge, per valutare i payload in ingresso istantaneamente.
Gestendo il routing per l'edge AI, il &Validation dello Schema e il rating di confidenza in finestre di esecuzione 50, il traffico viene filtratato prima di raggiungere cluster di modelli più pesi. Questa topologia ottimizza l'allocazione di risorse in tre livelli operativi cloud:
- Guardia edge e routing: I nodi di decisione rapidi valutano, l'intento dell'utente in un singolo passaggio, sanitizzano gli input e controllano la formalità.
- Trasferimento di Stato e Orchestrazione: L'orchestratore analizza i punteggi di confidenza: esecuzione immediate delle richieste ordine alta certezza, inoltro dei casi complessi al ragionamento.
- Ragionamento di System 2 Centralizzato: I cluster di LLM pesanti ricevono payload pre-filtered e strutturati solo quandoè strettamente necessario una ripne multi-statta o una generazione a test libero.
Implementare i Modelli a Larga Scala
Mentre le piattaforme cloud ampliano le capacità di hosting, l'integrazione di una soluzione TypeSafe Jev a lato infrastruttura ai bordi e processi di decisione essenziali. L'uso di modelli decisionali non-autoregestivi collegati ai medesimi nodi di accesso riduce il tempo di round- trip e taglio i costi di computazione per le applicazioni ad alta frequenza.
Costruire pipeline con livelli decisionali dedicati assicura che i backend rete rimangano fluctuations sotto carico pesante, evitando 'prosa' inutilizzata nei modelli di ragionamento di frontiera.


