Ultimo aggiornamento: Wan 3.0 è ora disponibile dal 24 agosto 2026.
Hai creato una cartella per uno spot da 15 secondi. Due immagini di personaggi. Un video di tono di marca inviato dal cliente. Un brand book che esiste solo come PDF. Un campione vocale dell'attore che vuoi davvero.
Poi hai aperto il tuo modello video e ti ha chiesto un'immagine.
Così hai fatto quello che fanno tutti. Hai tradotto la cartella in un prompt di 800 parole e hai pregato. Il volto è cambiato nell'inquadratura tre. La giacca ha cambiato colore. La voce era di qualcun altro.
Wan 3.0 con omni-reference è la prima volta che un modello video dice: va bene, dammi la cartella. Fino a 20 asset in una singola chiamata, su cinque tipi di input, tenuti insieme in un'unica ripresa continua di 30 secondi.
Questo articolo fa tre cose e salta il resto. Spiega cosa sono effettivamente quei 20 asset, usa i clip generati da Alibaba come prova e ti fornisce un flusso di lavoro equivalente che puoi eseguire oggi, perché Wan 3.0 è ancora in beta pubblica sul cloud di Alibaba e non è ancora richiamabile da piattaforme di terze parti.
Punti chiave
- Il riferimento multimodale di Wan 3.0 accetta fino a 20 asset in una chiamata, tra immagini, video, audio, documenti e pagine web live, e li mantiene coerenti in un'unica ripresa di 30 secondi.
- È il primo modello video mainstream a trattare un PDF, una presentazione o un URL come input creativo anziché qualcosa da parafrasare in un prompt.
- Wan 3.0 è entrato in beta pubblica il 6 agosto 2026 su Alibaba Cloud Model Studio e Qwen Cloud come
wan3.0-video. I pesi sono chiusi. Chiunque dica che è già Apache 2.0 sta indovinando. - Il titolo dei 20 asset non è dove si distingue davvero. I modelli reference-to-video che puoi chiamare ora accettano già più di 20 asset. Il divario sono i documenti e le pagine web, non il numero.
- Puoi testare il formato a due personaggi, ancorato ai riferimenti e completamente doppiato gratuitamente con il generatore gratuito di sketch pubblicitari AI di Atlas Cloud: carica quattro foto di prodotto, ottieni uno sketch parlato di 15 secondi, senza carta di credito.
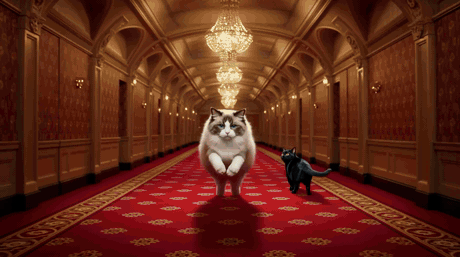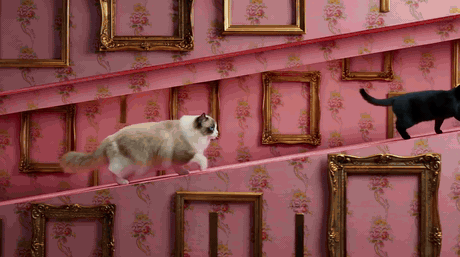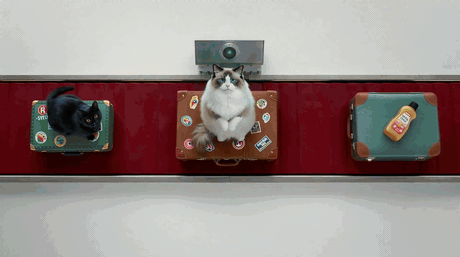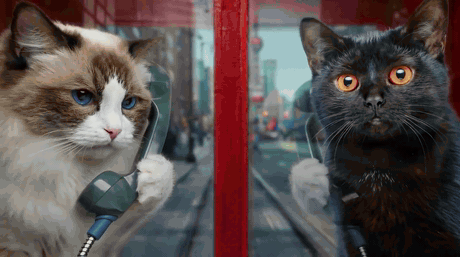
Due gatti inseguiti attraverso cinque scenari diversi da Wan 3.0 senza deriva del personaggio_Due immagini di riferimento. Cinque scenari completamente diversi, da un corridoio d'albergo a un cestello di lavatrice a una cabina telefonica rossa. Non un fotogramma di deriva. Fonte: manuale ufficiale per creatori di Wan 3.0 di Alibaba_ Wan 3.0 creator handbook , agosto 2026, da cui provengono anche tutti gli altri clip di Wan 3.0 in questo articolo.
Perché il video multi-riferimento crolla e cosa cambia Wan 3.0 Multimodal Reference
I modelli video non hanno memoria tra un clip e l'altro. Ogni generazione parte da zero. Questo è il problema in una frase.
Quindi, nel momento in cui la tua storia ha bisogno di più di un'inquadratura, stai cucendo. L'inquadratura uno ti dà un volto che ami. L'inquadratura due ti dà un cugino di quel volto. L'inquadratura tre cambia silenziosamente la giacca da prugna a bordeaux, e quando te ne accorgi hai già pagato undici rendering.
Il riferimento a immagine singola ha aiutato, ma ha sempre bloccato solo una cosa. Un volto. Non poteva tenere contemporaneamente un volto, un outfit, un oggetto di scena, una location e una voce, perché c'era uno slot e cinque lavori.
Ci sono due modi per uscirne. Dare al modello più slot, o smettere di farlo ricominciare da capo. Wan 3.0 fa entrambe le cose contemporaneamente, ed è per questo che le due caratteristiche principali sono in realtà una sola. Una ripresa nativa di 30 secondi significa che non c'è taglio per far deriva il personaggio. Venti asset di riferimento significa che ogni elemento che deve rimanere fisso ha il suo slot dedicato invece di lottare per uno.
Ecco come appare quando non si cuce nulla. Trenta secondi, una telecamera continua, un bambino in un carrello della spesa che finisce incorporato in un cartellone pubblicitario e poi ne esce da sotto.
30 secondi interi in unica passata, senza tagli, con la colonna sonora generata nella stessa passata. Fonte: manuale ufficiale per creatori di Wan 3.0 di Alibaba.
Cosa significano realmente "20 asset" all'interno di Wan 3.0 Multimodal Reference
Venti è un numero da titolo. Ciò che conta è che i venti non sono tutti dello stesso tipo. L'omni-reference di Wan 3.0 copre cinque tipi di input, e ciascuno controlla un asse diverso dell'output.
Le immagini controllano l'identità. Una scheda personaggio, una foto di prodotto, una foto di location. Wan 3.0 chiama questa coerenza a livello di pixel, e negli esempi ufficiali di Alibaba il blocco si estende oltre il volto fino al guardaroba: la veste grigia a strati, il corpetto di cuoio con cinghie, la fascia scura in vita sopravvivono a un combattimento corpo a corpo di sedici secondi in tre location.
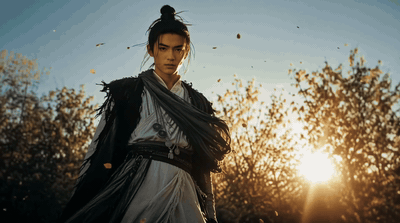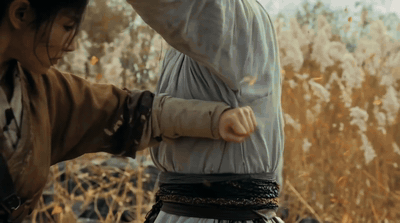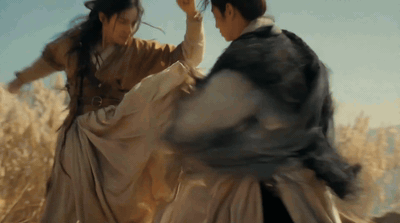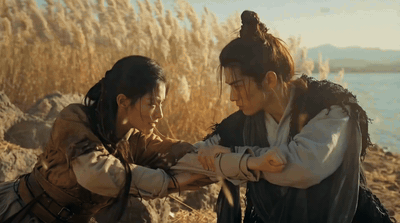
Due schede personaggio che guidano una scena di combattimento wuxia con dettagli del costume tenuti fotogramma per fotogramma
Due schede personaggio più una foto di location della riva dei canneti. Il guardaroba e l'ambientazione reggono attraverso ogni lancio. Mostrato qui come GIF silenziosa; il file consegnato include un mix stereo a 44,1kHz. Fonte: manuale ufficiale per creatori di Wan 3.0 di Alibaba.
L'audio controlla la voce. Questa è la parte che rende "multimodale" più che marketing. Alleghi un campione vocale per personaggio, scrivi le battute nel prompt, e il dialogo torna con quel timbro, sincronizzato labiale, nella stessa passata dell'immagine. Due persone, due riferimenti vocali, una palestra.
Due immagini soggetto più due clip di riferimento vocale separate, e il dialogo torna con quelle due voci. Vale la pena accendere l'audio per questo. Fonte: manuale ufficiale per creatori di Wan 3.0 di Alibaba.
Il video controlla il tempismo. Un video di riferimento non serve per essere copiato. Serve per donare il suo ritmo: quanto dura una pausa, come si muove una transizione. In questo, cinque fotogrammi chiave forniscono i soggetti e un video di riferimento fornisce la cadenza di capovolgimento a carta orizzontale tra di loro.
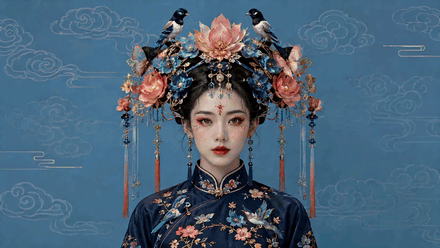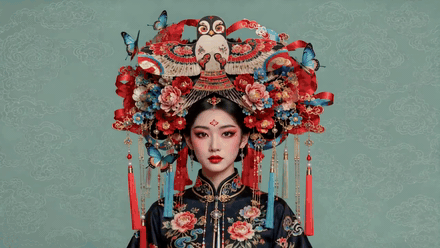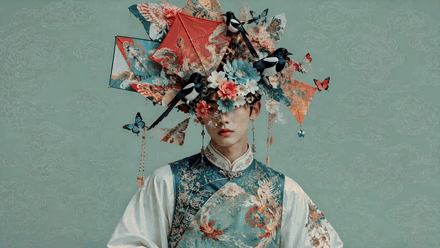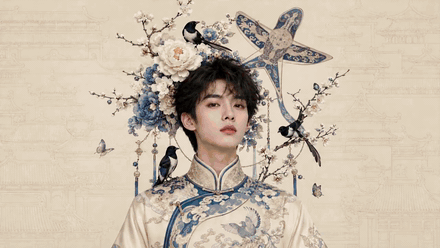
Cinque fotogrammi chiave capovolti con il ritmo preso da un video di riferimento_Cinque_ immagini chiave per i soggetti, un video di riferimento per il ritmo di capovolgimento. Fonte: manuale ufficiale per creatori di Wan 3.0 di Alibaba.
Documenti e pagine web controllano la struttura. Questa è la vera novità. Wan 3.0 accetta file di documenti e URL live come input creativo, e i report sulla beta elencano .doc, .xls, .ppt, .pdf e .txt tra i formati accettati (AlphaSignal, agosto 2026). La stessa logica funziona già con un'immagine storyboard: uno storyboard in, sei inquadrature fuori, nell'ordine dello storyboard stesso.
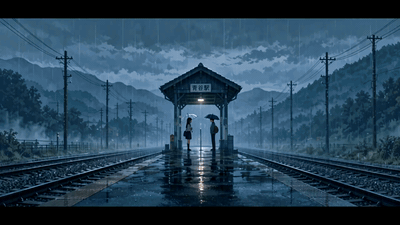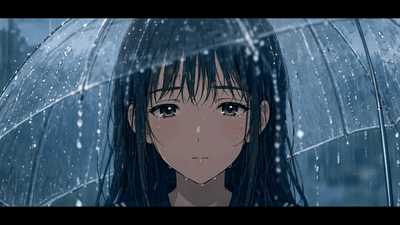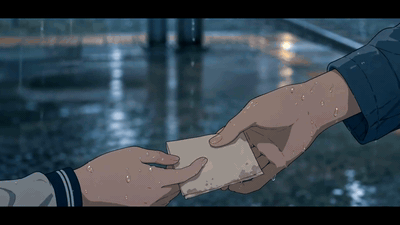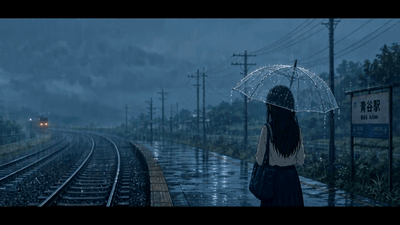
Un singolo foglio storyboard espanso in sei inquadrature sequenziali su una banchina ferroviaria piovosa
Un foglio storyboard come riferimento, sei inquadrature generate nel suo ordine, fino al passaggio di note nelle mani nell'inquadratura cinque. Fonte: manuale ufficiale per creatori di Wan 3.0 di Alibaba.
Primo e ultimo fotogramma controllano gli estremi. Il trucco più vecchio del libro, ancora supportato, ancora il modo più veloce per delimitare un'inquadratura.
Ecco come si confronta con la versione che la maggior parte delle persone usa oggi.
| Wan 2.7 Reference-to-Video | Wan 3.0 omni-reference | |
|---|---|---|
| Asset di riferimento | un'immagine per soggetto, fino a 3 video, 1 clip vocale | fino a 20 asset in totale |
| Modalità | immagine, video, audio | immagine, video, audio, documento, pagina web |
| Durata massima, una passata | 10 s | 30 s nativa, più durata intelligente |
| Audio nella stessa passata | sì | sì |
| Modifica ed estensione video | non esposta | modifica basata su istruzioni e riferimenti, più estensione |
| Disponibilità | live su API di terze parti | Alibaba Cloud Model Studio e Qwen Cloud beta |
C'è una regola che nessuno mette nei documenti e tutti imparano a proprie spese: un riferimento, un lavoro. Image1 blocca il volto e l'outfit. Video1 dona solo il movimento. Audio1 dona solo il timbro. Nel momento in cui assegni a un singolo asset due lavori in conflitto, o carichi un'immagine di riferimento con due persone, il modello deve indovinare, e indovinare è esattamente ciò che stavi cercando di fermare. Il manuale di Alibaba è chiaro anche su questo: un soggetto per immagine di riferimento.
Il flusso di lavoro Wan 3.0 Multimodal Reference che puoi eseguire oggi
Risposta diretta. Wan 3.0 è in beta pubblica sul cloud di Alibaba, con l'ID modello wan3.0-video (Alibaba Wan, agosto 2026). Non è ancora arrivato su piattaforme API di terze parti, Atlas Cloud inclusa. Chiunque ti venda l'accesso API a Wan 3.0 in questo momento sta rivendendo qualcos'altro.
Ciò che è arrivato è la forma del flusso di lavoro. Pacchetto di riferimenti, una chiamata, clip finito con audio. Questo funziona oggi sui modelli reference-to-video che puoi chiamare in una scheda del browser, e una volta che li allinei tutti, il titolo dei 20 asset appare diverso.
| Modello | Asset di riferimento | Modalità | Durata max | Audio nativo | Prezzo al secondo |
|---|---|---|---|---|---|
| Wan 3.0 (beta Alibaba, non su Atlas) | 20 totali | immagine, video, audio, documento, pagina web | 30 s | Sì | riportato $0,05 a $0,20 per risoluzione |
| Wan 2.7 Reference-to-Video | 1 immagine per soggetto, 3 video, 1 clip vocale | immagine, video, audio | 10 s | Sì | $0,10 |
| Seedance 2.5 Reference-to-Video | 50 (30 immagine / 10 video / 10 audio) | immagine, video, audio | 30 s | Sì | $0,13 |
| MiniMax H3 Reference-to-Video | misto, nessun limite dichiarato | immagine, video, audio | 15 s | Sì | $0,10 |
| Kling Video O3 Pro Reference-to-Video | 7 immagini, o 4 immagini + 1 video | immagine, video | 15 s | Sì | $0,10 |
| Vidu Q3-Mix Reference-to-Video | 4 immagini | immagine | 16 s | Sì | $0,11 |
| Veo 3.1 Reference-to-Video | 3 immagini | immagine | 8 s | Opzionale | $0,20 |
I prezzi sono le tariffe di Atlas Cloud ad agosto 2026. Le cifre di Wan 3.0 sono quelle riportate per la beta di Alibaba Cloud, non una tariffa Atlas, e Alibaba non ha ancora pubblicato una pagina dei prezzi pubblica per il modello, quindi tratta quella riga come provvisoria.
Leggi quella tabella due volte e la vera storia emerge. Il titolo dei 20 asset non è dove Wan 3.0 si distingue, perché Seedance 2.5 ne prende già 50 e raggiunge i 30 secondi. Ciò che nient'altro in quella lista accetta è un PDF.
Per il tutorial qui sotto, la demo funziona su Wan 2.7 Reference-to-Video, perché la sua forma di input è la parente vivente più vicina all'omni-reference: più immagini soggetto, un video di riferimento opzionale e un clip vocale, tutti mappati alle etichette character1 e character2 all'interno del prompt. Tre modelli, una scheda del browser, nessuna installazione locale.
Per un'esecuzione hostata corrente, apri Wan 3.0 su Atlas Cloud e testa un prompt come quello qui sotto prima di pubblicare il flusso di lavoro.
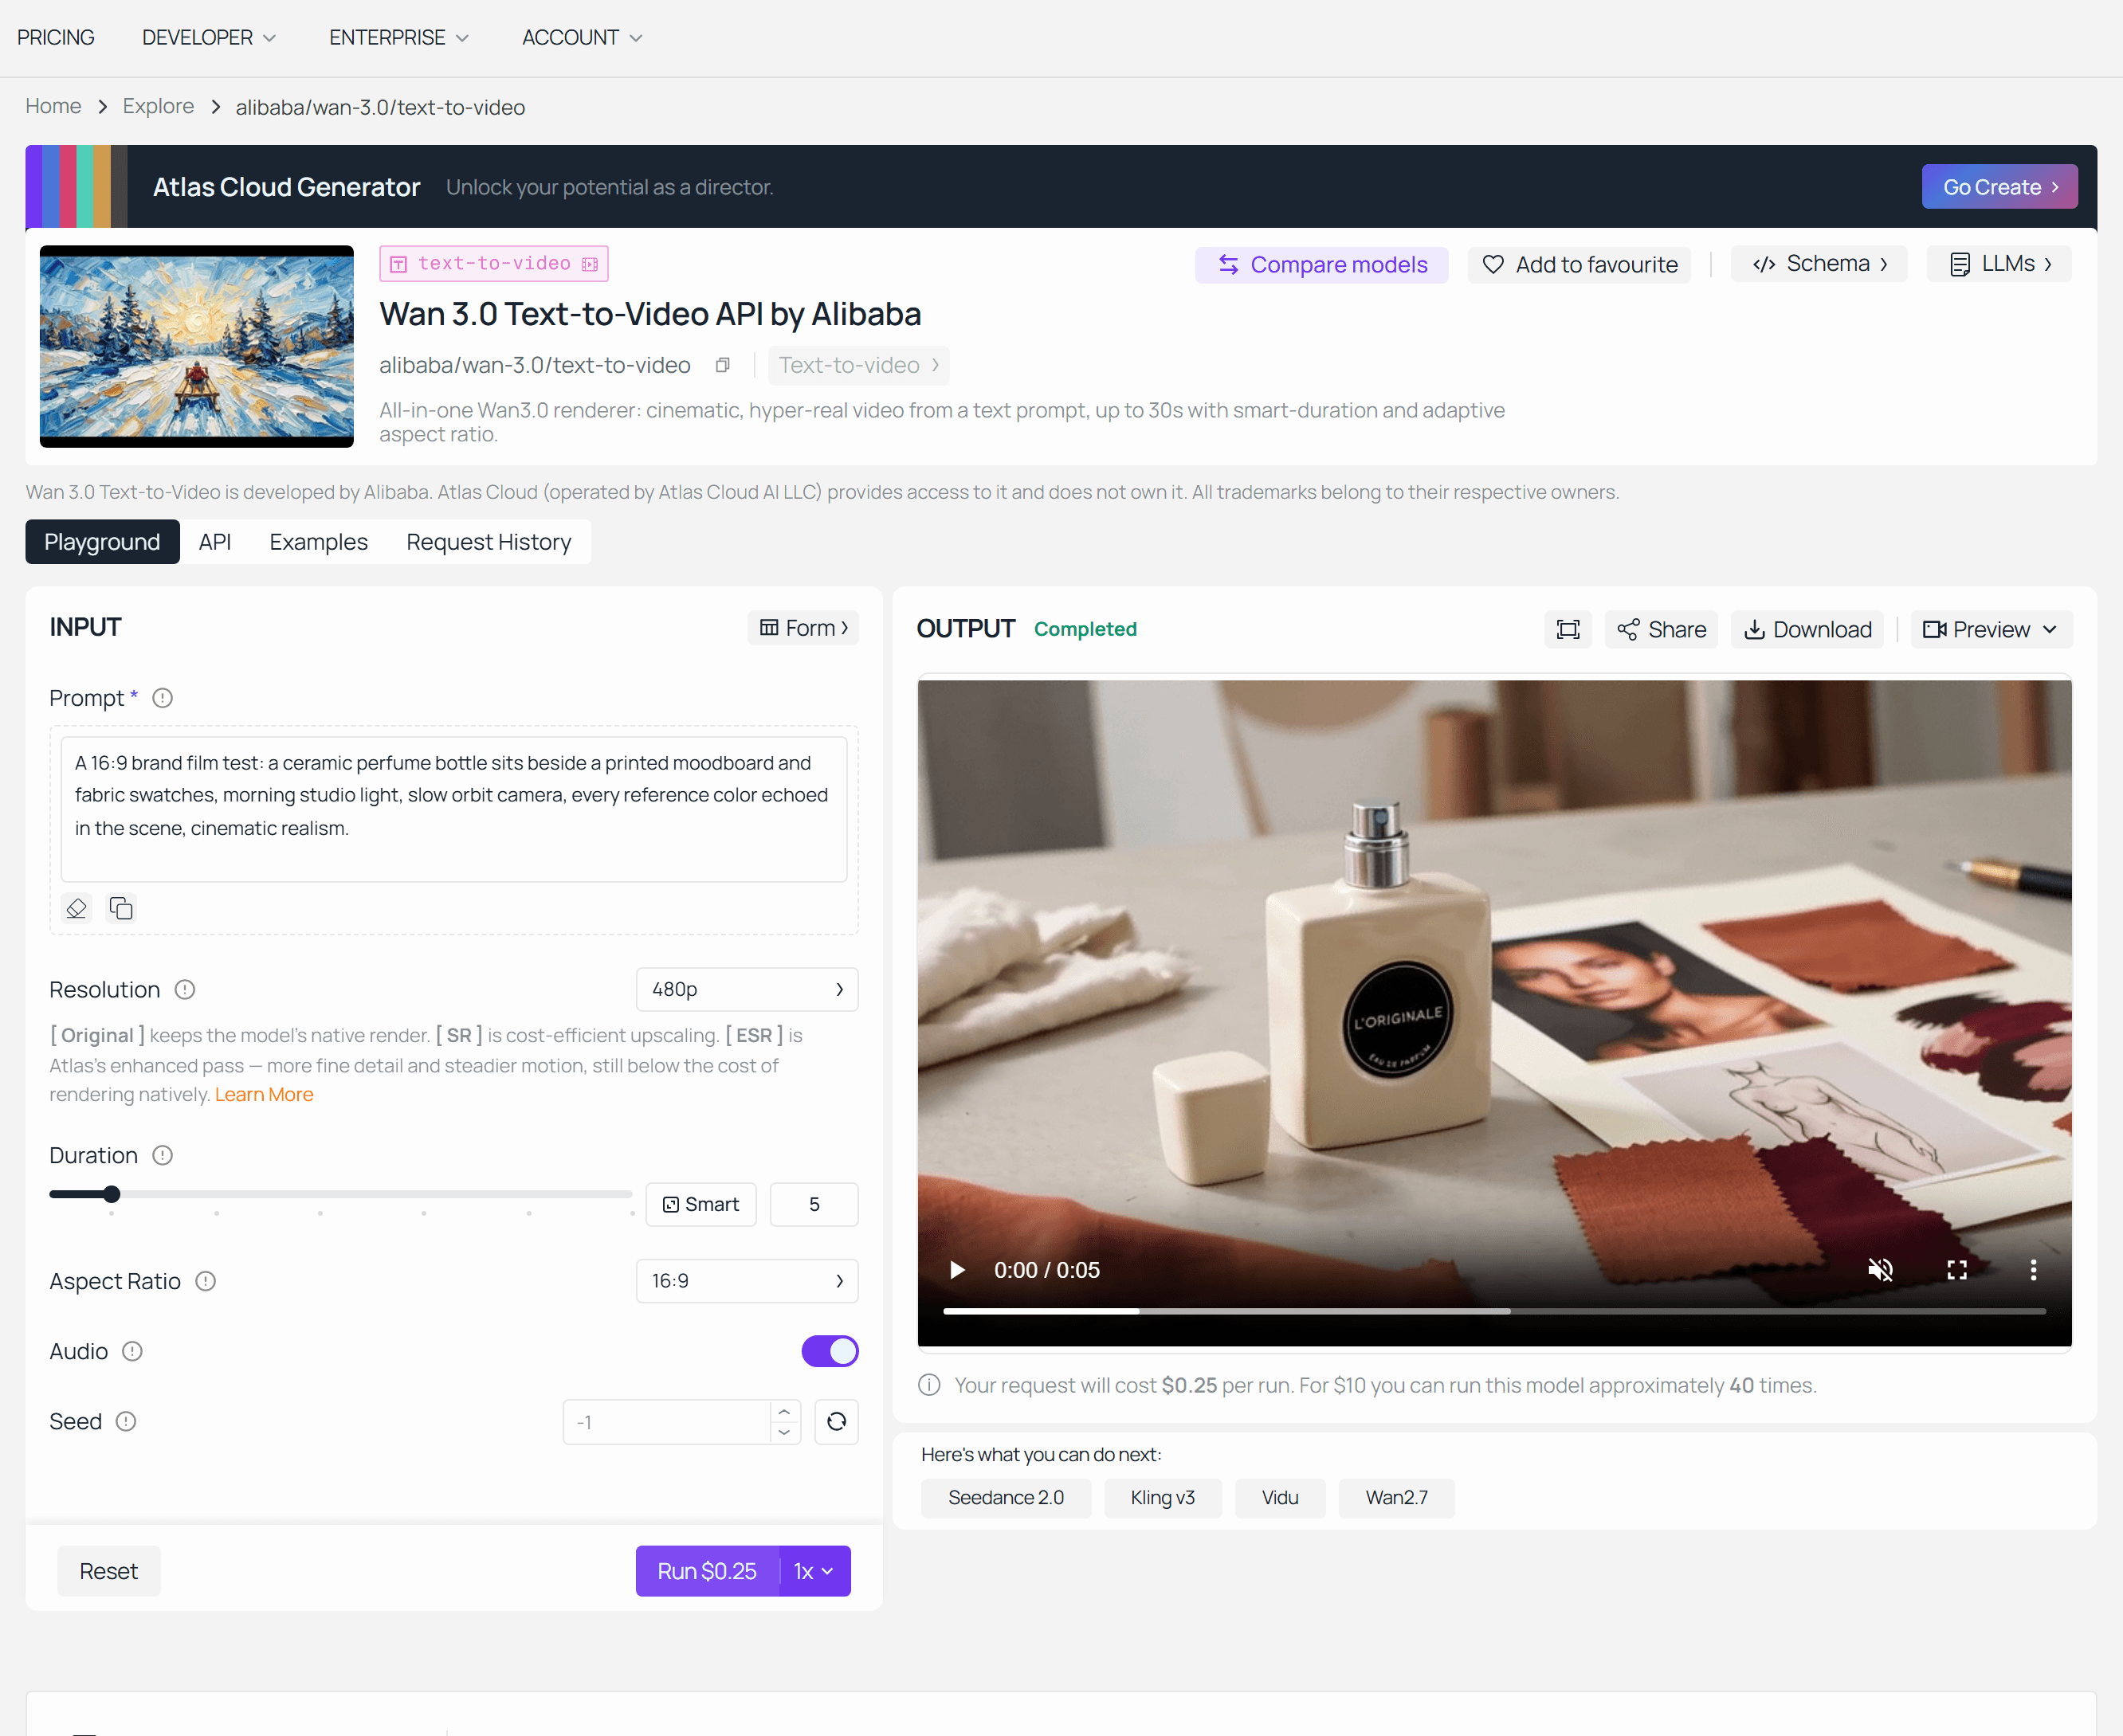
Wan 3.0 screenshot prompt-to-result: consegna marca con 20 riferimenti.
Costruiscilo da solo: una scena con riferimento multimodale in quattro passaggi
La scena: una reception di hotel pastello. Un concierge impassibile. Una viaggiatrice che tiene un gatto ragdoll. Il concierge guarda dritto nell'obiettivo e dice "Il gatto ha una prenotazione. Tu no."
Due immagini più un clip vocale, che sono tre asset di riferimento su due modalità. Questa è la costruzione più piccola che è onestamente multimodale, non solo multi-immagine.
Passaggio 1: Genera l'immagine di riferimento 1, il soggetto che devi bloccare
Le immagini di riferimento hanno tre lavori e solo tre: un soggetto, rivolto verso la telecamera, sfondo pulito. Tutto il resto è decorazione. Usa GPT Image 2 con qualità high, dimensione 16:9, n=1.
Plain1Full-body studio portrait of a middle-aged hotel concierge with a deadpan expression, standing dead-centre against a flat dusty-pink wall. He wears a plum-purple double-breasted bellhop uniform with gold piping and brass buttons, a small round pillbox hat, and a thin moustache. Perfectly symmetrical framing, even soft frontal light, no cast shadow on the wall, 35mm film grain, muted pastel palette. One subject only, no other people, no text, no logo, no props in frame. 2
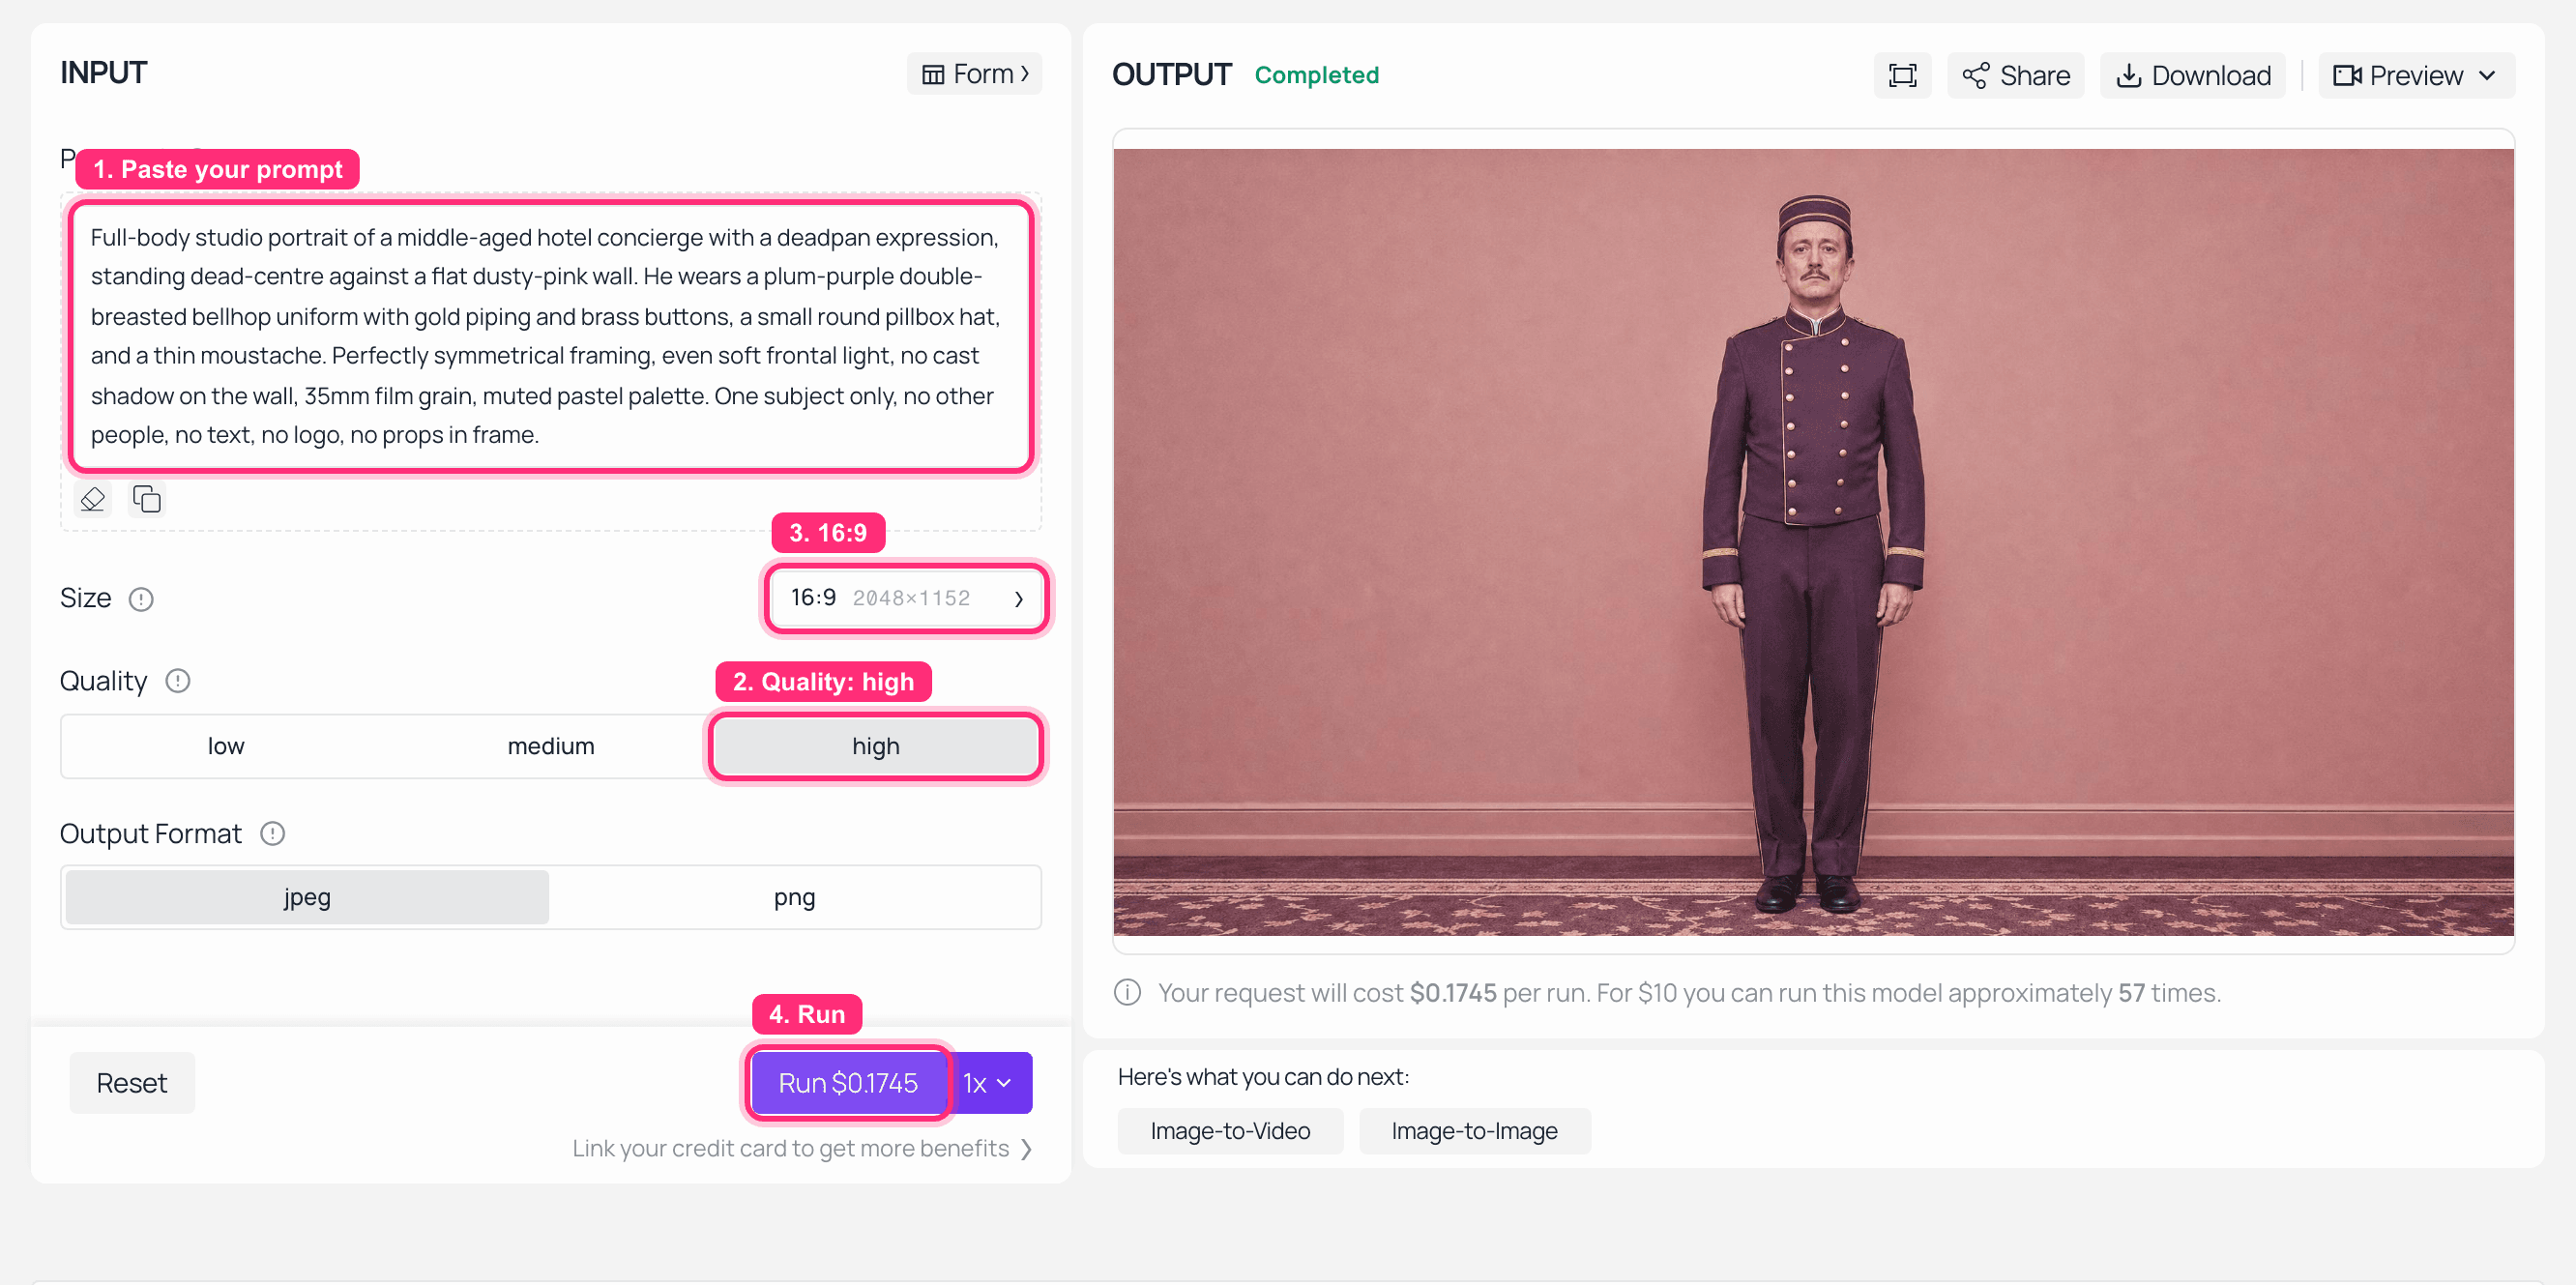
Playground GPT Image 2 su Atlas Cloud con il ritratto di riferimento del concierge renderizzato nel pannello di output
GPT Image 2 su Atlas Cloud: qualità alta, 16:9, un soggetto, sfondo piatto. Questo è il file che diventa character1.
Passaggio 2: Genera l'immagine di riferimento 2, il secondo soggetto bloccato
Stesso modello, stesse impostazioni. Il contrasto cromatico tra i due personaggi è voluto, poiché dà al modello un modo semplice per tenerli separati quando condividono un'inquadratura.
Plain1Full-body studio portrait of a young woman traveller holding a fluffy ragdoll cat against her chest, standing dead-centre against a flat mustard-yellow wall. She wears a mustard wool coat, a red beret and round tortoiseshell glasses, and holds a small vintage leather suitcase in her free hand. Perfectly symmetrical framing, even soft frontal light, no cast shadow on the wall, 35mm film grain, muted pastel palette. One subject only, no other people, no text, no logo. 2
Passaggio 3: Genera il riferimento vocale, che è la parte effettivamente multimodale
Il clip vocale è ciò che trasforma questo da un lavoro multi-immagine in uno multimodale. Lo slot audio di Wan 2.7 vuole un campione breve, circa da 1 a 10 secondi, quindi tieni la battuta corta. Usa MiniMax Speech 2.6 HD e scegli una voce maschile bassa, piatta e imperturbabile.
Plain1Good evening. Checking in? Of course. Everyone is. 2
Passaggio 4: Una chiamata, tre riferimenti, un clip finito
Ora l'intero pacchetto va insieme su Wan 2.7 Reference-to-Video. Impostazioni: resolution: 1080P, ratio: 16:9, duration: 10, che è il limite di questo modello, prompt_extend: false, seed: -1. Carica images in ordine, prima il passaggio 1, in modo che si mappi su character1, poi il passaggio 2 come character2, e allega il file del passaggio 3 a audio.
Plain1Symmetrical, dead-centre wide shot of a pastel hotel lobby front desk, dusty-pink walls and a mustard-yellow key rack behind it. character1 is the concierge standing behind the desk; character2 is the traveller standing in front of it, still holding her ragdoll cat. The camera pushes in slowly along a perfect centre axis and never tilts. character1 looks straight down the lens and says flatly: "The cat has a reservation. You do not." character2 blinks once, turns her head slowly towards the cat, then back to the desk. The cat stares directly into the camera without moving. 35mm film grain, even soft lighting, muted pastel palette, no camera shake, no cuts. 2
Negative prompt:
Plain1handheld shake, jump cuts, subtitles, on-screen text, watermark, extra people, deformed hands, face morphing, colour shift, motion blur 2
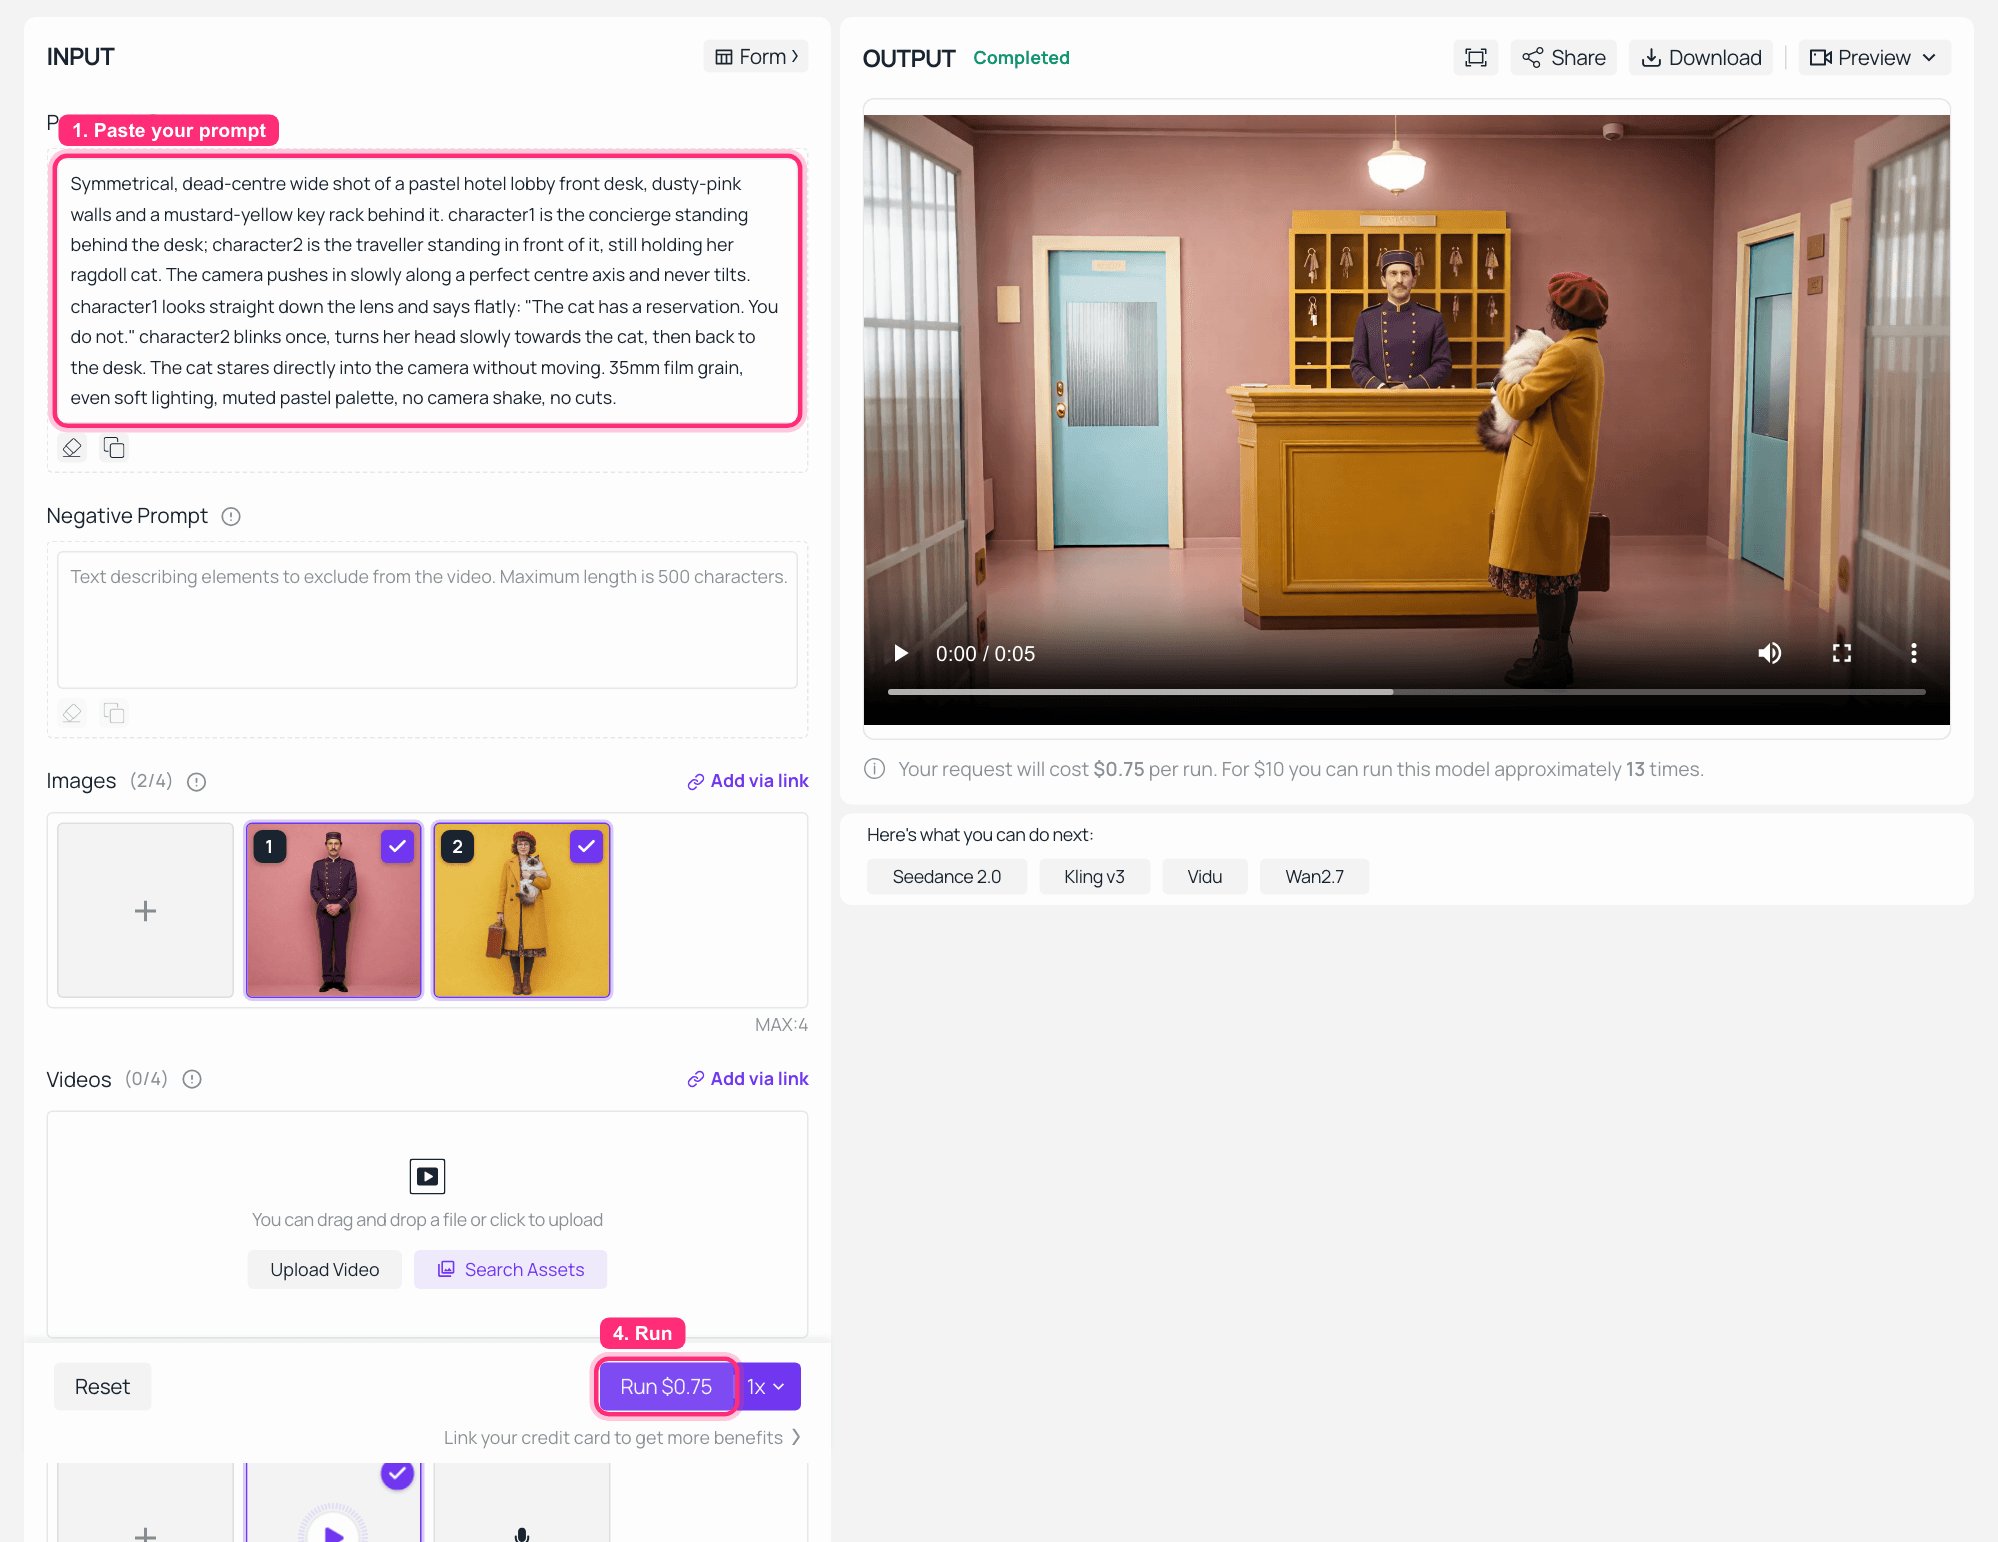
Playground Wan 2.7 Reference-to-Video su Atlas Cloud con due immagini di riferimento e un file audio caricati e il clip finito nel pannello di output
Wan 2.7 Reference-to-Video su Atlas Cloud: due immagini di riferimento e un clip vocale allegati a sinistra, la ripresa finita a destra a 1080P e 16:9. Questa acquisizione è stata eseguita alla durata predefinita del modello; impostala a 10 per la versione completa qui sotto.
Il clip finito. Entrambi i volti tenuti, entrambi gli outfit tenuti, e la battuta consegnata con la voce clonata dal passaggio 3, quindi vale la pena riprodurlo con l'audio.
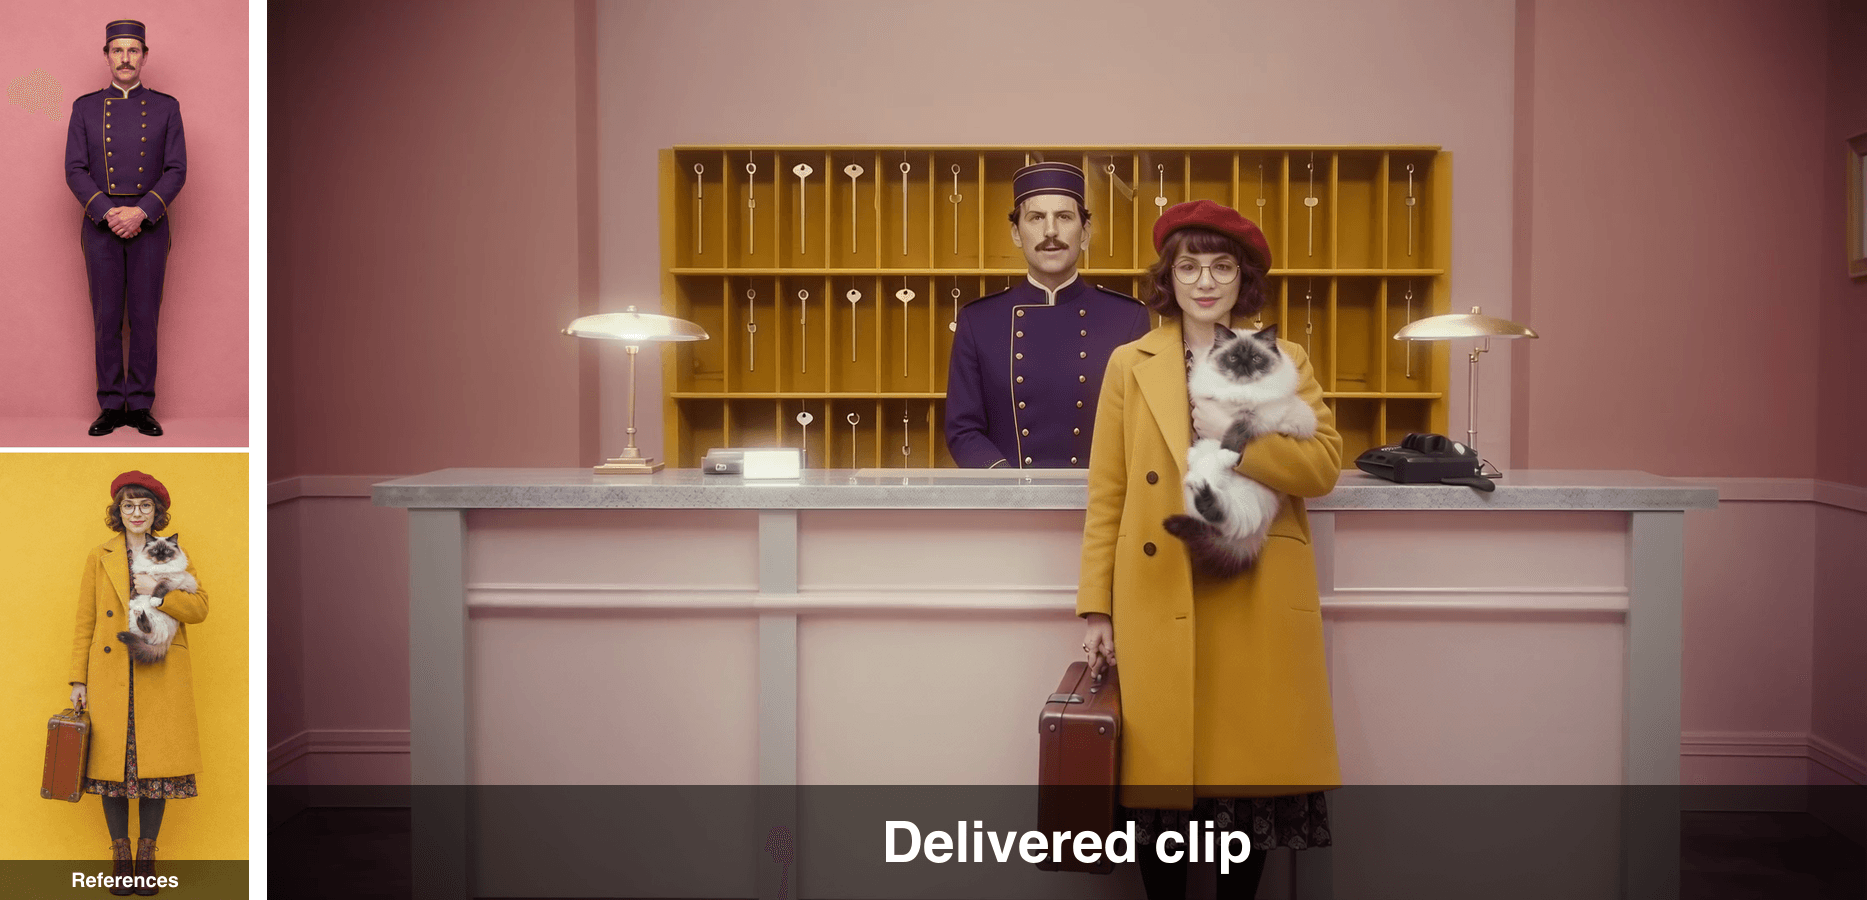
I due ritratti di riferimento accanto a un fotogramma del clip finito, che mostrano gli stessi volti e outfit
Riferimenti a sinistra, un fotogramma del clip consegnato a destra. Le bordature dell'uniforme, il berretto, gli occhiali e il gatto sopravvivono tutti al viaggio.
Variazioni sul flusso di lavoro Wan 3.0 Multimodal Reference
Portalo a 30 secondi. Lo stesso pacchetto di riferimenti funziona su Seedance 2.5 Reference-to-Video con duration: 30, che ti dà la lunghezza che promette Wan 3.0 senza aspettare la beta. Prende fino a 30 immagini di riferimento, 10 video e 10 clip audio, quindi il pacchetto ha spazio per crescere. Scrivi i 20 secondi extra come battute nel prompt, non come atmosfere, o il modello riempirà.
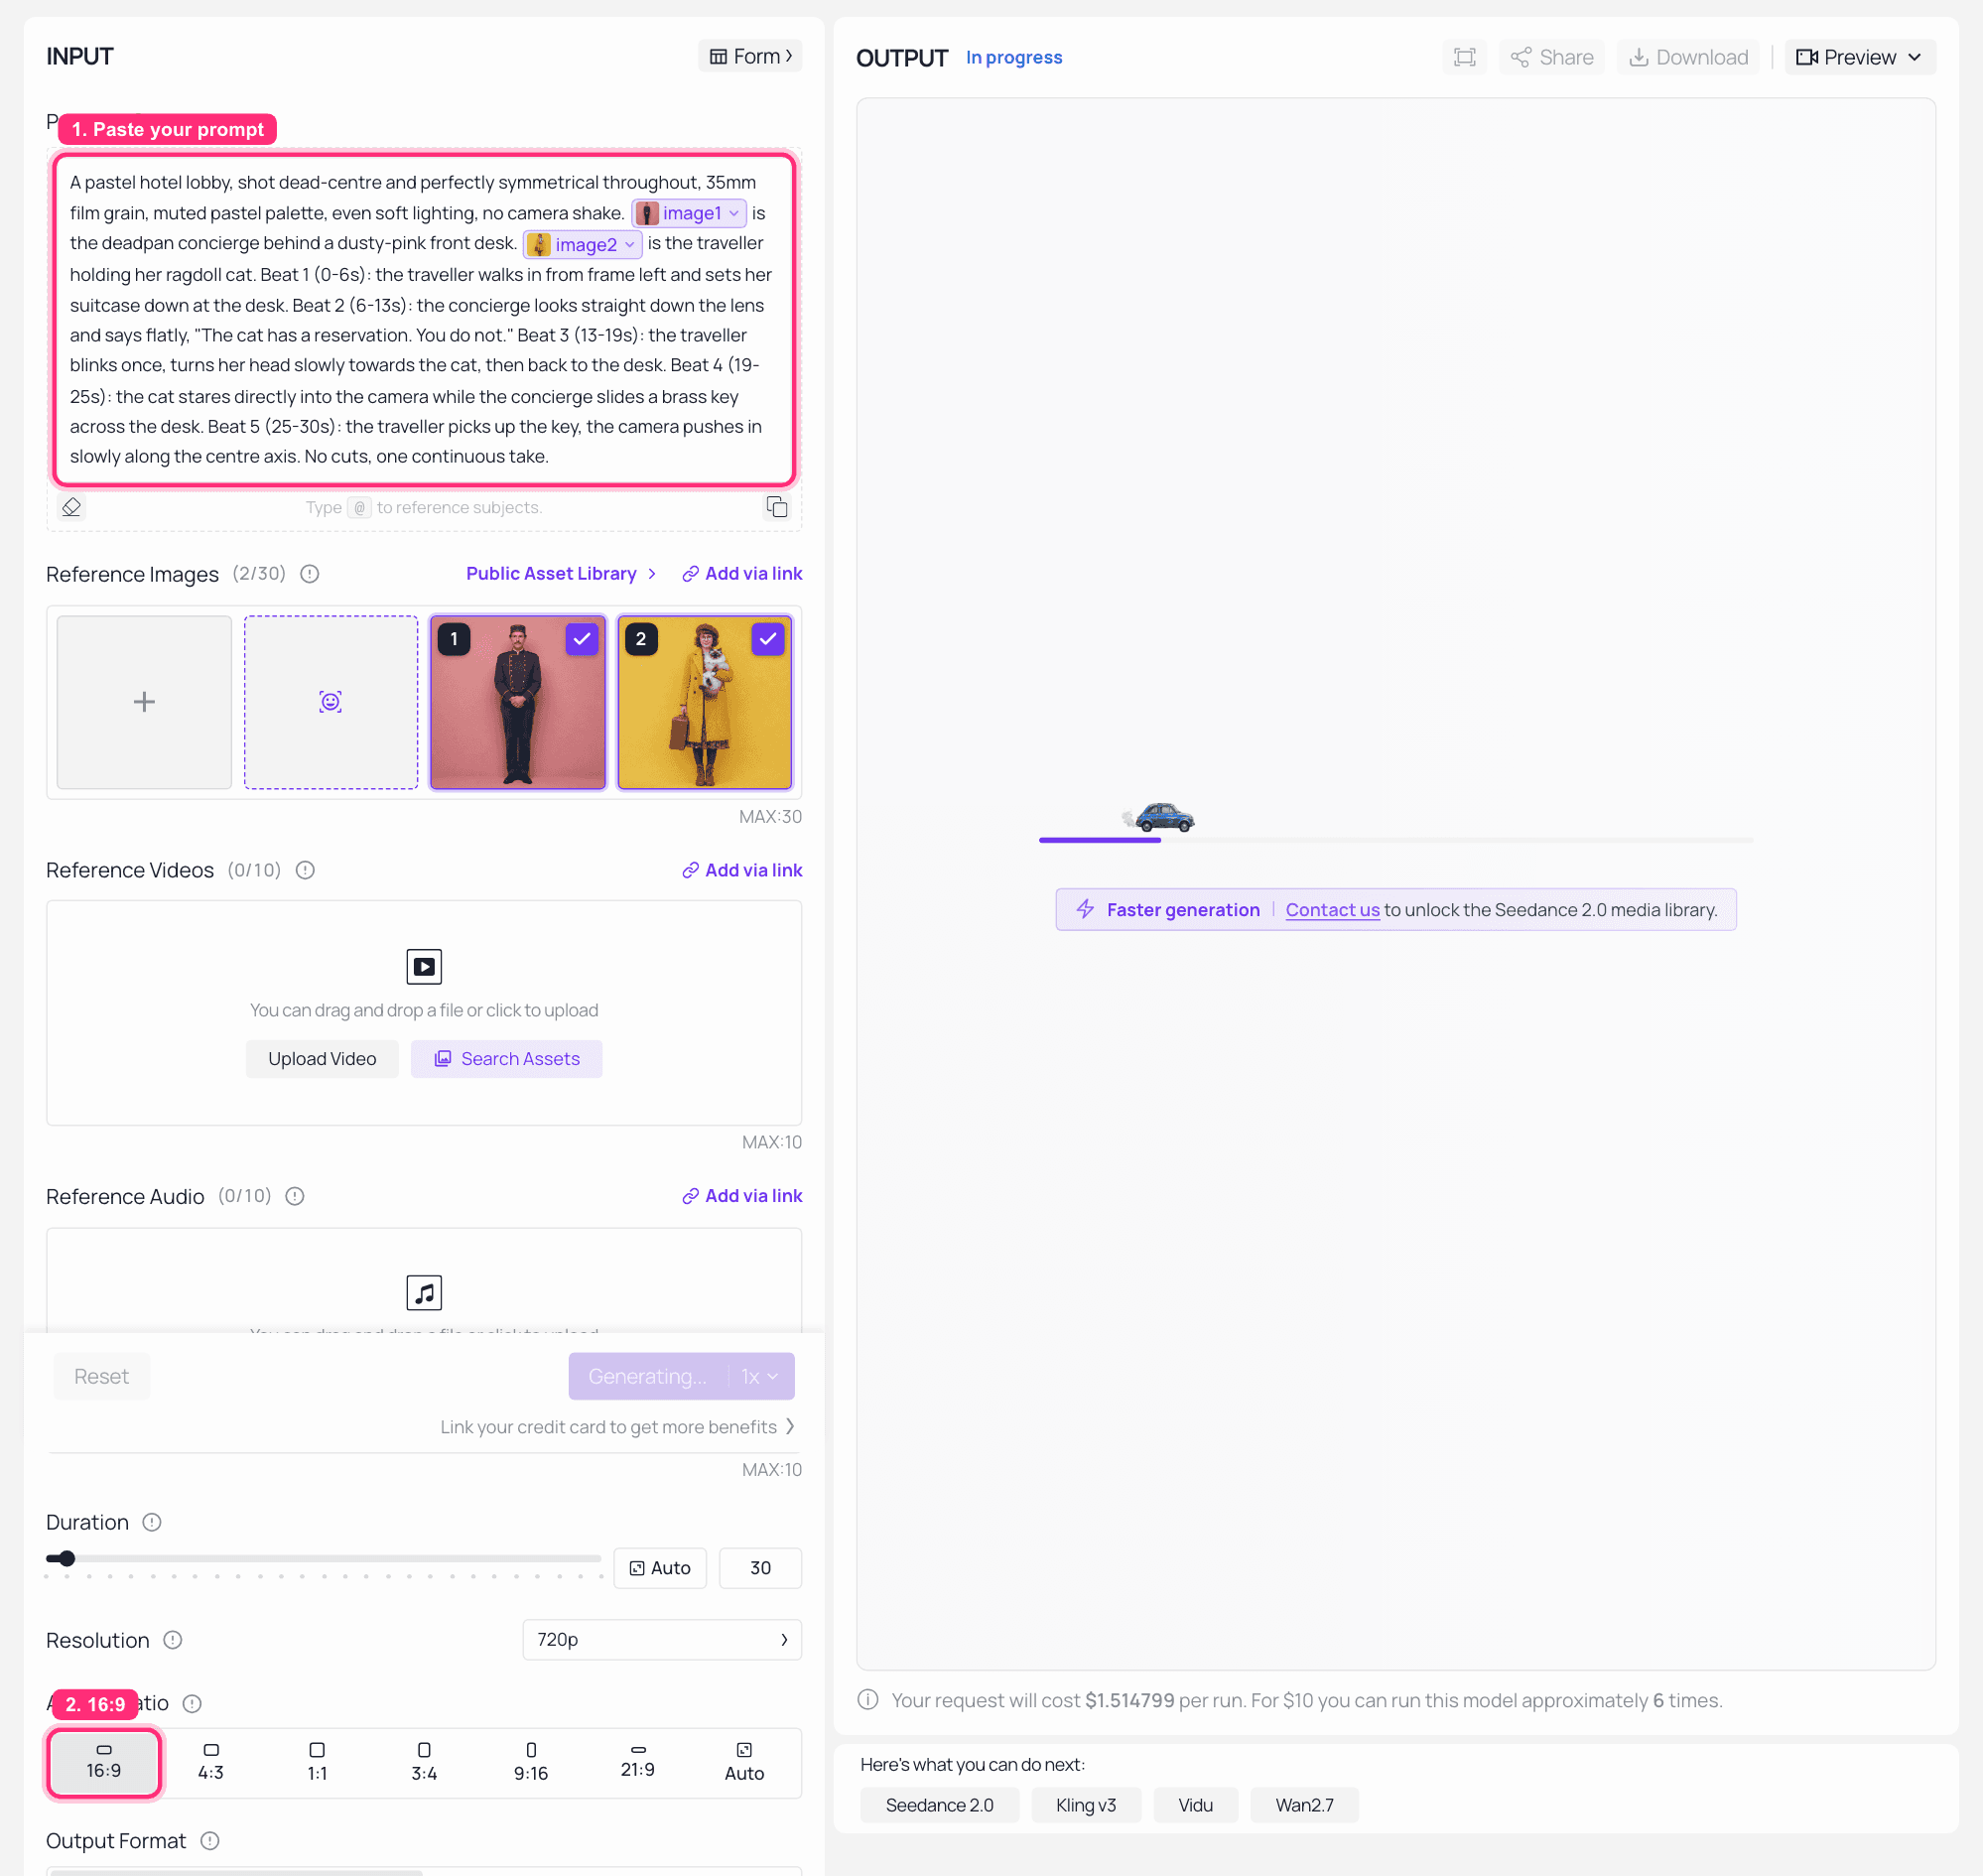
Playground Seedance 2.5 Reference-to-Video su Atlas Cloud con durata impostata a 30 e la lunga ripresa renderizzata
Seedance 2.5 Reference-to-Video su Atlas Cloud con durata impostata a 30 e gli stessi due ritratti di riferimento allegati, colto a metà generazione. Nota i chip @image1 e @image2 nel prompt: è così che dici a Seedance quale riferimento interpreta quale parte. Controlla il prezzo quotato sul pulsante Esegui prima di impegnarti, poiché riflette la durata che il lavoro effettivamente invierà.
La versione da 30 secondi della stessa scena, stesso pacchetto di riferimenti, battute scritte inquadratura per inquadratura.
Aggiungi un video di riferimento solo per il movimento. Allega un clip di cui ti piace il ritmo e dillo esplicitamente nel prompt, qualcosa come "segui il video di riferimento solo per il ritmo di taglio, ignora i suoi soggetti e ambientazione". Questo è il trucco dietro l'esempio di capovolgimento a carta più sopra.
Correggi la deriva con il prompt negativo prima di toccare quello positivo. La morfing del volto, lo spostamento del colore e la scossa a mano sono i tre che rovinano le inquadrature bloccate con riferimento, e di solito sono più economici da sopprimere che da descrivere.
Prova il formato riferimento multimodale gratuitamente
Se vuoi la forma di questo prima di volere i parametri, Atlas Cloud ha lanciato un generatore gratuito di sketch pubblicitari AI la scorsa settimana che esegue la stessa catena senza nessuna manopola.
Scrivi una riga sul tuo prodotto e i suoi punti di forza. Scrive uno script comico a due personaggi per te, gancio, conflitto, colpo di scena, poi renderizza un video di 15 secondi con dialogo parlato ed effetti sonori integrati. Puoi allegare fino a quattro foto reali del prodotto come riferimenti, e lo spot mantiene la loro forma, colore, etichetta e logo dalla sceneggiatura al fotogramma finale. Sei stili sono inclusi, dal meme divertente al colpo di scena e sitcom fino al lusso e alla vendita aggressiva, e il dialogo torna nella lingua in cui hai scritto la descrizione.
Questa è la stessa catena a due personaggi più immagini di riferimento più voce del tutorial, meno la scrittura del prompt e meno il conto. Il che lo rende un modo decente per scoprire se questo formato si adatta al tuo prodotto prima di spendere qualcosa per metterlo a punto.
Per un'idea di cosa fa una pila di immagini di riferimento a un pezzo di prodotto, ecco la versione di Wan 3.0 del lavoro: cinque immagini dentro, un reel di lancio fuori, ogni immagine che ancora un battito dell'editing.
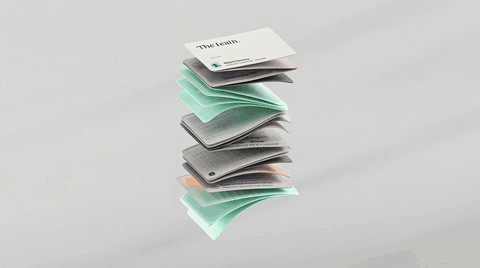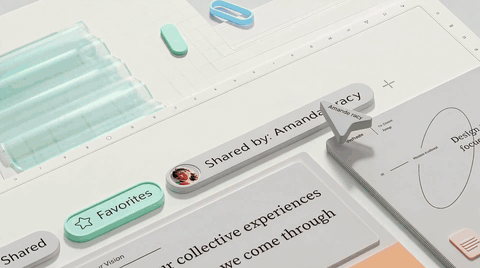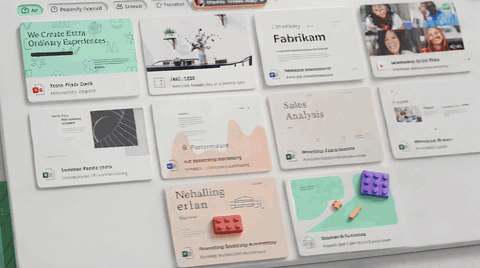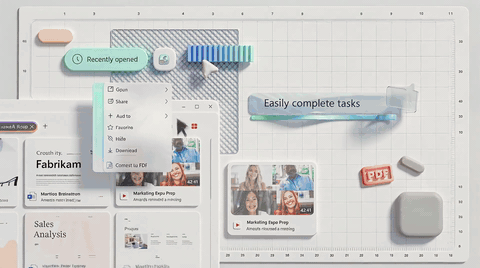
Cinque fermi immagine di riferimento espansi in un reel di lancio prodotto in stile Material Design_Cinque immagini di riferimento che guidano un film prodotto di nove secondi, ciascuna che ancora un battito e passa al successivo. Fonte: manuale ufficiale per creatori di Wan 3.0 di Alibaba._
Quanto costa un clip Wan 3.0 Multimodal Reference
| Passaggio | Modello | Prezzo unitario | Quantità | Costo |
|---|---|---|---|---|
| 1 e 2, due immagini di riferimento | GPT Image 2 | $0,009 per immagine | 2 | $0,02 |
| 3, riferimento vocale | MiniMax Speech 2.6 HD | $0,08 per 1K caratteri | 49 caratteri | $0,00 |
| 4, la ripresa da 10 secondi a 1080P | Wan 2.7 Reference-to-Video | $0,15 al secondo a 1080P | 10 s | $1,50 |
| Totale tutorial | circa $1,52 | |||
| Variazione, 30 secondi | Seedance 2.5 Reference-to-Video | $0,134 al secondo a 480P | 30 s | circa $4,02 |
| Via gratuita | Generatore gratuito di sketch pubblicitari AI | gratuito | 1 clip, 15 s | $0 |
Queste sono le tariffe della piattaforma, verificate ad agosto 2026 e fatturate con pagamento a consumo. Due cose fanno variare il totale più di quanto ci si aspetti. La risoluzione è la prima: i $0,10 al secondo nella tabella di confronto sono la tariffa base di Wan 2.7, e 1080P costa $0,15, che è da dove arrivano gli $1,50 sopra. La seconda è che Seedance calcola il prezzo in base al numero di pixel, quindi i suoi $0,134 al secondo dichiarati sono la cifra per 480P e una ripresa a 720P costa più di una semplice moltiplicazione. Per riferimento, la tariffa beta riportata di Wan 3.0 di $0,20 al secondo a 1080p metterebbe una ripresa completa di 30 secondi a circa $6, che è più della via Seedance a 480P oggi.
Una nota sull'uso di queste cose. Wan 3.0 è una beta e i suoi termini possono cambiare, quindi rileggili prima di costruire un pipeline su di esso. Se le tue immagini di riferimento sono persone reali, ottieni il loro permesso prima, poiché reference-to-video è precisamente la capacità che lo rende importante. I clip di esempio in questo articolo sono risultati generati da Alibaba dal suo manuale pubblico per creatori, riprodotti qui per commento.
Domande frequenti
Quanti riferimenti può effettivamente prendere il riferimento multimodale di Wan 3.0?
Fino a 20 asset in una singola chiamata, tratti da immagini, video, audio, documenti e pagine web. Il limite pratico è inferiore a quello tecnico. Assegna a ciascun asset esattamente un lavoro, un soggetto per immagine, e ne userai molti meno di 20 per la maggior parte delle scene.
Wan 3.0 può davvero trasformare un PDF o una pagina web in un video?
Sì, questa è la parte davvero unica. Oltre a testo, immagine, audio e video, accetta file di documenti e URL live, con i report sulla beta che elencano .doc, .xls, .ppt, .pdf e .txt. Nessun altro modello reference-to-video nella tabella di confronto sopra accetta un documento.
Wan 3.0 è open source? Posso eseguirlo in ComfyUI?
No, e non al momento. Wan 3.0 è una beta chiusa in esecuzione sul cloud di Alibaba. Le generazioni precedenti di Wan sono state rilasciate apertamente, motivo per cui esiste l'aspettativa, ma Alibaba non ha confermato i pesi per 3.0. Le pagine che affermano un rilascio Apache 2.0 di Wan 3.0 da 1,3B o 14B non sono supportate da nulla di ufficiale.
Wan 3.0 è disponibile tramite API di terze parti?
Non ancora, Atlas Cloud inclusa. La cosa più vicina che puoi chiamare oggi è Wan 2.7 Reference-to-Video, la cui forma di input corrisponde quasi esattamente all'omni-reference a parte le modalità documento e pagina web, o Seedance 2.5 Reference-to-Video se hai bisogno dei 30 secondi completi.
Qual è il modo più economico per testare un video a due personaggi bloccato con riferimento?
Il generatore gratuito di sketch pubblicitari AI collegato sopra. Quattro foto di riferimento dentro, un clip parlato a due personaggi di 15 secondi fuori, nessun parametro e nessuna spesa. Se tiene il tuo prodotto e il tuo formato, allora vai a mettere a punto la catena a pagamento.
Perché i miei personaggi continuano a derivare anche con le immagini di riferimento?
Tre cause, in ordine di frequenza. Un riferimento sta svolgendo due lavori, quindi gli viene chiesto di fissare sia il volto che la location. L'immagine di riferimento ha più di una persona o uno sfondo affollato, quindi il modello non sa quale parte bloccare. Oppure la deriva è un artefatto di rendering piuttosto che un fallimento del riferimento, nel qual caso metti face morphing, colour shift nel prompt negativo prima di riscrivere qualsiasi cosa.


