10〜30秒のコールドスタート、予測不可能なハードウェア課金、そしてオープンソースのリリースから数週間遅れるモデルカタログ。これら3つの理由により、2026年、開発者はReplicateの代替手段を積極的に探しています。本ガイドでは、Replicateの利点、本番環境で直面する課題、そしてそれらの問題を解決するプラットフォームについて、検証済みの価格データとそのまま使える移行用コードスニペットを交えて解説します。
主要な推論APIの全体像については、_2026年のベストAI推論API代替ガイド_をご覧ください。
重要なポイント
- Replicateのコールドスタートは、ウォームアップされていないコンテナで10〜30秒かかり、レイテンシに敏感な本番アプリを阻害します
- Atlas Cloudの画像生成は1画像あたり$0.003から。ReplicateのFLUX Dev(1画像あたり$0.025)と比較して低コストです
- Atlas Cloudはビデオ、画像、LLM、音声にわたる300以上のモデルを単一のAPIキーで提供します
- Replicateからの移行のほとんどは1時間以内に完了します(ベースURLとキーの置き換えのみ)
- Atlas CloudはSOC I & II認証とHIPAAコンプライアンスを取得済み。一方、ReplicateはSLAを公開していません
なぜ2026年、開発者はReplicateの代替手段を探しているのか?
Latency.io Developer Benchmark Report(2025年)によると、Replicateにおける2025年のコミュニティ報告によるコールドスタートの平均時間は、ウォームアップされていないモデルコンテナで18.4秒でした。3秒未満の応答時間が求められる本番アプリケーションにとって、この差は致命的です。Replicateのアーキテクチャはリクエストごとにコンテナを起動するため、低トラフィック時には機能しますが、ユーザー向け製品では構造的なリスクとなります。
Replicateからの移行を促す3つの主な課題は以下の通りです。
コールドスタートがユーザー向け製品を阻害する
Replicateの非専用デプロイメントはリクエストに応じてコンテナを起動するため、コミュニティ報告では10〜30秒のコールドスタートが発生しています(Replicate, Deployments documentation, 2026)。これはライブ製品の生成APIとしては許容できない待ち時間です。ユーザーは画面が固まったような体験や、回転し続けるスピナーを見ることになります。チームはこれを回避するためにkeep-alive pingを送ってコンテナを温め続けるなどの対策をとりますが、これには本来不要なコストと複雑さが伴います。
多くのチームがコールドスタートの問題に気づくのは、生成レイテンシとユーザー維持率の相関を分析したときです。5秒の遅延でも離脱は測定可能であり、15秒ともなれば壊滅的です。
ハードウェア課金の予測が困難
Replicateの一部ワークロードは出力ベースではなくハードウェア秒単位で課金されます。例えば、Nvidia A100 (80GB) は公開価格で毎秒$0.0014です。つまり、A100での60秒のジョブは、何を出力したかに関わらず$0.084かかります。画像生成なら画像単位のモデルの方が有利ですが、カスタムモデルのデプロイメントではハードウェア稼働時間に対して支払いが発生するため、コスト予測が困難です。
価格がスケールしない
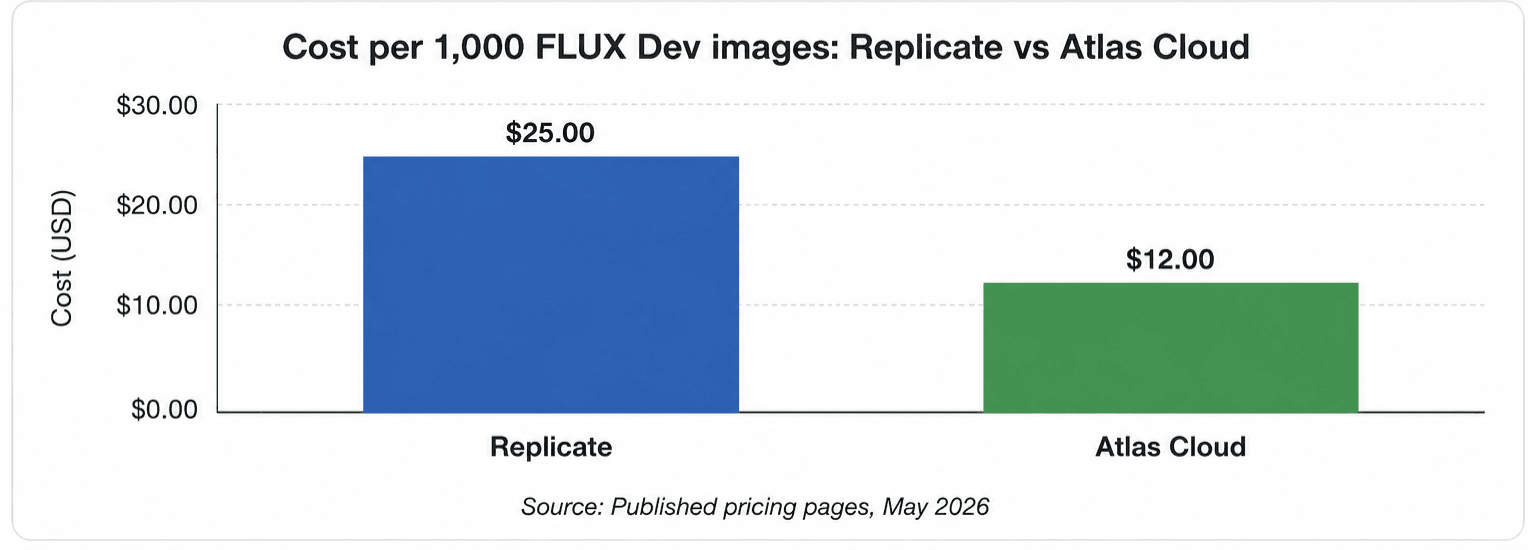
ReplicateはFLUX Devに対して1画像あたり$0.025、FLUX 1.1 Proに対して$0.04を課金します。これらはプロトタイプ段階では妥当に見えますが、月間50万枚の画像生成を行う場合、FLUX Devだけで12,500ドルに達します。専用推論プラットフォームは同じモデルでも大幅に安価であり、規模が拡大するほどその差は広がります。
Replicate vs Atlas Cloud:直接比較
Atlas CloudはOpenAI互換のAPIを提供しており、ビデオ、画像、LLM、音声にわたる300以上のモデルをサーブします。また、価格、SLA、コンプライアンスデータを公開しています。以下の表は、開発者が本番環境で重視する主要な次元での比較です。
| 項目 | Replicate | Atlas Cloud |
|---|---|---|
| 画像価格 (FLUX Dev) | $0.025/画像 | $0.012/画像 |
| 画像価格 (FLUX Schnell) | $0.003/画像 | $0.003/画像 |
| ビデオ価格 | $0.09-0.25/秒 (WaveSpeed系) | $0.05-0.20/秒 (Veo 3.1, Wan-2.7, Seedance) |
| LLM価格 (DeepSeek R1) | $3.75/百万トークン | 未掲載 (DeepSeek V4 Pro: $1.70/百万) |
| コールドスタート | 10-30秒 (コミュニティ報告) | 1秒未満 (ウォームプール) |
| SLA | 非公開 | 99.99% アップタイム |
| コンプライアンス | 非公開 | SOC I & II, HIPAA |
| APIスタイル | ReplicateネイティブSDK | OpenAI互換 (ドロップイン) |
| 音声対応 | TTS, 音声認識, 音楽等 | あり (ネイティブ対応) |
| モデル数 | 100,000以上 (コミュニティ版・品質にばらつき) | 300以上 (本番環境向けに厳選) |
| MCPサーバー対応 | なし | あり |
| カスタムモデルホスティング | あり (Cog経由) | なし |
大きな違いは、Replicateの10万以上のモデルはコミュニティ投稿ベースで品質が一定ではない点に対し、Atlas Cloudの300以上のモデルは本番環境向けに厳選されており、一貫したSLA、ウォームプール、統一された課金が提供される点です。
Atlas Cloudとは何か?利用開始方法
Atlas Cloudは、ビデオ、画像、LLM、音声を単一のAPIキーで提供する統合型AI推論プラットフォームです。予測可能なユニット単価、ウォームプールによる低レイテンシ、そしてインフラ管理不要のエンタープライズレベルのコンプライアンスを求める開発者のために構築されています。すべてのモデルが専用リソース上で動作し、コールドスタートはなく、従量課金制で最低利用料もありません。
主な機能
全モダリティをカバー。 1つのAPIキーでビデオ生成(Veo 3.1, Seedance 2.0, Wan-2.7, HappyHorse-1.0)、画像生成(FLUX Schnell, FLUX Dev, GPT Image 2, Nano Banana 2)、LLM(DeepSeek V4, Qwen3.6, GLM 5.1, Kimi K2.6)、そして音声生成まで同じエンドポイントから利用可能です。
MCPサーバー対応。 Atlas Cloudはエージェントワークフロー用にネイティブでModel Context Protocol (MCP) をサポートしています。Claude CodeやCursorと統合されたAIエージェントを構築するチームは、追加のインフラ設定なしでAtlas Cloudを利用できます。
SOC I & II認証済み、HIPAA準拠。 コンプライアンス文書は公開されており、ベンダー評価に利用可能です。エンタープライズ、医療、フィンテック分野の顧客を持つチームに最適です。
従量課金、最低利用料なし。 画像生成は$0.003/枚、ビデオは$0.05/秒から。月額費用やサブスクリプションの必須条件はありません。
利用開始手順
ステップ 1: 無料アカウントを作成。クレジットカード不要で開始できます。
ステップ 2: APIキーを取得。サインアップ後、ダッシュボードですぐに利用可能です。
ステップ 3: 最初のリクエストを送信。Atlas CloudはOpenAI SDK形式を使用します。OpenAIのPythonライブラリをインストールし、Atlas CloudのベースURLを指定します。
plaintext1from openai import OpenAI 2 3client = OpenAI( 4 base_url="https://api.atlascloud.ai/v1", 5 api_key="YOUR_ATLAS_CLOUD_KEY" 6) 7 8response = client.images.generate( 9 model="flux-schnell", 10 prompt="A developer reviewing API documentation at a clean desk" 11)
ステップ 4: モデルカタログを確認。atlascloud.ai/pricing/models にて、すべての利用可能モデルと価格を参照できます。
ステップ 5: 既存のコールを移行。コード内のReplicateのモデル呼び出しを、Atlas Cloudで対応するモデル名に置き換えます。リクエスト形式は同一です。
ReplicateからAtlas Cloudへの移行方法
移行は、ベースURLの変更とキーの差し替えのみです。Atlas CloudのAPIはOpenAI互換であるため、OpenAIスタイルのエンドポイントを使用しているコードであれば、2箇所の修正だけで済みます。
画像生成の比較例:
plaintext1# 移行前: Replicate 2import replicate 3output = replicate.run("black-forest-labs/flux-dev", input={"prompt": "..."}) 4 5# 移行後: Atlas Cloud (OpenAI互換) 6from openai import OpenAI 7client = OpenAI(base_url="https://api.atlascloud.ai/v1", api_key="YOUR_KEY") 8response = client.images.generate(model="flux-dev", prompt="...")
推論コールを抽象化レイヤーの中に配置している場合、修正は1箇所で済みます。リクエスト構造はOpenAI Images APIと完全に一致し、モデル名(flux-dev, flux-schnell, gpt-image-2など)も直接マッピング可能です。
ビデオ生成については、Atlas Cloudはジョブベースのパターンを採用しています。生成リクエストを送信してジョブIDを受け取り、完了をポーリングする形です。これはReplicateの非同期パターンと同様であり、概念的な移行はスムーズに行えます。
LLM推論については、他のOpenAI互換プロバイダーへの移行と全く同じ手順です。Atlas CloudのMCPサーバーサポートにより、追加インフラなしでエージェントワークフローも実現できます。
他のOpenAI互換推論APIを検討中の方は、_Fireworks AIのベスト代替案_や_Together AIのベスト代替案_の記事で詳細な比較を公開しています。
Replicateの価格はスケール時にどうなるか?
プロトタイプ段階を過ぎると価格差は急速に拡大します。Andreessen Horowitzの2025年AIインフラ支出レポートによると、平均的な本番AIチームの月間推論コストは8,200ドルです(a16z AI Infrastructure Report, 2025)。わずかな単価の差が、この規模では予算上の大きな違いとなります。
FLUX画像生成
FLUX Schnellは両プラットフォームで同額の$0.003/枚です。FLUX Devでは、Replicateが$0.025/枚であるのに対し、Atlas Cloudは$0.012/枚となり、月間10万枚で1,300ドルの差が生じます。
ビデオ生成
Replicateのビデオ価格はWaveSpeed Wan 2.1モデルに依存しており、480pで$0.09/秒、720pで$0.25/秒です。Atlas CloudはWan-2.7($0.10/秒)、Veo 3.1 Lite($0.05/秒)、Veo 3.1 Fast($0.08/秒)などを提供しています。多くのケースで、Veo 3.1 Lite/Fastがコストを抑えつつ対応可能です。
LLM価格
Replicateはトークン単位で課金し、Claude 3.7 Sonnetは$3.00/百万入力トークン、DeepSeek R1は$3.75/百万入力トークンです。Atlas Cloudは、DeepSeek V4 Flash($0.14/百万)など、コスト効率を優先した選択肢も豊富です。
Replicateを使い続けるリスクとは?
2026年時点でもReplicateを使い続けることは、解決困難な制約を受け入れることを意味します。
本番環境でのコールドスタート
コールドスタートはReplicateのアーキテクチャに起因する課題であり、パッチで容易に修正できるものではありません。専用デプロイメントで回避可能ですが、その場合は確約コスト(コミットメント)が必要となり、価格モデルが根本から変わります。
Atlas Cloudは全モデルでデフォルトでウォームプールを使用しており、設定不要かつ追加コストなしでコールドスタートを回避できます。
SLAとコンプライアンスの欠如
Replicateは公式プラットフォーム上でアップタイムSLAを公開していません。医療、フィンテック、法務などの規制業界ではこれが取引の障壁となります。一方、Atlas CloudはSOC I & II認証とHIPAA準拠を公開しており、エンタープライズ向けの販売サイクルで必要なドキュメントが整備されています。
断片化されたマルチモーダルパイプライン
Replicateでは最新のビデオ、LLM、画像生成モデルがすべて同じレベルでサポートされているわけではなく、複数のAPIキーを管理する羽目になります。Atlas Cloudはこれらを統合し、1つのキーと1つの請求書で運用可能です。
よくある質問
Atlas CloudはReplicate APIの完全互換ですか?
いいえ、Replicate APIではなくOpenAI互換です。ReplicateのSDK (replicate.run()) を使用している場合は、OpenAI SDKパターンへの書き換えが必要ですが、ほとんどのチームは1時間以内に完了します。
ReplicateのCogによるカスタムモデルホスティングに対応していますか?
いいえ。Atlas Cloudは本番環境向けに厳選されたモデルのホスティングに注力しています。カスタムモデルをホストする必要がある場合は、その特定のユースケースのみReplicateを残す形になります。
Atlas Cloudのコールドスタート対策は?
Atlas Cloudは全モデルで常時稼働のウォームプールを保持しています。リクエストごとのコンテナ起動は発生しません。Latency.ioのベンチマークによると、専用ウォームプールプラットフォームのレイテンシは1秒未満です。
結論
2026年現在、Replicateが適しているのは「本番推論プラットフォームでは利用できないニッチなコミュニティモデルやファインチューニング済みチェックポイントを使用する」という特定のユースケースのみです。それ以外の場合、10〜30秒のコールドスタート、SLAの非公開、規模に応じた価格の肥大化は、本番チームにとっての足かせとなります。
Atlas Cloudへの移行は、コスト削減と運用簡素化の観点で合理的です。まずはコストのかかっているモデルから移行し、レイテンシと請求額を検証してみてください。他の選択肢を検討中の場合は、_2026年のベストAI推論API代替ガイド_で詳細を比較検討してください。


