コードは完成したように見える。そこへテストが失敗し、修正がインターフェースを変えてしまい、また別のリクエストが動き始める。コーディングに最適なAI APIを選ぶとは、自分の仕事を許容できる予算内で完了してくれるモデルとエンドポイントを見つけることだ。
まずはClaude、GPT、Geminiを参照候補として始めよう。別のデプロイ先や支出オプションを求めるなら、DeepSeek、Qwen、Kimiを同じタスクで比較する。デバッグでは回帰テストを優先する。リファクタリングではdiffを確認する。コーディングエージェントでは、トークン価格を比較する前にツールループ全体を検証する。
このいらだちは数値で測れる。2025年Stack Overflow開発者調査では、いらだちに関する質問への回答者の66%が「ほぼ正しいAIソリューション」を報告し、45%が生成コードのデバッグに多くの時間を費やしていると回答した。これらは調査回答であり、2026年のモデル評価ではない。(Stack Overflow開発者調査、2025年)
主なポイント
- APIとエージェントは別々に選ぶ。
- タスクと必要なエンドポイント機能で候補を絞る。
- 最初の回答を保存し、固定した受け入れテストで判定する。
- 失敗した試行と修正をコスト計算に含める。
本ガイドでは候補リスト、コピー可能な3つの評価タスク、コストワークシートを提供する。調査は2026年9月21日に確認した。モデルの利用可否、文書化された機能、実測結果は、全体を通じて別々の証拠カテゴリである。
コーディングに最適なAI API:候補リスト
まず2つの候補から始める。既存アプリケーションに合うもの1つと、代替1つだ。この6つのファミリーを使って最初のペアを組み立てる。
この表は比較性能を主張するものではなく、テストを提案するものである。アクセスはアカウント、リージョン、クォータ、エンドポイントに依存し、ドキュメントに記載されているからといって自分の認証情報で呼び出せるとは限らない。
| 具体的なモデルとID | アクセス経路 | 評価する価値のあるタスク | 主な判断境界 | エンドポイントの証拠 | 価格確認 |
|---|---|---|---|---|---|
Claude Opus 5、claude-opus-5 | Anthropic API | 制約付きの複数ファイル変更 | クライアントと推論制御の検証 | Claude Platformモデル概要、アカウントアクセス未検証 | レート記載なし |
GPT-6 Astra、gpt-6-astra | OpenAI API | 複数条件のコーディングタスク | ルートとツールの検証 | OpenAIモデルドキュメント、アカウントアクセス未検証 | レート記載なし |
Gemini 3.8 Flash、gemini-3.8-flash | Gemini API | 対話的な生成とレビュー | レイテンシとプロトコルの検証 | Google AIモデルディレクトリ、アカウントアクセス未検証 | レート記載なし |
DeepSeek V4 Pro、deepseek-ai/deepseek-v4-pro | Atlas Cloud モデルルート | 数値修正、コンテキスト実験 | 0813バージョンは別扱い | 正確なモデルページを検証済み、ランタイム機能は未検証 | 2026年9月21日 |
Qwen3.5 122B A10B、qwen/qwen3.5-122b-a10b | Atlas Cloudモデルルート | リファクタリング、自己完結型インターフェース | 指定バージョン、最新ではない | 正確なモデルページを検証済み、ランタイム機能は未検証 | 2026年9月21日 |
Kimi K3、moonshotai/kimi-k3 | Atlas Cloudモデルルート | 同じ3タスク、CSVインターフェース | 出力と完了制限の検証 | 正確なモデルページを検証済み、ランタイム機能は未検証 | 2026年9月21日 |
Claude、GPT、Geminiは有用な参照候補を提供する。 各社の公式モデルディレクトリに上記のバージョンが記載されている。すでに理解しているプロバイダーをベースラインとして使い、代替が受け入れ済みタスクのコストや統合作業を減らすかどうかを検証しよう。コンシューマー向けアシスタントの挙動を、対応するAPIの結果として扱ってはならない。
OpenAIのモデルディレクトリには、GPT-5.6ファミリーと並んでGPT-6 Astraが掲載されている。これは現行の候補を示すものであり、他の行に対するコーディングでの優位を意味しない。この表は、日付のない比較ページから古いモデルIDを持ち込むことを意図的に避けている。(OpenAIモデルディレクトリ、2026年9月アクセス)
DeepSeekは別個に調査すべきモデルファミリーとしての位置を得ている。 変更を広げずに特定のバグを修正するかを検証しよう。デプロイされたルートが、必要な応答フォーマット、ツールの挙動、レイテンシ上限を満たせない場合は、モデルの一般的な評判にかかわらず別の候補を選ぶ。
Qwenはバージョン単位で評価する。 明示された122B A10Bデプロイは具体的な価格参照を提供する。価値判断を下す前に、パースとブラウザのチェックを実行しよう。他のQwenリリースのコンテキスト数値をこのモデルに当てはめることはできない。
Kimiは具体的に構成された候補である。 公開ページにモデルIDが記載されている。構成のレビューは可能だが、生成の成功は未検証のままだ。完成した出力を、他の候補と同じ制約で評価しよう。
この比較においてAtlas Cloudはアクセス層に位置する。7番目のモデルではない。その関連性は実用的だ。ワークフローを確定する前に、複数の候補モデルページを確認し、統合要件を比較できる。
オープンウェイトの場合、正確なリリースライセンスとデプロイ成果物を確認すること。ホスト型推論には別途のサービス条件と運用コストがある。モデルファミリーだけではこれらを確定できない。
コーディングAPI、モデル、エージェントの説明
モデルは入力に応じてコンテンツを生成する。APIは、アプリケーションがその入力の送信と結果の受信をどう行うかを定義する。コーディングエージェントは周辺作業を組織する。ファイルの読み取り、ツールの呼び出し、編集の適用、テストの実行、継続可否の判断である。
これら3つの層はそれぞれ独立に失敗しうる。モデルが正しいパッチを提案しても、エージェントがそれを誤ったファイルに書き込むことがある。APIが有効なJSONを返しても、アプリケーションがツール呼び出しを無視することがある。有能なエージェントでも、選択したエンドポイントがパラメータを拒否するために停止することがある。
ハンドラーを送り、IDパーサーを求めたとしよう。基本的なコード生成APIはコードを含むテキストを返す。プログラム側では依然として、そのコードを抽出し、適切なワークスペースに配置し、テストを実行する必要がある。HTTP応答の成功は配信を証明するものであり、正しさを証明するものではない。
エージェントがこれらの手順を自動化できるのは、ツールと権限を与えた場合だけだ。停止条件も必要である。それがなければ、すでに受け入れ可能な関数を繰り返し編集したり、タスクを拡大したり、無関係な細部を改善しようと追加リクエストを消費したりする可能性がある。
予算は次の3項目を分けて管理する。
- ツールのサブスクリプション: 使用するアプリケーション、エディタ統合、エージェントサービス。
- 推論利用: 選択したモデルエンドポイントへのリクエスト。その課金条件に従う。
- 実行環境: コンテナ、テストランナー、ストレージ、その他のインフラ。
一部の製品はこのスタックの一部をバンドルしている。別の製品は個別の認証情報を持ち込むことを前提としている。エディタのサブスクリプションが自社アプリケーションからの任意のAPIトラフィックを含むと仮定する前に、その特定のプランを確認しよう。
プロトコル互換性にも境界がある。見慣れたmessages配列を受け付けるサービスでも、ツールの挙動、ストリーミングイベント、コンテキスト上限、推論制御は異なる場合がある。ベースURLをコピーしても、他プロバイダーのエコシステムのすべての機能をサポートする証明にはならない。
アプリケーション、エージェント、エンドポイント、モデル、ツール、テストを対応付ける。モデルを変更する前に、各ステップで課金対象のコンポーネントと責任者を特定しよう。
コーディングに最適なAI API:7つの選定チェック
1. 機能的正しさと回帰動作。 コードを要求する前に期待される出力を書き出す。通常の整数は扱えてもnullをゼロとして受け入れる価格関数は、契約に違反している。新しいエッジケースと既存のプロジェクトテストの両方を実行する。新しいテスト1つが通っても、他の箇所の壊れた呼び出し元を隠してしまう可能性がある。
2. 変更の範囲。 パッチとリクエストを比較する。IDパーサーの抽出はURL、成功応答、エラー応答を維持すべきだ。求めていないフレームワーク移行は、置き換えがコンパイルできたとしてもレビュー作業を増やす。無関係な編集が回答を失格とするのか、修正を要するのかをあらかじめ決めておこう。
3. 有用なコンテキストと出力の余裕。 リクエストには指示、関連ファイル、ツール定義、以前の会話が含まれる。回答のためのスペースも十分に確保しよう。宣伝されている大きなコンテキストウィンドウは、モデルが関連する不変条件を見つけられることや、エンドポイントが同じ最大値を受け入れることを証明しない。
重要な依存関係を使ってコンテキストの品質をテストする。インターフェースを安定に保つ必要がある呼び出し元を含め、モデルがそれを尊重するか検証する。切り詰めは別途測定する。関数の途中で終わる応答は、冒頭の行が有望に見えても受け入れられない。
4. ツール呼び出しと構造化出力。 デプロイされたルートを実際のツールスキーマで検証する。引数の型、欠落フィールド、ツール識別子、ツール結果後のフォローアップ応答を確認する。もっともらしいJSONオブジェクトを書くモデルが、ネイティブのツール呼び出しラウンドトリップを完了したとは限らない。
5. 受け入れ結果までの時間。 修正とテストを含む試行全体の所要時間を記録する。対話型アシスタントでは、最初の可視テキストまでの時間も重要だが、完了時間の代わりにはならない。素早い最初のトークンの後に長く使えない回答が続けば、開発者は依然としてブロックされる。
6. 入力、出力、キャッシュ、リトライの課金。 選択したエンドポイントが実際に報告する課金カテゴリを読む。該当する場合、キャッシュ読み取りを通常の入力から分ける。失敗したリクエストと中断されたループを追跡する。プロバイダーが必要な詳細を公開していない場合は、見積もりの欠落した前提を明示的に記す。
7. 統合とコード取り扱いの条件。 エディタまたはアプリケーションがルート、認証方式、エラー形式をサポートすることを確認する。非公開ソースを送る前に、プロバイダーの現在のデータ取り扱い条件を確認する。オープンウェイトはモデル配布の選択を説明するものであり、ホスト型サービスがリクエストをどう扱うかを確定するものではない。
公開ベンチマークは、その条件を読むことを前提に、候補の選定に役立つ。SWE-bench Verifiedは人手でフィルタリングされた500件のインスタンスを含む。現在のページでは、同じmini-SWE-agent環境を使うBash Onlyビューについても説明されている。これらの詳細は、何が比較されているかを説明する助けになる。(SWE-bench、2026年9月アクセス)
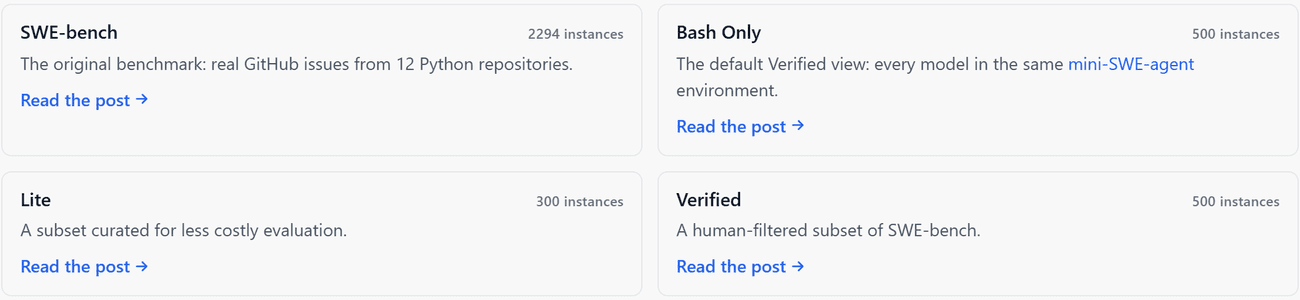 Verifiedデータセットのサイズと共有エージェント環境を示すSWE-benchページ
出典証拠:実際のベンチマークページ、2026年9月21日取得。データセットと実行条件は、あらゆる性能主張のそばに添えるべきである。
ベンチマーク結果は特定のセットアップを説明するものである。あなたの言語、ビジネスルール、権限、レビュー基準は異なるかもしれない。最終判断は、自分で検査できる作業に基づいて行おう。
コーディングに最適なAI API:3つの実践チェックを実行する
この3つの再現可能な評価例は、異なる失敗モードを明らかにする。出力を要求する前に受け入れルールを確定しよう。説明の質にかかわらず、関数やページをその契約に照らして判定する。
DeepSeek V4 Pro、Qwen3.5 122B A10B、Kimi K3では、想定プロトコルはタスクごとに3回の独立実行である。つまり最初の試行が27回となる。試行ごとにフィードバックによる修正を最大1回まで許可し、最初の回答を保存し、初回と修正後の結果を別々に報告する。
temperature 0は対応している場合にのみ要求し、実際に受け入れられた設定を記録する。エンドポイントの上限を確認したうえで、AとBには4,096トークン、Cには8,192トークンの出力上限を要求する。デフォルト値と未対応の制御は記録しなければならない。低いtemperatureは同一の回答を保証しない。
証拠の状況: テスト環境へのアクセスはCloudflare Accessのログイン画面でブロックされた。27回の候補試行は実行できなかった。以下の証拠は、ローカルで実行した元のコードと、記事用に作成したCSV参照フィクスチャを示すものであり、候補モデルの結果ではない。モデルの合格率、トークン使用量、タスクコストは未測定のままである。
タスクA:数値の価格選択を修正する。 このプロンプトをそのまま新しいセッションに貼り付ける:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
固定された受け入れ入力は[2,10,3]、["12","3"]、空配列、無効値のみ、ゼロ、負数、空白のみの文字列である。トリム後に空文字列を拒否する。呼び出し後、元の配列が同じ要素を同じ順序で正確に保持していることを確認する。
元のコードはJavaScriptのデフォルトのsortを使用し、入力を変更する。したがってこのタスクは、正しい数値最小値の選択と、呼び出し元のデータを変更しないという2つの異なる義務をチェックする。短い強制変換ベースの解決策が誤ってbooleanやnullを受け入れる可能性があるため、変換ルールを明示的にテストする。
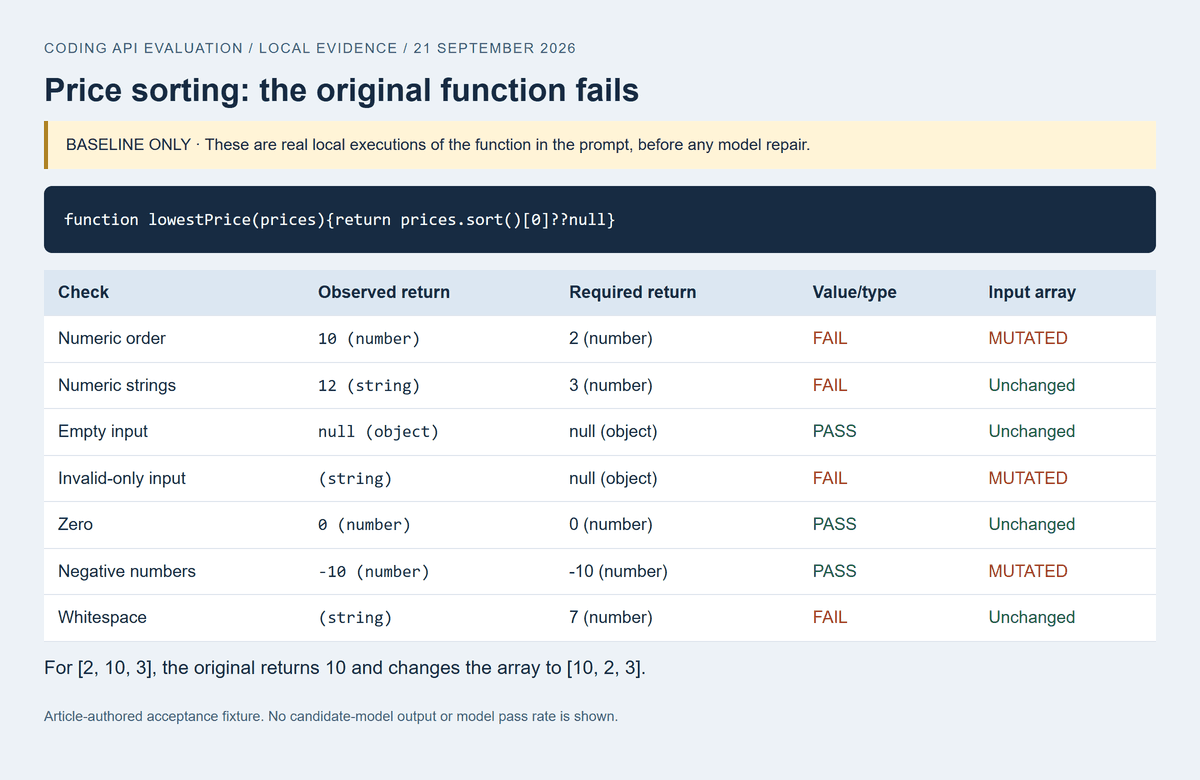 誤った数値ソートと入力の変更を示す、元の価格関数のローカル実行
実行済みベースライン:元の関数は[2,10,3]に対して10を返し、配列を[10,2,3]に変更する。数値文字列も戻り値の契約を満たさない。モデルによる修正は示していない。
タスクB:小規模なリファクタリング中にインターフェースを維持する。 このプロンプトをそのまま使用する:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
"12"と"0012"を12として受け入れる。"1e2"、"1.0"、負数、ゼロ、空白、非文字列入力、JavaScriptの安全な整数範囲を超える値を拒否する。登録されたパスと両方のレスポンスボディを確認する。無効な入力がfindUserに到達してはならない。
このタスクは、モデルが数値変換と指定された文字列文法の違いを理解しているかをテストする。diffに無関係な変更がないか確認し、スタブ化したリクエストとレスポンスオブジェクトでハンドラーを呼び出す。正しいヘルパーと、変更されていない寛容なハンドラーを組み合わせても、依然として失敗する。
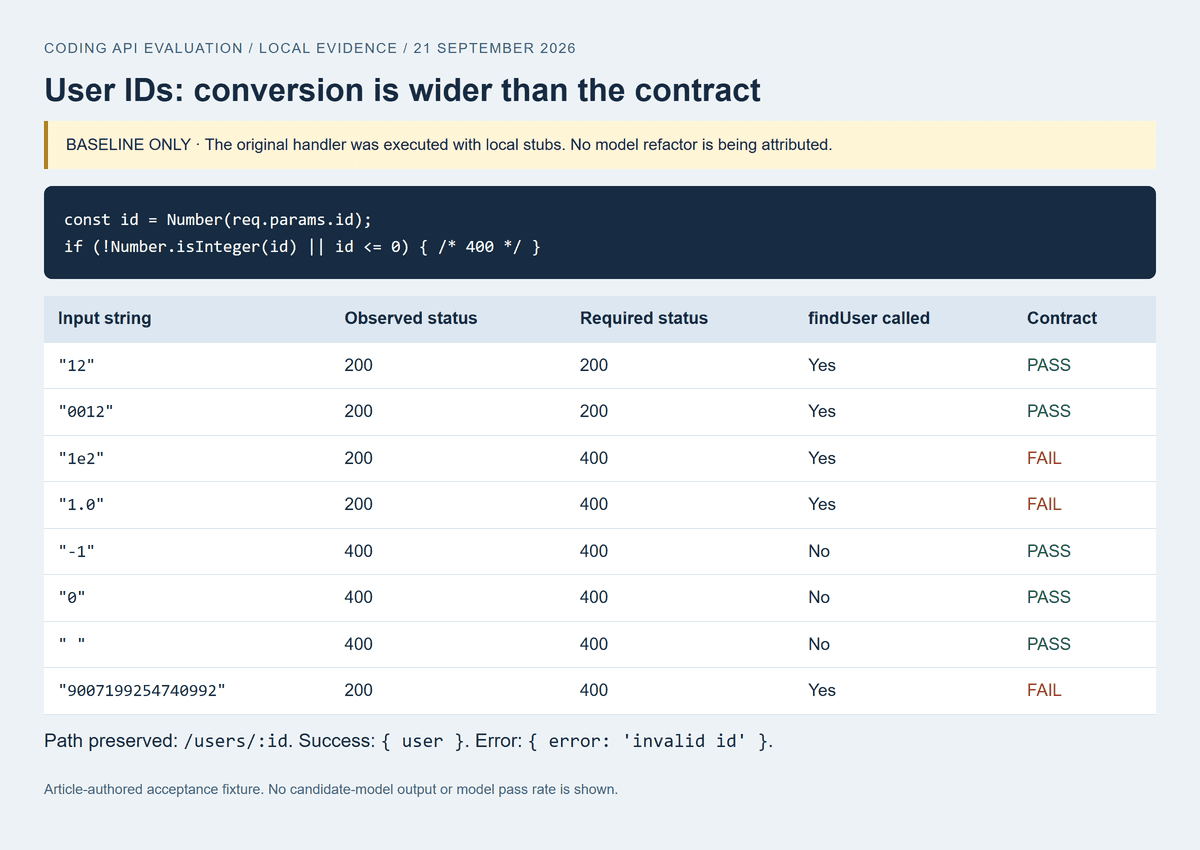 無効な数値文字列がステータス200で受け入れられたことを示す元のハンドラーテストログ
実行済みベースライン:元のハンドラーは、要求される400応答にもかかわらず、"1e2"、"1.0"、"9007199254740992"に対して200を返す。ローカルのスタブが呼び出しを記録した。これはモデルが生成したリファクタリングではない。
タスクC:自分で操作できるCSVプレビューを構築する。 次を提出する:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
次の正確なレコードでテストする。まずLF、次にCRLFを使用する:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
2つの列、3つのデータ行、Aliceのカンマが1つのセル内に収まること、Bobのエスケープされた引用符が正しく表示されることを期待する。Eveの値はリテラルテキストとして表示され、画像要素、イベント実行、ネットワークリクエストが発生してはならない。3フィールドの行を追加し、ページが不一致を目に見える形で報告することを確認する。
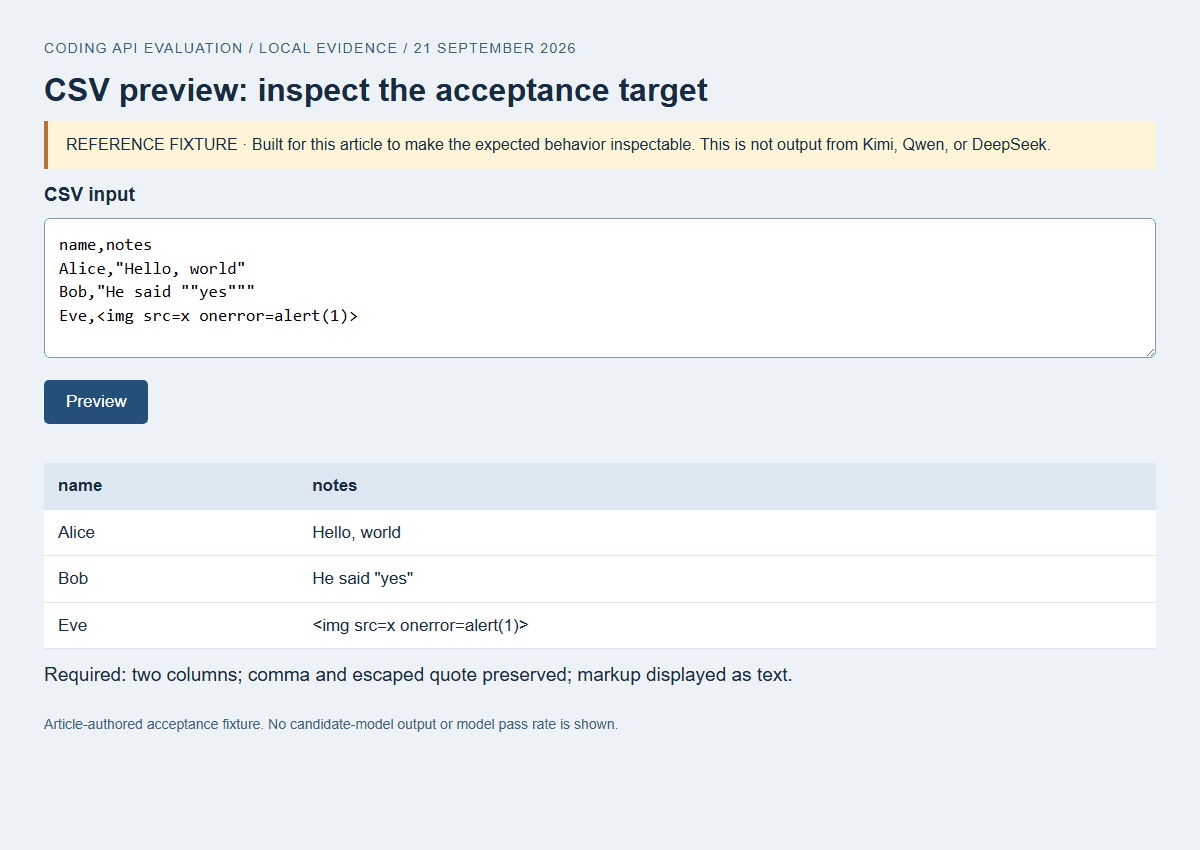 引用符付きの値とリテラルマークアップの要件を示すCSV受け入れフィクスチャ
本記事用に構築した操作済みの参照フィクスチャであり、候補モデルが生成したものではない。ブラウザチェックにより、LF/CRLFのパース、エスケープされた引用符、リテラルマークアップ、可視的なフィールド数エラー、HTTPリクエストなしを検証した。スクリーンショットはPreviewをクリックした後の有効入力状態を示す。
生の出力、ログ、モデルID、日付、パラメータ、タイミング、修正、手動編集を保存する。期待される結果を変えずに、失敗したアサーションを修正のために送る。拒否、切り詰め、エラーを成功と並べて保持する。
予算内でコーディングに最適なAI API
トークン料金は、完了品質と使用量と併せて比較する。繰り返される入力はコードレビューコストを支配する可能性があり、ファイル全体の生成は出力課金を増やしうる。繰り返しの修正は両方を増やす。
Atlasのカタログと正確な詳細ページは、2026年9月21日時点で以下の100万トークンあたりの米ドル料金を示していた:
- DeepSeek V4 Pro: 入力$1.68、出力$3.38。別個のV4 Pro 0813の掲載は異なる料金を使用している。代用してはならない。
- Qwen3.5 122B A10B: 入力$0.30、出力$2.40。カタログでは2026年9月時点で、通常料金$0.40と$3.20に25%の割引が表示されていた。
- Kimi K3: 入力$3.00、出力$15.00。
これらは表示されている本番料金であり、本記事の評価による請求書ではない。キャッシュ固有の料金とその適用可否は確認されていない。DeepSeekとKimiのプロモーション割引は確認されていない。割引の観察がないからといって、オファーが存在しないことの証明にはならない。
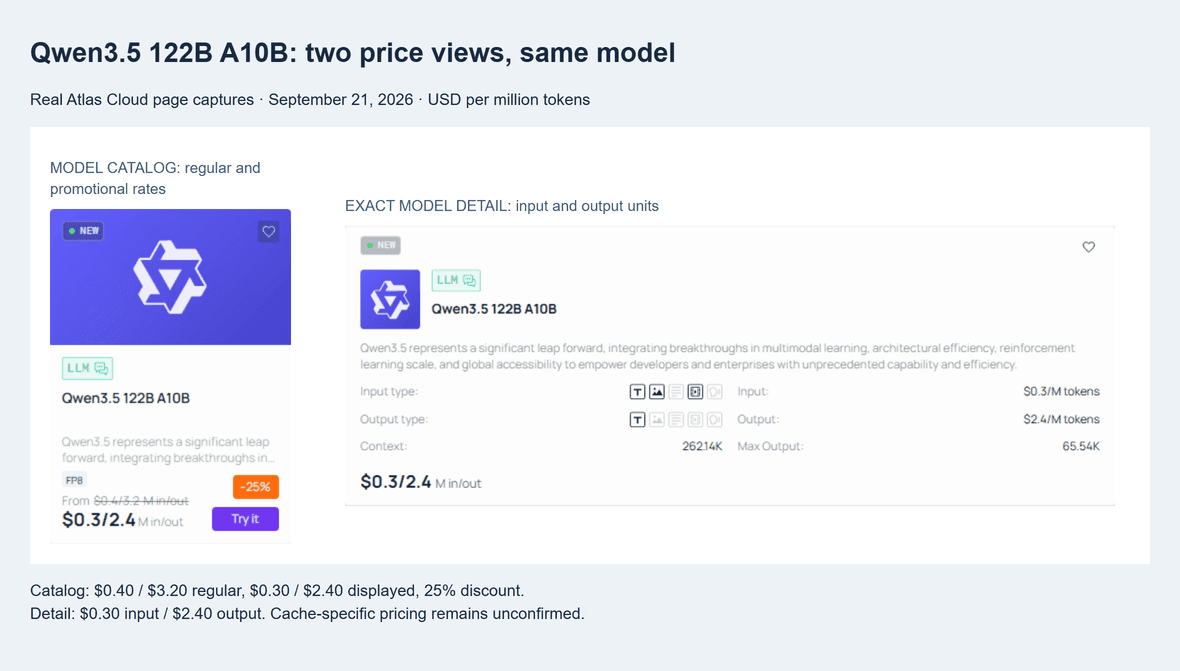 Qwen3.5 122B A10Bのカタログ割引と、正確なモデル詳細の入力・出力料金
Qwen料金のクロスチェック、2026年9月21日:カタログは25%プロモーションを示し、正確なモデル詳細は100万トークンあたり入力$0.30、出力$2.40を確認している。キャッシュ固有の料金は未確認のままである。
タスクのモデル部分は次のように計算する:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
課金記録がキャッシュされたトークンを別扱いしている場合、それらを通常の入力として再度課金してはならない。推論使用量が課金対象の出力に含まれるかを確認する。合格したタスクがない場合は「成功結果なし」と報告する。ゼロで割ったり、完了コストをゼロとして表示したりすると、読者を誤導する。
透明な算術例として、表示されているQwen料金で通常の入力トークン10,000と出力トークン2,000を仮定する。推定モデル料金は、他の該当項目を除いて$0.0078である。これは仮想的なリクエストであり、観測されたトークン使用量や実際の請求書ではない。
同じ規模の修正が1回あれば、推定値は$0.0156になる。実際の修正は異なるコンテキストと出力を含むため、各リクエストを記録された使用量から計算する。
| タスク | モデル | 初回パス | 修正後 | トークン使用量 | コストソース | 合計請求 | 合計時間 | 手動変更 |
|---|---|---|---|---|---|---|---|---|
| A、B、C、各3回繰り返しを予定 | DeepSeek V4 Pro | 未測定 | 未測定 | 未記録 | 使用量記録なし | 不明 | 未測定 | 未評価 |
| A、B、C、各3回繰り返しを予定 | Qwen3.5 122B A10B | 未測定 | 未測定 | 未記録 | 使用量記録なし | 不明 | 未測定 | 未評価 |
| A、B、C、各3回繰り返しを予定 | Kimi K3 | 未測定 | 未測定 | 未記録 | 使用量記録なし | 不明 | 未測定 | 未評価 |
自分のワークシートでは、各行をモデルと繰り返しごとに1行に展開する。修正して成功したものは、受け入れ済みタスクの分母に1回だけ数える。失敗した試行は分子に含め、初回パスと最終受け入れの列を別々に保持する。
人によるレビューとインフラは別々に追跡する。不要な書き直しの解消には、推論の節約分が消えかねない。受け入れ要件とレビュー時間の予算の両方を満たす候補を比較しよう。
Atlas Cloudでコーディングに最適なAI API
Kimi K3モデルページから始め、IDを確認し、APIビューとCodeビューを検査する。選択したバージョンをテスト記録のそばに保管する。
2つのルートを互換とみなす前に、LLMプロトコルドキュメントを読む。これはChat Completionsを広いカバレッジのルートとして示し、ユーザーを各モデルのsupported_apisへ導く。サンプリング制御とツール機能も、モデルが宣伝するサポートに依存する。
ここで確認する価値のある具体的な統合の詳細がある。ドキュメントによれば、翻訳されたAnthropicリクエストはcache_controlを適用せず、その翻訳ルートではプロバイダーホスト型ツールが利用できない。既存のエージェントがネイティブキャッシュやホスト型ブラウジングツールを前提としている場合、これらの制約は重要である。クライアントを実際のルートに合わせよう。
次のNode.jsの例は、1回のテキストリクエストを示している。組み込みのfetch、認証情報用の環境変数、検証済みのKimiモデルIDを使用する。タスクAの正確なプロンプトをtask-a.txtとして保存する。ベースURLの環境変数を、ドキュメントに示されているAtlas APIのベース(/v1で終わる)に設定する。
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messagesはタスクを運び、modelはデプロイを選択し、max_tokensは出力上限を要求する。応答リーダーは、コードを返す前に通常の完了テキストであるかを確認する。タイムアウトはこの例の待機を制限するものであり、サーバーが処理を停止したことや課金が発生しなかったことを確定するものではない。
temperatureは、モデルごとのサポートと確定した挙動の検証が必要なため省略している。この例は自動的にリトライしない。上限付きのリトライポリシーを追加する前に失敗クラスを確認し、認証ヘッダーを決してログに記録しない。この公開コードは、記事制作中にAPIキーを使って実行されたものではない。
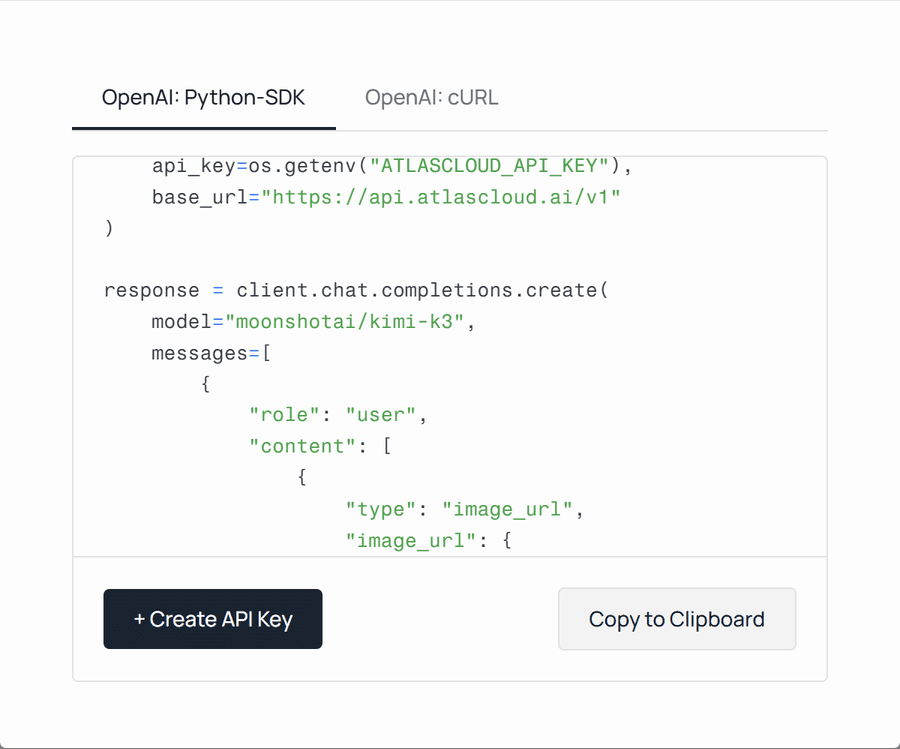 Atlasのエンドポイントとモデル識別子を示す公開Kimi K3 APIコード例
公開Kimi K3 Codeダイアログ、2026年9月21日取得。これは構成の証拠であり、完了したコーディング実行ではない。ページのサンプルにはメディア入力が含まれるが、記事の例はテキストのみを使用している。
返された関数に対してタスクAの受け入れチェックを実行する。DeepSeekやQwenに切り替える前に、そのプロトコルとパラメータを検証する。出力と使用量を比較する間はプロンプトとテストを変更しない。リクエストの形式が共通していても、同一の挙動を確定するものではない。
本番環境でコーディングAPIを使用する前に
生成されたコードは、まず使い捨てのブランチまたは隔離されたワークスペースで実行する。CSVタスクでは、ネットワークリクエストをブロックし、機密性の高いアプリケーション状態にアクセスできないローカルブラウザコンテキストを使用する。リポジトリタスクでは、評価に必要なファイルとコマンドだけをプロセスに与える。
成功はモデルの応答の外側で定義する。エージェントが「全テスト合格」と言ったら、実際のテストログ、終了コード、確認したリビジョンを確認すべきだ。その証拠とともにdiffを保存する。そうしなければ、後続の修正が見かけ上の成功後にファイルを変更し、レポートを古いものにしてしまう可能性がある。
タイムアウトとリトライは、自分が所有するアプリケーションの挙動として扱う。リクエストの期限とタスク全体の予算を設定する。認証情報や無効なパラメータによるエラーと、一時的な転送障害を分ける。無効なリクエストの繰り返しは時間の無駄であり、副作用を引き起こすリクエストの繰り返しは重複作業を生む可能性がある。
エージェントがツールを呼び出せる場合、読み取り専用の検査と書き込みを区別する。ツール設計が対応している場合は操作識別子を割り当て、不確実な書き込みを繰り返す前に状態を確認する。モデルエンドポイントのリトライポリシーは、その後アプリケーションが実行するツールの冪等性を保証できない。
ログはソースファイルと同じくらい意図的に保護する。モデルID、タイムスタンプ、ステータス、タイミング、使用量を記録しつつ、シークレットやプライベートリポジトリ全体をテレメトリに日常的にコピーしない。必要な生出力の証拠は適切に制限された場所に保管し、チームがそれを保持する必要がある期間を定める。
ストリーミングは実際のクライアントで確認する。部分的なイベント、終了、エラー、利用可能な場合は使用量レコードを処理できなければならない。実際のアカウントとデプロイのレート制限を確認する。静かなシングルユーザーの実験では、チームが一斉にリクエストを送信したときに同じルートがどう振る舞うかを確定できない。
この短いリリースチェックリストを使用する:
- 受け入れテストと既存の回帰テストが最終リビジョンで合格している。
- diffが承認されたタスク境界内に収まっている。
- タイムアウト、キャンセル、リトライの挙動が実行確認されている。
- ツール呼び出しと構造化応答が選択したエンドポイントで機能する。
- ログに認証情報や不要な非公開コードが含まれていない。
- データ取り扱い条件がチームの要件を満たしている。
- フォールバックが独自の検証済み構成とテスト記録を持っている。
プライベートリポジトリにはサービス固有の判断が必要である。現在の保持、トレーニング利用、アクセス、契約条件を、コードの責任者と確認する。承認された素材のみを送る。モデルの重みが入手可能であることや、すでに使用しているプロトコルに似ていることから、機密性を推測してはならない。
コーディングに最適なAI API:最終選定を行う
判断は3つの段階で行う。
第一に、必須機能を欠く候補を除外する。 満たすべき条件を書き出す。受け入れられる出力形式、機能するツールループ、適切なデータ取り扱いの取り決め、実行可能な応答期限などである。1つでも欠く候補は、最終比較に含める前に別途の是正判断が必要である。
第二に、受け入れ済みタスクのコストと経過時間を比較する。 同じ修正ポリシーのもとで全試行を使用する。初回パスの成功と修正後の成功を分け、欠落した使用量記録を示す。2つのモデルがどちらも契約を満たす場合は、モデル料金だけでなくレビュー負担も比較する。開発者はその結果としてのパッチと共に生きていくことになる。
第三に、フォールバックを1つ保持し、そのトリガーを定義する。 例として、エンドポイントの長期障害、構造化出力の繰り返し失敗、選択した上限を超えるタスクコストなどがある。代替構成は事前にテストする。圧力下でモデルIDを切り替えると、その制御や応答挙動が異なる場合、第二の統合問題を招きかねない。
本ガイドの3つの小さなタスクはスクリーニングの演習である。広範な変更を候補に任せる前に、自分のコードベースの代表的な作業でスイートを拡張しよう。プロンプト調整の対象外のタスクをいくつか保持し、改善が最適化した例を超えて転移するかを確認できるようにする。
コーディングに最適なAI APIとは、説明できる組み合わせである。必要な作業を完了し、追跡可能なコストを示し、アプリケーションの動作方法に適合する。その判断に普遍的な勝者は必要ない。
現在のモデルカタログを開き、2つの候補を選び、正確なIDと設定を保存する。そして両方に同じタスク、同じテスト、同じ停止ルールを使用する。
よくある質問
小規模な予算でコーディングに最適なAI APIは何ですか?
表示料金が想定される入出力量に合う候補から始め、受け入れ済みタスクあたりのコストを比較する。Qwen、DeepSeek、Kimiの行は調査すべき具体的なバージョンを提供するが、テスト済みの価値上の勝者を主張するものではない。修正試行を制限し、関連コンテキストを意図的に再利用し、失敗したリクエストを追跡する。レビュー時間を別途含め、低い推論請求額が大きな後始末負担を隠さないようにする。
コーディングのサブスクリプションはAPIトークンの支払いより安いですか?
ワークロードとプランの内容次第である。サブスクリプションは、サポート対象アプリケーション内での対話的な利用に適するかもしれず、従量課金は変動するトラフィックを持つカスタムサービスに合うかもしれない。モデルアクセス、上限、同時実行数、外部API呼び出しがそもそも含まれるかを確認する。代表的な期間で同じ量の有用な作業を比較する。月額の表示価格とトークン料金は別のものを測っている。
コーディングモデルとコーディングエージェントの違いは何ですか?
モデルは応答を生成する。エージェントはそれらの応答を囲むループを管理し、ファイルアクセス、ツール実行、テスト、停止ルールを含む。エージェントを構築せずにAPI経由でコーディングモデルを呼び出すこともできる。たとえば、人間のレビュー用に関数を提案させる場合だ。自律的な編集を望むなら、モデルを、実際に使用するエージェントと権限と併せて評価する。
デバッグとリファクタリングにはどのAI APIを使うべきですか?
エンドポイントとコード取り扱いの要件に合う候補を絞り、自分の仕事から小さなバグと制約のあるリファクタリングを使用する。タスクAは正しさと入力の変更をチェックし、タスクBはパースとインターフェースの維持をチェックする。その後、代表的なリポジトリテストを続ける。
単に最長の説明や最も広範な書き直しを生み出すものではなく、管理可能なレビュー労力で受け入れ条件を満たす候補を優先する。
コーディング向けの無料AI APIはありますか?
トライアルクレジット、無料枠のあるアプリケーション、ダウンロード可能なモデルの重みは、それぞれ異なるオファーである。いずれも、アプリケーションに無制限のホスト型推論を自動的に与えるものではない。無料アクセスを前提に予算を組む前に、現在の資格、有効期限、クォータ、サポートされるモデルを確認する。本記事は、現在利用可能な無料枠を主張するものではない。
自分で重みをホストする場合は、重みのダウンロードが無料であっても、コンピューティングと運用を考慮に入れる。
プライベートリポジトリのコードをコーディングAPIに送信できますか?
特定のサービスに適用される条件のもとで、組織が共有を許可するコードのみを送信する。選択したデプロイについて、保持、トレーニング利用、アクセス制御、契約要件を確認する。
認証情報と無関係なファイルを削除し、エージェントがプロンプトとログに自動的に何を含めるかを確認する。オープンウェイトモデルや見慣れたAPI形式だけでは、ホスト型サービスがチームの機密性要件を満たすことの証明にはならない。


