リクエストは正常に返ってくる。それでもアプリケーションには使える画像がない。おそらくレスポンスにはタスクIDが含まれているか、完成した画像に余計なオブジェクトが写り込んでいてページに使えないのだ。
開発者向けの生成AI APIを使えば、アプリケーションからモデルに入力を送り、生成されたコンテンツを受け取れる。必要な入力、出力形式、待ち時間、受け入れ基準を軸に選定しよう。そのうえで、レスポンスをユーザーが使えるものに変えるジョブ処理とチェックを実装する。
本ガイドでは、画像ワークフローを選定から配信まで追う。タスク選定表、JavaScriptとPythonの対応例、3つの具体的な画像ブリーフ、コスト計算ワークシートを紹介する。同じ意思決定プロセスはテキストや動画にも当てはまるが、プロトコルと出力チェックは異なる。
主なポイント
- モデルより先にタスクと受け入れ基準を決める。
- 非同期タスクIDを保存し、中断した作業を再開できるようにする。
- 却下された生成も含め、受け入れ済み出力あたりのコストを測る。
- 完成結果を表示する前に、ファイルと業務上の制約をテストする。
開発者向け生成AI API:何をするものか
生成を行うのはモデルだ。APIは、ソフトウェアがその処理をどうリクエストするかを定義する。SDKは言語固有のヘルパーでインターフェースをラップする。ホスト型プラットフォームはモデルへのアクセスを運用し、アプリケーション側はユーザー体験、権限、結果を受け入れるルールを提供する。
こうした区別は、製品ページを読むときに重要になる。画像を生成するチャットアプリがあっても、その開発者向けエンドポイントが同じ入力を受け付けるとは限らない。便利なメソッドを持つSDKがあっても、その背後にあるレスポンスと失敗状態を理解する必要性がなくなるわけではない。
まず次のタスクマップから始めよう。「検討するインタラクション」列は評価すべきアプリケーション設計を示すものであり、すべてのプロバイダーがそのモードをサポートするという約束ではない。
| タスク | 入力 | 必要な機能 | 出力 | 検討するインタラクション | 受け入れ基準 |
|---|---|---|---|---|---|
| サポート返信の下書き | チケットと承認済みヘルプコンテンツ | グラウンディングされたテキスト生成 | 下書きテキスト | 同期またはストリーミング | チケットに回答している。ポリシーを捏造していない |
| 文書フィールド抽出 | 文書テキストまたは対応ファイル | 構造化抽出 | JSONフィールド | リクエストまたはキュー投入ジョブ | 有効なスキーマと根拠 |
| 記事用イラスト | 文章によるビジュアルブリーフ | テキストto画像 | 画像ファイル | 非同期ジョブ | 正しいオブジェクト、レイアウト、寸法 |
| 画像編集 | 元画像と指示 | 画像条件付き編集 | 編集済み画像 | 非同期ジョブ | 要求された変更。保持された詳細 |
| 動画生成 | プロンプトまたは対応する参照 | 動画生成 | 動画ファイル | キュー投入ジョブ | 正しい長さ、動き、必要なら音声 |
| 検索支援回答 | 質問と取得したパッセージ | 検索と生成 | 回答と参照 | 同期またはストリーミング | 取得したパッセージに裏付けられた主張 |
画像生成、アップロード画像の分析、既存画像の編集は別々の機能だ。それぞれを明示的に確認する。同様に、動画エンドポイントは開始フレームに対応していても、任意の複数画像参照には対応していないことがある。
埋め込みは入力をベクトルに変換し、検索や類似度計算に役立てる。回答を生成する前に、関連文書を見つけるのに使える。ただし、埋め込み自体が回答を生成したり、取得したコンテンツがその主張を裏付けていると証明したりするわけではない。
実務上の境界は、入力 → リクエスト → 出力 → アプリケーションの受け入れだ。最終段階を担うのは自社である。生成された請求書フィールドにはなお検証が必要で、画像には目視確認が必要であり、サポート回答には、そこに含まれる約束をする権限が依然として必要だ。
プロトコルの選択肢もさまざまだ。Googleのリファレンスは、標準生成、ストリーミング、ライブインタラクションを区別している。これはインタラクションモードが異なる証拠として受け止め、他の場所でも同じサポートがあると仮定しないこと。(Google Gemini API reference、2026年9月参照。)
開発者向け生成AI API:選び方
カタログを比較する前に、小さな受け入れブリーフを書こう。記事用画像機能なら、横長出力、オブジェクト数の上限、目立つブランド表記なし、人によるレビュー工程などを指定する。チケット分類なら、固定ラベルセットと明示的な「不確実」結果を指定する。
候補は次の順で評価する。
- 入力と出力。 対応ファイル、入力上限、出力形式、参照画像の挙動について、正確なモデルエンドポイントを確認する。モデルファミリー名は広すぎて契約仕様にはならない。
- タスク準拠。 扱いにくいものも含め、代表的なブリーフを試す。制約違反はファイルやネットワークの失敗とは別に数え、何を直す必要があるかを把握する。
- 統合の適合性。 認証、レスポンスのエンベロープ、タスクステータス値、クライアントライブラリのサポートを確認する。これらを既存バックエンドに適合させる作業も含める。
- 待ち時間と同時実行。 ユーザーが離席して戻れるかを決める。短い期限のインタラクティブ体験にコミットする前に、想定されるワークロードをテストする。
- 課金の明確さ。 課金単位と、それを変える設定を特定する。すべての送信リクエストが同じ料金になると思い込まず、失敗時と返金の扱いを確認する。
- データ要件。 入力の扱い、保持、削除、適用される規約を、実際に送信する予定のデータと照らして確認する。機密性の高い素材を使う前に、未解決の疑問を文書化する。
- 変更管理。 リグレッションセットを維持し、モデル識別子、プロンプト、パラメータを記録する。更新や差し替え後に挙動をどう再評価するかを計画する。
組織的なガイダンスは、アクセスとデータのルールがなぜこの判断に含まれるかを示している。ハーバード大学は、AI開発者ツールに関する承認済みアクセス経路と制限を説明している。これはハーバードの取り決めであり、あなたのアプリケーションに普遍的に適用される許可ではない。(Harvard University Information Technology、2026年9月参照。)
| アクセス経路 | 適したチーム | 統合作業 | 運用責任 | 主な制限 | 選択前に確認する項目 |
|---|---|---|---|---|---|
| 直接モデルプロバイダー | 1社のプロバイダーの機能を中心とするチーム | プロバイダー固有のAPI、アカウント、アダプター | 自社のアプリとジョブ、プロバイダーの推論 | 追加プロバイダーごとに別々の契約が必要 | エンドポイント機能、リージョン、クォータ、規約 |
| マルチモデルのホスト型プラットフォーム | 複数の対応モデルを評価するチーム | 共有アクセスに加えモデル固有の検証 | 自社のアプリとジョブ、プラットフォーム上の推論 | 共有アクセスはすべてのパラメータを標準化するわけではない | 正確なモデル、スキーマ、課金、データ経路 |
| セルフホストのオープンモデル | インフラとモデルサービングのスキルを持つチーム | 推論のデプロイ、公開、セキュリティ確保、保守 | ハードウェア、サービング、スケーリング、監視、更新 | キャパシティとエンジニアリングのオーバーヘッド | ライセンス、ハードウェア適合性、スループット、保守 |
Atlas Cloud は、複数のモデル機能を同じアプリケーションにまとめたいときに検討できるホスト型の選択肢のひとつだ。本記事では、その画像タスクインターフェースを具体例として使う。それでも各モデルの入力と出力は検証する必要があり、モデルIDを変えるだけでは不十分だ。
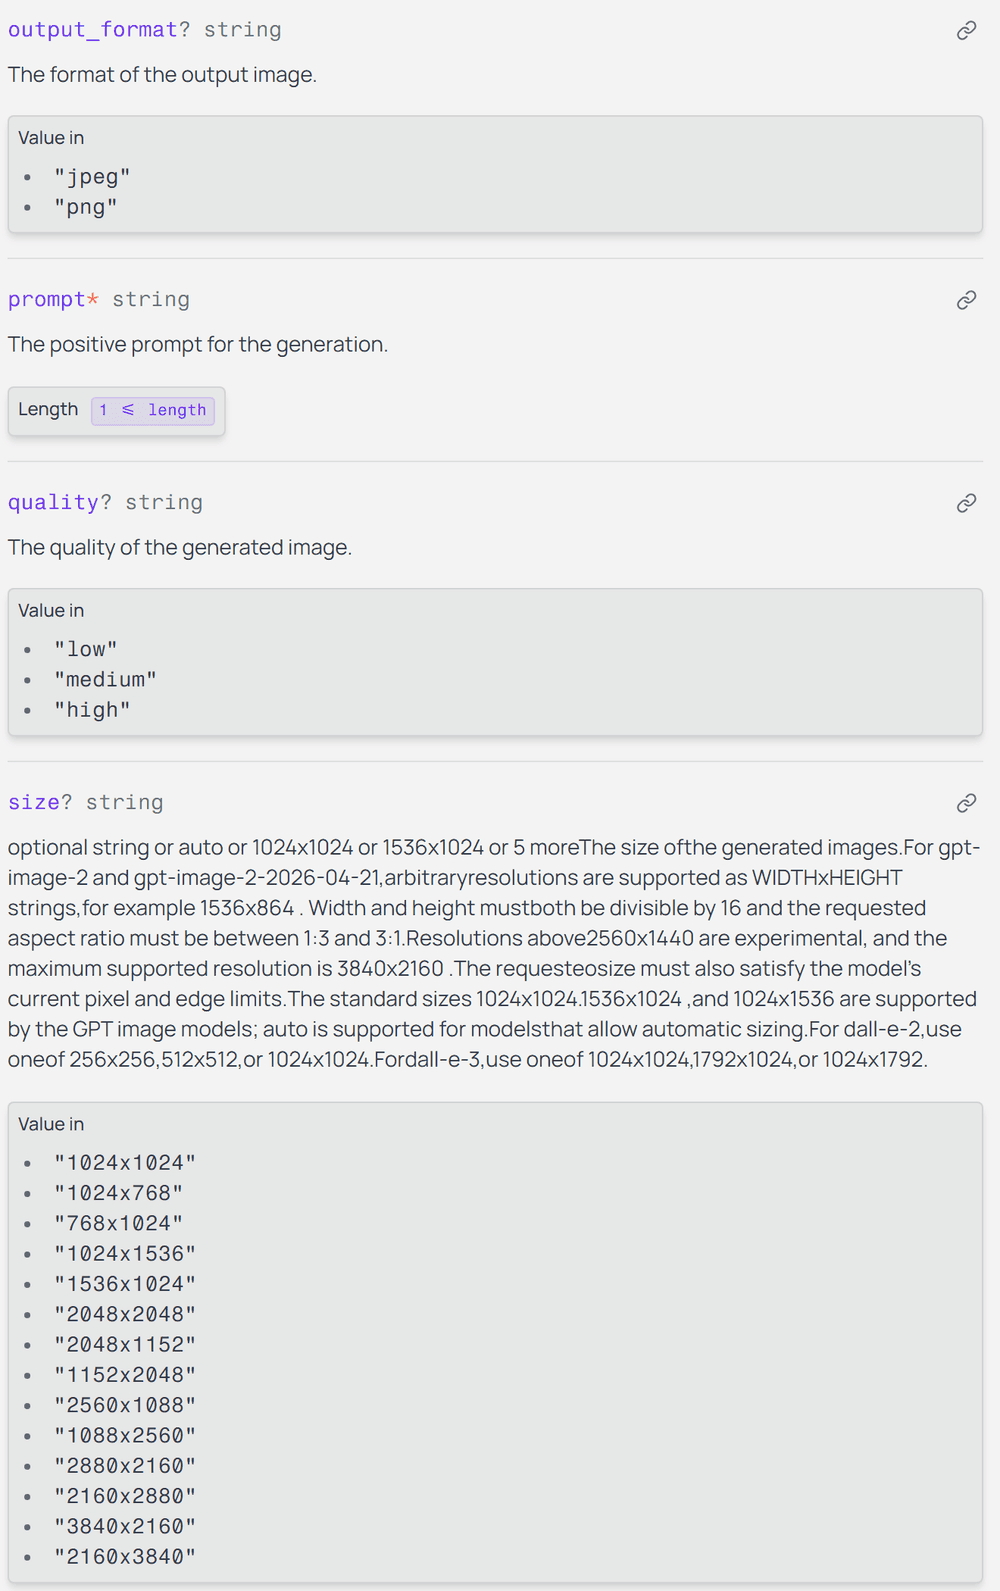
出力形式、品質、サイズ制約を示す公式の画像エンドポイントドキュメント
モデル固有のパラメータは統合契約の一部だ。リクエストボディを再利用する前に、許容値を読んでおこう。
小規模なSaaSチームにとって有用な比較は、受け入れ済みの結果を1つ提供するまでの総工数だ。推論料金に加え、アダプターコード、サポート調査、レビュー時間、移行テストを含める。そうすれば、便利なプロトタイプが高コストな本番ワークフローを覆い隠すことを防げる。
開発者向け生成AI API:最初のリクエスト
例ではGPT Image 2 Text-to-Imageを、モデルID openai/gpt-image-2/text-to-image で使用する。そのエンドポイントドキュメントには quality: high、size: 2048x1152、output_format: png が記載されている。以下で使う設定はこれらだ。
1. プレイグラウンドでプロンプトを固める。 参照画像を追加せず、以下の朝食ブリーフを使う。Runを押す前にモデル名と確定した設定を確認する。フィールドを離れると元に戻る選択は、要求した設定ではない。
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. 認証はサーバー側に置く。 フロントエンドは自社バックエンドにジョブ開始を依頼すべきだ。ATLAS_API_KEY はサーバー環境に保存する。ブラウザのJavaScript、画像URL、クライアントに表示されるログには絶対に含めない。ATLAS_API_HOST は api.atlascloud.ai に設定する。これはホスト名で、スキームやパスは含まない。
3. 1回だけ送信し、IDを永続化する。 ドキュメント化された生成ルートは POST /api/v1/model/generateImage だ。data.id を読み取り、アプリケーションのジョブに対応付けて保存する。送信レスポンスを失った場合は、課金対象になり得るタスクを新たに作る前に調査する。
4. 保存したジョブをポーリングする。 GET /api/v1/model/prediction/{prediction_id} を問い合わせる。prediction documentation には processing、completed、failed が説明されており、出力URLは data.outputs に含まれる。completed ステータスでも、出力配列が空でないかを確認すべきだ。
5. ダウンロードして検証する。 ファイルを自社管理下に保存し、デコードできることを確認し、ブリーフと照らして検査する。それから初めて、受け入れ済み結果をアプリケーションに返す。ダウンロードや検証のエラーは、既存のジョブに紐づけたままにしておくべきだ。
以下のコードは公式インターフェースドキュメントから組み立てたもので、実際のAPIベンチマークとして提示するものではない。本記事のメディアワークフローは、APIキーではなくブラウザのテストプレイグラウンドを使用している。
朝食プロンプトをそのまま prompt.txt として保存する。Node.jsなら、組み込みの fetch がある環境を使い、sharp をインストールし、これを generate.mjs として保存する。専用の作業ディレクトリで実行する。意図的に2つのジョブを作らない限り、2つの言語例のうち片方だけを実行すること。
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
より短いPython版は requests と Pillow を使い、同じ prompt.txt と同じ設定を用いる。PREDICTION_ID を受け付けて再開もできる。これらのスクリプトはローカルの1ジョブを示すものであり、デプロイされたサービスには永続的なジョブ記録と上限付きダウンロードが必要だ。
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
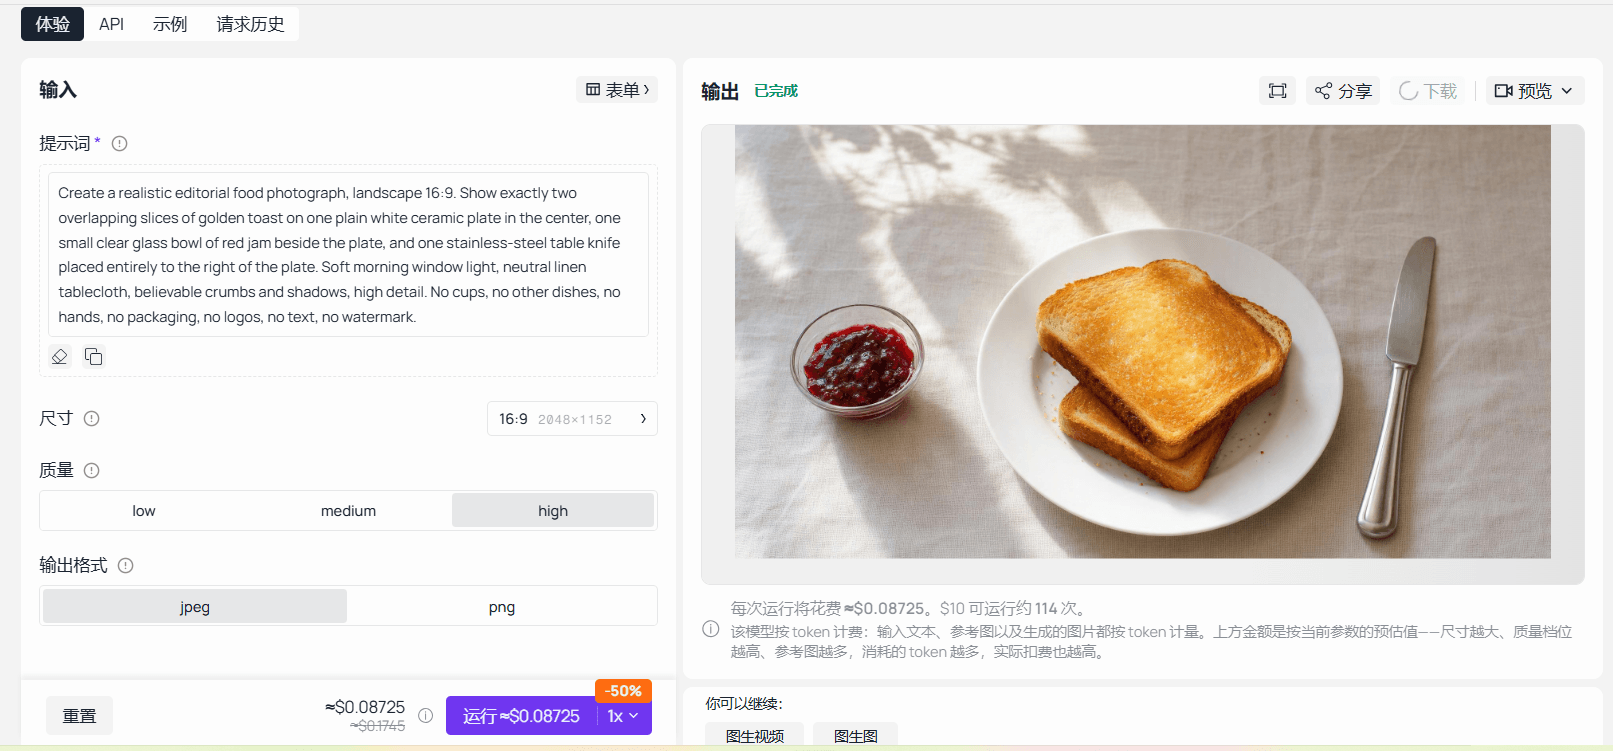 送信された朝食プロンプトと完成した出力を示す、完了したGPT Image 2プレイグラウンド
完了したプレイグラウンド実行では、送信したプロンプト、出力サイズ、品質設定、生成結果がまとめて記録される。
ポーリングの期限は、このクライアントが待つのを止めるだけで、サーバー側の処理をキャンセルするものではない。すでに実行中のリクエストはポーリング期間の後に完了することがあるため、これは厳密なエンドツーエンドのレイテンシ保証ではない。IDを保持し、後でワーカーが確認できるようにしておく。
開発者向け生成AI API:実用的な用途
以下の3つのブリーフは、それぞれ異なる要件をテストする。独立したリクエストであり、ある結果が次の入力になる連鎖ではない。ブリーフの違いを理解しやすいよう、同じモデルと同じ要求設定を使う。
A. フード記事用画像:数と配置。 朝食プロンプトは、出力にトースト2枚、皿1枚、ジャムボウル1つ、ナイフ1本が含まれるかをテストする。ナイフは皿の右側にあり、必要なオブジェクトはすべてフレーム内に収まっていなければならない。
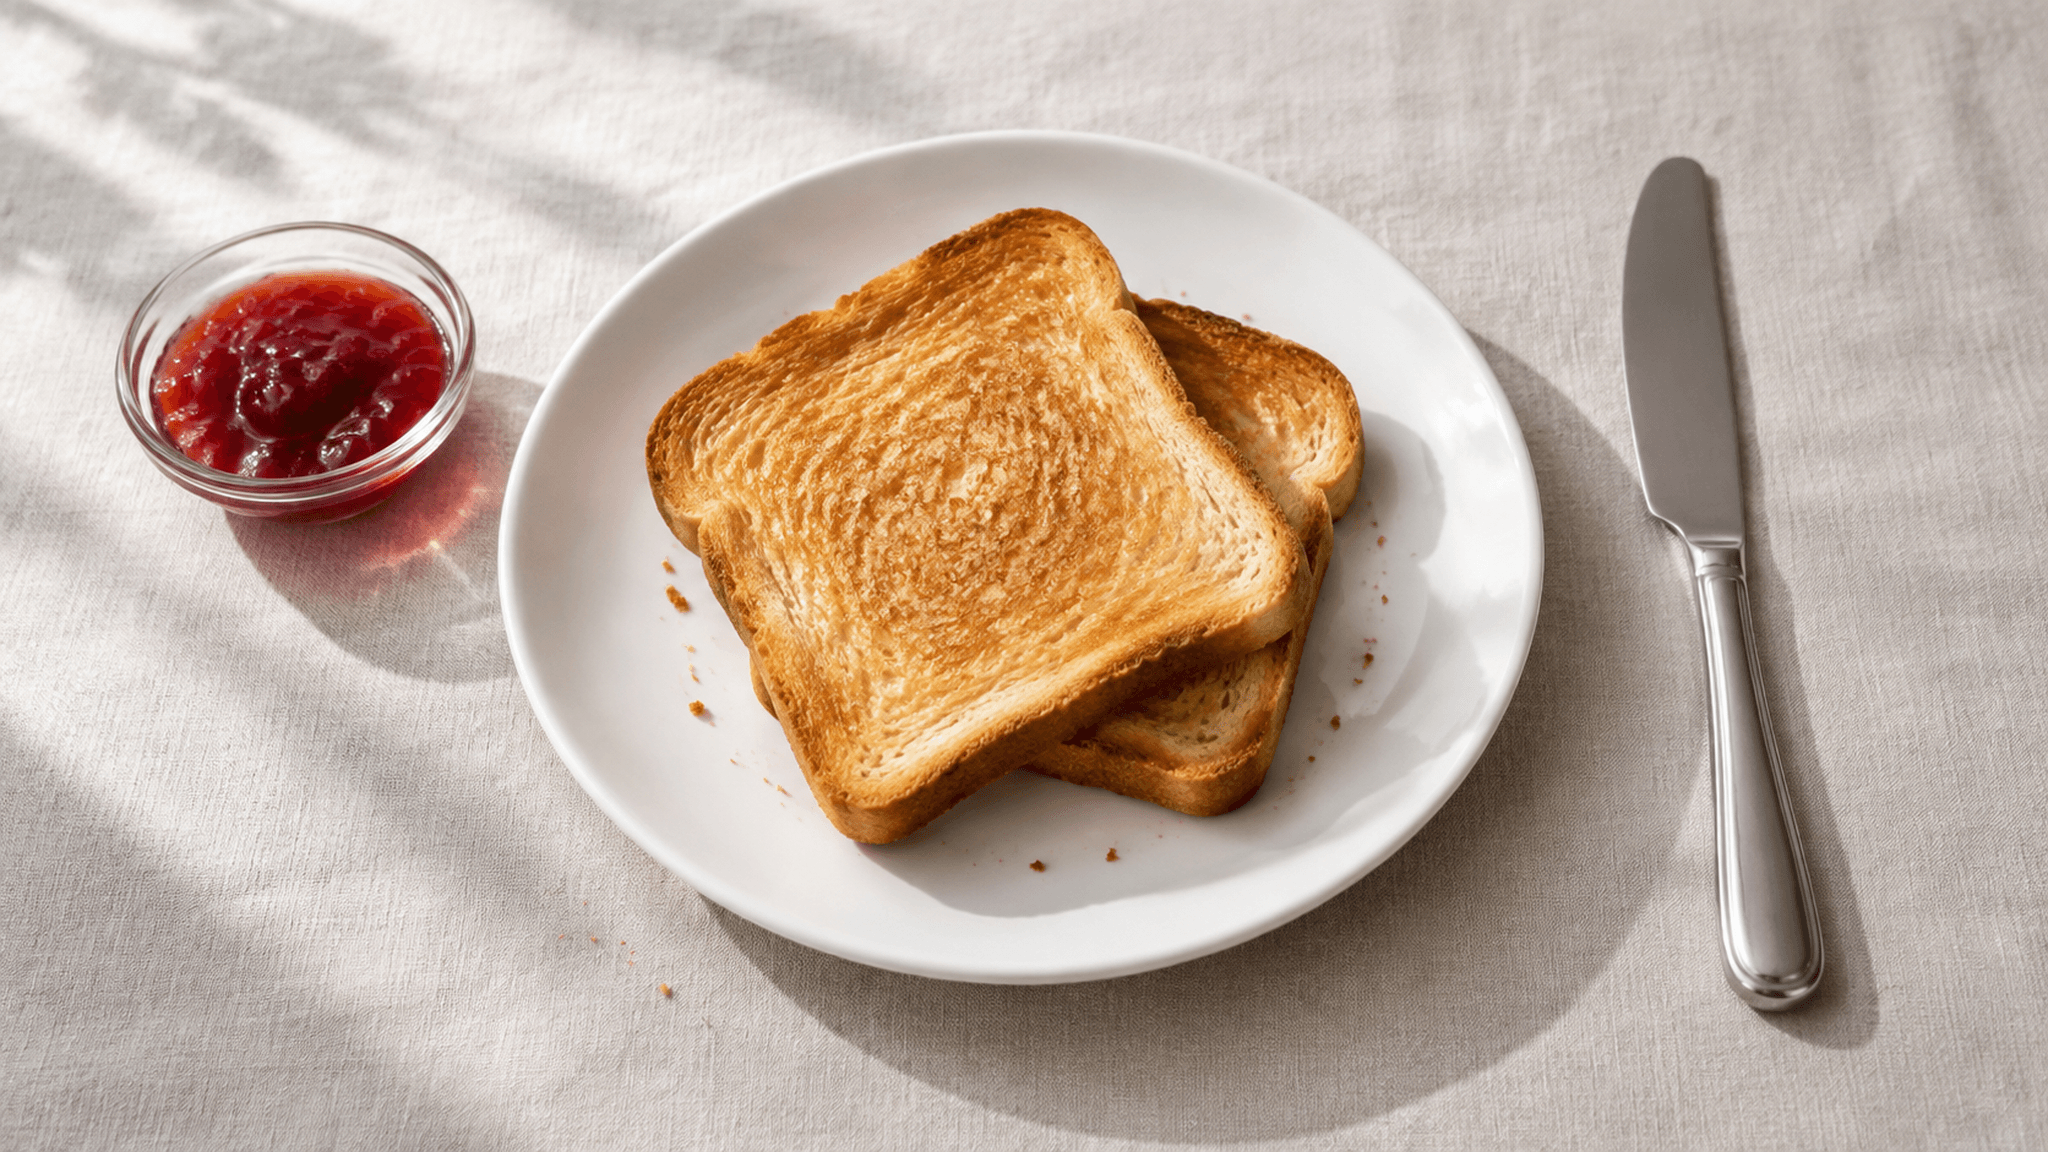
朝食画像生成の例と、オブジェクト数およびナイフ配置のチェックsThe 要求された皿、トースト、ジャムボウル、右側のナイフが生成結果に含まれており、以下の配置レビューに進める状態になっている。
重なり合ったスライスは1枚ずつ検査する。見た目に説得力のある朝食でも、背景にカップが写り込んだり、ナイフが皿の上に移動していたりすれば不合格になる。結果が不合格なら、曖昧な空間指示を修正し、変数を1つだけ変え、却下理由を残す。漠然と「もっと良い画像」を繰り返し要求するのは避ける。
B. 記事カバー:使える見出しスペース。 このリクエストでは、構図をレイアウト上の依存要素として扱う。ページ編集者は左側に空白が必要で、右側には道具と鉢を配置する。実際のタイトルは後からHTML/CSSで追加し、編集可能で読みやすい状態を保つ。
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
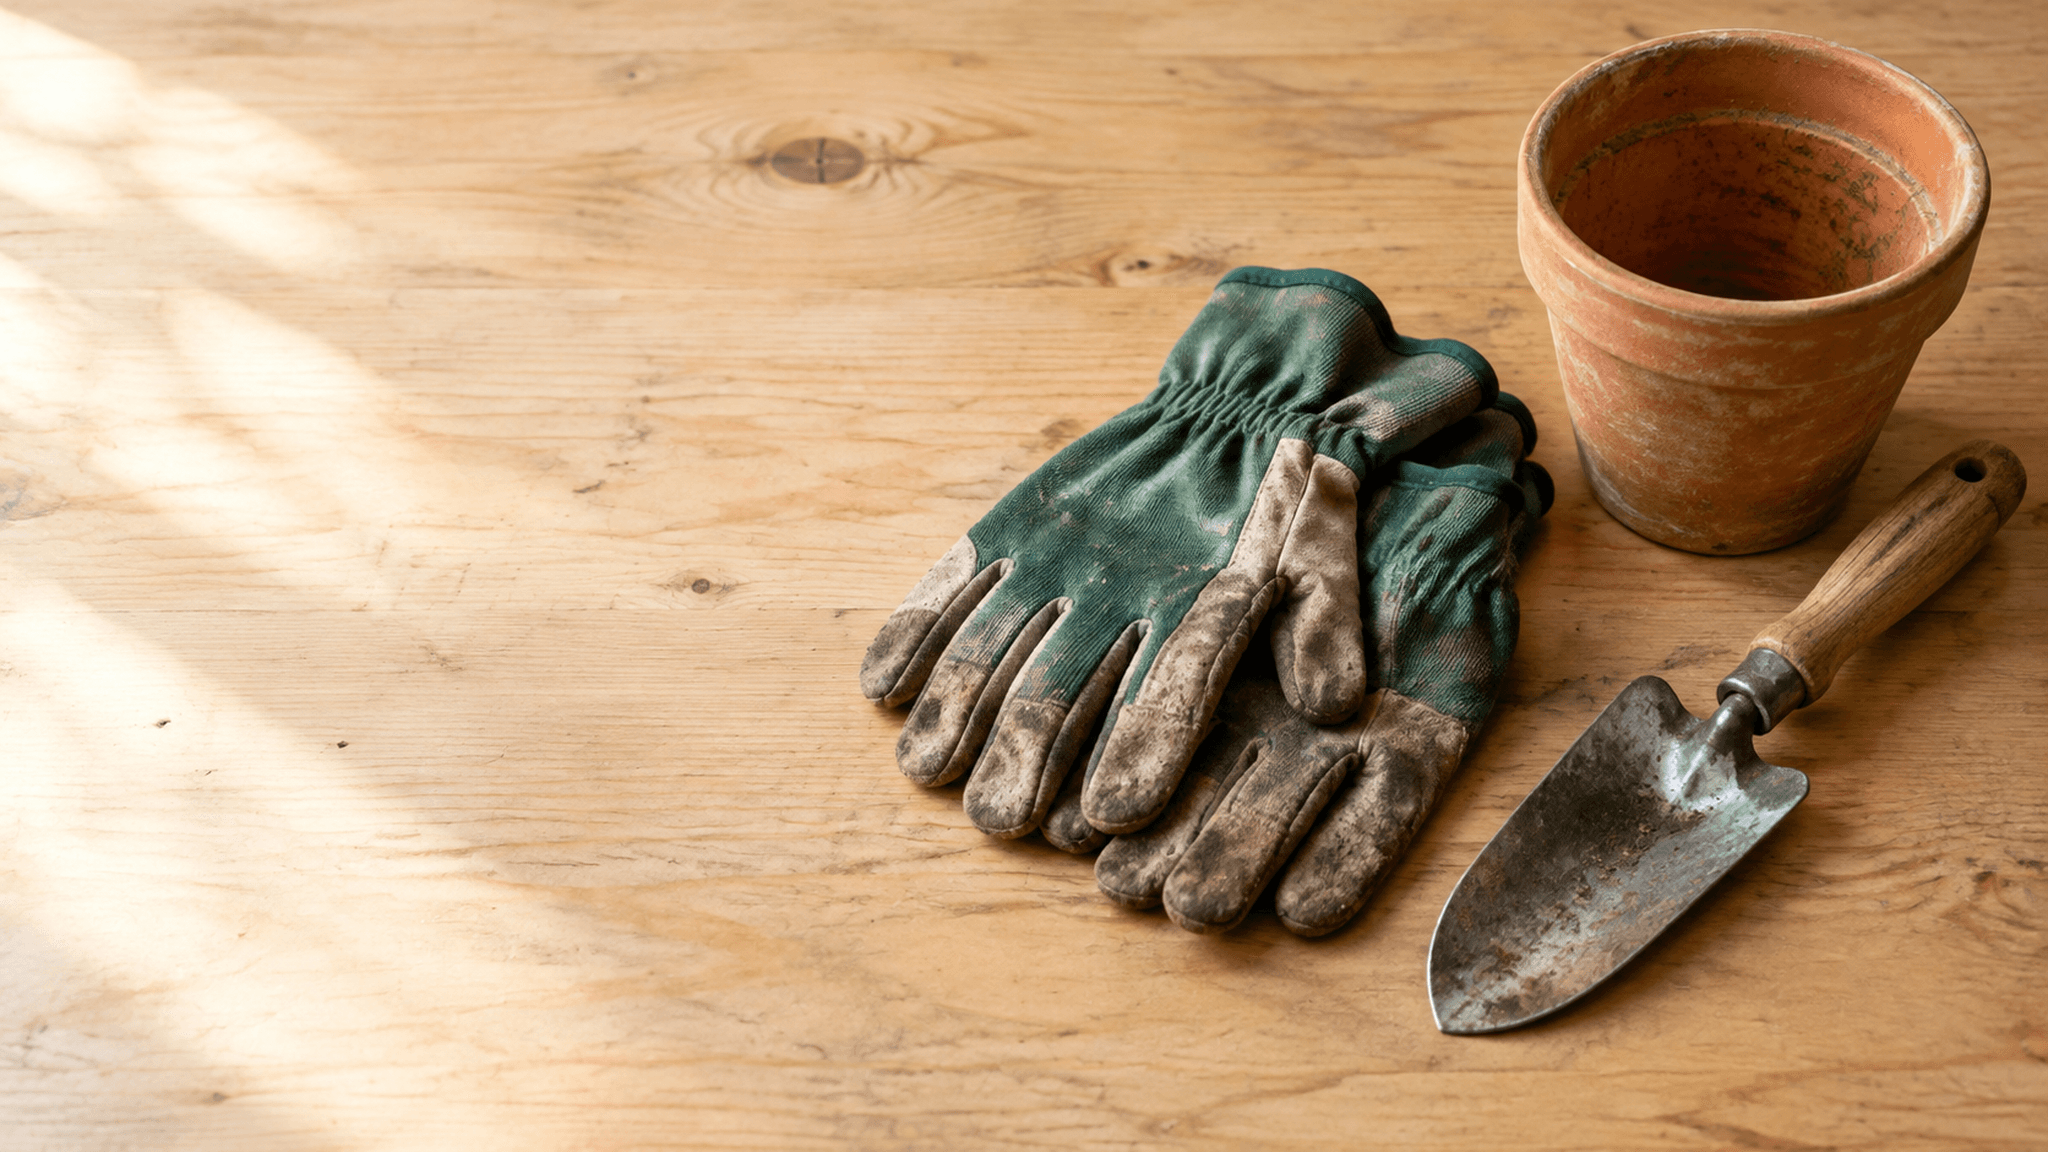 左側に要求した見出しスペース、右側にオブジェクトを配置したワークベンチカバーの例
結果は左側に使える空白を保ちつつ、手袋、鉢、移植ごてを右側に維持している。
結果は、意図した公開時のクロップで確認する。横長のマスター画像は、モバイルカードが中央でクロップすると、有用な空白領域を失うことがある。構図が不合格なら、オブジェクトの境界をより厳密に指定するか、アプリケーション側のクロップを変更する。要求した被写体の上にテキストを置いて失敗を隠してはいけない。
C. 布地イラスト:ディテールと順序。 次のリクエストでは、見分けのつくテクスチャが見える折りたたまれた布見本を3つ要求する。数、位置、そして読者が見るサイズで説明的なイラストとして機能するかをテストする。
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
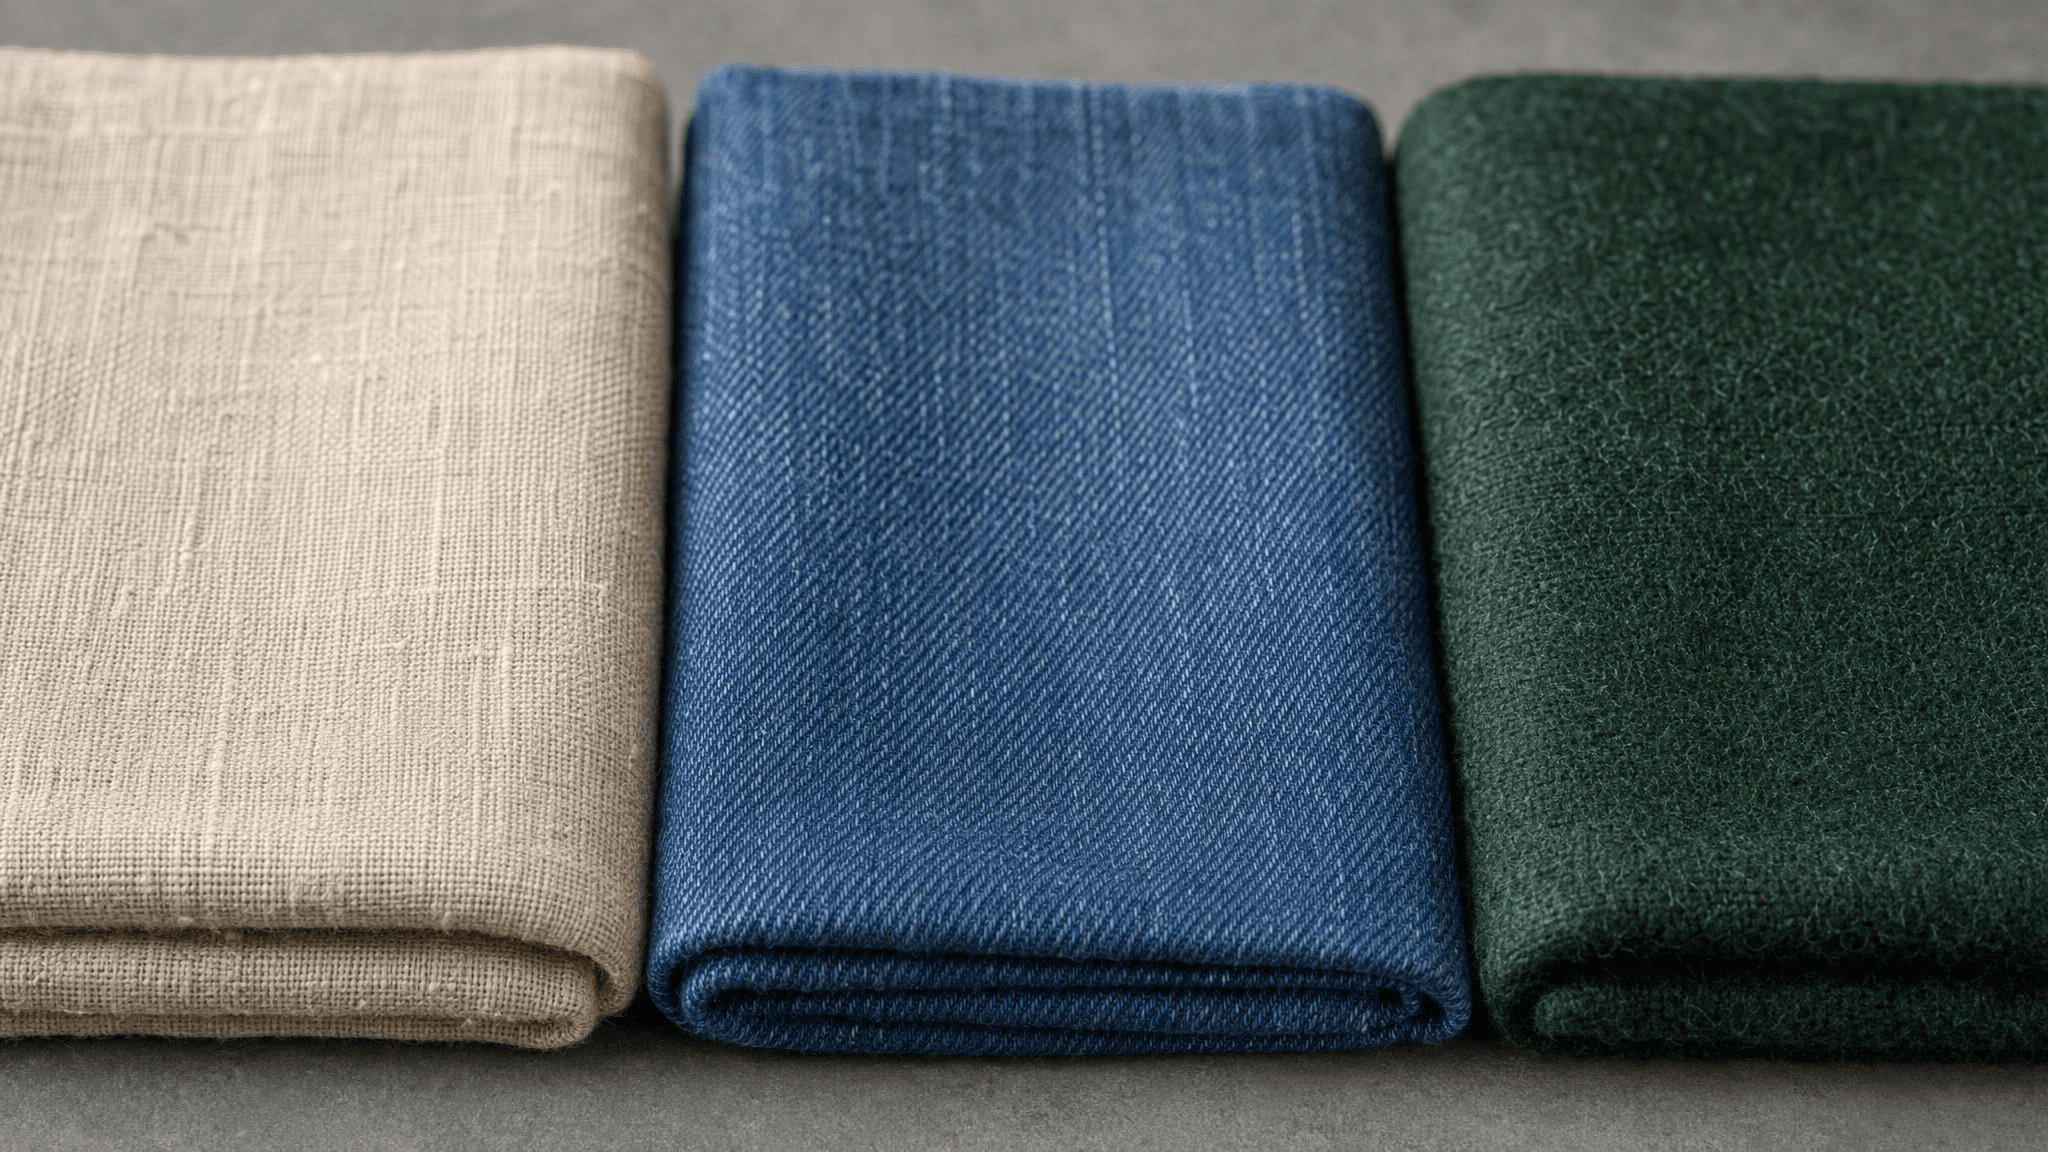 ベージュ、ブルー、ダークグリーンの布見本の配置チェックを伴うAI生成の布地イラスト
要求した3つの布見本は視覚的に区別できる。この生成されたテクスチャはイラストであり、実在製品の繊維組成の証拠ではない。
中央の布見本に読み取れる織り目がなければ、その問題を記録し、フレーミングかディテール指示を調整する。生成されたテクスチャを、実在製品の測定された特性として説明してはいけない。
テキスト機能にも同様に厳密なチェックが必要だ。チケット分類では、許可されたセット外のラベルを却下し、不確実な場合の経路を用意する。文書抽出では、パース可能なJSONに加えて、フィールドとソースの範囲を必須にする。構文的に有効なレスポンスでも、誤った金額を誤ったフィールドに入れることがある。
開発者向け生成AI API:失敗への対処
トランスポートの成功、タスクの完了、業務上の受け入れは別々に追跡する。成功したHTTPレスポンスが処理中のタスクを含むこともある。完了したタスクが壊れたダウンロードを生むこともある。読み取り可能な画像がブリーフに違反することもある。それぞれ異なる復旧アクションが必要だ。
3つの時間を意図的に設定する。個々のHTTPタイムアウト、ポーリング間隔、全体の待機ウィンドウだ。例では、APIリクエストのタイムアウト30秒、ポーリング2秒、ポーリングウィンドウ10分を使用している。これはアプリケーション側の選択であり、宣伝されているサービス性能ではない。
| 症状 | 考えられる原因 | 次に確認する項目 | 再試行の方法 |
|---|---|---|---|
| パラメータエラー | 未対応のフィールドまたは値 | 正確なエンドポイントスキーマと送信したペイロード | まずリクエストを修正する |
| HTTP 401 | 認証の問題または誤ったルート | キー設定とエンドポイントパス | 変更なしの再試行はしない |
| 残高不足 | 利用可能残高または許容量 | アカウントの請求状態 | まず資金または許容量を解決する |
| HTTP 429 | レート制限に到達 | アカウント/モデルの同時実行数とリクエストレート | ジッター付きの上限付きバックオフ |
| タスクがfailedを報告 | モデル、入力、ポリシーの失敗 | Prediction ID、エラーコード、エラー詳細 | 新たに生成する前に調査する |
| ポーリングタイムアウト | クライアントの期限または遅いタスク | 既存のタスクステータス | 同じIDへの問い合わせを再開する |
| 空の出力で完了 | 結果の欠落または想定外 | 完全な構造化ジョブレスポンス | 調査対象としてフラグを立てる。無闇な再送信はしない |
現在のプラットフォームのエラードキュメントによると、LLMとメディアのエンドポイントは Retry-After や残りのレート制限ヘッダーを提供しない。クライアント側の遅延ポリシーを使うこと。これらのルートが返さないヘッダーに復旧を依存させてはいけない。他のAPIファミリーは異なる挙動をとることがある。
自動読み取り再試行は上限を設ける。指数関数的な遅延に少しのランダムジッターを加えると、多数のワーカーが一斉に再試行するのを防ぎやすくなる。スロットリングが続く場合は同時実行数を減らす。繰り返しの失敗は、スピナーの裏に隠れた無限ループではなく、観測可能なインシデントにすべきだ。
送信の再試行にはより厳格な扱いが必要だ。ボディを送った後に接続が閉じた場合、サーバーがタスクを作成したかどうか分からないことがある。送信前にローカルの意図を記録し、prediction IDが届かないときはリクエスト履歴やサポートのトレースを調査する。エンドポイントがドキュメント化していない限り、冪等性ヘッダーを勝手に作ってはいけない。
IDを取得したら、それを使って再開する。ダウンロードの失敗は、別の画像生成リクエストではなく、再度のダウンロード試行やステータス確認をトリガーすべきだ。例では意図的に、ポーリングの読み取りには自動再試行を残し、送信の失敗では停止するようにしている。
すべてのジョブについて、アプリケーションのジョブID、prediction ID、リクエストID、モデル、設定、タイムスタンプ、最終的な処理結果を保持する。プロンプトは適切なデータポリシーの下でのみ保存する。認証ヘッダーや機密性の高いユーザーコンテンツを一般的なエラーログに入れてはいけない。
フロントエンドには説明可能な状態を与える。準備中、処理中、出力チェック中、準備完了、要対応などだ。誰かがページを再読み込みしたときは、復旧可能なジョブを表示する。同じローカルジョブが保留中の間は再送信を無効にしつつ、適切な場合は意図的な新規リクエストを許可する。
開発者向け生成AI API:実際のコスト
リクエスト単価が安いだけでは、使える機能のコストは分からない。予算には、課金された金額、受け入れ済み出力の数、それらを提供するために必要な付随作業が必要だ。
テキストAPIは一般に、入力トークンと出力トークンを区別する。長いコンテキスト、取得したパッセージ、会話履歴、繰り返しのレスポンスはいずれも利用量に寄与し得る。すべてのワークロードに単一のトークン見積もりを当てはめるのではなく、選択したエンドポイントが実際に課金するカテゴリを記録する。
画像では、正確なモデルの課金単位と構成を確認する。サイズと品質が課金に与える影響はモデルごとに異なる。動画では、長さ、解像度、モデルの選択が料金を変え得る。カタログの最低価格を、特定の構成の見積もりにしてはいけない。
本記事の調査中、選択した画像モデルの高品質・2048×1152の正確な価格を、カタログと詳細ページの両方で確認することはできなかった。ここでは現在の単価や割引を主張しない。有料の本番評価を実行する前に確認すること。
2つの関連する計算を使う。
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
観測期間は一貫させる。継続的なストレージについては、その計算が最初の1か月、定義された保持期間、割り当てられた経常コストのどれを対象とするかを明示する。あるモデルの推論のみの数値と、別のワークフローの総コストを比較するのは避ける。
仮の例: 100件のリクエストを送信し、80件の出力を受け入れたとする。そのバッチの実際の総課金を80で割る。100件すべてのリクエストに同一の金額 c が課金された場合、受け入れ済み出力あたりのAPIコストは 1.25c になる。この条件は重要だ。すべての失敗リクエストが課金されるとは仮定していない。
| モデル | 設定 | 送信数 | 実際の課金 | 受け入れ済み出力 | 受け入れ済み出力あたりのAPIコスト | 測定日 |
|---|---|---|---|---|---|---|
| GPT Image 2 Text-to-Image | high; 2048x1152; PNG | 記録する | 記録する | 記録する | 計算する | 記録する |
| 同じモデル、次の評価バッチ | 正確な設定を記録 | 記録する | 記録する | 記録する | 計算する | 記録する |
これは結果表ではなくワークシートとして使う。画像のデモは、代表的な受け入れ率や本番コストを立証するものではない。特にテスト環境で評価する場合は、プレイグラウンドの見積もりと確定した課金記録を分けておく。
受け入れ済み出力がゼロの場合は、そのバッチを不成功として報告し、総支出を示す。その場合、受け入れ済み出力あたりのコスト比は定義できない。失敗したバッチを隠すと、予算がアプリケーションの実態より良く見えてしまう。
まず無駄を減らす。送信前に入力を検証し、ジョブIDを保存し、偶発的な重複を防ぎ、製品が許す場合は受け入れ済みアセットを再利用する。そのうえで、同じブリーフとチェックでより安価な設定を比較する。見積もりを下げても却下作業が倍増する設定は、機能コストを増やしかねない。
レスポンスだけでなく出力をテストする
プロンプトを書く段階で受け入れ基準を書く。そうすれば、説得力のある画像が後から成功の定義を変えてしまうのを防げる。必須要件は任意の好みと分けておき、レビュアーが結果を却下した理由を記録する。
機械的に明確な答えがあるチェックは自動化する。ダウンロードの成功、ファイルのデコード、形式、寸法、ファイルサイズの上限などだ。JSONでは、スキーマ、必須フィールド、許可されたラベル、型を検証する。欠落した必須フィールドが、いつの間にか捏造されたデフォルト値になってはいけない。
解釈を要する要件には人によるレビューを使う。朝食の例では、レビュアーは重なったスライスを区別し、ナイフを特定し、その位置を評価し、余計なオブジェクトがないか探す必要がある。自動のビジョンチェッカーは補助になるが、それ単独で結果を承認させる前に、その誤りを評価する。
朝食のレビューには、次の独立したチェックを含めるべきだ。
- トーストはちょうど2枚、白い皿1枚、透明なジャムボウル1つ、ナイフ1本。
- ナイフは皿の右側。必要なオブジェクトはすべてフレーム内。
- 余計なカップ、皿、手、パッケージ、目立つブランド表記がない。
- 要求した寸法の読み取り可能なPNG。
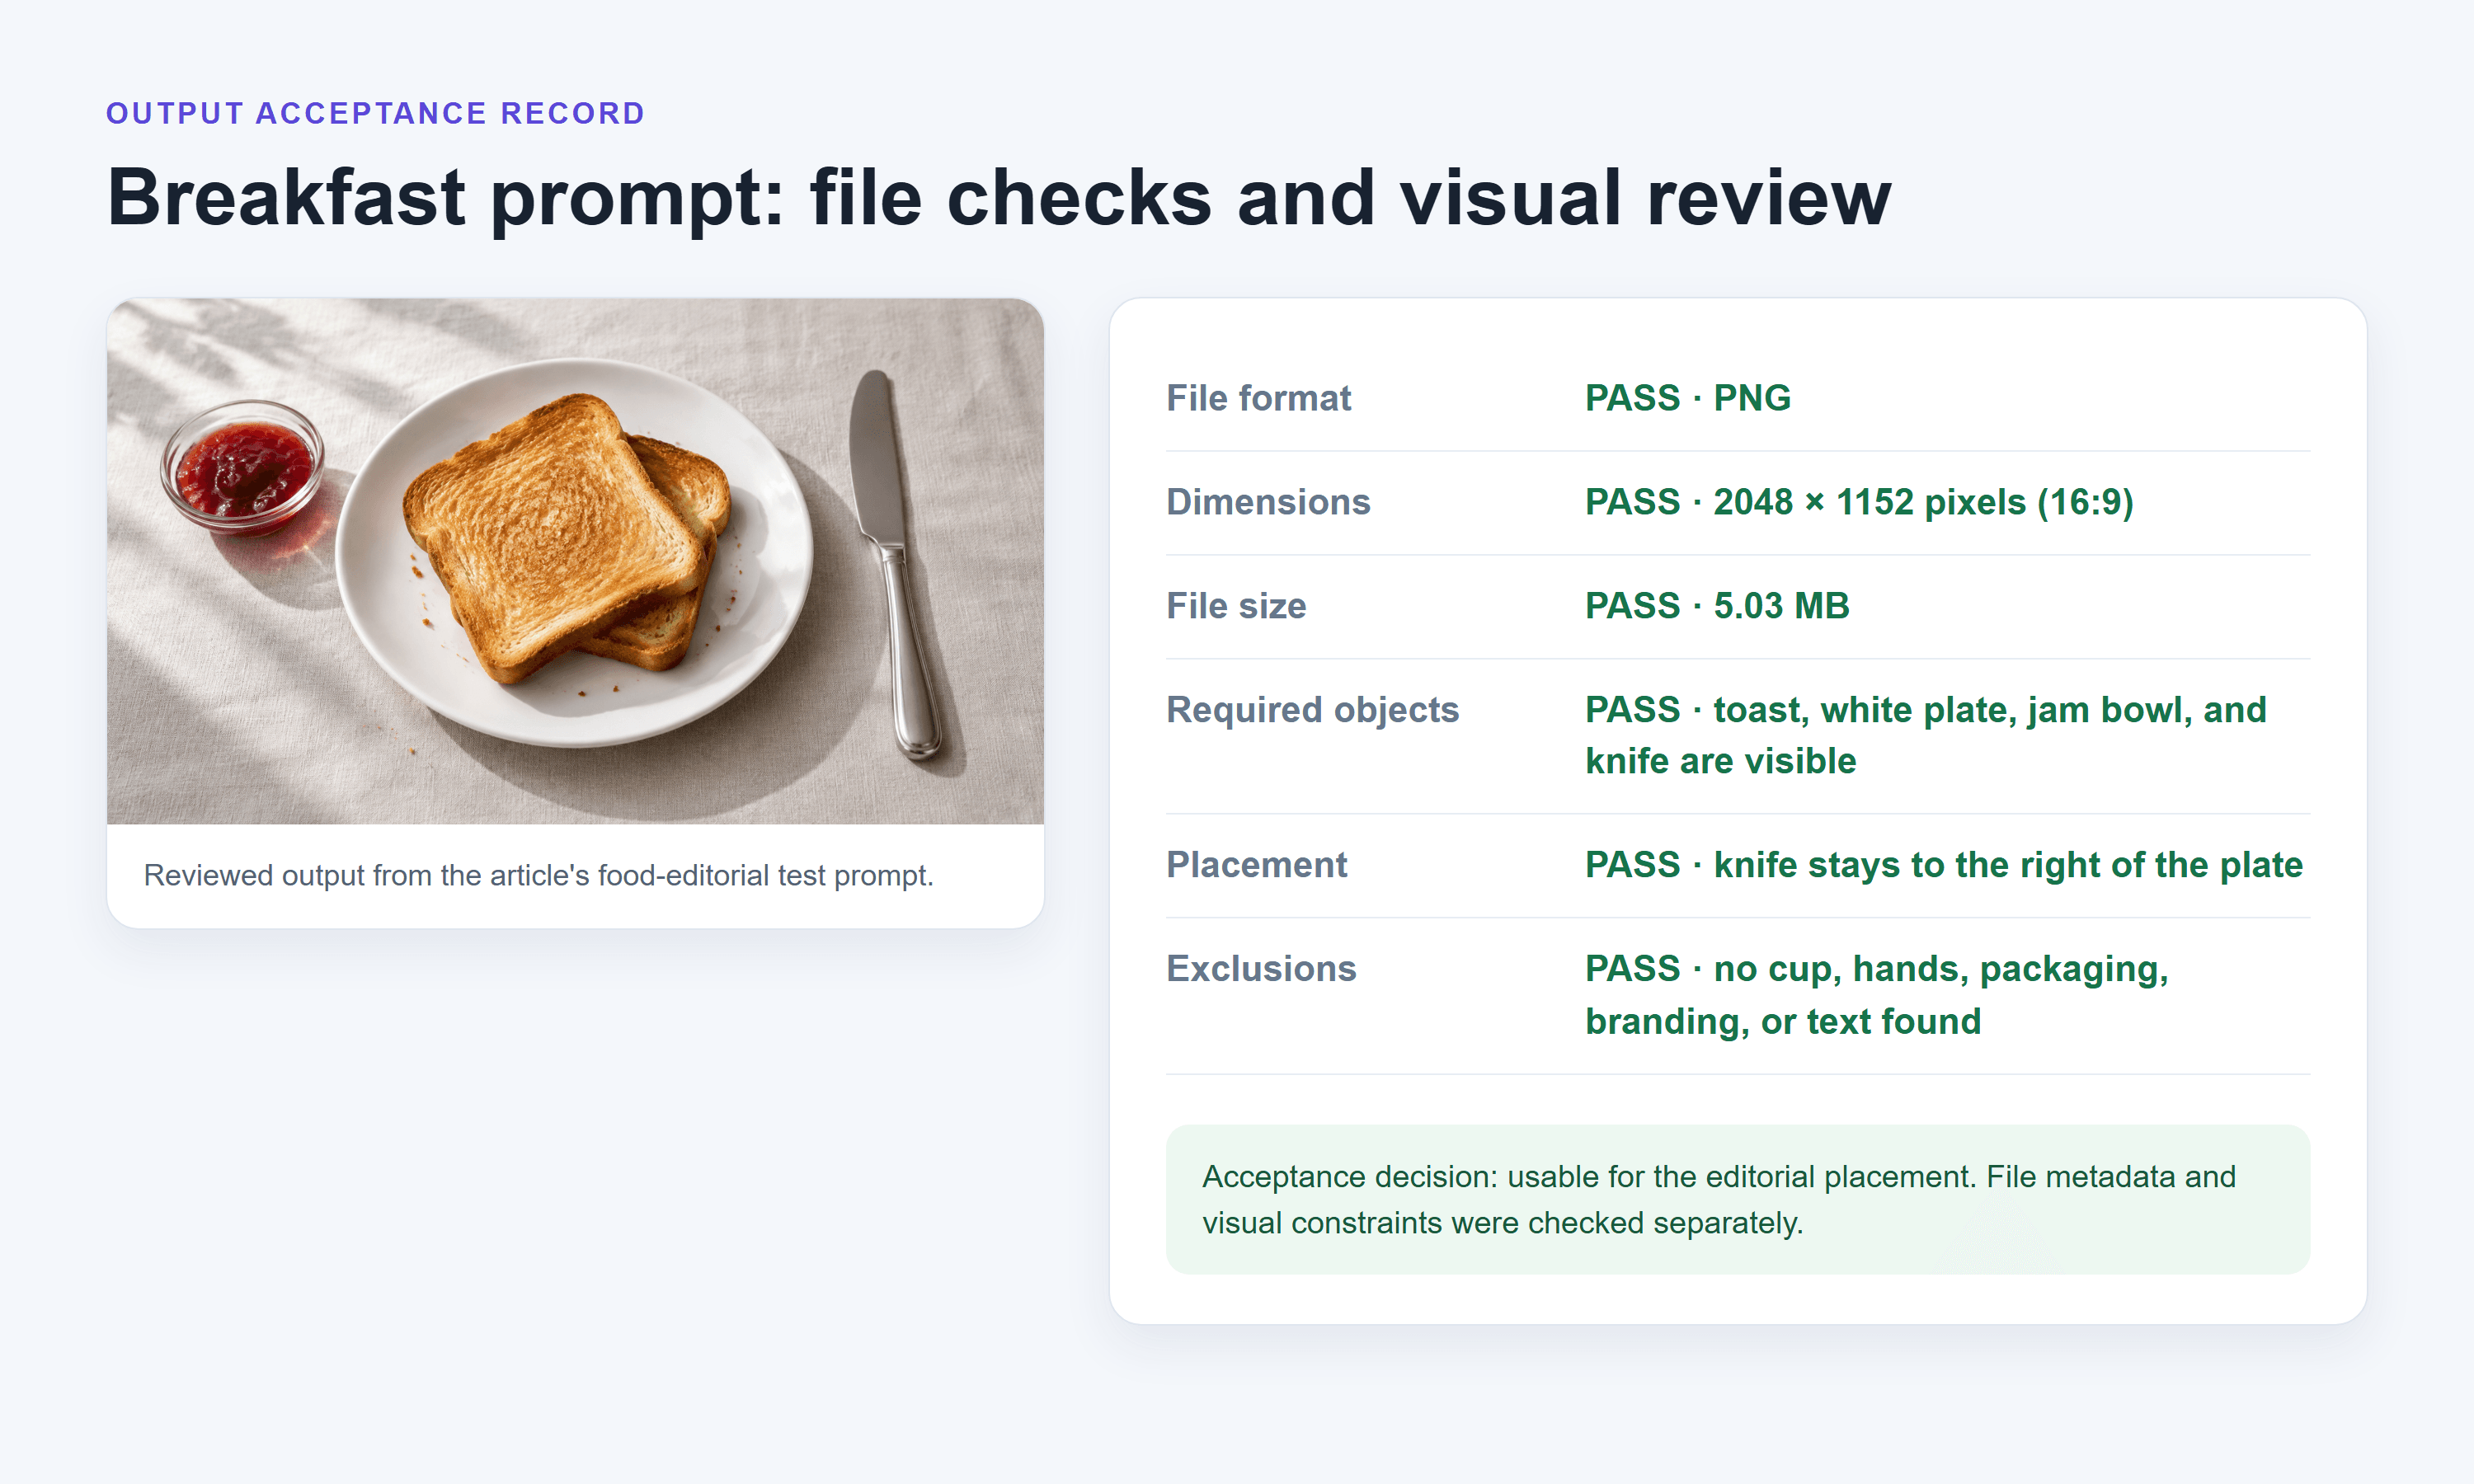 ファイルメタデータのチェックと視覚的な受け入れチェックを分けた検証記録
この記録は、生成ファイルの実際の寸法とサイズを、視覚的な受け入れチェックとは別に報告している。
実際の機能から固定のリグレッションセットを構築する。通常のリクエスト、混み合った構図、矛盾する指示、難しいクロップ、関連する入力上限などだ。ブリーフとレビュアルールはバージョン管理する。モデル、プロンプトテンプレート、出力設定を変更するときは繰り返し実行する。
技術的な成功と受け入れ済み出力率は別々に報告する。余計なオブジェクトを含む読み取り可能なファイルは、配信の成功であり、コンテンツの却下でもある。それらの結果を1つの成功率にまとめると、チームに必要な修正が覆い隠される。
2025年の開発者調査では、46%がAIツールの正確性を信頼しておらず、33%が信頼していると回答した。高い信頼を報告したのは3%だった。これらの回答は開発ワークフローにおけるAIツールに関するものであり、生成APIの測定された失敗率ではない。(Stack Overflow Developer Survey、2025年。)
同様に、3回の例示的な実行では、全体的な精度や有用なp95レイテンシを立証できない。本番で想定される条件を横断して、より大規模で関連性のあるサンプルを収集し、外れ値も保持する。デモはチェックを開発するために使い、リリース判断には体系的な評価を使う。
リリース前の本番チェックリスト
最初の動作するリクエストは、リリース判断のごく一部を決めるにすぎない。アプリケーションは支出を抑え、未完了の作業を復旧し、結果が得られなかったときに何が起きたかを説明できなければならない。
アクセスを保護する。 認証情報はバックエンドに置き、環境を分離し、ジョブ記録へのアクセスを制限し、認証情報のローテーションを計画する。すべてのステータス確認とダウンロードのリクエストを、そのジョブを所有するユーザーに対して認可する。推測不可能なタスクIDは、権限チェックの代わりにはならない。
入力とリソース使用を制限する。 プロンプトの長さ、アップロードの種類とサイズ、要求された出力設定、対応する組み合わせを検証する。ダウンロードするメディアについては、許可された宛先、リダイレクト、バイト上限、デコード上限を強制する。上記のコンパクトなスクリプトはライフサイクルを示すものであり、堅牢化された公開ダウンロードサービスではない。
送信前に予算を設定する。 ユーザー単位およびタスク単位の上限、最大同時ジョブ数、より高価な設定を要求できる人を定義する。作業が保留中の間は予算を予約し、同時リクエストがすべて同じ残高チェックを通過してしまわないようにする。
状態を永続化する。 プロバイダーを呼び出す前にローカルジョブを書き込む。返されたprediction IDを即座に保存し、プロセス再起動後もポーリングを再開できるようにする。送信ステータスが不明な場合は、ジョブが確実に失敗したとユーザーに伝えるのではなく、調査中ステータスを使う。
配信するアセットを管理する。 受け入れ済みファイルの保存場所、アクセスできる人、有効期限を決める。一時的な出力URLにいつまでも依存せず、プロバイダーのリンク寿命と保持条件を確認する。派生ファイルの削除をアプリケーションのデータワークフローに含める。
失敗を理解できる形にする。 遅延したタスク、却下された結果、サービスエラーを区別する。意図的に再試行するかレビューを依頼するための明確な経路を用意する。復旧の際に作業を再構築しなくて済むよう、ユーザーのブリーフを保持する。
変更を監視する。 完了、受け入れ、コスト、待ち時間を別々に追跡する。モデルやパラメータの変更後はリグレッションセットを再実行し、可能な場合は以前の構成を利用可能にしておく。機密性の高いログは伏せ字にし、コンテンツ記録と運用記録の両方に保持期間を割り当てる。
例示したプラットフォームを自分のアプリケーションで評価するには、まずAtlas Cloud model catalogを見て、次に選択したエンドポイントとpredictionのドキュメントを読む。タスクを1つ選び、受け入れを定義し、評価が実際に何を提供するかを記録してから、アクセスを広げる。
よくある質問
自分のアプリケーションには、どの生成AI APIを選ぶべきですか?
機能の入力、出力、許容できる待ち時間、レビュー要件を軸に選ぶ。法的・運用上利用できる候補に対して、同じ代表的なブリーフを実行する。受け入れ済み出力のコストと統合作業を、機能と併せて比較する。この3つの画像例から普遍的な選択が導かれるわけではない。
開発者向けの無料の生成AI APIはありますか?
一部のサービスはトライアルや限定的な無料利用を提供しているが、可用性、資格、クォータ、許可される用途は変わる。正確なエンドポイントについて現在の規約を確認する。無料のコンシューマーツールの枠がAPIアクセスを含むとは限らない。セルフホストも、モデルの重みをダウンロードできたとしても、ハードウェア、電力、エンジニアリング時間を使う。
生成AI APIを使うのに機械学習の経験は必要ですか?
HTTP、JSON、認証、通常のバックエンド開発スキルがあれば始められる。信頼できる機能を提供するには、さらに評価と運用の作業が必要だ。自分でモデルを訓練する必要はなくても、許容できる出力を定義できる程度にはモデルの限界を理解する必要がある。
1つのAPIでテキスト、画像、動画を扱えますか?
プラットフォームが3つすべてを提供することはあるが、各機能は異なるエンドポイント、パラメータ、出力タイプ、待ちパターンを使うことがある。各インターフェースを個別に確認する。アカウントや認証情報を共有していても、テキストのリクエストボディが画像や動画モデルと互換になるわけではない。
画像リクエストが画像ではなくタスクIDを返すのはなぜですか?
そのエンドポイントは作業を非同期で送信する。IDを保存し、ドキュメント化されたステータスルートに問い合わせる。タスク完了時にファイルを取得し、検証する。クライアントが待つのをやめても、サーバー側のジョブはまだ実行中かもしれない。別のリクエストを送信する前に、そのジョブを再開すること。
ワークフローを壊さずにAPIコストを下げるには?
重複送信を防ぎ、入力を早期に検証し、適切な場合は受け入れ済みアセットを再利用し、受け入れ基準を変えずに安価な構成をテストする。受け入れ済み結果あたりの実際の課金を測定する。開発者向け生成AI APIは、それを取り巻くアプリケーションが持続可能なコストで使える作業を提供できて初めて、その価値を持つ。


