写真をAI生成のミニチュア風景に変身させたことはありますか? とても楽しいAIエフェクトです。
最初に、画像生成ツールへ「チルトシフト・ポートレート」と入力してみました。出てきたのは、周辺がぼやけた普通の写真でした。
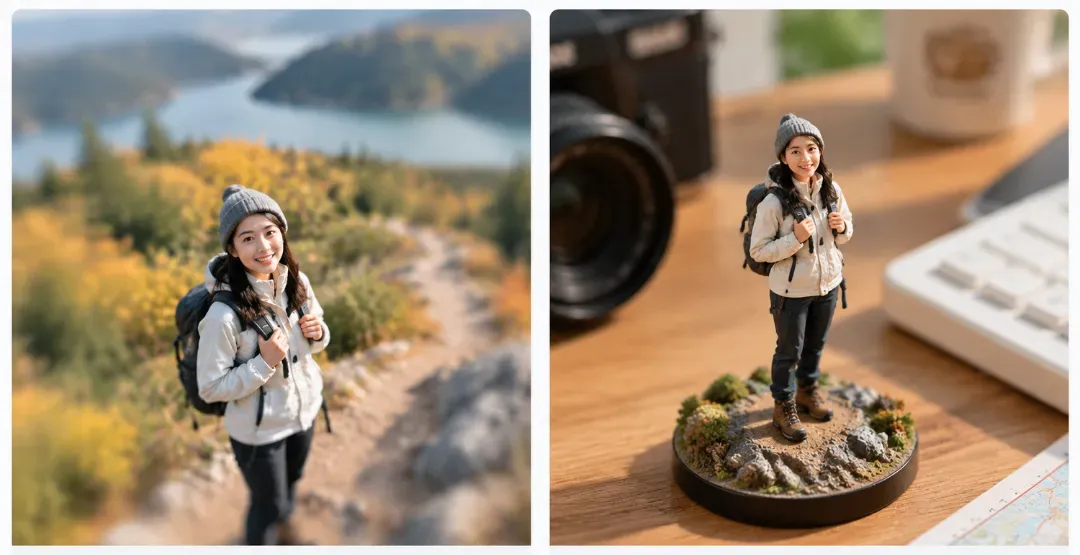
左はチルトシフトのハイキングポートレート、右はリアルな3Dミニチュアフィギュアです。
モデルはおもちゃらしい美学を無視しました。レンズぼかしだけでは脳をだませません。4つの光学的トリガーが相互作用して初めて、私たちはミニチュアのスケールを知覚します。
4つの光学的スケールトリガー
| 光学的トリガー | 視覚的メカニズム | プロンプトでの実装 |
| 焦点帯域 | 極めて薄い被写界深度 | マクロ100mmレンズ、f/2.0絞りの減衰 |
| 視点の高さ | 45度の見下ろし視点 | 卓上を見下ろすハイアングルショット |
| スケールの基準物 | 日常品との直接的なサイズ対比 | メカニカルキーボードのキーの隣に立つ |
| 鏡面光沢 | 玩具素材への鋭い光の反射 | 光沢のある成形PVC仕上げ、アクリルベース |
従来のチルトシフトは遠近感を偽装するためにスカイラインをぼかします。フィギュアの美学は逆に働きます。
被写体を透明な台座に載せ、硬いデスクライトをプラスチック表面に当て、背景に特大の小道具を配置すれば。
スケールの不一致が脳をだまします。視聴者は実在の人間ではなく、コレクター向け玩具として見ます。
ミニチュア化に適した参照写真の選び方
これを実現するのにプロのスタジオ撮影は必要ありません。ほぼどんな個人写真でも、山登りのスナップ、日常のコーデ確認、何気ないデスク写真をコレクター向けフィギュアに変えられます。
唯一譲れないルールは高解像度であることです。
マルチモーダル視覚モデルは、元ピクセルから直接3D形状を彫り出します。低解像度の切り抜き、圧縮されたスクリーンショット、ぼやけた自撮りは避けてください。
生成器は入力ノイズをフィギュアの型に直接焼き込みます。ピクセルのアーティファクトは顔の輪郭を溶かし、手足を歪めます。
プロンプトを触る前に、すべての元写真を準備しましょう:
- 明瞭さとシャープさ: 顔の細部、衣服の折り目、テクスチャがくっきりしたオリジナルの高解像度画像を選びます。シャープなエッジは、モデルがきれいな表面を彫るための明確な境界を与えます。
- バランスの取れたライティング: 方向性があり均一な照明の写真を選びます。濃い影は視覚モデルを混乱させ、手足を胴体に直接融合させます。
ステップバイステップのワークフロー:2D写真から3Dフィギュアを生成する
参照画像と簡単な自然言語の指示を使い、Google Gemini(Nano Banana 2)、Midjourney V8.1、ChatGPT(GPT Image 2)を試しました。3つともミニチュア風の結果を生成しましたが、構図と視覚処理は異なりました。
ステップ1:参照写真をアップロードする
被写体の外見と服装がわかる鮮明な画像から始めます。全身写真は単体のフィギュアに向いており、細部まで写ったワークスペース画像は、ミニチュアシーンとして再解釈できる環境要素をモデルに多く与えます。
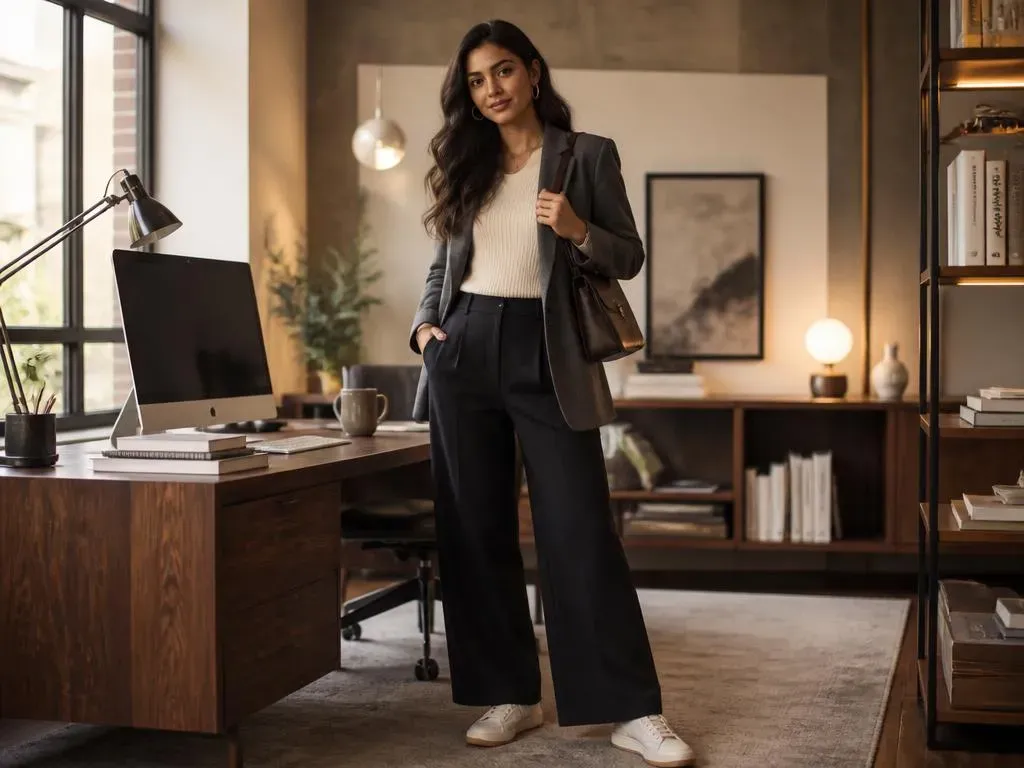
ステップ2:ミニチュア効果を記述する
被写体、スケール、素材、設定を指定するプロンプトを入力します。例えば:
"アップロードした画像を、リアルなミニチュア・コレクティブルフィギュアのシーンに変換します。人物の認識可能な外見、髪型、服装、色を保持します。机の上に展示された精巧な3Dフィギュアと、そのミニチュアスケールを確立する周囲のオブジェクトを表示します。リアルな素材、詳細なテクスチャ、自然光、プロの製品写真を使用します。"
このプロンプトは、モデル固有の構文に依存しない共通の出発点を提供します。よりそれらしいコレクティブル写真の見た目にしたい場合は、アクリル製ディスプレイベース、木製の机、コンピューターキーボードなどの詳細を追加できます。
ステップ3:結果を生成して比較する
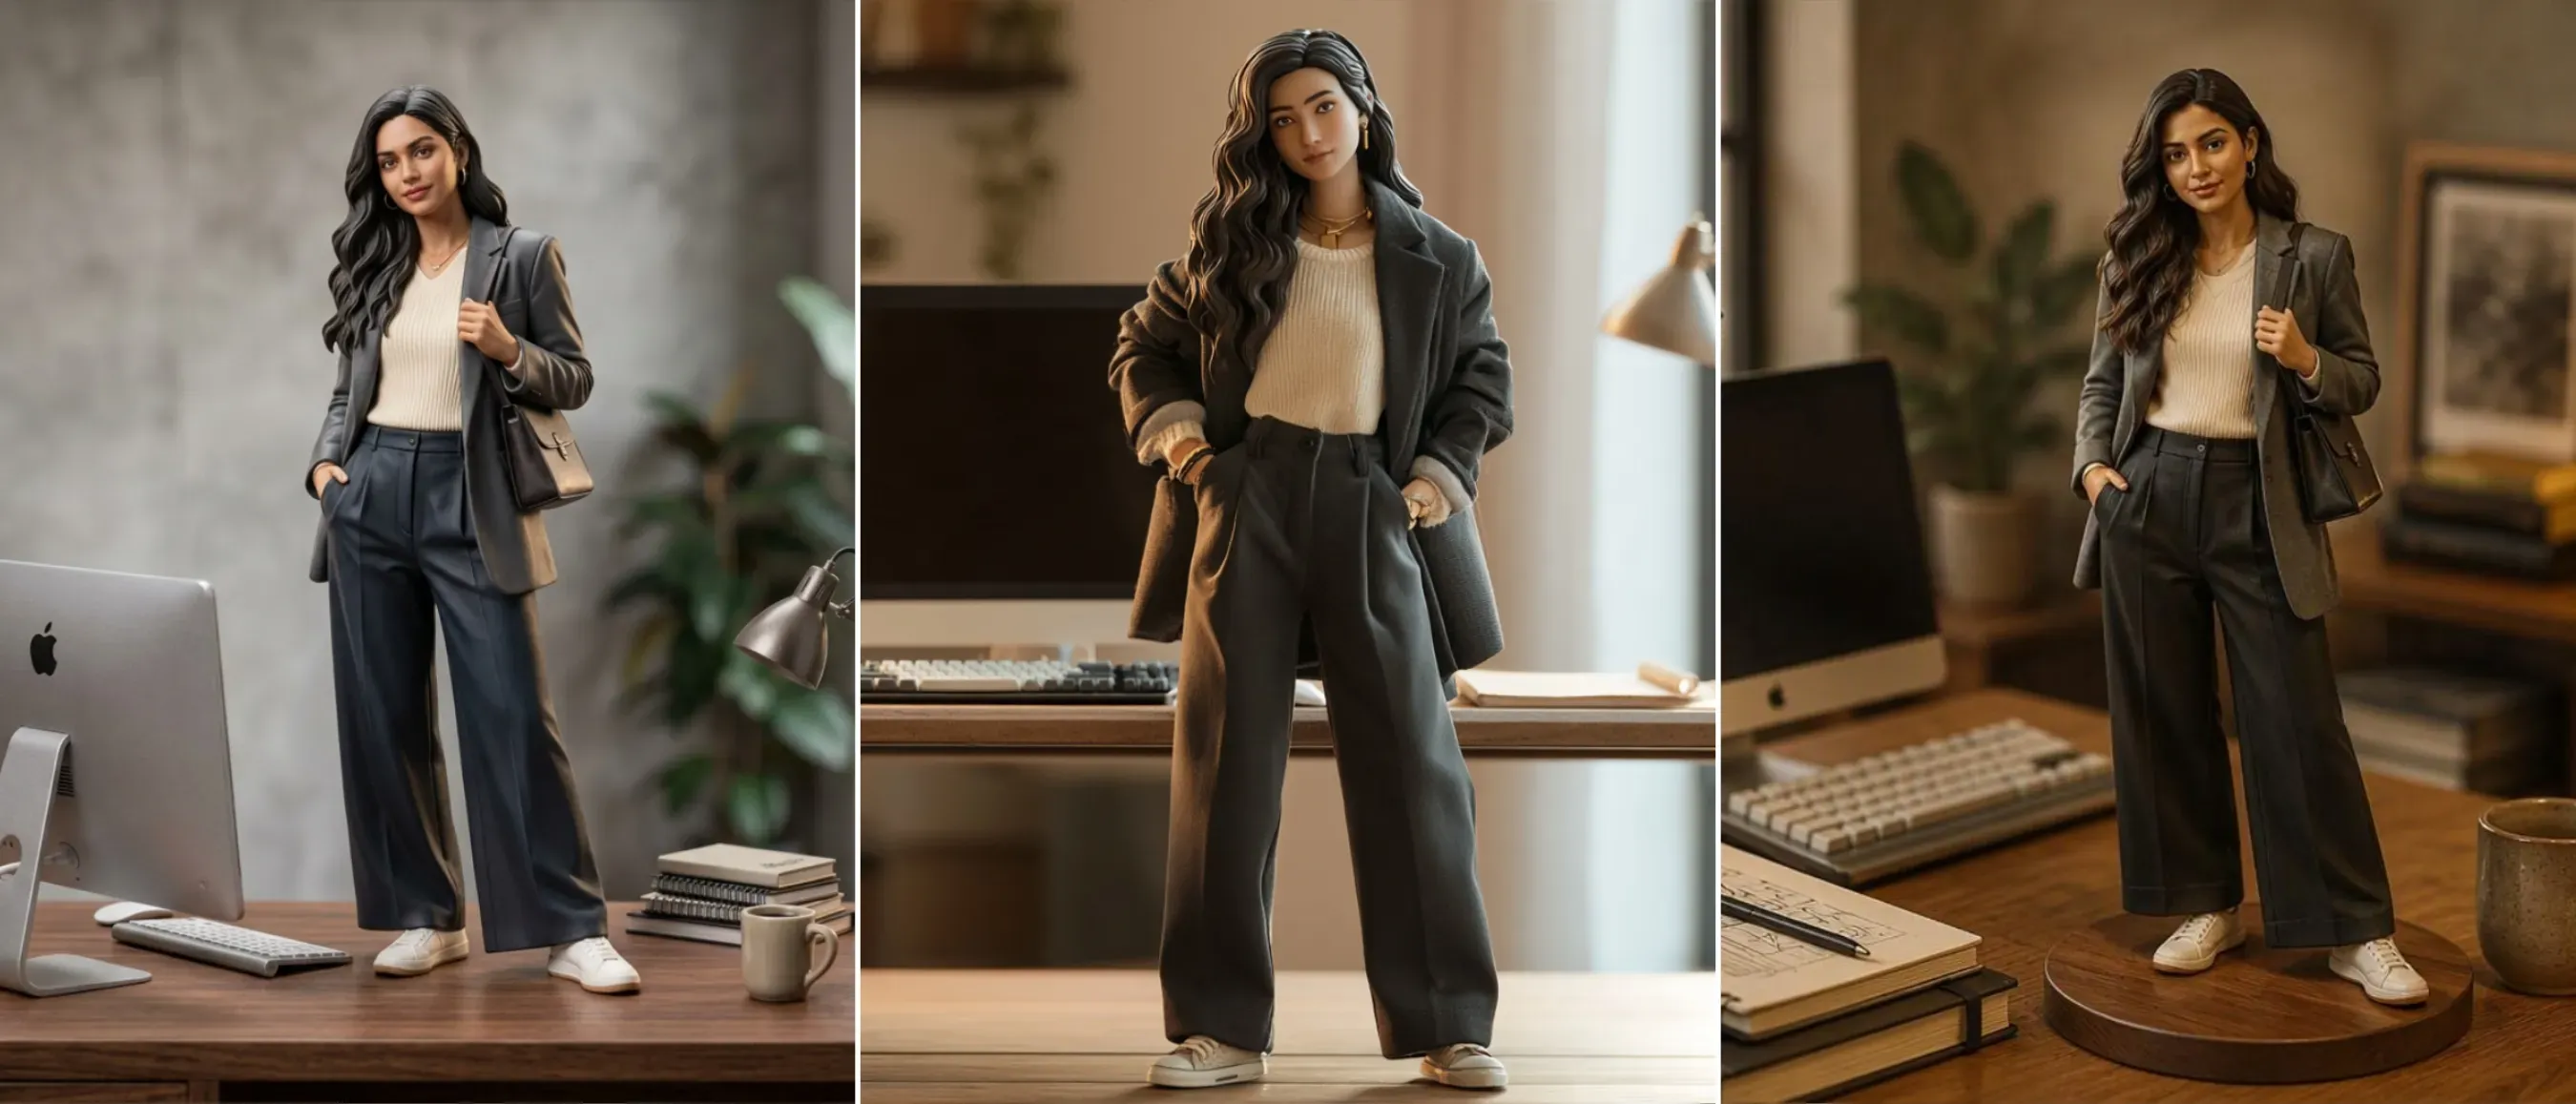
左から右へ、生成結果はNano Banana 2、Midjourney V8.1、GPT Image 2によるものです。
3つのツールはいずれも、細かなパラメータ調整なしで、参照写真から説得力のあるミニチュア風画像を生成できました。結果は、人物、衣服、ライティング、周囲のワークスペースの描画方法が異なりました。
- Google Gemini(Nano Banana 2): 透明なディスプレイベースとデスクトップ設定を備えたミニチュアフィギュアを生成しました。キーボードがフィギュアのスケールを伝える助けになりました。
- Midjourney V8.1: これは本当に気に入っています。このエンジンは明確に創造的な自由を取ります。元のポーズと顔の輪郭を変えます。出力は参照への忠実さよりも視覚的な洗練を優先します。
- ChatGPT(GPT Image 2): 被写体とワークスペースが構図に統合されたミニチュア風シーンを生成しました。
これらの出力はベンチマークであり、決定的なランキングではありません。これらは、厳密な幾何学的忠実さと超洗練されたコレクティブル美学という、GPT image 2 と Nano Banana vs. Midjourney の根本的な相違を浮き彫りにします。
元写真の品質、プロンプト構成、モデルパラメータが最終レンダーを左右します。目標とするビジュアルスタイルに合うエンジンを選びましょう。
ステップ4:必要なときだけ微調整する
最初のレンダーがミニチュアスケールを捉えているなら、そのままにします。そうでなければ、1つだけ狙いを定めた修正を加えます。成形プラスチックのテクスチャを強化する、元の衣服のディテールを固定する、背景の小道具を拡大するなどです。
反復の間にプロンプト全体を書き直さないでください。一度に1つの変数だけを調整します。切り分けた編集は、何がレンダーを改善するかを即座に明らかにします。
静的なAIミニチュアをアニメーション動画クリップに変換する
完成したミニチュアフィギュア画像は、物理的なコレクティブルとして提示すると、より魅力的になります。これを実証するため、前のセクションで生成したミニチュア画像の1つを、Veoを使って元のポートレートと対応するフィギュアをフィーチャーした8秒動画にしました。
手足のアニメーションは完全に省きます。代わりに、人間の手がフィギュアを持ち上げて間近で確認します。この物理的な接触がミニチュアスケールを証明し、3Dの奥行きを示し、キャラクターの形状を固定します。
Veoで既存のミニチュア画像をアニメーション化する
前のセクションで生成したミニチュア画像をVeoの参照画像としてアップロードします。プロンプトは、自然な手の動きと一貫したフィギュアの外見を備えた、1つの連続したアクションに集中させます。
プロンプト:
plaintext1Create an 8-second photorealistic, single continuous macro product video based on the uploaded image. The original portrait photo and its matching miniature figurine sit side by side on a wooden desk. A realistic human hand gently picks up the figurine by its base, lifts it toward the camera, and slightly tilts it for a closer look at the sculpted clothing and facial details. Keep the figurine's appearance, proportions, outfit, and base consistent with the reference image. Natural hand movements, realistic physical contact, soft daylight, shallow depth of field, and authentic miniature scale. No cuts, morphing, melting, or sudden movements.
生成動画で確認すべきこと
生成後、私は3つの中核チェックポイントを確認します:ポートレートの似姿、自然な手の握り方、持ち上げ中の構造的な剛性です。
動きはシンプルに保ちます。単一の連続テイクがミニチュアの錯覚を成立させます。複数シーンのカットや複雑なカメラパスは省きます。
バイラル向け演出レシピ4選:すぐ使える動画プロンプトテンプレート
すべてのフィギュアを同じ無地の木製デスクに置くと、すぐに単調になります。人の目を引き、注意を保持するには、演出をクリエイティブにする必要があります。環境とスケールの基準物を変えることで、毎回新鮮なマイクロストーリーを語り、視聴者にスクロールを止める本当の理由を与えます。
プロンプトを書く前に、クリエイティブなコンセプトを対象プラットフォームに合わせましょう:
| アスペクト比 | 対象プラットフォーム | フレーミング戦略 |
| 4:5 | Instagramフィード | タイトなマクロクロップで中央配置した卓上ジオラマ。 |
| 9:16 | TikTok、YouTube Shorts | モーションの傾きとUIクリアランス用に上部の余白を多めに取った縦フレーミング。 |
| 2:3 | スケール対比を強調する背の高い背景小道具を使った縦積み。 |
普遍的な4パート動画演出フォーミュラ
動画モデル間で構造の剛性とスケールの一貫性を保つため、すべての演出プロンプトは同じ4層構文に従います:
- [シーンとベース]:スケールの基準物、ライティングスタイル、表面素材。
- [インタラクション・アクション]:単一の連続した身体的接触(例:手で握る、カップを持ち上げる)。
- [カメラベクトル]:シーンカットなしのゆっくりしたマクロ移動(プッシュイン、弧、ラックフォーカス)。
- [ネガティブ制約]:モーフィングや解剖学的な不具合を防ぐ具体的なトークン。
デスクトップ・テック・ジオラマ
このテーマで最も認識しやすい要素は、メカニカルキーボード、RGBライティング、そしてミニチュアフィギュアとハイテクなデスクトップ環境の相互作用です。私は、実在の人物とフィギュアが同じフレームに現れる、テクノロジーを織り込んだミニチュアシーンを動画にしました。フィギュアは机の上のベースに、メカニカルキーボードの隣に立っており、人物はテーブルに座ってフィギュアを持ち上げ、間近で観察します。
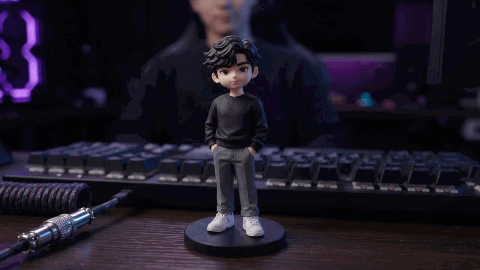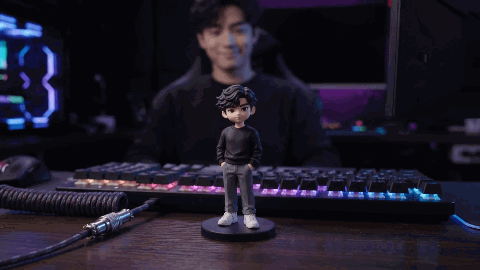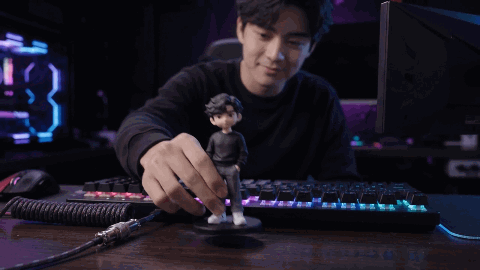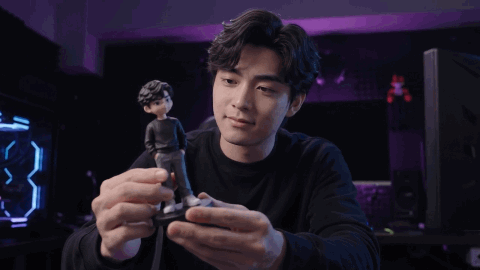
私のプロンプト:
両方の参照画像を使って、8秒間のフォトリアルでシネマティックな動画を1つの連続ショットで作成します。
ミニチュアフィギュアが、紫、シアン、マゼンタのRGBライティングが付いた特大のメカニカルキーボードの隣のディスプレイベースに立っています。同じ黒のスウェットシャツ、グレーのトラウザー、白いスニーカーを着用した実在の男性が机の後ろに座っています。
RGBライトが明るくなる中、フィギュアのクローズアップから始めます。カメラは滑らかに引いて、男性がミニチュアの自分に微笑むところを映します。彼はそっとフィギュアをベースごと持ち上げて観察し、最後のフレームでは彼の顔とフィギュアの両方が見えるようにします。
男性のアイデンティティと、フィギュアの正確な外見、服装、プロポーションを保持します。自然な手の動き、リアルな素材、浅い被写界深度、シネマティックなライティング。
1つの連続ショット、カットなし、モーフィングなし、キャラクターの重複なし、手の歪みなし、浮遊物なし、テキストやロゴなし。
コレクターのディスプレイケース
特別な意味を持つどんな写真もミニチュアコレクティブルに変えられます。たとえば、初めてのハイキング、初めての登山、初めてバイクに乗ったときのスナップなどです…
例として、バイクに乗っている写真を使いました:
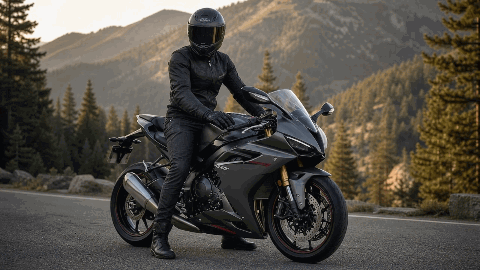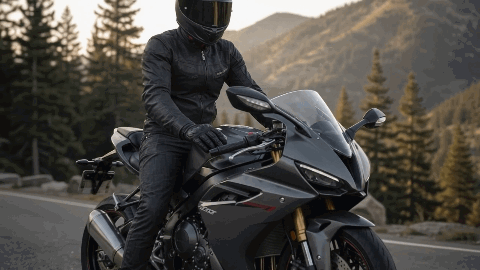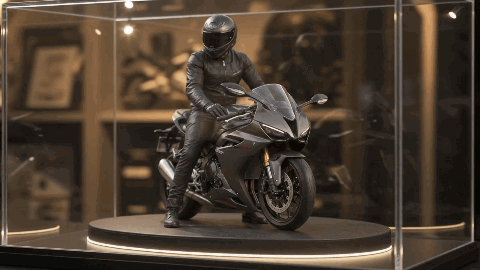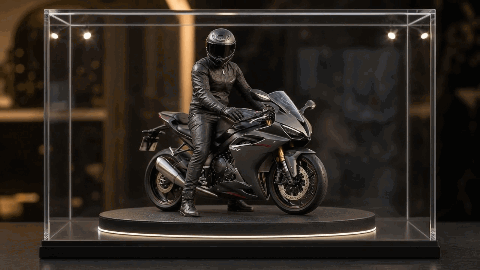
私のプロンプト:
両方の参照画像を使って、8秒間のフォトリアルでシネマティックな動画を1つの連続ショットで作成します。
山道で黒いスポーツバイクに乗る実在のライダーから始めます。カメラはゆっくりライダーへ押し寄り、その後、連続した前進カメラ移動と変化する被写界深度を使って、透明なアクリルディスプレイケース内の対応するミニチュアバイクコレクティブルへシームレスに移行します。
暖白色LEDベースライトが精巧なレジン製バイクとライダーを徐々に照らす中、カメラはショーケースの周りを滑らかに弧を描きます。最後にディスプレイケース全体を明確にフレーミングします。
両方の参照にわたって、バイクのデザイン、色、ライダーのポーズ、ライディングギアを保持します。ミニチュアは静止させ、リアルなアクリル反射とプレミアムな製品写真を保ちます。
途切れない1つのカメラ移動、カットなし、フェードなし、突然のトランジションなし、モーフィングアーティファクトなし、バイク部品の歪みなし、ちらつきなし、テキストやロゴなし。
心地よいティーカップの止まり木
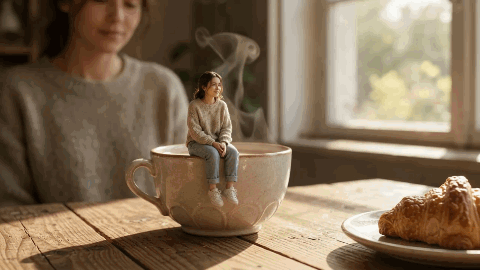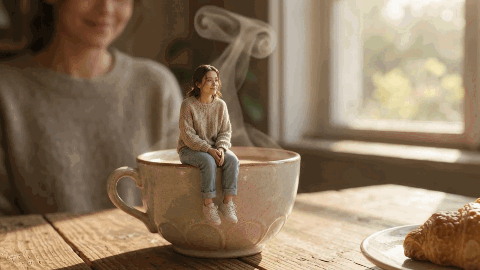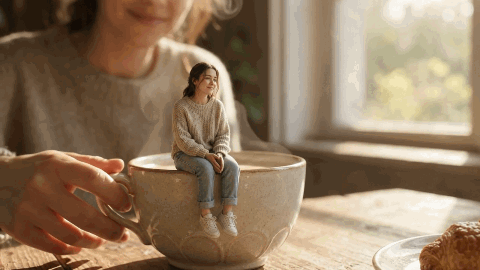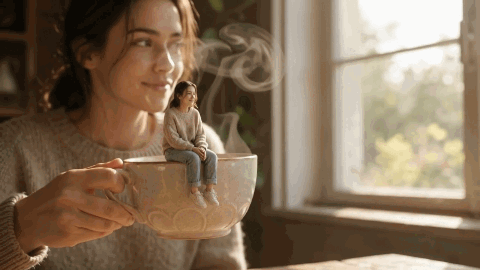
心温まる日常のスナップをミニチュア風動画に変えるのは素晴らしいアイデアです。次のコンセプトでは、コーヒーカップの縁にちょこんと座ったドールが実在の人物と交流します。
私のプロンプト:
両方の参照画像を使って、8秒間のフォトリアルでシネマティックな動画を1つの連続ショットで作成します。
日差しの当たる木製テーブルの上で、実在の人物の小さなフィギュアがヴィンテージ陶器のコーヒーカップの縁にしっかりと座っています。窓から温かな朝の光が差し込み、コーヒーから繊細な湯気が立ち上ります。
カメラはゆっくりカップへ滑っていき、フィギュアの詳細な顔、服装、陶器の釉薬、小さな結露の粒を明らかにします。実在の人物が背景に柔らかく現れ、ミニチュアに微笑み、フィギュアを乱さずにカップの取っ手をそっと持ち上げます。最後に、温かな朝の光の中に人物とフィギュアの両方が見えるようにします。
実在の人物のアイデンティティと、フィギュアの正確な外見を保持します。フィギュアはカップの縁にしっかり座ったまま静止させます。自然な手の動き、柔らかな逆光、浅いマクロ被写界深度、心地よいライフスタイル写真。
1つの連続ショット、カットなし、モーフィングなし、フィギュアの落下なし、手の歪みなし、コーヒーのこぼれなし、テキストやロゴなし。
テラリウムの探検家
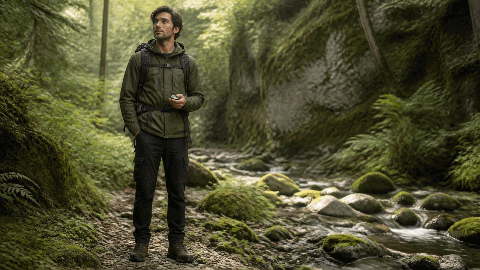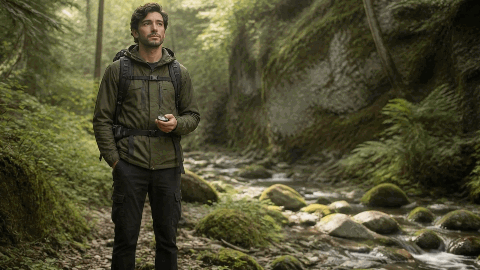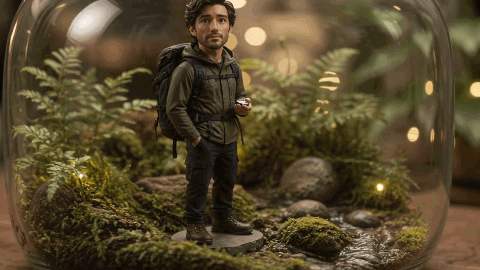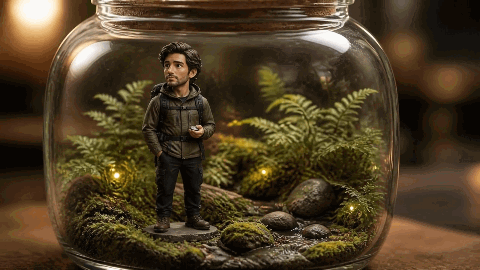
このプロンプトは、オーガニックな見た目を求めるアウトドア、旅行、冒険系プロフィールに合います。
私のプロンプト:
両方の参照画像を使って、8秒間のフォトリアルでシネマティックな動画を1つの連続ショットで作成します。森の小道に立つ実在の探検家から始めます。カメラをゆっくり彼らへ押し出し、ガラステラリウムジャー内の対応するミニチュアフィギュアへシームレスに移行します。温かなフェアリーライトが苔、小さなシダ、川の小石の上で柔らかく光る中、カメラはジャーの周りを穏やかに周回し続けます。探検家の外見と服装を保持します。フィギュアとテラリウムは静止させ、リアルなガラス反射とマクロ被写界深度を保ちます。最後にテラリウム全体を明確にフレーミングします。カットなし、突然の動きなし、ちらつきなし、歪んだ解剖学的構造なし、余分な人物なし、テキストやロゴなし。
よくあるミニチュアスケールのアーティファクトを診断して修正する
ほとんどのミニチュアの欠陥は、不明確なスケールの手がかり、一貫性のない素材、被写体への望ましくない変化に帰着します。以下の表を使って問題を特定し、的を絞った修正を適用してください。
ミニチュア欠陥解決マトリクス
| よくある問題 | 推奨される修正 |
| 被写体がミニチュアフィギュアではなく実写写真のように見える | 「コレクティブルフィギュア」「彫刻された表面」「ディスプレイベース」などの用語を強調します。 |
| 顔が過度に滑らか、またはプラスチックのように見える | 「マット塗装の顔のディテール」を指定し、顔の光沢ハイライトを減らします。 |
| 体のプロポーションや衣服が変わる | 元のポーズ、服装、髪型、主要な色を保持するよう、モデルに明示的に指示します。 |
| ミニチュアに説得力のあるスケール感がない | キーボード、コーヒーカップ、その他の実物大オブジェクトなど、身近なサイズ参照を追加します。 |
| 背景オブジェクトのプロポーションが一致しない | 背景の小道具の数を減らし、1つか2つの明確なスケール参照を優先します。 |
| 動画生成中にフィギュアが変形する | アクションを簡素化し、複雑な握り、回転、複数人が関わる相互作用を避けます。 |
クリーンな反復のための2つのルール
- 肌とプラスチックを分ける: 「アクリル」や「光沢プラスチック」のような全体素材タグを外します。高光沢の用語は衣服、髪、ディスプレイ台座に限定します。顔の特徴は手描きのマット表面として定義します。
- スケールの矛盾を強制する: 生成モデルは、ミニチュア化を引き起こすために矛盾するサイズの手がかりを要求します。フィギュアを、認識しやすい実物大のデスクトップオブジェクトのすぐ隣に配置します。
写真をAIミニチュアフィギュアに変えるのは、見た目より簡単です。適切な参照写真と少しのプロンプト調整があれば、デスクトップ用コレクティブルからガラステラリウムの中の小さな探検家まで、何でも作成できます。お気に入りの写真から始めて、さまざまなミニチュアスタイルを試し、何が作れるか見てみましょう。1枚の画像でできることの多さに驚くかもしれません。


