緑のAPIテストレポートは、すべてのアサーションがHTTP 200しかチェックしていないことに気づくまでは安心感を与えます。レスポンスに別の顧客のレコードが含まれていても、テストは通ってしまいます。
すでに手元にある仕事に合わせて APIテスト向けAIツール を選びましょう。チームがコレクションを維持しているならPostman Agent Modeを、仕様が出発点ならKushoAIを、生成されたフローや記録されたトラフィックから構築したリグレッションテストが必要ならKeployを評価してください。信頼する前に、生成されたテストをレビューして実行しましょう。
このガイドでは、通常のAPIをテストするためのAI支援を扱います。AIモデルの回答の正確性をテストすることは、別の評価問題です。
主なポイント
- コントラクト、リクエストの依存関係、承認済みのビジネス期待値を提供する。
- アサーションが誤ったデータ、欠落フィールド、壊れた型を拒否するか確認する。
- レビュー済みのテストが意図したCI環境で繰り返し実行されてから購入する。
以下の製品比較は、2026年9月21日に確認した公式ドキュメントを反映しています。3つの有料アカウントによる直接対決のベンチマークではありません。
実例では、固定されたSwagger Petstore仕様を使用し、コントラクトの期待値、観測された動作、意図的に変更したレスポンスコピーを区別しています。
ローカル実行では5つのライブテストが合格し、意図的に変更した3つのレスポンスコピーはすべて拒否されました。別の欠落名プローブは依然として200を返し、緑のレポートの範囲がなぜ重要かを示しています。
APIテスト向けAIツールが実際に行うこと
AI支援は通常、APIテストの4つの部分に入ります。モデルは仕様を読み、シナリオを提案し、アサーションの草案を作成し、失敗の説明を支援します。各部分には異なる証拠が必要です。失敗の説得力のある説明は、提案された修正が正しいことを証明しません。
仕様レビューでは、OpenAPIファイルと関連するビジネスルールを提供します。シナリオ計画では、有効なデータと既知の境界の例を追加します。実行可能なスクリプトでは、ランナー、認証設定、フィクスチャの規約を含めます。診断では、シークレットを削除した後の実際のリクエスト、レスポンス、失敗メッセージを提供します。
製品を評価する際は、これらの4つのメカニズムを切り離しておいてください。
- LLM生成: 言語、スキーマ、例からテストを提案します。レビュー担当者が期待される結果を確認する必要があります。
- トラフィックリプレイ: 後の動作をキャプチャしたインタラクションと比較します。多くの場合、記録された依存関係のレスポンスを使用します。
- プロパティベーステスト: スキーマ準拠などのプロパティに挑戦する入力を体系的に構築します。
- テスト実行: リクエストを送信し、アサーションを評価し、レポートと終了コードを返します。
製品は複数のメカニズムを組み合わせる場合があります。各テストがどのメカニズムで生成されたか、何が期待される結果を決定するかを尋ねてください。誤ったレスポンスを記録すると、同じエラーがリグレッションのベースラインとして保存される可能性があります。洗練されたテスト名を生成すると、サポートされていない期待値が隠れる可能性があります。
アサーションは3つの深さで考えてください。第1に、サーバーは正常に応答したか。第2に、ボディにドキュメント化されたフィールドと型があるか。第3に、このボディは要求したリソースと操作を表しているか。
ペットの検索では、整数IDを持つ有効なオブジェクトでも、そのIDが別のペットのものであれば第3のチェックに失敗します。逆に、要求したIDと一致しても、すべてのフィールドがスキーマを満たすことを証明するわけではありません。両方のチェックを使用し、チームが合意したソースがある場合のみビジネスルールを追加してください。
実際に得たい成果物は、説明可能なオラクルを備えた保守可能なテスト資産です。つまり、各結果がなぜ合格または失敗すべきかの明確な理由です。初期生成リストの長さを称賛するのではなく、拒否したものを含め、レビュー後に有用なシナリオを数えてください。
ワークフロー別に比較したAPIテスト向けAIツール
今日チームが提供できる成果物から始めましょう。確立されたコレクションの移行、欠落したビジネスルールの再構築、依存関係記録のセットアップは、それぞれ異なるプロジェクトです。ある出発点に適したツールが、別の出発点では余分な作業を生むことがあります。
| ツールまたはアプローチ | 有用な入力 | AIまたは自動化の役割 | 実行とCIの経路 | レビュー可能な出力 | 主な試行質問 |
|---|---|---|---|---|---|
| Postman Agent Mode | コレクション、リクエスト、レスポンス、環境、仕様 | ワークスペースのコンテキストでテストスクリプトを起草・編集 | Collection Runnerと互換CLIワークフロー | 標準的なPostman JavaScriptアサーション | 変数を保持し、コントラクトをテストするか? |
| KushoAI | OpenAPI、Postmanコレクション、cURL | シナリオとテストスイートを生成;自然言語による改良をサポート | プラットフォームでの実行とドキュメント化されたCI統合;権限を確認 | 生成されたリクエスト、依存関係、期待される結果を検査 | 選択したプランで、必要な場所でスイートを実行・保持できるか? |
| Keploy | 仕様またはリクエスト定義;あるいは実際のトラフィック | AI生成と別個の記録/リプレイ経路 | サポートされているローカル/CI環境での生成フローまたは記録済みテスト | テスト定義、ベースライン、依存関係モックをレビュー | どの経路が実際の障害モードをカバーするか? |
| 既存のランナーとLLM | 承認済みマトリクス、仕様、フィクスチャ規約 | レビュー用のコードを起草 | pytestまたは他の確立されたランナー | リポジトリにコミットされたコード | レビューは同じテストを直接書くより安価か? |
既存コレクション向けのPostman Agent Mode
コレクションにすでに有用なリクエスト順序、環境変数、認証設定が含まれている場合、Postmanは妥当な最初の評価対象です。Agent Modeはそのコンテキストを使用して標準的なJavaScriptテストスクリプトを生成できます。これらのスクリプトは、新しいアサーション言語を必要とせず、既存のコレクション実行ワークフローに入ることができます。
すべてをテストするよう求めるよりも、焦点を絞った試行の方がより明らかになります。コレクションで先に作成されたリソースを取得するリクエストを選択します。そのスキーマを提供し、必須フィールドの検証、ドキュメント化されたフィールド型、返されたIDを保存された作成IDに接続するアサーションを要求します。
次に、受け入れる前に提案された変更を検査します。レスポンス例にMiloという名前のペットが含まれているかもしれません。Miloとの等価性は、フィクスチャが明示的にMiloを作成した場合は意味がありますが、ジェネレーターが共有サンプルレコードから名前をコピーした場合は脆弱です。同じリテラルは、そのソースに応じて、有効なアサーションにも偶発的な依存関係にもなります。
変数のスコープを慎重に確認してください。環境変数に格納されたIDは、後のリクエストで利用可能でなければならず、その実行に属している必要があります。並行実行間で共有される変数は、サーバー欠陥に似た断続的な失敗を生む可能性があります。ジェネレーターにアサーションと同様にセットアップとクリーンアップの説明を求めてください。
最初の受け入れテストでは、隔離されたデータに対してコレクションを2回実行し、エクスポートまたはバージョン管理された表現を検査します。チームメイトがAIの会話を繰り返さずに変更されたスクリプトをレビューできることを確認します。また、選択したCLI、レポーター、プランが使用する予定の実行経路をサポートしていることも確認してください。
ここでは運用されたPostman生成は提示していません。有用な評価質問は、そのワークスペースのコンテキストが既存コレクションでのレビュー作業を減らすかどうかです。それには独自のコレクションとアカウントレベルの試行が必要であり、製品のスクリーンショットから引き出された結論ではありません。
仕様ベースのテスト生成向けKushoAI
KushoAIはSwagger/OpenAPI、Postman、cURLの入力を受理し、テスト生成、自然言語による改良、CI実行をドキュメント化しています。これは、チームが有用なAPI定義を持っているが未作成のテストのバックログがある場合の候補になります。これらはベンダーが説明する機能であり、測定された欠陥検出結果ではありません。(KushoAIドキュメント、2026年9月)
最も豊富で信頼できるコンテキストを持つ入力を選択してください。cURLリクエストは1つの有効なリクエストを記述できますが、通常はオプションフィールド、許可されたenum値、ドキュメント化されたエラーについてほとんど何も述べません。OpenAPIファイルは構造を追加しますが、承認されたシナリオマトリクスは、構造が曖昧に残す可能性のある意図を追加します。
Petstoreの試行では、有効なペット、欠落した必須名、誤った型のID、無効なステータスフィルターの個別のケースを要求します。ツールがリクエストボディの要件とレスポンススキーマの要件を区別しているかをレビューします。これらは例では似て見えるかもしれませんが、異なる義務を課します。
次に、接続されたcreate-read-updateフローを検査します。読み取りは現在のセットアップに関連付けられたIDを使用する必要があります。更新は同じリソースを対象とし、後の読み取りで変更されたフィールドを検証する必要があります。魅力的なテスト名を持つ4つの独立したリクエストは、依存関係チェーンが機能することを証明しません。
最初の生成は提案として扱ってください。ドキュメント化された期待値を保持し、データフローが正しくないスクリプトを修正し、不十分に指定された結果を要件の決定としてフラグを立てます。ツールが複数の同等の欠落フィールドケースを提案する場合は、重複を維持するコストを払うのではなく、有用な区別を保持してください。
購入前に、意図したパイプラインからスイートを実行し、失敗成果物を検査するよう求めてください。選択したプランでの現在のCI権限、認証情報の処理、利用可能なエクスポート形式を確認します。無料のインタラクティブ試行がチーム展開と同じ自動化権限を付与すると仮定しないでください。
生成されたテストとトラフィックリプレイ向けKeploy
Keployのドキュメントは2つの異なる出発経路を提示しています。AI生成はOpenAPI、Postman、cURL、エンドポイントなどのリソースを受理し、接続されたAPIフローを構築します。記録とリプレイはAPIインタラクションとその依存関係をキャプチャし、後でモックで実行します。AIフローの説明と依存関係記録の説明は、同一のメカニズムとして扱うべきではありません。(Keployドキュメント、2026年9月)
困難が、アプリケーションがデータベースやアップストリームサービスで何をしたかを再現することである場合、記録経路を評価してください。隔離された環境で小さなcreate-read-updateジャーニーをキャプチャし、キャプチャした依存関係を検査し、制御されたアプリケーション変更後にリプレイします。大規模な展開を計画する前に、ランタイムが何をサポートしているかを確認してください。
困難が仕様からケースを導出することである場合、生成経路を別途評価してください。提案されたリクエストが認証情報をどのように取得し、ステップ間でIDを運び、データをクリーンアップするかを尋ねてください。製品の他の場所に記録機能があることは、生成されたスイートについてこれらの質問に答えません。
動的な値には判断が必要です。タイムスタンプは正当に変動するかもしれませんが、リソースIDは2つのリクエストを接続するため比較が必要かもしれません。すべての変化するフィールドを広く無視すると、エラーが隠れる可能性があります。除外をフィールドごとにレビューし、意味のある関係を表現する比較を保持してください。
受け入れる前にベースラインも検査してください。誤った合計、偶発的なフォールバックレスポンス、古いデータを含む記録は一貫してリプレイされる可能性があります。一貫性は変更の検出に役立ちますが、キャプチャした動作が正しかったかどうかはチームが決定します。
有用な補足: Schemathesisはスキーマ駆動のプロパティベースAPIテストを提供します。レビュー済みの例と並行して、生成された入力でAPIに挑戦できます。これはLLMテストジェネレーターの同義語ではなく、別のテストメカニズムとして扱ってください。その発見はコントラクトと実装に対して解釈する必要があります。
無料のAPIテスト向けAIツール:制限とコスト
「無料」は、クライアント、限られたAI許容量、オープンソースランナー、または一時的な試行を表すことがあります。これらのオファーはワークフローの異なる部分をカバーしています。無料のクライアントは、自動生成、スケジュール実行、レポートエクスポートも無料であることを証明しません。
2026年9月21日に確認したところ、Postmanの無料プランは月50 AIクレジットを記載しています。クレジットはその課金単位であり、50テストや50の完全なスイートを意味しません。その比較表は、AI許容量を実行、データ駆動機能、結果エクスポートと区別しています。(Postman価格、2026年9月)
KushoAIの現在の価格提示はDeveloper EditionとEnterpriseを使用しています。KeployはPlayground、Pro、Enterpriseをオープンソース提供と並んで区別しています。関連する制限を確認するには、現在の購入画面を使用してください。古いツールまとめは、廃止されたプラン名を説明したり、別々に課金される許容量を組み合わせたりする場合があります。
| コスト構成要素 | 試行で記録すべきこと | 請求を誤解させる可能性があるもの |
|---|---|---|
| シートとプラン | 編集者、レビュー担当者、請求間隔、必要な機能 | 年間ヘッドライン価格を月次コミットメントと比較する |
| AI生成 | 同じ承認済みタスクのクレジット使用量(再試行を含む) | 1クレジットが1テストに等しいと仮定する |
| 実行 | ローカル実行、ホスト実行、CIジョブ、スケジュール、レポート | インタラクティブ実行をすべての自動化経路の許可として扱う |
| 独立したモデル | 起草とレビューのための入力および出力トークン | 繰り返しの完全仕様提出を無視する |
| エンジニアリング時間 | レビュー、フィクスチャ修正、失敗トリアージ、メンテナンス | 初期生成時間を総納品時間として数える |
コストを見積もるには小さな受け入れタスクを使用してください。各候補に同じ操作と期待値を与え、レビュー後に残るシナリオの数を記録します。生成時間、手作業のレビュー時間、実行時間を別々の列に保ちます。モデルを待つことと危険なアサーションを修正することは、チームに異なるコストを課します。
有用な分母は、チームが保持するレビュー済みで実行可能なシナリオです。これにより、出力が単に長いという理由で、冗長なケースが多いジェネレーターが安く見えることを防ぎます。削除したサポートされていないケースと、未解決のままの要件を記録してください。
この記事は、測定された労力節約率を主張したり、有料プランのスループットを比較したりしません。それらの数値には、同等の入力による制御された試行が必要です。購入決定には、必須フィールドの追加など1つの現実的なメンテナンス変更を含め、見積もりが最初のデモだけでなく次のスプリントもカバーするようにしてください。
APIテスト向けAIツール:OpenAPIから最初の実行まで
実際のSwagger Petstoreプロジェクトの隔離されたローカルインスタンスを使用します。コミットd57941e8fe959e508796b27469b1e8bba73392dcを固定します。その仕様はOpenAPI 3.0.4とアプリケーションバージョン1.0.29-SNAPSHOTを宣言しています。独立して更新された公開デモではなく、固定されたファイルを読んでください。(Swagger Petstore仕様、2026年9月)
1. サービスを準備し、環境を記録します。 そのソースページからリポジトリを取得し、固定されたリビジョンをチェックアウトし、互換性のあるJDKとMavenをインストールします。プロジェクトのREADMEは、リポジトリディレクトリからのこの起動コマンドを示しています。
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jettyはポート8080を使用します。BASE_URLをそのポートのループバックHTTPオリジンに/api/v3を追加して設定します。テスト前に、そのベースに対して/openapi.jsonが読み取り可能であることを確認してください。
この実行ではTemurin JDK 17.0.20.1、Maven 3.9.9、Python 3.12、pytest 9.1.1、jsonschema 4.26.0を使用しました。バージョンも記録してください。ソースビルドは依存関係とSwagger UIをダウンロードするため、固定されたアプリケーションコミットだけでは完全に密閉されたビルドではありません。
2. 固定された仕様をインポートします。 /pet、/pet/{petId}、/pet/findByStatusを選択します。クリーンアップのためにdeleteを利用可能にしておきます。仕様の公開サーバーロケーションをローカルベースで上書きします。書き込みリクエストを送信する前にこの設定を確認してください。
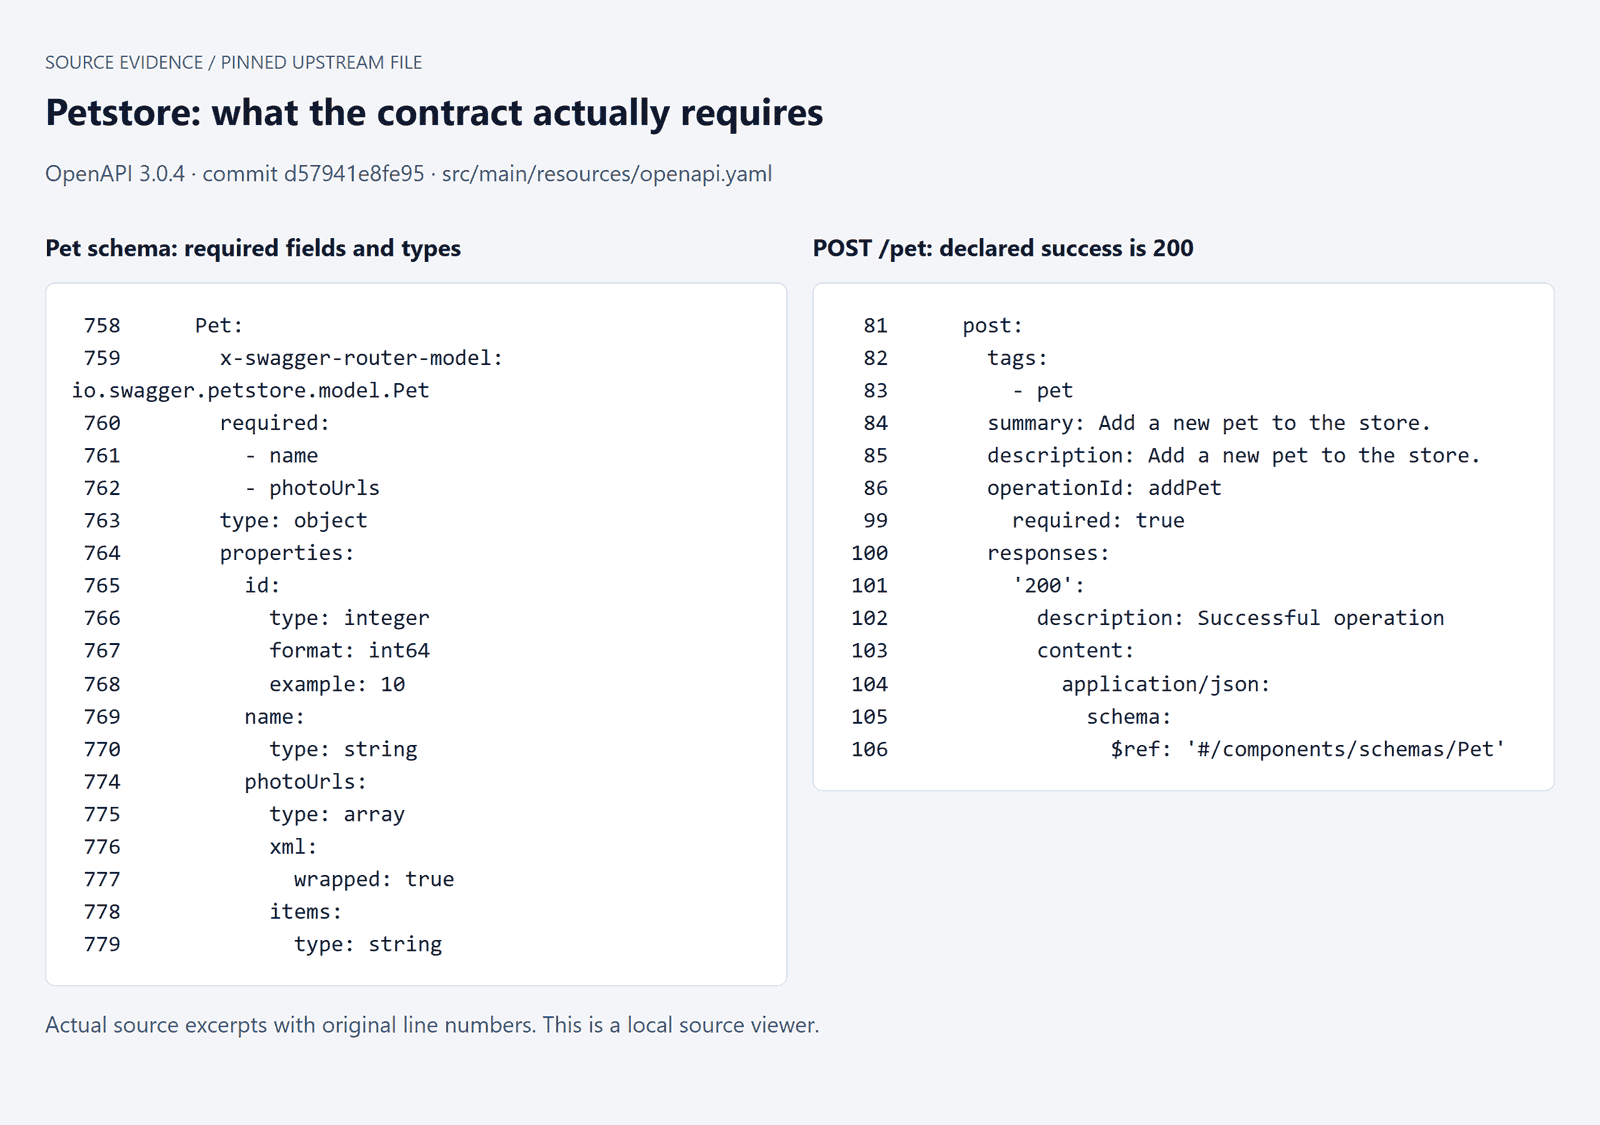 必須フィールドと選択された操作定義を示す固定されたOpenAPI Petstoreソース
ローカルでレンダリングされた実際のソース抜粋:PetはnameとphotoUrlsを要求し、POST /petは成功時に200を宣言。元の行番号は保持されています。
3. 実行可能コードの前にマトリクスを生成します(プロンプトA)。 仕様を添付し、このプロンプトを選択したジェネレーターに貼り付けます。
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. 各シナリオのオラクルをレビューします。 Petstoreは成功した作成を200としてドキュメント化しています。そのPetスキーマはnameとphotoUrlsを要求し、idは整数型ですがその必須リストにはありません。したがって、欠落フィールドの検証とリクエスト・レスポンスの同一性には異なるチェックが必要です。
| 操作 | 入力またはシーケンス | 期待される結果の証拠 | レビューするアサーション | 実行ステータス |
|---|---|---|---|---|
| addPet, getPetById | 作成してから現在のIDを読み取る | ドキュメント化された200とPetスキーマ;明示的なフロー期待値 | ボディを検証し返されたIDを比較 | ローカルで合格 |
| updatePet, getPetById | 名前を変更して再度読み取る | 更新操作と承認済みフィクスチャの意図 | 同じID、新しい名前、有効なスキーマ | ローカルで合格 |
| findPetsByStatus | セットアップ後にavailableをクエリ | ドキュメント化されたenumと成功した配列レスポンス | 返されたすべてのステータスが一致;作成されたIDが存在する | ローカルで合格 |
| getPetById | 非整数のパスID | ドキュメント化された無効ID 400 | このドキュメント化されたケースの正確なステータス | 合格:400 |
| findPetsByStatus | ドキュメント化されていないenum値 | ドキュメント化された無効ステータス400 | 正確なステータス、不一致を保持 | 合格:400 |
| addPet | 必須のnameを省略 | 必須のスキーマフィールド;400と422の説明がすべてのバリエーションをマップするわけではない | 動作を記録;ゲート前に正確なマッピングを解決 | 名前なしで200を返した;不一致を保持 |
5. 実行ファイルを生成して検査します(プロンプトB)。 承認済みマトリクスと仕様をこのプロンプトとともに添付します。
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. 実行、保存、クリーンアップ。 実行固有のペットIDを使用し、作成レスポンスをキャプチャし、そのIDを後のリクエストに渡します。更新を新規読み取りで検証します。更新レスポンスの成功だけでは、サーバーが変更を永続化したことを証明しません。
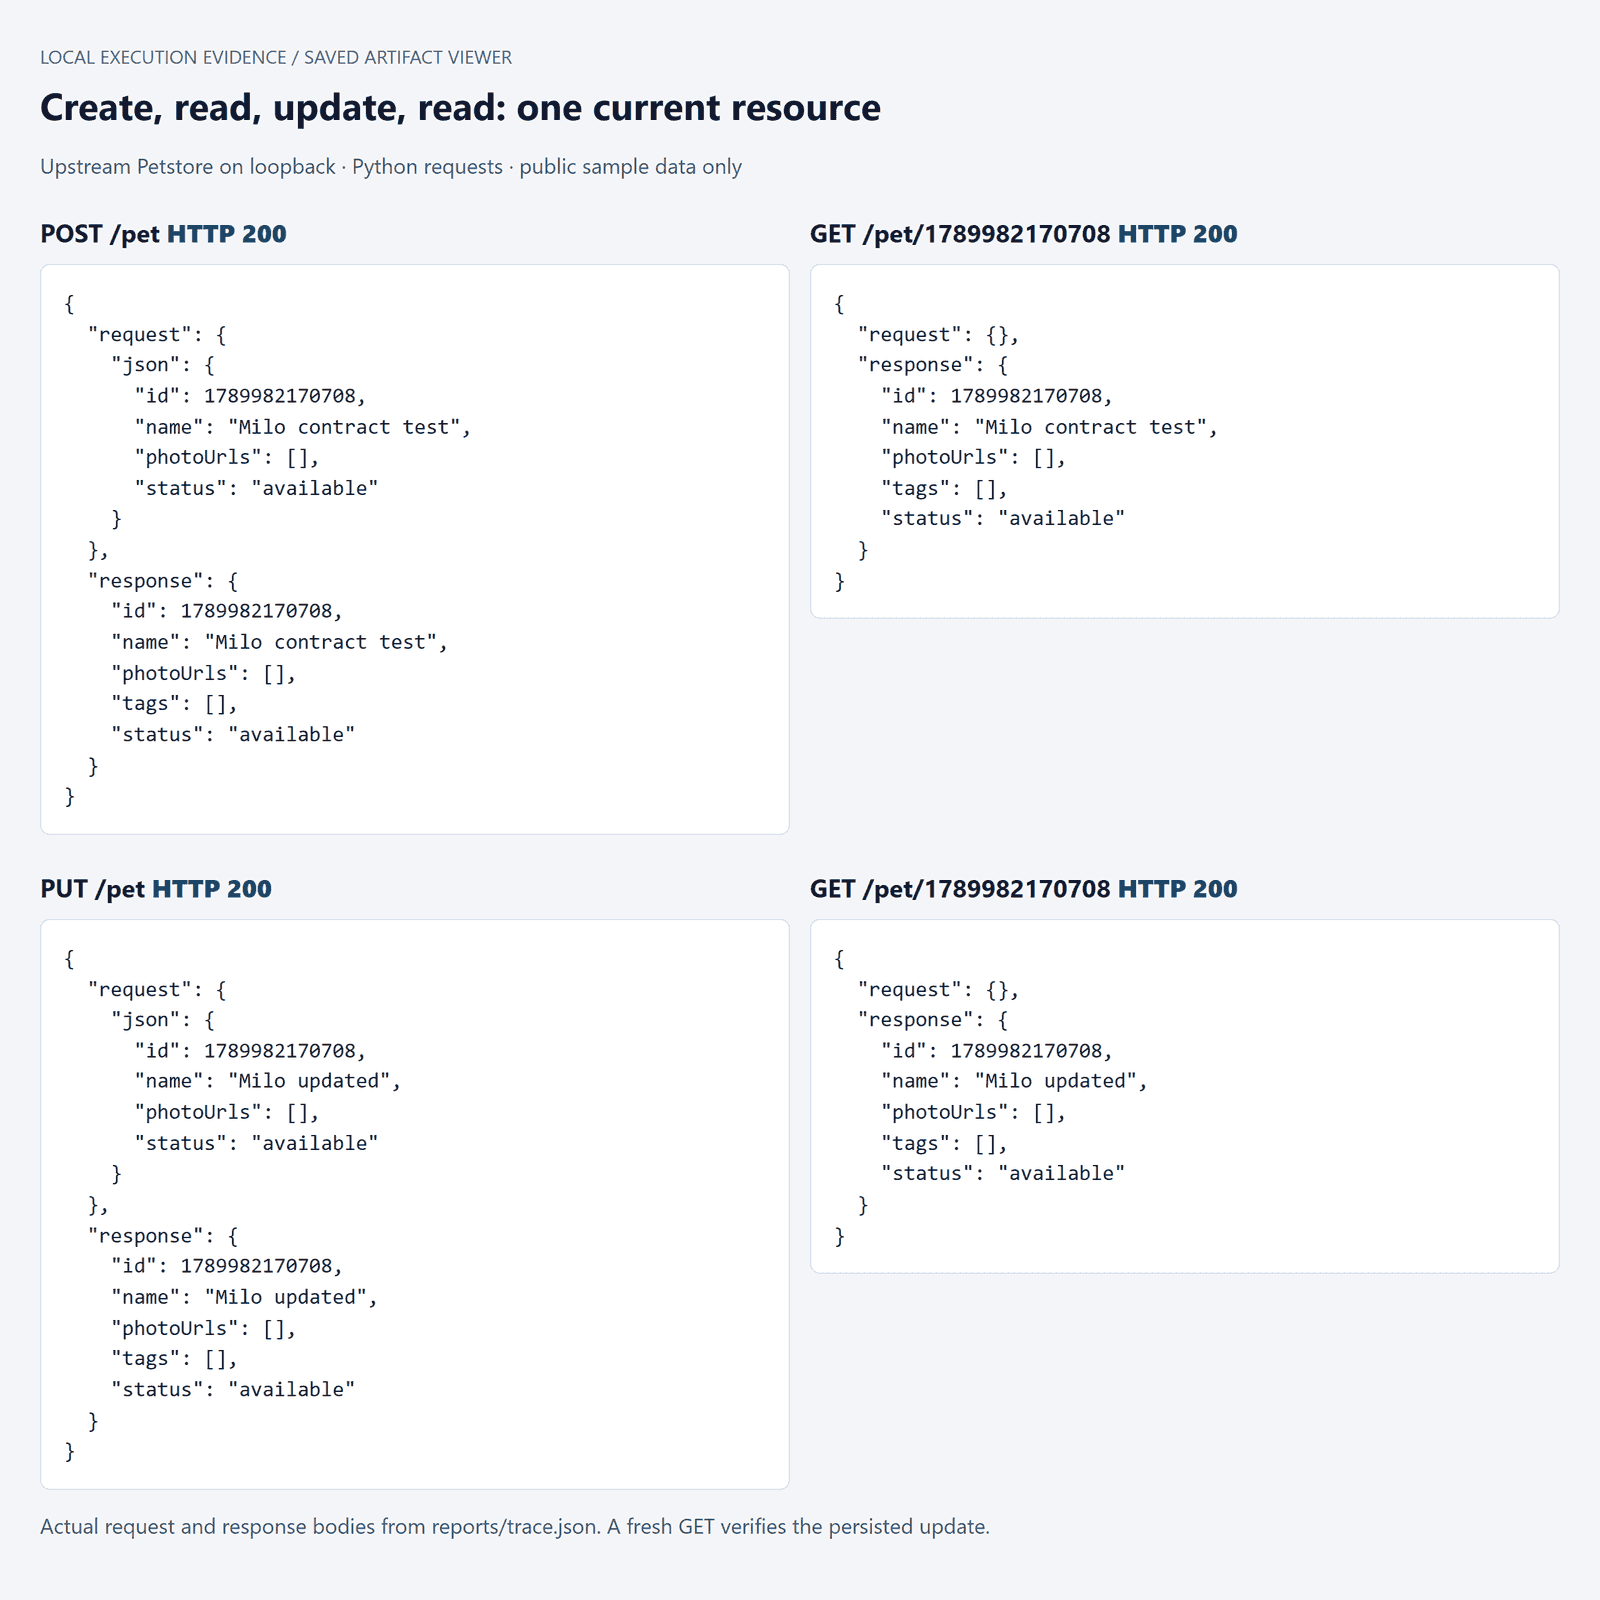 作成、検索、更新、ID転送を示すローカルPetstoreリクエストチェーン証拠
保存されたローカルリクエストとレスポンス:同じ実行固有IDが作成、読み取り、更新、新規読み取りを経て存続。表示された4つのリクエストはすべて200を返しました。
リクエストボディ、レスポンス、アサーション失敗、クリーンアップ結果を保存します。削除はこの実行で作成されたIDに限定します。デモ実装が無効な入力を受け入れる場合を含め、予期しないレスポンスを発見として保持します。緑のスクリーンショットを得るためだけにアサーションを調整しないでください。
この実行でわかったこと: 5つのライブテスト関数が合格しました。無効IDと無効ステータスのチェックが400を返すことも含みます。別の欠落名プローブは200を返し、nameのないボディを返しました。そのスキーマの不一致は緑のスイートの外に保持しました。その正確な意図されたエラーマッピングはまだ明確化が必要です。作成された両方のレコードは正常に削除されました。
ローカルテストはこの記事の実行で起草され、3つの商用ツールとは独立しています。5つのライブテストはすべて保持され、実行後に削除されたり期待値が緩和されたりしたものはありません。人間のレビュー時間は測定されませんでした。証拠フォルダにはテストファイル、依存関係ロック、生のレスポンス、再現手順が含まれています。
APIテスト向けAIツールを検証する方法
有用なアサーションは関連する誤った回答を拒否するべきです。実行中のサービスを変更せずにそのプロパティをテストできます。実際の成功レスポンスを保存し、コピーし、一度に1つのフィールドを意図的に変更します。これらは制御されたレスポンス変更であり、本番の脆弱性や完全なmutation-testingベンチマークではありません。
元のステータスとボディを一緒に保ちます。まず、変更されていないレスポンスに対してバリデータを実行し、ベースラインを受け入れることを確認します。次に3つの独立したコピーを作成します。IDを変更し、名前の型を変更し、必須の名前を削除します。各コピーは、変更と一致する理由で失敗するはずです。
| 保存されたベースライン | 制御された変更 | 関連するチェック | 実際の結果 |
|---|---|---|---|
| 現在のペットの成功した検索 | 別の整数IDに置き換える;ステータス200を保つ | 返されたIDがこの実行の期待IDと等しい | 失敗:期待IDと実際のIDが異なる |
文字列name | 名前を数値に置き換える | Petスキーマの文字列型 | 失敗:42は文字列ではない |
必須のnameが存在 | 名前を削除 | Petスキーマの必須リスト | 失敗:nameは必須 |
IDの例は一般的な弱点を露呈します。スキーマバリデータは、形状が有効なままであるため、誤った整数を受け入れることができます。関係アサーションが欠落した制約を提供します。他の2つの例では、スキーマ検証がステータスのみのチェックでは見えない制約を提供します。
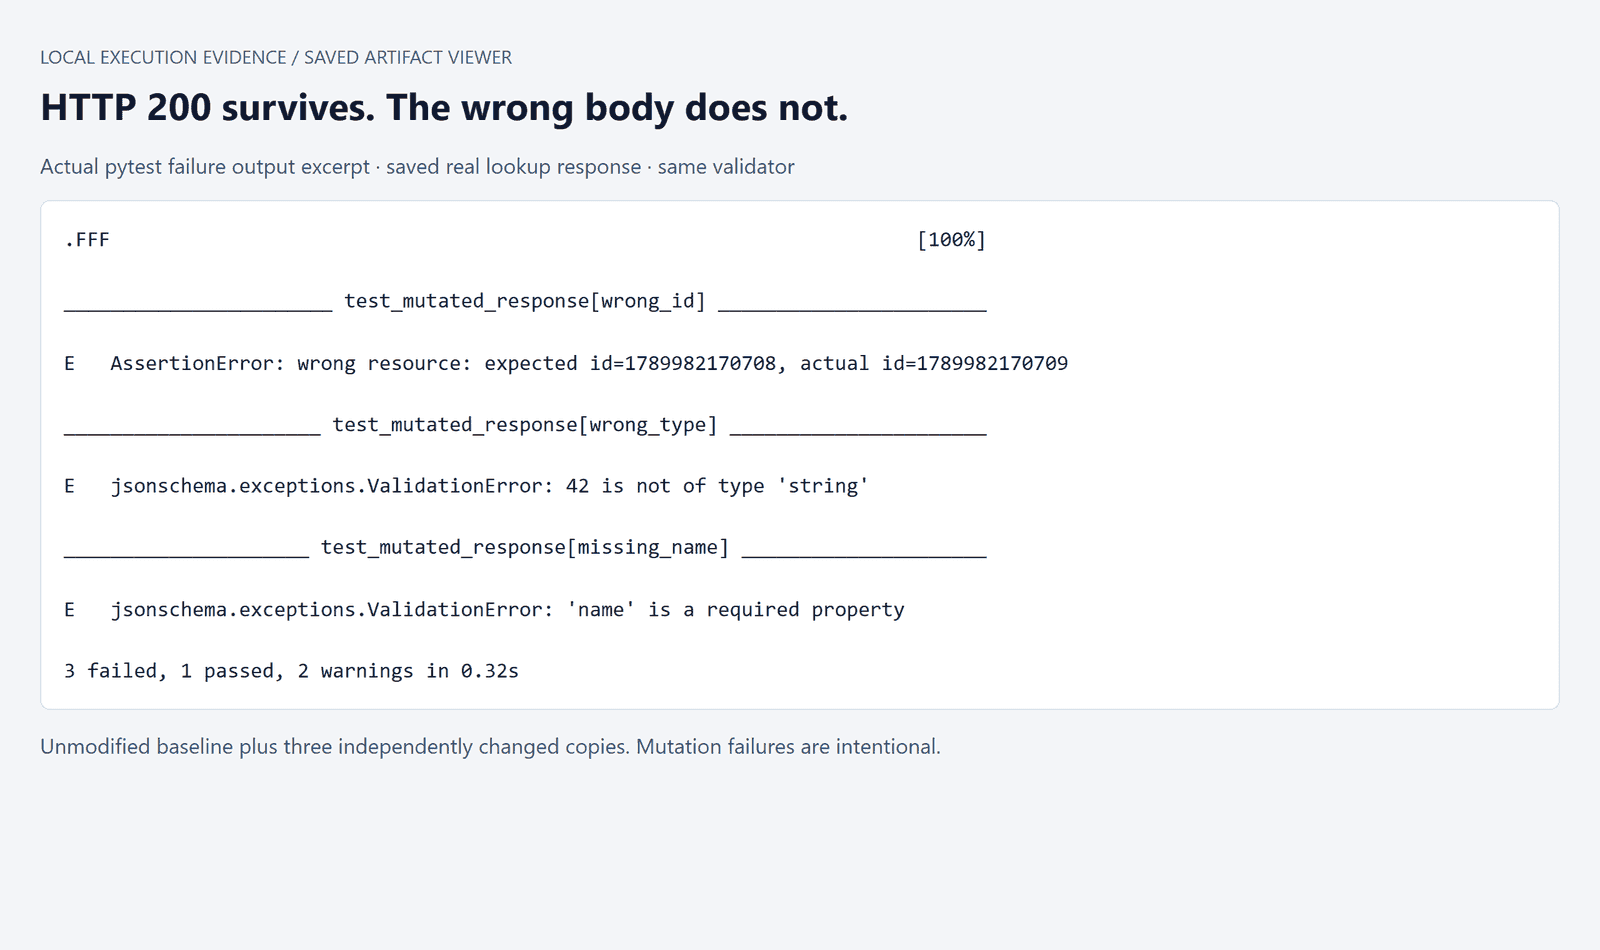 制御されたPetstoreレスポンス変更に対する実際のアサーション失敗出力
実際のpytest失敗抜粋:元のレスポンスは合格し、3つの独立した変更はすべて失敗しました。これらの失敗は保存されたコピーで意図的に誘発されました。
この実行では、変更されていないベースラインが合格し、変更されたコピーの3分の3が失敗しました。変更実行は終了コード1を返し、失敗シグナルを保持しました。バリデータはPetスキーマの関連する構造制約と別個のID関係チェックを適用します。この小さなデモは完全なOpenAPI準拠バリデータではありません。
再現可能な監査のために、テストファイルと固定された仕様をプロンプトCに添付します。
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
提案された「自己修復」の変更は特に注意してレビューしてください。期待される400を200に置き換えると、リグレッションが隠れる可能性があります。正当なコントラクト変更には、要件の参照とレビュー済みのテスト変更が必要です。観測されたレスポンスは調査の証拠であり、正確性を再定義する自動的な許可ではありません。
AIに修正を求める前に、失敗カテゴリを分離してください。タイムアウトは利用できない環境を示す場合があります。検索失敗は壊れたフィクスチャから生じる場合があります。インポートエラーはテストコードに属します。合意されたコントラクトとの再現可能な不一致は製品に属する場合があります。それらを区別するのに十分なコンテキストを保持してください。
分母を正直に報告してください。選択された3つのレスポンス変更を検出することは、それら3つの変更に対する感度を証明します。エンドポイントカバレッジ、コードカバレッジ、セキュリティカバレッジ、または一般的な欠陥検出率を証明するものではありません。同様に、多数のテスト数は、重複シナリオやそのアサーションの強さについてほとんど何も述べません。
認証と承認は、適切なアプリケーションで独立したテストに値します。欠落した認証情報、期限切れの認証情報、別のユーザーのリソースへのアクセスです。Petstoreのデモ動作は、本番のアクセス制御が機能することを証明できません。
CI/CDにおけるAPIテスト向けAIツール
レビュー担当者がスイートを受け入れたら、その正確なバージョンをコミットします。ビルドは候補アプリケーションに対して既知の期待値を実行するべきです。毎回のビルド中にテストを再生成すると、別の変化するコンポーネントが導入され、失敗の再現が難しくなります。
ランナー、依存関係、フィクスチャ、仕様を固定します。依存関係ロックをテストと並べて保存し、レポートにアプリケーションリビジョンを保持します。CI環境からシークレットを解決し、生成されたファイルに含めず、失敗ログがそれらを露出しないことを確認します。
pytestでは、基本的なレポート形式はシンプルです。
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
ジョブ環境を通じてBASE_URLを提供します。ジョブライフサイクルでローカルサービスを起動し、準備完了を待ってからスイートを実行します。失敗時でも常にレポートとサービスログを収集します。最後にジョブ自身のサービスを停止し、そのデータをクリーンアップします。共有エージェントでプロセス全体のクリーンアップコマンドを避けてください。
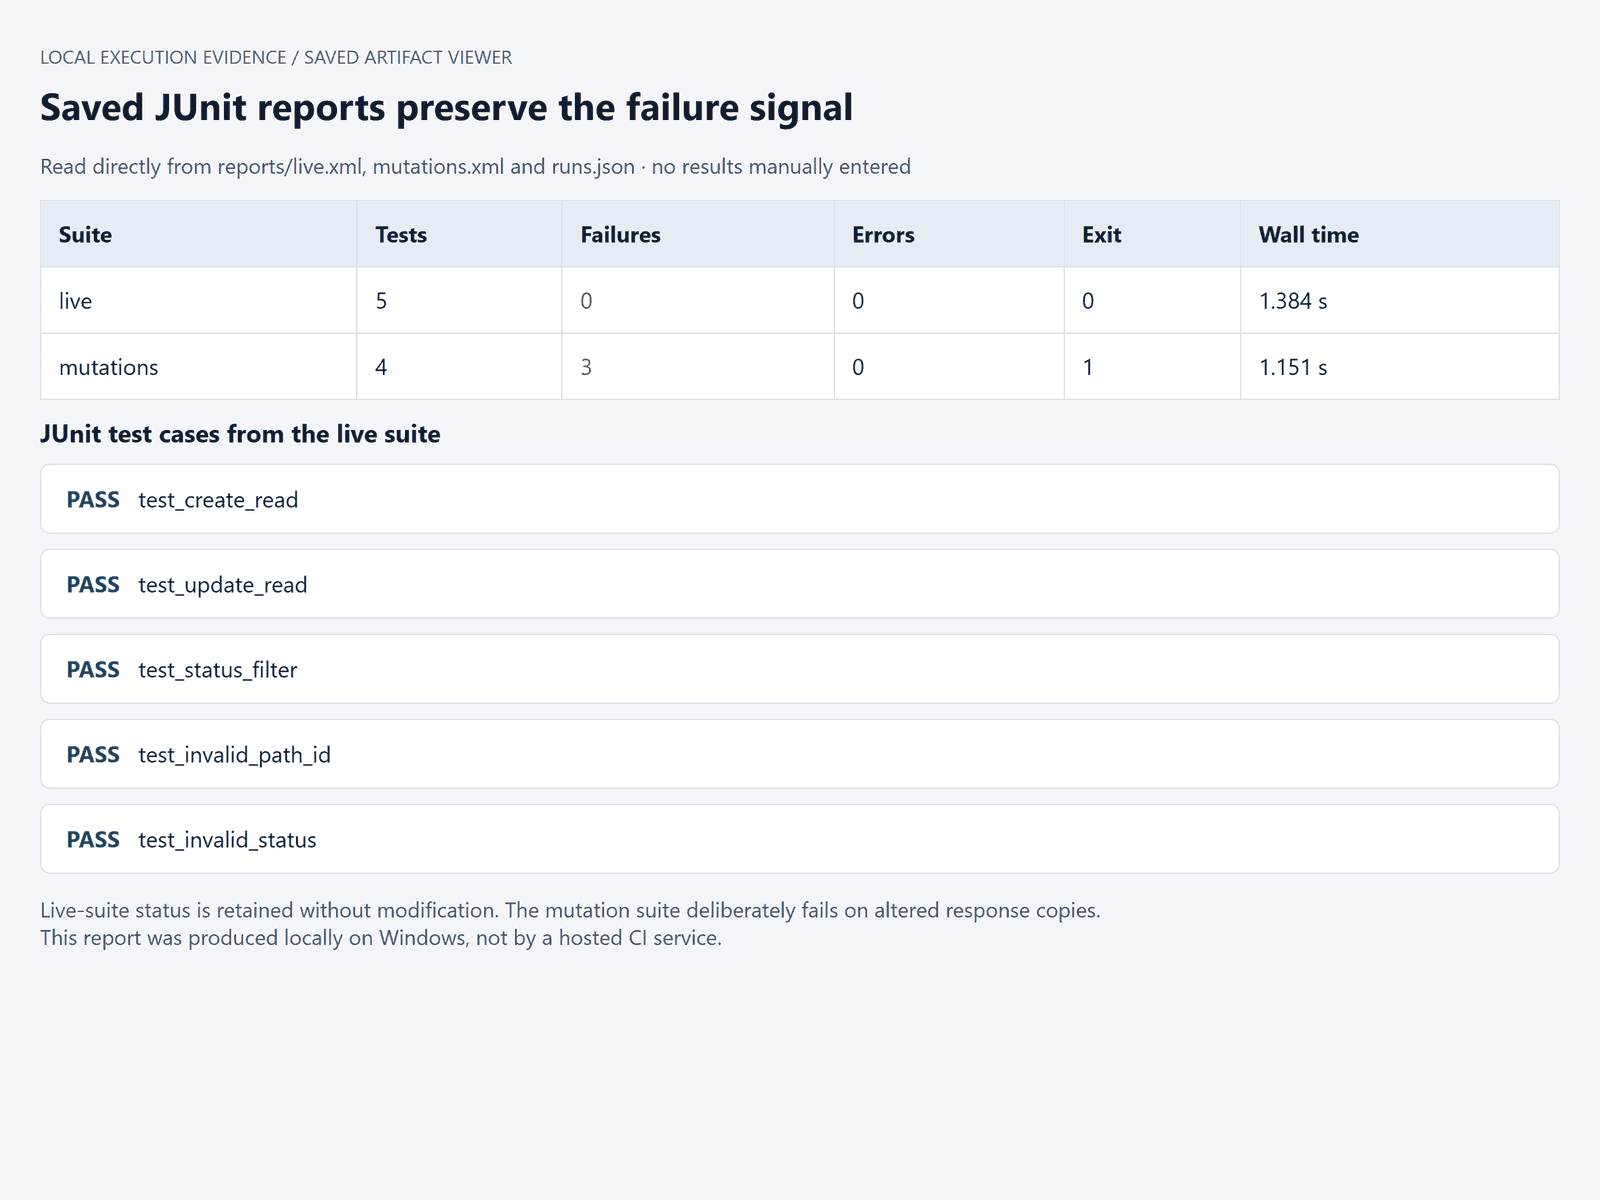 ライブコントラクトとアサーションチェックの結果を分けたローカルpytest JUnitレポート_実際のローカル_
JUnit結果:5つのライブテストが合格;制御されたコピーのスイートには1つの合格ベースラインと3つの意図的な失敗が含まれる。ホストされたCI実行は主張していません。
Pythonプロセス起動を含む測定されたウォールタイムは、ライブスイートが1.384秒、制御されたコピーのスイートが1.151秒でした。これらはサービスのビルド/起動、依存関係のインストール、起草、レビューを除外しています。JUnitファイルと省略されていないログは別々に保存されています。
ゲートに依存する前に失敗経路をテストします。失敗したアサーションは失敗するジョブ終了コードを生成する必要があります。再試行は、既知のインフラ一時的障害に対して制限され正当化されるべきです。最終的に製品の失敗を隠す繰り返しの再試行は、ゲートの情報価値を下げます。
クリーンアップ失敗を明示的に処理します。主要なアサーション失敗を可視化し続け、どのリソースが残っているかを記録し、teardownに独自の問題を報告させます。並列ジョブは別々の識別子または名前空間を必要とします。単独では合格するが別のジョブのデータを読み取るテストは、無人使用の準備ができていません。
すでにpytestがあるなら、起草モデルを別途選択できます。Atlas Cloudはこの狭い役割に適合します。実行とレポートがすでに存在するカスタムワークフローのためのモデル層です。ここでは完全なAPIテストプラットフォームや、上記3つの製品のネイティブバックエンドとして提示されていません。
その評価のために、DeepSeek V4.1 Flash、モデルIDdeepseek-ai/deepseek-v4.1-flashを開き、ローカルで使用したのと同じ公開仕様とレビュー済みマトリクスを提供します。プロンプトBを使用し、返された草案をレビュー済みテストとは別に保存します。何かを実行する前に、その仮定をコントラクトと比較してください。
インターフェースで公開されている場合、温度0.2は起草の開始設定であり、決定性の保証ではありません。利用可能な出力制限をスイートのサイズに対して確認してください。古い記事から予算を立てるのではなく、トークン価格については現在のモデルカタログを参照してください。
作業の分担は明示的に保たれます。モデルがコードを提案し、レビュー担当者が期待値を承認し、ランナーが結果を生成します。テスト環境アクセスゲートにより、この記事のAtlas実行は完了しなかったため、これは測定されたモデル結果ではなく評価レシピです。動作するテストランナーを移行したり、その実行責任をチャットモデルに引き渡したりせずに、この経路を評価できます。
チーム向けのAPIテスト用AIツールの選び方
意思決定を変えられる最小の評価を選んでください。1つの接続されたワークフロー、1つのドキュメント化されたネガティブケース、いくつかの制御された誤ったレスポンスを使用します。候補間で入力を同等に保ちます。洗練されたオンボーディング体験は、誤ったリソースを識別できないテストを上回るべきではありません。
成熟したコレクションワークフローでは、そのワークスペースのAI機能を評価することから始めます。既存の環境設定とリクエストの依存関係は価値のあるコンテキストです。生成された変更が脆い仮定を導入せずにレビュー作業を節約するかを測定します。
堅実な仕様と作成バックログを持つチームには、仕様ベースの生成を評価します。仕様が不完全なときに何が起こるかに注意してください。欠落した期待値を明確にフラグを立てるジェネレーターは、自信を持ってそれらをでっち上げるものよりレビューが容易です。
失敗がアップストリームの動作に依存するアプリケーションには、記録とリプレイを評価します。大規模な記録に投資する前に、キャプチャしたベースラインと依存関係サポートを検査します。どの動的フィールドが変動してよく、どの関係が無傷でなければならないかを決定します。
安定したランナーを持つチームには、起草とレビューのための独立したモデルを評価します。すでに知っている実行形式を保持しますが、統合、フィクスチャ設計、メンテナンスも所有します。その所有権をコスト計算に含めてください。
APIテスト用AIツールに支払う前に、5つの具体的な実証を要求してください。
- レビュー済みスイートが意図した環境に対して実行される。
- 関連する制御されたエラーが適切なアサーションを失敗させる。
- テストと有用なレポートが許容可能な形式で保持できる。
- 繰り返し実行(CI実行を含む)が分離と失敗シグナルを保持する。
- 生成、実行、メンテナンスのコストがチームの予算に適合する。
受け入れられたスイートを維持するために誰かを割り当てます。仕様変更は、影響を受けるアサーション、フィクスチャ、消費者のレビューをトリガーするべきです。変更が理解されるまで古い失敗証拠を保持します。これにより次のリリースが評価しやすくなり、チームが緑のレポートを信頼する理由が得られます。
よくある質問
APIテストにはどのAIツールを使うべきですか?
既存の入力から始めてください。確立されたコレクションにはPostman Agent Modeを、仕様主導の生成にはKushoAIを、その異なる生成フローと記録経路にはKeployを評価します。チームがすでにpytestや別のランナーを維持している場合、別の起草モデルが適合するかもしれません。各候補のアサーション、実行、レビュー作業を評価するために、同じ小さなワークフローを使用してください。
無料のAPIテスト向けAIツールはありますか?
無料のクライアント、オープンソースのテストツール、限られたAI許容量があります。それらは異なるニーズをカバーしています。Postmanの無料プランは2026年9月21日時点で月50 AIクレジットを記載しています。それはテスト数ではありません。インタラクティブ試行を無料のCIソリューションとして扱う前に、必要なエクスポート、自動化、レポート、コラボレーション機能が含まれているか確認してください。
AIはOpenAPI仕様からAPIテストを生成できますか?
はい、ジェネレーターは操作、スキーマ、パラメータ、レスポンス定義を使用してテストを提案できます。仕様はビジネスルールを省略したり、エラーマッピングを曖昧に残したりする場合があります。承認済みの期待値を提供し、結果をレビューしてください。固定されたPetstoreの例では、成功した作成が200としてドキュメント化されており、なじみのあるRESTの慣習が実際のコントラクトを置き換えられない理由を示しています。
AI生成のアサーションが有用かどうかをどうやって知りますか?
3つのことを確認します。ドキュメント化されたスキーマ制約、リクエストとレスポンスの関係、意図的に誤ったデータへの感度です。実際のレスポンスを保存し、関連するプロパティを1つ変更し、同じバリデータを再実行します。失敗メッセージを保持します。これにより、それらのアサーションについて狭く再現可能な証拠が得られますが、より広いカバレッジとセキュリティの質問は別のテストに残ります。
AI生成のAPIテストをCI/CDで実行できますか?
はい、生成された形式、ランナー、環境、プランがその経路をサポートしている場合です。レビュー済みテストをコミットし、固定された依存関係をインストールし、隔離されたフィクスチャを使用し、JUnitなどの構造化レポートをエクスポートします。失敗が非ゼロの終了コードを返すことを確認します。ローカル実行の成功はスイートをCIの準備をしますが、ホストされたパイプラインが実行されたことを証明しません。
AIは手動APIテストを置き換えられますか?
AIは反復的な起草を減らし、レビュー担当者が弱いアサーションを見つけるのを助けることができます。人は依然として意図された動作を決定し、曖昧な失敗を調査し、提供された例の外のリスクを探索します。APIテスト用AIツールを使用してレビュー可能なテスト資産を生成し、再現可能な証拠でそれらを判断してください。意味のある間違いを捉える小さなスイートは、説明のつかない緑のチェックの集合より信頼しやすいです。


