DeepSeek Harnessはそのベンチマークには含まれていませんでした。2日後にリリースされたのです。つまり、重要な質問は「どちらが勝ったか?」ではありません。重要な質問は、同じモデルで同じタスクを両方のツールで実行し、自分を欺かずに請求額を読み解く方法です。
主なポイント
- ハーネスの選択により、同等のエージェントタスクでトークン使用量が約7倍変動する可能性があります。
- DeepSeek HarnessとOpenCodeを同じモデル、同じリポジトリの状態で測定します。
- 日常的な作業に使用する前に、別々のAPIキーを使用してください。
2台のラップトップが、2つのエージェントハーネスを通じて同じコーディングタスクを実行
公平な設定:1つのモデル、1つのタスク、2つのターミナル。
公開ベンチマークが示すもの
Composioは、8つのエージェントハーネスを使用して30の複雑なマルチアプリワークフローを実行しました。すべてDeepSeek V4 Flashを使用し、タスクあたり900秒の上限、240回の実行でバイナリプログラム評価を行いました(Composio、2026年8月)。同じモデル、異なるハーネスです。
| ハーネス | 合格率 | 中央時間 | タスクあたりの平均トークン数 |
|---|---|---|---|
| Pi Agent | 66.7% | 132.2秒 | 559,000 |
| Prime Agent | 62.5% | 242.1秒 | 1,400,000 |
| OMP | 56.7% | 272.4秒 | 742,000 |
| Claude Code | 53.3% | 122.7秒 | 742,000 |
| Codex | 53.3% | 245.0秒 | 678,000 |
| DeepAgents | 53.3% | 187.1秒 | 665,000 |
| Hermes Agent | 50.0% | 175.5秒 | 192,000 |
| OpenCode | 46.7% | 129.7秒 | 692,000 |
トークン列はランキングよりも重要です。範囲はタスクあたり平均192,000トークンから1,400,000トークンに及びます。同じモデルが、異なるランタイムを通じて同等の作業を行っているのです。
OpenCodeはソース付きのベースラインを提供します:タスクあたり692,000トークン、合格率46.7%、中央時間129.7秒。DeepSeek Harnessは、DeepSeekが2026年8月13日にリリースしたため、このベンチマークからの公開された直接比較数値はありません。ベンチマーク公開の2日後です。
この表を警告として使い、評決として使わないでください。ハーネスがコストを支配する可能性があることを示しています。DeepSeek HarnessがあなたのリポジトリでOpenCodeに勝るかどうかを証明するものではありません。
ハーネスを切り替えると何が変わるか
テストする前に、現役の開発者に影響を与える部分(セットアップの表面、成熟度、トークンの可視性、エージェントループのどれだけを置き換えられるか)で2つのツールを比較してください。
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| 提供元 | DeepSeek AI | Anomaly (元SST) |
| リリース日 | 2026年8月13日 | 2025年後半 |
| GitHubスター数 | ~143k | ~198k |
| ライセンス | MIT | MIT |
| 言語 | TypeScript | Go |
| インターフェース | 127.0.0.1:3080上のWeb UI | ターミナルTUI |
| ステータス | 開発者プレビュー、破壊的変更の可能性あり | 成熟しており、広く展開されている |
| アーキテクチャ | モデル、ツール、セッション、サンドボックス、ストレージ、ループ、UIのプラグインを交換可能 | 固定コア+ビルド/プランエージェント、MCPサポート、LSP拡張 |
| 設定 | $DSH_HOME/settings.yaml | opencode.json |
| トークン管理 | コンテキストプレッシャーと内訳予測付きのトークンメーター | TUI内のセッションごとのトークンとコスト追跡 |
| 最適な用途 | エージェントループ自体を変更したいチーム | 今日すぐに使えるコーディングエージェントが必要なチーム |
OpenCodeは、安定したコーディングエージェントと、周辺の拡張ポイントを提供します。DeepSeek Harnessは、ループ自体を交換できるランタイムを提供します。その柔軟性は、エージェントインフラストラクチャを構築している場合に役立ちます。今週中に本番コード用のデフォルトツールが必要な場合、リスクが増します。
どちらのツールも同じOpenAI互換エンドポイントにアクセスできます。これにより、公平なテストが可能になります:1つのモデル、1つのベースURL、1つのタスク、1つの開始リポジトリ状態。
このチュートリアルでは、DeepSeek V4 FlashはAtlas Cloudを通じて実行されます。これは両方のツールで受け入れられるOpenAI互換エンドポイントを公開しています。deepseek-v4-flash-0731のリストには、入力トークン100万あたり0.14ドル、出力トークン100万あたり0.28ドル、コンテキストウィンドウ1,048,576トークン、最大出力393,216トークン(2026年8月現在)と表示されています。両方のハーネスが同じエンドポイントとモデルIDを使用する限り、任意のプロバイダーで機能します。
OpenCodeはまた、集計使用量データを公開しています。DeepSeekモデルはOpenCodeを通じて233兆トークンを移動しており、V4 Flashが85.5%、V4 Proが14.5%を占めています(OpenCode、2026年8月)。この使用パターンにより、V4 Flashは比較のための実用的なデフォルトになります。
ステップ1:両方のツールを同じモデルに向ける
1つのAPIキーと1つのベースURLを作成し、両方のツールに同じペアを提供します。Atlas Cloudコンソールでキーを作成し、一度エクスポートします:
plaintext1export ATLAS_API_KEY="your-api-key" 2
エンドポイントを確認してから、どちらかのハーネスに渡します:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Reply with the single word: ready"}] 7 }' 8
この呼び出しは、ハーネスがツール、リトライ、会話の再生を追加する前に、ルート、キー、モデルIDが機能することを証明します。
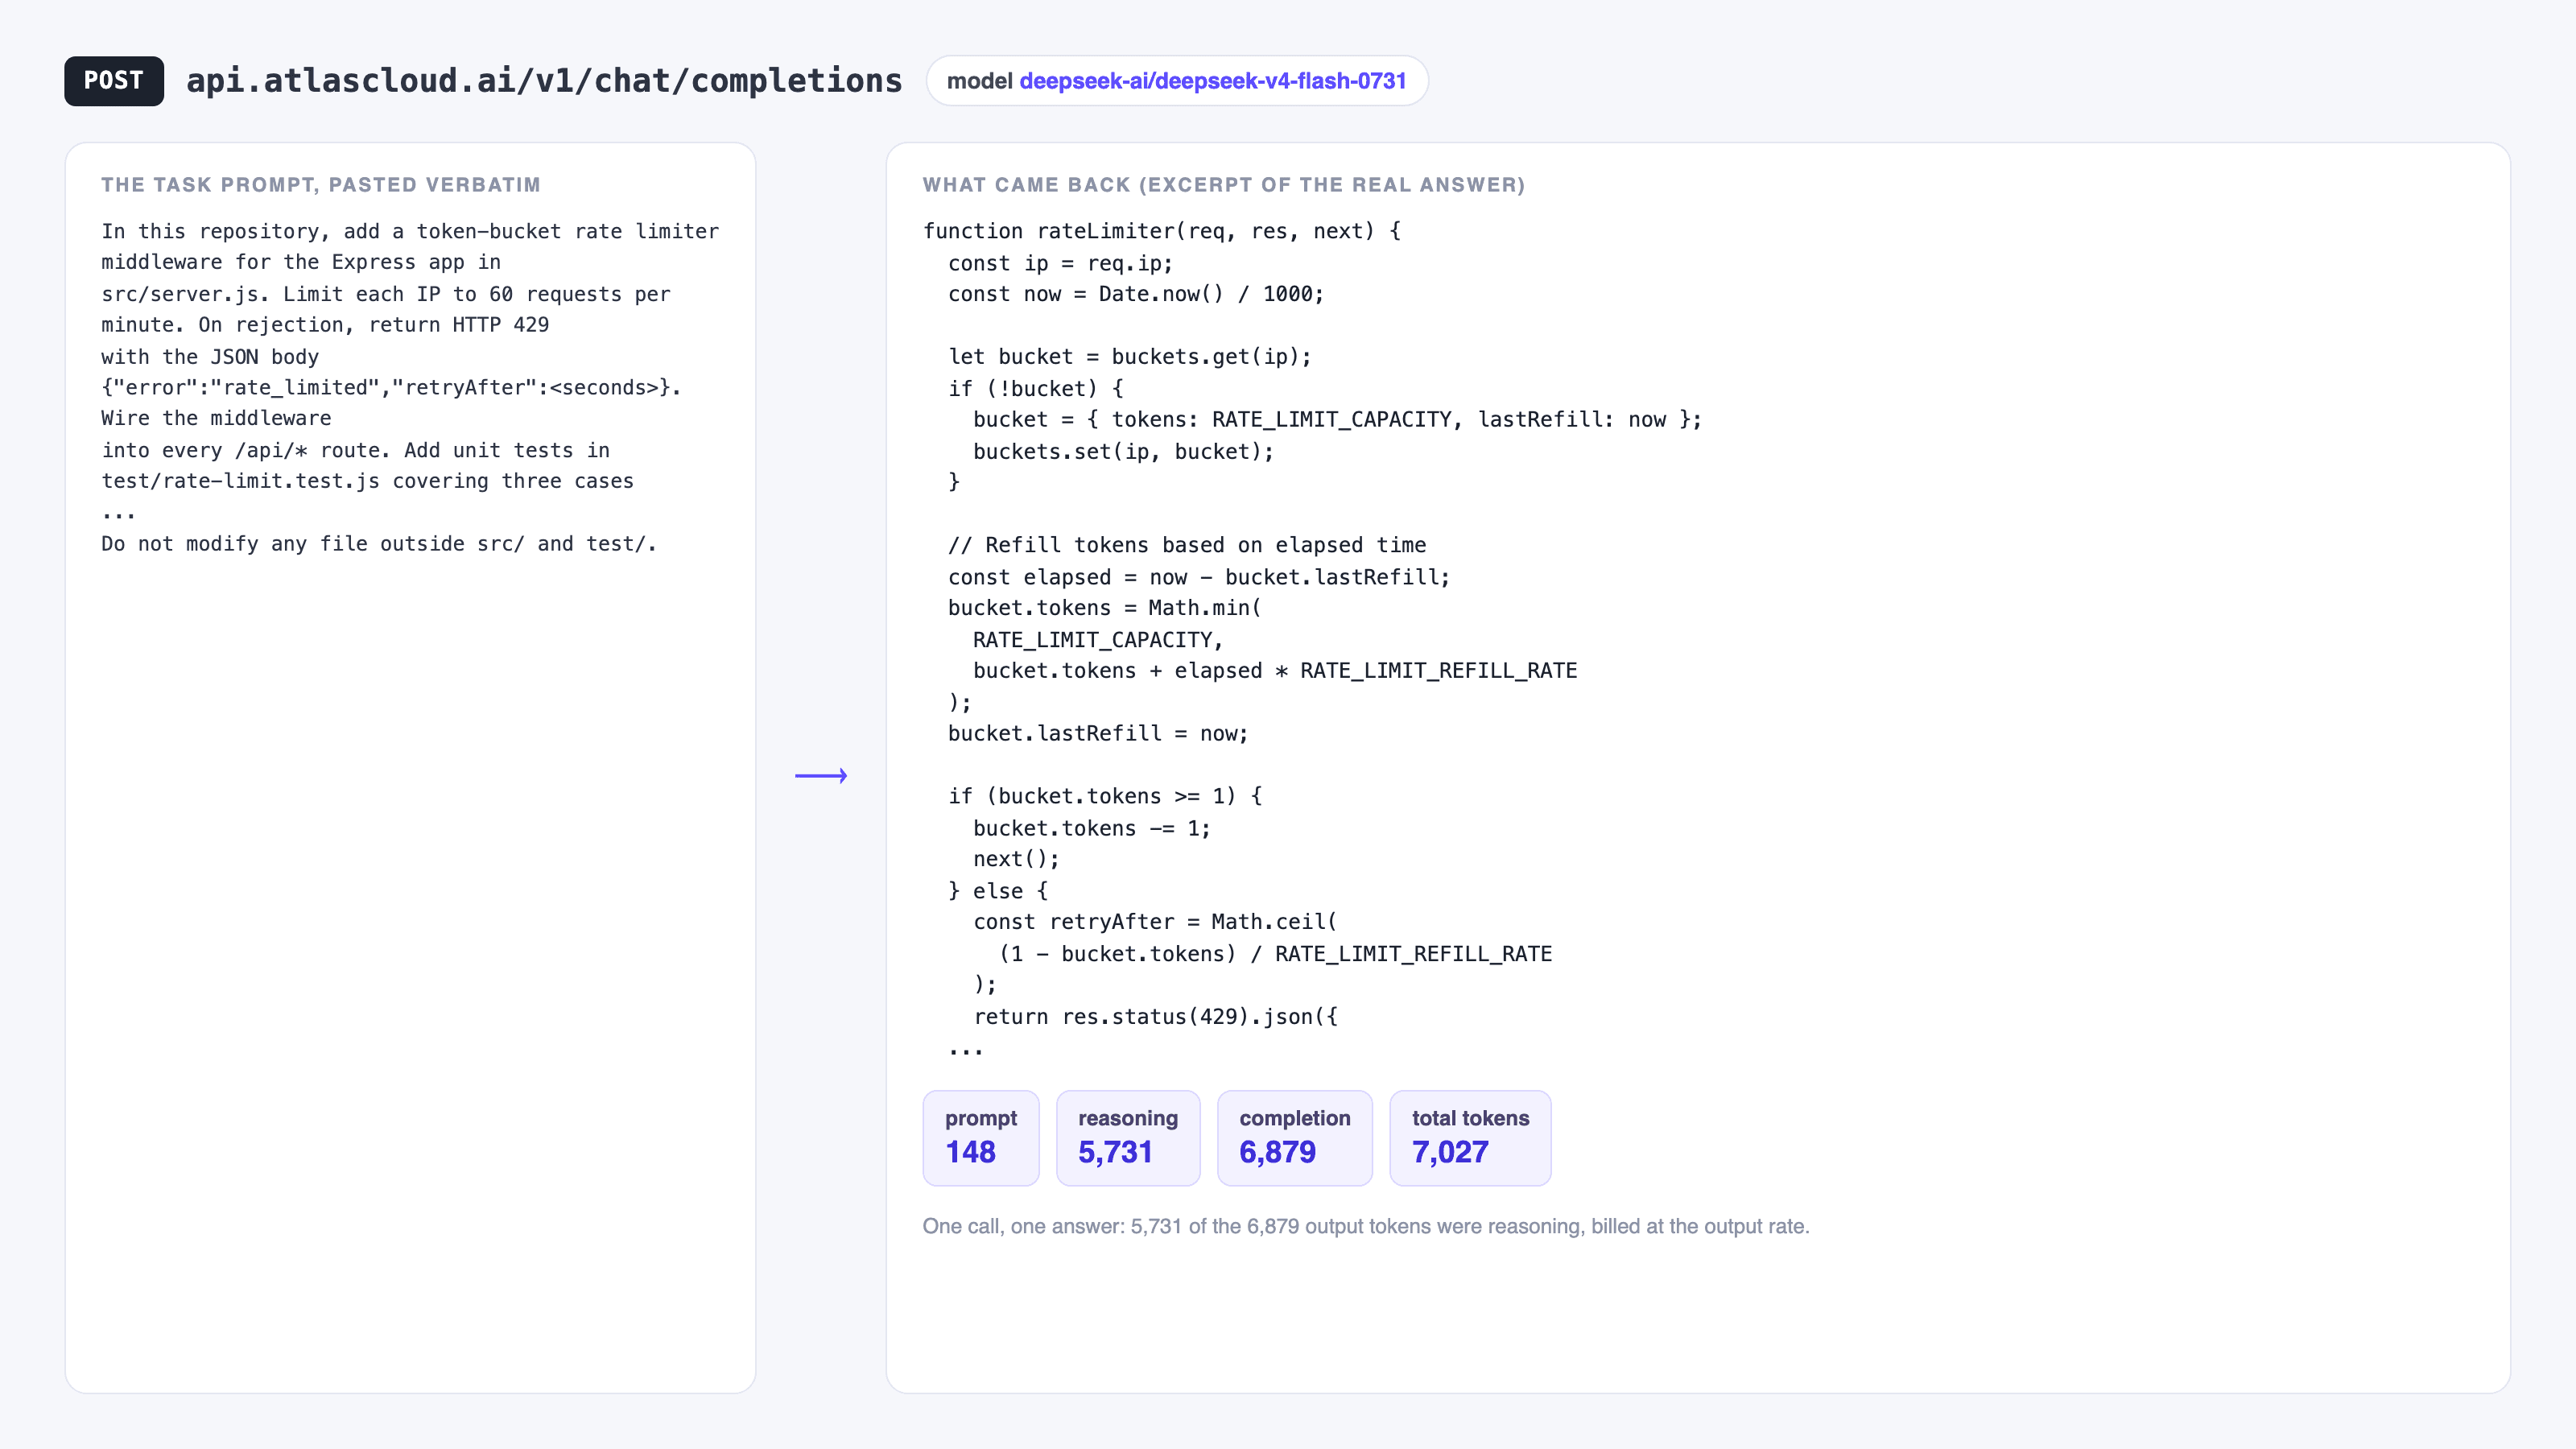
コーディングプロンプト、生成されたコード、1回のモデル呼び出しからのトークン統計
deepseek-ai/deepseek-v4-flash-0731への1回の直接呼び出し:入力148トークン、出力6,879トークン(うち推論トークン5,731)。ハーネスがツールスキーマと履歴を追加する前のフロアとして扱います。
DeepSeek Harnessは$DSH_HOME/settings.yamlを読み取り、カスタムのOpenAI互換プロバイダーはllm-pi-aiプラグインの下に設定します(DeepSeek Harnessドキュメント、2026年8月):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
このエンドポイントにはopenai-completionsを使用します。Web UIからも、設定、モデル、カスタムプロバイダーの追加で同じプロバイダーブロックを書き、キーを$DSH_HOME/.credentials.yamlに保存できます。
OpenCodeは、プロジェクトルートまたはグローバル設定ディレクトリにあるopencode.jsonを読み取ります(OpenCodeドキュメント、2026年8月):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
このエンドポイントは/v1/chat/completionsを提供するため、@ai-sdk/openai-compatibleを使用します。実際のコンテキストと出力制限を設定します。OpenCodeは要約を決定するときにこれらを使用し、間違った制限はトークン比較を歪める可能性があります。
ステップ2:DeepSeek Harnessで同じベンチマークタスクを実行する
複数のツール呼び出しを必要とし、かつ評価が可能な十分な大きさのタスクを選択します。両方の実行で同じリポジトリ状態を使用するため、開始前にコミットするかスタッシュします。
この正確なタスクを両方のツールに貼り付けます:
plaintext1このリポジトリ内で、src/server.jsのExpressアプリにトークンバケットレート制限ミドルウェアを追加してください。各IPを1分間あたり60リクエストに制限します。拒否時には、HTTP 429とJSONボディ {"error":"rate_limited","retryAfter":<秒数>} を返します。ミドルウェアをすべての /api/* ルートに配線します。test/rate-limit.test.js に、制限内のリクエストは許可される、制限を超えるリクエストは429でブロックされる、ウィンドウが期限切れになるとカウンターがリセットされる、の3つのケースをカバーする単体テストを追加します。テストスイートを実行し、通過するまで失敗を修正します。src/ と test/ 以外のファイルは変更しないでください。
プロジェクトディレクトリからHarnessを起動します:
plaintext1cd /path/to/your/repo 2npx @deepseek-ai/dsh web 3
UIはhttp://127.0.0.1:3080で実行されます。atlasプロバイダーとdeepseek-ai/deepseek-v4-flash-0731モデルを選択し、タスクを貼り付けて、完了するまで待ちます。実行開始後にヒントを追加しないでください。一方のツールに対する追加の助けは比較を無効にします。
Harnessが完了したら、Trajectoryビューを開きます。このセッションレコードにトークン数が表示されます。
ステップ3:OpenCodeで実行を繰り返す
リポジトリを正確な開始状態にリセットします。2番目のハーネスは、最初のハーネスがすでに変更したファイルを継承してはいけません。
plaintext1git checkout -- . && git clean -fd 2
次に、同じモデルに対してOpenCodeを実行します:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
ステップ2と同じタスクプロンプトを貼り付けます。デフォルトのbuildエージェントを使用します。ヒントなしで完了させます。
両方の実行を同じコマンドで評価します:
plaintext1npm test 2
スイートが赤のままの実行は失敗です。エージェントのサマリーが自信満々でもです。バイナリ評価を使用します:合格または不合格。
ステップ4:トークン使用量を読み取る
両方のツールが使用量を追跡しますが、どちらのカウンターも最終的な請求書番号として使用すべきではありません。
DeepSeek Harnessには、デフォルトでマウントされたトークンメーターが付属しています。TrajectoryビューでtokenUsage、contextPressure、contextBreakdownを公開します。contextBreakdownは、請求額がシステムプロンプト、ツールスキーマ、ファイル読み取り、会話の再生のどれから来たかを示します。メーターはおおよそ1トークンあたり4文字と見積もるため、診断ビューとして使用します。
OpenCodeはセッションごとのトークンとコストを追跡し、TUIステータス行に表示します。組み込みの内訳は小さいため、ツールごとの属性が必要なチームは、外部アナライザーでセッションデータベースを検査することがよくあります。
比較にはプロバイダー側の数値を使用します:
| 比較する項目 | 入手先 |
|---|---|
| 入力トークン合計 | プロバイダー使用量ダッシュボード、APIキーごと |
| 出力トークン合計 | プロバイダー使用量ダッシュボード、APIキーごと |
| モデル呼び出し回数 | ハーネストラジェクトリービュー / OpenCodeセッションログ |
| 経過時間 | ストップウォッチ、開始から最後のファイル書き込みまで |
| 合格または不合格 | npm test終了コード |
harness-testとopencode-testの2つのAPIキーを作成し、各キーを1回の実行に使用します。プロバイダーダッシュボードは、2つの内部推定器を調整することなく、クリーンなサイドバイサイドの使用量を提供します。
請求額が変動する理由
トークン使用量は具体的な理由で変化します。通常、以下の5つがモデル価格よりも重要です。
会話の再生が積み重なる。 エージェントは各ステップで成長する会話を再送信します。40ステップのタスクは、40個の同一プロンプトの合計ではなく、40個の成長するプロンプトの合計に近くなります。早期に要約するハーネスは、ベンチマークの範囲の低い方に近くなります。
キャッシュヒットは入力コストを削減する。 DeepSeek V4 Flashのキャッシュヒットは、ミス時の100万トークンあたり0.14ドルに対して約0.0028ドルで、約98%安くなります。キャッシュにはバイト単位で安定したプレフィックスが必要です。ハーネスが呼び出し間でシステムプロンプトテキストをシャッフルすると、ヒットがミスに変わります。
ツールスキーマが一緒に乗ってくる。 20個の接続されたMCPサーバーは、タスクがそのうちの2つを使用する場合でも、プロンプト内に20個のスキーマセットを意味します。ベンチマークする前に不要なツールを切断するか、ツールのセットアップを測定していることになります。
大きなツール出力がコンテキストを汚染する。 3,000行のファイルのcatや冗長な失敗テストログは、後続の呼び出しのために会話に残ります。DeepSeek Harnessは、要約する前に大きなツール結果を刈り込むことができます。タスクがノイズの多い出力を生成する場合は、それをオンにします。
リトライは呼び出し回数の中に隠れている。 失敗したテストループをリトライするハーネスは、毎回トークンを消費します。モデル呼び出しをトークン合計と比較して、リトライループと高価なプロンプトを分離できるようにします。
Atlas CloudのDeepSeek V4 Flashのレートでは、692,000トークンのタスク(入力に偏っている場合)は、1桁セントの低い範囲になります。1回の実行では小さく、チームがエージェントを1日中実行していると大きくなります。完全なモデルカタログを参照して、2番目のモデルでテストを繰り返し、モデル効果とハーネス効果を分離したい場合にどうぞ。
DeepSeek Harnessはまだ開発者プレビューであり、READMEは破壊的変更について警告しています。エージェントループを制御したい場合はベンチマークしてください。チームが変化に対応できる場合にのみ標準化してください。OpenCodeは、今日ツールを必要とするチームにとってより安定した選択肢です。
よくある質問
DeepSeek HarnessはOpenCodeより優れていますか?
ほとんどのチームにとってはまだ優れていません。OpenCodeは成熟しており、ターミナルネイティブで、約198kのスターと大規模なプロバイダーカタログを持ち、今日すぐに使えます。DeepSeek Harnessはより新しく、開発者プレビューであり、破壊的変更について警告しています。エージェント内部を変更したい場合はHarnessを選択してください。日常業務にコーディングエージェントが必要な場合はOpenCodeを選択してください。
DeepSeek HarnessはDeepSeekモデルでのみ動作しますか?
いいえ。モデルに依存しません。DeepSeek、Anthropic、OpenAI、Bedrock、Vertex、Azure、Codexのカタログプロバイダーが付属しており、$DSH_HOME/settings.yamlでopenai-completions、openai-responses、またはanthropic-messagesを話すカスタムプロバイダーを追加できます。ステップ1の設定では、アダプターコードなしでOpenAI互換エンドポイントを指定しています。
DeepSeek Harnessのトークン使用量を確認するにはどうすればよいですか?
Trajectoryビューの組み込みトークンメーターを使用します。tokenUsage、contextPressure、contextBreakdownを公開します。おおよそ1トークンあたり4文字と見積もるため、推定値として扱います。請求精度については、プロバイダー使用量ダッシュボードを読み取り、理想的には各実行に専用のAPIキーを使用します。
DeepSeek HarnessとOpenCodeでは、どちらのハーネスが少ないトークンを使用しますか?
公開された直接比較ベンチマークはまだありません。ComposioベンチマークはOpenCodeをタスクあたり平均692,000トークンと測定しましたが、DeepSeek Harnessが出荷される前に実行されました。独自のリポジトリでステップ2からステップ4のテストを実行してください。トークン使用量はコードベースのサイズ、ツールのセットアップ、タスクの形状に依存するためです。
DeepSeek HarnessとOpenCodeを同じAPIキーに対して実行できますか?
簡単なテストでは可能です。クリーンな測定のためには、ハーネスごとに別々のキーを使用してください。プロバイダーダッシュボードは、すべてのトークンを正しい実行に帰属させます。
エージェントとハーネスの違いは何ですか?
DeepSeekは、エージェントをモデル+ハーネスと説明しています。モデルが推論します。ハーネスはモデルをファイル、シェルコマンド、ツール、セッション、承認、および次のアクションを決定するループに接続します。ハーネスを変更すると、同じモデルでも同じタスクで異なるトークン数を使用する可能性があります。


