

900ページのプロジェクトアーカイブのアップロードは簡単です。難しいのは、モデルがあなたが必要とする正確な条項、コミット、またはデータポイントを指し示せるかどうかです。DeepSeek V4.1 Flash 1Mコンテキストウィンドウのユースケースは、コードベース、研究コーパス、長年のプロジェクト記録など、複数の関連ソースを一緒に考慮する必要がある場合に意味があります。より大きなウィンドウは、それらの資料を事前に分割する必要性を減らしますが、回答が信頼できるかどうかは依然として証拠チェックによって決まります。
最も適しているのは、ファイル横断的なコードレビュー、研究の統合、ポリシー比較、フィードバック分析、プロジェクトタイムライン、長いマルチモーダル記録です。DeepSeekは1Mトークンのコンテキストを記載していますが、その容量はすべての詳細が正確に想起されることを保証するものではありません。使用するルートのモデルとAPIの制限を確認し、結果に依存する前に独自の資料でテストしてください。
主なポイント
- 質問が多くの関連ソース間の関係に依存する場合は、100万トークンのウィンドウを使用します。
- ファイル、セクション、またはページ参照を求め、直接的な証拠と推論を分離します。
- 既知の回答テストから始め、結果が改善する場合にのみコンテキストを拡張します。
- コストは、入力、出力、キャッシュ処理から見積もり、コンテキスト制限だけから判断しないでください。
1Mトークンのコンテキストウィンドウとは何を意味するのか?
コンテキストウィンドウとは、モデルが1回のリクエストまたは会話状態で考慮できる情報の量であり、提供された資料と周囲の指示が含まれます。DeepSeekの現在のAPI価格ページには、DeepSeek-V4.1-Flashが1Mのコンテキスト長と最大384Kトークンの出力を持つと記載されています。これはプロバイダーが公表している制限です。アプリケーション、エンドポイント、またはリクエスト構成によって、より小さな制限が課される場合があります。( DeepSeek APIドキュメント )
トークンはテキストの断片であり、単語やページではありません。コード、表、マークアップ、繰り返しの定型文、スキャンを含むソースアーカイブは、同じページ数のクリーンな散文とは非常に異なるトークン化になる可能性があります。実際のワークロードでは、呼び出すAPIのトークナイザーまたは使用状況レポートでトークンを見積もります。見積もりには、システム指示、ファイル名、メタデータ、質問テキスト、回答の予算を含めます。
実用的な利点は継続性です。最初に手動で要約をつなぎ合わせることなく、複数のモジュールにまたがる依存関係や、現在のポリシーとその付録の間の矛盾について尋ねることができます。トレードオフは、非常に大きなプロンプトに無関係な資料や重複した資料が含まれ、処理に時間がかかり、それでも正確な検索が難しくなる可能性があることです。「ウィンドウに収まる」を容量チェックとして扱い、モデルがタスクに必要な事実を見つけられるかどうかをテストします。
DeepSeek V4.1 Flash 1Mコンテキストの最適なユースケース
正しい質問は「すべてをアップロードできますか?」ではありません。「この回答にはどのソースを比較する必要があるか?」です。回答が資料間のリンクに依存する場合は長いコンテキストを使用し、完全なアーカイブを送信する前にその回答をどのように検証するかを定義します。
| ユースケース | 長いコンテキストが役立つ理由 | 含めるもの | 検証するもの |
|---|---|---|---|
| 大規模コードベースのレビュー | インターフェースと規約がモジュールにまたがる | 関連するソース、テスト、アーキテクチャノート | ファイルパス、シンボル、テスト証拠 |
| 研究の統合 | 手法と知見を並べて比較する必要がある | 論文、レポート、限界 | 各主張の出典と注意事項 |
| 契約またはポリシーの比較 | 定義と例外がセクション全体で繰り返される | 現在および以前のバージョン、付録 | 条項番号と正確な文言 |
| フィードバック分析 | テーマが多くのコメントに現れる | 匿名化されたフィードバックとコーディングルール | 代表的な引用とカウント方法 |
| プロジェクト履歴のタイムライン | 決定が会議記録全体で進化する | 議事録、決定ログ、リリースノート | 日付、担当者、矛盾する記録 |
| 長いインシデントレビュー | ログ、チケット、ポストモーテムが異なる段階を説明する | 関連する時間範囲とインシデント文書 | タイムスタンプ、イベントソース、不確実性 |
| マルチモーダル文書レビュー | テキストと視覚的証拠を一緒に読む必要があるかもしれない | サポートされている画像とそのキャプションまたはコンテキスト | エンドポイントがメディアタイプをサポートしているか |
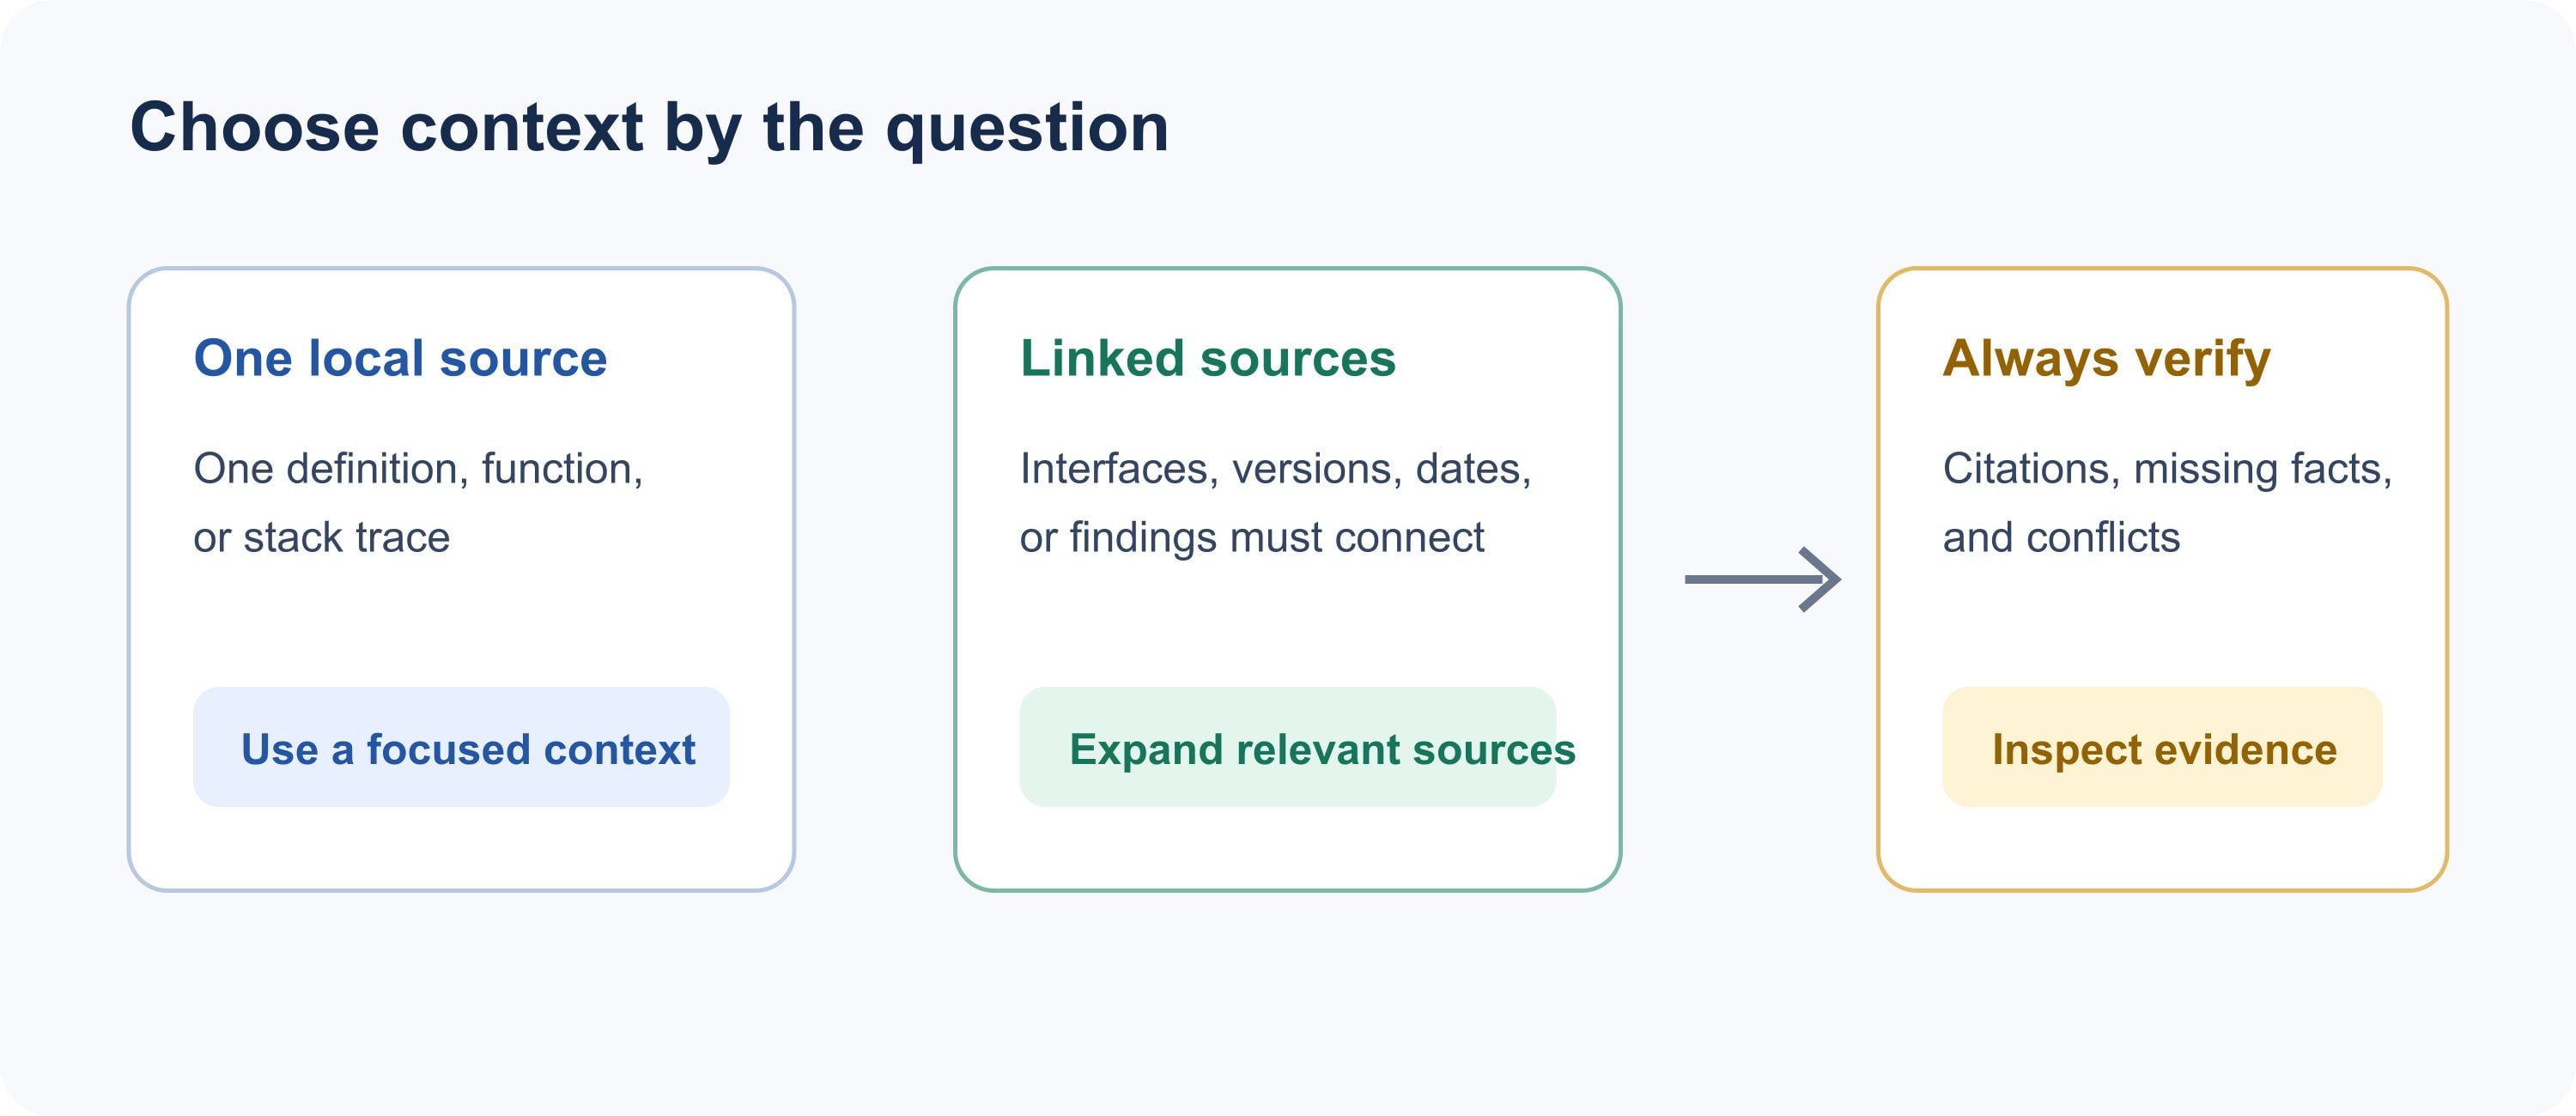
ローカルの質問には焦点を絞ったコンテキストを使用し、ソースを接続する必要がある場合は拡張し、証拠を検査します。
ファイル横断的な大規模コードベースのレビュー
100万トークンのコンテキストは、エンジニアがデータ構造をAPI境界からサービスロジック、ストレージ、テストまで追跡するのに役立ちます。アーキテクチャの要約、影響を受ける可能性のあるモジュールの特定、複数の場所に文書化された規約を尊重するリファクタリング計画の起草に役立ちます。
モデルには、フィルタリングされていないディスクダンプではなく、境界のあるリポジトリのスナップショットを提供します。変更に関連するソースファイル、最も近いテスト、依存関係マニフェスト、アーキテクチャノートを含めます。ビルド出力、ベンダー依存関係、生成されたバンドル、重複コピーは、質問がそれらに関するものでない限り除外します。提案されたすべての依存関係についてファイルパスとシンボル名を求め、観察された動作と仮定を区別します。
出力をレビュー計画として使用します。引用された各シンボルが存在することを確認し、引用された行を検査し、プロジェクトのチェックを自分で実行します。ツールが実際にテストを実行して結果を返さない限り、モデルはテストに合格したと主張すべきではありません。1つの関数内の局所的なバグの場合、より小さなコンテキストの方が速く、監査も容易であることがよくあります。
論文とレポートを横断した研究の統合
長いコンテキストは、研究が異なる方法、集団、測定、または定義を使用している場合に役立ちます。ソースごとに1行、研究課題、データ、方法、結果、限界、質問との関連性の列を持つ比較表を求めます。混合された要約が不一致を消してしまうのではなく、ソースレベルの主張をそのソースに結び付けておきます。
たとえば、ツールの評価を比較する場合、ベンチマーク結果をフィールド研究や著者の解釈と区別します。比較できない結果をランク付けする代わりに、互換性のない測定をフラグするようにモデルに依頼します。次に、最も意思決定に関連する主張の背後にあるソースの箇所を開きます。統合は証拠の地図であり、論文を確認する代わりにはなりません。
長い契約、ポリシー、仕様の比較
契約とポリシーは多くの場合、用語を一度定義し、別の場所で修飾します。有効なバージョン、修正、別紙、関連する古い草案を一緒に提供すると、変更された定義、相互参照、欠落した条件、明らかな矛盾を明らかにするのに役立ちます。
各所見について正確なセクションまたは条項と、レビュー担当者が特定できる短い抜粋を要求します。テキストの違いとその考えられる結果を分離します。モデルはレビューの整理を支援できますが、法的解釈、コンプライアンスの決定、署名権限は、管轄区域とコンテキストを考慮できる資格のある人に委ねられます。
顧客フィードバックの大規模分析
大量のフィードバックは、チャネルや期間を超えて繰り返される要望や反論を明らかにすることができます。定義されたサンプルを提供し、不要な個人情報を削除し、「オンボーディングの摩擦」「統合の欠如」「価格の混乱」などのコーディングスキームを指定します。テーマのリストだけでなく、代表的な例と反例を求めます。
モデルが生成したテーマのパーセンテージを調査統計として提示しないでください。カウントが必要な場合は、単位(メッセージ、顧客、または問題)を定義し、レコードを重複排除し、一貫したラベリングルールを適用し、再現可能なスクリプトまたは人間がレビューしたサンプルでカウントを検証します。モデルはカテゴリを提案し、例を見つけるのに役立ちます。文書化された方法が定量的な主張を裏付けます。
プロジェクト文書からタイムラインを構築する
引き継ぎやポストモーテムでは、関連する証拠が議事録、リリースノート、決定ログ、チケットに散在している場合があります。日付、イベント、記載されている場合は担当者名、ソースの場所、信頼性または曖昧さを含む時系列表を求めます。矛盾する日付を黙って選択するのではなく、保持するようにモデルに指示します。
有用なタイムラインは、新しいチームメイトが何が決定されたか、要件がいつ変更されたか、どの文書が各イベントを裏付けているかを理解するのに役立ちます。重要な遷移をソース記録に対して検証します。特に、メモが後で書かれたり、会議を直接記録するのではなく要約した場合に重要です。
長いインシデント記録とマルチモーダル資料のレビュー
インシデントレビューは、アラート、運用ノート、チケット、ポストモーテムを1つの証拠セットにまとめることで恩恵を受けることができます。観察されたイベントのシーケンスを求め、ログのタイムスタンプと後続のナラティブノートの推定値を明確に区別します。これにより最初のパスがより首尾一貫したものになりますが、オンコールエンジニアは行動を起こす前にソースシステムを確認する必要があります。
DeepSeekの公式発表によると、V4.1-Flashはネイティブマルチモーダルサポートを備えたAPIで公開されています。正確な画像形式、リクエスト方法、制限はエンドポイントと統合によって異なるため、100万トークンのテキスト予算が画像処理も説明していると仮定する前に、これらの詳細を確認してください。( DeepSeek V4.1-Flashの発表 )
100万トークンが役立つのはいつで、ノイズを追加するのはいつか?
より多くのコンテキストは、ソースを相互参照する必要がある場合に役立ちます。共有インターフェースを含むコード変更では、複数のモジュールとテストが必要になる場合があります。バージョン比較には、両方の完全なバージョンとその付録が必要です。プロジェクトタイムラインには、数か月にわたる記録が必要になる場合があります。
明確なスタックトレースを持つローカルのバグでは、関数、その呼び出し元、および関連するテストのみが必要な場合があります。1つの定義を求める質問では、信頼できるセクションのみが必要な場合があります。これらのタスクでは、リポジトリ全体を含めると検索スペースが増え、有用な箇所が埋もれてしまう可能性があります。
プロンプトを拡張する前に、繰り返しのエクスポート、廃止された草案、無関係なフォルダ、定型文、質問の時間範囲外の記録を削除します。何を含め、なぜ含めたかのマニフェストを保持します。無関係なファイルの大規模なバッチを追加したときに回答が変わる場合は、ソースセットを絞り込んでテストを再実行するシグナルです。
信頼性の高い長いコンテキスト回答のための実用的なワークフロー
流暢な回答が検証済みの回答と間違えられないように、一貫した証拠プロトコルを使用します。まず、安定したファイル名でソースにラベルを付け、可能な場合はページ番号、見出し、行番号、日付、またはバージョン識別子を付けます。抜粋を正しく解釈するために十分な周囲のコンテキストを保持します。
次に、1つの決定または研究課題を述べます。出力の形状と、モデルが引用する必要がある場所を指定します。再利用可能なプロンプトは次のとおりです。
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
コードベースの場合は、次を追加します。「リポジトリのパスと関数名またはクラス名を引用してください。変更を提案する前に、影響を受けるファイルと提案を裏付けるテスト証拠をリストしてください。結果が提供された証拠に含まれていない限り、テストが実行されたと言わないでください。」
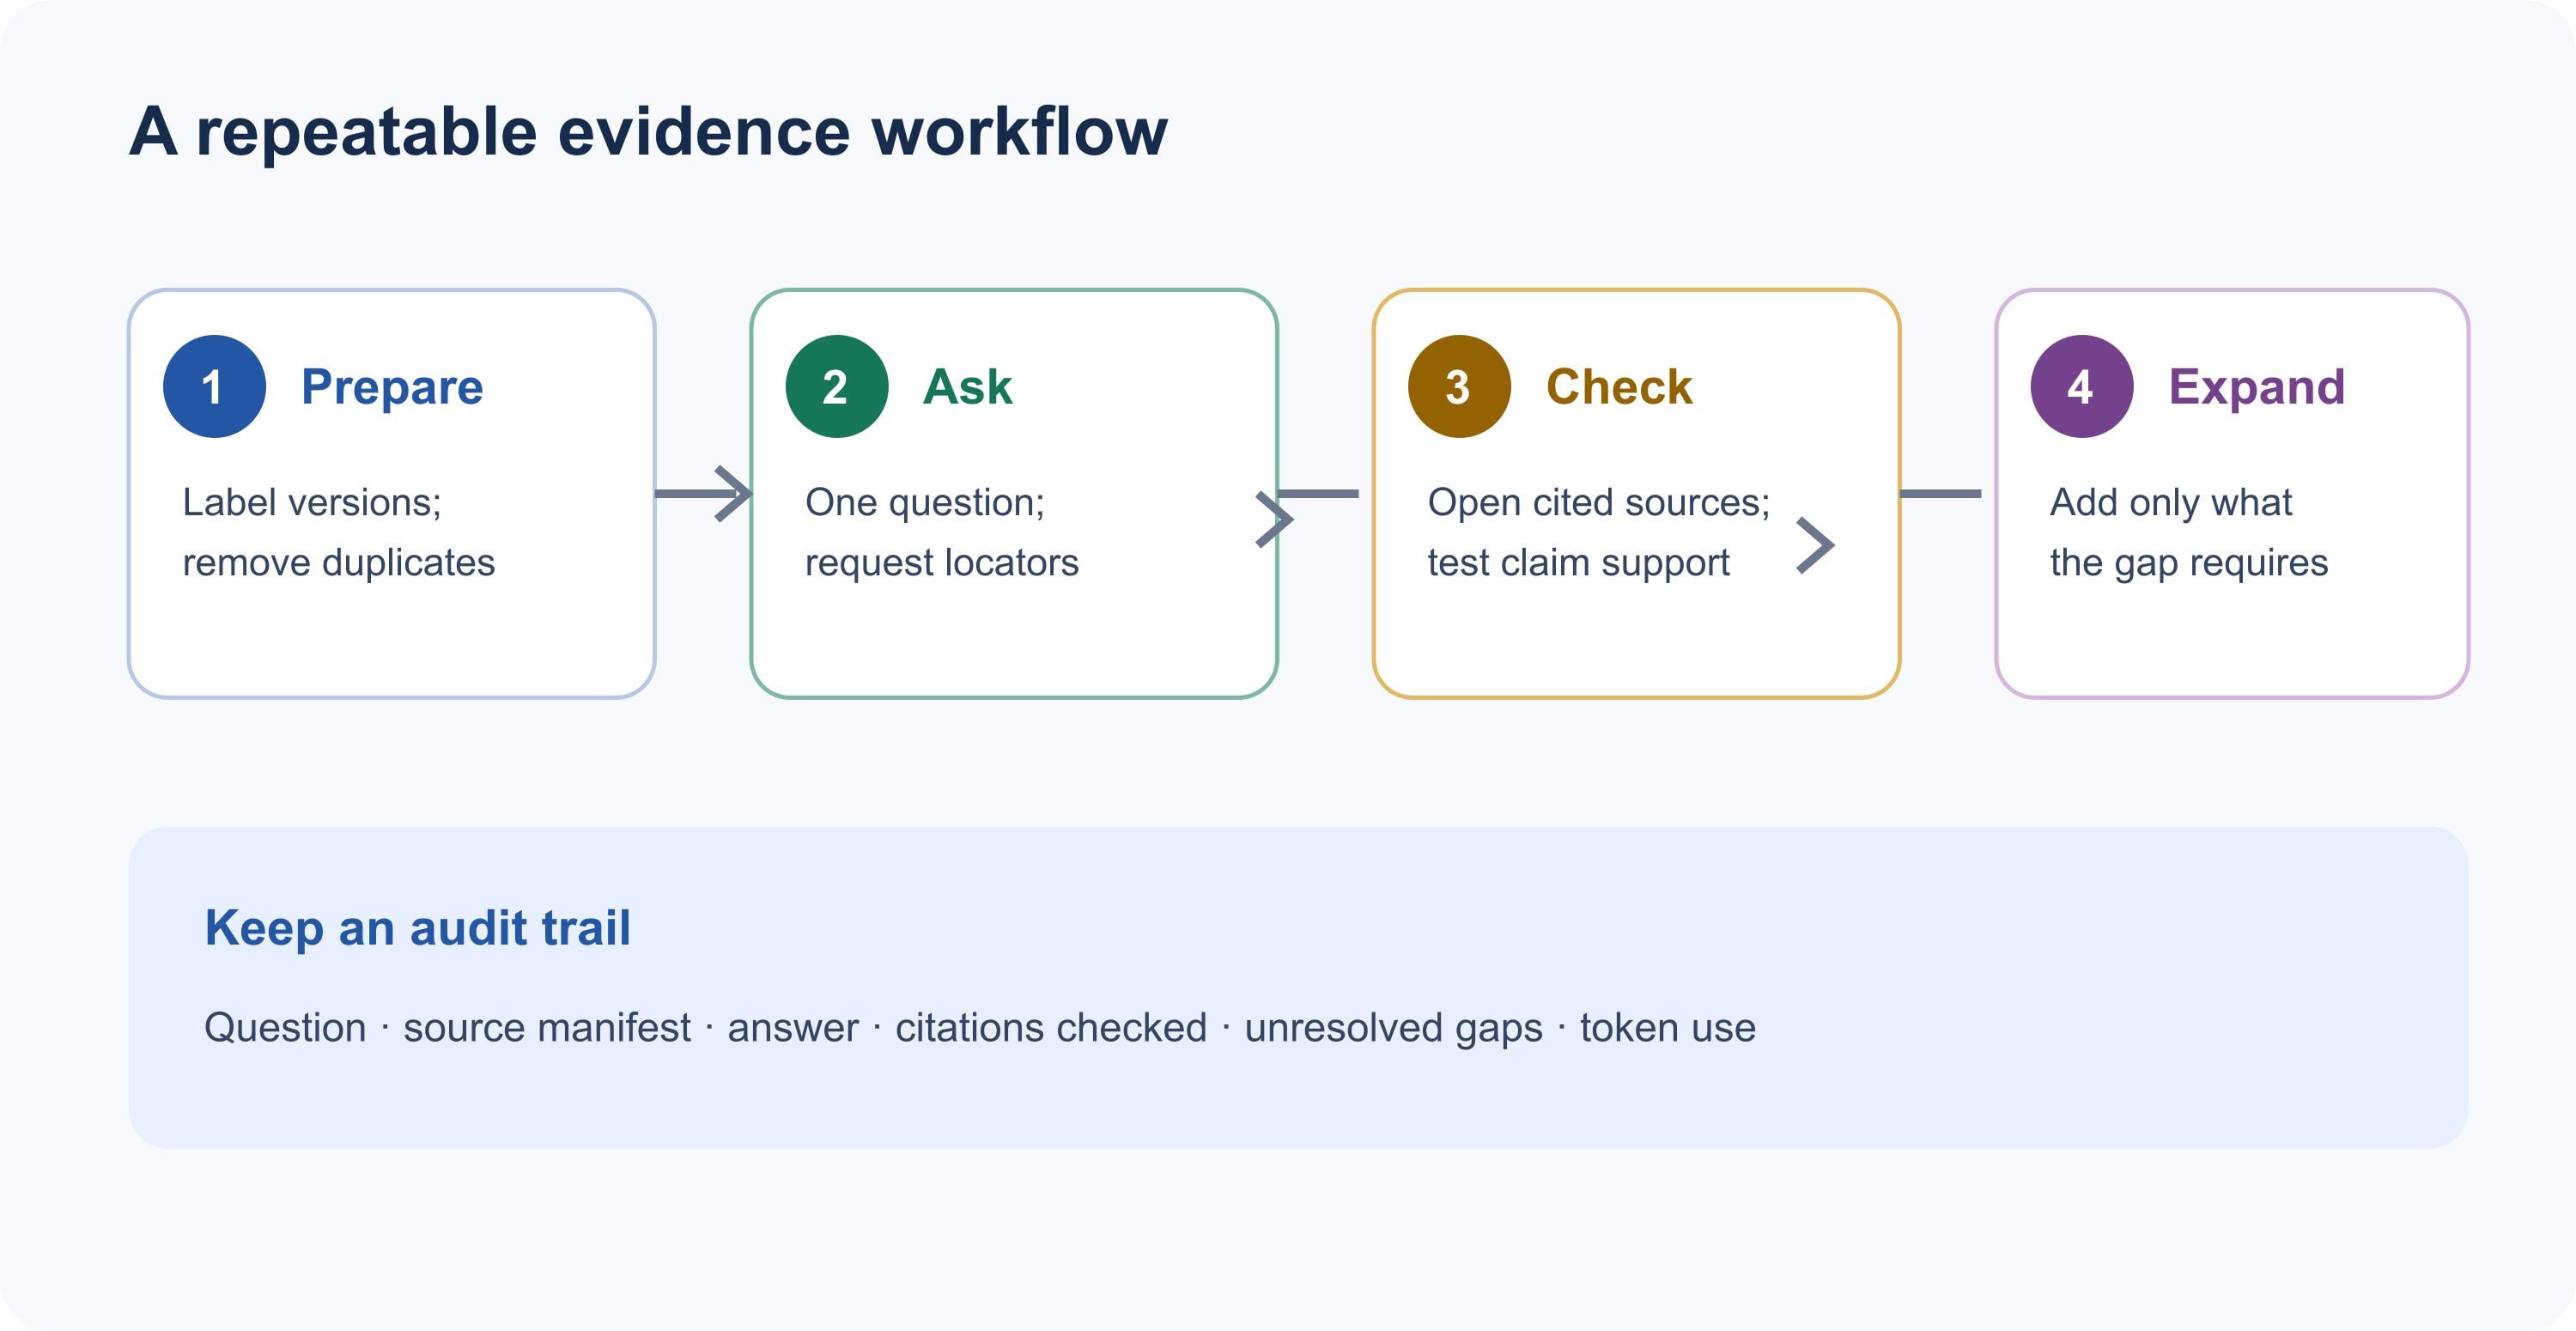
ソースを準備し、境界のある質問をし、引用を確認し、ギャップを解決するためにのみ拡張します。
次に、3つのパスで回答を検査します。各引用が実際の場所を指しているか確認します。引用された箇所が、単にトピックに言及しているだけでなく、主張を裏付けているか確認します。最後に、同じソースセットに対して的を絞ったフォローアップ質問をして、省略や矛盾をレビューします。重大な決定については、資格のあるレビュー担当者にソース資料を直接読んでもらいます。
長いコンテキストワークフローの証拠マップ
| ステージ | アクション | 保持する | 停止シグナル |
|---|---|---|---|
| 1. 準備 | ソースのラベル付け、重複排除、範囲設定 | ソースマニフェストとバージョン | 不明な出所または古い重複 |
| 2. 質問 | 1つの質問と証拠形式を設定 | 回答内のファイル名とロケーター | 決定ターゲットのない広範なリクエスト |
| 3. 確認 | 引用された箇所を開き、主張を比較 | サポートされた主張と明示的なギャップ | 引用が主張をサポートしていない |
| 4. 拡張 | 未解決のリンクに必要なソースのみを追加 | 既知の回答チェックでの改善 | より良い証拠なしのより多くの入力 |
1Mコンテキストがタスクに役立つかどうかをテストする方法
完全なアーカイブをロードする前に、小さな評価セットを作成します。ソース資料からすでに答えを知っている質問を書きます。いくつかの事実を最初の方に、いくつかを中間に、いくつかを最後の方に置きます。2つの文書を接続する必要がある質問と、提供されたソースからは答えられない質問を少なくとも1つ追加します。
最初に、より小さな関連サブセットで同じ質問を実行し、その後、測定されたステップでコンテキストを増やします。事実の正確さ、ロケーターの精度、見落とされた証拠、サポートされていない主張、答えられない質問への拒否、レイテンシ、トークン使用量を記録します。プロンプトとデコーディング設定を安定させ、変更を解釈できるようにします。実行間で出力が大きく異なる場合は、質問を繰り返します。
| チェック | 合格した回答が示すもの | 失敗後にすること |
|---|---|---|
| 初期、中間、後期の位置にある既知の事実 | ソーススパン全体にわたる検索 | インデックス、ファイルラベル、プロンプト長を確認 |
| 文書間リンク | 証拠をソース間で結合できる | 両方の引用を求め、次にリンク質問を絞り込む |
| 答えられない質問 | モデルが不足している証拠を報告できる | 「提供されたソースのみを使用する」を厳守し、再テスト |
| 引用監査 | ロケーターと抜粋が主張をサポート | 修正されるまで主張を未検証として扱う |
| より大きなコンテキストの比較 | 追加資料がターゲットタスクを改善する | 精度またはレイテンシが悪化する場合はノイズを除去 |
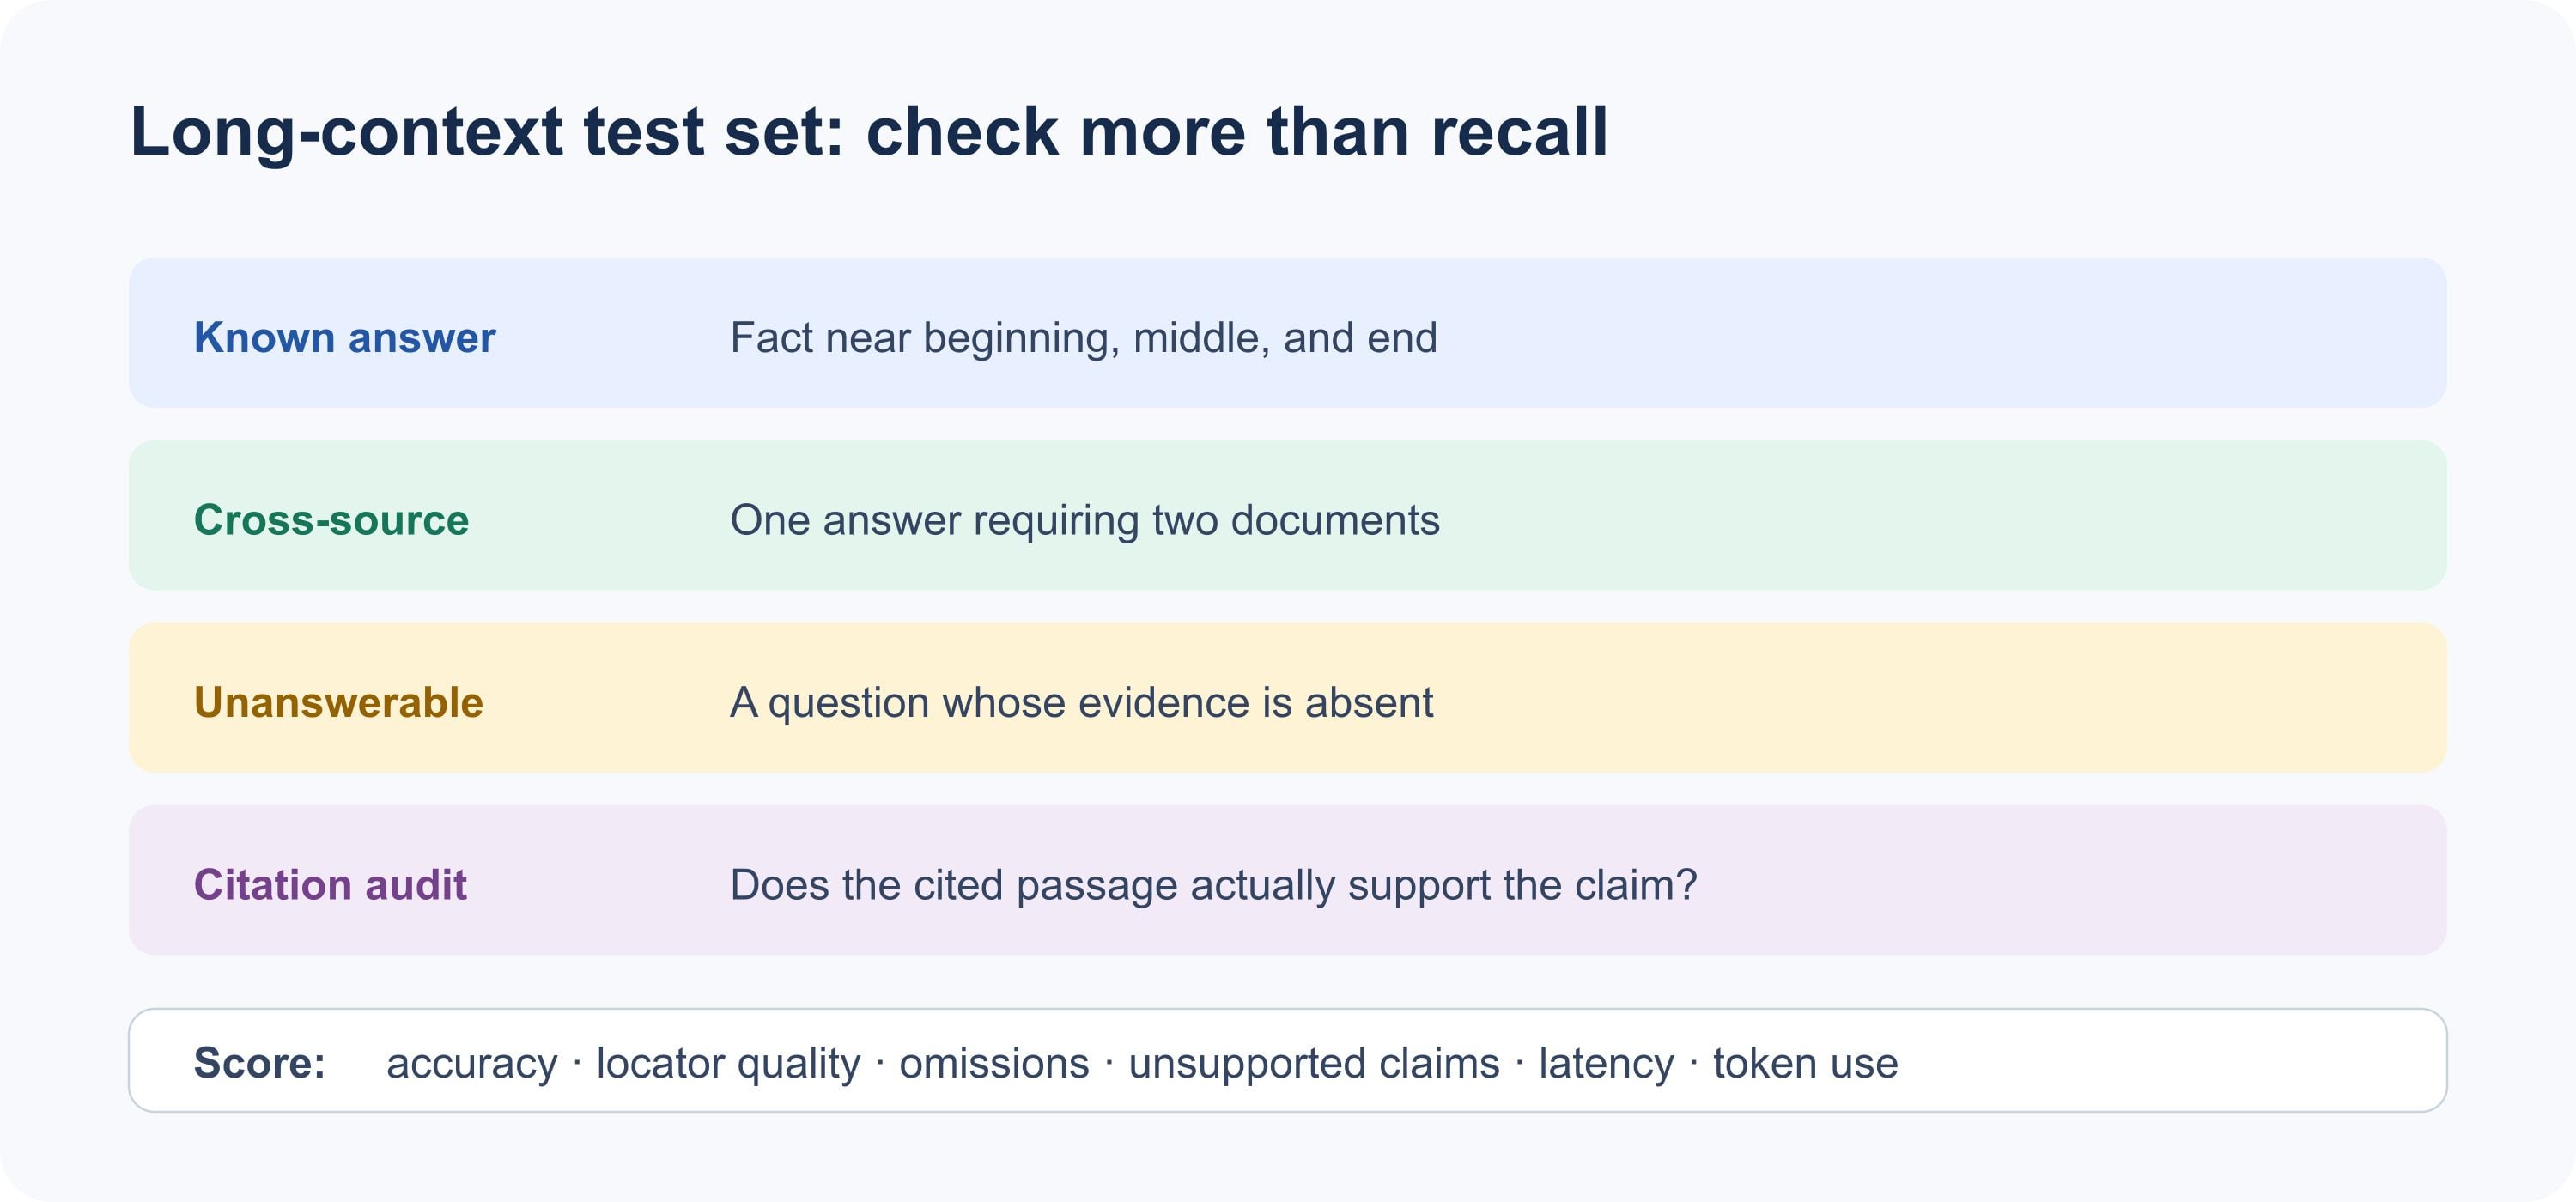
検索、引用サポート、省略、サポートされていない主張、レイテンシ、トークン使用量をスコアリングします。
コミュニティの報告はさまざまで、タスクに依存します。あるRedditユーザーは、より大きなコンテキストサイズで不正なツール引数がハーネス固有に増加したと共有しましたが、コメント投稿者は他の設定でより高いトークン数で成功した作業を説明しました。これは、独自のハーネスをベンチマークする有用な理由であり、普遍的な障害しきい値の証拠ではありません。( RedditでのDeepSeekコンテキストの議論 )
賢明なスケールアップは、小さなサンプルでプロンプトを検証し、文書横断的な質問に必要なソースグループを追加し、代表的な大きなリクエストをテストすることです。信頼できる証拠で実際の質問に答える最小のコンテキストを維持します。これにより、レイテンシとコストの比較も解釈しやすくなります。
DeepSeek V4.1 Flash APIの価格とアクセス
Atlas Cloudでは、モデルリストに現在DeepSeek V4.1 Flashが1Mコンテキストで表示され、料金は100万入力トークンあたり$0.30、100万出力トークンあたり$1.20、100万キャッシュ読み取りトークンあたり$0.03です。リストにはこのモデルの割引は表示されていません。これらはAtlas Cloudの料金であり、DeepSeek自身の時間依存のピーク料金とオフピーク料金とは異なります。料金は変更される可能性があるため、公開または予算編成の前にAtlas Cloudモデルカタログとモデル価格ページを再確認してください。
記載されている料金では、100,000の非キャッシュ入力トークンと2,000の出力トークンを含むリクエストのコストは、入力に約$0.03、出力に$0.0024、その他の適用される料金を除いて合計$0.0324です。入力がキャッシュ読み取りとして請求される場合、100,000のキャッシュ済みトークンは代わりに$0.003になります。この例はそれらのトークン数と料金を想定しており、特定のワークロードの見積もりではありません。1Mの容量全体が存在するだけで請求されるわけではありません。請求は使用量とキャッシュ処理に従います。
単一のAPIエントリポイントを希望するチーム向けに、DeepSeek V4.1 Flashモデルページがモデルと呼び出しの詳細を提供します。測定したトークン使用量と統合のニーズを公式エンドポイントとも比較してください。モデル名、制限、価格はプロバイダーによって異なる場合があります。
よくある質問
1Mトークンのコンテキストウィンドウは1M語と同じですか?
いいえ。トークンは単語の一部、句読点、コード断片、またはその他の単位である場合があります。収まる単語数やページ数は、資料とそのトークン化によって異なります。固定されたページ変換ではなく、測定されたトークン数を使用してください。
DeepSeek V4.1 Flashは常に完全なコンテキストウィンドウを使用しますか?
いいえ。100万トークンは最大コンテキスト仕様であり、すべてのリクエストの目標ではありません。短いプロンプトはより少なく使用し、特定のインターフェースやAPIルートはより低い上限を適用する場合があります。エンドポイントのドキュメントと実際の使用状況フィールドを確認してください。
1Mコンテキストはコードベース全体に十分ですか?
トークン数によっては一部のコードベースに収まるかもしれませんが、それですべてのファイルが関連するわけでも、すべての回答が信頼できるわけでもありません。質問に必要なファイルを含め、引用されたパスとシンボルを検証し、プロジェクトの実際のチェックで変更をテストします。
利用可能なすべての文書を1つのプロンプトに入れるべきですか?
文書が同じ質問に関係している場合にのみ行ってください。ソースマニフェストから始め、重複と無関係な資料を削除し、文書横断テストが必要とする場合にさらに追加します。最高のDeepSeek V4.1 Flash 1Mコンテキストウィンドウのユースケースは、アーカイブのサイズではなく、比較する必要がある証拠によって定義されます。





