2つのチームがDeepSeek V4.1 Flashで毎秒数百トークンを報告しても、測定しているものが異なることがあります。一方は単一リクエストのデコード速度を意味し、もう一方は数十の同時リクエストにわたる総出力を意味するかもしれません。DeepSeek V4.1 Flash推論スループット最適化を改善するには、まずサービスに必要な指標を選び、次に自社のリクエスト構成をベンチマークし、一度に1つのサービング変数のみを変更し、レイテンシ、品質、コストをまとめて検証します。モデルファミリーには現在10月17日のFlash-1017アップデートが含まれるため、結果を比較する前に正確なチェックポイントを記録してください。公開レポートは有用な最適化パスを示していますが、いずれも自社ハードウェアでの適合テストの代わりにはなりません。
主なポイント
- 総出力トークン/秒はリクエスト全体の容量を測定し、リクエストあたりのデコード速度は個々のユーザー体験を測定します。
- チューニング前に、プロンプト長、出力上限、同時実行数、ウォーム状態、レイテンシ目標を再現してください。
- V4.1 Flashの圧縮KVキャッシュとBounded Replayはメモリ負荷を軽減しますが、固定のエンドツーエンド高速化を保証するものではありません。
- vLLMとSGLangは、モデル、ハードウェア、ワークロード、測定条件が一致する場合にのみ比較してください。
DeepSeek V4.1 Flashにとってスループットとは何を意味するか?
スループットは率ですが、分子とテスト境界が重要です。推論サービスでは、少なくとも5つの測定値を記録します:
| 指標 | わかること | 典型的な用途 |
|---|---|---|
| 総出力トークン/秒 | すべてのアクティブなリクエストが毎秒生成する出力トークン | 容量計画とフリート効率 |
| リクエストあたりのデコードトークン/秒 | 個々のリクエストが経験する生成速度 | 生成中のインタラクティブな応答性 |
| プリフィルトークン/秒 | 毎秒処理される入力トークン | 長いプロンプトと検索負荷の高いワークロード |
| 初回トークンまでの時間(TTFT) | リクエスト到着から最初の出力トークンまでの時間 | 体感される起動遅延 |
| エンドツーエンド遅延、p50/p95 | トラフィック分布全体における総リクエスト時間 | サービスレベル目標とテール動作 |
サーバーは、より多くのシーケンスをバッチ処理することで総スループットを高められますが、その一方で各ユーザーがトークン間に待つ時間は長くなります。逆に、低同時実行数向けに調整された構成では、個々の応答は機敏でもアクセラレータが十分に活用されない可能性があります。どちらの結果も普遍的に優れているわけではありません。適切な目標は、製品のサービス目標を満たすスループット・レイテンシ曲線上の点です。
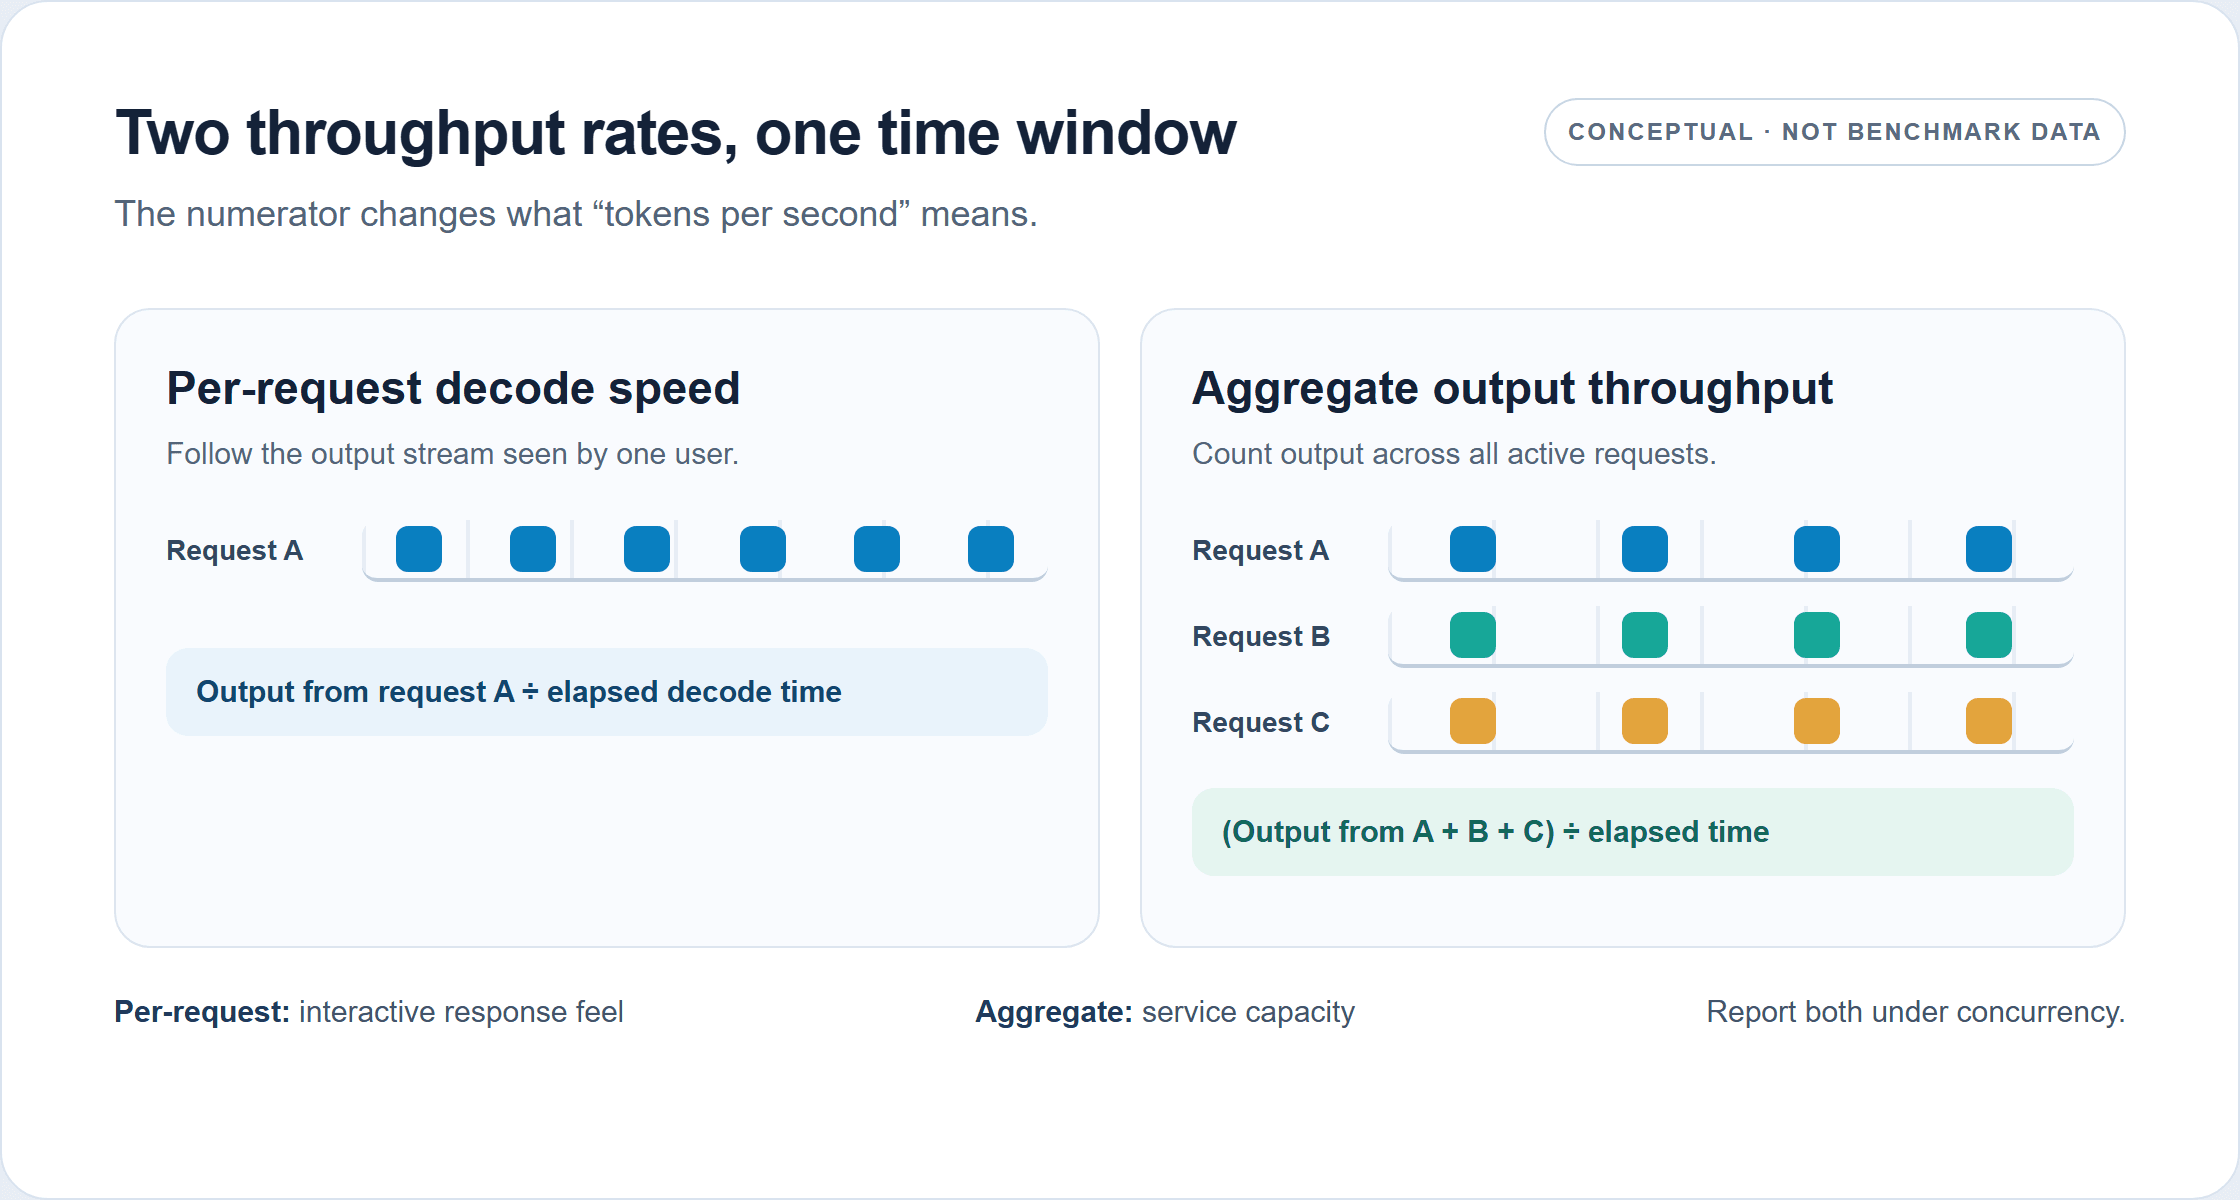
2つの率は異なる出力ストリームを数えています。これは概念図であり、測定されたDeepSeek V4.1 Flashのパフォーマンスではありません。
スループットにプリフィル、デコード、またはその両方が含まれるかを明記してください。GPU数で割るかどうかを述べてください。要求された最大トークン数ではなく、成功した出力トークンを報告し、キャンセルやエラーを開示してください。これらの詳細がなければ、トークン/秒の数値は、運用者にとって自分のアプリケーションを予測できるかどうかを判断できません。
再現可能なDeepSeek V4.1 Flashベースラインを構築する
有用なベースラインは、ボトルネックを明らかにできる程度に本番トラフィックに似ています。単一の短いプロンプトは、大きな会話履歴を繰り返し送信するエージェントの代理としては不十分であり、固定の1,024トークン出力では、早期に停止するワークロードや大きく変動するワークロードを捉えられません。
ワークロードと測定ウィンドウを固定する
観測されたトラフィックからリクエストバケットを作成します。各バケットについて、おおよその入力長、期待される出力長、到着パターン、および共有プレフィックスを保持します。実際のリクエストパスの一部を形成する場合は、ツールまたは推論のターンを含めます。プロンプト、サンプリング設定、停止条件、出力上限を実行間で固定します。
低同時実行数のケースと、サービスがピーク時に想定する同時実行数の両方を実行します。次に、中間の同時実行数レベルを追加して、スループットが上昇しなくなる点やレイテンシが限界を超える点を明らかにします。ウォームアップ後に安定した測定ウィンドウを使用し、各ポイントを繰り返し、中央値と範囲を報告します。短いバーストは、安定したサービス容量ではなく起動時の動作を測定している可能性があります。
コールドスタート測定とウォームサービングを分離します。コールド実行には、スタックに応じてモデルのロード、グラフキャプチャ、またはキャッシュの投入が含まれます。ウォーム実行は、サービス提供準備が整ったシステムを表します。プレフィックスキャッシュのワークロードでは、キャッシュヒットとキャッシュミスのトラフィックを別々に測定します。その混合が本番環境と一致しない限り、1つの平均にまとめないでください。
ベンチマーク記録を残す
各実行の行を次のフィールドとともに保存します:チェックポイントまたはモデルリビジョン、ランタイムとコミット、GPUモデルと数、インターコネクト、精度と量子化、テンソル・エキスパート・パイプライン並列レイアウト、入力および出力トークン分布、同時実行数とリクエスト到着パターン、ウォームまたはコールド状態、実行時間、成功率、総スループット、リクエストあたりのデコード速度、TTFT、p50/p95エンドツーエンド遅延。
この記録は、次の実験を再現可能にするため、リーダーボードの数値よりも有用です。チューニング前に固定してください。ワークロードまたはチェックポイントが変わった場合は、差分をサービングフラグに帰属させるのではなく、新しいベースラインを開始してください。
プリフィル、デコード、KVキャッシュ、スケジューリングを診断する
症状を使って次の測定を選び、修正を推測しないでください。許容できるデコード速度でTTFTが高い場合は、入力処理、キューイング、キャッシュミス、または起動オーバーヘッドを示唆します。低同時実行数でデコードが遅い場合は、カーネル、メモリ帯域幅、並列通信、モデルの実行パスを調べる必要があります。同時実行数の増加に伴い総スループットが頭打ちになる場合は、メモリ負荷、スケジューラの制限、通信オーバーヘッド、または計算パスの飽和を示している可能性があります。ロングコンテキストの劣化に対しては、キャッシュ常駐、プリフィル作業、ホストからデバイスへの移動を測定する必要があります。
| 観察 | 最初のチェック |
|---|---|
| TTFTがプロンプト長とともに増加する | プリフィル率、キュー時間、プレフィックスキャッシュヒット率、グラフまたはコンパイルのウォームアップ |
| 同時実行数1でもデコード速度が低い | ランタイムのモデルパス、カーネルサポート、精度、GPU使用率、通信オーバーヘッド |
| 同時実行数が増えると総トークン/秒が頭打ちになる | KVキャッシュ容量、スケジューラバッチ処理、メモリ帯域幅、並列トポロジ |
| 総出力が改善する一方でp95遅延が急上昇する | バッチサイズ、キューイングポリシー、リクエスト長の混合、サービス目標 |
| 長いプロンプトが有用なアクティブリクエストを追い出す | KVキャッシュ常駐、キャッシュ割り当て、コンテキスト分布、ホストメモリトラフィック |
V4.1 Flashには、これらの負荷の一部を軽減することを目的としたアーキテクチャ機能があります。モデルレポートでは、クロスレイヤーキャッシュ再利用とFP4グローバルKVキャッシュを備えたCSA2が説明されており、報告されているグローバルKVフットプリントはトークンあたり890バイトで、V4-Flashの対応するフットプリントの約4分の1です。SWA Bounded Replayは別のストレージトレードオフに対処します。すべてのスライディングウィンドウアテンション状態を永続化するのではなく、デプロイメントは最近のウィンドウをリプレイすることで欠落状態を再構築できます。DeepSeekはこの設計について、永続KVキャッシュがV4-Flashのフットプリントの約8分の1であり、少量の追加プリフィル再計算を伴うと報告しています。これらはアーキテクチャとデプロイメントの結果であり、8倍のスループットを約束するものではありません。(DeepSeek技術レポート、2026年9月)
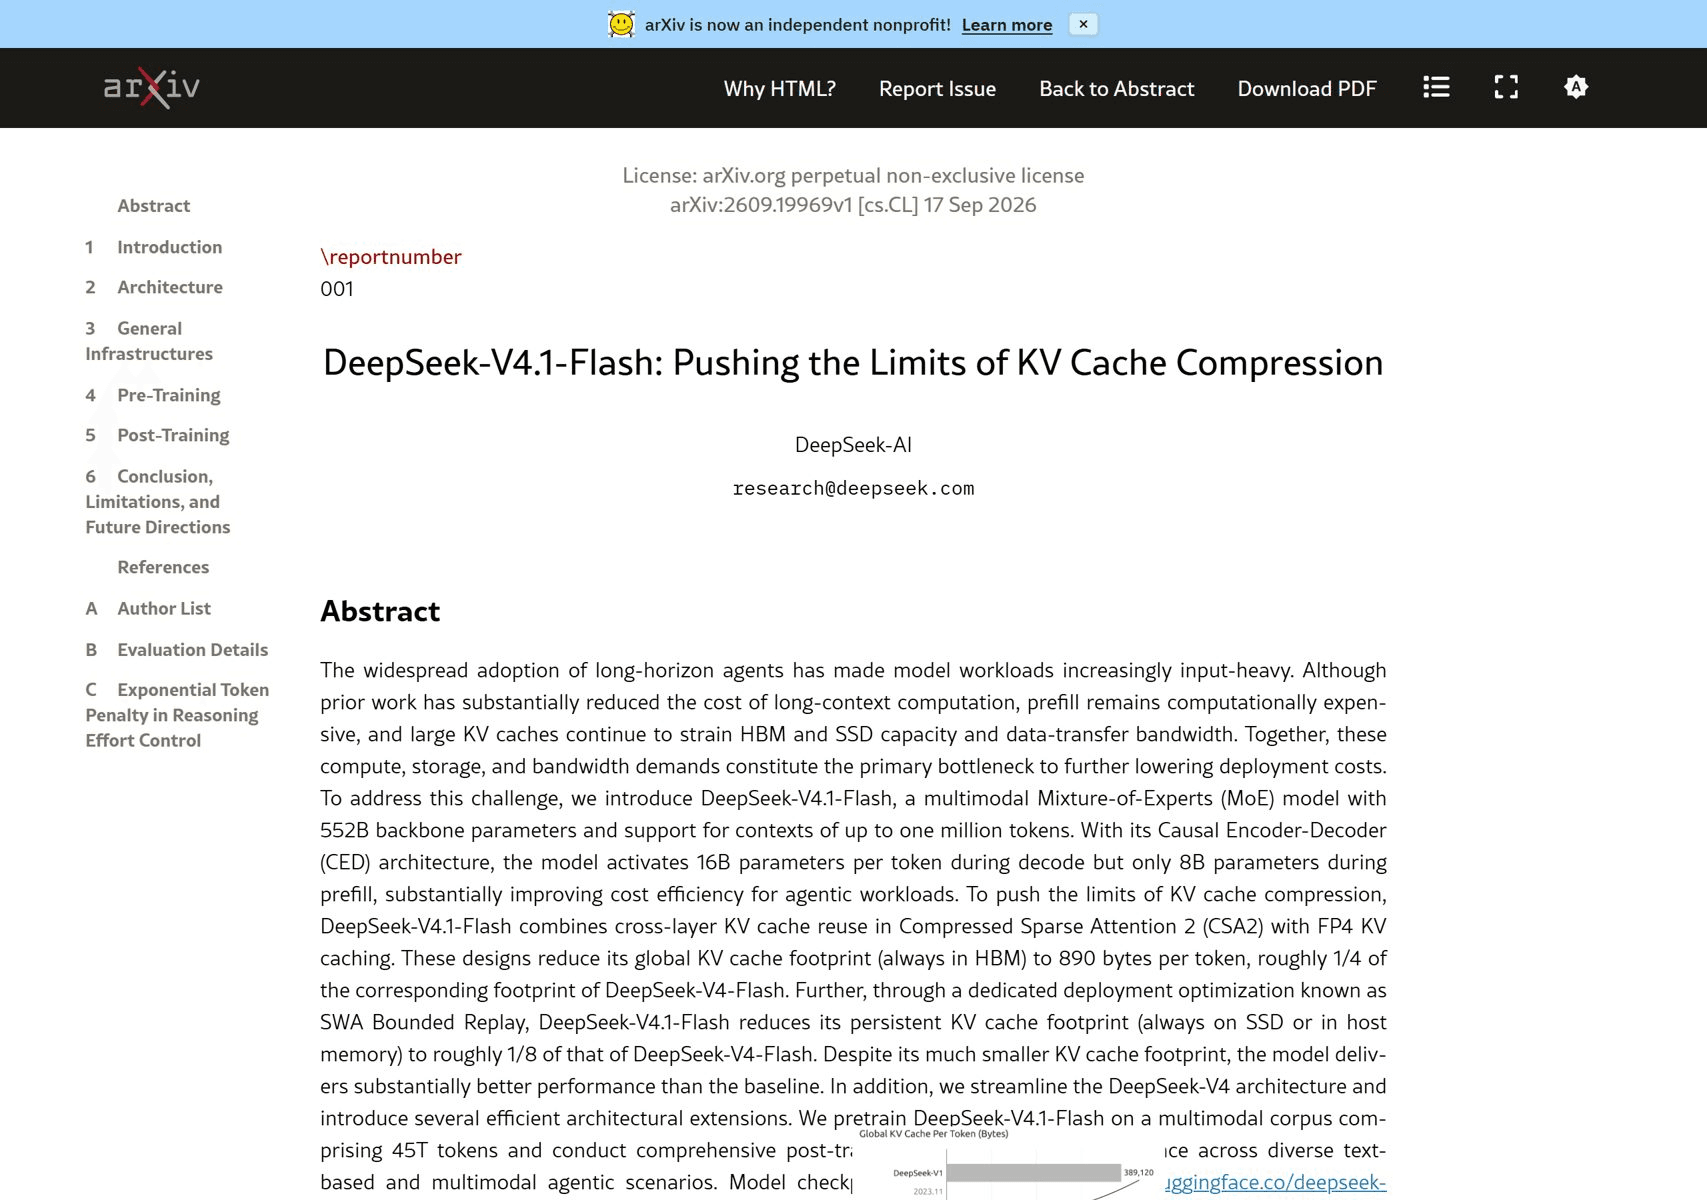
出典の図はキャッシュ容量を説明しており、すべてのデプロイメントに対するエンドツーエンドのスループット倍率ではありません。
診断が不明確な場合は、代表的な実行を1回プロファイリングし、キュー時間、GPU使用率、メモリ使用量、ステージごとのタイミングを検査します。1つの変数を変更し、同じワークロードを再実行し、出力の正確性またはタスク品質を確認します。これにより、見かけの高速化がサービスや回答のリグレッションを覆い隠すのを防げます。
同じ目標に対してvLLMまたはSGLangをチューニングする
デプロイ予定のチェックポイントとハードウェアを現在のモデルパスがサポートするランタイムを選択します。正確なリリース、カーネル、グラフ動作、並列レイアウトを確認します。モデルがサポート対象としてリストされているからといって、すべての量子化やトポロジが同等に最適化されているわけではありません。
vLLM:リリース固有のモデルパスを検証する
vLLMチームの10月のレポートでは、AgentXベンチマークでの進展が説明されています。初日ベースラインと比較して、低遅延結果で約1.9倍の改善、150 TPS制約下で約5.3倍のスループットです。この作業には、CUDAグラフを使用したSWA bounded replayとモデル固有のカーネル統合が含まれていました。これらの値は、そのベンチマーク下でスタックが時間とともに大きく変化した証拠として扱い、別のクラスタに適用する倍率とは見なさないでください。(vLLMエンジニアリングレポート、2026年10月)
自社の実行では、まずサポートされているリリースと既知の良好な構成を確立します。次に、グラフキャプチャまたはリプレイ動作、バッチ処理、並列処理を個別に測定します。より高いスループットのポイントを選択するために使用したレイテンシ制約を維持します。グラフキャプチャが起動やメモリ要件を変える場合は、それらのコストをデプロイメント判断に含めます。
SGLang:同時実行プロファイルを一致させる
SGLangチームのレポートは、テストコンテキストがなぜ重要かを非常に明確に示す例を提供しています。8台のH200 GPU上で、投機的デコーディングなしの最適化実行は、同時実行数1でユーザーあたり約76から168トークン/秒に、同時実行数64でGPUあたり約96から221出力トークン/秒に向上しました。固定の8,192トークン入力と1,024トークン出力を使用しました。別個の4×GB300の結果では、異なるプロンプト長、並列設定、DSpark投機的デコーディングを使用しました。したがって、このレポートはSGLangの最適化を自社トラフィックで評価することを支持するものであり、vLLMのAgentX数値と直接ランキングすることを支持するものではありません。(LMSYS/SGLang最適化レポート、2026年9月)
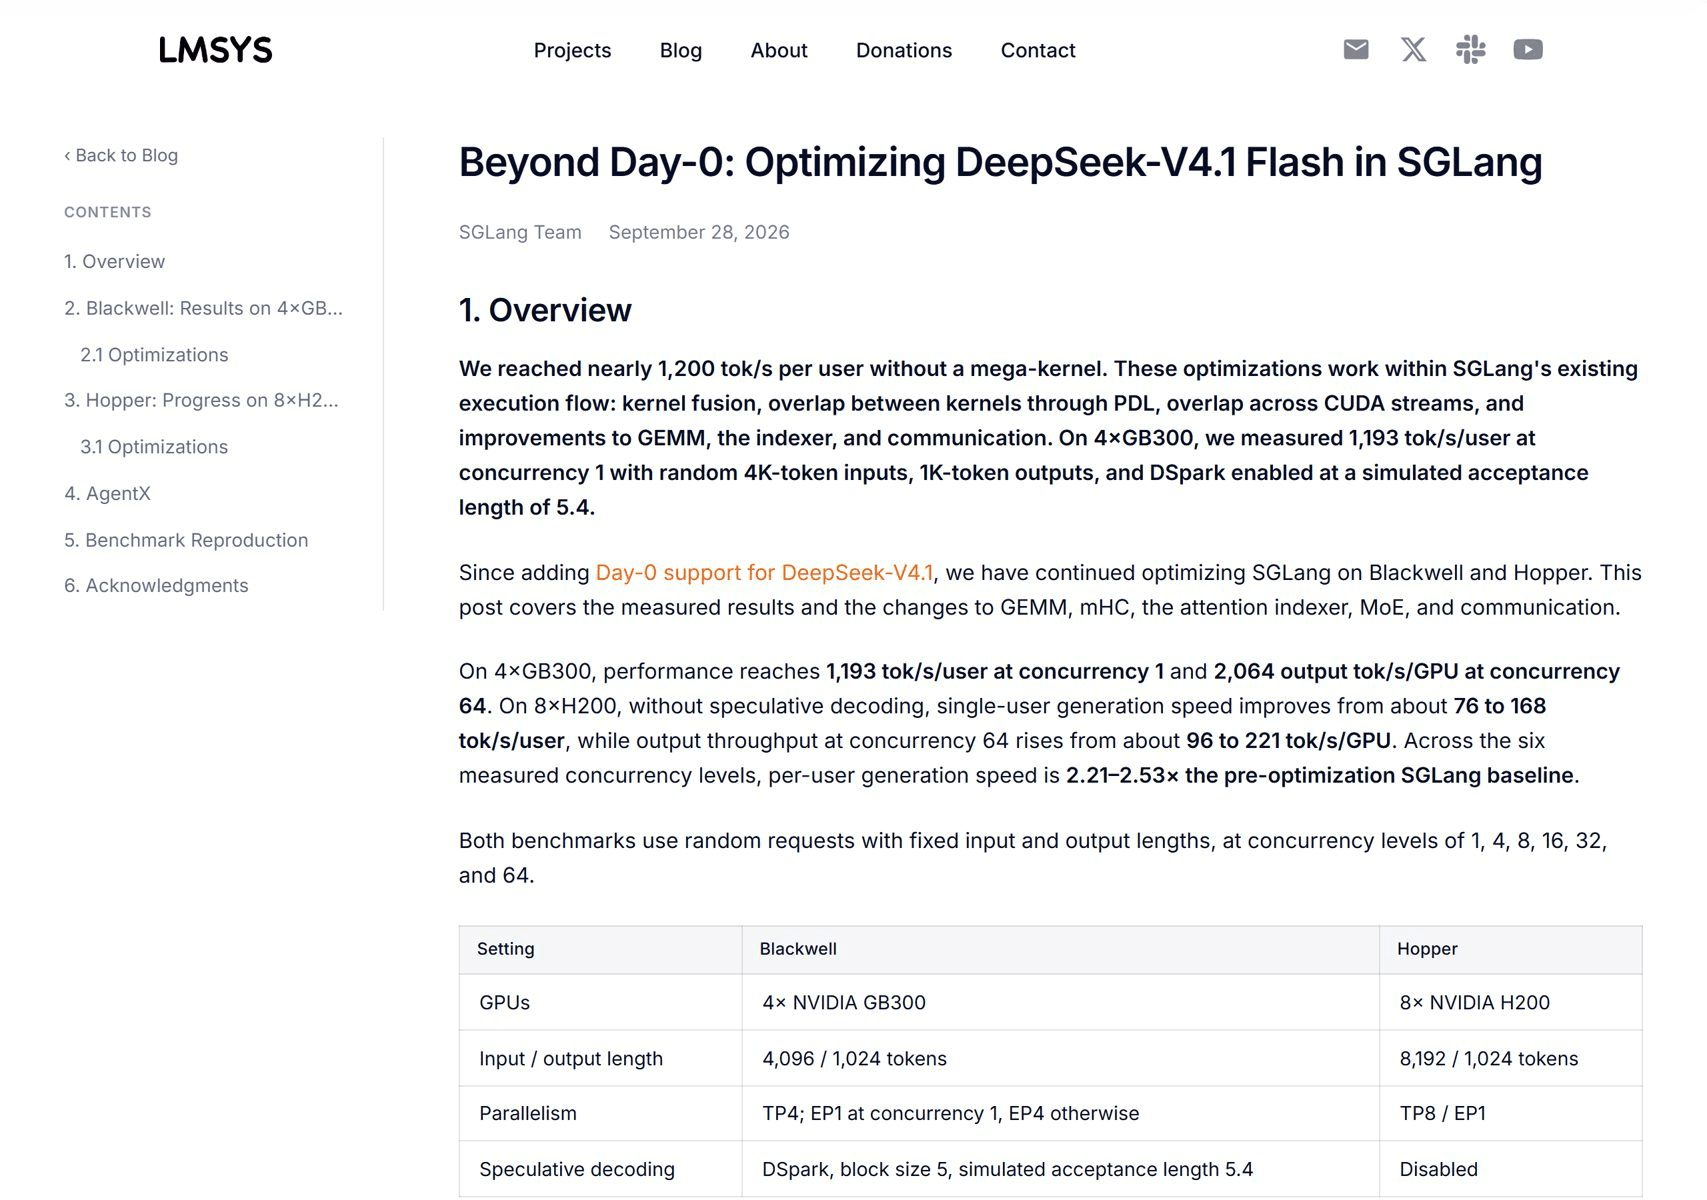
出典レポートは異なるワークロードとハードウェアを使用しているため、その数値は直接対決のチャートとして読むべきではありません。
まず1つのランタイムから始め、そのサポート対象パスを最適化します。チェックポイント、GPU割り当て、プロンプトと出力の分布、同時実行数、ウォームアップ、サービス目標を一定に保てる場合にのみ、2つ目のランタイム比較を構築してください。その比較にはエンジニアリング時間がかかるため、まず現在のスタックが実際に制限要因であることを確認してください。
SLOを損なわずに同時実行数とロングコンテキストを最適化する
同時実行数を段階的に増やし、各ステップで総出力、リクエストあたりのデコード速度、TTFT、p95遅延、メモリ使用量、失敗を記録します。最高スループットのポイントは、そのレイテンシとエラー率が依然としてサービス目標を満たす場合にのみ維持します。生成前にリクエストがキューに入る場合、より大きなバッチはデバイス使用率を改善する一方で、製品の体感速度を遅くする可能性があります。
ロングコンテキストトラフィックでは、アクティブなコンテキスト分布とキャッシュヒット率を測定します。記載された最大コンテキストウィンドウは、その長さですべてのリクエストを同時に処理できることを意味しません。KVキャッシュは、重み、アクティベーション、グラフプール、ランタイムバッファとメモリを競合します。変動するリクエスト長のために余裕を残し、現実的なトラフィック下でエビクションまたはプリエンプションを測定します。
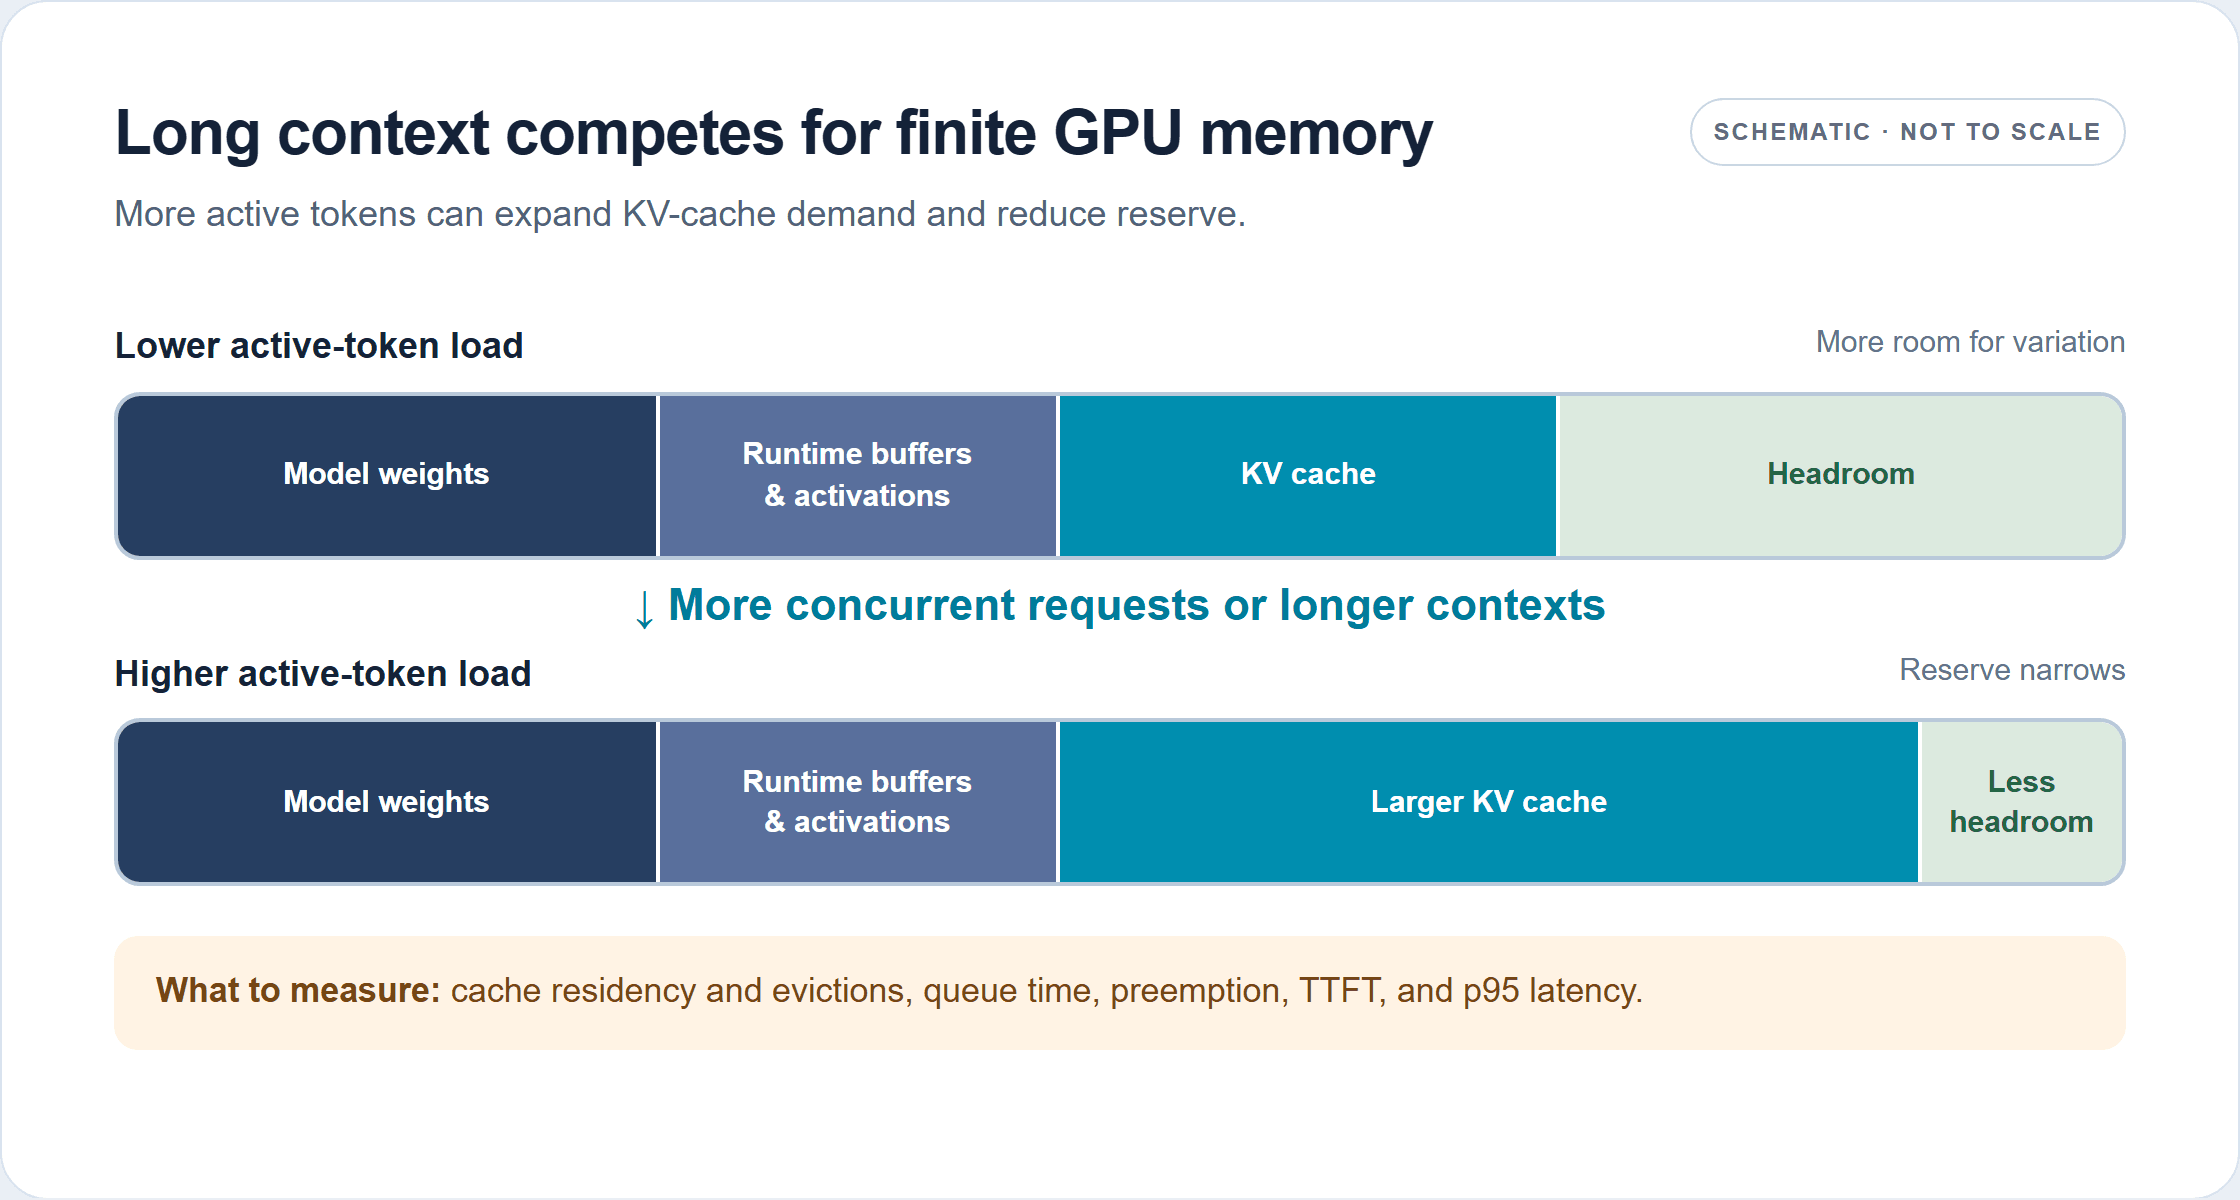
より長いコンテキストまたはより多くの同時リクエストは、KVキャッシュ需要を増やす可能性があります。メモリブロックは概略であり、縮尺どおりではありません。
量子化、KVキャッシュ精度、テンソル並列、エキスパート並列、プリフィル/デコード分離を別々の実験として扱います。これらはメモリ使用量、通信、カーネル選択、出力品質、レイテンシを変える可能性があります。最適なレイアウトはGPUタイプとインターコネクトに依存します。GPUを追加すると通信コストが増えたり、一部のリソースがアイドル状態になったりする可能性があります。精度またはモデル実行を変更した後は、正確な出力品質と障害モードを検証してください。
実践的な手順は単純です。ベースラインを再現し、目標を外している指標を特定し、1つのボトルネック仮説を立て、1つの設定を変更し、繰り返します。その設定が一方の指標を改善し他方を損なう場合は、そのトレードオフが製品に適合するかどうかを明示的に判断します。これにより、最適化はフラグの山ではなく、制御された意思決定になります。
投機的デコーディングと主張されたすべての高速化を検証する
投機的デコーディングは、ドラフトトークンが効率的に受け入れられ、ランタイムが検証を適切に実装している場合、逐次的なターゲットモデル作業を削減できます。その利点は、ドラフトパス、受け入れ動作、バッチ形状、ハードウェア、プロンプト/出力の混合に依存します。デコード律速のトラフィックには役立つ可能性がありますが、プリフィル、キューイング、通信が支配的な場合はほとんど価値がありません。
投機を有効にした場合と無効にした場合でA/Bテストを実行します。モデルチェックポイント、プロンプトセット、トークン上限、到着パターン、同時実行数、ウォームアップ、測定ウィンドウを固定します。利用可能な場合は検証ステップあたりの受け入れトークンを記録し、総スループット、リクエストあたりの速度、TTFT、p95遅延、GPU使用率、失敗、タスク品質も記録します。公開ベンチマークのシミュレートされた受け入れ長はテスト条件であり、自社プロンプトに当てはめると仮定する値ではありません。
主張された高速化は、次の3つのチェックを通過した場合にのみ有用です。同じサービス目標、許容できる回答品質、公正なコスト比較です。公開する数値には必ず完全なコンテキストを添えてください。異なるGPU数、プロンプト長、出力長、精度モード、モデルリビジョン、指標を、あたかも制御された実験であるかのように比較することは避けてください。
セルフホストか、マネージドDeepSeek V4.1 Flash APIを使用するか?
セルフホストは、トラフィックが安定してGPUを有効に活用でき、チームが推論インフラを運用でき、ハードウェアや実行の制御が運用作業を正当化する場合に理にかなっています。アクセラレータ、容量余裕、電力、ネットワーク、ストレージ、保守、エンジニアリング時間の全コストを含めます。高いピークトークン/秒の結果だけでは、成功したタスクあたりのコストが低いことを立証できません。
マネージドAPIは、チームが製品需要を迅速に検証する必要がある場合、サービングフリートの運用を避けたい場合、またはAPIベースラインを自社デプロイメントと比較したい場合に役立ちます。Atlas Cloudは、モデルID deepseek-ai/deepseek-v4.1-flash でDeepSeek V4.1 FlashをOpenAI互換APIとしてリストしています。DeepSeek V4.1 Flashモデルページでは現在、100万入力トークンあたり$0.30、100万出力トークンあたり$1.20、100万キャッシュ読み取りトークンあたり$0.03が表示されており、2026年10月時点で割引は表示されていません。支出を見積もる前に現在の価格リストを確認してください。マネージドエンドポイントは、自社リクエストのレイテンシやトラフィック経済性を測定する必要性をなくすものではありません。
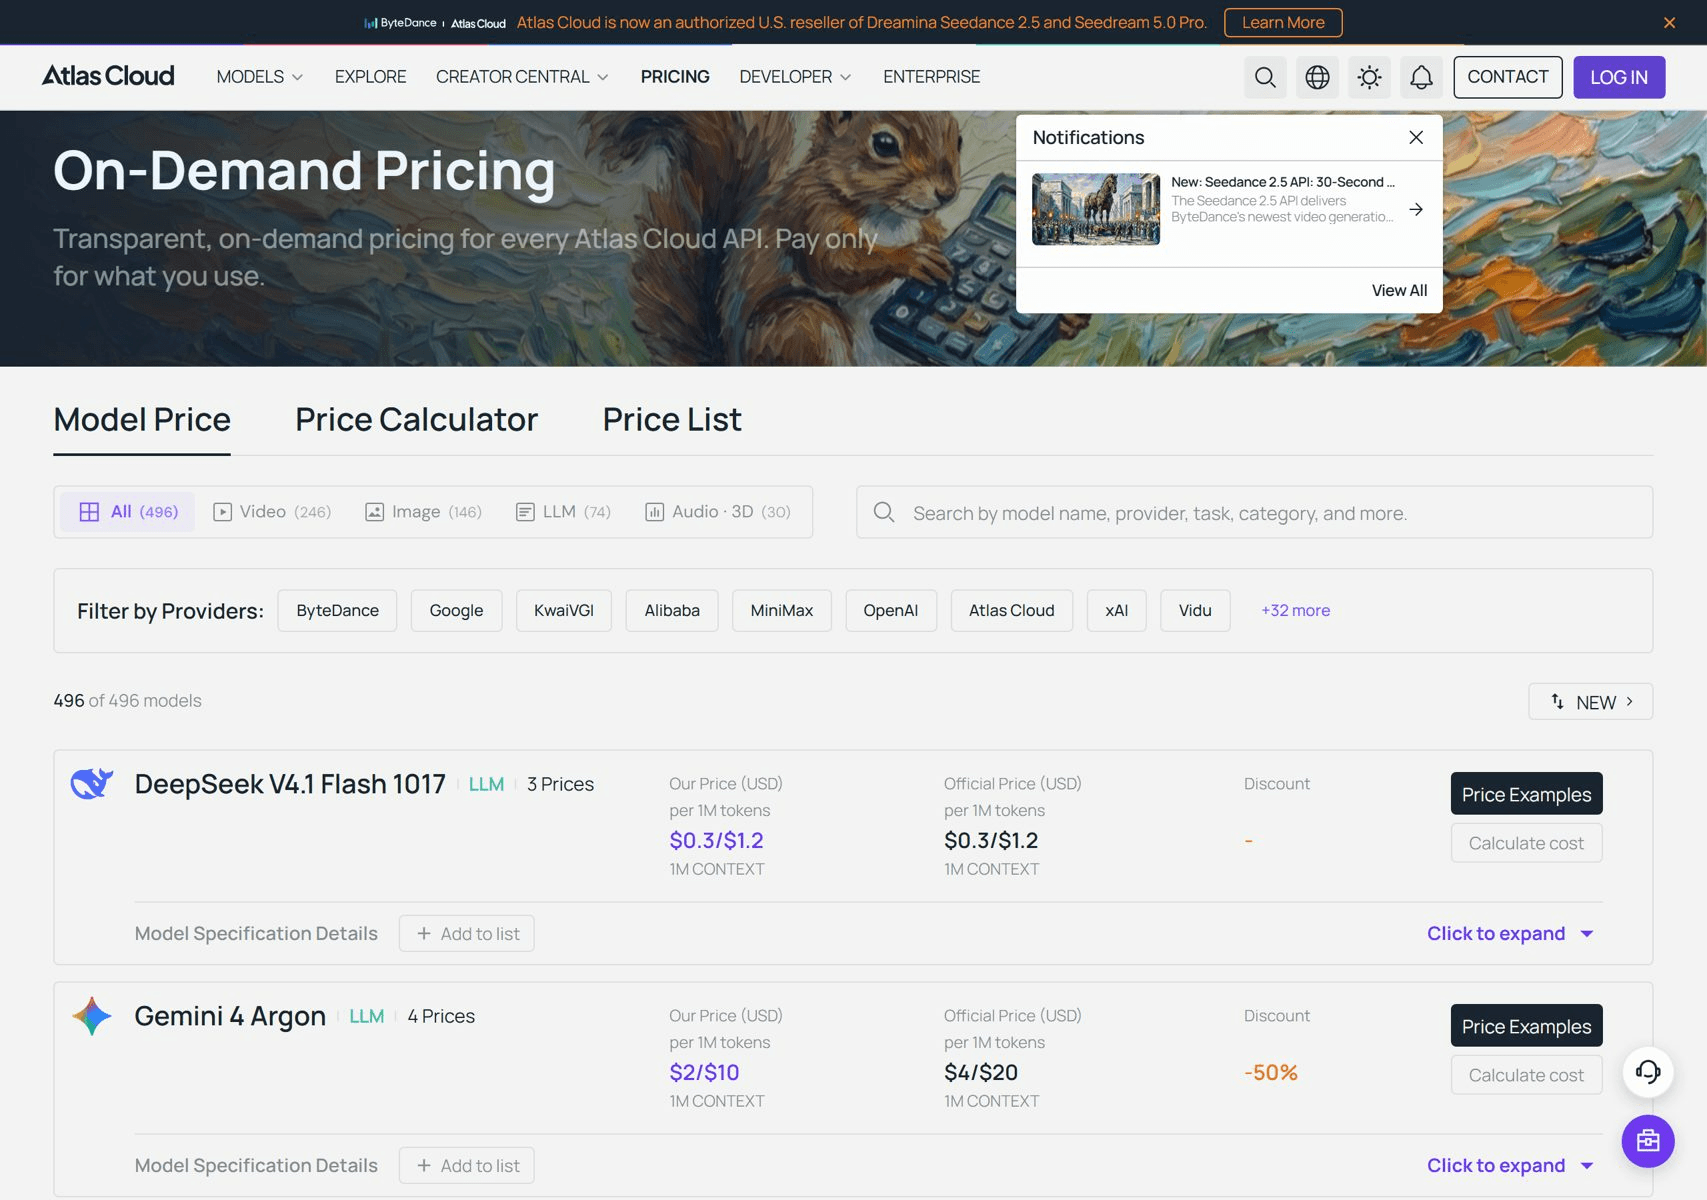
このリストはマネージドAPIオプションを示すものであり、サービングベンチマークではありません。
公正なデプロイメント判断のために、同じビジネスリクエストをセルフホストサービスとマネージドエンドポイントの両方に対してリプレイします。完了したタスクあたりのコスト、レイテンシ分布、信頼性、各オプションの維持に必要なスタッフ時間を比較します。主な目標がDeepSeek V4.1 Flash推論スループット最適化である場合は、両方のパスで同じワークロードと成功基準を維持してください。
よくある質問
スループットとユーザーあたりのトークン/秒の違いは何ですか?
総スループットはアクティブなリクエスト全体の出力を数えます。ユーザーあたりのトークン/秒は、1つのリクエストのデコード速度を測定します。バッチ処理は前者を増やしながら後者を減らす可能性があるため、インタラクティブサービスでは両方を報告してください。
同時実行数を増やすと常にスループットが向上しますか?
いいえ。総出力は計算またはメモリが飽和するまで上昇し、その後横ばいになる可能性があります。その時点以降もキューイングとテール遅延は悪化し続けることがあります。サービス目標を満たさなくなったら、同時実行数の増加を停止してください。
vLLMとSGLangのベンチマーク数値は直接比較できますか?
モデルリビジョン、ハードウェア、プロンプトと出力の長さ、同時実行数、ウォーム状態、測定境界、レイテンシ制約が一致する場合にのみ可能です。公開レポートは異なるセットアップを使用しているため、直接的なランタイムの勝者ではなく、最適化パスを示しています。
セルフホストの代わりにマネージドAPIをいつ使用すべきですか?
サービングスタックを所有することよりも、統合の速さとインフラ作業の削減が重要な場合は、マネージドAPIを使用してください。利用率、運用の専門知識、制御、および測定された総コストの根拠がGPUの運用を正当化する場合は、セルフホストしてください。





