100万トークンのコンテキストウィンドウは、モデルが受け入れられるテキストの量を示すものであり、すべての条項をどれだけ確実に解釈するかを示すものではありません。DeepSeek V4.1 Flashの長文書分析精度について、公開されているエビデンスは有用ですが不完全です。DeepSeekのモデルカードは、V4.1 FlashベースモデルのLongBench-V2において、1ショット設定で45.2の完全一致を報告していますが、APIはその後、新しい1017ビルドに移行しました。このベンチマークは1つの評価設定に関するシグナルであり、あなたの契約書、年次報告書、研究アーカイブの合格率ではありません。
実用的な答えは、Flashを高速な検索と第一段階の統合に使用し、重要な意思決定にはページレベルのエビデンスと人間によるレビューを要求することです。ここに引用されている公開ソースは、以下の5つの文書タスクにわたる再現可能な現在のビルドの評価を提供していません。テスト計画はすぐに実行できるプロトコルであり、それらの実行がすでに行われたという主張ではありません。
主なポイント
- モデルファミリーは最大100万トークンをサポートしますが、コンテキストの上限は精度の保証ではありません。
- 公開されている45.2のLongBench-V2スコアは、ベースモデルと1ショットのベンチマーク設定によるものです。
- DeepSeekのAPIは現在V4.1-Flash-1017を提供していますが、リリースノートには新しい長文書スコアは公開されていません。
- エビデンスの位置を尋ね、ソースと照合し、自分の文書でエラーを測定してください。
100万トークンのウィンドウが文書分析にとって何を意味するか
DeepSeekのモデルカードは、V4.1 Flashが最大100万トークンのコンテキストをサポートすると説明しています。APIドキュメントは現在、提供されているモデルをDeepSeek-V4.1-Flash-1017として識別し、100万トークンのコンテキスト長を記載しています。これらは容量の仕様です。モデルが脚注を見つける頻度、2つの文書バージョンを区別し続ける頻度、または要求された事実が存在しないことを認める頻度を確立するものではありません。(DeepSeekモデルカード)
トークンはページではありません。ページ数は表、脚注、レイアウト、言語、抽出品質によって異なります。スキャンしたPDFにはOCRが必要な場合があります。表はテキストに変換されると行ラベルを失うことがあります。ヘッダーや繰り返しのページ装飾は、質問に役立たないままコンテキストを消費する可能性があります。プロンプトと要求された回答もトークンを使用します。したがって、名目上の100万トークンの上限は、すべての100万トークンのファイルがすべてのチャットインターフェースやAPIクライアントを通じて完全に到着することを意味するものではありません。
テストの前に、正確なモデル識別子、クライアント、入力方法を記録します。抽出された完全なテキストが送信されたか、プロバイダーがそれを切り捨てたか、リクエストが期待されたモデルバージョンに到達したかを確認します。現在のDeepSeek APIは、最新のFlashビルドにdeepseek-flashを使用しています。ゲートウェイまたはSDKが別のエイリアスを使用している場合は、そのエイリアスを記録し、ルーティングを検証します。再現可能なホスト型呼び出しを設定するチームは、Atlas Cloudのモデルプラットフォームから始めて、そのDeepSeek V4.1 Flash APIリストを開くことができます。
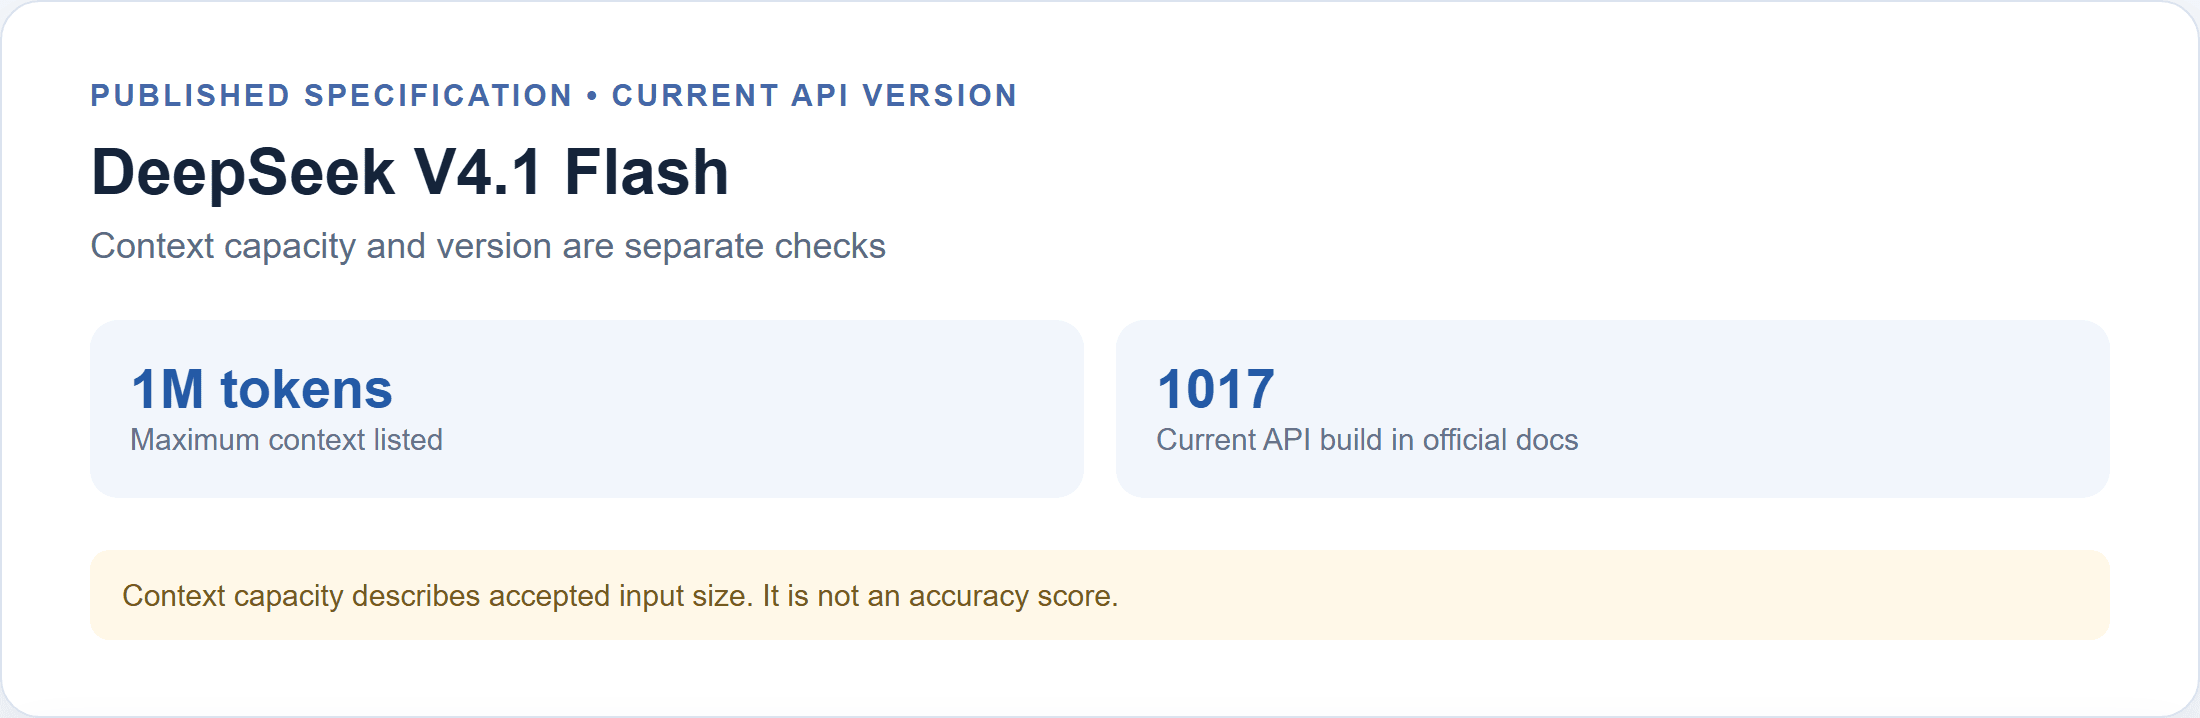
公開されている仕様では最大100万トークンのコンテキストが示されています。現在のAPIドキュメントは1017ビルドを識別しています。
アップロードまたはリクエストが成功したことは、システムが入力を受け入れたことだけを示します。関連する詳細が回答に影響を与えたことを確認するには、正確な位置を尋ね、その箇所を取得し、周囲のテキストが主張を裏付けていることを確認します。
LongBench-V2スコアが示すものと示さないもの
モデルカードのLongBench-V2の行は、1ショット設定での完全一致スコアを報告しています。その表は結果をベースモデル評価としてラベル付けし、すべてのベースモデルが同じ内部評価フレームワークを使用していると述べています。また、0.3以内のスコアは同等と見なされると述べています。値は次のとおりです。
| モデルカード内のベースモデル | LongBench-V2 (EM) | ショット数 |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44.7 | 1 |
| DeepSeek-V4-Pro-Base | 51.5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45.2 | 1 |
V4-Flash-BaseとV4.1-Flash-Baseの間の0.5ポイントの差は、カードに記載された0.3の同等帯よりも大きいですが、依然として狭いベンチマーク比較です。45.2は「長いPDFでの45.2%の精度」ではありません。これは、特定のベースモデル、ベンチマークセット、プロンプト設定、評価者に対する完全一致スコアです。異なるプロンプトであなたの質問に答えるホスト型のinstruct/APIモデルを直接スコアリングするものではありません。
LongBench-V2には、単一文書および複数文書の質問応答、長い対話、コードリポジトリ、構造化データを含む6つのカテゴリにわたる503の多肢選択問題が含まれています。そのコンテキストは8,000から200万語に及びます。ベンチマークの著者は、15分の制限下で専門家の平均精度が53.7%、報告された評価で最良の直接回答モデルが50.1%であると報告しています。その広範さは有用なストレステストになりますが、集計数値ではどの文書操作が強く、どの操作が弱いかを診断することはできません。(LongBench-V2論文)
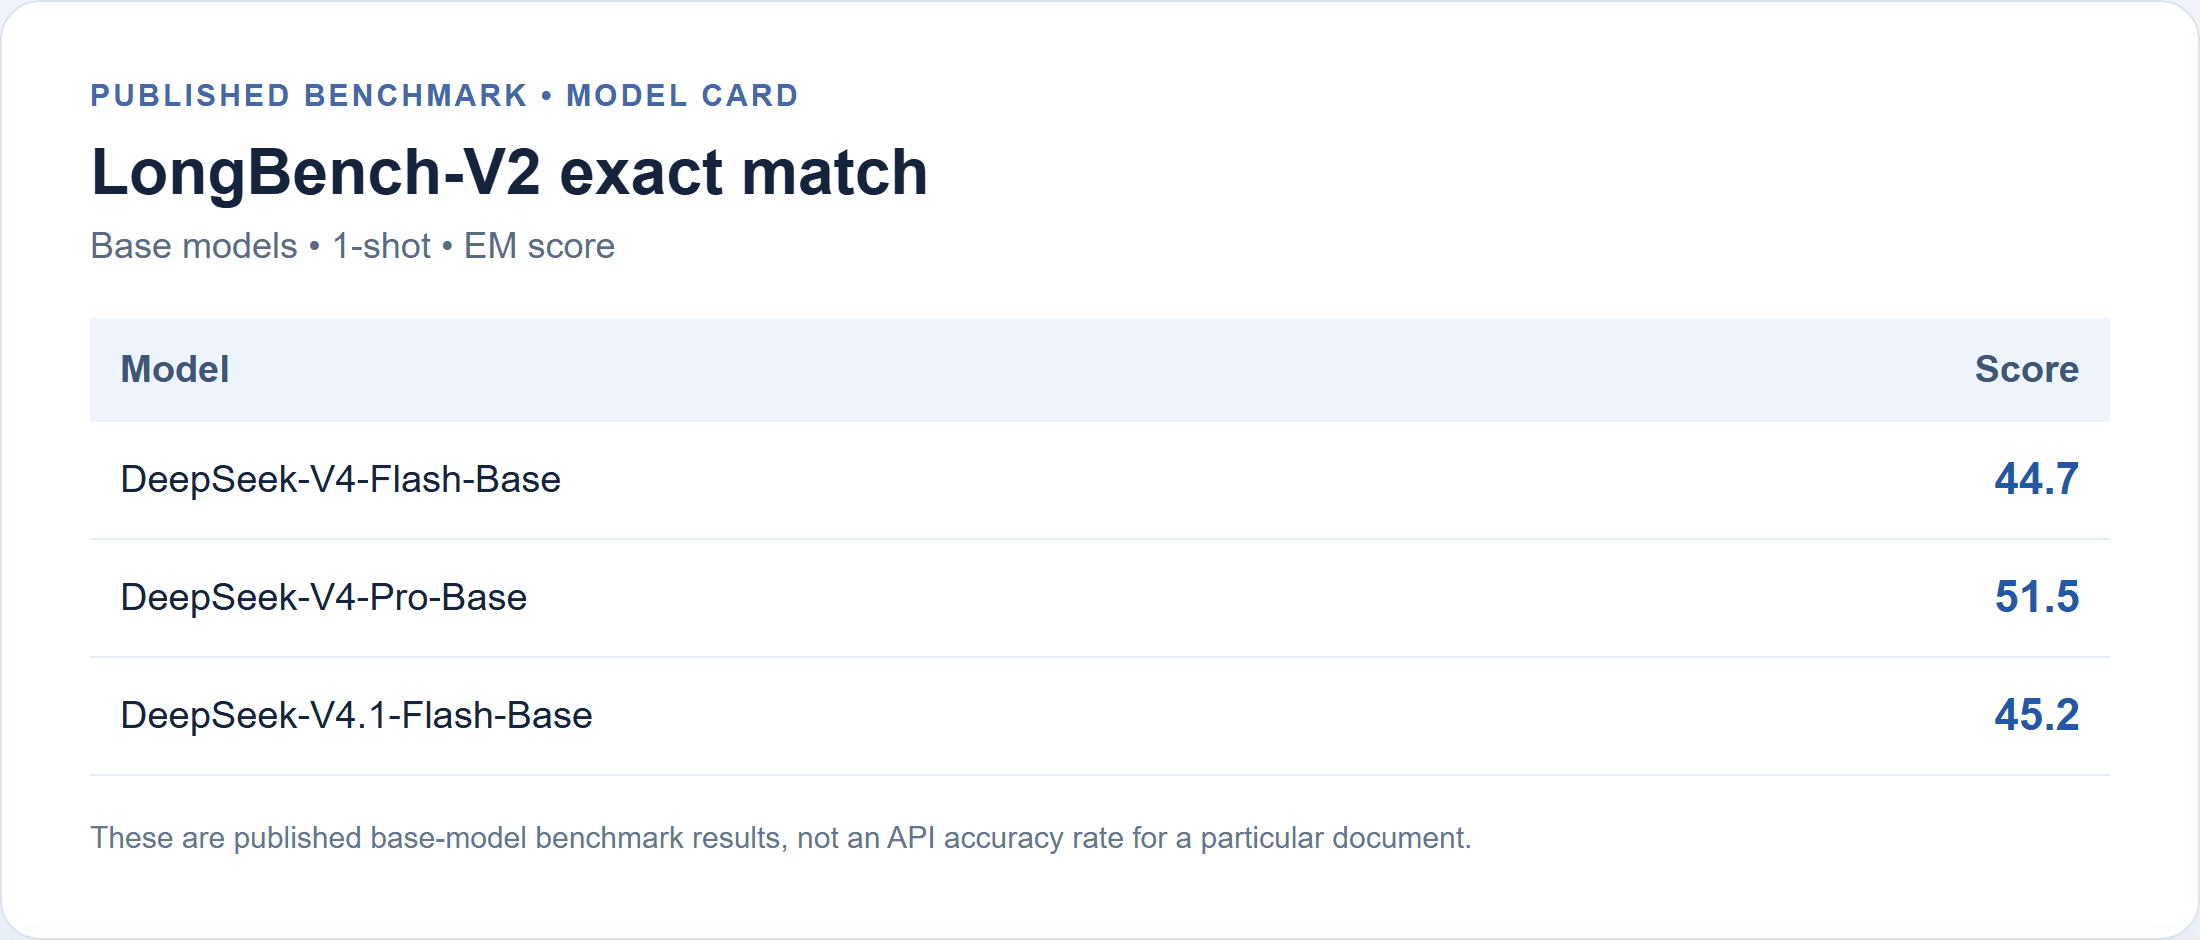
公開されている行はベースモデル、1ショットの結果です。測定されたAPI合格率ではありません。
バージョンに関する注意点があります。DeepSeekの10月17日のリリースノートによると、APIとWebアプリはV4.1-Flash-1017にアップグレードされ、APIモデル名はdeepseek-flashのままです。ノートには更新されたエージェントと推論のベンチマークが記載されていますが、新しいLongBench-V2の結果は報告されていません。したがって、45.2はV4.1 Flashベースモデルにとって有用な公開参考値であり続けますが、現在のAPIビルドの長文書質問における精度は、これらのソースでは定量化されていないままです。無関係なベンチマークの向上を文書QAに移さないでください。(DeepSeek V4.1-Flash-1017アップデート)
公正な長文書精度テストを実行する方法
有用な評価には、固定されたソース、解答キー、および採点ルールが必要です。バージョンとページ構造を共有できる公開年次報告書または技術レポートから始めます。PDFと抽出されたテキストを保存し、ソースURLと取得日を記録し、ネイティブのテキスト抽出を使用したかOCRを使用したかをメモします。モデルがうまく処理することをすでに知っているために文書を選択することは避けてください。
モデルにプロンプトを出す前に、ソースから自分で解答キーを作成します。各質問について、期待される回答と正確なページまたはセクションを記録します。これにより、説得力のある応答が採点基準になるのを防ぎます。読者が実際に直面する曖昧さを保ちながら、採点できる程度に質問を具体的にします。
各実行で同じ文書、質問セット、モデル識別子、プロンプト、推論設定、出力形式を使用します。APIが温度や推論コントロールを公開している場合は、それらを記録します。変動性を推定したい場合は、セットを複数回実行します。1回の実行はサンプルであり、安定した率ではありません。採点する前に出力を黙って修正しないでください。
コンパクトなセットで5つの異なる失敗の機会をカバーできます。
| タスク | 質問例の形式 | 確認するもの |
|---|---|---|
| 単一点検索 | 「報告書は改訂されたポリシーについてどのような日付を示していますか?」 | 正確な値と引用ページ |
| セクション間リンク | 「セクション2のリスクはセクション7の統制とどのように関連していますか?」 | 両方の箇所と、リンクが明示されているか推論されているか |
| 例外処理 | 「明記された補償範囲から誰が除外されていますか?」 | 脚注、範囲、修飾子 |
| バージョン競合 | 「改訂後に適用される値はどれで、何を置き換えましたか?」 | 日付、バージョンラベル、両方の場所 |
| 情報の欠落 | 「報告書はベンダーコピーの保存期間をどのように指定していますか?」 | 文書に何も記載がない場合の認識 |
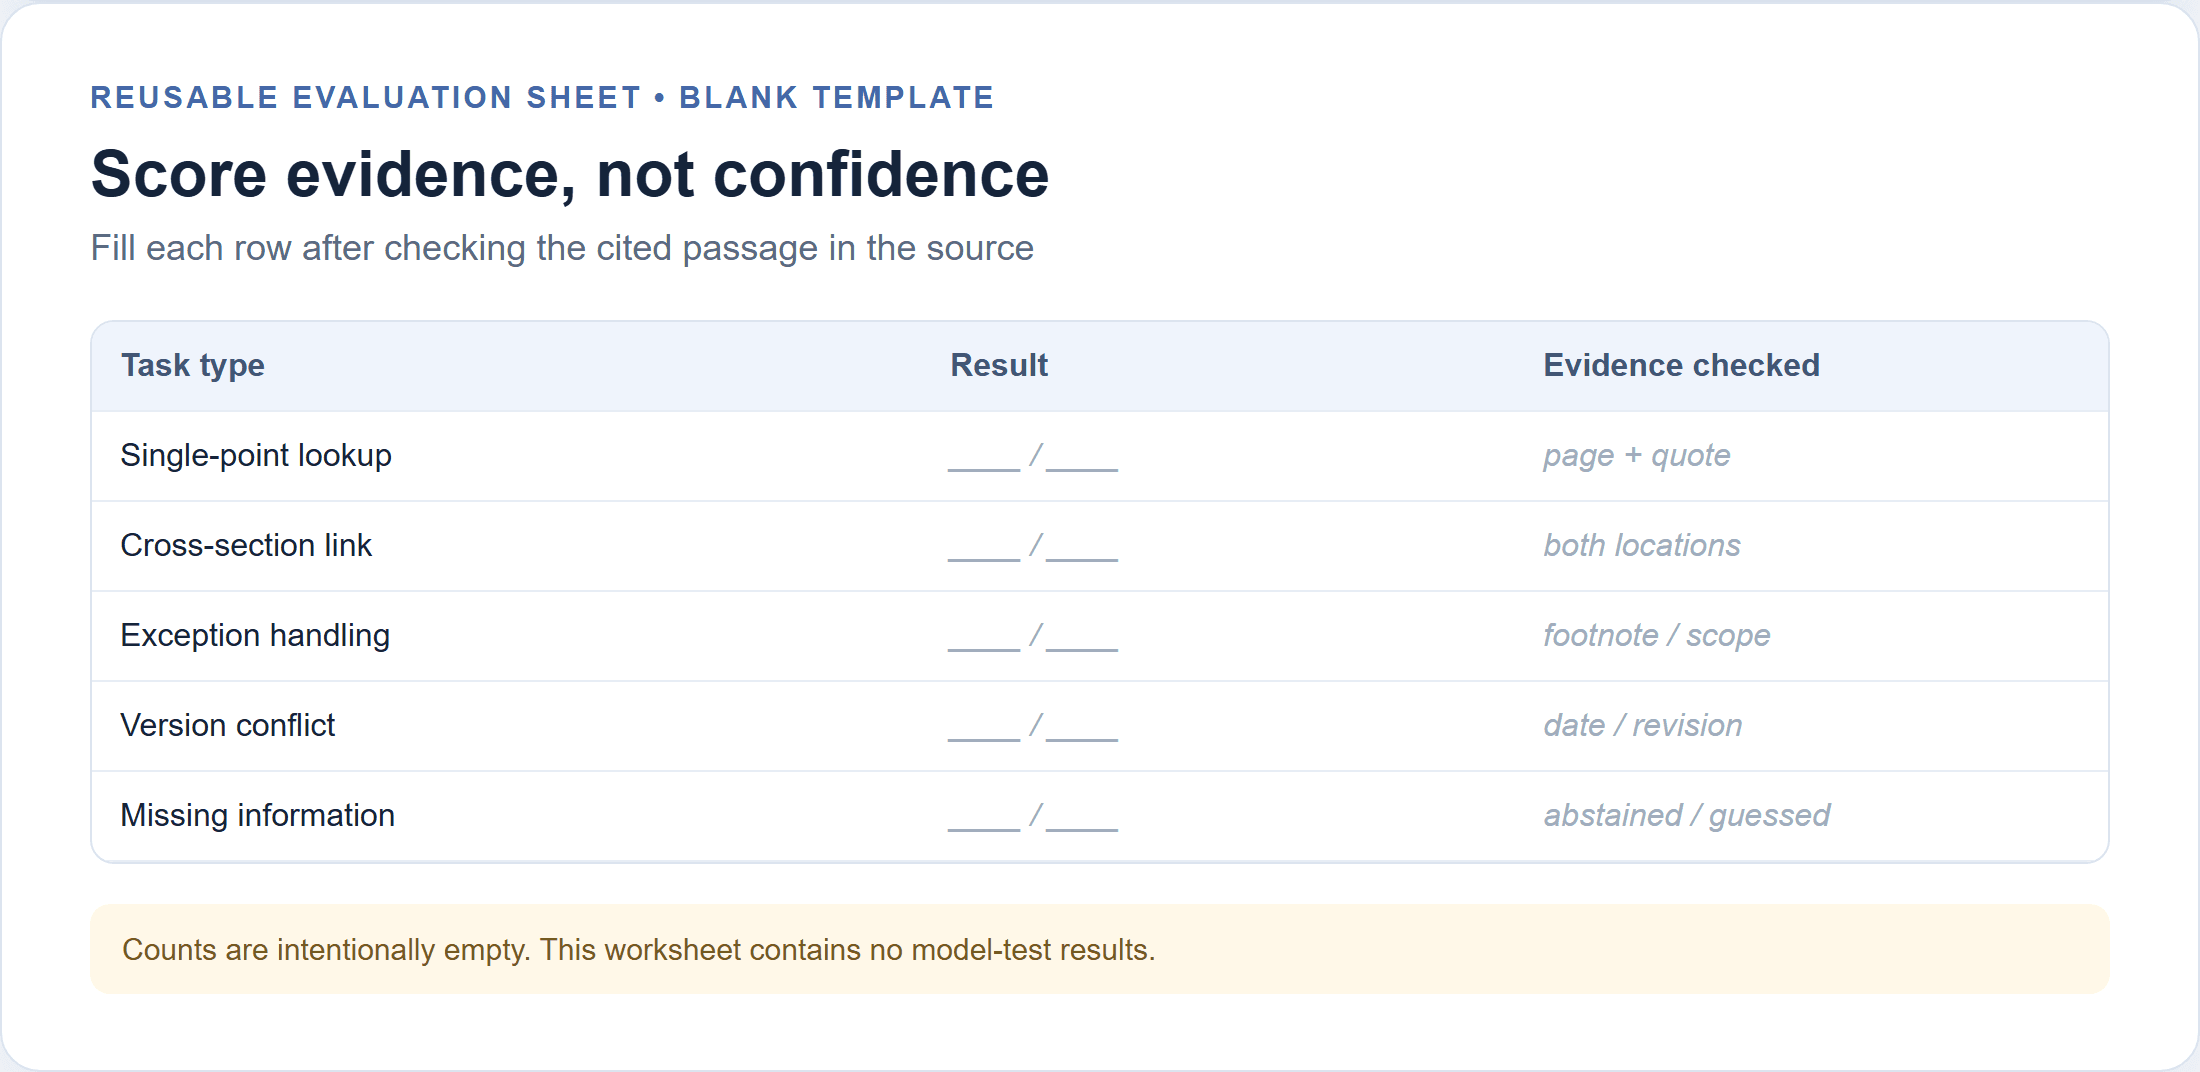
これは空白の採点ワークシートであり、結果表ではありません。各回答をソース文書と照合した後にのみ記入してください。
各回答を正解、部分正解、不正解、裏付けなし、正しく棄権した、として採点します。裏付けのない主張は不正解とは別に数えます。なぜなら、応答は正しい見出しの回答を提供し、詳細を捏造することがあるからです。各引用が主張を裏付ける箇所を指しているかを確認します。質問数とカテゴリ数を一緒に報告します。全体のパーセンテージは、モデルが脚注を見落としたか、情報がセクション全体に分散している場合にのみ苦戦したかを隠します。
正確なソースファイル、抽出、プロンプト、生の応答、採点シートを保存します。共有する許可を得た資料のみを公開し、機密の名前やアカウント詳細を編集します。レビュー担当者は、採点されたすべての回答をモデル出力から保存されたソースのページまで追跡できる必要があります。
長文書の回答が失敗しがちな箇所
特定の文書に対して現在のビルドの実行を行わない限り、V4.1 Flashが特定のエラー率や失敗パターンを示したと主張するのは誤りです。以下のカテゴリは検査するものであり、このモデルについて測定された調査結果ではありません。
まずスコープの喪失から始めます。本文の段落が規則を述べていても、脚注がそれを地域、日付範囲、または顧客クラスに限定している場合があります。例外を明示的に尋ね、引用された箇所がそれを含んでいるかを検査します。本文の段落だけからの引用では不十分な場合があります。
次にバージョンの混乱を確認します。報告書は草案と改訂セクションで類似の値を繰り返すことがあります。「現在の数字」だけを要求するのではなく、モデルに各値に付随する日付やバージョンを挙げるように依頼します。モデルが黙って1つを選択した場合、たとえ正しく選択したとしても、応答を不完全として採点します。
セクションをまたぐ質問は推論を招きます。モデルは2つの正確な事実を、文書が決して述べていない因果関係の説明に組み合わせる可能性があります。直接的な記述と推論を別々にラベル付けするよう要求します。次に、推論をエビデンスと比較し、それがタスクにとって妥当かどうかを判断します。
最後に、棄権をテストします。答えが存在しない質問を含めます。自信に満ちた推測は、もっともらしく聞こえても失敗です。契約、コンプライアンス、臨床資料、または結果を左右する財務分析については、結論を使用する前に資格のある人に原文を確認してもらいます。
より安全な回答のための検証ワークフロー
このプロンプトは回答を監査しやすくします。正確性を保証したり、ソースレビューを置き換えたりすることはできません。ページラベルを保持する抽出でこれを使用し、巨大なファイルの一般的な要約を要求するのではなく、焦点を絞った質問をします。
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
長いレポートの場合、作業を任意のページ数で自動的に分割するのではなく、タスクごとに分割します。まずソースマップを求めます:セクションタイトル、日付、定義された用語、関連する表。次に特定のトピックを照会し、その裏付けとなる箇所を要求します。セクションをまたぐ結論については、同じターンで両方の箇所を提供または取得し、推論をマークしながらリンクを説明するようモデルに依頼します。
人間による検証ループを使用します:
- 引用されたページと引用文を元のファイルで確認します。
- 引用文が隣接する例外や表のヘッダーを含んでいることを確認します。
- 各主張を直接、推論、裏付けなし、矛盾としてマークします。
- 抽出が重要な構造を省略した場合は、プロンプトを修正するかタスクを分割します。
- レビュー担当者が決定を再現できるように、生のリクエストと応答を保存します。
ホスト型エンドポイントを使用する場合、実行ログにトークン使用量を含めます。Atlas Cloudのモデル価格ページでは現在、DeepSeek V4.1 Flashを100万入力トークンあたり$0.30、100万出力トークンあたり$1.20、100万キャッシュ読み取りトークンあたり$0.03でリストしており、割引は記載されていません。予算を立てる前に現在のリストを確認してください。この価格参照はAtlas Cloudのものであり、普遍的なDeepSeek API価格ではありません。
これらの記載レートでは、100,000の非キャッシュ入力トークンと3,000の出力トークンのコストは約$0.033です:入力に$0.030、出力に$0.0036です。
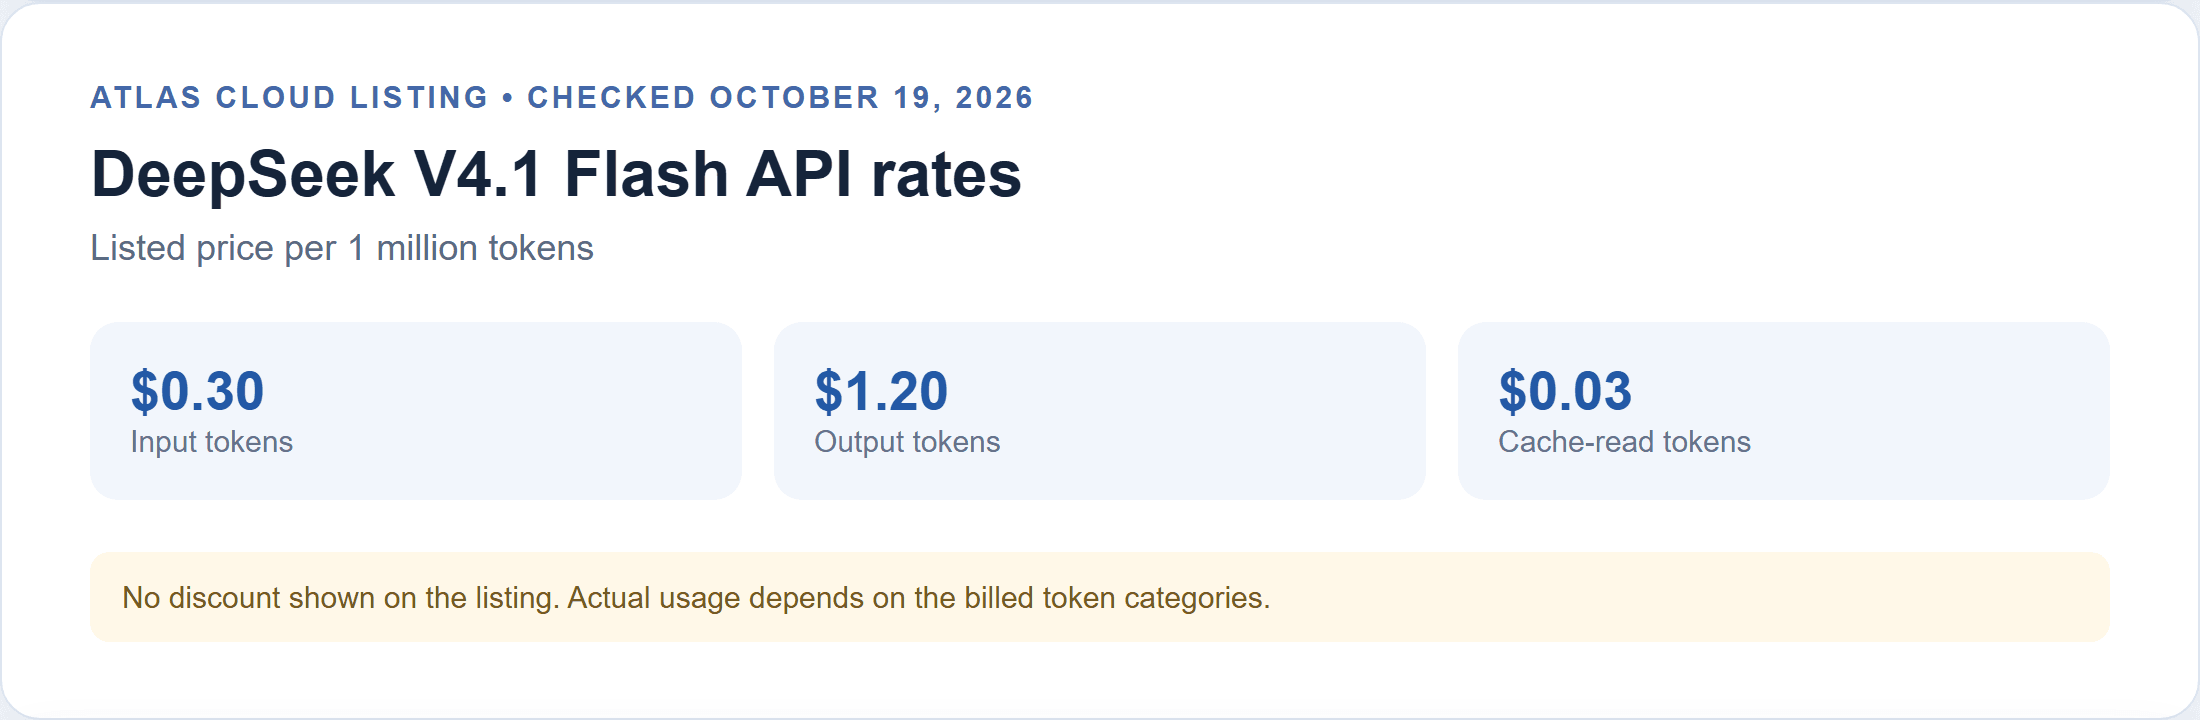
Atlas Cloudの価格は2026年10月19日に確認。リストに割引はありません。 100万トークンの入力と20,000トークンの回答は、同じレートで約$0.324のコストになります(キャッシュ処理やその他の課金項目を除く)。これらは算術的な例であり、測定された文書テストの請求額ではありません。実際の入力にはプロンプトと抽出されたテキストが含まれます。繰り返しの呼び出しは使用量を増やします。ページ数から推定するのではなく、プロバイダーが返すトークン数を使用してください。
長文書にDeepSeek V4.1 Flashをいつ使用するか
Flashは、定義を見つけたり、日付を収集したり、セクションマップを作成したり、人が確認する要約を起草したりする必要がある場合の合理的な第一段階です。これらのタスクには目に見えるエビデンスの軌跡があり、より厳密な質問で簡単に再実行できます。定期的な作業では、既知の回答の質問を保持し、モデルバージョン、抽出パイプライン、またはプロンプトが変更されたときに再実行します。
質問が離れたセクションを組み合わせたり、脚注に依存したり、改訂を比較したりする場合は、コントロールを追加します。引用はナビゲーションの補助として使用し、それ自体を証明として使用しないでください。回答が契約義務、コンプライアンス上の立場、財務開示、またはその他の影響の大きい決定に影響を与える場合は、資格のあるレビュー担当者にソース内の各重要な主張を検証してもらいます。
有用な問いは、このモデルがあなたのバージョンの文書と正確なワークフローで、チェックに耐えるエビデンスを伴う回答を返すかどうかです。それが、あなた自身のユースケースに対してDeepSeek V4.1 Flashの長文書分析精度を確立できるテストです。
よくある質問
100万トークンのコンテキストウィンドウは、モデルが100万トークンの文書を正確に分析できることを意味しますか?
いいえ。それはサポートされるコンテキスト容量を説明しています。実際のリクエストには命令と出力バジェットも含まれ、抽出、インターフェースの制限、質問の難しさが、有用なエビデンスが利用可能で正しく解釈されるかどうかに影響します。
LongBench-V2は文書質問応答の精度と同じですか?
いいえ。いくつかの長文コンテキストタスクカテゴリを含み、特定の設定でのパフォーマンスを報告しています。これは比較シグナルであり、特定のPDF、APIビルド、プロンプト、またはドメインに対する保証ではありません。
1つのプロンプトを使用するべきか、長い文書をセクションに分割するべきか?
構造が重要な場合は、ソースマップと焦点を絞った質問を使用します。比較する必要がある箇所は、統合ステップのために一緒に利用できるようにし、応答を検証できるようにページラベルを保持します。
AIが生成した要約からの引用をどのように検証するべきですか?
元のファイルで引用された各ページを開き、引用文と周囲のテキストを確認し、その箇所が特定の主張を裏付けていることを確認します。引用された文だけでなく、表の見出しや脚注も検証します。





