

開発者が「1Mトークン」を見て、リポジトリ全体、そのイシュー履歴、長い設計レポートを1回のリクエストで送信しようと準備しています。gemini 4 Argon 1Mコンテキストウィンドウの重要な点は、1,048,576トークンが入力、思考、出力で共有されることです。100万入力トークンに加えて、回答用にさらに100万トークンがあるわけではありません。Googleはデフォルトの同期出力上限を65,536トークンと記載しており、ロングデコードは残りの共有容量まで生成を延長できます。Googleのモデル仕様に制限が記載されています。本ガイドでは、それらを予算と、ロングコンテキスト、検索、チャンキングに関する判断に落とし込みます。
重要なポイント
- 1,048,576トークンのコンテキストは、入力、思考、出力を合わせた予算です。
- デフォルトの同期出力は65,536トークンに制限されます。ロングデコードによってコンテキストが増えるわけではありません。
- 既知のソースセット全体にまたがる関係性が重要な場合はロングコンテキストを使用し、そうでない場合は検索またはチャンキングを使用します。
Gemini 4 Argonの1Mコンテキストウィンドウとは何を意味するのか?
1,048,576トークンの予算は共有される
コンテキストウィンドウとは、1回のリクエストで利用できるトークン上限です。Argonについて、Googleは1,048,576という統合合計を記載しています。プロンプト、添付されたソース素材、思考トークン、生成された回答は、この許容量から消費されます。これは容量を表すものであり、すべての詳細が等しく簡単に検索または推論できるという約束ではありません。
リクエストに900,000のソーストークンが含まれる場合、インターフェース固有の制限を別として、思考と出力を合わせて最大148,576トークンが残ります。その後200,000トークンの回答を要求できると仮定するアプリケーションは、同じ予算を過剰に約束しています。
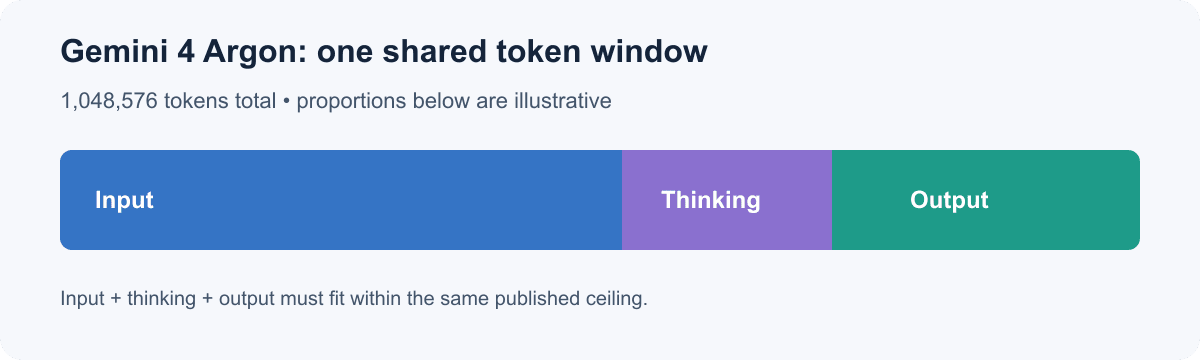
公開されているウィンドウは1つの共有上限です。セグメントのサイズは概念上のものであり、固定された割り当てではありません。
入力、思考、出力は1つのウィンドウから消費される
有用な計画式は次のとおりです:
input tokens + thinking tokens + output tokens <= 1,048,576
これは予算チェックであり、開発者がすべての呼び出しで正確な思考トークン数を設定できるという主張ではありません。Googleは思考設定をlow、medium、highとして記載しています。内部消費量はタスクと設定によって変動する可能性があります。理論上の残量を保証された回答容量として扱うのではなく、推論用のスペースを確保してください。
Argonはテキスト、画像、動画、音声、PDF入力を受け付け、テキストを出力します。メディアの計算はプレーンテキストと同等ではないため、ファイル数やページ数から総トークンを確実に予測することはできません。代表的なリクエストの使用状況メタデータを確認してください。
コンテキストウィンドウと出力制限:決定的な違い
デフォルトの出力上限
モデルページには、デフォルトの同期生成の最大出力が65,536トークンと記載されており、これは全ウィンドウの約16分の1です。リクエストは全体的なコンテキスト制限内に収まっていても、有効な出力上限を超える可能性があります。
多くのアプリケーションでは、そのデフォルトで十分です。リポジトリレビューやドキュメント統合では通常、ソースセットと同じ長さの回答ではなく、焦点を絞った回答が必要です。上限のある出力は、レビュー、保存、別のステップへの受け渡しが容易です。
ロングデコードが変えるもの
ロングデコードは、モデル仕様によると最大1,048,576トークンまで、はるかに長い生成をサポートします。ただし、全ウィンドウを拡張するわけではありません。プロンプトがすでにその大部分を占めている場合、思考と出力に残る容量は少なくなります。APIパス、SDK、リクエスト設定、レスポンス処理も重要であるため、本番環境で長い応答に依存する前に、現在の統合ガイダンスを確認してください。
ロングデコードは、大規模な構造化変換を1回の操作で返す場合など、成果物が本当に大量の生成素材を必要とする場合にのみ使用してください。回答を検証済みのセクションに分割できる場合は、段階的な生成によって、不完全な結果の検出と復旧が容易になります。
入力、思考、出力トークンを予算化する方法
成果物から始め、利用可能な場合は選択したモデルの計数ルートを使用してソーストークンを見積もります。指示、ツール結果、スキーマテキスト、会話履歴も数えます。理論上の残量を使い切るのではなく、思考と見積もり誤差のための余裕を確保してください。
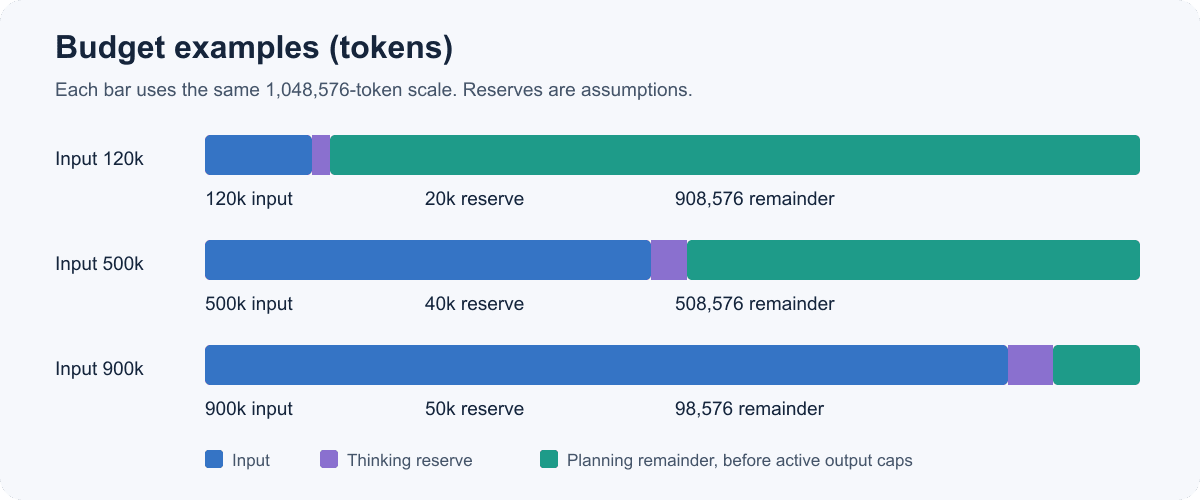
以下の数値は算術例であり、固定の推論消費量ではありません。「計画残量」は、想定入力と確保した思考許容量を差し引いた後の合計です。実際のサービス制限は引き続き適用されます。
| 想定入力 | 思考用の予備 | 出力用の計画残量 | 例 |
|---|---|---|---|
| 120,000 | 20,000 | 908,576 | 複数のマニュアル、簡潔な統合 |
| 500,000 | 40,000 | 508,576 | ファイル参照付きのコードベースレビュー |
| 900,000 | 50,000 | 98,576 | 範囲を限定した回答によるアーカイブ比較 |
1,048,576トークンの上限に基づく例示的な計算。予備量は計画上の仮定です。
次のリクエスト計画チェックリストを使用してください:
- 入力: 推定ソーストークンとプロンプトトークン。
- 思考: タスクの複雑さとサポートされている設定に基づいて容量を確保する。
- 出力: 成果物に合う上限を選択する。
- 確認: 3つの量を合計し、見積もり誤差の余地を残す。
- パス: 選択したエンドポイントまたはSDKが出力長と継続動作をサポートしていることを確認する。
500,000トークンのコードベースレビューの場合、チームは思考用に40,000トークンを確保し、25,000トークンの回答を目標にするかもしれません。その計画は紙の上では565,000トークンを使用し、不完全な見積もりや追加指示のための余裕を残します。チームは依然として実際の使用量と設定された生成制限を確認する必要があります。予備量は計画ツールであり、内部推論の予測ではありません。
バッチ実行の前に、複数の種類のリクエストをサンプリングします。短いドキュメントページ、コードの多いモジュール、表を含むPDFは、ファイルサイズが似ていても異なるトークン数を生成する可能性があります。代表的な入力を数え、見積もりをAPIから返された使用量と比較します。モデルの実際の思考または出力レポートが想定と異なる場合は、バッチサイズを増やす前に予備量と上限を更新します。この小さなキャリブレーション手順により、ロングコンテキストワークフローをトークンと予算の範囲内に保つのに役立ちます。
100万トークンに何を収められるか?
ドキュメント、コード、マルチモーダル素材
100万トークンあれば、一連のマニュアル、複数の契約書、大規模なソースツリー、メモ付きの長い文字起こしなどを1回で分析できる可能性があります。Googleは約1,500ページのテキストや30,000行のコードといった大まかな例を用いています。これらは規模の例として扱い、保証とは考えないでください。レイアウト、コード密度、言語、フォーマット、トークン化がすべてカウントに影響します。
リポジトリ作業では、ビルドファイル、生成コード、コメント、依存関係メタデータ、テスト、関連するイシューコンテキストを見積もりに含めます。その後、タスクにすべてが必要かどうかを問います。モジュール横断的なアーキテクチャレビューは広範なソースセットから恩恵を受けるかもしれませんが、1つのエラーメッセージに関する質問はおそらくそうではありません。
マルチモーダル入力も見積もりを複雑にします。動画の長さ、フレームサンプリング、音声、解像度、APIでの扱いは、使用量とモデルが見る証拠に影響する可能性があります。狭い質問の場合は、関連するメディアのみを含め、拡大する前に代表的なリクエストの使用量を確認してください。
トークン数はページ数ではない
トークンはモデル処理の単位であり、単語、文字、ページ、行ではありません。識別子、表、ソースコード、非英語の文章は、通常の散文とは異なるトークン化になることがあります。ページの見積もりでは、特定のコレクションが収まるかどうかはわかりません。
容量は品質とも異なります。ソースセットが収まるからといって、モデルがあらゆる埋もれた例外を見つけ、すべての依存関係を保持し、矛盾する箇所を正しく解決できる証拠にはなりません。仕様は制限を定めるものであり、網羅的な想起やタスク固有の精度スコアではありません。結果が重要な結論については、ソースの場所を要求し、重要な主張を原本と照合して検証してください。
1Mウィンドウが役立つ場合とそうでない場合
ロングコンテキストは、回答が単純なクエリでは検索できない可能性のある資料全体に散在する関係性に依存する場合に最も有用です。変化するコーパス全体に対して繰り返し狭い質問をする場合は、あまり魅力的ではありません。そのような場合、検索によってより小さな証拠セットを選択できます。これらはワークフローのトレードオフであり、普遍的な精度ランキングではありません。
| アプローチ | 検討すべき場合 | トレードオフ |
|---|---|---|
| ロングコンテキストリクエスト | 一度限りの分析で、既知のソースセット全体にまたがる関係性が必要な場合 | 大きな入力はコストとレイテンシを増大させる可能性がある。カバレッジを検証する |
| 検索 | ユーザーが変化するコーパス全体に対して繰り返し質問する場合 | インデックス作成と検索によって、どの証拠がモデルに届くかが決まる |
| チャンキング | ドキュメントを独立した単位または段階として処理できる場合 | チャンク間の関係性を調整する必要がある |
| ハイブリッド | 広い方向性を得た後、焦点を絞った証拠確認が必要な場合 | より多くのオーケストレーションと状態管理が必要 |
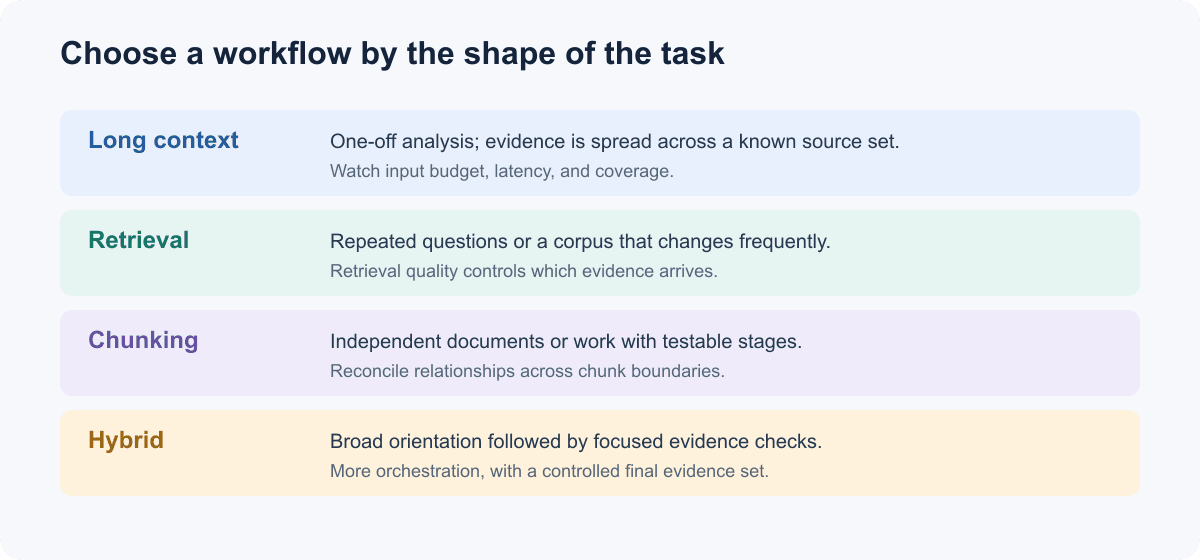 タスクの形状とクエリパターンに基づいて選択し、代表的な入力で検証します。
相互に影響する条項を持つポリシーの比較、多数のソフトウェアモジュールにまたがる変更のレビュー、またはあるソースの詳細が別のソースの解釈を変えるドキュメントの統合には、ロングコンテキストを検討してください。検索は、成長するナレッジベースに対する繰り返しのサポート質問に適しています。チャンキングは、ソース単位が独立している場合、または各段階にテスト可能な出力がある場合に機能します。ハイブリッドワークフローでは、まずコレクションをマッピングし、次に最終回答のためにパッセージを検索して検証できます。
同じ代表的な質問に対してオプションを評価します。必要な証拠が含まれていたか、引用が正しい箇所を指しているか、トークン使用量、応答時間、不完全な回答後の復旧努力を追跡します。これにより、より大きなウィンドウが自動的に改善すると仮定するのではなく、チームのワークロードに対する証拠が得られます。
ロングコンテキストタスクにGemini 4 Argonを使用する
モデルIDとリクエストパスを確認する
GoogleはGemini APIのモデルIDを `gemini-4-argon` として記載しています。自分のアカウントで有効になっていること、および必要な機能を正確なAPIサーフェスがサポートしていることを確認してください。同じモデル名であっても、すべてのプロキシ、SDK、コンソール、クライアントが同一の制限やロングデコード動作を提供するとは限りません。
本番環境の前に、次を確認してください:
- モデルIDと、自分のアカウントまたはリージョンでの可用性。
- 同期出力上限と、ロングデコードがどのように要求または返されるか。
- SDKが継続を処理するかどうか、および部分的な応答や失敗した応答をどのように報告するか。
- 選択したAPIでサポートされている思考設定、ツール、キャッシュ、モダリティ。
- リクエストの実際の入力および出力使用量フィールド。
Googleのロングコンテキストガイドでは、統合予算について説明しています。SDKとAPIのガイダンスは変更される可能性があるため、サポートされているSDKバージョンを固定し、現在の例を確認し、本番環境で計画しているものと同じトランスポートとレスポンス処理を統合テストしてください。古いモデル統合からパラメータ名をコピーする場合は、それらがまだ適用されるかを確認せずに行わないでください。
出力契約をソースセットより小さくする
モデルに範囲を限定したタスクと応答形式を与えます。リポジトリ監査では、重大度別にグループ化された所見をファイルパスと行参照付きで要求し、仮説を含めるのか、確認された欠陥のみを含めるのかを明記します。契約比較では、条項を指定し、セクション識別子または簡単な裏付け抜粋を要求します。これは「すべてを分析する」よりもレビューが容易です。大きな応答の場合は、継続と部分完了を計画します。SDKが公開する場合は識別子と応答チャンクを永続化し、下流で使用する前に構造化出力を検証し、可能な場合は失敗した部分のみを再試行します。これらは実装および検証すべき安全策であり、すべてのSDKが中断を同一に処理するという主張ではありません。
料金とアクセス:実行前に確認すべきこと
Googleの発表では現在、2026年11月30日まで、入力1百万トークンあたり$2、出力1百万トークンあたり$10の導入価格が記載されており、その後は記載されている1百万トークンあたり$4と$20の料金になります。これは時間に敏感です。公開または支出予測の前に、公式のGemini 4 Argon発表を再確認してください。プロンプト重視のワークロードと生成重視のワークロードではコストプロファイルが異なるため、入力と出力を別々に見積もってください。
本記事で確認したディレクトリページでは、Atlas Cloud経由でのArgonの可用性は確認されていません。Atlas Geminiモデルカタログには、現在そこに掲載されているGeminiモデルとアクセス詳細が表示されていますが、Argonが利用可能であることを証明するものではありません。リクエストをルーティングしたりコストを比較したりする前に、モデル固有の詳細ページ、プロトコル、価格を確認してください。
代表的なリクエストから始め、モデルとSDKのバージョン、トークン使用量、レイテンシ、エラー、タスク固有の品質チェックを記録します。ソースセットやクエリパターンが変わったら、予算と検索の選択を見直します。Gemini 4 Argon 1Mコンテキストウィンドウは、その広さが実際のソース横断的な問題を解決し、リクエストに明確な予算と検証計画がある場合に有用です。
よくある質問
Gemini 4 Argonの1Mウィンドウは入力と出力で共有されますか?
はい。Googleは、入力、思考、出力にまたがって共有される単一の1,048,576トークンウィンドウを定義しています。回答に残る量は、リクエストと適用されるインターフェース制限によって異なります。
Gemini 4 Argonのデフォルト出力制限は何ですか?
仕様には、デフォルトの同期出力が65,536トークンと記載されています。ロングデコードは、残りの共有容量とAPIパスに従い、より大きな生成をサポートできます。
Gemini 4 Argonは1回の応答で1Mトークンを生成できますか?
モデルページには、ロングデコードで最大1,048,576の出力トークンが記載されていますが、これは上限の能力であり、入力を含むリクエストが100万トークンも返せるという保証ではありません。入力と思考は同じ全ウィンドウを占めます。
1Mコンテキストウィンドウがあれば、すべての詳細が正確に想起されるということですか?
いいえ。これは最大トークン予算を表すものであり、完全な検索や推論を意味するものではありません。証拠参照を要求し、自分の資料から既知のエッジケースをテストしてください。
Gemini 4 Argonは現在Atlas Cloud経由で利用できますか?
本記事で確認したAtlas Cloudカタログでは、Argon固有のモデル掲載または詳細ページを確認できませんでした。サポートを前提とする前に現在のディレクトリを確認してください。上記のGeminiカタログリンク自体は、Argonの可用性を証明するものではありません。


