

アップロードした動画に必要な答えが含まれていても、誤って読み取られることがあります。Gemini 4 Argon は、テキスト、画像、動画、音声、PDF を入力として受け取り、それらの詳細を分析または関連付けたテキストを返します。gemini 4 Argon のマルチモーダル機能 は、新しいメディアを作成するのではなく、既存の資料を検査するタスクで最も役立ちます。その統合コンテキスト上限は 1,048,576 トークンですが、これは容量の上限であり、精度の保証ではありません。以下では、何を分析できるか、答えを検証する方法、現在の API と Atlas Cloud がどこに適合するかをタスク別に説明します。
主なポイント
- Argon はテキスト、画像、動画、音声、PDF の入力を受け付けます。文書化されている出力はテキストです。
- 1,048,576 トークンのコンテキストは入力と出力で共有されます。デフォルトの同期出力は 65,536 トークンに制限されています。
- 画像生成、音声生成、Live API は Argon モデルではサポートされていません。
- ワークフローで使用する前に、ページ番号、タイムスタンプ、または目に見える証拠と照合して主張を検証してください。
Gemini 4 Argon にとって「マルチモーダル」とは何か
Gemini API において、マルチモーダルとは、Argon がリクエスト内でさまざまな種類のソース資料を受け取り、テキスト指示とともにその資料について推論できることを意味します。現在の Gemini API モデルページ には、テキスト、画像、動画、音声、PDF の入力が記載されており、出力はテキストです。また、サポートされている機能として、構造化出力、関数呼び出し、コード実行、ファイル検索、検索グラウンディングも記載されています。これらのツールはワークフローを形作ることができますが、出力モダリティを画像、音声トラック、ライブ会話ストリームに変えるものではありません。(Google AI for Developers、2026年10月)
トークン数は注意深く読む必要があります。Google は、入力と出力を合わせた統合コンテキストウィンドウを 1,048,576 トークンと記載しています。通常の同期リクエストの最大出力は 65,536 トークンです。long decode は、文書化されたバックグラウンド継続フローにおいて最大 1,048,576 に達することがあります。プロンプトと添付コンテンツが共有ウィンドウのほとんどを消費する場合、推論と回答テキスト用の余裕が少なくなります。「1M コンテキスト」という見出しは、100万トークンのすべてのリクエストが 1 回の通常の応答に収まることを意味しません。
| 提供する資料 | 文書化された入力? | Argon の出力 | 有用な最初のタスク | 確認すべき証拠 |
|---|---|---|---|---|
| テキストと PDF | はい | テキスト | レポートを要約する、またはセクション間で主張を比較する | ページ、見出し、表の行、または引用箇所 |
| 画像 | はい | テキスト | グラフを読む、オブジェクトを識別する、または 2 つの画像を比較する | ラベル、値、位置、画像の切り抜き |
| 動画 | はい | テキスト | イベントの順序を説明する、またはクリップ内の瞬間を見つける | タイムスタンプと実際のフレーム |
| 音声 | はい | テキスト | アップロードされた録音について質問に答える | 音声セグメント、文字起こし、話者、または音 |
| 生成メディア | 画像/音声生成の記載なし | テキスト | 書面による分析または構造化された結果を返す | スキーマとソースのサポート |
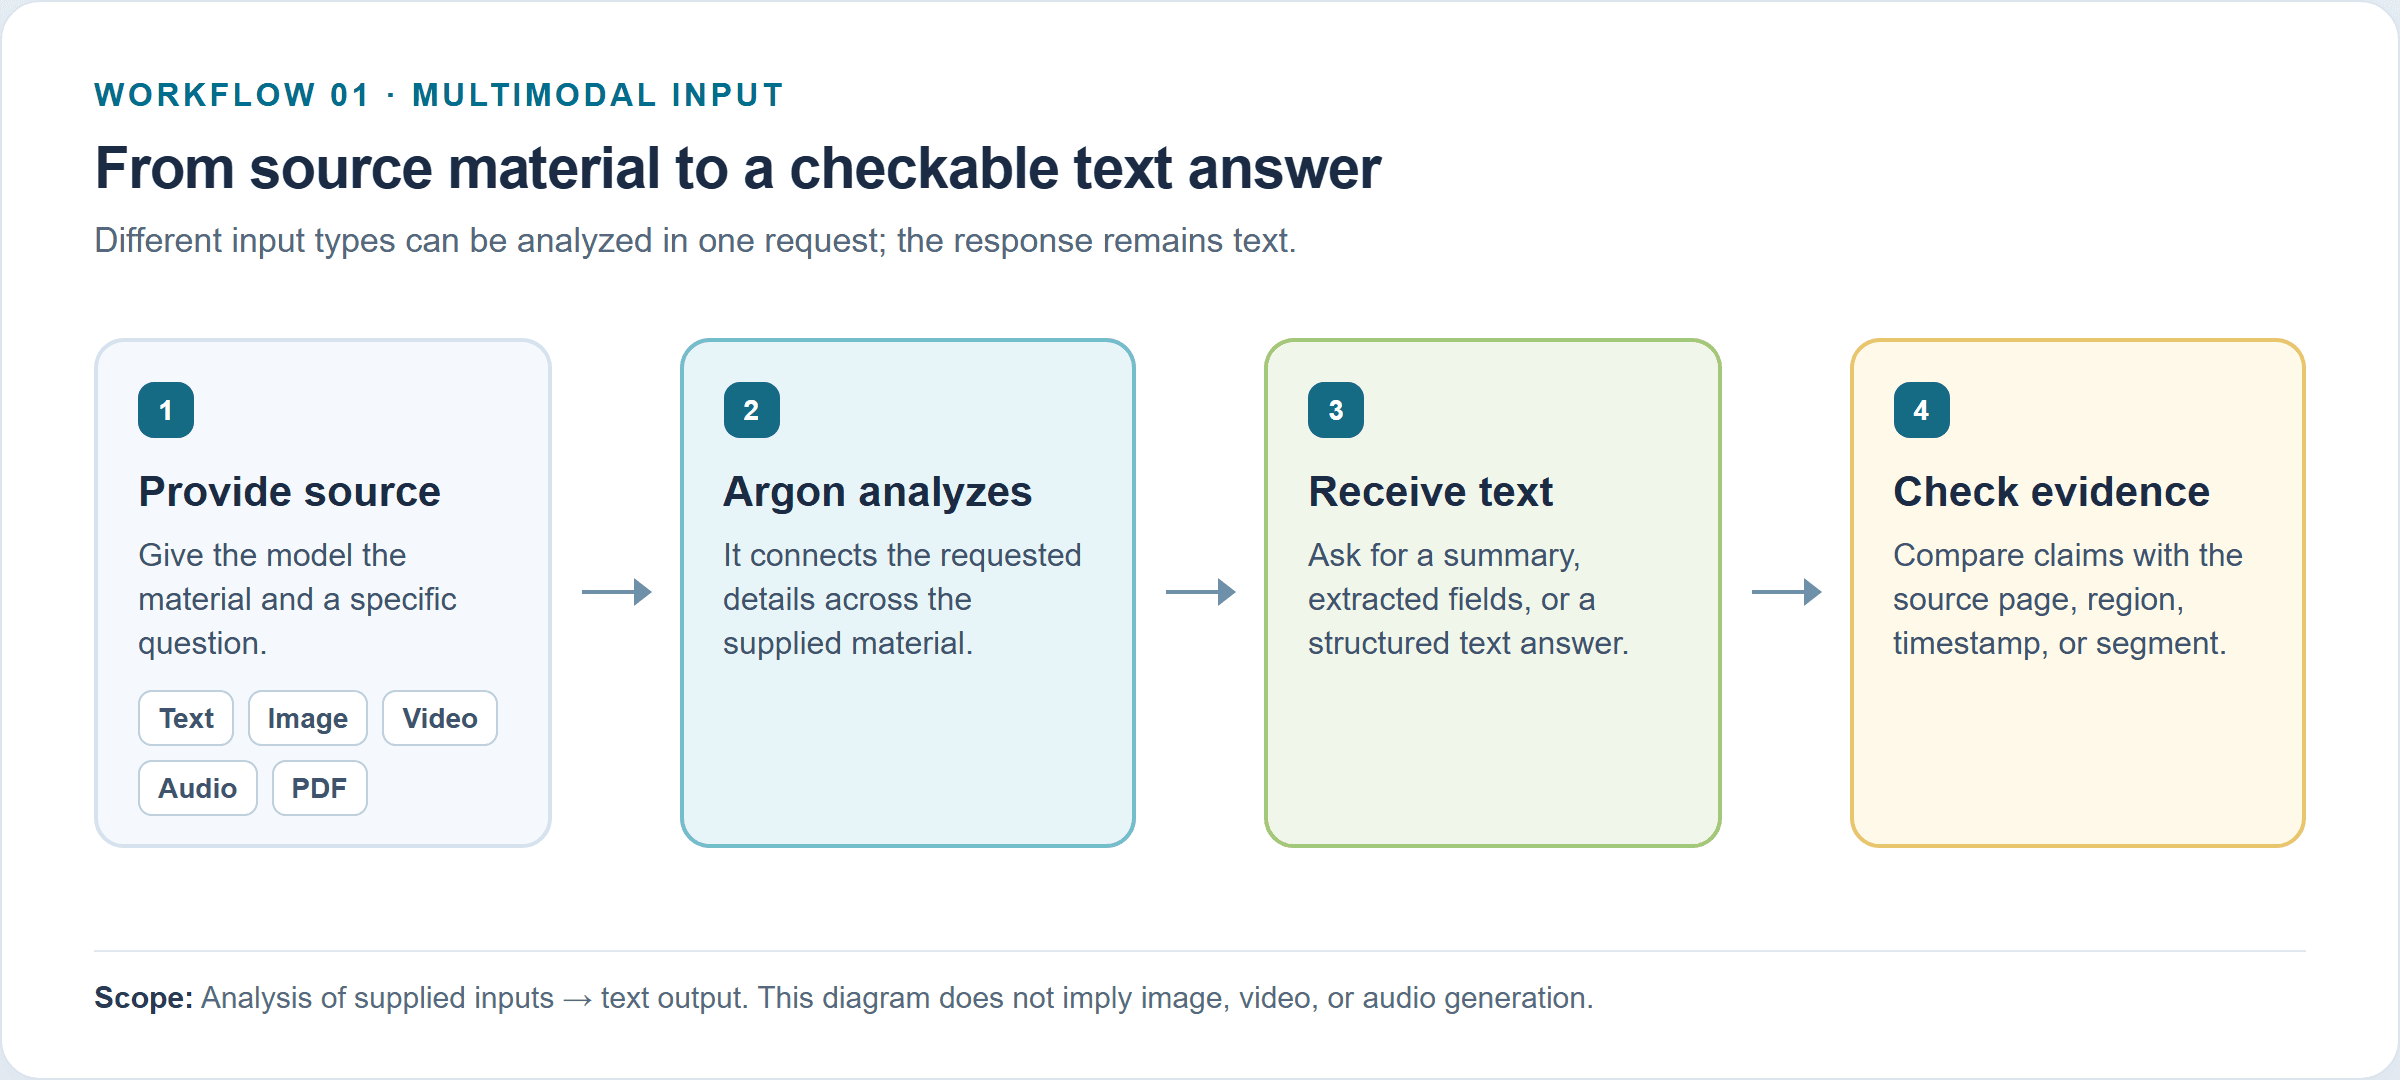 ワークフロー図: 提供されたテキスト、画像、動画、音声、または PDF がテキスト回答に分析され、その後ソース証拠と照合されます。
Gemini アプリは、他のモデルやツールを通じてメディアを構成または作成する機能を提供する場合があります。それらのアプリレベルの機能が gemini-4-argon API モデル自体の機能であると想定しないでください。実装の判断には、製品ファミリーのラベルではなく、API 機能表と正確なモデル ID を使用してください。
Gemini 4 Argon が画像、動画、音声、PDF で分析できること
Argon が適しているかどうかを判断する最善の方法は、タスクに必要な証拠を具体的に挙げることです。「動画を理解する」は広すぎます。「オペレーターが部品をトレイに置くたびに、そのタイムスタンプを引用する」は検証可能です。
画像: 視覚情報を検査、比較、抽出する
画像リクエストでは、Argon にシーンの説明、提供された 2 つの画像の比較、表示テキストの抽出、グラフの解釈、または視覚的所見を構造化形式で返すことを依頼できます。これらは分析タスクです。出力はテキストまたは構造化テキストです。サポートチームが製品写真をトリアージしたり、研究者が図をスキャンしたり、オペレーターが画像セットからラベルを抽出したりするのに役立ちます。
独立したテストは有用な現実確認を提供しますが、それは自分の画像に対する予測ではなく、1 つのベンチマーク設定として扱う場合に限ります。Roboflow の 2026年10月の Vision Evals は、テストされたオブジェクト検出、OCR、視覚推論タスクにおいて Argon をトップモデルの 1 つとして報告しています。その OCR 評価は正確な文字起こしと関連サブタスクを分けており、記事では小さなテキストやぼやけたテキスト、より難しい視覚的読み取りなどの弱点を報告しています。その設定、選択された画像、プロンプト、スコアリングがそれらの結果を定義しており、すべてのスキャンやグラフに対する一般的な成功率を確立するものではありません。(Roboflow、2026年10月)
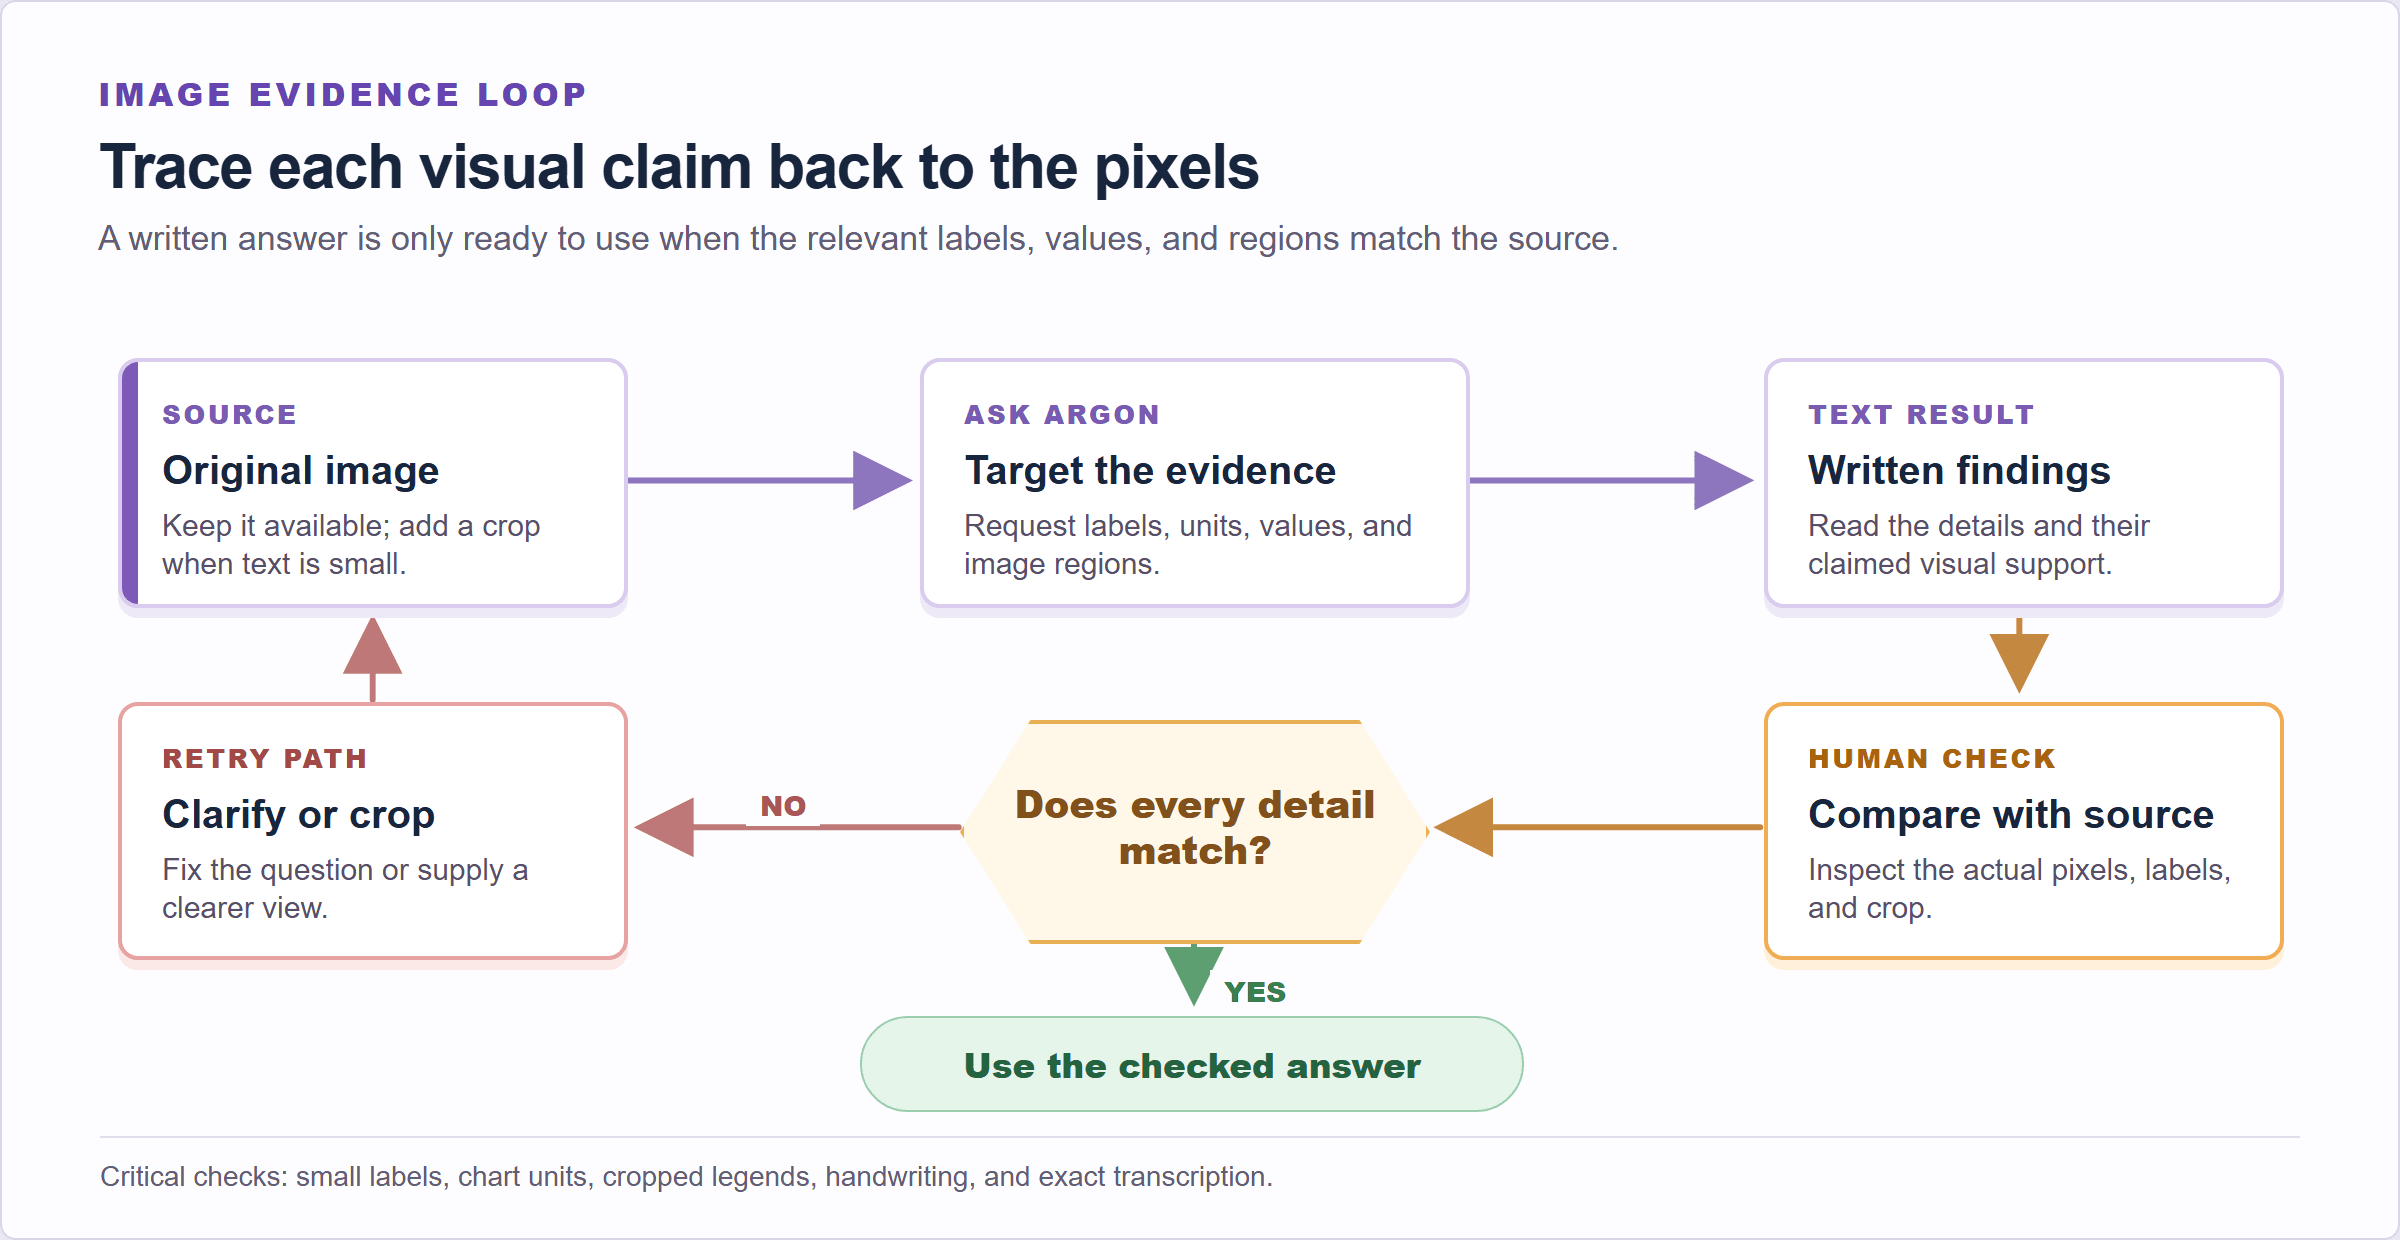 ワークフロー図: 画像の詳細とそれを裏付ける領域を求め、各主張を元の画像と照合して検証します。
グラフの場合、タイトル、軸、単位、関連する値、および各値を裏付ける画像領域を求めます。次に、それらの詳細をソースと比較します。小さなラベル、低解像度のスクリーンショット、手書き、重なり合うマーク、切り抜かれた凡例は手動レビューに値します。正確な文字起こしが重要な場合は、明確な切り抜きを含め、レビュー担当者がすべての文字を確認できるように元の画像を保存します。
動画: 時間経過に伴うイベントについて推論する
動画は順序と時間を追加します。Argon は、フレーム間のアクション、変化、イベントに関する質問に答えることができます。API は、タイムラインを動的に検査できるオプションであるエージェント型動画理解をサポートしています。文書化されたデフォルトモードは静的です。統合が実際に使用するモードについては、動画ガイドとリクエスト設定を確認してください。
有用な実務上の質問は、「技術者はいつフィルターを取り外しますか、またその直前と直後に何が起こりますか」というものです。タイムスタンプを要求し、それらの瞬間を検査します。時間に整合した証拠のない流暢な説明は、インシデントレビュー、品質チェック、トレーニングデータには十分ではありません。
Google のロボティクスチームは、2 本腕ロボットが紙を折って折り鶴を作る 136 秒間の頭上記録を分析する Argon ワークフローについて説明しています。システムは、全体タスクからサブタスク、接触レベルのアクションまで、時間に整合した注釈の階層を生成し、再試行に関する品質管理ラベルを付けます。これは、動画分析の出力が映像に結び付いたラベルと構造であることの具体的な例です。この記事は研究例であり、一般的な API 呼び出しがロボティクスパイプラインを再現することを保証するものではありません。(Google Developers Blog、2026年10月)
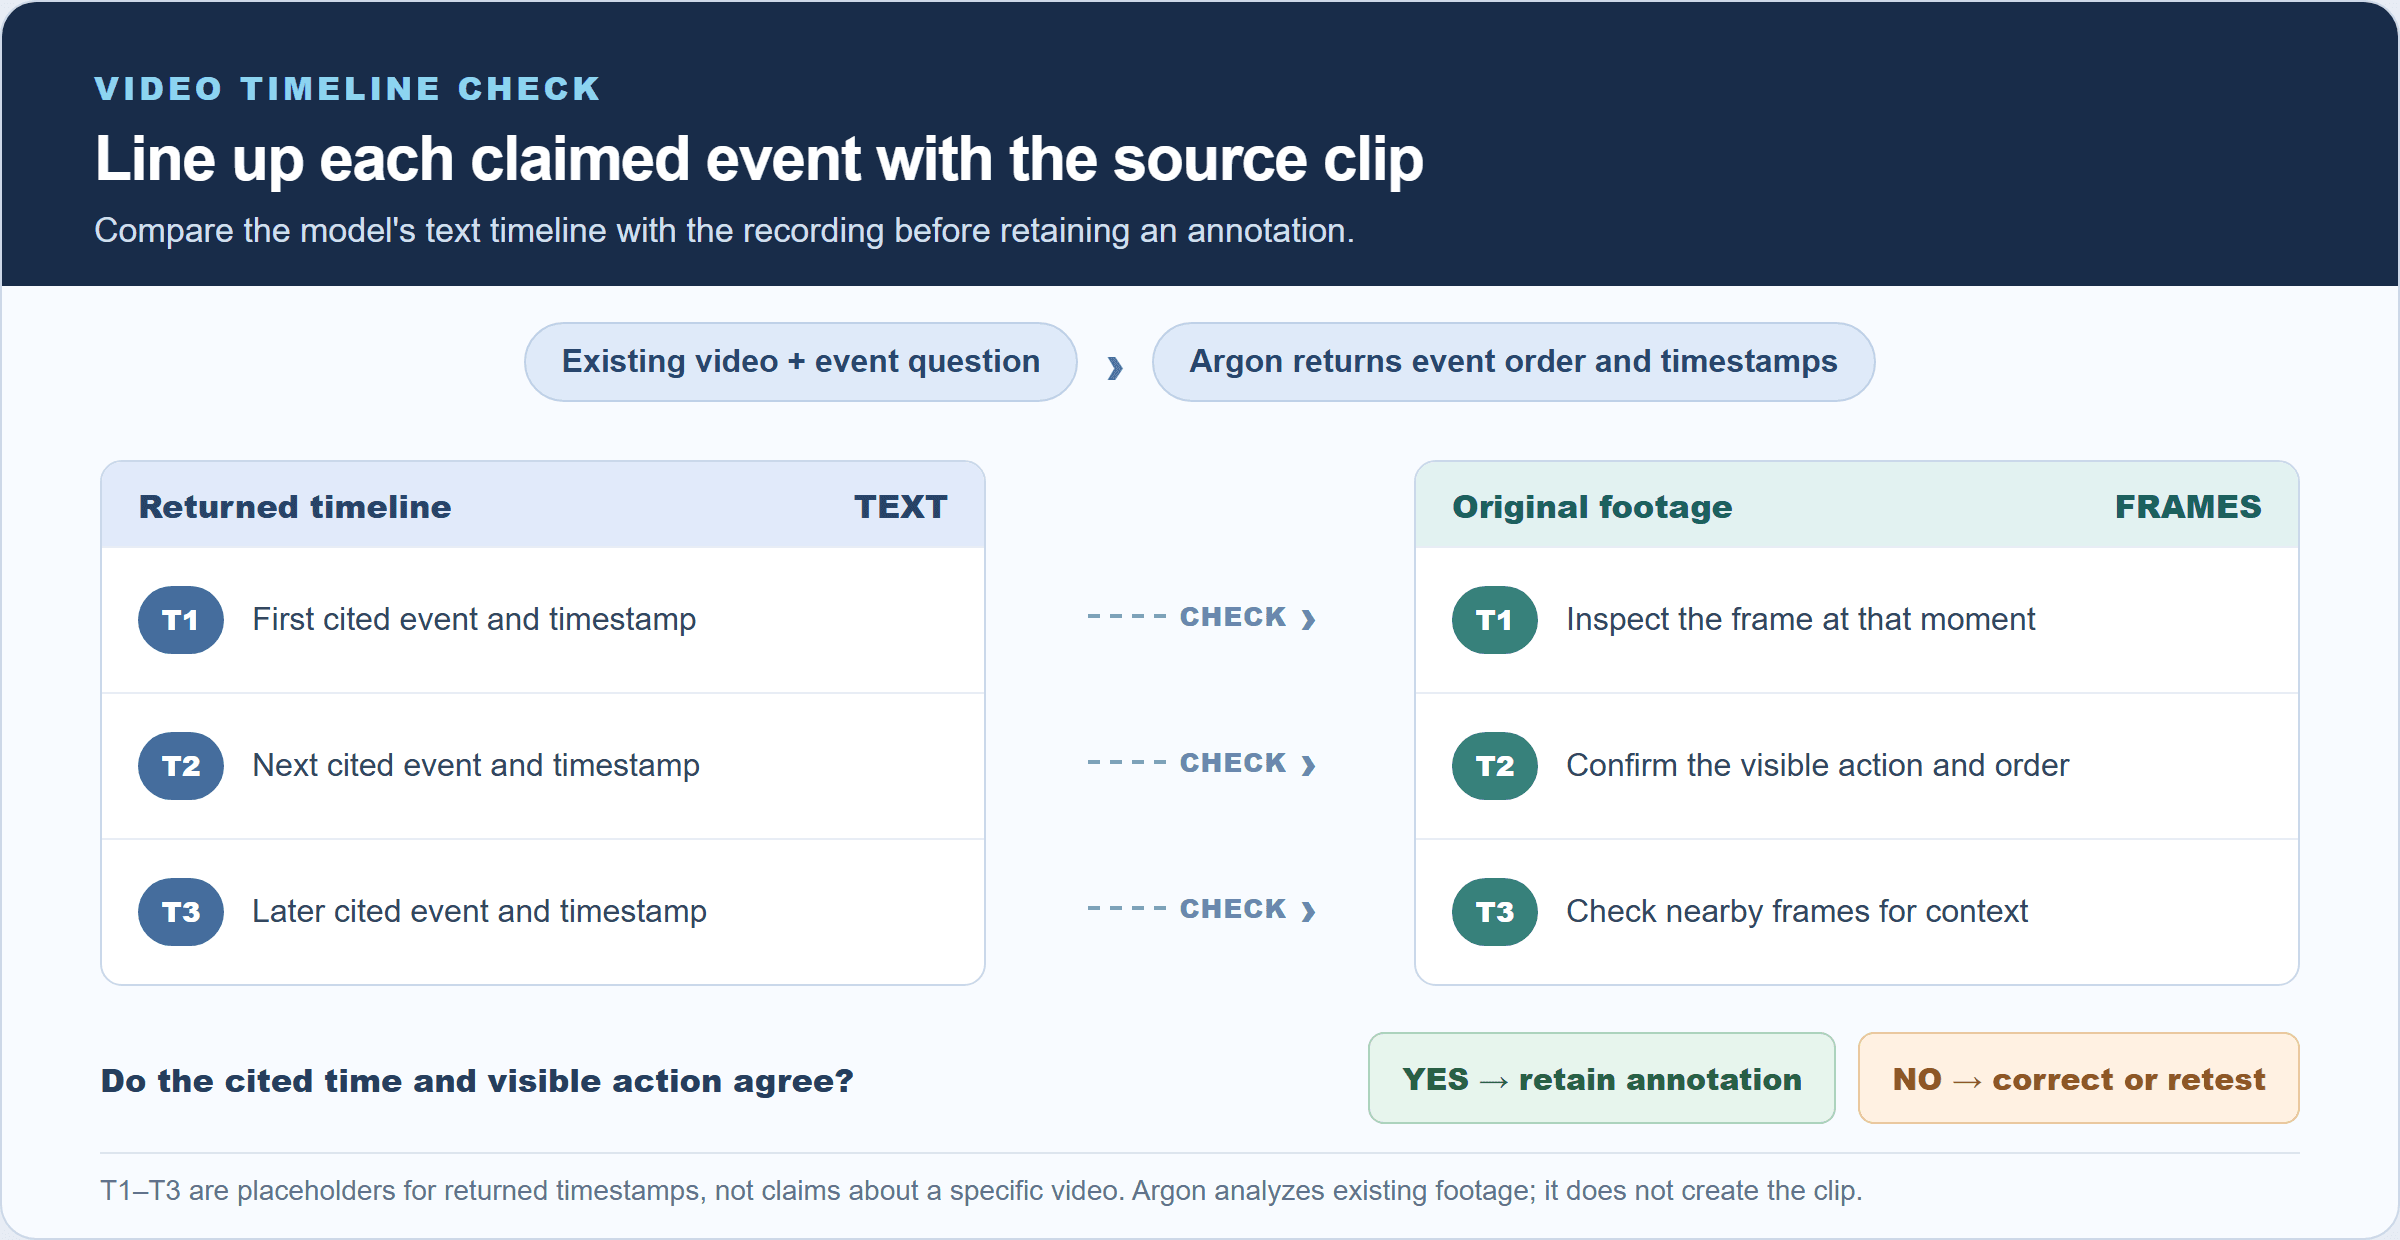 ワークフロー図: イベントの順序とタイムスタンプを求め、引用された各瞬間を元の記録と照合して検証します。
カメラが動く、手がオブジェクトを隠す、または 2 つのアクションが近接して発生する場合、動きは誤読されやすくなります。返されたタイムスタンプを元の映像と照合してサンプリングします。答えが安全性や合否判断に影響する場合は、人または専用のビジョンシステムに重要なフレームを検証させます。
音声: 提供された録音を分析する
音声入力では、何が言われたか、どの音が最初に発生したか、特定のフレーズが現れるかなど、録音に基づく質問ができます。統合を設計する前に、現在の音声入力ドキュメントで、サポートされている形式、再生時間とサンプリングの制約、正確なリクエスト形状を確認してください。「音声入力がサポートされています」だけでは、すべての文字起こし動作を指定したり、添付ファイルが実際にクライアントを通過したことを保証したりするものではありません。
処理する許可がある録音から、小さな既知の回答テストセットを構築します。クリーンな音声、重なり合う話者、背景ノイズ、無音、および本番環境で発生する場合は非音声サウンドを含めます。インターフェースがサポートしている場合は、タイムスタンプまたは短い証拠引用を求めます。添付ファイルがモデルに到達したことを確認し、結果を録音と比較します。これにより、ファイル部分の欠落やサポートされていないエンコーディングなどのモデルエラーと統合エラーの両方を捕捉できます。
PDF と混在ドキュメント: ソース間で詳細を結び付ける
PDF サポートは、質問が散文、表、図を横断する場合に価値があります。レビュー担当者は、レポートのエグゼクティブサマリーが文書内の後半の表と一致するかどうかを尋ねたり、主張とそれを裏付ける図を抽出したりできます。比較のために複数のドキュメントを提供できますが、リクエストのトークンとファイルの制限に従います。
各主張とともにソースの場所を求めます。ページ参照は有用ですが、PDF のページ番号は印刷されたページラベルと異なる場合があるため検証してください。表の場合は、値だけでなく行ラベルと列見出しも要求します。図の場合は、モデルが使用した視覚要素を挙げるよう求めます。PDF がスキャン、回転、かすれ、または密に組版されている場合は、すべてのページが等しく解析されたと想定するのではなく、代表的なページをテストします。
コンパクトな出力スキーマはレビューを容易にします。主張、ソースの場所、裏付ける抜粋または視覚的詳細、および信頼度または「見つかりません」。構造化出力は形状を強制できますが、有効な JSON オブジェクトでも誤った読み取りを含む可能性があります。形式検証と事実検証は別々のチェックです。
Gemini 4 Argon のマルチモーダル理解をテストする方法
モデルを大規模なバッチに接続する前に、短い評価を使用します。人間が正しい答えを確立できるソースを選択し、何が正しい結果と見なされるかを定義します。重要なのは、ファイル選択からモデル応答までの全経路をテストすることであり、単に答えがもっともらしく聞こえるかどうかを確認することではありません。
- グラフ付きの公開レポート、または明確に識別できるイベントを含む短い動画を 1 つ選択します。人間が確認した回答キーを保持します。
- モデルに添付資料のみを使用するよう指示し、各主張に場所を付加させます。
- すべての主張をソースと比較します。省略、誤読、サポートされていない推論、証拠に解決しない場所を記録します。
- 実際のファイルに似た複数の例(難しいケースを含む)で繰り返します。
- エラーのコストに基づいて合格しきい値を設定します。不確実または影響の大きい結果は人間のレビューに回します。
このプロンプトを適応できます。
添付資料のみを分析してください。以下の質問に表で答えてください。すべての主張について、それを裏付けるページ番号、タイムスタンプ、または目に見える証拠を引用してください。資料に答えが含まれていない場合は、「見つかりません」と述べてください。欠落している事実を推論しないでください。
画像の場合は、「ページ番号、タイムスタンプ」を「画像領域と表示ラベル」に置き換えます。PDF の場合は、ページと表またはセクション名を求めます。音声の場合は、タイムスタンプと回答を裏付ける言葉または音を要求します。これらの小さな変更により、出力が監査しやすくなります。
1 つの全体的な精度数値を使用するのではなく、タイプ別にエラーを追跡します。グラフの誤った数字、見逃されたイベント、誤ったページへの引用は、異なる結果をもたらします。この評価フレームは、印象的な機能リストを、モデルが自分のファイルに対して信頼できるかどうかに関する再現可能な判断に変換します。
Gemini 4 Argon の制限: マルチモーダルサポートが意味しないこと
入力サポートは、対応する出力サポートを意味しません。API は現在、画像生成、音声生成、Live API を Argon ではサポートされていないものとして記載しています。新しい画像、サウンドトラック、またはリアルタイム音声インタラクションを作成することがタスクの場合は、その出力を明示的に記載しているモデルまたはツールを選択してください。Argon を使用して、プロンプト、ソース資料、または生成結果を分析することは依然として可能です。
100万トークンのウィンドウも完全な想起を保証しません。それはリクエストと応答で共有され、長い入力はレイテンシとコストを増加させる可能性があります。モデルは詳細を見落としたり、存在しない情報を推論したり、確信があるように聞こえながら誤ったタイムスタンプを返したりする可能性があります。long decode は追加要件を伴う API 実行パスであり、すべてのクライアントのデフォルト動作ではありません。
ベンチマークは方向性のある証拠です。Roboflow は特定のタスクデータセットと評価設定からの結果を報告し、Google のモデルカードはより広範な内部および公開評価を要約しています。どちらも、カメラ品質、ドキュメントレイアウト、語彙、言語、エラー許容度を使用したテストの代わりにはなりません。1 つのカテゴリの高スコアは、異なるタスクでの信頼できるパフォーマンスを証明できません。
答えが財務、法務、安全性、医療、または雇用の決定に影響する場合は、レビュー担当者を使用します。元の入力と返された証拠を一緒に保持し、人が結論を監査できるようにします。反復的なワークフローでは、モデルバージョン、プロンプト、関連設定、ソース識別子、レビュー結果をログに記録します。その記録は、モデルの変更とファイルまたは統合の問題を区別するのに役立ちます。
| タスク | 良い最初のテスト | 注意深くレビューする |
|---|---|---|
| グラフの読み取り | 軸単位付きのラベル付き値を求める | 小さなフォント、密度の高い凡例、おおよその視覚的読み取り |
| OCR | 既知の文字起こしを含むクリーンな切り抜きを使用する | ぼかし、手書き、回転、混在スクリプト |
| 動画イベント | 順番にタイムスタンプ付きアクションを求める | 遮蔽、急激なカット、推論された原因 |
| 音声 Q&A | 短い録音について既知の質問をする | ノイズ、複数の話者、添付ファイルの処理 |
| PDF 比較 | 主張、ページ、裏付ける箇所を求める | スキャンページ、ページ番号の不一致、ページ間推論 |
アクセス、料金、Atlas Cloud の位置づけ
公開 API モデル ID は gemini-4-argon です。Google は現在、Gemini API と AI Studio をアクセス経路として記載しています。Google の現在の通知では、2026年11月30日まで、100万入力トークンあたり $2、100万出力トークンあたり $10 の導入料金が記載されており、その後はそれぞれ $4 と $20 になります。キャッシュされた入力には別の条件があるため、通常の入力として見積もらないでください。(Google、2026年10月)
この記事の確認時点で、Atlas Cloud の現在の All Models リスト には Gemini 4 Argon が表示されていませんでした。つまり、ここで引用できる検証済みの Atlas Argon モデルページや Atlas 価格はありません。一般的なプラットフォームのリストを可用性の証明として扱わないでください。チームがプロバイダーを比較している場合や、より広範なモデルワークフローを構築している場合、Atlas Cloud は他のリストされたモデルを閲覧する場所になり得ますが、プロバイダーを計画する前に正確なモデルページとサポートされている操作を確認してください。
ソース確認は推奨事項にも影響します。今日 Argon をテストするには Google の公式ルートを使用し、Atlas Cloud は実際にリストされているモデルの別の探索オプションとして扱ってください。ここで Argon が Atlas Cloud でホストされているという主張はありません。
Gemini 4 Argon はあなたのタスクに適していますか?
混合資料を横断して推論する、視覚的詳細を抽出する、動画を通じてイベントを追跡する、または長いレポートをレビューする仕事では、Argon を候補リストに入れてください。その大きな共有コンテキストとテキスト出力は、証拠を表または構造化結果に統合するのに役立ちます。次のステップは、独自の代表的な入力を使用した、人間が確認できる小規模な評価です。
必要な成果物が生成画像、生成音声、またはライブ音声/ビデオ会話である場合は、別のモデルまたはツールを選択してください。OCR または運用上の決定では、正確さ、速度、または予測可能なコストが広範な推論よりも重要である場合、その出力を専用の代替手段と比較してください。
評価がタスク固有のしきい値を通過した場合は、量を増やす前にログ記録と人間のレビューを行ってパイロットします。失敗した場合は、エラーを分類し、より明確な入力、変更されたプロンプト、別のモデル、または別の OCR/文字起こしシステムのどれが適切な修正であるかを判断します。有用な問いは、Gemini 4 Argon のマルチモーダル機能がエラー許容範囲を満たすかどうかです。
よくある質問
Gemini 4 Argon は動画と音声を分析できますか?
はい。その API は動画と音声の両方をサポート対象の入力として記載しています。動画理解は説明またはタイムスタンプ付き分析を返すことができ、音声は音声に基づく質問のために提供できます。現在のファイル形式とリクエストのドキュメントを確認し、応答を元のメディアと照合して検証してください。
Gemini 4 Argon は画像や音声を生成しますか?
いいえ。現在の API 機能表では、画像生成と音声生成はこのモデルではサポートされていないとされています。文書化された出力モダリティはテキストであり、入力に画像、音声、または動画が含まれている場合でも同様です。
Gemini 4 Argon の 1M トークンコンテキストウィンドウとは何を意味しますか?
1,048,576 トークンの制限は入力と出力で共有されます。デフォルトの同期出力は 65,536 トークンに制限されています。Google は、より大きな出力のために、共有制限まで、バックグラウンド実行と継続ステップを伴う別の long-decode フローを文書化しています。
Gemini 4 Argon API へのアクセスにはいくらかかりますか?
2026年10月16日時点で、Google は 2026年11月30日まで、100万入力トークンあたり $2、100万出力トークンあたり $10 を記載しています。その後に記載されている料金は $4 と $20 です。プロジェクトを見積もる前に、最新の料金とキャッシュトークンの条件を確認してください。


