2人のシーンが説得力を持つのは、各行を誰が話しているのかを目と耳で確認できるときです。Gemini Omni 1.2 Flash のマルチスピーカー対話をわかりやすくするには、各キャラクターに固定の視覚的・声のアイデンティティを与え、発話順に短いセリフを書き、完成した動画を目と耳でレビューします。Google の 2026年11月のアップデートは、より自然なマルチスピーカー音声と最大15秒のクリップをサポートしますが、プロンプトによって初回レンダリングでクリーンな話者割り当てが保証されるわけではありません。まずはシンプルな2人のやり取りから始め、基本的なハンドオフを判断できるようになってから、3番目のターンや街の環境音を追加してください。
主なポイント
- Gemini Omni 1.2 Flash は、対話を含むネイティブサウンド付きの動画を生成します。これは音声のみの Gemini テキスト読み上げモデルとは異なります。
- 名前付きの話者、正確に引用したセリフ、明確な位置、各ターンでの無言の聞き手を使用します。
- 最大15秒以内にポーズの余白を残し、クリップに対してすべてのセリフを確認します。
- レンダリングの価格は、選択した尺と解像度に基づいて計算し、プラットフォームの最低広告料金では判断しないでください。
Gemini Omni 1.2 Flash におけるマルチスピーカー対話とは?
このモデルは、生成された音声と動画の一部として人が話す短いシーンを作成します。実用的なテストは、視聴者がトランスクリプトを読まなくても、各行を誰が言っているのかを判別できるかどうかです。言葉、声、目に見える人物、口の動きが同時に一致している必要があります。音をミュートにすると説得力があるように見えても、このテストに失敗するクリップがあります。
Google は 2026年11月5日に Gemini Omni 1.2 Flash を発表し、最大15秒の生成または編集された動画を提供すると述べています。より流暢な対話、より明確なリップシンク、明確なマルチスピーカー条件付けを説明しています。これらは能力の主張であり、すべてのスクリプトが書かれたとおりに配信されることを約束するものではありません(Google の 2026年11月の発表)。
Google が公開したデモンストレーションは、発表された能力を示しています。これは以下に示す3つの提供ビデオケースとは別のものです。
Gemini Omni 1.1 Flash からの変更点は?
公式の比較では、1.2 の上限が長くなり、10秒ではなく15秒になっています。また、音声、リップシンク、参照追従、会話編集の改善も挙げています。追加の5秒は、3ターンのやり取りをスクリプト化するのに現実的にしますが、ディレクターがポーズ、身体的反応、シーン変更も要求する場合、長い尺が発話時間を増やすわけではありません。
最も安全な解釈は方向性です。より良い条件付けは対話を演出しやすくするかもしれませんが、配信された各クリップは依然として検査が必要です。クリエイターは15秒の制限をスクリプトの目標設定に使用できます。正確な法的コピーや正確な声の一致を約束するプロデューサーは、レビューに合格するまで生成出力をドラフトとして扱うべきです。
ビデオ対話 vs マルチスピーカーテキスト読み上げ
Gemini のテキスト読み上げモデルはテキストを受け取り、音声を返します。その話者設定と音声の選択はその音声ワークフローに属し、Google は別途ドキュメント化しています(Google の Gemini テキスト読み上げドキュメント、2026年11月アクセス)。Gemini Omni 1.2 Flash のテキスト-to-ビデオルートはシーンプロンプトを受け取り、ネイティブサウンド付きの動画を生成します。テキスト読み上げの speech_config の例は、Gemini Omni 1.2 Flash のビデオ制御ではありません。これらの例はテキストで声のキャラクターを記述するものであり、録音された声をアップロード、クローン、選択することを主張するものではありません。ブリーフが特定の俳優の声を要求する場合、ショットを計画する前にそのアクセスと同意を別途確認してください。
成果物がポッドキャストの会話やロックされたボイスオーバーである場合は、テキスト読み上げを使用し、その音声に合わせて映像を編集します。生成されたシーンで2人が目に見えて話している場合は、Gemini Omni 1.2 Flash ビデオを使用し、実際の出力で整合性をテストします。
どこで実行でき、クリップのコストはいくらか?
テキスト-to-ビデオルートを選択する
Google は Gemini Omni 1.2 Flash をクリエイティブ製品と開発者製品にリストしています。再現可能なテストには、1つのルートを使用します:Atlas Cloud がモデルを提供しており、その Gemini Omni 1.2 Flash Text-to-Video playground に以下のプロンプトを貼り付けます。ルート ID は google/gemini-omni-1.2-flash/text-to-video です。以下のプロンプトはテキストのみを使用し、画像、モーション、音声参照は使用しません。
プロンプトは、オフィス用に16:9で12秒、カフェ用に16:9で15秒、ストリートインタビュー用に16:9で12秒を要求します。提供された3つのファイルは720pです。実行を押す前に、ライブコントロールと選択された値を確認してください。製品ページに広告されている設定は、特定のテスト実行がそれを受け入れた証拠にはなりません。選択した値と見積もりを各出力と一緒に保存してください。これにより、すべてのレンダリングが有用な証拠になります。出力をレビューするときに、プロンプトを選択した解像度とルートと比較できます。このガイドはテキスト-to-ビデオルートを指定しているため、画像-to-ビデオまたは参照-to-ビデオルートからの結果は別途識別する必要があります。
提供されたビデオファイルには、完了したプレイグラウンドのキャプチャ、選択された設定、送信前の見積もりは含まれていません。したがって、それらのルートと構成は未検証のままです。
| ルート | このガイドの入力 | 最適な用途 | コストを確認する場所 |
|---|---|---|---|
| Google のクリエイティブ製品 | シーンプロンプト、コントロールは製品によって異なる | Google のエディターでの手動作成 | 現在のプランまたはクレジット画面 |
| Google API | 開発者向けビデオリクエスト | アプリケーション統合 | 正確な解像度に対する Google の価格 |
| Atlas Cloud テキスト-to-ビデオ | プロンプト、尺、アスペクト比、解像度 | これらのテキストのみのテストを1つのプレイグラウンドで繰り返す | 選択した構成の送信前見積もり |
レンダリング前に価格を確認する
Google は API を通じて720pで生成された1秒あたり $0.07 を提示しており、これは Gemini Omni 1.1 Flash より30%低いです。その提示レートでは、720pの12秒は他の課金作業を除いて $0.84 です。その計算は提供されたファイルに対する Atlas Cloud の見積もりではありません。それらのルートと請求は未検証です。Flow または別のエディターのクレジットは、その製品独自のルールに従います。
Atlas Cloud は モデルカタログ でより低い 開始 秒あたり料金をリストしていますが、最低額は別の解像度または構成に対応している可能性があります。尺と解像度を選択した後、ライブ見積もりを確認してください。360pのドラフトはプロンプトの探索に役立ちますが、それは後の1080pレンダリングのフレームごとのプレビューではなく、別の生成です。
2つの声を15秒のシーンに収める
各話者に視覚的・声のアイデンティティを与える
レビュアーが検証できる説明を書きます。「話者Aは左側で紺色のシャツを着ている」は「最初の同僚」よりも明確です。中音域対低音など、聞き分けられる違いを追加します。プロンプト全体で名前、服装、位置、声を一貫させます。これらのアンカーにより、入れ替わったセリフを見つけやすくなります。
視覚的アイデンティティは重要です。音声だけではレビュアーを欺く可能性があるからです。声が異なっても間違った口が動けば、そのクリップにはリップシンク問題があります。正しい口が動いても、Aの2回目のターンでAの声が変われば、声のドリフトがあります。カフェの例では、Bの後にAを戻すので、レビュアーはAの声が一貫しているかどうかを確認できます。
発話と反応の時間を計画する
意図したペースでスクリプトを声に出して読みます。各ハンドオフで自然なポーズを含め、聞き手が反応する時間と、オープニングショットで両方の顔を確立する時間を残します。改訂されたオフィスのスクリプトは12秒で5ターンです。カフェは15秒で8つの短いターンがあり、ここで最も厳しいタイミングテストになります。これらは例のスクリプトであり、普遍的な1秒あたりの単語数しきい値や出力に関する約束ではありません。
| シーン予算 | 発話シーケンス | 言葉以外に必要な時間 |
|---|---|---|
| 12秒オフィス | A-B-A-B-A | 両方の人物を確立し、4つのハンドオフを収める |
| 15秒カフェ | 8つの交互ターン | 余裕の少ない7つのハンドオフ |
| 12秒ストリート | A-B-A-B-A | 街の環境音の中で4つのハンドオフ |
長いセリフは、終わり近くで急いだり省略されたりする原因になります。ドラフトを声に出して読むのにほぼ15秒すべてかかる場合は、生成前に短くしてください。シナリオがより多くの対話を必要とする場合は、別々のショットを計画し、連続性を別の制作タスクとして検証します。最初の試みでは、発話中に顔が見えるようにします。急速なカットや口が隠れると、話者の割り当てを判断しにくくなります。セリフの順序が重要な場合は、2人で時間を計ったテーブルリードを行います。1人がAを話し、もう1人がBを話し、3人目が各文がどこで終わるかをメモします。最後の単語がクリップの限界に達する場合は、レンダリング前に節や反応のビートを削除します。短いスクリプトは、レビュアーがセリフがオフスクリーンで続くことを意図していたかどうかを推測することなく、やり取り全体を再生できるため、監査が容易です。
2人の話者に対して Gemini Omni 1.2 Flash をプロンプトする方法
有用なプロンプトは、簡潔な撮影ブリーフのように読めます。設定とカメラ、アイデンティティ、正確な対話、次に音と除外ルールです。この順序はレビュアーにチェックリストも与えます。これはプロンプト方法であり、文書化された制御の保証ではありません。アイデンティティの段落から対話ブロックまで、キャラクターラベルを同一に保ちます。後のターンに関する指示で、同じ人物をAと「顧客」の両方として言及することは避けてください。ただし、マッピングがすでに明示されている場合を除きます。読者は2つの列を描き、それぞれに1人を割り当て、要求されたすべてのアクションと発話行を正確に1つの列に配置できる必要があります。
明示的な話者ラベルと引用されたセリフを使用する
各ターンに1行を使用し、Speaker A: または Speaker B: と引用符付きの言葉を書きます。誰が沈黙しているかを指定します。「ローンチ準備に関する議論」を求めることは即興を許します。正確なスクリプトにより、欠落または書き換えられた単語をすぐにマークできます。
以下はコピーする最初のプロンプトです。これは両方の大人を1つの連続ショットに保ち、視聴者がそれぞれの口を検査できるようにします。
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
提供された12秒、720pのオフィスレンダリング。両方の人物が表示されたままです。5つの発話行とリップシンクには、依然として聴取レビューが必要です。
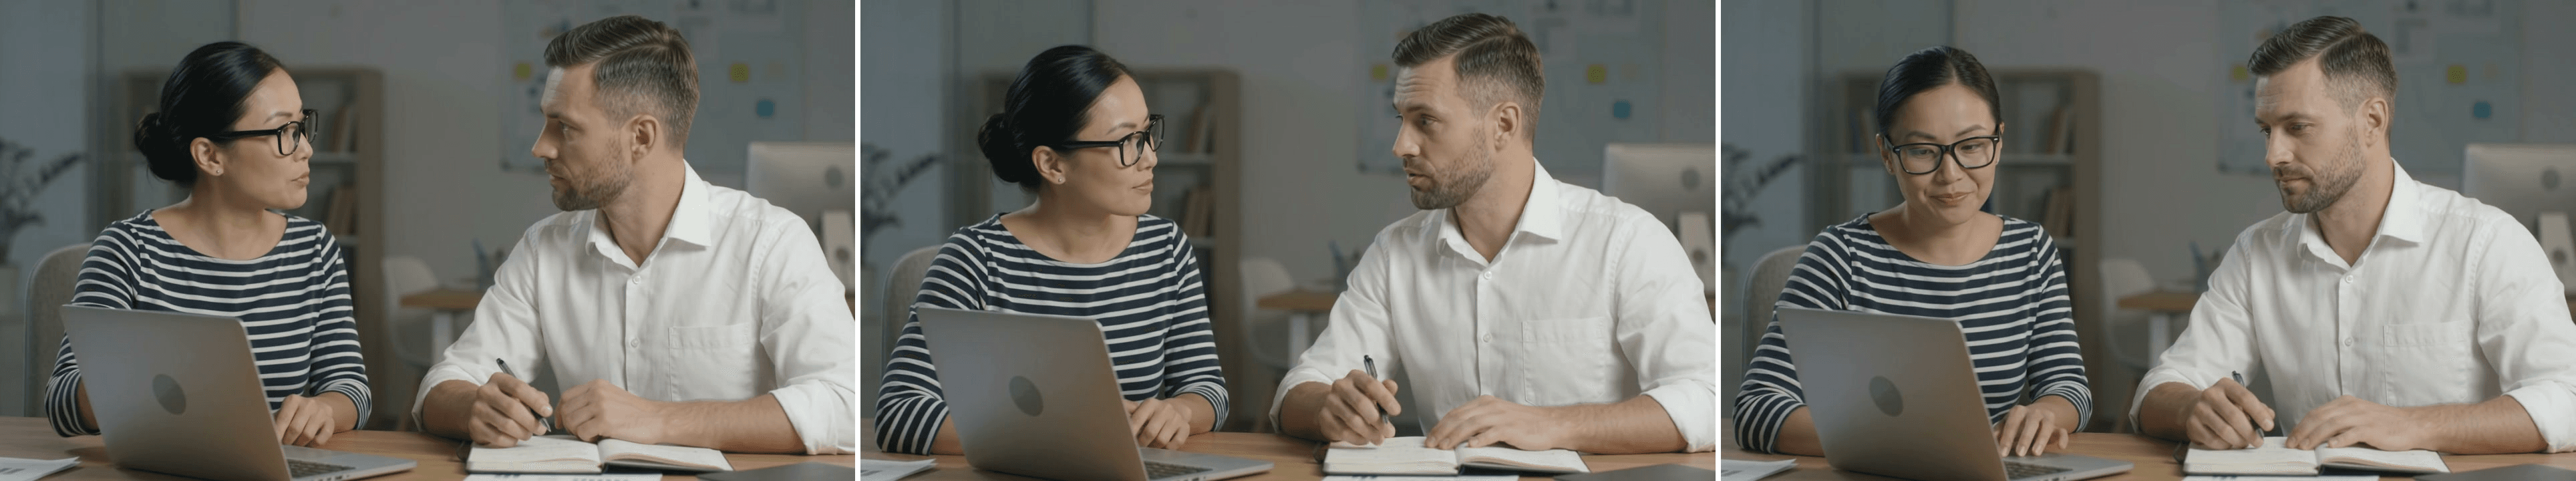 ケースAのフレーム、左から右(約0:02、0:05、0:10):女性が同僚の方を向いています。彼は両方がフレーム内に留まっている間に返答しているように見えます。彼らはラップトップとノートに注意を戻します。
話者を見失わずにカメラを制御する
連続したミディアム2ショットは診断的な選択です。両方の顔が視界に残るため、見逃されたハンドオフが編集の背後に隠れることはできません。モデルは依然としてフレーミングを変える可能性があるため、最終ファイルの検査が必要です。
ハンドオフが目的に合うようになったら、両方の顔を保持する控えめな動きを試してください。ストリートプロンプトは、両方の顔を見えるように保つ16:9フレームでの動きを要求し、口の動きを判断しやすくします。それが最初にオフィスのベースラインを確立する理由です。
バックグラウンドオーディオを対話より下に保つ
環境音とその優先度を指定します。静かなルームトーンは、オフィスのクリップがスピーチと競合するものをほとんど与えません。柔らかいカフェの音はコンテキストを追加しながら、セリフをテスト可能に保ちます。ストリートプロンプトは、歩行者の話し声なしで、両方の声より下に足音と遠くの音を要求します。
ネガティブ指示は不要な音声を減らすかもしれませんが、それらは依然としてリクエストです。第三の声、ナレーション、音楽、ブランドオーディオに注意してください。画像にキャプションやロゴがないかも確認してください。
誰がいつ話すかを示す3つの対話シーン
提供された3つのビデオファイルは、意図されたオフィス、カフェ、ストリートのシーンを示しています。それらの視覚的コンテンツはここで検査できますが、ファイルはどのルートまたは設定がそれらを生成したかを確立しません。以下のプロンプトは再現可能なリクエストであり、出力がすべての単語を正しく話したという主張ではありません。オフィスは5ターンをチェックし、カフェは8つの急速なターンをテストし、ストリートは環境音を追加します。
| ケース | プロンプトリクエスト | 提供ファイル | 主なチェック |
|---|---|---|---|
| A: オフィスハンドオフ | 12秒、16:9、5ターン | 12秒、16:9、720p | 5行、正しい口 |
| B: カフェ交換 | 15秒、16:9、8ターン | 15秒、16:9、720p | 8行、安定した声 |
| C: ストリートインタビュー | 12秒、16:9、5ターン | 12秒、16:9、720p | 街の可聴性と話者ターン |
5ターンのオフィスハンドオフ
上記の完全なプロンプトとビデオを使用します。両方の同僚は同じショットに留まるため、要求された5つのターンのそれぞれにチェックする目に見える人物がいます。聞こえる各行をテキストと照合して記録し、アクティブな口を検査します。提供されたファイルはシーンと尺を確立しますが、その言葉とリップシンクは独立して検証されていません。
1つのクリップでの明確なハンドオフは、そのクリップだけに関する結論を支持するものであり、モデル全体の成功率ではありません。最初の結果を保存して、改訂を元の結果と比較できるようにします。
8ターンのカフェ交換
16:9で15秒を要求します。8つの短いターンは、繰り返される声の所有権とタイミングに負荷をかけます。各人の最初と最後の行を比較し、いずれかの行が重なったり消えたりしていないかを確認します。提供されたファイルは720pです。
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
屋外Q&A
16:9で12秒を要求します。これにより、穏やかなカメラの動きと環境音が追加されます。提供されたファイルは720pの16:9で、5つの話者ターンと街の可聴性についてレビューできます。
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
結合再生:0:00–0:15 はケースB、カフェ交換です。0:15–0:27 はケースC、ストリートインタビューです。両方のソースクリップが完全に含まれています。
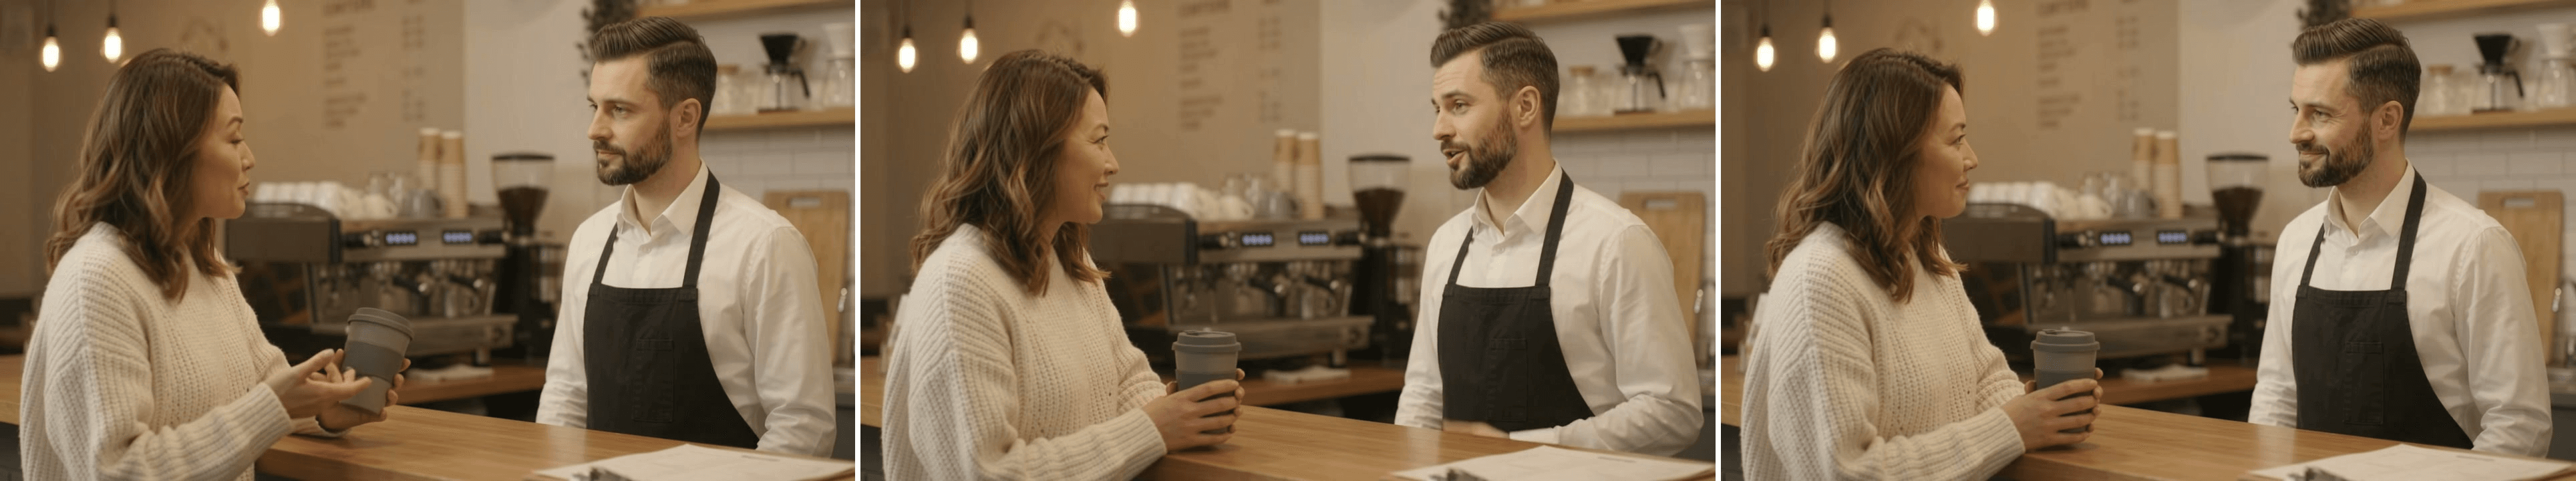 ケースBのフレーム、左から右(結合ビデオの約0:02、0:08、0:13):顧客がカップを見せています。カフェの従業員が答えているように見えます。最後に彼らは向かい合います。
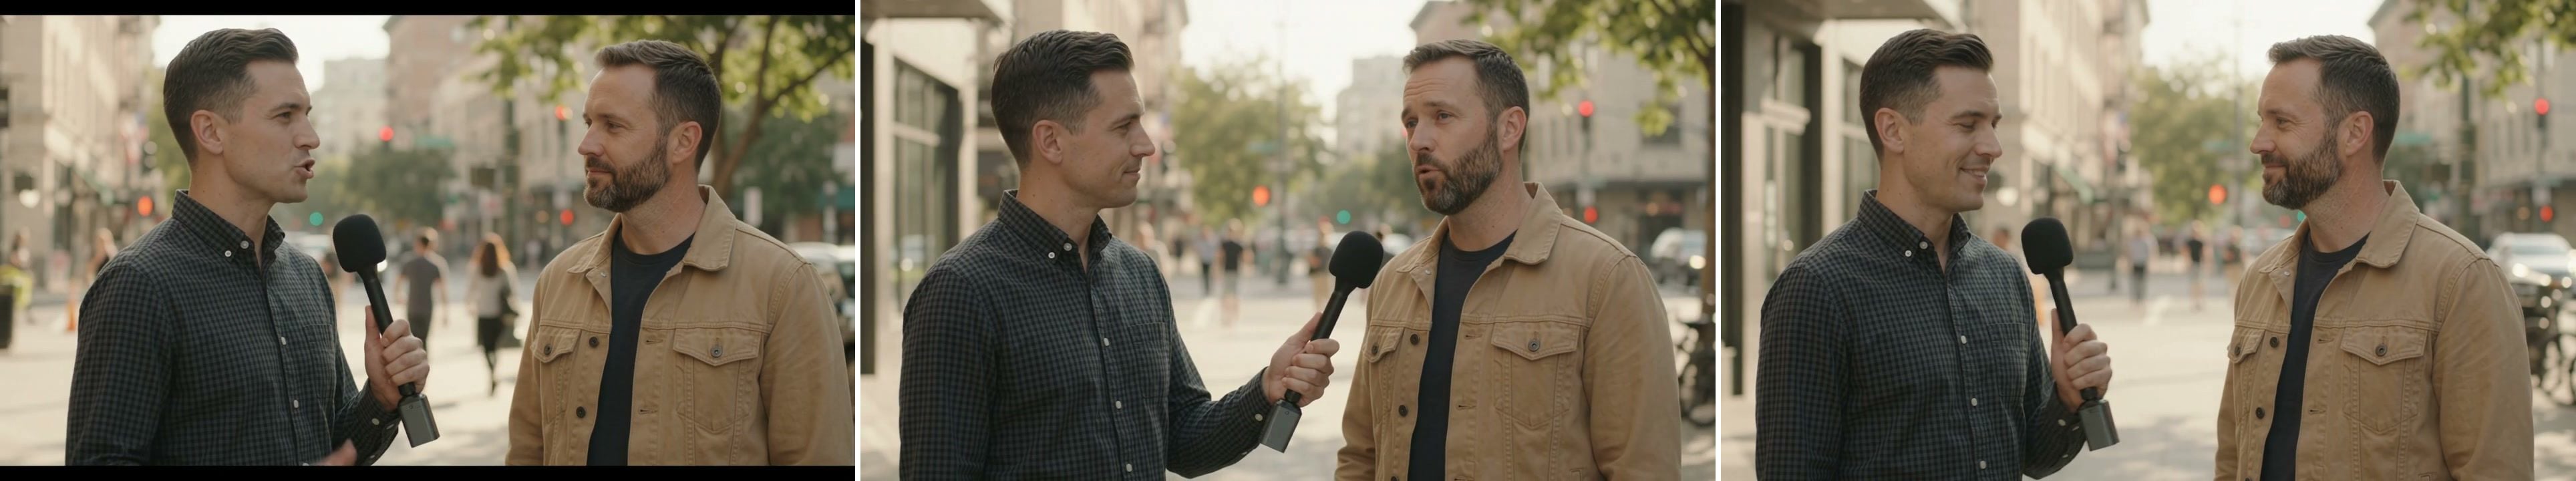
ケースCのフレーム、左から右(結合ビデオの約0:16、0:19、0:26):インタビュアーがマイクを持っています。彼はそれをインタビュイーの方に向けます。最後に両方が向かい合います。
公開前に話者の順序、リップシンク、声のドリフトを確認する
クリップを行ごとにレビューする
ビデオをダウンロードします。スクリプトを読まずに一度再生して、明らかな混乱を見つけ、次にプロンプトを横に置いて再生します。各ターンで一時停止し、聞こえたことを書き留めます。両方の口を検査し、スクリプト化されたターン外の発話に注意します。再現可能なレビューのために、聞こえる各行の開始時刻と終了時刻、期待される話者、聞こえた声、動いた目に見える口を記録します。顔が隠れているか、音が単語をマスクしている場合は「不明」と書きます。シーンの残りが説得力があるように見えるからといって、不明なセルを合格にしないでください。プロンプトを見ていない2人目のリスナーが、誰が話していると思うかを特定できます。公の視聴者がシーンを理解するかどうかを決める前に、その判断をスクリプトと比較します。
各行について4つのことを確認します:
- 言葉: 引用された言葉は、終わりが省略されたり文が追加されたりすることなく、順番に話されましたか?
- 声の持ち主: 名前を付けられた人物は、特にAが戻ったときに、話者として聞こえましたか?
- 目に見えるタイミング: 聞き手が沈黙している間に、その人物の口が動きましたか?
- その他のコンテンツ: クリップにナレーター、傍観者、キャプション、ロゴ、音楽が追加されましたか?
タイムスタンプ付きの品質保証タイムラインは、音声と口の動きが行ごとにレビューされるまで保留のままです。
一度に1つの制約を修正する
最後の行が消える場合は、スクリプトを短くするか、15秒の上限内でより長い尺を与えます。間違ったキャラクターが話す場合は、視覚的位置を繰り返し、聞き手が沈黙していることを指定します。環境音が単語を覆う場合は、それを下げるか削除します。カットがアクティブな口を隠す場合は、連続2ショットに戻します。再試行ごとに1つの要因を変更して、次の出力が明確な質問に答えるようにします。
これらの編集のいずれも修正を保証するものではありません。レンダリングに修正が必要な場合は、そのファイル、設定、対処したい問題を保存します。プロデューサーは、別のレンダリングがコストに見合うか、または録音された声と手動編集が必要な精度を与えるかを決定できます。短く、目に見えて話されるやり取りの場合、オフィスのプロンプトから始め、行ごとのチェックの後にのみクリップを受け入れます。これが Gemini Omni 1.2 Flash マルチスピーカー対話 の標準です。
よくある質問
Gemini Omni 1.2 Flash は、別々のクリップ間で同じ声を保つことができますか?
1つの生成されたクリップ内で声が認識可能であることは、別々の生成間でそれを保持するよりも狭い要件です。これらのテキストのみの例は最初のケースをテストします。それらからクリップ間の声のアイデンティティを約束しないでください。1人の定期的な話者を必要とするキャンペーンは、別の連続性テストを実行する必要があります。
Gemini Omni 1.2 Flash は英語以外の言語で対話を生成できますか?
モデルは他の言語を生成するかもしれませんが、これらのプロンプトは英語です。ターゲット言語を流暢なリスナーと一緒に単語ごとにレビューします。名前、数字、ローカライズされた主張を含みます。別のクリエイターの成功した言語テストは、そのテストの証拠であり、あなたのスクリプトの保証ではありません。
各行を正しい話者に割り当てるにはどうすればよいですか?
各人に視覚的位置と声を与え、すべての引用行にラベルを付け、もう一方の人のターン中に誰が沈黙しているかを指定します。生成されたビデオを行ごとにレビューします。レンダリングがブリーフを満たさない場合は、やり取りを短くするか、正確な配信のために制御されたオーディオワークフローを使用します。
15秒の Gemini Omni 1.2 Flash クリップにいくつの対話ターンが収まりますか?
カフェのプロンプトは15秒で8つの短いターンを要求し、オフィスとストリートのプロンプトは12秒で5つのターンを要求します。これらはスクリプトの例であり、保証された制限ではありません。セリフを声に出して読み、ポーズを考慮し、最後のターンがクリップの終わりに達する場合は短くします。
Gemini Omni 1.2 Flash は2話者対話に参照画像が必要ですか?
これらの3つのテキスト-to-ビデオプロンプトでは参照画像は使用されていません。それらは各話者の位置、服装、声をテキストで記述します。プロジェクトが特定の顔や視覚スタイルを必要とする場合は、参照を受け入れるルートをテストし、その出力を別途レビューします。


