白いカップ、コーヒーバー、コーヒー豆をアップロードしたのに、ビデオには別のカップが一般的な部屋に映っているとします。Gemini Omni 1.2 Flash multiple reference images をうまく使うには、Reference-to-Video を選択し、各画像に明確な役割を一つ与え、アップロード順にその役割を記述します。短いショットから始めて、始まり、中間、終わり、そしてそれらの間の動きを確認します。参照は生成を導くものであり、ピクセル単位の完全なコピーを保証するものではありません。
テストプロトコルでは、同じカップのショットを2回使用します。最初はカップ画像のみ、次にカップ、カフェ、豆を使用します。2番目の例では、パンテオンの外観と内部の写真を使用して、動く視点をテストします。比較により、プロンプトが求めているものと出力が実際に示しているものを分離するので、別の参照が役立ったか、競合を追加したかを判断できます。
主なポイント
- 画像がオープニングフレームを決定することなくコンテンツを導く場合は、Reference-to-Video を選択します。
- アップロードした各画像に役割を割り当て、プロンプト内でアップロード順に名前を付けます。
- 複雑さを増す前に、短い1画像のベースラインと3画像の実行を比較します。
- クリップ全体にわたって、アイデンティティ、設定、小道具、動きを確認します。最初のフレームだけでなく。
Gemini Omni 1.2 Flash で複数の参照画像が制御するもの
複数画像の参照セットは、1つのショットのいくつかの部分を記述できます。1枚の写真が製品を識別し、別の写真が場所を提供し、3枚目が小道具を識別する場合があります。キャラクターや視覚スタイルに画像を使用することもできます。これらの役割は、プロンプトがどの視覚的特徴がどの画像に属するかを示す場合にのみ役立ちます。「すべての画像を使用する」と、カフェの写真の2番目のカップが2番目の製品なのか背景の雑然としたものなのかをモデルに判断させることになります。
カップのテストでは、画像1が白い陶器のカップと取っ手を定義します。画像2がエスプレッソバーのカウンターと暖かい屋内の設定を提供します。画像3がカップの近くに見える豆を提供します。豆の写真の白い背景やカフェのカウンター上のすべてのオブジェクトをモデルに引き継がせることは求めません。この除外は重要です。参照写真には、実行してほしい役割よりも多くの視覚情報が含まれていることがよくあります。
参照セットはすべての曖昧さを排除できるわけではありません。手が取っ手を隠すかもしれません。カメラの動きにより、ソース写真には決して映らないカップの側面が明らかになるかもしれません。3枚のソース写真間で照明とカメラアングルが競合する可能性があります。プロンプトを優先順位の階層として扱い、カップの形状を背景の家具との完全一致よりも上位に置きます。2026年11月の発表で、GoogleはGemini Omni 1.2 Flashにおけるより強力な参照追従を説明しつつ、速い動きと複雑な物理は改善の余地がある分野であると述べています。
アップロードする前に、各ソースについて1文を書きます。「この画像はXを定義し、Yを無視します。」2つの画像に同じ役割を与えずにそれができない場合は、セットを簡素化します。次に、目標に合った入力モードを選択します。
Reference-to-Video か First-and-Last Frame か?
Reference-to-Video は、画像が新しい動くショットに影響を与えるべき場合に適したモードです。正確なオープニング画像が必要な場合は、代わりに first-frame または Image-to-Video ワークフローを使用します。2つの指定されたエンドポイントが必要な場合は、利用可能な場合は first-and-last-frame ワークフローを使用します。同じアップロードされた写真でも、選択したモードによってまったく異なる役割を果たすことができ、プロンプトの文が常にモードの入力契約を上書きできるわけではありません。
| モード | 入力が制御するもの | 予想されるオープニング | 最適な用途 |
|---|---|---|---|
| Reference-to-Video | 被写体、シーン、小道具、またはスタイルのキュー | 参照によって導かれる生成ビュー | カップ、カフェ、豆を1つのショットに組み合わせる |
| Image-to-Video / 最初のフレーム | 開始時の視覚状態 | 提供された最初の画像に密接に関連 | 特定のスチルをアニメーション化する |
| First-and-last frame | 開始時と終了時の視覚状態 | 指定された最初の画像から始まる | 固定されたエンドポイント間のトランジションを計画する |
Google Cloudの参照画像ドキュメント(2026年11月にアクセス)では、参照画像を生成のための追加ガイダンスとして説明しています。この区別は実用的です。アップロードされた最初の写真がフレーム1としてほとんど変わらずに表示され、新しく構成されたオープニングを望んでいた場合は、クリエイティブプロンプトを書き直す前に、モードと画像スロットを確認してください。
無地のソース背景にある白いカップは、Reference-to-Video ではカフェのカウンター上のカップに合理的になることができます。それがここでの実験です。パンテオンでは、外観とドームの写真が2つのシーンを導きますが、それらは規定された最初と最後のフレームではありません。それらの役割は、連続的な動きの間に建築要素を認識可能にすることです。
モデルが読み取れる参照セットを構築する
サポート画像を集める前に、明確なヒーロー参照を選択します。カップは、リム、本体、取っ手を判断できる大きさである必要があります。承認されたソース写真では、カップは小さく、ファイルタイトルが白と呼んでいるにもかかわらず淡いクリーム色に見えます。これにより、この入力は有用なストレステストになりますが、取っ手の詳細の損失はソースから始まる可能性があります。忙しいカフェの写真の中の小さなカップは、モデルが保持する具体的な形状情報がほとんどないため、弱い製品参照です。サポートするカフェの画像は別の役割を持ちます。環境、特にカウンターとエスプレッソ機器を読みやすくする必要があります。豆の画像は小道具を識別するものであり、競合する構図を提供するものではありません。
アップロード順を安定させます。以下のプロンプトでは「最初」「2番目」「3番目」と言っています。これらの単語は、ファイルの順序が一致する場合にのみ役立ちます。再試行中に1つのソースを置き換える場合は、実行する前にUIを再度確認してください。複数の写真が類似したカップを示している場合は、余分なカップを削除するか明示的に除外します。そうしないと、モデルが2つから取っ手、比率、色を混ぜ合わせる可能性があります。複雑なパッケージの製品の場合、同じオブジェクトの複数のビューが、別のスタイル参照よりも価値がある場合があります。
| アップロード | ターゲットの詳細 | 継承しないもの |
|---|---|---|
| 1: 白いカップ | カップ本体、リム、取っ手 | ソース写真の背景 |
| 2: ローマのコーヒーバー | カウンター、機器、屋内の雰囲気 | 製品参照としての他のカップや人々 |
| 3: コーヒー豆 | カップの横にある認識可能な豆 | 豆の写真の白い背景 |
3枚の写真はWikimedia Commonsから提供されています。白い陶器のカップとローマのコーヒーバーの写真はCC0とマークされ、コーヒー豆の写真はパブリックドメインとマークされています。それらの記載された再利用状況は、デモンストレーションを追跡しやすくしますが、生成された出力を実製品の検証済み写真にするものではありません。
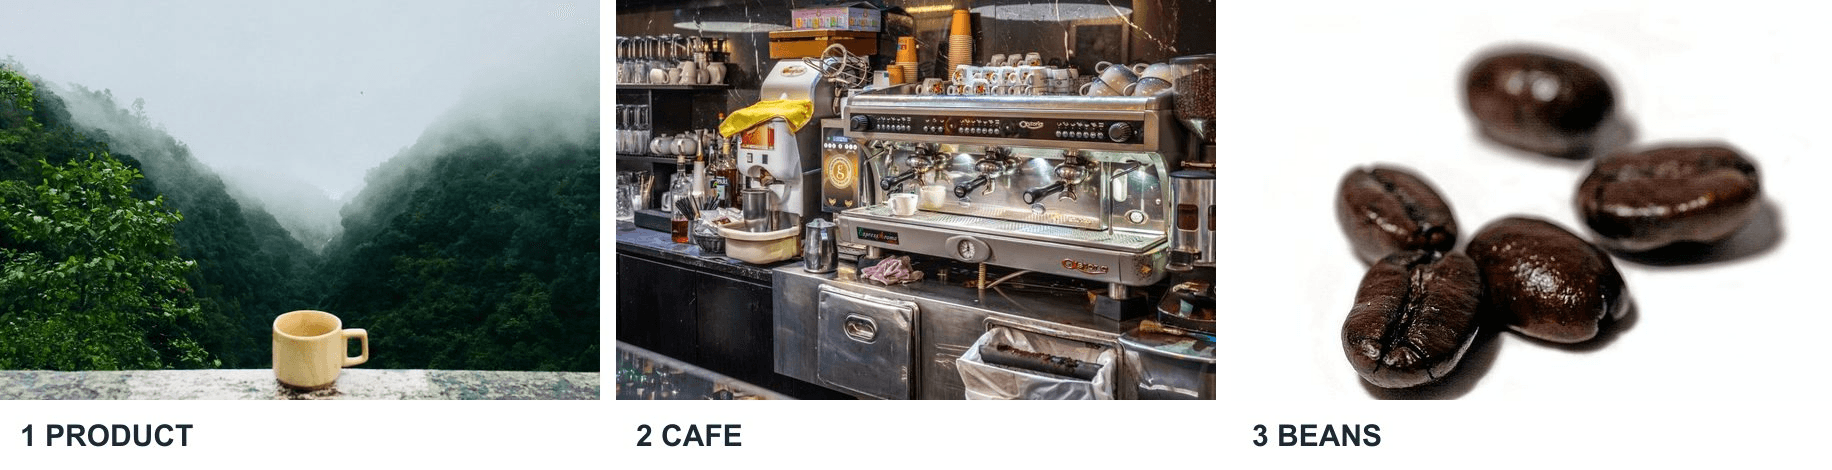
3枚のソース写真は、ビデオが生成される前に、製品、設定、小道具を分離します。
コピー可能なワークフロー:カップ1つ、参照3つ、動くショット1つ
フルサイズのソース写真をダウンロードし、各Commonsファイルページをメモしてください。Gemini Omni 1.2 Flash Reference-to-Video playground で、Image-to-Videoバリアントではなく、Reference-to-Videoモデルを選択します。実行A1ではカップのみをアップロードします。8秒、16:9、1080p、デフォルトの思考に設定します。アップロードされたファイルが参照画像フィールドに表示されることを確認します。このプロンプトを正確に貼り付けます:
plaintext1Create an eight-second product video featuring the white ceramic cup in the first reference image. Preserve its recognizable cup shape and handle. Begin with the cup resting still on a counter. The camera itself physically travels in a smooth semicircular arc around the stationary cup, so the counter and café background shift with clear parallax while the cup keeps the same orientation relative to the counter. Do not spin or rotate the cup, and do not place it on a turntable. After the camera arc, raise the camera to a slightly elevated viewpoint as a hand briefly lifts the cup and sets it back down without twisting it. Natural café ambience, no dialogue, no logos or added text. Use the uploaded image as a product reference, not as a literal opening frame.
A1を実行し、出力全体を視聴します。最初のアップロードがベースラインなので、カップの形状と、軌道と高所視点の両方が発生するかどうかをメモします。特定のカフェや豆を省略したことでA1を罰しないでください。どちらも参照として提供されていません。フォームを変更する前に、その結果を別に保存します。
実行A2では、同じモデルと設定を使用します。カップ、コーヒーバー、豆をこの順にアップロードします。3つのサムネイルすべてが参照フィールドに表示されることを確認し、次を貼り付けます:
plaintext1Create an eight-second product video. The first reference image defines the white ceramic cup: preserve its recognizable shape and handle. The second reference image defines the espresso bar counter and its warm indoor atmosphere, but do not copy any other cup from that image. The third reference image defines the coffee beans placed beside the cup, not the background. Begin with the cup and beans on the counter. Move the camera in a smooth semicircle around the cup, then change to a slightly elevated viewpoint as a hand lifts the cup and sets it down. Keep the same cup and counter through the whole shot. Natural café ambience, no dialogue, no logos or added text. Use all three images as references rather than literal opening frames.
A2を実行し、完了した出力を待ちます。プレビューサムネイルだけでなく、生成されたファイルを確認します。以下の2つの完成したクリップは、カメラの動きと手の動作を経てどの詳細が生き残ったかを示しています。
2番目と3番目の画像で何が変わるか?
同じ表示サイズでクリップを比較します。それぞれを最初から最後まで再生し、オープニング、中間、エンドの近くで一時停止します。カップのアイデンティティについては、リムのプロファイル、取っ手の側、本体の比率を調べます。特に手が持ち上げた後です。環境については、一般的な茶色の部屋ではなく、カウンターとエスプレッソバーの手がかりを探します。豆については、不明瞭なテクスチャではなく、カップの横にある明確な小道具であるかどうかを確認します。
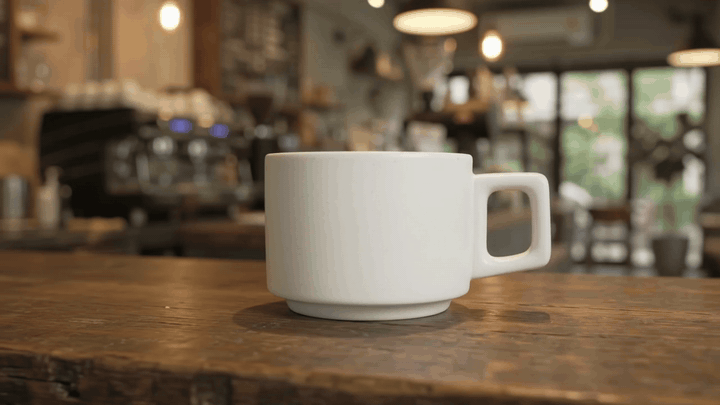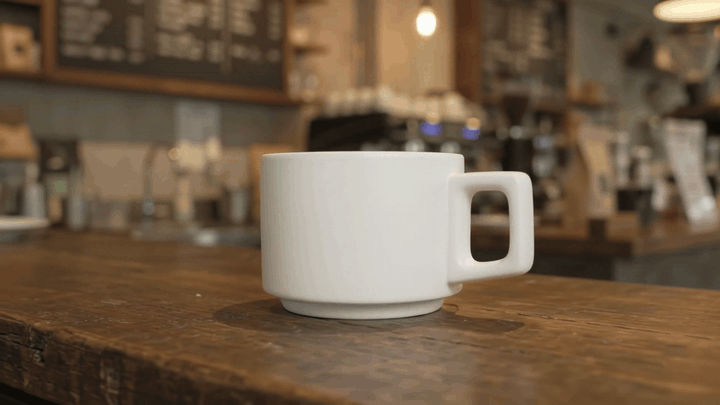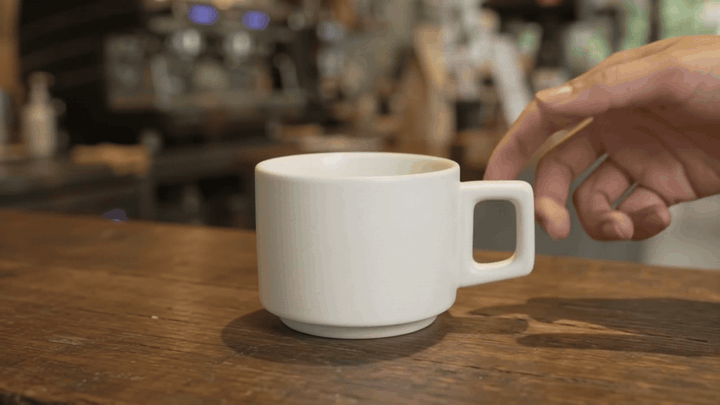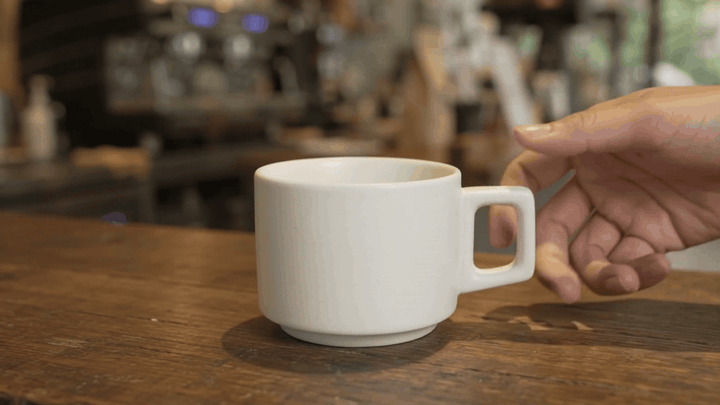
A1は、手の持ち上げを通して白いカップと目に見える取っ手を保持します。カメラのシフトは、明確な半円軌道ではなく控えめです。
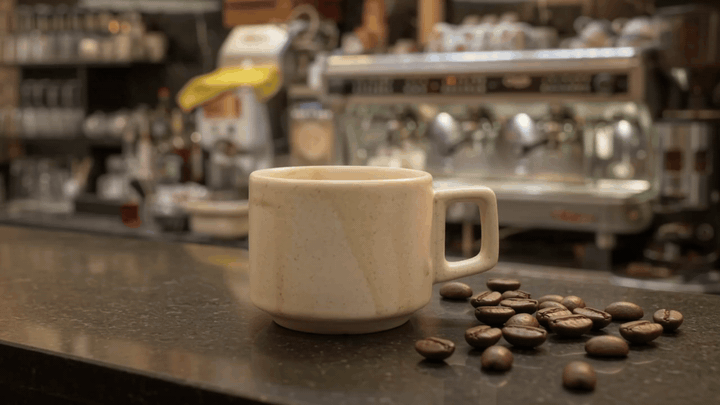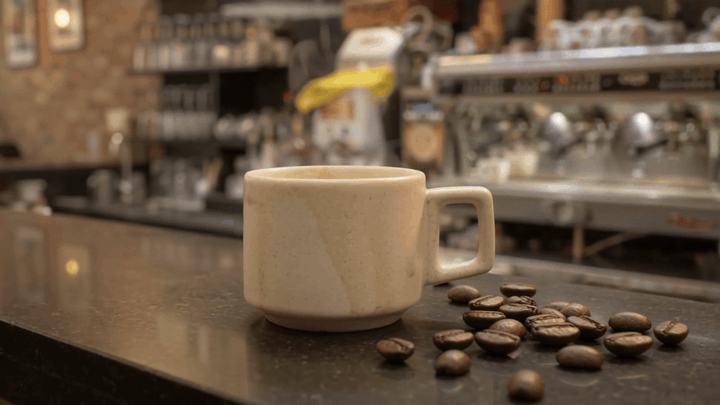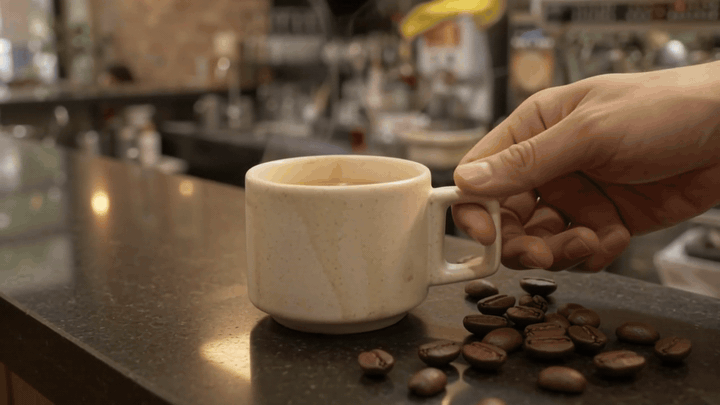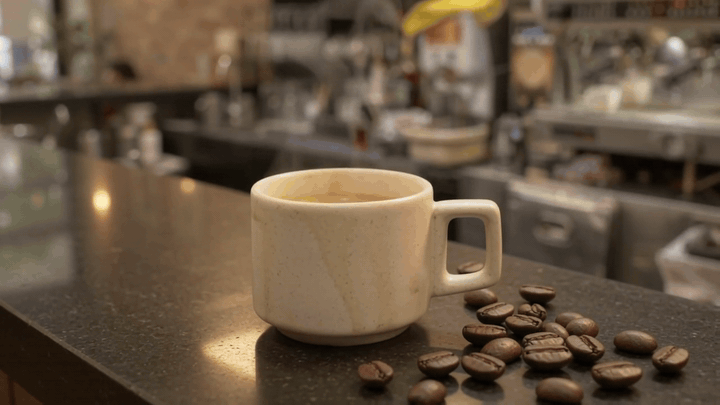
A2は、目に見えるコーヒー豆とより具体的なエスプレッソバーの設定を追加します。カップはクリーム色に見え、A1のカップよりも形状が不規則です。
| チェック | A1: 1画像 | A2: 3画像 | 何を探すか |
|---|---|---|---|
| カップの形状と取っ手 | 白い本体と取っ手が見える | 取っ手は見えるが、本体はクリーム色で不規則に見える | カメラが動いた後も同じ識別可能なオブジェクト |
| カフェカウンター | 一般的なカフェ設定 | エスプレッソマシンとカウンターが明確 | 環境がカウンターソースに似ている |
| コーヒー豆 | 表示されない | カップの横に見える | カップの横にある明確な豆 |
| 動き | 手がカップを持ち上げる。カメラのシフトは控えめ | 手がカップを持ち上げる。視点は控えめに変化 | 軌道、高所視点、持ち上げ、置き戻し |
追加された参照により、カウンターと豆が識別しやすくなりますが、カップの色と形状が変化します。どちらのクリップも、要求された半円形のカメラ移動を明確に完了していません。これらは単一の出力であるため、パフォーマンス統計ではなく診断例です。カップのアイデンティティが最も重要な場合は、次のテストでカップ参照を強化するか、他の設定を固定したまま手の動作を簡素化する必要があります。
2画像の建築テスト
カップテストは、1つの製品ショットにいくつかの種類の詳細が共存するかどうかを尋ねます。パンテオンの2枚の写真は別の質問をします。外観と内部の参照が一貫した動く視点を導くことができるか?最初のCommons画像は外観のファサードを示し、2番目は内部のドームとオクルスを示します。外観とドームの写真の両方のWikimedia Commonsファイルページは、それらをCC0とマークしています。
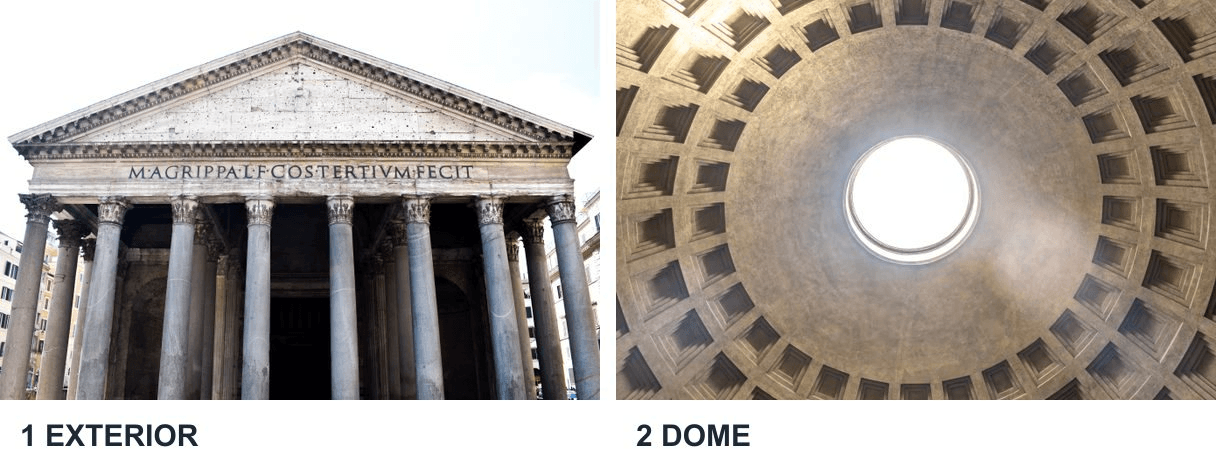 外観とドームの写真は、建物への生成された通路のために別々のシーンキューを提供します。
同じReference-to-Videoモデルで、外観を最初に、内部を2番目にアップロードします。12秒、16:9、1080p、デフォルトの思考に設定します。以下のプロンプトを使用します:
plaintext1Create a twelve-second architectural concept video guided by the two reference photographs of the Pantheon in Rome. The first image defines the exterior facade and entrance; the second defines the interior dome and oculus. Begin from a human-height viewpoint outside, move steadily toward and through the entrance, then tilt upward inside to reveal the dome and oculus. Use a continuous moving viewpoint with clear parallax and no sudden teleporting or isolated zoom. Keep the building recognizable while treating the result as a generated visualization, not documentary footage. Natural footsteps and room ambience, no dialogue, no titles or labels. Both images are scene references, not mandatory first and last frames.
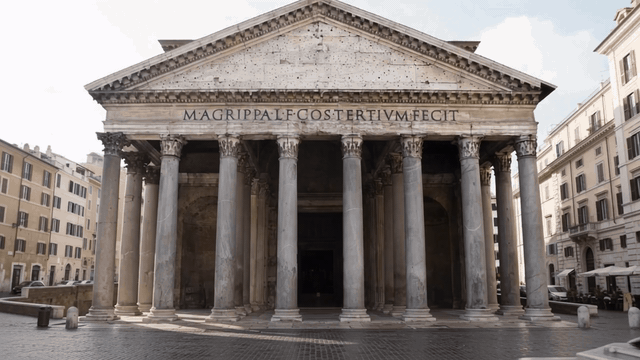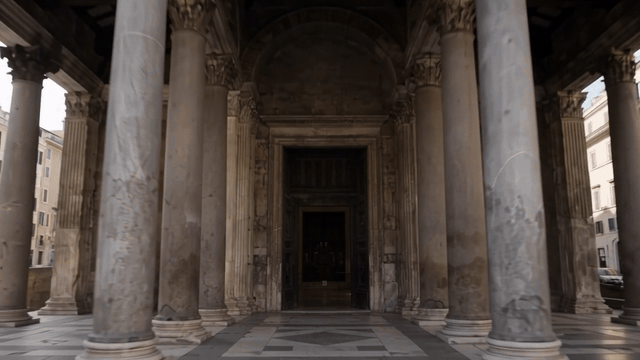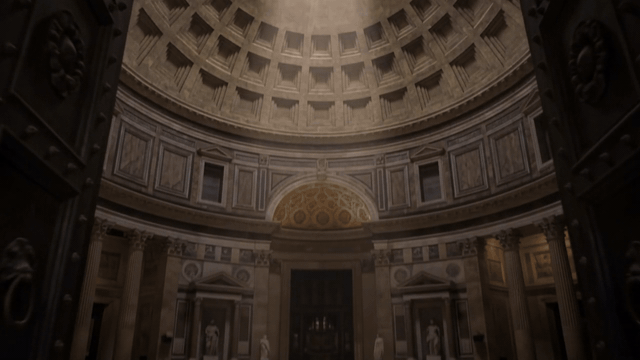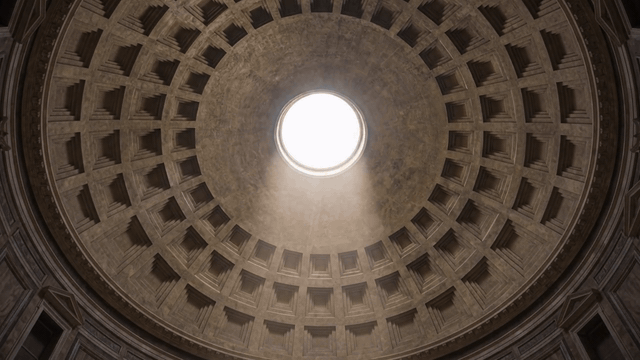
生成された通路は、ファサードからポルチコを通り、ドームとオクルスのビューに入ります。
地理的な精度ではなく、目に見える特徴とトランジションの品質でクリップを判断します。ファサード、ポルチコ、ドームは認識可能であり、視点は入り口に向かって進み、内部で見上げる前です。結果は写真に基づくAIビジュアライゼーションであり、ドキュメンタリー映像や信頼できる建築調査ではありません。First-and-last-frame設定は別の質問に答えます。2つの規定された画像をエンドポイントとして接続する方法。
1つの15秒ショットにおける3つの参照役割
カップの比較は、製品、場所、小道具をテストします。この追加ショットは、3つの参照により要求の厳しい役割を与えます。動く動物、カラフルな環境、後で入ってくる動くグループです。問題は、カメラがアクションを追うときに3つすべてが判読可能であり続けるかどうかです。孤立したフレームにのみ現れるのではなく。
画像1は、カメの広い甲羅、頭、ひれのためのWikimedia Commonsのアオウミガメの写真です。画像2は、ピンクとクリーム色のサンゴの形と澄んだ水のためのWikimedia Commonsのサンゴ礁の写真です。画像3は、魚の体と群れの動きのためのWikimedia Commonsの黄色い尾の魚の群れの写真です。各ファイルページは、その写真をパブリックドメインとマークしています。ソースは異なる場所から来ているため、生成されたシーンは視覚的概念であり、1つの実際の礁の記録ではありません。
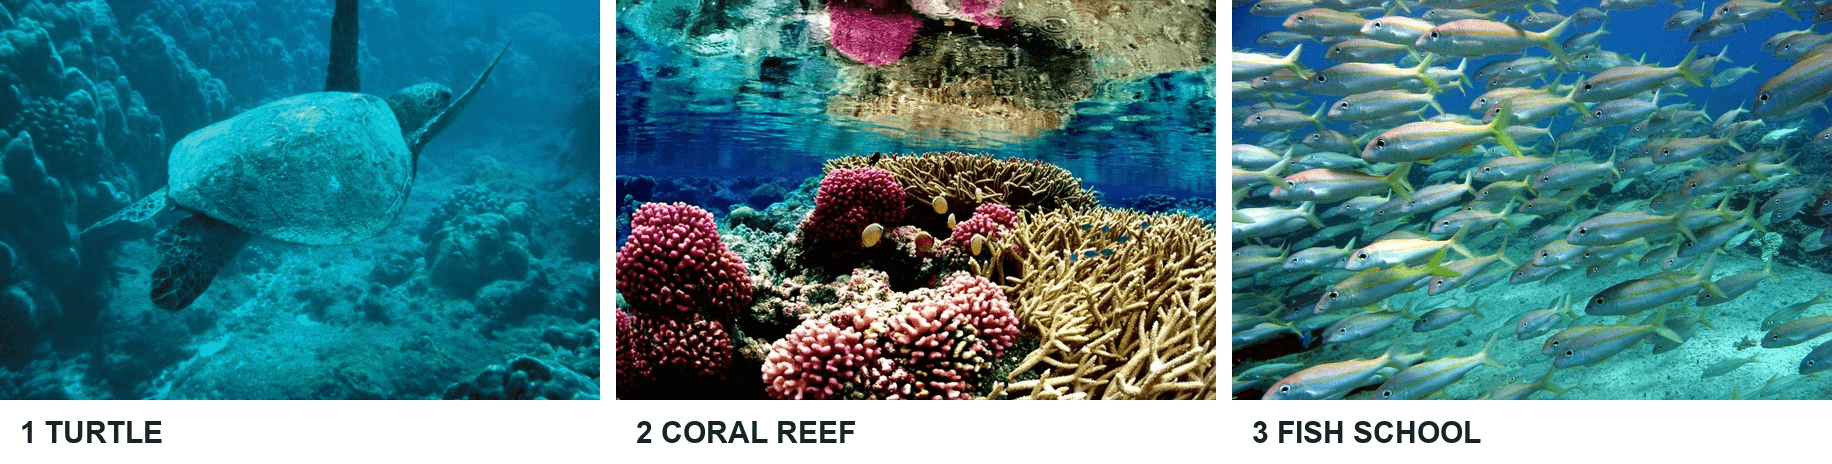 3つのアップロードは、モデルに被写体、設定、後でショットに入るべきグループを与えます。
Reference-to-Videoでその順にアップロードします。15秒、16:9、1080p、デフォルトの思考を選択します。このプロンプトを使用します:
plaintext1Create a 15-second, single continuous underwater concept film using the three uploaded photographs as references in their exact upload order. The first image defines one green sea turtle: preserve its broad mottled oval shell, head, and four flippers, but ignore that photo's background. The second image defines the setting: vivid pink and cream branching corals, rounded coral heads, clear turquoise water, and rippling sunlight; it is not a mandatory first frame. The third image defines a dense school of slender silver fish with yellow tails; use the fish as moving animals, not as a background texture or a copy of their original seabed. In the opening five seconds, the turtle swims forward above the colorful reef with visible flipper strokes while the camera tracks alongside it. In the middle five seconds, the yellow-tailed fish school sweeps across the frame and curves around the turtle as the camera rises to a three-quarter overhead view. In the final five seconds, the camera widens and arcs to show the same turtle, reef, and fish school together in one coherent underwater space. Keep the turtle's shell pattern and the fish appearance consistent throughout. Show real subject movement, water particles, soft sunbeams, and clear parallax. Smooth camera movement, no cuts, no teleporting, no spinning turtle, no additional turtles, no text, logos, or narration. This is a generated visualization, not documentary footage.
生成された15秒のクリップは、サンゴの上のカメから始まり、次に黄色い尾の群れを同じ動くシーンに持ち込みます。
カメのまだらな甲羅とひれは、オープニングからエンドまで認識可能です。ピンクのサンゴはオープニング近くで最も明確です。黄色い尾を持つ銀色の魚は中間あたりで入り、後でカメとフレームを共有します。カメラは追跡し、広がりますが、要求された頭上視点は明確に確立されていません。この単一の出力は、3つの参照役割が連携して機能することを示すと同時に、プロンプトのカメラ指示が部分的にしか従われなかった場所も示しています。
全体のアイデアを再起動せずに参照ドリフトを修正する
カップの形状が変わるとき、それが発生する正確なフレームを特定します。手が取っ手を覆っている間だけ消える場合、それはオクルージョンかもしれません。間違った側に戻ったり、カップが置かれた後にリムのプロファイルが変わったりする場合、製品のアイデンティティがドリフトしています。参照内でカップをより大きく、より明確にするか、持ち上げを簡素化するか、取っ手が見える視点を指定します。変更が役立ったかどうかを判断できるように、前の出力を保持します。
設定がカフェ間でジャンプする場合は、競合する部屋、照明、類似のオブジェクトについてソースセットを調べます。弱いシーン画像を置き換えるか、不要な家具を提供する参照を削除します。プロンプトで、どの画像がカウンターを所有し、どの視覚要素を無視するかを述べます。否定的な指示の長いリストは、より多くの曖昧さを生み出す可能性があります。1つの正確な役割ステートメントは通常、テストが容易です。
最後の秒が詳細を失う場合は、より多くの名詞を追加するのではなく、アクションを短縮します。いくつかのトランジションを含む長いシーケンスを試す前に、1つの連続した軌道と小さな持ち上げを要求します。Googleの起動ノートでは、モデルがフォローアップ編集をサポートしていると述べていますが、編集がすべての未変更の詳細を保持すると仮定しないでください。同じオープニング、中間、エンドのチェックで編集を検査します。
再試行ごとに1つの変数を変更します。参照選択、プロンプトの文言、期間、またはカメラタスク。正確なファイルと設定のログを保持します。これにより、期待外れの出力が実行可能な診断に変わり、幸運なフレームが一貫した制御と誤解されるのを防ぎます。
制限、コスト、試す場所
Googleは2026年11月5日にGemini Omni 1.2 Flashを発表し、最大15秒のネイティブクリップを提供しています。Atlas CloudのReference-to-Videoモデルページには現在、1~10枚の参照画像、3~15秒の期間選択、16:9または9:16のアスペクト比、360p、720p、1080p、4Kの出力オプションが記載されています。1080pと4Kの選択肢は、ネイティブに生成されたフレームからアップスケールされます。入力制限はアクセスルートによって異なる場合があるため、使用するインターフェースのフィールドを確認してください。このガイドでは1、2、または3枚の画像のみが必要です。
正確な例については、ワークフローにリンクされているモデルページを使用し、各実行前に現在の見積もりを確認してください。公開されているAtlas Cloudモデルカタログは、可用性と現在の価格を確認する2番目の場所を提供します。1秒あたりのヘッドライン料金は、すべての解像度やアカウント条件を説明しているわけではないため、起動価格を制作計画にコピーするのではなく、実際に選択したコントロールから予算を立ててください。
Gemini Omni 1.2 Flash multiple reference imagesの実用的な次のステップは、最初にカップのベースラインを実行することです。その正確なプロンプトと出力を保存します。ベースラインに欠けている詳細を特定できるようになってから、カフェと豆を追加し、上記の4つのチェックに対して完全なモーションクリップを判断します。
よくある質問
画像参照とモーション参照クリップを組み合わせることはできますか?
Googleは短いモーション参照のサポートを説明していますが、それはここでの静的写真テストとは異なる入力ミックスです。組み合わせる前に、特定のエントリポイントの制限と期間ルールを確認してください。モーションが別途提供される場合でも、画像の役割を明示的に保ちます。
モデルは参照写真を正確にコピーしますか?
いいえ。参照はアイデンティティ、設定、小道具、またはスタイルを導きます。生成されたフレームは、カメラアングル、照明、隠れた表面、または小さな詳細を変更する場合があります。正確な開始フレームが必要な場合は、first-frameワークフローを選択し、それでもクリップの残りを検査します。
他人の写真やブランド資産を使用できますか?
使用許可を得ている素材を使用し、意図する公開のためにそのライセンスを確認してください。ソース写真のWikimedia Commonsファイルページには、再利用条件が記載されています。公開前に該当する各ライセンスを確認してください。そのソースステータスは、後で追加する可能性のある無関係なロゴ、人物、または資産の権利を付与するものではありません。


