あるエンタープライズ顧客が、年間プランを更新後に返金できるかどうかを尋ねます。あなたのアシスタントは膨大な文書セットをスキャンし、明快な「はい」を返します。しかもポリシーを引用します。落とし穴は、署名済みの補遺とv4.2が別のことを述べているのに、アーカイブされたポリシーであるv4.1を選んだことです。
そのため、gpt-6 astra knowledge base best practicesは証明から始まります。モデルに権限の順序を与え、認可された現在の証拠のみを取得し、すべての重要な主張が文書、バージョン、セクションに紐づくようにします。証拠が矛盾したり不足したりする場合、回答は停止しなければなりません。
GPT-6 Astraは、File Searchと1,050,000トークンのコンテキストウィンドウ全体で動作し、最大出力は128,000トークンです。容量は調査に役立ちます。しかし、どのポリシーが最新か、どのユーザーが閲覧できるか、引用が近くの主張を実際に裏付けるかどうかは判断しません。( OpenAI GPT-6 Astra モデルページ、2026年9月 )
権限優先のナレッジベースワークフロー(アニメーション)
8秒で生成されたワークフローのビジュアル:署名済みのオーバーライドと現在のポリシーが証拠トレイに残り、アーカイブされたファイルが明らかに横に移動されます。これはソースガバナンスを示すものであり、実際の製品インターフェースやソース文書ではありません。
主なポイント
- アップロード前にソースの権限を承認する。
- 検索と回答の忠実性を別々に測定する。
- 検索前にアクセス、ステータス、日付、地域でフィルタリングする。
- 長いコンテキストを調査ツールとして扱い、デフォルトのプロンプトとして扱わない。
- 矛盾と不足している証拠を人にエスカレーションする。
GPT-6 Astraナレッジベースが100万トークンで失敗する理由
ほとんどの失敗は回答の前に始まります。Driveのエクスポートでは、署名済みの補遺、現在のポリシー、古いFAQ、下書きが、等しく検索可能な散文として扱われます。有能なモデルは、その乱雑なセットを非常に迅速に説得力のある段落に変えることができます。
4つのチェックが一般的な失敗モードを捉えます:
- 権限のドリフト: 新しいポリシーや顧客の補遺が、人気のある古いFAQに負ける。
- 引用の見せかけ: 回答にソースリンクが含まれているが、引用された箇所が主張を裏付けていない。
- 制御されていない実験: チャンクサイズ、top-k、コンテキスト予算がすべて一緒に変更されるため、何が改善されたか誰もわからない。
- アクセスのドリフト: 地域の例外、制限された下書き、またはプライベートノートが、誤ったオーディエンスに検索可能になる。
評価について議論する法務RAGの実務家は、「検索が必要なソースを見つけたか?」と「回答がそのソースを忠実に適用したか?」を分離する傾向があります。その分離は、内部サポートボットを含むすべてのリリースゲートに属します。( r/Rag 法務ナレッジベースの議論、2026年9月 )
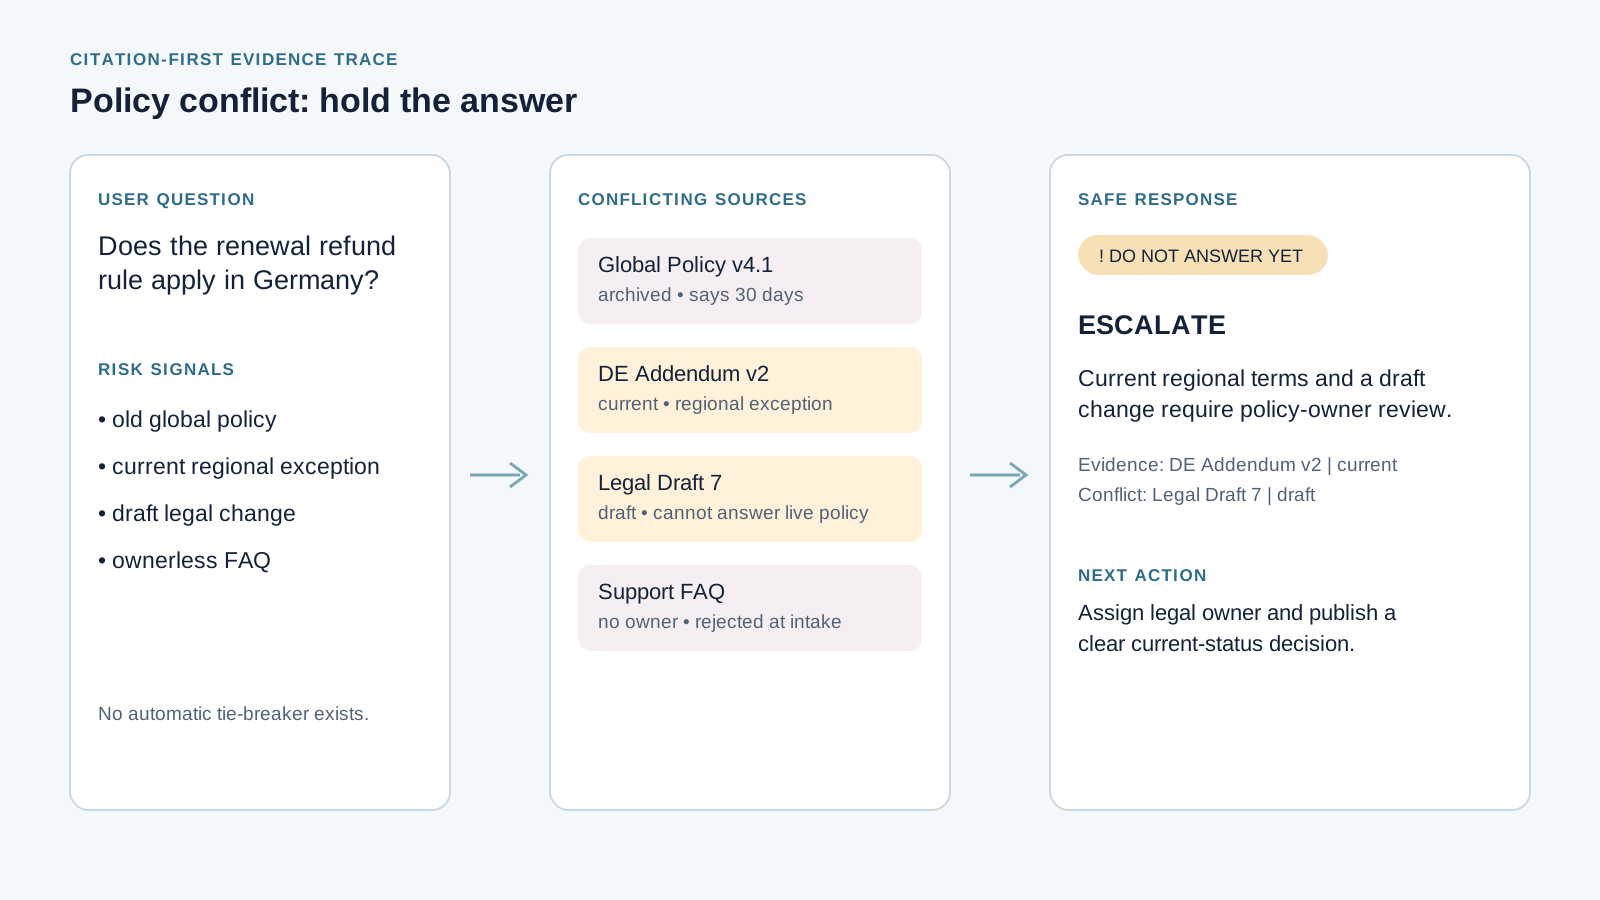
知識ベースのバージョン競合の証拠トレースと棄権結果
矛盾は有用な出力です。このケースは、システムが下書き、地域の例外、古いポリシー、所有者不明のファイルの中から黙って選択するのではなく、「まだ回答しないでください」を返すべき理由を示しています。
GPT-6 Astraナレッジベースのワークフロー、モデル、コスト
パイロットには1つのブラウザタブを使用します:ソースを棚卸しし、権限マニフェストを承認し、ファイルとメタデータを正規化し、小さな証拠セットを取得し、回答して評価します。運用上の目標は、巧妙なチャットデモではなく、レビュー可能な証拠トレイルです。
残りのスタックを比較するチームにとって、Atlas Cloudは現在のモデルオプションを確認する場所を提供します。公開日に確認するまで、カタログにGPT-6 Astraが掲載されていると仮定しないでください。
| レイヤー | 解決するジョブ | 単独では解決できないもの | パイロットルール |
|---|---|---|---|
| 長いコンテキスト | 大規模な調査パケットを読む | 権限、許可、引用サポート | 例外と調査に使用する |
| File Search | 小さなソースセットを取得する | バージョンガバナンス | 検索前にフィルタリングする |
| カスタム検索 | インデックス作成とランキングを調整する | 回答の忠実性 | テストではコンテキスト予算を一定に保つ |
| 人間へのエスカレーション | 矛盾と影響の大きいコールを解決する | ルーチンの規模 | 所有者と応答時間を定義する |
| モデルまたはツール | ジョブ | 推奨設定 | 計画に使用する公開価格 |
|---|---|---|---|
| GPT-6 Astra | 矛盾の判断、統合、評価 | reasoning.effort: high | $10/MTok 入力、$50/MTok 出力 |
| OpenAI File Search | 認可された文書の検索 | メタデータフィルタと引用 | 起動前にツール料金を確認する |
| ルーチンモデルルート | タグと低リスク分類 | 最初にベンチマーク | 価格をハードコードしない |
| Atlas Cloud モデルカタログ | 後のモデル探索 | ライブカタログを使用する | Astraの可用性は想定されていない |
20〜50の価値の高い質問と、意図的に扱いにくい文書セットから始めます。置き換えられたポリシー、欠落した補遺、地域の例外、そして少なくとも1つは回答を得てはならない質問を含めます。
ステップ1:権限マニフェストを作成する
何かをアップロードする前に、インベントリを承認済みの決定レイヤーに変えます。人間の所有者は、返されたJSONが KB_MANIFEST.md になる前に承認する必要があります。これは、廃止されたテキストに基づいて完璧な回答を構築することに対する最初のガードレールです。
plaintext1You are the knowledge-governance reviewer for an enterprise support knowledge base. 2 3Goal: 4Create an authority manifest before any answer-generation workflow begins. 5 6For every supplied document, identify: 7- document_id 8- title 9- owner 10- effective_date 11- region 12- audience 13- status: current, draft, archived, superseded, or unknown 14- authority_rank from 1 to 5 15- conflict_rules 16- access_policy 17- reason_for_rank 18 19Authority rules: 201. Signed customer addenda override general policies for the covered account. 212. Current policy versions override archived or superseded versions. 223. Official policy documents override FAQs and training notes. 234. Drafts may be used only when the user explicitly asks about a draft. 245. If two current sources conflict, do not resolve the conflict. Return ESCALATE. 25 26Return valid JSON only. Do not infer missing dates or policy terms.
設定: モデル gpt-6-astra、Responses API、reasoning.effort: high、構造化JSON出力。初期レビューには、タイトル、所有者、発効日、地域、ステータス、アクセスレベルのみを提供します。
完了条件: すべてのファイルに所有者、日付、ステータス、ランクがあり、Refund Policy v4.1 がv4.2によって置き換えられたとマークされている。
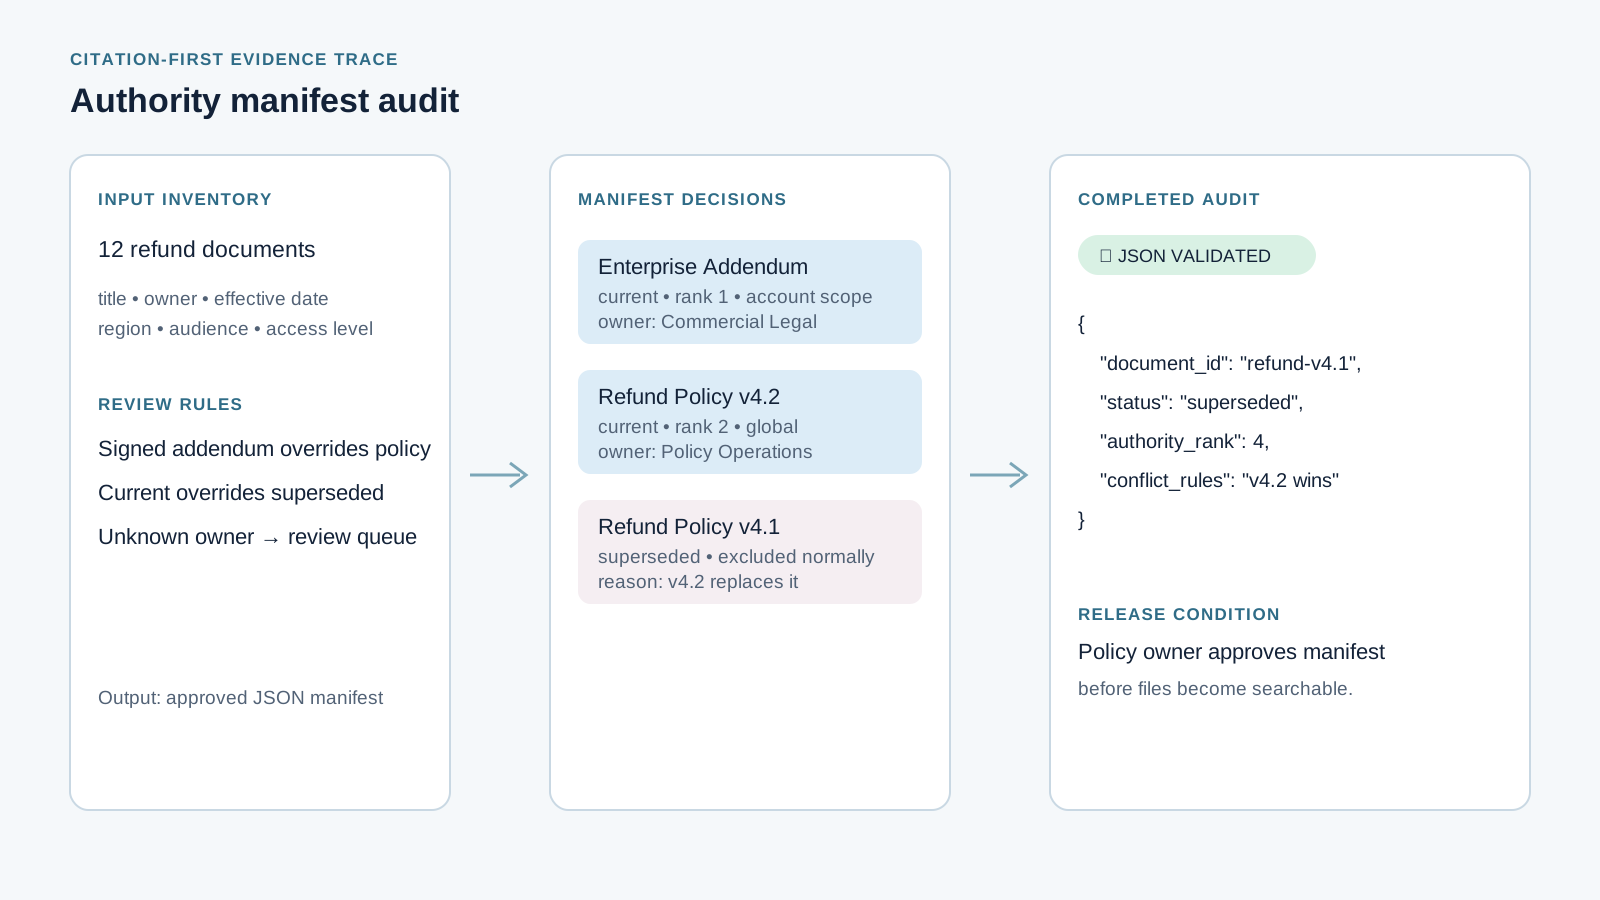
権限マニフェスト監査と完了したJSON決定
返金パイロットの完了した権限マニフェスト監査。監査ページには、置き換えられたv4.1とエンタープライズオーバーライドルールが記録されています。
ステップ2:検索用のGPT-6 Astraナレッジベースを準備する
承認されたソースを正規化します。見出し、条件、ページマーカー、バージョンデータを保持します。重複するフッター、ナビゲーション、OCRの残骸を削除します。所有者または発効日のない文書をアップロードしないでください。
plaintext1You are preparing files for a retrieval-based knowledge base. 2 3Inspect the supplied document inventory and return a file-preparation checklist. 4 5For each file: 61. Keep the source title, version, effective date, owner, and page or section markers. 72. Remove navigation, duplicated footers, stale boilerplate, and OCR fragments. 83. Preserve headings and lists that carry policy conditions. 94. Mark whether the file is current, archived, draft, or restricted. 105. Reject any file that cannot be assigned an owner and effective date. 11 12Return a table with: 13file_name | status | metadata_to_attach | cleanup_required | upload_decision | reason
設定: document_id、version、effective_date、status、region、audience、authority_rank をメタデータとして添付します。検索テストは、合計検索コンテキストが約2,000トークンで開始します。一度に1つの変数のみを変更します:チャンク戦略または検索数、両方は決して変更しないでください。
完了条件: アーカイブされた資料が通常のクエリから除外され、所有者不明のファイルがレビューキューに入る。
次のモーションケースでは、ソートの決定が可視化されます。2つの承認されたソースフォルダが権限トレイにまとまり、曖昧な下書きが別のレビューパスに移動します。これは例示的なワークフローレンダリングであり、実際のGPT-6の応答や製品インターフェースではありません。
人間のレビューへの証拠ハンドオフ(アニメーション)
8秒で生成されたワークフローのビジュアル:承認されたソースフォルダはまとまり、未解決のフォルダは人間のレビューにルーティングされます。
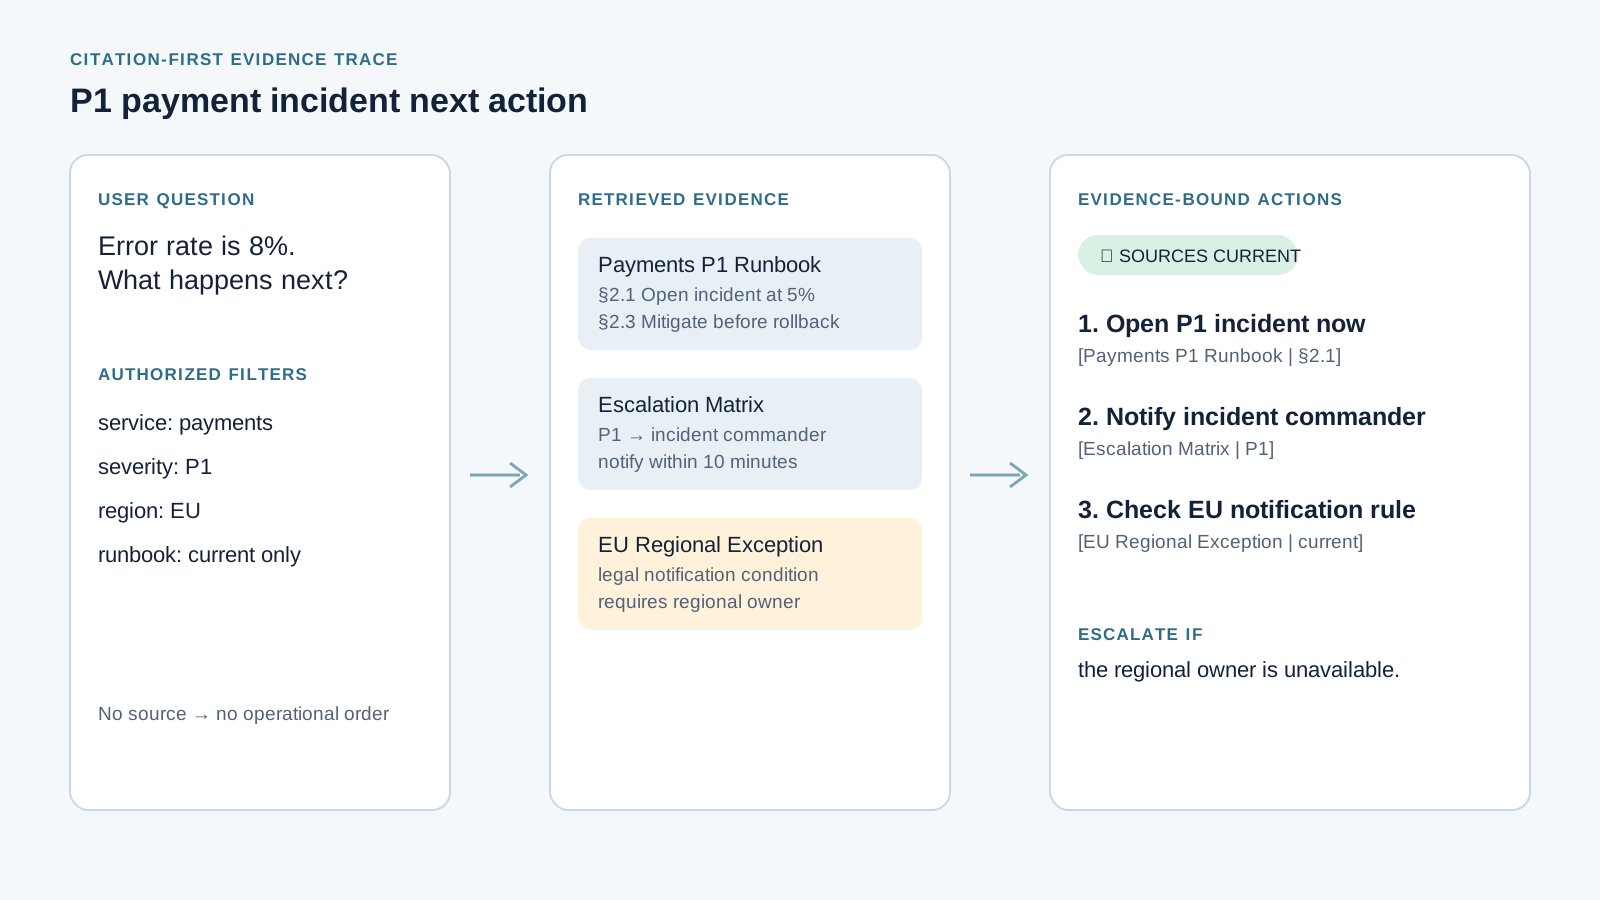
エスカレーション条件を含むP1支払インシデント証拠トレース
ケース2。支払エラーの質問が、オンコールランブック、エスカレーションマトリックス、地域の例外を引き出します。回答は、復旧計画を即興で作るのではなく、インシデントコマンダーのトリガーを特定します。
ステップ3:証拠に基づく回答を求める
回答生成を、取得された認可済みの証拠に結び付けます。モデルは事実、仮定、次のアクションを分離し、レビュー担当者がシステムがどこで知識を停止するかを確認できるようにする必要があります。
plaintext1You are an evidence-bound knowledge-base assistant. 2 3Answer the user question using only the retrieved, authorized knowledge-base sources. 4 5Rules: 6- Treat the authority manifest as binding. 7- Prefer the highest-ranked current source that applies to the user’s region and audience. 8- Every factual claim must include [document title | version | section or page]. 9- If sources conflict, identify the conflict and return ESCALATE instead of choosing silently. 10- If the evidence does not support a claim, write INSUFFICIENT_EVIDENCE. 11- Do not use general model knowledge to fill gaps. 12- Separate confirmed facts, assumptions, and recommended next actions. 13- For regulated or high-impact questions, state that a qualified human review is required when the evidence is incomplete. 14 15User question: 16Can an Enterprise annual-plan customer receive a refund after renewal if the account has a signed Enterprise addendum? 17 18Return: 191. Decision 202. Evidence 213. Exceptions or conflicts 224. Next action 235. Confidence: supported, partial, or insufficient
設定: reasoning.effort: high と File Search を使用します。検索前に、現在のステータス、ユーザー認可、地域、オーディエンスのフィルタを適用します。ツール呼び出しはResponses APIに属します。OpenAIの現在のガイダンスでは、Astraワークフローの明確な成功条件とツール境界も推奨されています。( OpenAIモデルガイダンス、2026年9月 )
完了条件: 回答が現在の一般ポリシーと署名済みのエンタープライズ補遺を引用し、アーカイブされたv4.1をルールとして決して使用せず、補遺が存在しない場合は INSUFFICIENT_EVIDENCE を返す。
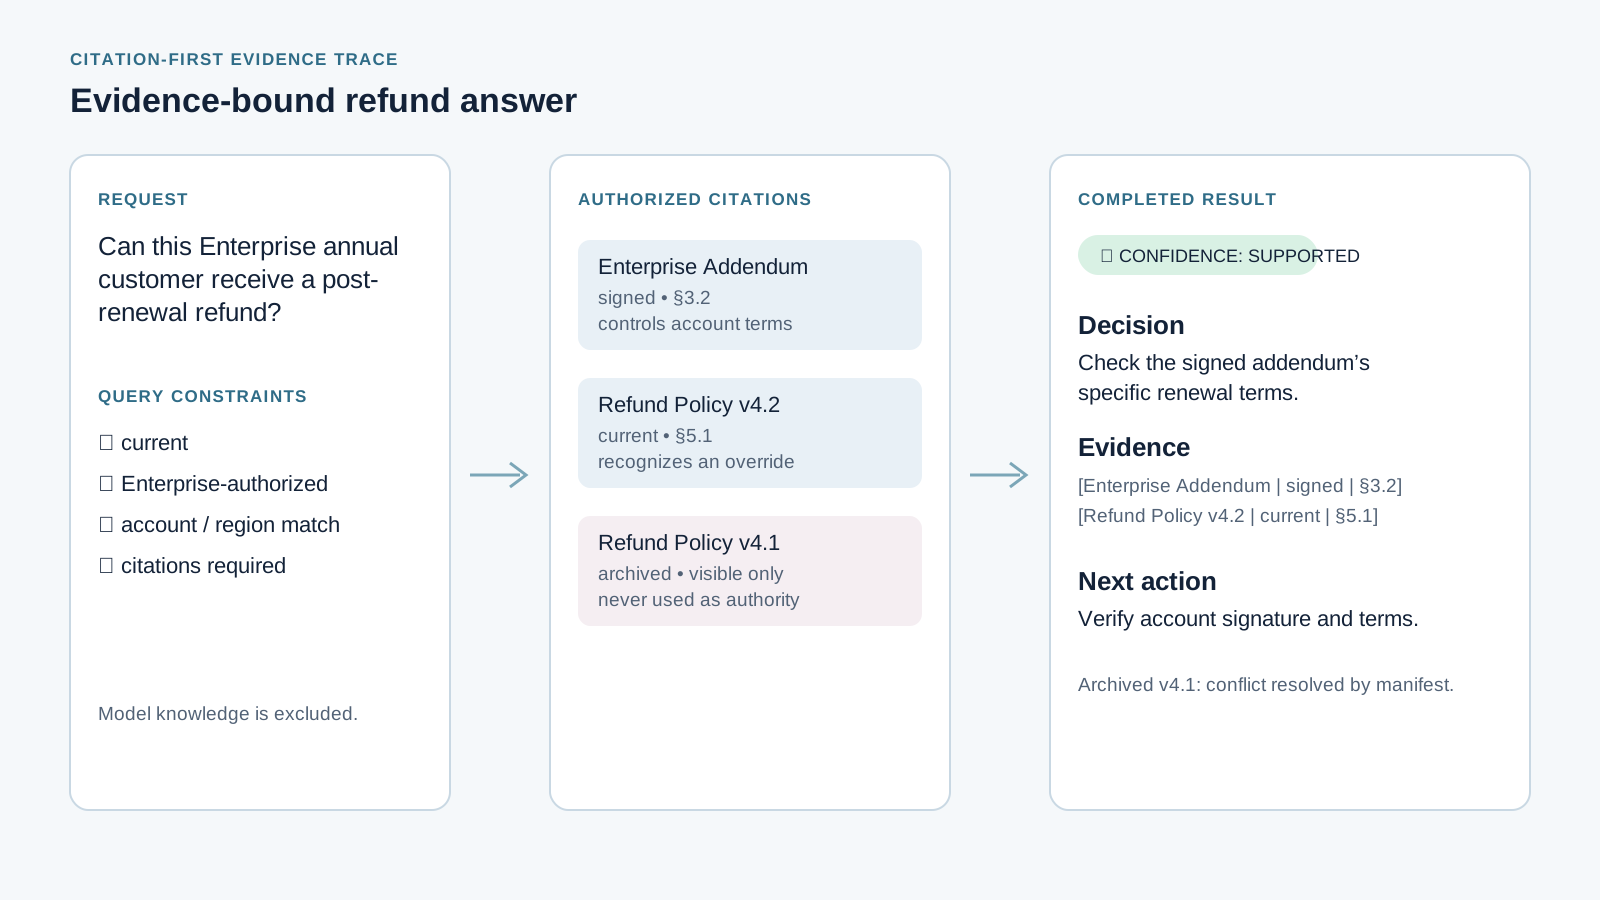
現在のポリシー引用を含む証拠に基づく返金回答
主要な完了結果:決定はv4.2と署名済み補遺によって支持され、アーカイブされた文書は解決済みの矛盾としてのみ表示されます。
ステップ4:検索と忠実性を別々に評価する
回答は文書を引用していても、間違った条項を適用することがあります。検索の再現率と主張の忠実性を別々にスコアリングします。これにより、製品、サポート、または法務の所有者が防御できるリリース決定が生成されます。
plaintext1You are evaluating a knowledge-base answer. 2 3Given: 4- the user question 5- expected source sections 6- retrieved source sections 7- the final answer 8 9Score these dimensions separately: 101. Retrieval recall: did the required source appear in the retrieved evidence? 112. Citation precision: does each cited source support the nearby claim? 123. Claim faithfulness: is every atomic factual claim supported by retrieved evidence? 134. Conflict handling: did the answer surface conflicting current sources? 145. Abstention quality: did the answer refuse unsupported conclusions? 15 16Return JSON with: 17question_id, retrieval_recall, citation_precision, claim_faithfulness, 18conflict_handling, abstention_quality, unsupported_claims, reviewer_notes, 19release_decision 20 21Use FAIL if any high-risk factual claim lacks supporting evidence.
設定: 単純、一般的、矛盾、回答なし、高リスクの各ケースに4問ずつ、合計20問のゴールデンセットを作成します。高リスクと矛盾の質問は高い推論に保ちます。ベースラインが合格した後、低リスクの作業にのみ低い努力をベンチマークします。
完了条件: セットに、正しい文書を取得したが間違った条項を適用した失敗と、正しい棄権が含まれている。人間のレビュー担当者は、サポートされたすべての高リスク回答をサンプリングします。
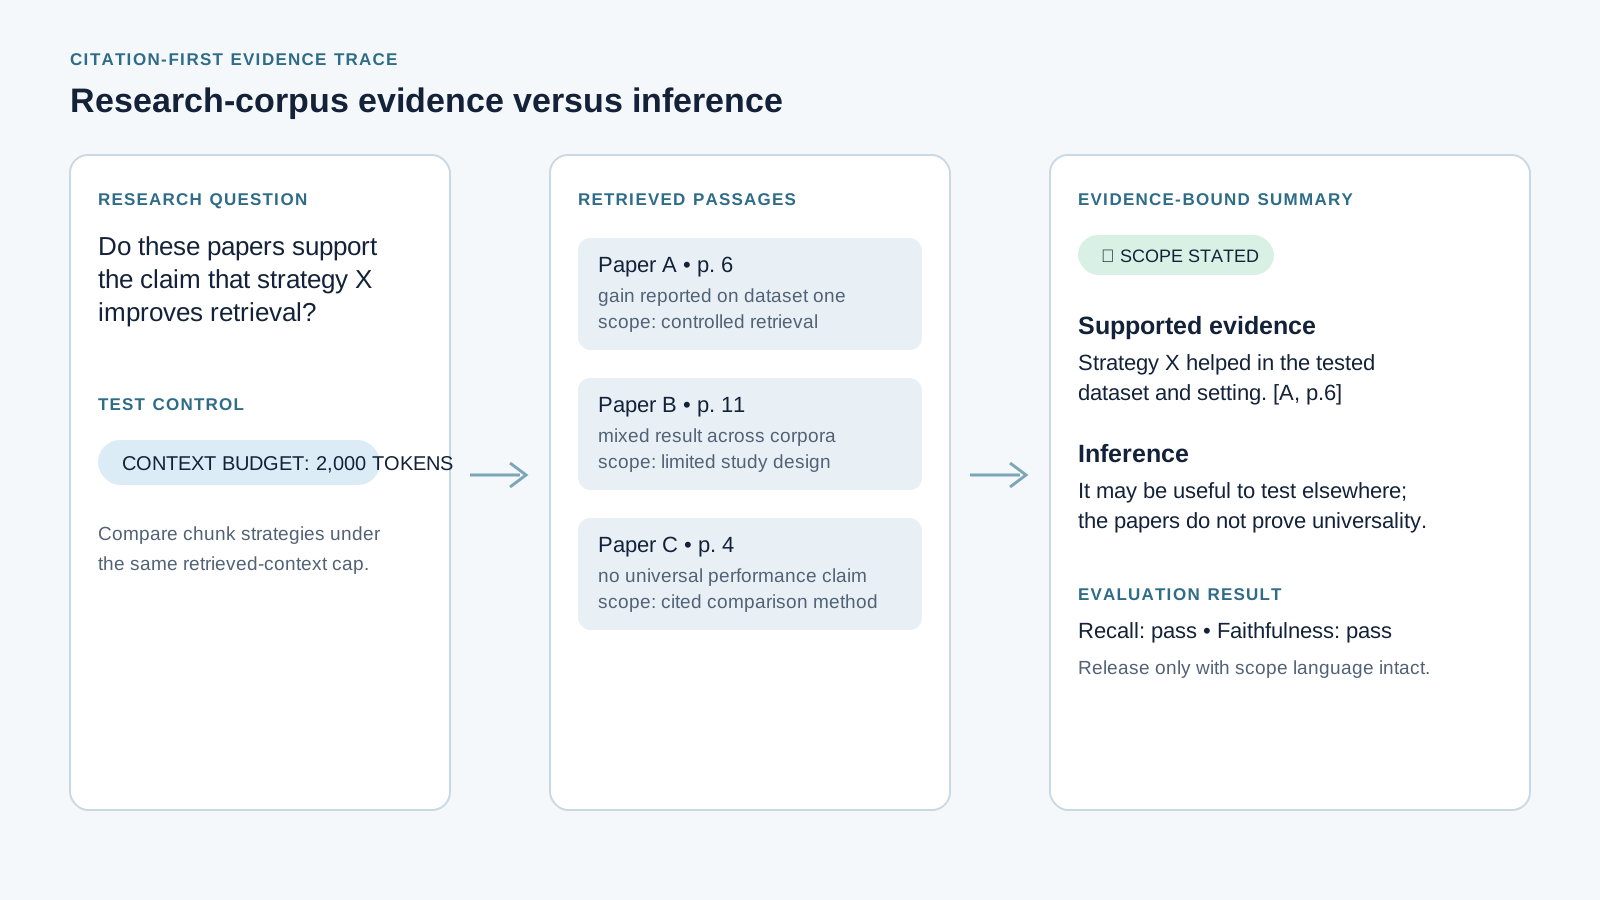
2000トークン予算でのサポートと推論を比較する研究コーパス証拠トレース
ケース3。研究コーパスの回答は、3つの論文が明示的にサポートする内容と推論を分離します。検索比較では、コンテキスト予算を2,000トークンに保ちます。
証明を失わずにGPT-6 Astraナレッジベースを拡張する
パイロットパターンはドメインによって変わります。証拠トレースは維持しますが、権限ソースと拒否境界を作業に固有のものにします。
| パイロット | 権限ソース | 必要なメタデータ | 拒否またはエスカレーションする条件 | 人間のリリースゲート |
|---|---|---|---|---|
| エンタープライズ返金ポリシー | 署名済み補遺、現在のポリシー | アカウント、地域、発効日、ステータス | 補遺が欠落しているか、現在のソースが矛盾している | サポートとポリシー所有者 |
| P1インシデントランブック | 現在のランブックとエスカレーションマトリックス | サービス、重大度、所有者、最後の訓練 | アクションに所有者または現在のランブックがない | インシデントコマンダー |
| 研究コーパス | 引用された論文の箇所 | DOI、ページ、発行日、方法 | 結論が証拠を超えている | 主題専門のレビュー担当者 |
コードと内部ルールライブラリについては、AGENTS.md、アーキテクチャ決定、現在のデプロイ手順、および廃止されたスクリプトに明示的なランクを与えます。研究については、「証拠」と「推論」を異なるフィールドとして返します。カスタマーサポートについては、製品、地域、発効日のフィルタが信頼性作業のほとんどを行います。
コストとルーティングのチェックリスト。 20K入力トークンと2K出力トークンを使用する高リスク回答の場合、GPT-6 Astraテキストトークンで約$0.30のコストがかかります:20,000 × $10 / 1,000,000 + 2,000 × $50 / 1,000,000。これにはFile Searchおよびその他のツール料金は含まれず、起動前に現在のコンソールで確認する必要があります。272Kトークンを超える入力にはより高いモデル価格が適用されるため、1Mトークンのプロンプトは通常のパスにすべきではありません。
| タスクリスク | 推論努力 | 証拠ルール | 人間のレビュー |
|---|---|---|---|
| タグとルーティング | 下げる前にベンチマーク | メタデータのみ | サンプリング |
| 標準サポート | テスト後は中または高 | 現在の引用ソース | 例外キュー |
| 矛盾、ポリシー、またはインシデント | 高 | すべての主張がソースに拘束される | 必須 |
| 法務、医療、金融、人事、プライバシー | 高 | 不完全な場合は棄権 | アクション前に必須 |
コスト管理は上流から始めます:古いファイルと所有者不明のファイルを削除し、検索前にメタデータをフィルタリングし、価値の高い質問を最初にテストし、マニフェスト、取得した箇所、モデルバージョン、リリース決定を保持します。後でマルチモデルルートが必要なチームは、現在のLLM APIドキュメントを自身のパイロット結果と併せて確認できます。
規制対象、プライベート、雇用、健康、金融、または本番インシデントのコンテンツについては、検索前にアクセスフィルタリングを適用し、データ処理と保持条件を確認し、撤回パスを保持し、不完全な証拠を説明責任のある人間にルーティングします。流暢な回答は、これらのコンテキストでは決して最終的なアドバイスではありません。
よくある質問
100万トークンのコンテキストウィンドウはRAGの必要性を排除しますか?
いいえ。調査担当者がより大きなパケットを読むのには役立ちますが、文書の権限、ユーザーアクセス、鮮度、引用精度、リリーステストを確立するものではありません。通常の証拠選択には検索を使用し、広範なコンテキストは例外調査のために確保してください。
GPT-6 Astraナレッジベースに決して入れてはならないものは何ですか?
所有者のないファイル、日付のないポリシー、明示的な下書きワークフローのない下書き、要求者が閲覧を認可されていないコンテンツ、または履歴使用ルールのないアーカイブ資料を取り込まないでください。それらのファイルはレビューに入れるか、通常の検索外にアーカイブしてください。
矛盾する2つの現在の文書はどのように処理すべきですか?
ESCALATE を返し、矛盾を明示し、両方の引用を保持し、所有者を割り当てます。モデルは黙ってタイブレーカーを発明すべきではありません。マニフェストには、次のリリース前に文書化されたルールが必要です。
GPT-6 Astraナレッジベースに最適なチャンクサイズは何ですか?
普遍的な数値はありません。意味のあるポリシーの見出しと条件を保持し、同じコンテキスト予算の下で戦略を比較します。固定のtop-kは、はるかに大きな取得トークン予算を隠し、実験を実際よりも良く見せることがあります。
回答が正しいソースに基づいていることをどのように証明しますか?
各ゴールデン質問の期待されるソース、取得された箇所、最終的なアトミッククレーム、およびレビュー担当者の再現率、引用精度、忠実性、矛盾処理、棄権のスコアを保存します。高リスク回答の場合、サポートリンクが欠落していることは失敗です。
GPT-6 Astraナレッジベースのコストはいくらですか?
トークンの計算式を使用し、現在のFile Searchとツール料金を追加します。上記の例では、20K入力+2K出力はモデルトークンで約$0.30です。実用的な節約は、古い資料を排除し、証拠が重要な場所で高い推論を使用することからもたらされます。それが gpt-6 astra knowledge base best practices の耐久版です。


