

how i become a millionaire in 30 days のクリップは、チャットボットに奇跡的な近道を尋ねて、可能な限り最も魔法のない答え「仕事に就け」を得るというジョークです。キャラクターの傷ついた視線、必死のタイピング、そして2度目の試みが本当のストーリーです。以下に、同じ設定が人間とペットでどのように機能するかを示す2つのオンライン例を紹介します。次に、オリジナルのキャラクター、新しい設定、読みやすいダイアログ、そして十分に長く続くリアクションを備えた、新しい長めのバージョンを作成します。
重要なポイント
- 認識できるシーケンスは、希望に満ちた質問、ぶっきらぼうな返答、気分を害した間、そしてもう一度試すことです。
- オンラインの人間とペットのバージョンは、ジョークのタイミングを保ちながら演者を変えています。
- 私たちのオリジナルの26秒の遊び場バージョンは、子役を使い、ビデオモデルに電話インターフェースを描かせるのではなく、編集で読みやすいダイアログを追加しています。
- 「仕事に就け」は台本に基づくオチとして扱い、チャットボットが答える内容の証明や実際の富の計画とはしないでください。
オンライン版では何が起こるのか?
最初のオンライン例は、ジョークを日常的な電話の会話に近づけています。人は完全な自信を持って電話を掲げ、答えを求めて見下ろし、突然その自信を失います。姿勢の変化に注目してください。設定は電話に向かって話されますが、オチは視聴者に向かって演じられます。このリアクションが短いセリフを記憶に残るものにしています。
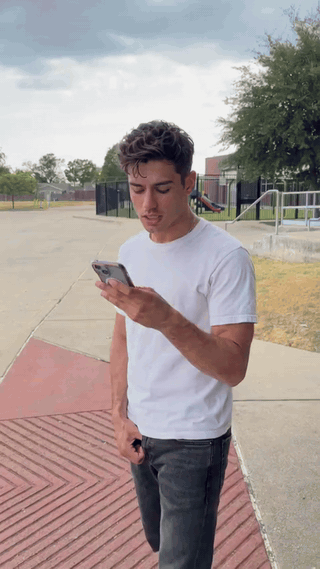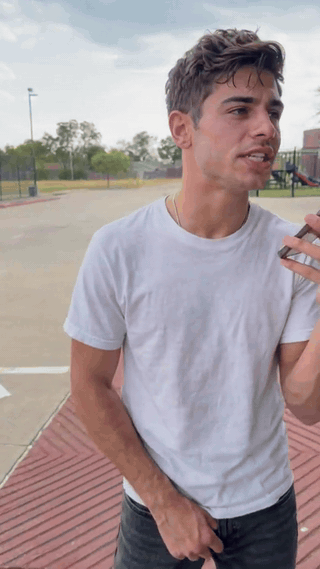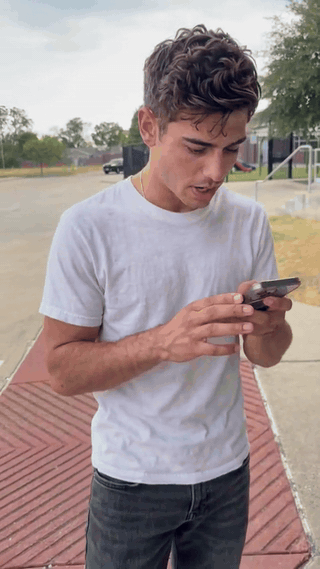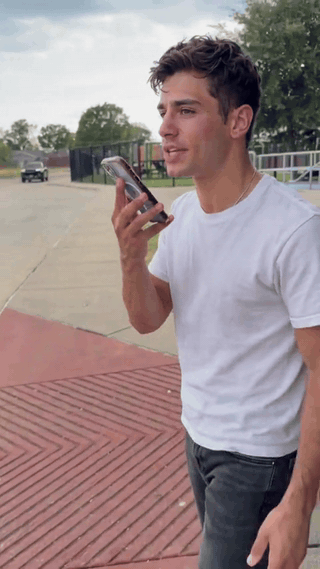
オンライン例、人間バージョン。重要な視覚的ビートは、希望に満ちたデリバリーから目に見える不信感への移行です。
2番目のオンライン例では、ペットが同じ役割を担います。その直立した姿勢と電話の小道具は、答えが届く前に野心を不条理なものにします。頭を回してカメラをじっと見つめることが、人間の俳優が眉とつぶやく抗議で行う仕事をします。これは単なる衣装の交換以上のものです。動物のボディランゲージがオチの感触を変える一方で、質問と返答は認識可能なままです。
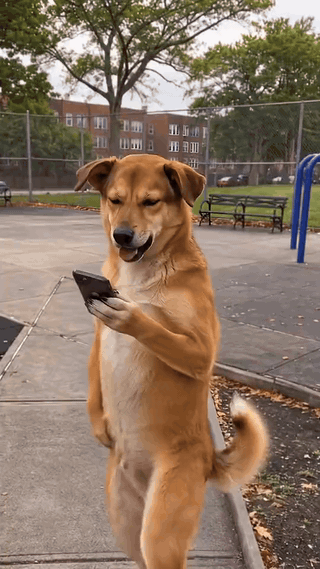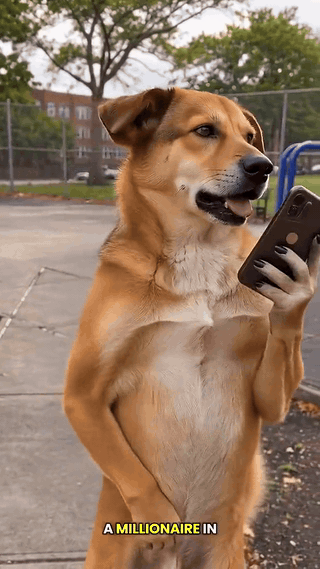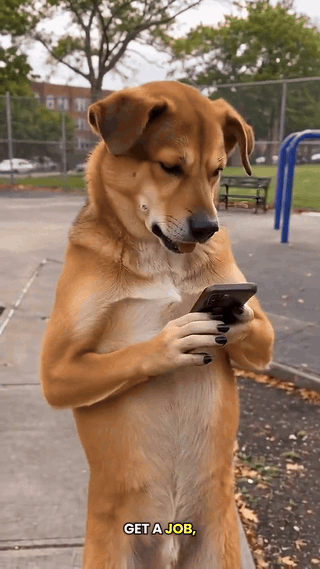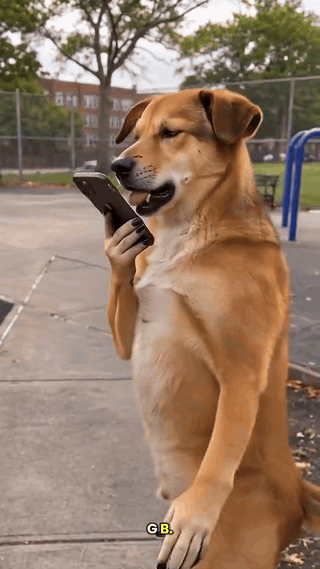
オンライン例、ペットバージョン。パフォーマンスは、直立した姿勢、読み取れる電話のジェスチャー、そして遅れて現れる気分を害した表情に依存しています。
これらは流通しているビデオフォーマットの例であり、特定のチャットボットの応答を確立する録画ではありません。コメディスケッチはやり取りを演出でき、AIリメイクは演者を生成できます。「how I become」というフレーズは、検索されるミームの一部であるためここで保持されていますが、「how do I become」が通常の英語です。どちらのフレーズもビデオを金融アドバイスにするものではありません。
認識させる4つのビート
| ビート | 視聴者が見るもの | なぜ重要か |
|---|---|---|
| 質問する | 秘密を明かせるかのように電話を掲げる | キャラクターの自信が過大な期待を設定します。 |
| 返答 | 「仕事に就け」が表示されるか読み上げられる | 答えは意図的に単純で短いです。 |
| リアクション | キャラクターが固まり、見上げる、またはカメラを見つめる | 間により、観客はキャラクターと一緒に侮辱を発見できます。 |
| 再度質問する | 素早いタイピングまたは別の音声メッセージ | キャラクターは平凡な答えを拒否し、ジョークを延長します。 |
順序は正確なショットの長さよりも重要です。視聴者が質問を理解する前に返答が来ると、コントラストがありません。リアクションがすぐに切られると、オチには息をつく余地がありません。キャラクターが単に歩き去るだけなら、クリップはこのフォーマットを特徴づける頑固な2度目の試みを失います。
自分だけのバージョンを作るには?
ジョークの構造から始めて、パフォーマンス、設定、結末を変えます。他人の映像をショットごとに再生すると、結果の区別が難しくなり、ダイアログの制御が減ります。私たちのデモでは、1人の架空の子供を日当たりの良い遊び場に配置します。子供は明朗な楽観主義で百万長者への近道を尋ね、次にぶっきらぼうな「仕事に就け」という返答に直面します。そのアドバイスは子供にとって意図的に不条理であり、喜びから不信への変化がジョークを運びます。電話の画面は子供の方を向いているので、モデルはアプリのボタンや読み取れるメッセージを発明する必要がありません。
有用な設計上の制約は、パフォーマンスとテキストを分離することです。ビデオモデルは、人が電話を掲げ、読み、たじろぎ、タイピングするのをアニメーション化できます。動いている電話に正確なチャットテキストをレンダリングするのはあまり信頼できません。したがって、最初に演技を生成し、後でクリーンな編集用キャプションを追加します。キャプションはジョークの台本のセリフを報告するものであり、実際のChatGPTセッションのスクリーンショットとして提示されるものではありません。
1. 一貫した最初のフレームを構築する
子供の顔、両手、電話が見える横長16:9の画像を使用します。腰から上の構図は、子供の後ろのカラフルな滑り台やブランコを失うことなく、表情が変化する余地を残します。キャプション用にいくらかの整理されたスペースを残します。最初のフレームは、すでにショックを受けているというよりも、希望に満ちているように見えるべきです。
この記事では、最初のフレームはAtlas CloudのSeedream v5.0 Proで生成されています。プロンプトは意図的に具体的です:
plaintext1Photorealistic 16:9 opening frame for a light comedy video. One fictional child around 10 years old stands in a colorful neighborhood playground on a sunny late afternoon. The child has curly dark hair, a yellow windbreaker over a blue T-shirt, and holds one smartphone near their mouth. Show the child from the waist up, with both hands visible. Their face is large and clear: bright eyes, raised eyebrows, and a wide, hopeful grin, as if they are about to ask for a secret way to become a millionaire. Place a red slide, teal climbing frame, swings, trees, and colorful playground flooring at different depths. Eye-level camera, natural warm light, realistic anatomy. Leave some open space on the right for captions. The phone screen faces the child. No other people, readable text, app interface, logos, or watermark.
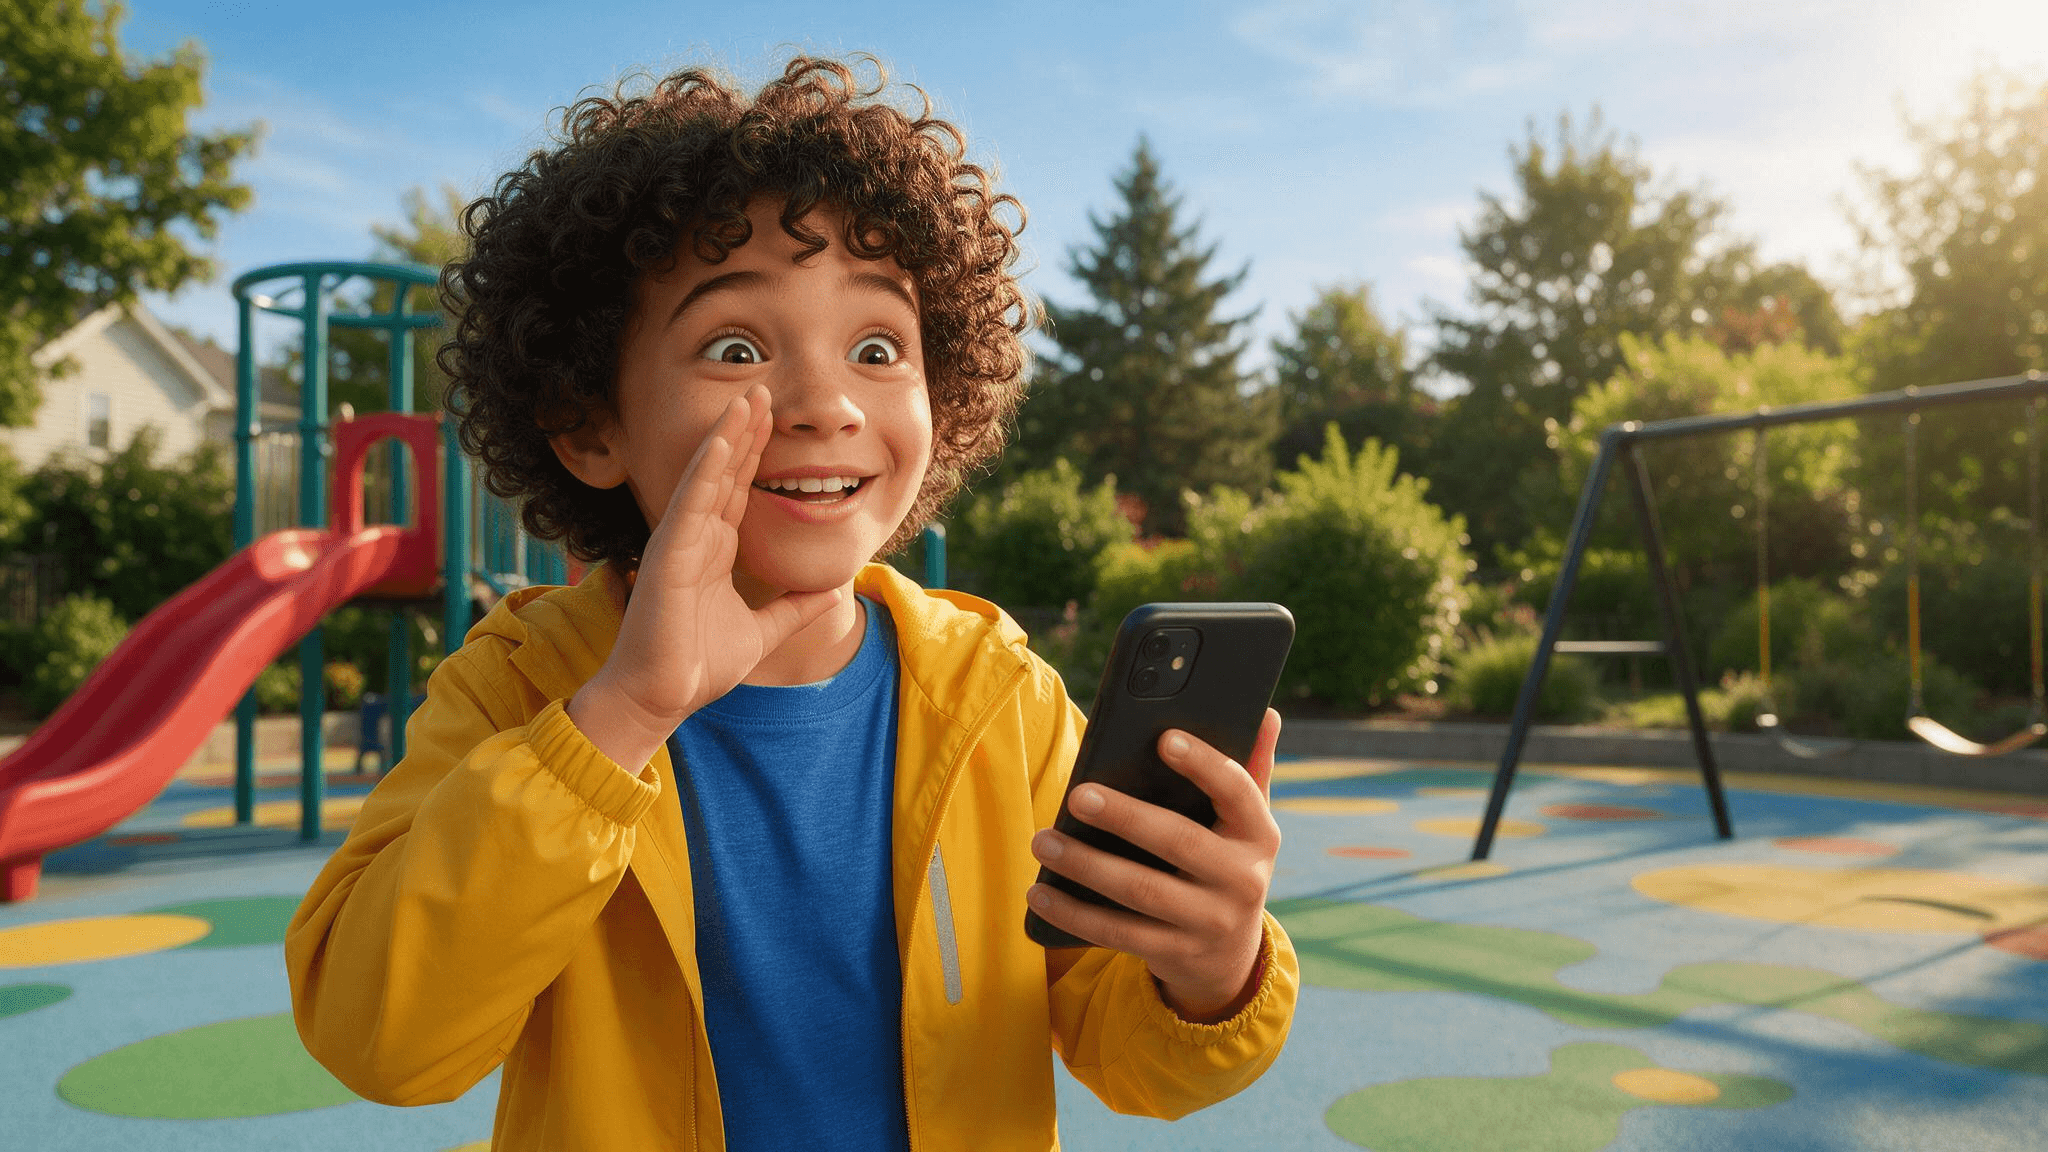
生成された開始フレーム。子供の広い笑顔と上がった眉が希望に満ちたオープニングを確立し、滑り台とブランコが新しい設定を紛れもなくします。
2. 動く肖像画ではなく、完全なリアクションをアニメーション化する
最初のフレームをAtlas CloudのSeedance 2.5 Image-to-Videoの画像入力として使用します。ターゲットを26秒、横長16:9、サウンド付きに設定します。プロンプトは、異なる表情のリアクションのシーケンスを要求します。モデルにチャットバブルを表示したり、オチを綴ったりするようには求めません。なぜなら、それらの正確な言葉は編集で追加されるからです。
plaintext1Use the uploaded image as the first frame and visual reference. Create one continuous 26-second, 16:9 video in the same sunny playground. Keep exactly the same child throughout: approximately ten years old, curly dark hair, yellow windbreaker over a blue T-shirt, holding the same black smartphone. Preserve the child's face, hairstyle, clothing, body proportions, and the playground layout: red slide, teal climbing frame, swings, trees, and colorful rubber ground. Do not add other people or change locations. The story is a playful reaction to asking a phone how to become a millionaire in 30 days. Show the story through the child's changing expressions and actions; do not render readable text on the phone. Begin with the child smiling hopefully, shifting their weight, raising the phone, and tapping in a question. As they read the first reply, let the smile gradually disappear: their eyes track the screen, eyebrows lift, the phone lowers slightly, and they lean back in surprise. The surprised expression lasts only a moment. Without pausing, they blink, turn their head slightly, glance toward the camera, then look back at the phone with an annoyed frown. They take a small sideways step, adjust their grip, and actively type a second question with both thumbs. Their expression softens into an exaggerated, hopeful plea. They tilt the phone closer, gesture once with their free hand, and keep shifting naturally on their feet. After reading the second reply, their eyebrows rise, then fall. They lower the phone, give one brief exasperated shrug with an open palm, shake their head slightly, and end with a disbelieving look toward the camera while still blinking and moving naturally. Keep each reaction connected to the next through visible head, hand, shoulder, eye, and body movement. There must be meaningful motion throughout the entire clip, especially from seconds 9 to 18. No held pose, frozen reaction, repeated frames, motion loop, or long motionless stare. Use a gentle handheld camera that subtly moves sideways with the child while keeping them clearly framed. No scene cuts, sudden camera jumps, pure zoom-in, character changes, extra fingers or limbs, changing clothes, or changing playground objects. Natural late-afternoon light and realistic playground ambience.
配信されたクリップは感情の変化を追いやすくします。子供はにっこり笑って始まり、最初の返答に驚いて口を開け、眉をひそめ、別の質問をタイプし、最後に腹立たしい肩すくめをします。下の追加のスチルは、平凡な答えが子供の百万長者計画を覆す瞬間を切り出しています。
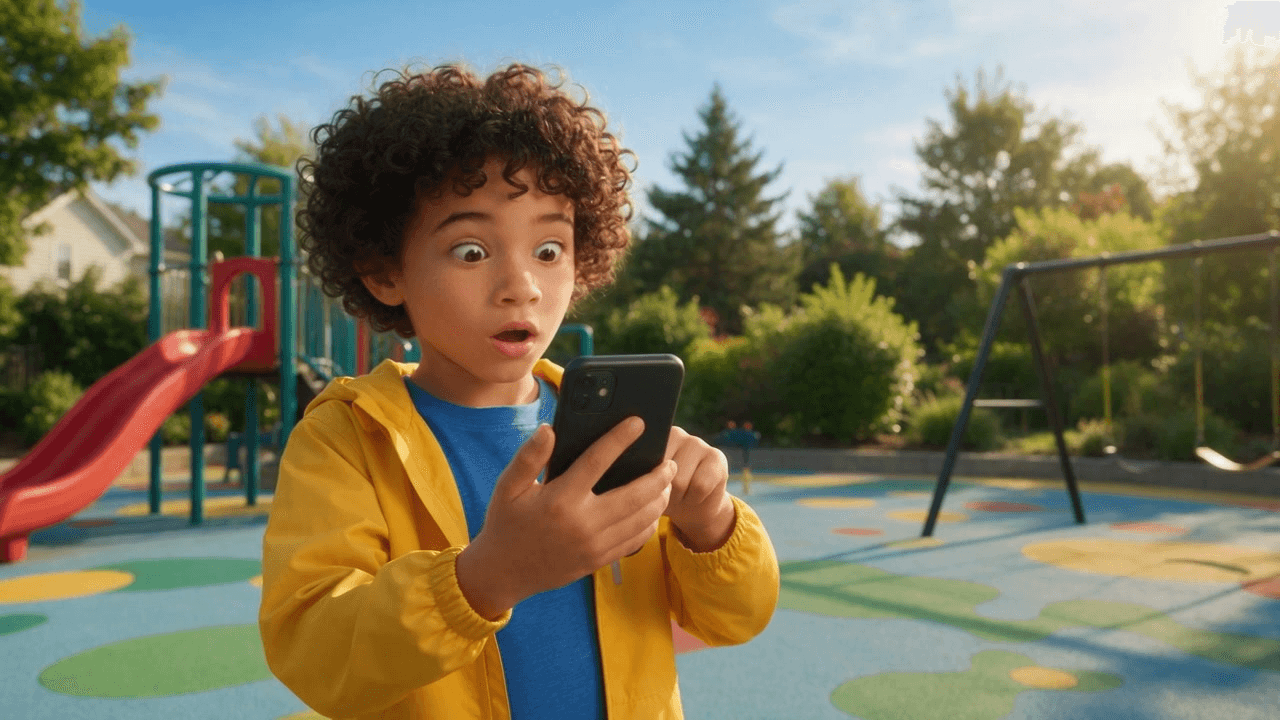
生成されたビデオの約6秒のフレーム。希望に満ちた最初の画像と比較して、見開かれた目と開いた口がオチの効果をすぐに目に見えるようにします。
3. 正確なダイアログを追加し、サウンドなしでもジョークを読めるようにする
短い台本で十分です。子供が電話に話しかける間に質問を画面に表示し、子供が返答を読むときにのみ「仕事に就け」を出し、抗議の前に間を置きます。フォローアップには、冒頭を逐語的に繰り返すのではなく、新しい質問を使用します。字幕は一貫した安全な領域に配置し、強いコントラストを持たせ、顔や手を決して覆わないようにします。
| 26秒のカットの瞬間 | 編集用キャプション | パフォーマンスの手がかり |
|---|---|---|
| オープニング | 「30日で百万長者になるには?」 | 明るく、確信を持って電話に話す。 |
| 返答 | 「仕事に就け。」 | 目が画面に落ち、笑顔が消える。 |
| リアクション | 「本気で?」 | 驚きがタイピングの前に眉をひそめる。 |
| 2度目の試み | 「わかった、でもその部分を飛ばしたら?」 | 電話が再び上がり、口調が懇願するようになる。 |
一瞥で読めるほど短く書いてください。アプリによって生成された行を証明するために、リアルなチャットのスクリーンショットを捏造しないでください。明確にデザインされたキャプションは、台本のやり取りを正直に伝え、16:9のクリップをサウンドオフでも理解できるようにします。元のオーディオはビデオに残ります。表示される4行は編集用キャプションです。
4. エクスポート、検査、ラベル付け
ソースクリップをいくつかの記事埋め込みにカットするのではなく、1つの連続したMP4をエクスポートします。エクスポート後に実際の長さを確認します。要求された26秒は、ファイルが本当に20秒より長く、余分な時間に意味のあるアクションが含まれている場合にのみ重要です。この記事では、最終的なオリジナル例がポスターフレーム付きで以下に埋め込まれており、読者は完成したシーケンスをその場で見ることができます。
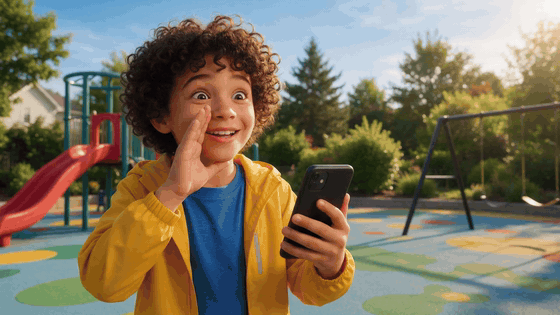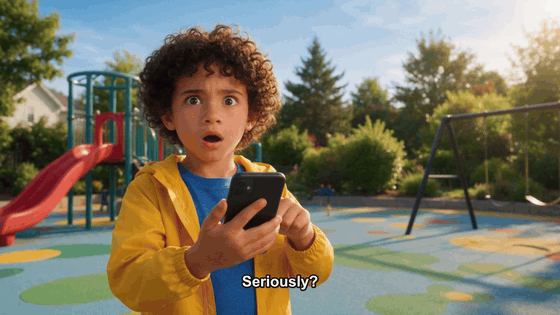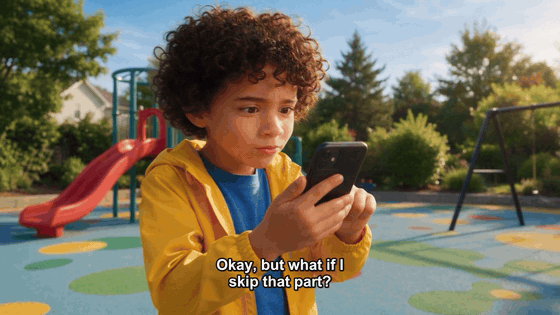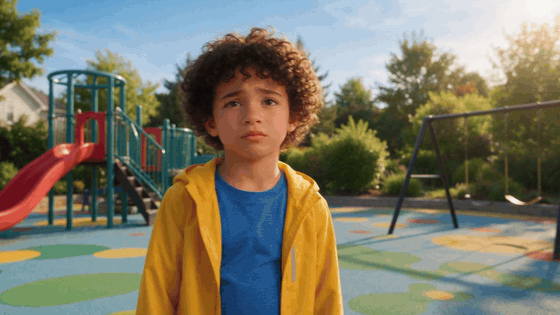
私たちのオリジナル例:遊び場の子供が尋ね、ぶっきらぼうな返答を受け取り、信じられない様子で見つめ、タイプし、1本の26秒の横長ビデオでもう一度試みます。字幕は生成されたパフォーマンスへの編集上の追加です。
AI生成のリアルなシーンを投稿する前に、該当する場合はプラットフォームのAIコンテンツラベルを使用してください。TikTokのAI生成コンテンツガイダンスは、リアルなAIメディアのラベル付けツールと要件を説明しています。YouTubeの改変または合成コンテンツに関するガイダンスは、アップロード時の開示について説明しています。自分の肖像、架空のキャラクター、または出演に同意した参加者を使用してください。上記の2つのオンラインGIFは分析用の例です。リメイクを公開するには、自分の映像、音声、許可が必要です。
長いカットでオチを決めるには?
26秒のバージョンには、13秒のミームを2つコピーした以上のものが必要です。子供に目に見える戦略の変化を与えます。最初は、電話は近道マシンのように扱われます。返答の後、子供は単に要求を繰り返すのではなく、眉をひそめ、タイプし、言い換え、答えと交渉しようとします。その変化が最後のビートを埋め草ではなく新しいジョークに変えます。
サウンドオフでの読みやすさも編集を変えます。フィードでは、視聴者はミュートでクリップに出会うかもしれません。キャプションは正しい瞬間に質問と返答を明らかにする必要があり、俳優の動きが感情を提供します。遅れて表示される「本気で?」のキャプションは、最初の呆然としたフレームの間には表示されるべきではありません。静かな視線が先に来ます。その小さな間で、視聴者は顔を読み取ります。
最後に、設定を正直に保ちます。ビデオは演出されたコメディシーンであり、セリフは台本に基づくギャグです。実際のチャットボットセッションを示したり、誰でも30日で金持ちになれると約束するものではありません。次の有用なアクションは、オリジナルの演者と設定を選び、4つのビートを絵コンテ化し、サウンドをオフにした状態で誰かがあなたのドラフトを理解できるかテストすることです。彼らが質問と気分を害した2度目の試みの両方を特定できれば、フォーマットは機能しています。
よくある質問
チャットボットは本当に「仕事に就け」と答えたのか?
このフレーズはコメディフォーマットのオチです。それを示すビデオは、実際のチャットボットのやり取りや、常に受け取る応答の証拠ではありません。
ペットや友人でミームを作ることはできますか?
はい、適切な写真と、写っている人からの許可があれば可能です。ペットバージョンには、はっきりした目、口吻、毛の模様が必要です。友人のバージョンには、はっきりした顔と、セリフを言うところを描写されることへの同意が必要です。
なぜビデオモデルを使ってから、別途キャプションを追加するのか?
モデルは動きと演技を処理し、編集者は正確なテキストを処理します。これらの仕事を分離することで、文字化けした電話画面を避け、オチのタイミングを制御できます。
ここでのオリジナル例は20秒を超えていますか?
はい。配信されたMP4は、ジェネレーターで選択された長さだけに依存するのではなく、エクスポート後に検証されます。余分な時間は、2度目の試みと最終的なリアクションに使用されます。





