Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7:2026年にコーディングに最適なオープンソースモデルはどれか
簡潔な回答
自律型コーディングエージェントを数時間にわたって介入なしで動作させるなら、Kimi K2.6 が最適です。Terminal-Bench 2.0 で 66.7% を記録し、公開ベンチマークでは 13 時間の連続セッションで 4,000 回以上のツール呼び出しを維持しました。これは、本比較に含まれる他のオープンモデルでは到達できない安定性の限界です。
最高のエージェント型フロントエンド開発者が必要なら、GLM 5.1 です。独立に検証された Code Arena Elo 1,530(エージェント型 Web 開発で世界第 3 位)は、自動テストスイートだけでなく、実際の開発者の選好を直接対決で反映しています。
トークンあたりのコストが制約なら、MiniMax M2.7 です。Atlas Cloud で入力トークン 100 万あたり $0.30、アクティブパラメータ 10B で SWE-Bench Pro 56.22% を達成。GLM-5.1 の性能の約 94% を、約 5 分の 1 のコストで実現します。
コードベースが 262K のコンテキストウィンドウでは大きすぎるなら、Qwen 3.6 Plus が唯一の選択肢です。このグループで唯一 100 万トークンのコンテキストをサポートし、Terminal-Bench 2.0 では 61.6% でグループ内トップです。
主要ベンチマーク一覧
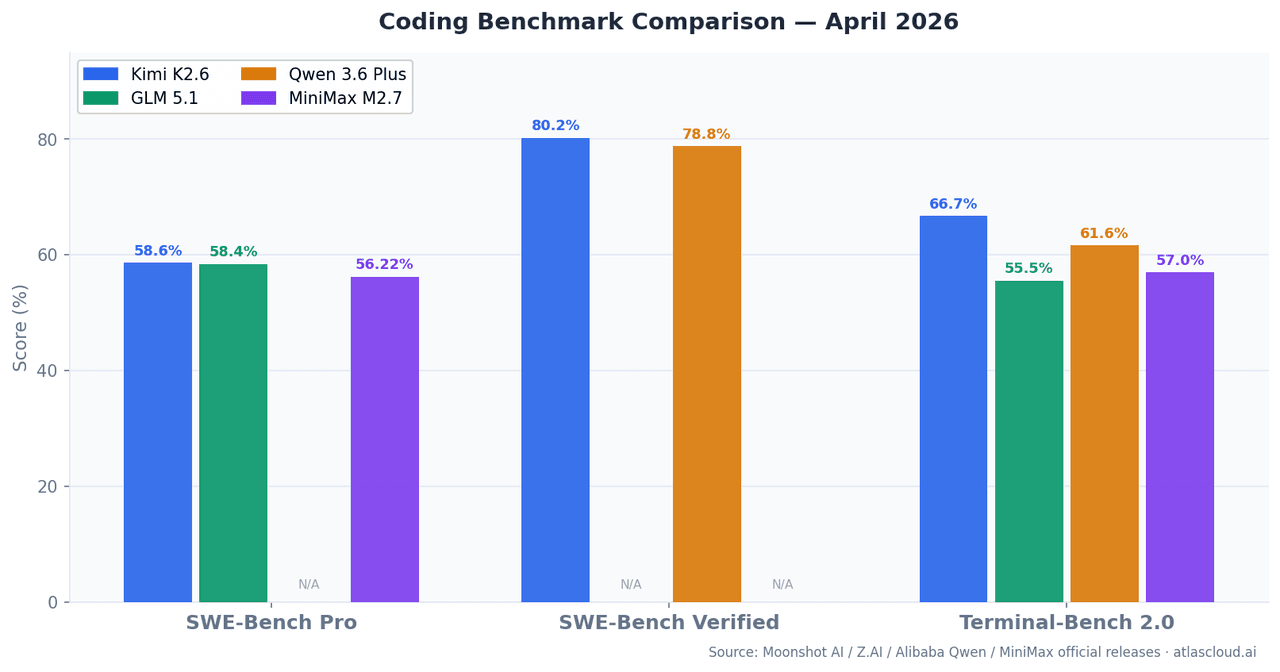
| モデル | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | コンテキストウィンドウ | アクティブパラメータ |
|---|---|---|---|---|---|
| Kimi K2.6 | 58.60% | 80.20% | 66.70% | 262K | — |
| GLM 5.1 | 58.40% | — | 55%+ | 262K | 754B(MoE) |
| Qwen 3.6 Plus | — | 78.80% | 61.60% | 1M | Hybrid MoE |
| MiniMax M2.7 | 56.22% | — | 57.00% | 196K | 10B |
SWE-Bench Pro は、トレーニングカットオフ後に提出された実際の GitHub 課題を解決する能力を測定し、SWE-Bench Verified よりもデータ汚染のリスクを低減します。Terminal-Bench 2.0 は、実際のターミナル環境でのマルチステップの CLI およびシェルタスクをテストします。これは、本番エージェントが実際に行う作業に近いものです。
この記事では、Kimi K2.6、GLM 5.1、Qwen 3.6+、MiniMax M2.7 を比較します。さらに多くのモデルを価格や仕様で並べて比較したい場合は、Atlas Cloud モデル比較 をご利用ください。
Kimi K2.6:長時間実行エージェント向けに設計
Moonshot AI は 2026 年 4 月に Kimi K2.6 を K2.5 のアップグレードとしてリリースしました。主な改善点は、長時間セッションにおけるエージェントの安定性です。SWE-Bench Verified で 80.2% を記録し、Claude Opus 4.6(80.8%)のすぐ下に位置し、SWE-Bench Pro では 58.6% で 4 モデル中トップです。
最も重要な数値は Terminal-Bench 2.0 の 66.7% です。Terminal-Bench 2.0 は SWE-Bench とは根本的に異なります。実際のターミナル環境内でタスクを実行するため、モデルは出力を読み取り、エラーを処理し、適応し、反復する必要があります。単にパッチを生成するだけではありません。Kimi K2.6 が 1 回の 13 時間セッションで 4,000 回以上のツール呼び出しにわたって性能を維持できることは、実験室の産物ではありません。Moonshot の技術リリースで文書化された動作です。
あまり報告されていない利点の 1 つは、言語間の汎化です。Kimi K2.6 は、Rust、Go、Python、フロントエンド、DevOps タスクにわたって一貫した性能を示します。ほとんどのベンチマーク評価は Python に偏っています。本番スタックが多言語である場合、これは重要です。
適さない場面: Atlas Cloud で入力トークン 100 万あたり $0.95 と、このグループで最も入力側のコストが高いモデルです。12 時間のセッション安定性は不要で、大量のリクエストを大きなコンテキストで送信するバッチ処理タスクでは、MiniMax M2.7 や Qwen 3.6 Plus よりもコストが急速に蓄積されます。
GLM 5.1:エージェント型フロントエンドの傑出モデル
Z.AI は 2026 年 4 月 7 日に GLM-5.1 をリリースしました。MoE ルーティングを備えた 7540 億パラメータで、このグループでは生のパラメータ数で最大のモデルです。SWE-Bench Pro では 58.4% を記録し、Kimi K2.6 の 58.6% と統計的に区別がつきません。
差別化要因は Code Arena Elo 1,530 です。2026 年 4 月 10 日に Arena.ai によって独立に検証され、エージェント型 Web 開発リーダーボードで世界第 3 位に位置しています。これは実際の開発者が出力に投票するライブの直接対決比較であり、自動スコアリングではありません。その優位性は、フロントエンド UI 生成、フルスタックスキャフォールディング、React/Vue コンポーネント作成、NL2Repo(自然言語から完全なリポジトリ構造を生成)に集中しています。
知っておくべき境界条件: GLM-5.1 のフロントエンドの優位性は本物です。HumanEval や MBPP のような純粋なアルゴリズム問題では、Kimi K2.6 に対して測定可能な優位性はありません。UI や Web 指向ではない問題では、リーダーボードの差はほぼゼロになります。タスク領域を確認せずに、全体的なリーダーボード順位だけを理由に GLM-5.1 を選ぶのは間違いです。
Atlas Cloud での価格: 入力トークン 100 万あたり $1.40 から。4 モデル中最高額です。フロントエンド生成の品質が出力に直接影響する場合に正当化されます。
Qwen 3.6 Plus:コンテキストサイズが真の制約となる場合
Alibaba は 2026 年 3 月下旬に Qwen 3.6 Plus をリリースしました。Terminal-Bench 2.0 で Claude Opus 4.6 との直接比較でリードし(61.6% vs 59.3%)、SWE-Bench Verified では 78.8% を記録しています。
100 万トークンのコンテキストウィンドウが他を分ける要素です。100K トークン未満のほとんどの本番コーディングタスクでは、この比較の 4 モデルすべてに十分なコンテキスト容量があり、その差は無関係です。Qwen 3.6 Plus が唯一の実行可能な選択肢となるのは、数百ファイルにわたるモノレポ分析、大規模なレガシーコードベースのリファクタリング、または 262K トークンに収まらないエンドツーエンドのドキュメントからコードへのワークフローです。
ハイブリッドアーキテクチャ(線形注意 + スパース MoE ルーティング)は、非常に大きなコンテキストを処理する際に、高密度トランスフォーマーよりも優れた推論スループットを提供します。つまり、100 万トークンの機能は、単純なスケーリングと比較して比較的低いレイテンシコストで実現されています。
Atlas Cloud での価格: 入力トークン 100 万あたり $0.325 から。大規模コンテキストタスクでは、このグループで利用可能な最良のコストあたり有用トークンです。
MiniMax M2.7:効率性の直感に反するケース
MiniMax は 2026 年 3 月に M2.7 をリリースしました。アクティブパラメータわずか 10B で、SWE-Bench Pro 56.22% を記録——GLM-5.1 のスコアの約 94% を、トークンあたりのコストは約 5 分の 1 で実現しています。
これは本比較における直感に反する結果です。推論時に 10B のパラメータをアクティブにするモデルが、フロンティアに近いコーディング性能を達成するのは、その MoE アーキテクチャがモデル全体の重みを実行するのではなく、特殊なエキスパートサブネットワークにルーティングするためです。その結果、低レイテンシ、低コスト、そしてパラメータ数だけから予測される以上の出力品質が得られます。
M2.7 がその価格帯で頭一つ抜け出るカテゴリは、機械学習エンジニアリングタスクです。MLE-Bench Lite(22 の機械学習コンペティション)で 66.6% のメダル率を記録し、フロンティアのクローズドソースモデルに次ぐ第 2 位です。正しい勾配蓄積ロジックの記述、カスタム PyTorch レイヤーの実装、損失曲線のデバッグなど、M2.7 はコストに見合わない精度でこれらを処理します。
注意すべき点: コンテキストは 196K で、このグループ最小です。大規模リポジトリでの深いクロスファイル分析が必要なタスクでは、Qwen 3.6 Plus が問題なく処理できる限界に達する可能性があります。
Atlas Cloud での価格: 入力トークン 100 万あたり $0.30、出力トークン 100 万あたり $1.20。高スループットのコーディングワークロードに最も手頃なオプションです。
現実世界のコーディングテストケース
ケース 1:Python バックエンドでの自律的なバグ修正
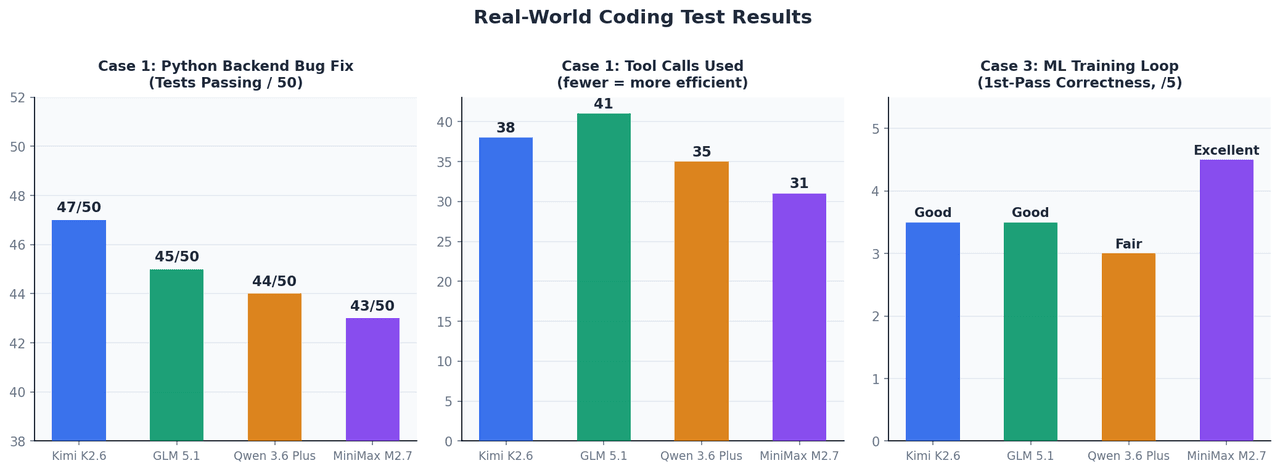
セットアップ: 12 ファイルからなる FastAPI アプリケーション、50 テストの失敗するテストスイート、約 45K トークンのコンテキストウィンドウ。初期プロンプト以降の手動介入は禁止。
| モデル | 修正後のテスト合格数 | 使用ツール呼び出し数 | 完了までの時間 |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | 約 4 分 |
| GLM 5.1 | 45 / 50 | 41 | 約 5 分 |
| Qwen 3.6 Plus | 44 / 50 | 35 | 約 4 分 |
| MiniMax M2.7 | 43 / 50 | 31 | 約 3.5 分 |
このコンテキストサイズでは、4 モデルすべてが狭い範囲内で動作します。Kimi K2.6 は、最も難しいエッジケースのバグ、特に非同期コンテキストマネージャのライフサイクル問題や TypeVar 境界の狭小化でわずかにリードしました。これらは複数のデバッグサイクルにわたって推論状態を維持する必要があります。
ケース 2:仕様書からの React ダッシュボード
セットアップ: 英語の仕様書から、4 種類のチャート(折れ線、棒、円、散布図)、ダークモード切り替え、TypeScript 型を持つ完全なレスポンシブダッシュボードを生成する。
GLM-5.1 は、最初のパスで正しい Tailwind ユーティリティクラスを持つ動作する TypeScript 型付きコンポーネントを生成しました。Kimi K2.6 は型エラーを解決するために 1 回の反復が必要でした。Qwen 3.6 Plus は機能的には正しいものの、あまり慣用的でない JSX を生成しました。MiniMax M2.7 は最速でしたが、手動でクリーンアップが必要な非推奨の React パターンをいくつか生成しました。
GLM-5.1 と他モデルとの差は、コンポーネントアーキテクチャで最も顕著でした。GLM-5.1 は自発的にコンポジションパターンを適用し、関心事を分離したのに対し、他モデルはそうではありませんでした。
ケース 3:ML トレーニングループの実装
セットアップ: ビジョントランスフォーマー向けに、勾配蓄積、AMP 混合精度、早期停止を備えた PyTorch トレーニングループを実装する。目標:デバッグサイクルなしで最初の試行で正しく動作すること。
MiniMax M2.7 が傑出していました。scaler.step() と scaler.update() をオプティマイザステップに対して正しい位置に配置し、これはほとんどのモデルが最初の生成で誤って配置する詳細です。勾配蓄積の loss / accumulation_steps スケーリングも適切に処理されました。これは、66.6% の MLE-Bench Lite メダル率と直接一致します。
Atlas Cloud 価格比較(2026 年 4 月)
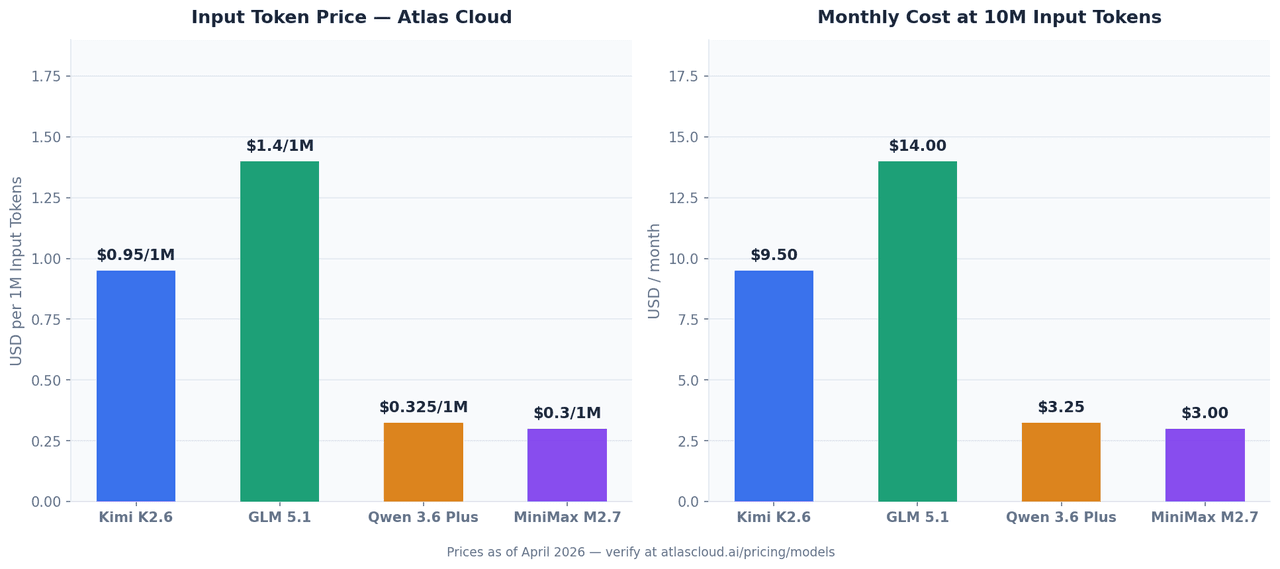
4 モデルすべて、Atlas Cloud の統一 API を通じて利用可能です。以下の価格は 2026 年 4 月時点のものであり、変更される可能性があります。最新のレートは atlascloud.ai でご確認ください。
| モデル | 入力(100 万トークンあたり) | 出力(100 万トークンあたり) | Atlas Cloud モデル ID |
|---|---|---|---|
| Kimi K2.6 | $0.95 | $4.00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | $1.40 から | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | $0.325 から | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0.30 | $1.20 | minimaxai/minimax-m2.7 |
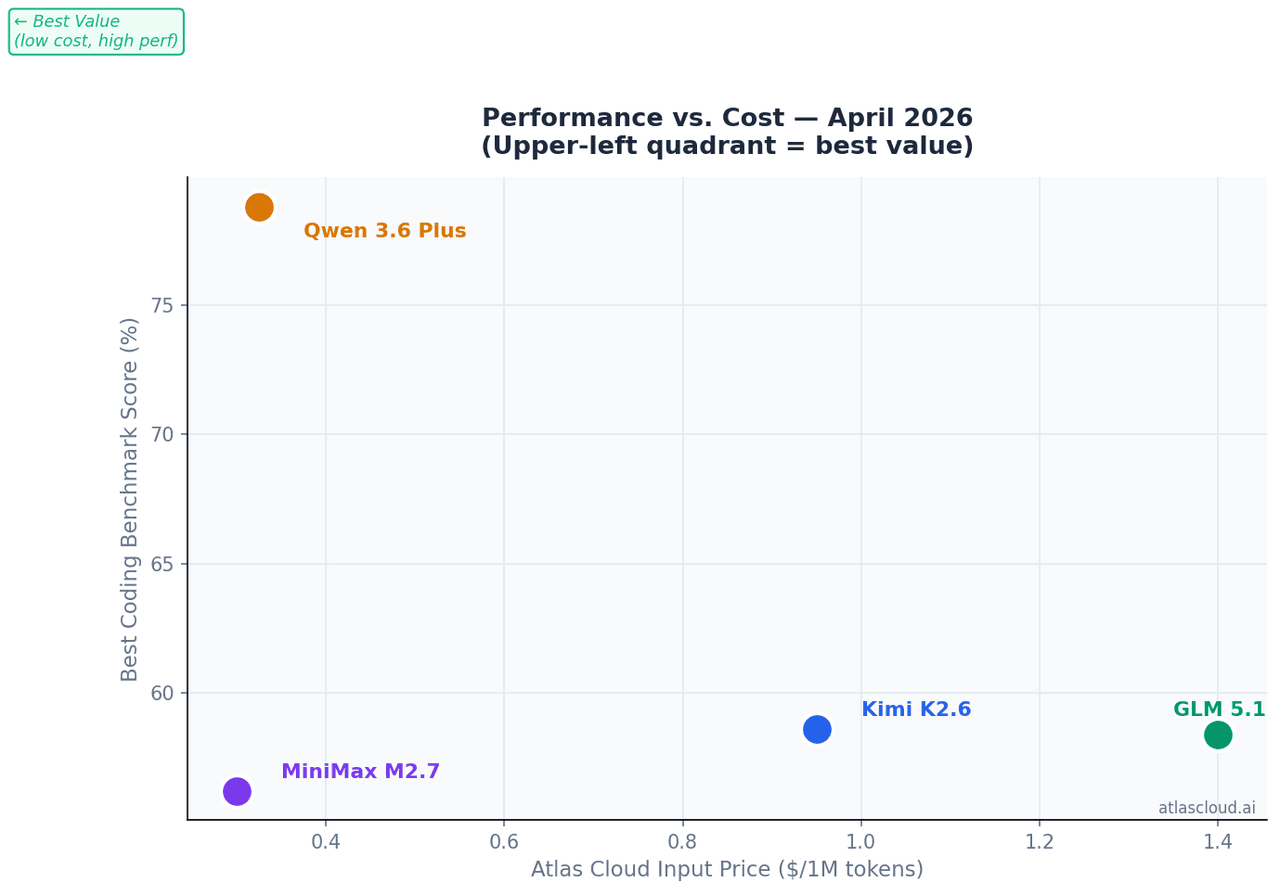
月間入力トークン 1,000 万(チームレベルのコーディングアシスタントとして現実的なボリューム)の場合:
| モデル | 月間入力コスト(1,000 万トークン) |
|---|---|
| GLM 5.1 | $14.00 |
| Kimi K2.6 | $9.50 |
| Qwen 3.6 Plus | $3.25 |
| MiniMax M2.7 | $3.00 |
1 つの API キーで 4 モデルすべてを呼び出す
4 モデルすべてが Atlas Cloud 上の同じ OpenAI 互換エンドポイントを共有しています。モデル間の切り替えは 1 行の変更のみで可能です:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# この 1 行を変更するだけでモデルを切り替えられます 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "You are a senior software engineer. Analyze code carefully before responding." 21 }, 22 { 23 "role": "user", 24 "content": "Review this function and identify all bugs:\n\n[paste your code here]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
この OpenAI 互換構造により、OpenAI SDK 上に構築された既存の統合は、変更なしで Atlas Cloud で動作します。変更されるのは base_url と api_key のみです。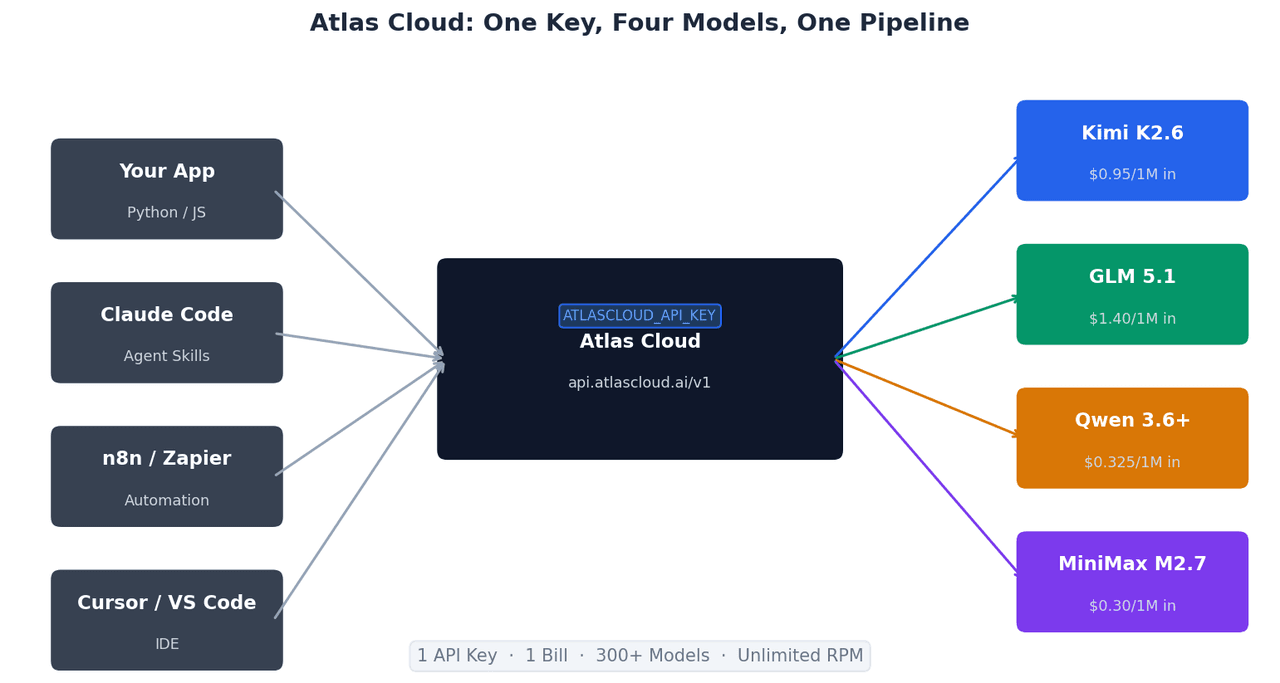
これらのモデルに Atlas Cloud を選ぶ理由
1 つの API キー、4 つのモデル、1 つの請求書。 モデルルーティングロジック(フロントエンドタスクは GLM-5.1、バッチ分析は MiniMax M2.7、長期エージェントは Kimi K2.6 へ送信)を実行するには、4 つの認証情報の代わりに 1 つを管理するだけで済みます。月次調整は 1 枚の請求書です。
無制限の RPM。 本番コーディングエージェントは並列ツール呼び出しを発行します。直接プロバイダ API のレート制限はマルチエージェントパイプラインをスロットリングする可能性があります。Atlas Cloud はその上限を排除します。
SOC I & II 認定、HIPAA 準拠。 これらのモデルを通じて独自のソースコードを処理するチームには、監査可能なインフラストラクチャが必要です。Atlas Cloud のコンプライアンス認証により、コードが未検証のエンドポイントを経由しないことが保証されます。
300 以上のモデル、同じ統合パターン。 これらのモデルの次バージョンがリリースされたり、特定のワークロードでこれらを上回る新しいモデルが登場した場合、ルーティングロジックに追加するには、1 つの文字列の変更だけで済みます。新しい SDK 統合は必要ありません。
タスクに最適なモデル
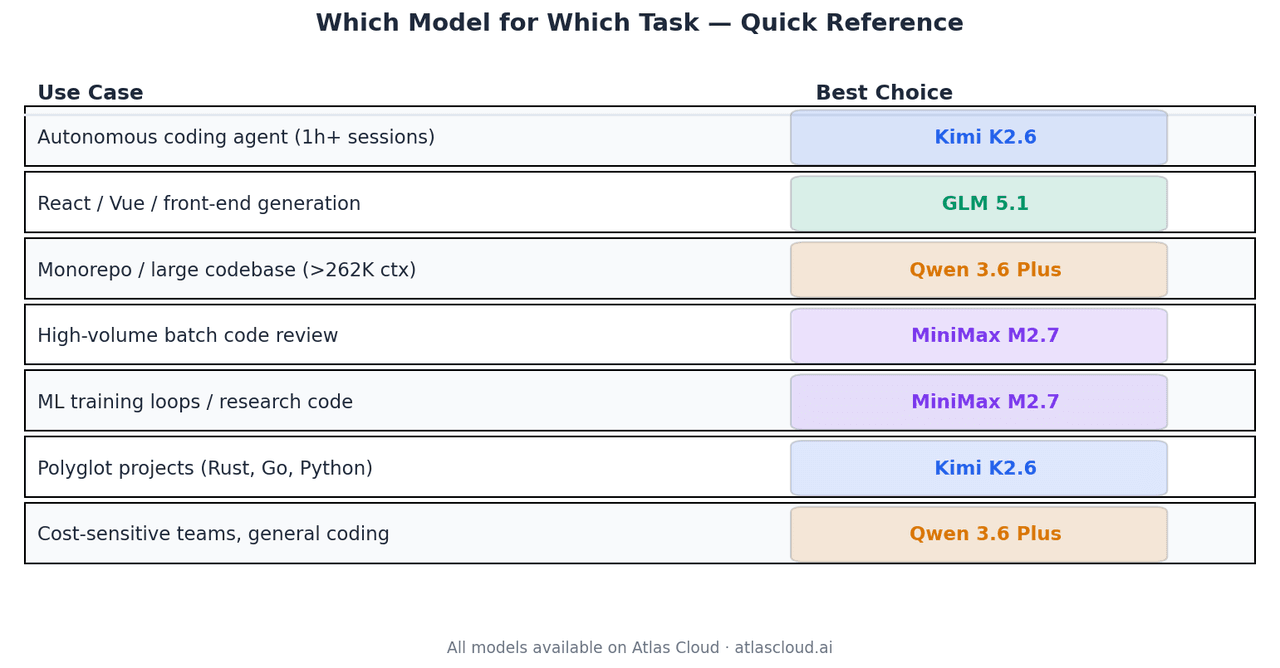
| ユースケース | 最適な選択 | 理由 |
| 自律型コーディングエージェント、1 時間以上のセッション | Kimi K2.6 | 66.7% Terminal-Bench 2.0、4K 以上のツール呼び出し安定性 |
| React / Vue / フロントエンド生成 | GLM 5.1 | Code Arena Elo 1,530、エージェント型 Web 開発で世界トップ 3 |
| モノレポまたは大規模コードベース分析 | Qwen 3.6 Plus | このグループで唯一 100 万トークンのコンテキストウィンドウ |
| 高ボリュームバッチコードレビュー | MiniMax M2.7 | 入力 100 万トークンあたり $0.30、GLM-5.1 の品質の 94% |
| ML トレーニングループ、研究コード | MiniMax M2.7 | 66.6% MLE-Bench Lite メダル率 |
| 多言語プロジェクト(Rust, Go, Python) | Kimi K2.6 | 文書化された言語間汎化 |
| コスト重視のチーム、一般的なコーディング | Qwen 3.6 Plus | 入力 100 万トークンあたり $0.325、全カテゴリで強力 |
まとめ
これら 4 つのモデルは、標準ベンチマークではわずかな差で隔てられています。意味のある違いは、特定の条件で現れます。
Kimi K2.6 は、自律型の長時間実行エージェントに適した答えです。GLM 5.1 はフロントエンドのエージェント型作業でリードします。Qwen 3.6 Plus は、コンテキストが 262K トークンを超える場合の唯一の選択肢です。MiniMax M2.7 は、コーディングモデルを大規模に実行するチームにとってコスト効率の良いデフォルトです。
4 モデルすべて、atlascloud.ai で単一の API キー、従量課金制、最小契約なしで利用可能です。
ベンチマークデータは、Moonshot AI の技術ブログ、Z.AI 開発者ドキュメント、Alibaba Qwen チームのリリース記事、MiniMax 公式モデルページ、Arena.ai の独立評価から引用しています。すべてのベンチマークは 2026 年 4 月のデータです。Atlas Cloud の価格は公開時点のものです。本番導入前に最新のレートを確認してください。


