


2人がテーブルを挟んで座っている。1人が話し始めると、両方の口が動く。切り返しが来ると、声がもう顔に貼り付いているようには感じられない。これが、クリエイターが Kling 4 対話リップシンクテスト を検索するときに避けようとしている失敗だ。
Kling 4.0 がローンチしました。Atlas Cloud の Kling 4.0 モデルファミリー で現在のモデルオプションを確認してください。
この記事はバージョンチェックから始まり、検証済みの Kling 3.0 ファミリーで3つの短く再現可能な対話テストを実行します。1人の話者、2人が交代で話すケース、英語とスペイン語を混ぜたやり取りです。各テストでは生成時にネイティブ音声を使用し、記事は視覚結果をGIFで表示するとともに、同じ10点スコアカードを示します。これらは個別の実行であり、普遍的なベンチマークではありません。
主なポイント
- Kling 4.0 は2026年10月15日に正式ローンチしました。この記事の3つのクリップは Kling 3.0 で生成されています。
- 短く、名前付きで、ターン制のセリフは、レビュアーが話者割り当てを確認するためのより明確な根拠を与えます。
- GIF は顔の動きと話者の受け渡しをすばやく確認できますが、音のタイミングを検証するには元の MP4 が依然として必要です。
- 10秒の実行は、より要求の厳しい制作版に投資する前のスクリプトチェックとして扱ってください。
- 話している人と同じくらい、黙っている聞き手も注意深く確認してください。
Kling 4 対話リップシンクテスト:まずバージョンチェック
Kling 4.0 は2026年10月15日に正式ローンチしました。この記事の3つの対話クリップは検証済みの Kling 3.0 ルートでレンダリングされたため、Kling 4.0 のリップシンク性能の証明ではなく、再現可能なベースラインにとどまります。スコアカードを繰り返す前に、選択した V4 モデルとその現在のコントロールを確認してください。
検証可能な現在の基準点は Kling AI 3.0 です。Kuaishou は2026年2月5日に Video 3.0、Video 3.0 Omni、Image 3.0、Image 3.0 Omni ファミリーを発表しました。発表では、言語、方言、アクセントをまたぐネイティブ音声、発話順を制御した対話シーン、マルチショット演出、最大15秒の動画長が説明されています(Kuaishou Technology、2026年2月)。
その製品主張は有用なテスト目標を設定します。ただし、すべての生成クリップを保証するものではありません。ネイティブ音声とは、モデルが動画ジョブの一部として音声を生成できるという意味です。特定の口がすべての子音で閉じること、聞き手が静止していること、カットが話者の同一性を保つことは保証しません。こうした細部をこのテストで確認します。
以下の3回の実行は、視覚結果とスコアカードを保持しているため、読者は執筆メモの根拠となった同じ証拠を評価できます。
テストした内容
このプロトコルは、言い訳の余地を意図的に排除しています。すべてのシーンは16:9のフレーミング、10秒の長さ、ネイティブ音声を有効化またはプレイグラウンドがその設定を公開している場合は Auto に設定、音楽なし、ポストプロダクションのリップシンクなしとしています。表示される各話者には短いセリフを1つ与えます。記事のGIFは視覚的な演技を保持していますが、音のタイミングを判断するときは元のMP4ファイルを別途確認してください。
| テスト | モデル | 長さ | 表示される人物 | 言語 | 発話セリフ数 | 主な評価対象 |
|---|---|---|---|---|---|---|
| 1 | Kling V3.0 Standard T2V | 10秒 | 1 | 英語 | 1 | 最初の音節、閉口音、終了時のポーズ |
| 2 | Kling V3.0 Standard T2V | 10秒 | 2 | 英語 | 2 | 正しい話者と静かな聞き手の挙動 |
| 3 | Kling V3.0 Pro T2V | 10秒 | 2 | 英語とスペイン語 | 2 | 言語の受け渡し、話者帰属、顔の連続性 |
スコアカードは各カテゴリに0、1、2点を与えます。2は、意図した10秒サンプルに対して挙動が十分明確であることを意味します。1は、部分的に説得力があるが再確認が必要であることを意味します。0は、視聴者が問題をはっきり確認できることを意味します。合計は1つのプロンプト下で生成された1つの結果の記録であり、モデルのすべての出力に関する主張ではありません。
| カテゴリ | 0点 | 1点 | 2点 |
|---|---|---|---|
| 口の動きと単語のタイミング | 明らかな不一致 | おおむね追従するが目に見えるずれがある | タイミングが全体を通して自然に読める |
| 正しい話者割り当て | 話者が誤っている、または共有されている | 不確かな瞬間が1つ | すべてのセリフが指名された人物のもの |
| 無言の聞き手の挙動 | 聞き手が話す、または口を動かす | 軽微な余分な口の動き | 聞き手が自然に注意を向けている |
| 表情の連続性 | 顔が目に見えて崩れる、または変わる | 小さな不安定さ | 表情が一貫している |
| カットをまたぐ音声の連続性 | 声が離れる、または突然変わる | 切り替わりが目立つ | カットが同じ対話のビートを支える |
このテスト設計は、この検索の背後にあると思われる派生質問にも答えます。Kling 4 はリリースされたのか、現在どのモデルが対話を生成できるのか、2人は交互に話せるのか、クリエイターはどうすれば両方のキャラクターが話すのを防げるのか、混合言語の対話は機能するのか、小規模なテスト予算で何をカバーすべきか。
Kling 対話テスト #1:1人の話者、1つの短いセリフ
1人が短いセリフを1つ言うのがベースラインです。これにより、最初の口の開き、「p」または「b」の音での閉口、発話終了後の緩やかな間という、最初の有用なチェック項目を切り出せます。このベースラインがおかしく見えるなら、別のキャラクター、カメラカット、別の言語を加えると、診断が難しくなるだけです。
この実行では、マヤという架空の会社員を使用します。シーンには小さな手のジェスチャーとまっすぐな視線がありますが、速いカメラ移動はありません。そのため、口と声が主な証拠になります。
実行設定: 16:9、10秒、実行時に利用可能なプレイグラウンドの最高解像度、ネイティブ音声は On または Auto、バックグラウンドミュージックなし。モデル: Kling V3.0 Standard Text-to-Video。
plaintext1A realistic 10-second medium close-up of Maya, a fictional woman in her early thirties wearing a navy blazer, seated at a bright office desk. She looks directly at her colleague just off camera and says exactly: “The report is ready. Please review the blue chart.” Natural conversational pacing, clear English speech, accurate mouth movements, subtle blinking, small hand gesture, quiet office room tone only. Maya is the only visible person and the only speaker. No subtitles, no background music, no narration.
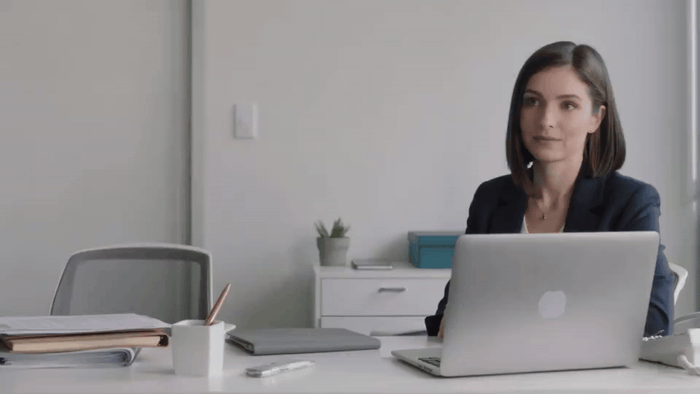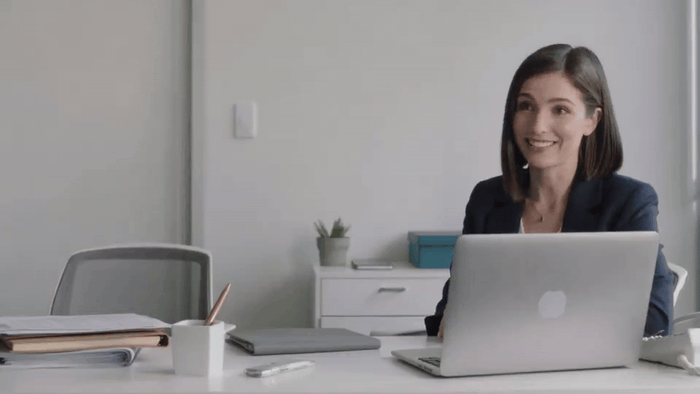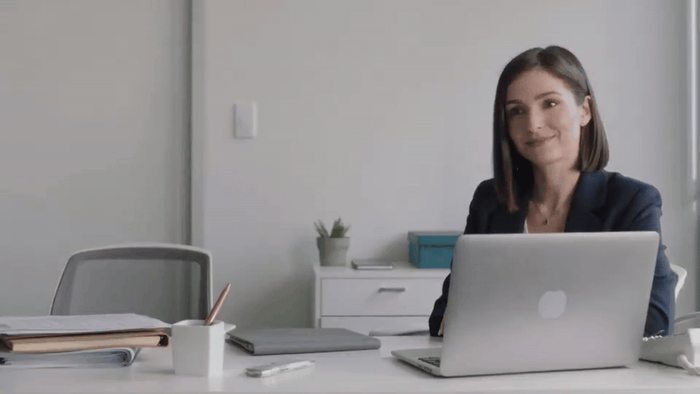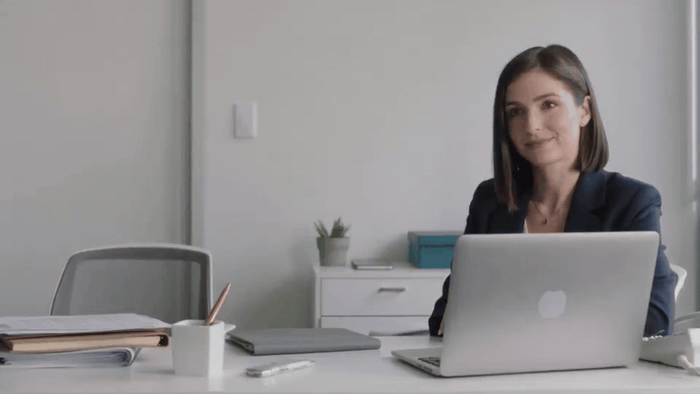
テスト1の視覚結果:マヤがオフィスのセリフを1つ話す
テスト1の視覚結果。マヤが「Please」で口を閉じる動きと、セリフ後の間を確認してください。音声タイミングの判断には元のMP4を使用します。
実行ステータス: Atlas テストプレイグラウンドでレンダリング済み。視覚GIFは上に埋め込まれています。
| テスト1の視覚結果 | ステータス | GIFに表示される内容 |
|---|---|---|
| 単一話者のフレーミング | 明確 | オフィスシーン全体を通して表示される人物はマヤだけ |
| 口の動き | 確認可能 | クローズ気味のフレーミングにより、発話動作を確認しやすい |
| 顔の連続性 | 安定 | まばたき、ポーズ、ライティングがクリップを通して一貫している |
| 聞き手の挙動とカット | 該当なし | このベースラインシーンには2人目の話者も切り返しもない |
| 音声タイミング | 元のMP4を確認 | 埋め込まれたGIFには音声がない |
セリフの明瞭さが失われる場合は、別ラベルの再実行のために変数を1つだけ変更してください。まず、話す文を短くします。次に、手のジェスチャーまたは不要なカメラ指示を削除します。キャラクター、長さ、言語を同時に変更しないでください。そうすると診断が新しい実験になってしまいます。
Kling 対話テスト #2:2人が交代で話す
ここで対話生成が厳しい目にさらされます。説得力のあるシーンには2つの別個の動作が必要です。マヤが話している間はダニエルが聞き、次にダニエルが話している間はマヤが聞きます。黙っている人は無駄な空間ではありません。閉じた口、アイコンタクト、小さな反応、安定した顔が証拠の一部です。
プロンプトは各話者に3つのアンカーを使用します。名前、左右の位置、目に見える服装のディテールです。また、聞き手に期待される挙動も明記します。これらは魔法の言葉ではありません。モデルにより明示的なシーン契約を与え、レビュアーに明確な失敗条件を与えます。
plaintext1A realistic 10-second two-person office dialogue in a sunlit meeting room. Maya, wearing a navy blazer, sits on the left. Daniel, wearing a light gray shirt, sits on the right. Shot 1: medium two-shot. Maya looks at Daniel and says exactly: “The report is ready. Please review the blue chart.” Daniel remains silent and listens naturally with his mouth closed. Shot 2: reverse medium shot on Daniel. Daniel says exactly: “Great. I will check it before lunch.” Maya remains silent and listens naturally with her mouth closed. Clear English speech, precise lip sync, one speaker at a time, no overlapping dialogue, no subtitles, no background music, quiet office room tone.
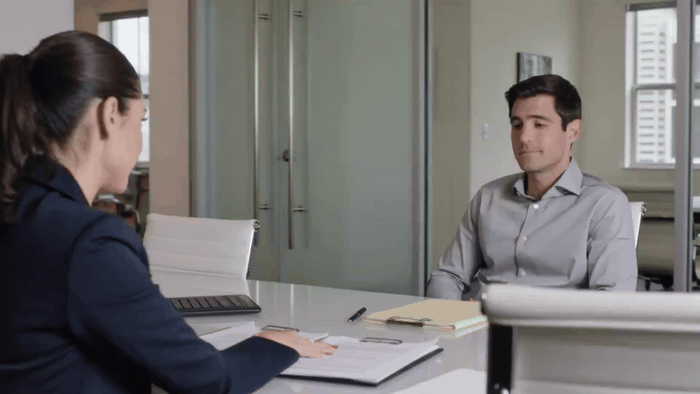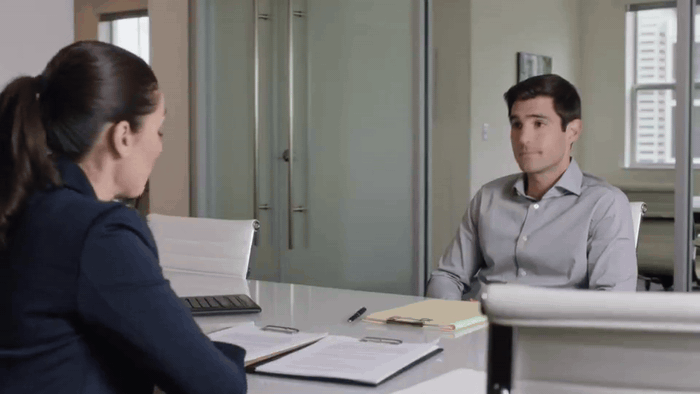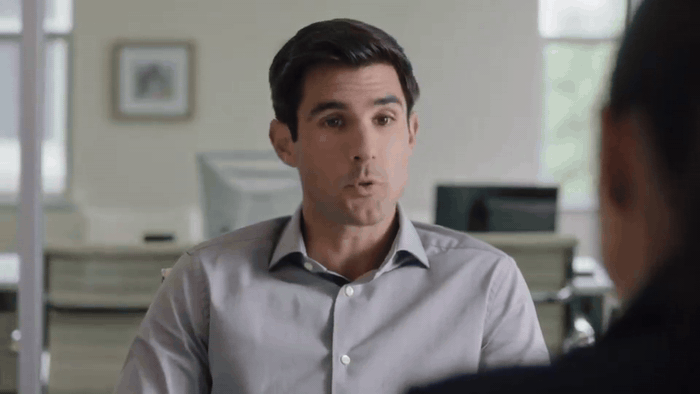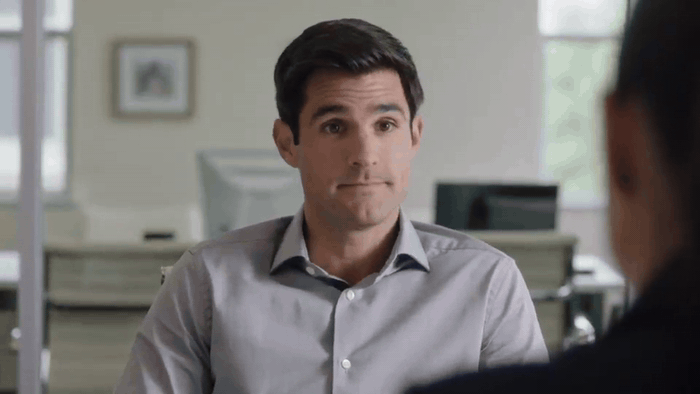
テスト2の視覚結果:マヤとダニエルがオフィスの会話で交代に話す
テスト2の視覚結果。各セリフ中の聞き手の口と、切り返しでの話者の受け渡しを確認してください。音声タイミングの判断には元のMP4を使用します。
クリエイターはコミュニティの議論で、しばしば逆の問題を述べています。リップシンクを意図したジョブが同期を失ったり、静かにしているべき人に不要な口の動きを与えたりすることがあります。これは製品仕様ではなく体験談ですが、毎回の実行で聞き手を確認する十分な理由になります(r/KLING、2026年9月)。
実行ステータス: Atlas テストプレイグラウンドでレンダリング済み。視覚GIFは上に埋め込まれています。
| テスト2の視覚結果 | ステータス | GIFに表示される内容 |
|---|---|---|
| 2話者セットアップ | 明確 | マヤとダニエルが同じオフィスの会話に登場する |
| 話者の受け渡し | 確認可能 | シーンがマヤのターンからダニエルの切り返しへ移る |
| 聞き手の挙動 | 検査可能 | GIFは非発話者を表示し続けるため、視覚的に確認できる |
| 顔の連続性 | 安定 | 切り返しでもダニエルの顔とオフィス設定が一貫している |
| 音声タイミング | 元のMP4を確認 | 埋め込まれたGIFには音声がない |
実用的な境界は控えめです。2人、順番、10秒のやり取りはテストできます。ただし、割り込み、グループの反応、速い編集、複数言語を伴う長いシーンの既製テンプレートとして扱うべきではありません。難易度は一度に1つの次元だけ上げてください。
Kling 対話テスト #3:混合言語の対話
3回目の実行では、Kuaishou が説明する機能のより厳密なバージョンをテストします。1人が英語を話し、もう1人がスペイン語で返答します。価値は目新しさではありません。混合言語のやり取りは、単一言語のクリップでは隠れる話者割り当てエラーを明らかにできます。特に、カットと異なる音声パターンが同時に来る場合に有効です。
スペイン語の返答は意図的に短くしています。各人には依然として1つのセリフがあり、ショット順は明示され、聞き手は黙っているよう指示されます。ここでは Pro ティアを、明確なプロンプトの代わりではなく、別のより要求の厳しいテストとして使用します。
実行設定: 16:9、10秒、実行時に利用可能な最高解像度と品質、ネイティブ音声は On または Auto、バックグラウンドミュージックなし。モデル: Kling V3.0 Pro Text-to-Video。
plaintext1A realistic 10-second two-person dialogue at a quiet outdoor café in late afternoon. Maya, wearing a navy blazer, is seated on the left. Daniel, wearing a light gray shirt, is seated on the right. Shot 1: Maya smiles and says exactly in English: “The product demo starts in five minutes.” Daniel remains silent and listens with his mouth closed. Shot 2: Daniel replies exactly in Spanish: “Perfecto, ya tengo las notas listas.” Maya remains silent and listens naturally with her mouth closed. One speaker at a time, accurate lip sync for each spoken language, natural pauses, stable faces, no subtitles, no background music, soft café ambience only.
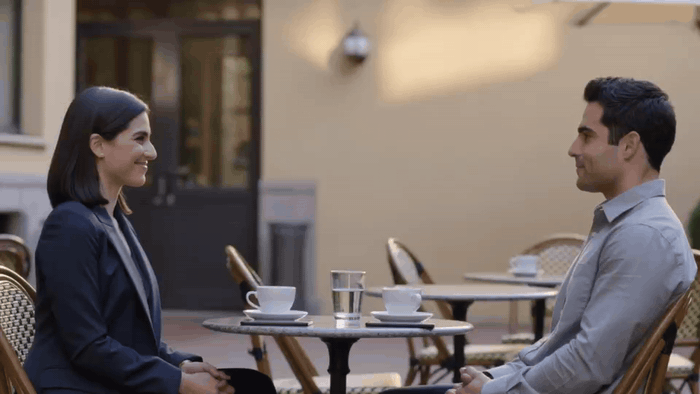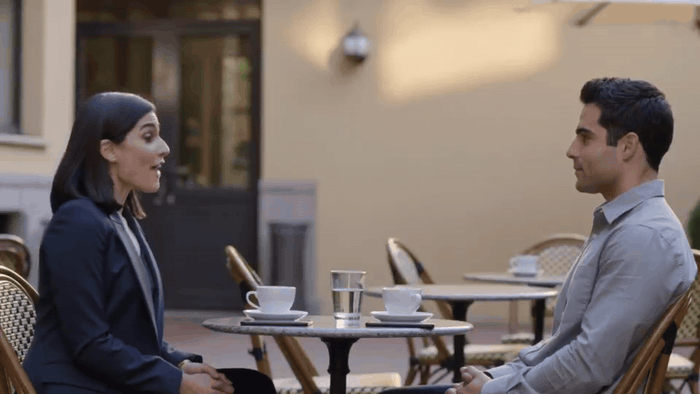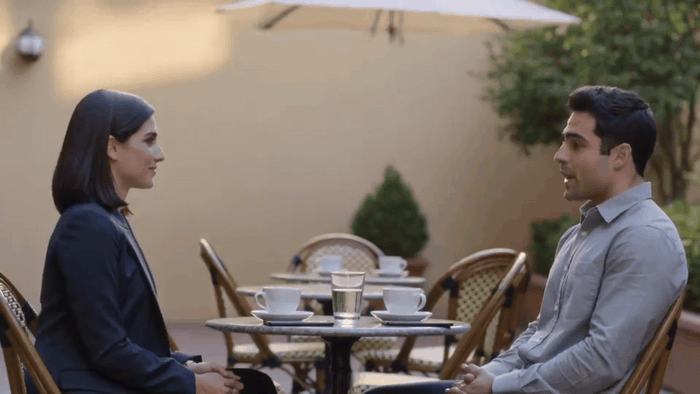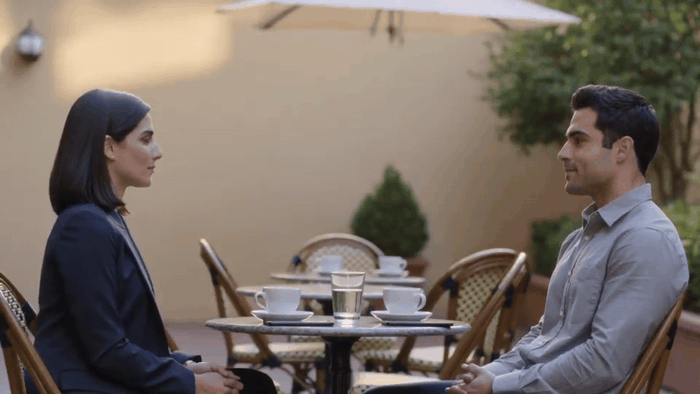
テスト3の視覚結果:2人の話者が屋外カフェでセリフを交わす
テスト3の視覚結果。英語からスペイン語への受け渡しを通じて、各セリフがどの顔に属するかを確認してください。音声タイミングの判断には元のMP4を使用します。
実行ステータス: Atlas テストプレイグラウンドでレンダリング済み。視覚GIFは上に埋め込まれています。
| テスト3の視覚結果 | ステータス | GIFに表示される内容 |
|---|---|---|
| 2人カフェのセットアップ | 明確 | 両者とも屋外カフェのテーブルに位置している |
| 話者の受け渡し | 確認可能 | フレーミングが2人のキャラクター間のやり取りを保持している |
| 顔と設定の連続性 | 安定 | 衣装、席、午後遅めのカフェの照明が一貫している |
よりクリーンな Kling リップシンク結果
3つのプロンプトは、失敗を可視化し、再実行を説明可能にする構造を共有しています。さらに磨きをかける前に、このチェックリストを使用してください。
- 最初の対話テストでは、表示される人物を2人以下に抑える。
- 各人にターンごと1文を与える。
- 可能な場合は英語のセリフを8~12語程度に保つ。
- 話者を位置、目に見える特徴、名前で示す。
- もう一方のキャラクターは口を閉じて自然に聞くことを明記する。
- ディテール設定や長さを上げる前に、10秒サンプルでスクリプトを確立する。
- リップのタイミング、話者割り当て、聞き手の挙動、顔の連続性、カットを別々のチェックとして確認する。
- 最初の実行では、長い独白、グループシーン、速いカット、言語切り替えを組み合わせない。
| プロンプト要素 | テストでの例 | レビュアーが切り分けやすくなるもの |
|---|---|---|
| 位置 | 「Maya ... on the left」 | どの人物が話すべきか |
| 外見のアンカー | 「navy blazer」 | カットをまたいで同一性が保たれるか |
| 正確なセリフ | 「Great. I will check it before lunch.」 | 期待される音と口のタイミング |
| 無言役の指示 | 「remains silent ... mouth closed」 | 聞き手の不要なリップの動き |
| ショット順 | 「Shot 1 ... Shot 2」 | カット後も音声が貼り付いているか |
このフォーマットは完璧な結果を約束するものではありません。小規模チームがソースプロンプト、メディア、意思決定を一緒に保つ方法を与えます。クリップの再実行が必要な場合は、失敗が最初の音節で起きたのか、聞き手の反応中に起きたのか、カットで起きたのかを記録してください。「リップシンクがずれているように感じた」では、制作スクリプトを改善するには曖昧すぎます。
予算とモデル選択
低コストの現行ティアでスクリプトを検証し、実際に提示する可能性があるバージョンには上位ティアのテストを取っておいてください。これがこの記事で Standard と Pro が果たす役割です。クリエイターは同じプロンプト構造を単一の Atlas Cloud モデルワークスペース で実行し、テスト記録を保持し、別のインターフェース用にスクリプトを書き直すことなく比較できます。
以下の数値は価格の文脈であり、プロモーションの主張ではありません。2026年9月28日に Atlas Cloud のモデルディレクトリとモデル詳細ページで確認しました。レビュー時点でディレクトリには15%の値下げが表示されていました。価格とモデルパラメータは変更される可能性があるため、クライアント予算を設定する前にページを再確認してください。
| このテストのモデル | ページ価格(1秒あたり、2026年9月確認) | 10秒生成の推定 | このプロトコルでの最適な用途 |
|---|---|---|---|
| Kling V3.0 Standard T2V | $0.071($0.084から値下げ) | $0.71 | 1人話者と交互発話のプロンプト構造を検証 |
| Kling V3.0 Pro T2V | $0.095($0.112から値下げ) | $0.95 | 混合言語またはプレゼン候補を実行 |
3つの10秒テストの表示合計コストは、再実行前で$2.37です。これは簡単な計画見積もりとして扱ってください。表示された1秒あたり価格、要求した長さがライブフォームに受け入れられること、アカウントの適用価格が公開ページと一致することを前提としています。実際のプレイグラウンドスキーマが、利用可能なアスペクト比、品質オプション、ネイティブ音声コントロールに関する最終的な基準です。
よくある質問
Kling 4 は正式にリリースされていますか?
はい。Kling 4.0 は2026年10月15日に正式ローンチしました。公式リリースとこの記事で使用した生成クリップは Kling 3.0 であるため、同じ対話テストで Kling 4.0 がどう性能を発揮するかを示すものではありません。V4 の結果を報告する前に、選択した V4 ルートでスコアカードを実行してください。
今日、Kling 対話リップシンクテストにはどのモデルを使うべきですか?
短いスクリプトチェックには、検証済みの現行 Kling V3.0 Standard Text-to-Video ルートを使用してください。この記事の混合言語シーンのような、より要求の厳しいフォローアップには Pro を使用します。結果の変化がプロンプトによるものかモデルティアによるものかを判断できるよう、セットアップを十分安定させてください。
Kling は2人を順番に話させられますか?
Kuaishou によると、Video 3.0 は内容と発話順を制御した複数キャラクターの対話を生成できます。実際には、まず短い交互発話サンプルを実行してください。各話者に名前を付け、位置と服装をアンカーし、ショット順を明記し、聞き手に黙っているよう明示的に指示します。
自分の Kling 動画で両方のキャラクターの唇が動くのはなぜですか?
シーンが話者の帰属を開放的すぎるままにしているか、その実行でモデルが不要な顔の動きを生成した可能性があります。テストを2人、各1セリフに限定してください。次に、無言の聞き手への直接的な指示を含め、音声付きで結果を確認します。問題が残る場合は、失敗結果として報告し、変更した変数を1つだけにして再実行してください。
Kling は1つのクリップで英語とスペイン語の対話をサポートしますか?
Kuaishou は、Video 3.0 のネイティブ音声がサポートする言語として英語とスペイン語の両方を挙げています。サポート言語リストは、あらゆる対話スクリプトを保証するものではありません。上記の3番目の Kling 4 対話リップシンクテスト はやり取りを短く保っているため、同じファイルで言語の受け渡し、口の動き、話者の帰属を判断できます。
リップシンクテストを示すには GIF と動画のどちらを使うべきですか?
記事で顔の動きと話者の受け渡しを軽量でざっと確認できるビューが必要な場合は GIF を使用します。言葉と音のタイミングを確認するときは元の MP4 を使用してください。ここに埋め込まれた3つの結果は GIF ですが、元の MP4 ファイルは記事のアセットフォルダに残っています。




