

有用なメモリテストは、「私について何を覚えている?」と尋ねるというより、1つの訂正と少数の妨害情報を伴うクローズドブック確認に近いものです。Muse Wonder Active Memoryテストを実行するには、1つの会話でMuse Wonderに架空の詳細を与え、そのうち1つを訂正し、新しい会話で関連する現在の事実を尋ねます。何を想起するか、何を間違えるか、不確実性を認めるかを記録します。
以下の手順は、セットアップと採点に約10分かかります。これは、日をまたいだ記憶、アカウント間の記憶、またはMuseのすべての製品サーフェスにおける記憶を証明するものではありません。再現可能な最初の確認です。個人情報ではなく架空の詳細を使用してください。
重要なポイント
- 想起、訂正、妨害情報への耐性、不確実性、追跡可能性を個別にテストする。
- 使用予定の製品サーフェスで、そのメモリ設定を記録したうえでテストを実行する。
- 新しいAPIリクエストは、アプリケーションまたはサービスが永続メモリを提供する場合にのみ、それをテストできる。
- MetaのMemoryBenchははるかに長い社内評価であり、この短い確認はそれを再現するものではない。
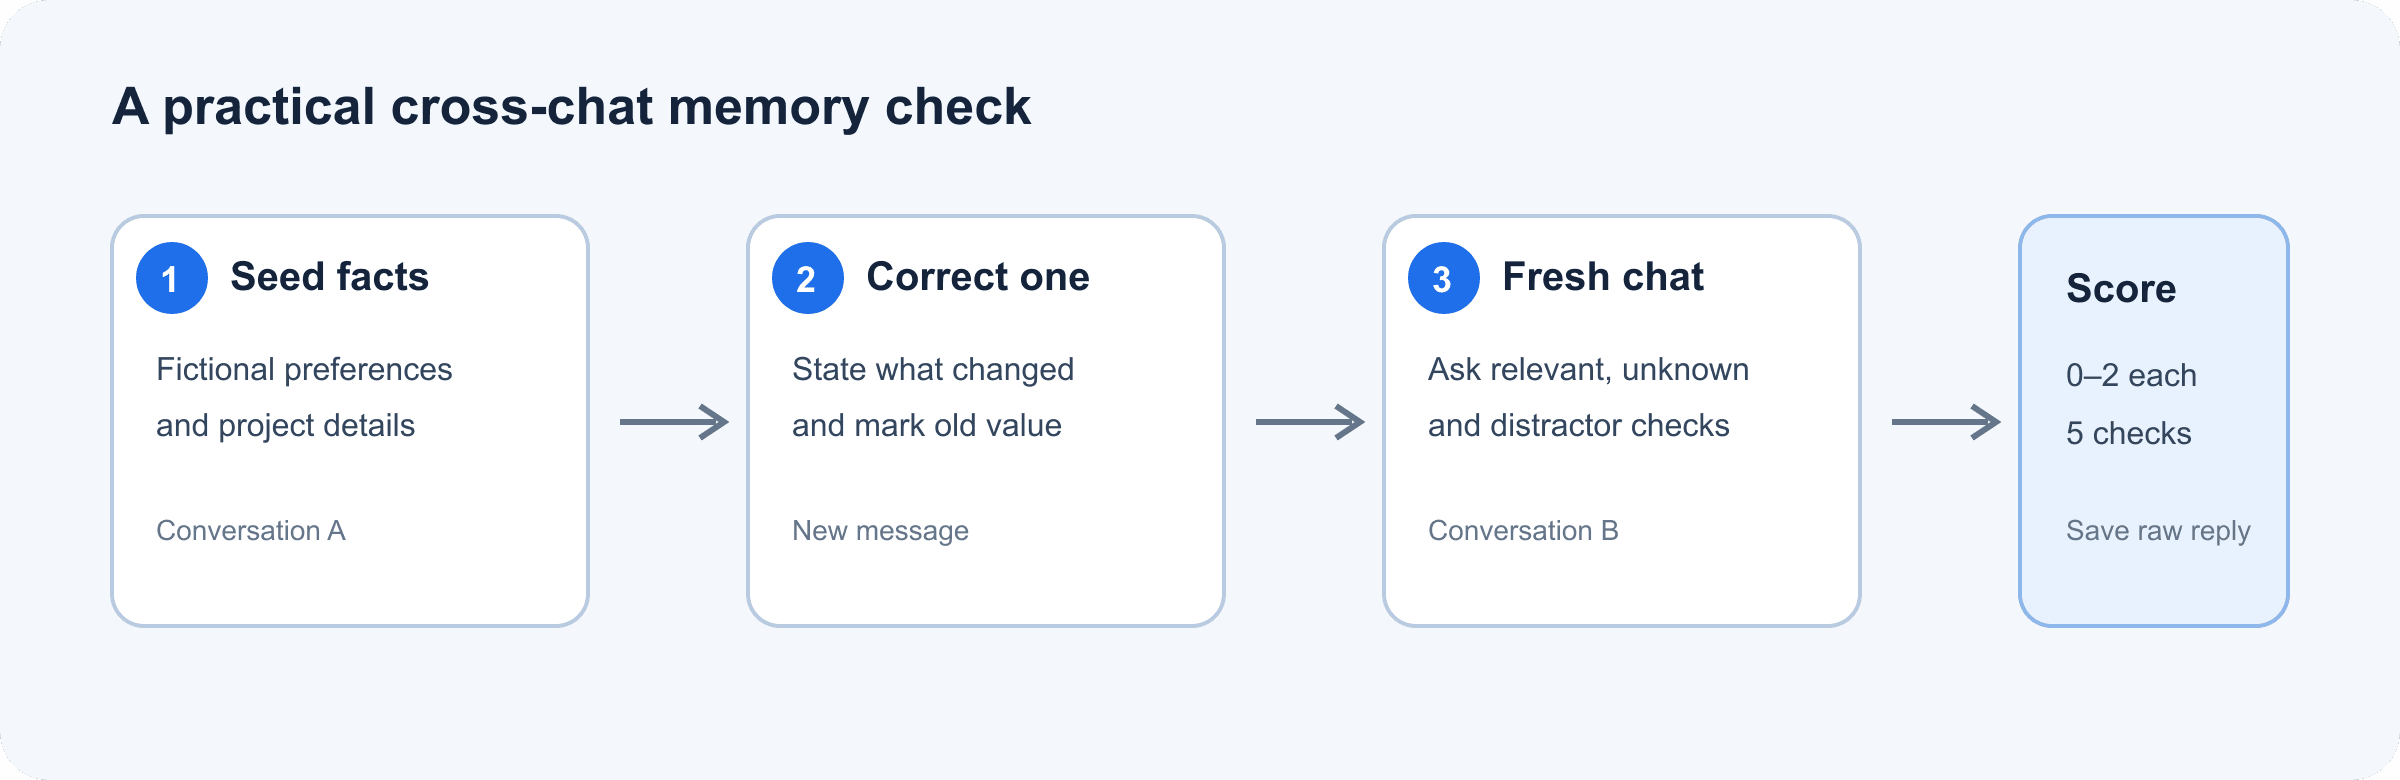
架空の詳細から訂正、新規チャットでの想起、採点までのMuse Wonder Active Memoryテストフロー
テストフローは、初期の事実、明示的な訂正、新しい会話での想起を分離します。
Muse Wonder Active Memoryが意図する機能
MetaはActive Memoryを、会話をまたいで人物に関する重要なコンテキストを保持し、後のタスクで重要になったときに詳細を想起するものと説明しています。Active Focusは、目標に向けた作業の継続を指し、行き詰まったときに別の選択肢を試すことや新しい情報に適応することを含みます。これらの考えは関連していますが、答える問いは異なります。メモリはどのコンテキストが想起されるかに関わり、フォーカスは作業がどのように進むかに関わります。
この説明は製品機能に関する主張であり、すべてのインターフェースやAPI呼び出しがユーザーの履歴を自動的に共有することを保証するものではありません。Metaは、Muse WonderがModel APIとMuse Codeを通じて利用可能だと述べています。開発者向けドキュメントには1,048,576トークンのコンテキストウィンドウとサポートされる推論設定が記載されていますが、コンテキストウィンドウは1回のリクエストに含められるコンテキスト量であり、以前のリクエストが保持される証拠ではありません。選択した製品が実際に提供する履歴またはメモリを確認してください。
Muse Wonderメモリテストの実行方法
1回の実行を通じて単一のアカウントと同じモデルバリアントを使用します。チャット製品の場合は、評価対象のメモリ機能をオンにし、その設定を記録します。API統合の場合は、自分のアプリケーションが以前のターン、保存済みプロフィール、または取得したノートをリクエストに含めているかを確認します。この情報がなければ、想起をモデルだけの成果と見なすことはできません。
1. 関連する事実を与える
最初の会話で、この架空のプロフィールを貼り付けます。モデルが事実をすぐに計画へ変えないよう、確認応答だけを求めます。
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
同じ製品で本当に新しい会話を開き、次のように尋ねます。
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
良い回答は、静かな屋外活動への好みを利用します。活動を提案するのに予算や甲殻類の詳細は必要ないため、それらに言及する必要はありません。でっち上げられた好みに注意してください。製品が以前のチャットにアクセスできない、またはメモリがオフの場合は、モデルが事実を受け取ったかのように採点するのではなく、「このサーフェスではメモリ利用不可」と記録します。
2. 古くなった事実を訂正する
別のテストスレッドで、予定を提示してから明示的に置き換えます。訂正を別のメッセージに保ち、後の更新が優先されるかどうかを判別できるようにします。
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
新しい会話でそれについて尋ねます。
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
木曜日の午前10時と答え、火曜日を古いものとして扱えば合格です。混ざった回答や、自信をもって火曜日を使う回答は、たとえ元の詳細を完全に想起していても、重大な失敗です。
3. 妨害情報を追加し、未知の事柄をテストする
最初の会話に、2つか3つの無害な架空の事実を追加します。たとえば、でっち上げたプロジェクトカラーや偽の小包番号などです。遅延の後、新しい会話を開始し、関連する好みについての質問を1つと、決して提供していない事実についての質問を1つ尋ねます。各回答を採点しやすいよう、質問は分けてください。
優れた結果は、関連する好みを使い、無関係な詳細を出さず、欠けている事実について知らないと述べます。より厳密な遅延テストでは、翌日に同じプロンプトを繰り返します。10分で新規チャットの境界は確認できますが、1週間の保持を立証することはできません。
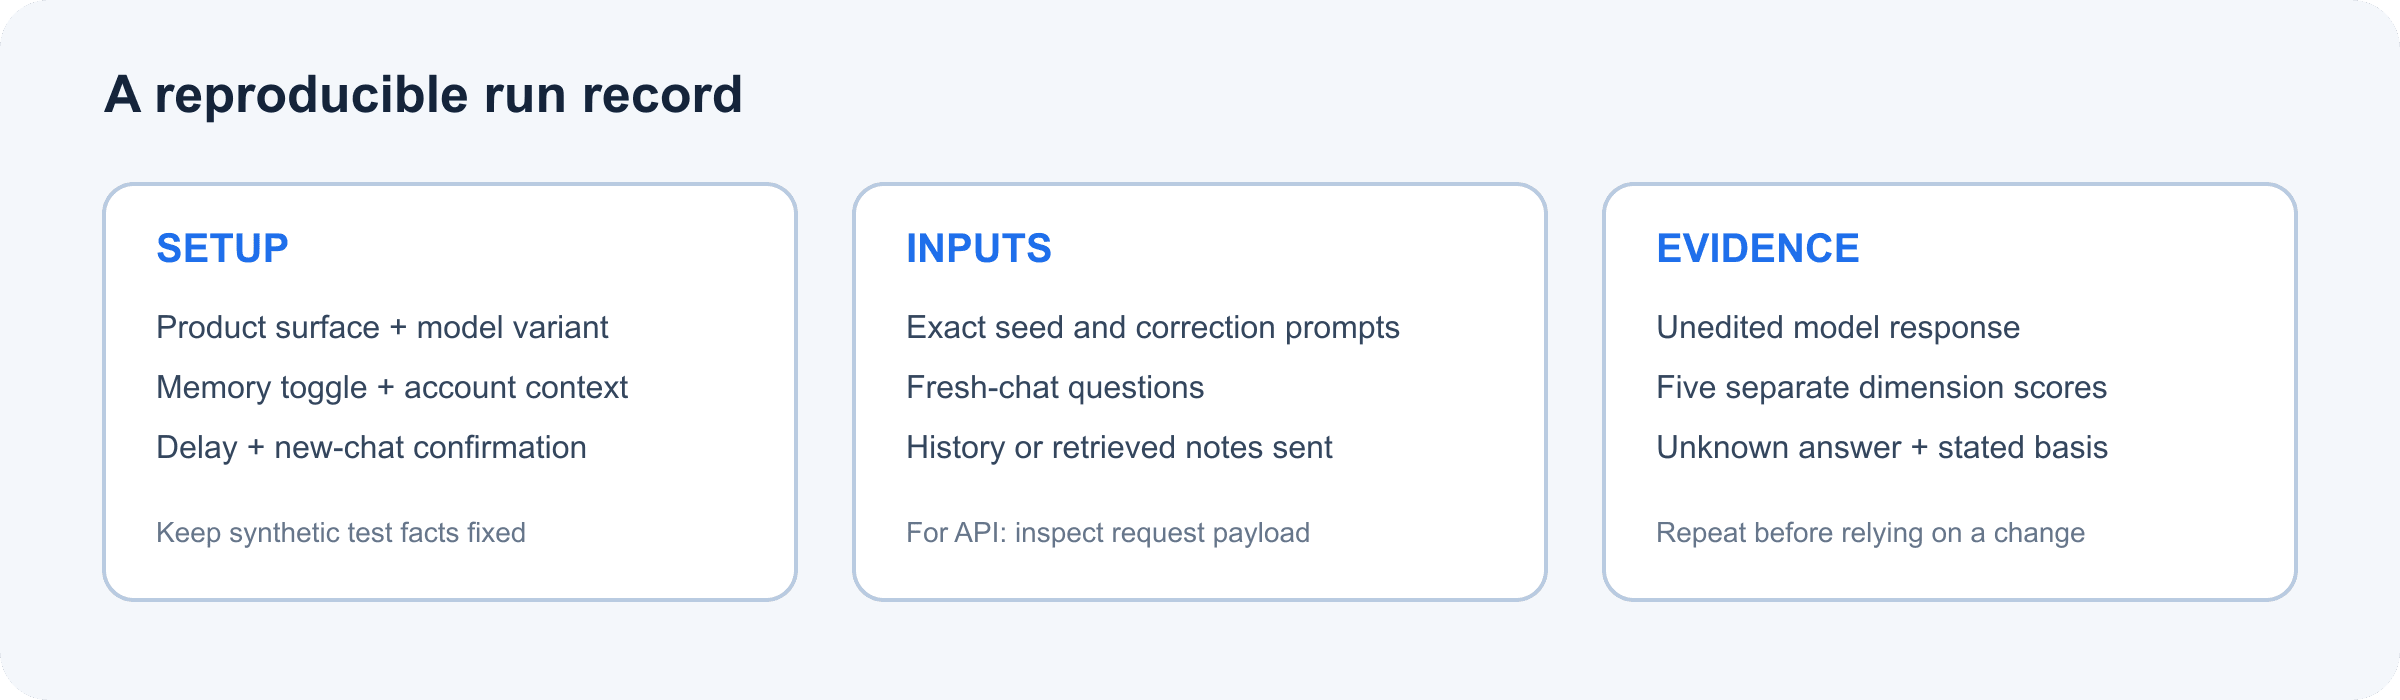
セットアップ、新規チャットでの質問、記録する証拠を示すMuse Wonder Active Memoryテストカード
プロンプト、製品サーフェス、メモリ設定、遅延、生の応答をまとめて保持し、別のレビュアーが確認を再現できるようにします。
Active Memoryテストの採点方法
各挙動を0~2で採点します。結果は、自分のワークフロー内で実行を比較するために使い、モデルを普遍的に順位付けするためには使わないでください。
| 評価軸 | 0点 | 1点 | 2点 |
|---|---|---|---|
| 関連する事実の想起 | 必要な事実を外す、またはでっち上げる | 一部正しい | 正しい事実を正確に選ぶ |
| 訂正の処理 | 古い値を使う | 曖昧、または両方を混ぜる | 最新の値を使い、古い方を時代遅れとして特定する |
| 妨害情報の制御 | 無関係な事実に引っ張られる | 無関係な詳細を一部含める | 質問に関連するコンテキストだけを使う |
| 不確実性 | 自信をもって推測する | 曖昧にしつつも依然として推測する | 答えが提供されていないと明確に言う |
| 追跡可能性 | 根拠を示さない | 根拠の一部だけを挙げる | 依拠したコンテキストを簡潔に列挙する |
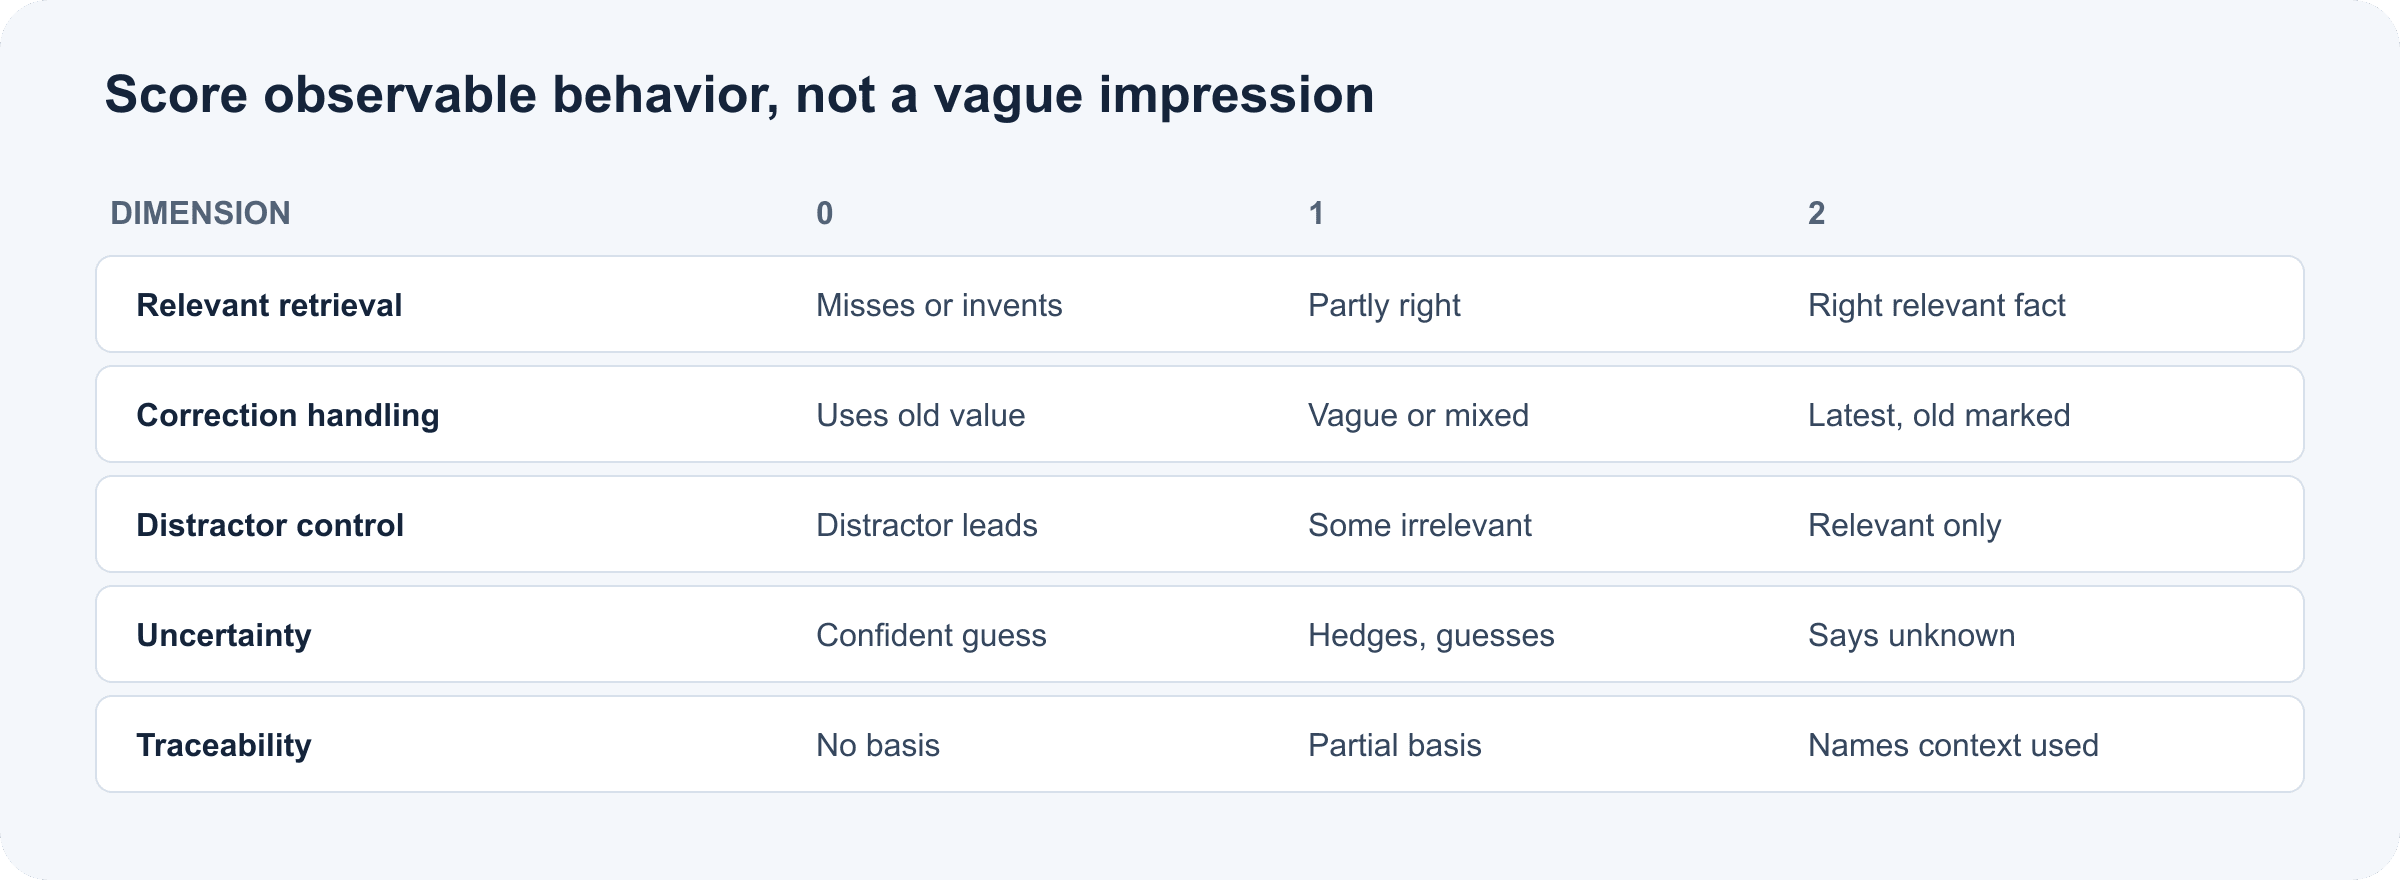
0~2点の5つのActive Memory採点軸と、観察可能な合格基準
0~2のルーブリックは、主観的な印象を5つの観察可能な確認に変えます。
10点は便利な社内スコアであり、検証済みのしきい値ではありません。個々の評価軸のスコアを保持してください。合計点は、他の部分の良好な想起の裏に深刻な訂正失敗を隠す可能性があります。正確なプロンプトと未編集の出力を保存し、デプロイ判断を変える前に実行を繰り返します。
MemoryBenchが教えてくれること、教えてくれないこと
Metaのモデルカードは、MemoryBenchを64K~100Kトークンの長く複雑な会話に対する社内評価として説明しています。そのタスクには、複数の事実、妨害となる会話、対象の詳細と矛盾する、または後で更新する注入ターンが含まれ、LLMジャッジが重み付きの質問固有の基準に照らして回答を採点します。これはベンチマークの範囲を理解するための有用な文脈ですが、ユーザーの個人メモリ設定がチャットをまたいで機能することと同じではありません。
モデルカードはタスク設計を説明していますが、この10分間の演習を再現実験に変えるものではありません。Metaが公開したスコアは、報告された評価設定に関する証拠です。あなたの実行は、より狭い運用上の問いに答えます。この特定の製品サーフェス、構成、アカウントが、あなたのワークフローに必要な事実を想起するかどうかです。どちらか一方だけでは、すべてのユーザーやタスクに対して信頼できるメモリを確立できません。
Muse Wonder vs. Muse Wonder Full:どこでテストするか
2つのバリアントは同じアクセス経路を持っていません。Metaの現在の開発者向けドキュメントによると、Muse Wonder(muse-wonder-1.0)はModel APIとMuse Codeで利用できます。Muse Wonder Fullは、Power UsageおよびMaximum UsageプランのMuse Codeでのみ利用できます。Muse Wonderの推論エフォートを「max」に設定しても、Wonder Fullに切り替わるわけではありません。
| バリアント | 文書化されたアクセス | 記録する内容 |
|---|---|---|
| Muse Wonder | Model APIとMuse Code | APIモデルIDまたはMuse Codeサーフェス、および以前のコンテキストが提供されるかどうか |
| Muse Wonder Full | Power UsageおよびMaximum UsageプランのMuse Code | プラン、選択したバリアント、そのサーフェスで利用可能なメモリ設定 |
利用可能な各サーフェスで、同じ架空のプロフィールを別々に実行します。保存済みプロフィールの詳細を取得できるMuse Codeテストと、現在のプロンプトだけを受け取ったステートレスなAPI呼び出しを比較しないでください。それは2つのモデルバリアントだけでなく、異なるシステムを比較することになります。
プライバシーと再現可能なテスト
架空の好み、日付、プロジェクト詳細を使用します。実データを試す前に、製品のメモリ制御、削除経路、保持情報、データ利用設定を確認します。MetaのAPIドキュメントによると、StandardモードのコンテンツはMetaモデルのトレーニングには使用されません。Muse CodeにはContributorモードもあり、これはデフォルトでオンで、オフにしない限りコンテンツをトレーニングに使用する可能性があります。すべてのサーフェスが同じようにデータを扱うと想定せず、使用する製品の現在の設定と規約を確認してください。
APIの場合、モデルとアプリケーションのメモリレイヤーを分離します。ソフトウェアが送信するデータベース、検索システム、またはプロンプト履歴が記憶を担っている可能性があります。テスト記録は合成のまま、アプリケーションが取得した内容と各リクエストに渡した内容をログに記録します。
チームは3つのラウンドを、小規模なバージョン管理された評価セットにできます。事実プロフィール、訂正、妨害情報、モデルバリアント、製品設定、遅延、生の応答を固定します。設定またはモデル変更後に再実行し、評価軸ごとに失敗を確認します。再現可能なハーネスでホスト型モデルをすでに比較しているチーム向けに、Atlas Cloudはカタログと統合LLM APIガイドを提供しています。別の比較のために、モデルディレクトリを閲覧できます。ディレクトリには現在Muse Wonderは掲載されておらず、そこにある別のモデルを使うと、アプリケーションがメモリレイヤーを追加しない限り、そのモデルに明示的に提供されたコンテキストだけをテストすることになります。
よくある質問
チャットをまたいでMuse WonderのActive Memoryをテストするにはどうすればよいですか?
1つの会話で架空の事実を提供し、新しい会話で関連する詳細について尋ねます。訂正と欠けている事実を含め、製品サーフェスとメモリ設定を記録します。
Muse Wonderは訂正を覚えますか、それとも以前の詳細だけを覚えますか?
MetaのMemoryBenchの説明には、以前の詳細を更新する、または矛盾するターンが含まれています。自分の訂正テストは、現在の製品設定が更新に従うかどうかを確認します。1つの結果だけでは一貫した動作を確立できないため、繰り返してください。
このチャット履歴テストはMetaのMemoryBenchと同じですか?
いいえ。MetaはMemoryBenchを、64K~100Kトークンの会話、妨害情報、矛盾するまたは更新された事実、LLMジャッジを用いる社内の長文コンテキストベンチマークとして説明しています。この短い確認は実用的なスモークテストであり、再現実験ではありません。
APIを通じてMuse Wonder Active Memoryをテストできますか?
リクエストに到達したコンテキストに対するAPIモデルの想起はテストできます。リクエストをまたぐ永続性については、APIまたはアプリケーションが何を保存し送信するかを確認してください。大きなコンテキストウィンドウが利用可能であること自体は、別々のリクエストがメモリを共有することを示しません。
モデルのメモリとアプリが保存するメモリをどう区別すればよいですか?
モデルに送信される完全なリクエストを検査します。アプリケーションがプロフィール、取得したノート、または以前の会話を挿入している場合、そのソフトウェアレイヤーがメモリを提供しています。適切な場合は、それを省略した対照実行と比較してください。
Active Memoryテストで個人情報を使用するのは安全ですか?
テストには架空の情報を使用してください。後で実データを評価する場合は、まずその製品固有のメモリ、削除、保持、データ利用設定を確認してください。
Muse Wonder Active Memoryテストは、どのステップが失敗したか(以前のコンテキストへのアクセス、想起、訂正、フィルタリング、不確実性)を明らかにするときに最も有用です。生の実行を保存し、信頼する予定の正確な設定で繰り返します。
出典: MetaのMuse Wonder発表 (2026年10月12日); Meta Model APIモデルドキュメント (2026年10月15日閲覧); Muse Wonderモデルカード (2026年10月)。





