

ベンチマークの首位は決定的に見えることがありますが、同じモデルが次の実行で要件を外すこともあります。有用な Muse Wonder 信頼性テスト は、より狭い問いを立てます。同じ条件で、モデルがあなたのタスクを、あなたの基準で、繰り返し完了できるか、という問いです。
初期の証拠は、テストが異なるものを測定しているため混在しています。ローンチ当日のあるタスクセットでは、標準 Muse Wonder がタスクごとに1回の実行で非常に高いスコアを獲得しました。別の評価では、リサーチ分析に強みがある一方、調査設計、販売主張、スライドレイアウトは弱いことがわかりました。どちらの結果も、あなたのコードベースやエージェントワークフローをどれだけ一貫して処理できるかを証明するものではありません。
主なポイント
- ローンチ時のベンチマークは、能力のシグナルとして扱い、本番環境の保証とは見なさない。
- Muse Wonder と Muse Wonder Full は別個のバリアントです。結果は分けて扱う。
- 合格率、再現性、完了、復旧を異なる成果として測定する。
- 実際のタスク10〜20件から始め、セットアップを固定し、重要なタスクは少なくとも3回繰り返す。
- 誤った回答のコストと人間のレビュープロセスに基づいてしきい値を選ぶ。
Muse Wonder は信頼できるのか? 短い答え
2026年10月15日時点で入手可能な証拠は、普遍的な信頼性の判定ではなく、タスクごとの評価を支持しています。Muse Wonder は一部の初期チェックでは良好に機能しましたが、他の実行ではエラーや、まだレビューが必要なプレゼンテーション作業が明らかになりました。研究ごとにプロンプト、推論設定、採点者、サンプルサイズ、試行回数が異なります。
(Meta、2026年10月12日)によると、Muse Wonder と Muse Wonder Full はプロフェッショナルおよび個人向けのエージェントタスク向けに構築されており、Active Memory と Active Focus と呼ばれる機能を備えています。これらは意図された動作に関する製品主張です。モデルがエラーから復旧できるという主張は、あなた自身のワークフローで復旧をテストする理由にはなりますが、確実に復旧する証拠ではありません。
標準 Wonder と Wonder Full は分けてください。Meta は標準 Muse Wonder を Model API と Muse Code 向けに記載しており、Full は Muse Code サブスクリプションを通じて提供されています。標準 Wonder をより高い推論設定で実行しても、Full にはなりません。
説明可能な意思決定を行うには、デプロイ予定の正確なバリアントとルートをテストしてください。タスクは、書面による受け入れ基準を満たし、その結果を確認できる場合にのみ成功と数えます。
Muse Wonder 信頼性テストで測定すべきこと
精度と一貫性は別物
合格率は、定義されたルーブリックを満たす試行がいくつあるかを測定します。一貫性は、同じタスクを繰り返し実行したときに毎回許容できる結果が得られるかを測定します。モデルは高い合格率を持ちながら、あなたのワークフローにとって重要な点で変動することがあります。
4つの次元を別々に追跡します。
| 測定項目 | 記録する内容 | 確認例 |
|---|---|---|
| 精度 | ルーブリックを満たす試行 | 抽出された合計はソース文書と一致するか? |
| 一貫性 | 繰り返し試行が合格し、一致するか | 3回の実行で同じ必須制約が維持されるか? |
| 完了品質 | 要求された成果物がすべて揃っているか | すべてのファイル、引用、要求されたフィールドが含まれているか? |
| 復旧 | 障害後に実行が正しく再開するか | ツール障害を報告し、安全に再試行し、最終状態を検証するか? |
完全に聞こえる回答が、必ずしも完全であるとは限りません。コード変更にはテストが必要であり、リサーチ要約には追跡可能な情報源が必要であり、エージェント実行には最終アクションが実際に行われた証拠が必要です。
モデルの失敗とワークフローの失敗を分ける
モデルのエラーと、サービングまたはツールの問題を区別できる十分なコンテキストを記録してください。少なくとも、モデルのバリアントとバージョン、推論設定、プロンプト、ツール設定、日付、実行時間、トークンまたはタスクのコスト、生の出力をログに記録します。
スコアリングの前に失敗を分類します。
- モデル: 事実誤認、誤った推論、要件の見落とし。
- ツール: API呼び出しの失敗、無効なツール引数、外部システムからの誤った結果。
- サービング: タイムアウト、中断、エンドポイント利用不可。
- 評価: 不明確なルーブリック、または許容可能な作業と許容できない作業を区別できないチェック。
4つすべてを1つの失敗率にまとめると、何を修正すべきかわからなくなります。
現在の Muse Wonder テストからわかること
Meta が公開したベンチマーク比較は、ベンチマーク性能に関するベンダーの証拠です。独立して実行されたワークフロー評価とは同じではありません。独立したテストにも限界があります。小さな公開タスクセット、1回の試行、特定のモデルルート、人間の選好評価は、狭い問いに答えるだけです。
以下の表は、証拠を情報源と範囲別に分けています。各結果が何を裏付けられるかの指針であり、統合スコアではありません。
| 証拠源 | テスト対象 | 日付とセットアップ | わかること | 主な限界 |
|---|---|---|---|---|
| Meta の発表とモデル資料 | 能力ベンチマークと想定されるエージェント機能 | 2026年10月12日発表、ベンダー報告の比較 | Meta がどの能力を重視し、どのバリアントをリリースしたか | ベンダーテストは、あなたのワークフローでの再現性を確立しない |
| (Spring Prompt、2026年10月13日) | 調査、製品リスティング、スライド、広告計画、チェス、ビジュアル検索 | 10月13日、標準APIモデル、一般に中程度の推論、公開タスク | パフォーマンスはタスクによって異なった。一部の評価には製品リスティングの反復実行が含まれていた | ほとんどのタスクは小規模サンプル。多くの結果はタスクごとに1回実行。コーディングや Muse Code のテストではない |
| (Quantslant、2026年10月12日) | エージェント、コーディング、執筆、推論、1つの長文文書にまたがる23タスク | 10月12日、OpenRouter 経由の標準モデル、低推論、タスクごとに1回実行 | モデルはその設定下で、定義されたタスクセットを高い割合で通過した | 1回の実行では実行間の一貫性を測定できない。100%に近い結果はタスクレベルの検査が必要 |
| コミュニティ投稿 | 個々のコーディング、エージェント、ベンチマークの反応 | ローンチ期間の投稿、自己選択したユーザーとタスク | 次に何をテストするかの有用な手がかり | 逸話や投票は測定された合格率ではない |
情報源の対比は重要です。Quantslant は23タスクセット全体で99.7%を報告し、タスクごとに1回実行、低い推論設定でした。また、数値から単語への変換コーディングタスクで1件のユニットテスト失敗を指摘しました。この結果はその特定のスイートに関する証拠であり、日常的なタスクの99.7%が合格することや、繰り返し実行が一致することを示す証拠ではありません。
Spring Prompt は、10月13日の API デフォルトでの標準 Wonder について、より多様な状況を報告しました。リサーチ分析スコアは9つの公開タスク全体で93.6/100でしたが、9つの調査計画のうちすべてのチェックを通過したのは3つだけでした。製品リスティングでは、3回の繰り返しで信頼性をもって公開準備完了と判断された割合は、事実概要で66.1%、販売概要で51.8%でした。6つのスライドデッキのうち5つはレイアウト修正が必要で、1つが提示可能と判断されました。これらはそれぞれ異なる分母を持つ別々の測定であり、1つの総合スコアの断片ではありません。
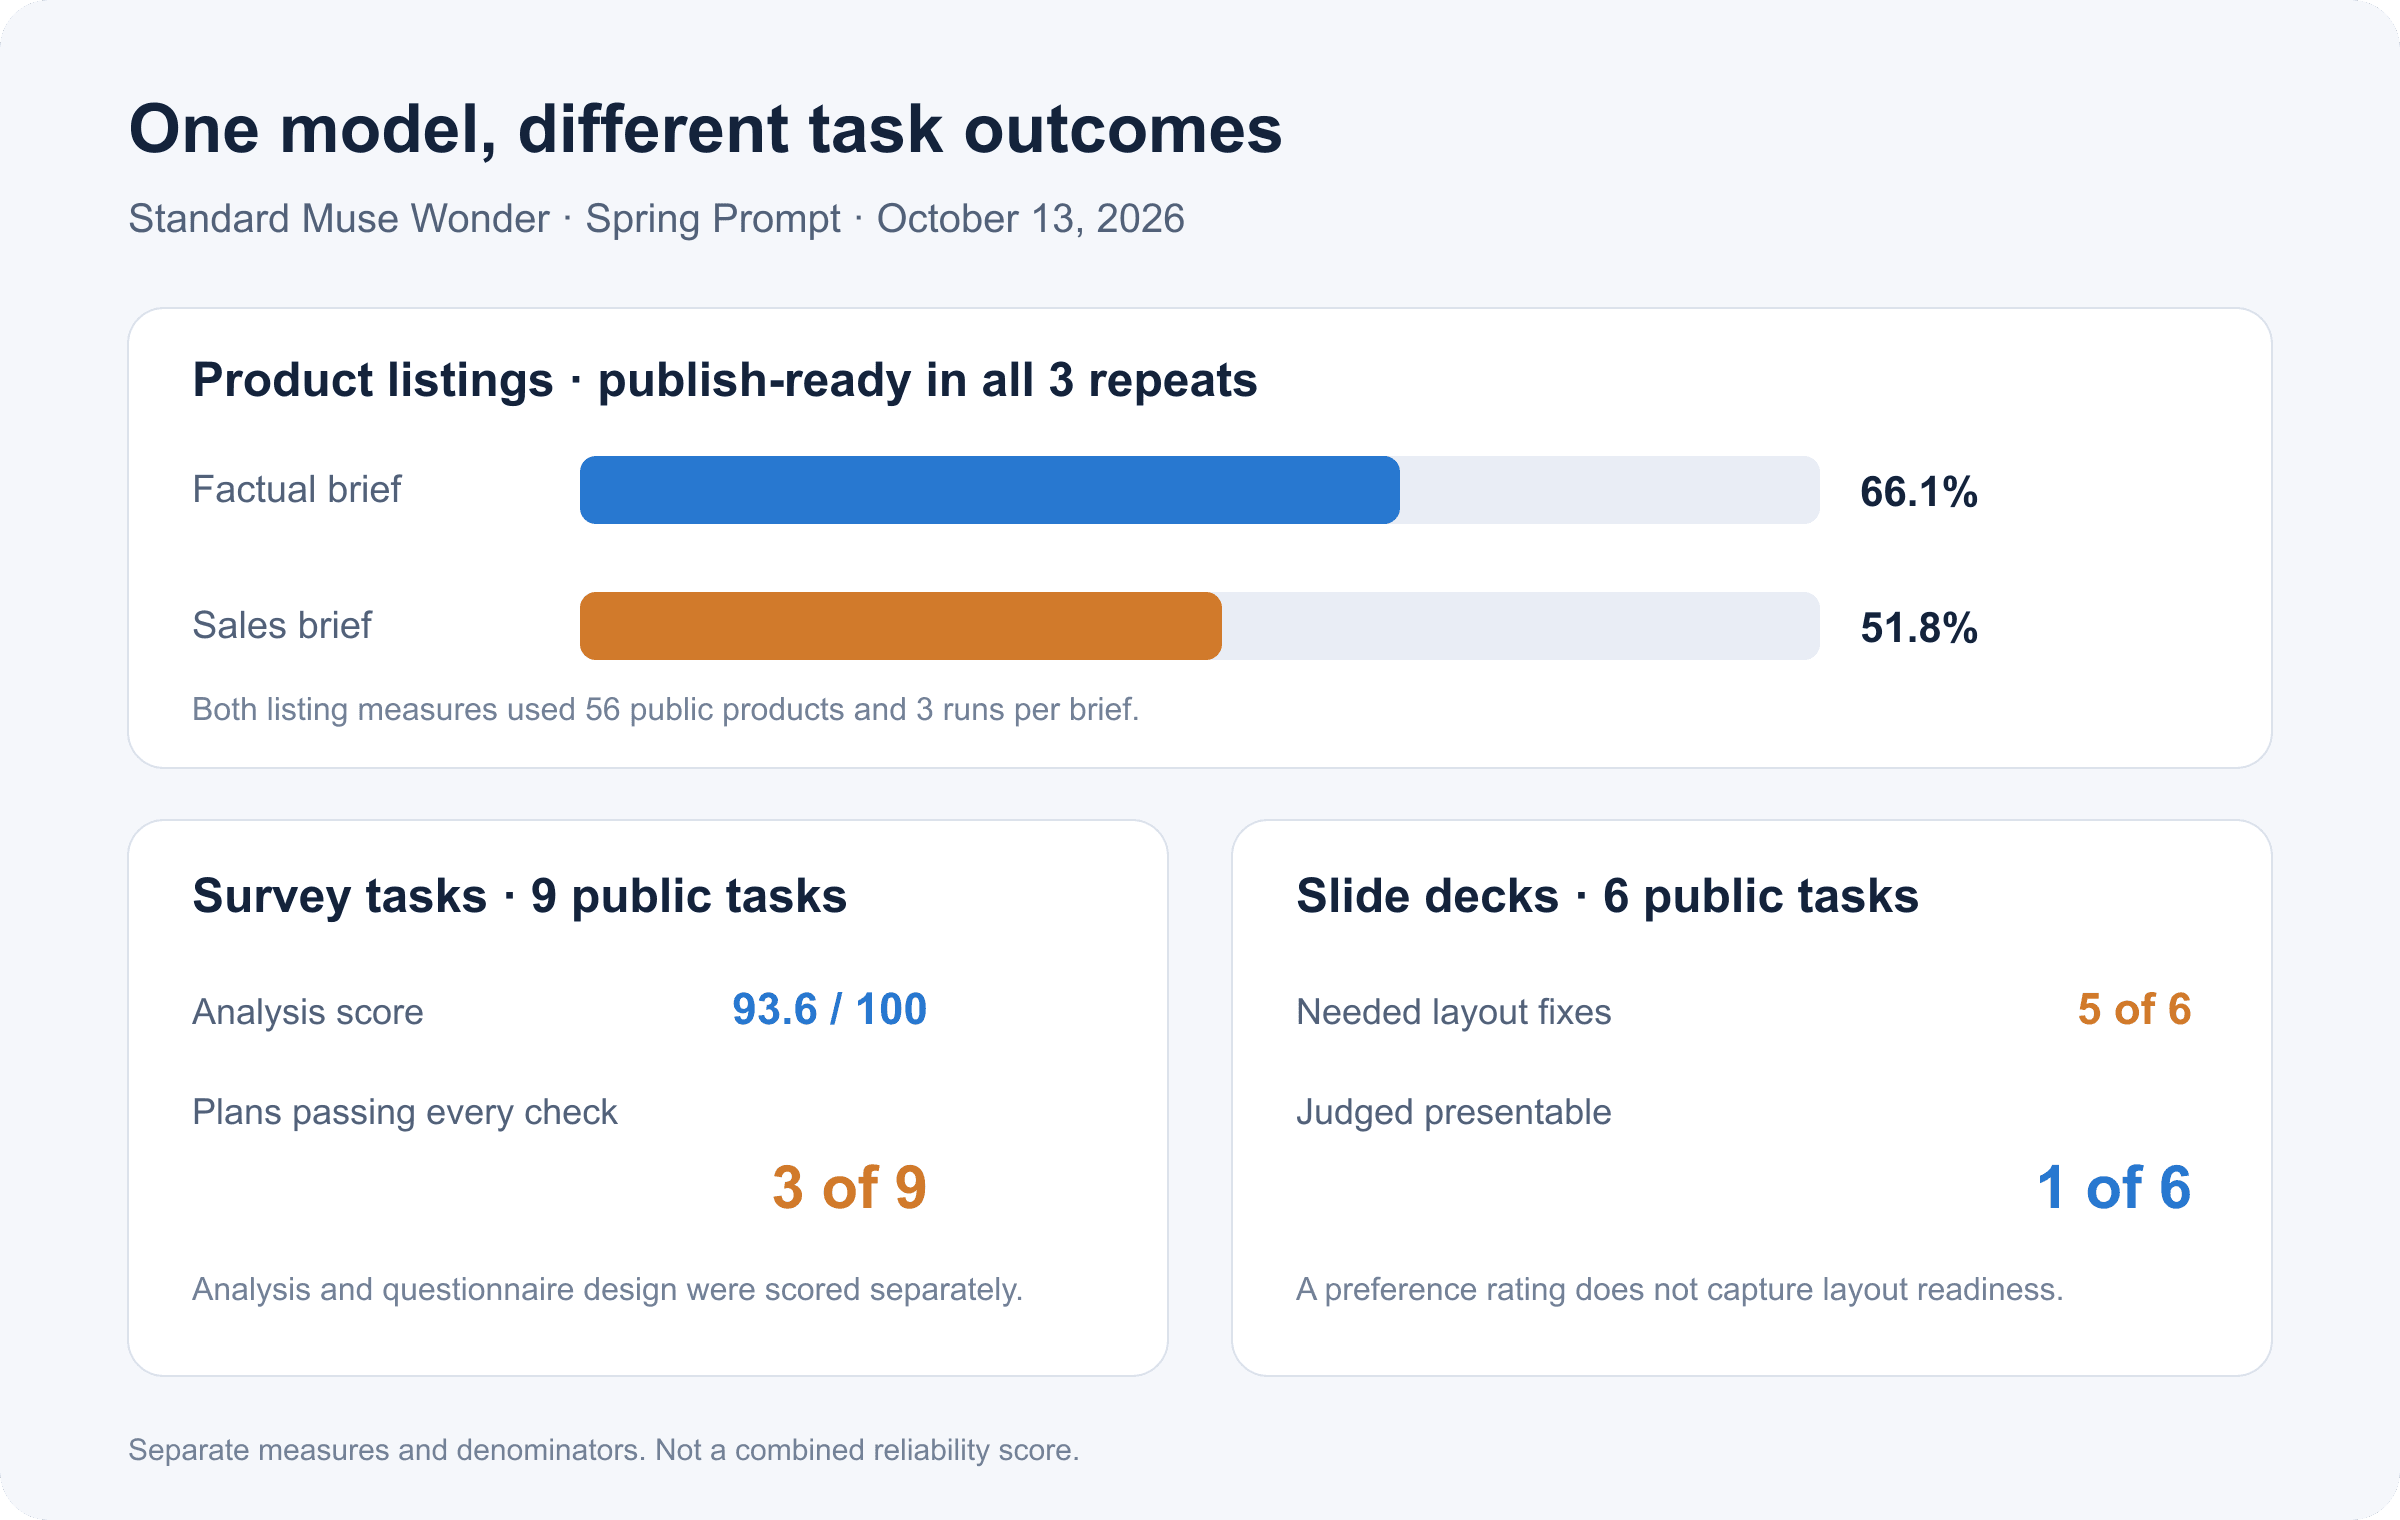
Spring Prompt の2026年10月13日の標準 Muse Wonder 結果:反復テストされたリスティング合格率、調査分析、デッキレビューの結果
1つの評価による独立したタスク結果。測定は異なる分母を使用し、スコアに統合されず、個別に示されています。
Spring Prompt のテストは、コーディング、永続メモリ、Muse Code を測定していませんでした。したがって、その比較では、Wonder がコーディングで信頼できるか、Full の方が優れた性能を出すかは決着しません。単一の広いラベルが重要なタスク差を隠す理由を示しています。
Meta のローンチ記事によると、標準 Muse Wonder は Meta Model API と Muse Code を通じて利用でき、Wonder Full は Muse Code サブスクライバーが利用できます。Active Memory と Active Focus を、有用な詳細を保持し、エラーを越えて作業を続けるための機能として説明しています。これらの説明はテストケースの定義に役立ちますが、ローンチ記事は独立した反復実行研究ではありません。
ローンチ週のコミュニティスレッドで議論されたコーディングや3Dビルドの主張については、投稿を仮説として扱ってください。具体的な不満を再現可能なタスクに変え、出力を検証します。コメントやアップボートを成功率に変換しないでください。
再現可能な Muse Wonder 信頼性テストの実行方法
1. 実作業から小さなタスクセットを構築する
チームが実際にモデルに処理してほしいと期待するタスクを10〜20件選びます。コーディング、事実抽出、指示追従、長いコンテキスト、ツール使用などのカテゴリに分けます。客観的テスト、参照回答、または明確なルーブリックがあるタスクを優先します。
現実的なエッジケースを含めます。入力欠落、矛盾する要件、利用できないツール、確認質問を引き起こすべきタスクなどです。承認されたプロセスで許可されていない限り、機密データや規制対象データは除外します。
2. プロンプト、モデル、設定を固定する
正確なプロンプトとシステム指示を書き留めます。モデル名とバージョン、推論レベル、ツール、提供されたコンテキスト、日付、時間制限を記録します。標準 Wonder と Full を同じモデルであるかのように比較しないでください。
有用なテストプロンプトでは、モデルに証拠を示し、テスト不能な要件を特定するよう求めることができます。
添付の仕様と実装を読んでください。次のものだけを返してください。(1) PASS、FAIL、NOT TESTABLE とマークした各要件、(2) 各ステータスの正確な証拠、(3) 欠落している要件、(4) すべての FAIL に対する最小限の再現可能なテスト。出力を指し示せない限り、テストが合格したと主張しないでください。
これは評価入力であり、モデルがそれに従う保証ではありません。得られた回答を採点し、主張されたテスト出力を独立して検証します。
3. タスクを繰り返し、すべての試行を採点する
影響の大きい各タスクを、同じセットアップで少なくとも3回実行します。予算上1回しか試行できない場合は、その結果を一貫性の結果ではなく初期サンプルとラベル付けします。各生の応答を保存し、最良のものだけを報告しないでください。
すべての試行に1行を使用します。受け入れルールは実行間で安定させます。
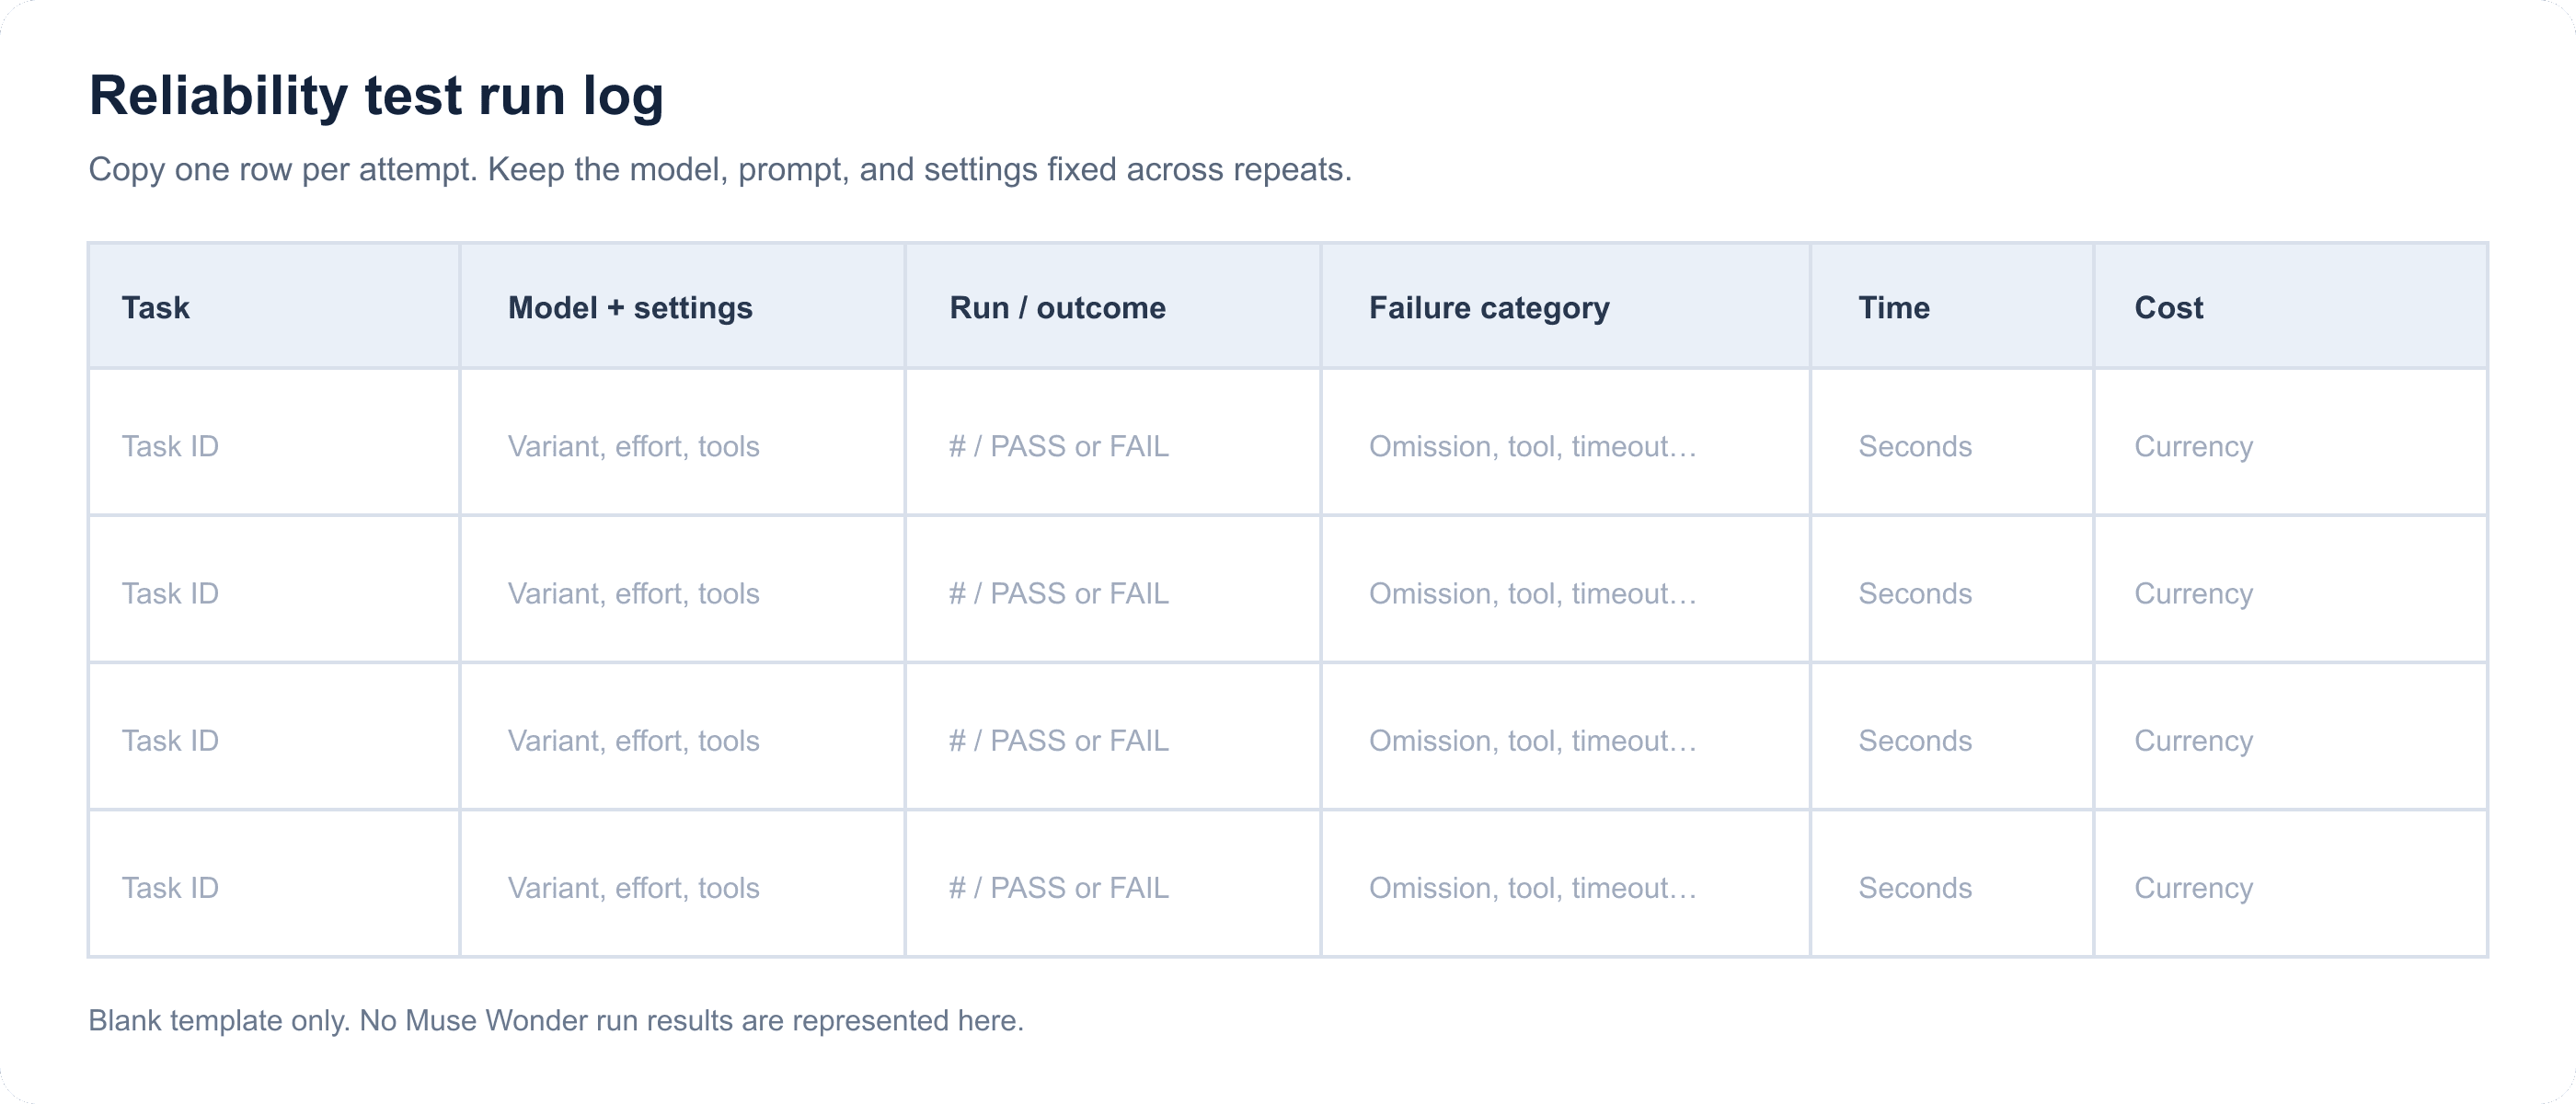
タスク、モデル、実行、結果、エラー、時間、コストのフィールドを示す、空の Muse Wonder 信頼性テストログ
再利用可能な空の記録テンプレート。試行ごとに1行を記入します。測定された Muse Wonder の結果は含まれていません。
4. 失敗ログを保持し、復旧を検証する
具体的なカテゴリを使用します。事実誤認、省略、コードテストの失敗、ツールエラー、タイムアウト、裏付けのない完了主張、形式の不一致などです。マルチステップ作業では、実行がどこで停止したか、再試行が完了済みアクションを繰り返したか、最終状態を検証したかを記録します。
証拠なしに「完了」と言うエージェントは、完了チェックを通過していません。タスクに一致するテスト結果、保存されたファイル、情報源の引用、または検証済み状態を要求します。
5. 失敗コストに基づいて意思決定のしきい値を設定する
有用な普遍的な合格率のカットオフはありません。人が1行ずつ確認する下書きは、データベース移行や自動支払いとは異なるリスクプロファイルを持ちます。
しきい値は3つの要因から設定します。
- 誤った結果はどれほど有害または高コストか?
- 誰かに影響を与える前に、人がエラーを発見できるか?
- ワークフローは、明確な停止と監査証跡を伴って安全に失敗するか?
低リスクの下書きでは、レビューで十分な場合があります。コード変更、金融、法務、医療、またはユーザーに影響するアクションでは、より強力なテストと独立した検証を使用します。高い平均が、1つの重大な失敗モードを覆い隠さないようにしてください。
タスクタイプ別の Muse Wonder 信頼性
コーディングとマルチステップビルド
リポジトリの実際のテストスイートを実行し、要求された動作を確認します。要件カバレッジ、リグレッション失敗、モデルが主張する変更がファイルとテスト出力に一致するかを採点します。説得力のある画面録画や説明は、実行可能なチェックの代替にはなりません。
初期の Quantslant スイートには4つのコーディングタスクが含まれ、1つの数値から単語へのタスクで16件中15件のユニットテストが合格したと報告しました。これは小規模な単一実行のシグナルです。Spring Prompt はコーディングを明示的にテストしていないため、その知見をコーディングエージェントの信頼性について一般化するために使用すべきではありません。
リサーチと事実抽出
レビュー担当者が検査できる情報源パケットまたは参照回答を使用します。各事実主張を一次情報源と照合し、捏造された引用や誤った帰属を、一般的な回答品質とは別に追跡します。
Spring Prompt の調査分析は、その小規模評価では相対的な強みでしたが、調査質問の設計は弱めでした。高い分析スコアが、調査手段や新しいリサーチタスクの背後にある情報源を暗黙に保証するべきではありません。
長いコンテキストとエージェントワークフロー
モデルがすべての制約を保持し、各ツールを正しく使用し、最終状態を検証するかを確認します。中断からの復旧を意図的にテストします。既知のステップの後で実行を停止し、チェックポイントから再開するか、副作用を繰り返すかを確認します。
Meta の発表はメモリと復旧機能について説明していますが、ここで引用した公開の初期評価は、永続メモリやエージェント復旧の長期的な一貫性を確立していません。それらに依存する前に、これらの動作を直接測定してください。
Muse Wonder 対 Muse Wonder Full:証拠は分けておく
Muse Wonder と Muse Wonder Full は別個のバリアントです。Meta のローンチ情報は別々のアクセスルートを説明しており、標準 Wonder の独立した API テストは、推論設定が変わるだけで Full の結果にはなりません。
| 比較の問い | 入手可能な証拠が支持する内容 |
|---|---|
| Full は最大推論の標準 Wonder と同じか? | いいえ。別個のバリアントとして扱い、正確な名前を記録します。 |
| 引用した Spring Prompt の API 評価は Full をテストしたか? | いいえ。標準 Wonder をテストしました。Full はその比較の対象外でした。 |
| 引用した標準 API の数値で Full を順位付けできるか? | いいえ。それらは Full をテストしていません。 |
| 公平な比較には何が必要か? | 同じタスクセット、採点ルーブリック、日付範囲、ツールアクセス、文書化された設定、および両バリアントの反復。 |
公平な比較は、ペアになったタスクと一致した条件から始まります。アクセスルートが異なるプロンプト、ツール、課金を課す場合は、それらの違いを文書化し、その比較を探索的と呼びます。
コスト、アクセス、Muse Wonder をテストする場所
トークンあたりの表示価格だけでなく、受け入れられたタスクあたりのコストを比較します。長いプロンプト、再試行、推論トークン、ツール呼び出し、タイムアウト、人間のレビューはすべて、使用可能な結果のコストを変えます。Quantslant は、2026年10月12日時点の標準 Wonder のトークン料金を入力100万トークンあたり$4、出力100万トークンあたり$20と報告し、自身の23タスク実行のコストは$0.64でした。これは報告された1つのルートとワークロードであり、普遍的なタスク価格ではありません。
Meta の現在のローンチ発表では、標準 Wonder は Meta Model API と Muse Code を通じて、Full は Muse Code サブスクリプションを通じて提供されています。予算を立てる前に、公式インターフェースでアクセス、地域の利用資格、現在の課金を確認してください。
より広い開発者プラットフォームの概要については、Atlas Cloud から始めてください。2026年10月15日時点で、モデルカタログ で Muse Wonder を確認できなかったため、この記事は Atlas Cloud をこのモデルの実行ルートとして提示していません。チームがすでにそこに掲載されている他のモデルを比較している場合、Atlas Cloud モデルライブラリ は、同じタスクセットに対して実行する候補の特定に役立ちます。
Muse Wonder 信頼性テストの有用な成果は、証拠に結びついたデプロイ判断です。どのタスクが合格したか、どのくらいの頻度で合格したか、コストはいくらか、どのレビューが依然として必要か、です。
よくある質問
Muse Wonder はコーディングで信頼できますか?
初期のローンチテストは、小規模なコーディングサンプルしか提供していません。Quantslant は4つのコーディングタスクを報告し、1つのタスクでユニットテストの失敗がありましたが、Spring Prompt はコーディングをテストしていません。コーディングワークフローの判断を下す前に、自分のタスクでリポジトリテストを実行し、重要なものを繰り返してください。
Muse Wonder の信頼性を自分でテストするには?
実際のタスクの固定セットを使用し、正確なモデルとプロンプト設定を保存し、合格基準を事前に定義し、すべての出力を保持します。重要なタスクを繰り返し、テストやソース文書で結果を検証します。
各 Muse Wonder タスクを何回繰り返すべきですか?
影響の大きいタスクでは、初期の一貫性チェックとして少なくとも3回実行します。3回の試行は依然として小規模なサンプルなので、エラーのコストが高い場合や出力が変動する場合はセットを拡大します。
Muse Wonder と Muse Wonder Full の違いは何ですか?
これらは別々のモデルバリアントで、利用可能なルートが異なります。最大推論の標準 Wonder を Full として扱ったり、一致したテストなしに結果を相互に移したりしないでください。
Meta の Muse Wonder ベンチマークスコアは信頼できますか?
ベンダー報告の能力証拠として使用し、ベンチマークのセットアップを読んでください。それらは、あなたのプロンプト、ツール、繰り返し実行にわたる一貫した性能を証明するものではありません。
Muse Wonder は Atlas Cloud で利用できますか?
2026年10月15日時点で、Atlas Cloud のモデルカタログで確認できませんでした。実行プロバイダーを選ぶ前に、ライブカタログを確認してください。





