

声は涙をこらえているように聞こえても、アニメーションの顔は無表情のままでいることがある。OmniHuman 2.0の感情音声と表情のマッチングでは、最初の修正は多くの場合、形容詞を増やすことではなく、もっと注意深く聴くことだ。音声にはすでに言葉、タイミング、声の強調が含まれている。短いプロンプトは、それらの手がかりを支える目に見える演技を指示するべきだ。
このガイドでは、クリエイターがポートレートとトラックを準備し、焦点を絞ったプロンプトを書き、結果を確認して意味のある不一致を見つけるための再現可能な方法を紹介する。音声と歌唱を扱い、文書化された情報、第三者によるガイダンス、未検証の製品主張を区別する。
重要なポイント
- 音声を演技の土台として扱い、目に見える動作、フレーミング、シーン詳細だけを指示する。
- プロンプトを書く前に感情の山場をマークし、同じ瞬間をミュートあり/なしで確認する。
- 再試行ごとに変更する変数は1つにする。プロンプトはすべてのソース音声や生成の問題を修復できるわけではない。
OmniHuman 2.0が音声、表情、動きをどのように結びつけるか
音声駆動型ポートレートモデルを考える有用な方法は、各入力に役割を割り当てることだ。画像は目に見える被写体を固定する。録音は、タイミングと話し方を含むスピーチや歌を提供する。任意のテキスト指示は、演技やシーンを説明できる。正確な動作と制御は製品実装によって異なる場合があるため、一般的なOmniHuman研究や第三者のスタジオの指示を、公式のOmniHuman 2.0仕様として扱わないこと。
元のOmniHuman-1の研究は、画像、テキスト、音声、ポーズの組み合わせを条件とするヒューマンアニメーションについて述べている。この論文は研究ファミリーのより広い枠組みを示すものであり、OmniHuman 2.0の正確なインターフェース、制限、品質を示すものではない(ICCV 2025、OmniHuman-1の論文)。
| 入力 | 考えられる寄与 | 準備できること |
|---|---|---|
| 参照ポートレート | 被写体の外見と開始ポーズ | 意図する動きに適した、はっきりした顔とフレーミングを選ぶ |
| 話し声または歌声の音声 | 言葉、抑揚、間、声のエネルギー | 意図した話し方のクリーンなトラックを使い、不要な無音をトリミングする |
| 任意の演出プロンプト | 目に見える動作、フレーミング、シーン、ムードの手がかり | 録音と一致する具体的な指示をいくつか与える |
リップシンクと感情的な演技は関連しているが、同じ品質チェックではない。口が音節を追っていても、目、頭、ジェスチャーがセリフに合わないと感じることがある。同様に、顔が表情豊かに見えても、タイミングが声からずれることがある。両方を確認する。
第三者のOmniHuman 2.0ガイドは、任意のテキスト指示を伴う画像+音声ワークフローを説明しているが、それらのページはBytePlusの技術文書ではない。公開されているAtlasの文書は、独自のAvatar Omni Human 1.5モデルを扱っており、OmniHuman 2.0ではない。したがって最も安全な作業上の前提は、絶対的ではなく実用的である。音声に演技に何が必要かを示唆させ、確認できる目に見える選択をプロンプトで要求する。
感情が読み取れるポートレートと音声トラックを選ぶ
モデルは、見たり聞いたりしにくい手がかりに基づいて演技することはできない。まずモデルに公平で簡単なタスクを与える入力を選び、プロンプトの文言をテストする間はそれらを固定する。
| 開始入力 | 役立つ理由 | 注意すべき複雑さ |
|---|---|---|
| 均一な光で、はっきりと遮られていない顔 | 顔の特徴を読み取りやすくする | 強い影、髪、手、小道具が重要な領域を覆うことがある |
| 中立または穏やかに表情のある開始ポーズ | 演技が変化する余地を残す | 強い固定表情が異なる声のムードと衝突することがある |
| はっきりした前景の声が1つ | スピーチと間を追いやすくする | 音楽、部屋のノイズ、重なる話し手が手がかりを覆い隠すことがある |
| 聞こえる間を伴う意図的なフレージング | 目に見える動作に対応づける瞬間を与える | 平板な話し方では明確な感情の変化が少なくなることがある |
| 明確なフレーズがあるボーカル主体の曲 | 歌われる言葉と強弱を特定しやすくする | 器楽部分は口の動きのための声の手がかりが少ない |
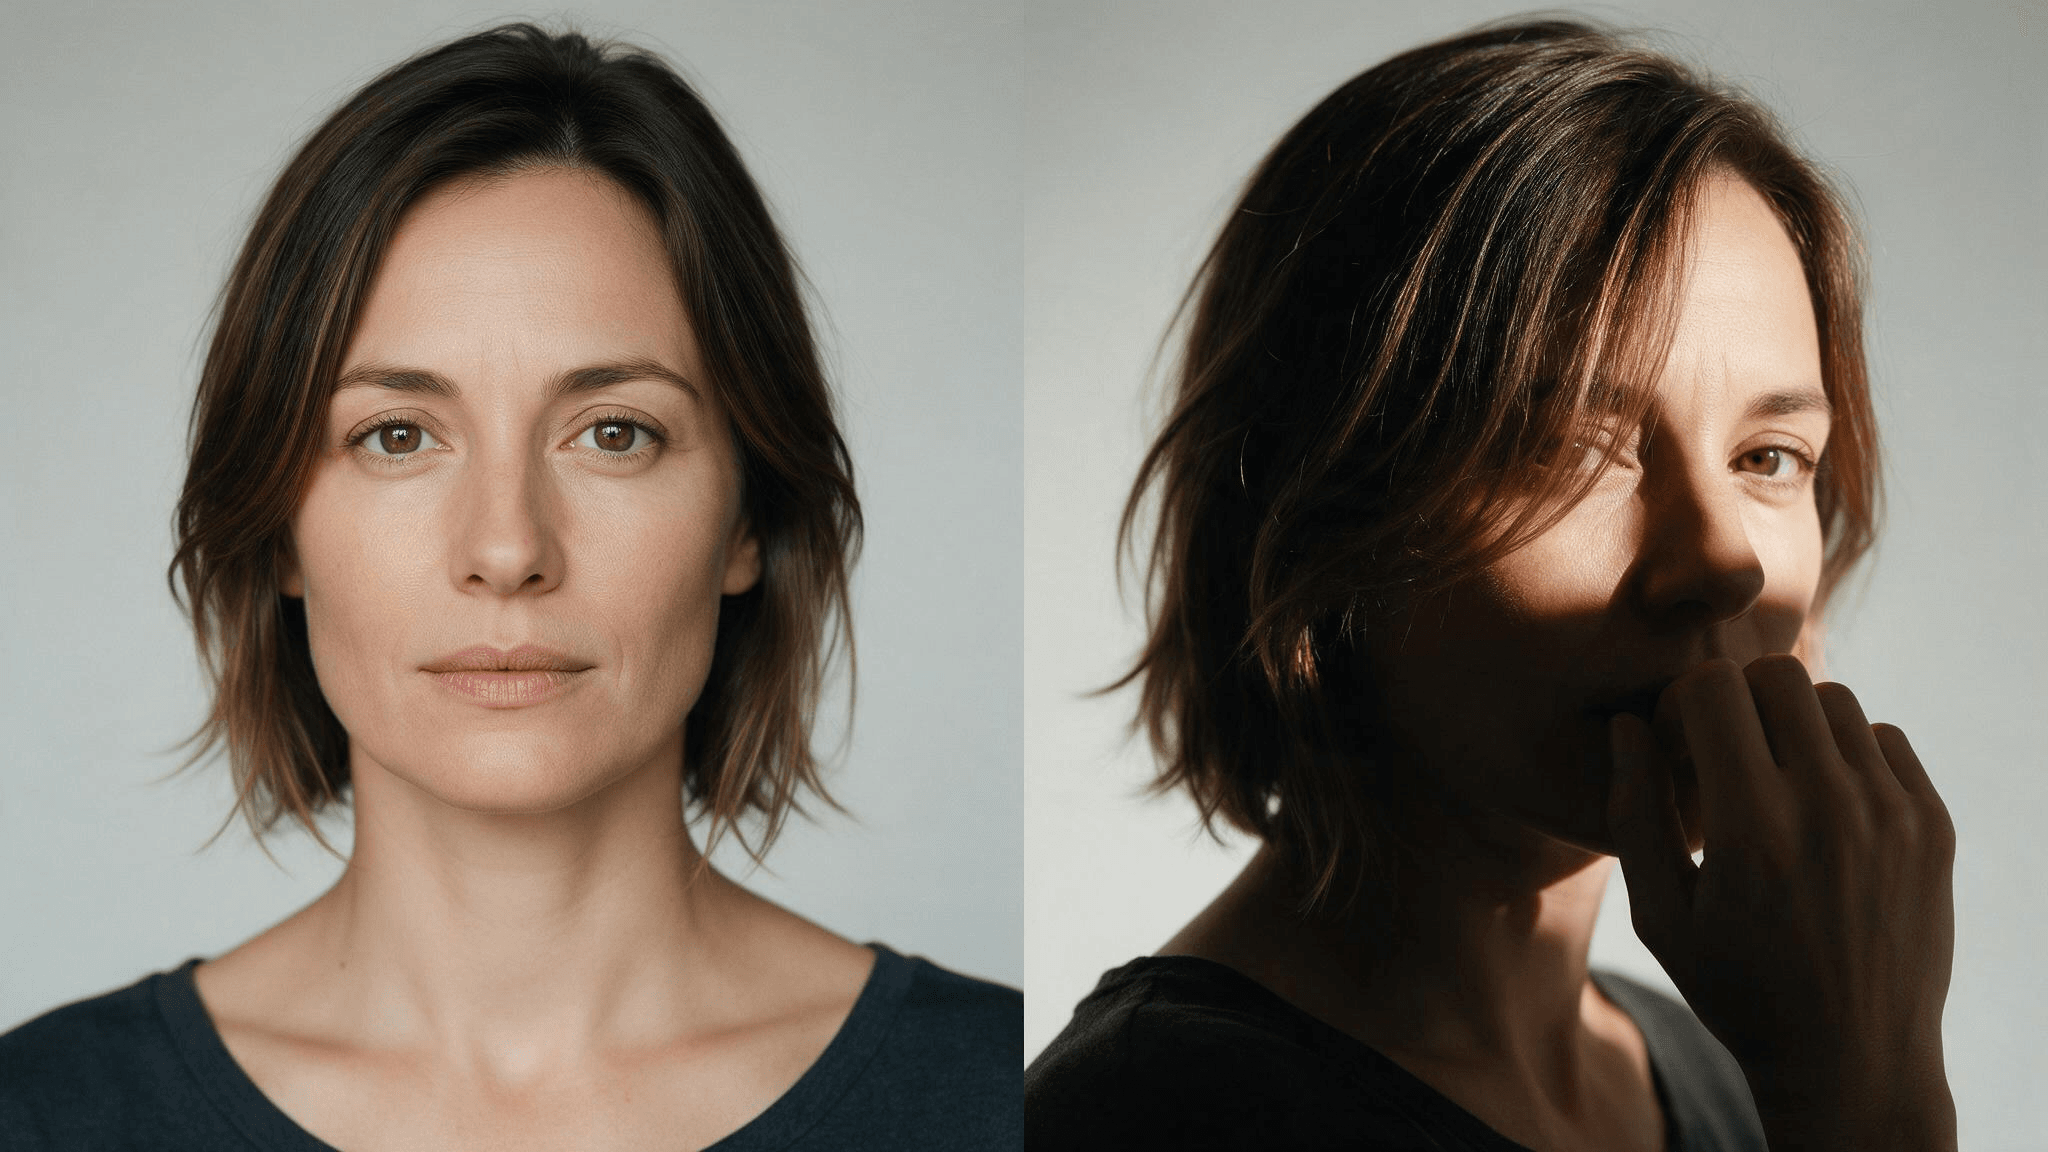 例示的なポートレート比較:はっきりした正面のビューの方が、影があり部分的に隠れたビューよりも顔の手がかりを確認しやすい。これはモデル出力の比較ではない。
これらは制作上のチェックであり、保証ではない。良い入力でも弱いテイクが生成されることがあり、視覚的に表情豊かなポートレートが一貫したアニメーションを保証するわけではない。最初のテストでは、1つのポートレート、1つの短い音声セクション、1つのプロンプトを使う。クロップ、録音、指示を同時に変えるのは避ける。そうしなければ、どの調整が役立ったのか分からなくなる。
歌唱では、フレーズの終わり、伸ばした音、強度の変化に耳を傾ける。プロンプトは音楽のビートの周辺で頭の傾きや手の動きを指示できるが、録音にすでに含まれている歌詞を繰り返すべきではない。話し言葉の対話では、間と強調語をマークする。継続する穏やかな文の間に大きなムードの変化を求めるプロンプトは、押しつけられたように感じられる演技を生むことがある。
声と表情を一致させるためのプロンプトの枠組み
指示は評価できる程度に短く保つ。実用的な構造は次のとおりだ。
フレーミング + 話し手と話し方 + トラックと一致する感情 + 目に見える動作を1つか2つ + 任意のカメラ指示。
たとえば、話し手が温かく落ち着いて聞こえるなら、次のように書ける:
安定したミディアムクローズアップ。女性はカメラに向かって温かく話し、最初は落ち着いた様子で、最後の行で小さな微笑みを浮かべる。間の後に一度、優しくうなずく。フレーミングは安定させる。
これは例示的なプロンプトであり、報告されたOmniHuman 2.0の実行ではない。役立つ特徴は、各指示が目に見える何かに対応していることだ。ショットは安定し、表情は終わり近くで変わり、うなずきには手がかりがある。広い要求(たとえば「感情的に」)を判断するのではなく、結果をトラックと比較できる。
第三者のプロンプトガイドは、簡潔な自然言語の指示と、要求する感情を声に合わせることを推奨している。それは保証や公式の製品ルールではなく、実用的な経験則として扱う(KreatorFlowプロンプトガイド)。
プロンプトを使う前に、録音と照らし合わせて確認する:
- 声が静かで抑制されているなら、大きな笑顔ではなく微妙な表情を要求する。
- 話し方がより自信に満ちていくなら、目に見える変化を聞こえる変化の後に置く。
- 録音に笑い、間、ため息が含まれるなら、その時点で顔を保つべきか、反応するべきか、動くべきかを決める。
- 開始ポートレートがすでに望ましい表情を示しているなら、表情を変えたいのでなければ、それを再び説明するのは避ける。
「最初に」「次に」「最後に」のような時間的な言葉は、音声に明確なビートがある場合にのみ使う。「固定フレーミング」と「周回カメラ」、「穏やか」と「激怒」など、矛盾する指示を重ねるのは避ける。プロンプトは既存の演技への指示であり、代替の音声トラックではない。
音声、感情の変化、歌唱のための3つのプロンプトパターン
音声に合う最小のパターンを選ぶ。これらの例は適応させるためのテンプレートであり、検証済みの出力主張ではない。
穏やかな説明
安定したミディアムクローズアップ。話し手は落ち着いた表情と、1つの小さな強調ジェスチャーで、冷静に要点を説明する。カメラは固定する。
トラックが節度があり一貫しているときに使う。1つのジェスチャーで、わかりやすい説明を芝居がかった演技にすることなく、強調を目に見える形にできる。
感情の変化
固定クローズアップ。話し手は真剣に始め、最後の文の前の間の後で、小さな微笑みへとやわらぐ。動きは控えめにする。
録音に、その変化を支える間または聞こえる変化がある場合にのみ使う。手がかりがなければ、遷移は恣意的に見えることがある。
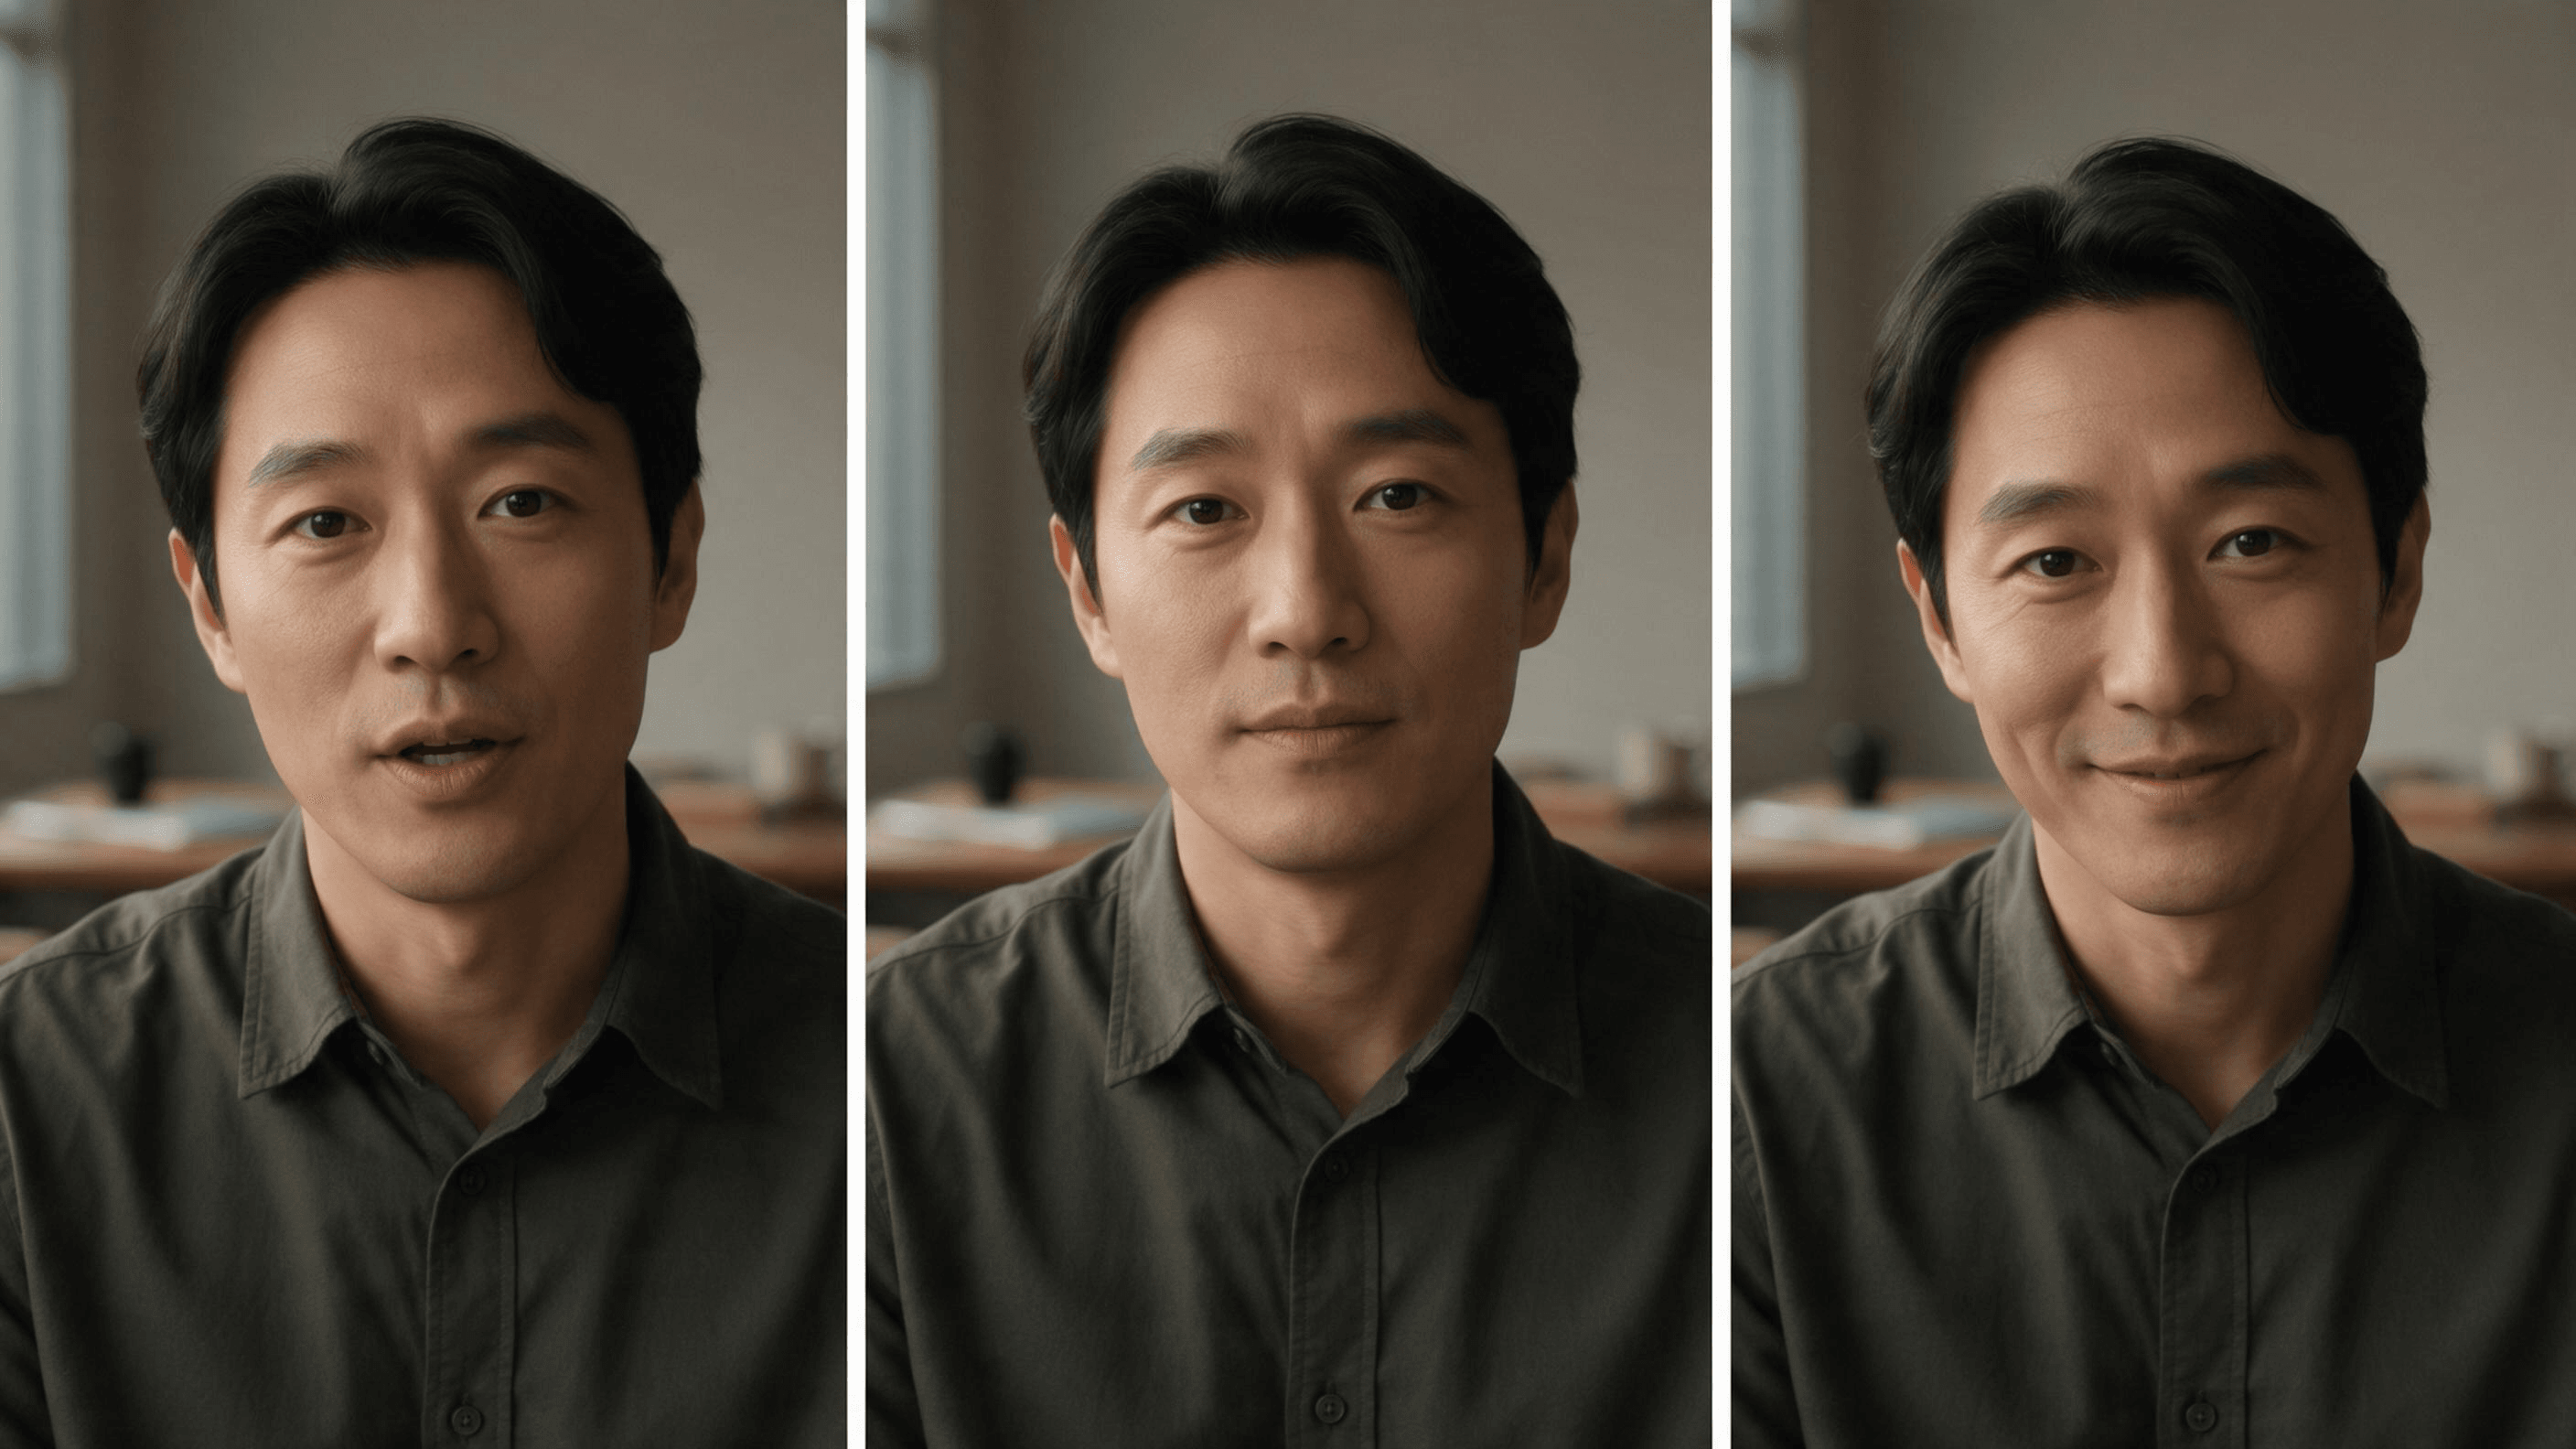 音声プロンプトの概念的ストーリーボード:真剣な話し方、間、そして控えめな微笑み。これらは計画された表情のビートであり、OmniHuman 2.0生成のフレームではない。
歌唱
ミディアムクローズアップ。歌手は集中した表情で演じ、伸ばした音で一瞬目を閉じ、フレーズが終わるにつれてあごを下げる。フレーミングは安定させる。
歌詞を言い換えるのではなく、音楽的な出来事の周辺で演技を指示する。プロンプトは目に見える動作を示唆できるが、提供されたトラックが歌われる言葉とタイミングの源であり続ける。
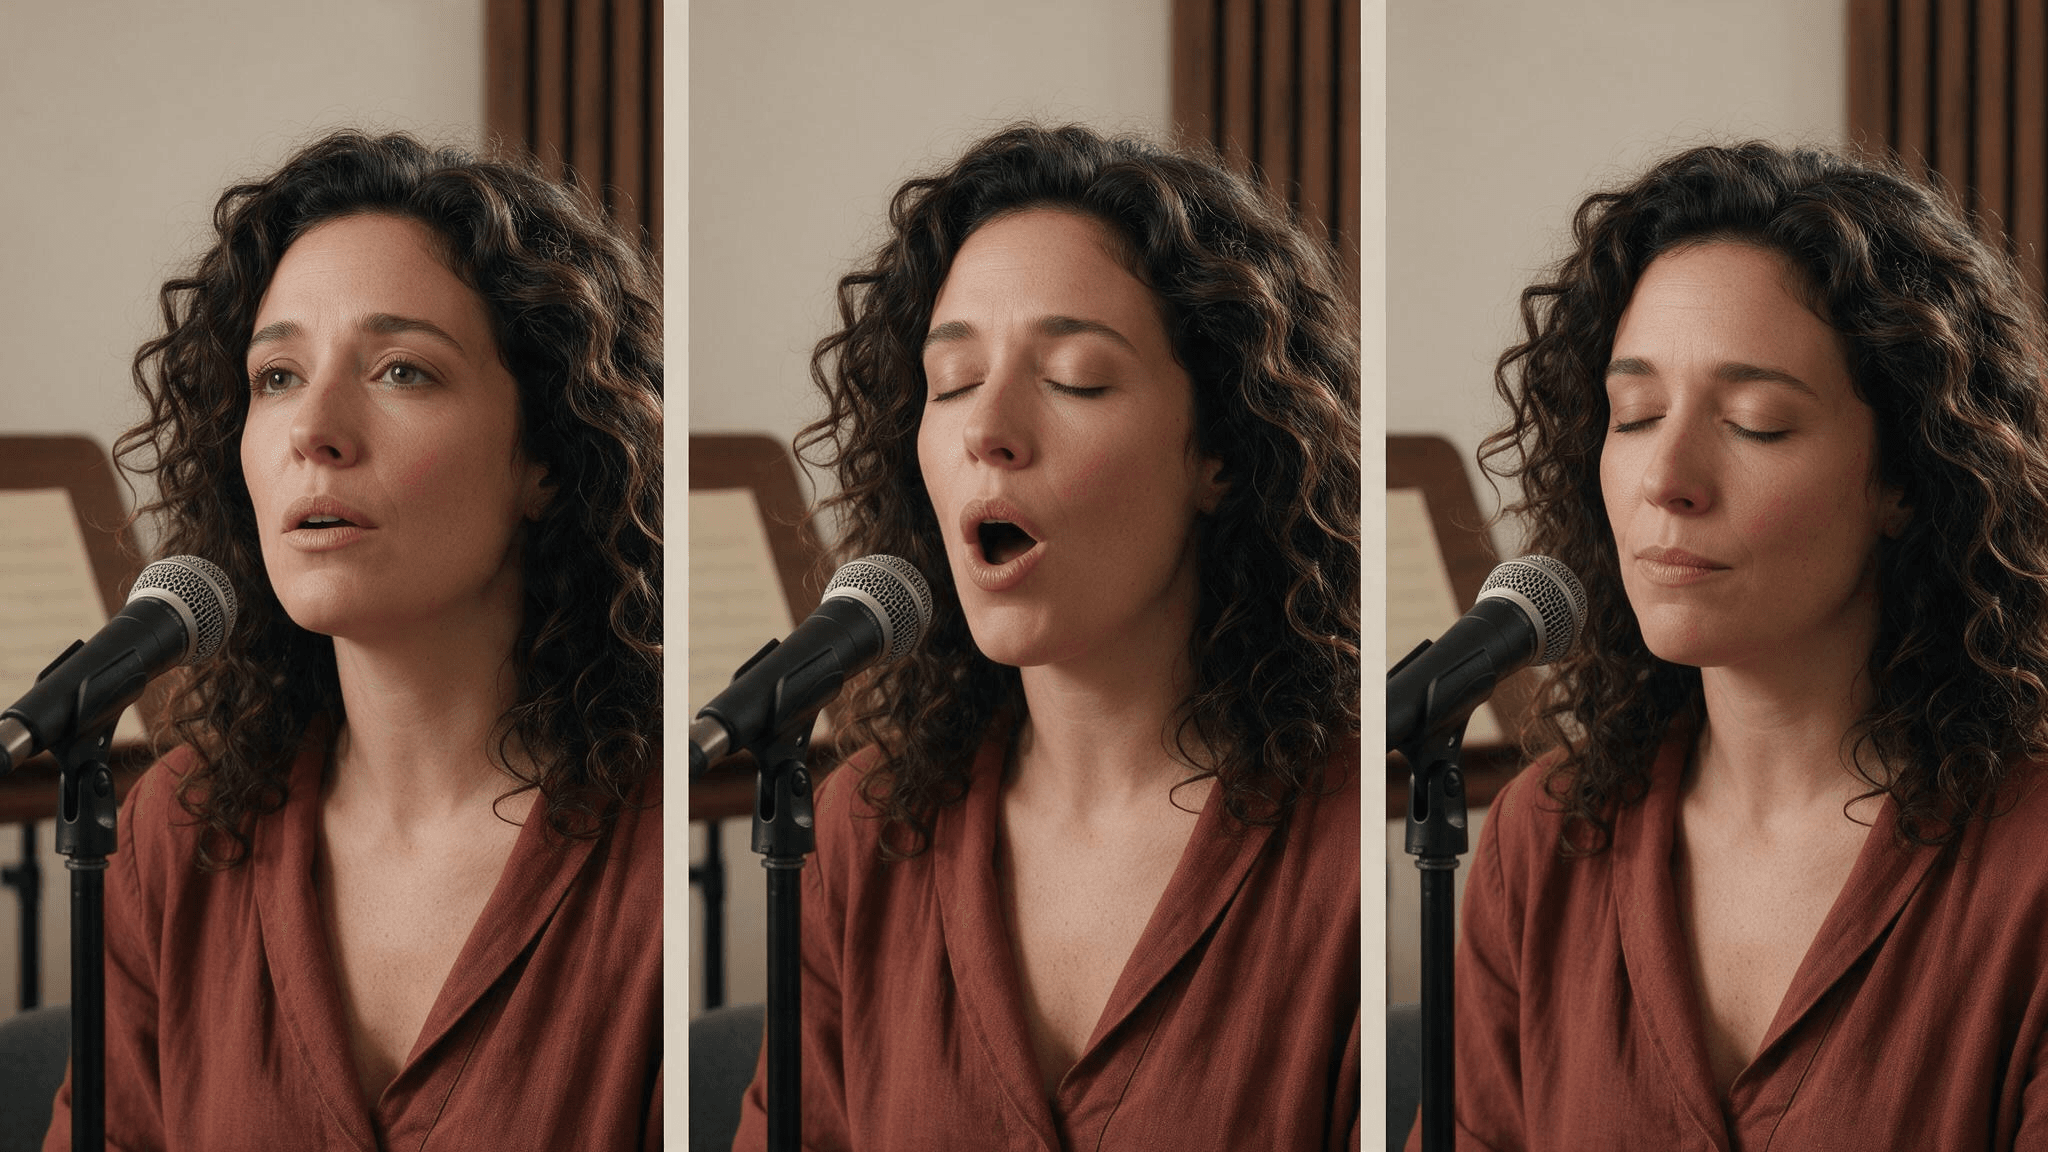 歌唱プロンプトの概念的ストーリーボード:フレーズを始め、音を伸ばし、最後に落ち着く。静止画は音声同期を示すものではない。
「感情的で映画的に」と「温かく話し、間の後で微笑む」を比較する。前者は感情、タイミング、目に見える動作を解釈に委ねる。後者は確認すべき特定の瞬間を1つ与える。結果がその瞬間を外したなら、次に行う的を絞ったテストがある。手がかりを移動する、表情をやわらげる、別の音声編集を選ぶなどだ。
声と顔の一致を確認する3パスチェック
簡単なレビュー方法で、問題が音声、視覚的な指示、生成されたテイクのどこにあるかを明らかにできる。3回すべてで同じタイムスタンプを使う。
以下の無音ループでは、話す演技の目に見える部分(口の動き、視線、表情の変化)を確認できる。声と顔のチェックには、音声付きの元のクリップを使う。
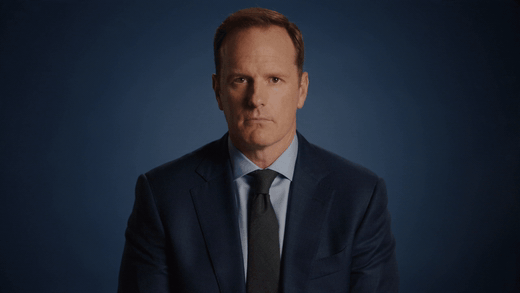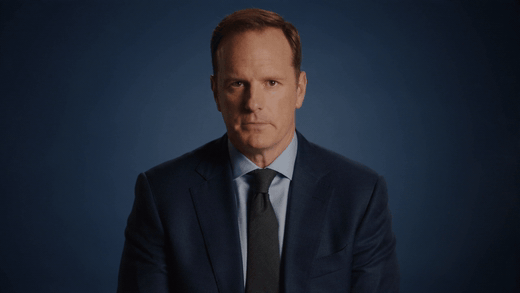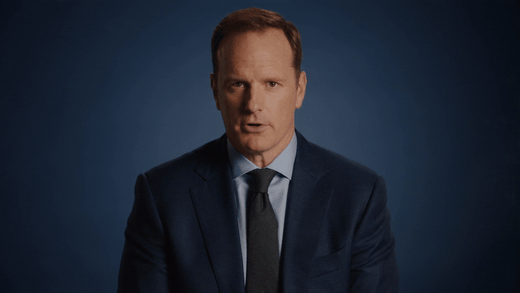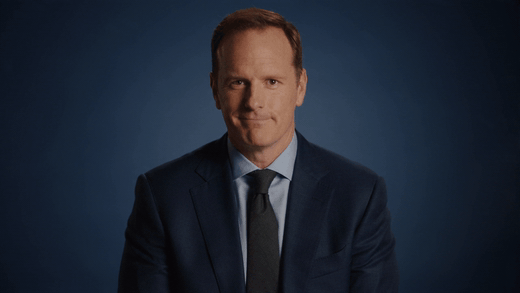
提供されたアバター動画から変換した無音GIF。目に見える動きは示すが、音声同期やOmniHuman 2.0のパフォーマンスを単独で証明することはできない。
- 見ずに聴く。 感情の変化、間、強調、笑い、ささやき、フレーズの終わりをマークする。聴き手が声だけで何を推測できるかを書き留める。
- ミュートで見る。 それらのタイムスタンプで、顔、視線、頭の動き、ジェスチャーに注目する。音声なしで演技が何を伝えているように見えるかを記録する。
- 一緒に再生する。 意味を変える、またはセリフから注意をそらす不一致だけに印をつける。苦悩のセリフの下の小さな微笑みは重要かもしれないが、軽いまばたきは通常重要ではない。
レビュー表は、それらの観察を1つの次のアクションに変える:
| 時間 | 声の手がかり | 目に見える手がかり | 一致? | 最小の次のテスト |
|---|---|---|---|---|
| 00:04 | 静かで緊張したフレーズ | 大きな笑顔 | いいえ | 要求する笑顔の強度を下げる |
| 00:09 | 安心させるセリフの前の間 | 顔が静止したまま | おそらく | 間の後に微妙なうなずきを1つ追加する |
| 00:13 | 録音内の笑い | 表情が真剣なまま | いいえ | 音声編集が笑いを明確に保っているか確認する |
上記の項目は、表の使い方の仮説的な例であり、モデル実行からの観察ではない。レビューノートは自分のクリップを参照するべきだ。一度に1つだけ変更する。プロンプトを修正する、音声編集を調整する、別のポートレートを試すなど。その後、同じ瞬間に同じチェックを繰り返す。
明確な手がかりと焦点を絞った指示があるにもかかわらず不一致が続く場合は、そのテイクの生成上の限界として扱う。形容詞を増やすと、タイミングや演技の問題を解決せずにノイズを加えるだけかもしれない。別の入力やワークフローを試す価値があるか、あるいはそのテイクが意図した文脈にすでに適しているかを判断する。
平板な表情や不一致な表情のトラブルシューティング
症状を使って、管理された次のステップを選ぶ。これらは一般的なトラブルシューティングの仮説であり、検証済みのOmniHuman 2.0の欠陥主張ではない。
| 気づくこと | 考えられる原因 | 次のテスト1つ |
|---|---|---|
| クリップ全体を通して顔が無表情に見える | 声にほとんどコントラストがない、または指示に目に見える手がかりがない | より表現豊かな音声部分を使う、または明確なビートで1つの具体的な動作を要求する |
| 顔が微妙なセリフを過剰に演じる | プロンプトがトラックの支える以上に強い感情を要求している | 余分な動作を削除し、感情の強度を下げる |
| 口がタイミングからずれて見える | 録音にノイズ、重なる声、長い無音、難しいカットがある | プロンプトを書き直す前に、よりタイトなタイミングのクリーンな編集を試す |
| グループ画像で聞き手が話しているように見える | テストしたワークフローでは話し手と聞き手の役割が曖昧かもしれない | インターフェースが対応しているなら、各人物を位置で特定し、誰が話すかを指定する |
| 動きの間に同一性や細部が変化する | ソースのフレーミングや要求した動きが一貫性の判断を難しくするかもしれない | 動きを簡素化し、より短く安定したテイクを比較する |
音声の問題に対してプロンプトだけの修正を想定しない。まず言葉が明確か、無音や編集がリズムを乱していないかを確認する。それらが問題なければ、目に見える指示を簡素化する。焦点を絞った再試行は、すべての入力を一度に書き直すよりも良い根拠を与える。
OmniHuman 2.0はAtlas Cloudで利用できますか?
Atlas Cloudの現在の公開モデルページにはAvatar Omni Human 1.5が掲載され、その画像、音声、任意のプロンプト入力が文書化されている。この確認時点で、Atlasのモデル一覧にOmniHuman 2.0は見つからなかった。つまり、正確な2.0モデルはAtlas Cloud経由で実行可能として提示されるべきではない。
Atlasで関連する音声駆動型アバタータスクを試したい場合は、Avatar Omni Human 1.5モデルページとその文書化された入力を確認する。ドキュメントでは参照画像、音声URL、任意のプロンプトが指定されている。音声は最大60秒で、最高品質には15秒以下を推奨している。これらはv1.5の詳細であり、OmniHuman 2.0の仕様ではない。ワークフローを選ぶ前に、現在のAtlasモデルカタログでリアルタイムの利用可否と価格を確認する。調査中にこのモデルの現在の公開価格を確認できなかったため、本記事では価格を引用していない。
公開前に権利と文脈を確認する
アニメーション化した人物を共有する前に、意図した目的でポートレートと声を使用する許可があることを確認する。特定の文脈について、音楽、肖像、声、配布の権利も確認する。要件はソース素材と用途によって異なる場合がある。このチェックリストは実用的なガイダンスであり、法的結論ではない。
視聴者がドキュメンタリー映像や実在人物の現在の発言と合理的に誤解する可能性がある場合は、合成または編集されたメディアにラベルを付ける。ソースファイルと編集に関するプロジェクトノートを保管する。特にクライアントやキャンペーンの作業ではそうする。技術的に一致した演技でも、責任ある公開の文脈が必要だ。
OmniHuman 2.0の感情音声と表情のマッチングでは、次に役立つステップは管理されたテストだ。明確なポートレートを選び、音声の感情のビートをマークし、短い指示を1つ書き、同じタイムスタンプを音声オフとオンで確認する。Atlasでホストされるオプションを検討しているなら、まず正確なモデルと現在の価格を確認する。
よくある質問
OmniHuman 2.0は声を生成しますか?
第三者のガイドで説明されているワークフローは、提供された音声から始まり、それに合わせてポートレートをアニメーション化する。特定の製品インターフェースがその機能を文書化していない限り、モデルが声を生成すると想定しない。
OmniHuman 2.0は音声だけでなく歌唱もアニメーション化できますか?
第三者のOmniHuman 2.0ガイドは、話し声と歌声の両方の音声利用を説明している。歌唱テストでは、明確なフレージングのボーカル主体の部分を使い、伸ばした音やフレーズの終わりの周辺で目に見える動作を指示する。
プロンプトはセリフや歌詞を繰り返すべきですか?
通常はいいえ。録音がすでに言葉を提供している。プロンプトは表情、ジェスチャー、フレーミング、シーンの手がかりなど、目に見える指示に使う。トラックと矛盾する文言を加えるのは避ける。
表情が間違っていると感じたら、最初に何を変えるべきですか?
3パスチェックを使って不一致の場所を特定する。音声自体が不明瞭または感情的に平板なら、まず音声編集を試す。手がかりが明確なのに顔がそれに合わないなら、1つのプロンプト指示を簡素化し、タイミングを調整する。
OmniHuman 2.0はAtlas Cloudにありますか?
この調査中に、Atlas Cloudの公開モデルカタログでOmniHuman 2.0は見つからなかった。Atlasは関連オプションとしてAvatar Omni Human 1.5を文書化している。選択する前に現在の掲載を確認する。





