

どんなに巧みな文でも、失われた肩、手、服装のディテールを確実に復元することはできません。OmniHuman 2.0による1枚の画像からの全身ジェスチャー生成は、調整された選択として最もよく機能します。動かしたい身体部位を含むフレーム、明確なパフォーマンスの手がかりがある音声、1つの動作を説明する短いプロンプトをモデルに与えます。
OmniHumanは音声駆動型の人物動画生成システムです。宣伝されているワークフローは、静止画像と音声を組み合わせ、動きやカメラ動作のための任意のテキスト指示を加えるものです。「全身」は、あなたが望むパフォーマンスの種類として扱い、すべてのポートレートが完全で安定した人物を生成できるという保証とは考えないでください。ここで引用する公開文書化された仕様はOmniHuman 1.5のものなので、すべてのOmniHuman 2.0インターフェースやデプロイを説明するものと想定すべきではありません。
主なポイント
- ソース画像は、表示される身体領域と開始時の構図を決定します。
- 音声は話し声または歌声のタイミングを提供し、プロンプトは視覚的な指示を加えます。
- クロップをジェスチャーに合わせ、要求する動作を可視フレーム内に収めます。
- コミットする前に、現在の公式製品ページでバージョン、入力制限、価格を確認してください。
OmniHuman 2.0が全身ジェスチャーに対して行うこと
OmniHuman 2.0は、人物パフォーマンス動画を作成するための画像・音声駆動型の方法として提示されています。静止画像が被写体と初期ビューを確立します。音声はパフォーマンスに声、リズム、タイミングの基準を与えます。任意のテキストでシーン、動き、カメラ方向を記述できます。生成されたクリップはこれらの手がかりを組み合わせて動く結果にします。
そのため、このタスクは静止した口を動かすだけよりも幅広くなります。有用なテイクには、口の動き、表情、頭の動き、姿勢、手のジェスチャーが含まれる場合があります。これらの部位は同じパフォーマンスと一致している必要があります。話し言葉の解説では、重要なフレーズで小さく手のひらを開くジェスチャーのほうが、絶え間ない腕の動きよりも自然に見えることがあります。歌唱では、身体がトラック全体のフレーズ運びとエネルギーに追随できます。
モデルは1枚の写真からその人物の完全な3D記録を受け取るわけではありません。クロップ外に何があるか、被写体が動くときに隠れた表面がどう見えるべきかを推論しなければなりません。したがって、入力が顔だけの場合は、全身動作の要求にはより大きな不確実性が伴います。実用的な制御は、必要な動作に合わせて参照画像を選び、すでに視覚的に支えられている内容をテキストで微調整することです。
OmniHuman 1.5の研究プロジェクトページでは、1枚の画像からの音声駆動アニメーションが説明され、動きとプロンプト制御が議論されています。これはモデルファミリーの有用な背景情報ですが、特定のOmniHuman 2.0プロンプトが毎回特定のジェスチャーを生み出す証拠ではありません(OmniHuman 1.5プロジェクトページ)。
入力を選ぶ前に、意図するショットを1文で定義します。「腰から上のプレゼンターが1つのポイントを強調する」「全身のパフォーマーが歌いながら重心を移す」「クローズアップの話し手が落ち着いたセリフを届ける」などです。そうすれば、フレームと音声はその1つのタスクに資することができます。
ジェスチャーの余地を残すソース画像を選ぶ
全身ジェスチャーでは、最終構図にまだ合う範囲で最も広いソース画像から始めます。結果をクローズアップのトーキングヘッド動画として意図するなら、タイトなポートレートが適切な場合があります。視聴者に、手がオブジェクトを指すところや被写体が重心を移すところを見せる必要があるなら、それらの部位をソース画像に含めます。
| 意図する結果 | 有用な開始クロップ | 要求する妥当な動き |
|---|---|---|
| クローズアップのナレーション | 頭と肩 | 表情、頭の向きの変化、控えめな肩の動き |
| 製品説明 | 手が見える腰から上 | 短い指差し、提示、手のひらを開いた強調 |
| 立ちパフォーマンス | 身体の周囲に空間がある全身 | 姿勢の変化、重心移動、より大きなジェスチャー |
これらは制作上の選択であり、公開されたBytePlusの要件や成功保証ではありません。全身フレームでは、手、肘、足の周囲に少し余白を残します。すでに端に接している手は、動いた瞬間に切れる可能性があります。顔は判読できる程度に鮮明に保ち、可能なら均一な光を使い、被写体を横切る別の人物がいるソースは避けます。クリーンな背景は、望まない背景の動きにも気づきやすくします。
画像は、公開予定のショットに似ている必要があります。ポートレートのソースをランドスケープ出力に置くと、より多くの創作された背景と身体領域が必要になる場合があります。縦構図のソースは、縦型ソーシャル投稿向けの立ちキャラクターを判断しやすいことがよくあります。これらは構図ガイドラインです。実際のアスペクト比や解像度制限については、対象ツールの現在のコントロールを確認してください。
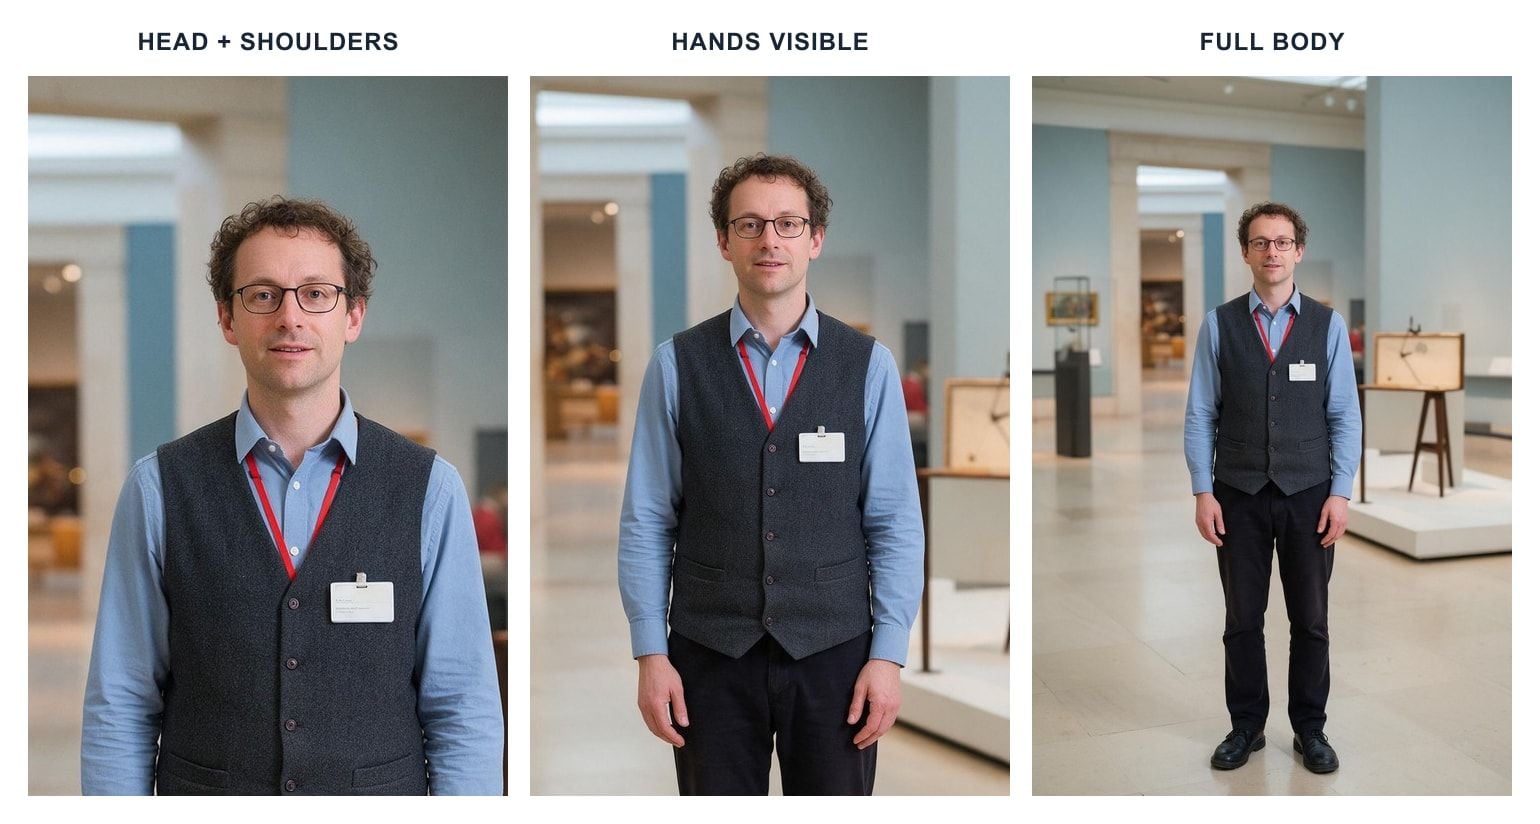
同じサンプルソース写真を3つのクロップで示したもの。クローズフレームは表情に適し、手が見えるとプレゼンターにジェスチャーの余地が生まれ、全身は立ちパフォーマンスを支えます。
簡単な判断テストが役立ちます。完成ショットで動かす必要がある身体部位を指し示します。それがソースに存在しないなら、画像を変更するか、動きの目標を下げます。たとえば、「3つの実践的なステップ」を強調するプレゼンターには、手が見える腰から上の画像を使います。顔だけのポートレートは、短い挨拶やクローズアップのナレーションにより適しています。
音声と指示から1枚画像のパフォーマンスを構築する
入力を3つの異なる役割と考えます。画像は、誰が画面にいて、ショットがどう始まるかに答えます。音声は実際の言葉、間、声のエネルギーを伝えます。テキスト指示は、それらの手がかりに合う視覚的振る舞いを求めます。入力は揃えてください。落ち着いた声と「激しく絶え間ないダンス」を組み合わせると、モデルに矛盾する指示を与え、ぎこちないパフォーマンスを生む可能性があります。
有用な初回ワークフローは次のとおりです。
- ショットを選ぶ。 視聴者に近い顔、見える手、全身のどれが必要かを決めます。その領域がフレーム内にあるソースを選びます。
- 代表的な音声を用意する。 実際のナレーションや楽曲の短いセクションを使い、ジェスチャーを行うべきフレーズを含めます。テストは最終的なリズムと話し方を表す必要があります。
- 動きのアイデアを1つ追加する。 1つのジェスチャーと、それがパフォーマンスのどこに入るかを説明します。他の動作やカメラ要求は控えめにします。
- 生成して確認する。 顔、手、身体、背景、全体のフレーミングを確認します。次の試行では一度に1つの入力だけを変更します。
製品説明では、独自のテスト用セリフは次のようになります。「3つの実践的なステップを取り上げ、その後、チームに合うものを選べます。」「3つの実践的なステップ」というフレーズの前に短い間を入れて録音します。両手が見える腰から上の画像を使います。これにより、意図するジェスチャーに明確な意味的な手がかりと目に見える可動範囲が与えられます。
ここで確認できる公式BytePlusドキュメントは、OmniHuman 2.0ではなくOmniHuman 1.5を参照しています。1.5では、必須入力として画像と音声、任意のプロンプト、サポートされるプロンプト言語、720pまたは1080p出力が記載されています。その概要には60秒の音声制限も記載され、品質のために短い音声を推奨しています。これらの詳細は、文書化された1.5製品を区別するのに役立ちます。2.0に適用する前に、2.0のインターフェースまたは公式ドキュメントを確認してください(BytePlus OmniHuman動画生成ドキュメント、2026年10月更新)。
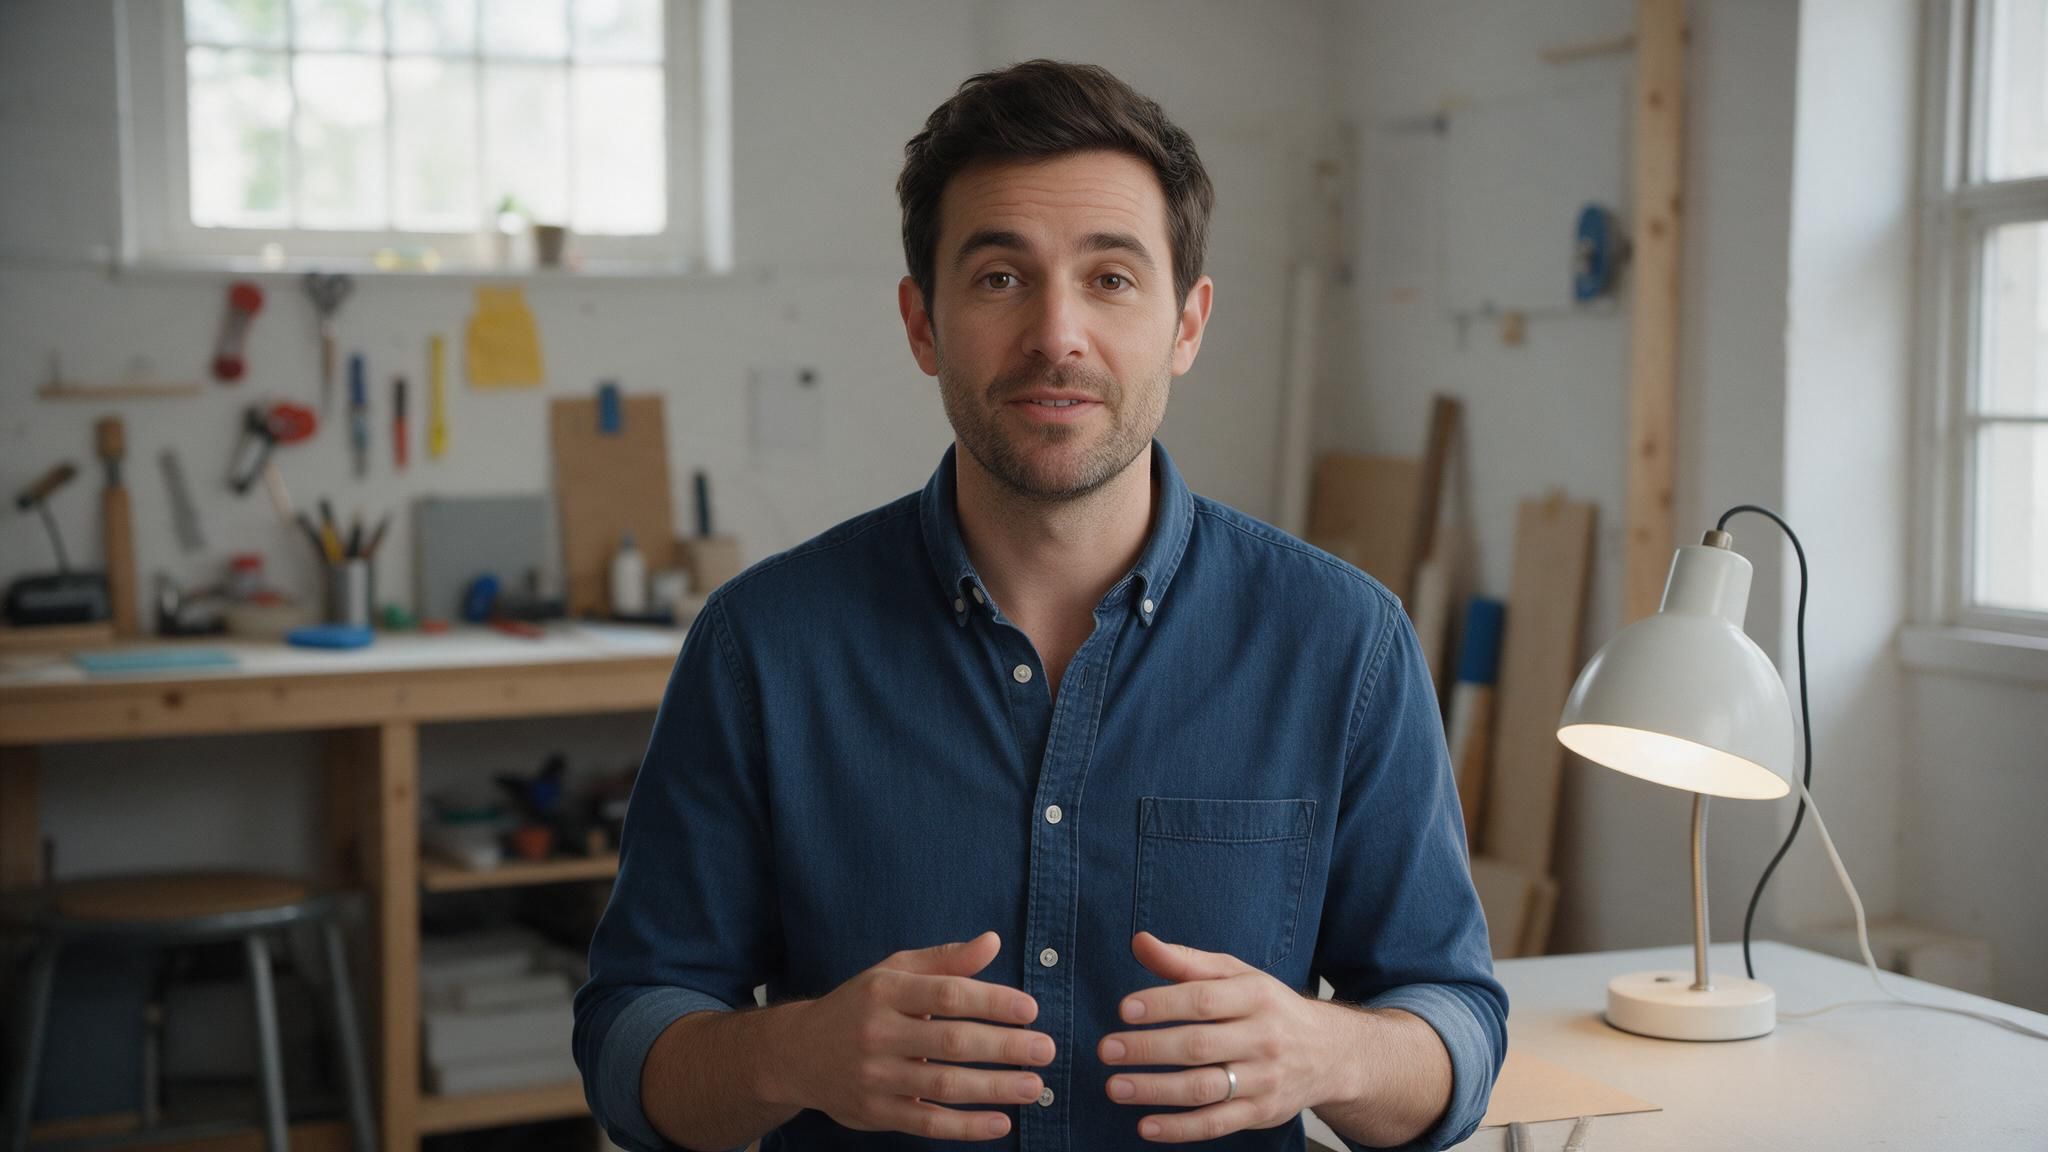
製品説明用のサンプルソーススチル。プレゼンターの顔、両手、ランプが見えるため、タイミングを合わせた小さな手のジェスチャーを評価しやすくなっています。これは入力写真であり、OmniHumanの出力ではありません。
長い録音を準備する前に、代表的なサンプルを1つ使います。短い試行は、一致しないクロップ、ジェスチャーの手がかりがないフレーズ、要求が多すぎるプロンプトに早く気づくのに役立ちます。これは品質管理上の選択であり、特定の2.0の長さ制限についての主張ではありません。
明確な手がかりを伴うジェスチャープロンプトを書く
プロンプトは、動作、その手がかり、大きさや速さ、構図上の制約を明示すると、評価しやすくなります。「人物を自然で表情豊かにする」のような広い指示では、いくつかの判断が開かれたままになります。焦点を絞った指示は、どの目に見える動作が重要で、いつ起こるべきかをモデルに伝えます。
上記のサンプルセリフでこの例を試してください:
話し手は落ち着いた自信のある口調でセリフを届けます。カメラは固定したままにします。話し手が「3つの実践的なステップ」と言ったら、ポイントを強調するために片手を短く上げ、その後自然に下ろします。可視フレーム内に収まる、小さくリラックスしたジェスチャーを使います。
引用したフレーズは、動作を音声内の瞬間に結びつけます。「片手を短く上げる」は範囲を限定したジェスチャーを与え、「可視フレーム内に収まる」はクロップを超える動きを要求しないようにします。これはプロンプト作成テンプレートであり、テスト済みまたは保証されたOmniHuman 2.0コマンドではありません。システムが正確な言葉やタイミングに一貫して従わない場合は、フレーズを広い手がかりとして扱い、フレーム単位で正確な振り付けを前提とせず、レンダリングされた動きを判断してください。
試行間では主要な変数を1つだけ変更します。ジェスチャーが早すぎる場合は、手がかりまたは音声の間を調整します。手の動きが大きすぎる場合は、要求する振幅を減らします。腕が不安定または一部が創作されている場合は、腕がすでに見えるソースを選びます。画像、音声、動き、カメラ方向を一度に変えると、どの変更が役立ったかを学びにくくなります。
無関係な要求を積み重ねるのは避けます。手を振る、指す、向きを変える、歩く、カメラ旋回、感情の変化をすべて1つの短い行に入れるなどです。それぞれが同じパフォーマンスに別の要求を追加します。意図のある動きを1つから始め、最初の結果が判読可能なままで、シーンが求める場合にのみ2つ目を追加します。
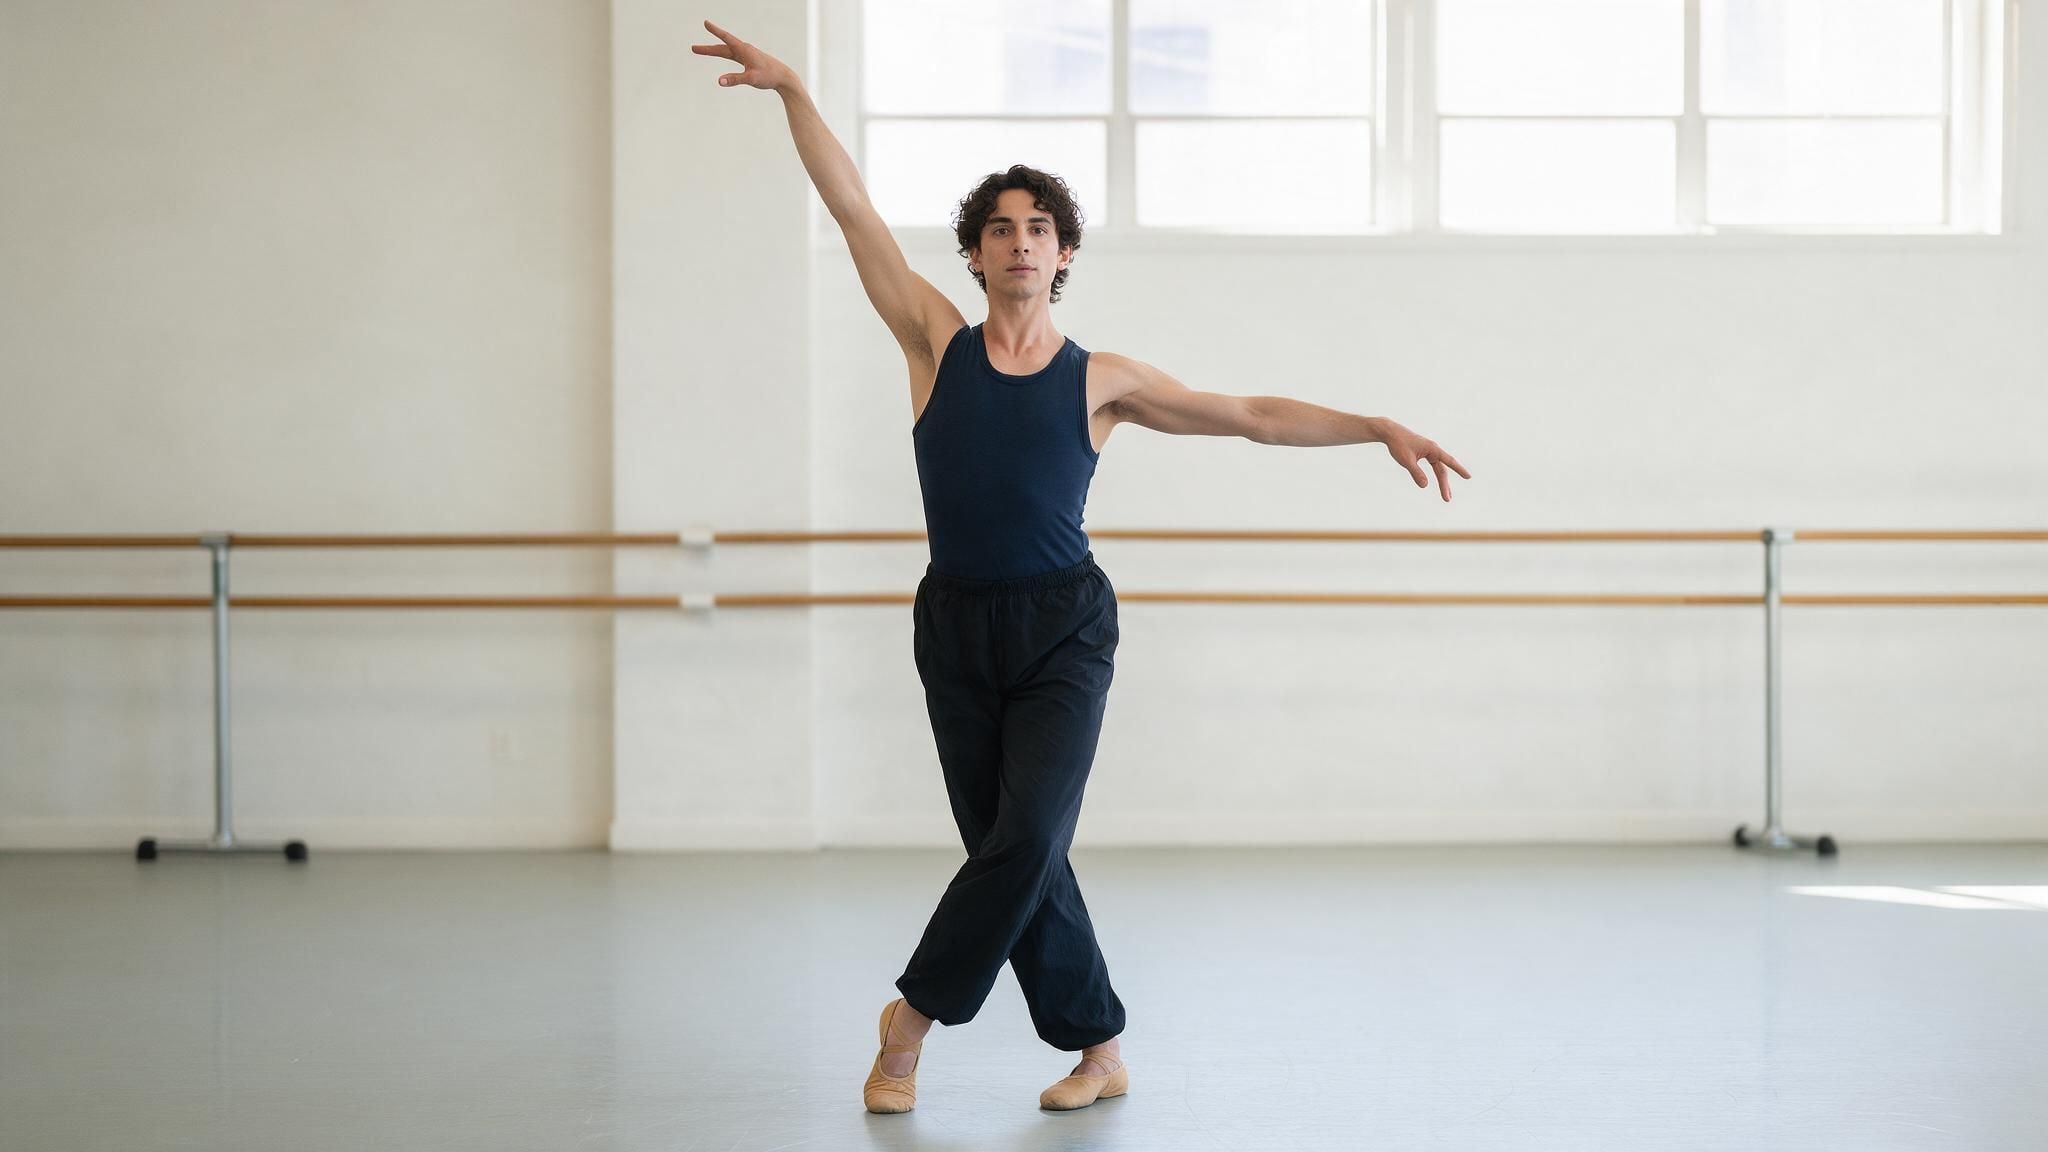
調整された全身ポーズ用のサンプルソーススチル。上げた腕、伸ばした腕、踏み出す足がフレーム内に収まっています。これはジェスチャーを計画するための参照画像であり、OmniHumanが生成したフレームではありません。
公開前に結果を確認する
結果をまず全体のパフォーマンスとして一度見て、次に特定の詳細をもう一度見ます。2回目の視聴は有用です。クリップは通常速度ではもっともらしく感じられても、よく見ると手や背景の問題が明らかになることがあるからです。
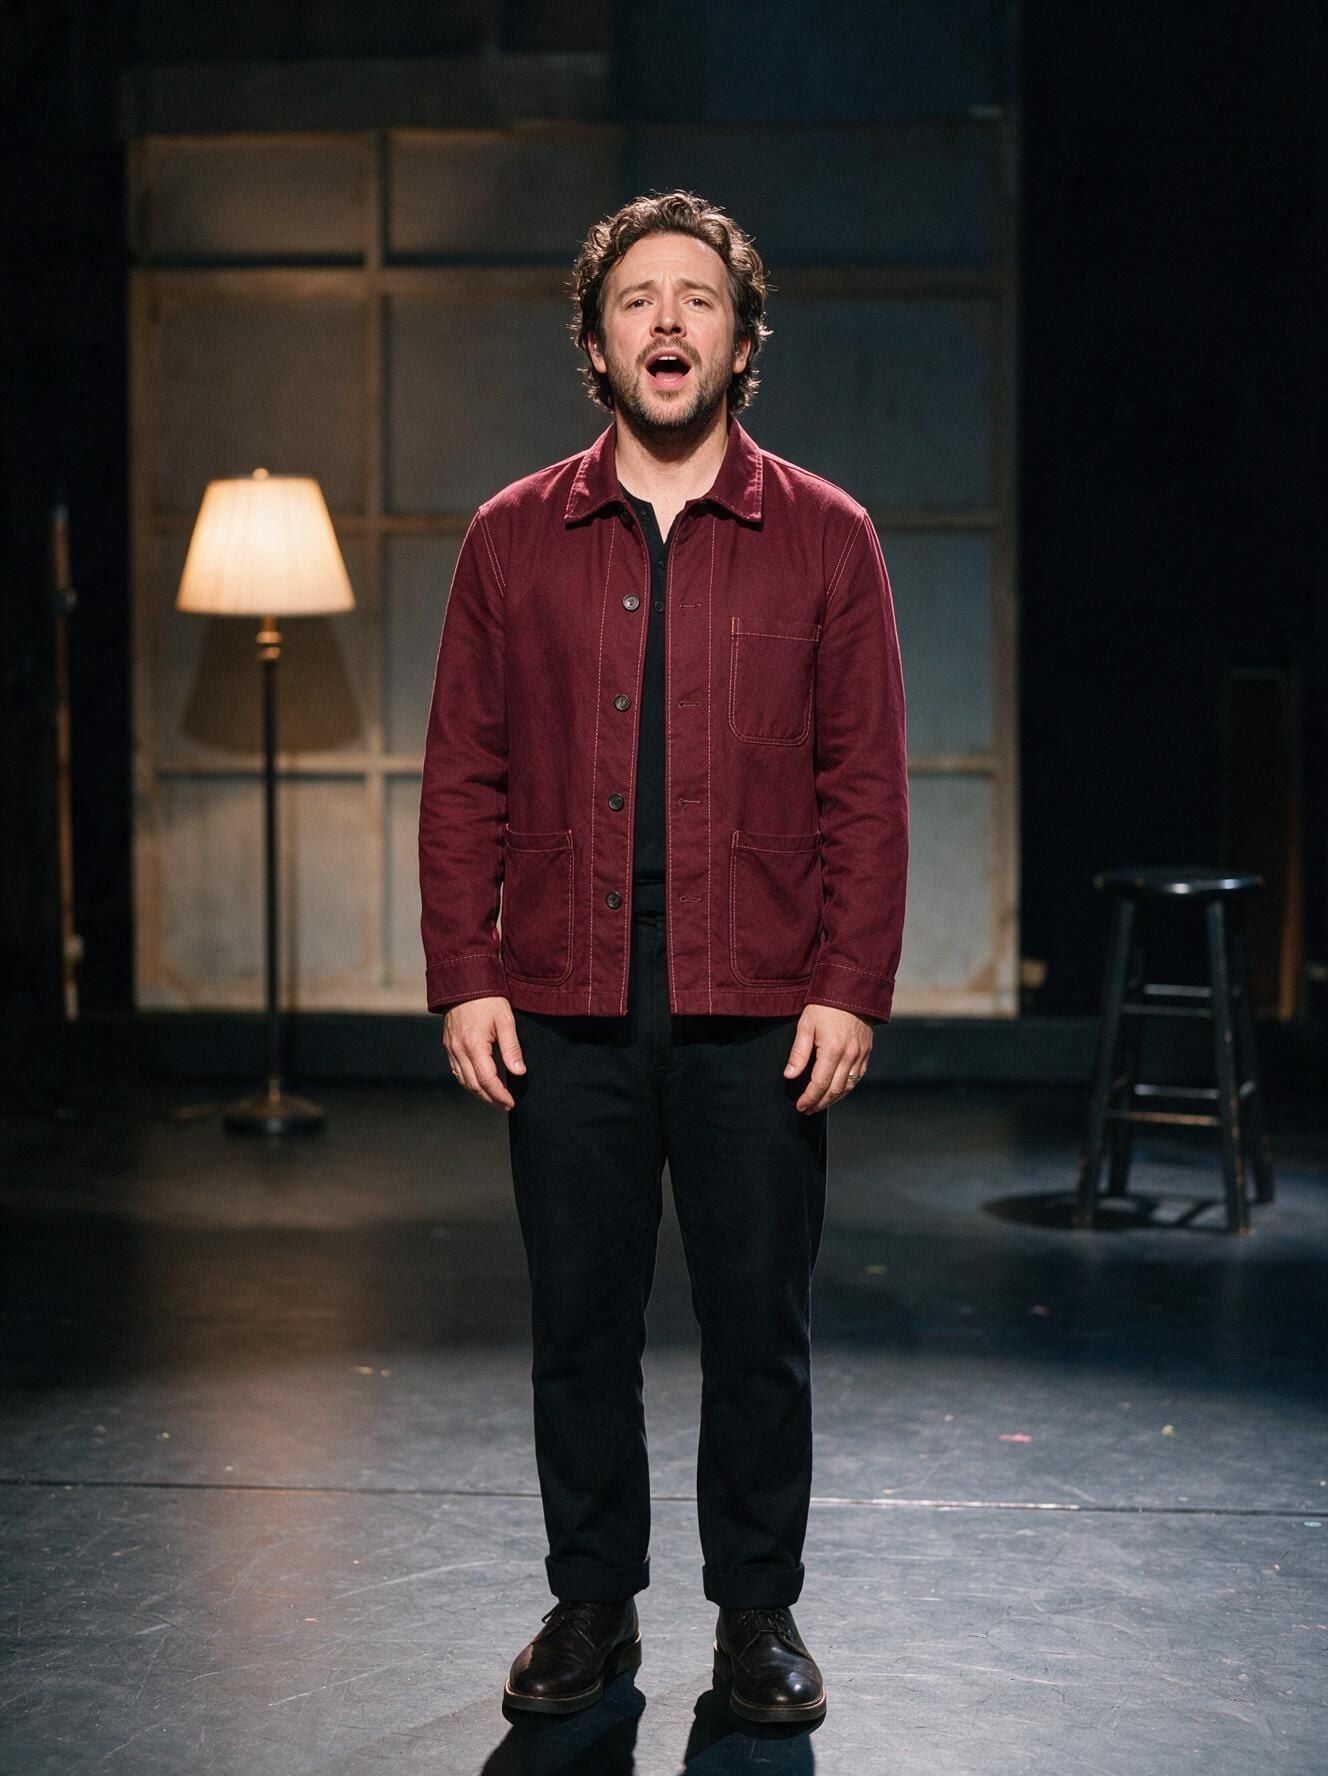
立ちパフォーマンス用のサンプルソーススチル。人物同一性とシーン一貫性を確認するときは、生成されたテイクを、見えている顔、手、ジャケット、靴、ランプ、スツールと比較します。これは入力写真であり、生成フレームではありません。
次の5つの領域を確認します:
- 発話と表情: 口は話されたフレーズや歌われたフレーズに大まかに従っていますか? 表情は声の届け方に合っていますか?
- ジェスチャーのタイミング: 動きは意図したアイデアや間の近くに現れますか? 強調が終わったら止まりますか?
- 手と身体: 一瞬指が融合する、関節が曲がる、袖が変わる、フレーム間で身体のプロポーションが変わるなどを探します。
- 人物同一性とシーン: 顔は認識できるままですか? 服装、背景オブジェクト、照明は合理的に一貫していますか?
- 見せ方の構図: 手や足が切れていませんか? 必要なアスペクト比とクロップで被写体がはっきり見えていますか?
何かが失敗したら、次の試行を観察された原因に結びつけます。必要な身体領域が欠けている、またはクロップに動きの余地がない場合は、画像を差し替えます。重要なフレーズが急ぎすぎている、不明瞭、感情的に不一致の場合は、音声を差し替えるか短くします。動作が間違ったタイミングで現れる、または広すぎる場合は、指示を書き直します。クリップが公開キャンペーン用なら、画像をアニメーション化して音声録音を使用する許可があることを確認し、表現される人々に必要な同意を取得してください。
有用な結果は、必ずしも最も動きが多いものではありません。コース紹介や製品説明では、人物同一性を保ち、被写体をフレーム内に保つ控えめなジェスチャーのほうが、視覚的なエラーに注意を引く凝った動作よりもよく伝わることがあります。メッセージを支え、公開形式を満たすテイクを残し、後で修正できるようにソース画像、音声、プロンプト、選択した出力をまとめて保存します。
OmniHuman 2.0のアクセス、バージョン、価格
BytePlusは、動画モデルの節約プランのドキュメントでOmniHuman V2.0を記載しています。これはバージョン名がBytePlusの資料に現れることを確認しますが、公開された2.0プレイグラウンド、詳細な入力制限、Atlas Cloudエンドポイントを確立するものではありません(BytePlus AI Savings Plans)。その周辺でワークフローを構築する前に、正確なモデルバージョンを確認してください。「OmniHuman 2.0」という名称は、「OmniHuman 1.5」と互換的に扱うべきではありません。この記事で現在参照できるBytePlusドキュメントは、OmniHuman 1.5と表示されています。それは独自の入力スキーマとサービス制約を文書化しており、対応する公式ソースなしに2.0に持ち越すべきではありません。
この記事のために確認した時点では、Atlas Cloudの公開モデルディレクトリに幅広いモデルカタログが表示されていましたが、そこにOmniHuman 2.0の詳細ページは確認できませんでした。特定のAvatar Omni Humanモデルページは、隣接する1.5の提供を識別しています。表示されている開始価格は公式資料で$0.12/秒と報告されていますが、価格と割引は変更される可能性があります。予算策定や公開の前に、詳細ページとAtlas Cloudモデルディレクトリを再確認してください。1.5の価格を2.0の見積もりとして使用しないでください。
特にOmniHuman 2.0が必要な場合は、制作アセットを準備する前に、BytePlusで公式のアクセス経路、現在の入力要件、価格を確認してください。隣接バージョンでもよければ、Atlas Cloudのディレクトリで、現在掲載されている動画モデルとアバターモデルのどれが1つのカタログから利用できるかを確認できます。それは別の製品選択として扱ってください。1.5の実行で2.0のプロンプトや結果を検証することはできません。
よくある質問
OmniHuman 2.0は顔だけの画像から全身動画を生成できますか?
顔だけの画像には、全身パフォーマンスを導くために必要な身体の詳細がありません。システムは欠けている領域を推論するかもしれませんが、その見た目と動きはソースに直接基づいていない度合いが高くなります。手のジェスチャーには、手と十分な腕が見えるソースを使います。立ち動作には、全身画像から始めます。
OmniHuman 2.0には音声が必要ですか、それともテキストプロンプトだけで画像をアニメーション化できますか?
説明されているOmniHumanワークフローは画像と音声によって駆動され、テキスト指示は任意です。使用予定の正確な2.0サービスがテキストのみの画像アニメーションをサポートすると想定しないでください。そのサービスの現在の製品ページで、受け入れられる入力を確認してください。
OmniHuman 2.0の音声入力はどのくらいの長さにできますか?
現在の公式2.0音声長制限を確認できませんでした。BytePlusが公開している1.5の概要では、60秒未満の制限が記載され、品質のために短い入力を推奨していますが、それは1.5の仕様です。長いトラックを録音またはアップロードする前に、公式アクセスポイントで2.0の制限を確認してください。
OmniHuman 2.0はすでにAtlas Cloudで利用できますか?
この記事の確認時点で、Atlas Cloudディレクトリに公開されたOmniHuman 2.0の掲載は確認できませんでした。Atlas Cloudの隣接するOmniHumanページは1.5用です。カタログの利用可能性は変わる可能性があるため、使用前にディレクトリを再確認してください。
次に OmniHuman 2.0による1枚の画像からの全身ジェスチャー生成 を試す前に、まず1つ決めてください。完成ショットで必ず見せる必要がある身体領域を特定し、それをすでに含むソースを選びます。使用するサービスで正確なバージョンと現在の制限を確認し、本番用のテイクを準備する前に、短く代表的な音声パッセージを1つテストしてください。





