本番環境のエージェント型パイプラインは、予期しないスキーマ違反によって頻繁にクラッシュします。最高水準の自己回帰型LLMでさえ、大量のツール呼び出し時にJSON解析に失敗し、開発者は複雑なリトライループとカスタムエラーハンドラーを構築せざるを得ません。
TypeSafe Jev は、逐次的なトークン単位の生成を完全に放棄することで、この構造的欠陥を解決します。非自己回帰型の意思決定モデルとして動作するJevは、アプリケーション状態を取り込み、事前宣言されたスキーマの質問を単一の並列フォワードパスで評価します。可能な出力選択肢が実行前に厳密に制限されるため、Jevは不正なJSON、無効なツール名、スキーマ外のテキストを数学的に排除します。
クイックまとめ: TypeSafe Jev AIとは? パフォーマンスと速度のベンチマーク
TypeSafe Jev AIは、サブ秒の分類、インテントスコアリング、構造化マイクロサービスルーティング向けに特化して構築された非自己回帰型の意思決定モデルです。自己回帰型LLMとは異なり、Jevは事前宣言されたスキーマ選択肢を単一のフォワードパスで評価します。
- 型レベルでのゼロハルシネーション: 文字列デコードループを境界付き状態スキーマプリミティブに置き換え、型エラー率0%を実現します。
- 500ms未満の実行: 非自己回帰型並列サンプリングにより、標準的なLLMより最大200倍高速な70ms~500msのP95レイテンシを達成します。
- 無料の出力トークン: 逐次生成トークンがゼロなので、出力トークンは完全に無料です $0.042/1M入力トークン。
- 最適な用途: マイクロサービスルーティング、エージェント型ツールディスパッチ、チケットトリアージ、インテントゲーティング。
AIスタックを再考する: System 1の直感 vs. System 2の推論
スケーラブルなバックエンドソフトウェアを設計する際、単純な条件チェックを重いチャット補完エンドポイントに通すと、深刻なシステムレイテンシが生じます。ほとんどのマイクロサービスは、創造的な文章や多段階の思考連鎖生成を必要としません。必要なのは、既知の選択肢に対する即時かつ決定論的な選択です。
カーネマンの認知フレームワークをソフトウェアアーキテクチャに適用する
TypeSafeの共同創業者Diogo Almeida氏は、以前OpenAIでReinforcement Learning from Human Feedbackの共同開発に携わりましたが、この非効率を解決するためTypeSafe Jevで構造的転換を導入しました。カーネマンの認知フレームワークを直接取り入れ、このプラットフォームは現代のAIスタックアーキテクチャ内で処理を2つの異なる運用レイヤーに分割します:
- System 2の遅く熟慮的な推論: 逐次的なトークン単位生成で動作する標準的な自己回帰型LLM。これらのモデルは、長文の下書き、曖昧な推論の処理、複雑なコードの作成を得意とします。
- System 1の高速で直感的な意思決定: 従来のRLHFではなく、Reinforcement Learning for Calibrated Decisionsで訓練された専用のSystem One AIモデル。会話的なオーバーヘッドなしで、サブ秒の分類、インテントスコアリング、実行ルーティングに特化して設計されています。
Jev vs LLMのコストとアーキテクチャ: 意思決定モデル vs. チャットモデル
汎用チャットモデルを特化型の型付き意思決定モデルに置き換えることは、迅速な評価を深い生成から分離することで、マイクロサービスワークフローを根本的に最適化します。
| アーキテクチャ次元 | 自己回帰型LLM (System 2) | TypeSafe Jev (System 1) |
| 主なタスク | オープンエンドなテキスト合成 | 離散選択とスキーマ評価 |
| 実行レイテンシ | 3,000ms~30,000ms+ | 70ms~500ms |
| 出力形式 | 非構造化テキストストリーム | 厳密に型付けされたスキーマプリミティブ |
| 計算ループ | 逐次トークンデコード | 単一フォワードパス評価 |
| 訓練目的 | 人間の選好 (RLHF) | 較正された意思決定信頼度 (RLCD) |
ルーティング、安全ガードレール、関数ディスパッチを標準チャットモデルからオフロードすることで、自己回帰型LLMに固有のパフォーマンスボトルネックを解消します。System One AIモデルを組み込むことで、重い推論エンジンはオープンエンドな生成が本当に必要な場合にのみ起動します。
TypeSafe Jevモデルが型レベルのゼロハルシネーションを実現する仕組み
厳密なJSONモードを有効にしても、フロンティアLLMは高並行の本番実行中にスキーマ外のキーやハルシネーションによるenum値をしばしば返し、パイプラインリクエストの0.5%~5%が失敗します。本番マイクロサービスには絶対的な型決定性が必要ですが、自己回帰型モデルは文字列生成エラーに対して本質的に脆弱なままです。
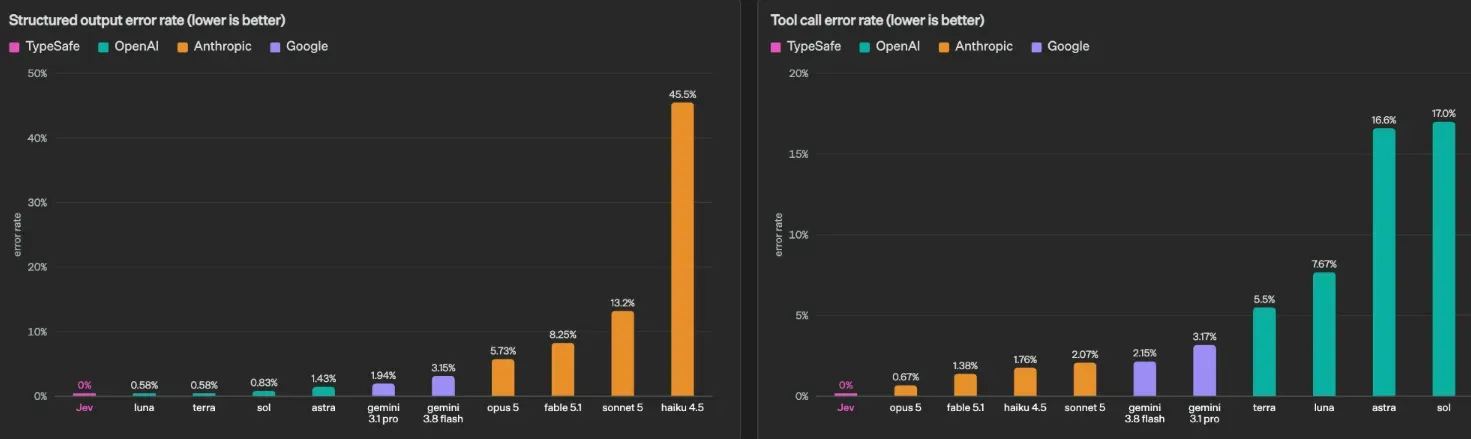
TypeSafe Jevは、文字列デコードループを境界付き状態アーキテクチャに置き換えることでこれを解決します。任意のテキストを生成してJSON構文に押し込もうとする代わりに、Jevは入力データを事前定義されたスキーマ制約に対して単一パスで評価します。この構造的転換により、型レベルでの真のゼロハルシネーションAIが実現し、自動化ワークフロー全体で型エラー0%を達成します。
3つの中核スキーマプリミティブ
Jevはすべての入力質問を3つの明示的プリミティブで処理します:
- Choiceプリミティブ: 最大255のカテゴリ選択肢からなる事前定義リストから正確に1つを選び、勝者ラベルと完全な確率分布を返します。
- Scoreプリミティブ: 順序付き数値スケールまたは記述的ルーブリックに対して入力を評価し、各レベルにわたる確率分布とともに評価を提供します。
- Noulプリミティブ: yesまたはno条件の正確な確率を0.0~1.0の浮動小数点数として計算し、中間的なテキスト根拠を排除します。
すべてのクエリが厳密にこれら3つのプリミティブにマッピングされるため、実行エンジンは無効なキー、リスト外のツール名、不正なペイロードを出力できません。
構造化出力評価における型安全性
従来のチャットモデルは構文を1文字ずつ生成するため、バックエンドパイプラインに絶え間ない解析リスクを生じさせます。
| 評価指標 | 自己回帰型JSONモード | TypeSafe Jev System One |
| 出力型の強制 | 生成後の文字列検証 | ネイティブな数学的境界付きプリミティブ |
| 型エラー頻度 | 可変 (0.5%~5%+の失敗率) | 型エラー0% (スキーマ境界付き) |
| 無効なenumのリスク | カスタムリトライループなしでは高い | ゼロ (設計上不可能) |
型決定性と確率に関する注意: TypeSafe Jevは設計上、型エラー0%とスキーマ一致を保証し、不正な構文、欠落キー、リスト外のenum値を数学的に排除します。ただし、すべての意思決定モデルと同様、その出力選択は確率的なままです。本質的に曖昧な入力では、絶対的な意味論的確実性を前提とするのではなく、信頼スコアを実行のゲートに使用すべきです。
非自己回帰型並列サンプリングが500ms未満のレイテンシと無料の出力を実現する仕組み
{"category": "billing"} のような単純な分類タグに標準チャットエンドポイントを使用すると、本番マイクロサービスに不要なレイテンシが生じます。自己回帰型モデルは逐次トークンデコードに依存するため、バックエンドスレッドは1文字ずつの生成ループを待つ間ブロックされたままになります。
単一パス評価の仕組み
従来のTransformerは自己回帰型生成ループを実行し、新しいトークンごとにネットワークスタックを別々に通過する必要があります。この逐次依存性は高いレイテンシを生み、生成トークン量に基づいてインフラコストを膨張させます。
TypeSafe Jevは、非自己回帰型並列サンプリングを利用して逐次生成を排除します。TypeSafeのローンチリリースで概説されているように、Jevはコンテキスト状態を取り込み、すべての事前宣言されたスキーマ選択肢を単一のフォワードパス内で同時に評価します。
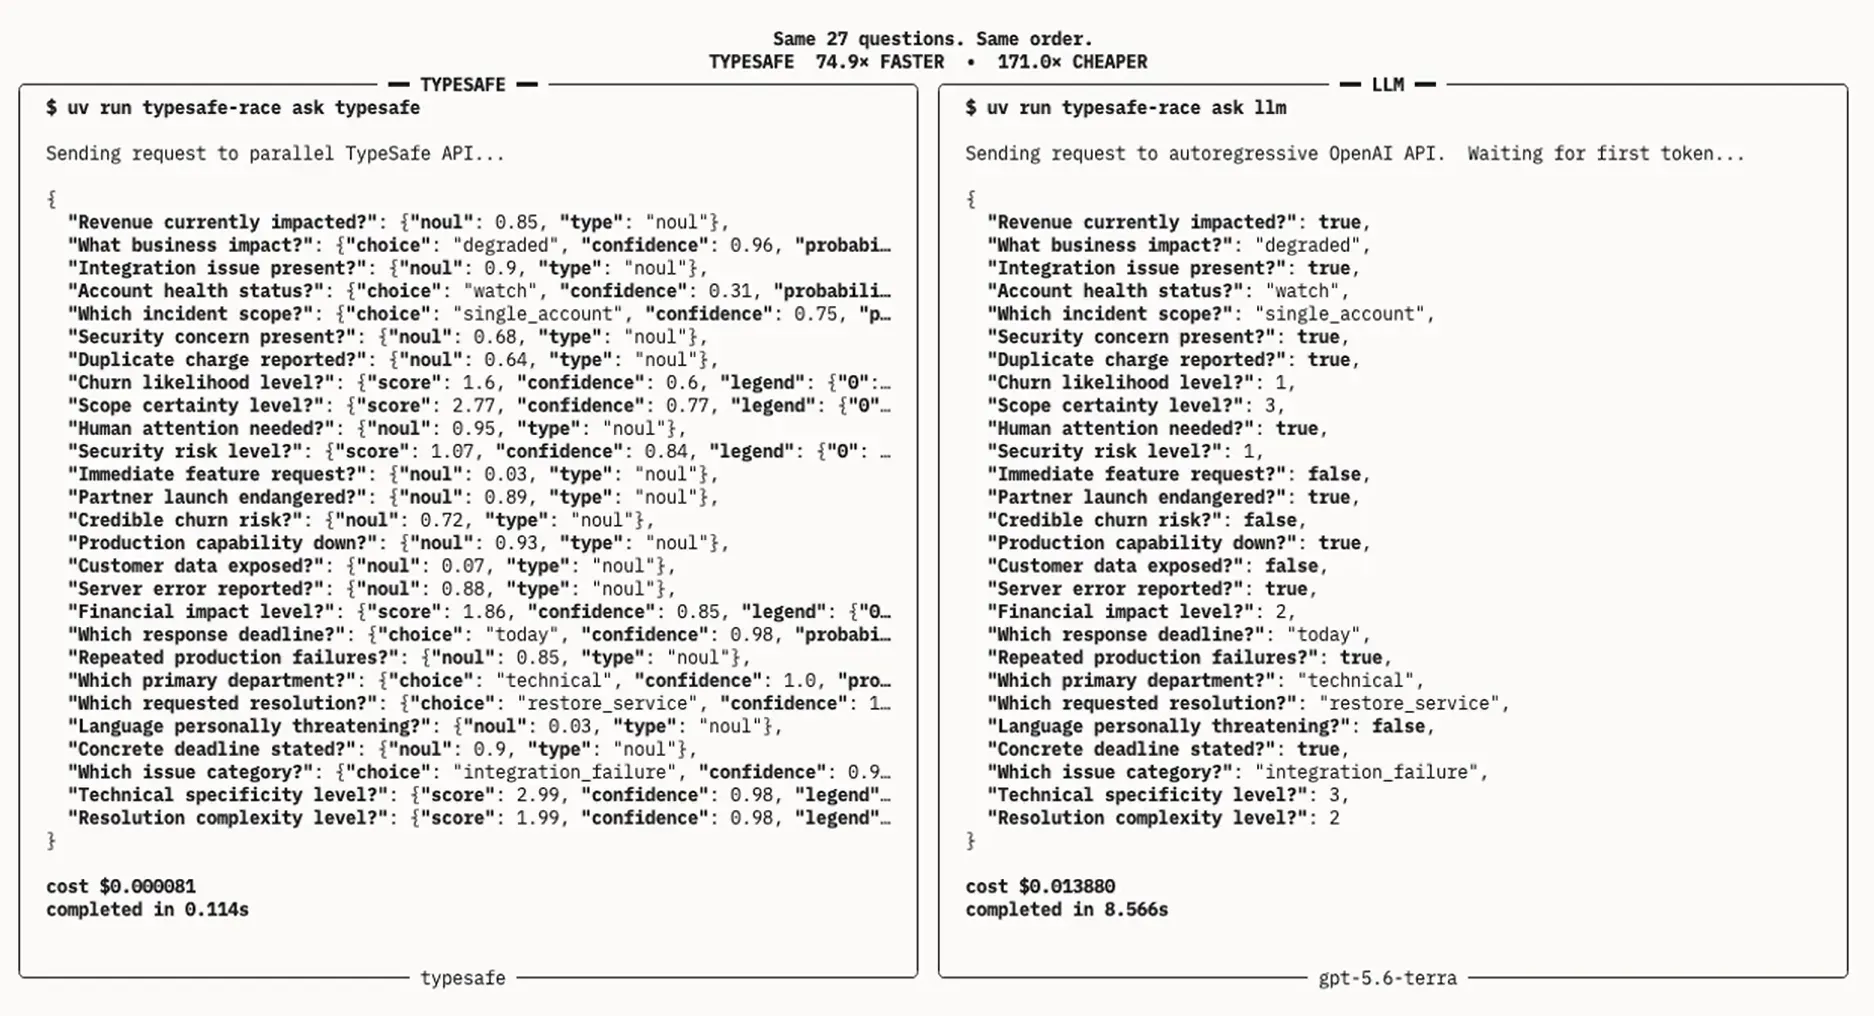
TypeSafe JevとGPT 5.6 Terraエンドポイントで27の同時スキーマ評価質問を実行したターミナルベンチマーク比較
モデルは自由テキストを生成するのではなく、事前定義された出力に対する確率分布を計算するため、出力デコードループは完全に消えます。この構造的転換は3つの主要なパフォーマンス向上をもたらします:
- **無料の出力トークン(メーターが不要なほど安価): **Jevは逐次トークンを生成せずに単一のフォワードパスで選択肢を評価するため、出力評価による増分コンピュートは実質ゼロであり、出力トークンは事実上無料になります。
- 予測可能な価格設定: コンテキスト処理は100万入力トークンあたり定額$0.042です。Jevで静的なプロンプトスキーマを評価すると、重いチャットエンドポイントに伴う従来の長コンテキスト実行オーバーヘッドと比較して、API請求の指数的な膨張を防げます。
- サブ秒実行: 公開されているTypeSafe Jevのレイテンシベンチマークは、P95応答時間が一貫して70ms~500msであり、フロンティアチャットモデルより最大200倍高速に動作することを示しています。
アーキテクチャ別パフォーマンス内訳
| 指標 / 次元 | 従来の自己回帰型LLM (System 2) | TypeSafe Jev System Oneエンジン |
| 実行ループ | トークン単位の逐次デコード | 事前宣言スキーマに対する単一並列パス |
| 出力タイプ | 非構造化テキスト文字列 / JSON文字列 | 型付き意思決定プリミティブ (Choice, Score, Noul) |
| スキーマエラー率 | モデル/プロンプトにより0.58%~45%+ | 型エラー率0% (数学的に境界付け) |
| P95レイテンシプロファイル | 3,000ms~30,000ms+ | 70ms~500ms |
| 出力経済性 | トークンごとに変動 ($15~$60 / MTok) | 無料 (メーターが不要なほど安価) 逐次出力トークン生成なし |
| 主な領域 | 推論、下書き作成、オープン合成 | 分類、ツール選択、信頼度ゲーティング |
メモリ帯域幅のボトルネックを回避する
標準的なLLM推論では、トークンごとにモデル重みがメモリロジックに再ロードされるため、メモリ帯域幅が飽和します。意思決定評価を単一のフォワードパスで完了させることで、Jevはこのメモリボトルネックを完全に回避し、高い同時トラフィック下でも安定した応答速度を維持します。
較正された意思決定のための強化学習と信頼度ゲート
標準的なチャットモデルは、従来の微調整が統計的真実ではなく説得力のある言い回しを報酬として与えるため、99%の自己申告信頼度で誤った記述をしばしば出力します。本番マイクロサービスでは、過信した誤った意思決定がデータベースレコードの破損、壊れたツール引数、予期しないシステムダウンタイムに直結します。
モデルの信頼度を経験的精度に整合させる
この構造的な過信を解決するため、TypeSafeはReinforcement Learning for Calibrated Decisionsを導入しました。主観的な人間の選好に最適化する従来のRLHF手法とは異なり、RLCDは較正された確率を生成するように意思決定モデルを専門的に訓練します。
精度に整合した信頼度により、Jevからの0.90の確率出力は、候補選択がテストセット全体で経験的に90%の確率で正しいことを意味します。この数学的較正により、開発者が出力の確実性を見積もるための複雑なプロンプトヒューリスティックを書かなくても、信頼できる確率的意思決定が可能になります。
本番環境での信頼度ゲート付きルーティングの実装
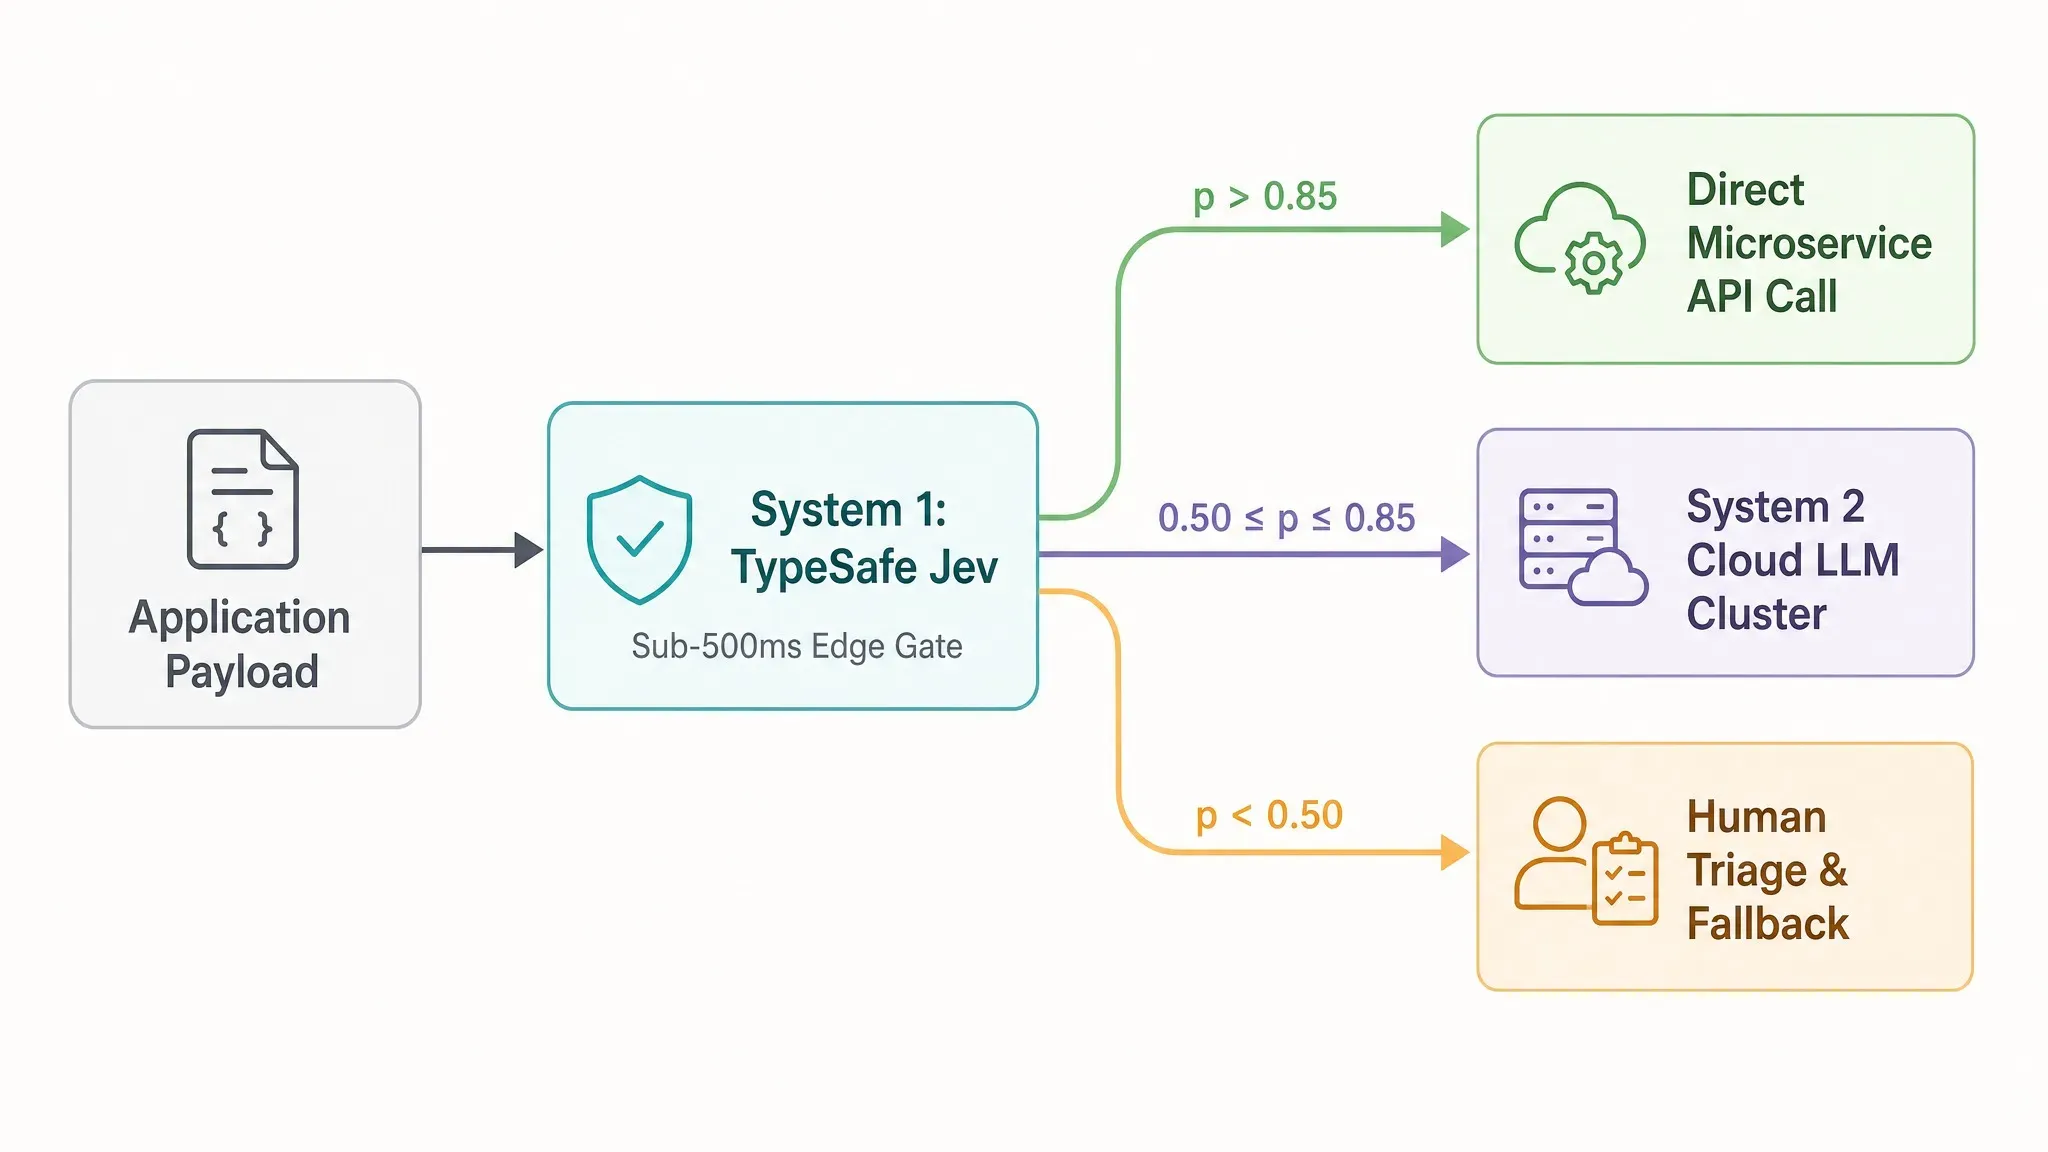
エンジニアはこれらの較正された確率分布を活用して、しきい値ベースの意思決定ゲートを構成できます。たとえば、一般的な本番設定では:
p > 0.85(高速パス実行): 低速なLLMエンドポイントを完全に迂回し、高速パスで即時実行します。0.50 ≤ p ≤ 0.85(System 2へのエスカレーション): 境界線上の出力を推論LLMに渡し、曖昧なエッジケースを処理します。p < 0.50(フォールバックトリアージ): 安全デフォルトをトリガーするか、リクエストを人手レビューキューに送ります。
境界線上のエッジケース 0.50≤ p ≤ 0.85 では、信頼度ゲート付きルーティングがペイロードをエンタープライズ推論層にリダイレクトします。GPT 5.6 Terra on Atlas Cloud は、これらのエスカレーションされたリクエストに最適なフォールバック先を提供し、その1,050Kコンテキストウィンドウとコスト効率の高い$2/$12のトークン価格を活用して、マイクロサービスインフラコストを膨張させずに深い分析を実行します。
自己回帰型LLMからの生のlogprobsは、悪名高いほど較正されておらず、システムプロンプトが変わるたびに変化します。RLCDをコア訓練プロセスに直接統合することで、Jevは信頼度ゲート付きルーティングを本番導入可能にし、ソフトウェアチームがエッジケースを分離しつつ大量パイプラインを安全に自動化できるようにします。
本番設計パターン: 高速AIパイプラインの実践
本番AIエージェントは、LLMが get_user_billing_v2() のような存在しない関数シグネチャをでっち上げたり、内部APIエンドポイントに無効なパラメータ型を渡したりすると頻繁にクラッシュします。標準チャット補完エンドポイントを通して複数の条件チェックを連鎖させると、システム全体のレイテンシが累積し、顧客向けマイクロサービスがタイムアウトします。
高ボリュームマイクロサービス向けの中核アーキテクチャパターン
サブ秒の意思決定エンジンを本番AIパイプラインに統合することで、ソフトウェアチームは予測不能なプロンプトループを決定論的なバックエンド設計パターンに置き換えられます:
- エージェント型ツール選択: 自動化エージェントワークフロー内でツールを選ぶ際、Jevは利用可能な関数シグネチャを現在のアプリケーション状態に対して評価します。候補関数はリクエストスキーマ内で明示的な選択肢として渡されるため、Jevは未定義の関数名を返せず、エージェント型ツール選択中のサイレントな実行時障害を排除します。この高速な事前フィルタリングにより、自律型LLMコーディングエージェントパイプラインに指示を渡す前に、有効なスキーマペイロードを保証します。
- 並列マルチ質問評価: 標準チャットエンドポイントでは、アプリケーションは条件付き質問を逐次評価せざるを得ず、実行するチェック数だけ総レイテンシが倍増します。Jevは、単一の状態ペイロードに対する数十のスキーマ質問を1回の並列フォワードパスで評価することで、並列マルチ質問評価を可能にします。15個の個別分類チェックを実行しても、1個を実行するのと同じ100msの時間枠で済みます。
- チケットトリアージ自動化: 受信顧客チケットを処理する高ボリュームマイクロサービス向けに、Jevは顧客センチメントを解析し、技術的優先度をルーティングし、返金資格を同時に確認します。サブ秒の応答時間でチケットトリアージ自動化を実装すると、突然のトラフィックスパイク時でもキューの滞留を防げます。
SDKによるSystem One意思決定ノードの実装
開発者は、公式 typesafe-sdk を既存のマイクロサービスに統合することで、低レイテンシの意思決定ノードをインスタンス化できます。実行ペイロードは、アプリケーション状態を事前宣言されたスキーマプリミティブとともに https://api.typesafe.ai/v1/systemone エンドポイントに直接送信します。
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
従来のツール呼び出し設定では、関数評価ごとにプロンプトコンテキスト全体を再トークン化します。状態表現を意思決定の質問から分離することで、Jevはコンテキストトークンのオーバーヘッドを倍増させたり、API請求を膨張させたり、P95レイテンシ保証を犠牲にしたりすることなく、バックエンドシステムでマルチブランチ分類パイプラインを実行します。
既知のTypeSafe Jevの制限とアーキテクチャ上のトレードオフ(Jevにできないこと)
非自己回帰型の意思決定モデルを、丁寧なメール返信を書いたり請求書の明細行を合計したりすることを期待してデプロイすると、必然的に本番コードが壊れます。汎用LLMを完全にSystem Oneモデルに置き換えようとするエンジニアリングチームは、すぐに物理的なアーキテクチャ限界に突き当たります。
構造的境界の分析
Jevをマイクロサービスワークフローに組み込む前に、Jev固有の失敗モードを理解することが重要です。Jevの単一フォワードパス設計は、いくつかのコアタスクに厳格な境界を課します:
- オープンエンドなテキスト生成: Jevは会話テキストを一切生成しません。エッセイを書いたり、文書を要約したり、選択に対する自然言語の説明を生成したりすることはできません。
- マルチホップ推論の制限: このアーキテクチャは即時的な状態表現を評価します。複雑な逐次論理チェーンや多段階推論の制限には、タスクを従来の自己回帰型LLMに委任する必要があります。
- 算術の制限: Jevは数学計算やコンテキスト文字列内の項目の信頼できるカウントを行えません。算術の制限により、財務計算や配列操作は標準バックエンドコード内に保持する必要があります。
- 文字通りの基準解釈: モデルは明示されていないビジネスロジックを推論せず、プロンプトルールに文字通り従います。曖昧なスキーマ選択肢は予期しない確率分布につながります。
- 重いペイロード下でのコンテキスト腐敗: 大量の非構造化ログを渡すとコンテキスト腐敗が生じ、評価精度が低下します。リクエスト送信前に入力状態ペイロードからノイズを除去することが引き続き不可欠です。
アーキテクチャマッピング: System One vs System Twoの機能
| 運用タスク | TypeSafe Jev System One | 自己回帰型LLM System Two |
| カテゴリ分類 | ネイティブ (500ms未満) | 低速 (逐次テキスト) |
| テキスト合成と下書き | 不可能 (デコードループなし) | ネイティブ (オープンエンドなテキスト生成) |
| 数学計算 | 非対応 (算術の制限) | 可変 (コード実行が必要) |
| ノイズ耐性 | 大規模状態ではコンテキスト腐敗しやすい | より高いコンテキストウィンドウ耐性 |
Jevを万能な推論エンジンではなく、サブ秒の意思決定ノードとして扱うことで、本番マイクロサービス全体で適切なシステム設計を確保できます。
将来のクラウドインフラ: 高速意思決定ノードのオーケストレーション
受信するすべてのユーザーリクエストを直接700億パラメータの推論モデルにルーティングすると、数千ドル分のGPUサイクルを無駄に消費し、ユーザーは基本的なセキュリティチェックとペイロードルーティングのために数秒待たされます。現代のマイクロサービススタックは、受信するすべてのHTTPペイロードをオープンエンドな推論問題として扱う余裕はありません。
ハイブリッドAIアーキテクチャへの移行
クラウド環境は、モノリシックなLLMエンドポイントから、分離されたハイブリッドAIアーキテクチャへと移行しています。この新たなパラダイムでは、クラウドオーケストレーターが高速意思決定ノードをネットワークエッジに配置し、受信ペイロードを即座に評価します。
500ms未満の実行ウィンドウ内でエッジAIルーティング、スキーマ検証、信頼度スコアリングを処理することで、高速意思決定ノードはより重いモデルクラスタに到達する前にトラフィックをフィルタリングします。このトポロジーは、3つの異なるクラウド運用レイヤーにわたってリソース割り当てを最適化します:
- エッジガードレールとルーティング: 高速意思決定ノードは、単一のフォワードパスでユーザーインテントを評価し、入力をサニタイズし、スキーマ準拠を検証します。
- 状態ハンドオーバーとオーケストレーション: クラウドオーケストレーターは信頼度スコアを分析し、高確実性リクエストを即時実行し、複雑な推論タスクを転送します。
- 集中型System 2推論: 重いLLMクラスタは、マルチターン合成やオープンエンド生成が厳密に必要な場合にのみ、事前フィルタリングされた構造化ペイロードを受け取ります。
System Oneモデルの大規模デプロイ
クラウドプラットフォームがホスティング機能を拡張するにつれて、TypeSafe JevのデプロイをAIインフラに組み込むことは、エッジマイクロサービス向けの効率的なパターンを提供します。非自己回帰型の意思決定モデルをエンドユーザーの近くで実行すると、往復時間が劇的に短縮され、高スループットアプリケーションのコンピュートコストが削減されます。
専用の意思決定レイヤーを備えたパイプラインを構築することで、バックエンドネットワークは高負荷時でも応答性を維持し、フロンティア推論モデルは深い計算を必要とするタスクだけに集中できます。


