最新情報: Wan 3.0は2026年8月24日より提供開始となりました。
あなたは1本の15秒広告用フォルダを作成しました。キャラクター静止画2枚。クライアントから送られてきたブランドトーンビデオ。PDFでしか存在しないブランドブック。実際に起用したい俳優のボイスサンプル。
そしてビデオモデルを開くと、画像が1枚だけ求められました。
そこで誰もがやることをやったのです。そのフォルダを800語のプロンプトに変換して祈りました。ショット3で顔が変わった。ジャケットの色が変わった。声はまったく別の人のものだった。
Wan 3.0のオムニリファレンスは、ビデオモデルとして初めて「よし、フォルダをよこせ」と言います。1回の呼び出しで最大20のアセット、5種類の入力、1本の連続した30秒テイクで一貫性を保ちます。
この記事は3つのことを行い、残りは省きます。その20のアセットが実際に何であるかを分解し、アリババ公式の生成クリップを証拠として用い、今日実行可能な同等のワークフローを提供します。なぜなら、Wan 3.0はまだアリババ独自のクラウド上でパブリックベータであり、サードパーティのプラットフォームからは呼び出せないからです。
ポイント
- Wan 3.0のマルチモーダルリファレンスは、1回の呼び出しで最大20のアセット(画像、動画、音声、ドキュメント、ライブWebページ)を受け付け、1本の30秒テイク全体で一貫性を維持します。
- PDF、スライドデッキ、URLを、プロンプトに言い換えるのではなく、クリエイティブな入力として扱う初のメインストリームビデオモデルです。
- Wan 3.0は2026年8月6日に、Alibaba Cloud Model StudioとQwen Cloudで
wan3.0-videoとしてパブリックベータに入りました。クローズドウェイトです。すでにApache 2.0だと言う人は推測しているだけです。 - 20アセットという見出しは、実際の優位性ではありません。現在呼び出せるリファレンスツービデオモデルは、すでに20以上のアセットを受け付けます。差はドキュメントとWebページであって、数ではありません。
- 2キャラクター、リファレンス固定、フル音声のフォーマットは、Atlas Cloudの無料AI広告スキットジェネレーターで無料でテストできます。商品写真4枚を入力し、15秒の音声付きスキットを出力、カード不要です。
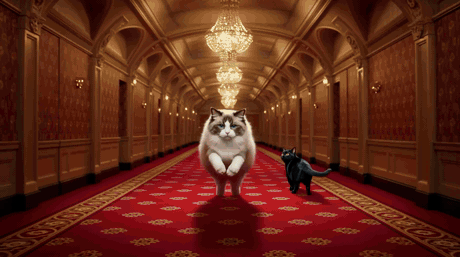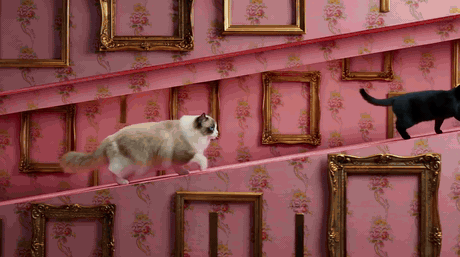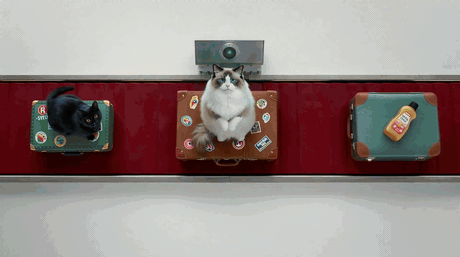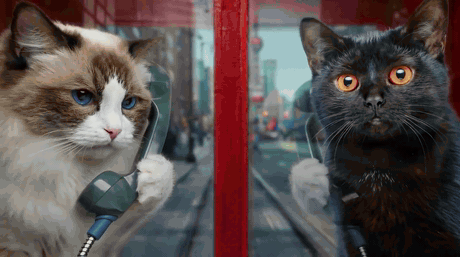
Wan 3.0によって5つの異なるセットを追いかけられる2匹の猫、キャラクターのドリフトなし_2枚のリファレンス画像。ホテルの廊下から洗濯機のドラム、赤い電話ボックスまで、まったく異なる5つのセット。フレームのドリフトは一切なし。出典: Alibaba公式の_Wan 3.0 クリエイターハンドブック_、2026年8月。この記事の他のWan 3.0クリップもすべてここから。
マルチリファレンスビデオが崩れる理由と、Wan 3.0マルチモーダルリファレンスが変えること
ビデオモデルにはクリップ間のメモリがありません。生成は毎回ゼロから始まります。これが問題のすべてを一言で言い表しています。
そのため、ストーリーに複数のショットが必要になった瞬間、継ぎ接ぎが始まります。ショット1で気に入った顔が得られます。ショット2ではそのいとこにあたる顔が現れます。ショット3では静かにジャケットがプラムからバーガンディに変わり、気づいたときにはすでに11回のレンダリング代金を支払っています。
単一画像リファレンスは役立ちましたが、ロックできるのは常に1つのものだけでした。顔です。顔、衣装、小道具、場所、声を同時に保持することはできませんでした。スロットが1つで仕事が5つあったからです。
解決策は2つあります。モデルにより多くのスロットを与えるか、最初からやり直させないようにするかです。Wan 3.0は両方を同時に行い、これこそが2つの主要機能が実は1つの機能である理由です。ネイティブ30秒テイクは、キャラクターがドリフトするカットが存在しないことを意味します。20のリファレンスアセットは、固定しなければならないすべての要素が、1つのスロットを奪い合う代わりに、専用のスロットを得ることを意味します。
継ぎ接ぎがない場合の様子は次のとおりです。30秒、1台の連続カメラ、ショッピングカートに乗った子供がビルボードに埋め込まれ、その後下から歩き出てきます。
1回のパスで30秒のフルテイク、カットなし、サウンドトラックも同じパスで生成。出典: Alibaba公式のWan 3.0クリエイターハンドブック。
Wan 3.0マルチモーダルリファレンスにおける「20アセット」の実際の意味
20は見出しの数字です。重要なのは、20すべてが同じ種類のものではないということです。Wan 3.0のオムニリファレンスは5つの入力タイプをカバーし、それぞれが出力の異なる軸を制御します。
画像はアイデンティティを制御します。 キャラクターカード、商品写真、場所のプレート。Wan 3.0はこれをピクセルレベルの一貫性と呼び、アリババの公式例では、そのロックは顔を超えて衣装にまで及びます。重ね着された灰色のローブ、ストラップ付きの革製ベスト、暗い腰巻きが、3つの場所をまたいだ16秒の格闘シーン全体で保持されます。
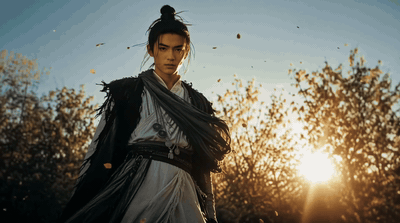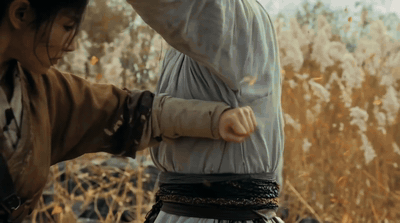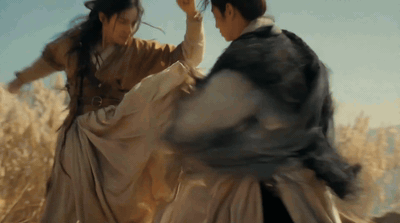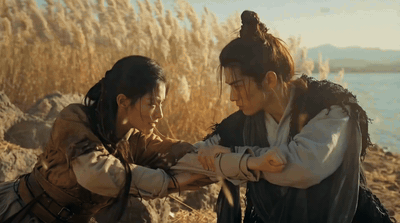
2枚のキャラクターカードが武術の戦闘シーンを駆動し、コスチュームの詳細がフレームごとに保持される
2枚のキャラクターカードと1枚の葦原の場所プレート。衣装と設定はすべての投げ技を通して保持されます。ここでは無音GIFとして表示されていますが、配信ファイルには44.1kHzステレオミックスが含まれています。出典: Alibaba公式のWan 3.0クリエイターハンドブック。
音声は声を制御します。 これこそが「マルチモーダル」を単なるマーケティング以上のものにしている部分です。キャラクターごとにボイスサンプルを添付し、プロンプトにセリフを書き、その声色で、リップシンクされたダイアログが、画像と同じパスで返ってきます。2人、2つの音声リファレンス、1つのジム。
2枚の被写体画像と2つの別々のボイスサンプルクリップ、ダイアログはそれらの2つの声で返ってきます。これは音声をオンにして見る価値があります。出典: Alibaba公式のWan 3.0クリエイターハンドブック。
動画はタイミングを制御します。 リファレンス動画はコピーされるためではありません。そのリズムを提供するためです:ビートがどれだけ持続するか、トランジションがどのように動くか。この例では、5つのキーフレームが被写体を提供し、リファレンス動画がそれらの間の水平なカードフリップのリズムを提供しています。
リファレンス動画からペースを取った5つのキーフレームをフリップ_被写体用の5つのキーフレーム画像、フリップリズム用の1つのリファレンス動画。出典: Alibaba公式のWan 3.0クリエイターハンドブック。_
ドキュメントとWebページは構造を制御します。 これが本当に新しい部分です。Wan 3.0はドキュメントファイルとライブURLをクリエイティブ入力として受け入れ、ベータ版の報告では、受け入れられる形式として.doc、.xls、.ppt、.pdf、.txtが挙げられています(AlphaSignal、2026年8月)。同じロジックはすでにストーリーボード画像でも機能します。1枚のボードを入力し、6つのショットを出力、ボードの順序通りに。
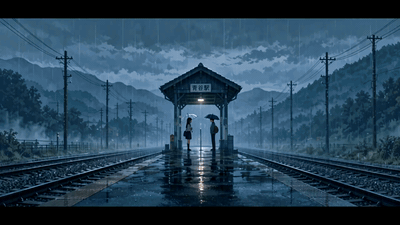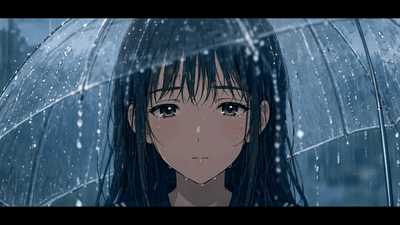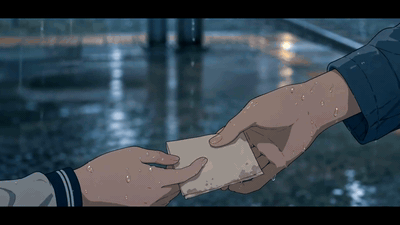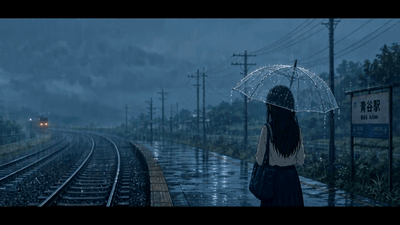
1枚のストーリーボードシートが、雨の駅ホームで6つの連続ショットに展開される
1枚のストーリーボードシートをリファレンスとして、その順序で6つのショットを生成、ショット5で手渡されるメモまで正確に。出典: Alibaba公式のWan 3.0クリエイターハンドブック。
最初と最後のフレームはエンドポイントを制御します。 最も古い手法で、現在もサポートされており、ショットを区切る最も速い方法です。
これが、現在ほとんどの人が実際に使用しているバージョンと比較してどのようになるかを示します。
| Wan 2.7 リファレンスツービデオ | Wan 3.0 オムニリファレンス | |
|---|---|---|
| リファレンスアセット | 被写体ごとに1枚の画像、最大3本の動画、1つのボイスクリップ | 合計最大20アセット |
| モダリティ | 画像、動画、音声 | 画像、動画、音声、ドキュメント、Webページ |
| 1パスあたりの最大長 | 10秒 | ネイティブ30秒、スマートデュレーション |
| 同一パス内の音声 | あり | あり |
| 動画編集と拡張 | 公開されていない | 指示およびリファレンスベースの編集、拡張あり |
| 利用可能性 | サードパーティAPIで利用可能 | Alibaba Cloud Model StudioおよびQwen Cloudベータ |
ドキュメントには決して書かれず、誰もが苦労して学ぶルールが1つあります。1つのリファレンス、1つの仕事。 Image1は顔と衣装を固定します。Video1は動きのみを提供します。Audio1は声色のみを提供します。1つのアセットに2つの矛盾する仕事を与えたり、2人が写ったリファレンス画像をアップロードしたりすると、モデルは推測する必要があり、推測こそがまさにあなたが止めようとしていたことです。アリババのハンドブックもこれについて率直です。リファレンス画像は被写体1人につき1枚です。
今日実行できるWan 3.0マルチモーダルリファレンスワークフロー
まずはストレートな回答です。Wan 3.0はアリババのクラウド上で、モデルID wan3.0-video としてパブリックベータです(Alibaba Wan、2026年8月)。まだサードパーティのAPIプラットフォームには登場していません。Atlas Cloudも含まれます。今すぐWan 3.0 APIアクセスを販売している人は、何か別のものを再販していることになります。
すでに登場しているのはワークフローの形状です。リファレンスパックを入力し、1回の呼び出しで、サウンド付きの完成したクリップを出力します。これは、ブラウザタブで呼び出せるリファレンスツービデオモデルで今日実行可能であり、すべてを並べると、20アセットという見出しは違って見えます。
| モデル | リファレンスアセット | モダリティ | 最大長 | ネイティブ音声 | 秒あたりの価格 |
|---|---|---|---|---|---|
| Wan 3.0 (Alibabaベータ、Atlasでは未提供) | 合計20 | 画像、動画、音声、ドキュメント、Webページ | 30秒 | あり | 解像度により0.05ドルから0.20ドルと報告 |
| Wan 2.7 リファレンスツービデオ | 被写体ごとに1枚の画像、3本の動画、1つのボイスクリップ | 画像、動画、音声 | 10秒 | あり | 0.10ドル |
| Seedance 2.5 リファレンスツービデオ | 50 (画像30 / 動画10 / 音声10) | 画像、動画、音声 | 30秒 | あり | 0.13ドル |
| MiniMax H3 リファレンスツービデオ | 混合、上限なし | 画像、動画、音声 | 15秒 | あり | 0.10ドル |
| Kling Video O3 Pro リファレンスツービデオ | 画像7枚、または画像4枚+動画1本 | 画像、動画 | 15秒 | あり | 0.10ドル |
| Vidu Q3-Mix リファレンスツービデオ | 画像4枚 | 画像 | 16秒 | あり | 0.11ドル |
| Veo 3.1 リファレンスツービデオ | 画像3枚 | 画像 | 8秒 | オプション | 0.20ドル |
価格は2026年8月時点のAtlas Cloudレートです。Wan 3.0の数値はAlibaba Cloudベータについて報告されたものであり、Atlasのレートではありません。Alibabaはまだこのモデルの公開価格ページを公開していないため、その行は暫定値として扱ってください。
その表を2回読むと、本当の話が見えてきます。20アセットという見出しはWan 3.0が優位に立つ部分ではありません。なぜなら、Seedance 2.5はすでに50を受け付け、30秒に匹敵するからです。そのリストの中で、PDFを受け付けるものは他にありません。
以下のチュートリアルでは、デモはWan 2.7 リファレンスツービデオで実行します。なぜなら、その入力形状がオムニリファレンスに最も近いからです。複数の被写体画像、オプションのリファレンス動画、ボイスクリップ、すべてプロンプト内の character1 および character2 ラベルにマッピングされます。3つのモデル、1つのブラウザタブ、ローカルインストールは不要です。
現在ホストされている実行については、Atlas CloudのWan 3.0 を開き、ワークフローを公開する前に以下のようなプロンプトをテストしてください。
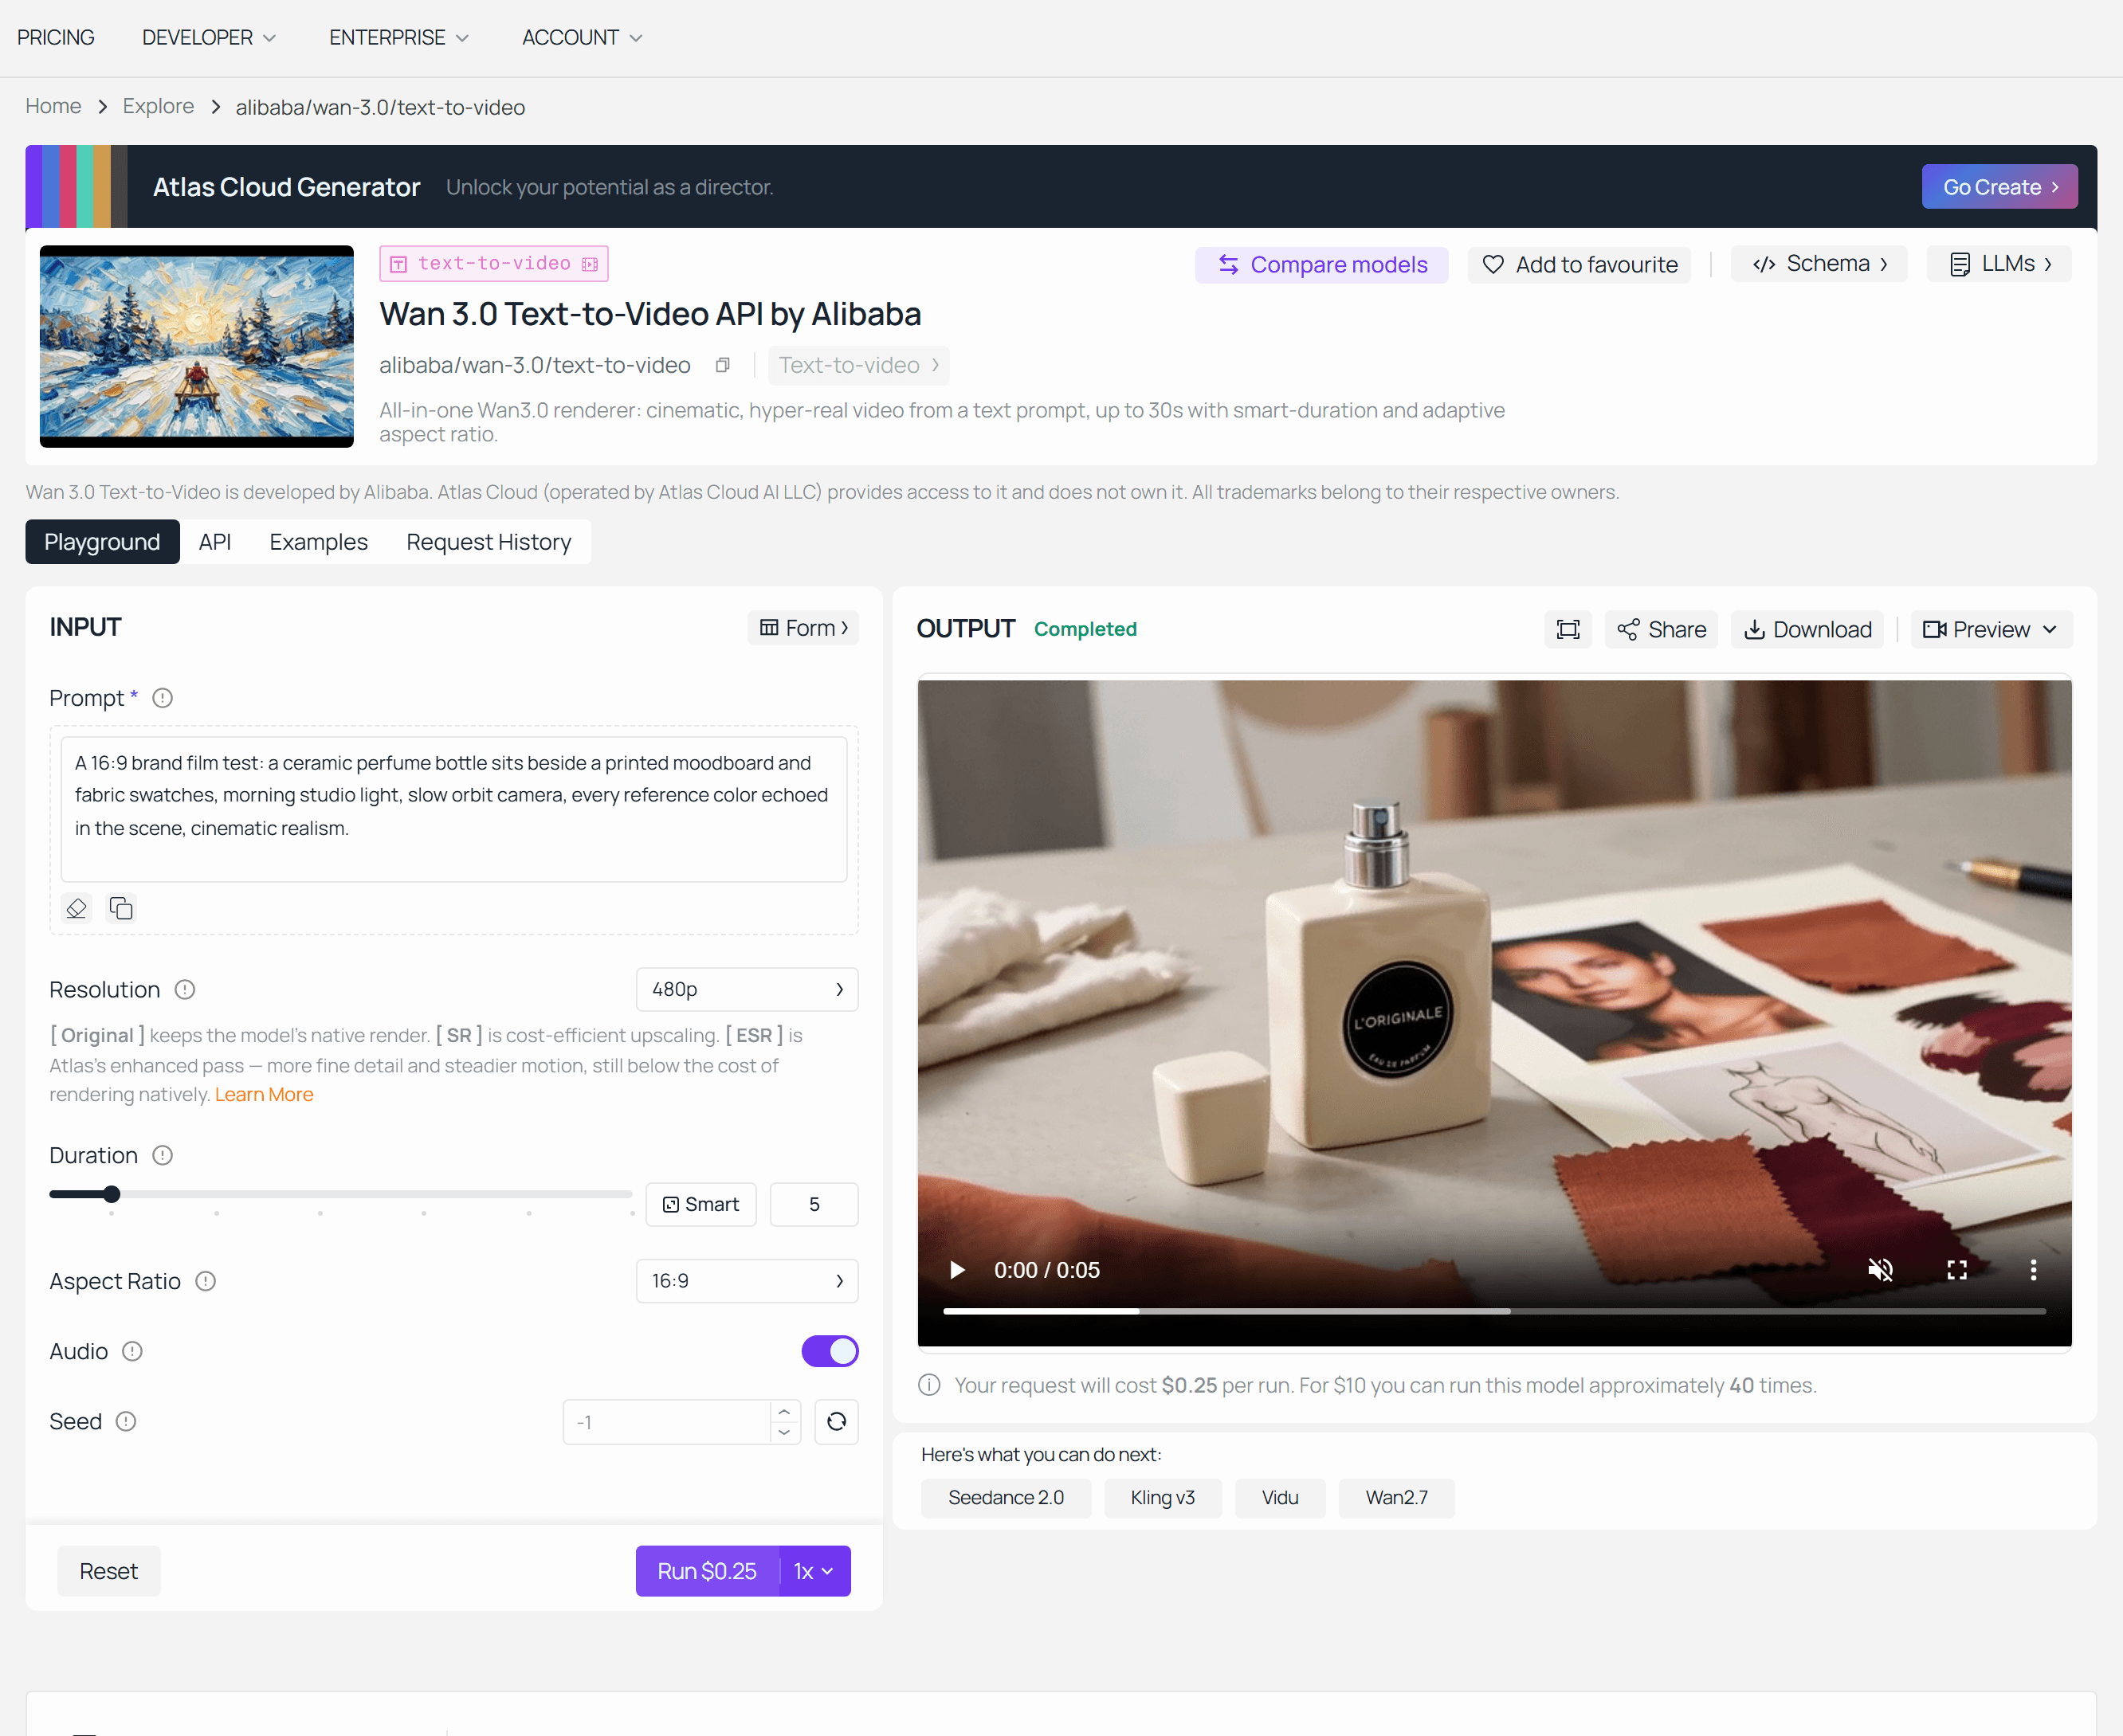
Wan 3.0 プロンプトから結果へのスクリーンショット: 20リファレンスブランドハンドオフ。
自分で構築する: 4ステップで作るマルチモーダルリファレンスシーン
シーン: パステル調のホテルフロントデスク。無表情のコンシェルジュ。ラグドールキャットを抱えた旅行者。コンシェルジュはレンズの真上を見つめて言います。「猫様のご予約はございますが、あなた様のはございません。」
2枚の画像と1つのボイスクリップ、つまり2つのモダリティにわたる3つのリファレンスアセット。これは、単なるマルチイメージではなく、正直にマルチモーダルであるための最小構成です。
ステップ1: リファレンス画像1を生成する、ロックすべき被写体
リファレンス画像には3つの仕事とそれだけしかありません。被写体1人、カメラに向いている、背景は無地。それ以外はすべて装飾です。GPT Image 2 を quality は high、size は 16:9、n=1 で使用します。
Plain1中年のホテルコンシェルジュの全身スタジオポートレート、無表情で、フラットなダスティピンクの壁を背景に真ん中に立っている。プラムパープルのダブルブレストベルホップユニフォームに金のパイピングと真鍮のボタン、小さな丸いピルボックスハット、細い口ひげ。完全に対称的なフレーミング、均一な柔らかい正面光、壁に影なし、35mmフィルムグレイン、落ち着いたパステルパレット。被写体1人だけ、他の人物なし、テキストなし、ロゴなし、フレーム内に小道具なし。 2
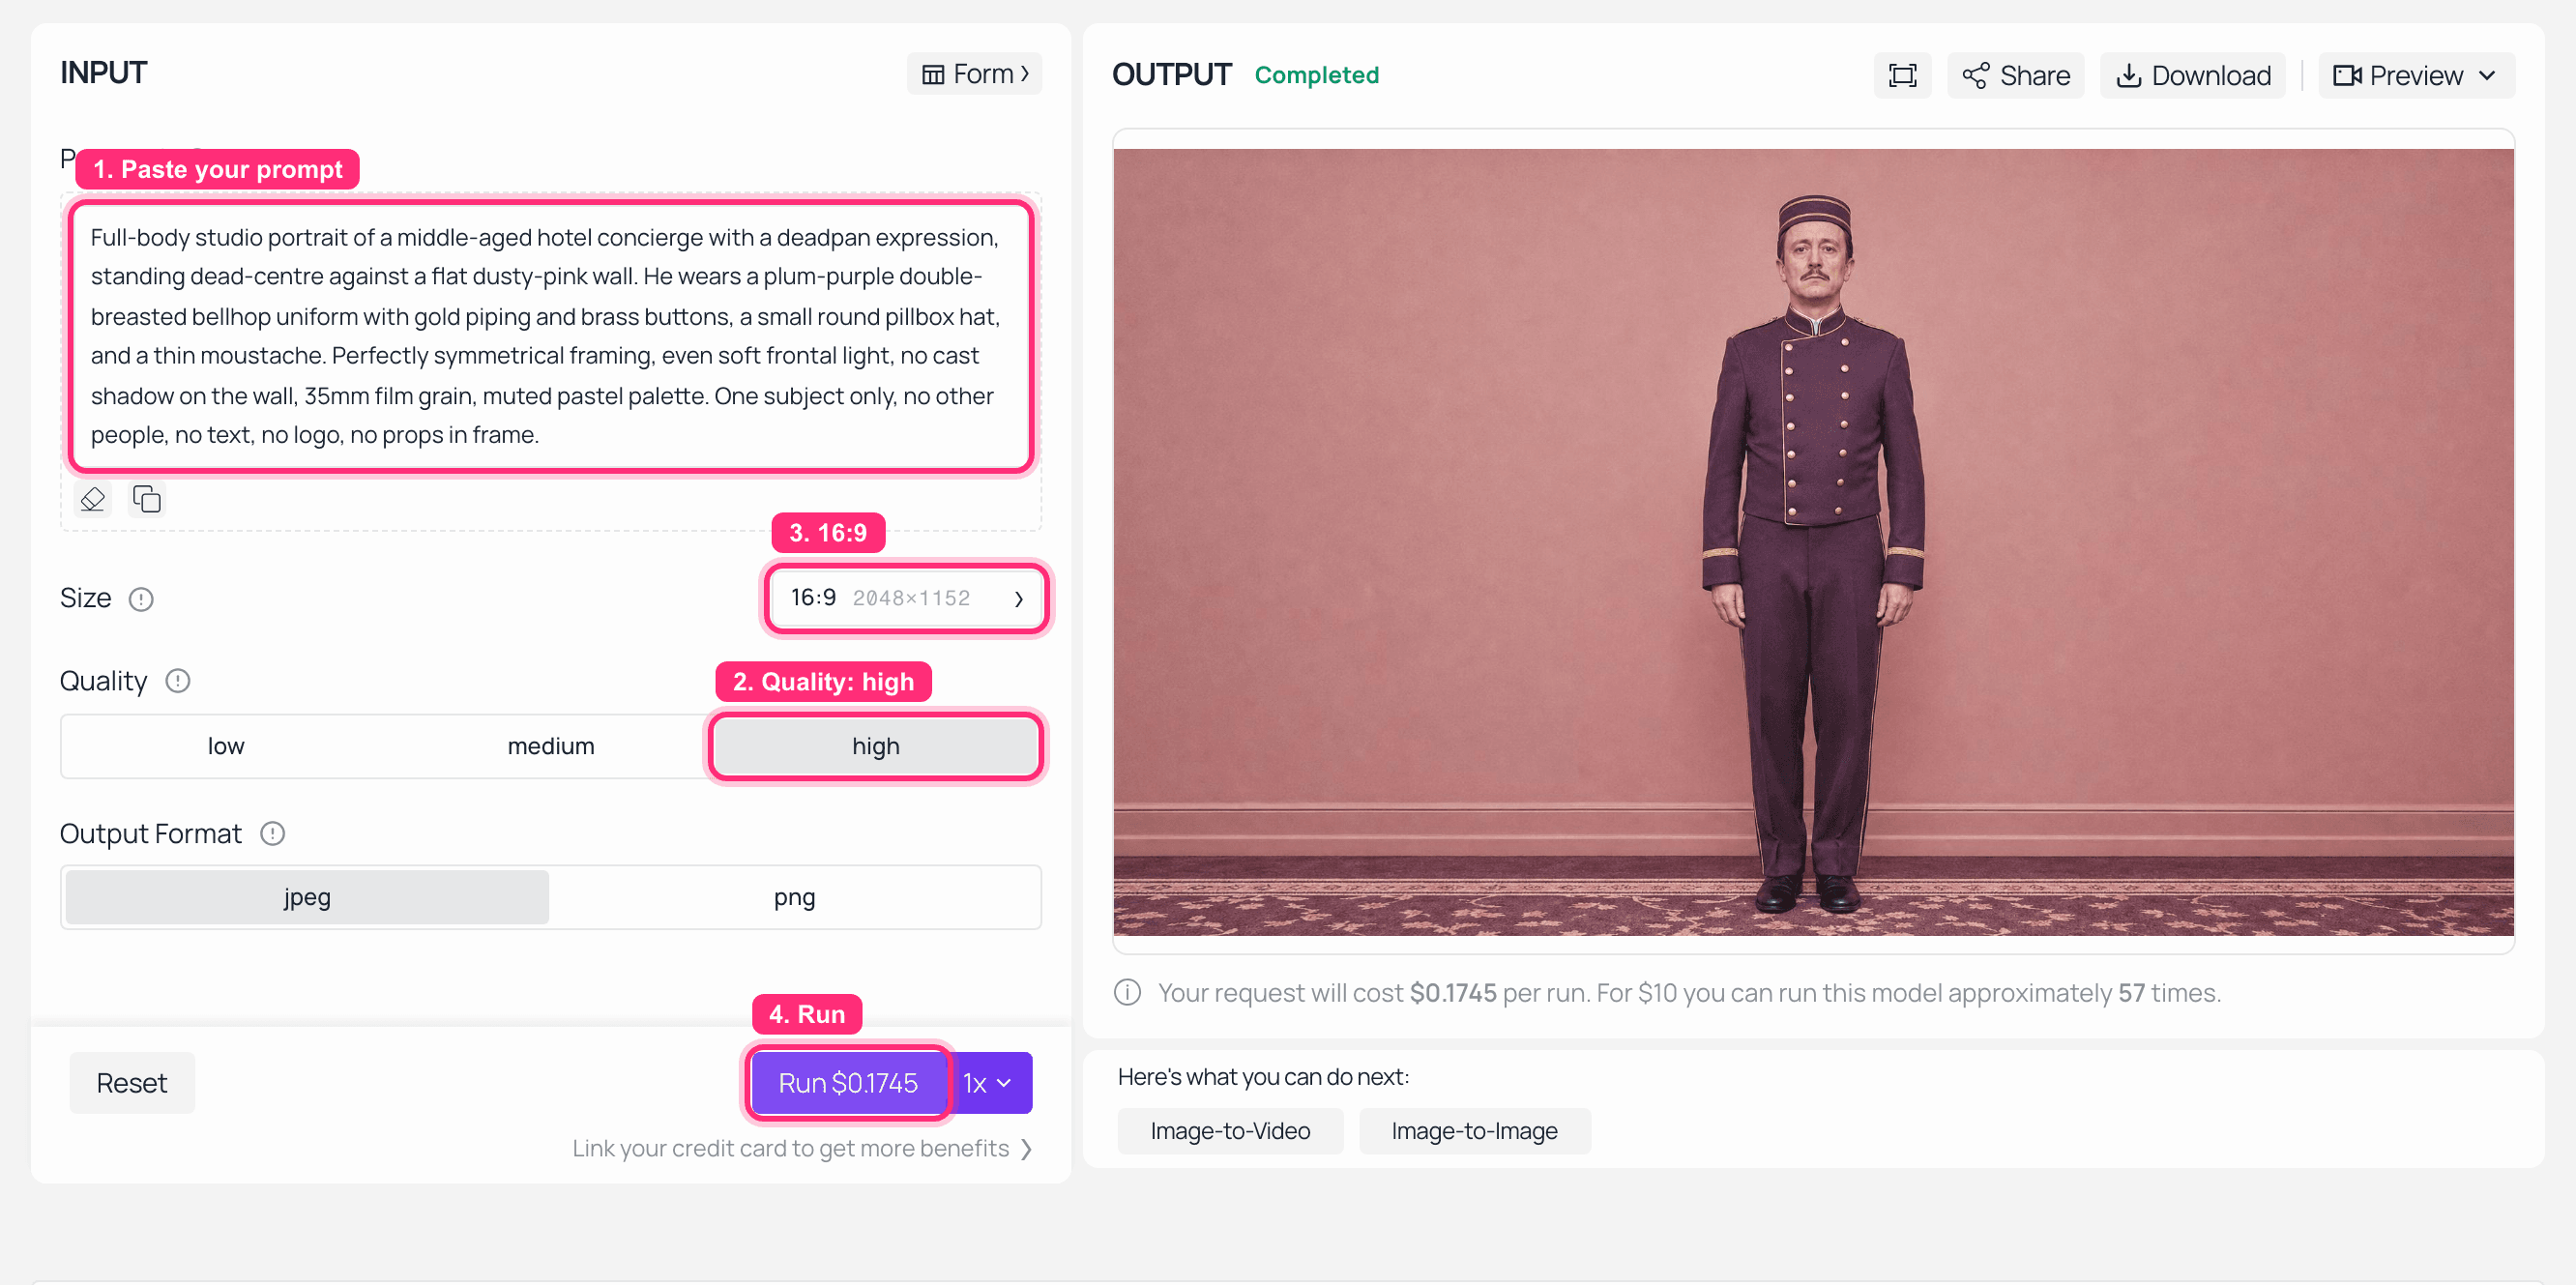
Atlas Cloud上のGPT Image 2プレイグラウンド、出力パネルにコンシェルジュのリファレンスポートレートがレンダリングされている
Atlas Cloud上のGPT Image 2: quality high、16:9、被写体1人、フラットな背景。このファイルがcharacter1になります。
ステップ2: リファレンス画像2を生成する、2番目のロックされた被写体
同じモデル、同じ設定。2人のキャラクター間の色のコントラストは意図的であり、フレームを共有するときにモデルがそれらを簡単に区別できるようにします。
Plain1ふわふわのラグドールキャットを胸に抱えた若い女性旅行者の全身スタジオポートレート、フラットなマスタードイエローの壁を背景に真ん中に立っている。マスタードウールのコート、赤いベレー帽、丸い亀甲縁メガネ、空いた手に小さなビンテージレザースーツケースを持っている。完全に対称的なフレーミング、均一な柔らかい正面光、壁に影なし、35mmフィルムグレイン、落ち着いたパステルパレット。被写体1人だけ、他の人物なし、テキストなし、ロゴなし。 2
ステップ3: 音声リファレンスを生成する、これが実際のマルチモーダル部分
ボイスクリップは、これをマルチイメージジョブからマルチモーダルジョブに変えるものです。Wan 2.7のオーディオスロットは短いサンプル(約1~10秒)を必要とするため、セリフは短く保ちます。MiniMax Speech 2.6 HD を使用し、低く、フラットで、気にしない男性の声を選びます。
Plain1こんばんは。チェックインですか?もちろんです。皆さんそうです。 2
ステップ4: 1回の呼び出し、3つのリファレンス、1つの完成したクリップ
ここで、パック全体をまとめてWan 2.7 リファレンスツービデオに入力します。設定: resolution: 1080P、ratio: 16:9、duration: 10(これがこのモデルの上限)、prompt_extend: false、seed: -1。images を順番に読み込み、ステップ1を最初にしてcharacter1にマッピングし、次にステップ2をcharacter2として、ステップ3のファイルを audio に添付します。
Plain1対称的な、真ん中からのワイドショットのパステル調ホテルロビーフロントデスク、ダスティピンクの壁とその後ろのマスタードイエローのキーラック。character1はデスクの後ろに立つコンシェルジュ。character2はその前に立つ旅行者で、まだラグドールキャットを抱えている。カメラは完璧な中心軸に沿ってゆっくりと押し出し、決して傾かない。character1はレンズの真上を見つめてフラットに言う:「猫様のご予約はございますが、あなた様のはございません。」character2は一度瞬きし、ゆっくりと猫の方に顔を向け、それからデスクに戻す。猫は動かずにカメラをまっすぐ見つめる。35mmフィルムグレイン、均一な柔らかい照明、落ち着いたパステルパレット、カメラの揺れなし、カットなし。 2
ネガティブプロンプト:
Plain1手持ちカメラの揺れ、ジャンプカット、字幕、画面上のテキスト、透かし、余分な人物、変形した手、顔の変形、色の変化、モーションブラー 2
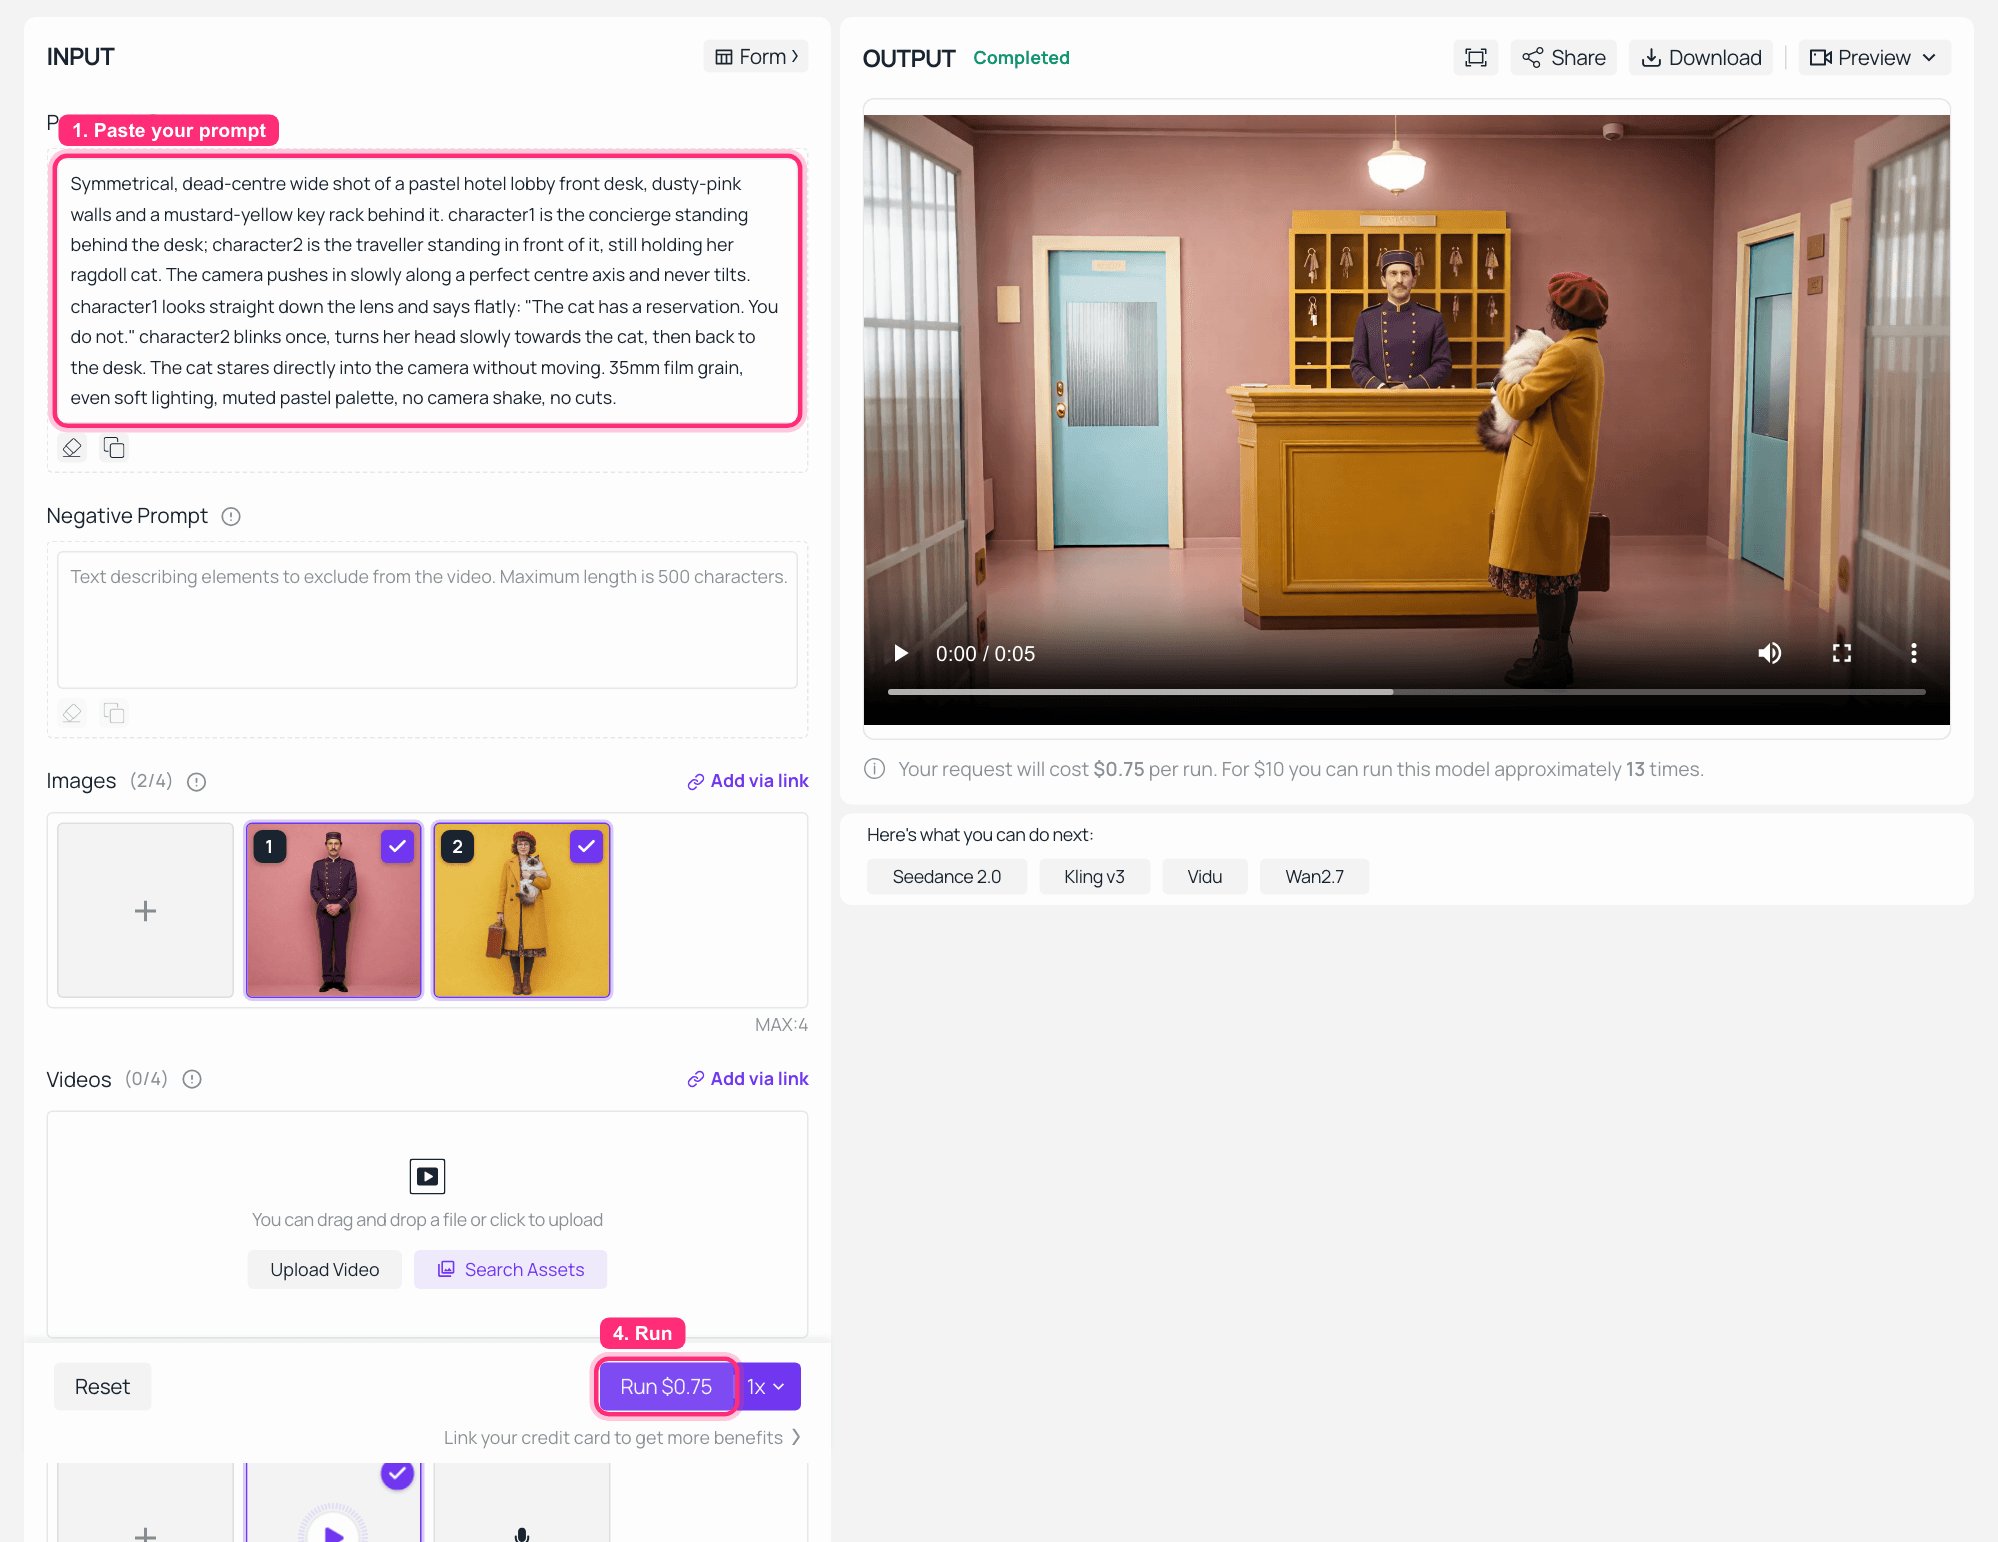
Atlas Cloud上のWan 2.7 リファレンスツービデオプレイグラウンド、2枚のリファレンス画像と1つの音声ファイルが読み込まれ、出力パネルに完成したクリップが表示されている
Atlas Cloud上のWan 2.7 リファレンスツービデオ: 左側に2枚のリファレンス画像と1つのボイスクリップが添付され、右側で完成したテイクが1080P、16:9で再生されている。このキャプチャはモデルのデフォルトの長さで実行されました。以下の完全版では10に設定してください。
完成したクリップ。両方の顔が保持され、両方の衣装が保持され、セリフはステップ3でクローンされた声で配信されています。そのため、これは音声をオンにして再生する価値があります。
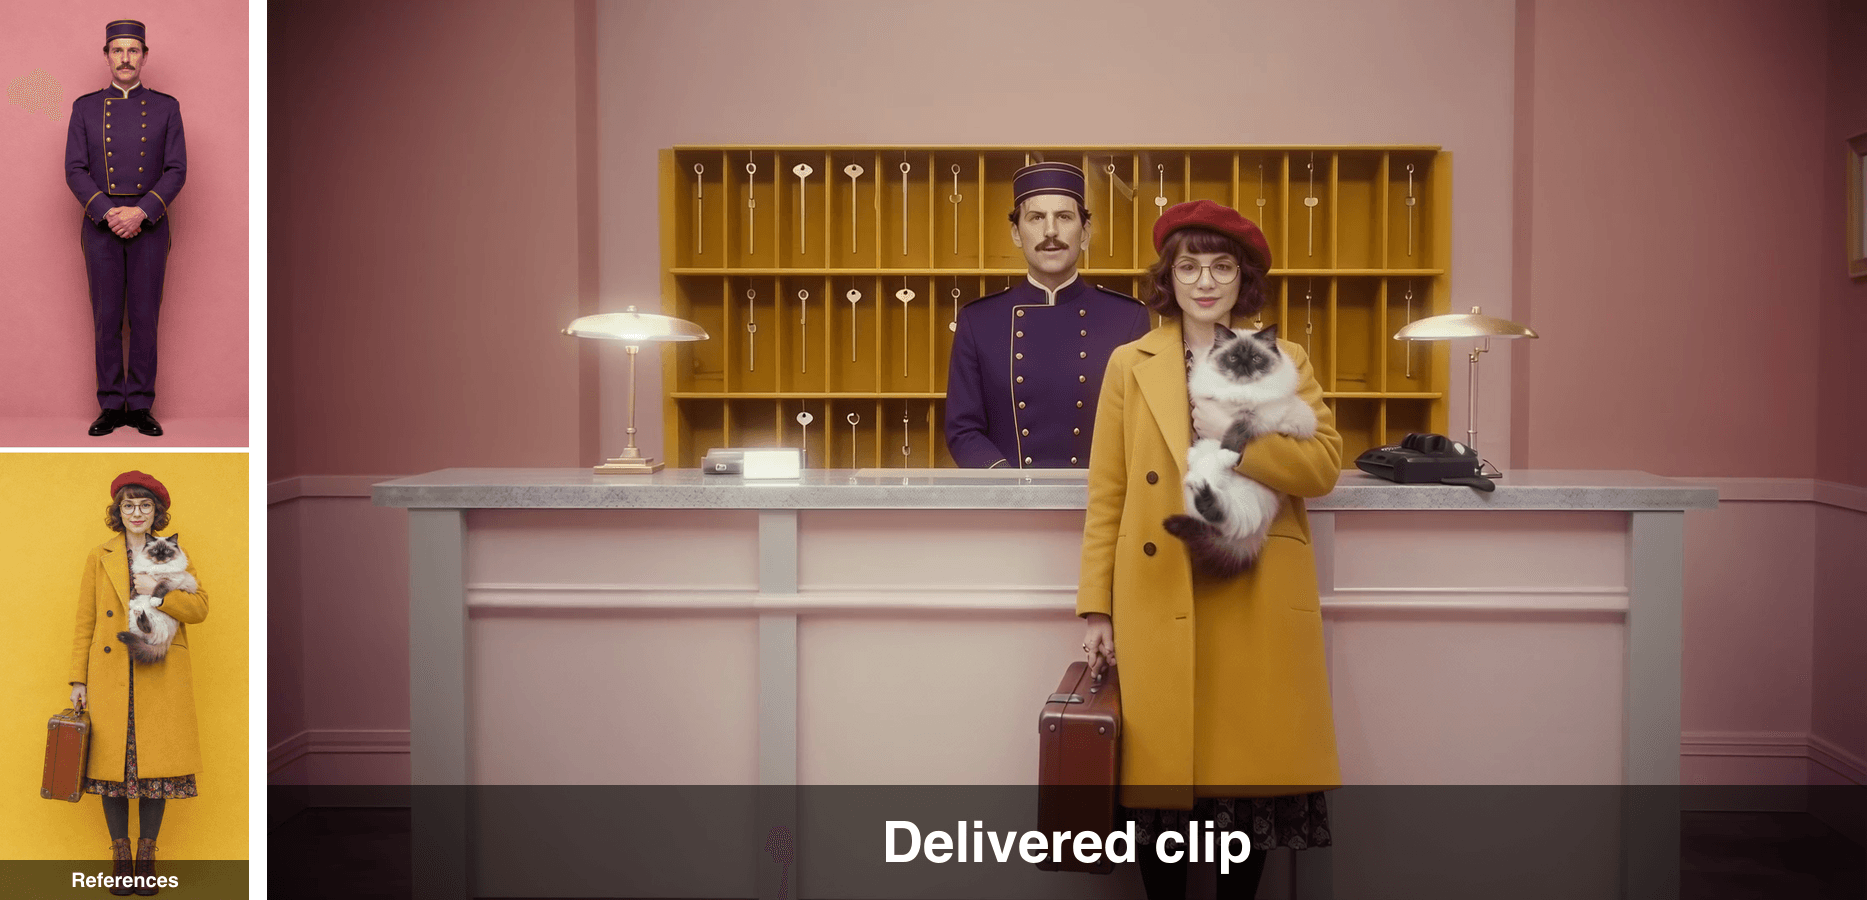
2枚のリファレンスポートレートと完成したクリップのフレームを比較、同じ顔と衣装を示している
左側がリファレンス、右側が配信されたクリップのフレーム。ユニフォームのパイピング、ベレー帽、メガネ、猫はすべて変換を生き延びています。
Wan 3.0マルチモーダルリファレンスワークフローのバリエーション
30秒にプッシュする。 同じリファレンスパックは、Seedance 2.5 リファレンスツービデオ で duration: 30 として実行でき、ベータを待たずにWan 3.0が約束する長さを得られます。最大30枚のリファレンス画像、10本の動画、10の音声クリップを受け付けるため、パックには成長の余地があります。追加の20秒は、プロンプトに雰囲気ではなくビートとして書き込まないと、モデルが間を埋めてしまいます。
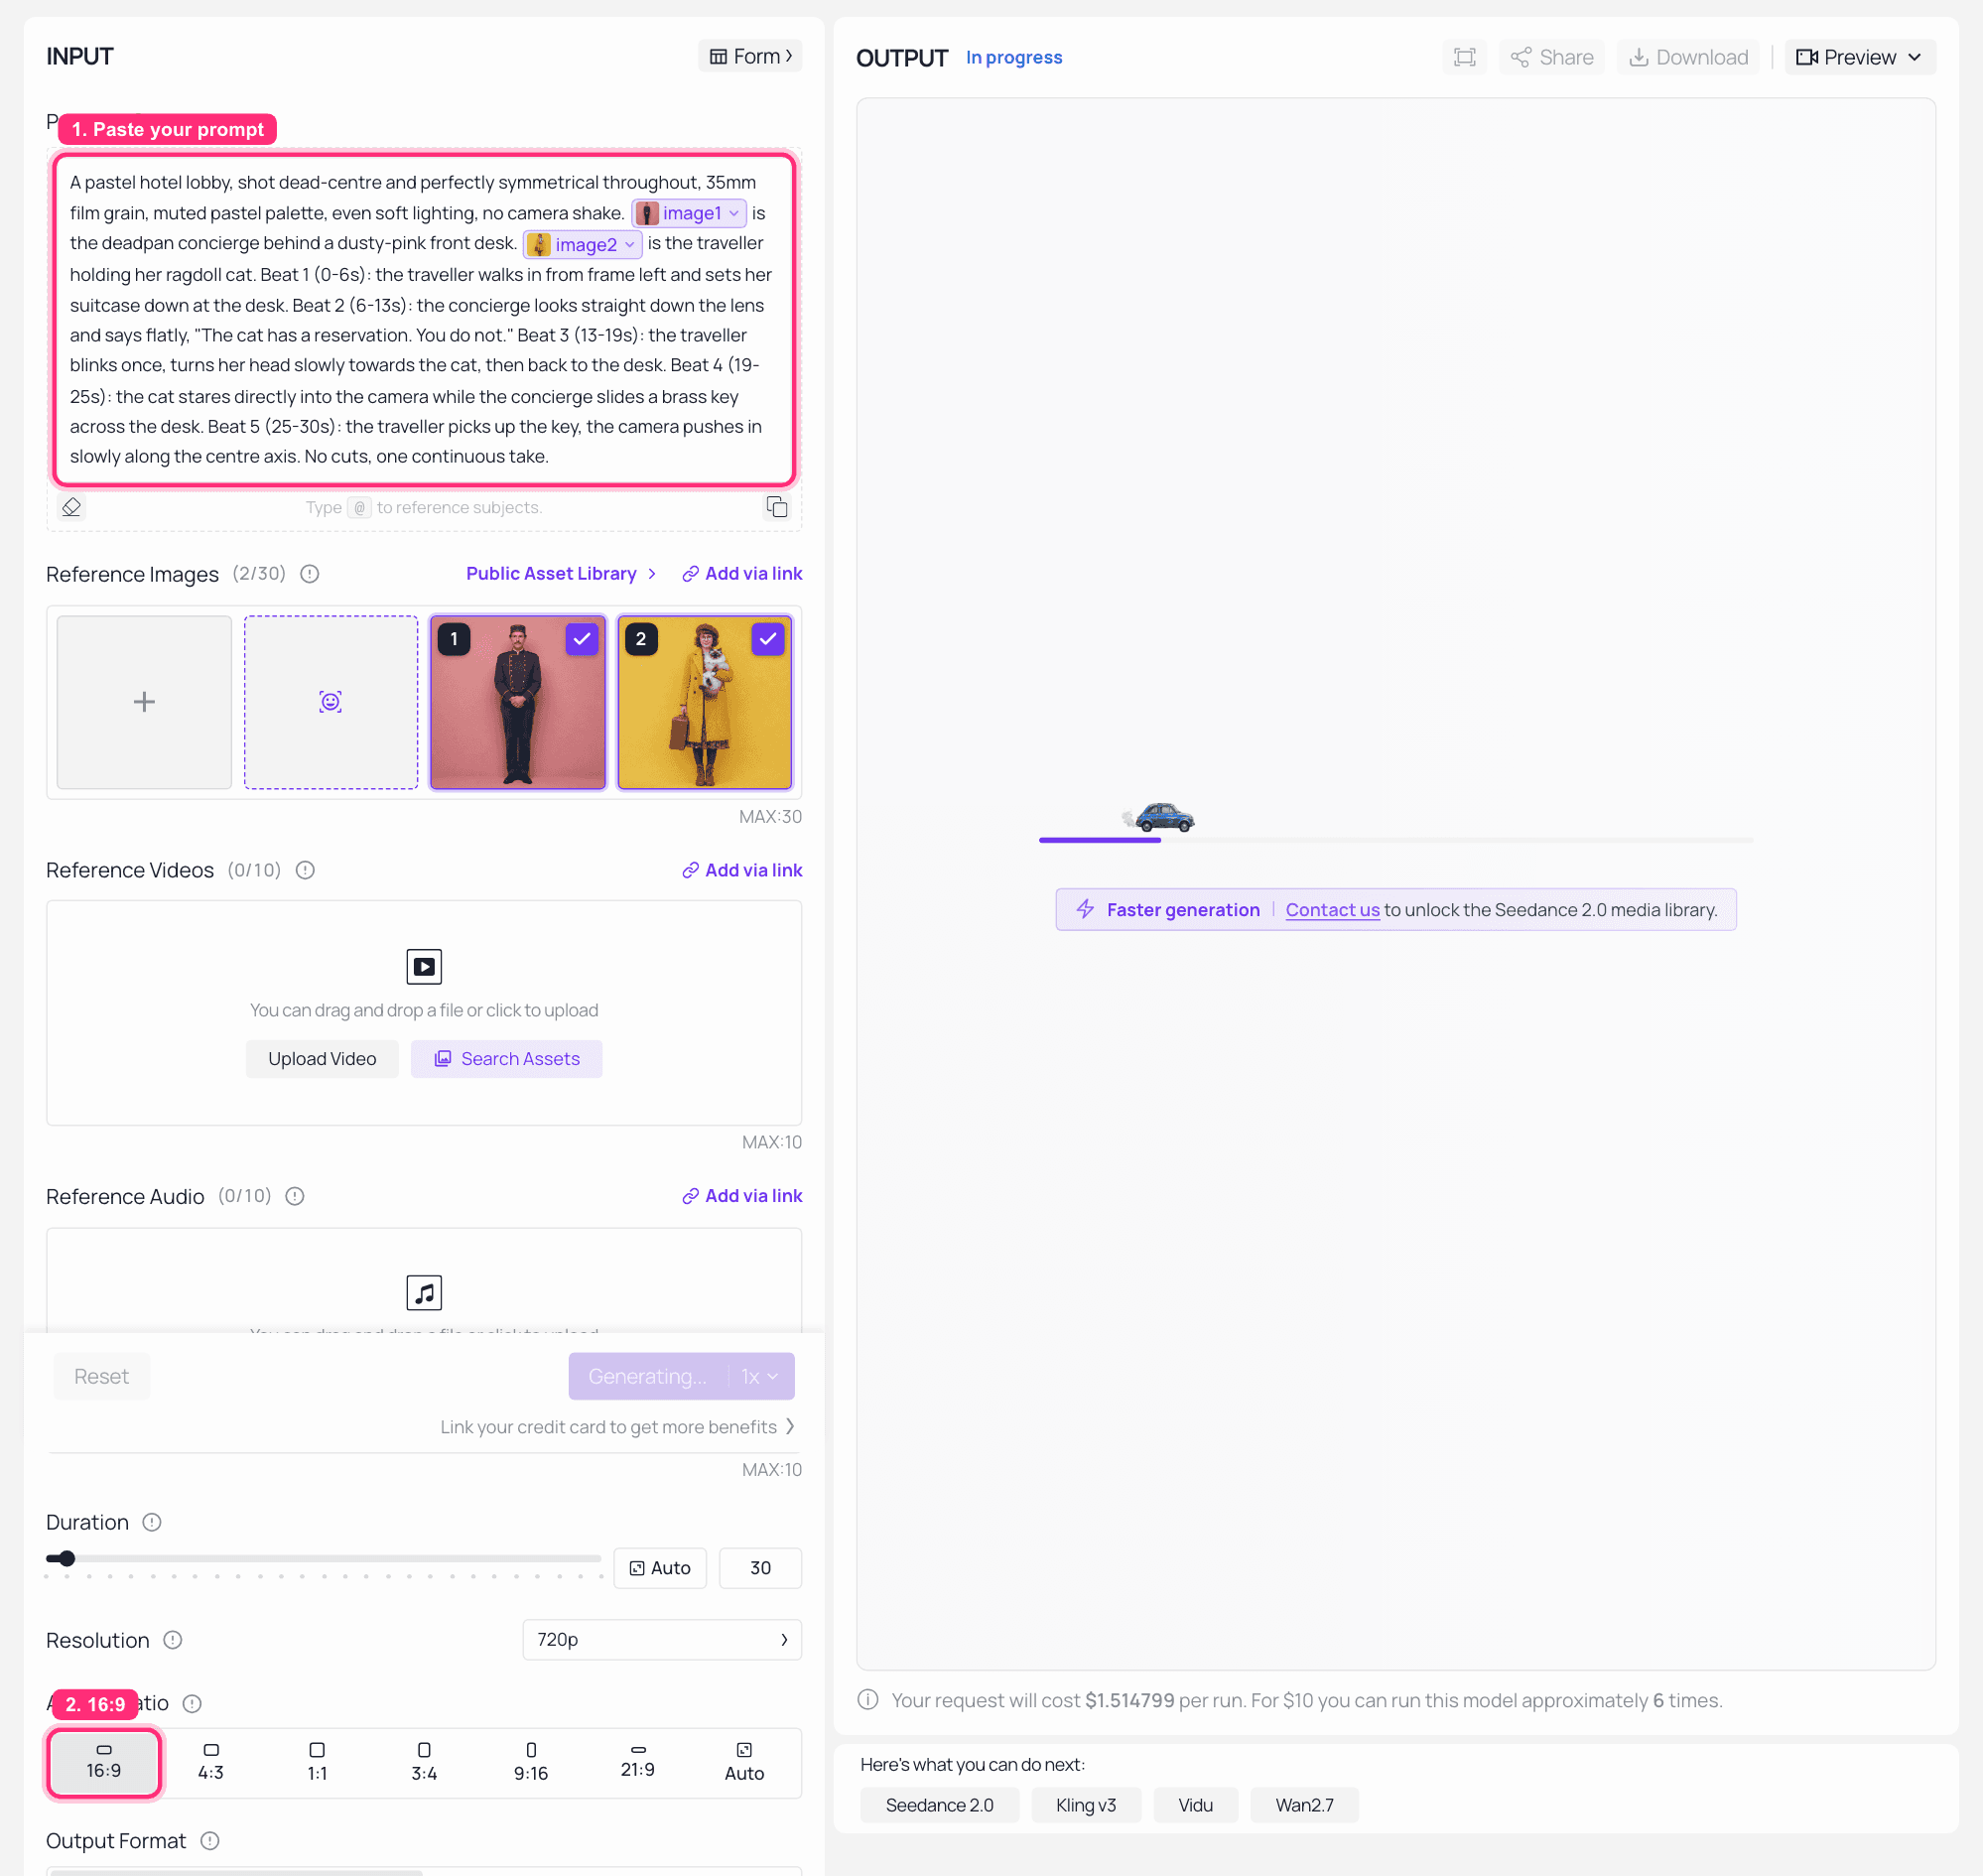
Atlas Cloud上のSeedance 2.5 リファレンスツービデオプレイグラウンド、durationが30に設定され、ロングテイクがレンダリングされている
Atlas Cloud上のSeedance 2.5 リファレンスツービデオ、durationを30に設定し、同じ2枚のリファレンスポートレートを添付、生成途中の状態。プロンプト内の @image1 と @image2 チップに注目。これがSeedanceにどのリファレンスがどの役割を果たすかを伝える方法です。コミットする前に、Runボタンの見積もり価格を確認してください。これはジョブが実際に送信する長さを反映するためです。
同じシーンの30秒バージョン、同じリファレンスパック、ビートはショットごとに書き出されています。
動きのみのリファレンス動画を追加する。 ペースが気に入ったクリップを添付し、プロンプトで「カットのリズムのみリファレンス動画に従い、被写体と設定は無視する」と明示的に指示します。これが前述のカードフリップの例の背後にあるトリックです。
ポジティブプロンプトに触れる前に、ネガティブプロンプトでドリフトを修正する。 顔の変形、色の変化、手持ちカメラの揺れは、リファレンスロックショットを台無しにする3つの要素であり、これらは通常、説明しようとするよりも抑制する方が安上がりです。
マルチモーダルリファレンスフォーマットを無料で試す
パラメータの前にこの形状を試したい場合は、先週Atlas Cloudがリリースした無料AI広告スキットジェネレーターがあり、ノブは一切なしで同じチェーンを実行します。
商品とそのセールスポイントについて1行書くだけで、フック、対立、どんでん返しを含む2キャラクターのコメディスクリプトを作成し、音声付きの15秒動画と効果音を組み込んでレンダリングします。最大4枚の実際の商品写真をリファレンスとして添付でき、広告はスクリプトから最終フレームまで、その形状、色、ラベル、ロゴを保持します。ファニーミームからプロットツイスト、シットコム、ラグジュアリー、ハードセルまで6つのスタイルが付属し、ダイアログは説明文を書いた言語で返ってきます。
これは、チュートリアルと同じ2キャラクター+リファレンス画像+音声チェーンですが、プロンプト作成とコストが不要です。そのため、このフォーマットがあなたの商品に合うかどうかを、チューニングに費用を費やす前に確認するのに適した方法です。
リファレンス静止画のスタックが商品映像に何をもたらすかを知るには、Wan 3.0自身のバージョンをご覧ください。5枚の画像を入力し、1本のローンチリールを出力、各静止画が編集の1ビートを支えています。
5枚のリファレンス静止画がマテリアルデザインスタイルの商品ローンチリールに展開される_5枚のリファレンス画像が9秒の商品フィルムを駆動し、各画像が1ビートを支え、次の画像に引き継ぐ。出典: Alibaba公式のWan 3.0クリエイターハンドブック。_
Wan 3.0マルチモーダルリファレンスクリップのコスト
| ステップ | モデル | 単価 | 数量 | コスト |
|---|---|---|---|---|
| 1と2、リファレンス画像2枚 | GPT Image 2 | 画像1枚あたり0.009ドル | 2 | 0.02ドル |
| 3、音声リファレンス | MiniMax Speech 2.6 HD | 1K文字あたり0.08ドル | 49文字 | 0.00ドル |
| 4、1080Pでの10秒テイク | Wan 2.7 リファレンスツービデオ | 1080Pで1秒あたり0.15ドル | 10秒 | 1.50ドル |
| チュートリアル合計 | 約1.52ドル | |||
| バリエーション、30秒 | Seedance 2.5 リファレンスツービデオ | 480Pで1秒あたり0.134ドル | 30秒 | 約4.02ドル |
| 無料ルート | 無料AI広告スキットジェネレーター | 無料 | 1クリップ、15秒 | 0ドル |
これらはプラットフォーム自身のレートであり、2026年8月に確認され、従量課金制です。合計を人々が予想以上に動かす2つのことがあります。1つ目は解像度です。比較表の1秒あたり0.10ドルはWan 2.7の基本レートであり、1080Pでは0.15ドルが請求され、上記の1.50ドルはここから来ています。2つ目は、Seedanceはピクセル数で価格設定されているため、表示されている1秒あたり0.134ドルは480Pの数値であり、720Pのテイクは単純な掛け算よりも高くなります。参考までに、報告されているWan 3.0ベータの1080pでの1秒あたり0.20ドルのレートは、フル30秒テイクで約6ドルになり、これは今日の480PでのSeedanceルートよりも高くなります。
これらを使用する際の注意事項。 Wan 3.0はベータ版であり、その条件は変わる可能性があるため、パイプラインを構築する前に再読してください。リファレンス画像が実在の人物である場合は、事前に許可を得てください。リファレンスツービデオは、まさにそれを重要にする機能だからです。この記事の例のクリップは、アリババ公式の公開クリエイターハンドブックからの生成結果であり、解説のためにここで転載しています。
よくある質問
Wan 3.0のマルチモーダルリファレンスは、実際にいくつのリファレンスを受け付けますか?
1回の呼び出しで最大20アセットで、画像、動画、音声、ドキュメント、Webページから取得します。実際の制限は技術的なものよりも低くなります。各アセットに正確に1つのジョブを割り当て、画像ごとに被写体1人とすれば、ほとんどのシーンで20をはるかに下回る使用量になります。
Wan 3.0は本当にPDFやWebページを動画に変換できますか?
はい、それが本当にユニークな部分です。テキスト、画像、音声、動画に加えて、ドキュメントファイルとライブURLを受け付け、ベータ版の報告では.doc、.xls、.ppt、.pdf、.txtが挙げられています。上記の比較表にある他のリファレンスツービデオモデルで、ドキュメントをまったく受け付けるものはありません。
Wan 3.0はオープンソースですか?ComfyUIで実行できますか?
いいえ、そして今のところはできません。Wan 3.0はアリババのクラウド上で動作するクローズドベータです。初期のWan世代はオープンにリリースされたため、そのような期待が存在しますが、アリババは3.0のウェイトを確認していません。Wan 3.0の1.3Bまたは14B Apache 2.0リリースを主張するページは、公式の裏付けがありません。
Wan 3.0はサードパーティのAPIから利用できますか?
まだです。Atlas Cloudも含まれます。今日呼び出せる最も近いものは、Wan 2.7 リファレンスツービデオ(その入力形状はドキュメントとWebページのモダリティを除いてオムニリファレンスとほぼ完全に一致します)、またはフル30秒が必要な場合はSeedance 2.5 リファレンスツービデオです。
リファレンスロックされた2キャラクター動画をテストする最も安い方法は何ですか?
上記のリンク先の無料AI広告スキットジェネレーターです。4枚のリファレンス写真を入力し、15秒の音声付き2キャラクタークリップを出力、パラメータも費用も不要です。これがあなたの商品とフォーマットを保持するなら、その後で有料チェーンを調整してください。
リファレンス画像を使用しているのに、なぜキャラクターがまだドリフトするのですか?
頻度順に3つの原因があります。1つのリファレンスが2つの仕事を担っており、顔と場所の両方を固定するよう求められている。リファレンス画像に複数の人がいるか、背景が混雑しており、モデルがどの部分をロックすべきかわからない。または、ドリフトがレンダリングアーティファクトであり、リファレンスの失敗ではない場合、何かを書き直す前にネガティブプロンプトに face morphing, colour shift を入れてください。


