
 Atlas Cloud は Dreamina Seedance 2.5 および Seedream 5.0 Pro の米国認定リセラーになりました。Atlas Cloud は Dreamina Seedance 2.5 および Seedream 5.0 Pro の米国認定リセラーになりました。
GPT Image 1は、実用的なビジュアルツールを構築する開発者向けに、OpenAIの画像モデルファミリーの中核を担います。判読しやすいテキストを描画し、詳細なプロンプトに従い、フォトリアルなシーンを生成できます。また、世界に関する知識を活用して、さまざまなビジュアルスタイルに対応します。Atlas Cloudは、コールドスタートなしの本番ワークロード、透明性の高い従量課金制、99.99%の稼働率、300以上のモデルへのアクセスを提供します。今日から開発を始めましょう。
GPT Image は OpenAI が開発したモデルです。Atlas Cloud(運営:Atlas Cloud AI LLC)は本モデルへのアクセスを提供するものであり、その所有者ではありません。すべての商標は各所有者に帰属します。
Atlas Cloudは、業界をリードする最新のクリエイティブモデルを提供します。
最低コスト
| Modality | Description |
|---|---|
| GPT Image 1 T2I API (Text to Image) | Turn text prompts into generated images with the GPT Image 1 text to image endpoint. Built for visual asset creation, its ready to use REST inference API offers no cold starts at a standard price of $0.011 per image. |
| GPT Image 1 Edit API (Image to Image) | Refine or transform supplied images through the GPT Image 1 editing endpoint. Its REST inference API supports image creation and revision workflows with no cold starts and standard pricing of $0.011 per image. |
GPT Image 1 は、正確なテキスト描画、詳細なプロンプト制御、多彩なビジュアルスタイル、参照画像とマスクによる編集、3 段階の品質、3 種類の出力サイズ、バッチ生成、そして Atlas Cloud による本番対応の配信制御を一体化しています。
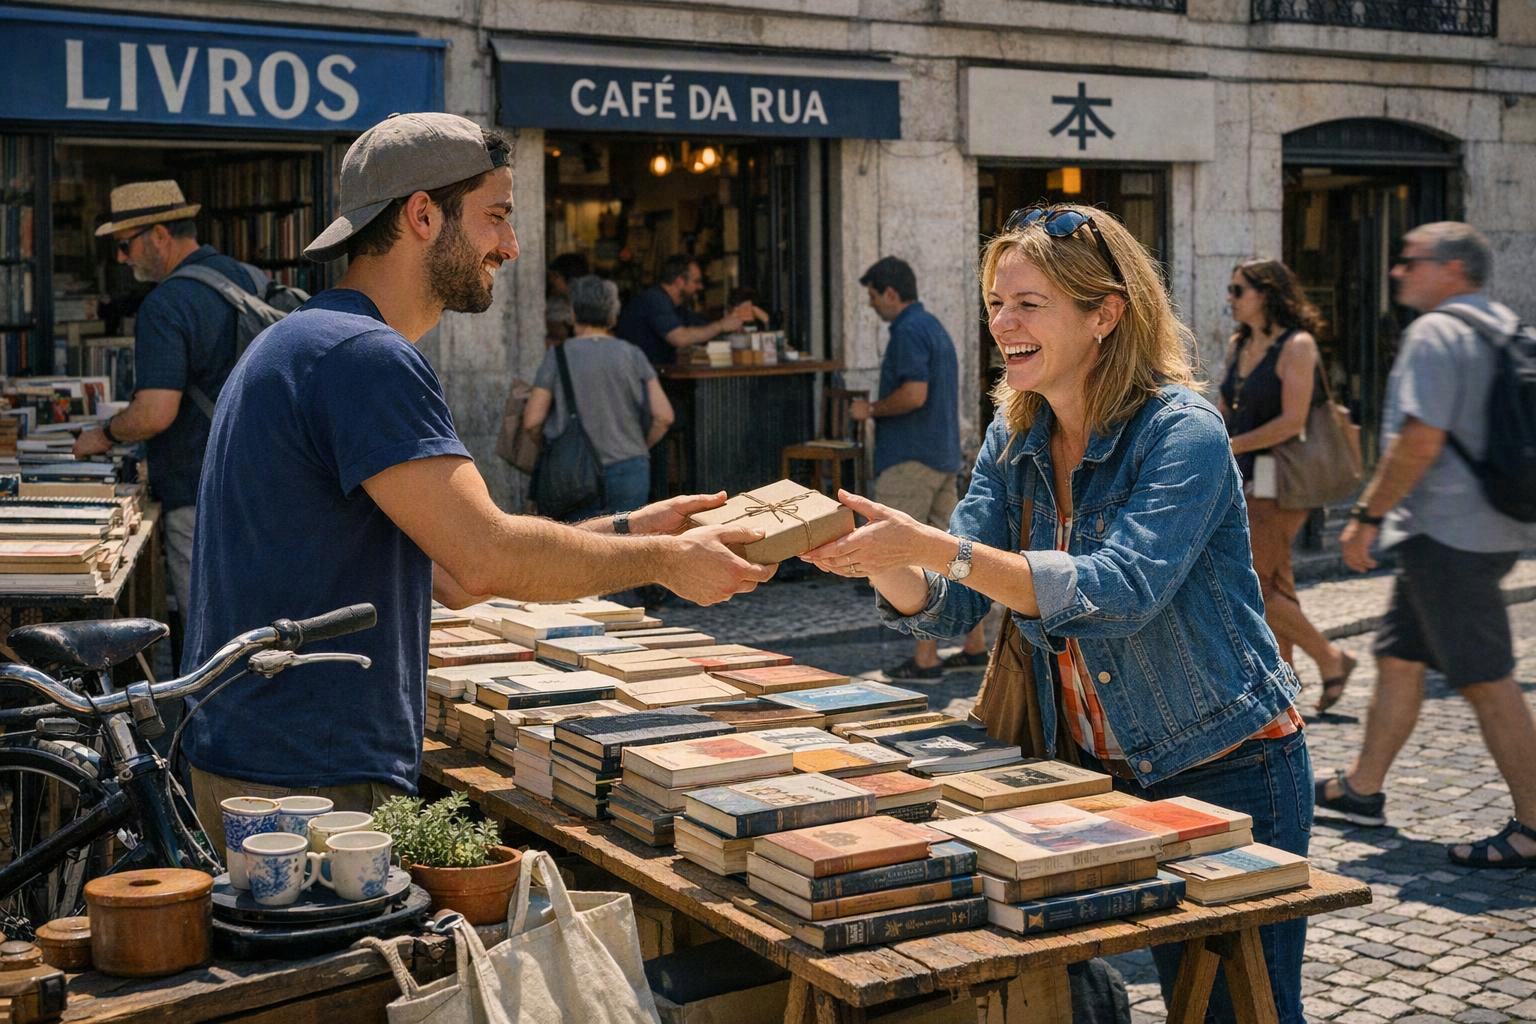
GPT Image 1 は詳細なプロンプトに従い、読みやすいテキストを描画できます。また、複雑なシーン内でおよそ 10〜20 個の異なるオブジェクトを整理して配置できます。看板、商品ラベル、インフォグラフィック、インターフェースのモックアップを指定する際は、構図やビジュアル要素の関係性を指示しながら、明確な表現を使ってください。言語理解と画像理解を組み合わせることで、開発者は本番ワークフローにおいて、要求の厳しいクリエイティブブリーフにより近いアセットを作成できます。
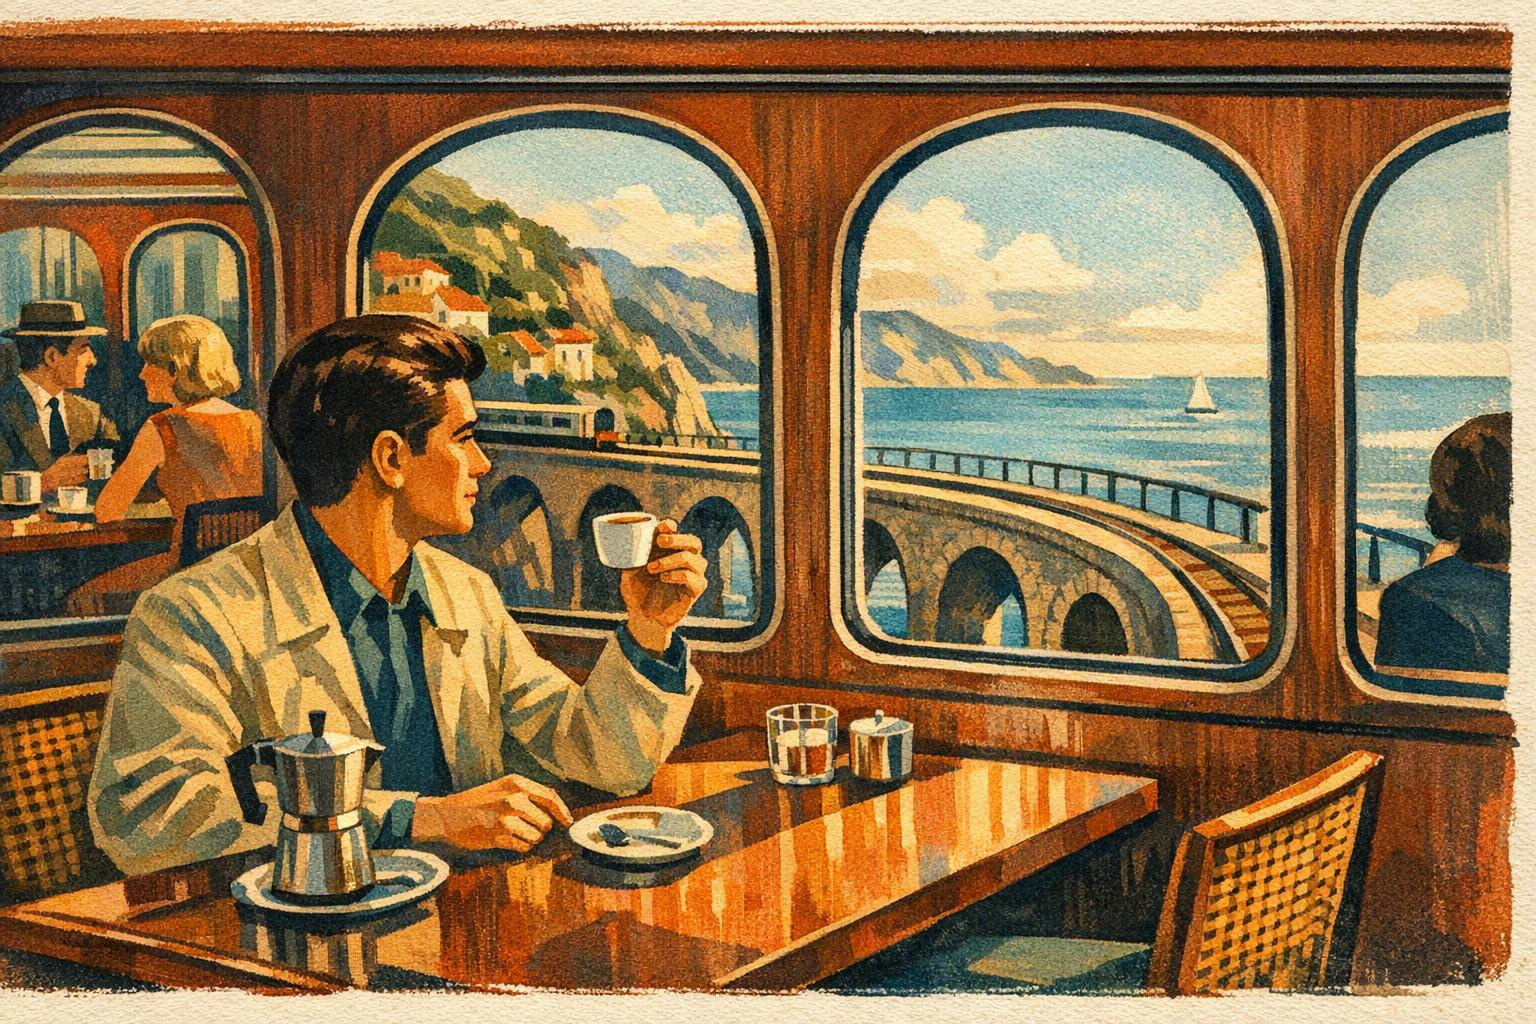
フォトリアルな写真から、スタイライズドイラスト、コンセプトアート、インフォグラフィック、3D 風のビジュアルまで、GPT Image 1 はさまざまな美的方向性を解釈できます。文化的、歴史的、または業界固有のコンテキストをプロンプトに取り入れることで、表面的なスタイル付けにとどまらないモデルの世界知識を活用できます。この幅広さにより、基盤モデルを変更したり統合スタックを作り直したりすることなく、複数のビジュアル表現を必要とするクリエイティブパイプラインに対応できます。
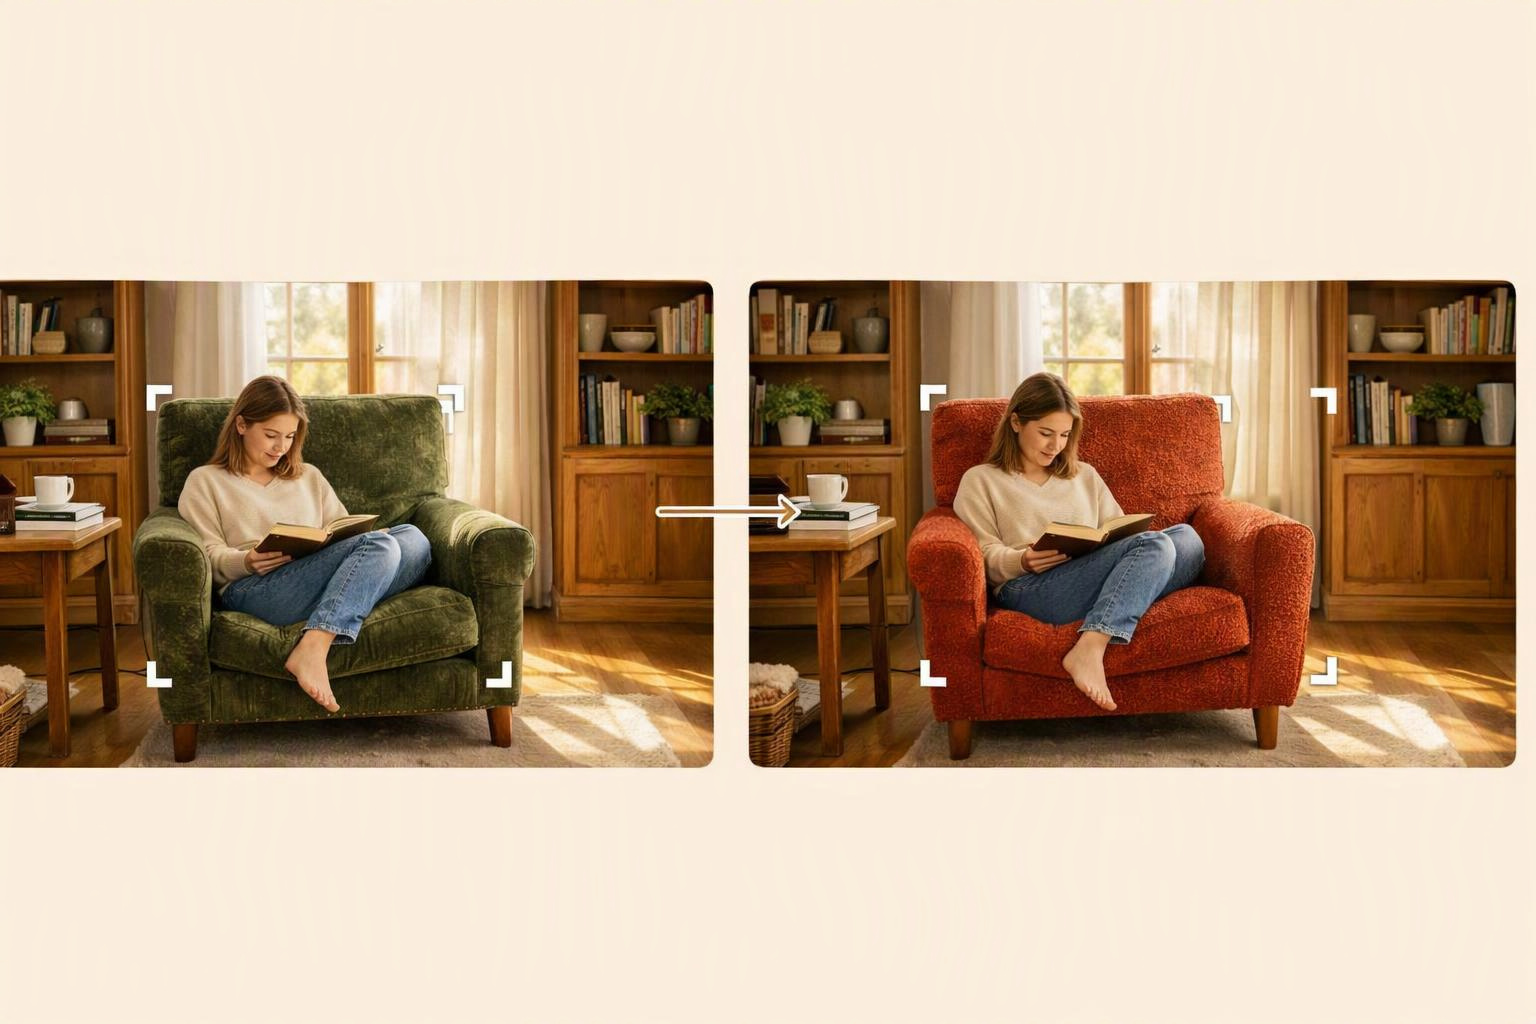
1〜4 枚の入力画像に加え、変更対象の透明領域を示すオプションの PNG マスクを使って、既存のアセットを編集できます。複数の参照画像を指定した場合、マスクは 1 枚目の画像に適用され、プロンプトが要求する変更内容を指示します。これにより、対象を絞ったレタッチ、オブジェクトの置き換え、合成、制御された反復編集が可能になり、本番アセット内の変更しない領域を維持できます。
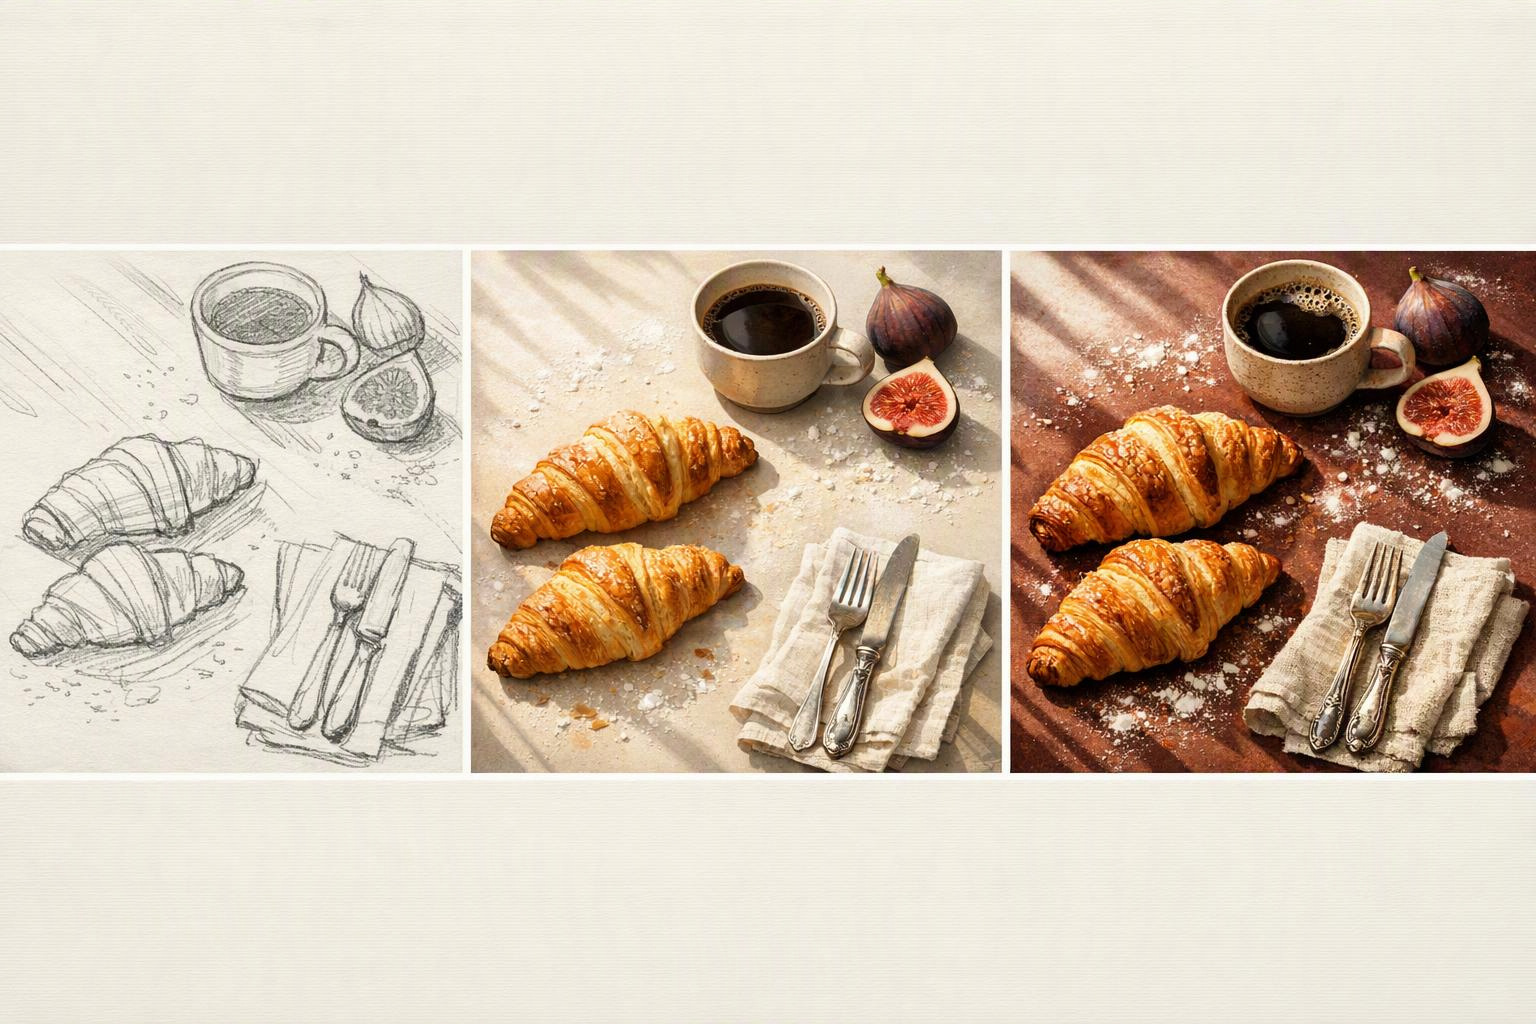
GPT Image 1 の各リクエストで Low、Medium、High のいずれかの品質を選択し、1024x1024、1024x1536、1536x1024 の出力サイズから選べます。詳細度と処理負荷のバランスを取りながら、配信先に合わせて正方形、縦長、横長の構図を選択できます。これらの明示的な制御により、同じエンドポイントをドラフトの検討、キャンペーン用アセット、さまざまな配信チャネル向けの最終本番画像に実用的に活用できます。
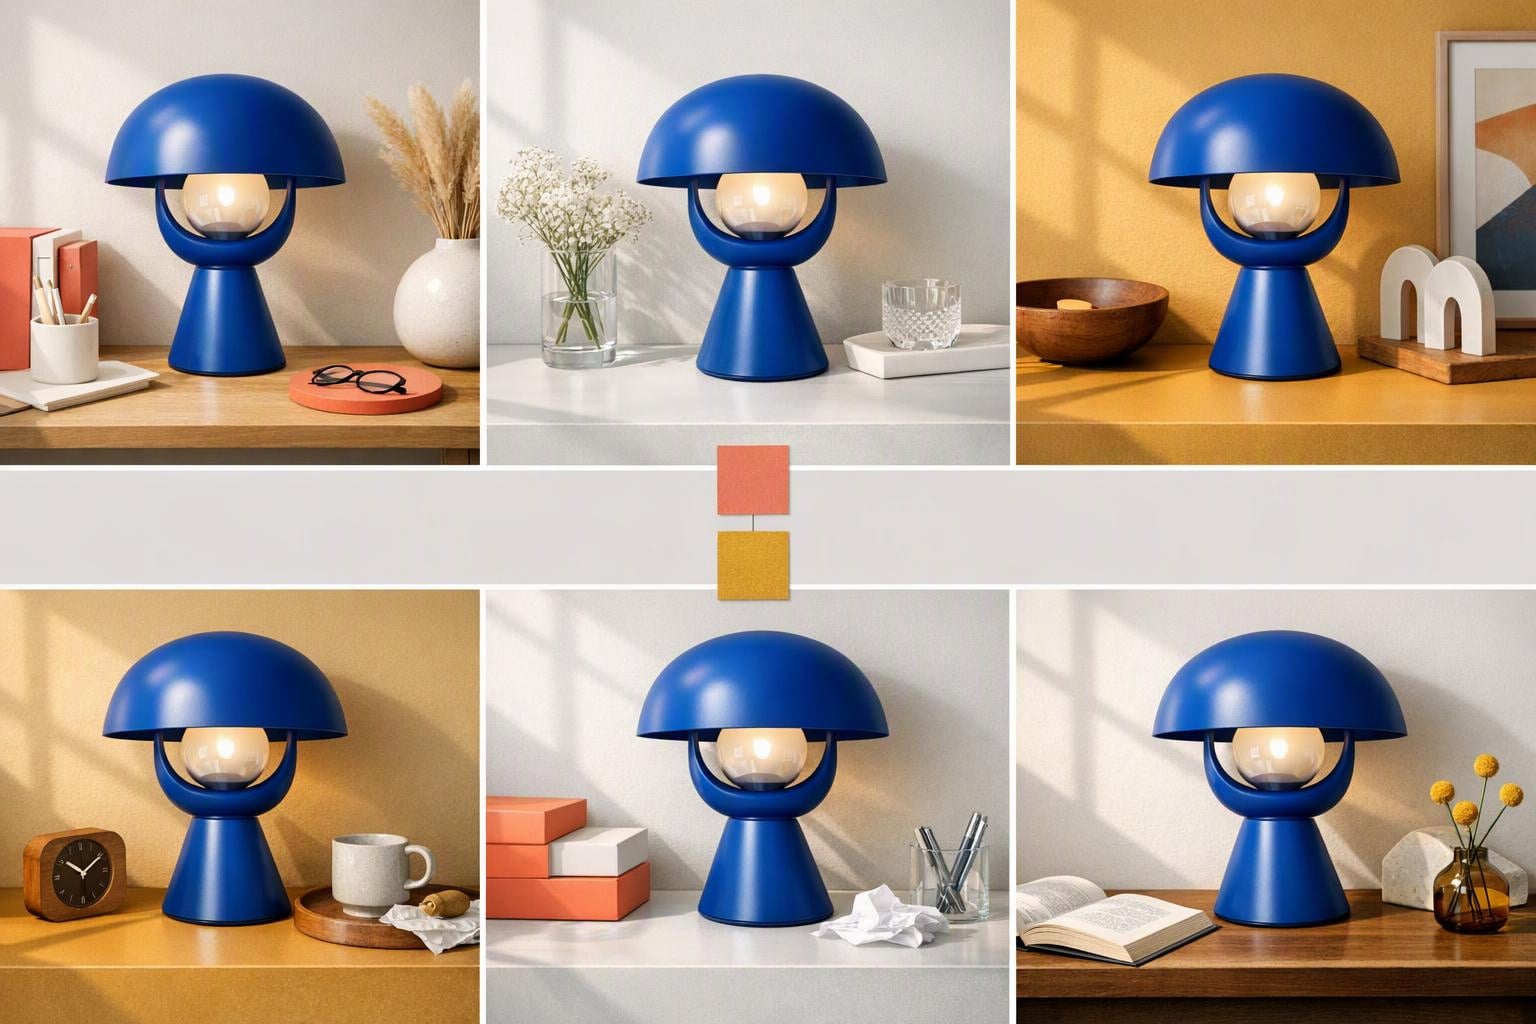
テキストプロンプトから 1〜10 枚の画像を生成でき、PNG または JPEG で出力できます。JPEG で配信する場合は、圧縮率を 0〜100 に設定できます。また、Base64 出力と同期完了により、アプリケーションから直接処理できます。これらの制御を組み合わせることで、バッチでのアイデア展開、アセットパイプライン、予測可能なメディア形式と柔軟なレスポンスワークフローを大規模に必要とする統合処理を簡素化できます。
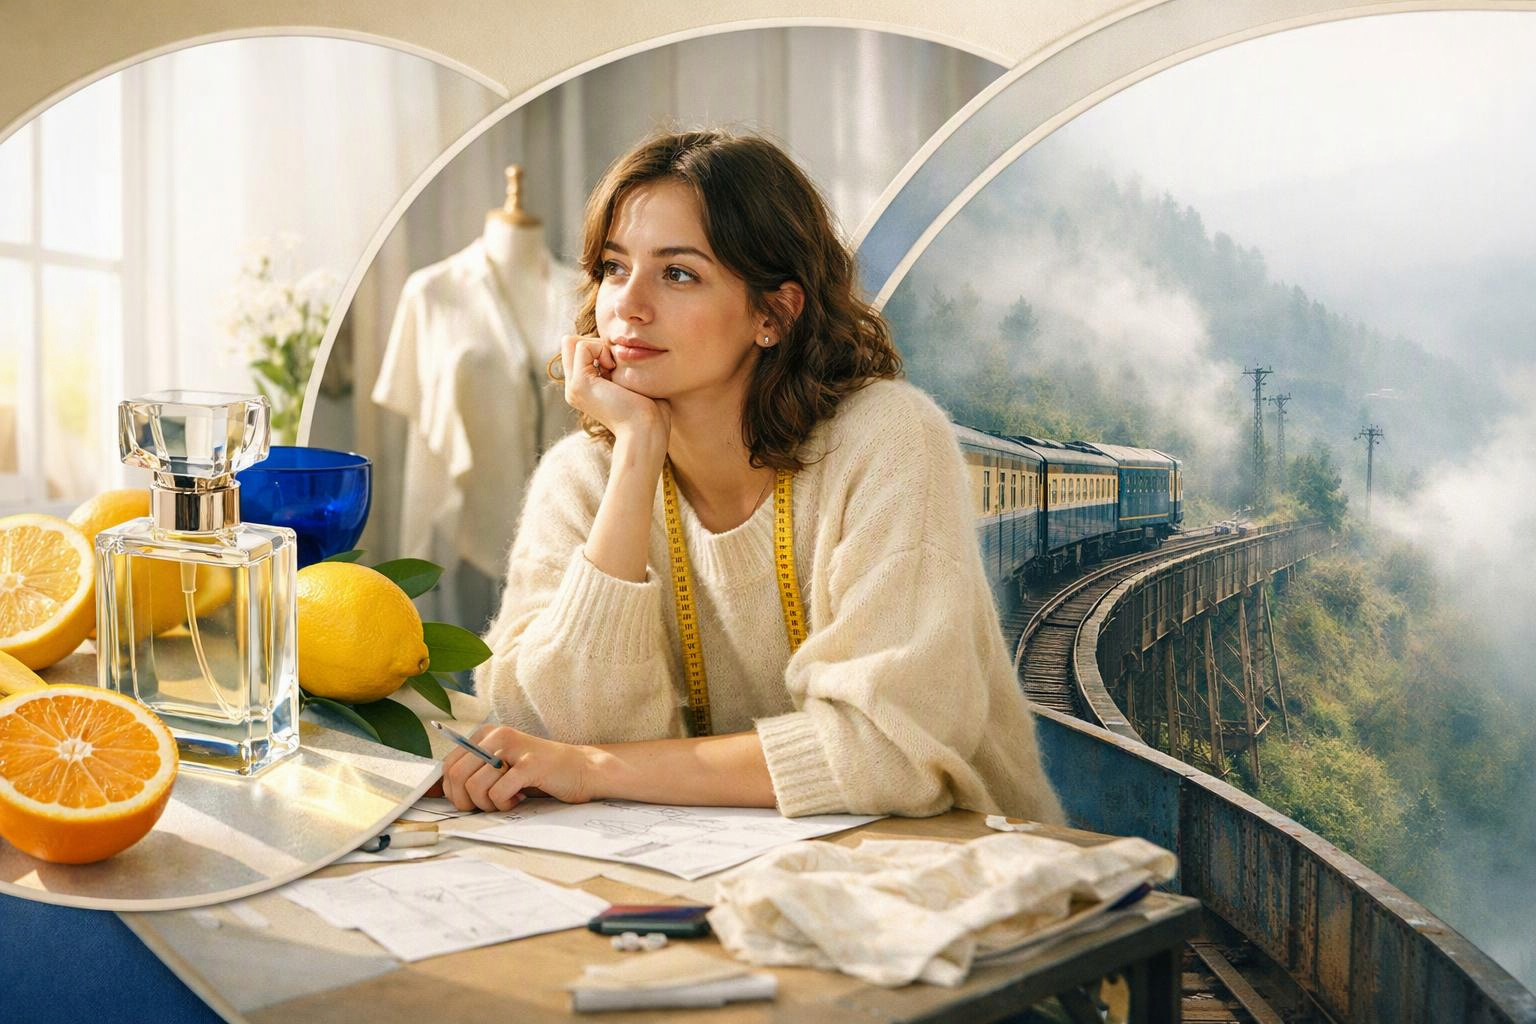
Atlas Cloud を通じて GPT Image 1 の生成と編集を実行できます。料金は従量課金制で、標準価格は 1 画像あたり $0.011 です。どちらのモデルバリアントもコールドスタートなしで同じ Atlas の生成ルートを使用し、同期処理と Base64 オプションによってさまざまなアプリケーションフローに対応できます。個別の画像サービスを管理せず、REST で直接アクセスしたい開発者に適した構成です。
同一のプロンプトを使って、タイポグラフィ、構図、質感、ライティング、決定的瞬間の表現を検証し、GPT Image 1系譜と有力な競合モデルを比較します。
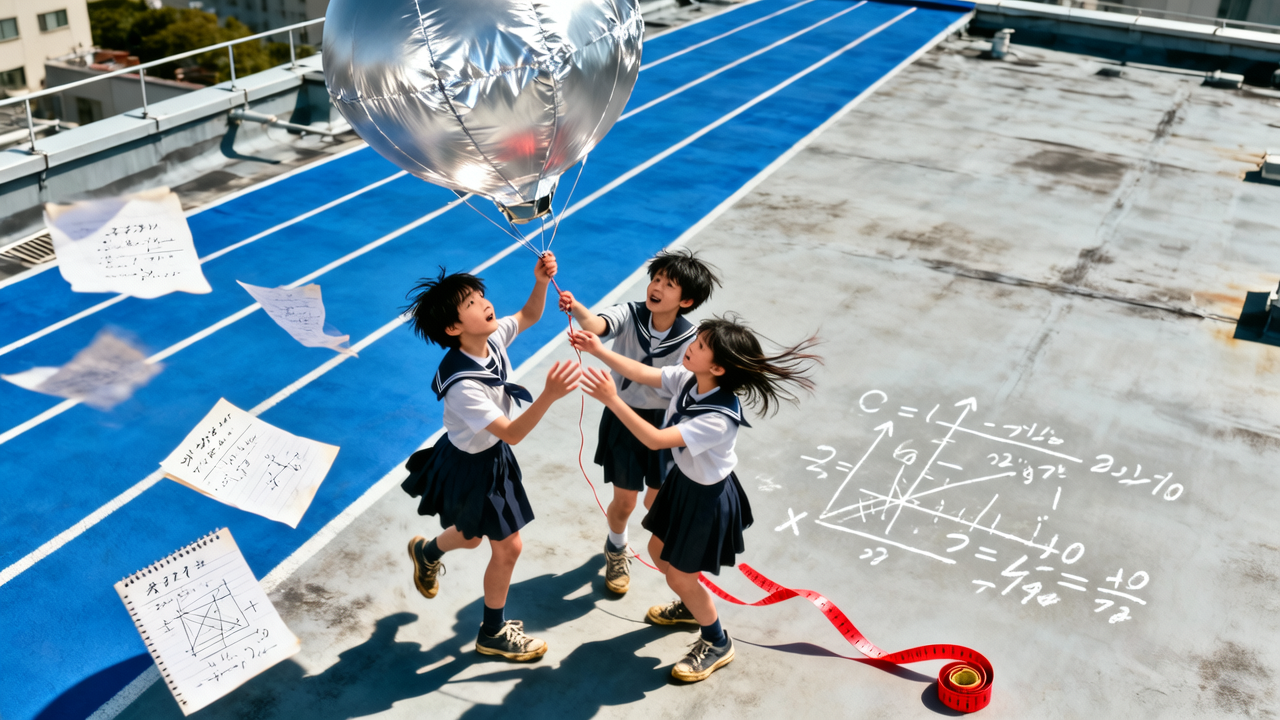
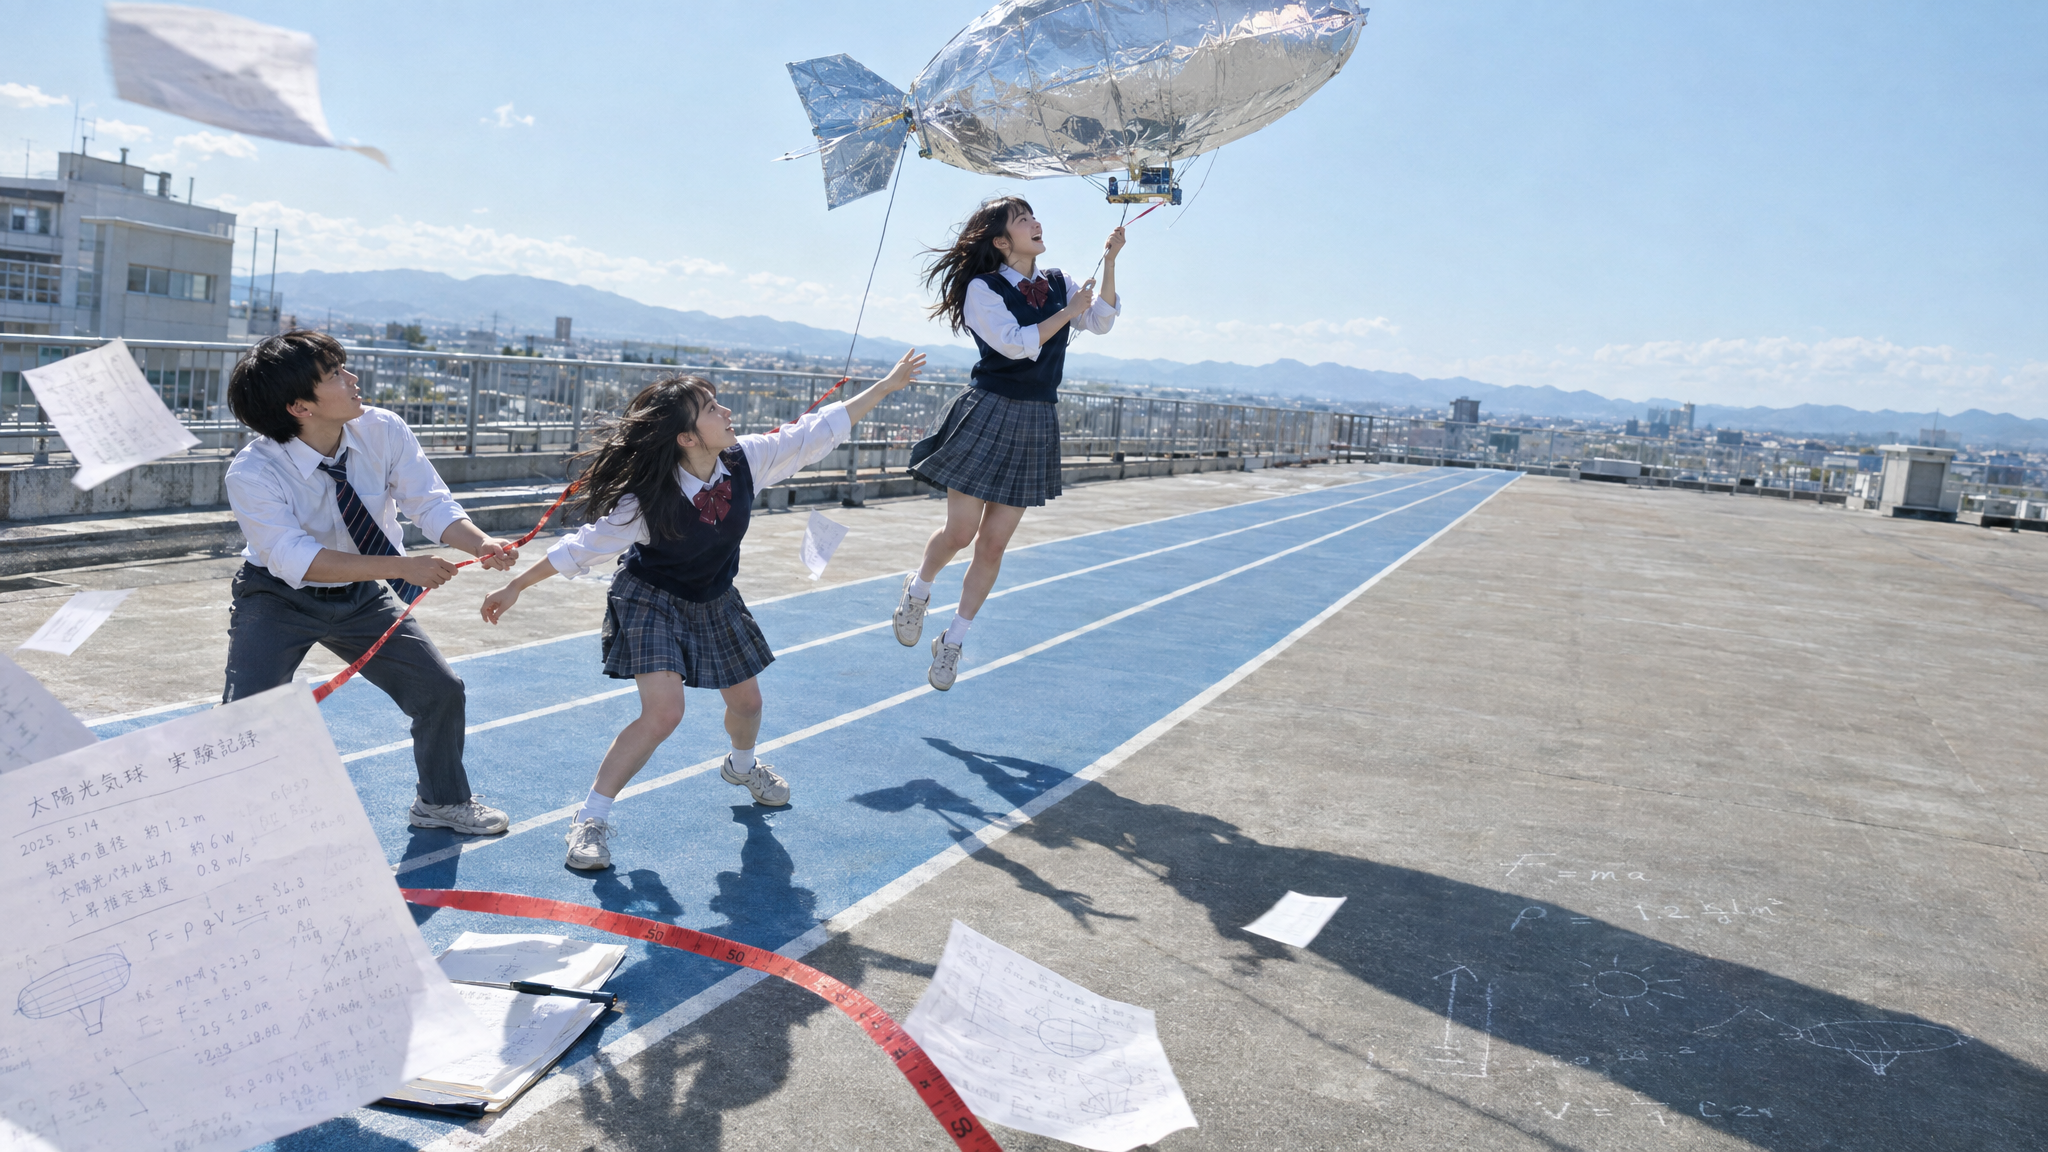
晴れたキャンパスの屋上で行われる、レトロな高校科学部の実験を高角度の斜め構図で捉えた写真。日本の本物の高校制服を着た3人のティーンエージャーが手作りの銀色のソーラー飛行船を一緒に打ち上げている。突然の揚力の急上昇によって1人の生徒が地面からそっと引き上げられ、つま先がコンクリートから浮いた瞬間を捉える一方、他の2人は係留索を踏ん張って支え、空中に浮いた友人へ手を伸ばしている。手は解剖学的に正確で、身体同士の物理的な関係が明確に読み取れる。小さな手書きの計算、図、そして日本語のメモで埋め尽くされた実験記録用紙が、ほどけていくトマトレッドのメジャーとともに風に舞い、驚きと喜びに満ちた、少し制御不能な瞬間を生み出している。コバルトブルーの屋上ランニングレーンのマーキングが、グループへ向かう強い対角線の誘導線を形成する一方、右側全体には意図的に大きく取った、何もないコンクリートのネガティブスペースを残す。硬質で方向性のある真昼の太陽光、エッジの明瞭な細長い影、半透明で反射する飛行船膜の上の明るく抑制されたハイライト。飛んでいる紙、メジャー、風になびく髪だけに控えめなモーションブラーを施す。シルバーグレー、コバルトブルー、トマトレッドによる統制されたカラーパレット。触感のあるしわの寄った金属フィルム、コンクリート上のチョークの数式、織り目のある制服生地、擦れたスニーカー、細い髪の毛、自然な肌理を持つリアルな若い肌。日本のユース向け雑誌のエディトリアルリアリズム、率直なアナログフィルム写真、わずかに露出オーバーの空、繊細な35mmグレイン、自然なコントラスト。ポーズを取った表情、光沢のあるプラスチックのような肌、HDR、濁った色、過剰なマイクロディテール、人工的な発光、映画的なファンタジーのスペクタクルは避ける。深い空間的一貫性、説得力のある屋上の遠近感、統一された風向き、正確な反射と透明感、判読可能な小さな手書きメモ、躍動的でありながら説得力のある複数人物の動き。フレーム全体を満たす横長構図、ワイド16:9アスペクト比、フルブリード。
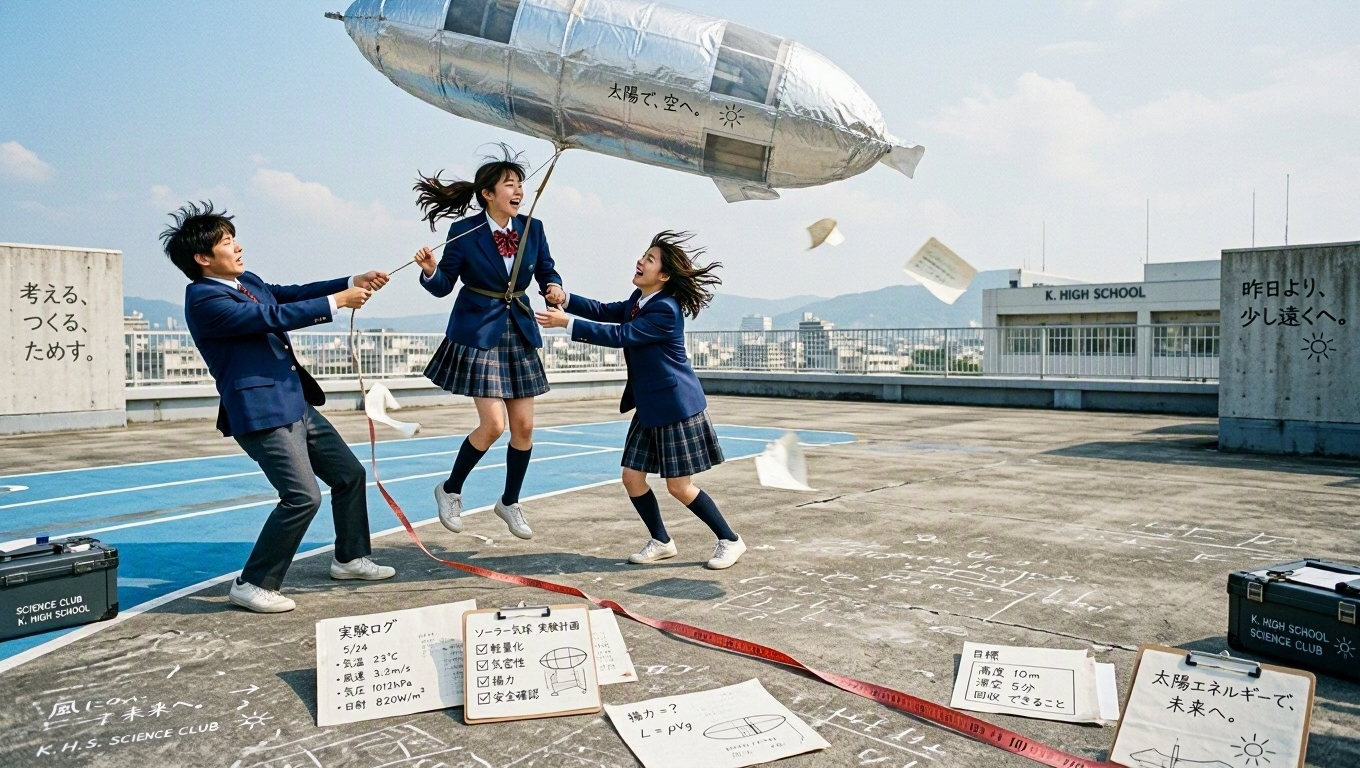
Generated with GPT Image 2.5 Sunburst Text-to-Image on Atlas Cloud
Generated with Nano Banana 2 Text-to-Image on Atlas Cloud
Generated with Openai GPT Image 2 Text-to-Image on Atlas Cloud
エディトリアル・ドキュメンタリー写真。ミントグリーンのタイル床が敷かれた若い陶芸家の工房を、厳密な垂直真上から捉える。高速回転するろくろの上で、コバルトブルーの粘土の器が優雅な螺旋状に崩れ落ちる、決定的でコミカルな瞬間を写す。遠心運動は物理的に説得力のあるものとし、控えめな回転ブラーを加える。湿った泥漿が、質感のある白いキャンバスエプロンの上を優雅な弧を描いて飛び散っている。若い陶芸家の、粘土で覆われた解剖学的に正確な両手が自然に引き戻され、顔には驚きと、笑いをこらえている表情が浮かぶ。ろくろのそばではショウガ色の猫が、空中で捉えられたスポンジへ正確な前足を伸ばしている。毛の動きは説得力があり、遊び心のある焦点を生み出す。硬質で方向性のある午後の陽光が高窓から斜めに差し込み、床全体に輪郭のくっきりした長方形の光の帯と、エッジの長い影を刻む。中心から外れた回転するろくろを軸に、風変わりな円形構図を組み立てる。木製の道具、抑制された釉薬の皿、粘土の切れ端、割れた陶器の破片を、密度に変化のある放射状のリズムで配置しつつ、余白の大きく取られた、整理されたコーナーを1つ残す。コバルトブルー、テラコッタオレンジ、ミントグリーンの3色による統制されたカラーパレットを使い、白と控えめなニュートラルカラーでバランスを取る。光沢のある濡れた粘土と粘り気のある飛沫、粗い織りのエプロン繊維、釉薬を施した陶器の光沢、傷のついた木、マットで多孔質な破片、柔らかな猫の一本一本の毛、わずかなフィルムグレイン、工房に実在する小さな不完全さなど、素材ごとの触感を明確に描き分ける。洗練された現代的なエディトリアル写真。ポーズを取ったものではなく自発的で、自然な表情、整合性のある真上からの空間幾何学、クリーンで抑制された色分離、選択的なモーションブラーを伴う鮮明な焦点ディテール。脂っこい過剰描写、HDRによる雑然とした表現、プラスチックのような肌、濁った色、どこにでもある発光、安っぽく大げさなライティングは避ける。ワイドな横長16:9アスペクト比、端から端まで広がるフルブリード構図。
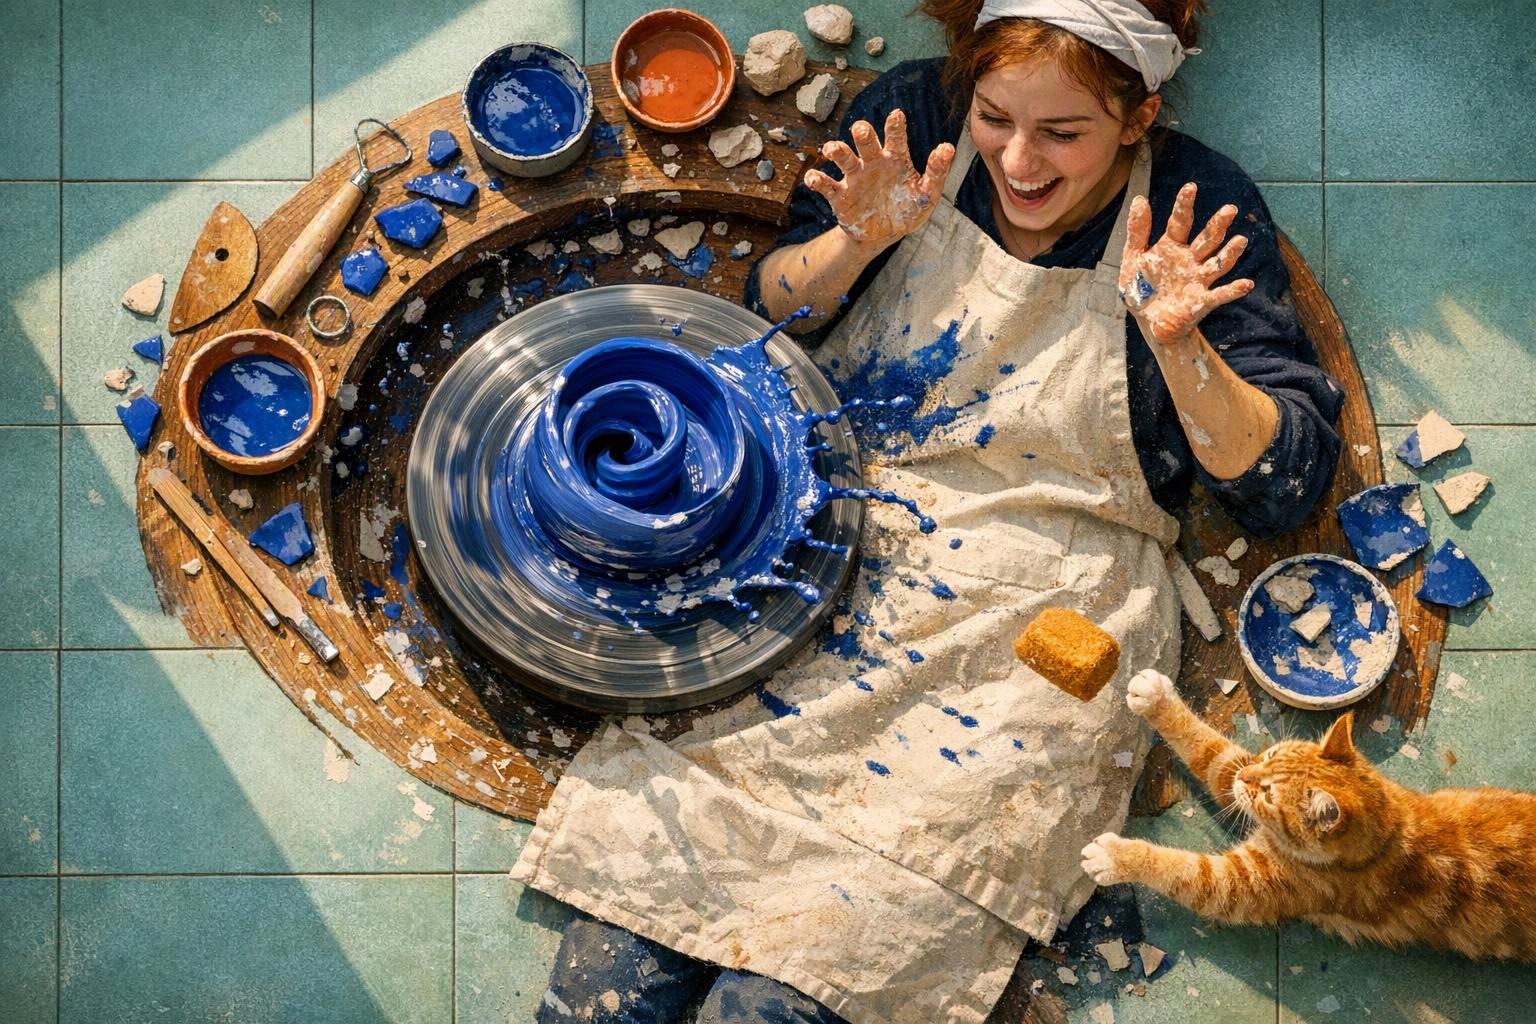
Generated with GPT Image 2.5 Sunburst Text-to-Image on Atlas Cloud
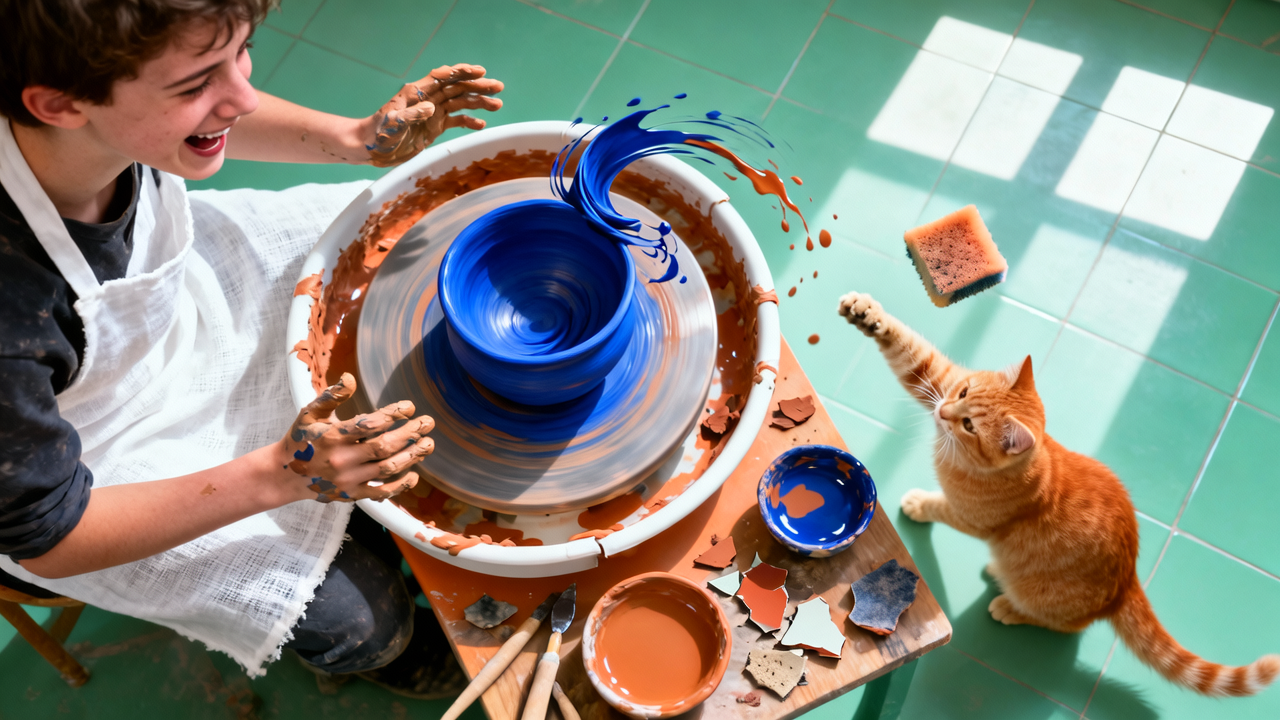
Generated with Nano Banana 2 Text-to-Image on Atlas Cloud
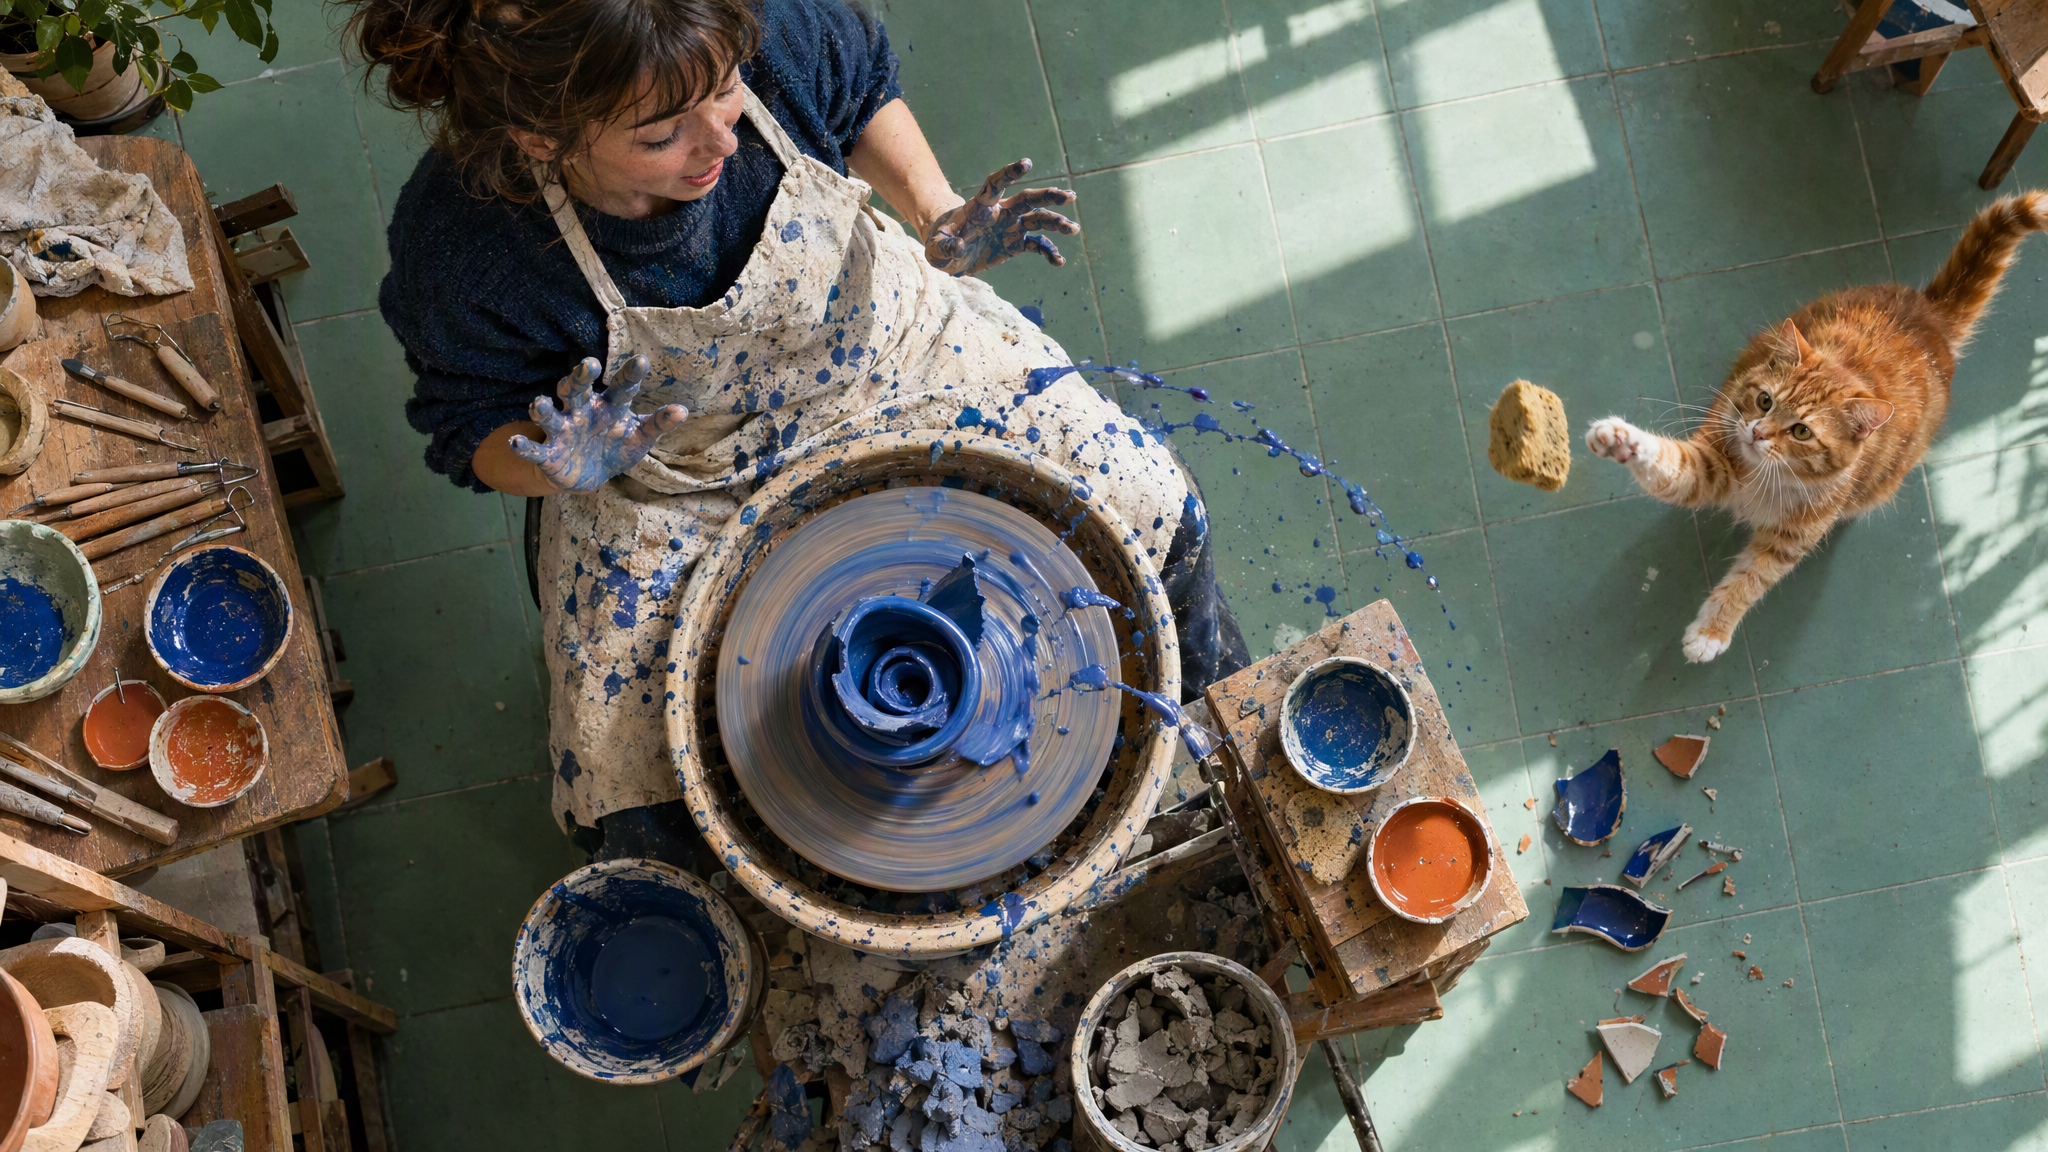
Generated with Openai GPT Image 2 Text-to-Image on Atlas Cloud
3つのモデル階層にわたり、GPT Image 1はテキストと画像の入力を通じて、キャンペーン向けクリエイティブ、製品ビジュアライゼーション、インターフェースのコンセプト設計、対象を絞った編集、コンセプト開発、説明用グラフィックをサポートします。

読みやすい見出し、緻密な構成、クリエイティブブリーフに沿ったスタイルで、キャンペーン用ビジュアルを作成します。マーケティングチームは、SNS用グラフィック、ランディングページ用画像、ポスター、広告コンセプトを制作し、迅速に改善を重ねられます。

自然な照明、質感、空間的な関係性を保ちながら、製品を写実的なシーンに配置します。ECチームは、新たな撮影を手配することなく、カタログのバリエーション、ライフスタイル画像、パッケージのコンセプト、プレゼンテーション用素材を作成できます。

詳細なプロンプトを、構造化されたレイアウト、読みやすいラベル、補助ビジュアルを組み合わせたインターフェースコンセプトへと変換します。プロダクトデザイナーは、実装前にステークホルダーレビューへ提出できるアプリケーション画面、ダッシュボード、オンボーディングフロー、プロトタイプを検討できます。

元画像と任意のマスクを使用して、周囲の構図を維持しながら選択した領域を編集します。クリエイティブチームは、素材制作中に被写体のレタッチ、オブジェクトの削除、背景の置き換え、個別要素の調整を行えます。

複雑なブリーフを、プロンプトへの高い忠実度を保ちながら、写実的、イラスト風、またはスタイライズされたビジュアルの方向性へと落とし込みます。ゲームスタジオ、出版社、クリエイティブチームは、制作リソースを投入する前に、キャラクター、環境、物語の場面、ムードボードを検討できます。

世界知識、テキスト描画、詳細な指示を組み合わせて、図解、イラスト付きガイド、インフォグラフィックを作成します。教育関係者、出版社、プロダクトチームは、説明内容を授業、ドキュメント、オンボーディング向けの親しみやすいビジュアル教材へと変換できます。
異なるプロバイダーのモデルを比較 — パフォーマンス、料金、独自の強みを確認して最適な選択を。
| モデル | 参照画像上限 | 出力数 | 解像度 | アスペクト比 |
|---|---|---|---|---|
| GPT Image-1 | 4 | 1~10 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| GPT Image-1.5 | 10 | 1 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| GPT Image-1 Mini | 4 | 1~10 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| Nano Banana 2 | 14 | 1 | 4K, 2K, 1K | 1:1 3:2 2:3 3:4 4:3 4:5 5:4 9:16 16:9 21:9 |
| Seedream 5.0 | 14 | 1~15 | 2K~4K+ | 1:1 3:2 2:3 3:4 4:3 4:5 5:4 9:16 16:9 21:9 |
数分で始められます — 以下の簡単なステップに従って、Atlas Cloud プラットフォームでモデルを統合・デプロイしましょう。
atlascloud.ai でサインアップし、認証を完了します。新規ユーザーには無料クレジットが付与され、プラットフォームの探索やモデルのテストに使用できます。
高度なGPT ImageモデルとAtlas CloudのGPU加速プラットフォームを組み合わせることで、比類のないパフォーマンス、スケーラビリティ、開発者エクスペリエンスを提供。
低レイテンシ:
リアルタイム推論のためのGPU最適化推論。
統合API:
1つの統合でGPT Image、GPT、Gemini、DeepSeekを実行。
透明な料金:
サーバーレスオプション付きの予測可能なtoken単位の課金。
開発者エクスペリエンス:
SDK、分析、ファインチューニングツール、テンプレート。
信頼性:
99.99%の稼働率、RBAC、コンプライアンス対応ロギング。
セキュリティとコンプライアンス:
SOC 2 Type II、HIPAA準拠、米国内のデータ主権。
GPT Image 1 は、画像の生成と編集に対応した OpenAI のネイティブなマルチモーダルモデルです。テキストと画像を入力として受け取り、画像を出力します。Atlas Cloud では、テキストから画像を生成するための REST エンドポイントと、画像を編集するための REST エンドポイントを個別に提供しています。
GPT Image 1 は初代のフルモデル、GPT Image 1.5 は後発のフルサイズ改良版、Mini は低コストと高スループットを優先したモデルです。品質、レイテンシー、指示追従性はワークロードによって異なるため、各階層で代表的なプロンプトや編集結果を比較してください。新規の統合では、OpenAI は現在 GPT Image 2 への移行を推奨しています。
生成する場合は、openai/gpt-image-1/text-to-image にプロンプトを送信します。編集する場合は、プロンプトと必要な元画像を指定して openai/gpt-image-1/edit を呼び出します。Atlas Cloud API の認証情報は、ブラウザやモバイルコードに公開せず、サーバー上で管理してください。
対応サイズは 1024x1024、1024x1536、1536x1024、auto です。品質は low、medium、high、auto から選択でき、出力形式は PNG、JPEG、WebP に対応しています。透過出力には PNG または WebP を使用し、background パラメータを transparent に設定する必要があります。
編集対象を選択した領域だけに限定する場合はマスクを使用します。一方、入力忠実度は、元画像のディテールをモデルがどの程度維持するかを制御します。元画像とマスクは同じ形式・寸法で、50 MB 未満である必要があり、マスクにはアルファチャンネルが含まれていなければなりません。入力忠実度を high にすると元画像のディテールをより多く保持できますが、より多くの画像入力トークンを消費します。
確認済みの Atlas Cloud の標準基本料金は、テキストから画像を生成するモデルと編集モデルのどちらも、1 画像あたり $0.011 です。これは通常料金であり、一時的な割引は含まれていません。
ChatGPT と直接呼び出す画像エンドポイントは異なる製品ワークフローであるため、同一のプロンプト文でも同じ結果になるとは限りません。ChatGPT は会話のコンテキストを取り入れる場合がありますが、API リクエストはその呼び出しで指定されたプロンプトとパラメータに従います。一貫性が重要な場合は、サイズと品質の設定を固定し、制約を明示したうえで、複数の出力を評価してください。
正確なテキスト配置、繰り返し登場するキャラクターの一貫性、厳密なレイアウト制御には、再試行や追加編集が必要になる場合があります。プロンプトと生成画像はコンテンツモデレーションの対象であり、ブロックされたリクエストは、プロンプトまたは入力を変更せずに再試行しないでください。一時的なレート制限やサーバーエラーの場合は、リクエスト ID を記録し、バックオフを適用して再試行してください。
はい。OpenAI は GPT Image 1 を 2026 年 10 月 23 日に、GPT Image 1.5 と GPT Image 1 Mini を 2026 年 12 月 1 日に終了する予定です。OpenAI は後継として GPT Image 2 を推奨しているため、新しい本番ワークフローをデプロイする前に、移行時の動作を検証してください。
Seedance 2.5 APIがAtlas Cloudで利用可能になりました!これにより、開発者はByteDanceの最新の動画モデルを利用できます。テキスト、単一の画像、または最大50のマルチモーダルな参照から、同期されたオーディオとフレーム内の多言語テキストを含む最大30秒のネイティブ動画をシングルパスで生成します。Atlas Cloudでは1つのキーでアクセスでき、被写体の一貫性と改善された物理演算により、ロングショットの整合性が保たれます。

Wan 3.0 APIは、AlibabaのWanビデオファミリーの次世代モデルであり、長尺動画生成、マルチリファレンス制御、およびオーディオビジュアル品質を新たな高みへと押し上げるために構築されました。Atlas CloudはすでにWan 2.7、2.6、2.5をホストしており、Wan 3.0は追加のセットアップなしで同じ統合キーで実行されます。今日から開発を始めましょう。Wan 3.0で何を作成できるかを確認するには、下のショーケースまでスクロールしてください。
MiniMax H3は、テキスト、画像、リファレンスによる生成に対応したMiniMaxのマルチモーダル動画ファミリーです。対応するルート全体で参照メディアの被写体を保持し、柔軟なアスペクト比を提供します。また、H3 Developerを通じて生成音声と映像を組み合わせ、出力プロファイルはエンドポイントごとに選択されます。Atlas Cloudは、1つのOpenAI互換キーのもとでこのファミリーを統合し、標準料金である1秒あたり$0.038からの明瞭な従量課金制を提供します。今すぐ開発を始めましょう。
OpenAIのgpt-image-2.5ファミリーでは、本番の画像ワークフロー向けにFlareとSunburstを選択できます。最大3840x2160までの任意の解像度でレンダリングし、xhighやmaxを含む5段階の品質ティアから、具体的な出力要件に合ったものを選択できます。Atlas Cloudでは、コールドスタートなしですぐに使えるREST推論を、生成1回あたり$0.004からの標準料金で提供しています。今すぐ開発を始めましょう。
Seedream 5.0 Pro API は、開発者に Atlas Cloud 上で ByteDance の制御可能な画像編集モデルを提供します。アンカーと座標を使用して編集を正確に配置し、画像を編集可能なレイヤーに分離し、複数の参照を融合し、正確な色と素材を一致させ、2K および 3K での多言語テキストをサポートします。Atlas Cloud では、単一のキーでアクセスできます!
Seedance 2.0は、正確なショット作成に対応したByteDanceの本番向け動画モデルです。プロンプトから動画を生成したり、オプションの最終フレームガイダンスを使って先頭フレームの画像をアニメーション化したり、参照メディアとオプションのウェブ検索で結果を形作ったりできます。Atlas Cloudは、これらのワークフローを透明性の高い従量課金と1つのOpenAI互換キーで、統合されたAPIにまとめます。今すぐ開発を始めましょう。
Kling 3.0 APIは、OpenAI互換の1つのキーを通じて、Kuaishouの旗艦ビデオスイートをAtlas Cloudにもたらします。これには2つのモデルが含まれます。AI Directorによるストーリーテリング、多言語のリップシンク、正確なオンスクリーンテキスト用のKling 3.0と、短い動画や画像からの被写体および音声クローニング用のKling 3.0 Omni(O3)です。どちらも同じパスでネイティブオーディオを生成し、最大4Kの出力に対応しています。信頼性の高いインフラストラクチャ上で、映画のような物語、グローバルマーケティング、多言語広告、連続したキャラクターコンテンツを構築します。
Grok Imagine Video は、開発者が xAI の動画ファミリーにアクセスし、クリップの作成、アニメーション化、拡張、編集を行えるようにします。プロンプトから 1~15 秒の動画を生成し、最大 7 枚の参照画像を使って人物、オブジェクト、スタイルを指定できます。また、480p または 720p で利用できます。Atlas Cloud は、透明性の高い従量課金制の料金体系と OpenAI 互換エンドポイントを通じて、これらの機能を一つにまとめます。今すぐ開発を始めましょう。
Vidu Q4は、画像から動画およびリファレンスから動画を生成するために設計された、Viduの最新フラッグシップ動画モデルです。1枚の静止画をアニメーション化し、シーン間のトランジションを自動で作成できるため、さまざまなプロダクトワークフローに対応する2つの入力パスを開発者に提供します。Atlas Cloudでは、公開済みのパラメータスキーマを備えた専用APIエンドポイントを、確認済みの標準価格である1秒あたり$0.04で利用できます。今すぐ開発を始めましょう。
Gemini Omni 1.1 Flashは、柔軟な制作ワークフローに対応するGoogle DeepMindのネイティブマルチモーダル動画ファミリーです。テキスト指示で既存の映像を編集したり、最大10枚の参照画像と3本の動画クリップでビジュアルの一貫性を維持したり、ショットを連結可能なセグメントとして拡張して最大40秒の映像を作成したりできます。OpenAI互換APIキー1つで、Atlas Cloud上のすべてのワークフローにアクセスできます。従量課金制で、Day-0から利用可能です。今すぐ開発を始めましょう。
Nano Banana 2.1は、Gemini 3.6 Flashを基盤にGoogleが構築した画像モデルファミリーです。Flashレベルの速度でProレベルの生成・編集を実現し、1〜14枚の入力画像をまたいだ自然言語による編集や合成に対応しています。また、最大4人のキャラクターと10個のオブジェクトの一貫性を維持できます。Atlas Cloudを通じて、開発者は1つのOpenAI互換キーでこのモデルファミリーにアクセスでき、安定した稼働率とDay-0での利用開始が可能です。今すぐ開発を始めましょう。
Google の Gemini 3.1 Flash Image モデルを搭載した Nano Banana 2 API で構築しましょう。生成と編集の両方で最大14枚の参照画像にわたり、正確なテキストレンダリングと一貫したキャラクターを維持しながら、最大 4096x2304 のネイティブ 4K ビジュアルを生成します。Atlas Cloud では、300以上のモデルとともに1つの統合 API を通じてアクセスでき、料金は画像1枚あたり0.04ドルから、99.99%の稼働率、そして開始用の無料クレジットが提供されます。
Atlas Cloud を最大限に活用するためのガイド、チュートリアル、製品アップデート。


