
 Atlas Cloud は Dreamina Seedance 2.5 および Seedream 5.0 Pro の米国認定リセラーになりました。Atlas Cloud は Dreamina Seedance 2.5 および Seedream 5.0 Pro の米国認定リセラーになりました。
Gemini Omniは、Google DeepMindによるネイティブなマルチモーダル動画ファミリーです。プロンプトによる生成・編集に対応し、テキストからの生成、静止画のアニメーション化、任意のビジュアルリファレンスを使った既存映像の編集を、変更していない部分を保持しながら行えます。解像度、アスペクト比、動画の長さを柔軟に設定でき、さまざまな制作ワークフローに対応します。Atlas Cloudは、透明性の高い従量課金でアクセスを一元化します。今日から開発を始めましょう。
Gemini Omni Flash は Google が開発したモデルです。Atlas Cloud(運営:Atlas Cloud AI LLC)は本モデルへのアクセスを提供するものであり、その所有者ではありません。すべての商標は各所有者に帰属します。
Atlas Cloudは、業界をリードする最新のクリエイティブモデルを提供します。
7つの専門的なビデオエンドポイントを対象に、Gemini Omniの入力ルート、出力機能、プロダクションでの用途を比較します。
| モダリティ | 説明 |
|---|---|
| Gemini Omni Flash R2V API (Reference To Video) | テキストプロンプトと1〜5枚の参照画像を組み合わせ、ネイティブサウンド付きのシネマティックなビデオを生成します。被写体、シーン、スタイルの一貫性を保てるため、ブランド向けシーケンス、繰り返し登場するキャラクター、連続性のあるビジュアルストーリーテリングに適しています。 |
| Gemini Omni Flash I2V API (Image To Video) | 静止画像とテキストプロンプトを起点に、元の被写体と構図を維持したシネマティックでサウンド対応のビデオを作成します。プロダクトアニメーション、ポートレートのモーション化、ビジュアルコンセプトの開発に適しています。 |
| Gemini Omni Flash Video Edit API | 既存のビデオ、テキスト指示、必要に応じて参照画像を入力し、ネイティブオーディオ付きでシーンの一貫性を保った変更を適用します。変更しない映像は保持されるため、シーン全体を再構成せずに、対象を絞った修正を行えます。 |
| Gemini Omni Flash T2V API (Text To Video) | テキストプロンプトだけで、同期したネイティブオーディオと現実世界の物理法則に基づくモーションを備えたシネマティックなビデオを生成します。制御しやすい高速生成により、コンセプトの可視化、ストーリー開発、迅速なビデオプロトタイピングを支援します。 |
| Gemini Omni Flash R2V Developer API | 既存のビデオクリップに参照画像とテキストプロンプトを組み合わせ、意図に沿った変換を行います。ビデオのスタイル転送、シーン編集、キャラクター挿入に対応し、提供された映像から方向性のあるバリエーションを生成するクリエイティブ用途に利用できます。 |
| Gemini Omni Flash I2V Developer API | 最大7枚の参照画像でテキストプロンプトによるビデオ生成を誘導し、結果全体を通してビジュアルアイデンティティを維持します。繰り返し登場するキャラクター、一貫したプロダクト画像、キャンペーン全体で統一感のあるアセットが必要な場合に適しています。 |
| Gemini Omni Flash T2V Developer API | テキストプロンプトに加えて、必要な解像度、アスペクト比、長さを指定し、制御可能なシネマティックビデオを生成します。柔軟な出力設定により、開発者はプラットフォームに適したコンテンツの作成、生成ワークフローの自動化、複数のクリエイティブ方針の検証を行えます。 |
Gemini Omni Flash APIへのすべてのリクエストで、テキスト、画像、動画、音声を自由に組み合わせて入力でき、映像と同期したサウンドを生成し、現実世界の物理法則を再現し、会話を通じて結果を洗練できます。
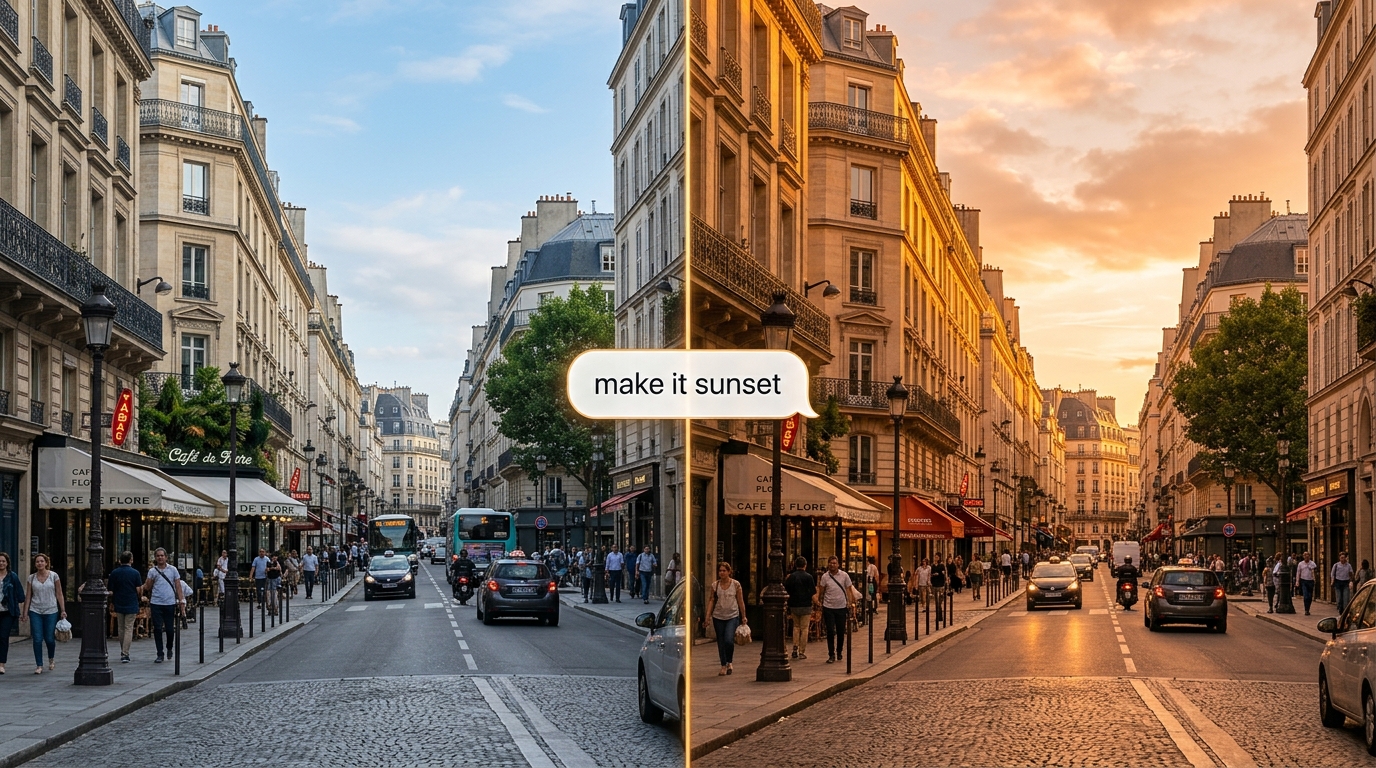
自然言語でクリップを調整すると、Gemini Omni Flash APIがシーンの他の部分を維持したまま変更を適用します。ステートフルなInteractions APIが各ターンを記憶するため、編集を積み重ねていけます。
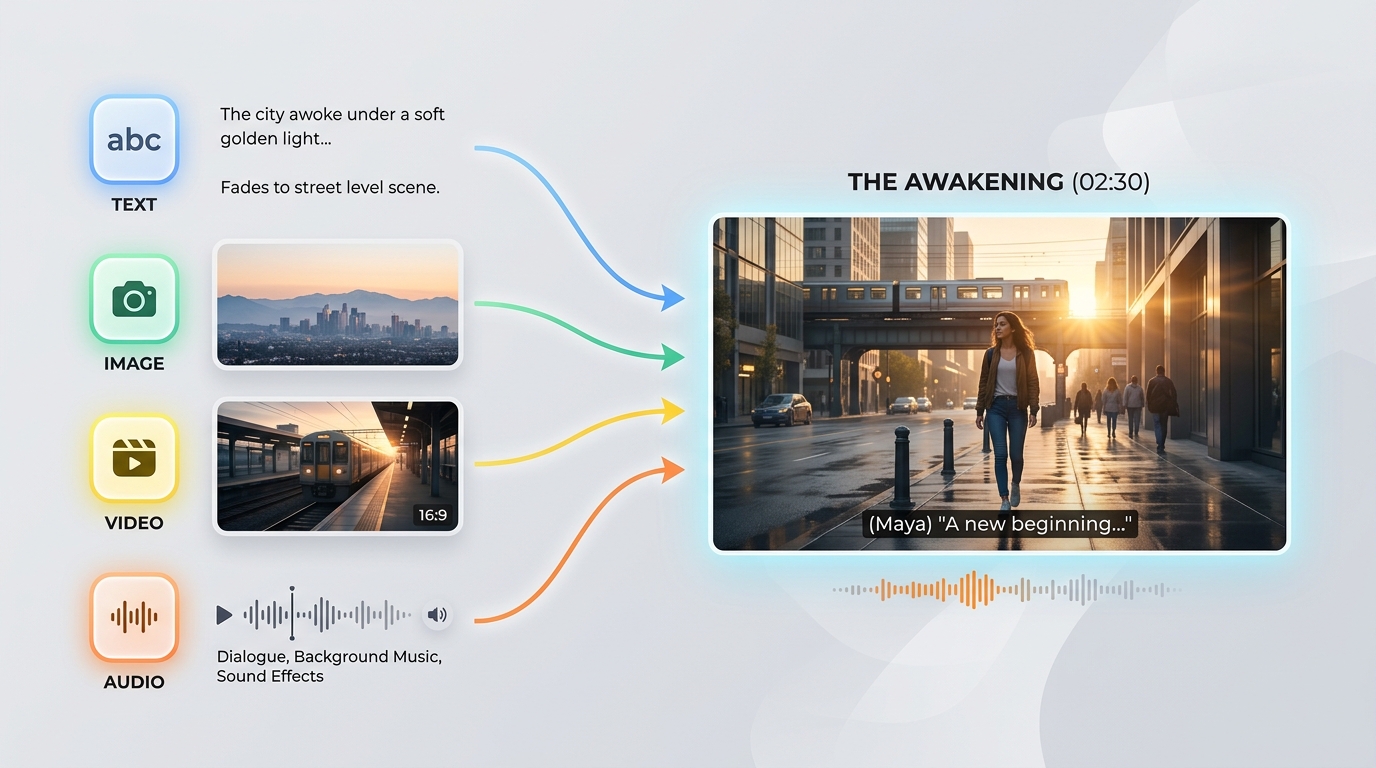
Gemini Omni Flash APIは、1つのプロンプト内でテキスト、画像、動画、音声を自由に組み合わせて受け付けます。あらゆる素材からあらゆるものを生み出せるため、手元にある素材を使って生成を始められます。
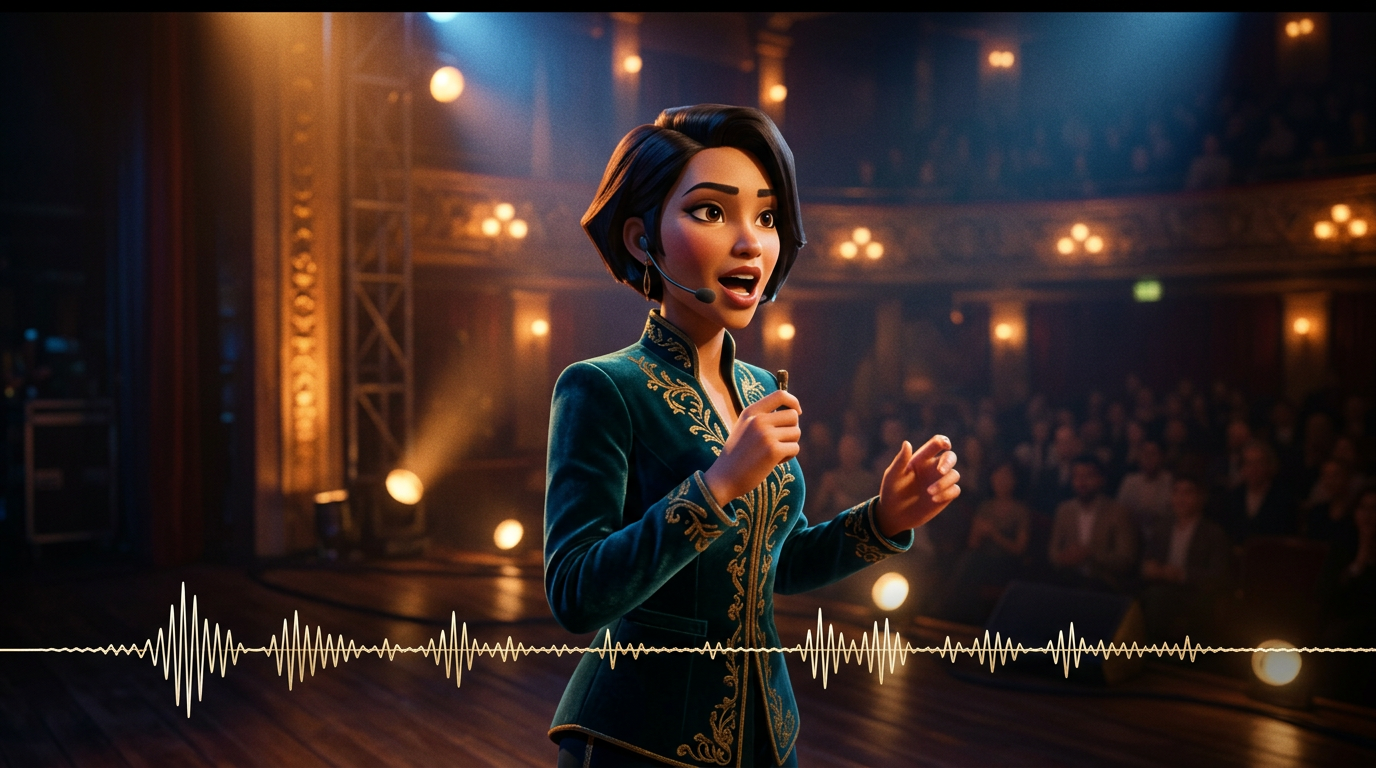
音声は映像と同じ推論処理で生成されるため、セリフ、効果音、環境音がアクションと常に同期します。Gemini Omni Flash APIでは、後から別途音声処理を行う必要がありません。
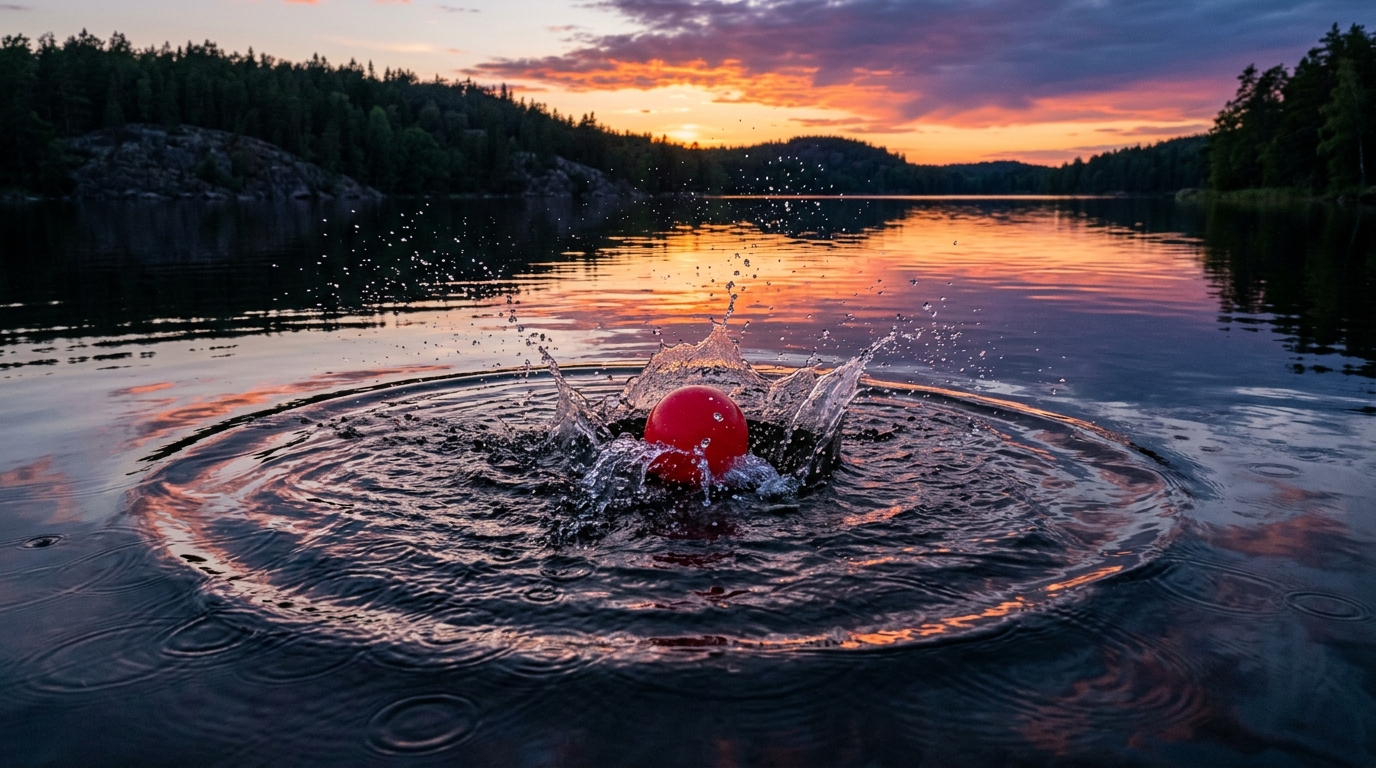
現実世界の物理法則をモデル化しているため、Gemini Omni Flash APIは説得力のある反射、重力、照明、天候を描画します。動きのあるショットでも、アーティファクトに崩れることなく、シーン全体の視覚的な整合性が保たれます。
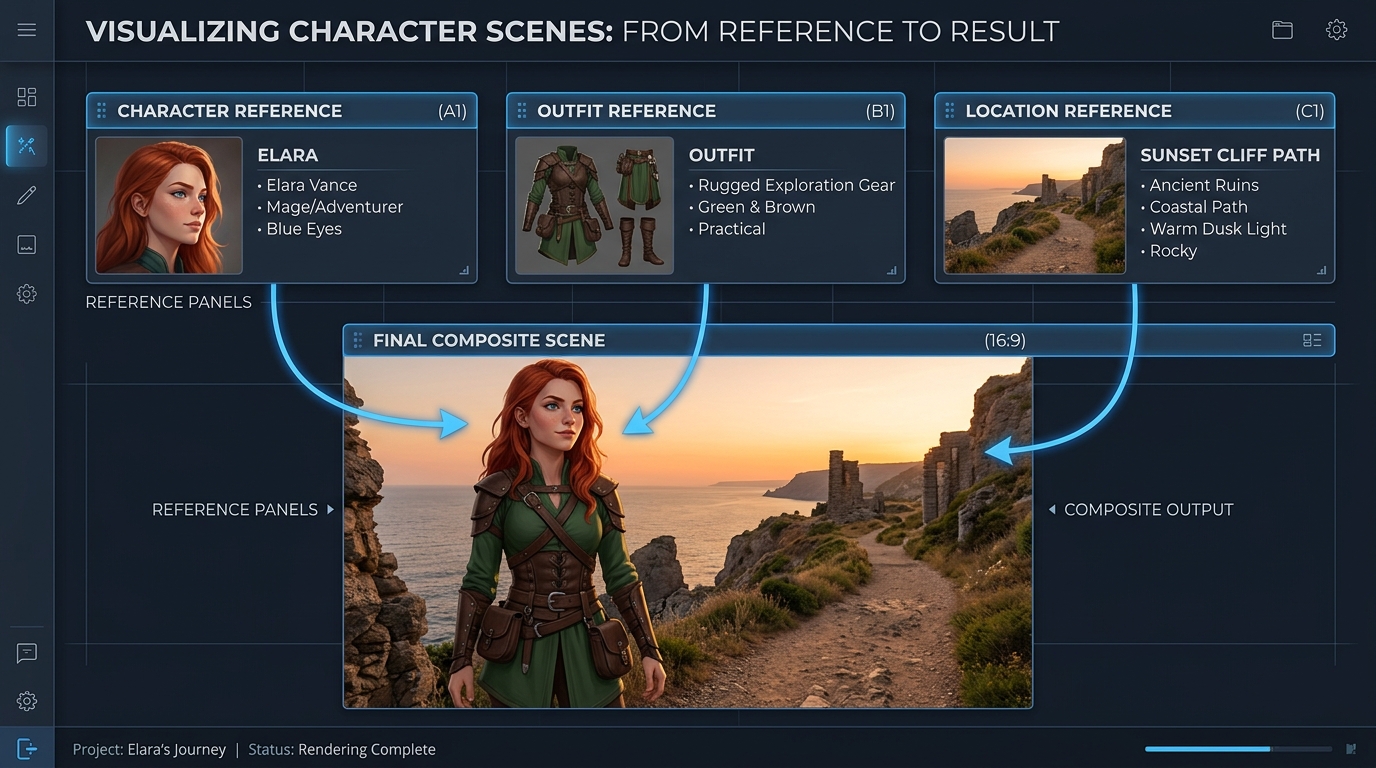
最大7枚の参照画像と3本の短い動画クリップを使って生成を導くと、Gemini Omni Flash APIが被写体、スタイル、シーンの一貫性を保ちます。編集やショットをまたいでも、同一性を安定して維持できます。
同じプロンプトを Gemini Omni とその他の主要な動画モデルで生成:マルチショットとハイエンドな商用映画
3シーン構成の連続動画を生成してください: シーン1: 女性が東京の雨に濡れた通りで、ネオンライトの下に立っています。濡れた地面に反射が映り、映画的な被写界深度と手持ちカメラの動きを表現してください。 シーン2: カメラがゆっくりと、より近いショットへ移行します。女性は入力された音声と完全に同期して、優しく話します。リップシンクは完璧に一致させてください。背景の交通も途切れることなく続きます。 シーン3: 女性が地下鉄駅に入ります。照明、天候、雰囲気の一貫性を維持してください。カメラは女性を後ろから追い、人物の同一性を保ちます。 制約: - すべてのシーンで顔の同一性を完全に維持する - 照明の連続性(雨、ネオンの反射)を保持する - 物理的なリアリティ(雨との相互作用、濡れた表面)を確保する - 音声入力との音声・映像同期を確保する - トランジション間でシーンをリセットせず、連続したワールドの状態を維持する スタイル: ハイエンドな映画的リアリズム、フィルムグレイン、アナモルフィックレンズ、浅い被写界深度、4Kフィルムルック
Gemini Omni
Wan 2.7
Kling v3.0
4シーン構成の連続動画を生成してください: シーン1: 小さな白いロボットが、深夜の薄暗いアパートの木製デスクの上に静止しています。窓から月明かりが差し込んでいます。ロボットの目がゆっくりと点灯し、かすかな機械音が鳴り始めます。 シーン2: ロボットが慎重にデスクから降ります。小さな金属製の足が木製の床に触れるたび、柔らかなクリック音がします。カメラは低いアングルから追い、ロボットの大きさと形状を一貫して保ちます。 シーン3: ロボットがキッチンへ歩いて入ります。冷蔵庫の扉とタイル張りの床からの反射が、ロボットの動きに自然に反応します。前のシーンから同じ月明かりと静かな夜の雰囲気が続きます。 シーン4: ロボットが窓の近くで立ち止まり、外の街の明かりを見つめます。カメラは後方からゆっくりと寄り、ロボットの同一性、素材、スケール、照明、音の連続性を維持します。 要件: - すべてのシーンでまったく同じロボットデザインを維持する - シーンをリセットせず、1つの連続したアパートのレイアウトを保持する - 部屋から部屋へ移動しても照明を一貫させる - 足音と機械音をロボットの動きに同期させる - 物理的にリアルな反射、影、物体同士の相互作用を使用する - 1つの連続した世界を撮影しているかのように、シーン間を滑らかにつなぐ スタイル: 映画的なリアリズム、静かな SF の雰囲気、柔らかな月明かり、精細な素材表現、リアルなカメラワーク、浅い被写界深度、ハイエンドな商用映画のルック
Gemini Omni
Kling V3.0
Pixverse v6
Gemini Omniは、テキスト、画像、リファレンス、動画編集のワークフローを通じて、キャンペーン制作、対話による修正、プレビジュアライゼーション、ビジュアル学習、ブランドの一貫性維持、クリエイターツールの組み込みを、同期されたネイティブ音声とともに実現します。

承認済みの製品静止画を、被写体と構図を維持したままシネマティックなモーションへ変換します。マーケティングチームは、同期されたネイティブ音声付きで、ローンチティザー、ソーシャル広告、洗練された製品紹介映像を制作できます。

変更内容を具体的に指示すると、Gemini Omniは未変更のコンテンツを維持したまま既存の映像を編集します。編集者は、承認済みのシーンを再構築することなく、別バージョンの演出、ローカライズ版、クライアント向け修正版を作成できます。

リファレンス画像を使って生成を誘導し、クリップ全体で製品、キャラクター、ビジュアルスタイルの一貫性を保ちます。スタジオは、連携したキャンペーン素材、継続的に展開されるブランド世界観、各チャネルで認識されやすいエピソード型コンテンツを開発できます。

テキストプロンプトから始めて、同期された音声と、現実世界の物理法則に基づくモーションを備えたシネマティックな動画を生成します。ディレクターやデザイナーは、制作前にストーリービート、カメラのアイデア、プラットフォーム別のフォーマットを検討できます。

シーン、アクション、意図した学習の流れを記述して、抽象的な概念を短いビジュアル解説へ変換します。教育チームは、ネイティブサウンド付きで、科学実験のデモ、手順の解説、トレーニングモジュールを作成できます。

テキスト生成、静止画のアニメーション化、リファレンスに基づく制作、動画編集を、1つのGemini Omni統合のもとで組み合わせます。クリエイタープラットフォームは、映像と音声のパイプラインを個別に構築することなく、連携した制作ツールを提供できます。
Gemini Omni APIのリファレンス動画モデル(Gemini Omni 1.1 Flashを含む)を、対応入力、リファレンス容量、音声生成、標準価格の観点から主要な代替モデルと比較します。
| モデル | 対応入力 | リファレンス容量 | 音声生成 | 標準価格 | Standard Base Price |
|---|---|---|---|---|---|
| Gemini Omni 1.1 Flash Reference-to-Video | Text, source video, reference images | Conversational additions, removals, replacements, and restyling | 360p, 720p, upscaled 1080p, upscaled 4K | Native synchronized audio | $0.041 |
| Gemini Omni Flash Reference-to-Video | Text, source video, up to 5 reference images | Scene-consistent edits that preserve untouched footage | 720p | Native audio editing | $0.14 |
| Seedance 2.0 Reference-to-Video | Text, source video, up to 5 reference images | Instruction-guided video changes with visual references | 720p, 1080p | Automatic audio or original audio retention | $0.14 |
| Wan-2.7 Reference-to-video | Text, source video, reference images, optional driving audio | Style transfer, scene changes, and element replacement | 720p, 1080p | Original audio retention, regeneration, or driving audio | $0.10 |
数分で始められます — 以下の簡単なステップに従って、Atlas Cloud プラットフォームでモデルを統合・デプロイしましょう。
atlascloud.ai でサインアップし、認証を完了します。新規ユーザーには無料クレジットが付与され、プラットフォームの探索やモデルのテストに使用できます。
高度なGemini Omni FlashモデルとAtlas CloudのGPU加速プラットフォームを組み合わせることで、比類のないパフォーマンス、スケーラビリティ、開発者エクスペリエンスを提供。
低レイテンシ:
リアルタイム推論のためのGPU最適化推論。
統合API:
1つの統合でGemini Omni Flash、GPT、Gemini、DeepSeekを実行。
透明な料金:
サーバーレスオプション付きの予測可能なtoken単位の課金。
開発者エクスペリエンス:
SDK、分析、ファインチューニングツール、テンプレート。
信頼性:
99.99%の稼働率、RBAC、コンプライアンス対応ロギング。
セキュリティとコンプライアンス:
SOC 2 Type II、HIPAA準拠、米国内のデータ主権。
Gemini Omni API を利用すると、Atlas Cloud を通じて、Google DeepMind のネイティブマルチモーダル動画生成・編集ファミリーに開発者がアクセスできます。選択したエンドポイントに応じて、テキストや画像からの動画生成、参照メディアの利用、既存映像の編集、同期されたネイティブ音声の生成が可能です。
Gemini Omni 1.1 Flash では、動画の延長、最初と最後のフレーム間の補間、360p から 4K までの出力解像度、拡張された参照ガイダンスが追加されました。動画延長のバリアントでは、1回のリクエストにつき 3〜10 秒を追加でき、連結することで最長 40 秒の一貫した動画を作成できます。
Atlas Cloud アカウントを作成し、API キーはサーバー上で安全に管理したうえで、ワークフローに合ったモデルエンドポイントを選択してください。Atlas Cloud では OpenAI 互換のキーを1つ利用でき、各エンドポイントで公開されているスキーマに、必要なプロンプト、メディア入力、生成設定が定義されています。
プロンプトから始める場合は text to video、静止画をアニメーション化する場合は image to video、人物や物体の同一性・スタイルのガイダンスが重要な場合は reference to video を選択してください。既存映像を変更する場合は video edit を、シーンを継続する場合は Gemini Omni 1.1 Flash video extend エンドポイントを使用します。
参照数の上限はエンドポイントとモデルのバージョンによって異なります。Gemini Omni 1.1 Flash Reference to Video では、最大 10 枚の参照画像と 3 本の参照動画クリップを受け付けます。以前のエンドポイントでは上限が異なるため、メディアを送信する前に、選択したエンドポイントのスキーマを確認してください。
Gemini Omni 1.1 Flash は、24 FPS で 3〜10 秒の動画を生成でき、360p、720p、アップスケールされた 1080p、アップスケールされた 4K の解像度オプションに対応しています。対応アスペクト比は 16:9 と 9:16 ですが、利用できる制御項目は Atlas Cloud のエンドポイントによって異なる場合があります。
はい。video edit バリアントでは、テキスト指示に従って要素の追加、削除、置換、スタイル変更を行いながら、プロンプトで言及されていない映像は維持します。反復的に変更する場合は、対象を絞った指示と、選択したワークフローでサポートされるインタラクションコンテキストを使用してください。
シーンを継続するには、Gemini Omni 1.1 Flash video extend エンドポイントに既存のクリップを渡し、追加する 3〜10 秒を指定します。延長は合計 40 秒まで連結できます。一方、image to video バリアントでは、指定した最初と最後のフレーム間を補間できます。
Gemini Omni 1.1 Flash の Atlas Cloud 標準料金は、text to video、reference to video、動画編集、動画延長が 1 秒あたり $0.041、image to video が 1 秒あたり $0.043 です。以前の Gemini Omni Flash エンドポイントは、従量課金制でサブスクリプション不要、1 秒あたり $0.112 から利用できます。
生成されたすべての動画には、プログラムで検出できる不可視の SynthID ウォーターマークが含まれます。安全性フィルターはプロンプトと生成結果の両方に適用され、処理時間は再生時間、解像度、サービスの負荷によって変動します。専用の negative prompt、system instruction、temperature、top_p、stop sequence 制御には対応していないため、除外したい内容はメインプロンプトに記述してください。
Seedance 2.5 APIがAtlas Cloudで利用可能になりました!これにより、開発者はByteDanceの最新の動画モデルを利用できます。テキスト、単一の画像、または最大50のマルチモーダルな参照から、同期されたオーディオとフレーム内の多言語テキストを含む最大30秒のネイティブ動画をシングルパスで生成します。Atlas Cloudでは1つのキーでアクセスでき、被写体の一貫性と改善された物理演算により、ロングショットの整合性が保たれます。

Wan 3.0 APIは、AlibabaのWanビデオファミリーの次世代モデルであり、長尺動画生成、マルチリファレンス制御、およびオーディオビジュアル品質を新たな高みへと押し上げるために構築されました。Atlas CloudはすでにWan 2.7、2.6、2.5をホストしており、Wan 3.0は追加のセットアップなしで同じ統合キーで実行されます。今日から開発を始めましょう。Wan 3.0で何を作成できるかを確認するには、下のショーケースまでスクロールしてください。
MiniMax H3は、テキスト、画像、リファレンスによる生成に対応したMiniMaxのマルチモーダル動画ファミリーです。対応するルート全体で参照メディアの被写体を保持し、柔軟なアスペクト比を提供します。また、H3 Developerを通じて生成音声と映像を組み合わせ、出力プロファイルはエンドポイントごとに選択されます。Atlas Cloudは、1つのOpenAI互換キーのもとでこのファミリーを統合し、標準料金である1秒あたり$0.038からの明瞭な従量課金制を提供します。今すぐ開発を始めましょう。
OpenAIのgpt-image-2.5ファミリーでは、本番の画像ワークフロー向けにFlareとSunburstを選択できます。最大3840x2160までの任意の解像度でレンダリングし、xhighやmaxを含む5段階の品質ティアから、具体的な出力要件に合ったものを選択できます。Atlas Cloudでは、コールドスタートなしですぐに使えるREST推論を、生成1回あたり$0.004からの標準料金で提供しています。今すぐ開発を始めましょう。
Seedream 5.0 Pro API は、開発者に Atlas Cloud 上で ByteDance の制御可能な画像編集モデルを提供します。アンカーと座標を使用して編集を正確に配置し、画像を編集可能なレイヤーに分離し、複数の参照を融合し、正確な色と素材を一致させ、2K および 3K での多言語テキストをサポートします。Atlas Cloud では、単一のキーでアクセスできます!
Seedance 2.0は、正確なショット作成に対応したByteDanceの本番向け動画モデルです。プロンプトから動画を生成したり、オプションの最終フレームガイダンスを使って先頭フレームの画像をアニメーション化したり、参照メディアとオプションのウェブ検索で結果を形作ったりできます。Atlas Cloudは、これらのワークフローを透明性の高い従量課金と1つのOpenAI互換キーで、統合されたAPIにまとめます。今すぐ開発を始めましょう。
Kling 3.0 APIは、OpenAI互換の1つのキーを通じて、Kuaishouの旗艦ビデオスイートをAtlas Cloudにもたらします。これには2つのモデルが含まれます。AI Directorによるストーリーテリング、多言語のリップシンク、正確なオンスクリーンテキスト用のKling 3.0と、短い動画や画像からの被写体および音声クローニング用のKling 3.0 Omni(O3)です。どちらも同じパスでネイティブオーディオを生成し、最大4Kの出力に対応しています。信頼性の高いインフラストラクチャ上で、映画のような物語、グローバルマーケティング、多言語広告、連続したキャラクターコンテンツを構築します。
Grok Imagine Video は、開発者が xAI の動画ファミリーにアクセスし、クリップの作成、アニメーション化、拡張、編集を行えるようにします。プロンプトから 1~15 秒の動画を生成し、最大 7 枚の参照画像を使って人物、オブジェクト、スタイルを指定できます。また、480p または 720p で利用できます。Atlas Cloud は、透明性の高い従量課金制の料金体系と OpenAI 互換エンドポイントを通じて、これらの機能を一つにまとめます。今すぐ開発を始めましょう。
Vidu Q4は、画像から動画およびリファレンスから動画を生成するために設計された、Viduの最新フラッグシップ動画モデルです。1枚の静止画をアニメーション化し、シーン間のトランジションを自動で作成できるため、さまざまなプロダクトワークフローに対応する2つの入力パスを開発者に提供します。Atlas Cloudでは、公開済みのパラメータスキーマを備えた専用APIエンドポイントを、確認済みの標準価格である1秒あたり$0.04で利用できます。今すぐ開発を始めましょう。
Gemini Omni 1.1 Flashは、柔軟な制作ワークフローに対応するGoogle DeepMindのネイティブマルチモーダル動画ファミリーです。テキスト指示で既存の映像を編集したり、最大10枚の参照画像と3本の動画クリップでビジュアルの一貫性を維持したり、ショットを連結可能なセグメントとして拡張して最大40秒の映像を作成したりできます。OpenAI互換APIキー1つで、Atlas Cloud上のすべてのワークフローにアクセスできます。従量課金制で、Day-0から利用可能です。今すぐ開発を始めましょう。
Nano Banana 2.1は、Gemini 3.6 Flashを基盤にGoogleが構築した画像モデルファミリーです。Flashレベルの速度でProレベルの生成・編集を実現し、1〜14枚の入力画像をまたいだ自然言語による編集や合成に対応しています。また、最大4人のキャラクターと10個のオブジェクトの一貫性を維持できます。Atlas Cloudを通じて、開発者は1つのOpenAI互換キーでこのモデルファミリーにアクセスでき、安定した稼働率とDay-0での利用開始が可能です。今すぐ開発を始めましょう。
Google の Gemini 3.1 Flash Image モデルを搭載した Nano Banana 2 API で構築しましょう。生成と編集の両方で最大14枚の参照画像にわたり、正確なテキストレンダリングと一貫したキャラクターを維持しながら、最大 4096x2304 のネイティブ 4K ビジュアルを生成します。Atlas Cloud では、300以上のモデルとともに1つの統合 API を通じてアクセスでき、料金は画像1枚あたり0.04ドルから、99.99%の稼働率、そして開始用の無料クレジットが提供されます。
Atlas Cloud を最大限に活用するためのガイド、チュートリアル、製品アップデート。


