
 A Atlas Cloud agora é revendedora autorizada nos EUA do Dreamina Seedance 2.5 e do Seedream 5.0 Pro.A Atlas Cloud agora é revendedora autorizada nos EUA do Dreamina Seedance 2.5 e do Seedream 5.0 Pro.

GPT 6 Astra é o modelo mais inteligente e alinhado da OpenAI, desenvolvido para uso de computadores, navegação na web, engenharia de software, cibersegurança, ciência e trabalho profissional exigentes. Sua capacidade de julgamento dá suporte a fluxos de trabalho complexos envolvendo código, pesquisa e ferramentas digitais. O Atlas Cloud disponibiliza Astra e Astra Codex por meio de uma única chave compatível com OpenAI, com tarifas padrão a partir de US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída. Comece a desenvolver hoje.
GPT 6 Astra foi desenvolvido pela OpenAI. A Atlas Cloud (operada pela Atlas Cloud AI LLC) fornece acesso ao modelo, mas não é sua proprietária. Todas as marcas registradas pertencem aos seus respectivos titulares.
Veja como cada endpoint do GPT 6 Astra oferece suporte a fluxos de trabalho de conversação, geração de conteúdo e experiências de IA personalizadas.
| Modalidade | Descrição |
|---|---|
| GPT 6 Astra API (Text) | O GPT 6 Astra processa prompts de texto e retorna texto gerado por meio de um perfil de modelo criativo e intuitivo. Escolha-o para conversas naturais, geração de conteúdo e experiências de IA personalizadas. |
| GPT 6 Astra Codex API (Text) | Para o endpoint GPT 6 Astra Codex, as solicitações de texto produzem respostas em texto usando o perfil criativo e intuitivo verificado. Ele é adequado para fluxos de trabalho de conversação, criação de conteúdo e experiências personalizadas que exigem um endpoint de modelo separado. |
O GPT 6 Astra oferece um contexto de 1,050,000 tokens, cinco níveis de raciocínio, compreensão de texto e imagens, recursos de uso do computador, dois endpoints de modelo Atlas e preços transparentes por faixas em uma única integração compatível com OpenAI.
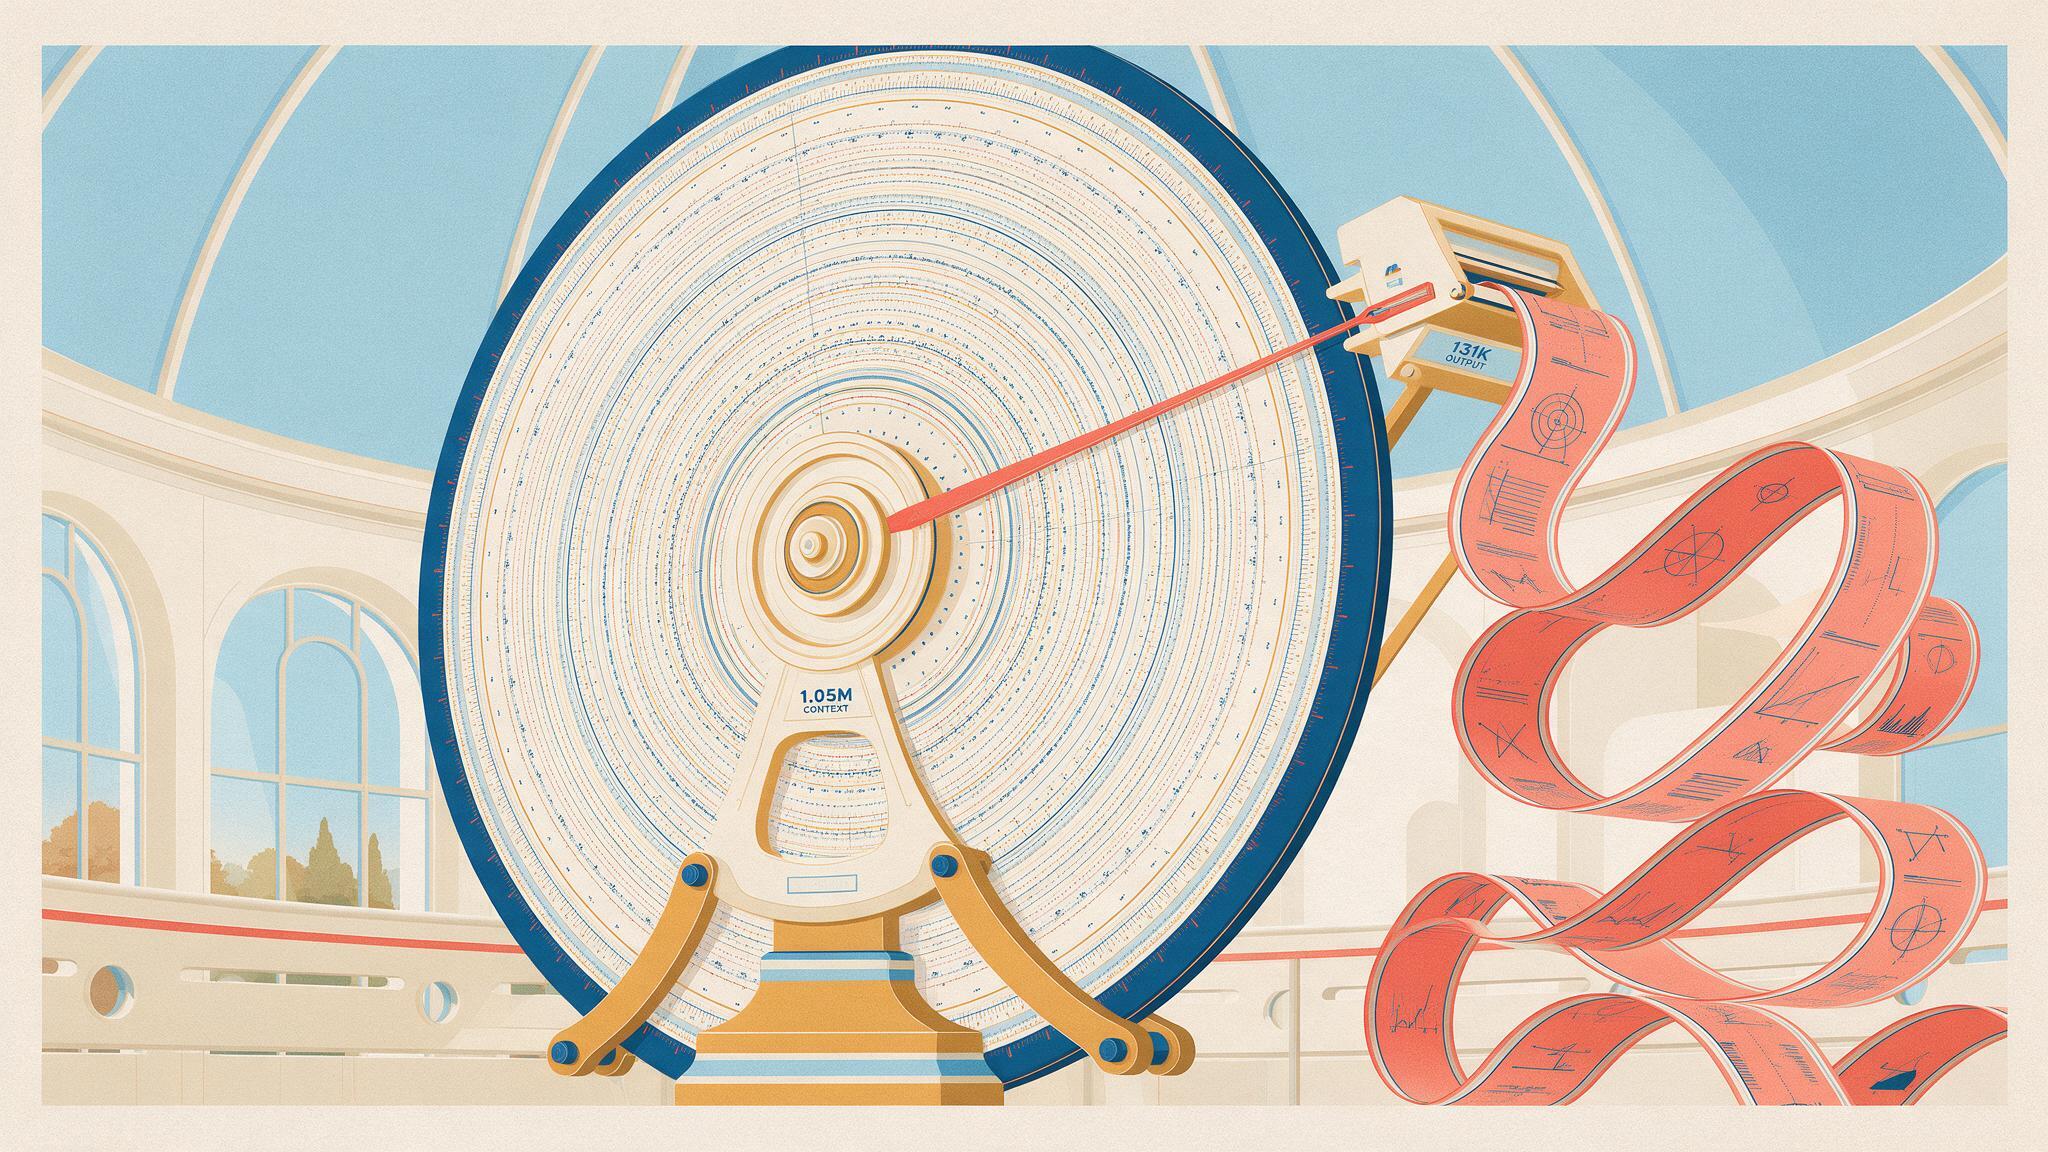
O GPT 6 Astra aceita até 1,050,000 tokens de contexto e pode retornar até 131,072 tokens de saída. Forneça repositórios extensos, coleções de pesquisas ou longos históricos de conversas em uma única solicitação. Essa janela de trabalho ampliada reduz a necessidade de fragmentar o material de origem em várias chamadas desconectadas, tornando-o ideal para revisões abrangentes, análises prolongadas e contextos complexos de projetos.
Cinco níveis de esforço de raciocínio permitem ajustar o grau de deliberação recebido por cada solicitação: baixo, médio, alto, xhigh e max. Escolha uma configuração mais leve para tarefas diretas e aumente o esforço quando o planejamento, a análise científica ou a depuração difícil exigirem uma consideração mais aprofundada. Esse controle no nível da solicitação ajuda as equipes a equilibrar velocidade de resposta, uso de tokens e profundidade da solução sem alterar os modelos.
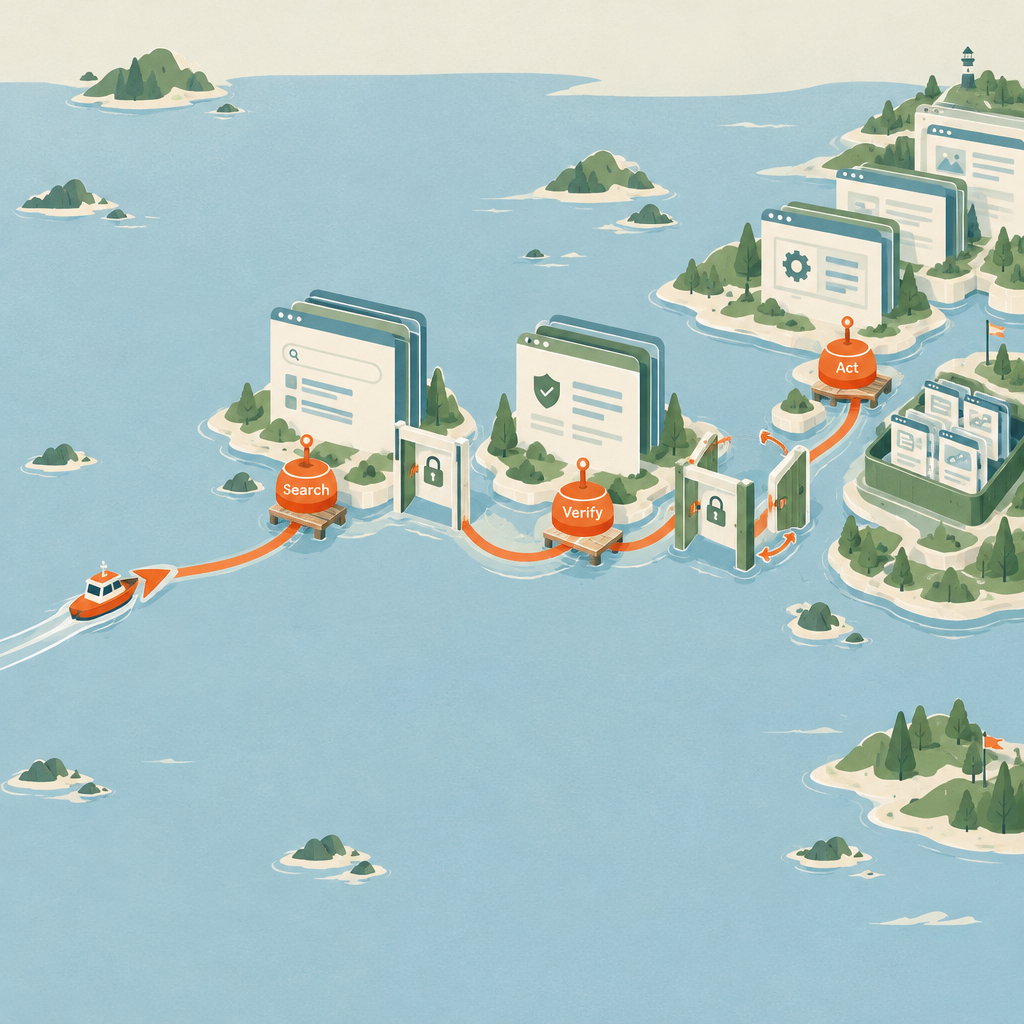
A OpenAI posiciona o Astra na vanguarda do uso do computador e da navegação. Quando sua aplicação fornece as ferramentas e permissões necessárias, o modelo pode interpretar o estado da interface, planejar ações em várias etapas e responder aos resultados ao longo de um fluxo de trabalho mais extenso. Essa combinação é adequada para pesquisas na web, assistência operacional e tarefas orientadas por software, nas quais o julgamento é tão importante quanto o próximo clique.
O Atlas Cloud disponibiliza openai/gpt-6-astra e openai/gpt-6-astra-codex por meio de uma única chave compatível com OpenAI. Cada modelo oferece uma janela de contexto de 1,050,000 tokens e até 131,072 tokens de saída, com os mesmos preços verificados por faixas. Alterne os IDs dos modelos conforme seu fluxo de trabalho muda, mantendo consistentes a integração e o processo de autenticação. Isso oferece às equipes uma forma prática de comparar as variantes geral e Codex dentro da mesma pilha.
As entradas de texto e imagem permitem que o Astra raciocine sobre textos, capturas de tela, diagramas e documentos visuais mistos, produzindo respostas em texto. Combine evidências visuais com instruções escritas para que o modelo relacione o que vê à tarefa descrita. Os desenvolvedores podem usar esse caminho de entrada combinado para revisão de documentos, análise de interfaces, interpretação de gráficos e outros fluxos de trabalho nos quais apenas o texto deixa de fora um contexto importante.
O Atlas Cloud utiliza preços transparentes por faixas e conforme o uso para ambas as variantes do Astra. Para prompts de até 272,000 tokens de entrada, as tarifas padrão são de $10 por milhão de tokens de entrada, $50 por milhão de tokens de saída, $12.50 para criação de cache e $1 para leituras do cache. Acima desse limite, as tarifas correspondentes são $20, $75, $25 e $2, ajudando os desenvolvedores a estimar os custos de contextos longos antes da implantação.
Compare como o GPT 6 Astra e duas alternativas líderes transformam prompts idênticos em experiências HTML refinadas e interativas.
Crie uma página da web HTML interativa completa, em um único arquivo, intitulada “Laboratório de Acidentes de Tipografia Midnight”. Exiba apenas o documento HTML finalizado, com todo o CSS e JavaScript incorporados. A página deve abrir e funcionar diretamente em um navegador moderno, sem dependências externas, CDNs, bibliotecas, fontes, links de imagens, arquivos SVG ou outros recursos. Esta é uma página responsiva, não uma imagem fixa em 16:9 nem uma composição em canvas; ela deve se adaptar naturalmente a telas desktop, tablet e mobile. Crie um simulador tátil de tipografia experimental no qual o usuário compõe uma impressão arrastando blocos individuais de tipos de chumbo para uma folha central, girando-os e reposicionando-os, e então ajustando a quantidade de tinta, a pressão da prensa e a umidade do papel antes de puxar uma enorme alavanca mecânica de impressão. O resultado impresso deve responder proceduralmente a esses parâmetros: excesso de tinta causa sangramento e obstrução dos contra-grafismos, pouca tinta cria bordas secas e quebradas, a pressão altera a indentação e a deformação, a umidade aumenta o espalhamento e os danos às fibras do papel, o posicionamento imperfeito dos tipos cria desalinhamento de registro e impressões repetidas produzem sombras deslocadas e imagens fantasma. Permita várias passagens de cor usando apenas vermelho vermelhão, azul ultramarino e amarelo ácido, com mistura realista de sobreposição, ordenação de camadas visível, visibilidade por camada, desfazer/refazer passo a passo e a possibilidade de levantar o canto do papel para revelar a impressão em evolução. Congele o drama visual principal no instante em que o rolo da prensa acabou de subir e a impressão finalizada está prestes a ser revelada. O papel central deve parecer um palco teatral. Organize blocos tipográficos, rolos de tinta, pinças, pinos de registro, retalhos, medidores e controles em um anel assimétrico ao seu redor. Use uma base de papel ósseo quase branco e cinza-chumbo, iluminada por uma lâmpada de trabalho branco-quente que incide diagonalmente a partir do canto superior esquerdo. Renderize tudo com CSS, elementos HTML, Canvas e texturas procedurais em um estilo físico de serigrafia bruta e colagem artesanal: bordas rasgadas, granulação fibrosa do papel, pigmento irregular, pontos de meio-tom, metal riscado, manchas de tinta, fragmentos de fita, leve perspectiva, registro imperfeito e sombras em camadas. Evite gradientes brilhantes, estilo SaaS estéril, cartões genéricos, cores neon cyberpunk, imagens fotorrealistas, emoji, ilustrações de banco de imagens e geometria vetorial perfeitamente limpa. Inclua um inventário substancial de tipos móveis com letras, pontuação, numerais e vários blocos decorativos. Os usuários devem poder arrastar blocos do inventário para a área de composição, selecionar vários blocos, girá-los usando alças ou atalhos de teclado, deslocá-los com as teclas de seta, excluí-los ou duplicá-los e editar o conteúdo textual sem perder a aparência física do bloco. Adicione guias de encaixe que possam ser ativadas ou desativadas, mas preserve pequenas irregularidades manuais. Forneça estados claros de foco ao passar o cursor, ativo, selecionado, desativado e foco de teclado. Suporte interação por ponteiro e toque, controles de teclado intuitivos, rótulos acessíveis e indicadores de foco visíveis. Crie três controles táteis para quantidade de tinta, pressão e umidade, cujos valores atualizem em tempo real a prévia do papel, a simulação de textura, os medidores, os rótulos de alerta e o comportamento ambiente da máquina. O sistema deve revelar estados de acidente lúdicos em combinações extremas, como explosões violentas de tinta, letras duplicadas, tipos deslocados, rachaduras irregulares nas fibras, trepidação do rolo e marcas de registro salpicadas, mantendo a composição legível. Adicione um registro compacto do experimento que grave cada impressão e seus parâmetros. Os usuários devem poder selecionar uma cor de passagem, pressionar a alavanca arrastando-a por um arco convincente, assistir a um ciclo de impressão curto, porém detalhado, e depois descascar o papel. A animação deve incluir resistência da alavanca, vibração da máquina, movimento do rolo, compressão do papel, partículas de poeira, leve oscilação da lâmpada e uma pausa de suspense antes da revelação. Respeite prefers-reduced-motion. Faça com que desfazer e refazer funcionem de verdade para posicionamento, rotação, alterações de parâmetros, impressão, passagens de cor e ações de revelação. Inclua controles de Reset, Random Accident, Re-ink, Add Pass, Undo e Redo, além de uma dica concisa de introdução que desapareça após a interação. Inicialize a página com um pôster parcialmente composto e intrigante para que a primeira visualização seja visualmente rica, mas permita que todos os elementos importantes continuem editáveis. Adicione feedback visual sutil semelhante a sons sem usar recursos de áudio. Garanta texturas procedurais determinísticas sempre que possível, para que desfazer restaure a mesma aparência. A experiência deve parecer cerimonial, artesanal, tensa e maliciosamente incontrolável, em vez de meramente decorativa. Priorize detalhes refinados de interação, acoplamento convincente entre parâmetros, artefatos de impressão procedurais em camadas, sincronização de animação bem trabalhada e uma composição responsiva excelente. Use HTML semântico e JavaScript vanilla limpo e bem estruturado. A resposta final deve conter apenas o documento HTML completo e executável.
Generated with GPT 6 Astra on Atlas Cloud
Generated with Gemini 3.1 Pro Preview on Atlas Cloud
Generated with GPT 5.6 Sol on Atlas Cloud
Crie uma página da web HTML interativa completa, refinada e em um único arquivo, intitulada “Teatro de Paisagem Sonora de Ramen à Meia-Noite”. Exiba apenas o documento HTML final, com todo o CSS e JavaScript incorporados. Ele deve funcionar diretamente em um navegador moderno, sem etapa de build e sem dependências externas, bibliotecas, fontes, imagens, arquivos de áudio, recursos CDN, solicitações de rede ou recursos vinculados. Crie uma cena expressiva ambientada em uma loja surreal de ramen à meia-noite. O objeto central é um único feixe contínuo de noodles elásticos, renderizado com Canvas, SVG ou uma combinação cuidadosamente integrada de ambos. O feixe de noodles deve atravessar diagonalmente o primeiro plano e parecer fisicamente tangível: os usuários podem agarrá-lo em qualquer ponto com o mouse ou toque, arrastá-lo, esticá-lo, chicoteá-lo, dobrá-lo sobre si mesmo e soltá-lo. Implemente uma física de mola convincente com inércia, amortecimento, gravidade, múltiplos segmentos conectados, resposta a colisões e movimento secundário visível. Mantenha a simulação estável mesmo durante arrastamentos agressivos, mudanças rápidas de direção, redimensionamento da janela ou interações repetidas. Organize pelo menos três tigelas distintas de ramen e vários ingredientes ao longo de um arco amplo pela composição, criando um ritmo visual marcante ao redor do noodle diagonal. Cada tigela deve ter seu próprio padrão ilustrado de caldo, identidade cromática, rótulo e personalidade sonora. Quando o noodle tocar ou cair em uma tigela, acione uma resposta audiovisual sincronizada: uma batida percussiva exclusiva sintetizada com a Web Audio API, uma explosão crescente de vapor, sprays de partículas verde-cebolinha, ondulações no caldo, pequenas gotas, tremulação do registro de serigrafia e onomatopeias animadas no estilo de caligrafia japonesa, como “ZURU!”, “PON!”, “JUU!” ou “BASHAN!”, criadas com texto estilizado em vez de fontes externas. A intensidade da colisão deve afetar o volume, o tom, a quantidade de partículas, o tamanho das ondulações, a escala das letras e a força da animação. O áudio deve começar somente após a primeira interação do usuário e incluir um controle claro de silenciar/ativar o som. O estado visual culminante deve evocar um quadro congelado em que o noodle está dramaticamente esticado no ar enquanto o caldo permanece suspenso pouco antes de espirrar. Dê suporte a isso com um controle “FREEZE THE SPLASH” e a tecla Space: ao entrar no modo de congelamento, aplique uma breve transição impactante, suspenda a cena física sem perder seu estado, enfatize as gotas no ar e a tensão do noodle esticado, exiba uma tipografia cinética marcante com aparência de pôster e preserve um brilho sutil procedural das linhas para que a página continue viva. Pressionar Space ou o controle novamente deve retomar a cena sem interrupções. Adicione um controle de reset, um indicador compacto do estado do som e uma leitura discreta ao vivo de “tempo/impacto” orientada pelas colisões recentes. Os controles de teclado devem ser descobríveis em um pequeno painel de ajuda integrado: Space alterna o congelamento, R redefine, M silencia e as teclas de seta aplicam impulsos direcionais ao noodle. Use uma combinação visual sofisticada de design de pôster vintage em serigrafia e animação procedural de linhas. Um fundo índigo profundo deve dominar a cena, interrompido pelo calor localizado do fogo do fogão ao redor das tigelas e dos pontos de colisão. Use cores especiais em camadas — vermelho vermelhão, amarelo gengibre, verde-cebolinha, creme quente e quase preto — com texturas de meio-tom, bordas de tinta ásperas, leve desalinhamento cromático, sombras gráficas marcantes e linhas de contorno animadas. O resultado deve parecer artesanal e teatral, em vez de brilhante ou fotorrealista. Inclua vapor ambiente sutil, brilho trêmulo do fogão, granulação flutuante e linhas em movimento, preservando forte contraste e controles legíveis. Evite o estilo cyberpunk neon genérico. Faça a composição ser responsiva em telas desktop largas, tablet e mobile; isto é uma página da web, portanto não force uma proporção fixa de 16:9. Adapte fluidamente o posicionamento das tigelas, a tipografia, os controles, os limites da simulação e as áreas de toque sem cortar conteúdo essencial. Use pointer events para unificar o tratamento de mouse, caneta e toque. Impeça a rolagem da página somente enquanto o noodle estiver sendo manipulado ativamente. Respeite prefers-reduced-motion reduzindo a animação ambiente, mas mantendo a interação principal funcional. Preserve um desempenho fluido por meio de reutilização eficiente de partículas ou limites rígidos de partículas, requestAnimationFrame, renderização consciente de device-pixel-ratio com um limite de resolução adequado e tratamento de coordenadas seguro durante o redimensionamento. Requisitos de conteúdo e acabamento: inclua um tratamento atmosférico para o título, um convite curto de uma linha à interação, três ou mais tigelas identificadas, várias coberturas visualmente distintas, palavras sonoras manuscritas contextuais, estados de controle refinados, estilos de foco claros, rótulos acessíveis para botões e uma dica discreta de interação que desapareça após o primeiro uso. A cena inicial já deve parecer um pôster colecionável finalizado antes de qualquer interação, enquanto o estado ativo deve se transformar em um brinquedo rítmico animado, com feedback em camadas e movimento emergente surpreendente. Restrições negativas: nenhum recurso ou dependência externa; nenhuma URL de imagem; nenhum áudio pré-gravado; nenhum framework; nenhum placeholder inacabado; nenhum comentário TODO; nenhum controle quebrado; nenhum canvas fixo em 16:9; nenhuma interface padrão simples; nenhum fundo baseado apenas em gradientes genéricos; nenhum emoji usado como arte principal; nenhum excesso de texto explicativo; nenhum áudio reproduzido automaticamente; nenhum crescimento descontrolado de partículas; nenhuma física frágil que exploda ou produza valores NaN; nenhuma interação que funcione somente com mouse; e nenhuma saída além do documento HTML completo e único.
Generated with GPT 6 Astra on Atlas Cloud
Generated with Gemini 3.1 Pro Preview on Atlas Cloud
Generated with GPT 5.6 Sol on Atlas Cloud
O GPT 6 Astra transforma raciocínio avançado, navegação na web, uso do computador, engenharia de software, análise multimodal e contexto longo em fluxos de trabalho práticos para desenvolvedores, pesquisadores, equipes de segurança e profissionais do conhecimento.

O GPT 6 Astra executa tarefas de uso do computador e navegação na web que exigem várias etapas coordenadas. Implante-o para operações baseadas no navegador, coleta de informações e fluxos de trabalho digitais nos quais um agente precisa passar da instrução à conclusão.

Em bases de código existentes, o GPT 6 Astra pode apoiar trabalhos complexos de engenharia de software. Os desenvolvedores podem usá-lo para inspecionar o contexto, depurar problemas, implementar alterações e revisar os resultados antes de integrá-los aos fluxos de trabalho de produção.

Transforme grandes coleções de fontes em pesquisas estruturadas com os recursos de navegação na web e contexto longo do GPT 6 Astra. Os analistas podem comparar evidências, preservar o contexto de todo o projeto e produzir conclusões claras para decisões bem fundamentadas.

Quando o trabalho de segurança exige um raciocínio cuidadoso, o GPT 6 Astra pode examinar código, configurações e evidências técnicas. Use suas conclusões para apoiar a revisão de vulnerabilidades, o planejamento de correções e transferências documentadas para as equipes de segurança.

Equipes científicas podem aplicar o GPT 6 Astra a análises exigentes que combinam texto, imagens e contexto extenso. Ele ajuda os pesquisadores a organizar observações, testar linhas de raciocínio e elaborar resultados para validação por especialistas.

Reúna documentos extensos, referências visuais e registros de projetos em um único fluxo de trabalho profissional. Com o GPT 6 Astra, as equipes podem conciliar materiais e preparar relatórios, briefings ou decisões preservando o contexto circundante.
Compare o GPT 6 Astra com os principais modelos multimodais disponíveis no Atlas Cloud quanto ao suporte de entrada, à capacidade de contexto, ao limite de saída e ao preço padrão por token.
| Modelo | Tipos de entrada | Janela de contexto | Saída máxima | Preço padrão por 1 milhão de tokens |
|---|---|---|---|---|
| GPT 6 Astra | Texto, Imagem | 1,050,000 tokens | 131,072 tokens | $10 de entrada / $50 de saída; para prompts acima de 272K: $20 de entrada / $75 de saída |
| GPT 6 Astra Codex | Texto, Imagem | 1,050,000 tokens | 131,072 tokens | $10 de entrada / $50 de saída; para prompts acima de 272K: $20 de entrada / $75 de saída |
| Gemini 3.1 Pro Preview | Texto, Imagem, Vídeo | 1,000,000 tokens | 64,000 tokens | $2 de entrada / $12 de saída; para prompts acima de 200K: $4 de entrada / $18 de saída |
| Grok 4.6 | Texto, Imagem | 500,000 tokens | 500,000 tokens | $2 de entrada / $6 de saída; para prompts acima de 200K: $4 de entrada / $12 de saída |
| Kimi K3 | Texto, Imagem, Vídeo | 1,048,576 tokens | 1,048,576 tokens | $3 de entrada / $15 de saída |
Comece em minutos — siga estes passos simples para integrar e implantar modelos pela plataforma da Atlas Cloud.
Cadastre-se em atlascloud.ai e conclua a verificação. Novos usuários recebem créditos gratuitos para explorar a plataforma e testar modelos.
Combine modelos avançados de GPT 6 Astra com a plataforma acelerada por GPU do Atlas Cloud, fornecendo desempenho, escalabilidade e experiência de desenvolvimento incomparáveis.
Baixa Latência:
Inferência otimizada por GPU para respostas em tempo real.
API Unificada:
Uma única integração para acessar GPT 6 Astra, GPT, Gemini e DeepSeek.
Preços Transparentes:
Faturamento por Token, suporta modo Serverless.
Experiência do Desenvolvedor:
SDK, análise de dados, ferramentas de ajuste fino e modelos tudo em um.
Confiabilidade:
99.99% de disponibilidade, controle de permissões RBAC, logs de conformidade.
Segurança e Conformidade:
Certificação SOC 2 Type II, conformidade HIPAA, soberania de dados nos EUA.
O GPT-6 Astra é o modelo de ponta da OpenAI para uso exigente de computadores, navegação, engenharia de software, cibersegurança, ciência e trabalho profissional. O Atlas Cloud oferece acesso baseado em uso ao GPT 6 Astra e ao GPT 6 Astra Codex por meio de uma única chave compatível com a OpenAI.
Projetado para trabalhos complexos, o Astra oferece suporte a raciocínio, programação, navegação, uso de computadores, pesquisa e análise de contextos longos. Ele aceita entradas de texto e imagem e produz texto para fluxos de trabalho de agentes, criação de documentos e outras tarefas profissionais exigentes.
Configure um cliente compatível com a OpenAI para usar o endpoint do Atlas Cloud, adicione sua chave de API do Atlas e selecione openai/gpt-6-astra ou openai/gpt-6-astra-codex. O Atlas Cloud disponibiliza essa família por meio do protocolo Chat Completions, permitindo manter estruturas familiares de solicitação e resposta.
O Atlas Cloud oferece suporte a entradas de texto e imagem com saída de texto. A janela de contexto listada é de 1,050,000 tokens, a saída máxima é de 131,072 tokens e a data de corte do conhecimento é 30 de abril de 2026.
Sim. Há suporte a streaming, e o esforço de raciocínio pode ser definido como low, medium, high, xhigh ou max. Configurações mais baixas priorizam a velocidade e o uso reduzido de tokens, enquanto configurações mais altas permitem mais raciocínio para trabalhos difíceis.
O preço padrão é de $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída. A entrada em cache custa $1 por milhão de tokens, enquanto a criação do cache custa $12.50 por milhão. Para prompts com mais de 272,000 tokens, as respectivas tarifas são $20, $75, $2 e $25 por milhão de tokens.
Comece com um esforço de raciocínio low ou medium e meça o uso de tokens em tarefas representativas antes de aumentar a configuração. O cache de prompts pode reduzir o custo de entradas reutilizáveis, enquanto um modelo de menor custo pode ser mais adequado para solicitações rotineiras ou de alto volume.
O Atlas Cloud lista dois IDs de modelo separados: openai/gpt-6-astra e openai/gpt-6-astra-codex. Ambos usam a mesma tabela de preços verificada, mas os dados de backend disponíveis não estabelecem uma diferença quantificada de capacidade ou latência. Faça benchmarks de ambos com suas próprias cargas de trabalho de programação e gerais antes de selecionar um padrão de produção.
Escolha o Astra para trabalhos difíceis em que a qualidade é o fator mais importante, incluindo uso agentivo de computadores, engenharia de software complexa, análise de contextos longos e tarefas científicas ou profissionais exigentes. Para solicitações rotineiras, tráfego de alto volume ou fluxos de trabalho em que a latência é importante, compare um modelo menor com base no sucesso das tarefas e no custo total.
A API do Seedance 2.5 já está disponível no Atlas Cloud! Ela oferece aos desenvolvedores o mais novo modelo de vídeo da ByteDance. Ele gera até 30 segundos de vídeo nativo em uma única passagem a partir de texto, uma única imagem ou até 50 referências multimodais, com áudio sincronizado e texto multilíngue no quadro. No Atlas Cloud, você o acessa por meio de uma única chave, com consistência de sujeito e física aprimorada mantendo a coerência em tomadas longas.

A API Wan 3.0 é a próxima geração da família de vídeos Wan da Alibaba, desenvolvida para elevar a geração de formato longo, o controle de múltiplas referências e a qualidade audiovisual a novos patamares. O Atlas Cloud já hospeda o Wan 2.7, 2.6 e 2.5, e o Wan 3.0 funciona com a mesma chave unificada, sem necessidade de configuração separada. Comece a construir hoje mesmo. Role a tela para baixo até a vitrine para ver o que o Wan 3.0 pode criar.
MiniMax H3 é a família de vídeo multimodal da MiniMax para criação guiada por texto, imagem e referências. Nas rotas compatíveis, preserva os elementos das mídias de referência, oferece proporções flexíveis e combina som gerado com elementos visuais por meio do H3 Developer, com perfis de saída selecionados por endpoint. O Atlas Cloud unifica a família com uma única chave compatível com a OpenAI e preços transparentes de pagamento conforme o uso, a partir da tarifa padrão de $0.038 por segundo. Comece a criar hoje.
A família gpt-image-2.5 da OpenAI oferece aos desenvolvedores a opção entre Flare e Sunburst para fluxos de trabalho de imagens em produção. Renderize em resoluções arbitrárias de até 3840x2160 e escolha entre cinco níveis de qualidade, incluindo xhigh e max, para atender a requisitos específicos de saída. A Atlas Cloud oferece inferência REST pronta para uso, sem cold starts, com preços padrão a partir de US$ 0,004 por geração. Comece a criar hoje.
A API do Seedream 5.0 Pro fornece aos desenvolvedores o modelo de edição de imagens controlável da ByteDance no Atlas Cloud. Ela posiciona as edições com precisão usando âncoras e coordenadas, separa as imagens em camadas editáveis, funde múltiplas referências e combina cores e materiais exatos, com texto multilíngue em 2K e 3K. No Atlas Cloud, você pode acessá-lo por meio de uma única chave!
Seedance 2.0 é o modelo de vídeo para produção da ByteDance, desenvolvido para a criação precisa de planos. Transforme prompts em vídeo, anime uma imagem do primeiro quadro com orientação opcional do último quadro ou defina os resultados com mídia de referência e pesquisa opcional na web. O Atlas Cloud reúne esses fluxos de trabalho em uma única API, com preços transparentes conforme o uso e uma única chave compatível com OpenAI. Comece a desenvolver hoje.
A Kling 3.0 API leva a suíte de vídeo principal da Kuaishou para a Atlas Cloud através de uma chave compatível com OpenAI. Ela abrange dois modelos: Kling 3.0 para narrativa AI Director, sincronização labial multilíngue e texto preciso na tela, e Kling 3.0 Omni (O3) para clonagem de sujeito e voz a partir de um vídeo curto ou imagem. Ambos geram áudio nativo na mesma passagem, com saída de até 4K. Crie narrativas cinematográficas, marketing global, anúncios multilíngues e conteúdo de personagens em série em uma infraestrutura confiável.
Grok Imagine Video dá aos desenvolvedores acesso à família de modelos de vídeo da xAI para criar, animar, estender e editar clipes. Gere vídeos de 1 a 15 segundos a partir de prompts, oriente pessoas, objetos ou estilos com até sete imagens de referência e trabalhe em 480p ou 720p. A Atlas Cloud reúne esses recursos por meio de endpoints compatíveis com a OpenAI, com preços transparentes conforme o uso. Comece a desenvolver hoje.
O Vidu Q4 é o mais recente modelo de vídeo topo de linha da Vidu, desenvolvido para geração de imagem para vídeo e referência para vídeo. Ele pode animar uma única imagem estática e criar transições automáticas de cena, oferecendo aos desenvolvedores dois caminhos de entrada para diferentes fluxos de trabalho de produtos. A Atlas Cloud fornece endpoints de API dedicados com esquemas de parâmetros publicados pelo preço padrão verificado de $0.04 por segundo. Comece a desenvolver hoje.
Gemini Omni 1.1 Flash é a família de vídeos nativamente multimodal do Google DeepMind, criada para fluxos de produção flexíveis. Edite filmagens existentes por meio de instruções de texto, mantenha a consistência visual com até 10 imagens de referência e 3 clipes de vídeo ou estenda uma tomada em segmentos encadeáveis de até 40 segundos. Acesse todos os fluxos de trabalho no Atlas Cloud com uma única chave de API compatível com a OpenAI, preços conforme o uso e disponibilidade desde o Dia 0. Comece a desenvolver hoje.
Nano Banana 2.1 é a família de modelos de imagem do Google baseada no Gemini 3.6 Flash. Oferece geração e edição de nível Pro com a velocidade do Flash, permite edições em linguagem natural e combinações entre 1 e 14 imagens de entrada, além de manter a consistência de até 4 personagens e 10 objetos. Por meio do Atlas Cloud, os desenvolvedores podem acessar a família com uma única chave compatível com OpenAI, disponibilidade confiável e disponibilidade desde o Dia 0. Comece a criar hoje.
Construa com a API Nano Banana 2, desenvolvida com o modelo Gemini 3.1 Flash Image do Google. Ele gera imagens em 4K nativo de até 4096x2304 com renderização de texto precisa e personagens consistentes em até 14 imagens de referência para geração e edição. No Atlas Cloud, você pode acessá-lo por meio de uma API unificada junto com mais de 300 modelos, com preços a partir de US$ 0,04 por imagem, 99,99% de tempo de atividade e créditos gratuitos para começar.
Guias, tutoriais e novidades de produto para você aproveitar ao máximo a Atlas Cloud.



