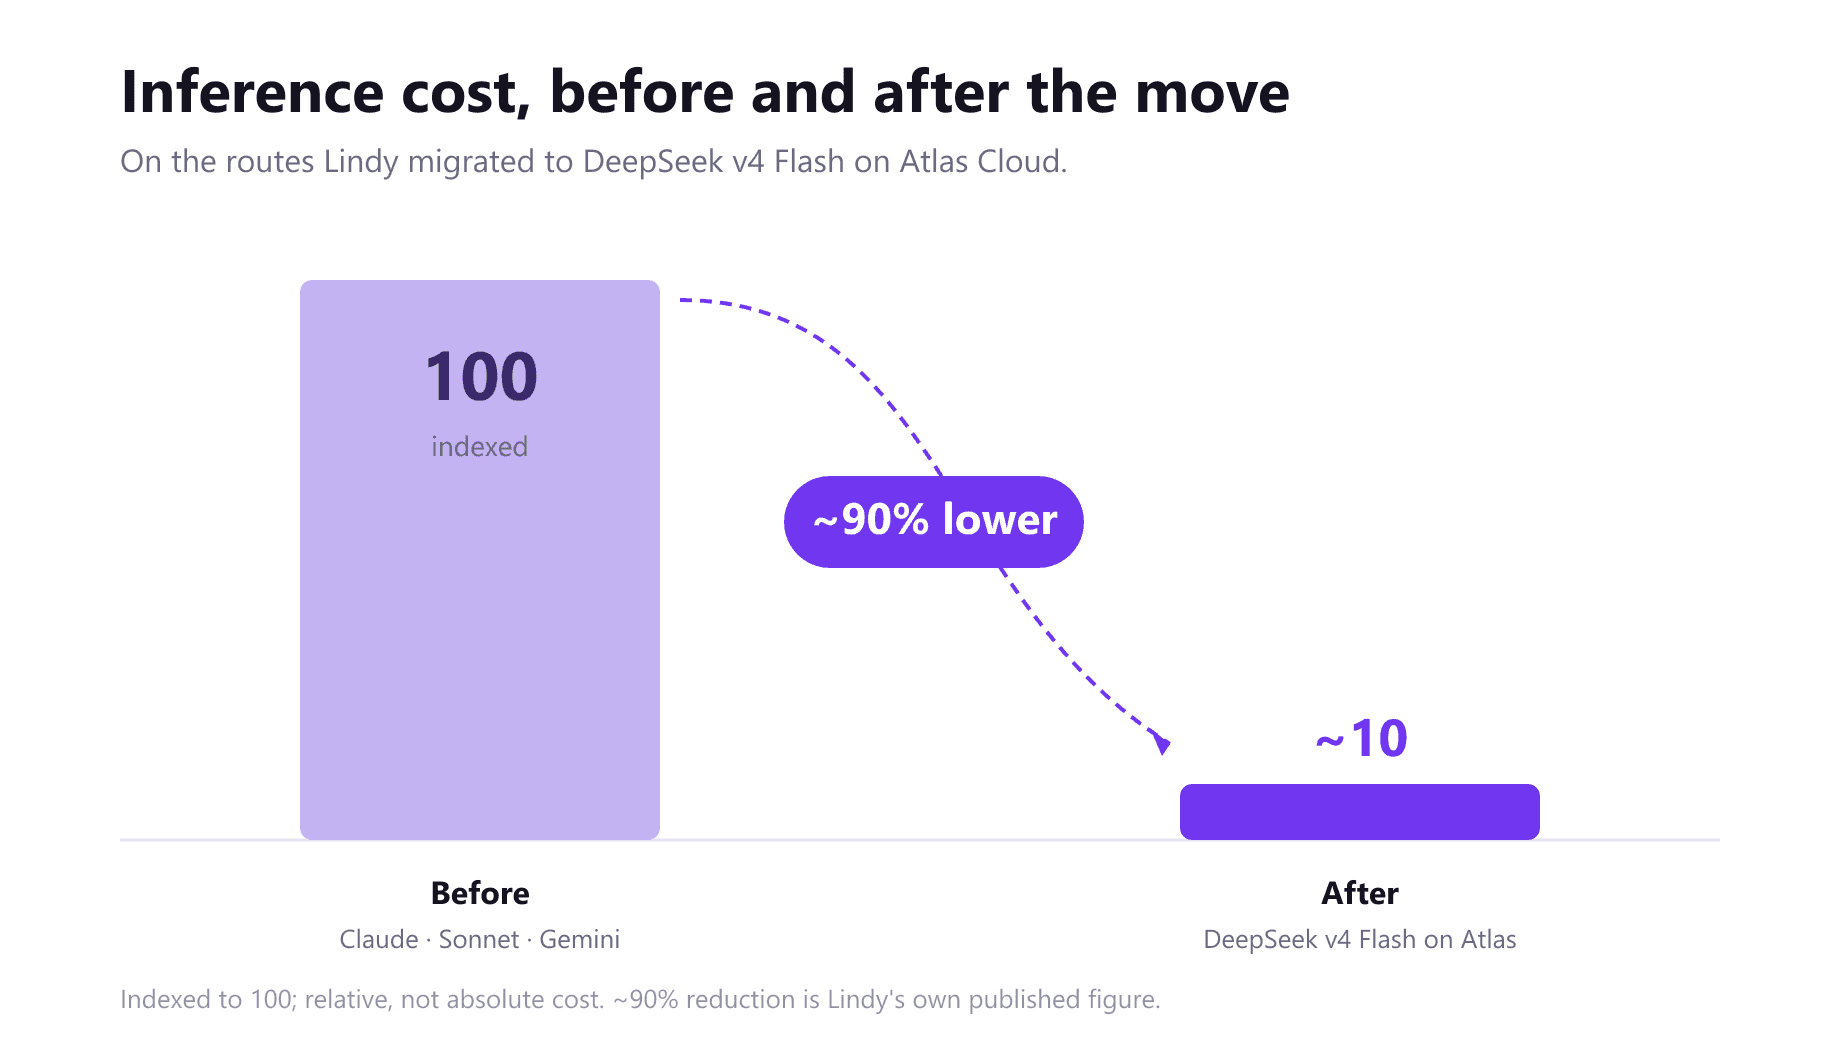
Lindy สร้างพนักงาน AI ขึ้นมา มันย้ายพนักงาน AI ทั้งหมดไปใช้โมเดลน้ำหนักเปิดที่ให้บริการโดย Atlas Cloud_, ลดต้นทุนการอนุมานลงได้ประมาณ 90%, และไม่ได้ส่งมอบผลิตภัณฑ์ที่แย่ลง
ต้นทุนอินเฟอเรนซ์ลดลง ~90% · 60% ของโทเคนอินพุตเสิร์ฟจากแคช · รองรับคำขอมากกว่า 3,000 รายการต่อนาที · ปริมาณทราฟฟิกโตกว่า 10 เท่าโดยไม่ต้องสร้างอะไรใหม่ · 24 โมเดลจาก 11 Labs ด้วยคีย์เดียว
Lindy รันเวิร์กโหลดของเอเจนต์ที่ต้องการทรัพยากรสูงสุดตัวหนึ่งในโปรดักชัน และมันรันอยู่บน Atlas Cloud นี่คือสิ่งที่เปลี่ยนไป:
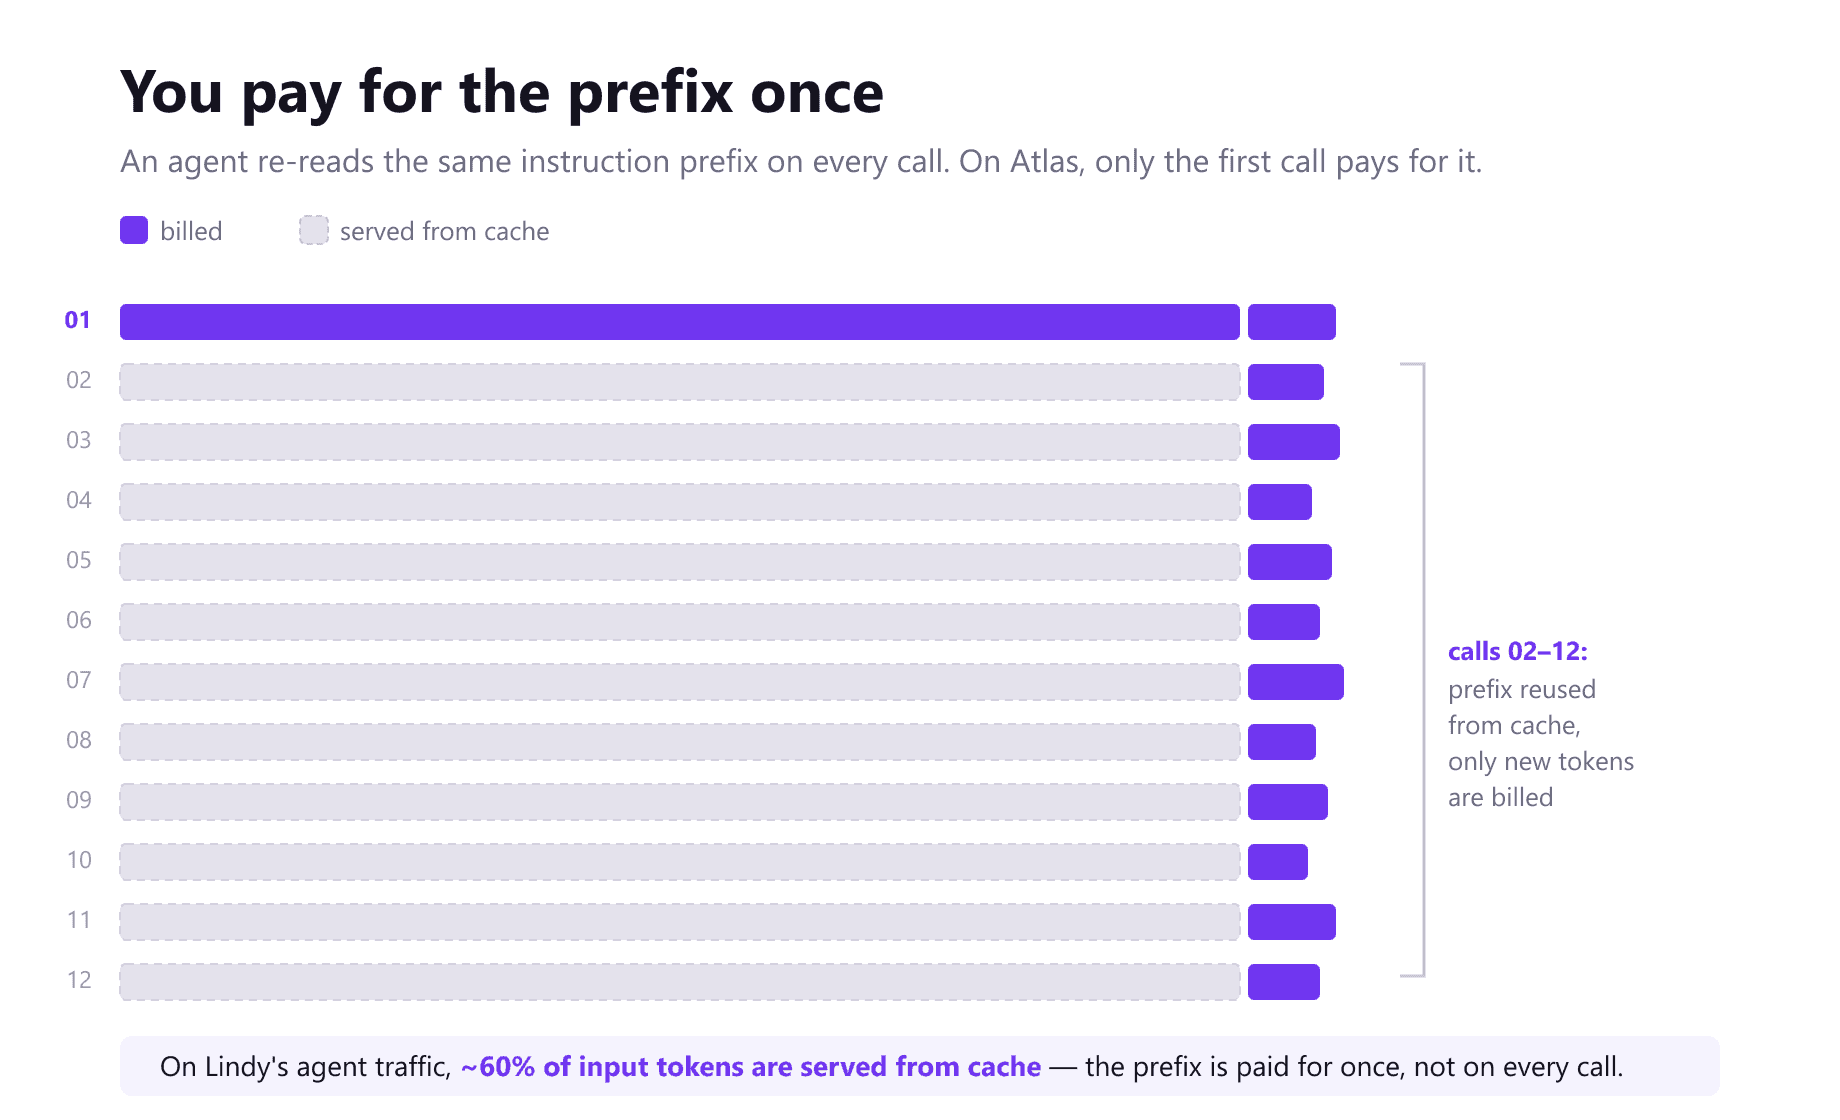
- เพราะ Atlas คิดราคาคอลที่เกิดซ้ำในอัตราแคช Lindy จึงรันเอเจนต์ที่ตรวจสอบงานของตัวเองแทนการเดา ทุก ๆ สิบโทเคนอินพุตที่ส่งไป หกโทเคนเสิร์ฟจากแคช ดังนั้น prefix ที่เอเจนต์อ่านซ้ำแล้วซ้ำอีกหลายสิบครั้งต่อหนึ่งงานจึงแทบไม่มีต้นทุน
- เพราะ Atlas เตรียมทรัพยากรตามปริมาณงาน Lindy เพิ่มปริมาณงานได้มากกว่าสิบเท่าด้วยการส่งทราฟฟิกมากขึ้น โดยไม่ต้องสร้างอะไรใหม่ และ Atlas รองรับคำขอมากกว่า 3,000 รายการต่อนาทีได้นานต่อเนื่องหนึ่งชั่วโมง
- เพราะ Atlas ให้แคตตาล็อกทั้งหมดผ่านคีย์เดียว Lindy จึงเปลี่ยนไปใช้โมเดลใหม่ได้ภายในบ่ายเดียว มันรันโมเดล 24 ตัวจาก 11 Labs ผ่านอินทิเกรชันเดียว
- เพราะ Atlas ให้บริการผ่านสัญญาที่ระบุผู้ให้บริการชัดเจนและผ่านการรับรอง SOC 2 Lindy จึงสามารถนำโมเดลน้ำหนักเปิดมาประมวลผลข้อมูลของลูกค้า และรับผิดชอบต่อตัวตนของผู้ให้บริการที่รันอยู่ได้
ตัวเลข 90% คือพาดหัวของ Lindy เหตุผลที่ตัวเลขนี้ยังคงอยู่ และเหตุผลที่การย้ายระบบครั้งหน้าจะง่ายกว่าครั้งนี้ ก็คือแพลตฟอร์มที่รองรับอยู่เบื้องหลัง
สำหรับ Lindy ค่าใช้จ่ายคือธุรกิจ
Lindy สร้างพนักงาน AI Lindy Teammate เข้าร่วมบริษัทแบบเดียวกับพนักงานใหม่อีกคน: มันรับคำขอใน Slack เชื่อมต่อกับเครื่องมือที่ทีมใช้งานอยู่แล้ว เข้าร่วมประชุม และเก็บสิ่งที่เรียนรู้ไว้ เพื่อให้คำขอถัดไปเริ่มต้นจากจุดที่ไกลกว่าครั้งก่อน ไม่มีใครเขียนออโตเมชัน พวกเขาเพียงมอบหมายงาน แล้วเอเจนต์ก็ลงมือทำ
การออกแบบเช่นนี้ทำให้ต้นทุนโครงสร้างพื้นฐานสูงมาก พนักงาน AI คนหนึ่งที่อ่านเธรด ตรวจปฏิทิน ค้นหาข้อมูล และร่างคำตอบ จะเรียกใช้โมเดลเป็นสิบครั้งก่อนที่ใครจะได้เห็นสักคำ และเพราะ Teammate ให้บริการทั้งทีม ปริมาณงานจึงเพิ่มขึ้นตามจำนวนพนักงาน ในโครงสร้างแบบนี้ ราคาของโมเดลที่อยู่เบื้องหลังผลิตภัณฑ์จึงเป็นตัวกำหนดความอยู่รอดของธุรกิจ
"ราคาของ Lindy จะใช้ได้ก็ต่อเมื่ออินเฟอเรนซ์มีราคาถูกลงเรื่อย ๆ."
— Bruno Škvorc, Staff Software Engineer, Lindy
Lindy จึงทำในสิ่งที่ตัวเลขทางการเงินต้องการ มันย้ายทราฟฟิกของเอเจนต์ที่จัดการส่วนใหญ่จาก Claude, Sonnet และ Gemini ไปยัง DeepSeek v4 Flash ที่รันบน Atlas Cloud และต้นทุนอินเฟอเรนซ์ในเส้นทางที่ย้ายลดลงประมาณ 90% การเปลี่ยนชื่อโมเดลใช้เวลาแค่บ่ายเดียว การทำให้ตัวเลขนี้คงอยู่กับปริมาณงานระดับโปรดักชัน โดยที่ผลิตภัณฑ์ไม่ได้แย่ลง คือเหตุผลที่พวกเขาเลือก Atlas Cloud
ทำไมตัวเลข 90% จึงยังคงอยู่: คอลที่สิบเอ็ดแทบไม่มีค่าใช้จ่าย
เมื่อคิดราคาตามโทเคน เอเจนต์จะจ่ายเต็มราคาสำหรับ prefix เดิมหลายสิบครั้งต่อหนึ่งงาน และค่าใช้จ่ายก็เพิ่มขึ้นตามความรอบคอบของมัน ภาษีนี้เองที่ทำให้โปรดักต์เอเจนต์ทำได้เพียงผิวเผิน: รอบเดียวแทนที่จะเป็นสามรอบ เพราะรอบที่สามมีราคาเท่ารอบแรก มันยังเป็นเหตุผลที่การสลับโมเดลแบบง่าย ๆ ประหยัดได้น้อยกว่าที่ตัวเลขบอก เพราะ prefix ที่ถูกเรียกซ้ำ ๆ จะค่อย ๆ ทำให้ค่าใช้จ่ายกลับมาสูงอีกครั้ง
"Agent เวิร์กโหลดมีการใช้คอนเท็กซ์ซ้ำ ๆ ในหลายคอล แคชของ Atlas ทำให้เราไม่ต้องจ่ายเต็มราคาสำหรับคอนเท็กซ์เดิมทุกครั้ง ซึ่งเป็นส่วนสำคัญที่ทำให้การประหยัดยังคงอยู่แม้ในสเกลใหญ่..""
— Ian McGregor, Head of Engineering, Lindy
ความจุที่พร้อมใช้ก่อนที่ Lindy จะต้องการ
ทราฟฟิกของเอเจนต์ไม่มีช่วงเวลาที่เงียบสงบในตอนกลางคืน และไม่มีวันเปิดตัวให้วางแผนล่วงหน้า งานจะเข้ามาในขณะที่ทีมกำลังทำงาน และไม่หยุดแม้คุณจะสเกล สิ่งที่สำคัญไม่ใช่สไปก์ที่บัฟเฟอร์รองรับได้ แต่เป็นอัตราที่ผู้ให้บริการประคองไว้ได้ Lindy เพิ่มปริมาณงานได้มากกว่าสิบเท่าด้วยการส่งทราฟฟิกมากขึ้น โดยไม่ต้องสร้างอะไรใหม่ และ Atlas รองรับคำขอมากกว่า 3,000 รายการต่อนาทีได้นานต่อเนื่องหนึ่งชั่วโมง ความจุมาก่อนปริมาณงานเสมอ ดังนั้นการสเกลจึงเป็นการตัดสินใจทางธุรกิจ ไม่ใช่โปรเจกต์โครงสร้างพื้นฐาน
ซัพพอร์ตที่ส่งมอบผลิตภัณฑ์ ไม่ใช่ส่งตั๋ว
ที่ปริมาณงานระดับนี้ ความแตกต่างระหว่างผู้ให้บริการไม่ใช่แดชบอร์ด แต่เป็นใครที่จะตอบเมื่อมีอะไรดูผิดปกติ วิศวกรของ Lindy และวิศวกรอินเฟอเรนซ์ของ Atlas แชร์ช่องทางเดียวกัน และคำตอบจะกลับมาในวันเดียวกันจากคนที่ลงมือทำได้จริง คำตอบบางส่วนกลายเป็นการเปลี่ยนแปลงผลิตภัณฑ์: Lindy ขอวิธีโอนความเป็นเจ้าของทีมแอคเคานต์ ซึ่งตอนนั้น Atlas ยังไม่รองรับ และฟีเจอร์นั้นก็ถูกส่งออกมา โดยวิศวกรของ Atlas ช่วยย้ายแอคเคานต์ให้เอง
ผู้ให้บริการที่คุณชี้ตัวได้
การย้ายไปใช้โมเดลน้ำหนักเปิดเป็นการตัดฝ่ายที่เคยรับผิดชอบว่าวิธีรันโมเดลเป็นอย่างไรออกไป คำถามที่แบรนด์ห้องแล็บเคยเป็นคำตอบ ตอนนี้ชี้ไปที่ผู้ให้บริการ: ใครเป็นผู้ให้บริการ อยู่ภายใต้การควบคุมแบบใด และข้อมูลที่ผ่านไปจะเกิดอะไรขึ้น Atlas ตอบคำถามเหล่านั้นด้วยชื่อโดยตรง ไม่ใช่ผ่านเราเตอร์ บนสัญญาที่ผ่านการรับรอง SOC 2 โดยไม่ได้จัดเก็บหรือนำข้อมูลลูกค้าไปฝึกโมเดล เรื่องนี้สำคัญกับพนักงาน AI มากกว่าผลิตภัณฑ์แชต เพราะ Teammate อ่านเธรด Slack ปฏิทิน และข้อมูลบริษัทที่มันทำงานให้ คำถามเรื่องโครงสร้างพื้นฐานเชื่อมโยงโดยตรงกับคำถามเรื่องความไว้วางใจของลูกค้า และ Atlas คือคำตอบของทั้งสอง
ไม่ผูกติดกับ DeepSeek หรืออะไรทั้งสิ้น
การย้ายครั้งนี้ผูก Lindy ไว้กับกลยุทธ์ ไม่ใช่กับโมเดลตัวใดตัวหนึ่ง DeepSeek v4 Flash ชนะในเวิร์กโหลดที่ทดสอบ และครองตำแหน่งต่อไปตราบใดที่มันยังมีราคาดีที่สุดในคุณภาพที่พอรับได้ ผู้ชนะตัวต่อไปอาจมาจากแล็บอื่นภายใต้ไลเซนส์ที่ต่างออกไป และเพราะ Atlas Cloud ให้เข้าถึงโมเดลทั้งหมดผ่าน API เดียว การลองจึงใช้เวลาแค่บ่ายเดียวแทนที่จะเป็นกระบวนการจัดซื้อจัดจ้าง ในการทดสอบวันเดียว Lindy รันคำขอ 47 รายการผ่านโมเดล 12 ตัวที่ไม่เคยใช้มาก่อน จาก 7 Labs และ 3 โมดาลิตี โดยใช้คีย์เดิมที่มีอยู่แล้ว สามตัวกลายเป็นเวิร์กโหลดในโปรดักชัน อิสระในการรันโมเดลที่ดีที่สุดผ่าน Atlas Cloud เสมอ ทำให้ Lindy มีความคล่องตัวทางธุรกิจในการดำเนินงานอย่างแท้จริง
ถ้าคุณกำลังรันเอเจนต์บนมาร์เก็ตเพลซ จงย้ายมัน
Lindy เดินเส้นทางนี้มาแล้ว มันพบ DeepSeek ครั้งแรกบน OpenRouter รันโมเดลผ่านการประเมิน (evals) ที่นั่น และพิสูจน์ว่ามันคุ้มค่าที่จะย้าย ในการทดสอบเดียวกันนั้น มันพบสิ่งที่ชี้ขาดว่าโปรดักชันควรไปรันที่ไหน
"เราทดสอบโมเดลเดียวกันบนผู้ให้บริการอินเฟอเรนซ์หลายราย ที่น่ารำคาญคือผู้ให้บริการมีผล โมเดลชื่อเดียวกันให้คะแนนต่างกันได้ ขึ้นอยู่กับใครเป็นผู้เสิร์ฟ."
— Bruno Škvorc, Staff Software Engineer, Lindy
มาร์เก็ตเพลซถูกสร้างมาเพื่อช่วยให้คุณเลือกซื้อ ไม่ใช่เพื่อรันโปรดักต์ของคุณ เมื่อส่งทราฟฟิกโปรดักชันผ่านเราเตอร์ มันจะไปยังผู้ให้บริการรายใดก็ได้ที่มีความจุว่าง คุณจึงไม่ได้เลือกว่าผู้ใดเสิร์ฟโมเดลของคุณ และไม่เห็นด้วยซ้ำว่าใครเป็นคนเสิร์ฟ น้ำหนักเดียวกันบนเครื่องคนละเครื่องให้ตัวเลขต่างกัน จากการทำควอนไทซ์หรือช็อตคัตในสแตกการเสิร์ฟของใครบางคน และตัวเลขเหล่านั้นถึงผู้ใช้ก่อนที่จะถึงแดชบอร์ดของคุณ ทุกครั้งที่เราเตอร์กระโดด (hop) จะสุ่มคุณภาพของโปรดักต์ที่ลูกค้ากำลังจ่ายเงินอย่างเงียบ ๆ คุณไม่สามารถดีบักได้ เพราะคุณไม่เห็นว่าใครเสิร์ฟคอลนั้น คุณไม่สามารถแก้ไขได้ เพราะคุณไม่ได้ควบคุมการจัดเส้นทางทั้งหมด นั่นคือชื่อเสียงของคุณ ถูกตัดสินด้วยเหรียญที่คุณไม่มีสิทธิ์โยน
Lindy จึงไม่รันโปรดักชันบน OpenRouter เมื่อทราฟฟิกเริ่มทำงานจริง มันไปอยู่บนสัญญาโดยตรงกับ Atlas: สแตกการเสิร์ฟเดียว ใช้ตัวเดิมทุกคำขอ ปรับแต่งสำหรับโมเดลนั้น และผูกพันตามสัญญา พร้อมแคชและความจุที่เวิร์กโหลดเอเจนต์จริงต้องการ และแคตตาล็อกทั้งหมดบนคีย์เดียวกัน ถ้าเอเจนต์ของคุณอยู่ในโปรดักชันแล้วแต่ยังรันผ่านเราเตอร์ คุณกำลังส่งมอบโปรดักต์ที่คุณไม่สามารถควบคุมเสถียรภาพได้ และคุณจะไม่รู้จนกว่าลูกค้าจะรู้ก่อน จงย้ายมัน อย่างที่ Lindy ทำ
คุยกับเราเกี่ยวกับเวิร์กโหลดของคุณ แล้วเราจะบอกคุณว่าควรมีค่าใช้จ่ายเท่าไร หรือ เรียกดูแคตตาล็อก.
เกี่ยวกับ Lindy
Lindy สร้างพนักงาน AI Lindy Teammate เปิดตัวในเดือนสิงหาคม 2026 ทำงานเคียงข้างทีมมนุษย์: มันรับคำขอใน Slack เชื่อมต่อกับเครื่องมือที่บริษัทใช้งานอยู่แล้ว เข้าร่วมประชุม และสั่งสมบริบทของทีมเพื่อให้ทุกคำขอเริ่มต้นจากจุดที่ไกลกว่าครั้งก่อน แทนที่จะให้คนสร้างและดูแลออโตเมชัน Lindy ขอให้พวกเขามอบหมายงานเท่านั้น Lindy ก่อตั้งโดย Flo Crivello และมีสำนักงานใหญ่อยู่ที่ซานฟรานซิสโก
เกี่ยวกับ Atlas Cloud
Atlas Cloud คือแพลตฟอร์ม AI แบบครบทุกโมดาลิตี้ (full-modal) ในที่เดียว: โมเดลมากกว่า 400 ตัวครอบคลุมวิดีโอ รูปภาพ ภาษา และเสียง ผ่านคีย์ API เดียว เอนด์พอยต์เดียว และบัญชีเรียกเก็บเงินเดียว เข้ากันได้กับ OpenAI สำหรับโมเดลภาษา ได้รับการรับรอง SOC 2 และ HIPAA





