รายงานการทดสอบ API ที่เป็นสีเขียวสร้างความอุ่นใจได้ จนกว่าคุณจะสังเกตว่าทุกการยืนยันตรวจเพียง HTTP 200 เท่านั้น คำตอบอาจมีข้อมูลของลูกค้าผิดคนและยังผ่านได้
เลือก เครื่องมือ AI สำหรับการทดสอบ API ให้สอดคล้องกับงานที่คุณมีอยู่แล้ว ประเมิน Postman Agent Mode หากทีมของคุณดูแล collections อยู่, KushoAI หากข้อกำหนด (specification) เป็นจุดเริ่มต้นของคุณ, และ Keploy หากคุณต้องการโฟลว์ที่สร้างขึ้นหรือการทดสอบ regression ที่สร้างจากทราฟฟิกที่บันทึกไว้ ตรวจทานและรันการทดสอบที่ได้ก่อนที่จะเชื่อถือ
คู่มือนี้ครอบคลุมความช่วยเหลือจาก AI สำหรับการทดสอบ API ทั่วไป การทดสอบความถูกต้องของคำตอบของโมเดล AI เป็นปัญหาการประเมินที่แยกต่างหาก
ประเด็นสำคัญ
- จัดเตรียมสัญญา (contract), dependencies ของคำขอ และความคาดหวังทางธุรกิจที่ได้รับอนุมัติ
- ตรวจสอบว่าการยืนยันปฏิเสธข้อมูลผิด ฟิลด์ที่หายไป และชนิดข้อมูลที่เสียหรือไม่
- ซื้อเฉพาะหลังจากที่การทดสอบที่ตรวจทานแล้วรันซ้ำ ๆ ในสภาพแวดล้อม CI ที่คุณต้องการ
การเปรียบเทียบผลิตภัณฑ์ด้านล่างสะท้อนเอกสารทางการที่ตรวจสอบเมื่อวันที่ 21 กันยายน 2026 ไม่ใช่การเปรียบเทียบแบบ head-to-head ของบัญชีแบบชำระเงินสามบัญชี
ตัวอย่างที่ลงมือทำใช้ข้อกำหนด Swagger Petstore ที่ปักหมุดไว้ และแยกความคาดหวังตามสัญญา พฤติกรรมที่สังเกตได้ และสำเนาคำตอบที่แก้ไขโดยเจตนา
การรันในเครื่องของเราผ่านการทดสอบแบบ live 5 รายการ และปฏิเสธสำเนาคำตอบที่เปลี่ยนแปลงโดยเจตนาทั้ง 3 รายการ การ probe ฟิลด์ name ที่หายไปแยกต่างหากยังคงคืนค่า 200 ซึ่งแสดงให้เห็นว่าขอบเขตของรายงานสีเขียวมีความสำคัญอย่างไร
เครื่องมือ AI สำหรับการทดสอบ API ทำอะไรจริง ๆ
ความช่วยเหลือจาก AI มักเข้ามาในสี่ส่วนของการทดสอบ API โมเดลอ่านข้อกำหนดของคุณ เสนอสถานการณ์ ร่างการยืนยัน และช่วยอธิบายความล้มเหลว แต่ละส่วนต้องใช้หลักฐานที่แตกต่างกัน คำอธิบายความล้มเหลวที่ดูสมเหตุสมผลไม่ได้พิสูจน์ว่าวิธีแก้ที่เสนอไว้นั้นถูกต้อง
สำหรับการตรวจทานข้อกำหนด ให้ OpenAPI file และกฎทางธุรกิจที่เกี่ยวข้อง สำหรับการวางแผนสถานการณ์ ให้เพิ่มตัวอย่างข้อมูลที่ถูกต้องและขอบเขตที่ทราบ สำหรับสคริปต์ที่รันได้ ให้รวม runner, การตั้งค่าการยืนยันตัวตน และแนวทาง fixture ของคุณ สำหรับการวินิจฉัย ให้คำขอจริง คำตอบ และข้อความความล้มเหลวหลังนำข้อมูลลับออก
แยกกลไกทั้งสี่นี้ให้ชัดเจนเมื่อประเมินผลิตภัณฑ์:
- การสร้างด้วย LLM: เสนอการทดสอบจากภาษา สคีมา และตัวอย่าง ผู้ตรวจทานต้องตรวจสอบผลลัพธ์ที่คาดหวัง
- การเล่นทราฟฟิกซ้ำ (Traffic replay): เปรียบเทียบพฤติกรรมภายหลังกับปฏิสัมพันธ์ที่บันทึกไว้ ซึ่งมักใช้คำตอบของ dependency ที่บันทึกไว้
- การทดสอบแบบ property-based: สร้างอินพุตอย่างเป็นระบบเพื่อท้าทายคุณสมบัติ เช่น ความสอดคล้องกับสคีมา
- การรันการทดสอบ: ส่งคำขอ ประเมินการยืนยัน และคืนรายงานและ exit codes
ผลิตภัณฑ์หนึ่งอาจรวมหลายกลไก ถามว่ากลไกใดสร้างการทดสอบแต่ละรายการ และอะไรกำหนดผลลัพธ์ที่คาดหวัง การบันทึกคำตอบที่ไม่ถูกต้องสามารถรักษาข้อผิดพลาดเดิมไว้เป็น baseline สำหรับ regression การสร้างชื่อการทดสอบที่ดูดีสามารถปกปิดความคาดหวังที่ไม่มีการสนับสนุน
คิดถึงการยืนยันในสามระดับ ชั้นแรก เซิร์ฟเวอร์ตอบกลับสำเร็จหรือไม่? ชั้นที่สอง body มีฟิลด์และชนิดข้อมูลตามเอกสารหรือไม่? ชั้นที่สาม body นี้เป็นตัวแทนของ resource และ operation ที่คุณร้องขอหรือไม่?
สำหรับการค้นหา pet วัตถุที่ถูกต้องซึ่งมี ID เป็นจำนวนเต็มยังคงล้มเหลวในการตรวจชั้นที่สาม หาก ID นั้นเป็นของ pet อื่น ในทางกลับกัน การตรงกับ ID ที่ร้องขอไม่ได้พิสูจน์ว่าทุกฟิลด์เป็นไปตามสคีมา ใช้ทั้งสองการตรวจ และเพิ่มกฎทางธุรกิจเฉพาะเมื่อทีมมีแหล่งที่ตกลงกันไว้สำหรับกฎเหล่านั้น
ผลลัพธ์เชิงปฏิบัติที่คุณต้องการคือ test asset ที่บำรุงรักษาได้พร้อม oracle ที่อธิบายได้: เหตุผลชัดเจนว่าทำไมผลลัพธ์แต่ละรายการจึงควรผ่านหรือล้มเหลว นับสถานการณ์ที่มีประโยชน์หลังการตรวจทาน รวมถึงรายการที่คุณปฏิเสธ แทนที่จะฉลองความยาวของรายการที่สร้างขึ้นในตอนแรก
เครื่องมือ AI สำหรับการทดสอบ API เปรียบเทียบตามเวิร์กโฟลว์
เริ่มจาก artifact ที่ทีมของคุณจัดหาได้ในวันนี้ การย้าย collection ที่มีอยู่แล้ว การสร้างกฎทางธุรกิจที่หายไปขึ้นใหม่ และการตั้งค่าการบันทึก dependency เป็นโครงการที่แตกต่างกัน เครื่องมือที่เหมาะกับจุดเริ่มต้นหนึ่งอาจสร้างงานเพิ่มที่อีกจุดเริ่มต้นหนึ่ง
| เครื่องมือหรือแนวทาง | อินพุตที่มีประโยชน์ | บทบาท AI หรือระบบอัตโนมัติ | เส้นทางการรันและ CI | ผลลัพธ์ที่ตรวจทานได้ | คำถามหลักในการทดลอง |
|---|---|---|---|---|---|
| Postman Agent Mode | Collections, requests, responses, environments, specs | ร่างและแก้ไขสคริปต์ทดสอบในบริบทของ workspace | Collection Runner และเวิร์กโฟลว์ CLI ที่เข้ากันได้ | การยืนยัน JavaScript มาตรฐานของ Postman | มันรักษาตัวแปรของคุณและทดสอบสัญญาหรือไม่? |
| KushoAI | OpenAPI, Postman collection, cURL | สร้างสถานการณ์และชุดทดสอบ; รองรับการปรับแต่งด้วยภาษาธรรมชาติ | การรันบนแพลตฟอร์มและการผสาน CI ตามเอกสาร; ตรวจสอบสิทธิ์การใช้งาน | ตรวจดูคำขอที่สร้างขึ้น dependency และผลลัพธ์ที่คาดหวัง | แผนที่คุณเลือกสามารถรันและเก็บชุดทดสอบในที่ที่คุณต้องการได้หรือไม่? |
| Keploy | Specs หรือคำจำกัดความคำขอ; หรือทราฟฟิกจริง | การสร้างด้วย AI และเส้นทางการบันทึก/เล่นซ้ำแยกต่างหาก | โฟลว์ที่สร้างขึ้นหรือการทดสอบที่บันทึกไว้ในสภาพแวดล้อม local/CI ที่รองรับ | ตรวจทานคำจำกัดความการทดสอบ baseline และ dependency mocks | เส้นทางใดครอบคลุมโหมดความล้มเหลวจริงของคุณ? |
| Existing runner plus an LLM | เมทริกซ์ที่อนุมัติ, spec, แนวทาง fixture | ร่างโค้ดเพื่อการตรวจทาน | pytest ของคุณหรือ runner อื่นที่ตั้งไว้แล้ว | โค้ดที่คอมมิตเข้า repository ของคุณ | การตรวจทานถูกกว่าการเขียนการทดสอบเดียวกันโดยตรงหรือไม่? |
Postman Agent Mode สำหรับ Collections ที่มีอยู่
Postman เป็นการประเมินแรกที่สมเหตุสมผลเมื่อ collection ของคุณมีลำดับคำขอ ตัวแปรสภาพแวดล้อม และการตั้งค่าการยืนยันตัวตนที่มีประโยชน์อยู่แล้ว Agent Mode สามารถใช้บริบทนั้นเพื่อสร้างสคริปต์ทดสอบ JavaScript มาตรฐาน สคริปต์เหล่านั้นสามารถเข้าสู่เวิร์กโฟลว์การรัน collection ที่มีอยู่ แทนที่จะต้องใช้ภาษาการยืนยันใหม่
การทดลองแบบเจาะจงจะเปิดเผยมากกว่าการขอให้มันทดสอบทุกอย่าง เลือกคำขอที่ดึง resource ที่สร้างไว้ก่อนหน้าใน collection ให้สคีมาของมัน และขอให้ตรวจสอบฟิลด์ที่จำเป็น ชนิดฟิลด์ตามเอกสาร และการยืนยันที่เชื่อม ID ที่คืนมากับ ID การสร้างที่จัดเก็บไว้
จากนั้นตรวจดูการเปลี่ยนแปลงที่เสนอก่อนยอมรับ ตัวอย่างคำตอบอาจมี pet ชื่อ Milo การเท่ากับ Milo มีความหมายหาก fixture ของคุณสร้าง Milo อย่างชัดเจน; แต่เปราะบางหากตัวสร้างคัดลอกชื่อจากบันทึกตัวอย่างที่ใช้ร่วมกัน ตัวอักษรliteral เดียวกันอาจเป็นการยืนยันที่ถูกต้องหรือ dependency โดยบังเอิญ ขึ้นอยู่กับแหล่งที่มา
ตรวจสอบขอบเขตของตัวแปรอย่างระมัดระวัง ID ที่จัดเก็บในตัวแปรสภาพแวดล้อมต้องพร้อมใช้งานสำหรับคำขอภายหลัง และต้องเป็นของการรันนั้น ตัวแปรที่ใช้ร่วมกันข้ามการรันพร้อมกันสามารถสร้างความล้มเหลวเป็นครั้งคราวที่ดูคล้ายข้อบกพร่องของเซิร์ฟเวอร์ ขอให้ตัวสร้างอธิบายการตั้งค่าและการล้างข้อมูลตลอดจนการยืนยัน
สำหรับการทดสอบยอมรับครั้งแรก ให้รัน collection สองครั้งกับข้อมูลที่แยกออกจากกัน จากนั้นตรวจดูตัวแทนที่ส่งออกหรือจัดเก็บเวอร์ชัน ยืนยันว่าสมาชิกในทีมสามารถตรวจทานสคริปต์ที่เปลี่ยนแปลงได้โดยไม่ต้องทำการสนทนากับ AI ซ้ำ ตรวจสอบด้วยว่า CLI, reporter และแผนที่คุณเลือกสนับสนุนเส้นทางการรันที่คุณตั้งใจจะใช้
ไม่มีการนำเสนอการสร้าง Postman ที่ดำเนินการจริงที่นี่ คำถามการประเมินที่มีประโยชน์คือบริบท workspace ของมันลดงานตรวจทานของคุณบน collection ที่มีอยู่หรือไม่ ซึ่งต้องใช้ collection ของคุณเองและการทดลองในระดับบัญชี ไม่ใช่ข้อสรุปที่ได้จากภาพหน้าจอผลิตภัณฑ์
KushoAI สำหรับการสร้างการทดสอบจาก Spec
KushoAI รับอินพุต Swagger/OpenAPI, Postman และ cURL และมีเอกสารเกี่ยวกับการสร้างการทดสอบ การปรับแต่งด้วยภาษาธรรมชาติ และการรันใน CI ทำให้เป็นตัวเลือกเมื่อทีมมีคำจำกัดความ API ที่มีประโยชน์แต่มีงานค้างของการทดสอบที่ยังไม่ได้เขียน สิ่งเหล่านี้เป็นความสามารถที่ผู้ขายอธิบายไว้ ไม่ใช่ผลลัพธ์การตรวจจับข้อบกพร่องที่วัดได้ (เอกสาร KushoAI, กันยายน 2026)
เลือกอินพุตที่มีบริบทน่าเชื่อถือมากที่สุด คำขอ cURL สามารถอธิบายคำขอที่ถูกต้องหนึ่งรายการ แต่โดยทั่วไปให้ข้อมูลน้อยเกี่ยวกับฟิลด์ที่ไม่บังคับ ค่า enum ที่อนุญาต หรือข้อผิดพลาดตามเอกสาร ไฟล์ OpenAPI เพิ่มโครงสร้าง; เมทริกซ์สถานการณ์ที่อนุมัติเพิ่มเจตนาที่โครงสร้างอาจทิ้งความกำกวมไว้
สำหรับการทดลองกับ Petstore ให้ขอกรณีแยกต่างหากสำหรับ pet ที่ถูกต้อง, name ที่จำเป็นหายไป, ID ที่มีชนิดผิด และตัวกรอง status ที่ไม่ถูกต้อง ตรวจทานว่าเครื่องมือแยกข้อกำหนดของ request-body จากข้อกำหนดของ response-schema หรือไม่ สิ่งเหล่านี้อาจดูคล้ายกันในตัวอย่างแต่กำหนดภาระผูกพันที่แตกต่างกัน
จากนั้นตรวจสอบโฟลว์ create-read-update ที่เชื่อมต่อกัน การอ่านต้องใช้ ID ที่เชื่อมโยงกับการตั้งค่าปัจจุบัน การอัปเดตต้องกำหนดเป้าหมายไปที่ resource เดียวกัน และการอ่านภายหลังต้องยืนยันฟิลด์ที่เปลี่ยนแปลง คำขออิสระสี่รายการที่มีชื่อการทดสอบน่าดึงดูดไม่ได้พิสูจน์ว่าห่วงโซ่ dependency ทำงานได้
มองการสร้างครั้งแรกเป็นข้อเสนอ เก็บความคาดหวังตามเอกสาร แก้ไขสคริปต์ที่มี data flow ไม่ถูกต้อง และตั้งธงผลลัพธ์ที่ระบุไม่ครบสำหรับการตัดสินใจด้านข้อกำหนด หากเครื่องมือเสนอกรณีฟิลด์หายไปที่เทียบเท่ากันหลายรายการ ให้เก็บความแตกต่างที่มีประโยชน์ไว้แทนที่จะจ่ายเพื่อดูแลรายการซ้ำ
ก่อนซื้อ ให้ขอให้รันชุดทดสอบจากไปป์ไลน์ที่คุณตั้งใจและตรวจดู artifact ของความล้มเหลว ยืนยันสิทธิ์ CI ปัจจุบัน การจัดการข้อมูลรับรอง และรูปแบบการส่งออกที่มีในแผนที่เลือก อย่าสันนิษฐานว่าการทดลองแบบอินเทอร์แอกทีฟฟรีให้สิทธิ์ระบบอัตโนมัติเช่นเดียวกับการติดตั้งสำหรับทีม
Keploy สำหรับการทดสอบที่สร้างขึ้นและการเล่นทราฟฟิกซ้ำ
เอกสารของ Keploy นำเสนอเส้นทางเริ่มต้นสองเส้นทางที่แตกต่างกัน การสร้างด้วย AI รับ resource เช่น OpenAPI, Postman, cURL หรือ endpoints และสร้าง API flows ที่เชื่อมต่อกัน การบันทึกและเล่นซ้ำจับปฏิสัมพันธ์ API และ dependency เพื่อรันภายหลังด้วย mocks คำอธิบาย AI flow และคำอธิบายการบันทึก dependency ไม่ควรถือว่าเป็นกลไกเดียวกัน (เอกสาร Keploy, กันยายน 2026)
หากความยากของคุณคือการทำซ้ำสิ่งที่แอปพลิเคชันทำกับฐานข้อมูลหรือบริการต้นทาง ให้ประเมินเส้นทางการบันทึก จับการเดินทาง create-read-update ขนาดเล็กในสภาพแวดล้อมที่แยกออกจากกัน ตรวจดู dependency ที่จับไว้ และเล่นซ้ำหลังการเปลี่ยนแปลงแอปพลิเคชันที่ควบคุมไว้ ตรวจสอบว่า runtime รองรับอะไรก่อนวางแผนการเปิดใช้ที่ใหญ่ขึ้น
หากความยากของคุณคือการได้มาซึ่งกรณีจากข้อกำหนด ให้ประเมินเส้นทางการสร้างแยกต่างหาก ถามว่าคำขอที่เสนอได้รับข้อมูลรับรองอย่างไร พา ID ระหว่างขั้นตอนอย่างไร และล้างข้อมูลอย่างไร การมีคุณสมบัติการบันทึกที่อื่นในผลิตภัณฑ์ไม่ได้ตอบคำถามเหล่านั้นสำหรับชุดทดสอบที่สร้างขึ้น
ค่าที่เปลี่ยนแปลงได้ต้องใช้วิจารณญาณ timestamp อาจแตกต่างได้อย่างชอบธรรม; resource ID อาจเชื่อมคำขอสองรายการและจึงต้องเปรียบเทียบ การเพิกเฉยต่อทุกฟิลด์ที่เปลี่ยนแปลงอย่างกว้าง ๆ สามารถซ่อนข้อผิดพลาดได้ ตรวจทานการยกเว้นทีละฟิลด์ และเก็บการเปรียบเทียบที่แสดงความสัมพันธ์ที่มีความหมาย
ตรวจดู baseline ก่อนยอมรับด้วย การบันทึกที่มียอดรวมผิด คำตอบ fallback โดยบังเอิญ หรือข้อมูลเก่า สามารถเล่นซ้ำได้อย่างสม่ำเสมอ ความสม่ำเสมอช่วยตรวจจับการเปลี่ยนแปลง แต่ทีมยังคงตัดสินว่าพฤติกรรมที่บันทึกไว้ถูกต้องหรือไม่
ส่วนเสริมที่มีประโยชน์: Schemathesis ให้การทดสอบ API แบบ property-based ที่ขับเคลื่อนด้วยสคีมา มันสามารถท้าทาย API ด้วยอินพุตที่สร้างขึ้นควบคู่กับตัวอย่างที่ตรวจทานแล้ว มองมันเป็นกลไกการทดสอบที่แตกต่าง ไม่ใช่คำพ้องของตัวสร้างการทดสอบ LLM การค้นพบของมันยังต้องตีความเทียบกับสัญญาและการนำไปใช้
เครื่องมือ AI ฟรีสำหรับการทดสอบ API: ข้อจำกัดและค่าใช้จ่าย
“ฟรี” อาจหมายถึงไคลเอนต์ สิทธิ์ใช้ AI แบบจำกัด runner โอเพนซอร์ส หรือการทดลองชั่วคราว ข้อเสนอเหล่านี้ครอบคลุมส่วนต่าง ๆ ของเวิร์กโฟลว์ ไคลเอนต์ฟรีไม่ได้พิสูจน์ว่าการสร้างอัตโนมัติ การรันตามกำหนด หรือการส่งออกรายงานนั้นฟรีด้วย
จากการตรวจสอบเมื่อวันที่ 21 กันยายน 2026 แผนฟรีของ Postman ระบุ 50 AI credits ต่อเดือน Credits เป็นหน่วยการเรียกเก็บเงินของมัน ไม่ได้หมายถึง 50 การทดสอบหรือ 50 ชุดทดสอบที่สมบูรณ์ ตารางเปรียบเทียบของมันแยกสิทธิ์ใช้ AI ออกจากการรัน คุณสมบัติที่ขับเคลื่อนด้วยข้อมูล และการส่งออกผลลัพธ์ (ราคา Postman, กันยายน 2026)
การนำเสนอราคาปัจจุบันของ KushoAI ใช้ Developer Edition และ Enterprise Keploy แยก Playground, Pro และ Enterprise ควบคู่กับข้อเสนอโอเพนซอร์ส ใช้หน้าจอการซื้อปัจจุบันเพื่อยืนยันข้อจำกัดที่เกี่ยวข้อง บทความรวบรวมเครื่องมือเก่าอาจอธิบายชื่อแผนที่เลิกใช้แล้วหรือรวมสิทธิ์ที่เรียกเก็บเงินแยกกัน
| องค์ประกอบค่าใช้จ่าย | สิ่งที่ต้องบันทึกในการทดลอง | สิ่งที่ทำให้บิลเข้าใจผิดได้ |
|---|---|---|
| ที่นั่งและแผน | Editors, reviewers, ช่วงเวลาการเรียกเก็บเงิน, คุณสมบัติที่จำเป็น | เปรียบเทียบราคาปีที่โฆษณากับข้อผูกพันรายเดือน |
| การสร้างด้วย AI | การใช้ credits สำหรับงานที่อนุมัติเดียวกัน รวมถึงการลองใหม่ | สันนิษฐานว่า 1 credit เท่ากับ 1 การทดสอบ |
| การรัน | การรันในเครื่อง, การรันแบบโฮสต์, งาน CI, ตารางเวลา, รายงาน | มองการรันแบบอินเทอร์แอกทีฟเป็นสิทธิ์สำหรับทุกเส้นทางระบบอัตโนมัติ |
| โมเดลอิสระ | โทเคนอินพุตและเอาต์พุตสำหรับการร่างและตรวจทาน | ปล่อยผ่านการส่ง spec ทั้งฉบับซ้ำ ๆ |
| เวลาทางวิศวกรรม | การตรวจทาน, การซ่อม fixture, การคัดแยกความล้มเหลว, การบำรุงรักษา | นับเวลาการสร้างเริ่มต้นเป็นเวลาส่งมอบทั้งหมด |
ใช้งานยอมรับขนาดเล็กเพื่อประมาณค่าใช้จ่าย ให้ผู้สมัครแต่ละรายการดำเนินการและความคาดหวังเดียวกัน จากนั้นบันทึกว่ามีกี่สถานการณ์ที่รอดจากการตรวจทาน เก็บเวลาการสร้าง เวลาตรวจทานด้วยมือ และเวลารันในคอลัมน์แยกกัน การรอโมเดลและการแก้ไขการยืนยันที่อันตรายสร้างค่าใช้จ่ายที่แตกต่างกันให้ทีม
ตัวหารที่มีประโยชน์คือสถานการณ์ที่ตรวจทานแล้วและรันได้ซึ่งทีมของคุณจะเก็บไว้ มันป้องกันไม่ให้ตัวสร้างที่มีกรณีซ้ำจำนวนมากดูเหมือนถูกกว่าเพียงเพราะผลลัพธ์ยาวกว่า บันทึกกรณีที่ไม่มีการสนับสนุนซึ่งคุณลบออกและข้อกำหนดที่ยังไม่ได้รับการแก้ไข
บทความนี้ไม่ได้อ้างเปอร์เซ็นต์การประหยัดแรงงานที่วัดได้หรือเปรียบเทียบปริมาณงานของแผนชำระเงิน ตัวเลขเหล่านั้นต้องใช้การทดลองแบบควบคุมที่มีอินพุตเทียบเท่ากัน สำหรับการตัดสินใจซื้อ ให้รวมการเปลี่ยนแปลงการบำรุงรักษาที่สมจริงหนึ่งรายการ เช่น การเพิ่มฟิลด์ที่จำเป็น เพื่อให้การประเมินครอบคลุมสปรินต์ถัดไปตลอดจนเดโมแรก
เครื่องมือ AI สำหรับการทดสอบ API: OpenAPI สู่การรันครั้งแรก
ใช้ instance ภายในเครื่องที่แยกออกจากกันของโปรเจกต์ Swagger Petstore จริง ปักหมุด commit d57941e8fe959e508796b27469b1e8bba73392dc; ข้อกำหนดของมันประกาศ OpenAPI 3.0.4 และเวอร์ชันแอปพลิเคชัน 1.0.29-SNAPSHOT อ่านไฟล์ที่ปักหมุดไว้แทนเดโมสาธารณะที่อัปเดตแยกต่างหาก (ข้อกำหนด Swagger Petstore, กันยายน 2026)
1. เตรียมบริการและบันทึกสภาพแวดล้อม รับ repository ผ่านหน้า source นั้น checkout revision ที่ปักหมุดไว้ และติดตั้ง JDK และ Maven ที่เข้ากันได้ README ของโปรเจกต์ให้คำสั่งเริ่มต้นนี้จากไดเรกทอรี repository:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty ใช้พอร์ต 8080 ตั้งค่า BASE_URL เป็น origin HTTP loopback ของคุณบนพอร์ตนั้นโดยต่อท้ายด้วย /api/v3 ยืนยันว่า /openapi.json อ่านได้เมื่อเทียบกับ base นั้นก่อนทดสอบ
การรันนี้ใช้ Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 และ jsonschema 4.26.0 บันทึกเวอร์ชันของคุณด้วย การ build จาก source จะดาวน์โหลด dependency และ Swagger UI ดังนั้น commit แอปพลิเคชันที่ปักหมุดเพียงอย่างเดียวไม่ใช่ build ที่ hermetic อย่างสมบูรณ์
2. นำเข้าข้อกำหนดที่ปักหมุดไว้ เลือก /pet, /pet/{petId} และ /pet/findByStatus เก็บ delete ไว้ใช้สำหรับการล้างข้อมูล แทนที่ตำแหน่งเซิร์ฟเวอร์สาธารณะของข้อกำหนดด้วย base ภายในเครื่องของคุณ ตรวจสอบการตั้งค่านี้ก่อนส่งคำขอเขียนใด ๆ
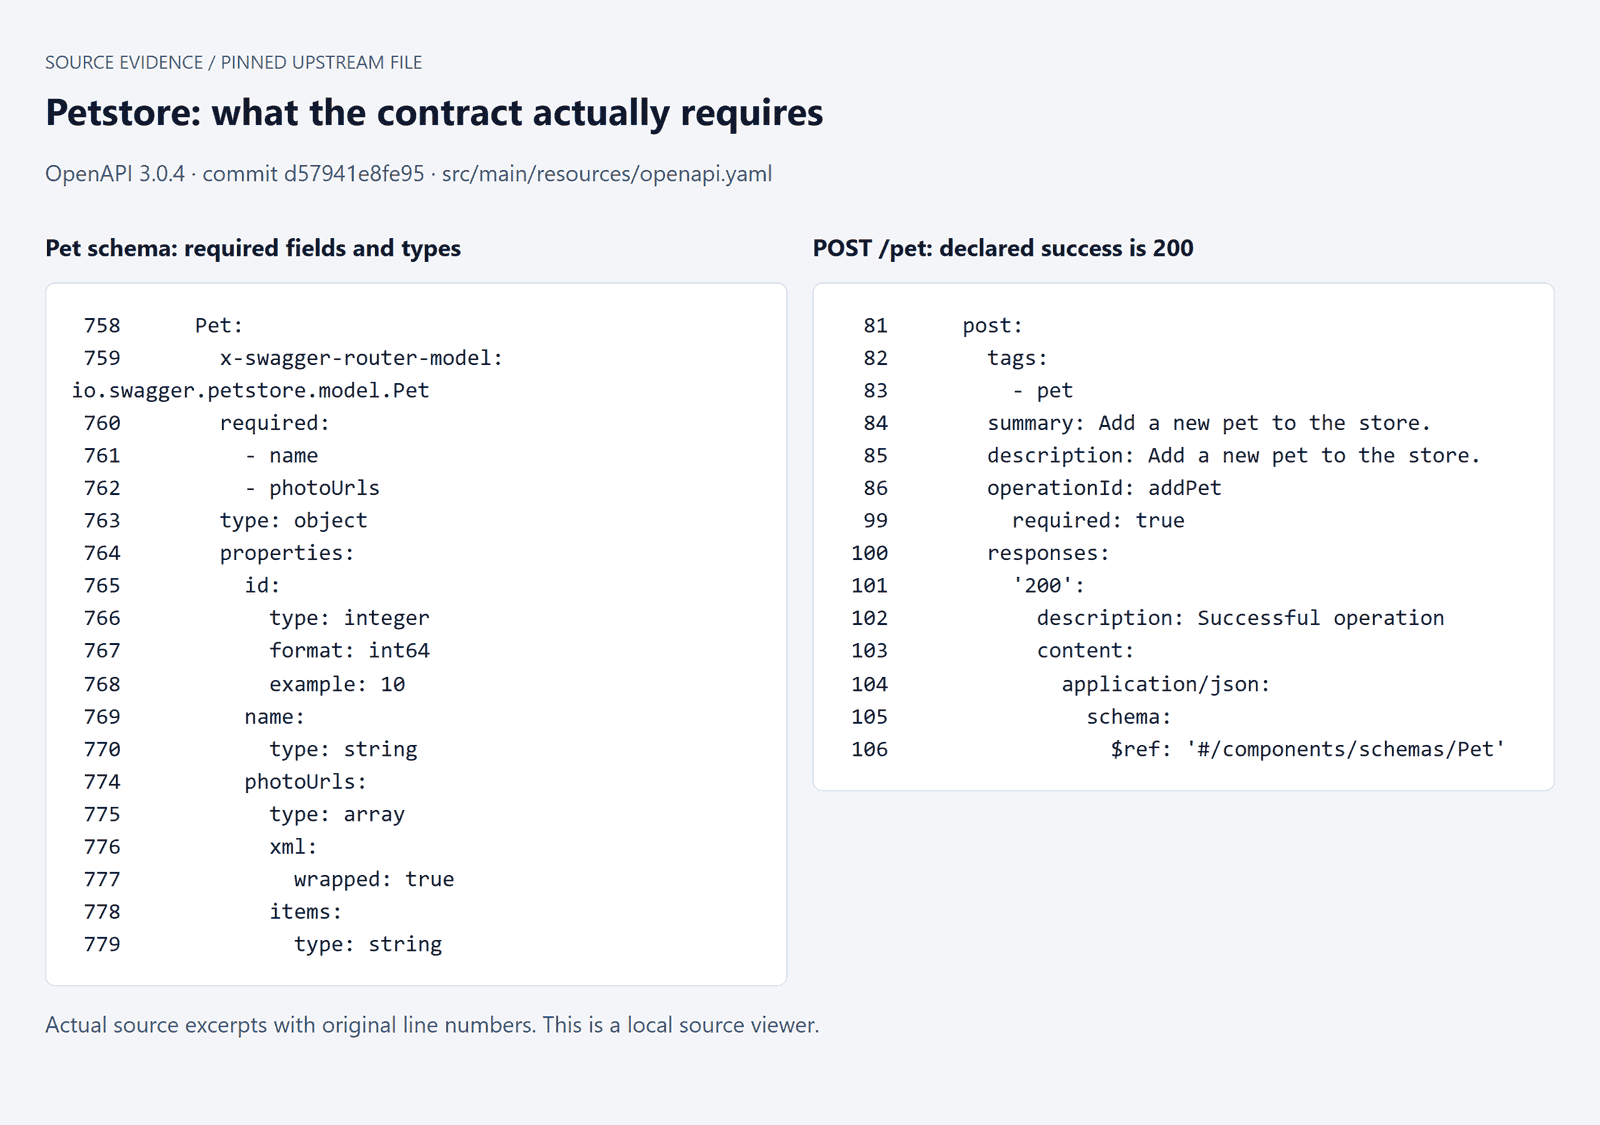 ซอร์ส OpenAPI Petstore ที่ปักหมุดซึ่งแสดงฟิลด์ที่จำเป็นและคำจำกัดความ operation ที่เลือก
ตัวอย่าง source จริงที่เรนเดอร์ในเครื่อง: Pet ต้องมี name และ photoUrls; POST /pet ประกาศ 200 สำหรับความสำเร็จ หมายเลขบรรทัดเดิมถูกเก็บไว้
3. สร้างเมทริกซ์ก่อนโค้ดที่รันได้ (Prompt A) แนบข้อกำหนดและวางพรอมป์นี้ลงในตัวสร้างที่คุณเลือก:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. ตรวจทาน oracle สำหรับแต่ละสถานการณ์ Petstore ระบุการสร้างที่สำเร็จเป็น 200 สคีมา Pet ของมันต้องการ name และ photoUrls; id มีชนิด integer แต่ไม่อยู่ในรายการที่จำเป็นนั้น ดังนั้นการตรวจสอบฟิลด์ที่หายไปและอัตลักษณ์ของ request-response จึงต้องใช้การตรวจที่แตกต่างกัน
| Operation | อินพุตหรือลำดับ | หลักฐานผลลัพธ์ที่คาดหวัง | การยืนยันที่ต้องตรวจทาน | สถานะการรัน |
|---|---|---|---|---|
| addPet, getPetById | สร้าง แล้วอ่าน ID ปัจจุบัน | เอกสารระบุ 200 และสคีมา Pet; ความคาดหวังโฟลว์ที่ชัดเจน | ตรวจสอบ body และเปรียบเทียบ ID ที่คืนมา | ผ่านในเครื่อง |
| updatePet, getPetById | เปลี่ยน name แล้วอ่านอีกครั้ง | operation การอัปเดตบวกเจตนาของ fixture ที่อนุมัติ | ID เดียวกัน, name ใหม่, สคีมาถูกต้อง | ผ่านในเครื่อง |
| findPetsByStatus | Query available หลังตั้งค่า | enum ตามเอกสารและคำตอบ array ที่สำเร็จ | status ที่คืนมาทั้งหมดตรงกัน; ID ที่สร้างมีอยู่ | ผ่านในเครื่อง |
| getPetById | path ID ที่ไม่ใช่จำนวนเต็ม | เอกสารระบุ invalid-ID 400 | status ที่แน่นอนสำหรับกรณีตามเอกสารนี้ | ผ่าน: 400 |
| findPetsByStatus | ค่า enum ที่ไม่ documented | เอกสารระบุ invalid-status 400 | status ที่แน่นอน, เก็บความไม่ตรงกันใด ๆ | ผ่าน: 400 |
| addPet | ละเว้น name ที่จำเป็น | ฟิลด์สคีมาที่จำเป็น; คำอธิบาย 400 และ 422 ไม่ได้ map ทุก variation | บันทึกพฤติกรรม; แก้ mapping ที่แน่นอนก่อน gating | คืน 200 โดยไม่มี name; เก็บความคลาดเคลื่อนไว้ |
5. สร้างและตรวจดูไฟล์รัน (Prompt B) แนบเมทริกซ์ที่อนุมัติและข้อกำหนดพร้อมพรอมป์นี้:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. รัน เก็บรักษา และล้างข้อมูล ใช้ pet ID เฉพาะการรัน จับคำตอบการสร้าง และส่ง ID ของมันไปยังคำขอภายหลัง ยืนยันการอัปเดตผ่านการอ่านใหม่ คำตอบการอัปเดตที่สำเร็จเพียงอย่างเดียวไม่ได้พิสูจน์ว่าเซิร์ฟเวอร์บันทึกการเปลี่ยนแปลงไว้จริง
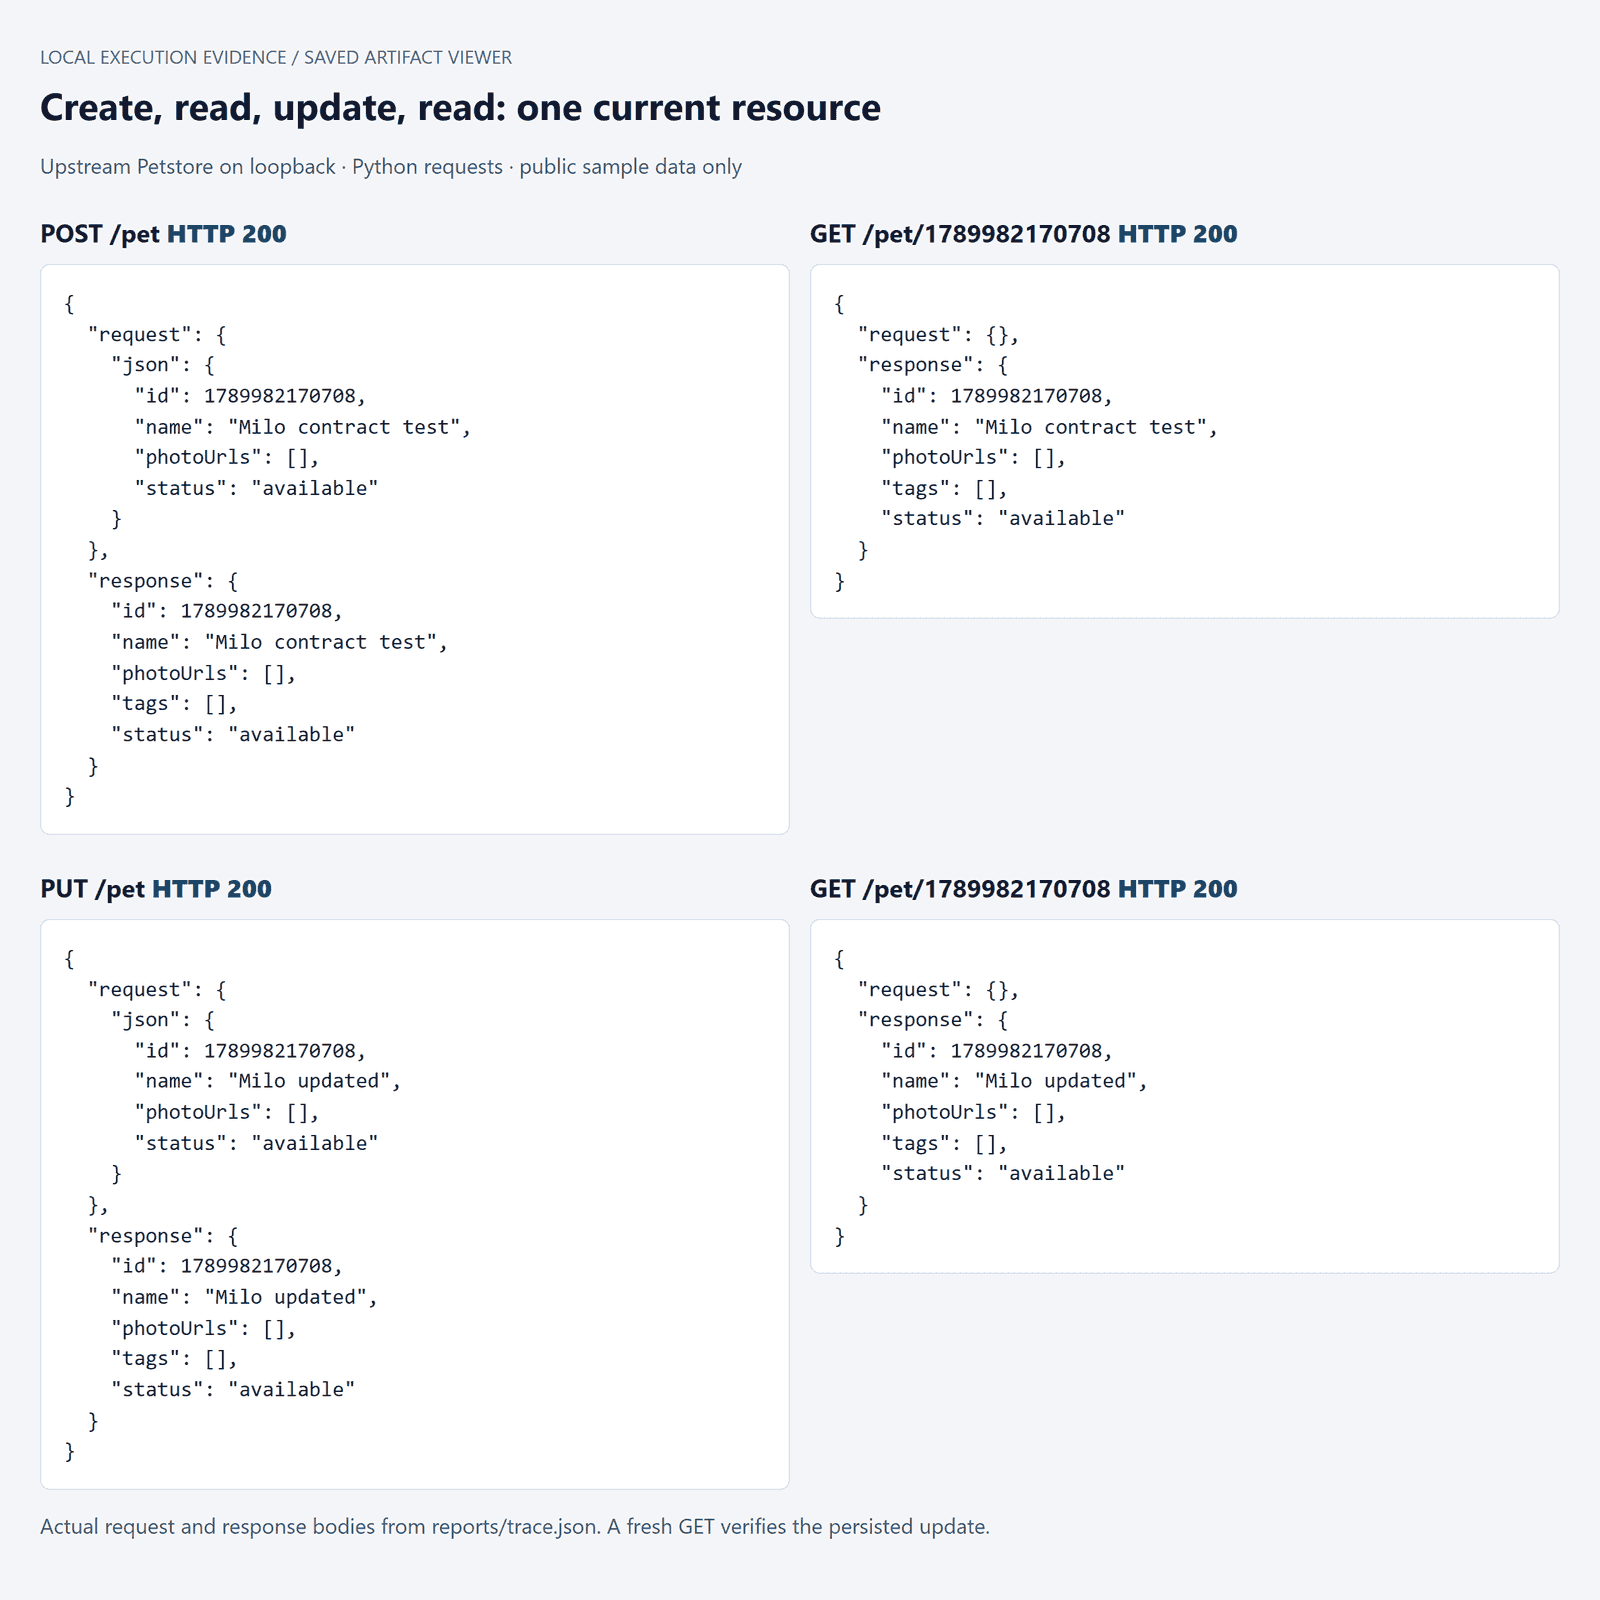 หลักฐานห่วงโซ่คำขอ Petstore ในเครื่องซึ่งแสดงการสร้าง การค้นหา การอัปเดต และการส่งต่อ ID
คำขอและคำตอบในเครื่องที่บันทึกไว้: ID เฉพาะการรันเดียวกันอยู่รอดผ่าน create, read, update และการอ่านใหม่ คำขอที่แสดงทั้ง 4 รายการคืนค่า 200
บันทึก request bodies, responses, ความล้มเหลวของการยืนยัน และผลลัพธ์การล้างข้อมูล จำกัดการลบเฉพาะ ID ที่สร้างโดยการรันนี้ เก็บคำตอบที่ไม่คาดคิดเป็นข้อค้นพบ รวมถึงกรณีที่ implementation สาธิตยอมรับอินพุตที่ไม่ถูกต้อง อย่าปรับการยืนยันเพียงเพื่อให้ได้ภาพหน้าจอสีเขียว
สิ่งที่การรันนี้พบ: ฟังก์ชันทดสอบ live 5 รายการผ่าน รวมถึงการตรวจ invalid-ID และ invalid-status ที่คืนค่า 400 การ probe ฟิลด์ name ที่หายไปแยกต่างหากคืนค่า 200 และ body ที่ไม่มี name เราเก็บความคลาดเคลื่อนของสคีมานั้นไว้นอกชุดสีเขียว; mapping ข้อผิดพลาดที่ตั้งใจไว้อย่างแน่นอนยังต้องทำให้กระจ่าง บันทึกที่สร้างทั้งสองรายการถูกลบสำเร็จ
การทดสอบในเครื่องถูกร่างขึ้นในระหว่างการรันสำหรับบทความนี้ โดยเป็นอิสระจากเครื่องมือเชิงพาณิชย์ทั้งสาม การทดสอบ live ทั้ง 5 รายการถูกเก็บไว้; ไม่มีรายการใดถูกลบหรือมีความคาดหวังผ่อนลงหลังการรัน ไม่ได้วัดเวลาตรวจทานของมนุษย์ โฟลเดอร์หลักฐานมีไฟล์ทดสอบ dependency lock คำตอบดิบ และคำแนะนำการทำซ้ำ
วิธีตรวจสอบความถูกต้องของเครื่องมือ AI สำหรับการทดสอบ API
การยืนยันที่มีประโยชน์ควรปฏิเสธคำตอบผิดที่เกี่ยวข้อง คุณสามารถทดสอบคุณสมบัตินั้นได้โดยไม่ต้องเปลี่ยนบริการที่กำลังรัน: บันทึกคำตอบที่สำเร็จจริง คัดลอกมัน และแก้ไขทีละฟิลด์โดยเจตนา สิ่งเหล่านี้คือ การกลายพันธุ์คำตอบแบบควบคุม ไม่ใช่ช่องโหว่ใน production หรือ benchmark การทดสอบการกลายพันธุ์เต็มรูปแบบ
เก็บสถานะและ body เดิมไว้ด้วยกัน ขั้นแรกให้รัน validator กับคำตอบที่ไม่แก้ไขและยืนยันว่ามันยอมรับ baseline จากนั้นสร้างสำเนาอิสระสามชุด เปลี่ยน ID เปลี่ยนชนิดของ name และลบ name ที่จำเป็น สำเนาแต่ละชุดควรล้มเหลวด้วยเหตุผลที่ตรงกับการแก้ไข
| Baseline ที่บันทึกไว้ | การแก้ไขแบบควบคุม | การตรวจที่เกี่ยวข้อง | ผลลัพธ์จริง |
|---|---|---|---|
| การค้นหา pet ปัจจุบันที่สำเร็จ | แทนที่ด้วย ID จำนวนเต็มอื่น; เก็บ status 200 | ID ที่คืนมาเท่ากับ ID ที่คาดหวังของการรันนี้ | ล้มเหลว: ID ที่คาดหวังและจริงต่างกัน |
name ชนิด string | แทน name ด้วยตัวเลข | ชนิด string ของสคีมา Pet | ล้มเหลว: 42 ไม่ใช่ string |
มี name ที่จำเป็น | ลบ name | รายการที่จำเป็นของสคีมา Pet | ล้มเหลว: ต้องมี name |
ตัวอย่าง ID เปิดเผยจุดอ่อนทั่วไป validator สคีมาสามารถยอมรับจำนวนเต็มผิดได้เพราะรูปทรงยังคงถูกต้อง การยืนยันความสัมพันธ์ให้ข้อจำกัดที่หายไป ในอีกสองตัวอย่าง การตรวจสอบสคีมาให้ข้อจำกัดที่การตรวจเฉพาะ status มองไม่เห็น
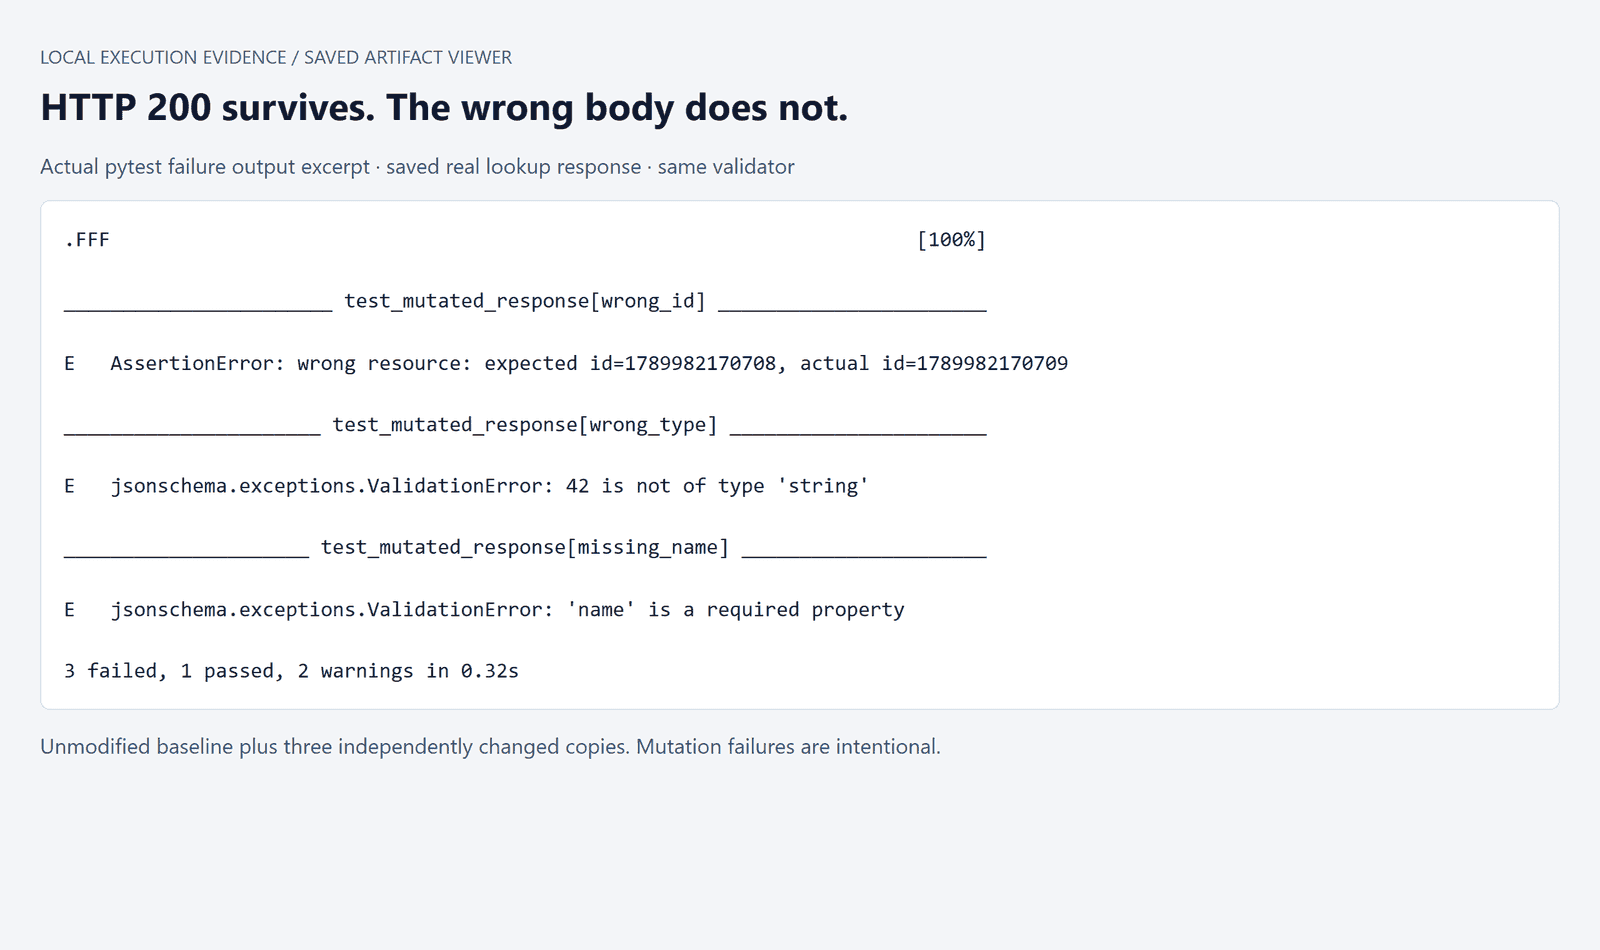 เอาต์พุตความล้มเหลวของการยืนยันจริงสำหรับการกลายพันธุ์คำตอบ Petstore แบบควบคุม
ตัวอย่างความล้มเหลว pytest จริง: คำตอบเดิมผ่าน และการกลายพันธุ์อิสระทั้ง 3 รายการล้มเหลว ความล้มเหลวเหล่านี้ถูกกระตุ้นโดยเจตนาในสำเนาที่บันทึกไว้
ในการรันนี้ baseline ที่ไม่เปลี่ยนแปลงผ่าน และสำเนาที่แก้ไข 3 จาก 3 ล้มเหลว การรันการกลายพันธุ์คืน exit code 1 ซึ่งรักษาสัญญาณความล้มเหลวไว้ validator ใช้ข้อจำกัดเชิงโครงสร้างที่เกี่ยวข้องของสคีมา Pet และการตรวจความสัมพันธ์ ID แยกต่างหาก; การสาธิตเล็ก ๆ นี้ไม่ใช่ validator ความสอดคล้อง OpenAPI ที่สมบูรณ์
สำหรับการตรวจสอบที่ทำซ้ำได้ ให้แนบไฟล์ทดสอบและข้อกำหนดที่ปักหมุดไว้กับ Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
ตรวจทานการเปลี่ยนแปลง “self-healing” ที่เสนอด้วยความระมัดระวังเป็นพิเศษ การแทนที่ 400 ที่คาดหวังด้วย 200 อาจซ่อน regression การเปลี่ยนแปลงสัญญาที่ชอบด้วยเหตุผลต้องมีเอกสารอ้างอิงข้อกำหนดและการเปลี่ยนแปลงการทดสอบที่ตรวจทานแล้ว คำตอบที่สังเกตได้เป็นหลักฐานสำหรับการสืบสวน ไม่ใช่สิทธิ์อัตโนมัติในการนิยามความถูกต้องใหม่
แยกหมวดหมู่ความล้มเหลวก่อนขอให้ AI แก้ไข timeout อาจบ่งชี้สภาพแวดล้อมใช้งานไม่ได้ ความล้มเหลวในการค้นหาอาจมาจาก fixture ที่เสีย import error เป็นของโค้ดทดสอบ ความไม่ตรงกันที่ทำซ้ำได้กับสัญญาที่ตกลงกันอาจเป็นของผลิตภัณฑ์ เก็บบริบทให้เพียงพอเพื่อแยกแยะสิ่งเหล่านี้
รายงานตัวหารอย่างซื่อสัตย์ การตรวจจับการเปลี่ยนแปลงคำตอบที่เลือกสามรายการพิสูจน์ความอ่อนไหวต่อการเปลี่ยนแปลงทั้งสามนั้น ไม่ได้พิสูจน์ความครอบคลุมของ endpoint, ความครอบคลุมของโค้ด, ความครอบคลุมด้านความปลอดภัย หรืออัตราการตรวจจับข้อบกพร่องทั่วไป เช่นเดียวกัน จำนวนการทดสอบที่มากบอกได้น้อยเกี่ยวกับสถานการณ์ซ้ำหรือความแข็งแกร่งของการยืนยัน
การยืนยันตัวตนและการอนุญาตสมควรได้รับการทดสอบแยกต่างหากในแอปพลิเคชันที่เหมาะสม: ข้อมูลรับรองที่หายไป ข้อมูลรับรองที่หมดอายุ และการเข้าถึง resource ของผู้ใช้อื่น พฤติกรรมการสาธิตของ Petstore ไม่สามารถพิสูจน์ว่าการควบคุมการเข้าถึงใน production ของคุณทำงานได้
เครื่องมือ AI สำหรับการทดสอบ API ใน CI/CD
เมื่อผู้ตรวจทานยอมรับชุดทดสอบแล้ว ให้คอมมิตเวอร์ชันนั้นอย่างแน่นอน การ build ควรรันความคาดหวังที่รู้จักกับแอปพลิเคชันผู้สมัคร การสร้างการทดสอบใหม่ระหว่างทุก build เพิ่มองค์ประกอบที่เปลี่ยนแปลงอีกอย่างและทำให้ความล้มเหลวยากต่อการทำซ้ำ
ปักหมุด runner, dependencies, fixtures และ specification เก็บ dependency lock ไว้ข้าง ๆ การทดสอบ และเก็บ revision ของแอปพลิเคชันไว้ในรายงาน แก้ไข secrets จากสภาพแวดล้อม CI เก็บไว้ไม่ให้อยู่ในไฟล์ที่สร้างขึ้น และตรวจสอบว่าบันทึกความล้มเหลวไม่เปิดเผย secrets เหล่านั้น
กับ pytest รูปแบบการรายงานพื้นฐานนั้นง่าย:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
จัดหา BASE_URL ผ่านสภาพแวดล้อมของงาน เริ่มบริการภายในเครื่องใน lifecycle ของงาน รอให้พร้อม แล้วรันชุดทดสอบ เก็บรายงานและ log ของบริการเสมอ แม้ในกรณีล้มเหลว จบด้วยการหยุดบริการของงานเองและล้างข้อมูล; หลีกเลี่ยงคำสั่งล้างข้อมูลทั้ง process บน agent ที่ใช้ร่วมกัน
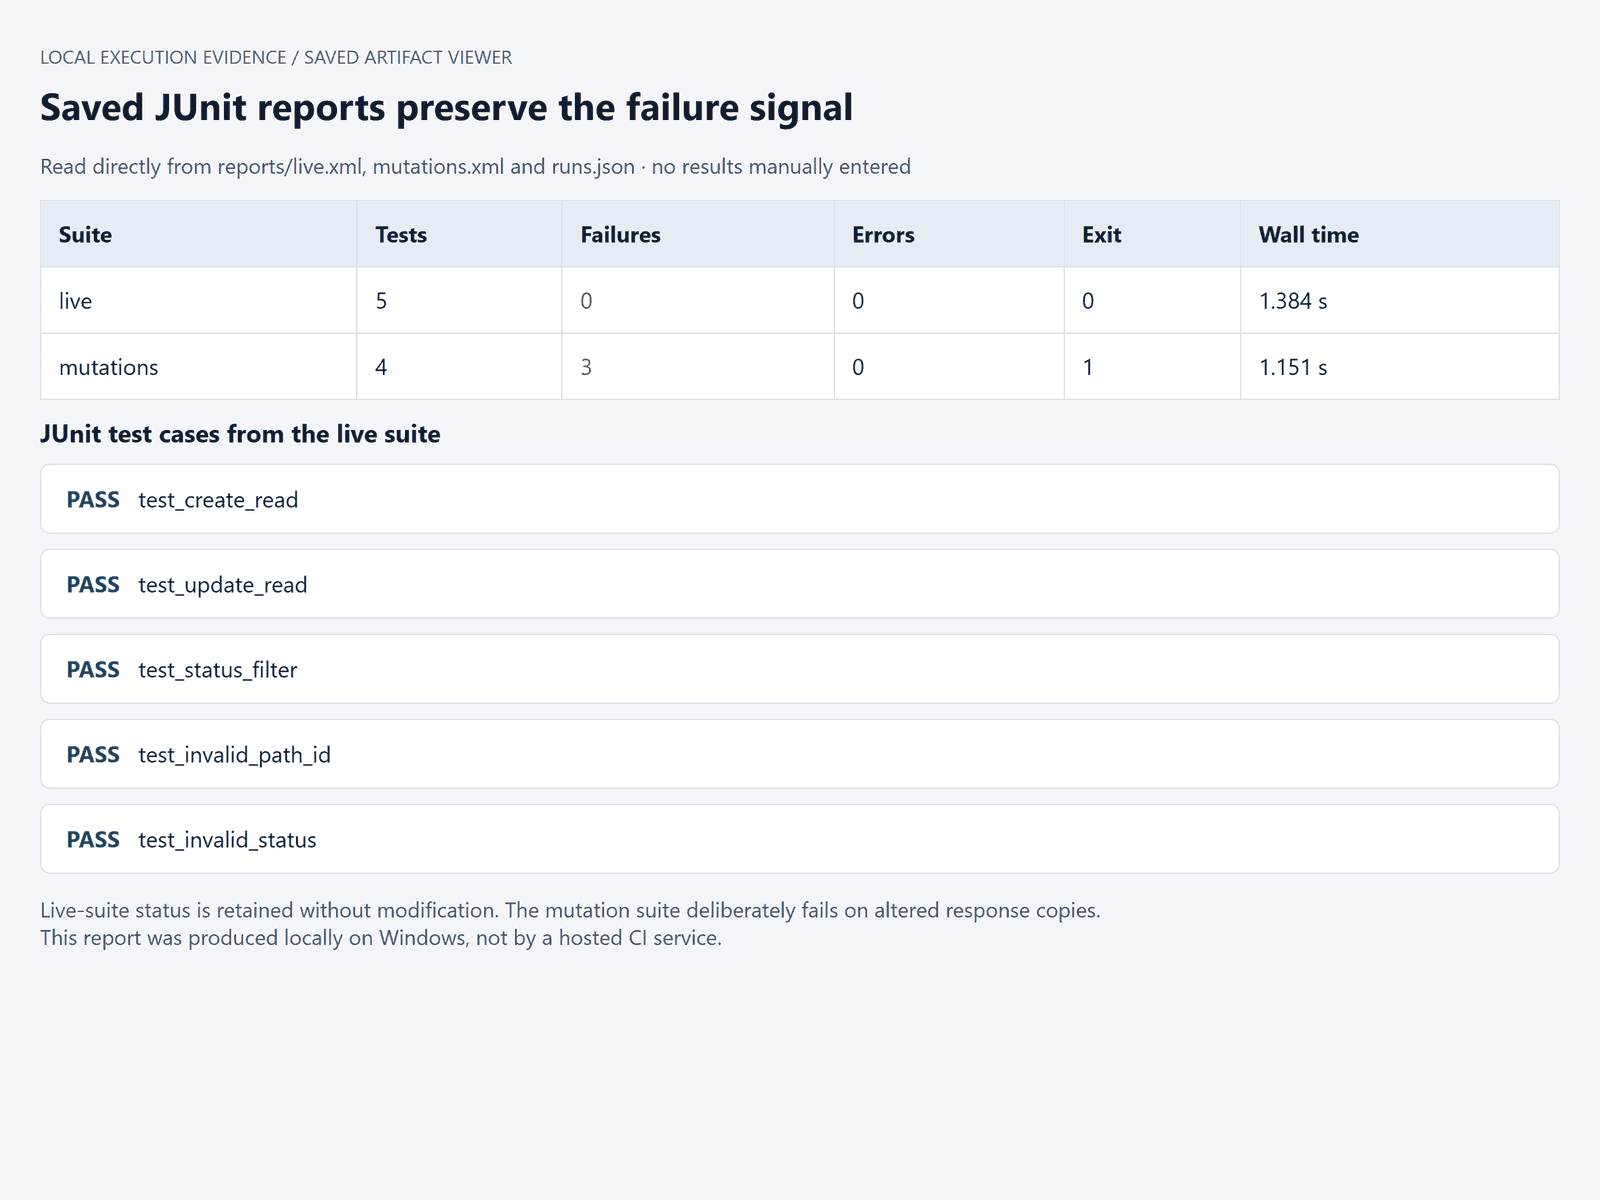 รายงาน local pytest JUnit ที่มีผล live-contract และ assertion-check แยกกันsActual local
ผลลัพธ์ JUnit: การทดสอบ live 5 รายการผ่าน; ชุดสำเนาแบบควบคุมมี baseline ที่ผ่าน 1 รายการและความล้มเหลวโดยเจตนา 3 รายการ ไม่ได้อ้างว่ามีการรัน CI แบบโฮสต์
เวลา wall time ที่วัดได้ รวมการเริ่ม process Python คือ 1.384 วินาทีสำหรับชุด live และ 1.151 วินาทีสำหรับชุดสำเนาแบบควบคุม สิ่งเหล่านี้ไม่รวมการ build/เริ่มบริการ การติดตั้ง dependency การร่าง และการตรวจทาน ไฟล์ JUnit และ log ฉบับไม่ตัดทอนถูกบันทึกแยกกัน
ทดสอบเส้นทางความล้มเหลวก่อนพึ่งพา gate การยืนยันที่ล้มเหลวต้องสร้าง exit code ของงานที่ล้มเหลว การลองใหม่ควรมีขอบเขตและมีเหตุผลสำหรับปัญหาชั่วคราวของโครงสร้างพื้นฐานที่ทราบ; การลองใหม่ซ้ำ ๆ ที่สุดท้ายซ่อนความล้มเหลวของผลิตภัณฑ์ทำให้ gate ให้ข้อมูลน้อยลง
จัดการความล้มเหลวของการล้างข้อมูลอย่างชัดเจน เก็บความล้มเหลวของการยืนยันหลักให้มองเห็น บันทึกว่า resource ใดยังเหลืออยู่ และให้ teardown รายงานปัญหาของตัวเอง งานแบบขนานต้องมีตัวระบุหรือ namespace แยกกัน การทดสอบที่ผ่านเมื่ออยู่ลำพังแต่อ่านข้อมูลของงานอื่นยังไม่พร้อมสำหรับการใช้งานแบบไม่มีคนดูแล
หากคุณมี pytest อยู่แล้ว คุณสามารถเลือกโมเดลสำหรับร่างแยกต่างหากได้ Atlas Cloud เหมาะกับบทบาทที่แคบกว่านี้: ชั้นโมเดลสำหรับเวิร์กโฟลว์กำหนดเองซึ่งมีการรันและการรายงานอยู่แล้ว ไม่ได้นำเสนอที่นี่เป็นแพลตฟอร์มทดสอบ API แบบเต็มหรือแบ็กเอนด์เนทีฟสำหรับผลิตภัณฑ์ทั้งสามข้างต้น
สำหรับการประเมินนั้น ให้เปิด DeepSeek V4.1 Flash, model ID deepseek-ai/deepseek-v4.1-flash, และให้ข้อกำหนดสาธารณะและเมทริกซ์ที่ตรวจทานแล้วชุดเดียวกับที่ใช้ในเครื่อง ใช้ Prompt B แล้วบันทึกร่างที่คืนมาแยกจาก การทดสอบที่ตรวจทานแล้ว เปรียบเทียบสมมติฐานของมันกับสัญญาก่อนรันสิ่งใด
หากอินเทอร์เฟซเปิดให้ใช้ temperature 0.2 เป็นค่าตั้งต้นสำหรับการร่าง ไม่ใช่การรับประกันความแน่นอน ตรวจสอบขีดจำกัดเอาต์พุตที่มีเทียบกับขนาดชุดทดสอบของคุณ ดูแคตตาล็อกโมเดลปัจจุบัน สำหรับราคาโทเคน แทนการจัดงบจากบทความเก่า
การแบ่งงานยังคงชัดเจน: โมเดลเสนอโค้ด ผู้ตรวจทานอนุมัติความคาดหวัง และ runner สร้างผลลัพธ์ gate การเข้าถึงสภาพแวดล้อมทดสอบทำให้ไม่สามารถรัน Atlas ให้เสร็จสมบูรณ์สำหรับบทความนี้ ดังนั้นนี่คือสูตรการประเมิน ไม่ใช่ผลลัพธ์โมเดลที่วัดได้ คุณสามารถประเมินเส้นทางนี้ได้โดยไม่ต้องย้าย runner ทดสอบที่ทำงานอยู่หรือมอบความรับผิดชอบในการรันให้โมเดลแชท
การเลือกเครื่องมือ AI สำหรับการทดสอบ API สำหรับทีมของคุณ
เลือกการประเมินที่เล็กที่สุดซึ่งสามารถเปลี่ยนการตัดสินใจของคุณได้ ใช้เวิร์กโฟลว์ที่เชื่อมต่อกันหนึ่งรายการ กรณีเชิงลบตามเอกสารหนึ่งรายการ และคำตอบผิดแบบควบคุมสองสามรายการ ทำให้อินพุตเทียบเท่ากันในผู้สมัครแต่ละราย ประสบการณ์ onboarding ที่ขัดเกลาไม่ควรมีน้ำหนักมากกว่าการทดสอบที่ไม่สามารถระบุ resource ผิดได้
สำหรับเวิร์กโฟลว์ collection ที่เติบโตเต็มที่ เริ่มจากการประเมินคุณสมบัติ AI ใน workspace นั้น การตั้งค่าสภาพแวดล้อมที่มีอยู่และ dependency ของคำขอเป็นบริบทที่มีค่า วัดว่าการเปลี่ยนแปลงที่สร้างขึ้นช่วยประหยัดงานตรวจทานโดยไม่นำสมมติฐานที่เปราะบางเข้ามาหรือไม่
สำหรับทีมที่มีข้อกำหนดที่มั่นคงและมีงานเขียนค้างอยู่ ให้ประเมินการสร้างจาก spec สนใจว่าเกิดอะไรขึ้นเมื่อข้อกำหนดไม่ครบถ้วน ตัวสร้างที่ตั้งธงความคาดหวังที่หายไปอย่างชัดเจนตรวจทานได้ง่ายกว่าตัวที่คิดค้นความคาดหวังเหล่านั้นอย่างมั่นใจ
สำหรับแอปพลิเคชันที่ความล้มเหลวขึ้นอยู่กับพฤติกรรมต้นทาง ให้ประเมินการบันทึกและเล่นซ้ำ ตรวจดู baseline ที่จับไว้และการสนับสนุน dependency ก่อนลงทุนกับการบันทึกขนาดใหญ่ ตัดสินว่าฟิลด์ที่เปลี่ยนแปลงได้ใดอาจแตกต่าง และความสัมพันธ์ใดต้องคงอยู่
สำหรับทีมที่มี runner ที่เสถียร ให้ประเมินโมเดลอิสระสำหรับการร่างและตรวจทาน คุณคงรูปแบบการรันที่คุณรู้อยู่แล้ว แต่คุณก็เป็นเจ้าของการผสาน การออกแบบ fixture และการบำรุงรักษาด้วย รวมความเป็นเจ้าของนั้นไว้ในการคำนวณต้นทุน
ก่อนจ่ายเงินสำหรับเครื่องมือ AI สำหรับการทดสอบ API ให้กำหนดให้มีการสาธิตที่เป็นรูปธรรมห้าประการ:
- ชุดทดสอบที่ตรวจทานแล้วรันกับสภาพแวดล้อมที่คุณตั้งใจ
- ข้อผิดพลาดแบบควบคุมที่เกี่ยวข้องทำให้การยืนยันที่เหมาะสมล้มเหลว
- การทดสอบและรายงานที่มีประโยชน์สามารถเก็บไว้ในรูปแบบที่ยอมรับได้
- การรันซ้ำ รวมถึงการรัน CI รักษาการแยกออกจากกันและสัญญาณความล้มเหลว
- ค่าใช้จ่ายด้านการสร้าง การรัน และการบำรุงรักษาเหมาะสมกับงบประมาณของทีม
มอบหมายให้ใครสักคนดูแลชุดทดสอบที่ยอมรับแล้ว การเปลี่ยนแปลงข้อกำหนดควรกระตุ้นการตรวจทานการยืนยัน fixture และผู้บริโภคที่ได้รับผลกระทบ เก็บหลักฐานความล้มเหลวเดิมไว้จนกว่าจะเข้าใจการเปลี่ยนแปลง สิ่งนี้ทำให้การประเมินรีลีสครั้งถัดไปง่ายขึ้นและให้เหตุผลกับทีมในการเชื่อถือรายงานสีเขียว
คำถามที่พบบ่อย
ฉันควรใช้เครื่องมือ AI ตัวใดสำหรับการทดสอบ API?
เริ่มจากอินพุตที่มีอยู่ของคุณ ประเมิน Postman Agent Mode สำหรับ collection ที่ตั้งไว้แล้ว, KushoAI สำหรับการสร้างที่นำโดยข้อกำหนด และ Keploy สำหรับเส้นทางการสร้างโฟลว์และการบันทึกที่แตกต่าง หากทีมของคุณดูแล pytest หรือ runner อื่นอยู่แล้ว โมเดลสำหรับร่างแยกต่างหากอาจเหมาะ ใช้เวิร์กโฟลว์ขนาดเล็กเดียวกันเพื่อประเมินการยืนยัน การรัน และความพยายามตรวจทานของผู้สมัครแต่ละราย
มีเครื่องมือ AI ฟรีสำหรับการทดสอบ API หรือไม่?
มีไคลเอนต์ฟรี เครื่องมือทดสอบโอเพนซอร์ส และสิทธิ์ใช้ AI แบบจำกัด สิ่งเหล่านี้ครอบคลุมความต้องการที่แตกต่างกัน แผนฟรีของ Postman ระบุ 50 AI credits ต่อเดือน ณ วันที่ 21 กันยายน 2026; นั่นไม่ใช่จำนวนการทดสอบ ตรวจสอบว่าการส่งออก ระบบอัตโนมัติ การรายงาน และคุณสมบัติการทำงานร่วมกันที่คุณต้องการรวมอยู่หรือไม่ก่อนมองว่าการทดลองแบบอินเทอร์แอกทีฟเป็นโซลูชัน CI ฟรี
AI สามารถสร้างการทดสอบ API จากข้อกำหนด OpenAPI ได้หรือไม่?
ได้ ตัวสร้างสามารถใช้ operations, schemas, parameters และคำจำกัดความคำตอบเพื่อเสนอการทดสอบ ข้อกำหนดอาจยังละเว้นกฎทางธุรกิจหรือทิ้ง mapping ข้อผิดพลาดให้กำกวม ให้ความคาดหวังที่อนุมัติและตรวจทานผลลัพธ์ ในตัวอย่าง Petstore ที่ปักหมุด การสร้างที่สำเร็จถูกระบุเป็น 200 ซึ่งแสดงให้เห็นว่าแนวทาง REST ที่คุ้นเคยไม่สามารถแทนที่สัญญาจริงได้
ฉันจะรู้ได้อย่างไรว่าการยืนยันที่สร้างโดย AI มีประโยชน์?
ตรวจสอบสามสิ่ง: ข้อจำกัดสคีมาตามเอกสาร ความสัมพันธ์ระหว่างคำขอและคำตอบ และความอ่อนไหวต่อข้อมูลที่ไม่ถูกต้องโดยเจตนา บันทึกคำตอบจริง แก้ไขคุณสมบัติที่เกี่ยวข้องหนึ่งรายการ และรัน validator เดิมซ้ำ เก็บข้อความความล้มเหลว สิ่งนี้ให้หลักฐานที่แคบและทำซ้ำได้เกี่ยวกับการยืนยันเหล่านั้น ในขณะที่ทิ้งคำถามเรื่องความครอบคลุมที่กว้างขึ้นและความปลอดภัยไว้สำหรับการทดสอบแยกต่างหาก
ฉันสามารถรันการทดสอบ API ที่สร้างโดย AI ใน CI/CD ได้หรือไม่?
ได้ เมื่อรูปแบบที่สร้าง runner สภาพแวดล้อม และแผนสนับสนุนเส้นทางนั้น คอมมิตการทดสอบที่ตรวจทานแล้ว ติดตั้ง dependency ที่ปักหมุด ใช้ fixture ที่แยกออกจากกัน และส่งออกรายงานแบบมีโครงสร้าง เช่น JUnit ยืนยันว่าความล้มเหลวคืน exit code ที่ไม่เป็นศูนย์ การรันในเครื่องที่สำเร็จเตรียมชุดทดสอบสำหรับ CI; ไม่ได้พิสูจน์ว่าไปป์ไลน์แบบโฮสต์ได้รันแล้ว
AI สามารถแทนที่การทดสอบ API ด้วยมือได้หรือไม่?
AI สามารถลดการร่างซ้ำ ๆ และช่วยผู้ตรวจทานค้นหาการยืนยันที่อ่อนแอ ผู้คนยังคงตัดสินพฤติกรรมที่ตั้งใจ สืบสวนความล้มเหลวที่กำกวม และสำรวจความเสี่ยงนอกเหนือจากตัวอย่างที่ให้มา ใช้เครื่องมือ AI สำหรับการทดสอบ API เพื่อสร้าง test asset ที่ตรวจทานได้ จากนั้นตัดสินโดยหลักฐานที่ทำซ้ำได้ ชุดทดสอบที่เล็กกว่าซึ่งจับข้อผิดพลาดที่มีความหมายได้นั้นน่าเชื่อถือกว่าการรวบรวมการตรวจสีเขียวที่อธิบายไม่ได้


