

โค้ดดูเสร็จแล้ว จากนั้นการทดสอบก็ล้มเหลว การแก้ไขไปเปลี่ยนอินเทอร์เฟซ แล้วคำขออื่นก็เริ่มทำงาน การเลือก best ai api for coding ที่ดีที่สุดหมายถึงการหาโมเดลและ endpoint ที่ทำงานประเภทของคุณให้เสร็จภายในงบประมาณที่ยอมรับได้
เริ่มต้นด้วย Claude, GPT หรือ Gemini เป็นตัวเลือกอ้างอิง เปรียบเทียบ DeepSeek, Qwen และ Kimi บนงานเดียวกันหากคุณต้องการตัวเลือกการ deploy และการใช้จ่ายทางเลือก สำหรับการดีบัก ให้จัดลำดับความสำคัญกับการทดสอบ regression สำหรับการ refactor ให้ตรวจสอบ diff สำหรับ coding agent ให้ตรวจสอบ tool loop ทั้งหมดก่อนเปรียบเทียบราคา token
ความหงุดหงิดนั้นวัดผลได้ ในแบบสำรวจ Stack Overflow Developer Survey ปี 2025 ผู้ตอบ 66% ของคำถามเรื่องความหงุดหงิดรายงานว่าเจอโซลูชัน AI ที่เกือบถูกต้อง ส่วน 45% รายงานว่าใช้เวลาในการดีบักโค้ดที่สร้างขึ้นมากขึ้น นี่คือผลสำรวจ ไม่ใช่การประเมินโมเดลปี 2026 (Stack Overflow Developer Survey, 2025)
ประเด็นสำคัญ
- เลือก API และ agent แยกจากกัน
- คัดตัวเลือกตามงานและฟีเจอร์ endpoint ที่ต้องการ
- เก็บคำตอบแรกและตัดสินเทียบกับการทดสอบยอมรับที่กำหนดไว้
- รวมความพยายามที่ล้มเหลวและการซ่อมแซมไว้ในการคำนวณต้นทุน
คู่มือนี้ให้ shortlist, งานประเมินสามงานที่คัดลอกได้ และแบบคำนวณต้นทุน งานวิจัยได้รับการตรวจสอบเมื่อวันที่ 21 กันยายน 2026 ความพร้อมใช้งานของโมเดล ความสามารถที่ระบุไว้ในเอกสาร และผลลัพธ์ที่วัดได้เป็นหมวดหมู่หลักฐานที่แยกจากกันตลอดทั้งบทความ
Best AI API for Coding: Shortlist
เริ่มต้นด้วยสองตัวเลือก: ตัวหนึ่งที่เข้ากับแอปพลิเคชันปัจจุบันของคุณ และอีกตัวเป็นทางเลือก ใช้หกตระกูลนี้เพื่อสร้างคู่เริ่มต้นนั้น
ตารางนี้เสนอการทดสอบ โดยไม่ได้อ้างว่ามีประสิทธิภาพเชิงเปรียบเทียบ การเข้าถึงขึ้นอยู่กับบัญชี ภูมิภาค โควตา และ endpoint ของคุณ การระบุในเอกสารไม่ได้ยืนยันว่าข้อมูลรับรองของคุณสามารถเรียกใช้ได้
| โมเดลและ ID ที่เฉพาะเจาะจง | เส้นทางการเข้าถึง | งานที่ควรประเมิน | ขอบเขตการตัดสินใจหลัก | หลักฐาน endpoint | ตรวจสอบราคา |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | การแก้ไขไฟล์หลายไฟล์แบบมีข้อจำกัด | ตรวจสอบการควบคุม client และ reasoning | ภาพรวมโมเดล Claude Platform; ยังไม่ได้ทดสอบการเข้าถึงบัญชี | ไม่ได้ระบุราคา |
GPT-6 Astra, gpt-6-astra | OpenAI API | งานเขียนโค้ดแบบหลายเงื่อนไข | ตรวจสอบ route และ tools | เอกสารโมเดล OpenAI; ยังไม่ได้ทดสอบการเข้าถึงบัญชี | ไม่ได้ระบุราคา |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | การสร้างและรีวิวแบบอินเทอร์แอกทีฟ | ตรวจสอบ latency และโปรโตคอล | ไดเรกทอรีโมเดล Google AI; ยังไม่ได้ทดสอบการเข้าถึงบัญชี | ไม่ได้ระบุราคา |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud model route | การแก้ไขตัวเลข; การทดลอง context | แยกเวอร์ชัน 0813 ออกต่างหาก | ตรวจสอบหน้าตัวโมเดลแล้ว; ยังไม่ได้ทดสอบฟีเจอร์รันไทม์ | 21 กันยายน 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Atlas Cloud model route | การ refactor; อินเทอร์เฟซที่สมบูรณ์ในตัวเอง | เวอร์ชันที่ระบุ; ไม่ใช่ตัวล่าสุด | ตรวจสอบหน้าตัวโมเดลแล้ว; ยังไม่ได้ทดสอบฟีเจอร์รันไทม์ | 21 กันยายน 2026 |
Kimi K3, moonshotai/kimi-k3 | Atlas Cloud model route | ทั้งสามงาน; อินเทอร์เฟซ CSV | ตรวจสอบข้อจำกัด output และ completion | ตรวจสอบหน้าตัวโมเดลแล้ว; ยังไม่ได้ทดสอบฟีเจอร์รันไทม์ | 21 กันยายน 2026 |
Claude, GPT และ Gemini เป็นตัวเลือกอ้างอิงที่มีประโยชน์ ไดเรกทอรีโมเดลอย่างเป็นทางการระบุเวอร์ชันด้านบน ใช้ผู้ให้บริการที่คุณเข้าใจอยู่แล้วเป็น baseline จากนั้นทดสอบว่าทางเลือกช่วยลดต้นทุนงานที่ยอมรับหรืองานผสานรวมหรือไม่ อย่าถือว่าพฤติกรรมของ assistant สำหรับผู้บริโภคเป็นผลลัพธ์ API ที่สอดคล้องกัน
ไดเรกทอรีโมเดลของ OpenAI แสดงรายการ GPT-6 Astra พร้อมกับตระกูล GPT-5.6 นั่นเป็นการยืนยันตัวเลือกปัจจุบัน ไม่ใช่การชนะด้านการเขียนโค้ดเหนือแถวอื่นๆ ตารางนี้จงใจหลีกเลี่ยงการดึง model ID เก่าจากหน้าเปรียบเทียบที่ไม่มีวันที่ (ไดเรกทอรีโมเดล OpenAI, เข้าถึงกันยายน 2026)
DeepSeek ได้ที่ทางในฐานะตระกูลโมเดลแยกต่างหากที่ควรตรวจสอบ ทดสอบว่ามันแก้บั๊กเฉพาะเจาะจงโดยไม่ขยายขอบเขตการเปลี่ยนแปลงหรือไม่ เลือกตัวเลือกอื่นหาก route ที่ deploy อยู่ไม่สามารถตอบสนองรูปแบบการตอบกลับที่ต้องการ พฤติกรรมของ tool หรือเพดาน latency โดยไม่คำนึงถึงชื่อเสียงทั่วไปของโมเดล
ประเมิน Qwen ตามเวอร์ชัน การ deploy 122B A10B ที่ระบุไว้ให้ข้อมูลอ้างอิงราคาที่เป็นรูปธรรม รันการตรวจสอบการแยกวิเคราะห์และเบราว์เซอร์ก่อนจะสรุปเรื่องคุณค่า ตัวเลข context จาก Qwen เวอร์ชันอื่นไม่สามารถนำมาใช้กับโมเดลนี้ได้
Kimi เป็นตัวเลือกการตั้งค่าที่ทำเป็นตัวอย่างไว้ หน้าสาธารณะของมันระบุ model ID การตรวจสอบการตั้งค่าเป็นไปได้ แต่การสร้างที่สำเร็จยังไม่ได้รับการยืนยัน ประเมินผลลัพธ์ที่เสร็จสมบูรณ์เทียบกับข้อจำกัดเดียวกับตัวเลือกอื่นๆ
Atlas Cloud อยู่ในชั้นการเข้าถึงในการเปรียบเทียบนี้ ไม่ใช่โมเดลที่เจ็ด ความเกี่ยวข้องของมันเป็นเชิงปฏิบัติ: คุณสามารถตรวจสอบหน้าตัวโมเดลตัวเลือกหลายตัวและเปรียบเทียบข้อกำหนดการผสานรวมก่อนตัดสินใจใช้ workflow
สำหรับ open weights ให้ตรวจสอบใบอนุญาตการเผยแพร่และชิ้นงานการ deploy ที่แน่นอน การ inference แบบโฮสต์มีข้อกำหนดการบริการและต้นทุนการดำเนินงานแยกต่างหาก ตระกูลโมเดลเพียงอย่างเดียวไม่สามารถยืนยันสิ่งเหล่านี้ได้
อธิบาย Coding API, Model และ Agent
โมเดลสร้างเนื้อหาตอบสนองต่ออินพุต API กำหนดว่าแอปพลิเคชันของคุณส่งอินพุตนั้นและรับผลลัพธ์อย่างไร coding agent จัดระเบียบงานโดยรอบ: อ่านไฟล์ เรียกใช้ tool นำการแก้ไขไปใช้ รันการทดสอบ และตัดสินใจว่าจะดำเนินการต่อหรือไม่
สามชั้นนี้สามารถล้มเหลวได้อย่างอิสระ โมเดลอาจเสนอ patch ที่ถูกต้องในขณะที่ agent เขียนมันไปยังไฟล์ผิด API อาจส่งคืน JSON ที่ถูกต้องในขณะที่แอปพลิเคชันเพิกเฉยต่อการเรียก tool agent ที่มีความสามารถอาจหยุดชะงักเพราะ endpoint ที่เลือกปฏิเสธพารามิเตอร์
สมมติว่าคุณส่ง handler และขอ ID parser API สร้างโค้ดพื้นฐานจะส่งคืนข้อความที่มีโค้ด โปรแกรมของคุณยังคงต้องดึงโค้ดนั้นออกมา วางใน workspace ที่เหมาะสม และรันการทดสอบ การตอบกลับ HTTP ที่สำเร็จยืนยันการส่งมอบ ไม่ใช่ความถูกต้อง
agent สามารถทำงานเหล่านั้นโดยอัตโนมัติได้ก็ต่อเมื่อคุณจัดหา tool และสิทธิ์ให้ มันยังต้องการเงื่อนไขการหยุดด้วย หากไม่มี มันอาจแก้ไขฟังก์ชันที่ยอมรับได้แล้วซ้ำแล้วซ้ำอีก ขยายงาน หรือใช้คำขอเพิ่มเติมเพื่อพยายามปรับปรุงรายละเอียดที่ไม่เกี่ยวข้อง
แยกบรรทัดงบประมาณสามบรรทัดออกจากกัน:
- การสมัครใช้ tool: แอปพลิเคชัน การผสานรวมกับ editor หรือบริการ agent ที่คุณใช้
- การใช้ inference: คำขอไปยัง endpoint โมเดลที่เลือก ภายใต้ข้อกำหนดการเรียกเก็บเงินของมัน
- สภาพแวดล้อมการทำงาน: container, test runner, ที่จัดเก็บ และโครงสร้างพื้นฐานอื่นๆ
ผลิตภัณฑ์บางอย่างรวมส่วนต่างๆ ของ stack นี้เข้าด้วยกัน ส่วนอื่นๆ คาดหวังให้คุณนำข้อมูลรับรองมาเอง ตรวจสอบแผนเฉพาะก่อนสันนิษฐานว่าการสมัคร editor รวมทราฟฟิก API ที่กำหนดเองจากแอปพลิเคชันของคุณ
ความเข้ากันได้ของโปรโตคอลก็มีขอบเขตเช่นกัน บริการที่ยอมรับอาร์เรย์ messages ที่คุ้นเคยอาจยังคงแสดงพฤติกรรม tool, เหตุการณ์ streaming, ข้อจำกัด context หรือการควบคุม reasoning ที่แตกต่างกัน การคัดลอก base URL ไม่สามารถยืนยันการรองรับทุกฟีเจอร์ในระบบนิเวศของผู้ให้บริการรายอื่นได้
ทำแผนที่แอปพลิเคชัน, agent, endpoint, โมเดล, tool และการทดสอบ ระบุส่วนประกอบที่คิดค่าใช้จ่ายและผู้รับผิดชอบในแต่ละขั้นตอนก่อนเปลี่ยนโมเดล
Best AI API for Coding: 7 การตรวจสอบคัดเลือก
1. ความถูกต้องเชิงฟังก์ชันและพฤติกรรม regression เขียนผลลัพธ์ที่คาดหวังก่อนขอโค้ด ฟังก์ชันราคาที่จัดการจำนวนเต็มธรรมดาแต่ยอมรับ null เป็นศูนย์ละเมิดสัญญา รันทั้ง edge case ใหม่และการทดสอบโปรเจกต์ที่มีอยู่; การผ่านการทดสอบใหม่หนึ่งรายการอาจซ่อนผู้เรียกที่เสียหายที่อื่นได้
2. ขอบเขตของการเปลี่ยนแปลง เปรียบเทียบ patch กับคำขอ การดึง ID parser ออกควรคง URL, การตอบกลับสำเร็จ และการตอบกลับข้อผิดพลาดไว้ การย้าย framework ที่ไม่ได้ขอเพิ่มงานตรวจสอบแม้ว่าตัวแทนจะคอมไพล์ได้ ตัดสินใจล่วงหน้าว่าการแก้ไขที่ไม่เกี่ยวข้องจะทำให้คำตอบถูกตัดสิทธิ์หรือต้องซ่อมแซมหรือไม่
3. context ที่มีประโยชน์และพื้นที่ output คำขอของคุณรวมคำแนะนำ ไฟล์ที่เกี่ยวข้อง คำนิยาม tool และบทสนทนาก่อนหน้า สงวนพื้นที่เพียงพอสำหรับคำตอบด้วย หน้าต่าง context ขนาดใหญ่ที่โฆษณาไว้นั้นไม่ได้ยืนยันว่าโมเดลจะหา invariant ที่เกี่ยวข้องเจอ หรือ endpoint ของคุณยอมรับค่าสูงสุดเดียวกัน
ทดสอบคุณภาพ context ด้วย dependency ที่สำคัญ รวมผู้เรียกที่อินเทอร์เฟซต้องคงที่และตรวจสอบว่าโมเดลเคารพมัน วัดการตัดทอนแยกต่างหาก: คำตอบที่จบกลางฟังก์ชันไม่สามารถยอมรับได้เพียงเพราะบรรทัดเปิดดูมีแนวโน้มดี
4. การเรียก tool และ structured output ตรวจสอบ route ที่ deploy อยู่กับ schema tool จริงของคุณ ตรวจสอบประเภทอาร์กิวเมนต์ ฟิลด์ที่หายไป ตัวระบุ tool และการตอบกลับติดตามหลังผลลัพธ์ tool โมเดลที่เขียนออบเจกต์ JSON ที่ดูสมเหตุสมผลไม่จำเป็นต้องทำ native tool-call round trip สำเร็จ
5. เวลาจนถึงผลลัพธ์ที่ยอมรับ บันทึกระยะเวลาของความพยายามทั้งหมด รวมการซ่อมแซมและการทดสอบ สำหรับ assistant แบบอินเทอร์แอกทีฟ เวลาจนถึงข้อความแรกที่มองเห็นก็สำคัญ แต่ไม่สามารถแทนที่เวลาการทำงานให้เสร็จได้ token แรกที่เร็วตามด้วยคำตอบยาวที่ใช้ไม่ได้ยังคงบล็อกนักพัฒนา
6. ค่าใช้จ่าย input, output, cache และ retry อ่านหมวดหมู่การเรียกเก็บเงินที่ endpoint ที่เลือกของคุณรายงานจริง แยก cache read จาก input ธรรมดาเมื่อเกี่ยวข้อง ติดตามคำขอที่ไม่สำเร็จและ loop ที่ถูกยกเลิก หากผู้ให้บริการไม่เปิดเผยรายละเอียดที่คุณต้องการ ให้ทำเครื่องหมายสมมติฐานที่ขาดหายของการประมาณการไว้อย่างชัดเจน
7. เงื่อนไขการผสานรวมและการจัดการโค้ด ยืนยันว่า editor หรือแอปพลิเคชันของคุณรองรับ route วิธีการพิสูจน์ตัวตน และรูปแบบข้อผิดพลาด ตรวจสอบข้อกำหนดการจัดการข้อมูลปัจจุบันของผู้ให้บริการก่อนส่งซอร์สโค้ดส่วนตัว open weights อธิบายทางเลือกการเผยแพร่โมเดล; ไม่ได้ยืนยันว่าบริการแบบโฮสต์จัดการคำขอของคุณอย่างไร
benchmark สาธารณะสามารถช่วยคุณเลือกตัวเลือกได้ หากคุณอ่านเงื่อนไขของมัน SWE-bench Verified มี 500 อินสแตนซ์ที่ผ่านการกรองโดยมนุษย์ หน้าปัจจุบันยังอธิบายมุมมอง Bash Only ที่ใช้สภาพแวดล้อม mini-SWE-agent เดียวกันด้วย รายละเอียดเหล่านี้ช่วยอธิบายว่ากำลังเปรียบเทียบอะไร (SWE-bench, เข้าถึงกันยายน 2026)
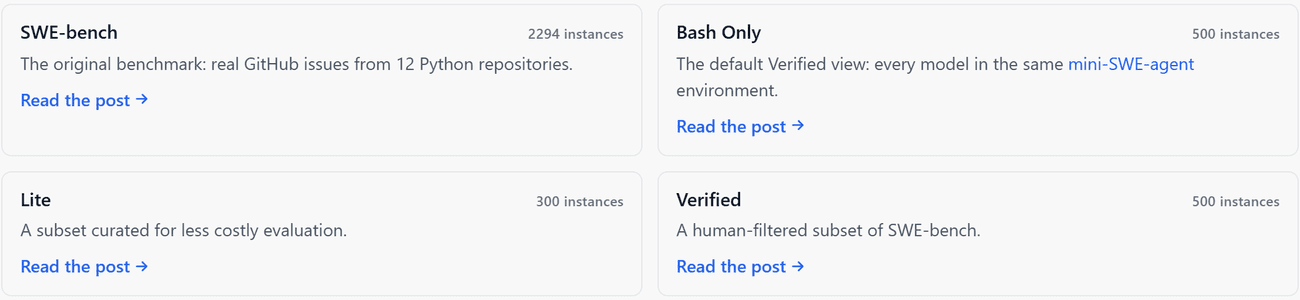 หน้า SWE-bench แสดงขนาดชุดข้อมูล Verified และสภาพแวดล้อม agent ที่ใช้ร่วมกัน
หลักฐานต้นทาง: หน้าจอ benchmark จริง, บันทึก 21 กันยายน 2026 ชุดข้อมูลและเงื่อนไขการดำเนินการอยู่ข้างๆ ข้ออ้างด้านประสิทธิภาพใดๆ
ผลลัพธ์ benchmark อธิบายการตั้งค่าเฉพาะ ภาษา กฎทางธุรกิจ สิทธิ์ และมาตรฐานการตรวจสอบของคุณอาจแตกต่างออกไป ตัดสินใจขั้นสุดท้ายจากงานที่คุณตรวจสอบได้
Best AI API for Coding: รันการตรวจสอบเชิงปฏิบัติสามแบบ
ตัวอย่างการประเมินที่ทำซ้ำได้สามตัวอย่างนี้เปิดเผยโหมดความล้มเหลวที่แตกต่างกัน กำหนดกฎการยอมรับก่อนขอผลลัพธ์ ตัดสินฟังก์ชันหรือหน้าเว็บเทียบกับสัญญาของมัน โดยไม่คำนึงถึงคุณภาพของคำอธิบาย
สำหรับ DeepSeek V4 Pro, Qwen3.5 122B A10B และ Kimi K3 โปรโตคอลที่ตั้งใจไว้คือการรันอิสระสามครั้งต่องาน นั่นหมายถึง 27 ความพยายามเริ่มต้น อนุญาตการซ่อมแซมจาก feedback ได้สูงสุดหนึ่งครั้งต่อความพยายาม เก็บคำตอบแรกไว้ และรายงานผลลัพธ์เริ่มต้นและที่ซ่อมแซมแยกจากกัน
ขอ temperature เป็นศูนย์เฉพาะที่รองรับ บันทึกค่าที่ตั้งไว้ที่ยอมรับจริง ใช้เพดาน output ที่ขอ 4,096 token สำหรับ A และ B และ 8,192 สำหรับ C หลังจากตรวจสอบข้อจำกัด endpoint แล้ว ค่าเริ่มต้นและการควบคุมที่ไม่รองรับต้องถูกบันทึก temperature ต่ำไม่รับประกันคำตอบที่เหมือนกัน
สถานะหลักฐาน: การเข้าถึงสภาพแวดล้อมทดสอบถูกบล็อกโดยหน้าล็อกอิน Cloudflare Access ไม่สามารถดำเนินการ 27 ความพยายามของผู้สมัครได้ หลักฐานต่อไปนี้แสดงโค้ดต้นฉบับที่รันในเครื่องและ fixture อ้างอิง CSV ที่เขียนขึ้นสำหรับบทความ ไม่ใช่ผลลัพธ์จากโมเดลผู้สมัคร อัตราการผ่านของโมเดล การใช้ token และต้นทุนงานยังไม่ถูกวัด
งาน A: แก้ไขการเลือกตัวเลขราคา วาง prompt นี้แบบตรงตัวลงในเซสชันใหม่:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
อินพุตการยอมรับที่กำหนดไว้คือ [2,10,3], ["12","3"], อาร์เรย์ว่าง, ค่าที่ไม่ถูกต้องเท่านั้น, ศูนย์, จำนวนลบ และสตริงที่มีแต่ช่องว่าง ปฏิเสธสตริงว่างหลัง trim ตรวจสอบว่าอาร์เรย์ต้นฉบับมีสมาชิกเหมือนเดิมทุกประการในลำดับเดียวกันหลังการเรียก
ต้นฉบับใช้ sort เริ่มต้นของ JavaScript และเปลี่ยนแปลงอินพุต งานนี้จึงตรวจสอบพันธะสองอย่างที่แยกจากกัน: เลือกค่าต่ำสุดเชิงตัวเลขที่ถูกต้องและหลีกเลี่ยงการเปลี่ยนข้อมูลของผู้เรียก ทดสอบกฎการแปลงอย่างชัดเจนเพราะโซลูชันที่ใช้ coercion สั้นๆ อาจยอมรับ boolean หรือ null โดยไม่ตั้งใจ
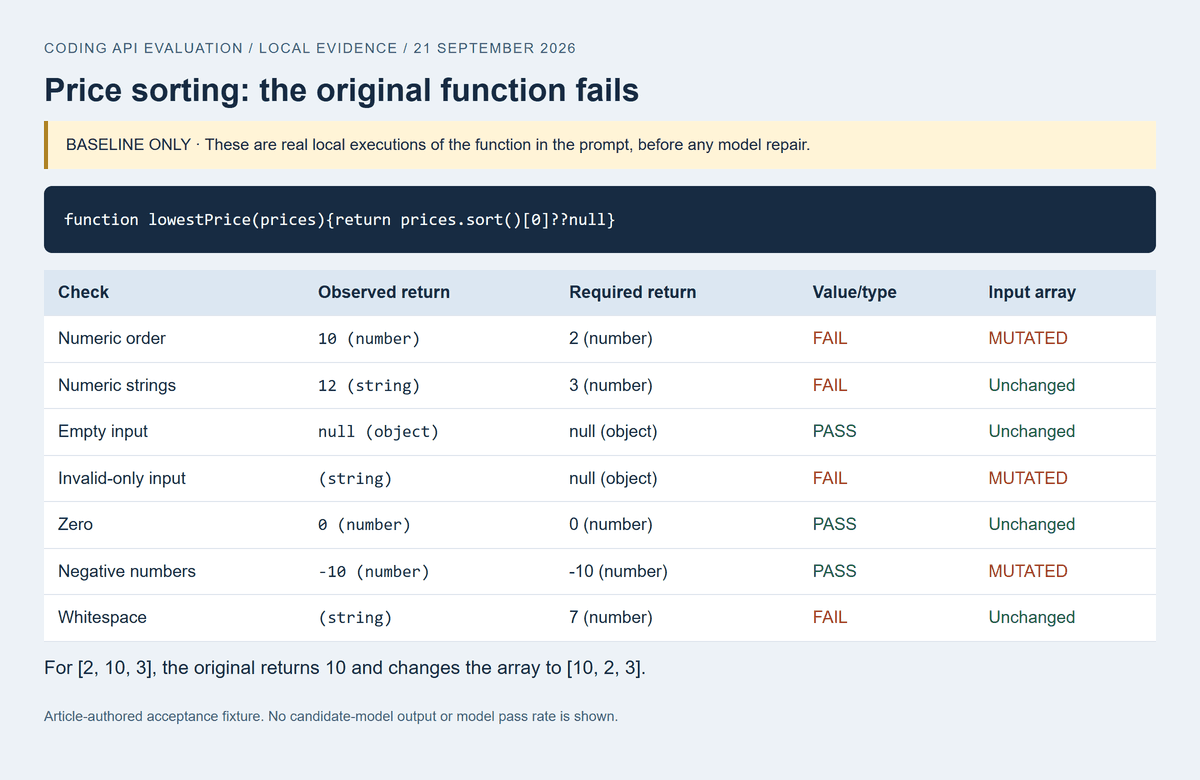 การรันในเครื่องของฟังก์ชันราคาต้นฉบับแสดงการจัดเรียงเชิงตัวเลขที่ไม่ถูกต้องและอินพุตที่ถูกเปลี่ยนแปลง
baseline ที่รันแล้ว: ฟังก์ชันต้นฉบับส่งคืน 10 สำหรับ [2,10,3] และเปลี่ยนอาร์เรย์เป็น [10,2,3] สตริงตัวเลขยังล้มเหลวในสัญญาค่าการส่งคืน ไม่แสดงการซ่อมแซมจากโมเดล
งาน B: รักษาอินเทอร์เฟซระหว่างการ refactor เล็กน้อย ใช้ prompt นี้แบบไม่เปลี่ยนแปลง:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
ยอมรับ "12" และ "0012" เป็น 12 ปฏิเสธ "1e2", "1.0", จำนวนลบ, ศูนย์, ช่องว่าง, อินพุตที่ไม่ใช่สตริง และค่าที่เกินช่วง safe integer ของ JavaScript ยืนยันพาธที่ลงทะเบียนและ body การตอบกลับทั้งสอง อินพุตที่ไม่ถูกต้องต้องไม่ไปถึง findUser
งานนี้ทดสอบว่าโมเดลเข้าใจความแตกต่างระหว่างการแปลงเชิงตัวเลขกับไวยากรณ์สตริงที่ระบุหรือไม่ ตรวจสอบ diff สำหรับการเปลี่ยนแปลงที่ไม่เกี่ยวข้อง จากนั้นเรียก handler ด้วยออบเจกต์ request และ response แบบ stub helper ที่ถูกต้องจับคู่กับ handler ที่ยังคงหลวมอยู่และไม่เปลี่ยนแปลงก็ยังล้มเหลว
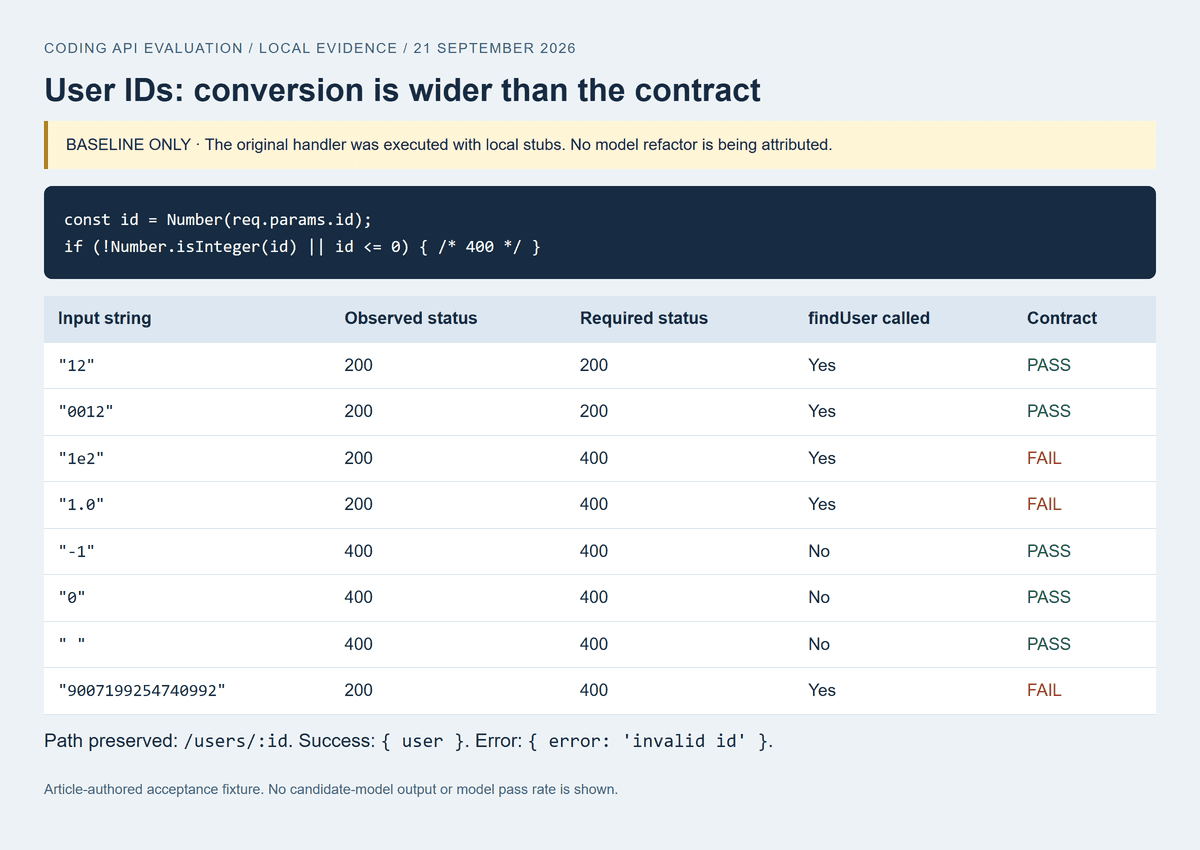 บันทึกการทดสอบ handler ต้นฉบับแสดงสตริงตัวเลขที่ไม่ถูกต้องถูกยอมรับด้วยสถานะ 200
baseline ที่รันแล้ว: handler ต้นฉบับส่งคืน 200 สำหรับ "1e2", "1.0" และ "9007199254740992" แม้ว่าต้องการการตอบกลับ 400 stub ในเครื่องบันทึกการเรียก; นี่ไม่ใช่การ refactor ที่สร้างโดยโมเดล
งาน C: สร้าง CSV preview ที่คุณใช้งานได้ ส่ง:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
ทดสอบด้วยเรกคอร์ดเหล่านี้แบบตรงตัว โดยใช้ LF ก่อนแล้วจึง CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
คาดหวังสองคอลัมน์ สามแถวข้อมูล เครื่องหมายจุลภาคของ Alice อยู่ในเซลล์เดียว และเครื่องหมายคำพูดที่ escape แล้วของ Bob แสดงอย่างถูกต้อง ค่าของ Eve ต้องปรากฏเป็นข้อความธรรมดา โดยไม่มีอิลิเมนต์รูปภาพ การทำงานของเหตุการณ์ หรือคำขอเครือข่าย เพิ่มแถวที่มีสามฟิลด์และยืนยันว่าหน้าเว็บรายงานความไม่ตรงกันอย่างชัดเจน
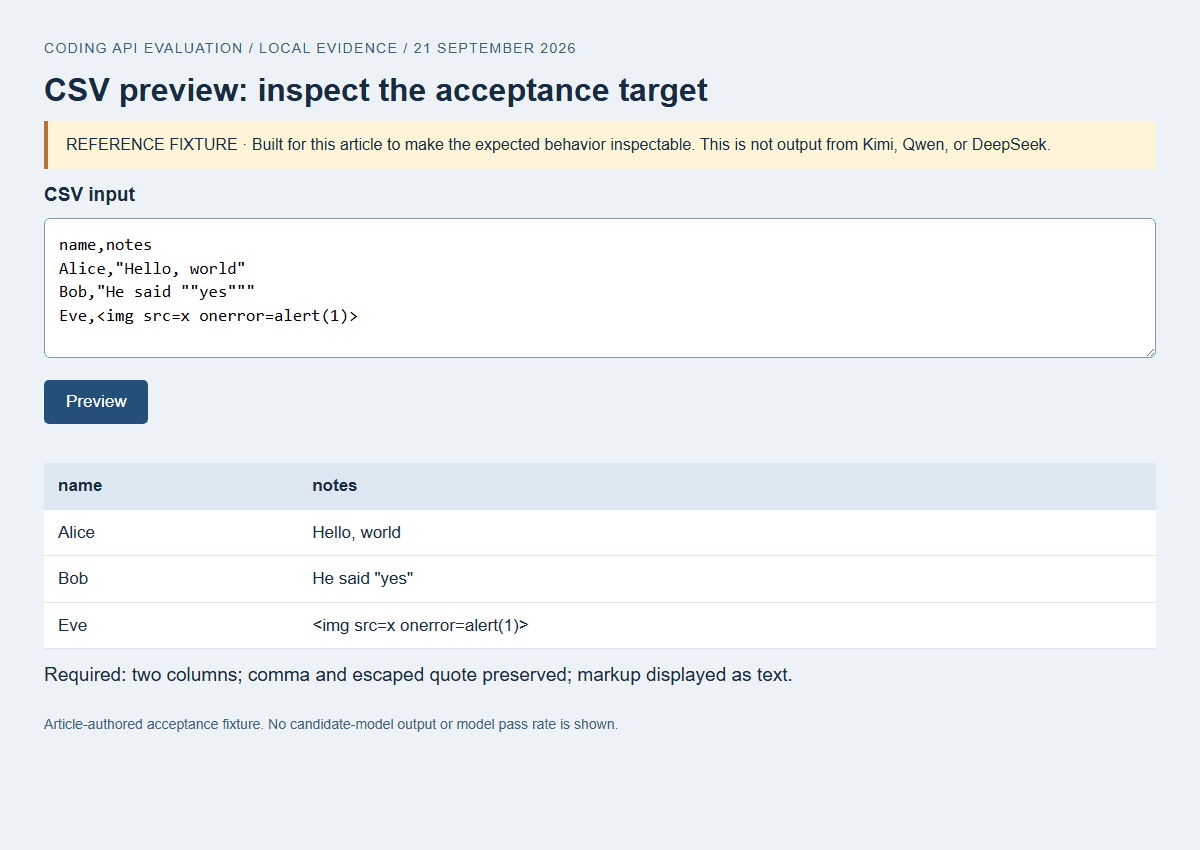 CSV acceptance fixture แสดงค่าที่อ้างอิงและข้อกำหนด markup แบบธรรมดา
reference fixture ที่ใช้งานได้ สร้างขึ้นสำหรับบทความนี้ ไม่ได้สร้างโดยโมเดลผู้สมัคร การตรวจสอบในเบราว์เซอร์ยืนยันการแยกวิเคราะห์ LF/CRLF, เครื่องหมายคำพูดที่ escape แล้ว, markup แบบธรรมดา, ข้อผิดพลาดจำนวนฟิลด์ที่มองเห็นได้ และไม่มีคำขอ HTTP ภาพหน้าจอแสดงสถานะอินพุตที่ถูกต้องหลังจากคลิก Preview
บันทึก output ดิบ บันทึก model ID วันที่ พารามิเตอร์ เวลา การซ่อมแซม และการแก้ไขด้วยมือ ส่งการยืนยันที่ล้มเหลวสำหรับการซ่อมแซมโดยไม่เปลี่ยนผลลัพธ์ที่คาดหวัง เก็บการปฏิเสธ การตัดทอน และข้อผิดพลาดไว้พร้อมกับความสำเร็จ
Best AI API for Coding แบบประหยัดงบ
เปรียบเทียบอัตรา token ควบคู่กับคุณภาพการทำงานให้เสร็จและการใช้งาน อินพุตที่ซ้ำกันอาจครอบงำต้นทุนการรีวิวโค้ด; การสร้างทั้งไฟล์อาจเพิ่มค่าใช้จ่าย output การซ่อมแซมซ้ำๆ เพิ่มทั้งสองอย่าง
แค็ตตาล็อก Atlas และหน้ารายละเอียดที่แน่นอนแสดงอัตรา USD ต่อล้าน token เหล่านี้เมื่อวันที่ 21 กันยายน 2026:
- DeepSeek V4 Pro: $1.68 อินพุต และ $3.38 เอาต์พุต รายการ V4 Pro 0813 แยกต่างหากใช้อัตราที่ต่างกัน; อย่าใช้แทนกัน
- Qwen3.5 122B A10B: $0.30 อินพุต และ $2.40 เอาต์พุต แค็ตตาล็อกแสดงอัตราปกติ $0.40 และ $3.20 พร้อมส่วนลด 25% ณ กันยายน 2026
- Kimi K3: $3.00 อินพุต และ $15.00 เอาต์พุต
นี่คืออัตราการผลิตที่แสดงไว้ ไม่ใช่ใบแจ้งหนี้จากการประเมินของบทความ อัตราเฉพาะสำหรับ cache และการนำไปใช้ไม่ได้ถูกยืนยัน ส่วนลดโปรโมชันสำหรับ DeepSeek และ Kimi ไม่ได้ถูกยืนยัน การที่ไม่มีข้อสังเกตเรื่องส่วนลดไม่ได้พิสูจน์ว่าไม่มีข้อเสนออยู่
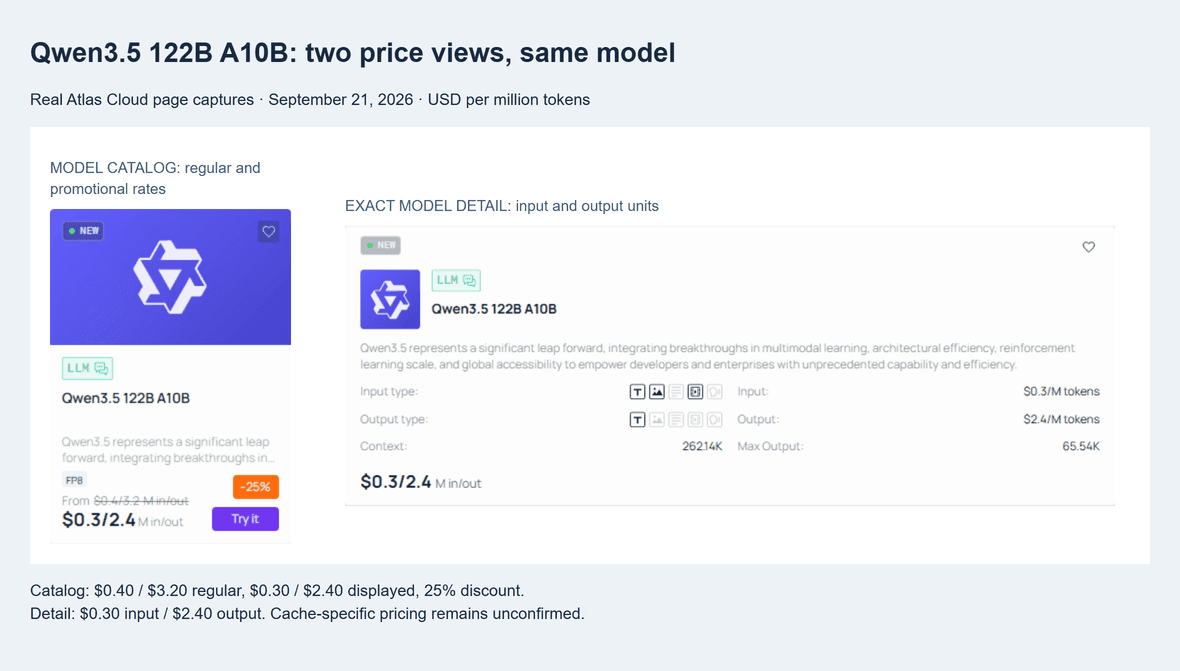 ส่วนลดแค็ตตาล็อก Qwen3.5 122B A10B ข้างอัตราอินพุตและเอาต์พุตของหน้ารายละเอียดโมเดลที่แน่นอน
การตรวจสอบราคา Qwen ซ้ำ, 21 กันยายน 2026: แค็ตตาล็อกแสดงโปรโมชัน 25%; หน้ารายละเอียดโมเดลที่แน่นอนยืนยัน $0.30 อินพุต และ $2.40 เอาต์พุตต่อล้าน token อัตราเฉพาะสำหรับ cache ยังไม่ได้รับการยืนยัน
คำนวณส่วนของโมเดลในงานเป็น:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
อย่าคิดค่าธรรมเนียม token ที่ cache ไว้อีกครั้งเป็นอินพุตธรรมดาหากบันทึกการเรียกเก็บเงินจัดการแยกต่างหาก ตรวจสอบว่าการใช้งาน reasoning รวมอยู่ใน output ที่คิดค่าบริการหรือไม่ หากไม่มีงานใดผ่าน ให้รายงานว่า "ไม่มีผลลัพธ์ที่สำเร็จ"; การหารด้วยศูนย์หรือแสดงต้นทุนการทำงานให้เสร็จเป็นศูนย์จะทำให้ผู้อ่านเข้าใจผิด
สำหรับตัวอย่างเลขคณิตที่โปร่งใส สมมติว่ามีอินพุตธรรมดา 10,000 token และเอาต์พุต 2,000 token ที่อัตรา Qwen ที่แสดงไว้ ค่าใช้จ่ายโมเดลโดยประมาณคือ $0.0078 ก่อนรายการอื่นๆ ที่เกี่ยวข้อง นี่เป็นคำขอสมมติ ไม่ใช่การใช้ token ที่สังเกตได้หรือใบเรียกเก็บเงินจริง
การซ่อมแซมขนาดเดียวกันหนึ่งครั้งจะนำการประมาณการไปที่ $0.0156 การซ่อมแซมจริงมี context และ output ที่แตกต่างกัน ดังนั้นให้คำนวณแต่ละคำขอจากการใช้งานที่บันทึกไว้
| งาน | โมเดล | รอบแรก | หลังซ่อมแซม | การใช้ token | แหล่งที่มาของต้นทุน | ค่าใช้จ่ายรวม | เวลารวม | การแก้ไขด้วยมือ |
|---|---|---|---|---|---|---|---|---|
| A, B, C; วางแผนทำซ้ำ 3 ครั้งต่ออัน | DeepSeek V4 Pro | ยังไม่วัด | ยังไม่วัด | ไม่ได้บันทึก | ไม่มีบันทึกการใช้งาน | ไม่ทราบ | ยังไม่วัด | ไม่ได้ประเมิน |
| A, B, C; วางแผนทำซ้ำ 3 ครั้งต่ออัน | Qwen3.5 122B A10B | ยังไม่วัด | ยังไม่วัด | ไม่ได้บันทึก | ไม่มีบันทึกการใช้งาน | ไม่ทราบ | ยังไม่วัด | ไม่ได้ประเมิน |
| A, B, C; วางแผนทำซ้ำ 3 ครั้งต่ออัน | Kimi K3 | ยังไม่วัด | ยังไม่วัด | ไม่ได้บันทึก | ไม่มีบันทึกการใช้งาน | ไม่ทราบ | ยังไม่วัด | ไม่ได้ประเมิน |
สำหรับ worksheet ของคุณเอง ให้ขยายแต่ละแถวเป็นหนึ่งแถวต่อโมเดลและการทำซ้ำ นับความสำเร็จที่ซ่อมแซมแล้วหนึ่งครั้งในตัวหารของงานที่ยอมรับ รวมความพยายามที่ไม่สำเร็จในตัวเศษ และเก็บคอลัมน์การยอมรับรอบแรกและรอบสุดท้ายแยกจากกัน
ติดตามการรีวิวโดยมนุษย์และโครงสร้างพื้นฐานแยกต่างหาก การคลี่คลายการเขียนใหม่ที่ไม่จำเป็นสามารถลบการประหยัดจาก inference ได้ เปรียบเทียบตัวเลือกที่ตรงกับทั้งข้อกำหนดการยอมรับและงบเวลาการรีวิวของคุณ
Best AI API for Coding ด้วย Atlas Cloud
เริ่มต้นที่ หน้าตัวโมเดล Kimi K3 ยืนยัน ID และตรวจสอบมุมมอง API และ Code เก็บเวอร์ชันที่เลือกไว้ข้างบันทึกการทดสอบ
อ่าน เอกสารโปรโตคอล LLM ก่อนที่จะถือว่า route สองอันใช้แทนกันได้ มันระบุว่า Chat Completions เป็น route ที่ครอบคลุมกว้างและแนะนำให้ผู้ใช้ดู supported_apis ของแต่ละโมเดล การควบคุมการสุ่มและฟีเจอร์ tool ก็ขึ้นอยู่กับการรองรับที่โฆษณาไว้ของโมเดลเช่นกัน
มีรายละเอียดการผสานรวมที่เป็นรูปธรรมที่ควรตรวจสอบตรงนี้ เอกสารระบุว่าคำขอ Anthropic ที่แปลแล้วจะไม่นำ cache_control ไปใช้ และ tool ที่โฮสต์โดยผู้ให้บริการไม่พร้อมใช้งานบน route ที่แปลแล้วนั้น ข้อจำกัดเหล่านั้นสำคัญหาก agent ปัจจุบันของคุณสมมติว่าใช้ native caching หรือ tool การท่องเว็บแบบโฮสต์ จับคู่ client กับ route จริง
ตัวอย่าง Node.js ต่อไปนี้แสดงคำขอข้อความหนึ่งรายการ ใช้ fetch ที่มีมาให้ ตัวแปรสภาพแวดล้อมสำหรับข้อมูลรับรอง และ model ID ของ Kimi ที่ยืนยันแล้ว บันทึก prompt ของงาน A แบบตรงตัวเป็น task-a.txt ตั้งค่าตัวแปรสภาพแวดล้อม base URL เป็น base ของ Atlas API ที่แสดงในเอกสาร ซึ่งลงท้ายด้วย /v1
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages บรรทุกงาน; model เลือกการ deploy; max_tokens ขอเพดาน output ตัวอ่านคำตอบตรวจสอบข้อความที่เสร็จสมบูรณ์ธรรมดาก่อนส่งคืนโค้ด timeout จำกัดการรอของตัวอย่างนี้; ไม่ได้ยืนยันว่าเซิร์ฟเวอร์หยุดประมวลผลหรือไม่มีค่าใช้จ่ายเกิดขึ้น
temperature ถูกตัดออกเพราะการรองรับต่อโมเดลและพฤติกรรมที่ผูกพันต้องได้รับการตรวจสอบ ตัวอย่างไม่ลองใหม่โดยอัตโนมัติ ตรวจสอบประเภทความล้มเหลวก่อนเพิ่มนโยบาย retry ที่มีขอบเขต และอย่าบันทึก authorization header เด็ดขาด โค้ดที่เผยแพร่นี้ไม่ได้ถูกรันด้วย API key ในระหว่างการผลิตบทความ
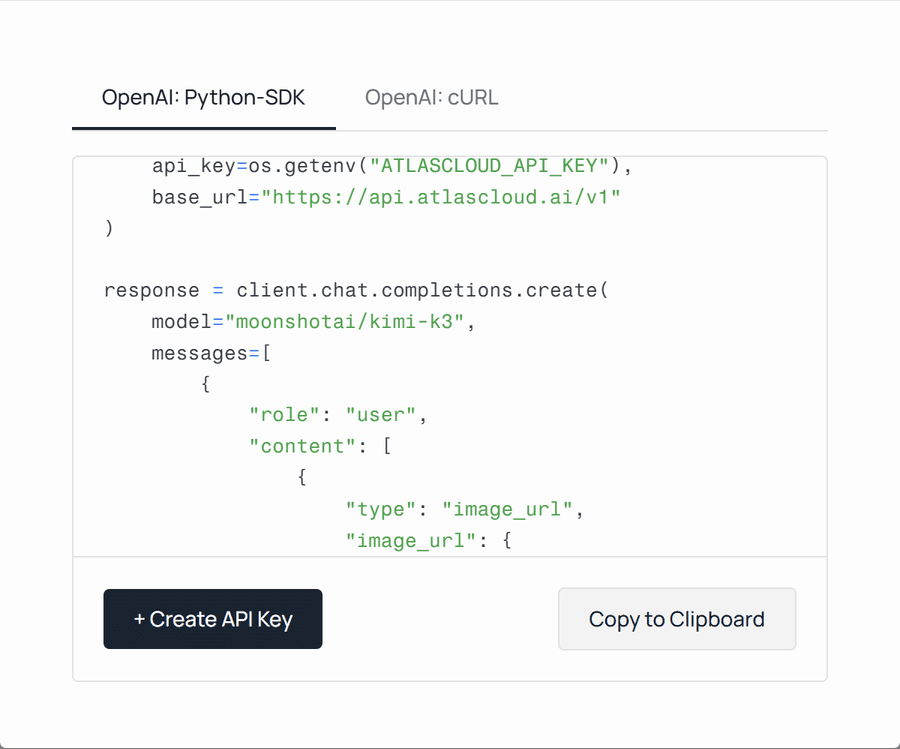 ตัวอย่างโค้ด API สาธารณะของ Kimi K3 แสดง endpoint ของ Atlas และตัวระบุโมเดล
กล่องโต้ตอบ Code สาธารณะของ Kimi K3, บันทึก 21 กันยายน 2026 นี่คือหลักฐานการตั้งค่า ไม่ใช่การรันเขียนโค้ดที่เสร็จสมบูรณ์ ตัวอย่างในหน้ารวมอินพุตสื่อ; ตัวอย่างในบทความใช้ข้อความเท่านั้น
รันการตรวจสอบการยอมรับของงาน A บนฟังก์ชันที่ส่งคืนมา ก่อนเปลี่ยนไปใช้ DeepSeek หรือ Qwen ให้ยืนยันโปรโตคอลและพารามิเตอร์ของมัน เก็บ prompt และการทดสอบไว้ไม่เปลี่ยนแปลงขณะเปรียบเทียบ output และการใช้งาน; รูปแบบคำขอที่ใช้ร่วมกันไม่ได้ยืนยันพฤติกรรมที่เหมือนกัน
ก่อนใช้ Coding API ในโปรดักชัน
รันโค้ดที่สร้างขึ้นใน branch ที่ใช้แล้วทิ้งหรือ workspace ที่แยกออกก่อน สำหรับงาน CSV ให้ใช้บริบทเบราว์เซอร์ในเครื่องที่มีคำขอเครือข่ายถูกบล็อกและไม่มีการเข้าถึงสถานะแอปพลิเคชันที่ละเอียดอ่อน สำหรับงาน repository ให้ให้ไฟล์และคำสั่งที่จำเป็นสำหรับการประเมินแก่ process เท่านั้น
กำหนดความสำเร็จจากภายนอกคำตอบของโมเดล agent ที่พูดว่า "การทดสอบทั้งหมดผ่าน" ควรนำคุณไปสู่บันทึกการทดสอบจริง รหัส exit และ revision ที่ตรวจสอบแล้ว เก็บบันทึก diff ไว้พร้อมหลักฐานนั้น มิฉะนั้น การซ่อมแซมในภายหลังอาจเปลี่ยนไฟล์หลังความสำเร็จที่ดูเหมือนจะเกิดขึ้นและทำให้รายงานล้าสมัย
ถือว่า timeout และ retry เป็นพฤติกรรมแอปพลิเคชันที่คุณเป็นเจ้าของ ตั้งกำหนดเวลาคำขอและงบงานทั้งหมด แยกข้อผิดพลาดที่เกิดจากข้อมูลรับรองหรือพารามิเตอร์ที่ไม่ถูกต้องออกจากความล้มเหลวในการขนส่งชั่วคราว การทำคำขอที่ไม่ถูกต้องซ้ำเสียเวลา; การทำคำขอที่กระตุ้น side effect ซ้ำอาจสร้างงานซ้ำซ้อน
เมื่อ agent สามารถเรียก tool ได้ ให้แยกการตรวจสอบแบบอ่านอย่างเดียวออกจากการเขียน กำหนดตัวระบุการดำเนินการในจุดที่การออกแบบ tool ของคุณรองรับ และยืนยันสถานะก่อนทำการเขียนที่ไม่แน่ใจซ้ำ นโยบาย retry ของ endpoint โมเดลไม่สามารถรับประกัน idempotency สำหรับ tool ที่แอปพลิเคชันของคุณดำเนินการต่อได้
ปกป้องบันทึกอย่างตั้งใจเท่ากับไฟล์ซอร์ส บันทึก model ID เวลา สถานะ จังหวะเวลา และการใช้งานโดยไม่คัดลอกความลับหรือ repository ส่วนตัวทั้งหมดลงใน telemetry เป็นประจำ เก็บหลักฐาน output ดิบที่จำเป็นไว้ในตำแหน่งที่จำกัดอย่างเหมาะสม และกำหนดว่าทีมต้องเก็บไว้นานเท่าใด
ตรวจสอบ streaming กับ client จริงของคุณ มันต้องจัดการเหตุการณ์บางส่วน การสิ้นสุด ข้อผิดพลาด และบันทึกการใช้งานที่มีให้ ยืนยันขีดจำกัดอัตราสำหรับบัญชีและการ deploy จริง การทดลองแบบผู้ใช้คนเดียวที่เงียบไม่สามารถยืนยันว่า route เดียวกันทำงานอย่างไรเมื่อทีมส่งคำขอพร้อมกัน
ใช้รายการตรวจสอบการเผยแพร่สั้นๆ นี้:
- การทดสอบการยอมรับและ regression ที่มีอยู่ผ่านใน revision สุดท้าย
- diff อยู่ภายในขอบเขตงานที่อนุมัติ
- พฤติกรรม timeout การยกเลิก และ retry ได้ถูกทดสอบแล้ว
- การเรียก tool และการตอบกลับแบบมีโครงสร้างทำงานบน endpoint ที่เลือก
- บันทึกไม่รวมข้อมูลรับรองและโค้ดส่วนตัวที่ไม่จำเป็น
- ข้อกำหนดการจัดการข้อมูลตรงกับความต้องการของทีม
- fallback มีการตั้งค่าและบันทึกการทดสอบที่ยืนยันแล้วของตัวเอง
repository ส่วนตัวต้องมีการตัดสินใจเฉพาะบริการ ตรวจสอบเงื่อนไขการเก็บรักษา การใช้เพื่อฝึกฝน การเข้าถึง และสัญญาปัจจุบันกับผู้รับผิดชอบโค้ด ส่งเฉพาะวัสดุที่ได้รับอนุมัติ อย่าอนุมานความลับจากน้ำหนักโมเดลที่พร้อมใช้งาน หรือจากโปรโตคอลที่คล้ายกับที่คุณใช้อยู่แล้ว
Best AI API for Coding: เลือกขั้นสุดท้าย
ตัดสินใจในสามรอบ
หนึ่ง กำจัดตัวเลือกที่ขาดความสามารถที่จำเป็น เขียนเงื่อนไขที่ต้องคงไว้: รูปแบบ output ที่ยอมรับได้, tool loop ที่ทำงานได้, การจัดการข้อมูลที่เหมาะสม หรือกำหนดเวลาการตอบกลับที่ใช้งานได้ ตัวเลือกที่ขาดอย่างใดอย่างหนึ่งต้องมีการตัดสินใจแก้ไขแยกต่างหากก่อนจะอยู่ในารเปรียบเทียบสุดท้าย
สอง เปรียบเทียบต้นทุนงานที่ยอมรับและเวลาที่ใช้ ใช้ความพยายามทั้งหมดภายใต้นโยบายการซ่อมแซมเดียวกัน แยกความสำเร็จรอบแรกออกจากความสำเร็จที่ซ่อมแซมแล้ว และแสดงบันทึกการใช้งานที่ขาดหาย หากทั้งสองโมเดลตรงตามสัญญา ให้เปรียบเทียบภาระการรีวิวรวมทั้งค่าใช้จ่ายโมเดลด้วย นักพัฒนาของคุณจะอยู่กับ patch ที่เป็นผลลัพธ์
สาม เก็บ fallback ไว้หนึ่งอันและกำหนดทริกเกอร์ ตัวอย่างรวมถึงการล่มของ endpoint ต่อเนื่อง, ความล้มเหลวของ structured output ซ้ำๆ หรือต้นทุนงานเกินเพดานที่เลือก ทดสอบการตั้งค่าทางเลือกล่วงหน้า การเปลี่ยน model ID ภายใต้ความกดดันอาจแนะนำปัญหาการผสานรวมที่สองหากการควบคุมหรือพฤติกรรมการตอบกลับของมันแตกต่างกัน
งานเล็กๆ สามงานในคู่มือนี้เป็นการฝึกคัดกรอง ขยายชุดด้วยงานที่เป็นตัวแทนจาก codebase ของคุณเองก่อนพึ่งพาตัวเลือกสำหรับการเปลี่ยนแปลงที่กว้างขวาง เก็บงานบางส่วนไว้นอกการปรับแต่ง prompt เพื่อให้คุณตรวจสอบได้ว่าการปรับปรุงถ่ายโอนไปไกลกว่าตัวอย่างที่คุณปรับให้เหมาะสมหรือไม่
best ai api for coding ที่ดีที่สุดคือการรวมกันที่คุณอธิบายได้: มันทำงานที่จำเป็นให้เสร็จ เปิดเผยต้นทุนที่คุณติดตามได้ และเข้ากับวิธีที่แอปพลิเคชันของคุณทำงาน ไม่จำเป็นต้องมีผู้ชนะสากลเพื่อทำการตัดสินใจนั้น
เปิด แค็ตตาล็อกโมเดลปัจจุบัน เลือกสองตัวเลือก และบันทึก ID และการตั้งค่าที่แน่นอนของมัน จากนั้นใช้งานเดียวกัน การทดสอบเดียวกัน และกฎการหยุดเดียวกันกับทั้งสอง
คำถามที่พบบ่อย
AI API สำหรับเขียนโค้ดที่ดีที่สุดสำหรับงบประมาณจำกัดคืออะไร?
เริ่มต้นด้วยตัวเลือกที่อัตราที่แสดงไว้เข้ากับปริมาณอินพุตและเอาต์พุตที่เป็นไปได้ของคุณ จากนั้นเปรียบเทียบต้นทุนต่องานที่ยอมรับ แถว Qwen, DeepSeek และ Kimi ให้เวอร์ชันที่เป็นรูปธรรมให้ตรวจสอบ โดยไม่ยืนยันผู้ชนะด้านคุณค่าที่ผ่านการทดสอบ จำกัดความพยายามในการซ่อมแซม ใช้ context ที่เกี่ยวข้องซ้ำอย่างตั้งใจ และติดตามคำขอที่ล้มเหลว รวมเวลาการรีวิวแยกต่างหากเพื่อให้บิล inference ที่ต่ำไม่ซ่อนภาระการทำความสะอาดที่ใหญ่
การสมัครใช้บริการเขียนโค้ดถูกกว่าการจ่ายค่า token API หรือไม่?
ขึ้นอยู่กับงานของคุณและสิ่งที่แผนรวมไว้ การสมัครอาจเหมาะกับการใช้งานแบบอินเทอร์แอกทีฟภายในแอปพลิเคชันที่รองรับ ในขณะที่การเรียกเก็บตามการใช้งานอาจเหมาะกับบริการที่กำหนดเองที่มีทราฟฟิกผันแปร ตรวจสอบการเข้าถึงโมเดล เพดาน concurrency และว่าการเรียก API ภายนอกรวมอยู่ด้วยหรือไม่ เปรียบเทียบปริมาณงานที่มีประโยชน์เท่ากันในช่วงเวลาตัวแทน; ราคาติดป้ายรายเดือนและอัตรา token วัดสิ่งที่แตกต่างกัน
ความแตกต่างระหว่าง coding model และ coding agent คืออะไร?
โมเดลสร้างคำตอบ agent จัดการ loop รอบคำตอบเหล่านั้น รวมถึงการเข้าถึงไฟล์ การดำเนินการ tool การทดสอบ และกฎการหยุด คุณสามารถเรียก coding model ผ่าน API โดยไม่สร้าง agent เช่น เพื่อแนะนำฟังก์ชันให้มนุษย์รีวิว หากต้องการการแก้ไขแบบอัตโนมัติ ให้ประเมินโมเดลพร้อมกับ agent และสิทธิ์ที่มันจะใช้จริง
ควรใช้ AI API ใดสำหรับการดีบักและ refactor?
คัดตัวเลือกที่เข้ากับข้อกำหนด endpoint และการจัดการโค้ดของคุณ จากนั้นใช้บั๊กเล็กๆ และการ refactor แบบมีข้อจำกัดจากงานของคุณ งาน A ตรวจสอบความถูกต้องและการเปลี่ยนแปลงอินพุต; งาน B ตรวจสอบการแยกวิเคราะห์และการรักษาอินเทอร์เฟซ ตามด้วยการทดสอบ repository ที่เป็นตัวแทน
เลือกตัวเลือกที่ตรงกับเงื่อนไขการยอมรับด้วยความพยายามรีวิวที่จัดการได้ แทนที่จะเป็นตัวที่แค่ให้คำอธิบายยาวที่สุดหรือเขียนใหม่มากที่สุด
มี AI API ฟรีสำหรับเขียนโค้ดหรือไม่?
เครดิตทดลอง แอปพลิเคชันที่มี tier ฟรี และน้ำหนักโมเดลที่ดาวน์โหลดได้เป็นข้อเสนอที่แตกต่างกัน ไม่มีสิ่งใดให้ inference แบบโฮสต์ไม่จำกัดแก่แอปพลิเคชันของคุณโดยอัตโนมัติ ยืนยันคุณสมบัติปัจจุบัน วันหมดอายุ โควตา และโมเดลที่รองรับก่อนจัดงบประมาณรอบการเข้าถึงฟรี บทความนี้ไม่ได้ยืนยันว่ามีการให้ฟรีที่พร้อมใช้งานในปัจจุบัน
หากคุณโฮสต์น้ำหนักด้วยตัวเอง ให้คำนึงถึงการประมวลผลและการดำเนินงานแม้ว่าการดาวน์โหลดน้ำหนักจะไม่มีค่าใช้จ่าย
ฉันสามารถส่งโค้ด repository ส่วนตัวไปยัง coding API ได้หรือไม่?
ส่งเฉพาะโค้ดที่องค์กรของคุณอนุญาตให้แชร์ภายใต้ข้อกำหนดที่เกี่ยวข้องของบริการนั้นๆ ตรวจสอบการเก็บรักษา การใช้เพื่อฝึกฝน การควบคุมการเข้าถึง และข้อกำหนดตามสัญญาสำหรับการ deploy ที่เลือก
ลบข้อมูลรับรองและไฟล์ที่ไม่เกี่ยวข้อง และตรวจสอบว่า agent ของคุณรวมอะไรโดยอัตโนมัติใน prompt และบันทึก โมเดล open-weight หรือรูปแบบ API ที่คุ้นเคยไม่ได้ยืนยันด้วยตัวเองว่าบริการแบบโฮสต์ตรงกับข้อกำหนดความลับของทีมคุณ





