อวตารในคอร์สที่ขยับแค่ปากสามารถดึงความสนใจได้เพียงหนึ่งประโยค จากนั้นก็ทำผู้เรียนหลุดจากบทเรียน วิดีโอผู้สอนหลักสูตรด้วย AI OmniHuman 2.0 มอบวิธีให้คุณวางแผนสีหน้าที่มองเห็นได้ ท่าทางที่ตั้งใจ และทิศทางกล้องรอบคำอธิบายที่บันทึกไว้ ตัวอย่างคอนทราสต์สีด้านล่างแสดงฉากผู้สอน 30 วินาทีที่สมบูรณ์ และที่สำคัญไม่แพ้กัน คือปัญหาความต่อเนื่องของอุปกรณ์ประกอบฉากที่ควรจับก่อนเผยแพร่บทเรียน
ประเด็นสำคัญ
- อินพุตหลักคือภาพผู้สอนและเสียง; พรอมป์ต์ข้อความสามารถแนะนำการแสดงหรือทิศทางกล้องได้
- มอง OmniHuman 2.0 เป็นขั้นตอนวิดีโอผู้นำเสนอ คุณยังคงเป็นเจ้าของบทเรียน สไลด์ การบันทึกหน้าจอ การตรวจสอบข้อเท็จจริง และการตัดต่อ
- ตัวอย่างคอนทราสต์สี 30 วินาทีแสดงการเปลี่ยนแปลงท่าทางและมุมมองที่เป็นประโยชน์ รวมถึงการ์ดที่หายไปซึ่งต้องตรวจทานเชิงบรรณาธิการ
- ตรวจสอบการขยับปากให้ตรงเสียง สีหน้า ท่าทาง ความเสถียรของภาพ และสิทธิ์ก่อนเผยแพร่
- Atlas Cloud ระบุราคา $0.07 ต่อวินาที และแสดงราคาลด $0.056; ยืนยันราคาปัจจุบันก่อนสร้าง
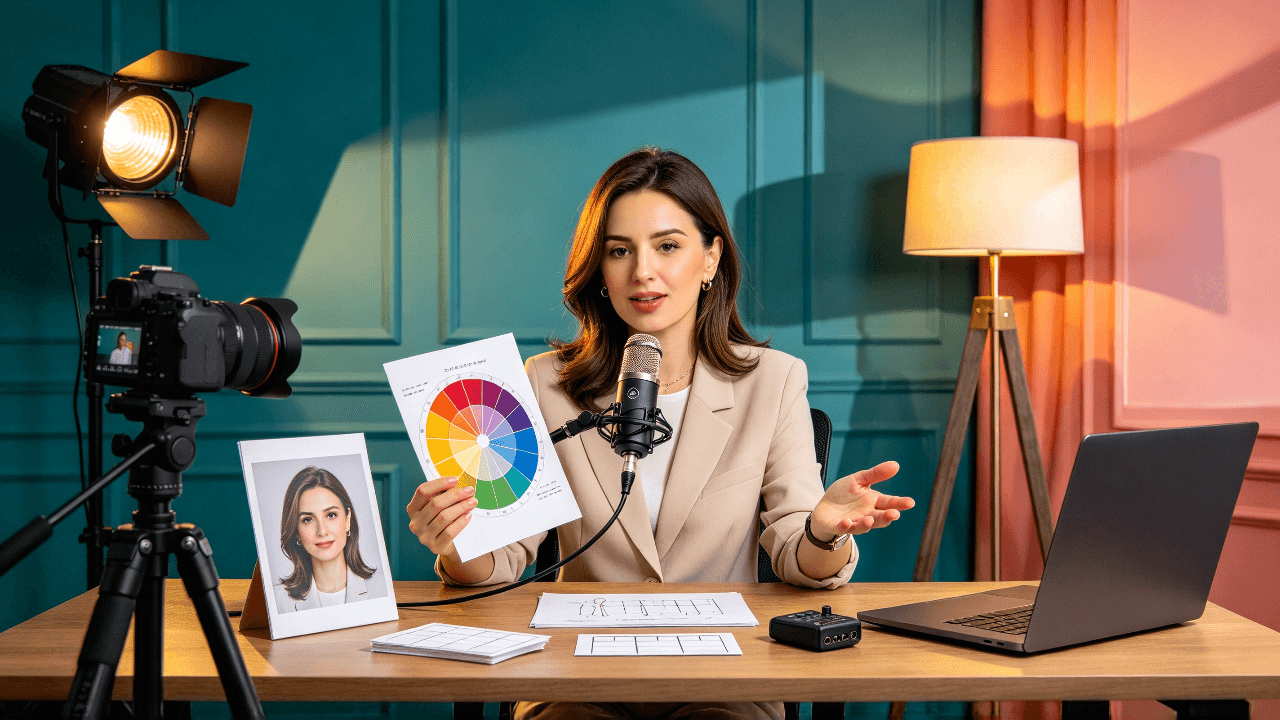
ฉากการเตรียมตัวอย่างประกอบ: ภาพพอร์ตเทรตอ้างอิง การบันทึกเสียงบรรยาย และสื่อบทเรียนคืออินพุตที่ต้องวางแผนก่อนทำวิดีโอผู้นำเสนอ
OmniHuman 2.0 ทำอะไรได้สำหรับวิดีโอผู้สอนหลักสูตร
OmniHuman 2.0 เปลี่ยนภาพอ้างอิงและแทร็กเสียงให้เป็นวิดีโอ 720p ของตัวละครในภาพที่กำลังพูดหรือร้องเพลง ไดเรกทอรีโมเดลของ Atlas Cloud อธิบายถึงการกำหนดทิศทางด้วยข้อความเสริม ท่าทางแบบไดนามิก ฉากหลายคน การเคลื่อนกล้อง และคลิปนานสูงสุดห้านาที สิ่งเหล่านี้เป็นความสามารถที่ระบุไว้ ไม่ใช่การรับประกันว่าทุกพรอมป์ต์ในคอร์สจะให้เทคที่เหมาะสม
(รายละเอียดโมเดล Avatar Omni Human 2.0)
การแบ่งความรับผิดชอบมีความสำคัญ คุณเป็นผู้จัดหาคอนเทนต์การสอนและเสียงบันทึก โมเดลสร้างการแสดงที่มองเห็นได้ คุณตัดสินใจว่าจุดใดผู้นำเสนอช่วยได้ และจุดใดแผนภาพ สไลด์ การจับภาพซอฟต์แวร์ หรือการสาธิตแบบโคลสอัพอธิบายเนื้อหาได้ดีกว่า
| องค์ประกอบการผลิต | สิ่งที่คุณเตรียมหรือทำ | สิ่งที่โมเดลมีส่วนช่วย | สิ่งที่คุณตรวจสอบ |
|---|---|---|---|
| ภาพผู้สอน | ภาพพอร์ตเทรตที่ชัดเจนและได้รับอนุญาต | ข้อมูลอ้างอิงตัวตนที่มองเห็นได้ | ความสอดคล้องของใบหน้า เสื้อผ้า และฉากหลัง |
| เสียงบรรยายบทเรียน | การบันทึกที่ตรวจสอบแล้วด้วยจังหวะที่ตั้งใจ | การแสดงการพูดที่ขับเคลื่อนด้วยเสียง | จังหวะ การออกเสียง และการหยุด |
| การกำหนดทิศทาง | บันทึกสั้น ๆ เกี่ยวกับการจัดเฟรมและการนำเสนอ | การแสดงที่แนะนำด้วยพรอมป์ต์และทิศทางกล้อง | การเคลื่อนไหวสนับสนุนบทเรียนหรือไม่ |
| สื่อการสอน | สไลด์ การบันทึกหน้าจอ แผนภาพ หรือตัวอย่าง | ไม่สามารถแทนที่สื่อเหล่านี้ได้ | แต่ละแนวคิดติดตามได้ง่ายหรือไม่ |
| บทเรียนสุดท้าย | การตัดต่อ คำบรรยาย และการตรวจสอบคุณภาพ | ส่วนวิดีโอที่สร้างขึ้น | ความถูกต้อง การเข้าถึง และสิทธิ์ |
งานวิจัย OmniHuman ฉบับแรก ๆ อธิบายการสร้างแอนิเมชันมนุษย์ที่ปรับด้วยเสียง แต่ครอบคลุม OmniHuman-1 และไม่ควรถือเป็นการทดสอบประสิทธิภาพของเวอร์ชัน 2.0 สำหรับการตัดสินใจผลิตคอร์ส ให้ยึดตามรายการโมเดลปัจจุบันสำหรับอินพุตและขีดจำกัดเอาต์พุตที่ระบุไว้ จากนั้นตัดสินตัวอย่างที่ทำจากสื่อของคุณเอง (งานวิจัย OmniHuman-1)
สิ่งที่ต้องเตรียมก่อนสร้างวิดีโอผู้สอนด้วย AI
ตัวอย่างที่น่าเชื่อถือไม่ได้ขึ้นอยู่กับการอัปโหลดภาพพอร์ตเทรตใด ๆ และการบันทึกใด ๆ เท่านั้น เลือกสื่อที่ทำให้ง่ายต่อการตัดสินว่าผลลัพธ์เข้ากับบทเรียนจริงหรือไม่
เลือกภาพผู้สอนที่ชัดเจนและได้รับอนุญาต
ใช้ภาพพอร์ตเทรตที่หันหน้าตรงหรือเอียงเล็กน้อย โดยมองเห็นใบหน้าชัดเจน มีไหล่อยู่ในเฟรม และฉากหลังไม่รก หลีกเลี่ยงใบหน้าเล็กมาก การบดบังมาก เงาที่รุนแรง หรือการครอปที่ไม่เหลือที่ให้การขยับศีรษะตามธรรมชาติ หากต้องการผู้นำเสนอคนเดิมในหลายโมดูล ให้เก็บสำเนาภาพต้นฉบับที่อนุมัติไว้และนำกลับมาใช้อย่างสม่ำเสมอ
ใช้ภาพของคุณเองหรือยืนยันว่าบุคคลนั้นให้อนุญาตสำหรับการใช้ในวิดีโอสังเคราะห์ตามที่ตั้งใจ การมีภาพพอร์ตเทรตอยู่บนอินเทอร์เน็ตไม่ได้หมายความว่าได้รับอนุญาตให้นำไปทำแอนิเมชันหรือเผยแพร่
บันทึกเสียงบทเรียนที่ฟังดูเป็นธรรมชาติเมื่ออยู่หน้ากล้อง
บันทึกประเด็นการสอนที่ต่อเนื่องหนึ่งประเด็นด้วยจังหวะที่พอดี พารากราฟสั้น ๆ ง่ายต่อการประเมินและแก้ไขมากกว่าการบรรยายทั้งหมด ก่อนบันทึก ให้ตรวจสอบศัพท์เฉพาะ ชื่อ ตัวเลข และข้อกล่าวอ้างเชิงข้อเท็จจริงของบทเรียน เว้นช่วงหยุดตามธรรมชาติระหว่างแนวคิด แต่ตัดช่องว่างยาว ๆ และเสียงรบกวนพื้นหลังที่อาจทำให้ประเมินจังหวะได้ยากขึ้น
ฟังหนึ่งครั้งโดยมีข้อความบทเรียนอยู่ตรงหน้า หากตัวเลขหรือศัพท์ทางเทคนิคไม่ชัดเจนในRecording ให้แก้ไขเสียงต้นฉบับก่อน ใบหน้าที่สร้างขึ้นไม่สามารถซ่อมคำอธิบายที่ไม่ถูกต้องหรือการออกเสียงที่กำกวมได้
ทำให้บทเรียนยังมีประโยชน์แม้ไม่มีอวตาร
เขียนคำอธิบายให้ยังเข้าใจได้เมื่อจับคู่กับสไลด์หรือการจับภาพหน้าจอ ใช้ผู้นำเสนอสำหรับบริบท การเปลี่ยนผ่าน และคำอธิบายสั้น ๆ ใช้การบันทึกหน้าจอสำหรับการกระทำในซอฟต์แวร์ ใช้แผนภาพที่มีป้ายกำกับสำหรับกระบวนการ และใช้ตัวอย่างที่แสดงวิธีทำสำหรับการคำนวณ จากนั้นตัดต่อองค์ประกอบเหล่านั้นเข้าด้วยกันในโปรแกรมตัดต่อคอร์สของคุณ
เตรียมชุดตัวอย่างที่มีภาพพอร์ตเทรต เสียงบรรยายที่สมบูรณ์หนึ่งชิ้น พรอมป์ต์กำหนดทิศทาง และสไลด์หรือการจับภาพหน้าจอประกอบที่คุณคาดว่าจะใช้ สิ่งนี้ให้การทดสอบเชิงปฏิบัติของกระบวนการผลิต แทนที่จะเป็นแอนิเมชันใบหน้าแบบแยกส่วน
วิธีทำวิดีโอผู้สอนหลักสูตรด้วย OmniHuman 2.0
เป้าหมายของการสร้างครั้งแรกคือการตัดสินใจ: การรวมผู้นำเสนอและเสียงนี้ช่วยบทเรียนนี้หรือไม่? ทำให้การทดสอบแคบลงเพื่อให้วินิจฉัยผลลัพธ์ที่อ่อนได้ง่าย
เริ่มด้วยส่วนบทเรียนสั้น ๆ หนึ่งส่วน
เลือกความคิดที่สมบูรณ์ซึ่งแนะนำแนวคิด ให้ตัวอย่างหนึ่งอย่าง และจบด้วยขั้นตอนถัดไปที่ชัดเจน อย่าตัดประโยคครึ่ง ๆ กลาง ๆ เพื่อให้ได้ความยาวตามเป้าหมาย ตัวอย่างที่ให้มาด้านล่างมีความยาว 30 วินาที นานพอที่จะแสดงการกระทำที่มองเห็นได้และมุมกล้องที่เปลี่ยนไป ตรวจสอบความยาวเสียงที่รองรับจริงและกฎอินพุตปัจจุบันในอินเทอร์เฟซโมเดลสดก่อนอัปโหลด
อัปโหลดภาพและเสียงบรรยาย จากนั้นกำหนดทิศทางการแสดง
เปิด เพลย์กราวด์ Avatar Omni Human 2.0 เพื่อตรวจสอบอินพุตปัจจุบัน เตรียมภาพและเสียงบรรยายด้วยตัวคุณเอง; รายการโมเดลอธิบายภาพและเสียงเป็นวิดีโอ ไม่ใช่เวิร์กโฟลว์ข้อความเป็นเสียง หากคุณยังไม่ได้บันทึกเสียง ให้สร้างและตรวจสอบในเวิร์กโฟลว์เสียงที่คุณต้องการก่อนขั้นตอนนี้
สำหรับเวิร์กโฟลว์นี้ เสียงที่ให้มาจะกำหนดคำพูดและจังหวะ พรอมป์ต์ข้อความกำหนดการกระทำที่มองเห็นได้ สีหน้า และการเคลื่อนกล้อง ตรวจสอบผลลัพธ์ที่คุณสร้างเองก่อนจะอธิบายการเคลื่อนไหวที่วางแผนไว้ว่าเป็นเอาต์พุตที่สำเร็จ Atlas Cloud ระบุเอาต์พุต 720p และคลิปนานสูงสุดห้านาที แต่ตัวควบคุมสดและงานที่เสร็จสมบูรณ์คือการตรวจสอบขั้นสุดท้ายสำหรับการรันของคุณเอง
ตรวจสอบคลิปก่อนทำบทเรียนเต็ม
ดูผลลัพธ์หนึ่งครั้งพร้อมเสียง จากนั้นอีกครั้งพร้อมอ่านข้อความบทเรียน สังเกตช่วงเวลาที่การขยับปาก การหยุด หรือท่าทางรู้สึกว่ารบกวนสมาธิ หากปัญหาเกิดที่วลีใดวลีหนึ่ง ให้ย่อหรือบันทึกประโยคนั้นใหม่ และสร้างเฉพาะส่วนที่แก้ไขแล้ว หากใบหน้ายังดูน่าเชื่อถือแต่คำอธิบายต้องการแผนภาพ ให้เก็บช็อตผู้นำเสนอไว้และเพิ่มภาพเหล่านั้นในการตัดต่อ
หลังจากส่วนหนึ่งผ่านการตรวจสอบแล้วเท่านั้น จึงนำภาพพอร์ตเทรตที่อนุมัติแล้ว สไตล์การบันทึก และโครงสร้างพรอมป์ต์ไปใช้กับส่วนบทเรียนถัดไป ความสม่ำเสมอมาจากกระบวนการป้อนข้อมูลที่ทำซ้ำได้ ไม่ได้หมายความว่าทุกส่วนที่สร้างขึ้นจะเหมือนกันทุกประการ
ตัวอย่างที่แสดงวิธีทำ: บทเรียนคอนทราสต์สี 30 วินาที
บทเรียนมีงานด้านภาพหนึ่งอย่าง: ทำให้ผู้เรียนเห็นว่าการจับคู่สีคอรัลและทีลที่สดใสเปลี่ยนไปอย่างไรเมื่อสีเหลืองที่นุ่มนวลกว่าเข้ามาในองค์ประกอบ ภาพผู้สอนที่ให้มา สองเฟรมที่เลือกจากวิดีโอที่เสร็จสมบูรณ์ และคลิปเต็มช่วยให้คุณตรวจสอบการกระทำการสอนจริง แทนที่จะอนุมานจากพรอมป์ต์ ตัวอย่างนี้แสดงการออกแบบฉากและการตรวจทานเชิงบรรณาธิการ; ทดสอบเวิร์กโฟลว์ที่อธิบายข้างต้นด้วยภาพและเสียงที่คุณอนุมัติเองก่อนสรุปเกี่ยวกับเอาต์พุต
เริ่มด้วยองค์ประกอบที่สนับสนุนการสอน
ภาพอินพุตมีใบหน้าที่ชัดเจนและมือที่มองเห็นได้ พร้อมการ์ดผิวด้านสามใบวางบนโต๊ะทำงาน สีคอรัล ทีล และเหลืองมีอยู่ทั้งหมดก่อนการเคลื่อนไหวใด ๆ จะเริ่มขึ้น ซุ้มทีล แผงคอรัล และแก้วอำพันของสตูดิโอสร้างฉากที่มีสีสัน ขณะที่ยังทำให้การ์ดแยกแยะได้ง่าย
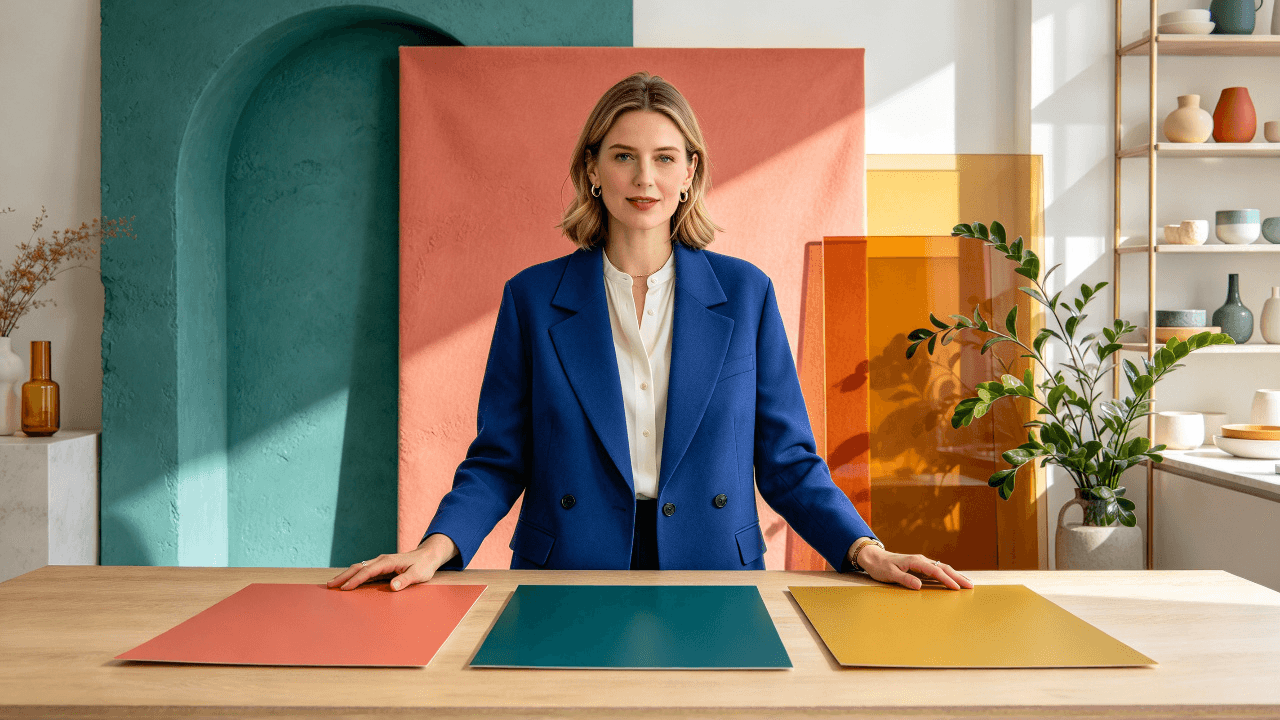
ภาพอ้างอิงที่ให้มาทำให้ใบหน้า มือ และอุปกรณ์ประกอบการสอนสามชิ้นของผู้สอนมองเห็นได้ชัดเจนก่อนทำแอนิเมชัน
การเปรียบเทียบครั้งแรกอ่านได้ชัด
ในช่วงต้นของคลิป ผู้สอนหันความสนใจไปที่โต๊ะทำงานและวางมือไว้ใกล้ขอบเขตคอรัลและทีล กล้องขยับเข้ามาใกล้กว่าในภาพนิ่งอ้างอิง แต่ใบหน้าและสีเดิมทั้งสามยังคงมองเห็นได้ เฟรมนี้แสดงการกระทำที่ผู้เรียนต้องติดตาม: เปรียบเทียบสีที่อยู่ติดกันสองสีก่อนเปลี่ยนองค์ประกอบ
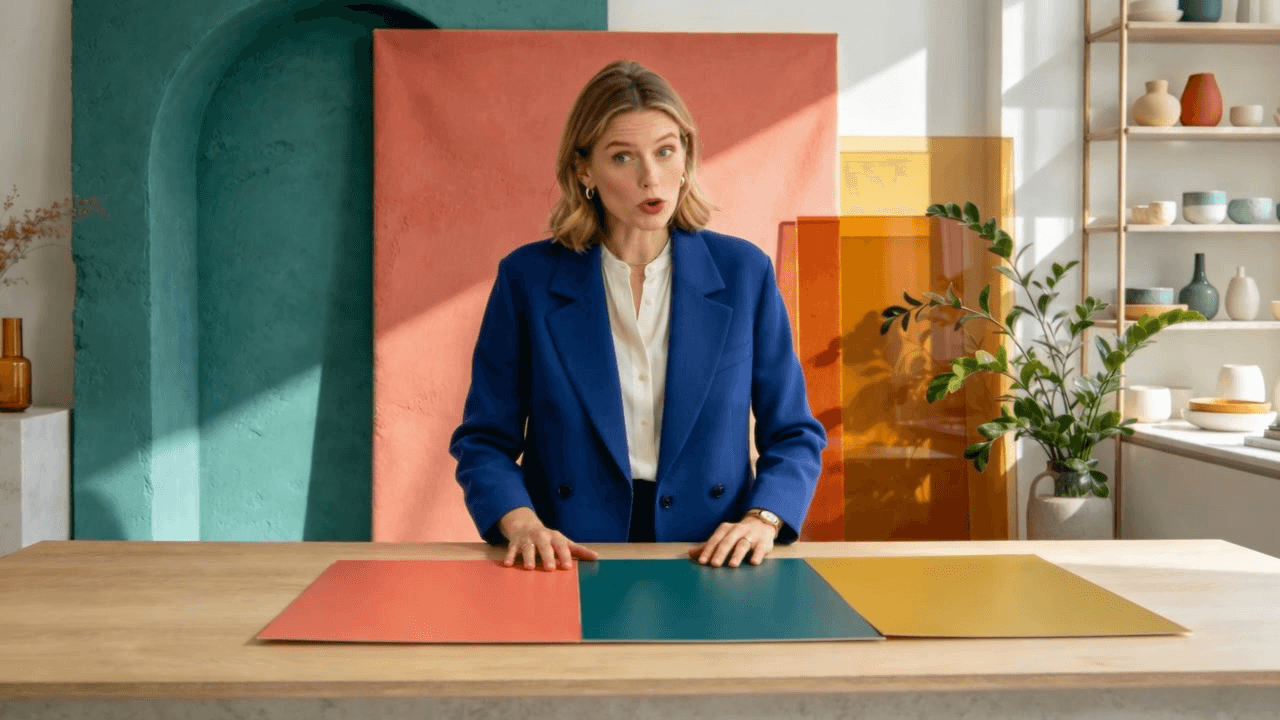
เฟรมจริงจากวิดีโอที่ให้มา: ผู้สอนชี้นำความสนใจไปที่ขอบคอรัลและทีล ขณะที่การ์ดทั้งสามยังคงมองเห็นได้
มุมมองที่เปลี่ยนไปเผยปัญหาความต่อเนื่อง
ต่อมา มุมมองเปลี่ยนไปยังอีกด้านของโต๊ะ และผู้สอนทำท่าทางไปทางสีเหลือง การ์ดสีทีลไม่ปรากฏให้เห็นอีกต่อไป นั่นแตกต่างจากองค์ประกอบสามการ์ดที่วางแผนไว้ ซึ่งสีเหลืองควรอยู่ระหว่างคอรัลและทีล ช็อตที่ใกล้ขึ้นและสีหน้าช่วยให้ฉากมีความหลากหลาย แต่การ์ดที่หายไปเปลี่ยนตัวอย่างการสอน หากนี่เป็นบทเรียนคอร์สขั้นสุดท้าย การเปลี่ยนอุปกรณ์ประกอบฉากจะต้องถ่ายใหม่หรือตัดต่อเพื่อให้การเปรียบเทียบที่ตั้งใจไว้ถูกต้อง
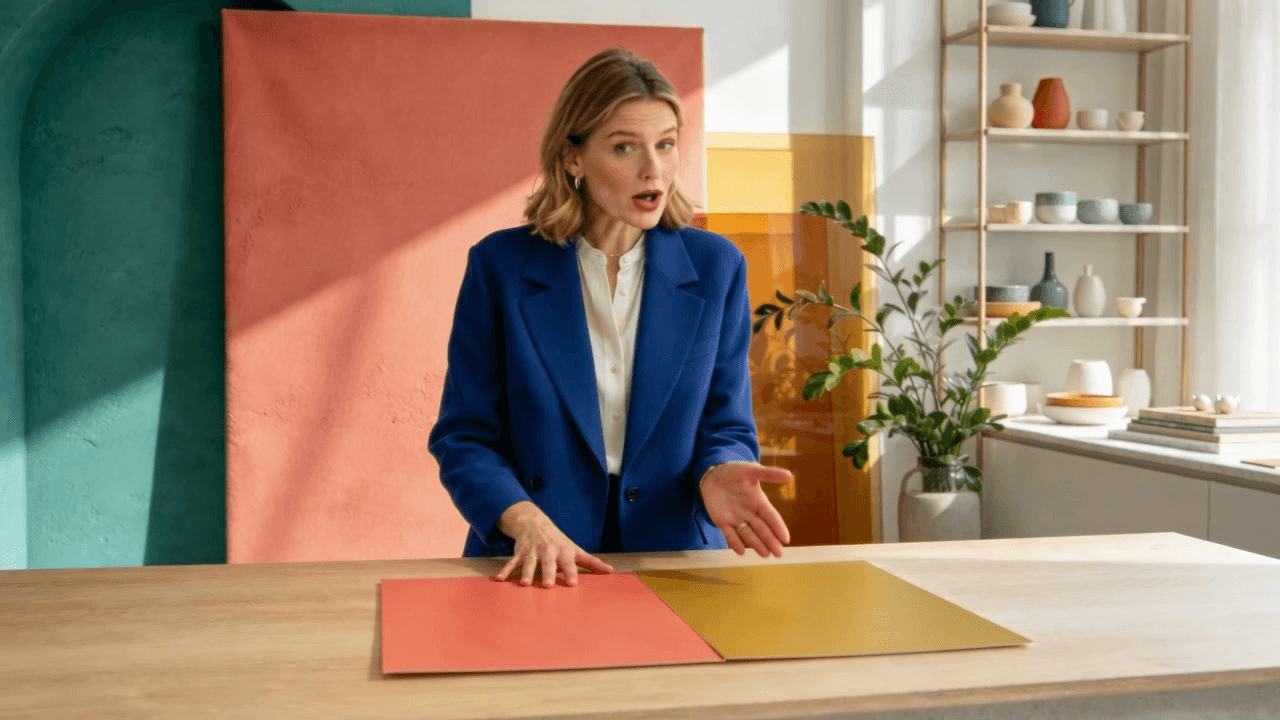
เฟรมต่อมาของคลิปเดียวกัน: มุมกล้องและท่าทางเปลี่ยนไป ขณะที่การ์ดสีทีลหายไปจากองค์ประกอบ
ดูฉากที่สมบูรณ์พร้อมเสียง
วิดีโอที่ให้มาความยาวกว่าประมาณ 30 วินาทีเล็กน้อยและมีแทร็กเสียง ดูเป็นตัวอย่างต่อเนื่องหนึ่งชิ้นเพื่อให้ตัดสินท่าทาง สีหน้า การเคลื่อนกล้อง และเสียงร่วมกัน ภาพนิ่งสองภาพด้านบนเป็นหลักฐานของช่วงเวลาที่ต่างกัน ไม่ใช่กรณีที่สร้างแยกจากกัน
ฉากนี้ประสบความสำเร็จในการให้ผู้สอนมีอะไรทำมากกว่าแค่หันหน้าเข้ากล้อง: เธอจัดการอุปกรณ์ประกอบฉาก เปลี่ยนสายตา และถูกนำเสนอจากมากกว่าหนึ่งมุมมอง การ์ดสีทีลที่หายไปคือสิ่งที่สำคัญที่พบจากการตรวจทาน เก็บบทเรียนสุดท้ายไว้เฉพาะเมื่อตัวอย่างภาพตรงกับสิ่งที่ผู้เรียนควรเข้าใจ และตรวจสอบคำอธิบายที่พูดเทียบกับเสียงก่อนเผยแพร่
วิธีตรวจสอบว่าวิดีโอผู้สอนด้วย AI พร้อมหรือยัง
ใช้รอบการตรวจทานที่ตรวจสอบทั้งการแสดงที่สร้างขึ้นและบทเรียนในแบบที่ผู้เรียนจะเห็น:
- จังหวะปาก: การขยับปากตรงกับพยางค์หลักและการหยุดโดยรวมหรือไม่? เล่นชื่อที่ออกเสียงยากและช่วงหยุดสั้น ๆ ซ้ำ
- สีหน้า: ใบหน้าเหมาะสมกับคำอธิบายที่สงบหรือไม่ หรือเปลี่ยนเป็นรอยยิ้มที่ไม่เกี่ยวข้องหรืออารมณ์ที่เกินจริง?
- ท่าทาง: มืออยู่ห่างจากใบหน้าและไม่เบี่ยงเบนความสนใจจากสไลด์สำคัญหรือไม่?
- ตัวตนและฉาก: ลักษณะใบหน้า เสื้อผ้า และฉากหลังคงที่ตลอดคลิปหรือไม่?
- ความถูกต้องของเสียง: ศัพท์ ชื่อ และตัวเลขออกเสียงถูกต้องในRecording ที่ให้มาหรือไม่?
- ความชัดเจนในการสอน: การตัดต่อมีสไลด์ การจับภาพหน้าจอ คำบรรยาย หรือตัวอย่างที่แสดงวิธีทำในจังหวะที่เหมาะสมหรือไม่?
- สิทธิ์และการเปิดเผย: คุณมีสิทธิ์สำหรับภาพและเสียงหรือไม่ และคุณได้ตรวจสอบกฎการเปิดเผยและนโยบายของสถาบันสำหรับผู้ชมและตลาดที่ตั้งใจไว้หรือยัง?
ตัดสินใจว่าจะเก็บคลิป แก้ไขเสียงหรือภาพต้นฉบับ หรือใช้เสียงบรรยายกับสไลด์แทน อย่าเก็บช็อตผู้นำเสนอเพียงเพราะการสร้างใช้เวลา การบันทึกหน้าจอที่ชัดเจนอาจสอนขั้นตอนตามกระบวนการได้ดีกว่า
ค่าใช้จ่ายและการขยายสำหรับวิดีโอคอร์ส
ณ เดือนตุลาคม 2026 หน้าโมเดลของ Atlas Cloud ระบุอัตรามาตรฐาน $0.07 ต่อวินาที และแสดงอัตราลด $0.056 ต่อวินาทีพร้อมส่วนลด 20% การประมาณการอย่างง่ายจากอัตราที่ระบุเหล่านั้นคือ:
| ระยะเวลาที่สร้าง | ที่ $0.07/วินาที | ที่แสดง $0.056/วินาที |
|---|---|---|
| 20 วินาที | $1.40 | $1.12 |
| 60 วินาที | $4.20 | $3.36 |
| 5 นาที | $21.00 | $16.80 |
สิ่งเหล่านี้เป็นการคำนวณตามอัตราโมเดล ไม่ใช่ใบเสนอราคาสำหรับบัญชีของคุณหรือการรับประกันค่าบริการสุดท้าย ส่วนลดที่แสดงอาจเปลี่ยนแปลง และภาษี เงื่อนไขระดับบัญชี หรือค่าใช้จ่ายอื่น ๆ อาจส่งผลต่อการชำระเงิน ตรวจสอบรายละเอียดโมเดลและหน้าจอยืนยันจริงอีกครั้งก่อนผลิต
ตัวอย่างสั้น ๆ จำกัดค่าใช้จ่ายในการตรวจสอบภาพพอร์ตเทรต เสียง หรือพรอมป์ต์ใหม่ สำหรับเนื้อหาที่ยาวกว่า ให้แบ่งบทเรียนที่ขอบเขตการสอนจริง เช่น แนวคิดใหม่หรือตัวอย่างที่แสดงวิธีทำ อย่าแยกประโยคหรือลบคำอธิบายที่จำเป็นเพียงเพื่อให้ตรงกับขีดจำกัดการสร้าง ที่อัตรามาตรฐานที่ระบุ เอาต์พุตห้านาทีจะอยู่ที่ $21 ก่อนส่วนลดที่อาจใช้ได้ เปรียบเทียบกับส่วนที่สั้นกว่าบวกเวลาตัดต่อและตัดสินว่ารูปแบบใดตอบโจทย์บทเรียน
ความเป็นส่วนตัว ความยินยอม และความน่าเชื่อถือของคอร์ส
ก่อนสร้าง ให้ยืนยันว่าคุณสามารถใช้ภาพพอร์ตเทรตและเสียงของผู้สอนสำหรับวิดีโอสังเคราะห์ในคอร์ส ช่องทางการเผยแพร่ และระยะเวลาที่ตั้งใจไว้ หากมีผู้รับจ้าง พนักงาน วิทยากรรับเชิญ หรือนักศึกษาปรากฏอยู่ ให้บันทึกการอนุญาตและข้อจำกัดใด ๆ ตรวจสอบข้อกำหนดของสถาบันของคุณสำหรับสื่อที่สร้างหรือดัดแปลงด้วย AI และกฎที่บังคับใช้ในตลาดเป้าหมายของคุณ บทความนี้ไม่ได้กำหนดพันธะทางกฎหมาย
ตรวจทานบทเรียนที่เสร็จแล้วเหมือนที่ผู้สอนจะทำ แก้ไขสคริปต์และการบันทึก เปิดเผยการนำเสนอแบบสังเคราะห์ในจุดที่ผู้ชมหรือนโยบายคาดหวัง และให้มนุษย์รับผิดชอบต่อข้อกล่าวอ้างของคอร์ส ผู้นำเสนอที่ขัดเกลาสามารถทำให้เนื้อหาที่อ่อนแอหรือไม่ตรวจสอบดูน่าเชื่อถือ ดังนั้นเจ้าของบทเรียนควรอนุมัติทั้งคำพูดและการตัดต่อขั้นสุดท้าย
สำหรับการผลิตครั้งแรก ทำส่วนสั้น ๆ หนึ่งส่วน ตรวจสอบกับรายการตรวจสอบ และประมาณการชุดถัดไปโดยใช้อัตราต่อวินาทีปัจจุบัน การตัดสินใจเล็ก ๆ นี้บอกคุณว่า วิดีโอผู้สอนหลักสูตรด้วย AI OmniHuman 2.0 ควรอยู่ในเวิร์กโฟลว์คอร์สของคุณหรือไม่
คำถามที่พบบ่อย
OmniHuman 2.0 สร้างวิดีโอคอร์สจากข้อความอย่างเดียวได้หรือไม่?
รายการของ Atlas Cloud อธิบายเวิร์กโฟลว์ภาพและเสียงเป็นวิดีโอพร้อมการกำหนดทิศทางด้วยข้อความเสริม ไม่ได้ระบุข้อความธรรมดาเป็นสิ่งทดแทนเสียงบรรยาย ดังนั้นให้เตรียมแทร็กเสียงแยกต่างหาก
ฉันสามารถใช้ภาพผู้สอนเดิมซ้ำในหลายบทเรียนได้หรือไม่?
คุณสามารถเตรียมภาพที่อนุมัติแล้วเดิมสำหรับการสร้างแยกครั้งได้ การใช้ซ้ำช่วยให้มีการอ้างอิงภาพที่สม่ำเสมอ แม้จะไม่รับประกันสีหน้า การจัดเฟรม หรือท่าทางที่เหมือนกันในทุกเอาต์พุต ตรวจสอบแต่ละส่วนก่อนนำมาต่อกัน
OmniHuman 2.0 สร้างเสียงบทเรียนหรือไม่?
เวิร์กโฟลว์ที่ระบุใช้แทร็กเสียงเป็นอินพุต บันทึกหรือผลิตเสียงแยกต่างหาก ตรวจสอบ และอัปโหลดเสียงบรรยายที่เสร็จแล้ว
คลิปคอร์ส OmniHuman 2.0 ความยาว 20 วินาทีราคาเท่าไรบน Atlas Cloud?
ที่อัตรามาตรฐานที่ระบุ $0.07 ต่อวินาที 20 วินาทีคำนวณเป็น $1.40 ที่อัตราที่แสดง $0.056 คำนวณเป็น $1.12 ยืนยันราคาปัจจุบันและค่าบริการสุดท้ายก่อนรันการสร้าง


