คุณอาจไม่จำเป็นต้องใช้โมเดล Qwen ที่ใหญ่ที่สุด สำหรับนักพัฒนาส่วนใหญ่ที่ค้นหา โมเดล Qwen ที่ดีที่สุดสำหรับการเขียนโค้ดแบบโลคอล คำตอบที่ใช้ได้จริงคือ Qwen3 Coder 30B A3B โดยปกติผ่าน qwen3-coder:30b ใน Ollama หรือ GGUF ที่โหลดใน LM Studio
ส่วนที่ทำให้สับสนไม่ใช่คำถามว่า Qwen เขียนโค้ดได้หรือไม่ แต่เป็นว่าเครื่องของคุณรับ Qwen รุ่นไหนไหวขณะที่เอเจนต์อ่านไฟล์ เขียนแพตช์ และรันเทสต์ โดยไม่ทำให้การแก้บั๊กวันอังคารกลายเป็นโปรเจกต์ฮาร์ดแวร์
คู่มือนี้เลือกตามเวิร์กโฟลว์จริง: ระดับหน่วยความจำของคุณ เอเจนต์ของคุณ หน้าต่างคอนเท็กซ์ และลูปเทสต์ของคุณ ใช้ Qwen โลคอลก่อนเมื่อความเป็นส่วนตัวสำคัญ ใช้ Qwen แบบโฮสต์เมื่อ repo ใหญ่เกินไป แพตช์มีความเสี่ยง หรือแล็ปท็อปของคุณกำลังทำงานหนักอย่างชัดเจน
ประเด็นสำคัญ
- ตัวเลือกโลคอลที่เหมาะใช้งานจริงที่สุด: Qwen3 Coder 30B
- ระดับฮาร์ดแวร์ที่เหมาะสมที่สุด: VRAM 24GB หรือ RAM 32GB ขึ้นไป
- เวิร์กโฟลว์ที่ดีที่สุด: Ollama หรือ LM Studio ร่วมกับ Cline, Continue หรือ Aider
- สาเหตุที่ล้มเหลวมากที่สุด: คอนเท็กซ์ไม่ดีและการตั้งค่าเอเจนต์อ่อน
- ทางเลือกสำรองที่ดีที่สุด: รีวิว Qwen แบบโฮสต์สำหรับแพตช์เสี่ยงหนึ่งรายการ
เวิร์กโฟลว์การแก้บั๊ก checkout ด้วย Qwen โลคอลแบบแอนิเมชัน
ตัวอย่างเวิร์กโฟลว์แบบแอนิเมชัน: เริ่มจากแผนเทสต์ checkout ขอให้ Qwen โลคอลแก้เส้นทาง state ของ React ที่เล็กที่สุด แล้วรันการตรวจสอบอีกครั้ง
ทำไมโมเดล Qwen ที่ดีที่สุดสำหรับการเขียนโค้ดแบบโลคอลจึงสับสนในปี 2026
การตั้งชื่อของ Qwen ตอนนี้ครอบคลุมโมเดลแชตขนาดเล็ก โมเดลเขียนโค้ดแบบคอนเท็กซ์ยาว รุ่น MoE และตัวเลือก frontier แบบโฮสต์ ผลการค้นหาหนึ่งรายการอาจพูดถึง Qwen3 Coder 30B, Qwen3 Coder Next, Qwen3.6, 480B, GGUF, MLX, Q4, Q8, A3B และ A35B ในประโยคเดียวกัน นั่นคือป้ายกำกับจำนวนมากก่อนที่คุณจะเปิด VS Code ด้วยซ้ำ
ความแตกต่างที่มีประโยชน์นั้นง่ายมาก โมเดลเขียนโค้ดแบบโลคอลต้องทำมากกว่าตอบคำถามเรื่องโค้ด มันต้องจำบริบทของ repository ทำตาม tool call เขียน diff ที่น้อยที่สุด และกู้คืนจากผลลัพธ์เทสต์ Qwen3 Coder 30B A3B น่าสนใจเพราะการ์ดโมเดลระบุว่ามีพารามิเตอร์รวม 30.5B พารามิเตอร์ที่เปิดใช้งาน 3.3B คอนเท็กซ์เนทีฟ 262,144 โทเค็น สัญญาอนุญาต Apache 2.0 และพฤติกรรม instruct แบบ non-thinking (การ์ดโมเดล Hugging Face, เข้าถึงเมื่อสิงหาคม 2026)
สาย Qwen3 Coder ระดับ 480B เป็นเครื่องคนละคลาส การเปิดตัว Qwen3 Coder อย่างเป็นทางการวางตำแหน่งไว้รอบ agentic coding, การใช้เบราว์เซอร์, การใช้เครื่องมือ และคอนเท็กซ์เนทีฟ 256K ที่ขยายถึง 1M ผ่าน YaRN (Qwen Team, กรกฎาคม 2025) ขนาดนั้นสำคัญสำหรับการตั้งค่าแบบโฮสต์หรือเซิร์ฟเวอร์ แต่ไม่ได้ทำให้แล็ปท็อป 16GB ของคุณกลายเป็นเวิร์กสเตชัน 480B
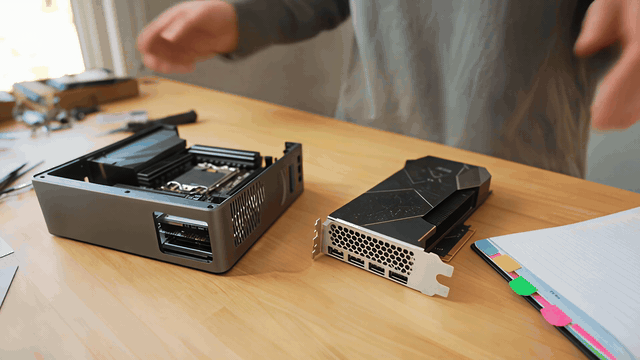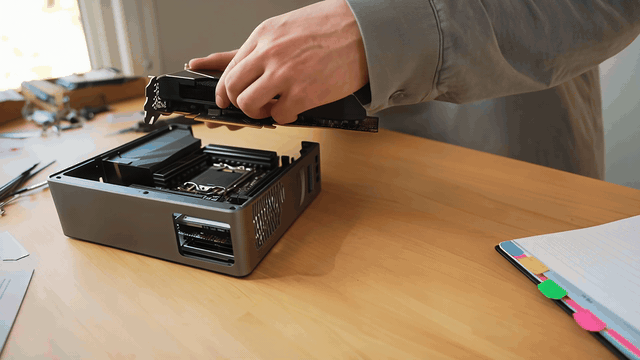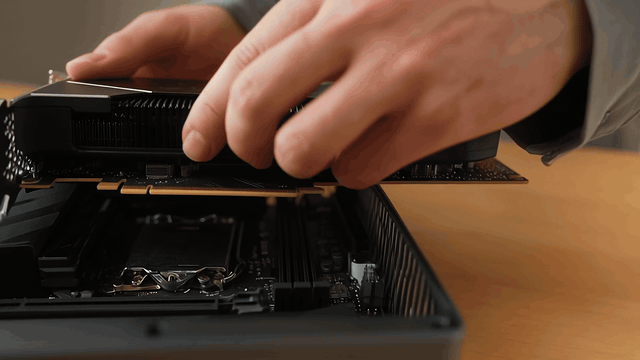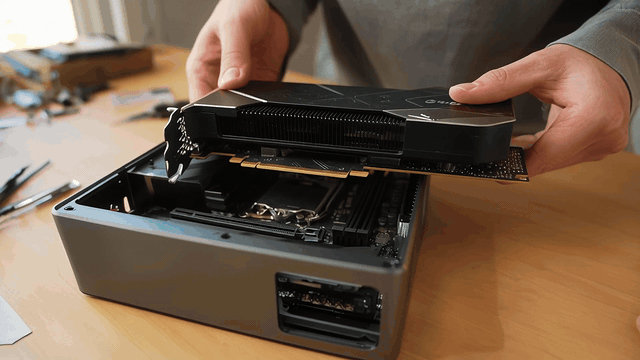
เวิร์กโฟลว์เตรียมฮาร์ดแวร์สำหรับ Qwen โลคอลแบบแอนิเมชัน
ตัวอย่างเวิร์กโฟลว์แบบแอนิเมชัน: ตรวจสอบฮาร์ดแวร์โลคอลขนาดกะทัดรัดก่อนโหลด Qwen เพราะ VRAM และความจุคอนเท็กซ์เป็นตัวกำหนดว่าการรันเขียนโค้ดจะยังใช้งานได้หรือไม่
โมเดล Qwen ที่ดีที่สุดสำหรับการเขียนโค้ดแบบโลคอลตามระดับฮาร์ดแวร์
เริ่มจากฮาร์ดแวร์ที่คุณมี แท็กเริ่มต้น qwen3-coder:30b บน Ollama เป็นอาร์ติแฟกต์ Q4_K_M ขนาดประมาณ 19GB และเปิดใช้ได้ด้วย ollama run qwen3-coder:30b (คลัง Ollama, เข้าถึงเมื่อสิงหาคม 2026) ขนาดนี้ทำให้มันสมจริงสำหรับเดสก์ท็อปจริงจัง ไม่ใช่แล็ปท็อปขนาดเล็ก
Atlas Cloud เหมาะเป็นเลนตรวจสอบ ไม่ใช่ตัวแทนของความเป็นส่วนตัวแบบโลคอล หากเครื่องของคุณรับโมเดลไม่ได้ หรือคุณต้องการความเห็นที่สองต่อแพตช์เสี่ยง ให้รันพรอมป์ต์เดียวกันหนึ่งครั้งผ่าน Atlas Cloud แล้วนำรีวิวกลับเข้าสู่เวิร์กโฟลว์โลคอลของคุณ
| ระดับฮาร์ดแวร์ | Qwen ที่เหมาะใช้งานจริง | รันไทม์ | การใช้งานที่ดีที่สุด | ข้อควรระวัง | ทางเลือกโฮสต์ |
|---|---|---|---|---|---|
| 16GB VRAM / 32GB RAM | Qwen3 Coder 30B Q4 พร้อม offload | Ollama หรือ LM Studio | แก้บั๊กเล็ก ๆ, รันเทสต์, แชตโลคอล | คอนเท็กซ์ยาวจะช้า | Qwen3 Coder Next บน Atlas |
| 24GB VRAM | Qwen3 Coder 30B Q4 หรือ Q5 | Cline, Continue, Aider | เขียนโค้ดโลคอลประจำวัน | ปรับคอนเท็กซ์ก่อนโทษโมเดล | Qwen3 Coder Next |
| หน่วยความจำแบบรวมหรือ RAM 64GB | Qwen3 Coder 30B Q8 หรือ Qwen coder รุ่นใหญ่กว่า | LM Studio, llama.cpp, vLLM | แก้ไขหลายไฟล์และรีวิว repo | แรงกดดัน KV cache | Qwen3.6 35B A3B เพื่อเปรียบเทียบ |
| 128GB ขึ้นไป | Qwen3 Coder Next หรือการทดลอง quantized ขนาดใหญ่กว่าเมื่อมีให้ใช้ | llama.cpp, vLLM, SGLang | ลูปเอเจนต์ระดับ repo | เวลาติดตั้งและความร้อน | Atlas สำหรับรีวิว A/B แบบเร็ว |
| ไม่มีฮาร์ดแวร์โลคอลที่เหมาะสม | Qwen แบบโฮสต์ | โมเดลเพลย์กราวด์หรือ API ของ Atlas | รีวิวแพตช์และพรอมป์ต์ยาว | ปฏิบัติตามนโยบายความเป็นส่วนตัวของโค้ด | รันโฮสต์โดยตรง |
สำหรับทางเลือกโฮสต์สำรอง หน้า Atlas แบบเรียลไทม์แสดงราคา LLM เหล่านี้ระหว่างการตรวจสอบในเดือนสิงหาคม 2026: Qwen3 Coder Next ที่คอนเท็กซ์ 262.14K, $0.18/ล้านโทเค็นอินพุต และ $1.35/ล้านโทเค็นเอาต์พุต; Qwen3.6 35B A3B ที่คอนเท็กซ์ 262.14K โดยหน้ารายละเอียดแสดง $0.248/ล้านโทเค็นอินพุต และ $1.485/ล้านโทเค็นเอาต์พุต พร้อมตัวบ่งชี้ส่วนลด 35%; และ Qwen3.6 Plus ในรายการโมเดลที่คอนเท็กซ์ 1,000K, $0.325/ล้านโทเค็นอินพุต และ $1.95/ล้านโทเค็นเอาต์พุต ตรวจสอบ ตัวสำรวจโมเดล Atlas แบบเรียลไทม์ ก่อนจัดงบสำหรับการรันยาว
| รันไทม์ | เหมาะกับใคร | รูปแบบ endpoint | ค่าเริ่มต้นที่ดี | ข้อควรระวัง |
|---|---|---|---|---|
| Ollama | เริ่มต้นโลคอลเร็วที่สุด | โฮสต์ Ollama โลคอล | qwen3-coder:30b | ต้องตั้งค่าคอนเท็กซ์อย่างตั้งใจ |
| LM Studio | ผู้ใช้ Mac และ GUI | เซิร์ฟเวอร์โลคอลที่เข้ากันได้กับ OpenAI | Q4/Q5 GGUF | โหลดคอนเท็กซ์ก่อนเปิดเอเจนต์ |
| llama.cpp | การควบคุมการควอนไทซ์ขั้นสูง | แฟล็กเซิร์ฟเวอร์โลคอล | Q4_K_M หรือ Q8 | ต้องปรับด้วยตัวเองมากกว่า |
| vLLM / SGLang | การเสิร์ฟให้ทีมหรือแล็บ | เซิร์ฟเวอร์ที่เข้ากันได้กับ OpenAI | BF16 หรือ FP8 เมื่อรองรับ | ความซับซ้อนของฮาร์ดแวร์และการตั้งค่า |
ขั้นตอนที่ 1: ติดตั้งและเชื่อมต่อโมเดล Qwen ที่ดีที่สุดสำหรับการเขียนโค้ดแบบโลคอล
ติดตั้งด้วย Ollama. Ollama เป็นเส้นทางที่ทำซ้ำได้เร็วที่สุด ดึงโมเดลก่อน จากนั้นเริ่มแชตโลคอลเพื่อยืนยันว่าโมเดลตอบสนองก่อนเชื่อมต่อกับเอเจนต์
plaintext1ollama pull qwen3-coder:30b 2ollama run qwen3-coder:30b
พรอมป์ต์ที่ต้องวาง:
plaintext1You are a local coding assistant. Reply with one sentence confirming that you can inspect code, propose patches, and explain test failures. Do not write code yet.
การตั้งค่าที่ควรเลือก:
| การตั้งค่า | ค่า |
|---|---|
| รันไทม์ | Ollama |
| โมเดล | qwen3-coder:30b |
| คอนเท็กซ์ | เริ่มที่ 32K หรือ 64K |
| อุณหภูมิ | 0.2 สำหรับแก้บั๊ก, 0.7 สำหรับคุยเรื่องดีไซน์ |
| top_p / top_k | 0.8 / 20 |
| repetition_penalty | 1.05 |
เชื่อมต่อเอเจนต์เขียนโค้ด
ใช้ Cline, Continue หรือ Aider Cline เป็นเอเจนต์แรกที่ดี เพราะคู่มือโมเดลโลคอลของมันแนะนำ Qwen3 Coder 30B ระบุประโยชน์ด้านความเป็นส่วนตัวที่ไม่มีค่า API และเตือนว่าโมเดลเล็กลงอาจล้มเหลวกับรูปแบบ tool-use (เอกสาร Cline, เข้าถึงเมื่อสิงหาคม 2026)
พรอมป์ต์ที่ต้องวาง:
plaintext1Inspect this repository without editing files. Summarize the app structure, identify the test command, and tell me which files are likely involved in the failing checkout discount behavior.
การตั้งค่าที่ควรเลือก:
| การตั้งค่า | ค่า |
|---|---|
| ผู้ให้บริการ | Ollama หรือ endpoint โลคอลที่เข้ากันได้กับ OpenAI |
| Base URL | localhost:11434 หรือรูปแบบ /v1 ที่เครื่องมือต้องการ |
| โมเดล | qwen3-coder:30b |
| คอนเท็กซ์ | 64K สำหรับ repo ขนาดกลาง |
| อุณหภูมิ | 0.2 |
| สิทธิ์ | อ่านอย่างเดียวในตอนแรก |
| ตัวเลือกเอเจนต์ | เปิด compact prompt เมื่อมีให้ใช้ |
ขั้นตอนที่ 2: ใช้โมเดล Qwen ที่ดีที่สุดสำหรับการเขียนโค้ดแบบโลคอลกับบั๊กที่แก้ด้วยเทสต์ก่อน
อย่าขอคำอธิบายสวย ๆ ก่อน ให้โมเดลอ่านเทสต์ที่ล้มเหลว แพตช์เส้นทางโค้ดที่เล็กที่สุด และรายงานผลเทสต์ที่แน่นอน การเขียนโค้ดแบบโลคอลจะได้รับความไว้วางใจเมื่อเทอร์มินัลดีขึ้น
พรอมป์ต์ที่ต้องวาง:
plaintext1Fix the checkout discount bug using a tests-first workflow. 2 3Rules: 41. Read the failing test output before editing. 52. Identify the smallest code path that can cause the discount to apply twice after quantity changes. 63. Patch only the necessary files. 74. Do not change public component props. 85. After editing, run the relevant test command and report the exact result.
การตั้งค่าที่ควรเลือก:
| การตั้งค่า | ค่า |
|---|---|
| โมเดล | qwen3-coder:30b |
| อุณหภูมิ | 0.2 |
| คอนเท็กซ์ | 64K |
| Compact prompt | เปิด |
| อนุญาตเครื่องมือ | อ่านไฟล์, แก้ไฟล์, รันคำสั่งเทสต์ |
เวิร์กโฟลว์แก้บั๊กด้วย Qwen โลคอลแบบเทสต์ก่อน
ตัวอย่างเวิร์กโฟลว์แบบแอนิเมชัน: ใช้เทสต์ checkout ที่ล้มเหลวหนึ่งรายการเพื่อจำกัดการแก้ไข ทำการแก้ไขที่เล็กที่สุด และปิดท้ายด้วยการตรวจสอบผลลัพธ์
ขั้นตอนที่ 3: ลองรีแฟกเตอร์ข้ามไฟล์ด้วย Qwen3 Coder 30B
หลังจากแก้บั๊กหนึ่งรายการได้แล้ว ลองรีแฟกเตอร์แบบควบคุมไว้ คุมงานให้แคบ รักษาชื่อฟังก์ชันสาธารณะ และบังคับให้มีเทสต์ นี่คือจุดที่โมเดลโลคอลขนาดเล็กกว่าหลายตัวหลุด เพราะต้องจำตัวห่อเก่า ชนิดข้อมูลใหม่ และจุดเรียกใช้สองจุดพร้อมกัน
พรอมป์ต์ที่ต้องวาง:
plaintext1Refactor the billing API client into a typed service. 2 3Goal: 4- Create a BillingService with typed request and response objects. 5- Keep the existing public function names working through thin wrappers. 6- Update the two current call sites. 7- Add or update tests for the wrapper behavior. 8- Do not introduce a new dependency. 9- Show the final diff summary and test result.
การตั้งค่าที่ควรเลือก:
| การตั้งค่า | ค่า |
|---|---|
| โมเดล | qwen3-coder:30b |
| อุณหภูมิ | 0.2 |
| คอนเท็กซ์ | 96K หาก repo มีไฟล์ที่เกี่ยวข้องจำนวนมาก |
| ถ้าช้า | ลดไฟล์ที่รวมไว้และระบุรายการไฟล์ให้ชัดเจน |
เวิร์กโฟลว์วางแผนรีแฟกเตอร์ข้ามไฟล์แบบแอนิเมชัน
ตัวอย่างเวิร์กโฟลว์แบบแอนิเมชัน: วางเส้นทางเซอร์วิสที่ได้รับผลกระทบ ย้ายความรับผิดชอบหนึ่งขอบเขต แล้วรักษาตัวห่อและเทสต์ให้สอดคล้องกัน
ขั้นตอนที่ 4: ใช้ Fill-in-the-Middle ของ Qwen Local Coding เฉพาะจุดที่เหมาะ
Fill-in-the-middle ยอดเยี่ยมสำหรับเนื้อหาฟังก์ชันที่หายไปเพียงส่วนเดียวหรือช่องว่างการเติมโค้ดในเอดิเตอร์ แต่เป็นรูปแบบที่ผิดสำหรับงาน repo ทั้งหมด เพราะมันไม่ได้พา planning, tool use และลูปฟีดแบ็กแบบเดียวกันมา
พรอมป์ต์ที่ต้องวาง:
plaintext1Complete only the missing function body. Preserve the surrounding code style and do not add explanations. 2 3<|fim_prefix|> 4export function normalizeDiscountCode(input: string): string { 5<|fim_suffix|> 6} 7 8export function isValidDiscountCode(input: string): boolean { 9 return /^[A-Z0-9-]{4,24}$/.test(normalizeDiscountCode(input)); 10} 11<|fim_middle|>
การตั้งค่าที่ควรเลือก:
| การตั้งค่า | ค่า |
|---|---|
| อุณหภูมิ | 0.1 |
| เอาต์พุตสูงสุด | 300 โทเค็น |
| ใช้ | เติมโค้ดในเอดิเตอร์หรือแชตโลคอลโดยตรง |
| หลีกเลี่ยง | การรีแฟกเตอร์กว้าง ๆ และงานเอเจนต์หลายไฟล์ |
ขั้นตอนที่ 5: ตรวจสอบการเปลี่ยนแปลงจาก Qwen Local Coding ด้วย Atlas Cloud Qwen3 Coder Next
Qwen3 Coder Next เป็นเลนรีวิวแบบโฮสต์ในเวิร์กโฟลว์นี้ มีประโยชน์เมื่อคอนเท็กซ์โลคอลของคุณแน่นเกินไป เครื่องของคุณช้าเกินไป หรือแพตช์สำคัญพอที่จะควรได้รับการตรวจทานอิสระ Atlas Cloud คือการทำงานบนคลาวด์ ดังนั้นวาง diff ที่เล็กที่สุดที่มีประโยชน์ และปฏิบัติตามนโยบายบริษัทของคุณ
พรอมป์ต์ที่ต้องวาง:
plaintext1Review this patch as a senior software engineer. 2 3Context: 4- The local model fixed a checkout discount bug and all current tests pass. 5- I want a second opinion before merging. 6 7Review checklist: 81. Look for missed edge cases. 92. Look for state-management regressions. 103. Look for test gaps. 114. Do not rewrite the whole patch. 125. Return only: blocking issues, non-blocking improvements, and one recommended extra test. 13 14Patch: 15[paste diff here]
การตั้งค่าที่ควรเลือก:
| การตั้งค่า | ค่า |
|---|---|
| โมเดล | qwen/qwen3-coder-next |
| โทเค็นสูงสุด | 2,000 ถึง 4,000 |
| อุณหภูมิ | 0.2 |
| สตรีม | ไม่บังคับ |
| วินัยของอินพุต | วาง diff ขั้นต่ำ ไม่ใช่ข้อมูลลับ |
เวิร์กโฟลว์รีวิวแพตช์สุดท้ายแบบอิสระ
ตัวอย่างเวิร์กโฟลว์แบบแอนิเมชัน: การรีวิวแบบอิสระอ่านแพตช์และบันทึกเทสต์ไปพร้อมกัน แล้วชี้เคสขอบที่ยังเหลือก่อนปล่อย
รูปแบบต่าง ๆ: Cline, Continue, Aider
Cline เหมาะกับนักพัฒนาที่ต้องการเอเจนต์ VS Code เพื่ออ่านไฟล์ แก้ไข และรันคำสั่ง เปิด compact prompt เมื่อมีให้ใช้ คงการอนุมัติอัตโนมัติแบบระวังไว้ในตอนแรก และเริ่มจากเทสต์ที่ล้มเหลวหนึ่งรายการแทนคำขอฟีเจอร์ที่คลุมเครือ
Continue เหมาะกับนักพัฒนาที่ต้องการแชตโลคอล การเติมโค้ดแบบอินไลน์ และบริบท repo โดยไม่ให้โมเดลมีอำนาจสั่งการมากเกินไป เป็นการตั้งค่าประจำวันที่ดีเมื่อคุณต้องการอ่านโค้ดเป็นหลัก แก้ไขเล็กน้อย และได้คำตอบเร็ว
Aider เหมาะกับการแก้ไขที่ขับด้วยเทสต์ ทำงานได้ดีเมื่อคุณระบุชื่อไฟล์และคำสั่งที่ตัดสินความสำเร็จได้ สไตล์นี้ยังให้วิธีเปรียบเทียบ 30B โลคอลกับรีวิว Qwen แบบโฮสต์อย่างยุติธรรม: diff เดียวกัน เทสต์เดียวกัน เกณฑ์ยอมรับเดียวกัน
ใช้ LM Studio หากคุณชอบ GUI และต้องการตรวจสอบ quantization, คอนเท็กซ์ และสถานะเซิร์ฟเวอร์ ใช้ llama.cpp เมื่อต้องการควบคุมแฟล็กให้แน่นขึ้น ใช้ vLLM หรือ SGLang เมื่อทีมต้องการ endpoint ที่ใช้ร่วมกันและมีฮาร์ดแวร์พอที่จะคุ้มกับการตั้งค่า
ค่าใช้จ่าย: ฮาร์ดแวร์โลคอลเทียบกับ Qwen แบบโฮสต์
Qwen โลคอลไม่มีบิล API ต่อโทเค็น แต่ไม่ได้ฟรีในแง่ปฏิบัติ คุณจ่ายด้วย VRAM, RAM, ไฟฟ้า, เวลาติดตั้ง, การรันคอนเท็กซ์ยาวที่ช้าลง และบางครั้งก็เสียเวลาหนึ่งบ่ายไปกับการหาการตั้งค่าที่ควรจะชัดเจนอยู่แล้ว
สำหรับการตั้งค่าเขียนโค้ดแบบโลคอลส่วนใหญ่ Qwen3 Coder 30B Q4 เป็นทางประนีประนอมที่มีประโยชน์ ใหญ่พอสำหรับ agentic coding เล็กพอจะใส่ในฮาร์ดแวร์ผู้บริโภคจริงจัง และมีเอกสารครบถ้วนในรันไทม์โลคอลต่าง ๆ คลาส 480B เป็นเรื่องของหน่วยความจำระดับเซิร์ฟเวอร์หรือเลนโฮสต์
| สถานการณ์ | ตัวเลือก Qwen โลคอล | การใช้ Atlas Cloud | เหตุผลที่สมเหตุสมผล |
|---|---|---|---|
| โปรเจกต์อดิเรก | Qwen3 Coder 30B Q4 | รีวิวแพตช์สุดท้ายเท่านั้น | ค่าใช้จ่ายต่อเนื่องต่ำ คุณภาพเพียงพอ |
| Repo ที่อ่อนไหวด้านความเป็นส่วนตัว | โลคอลเท่านั้น | ไม่ใช้ เว้นแต่นโยบายอนุญาต | โค้ดอยู่ในเครื่อง |
| แล็ปท็อปสเปกต่ำ | โมเดลโลคอลเล็กลงสำหรับจดบันทึก | Qwen แบบโฮสต์สำหรับพรอมป์ต์หนัก ๆ | เลี่ยงความหน่วงโลคอลที่ทรมาน |
| ทีมที่ประเมิน Qwen | 30B โลคอลและ Qwen Next แบบโฮสต์ | เปรียบเทียบพรอมป์ต์เดียวกัน | แยกคุณภาพโมเดลออกจากข้อจำกัดฮาร์ดแวร์ |
หมายเหตุด้านความเป็นส่วนตัว
การอนุมานแบบโลคอลคือข้อได้เปรียบด้านความเป็นส่วนตัว repo ส่วนตัวของคุณอยู่ในเครื่องได้ และเอเจนต์ของคุณรันเทสต์ได้โดยไม่ส่งโค้ดไปยัง endpoint แบบโฮสต์
การรีวิวแบบโฮสต์ยังมีประโยชน์ แต่ปฏิบัติกับมันเหมือนเครื่องมือโค้ดบนคลาวด์อื่น ๆ อย่าวางข้อมูลลับ คีย์ส่วนตัว ข้อมูลลูกค้า หรือ repository ที่เป็นกรรมสิทธิ์ทั้งหมด วาง diff ที่เล็กที่สุดและผลลัพธ์เทสต์ที่เกี่ยวข้อง นอกจากนี้ตรวจสอบสัญญาอนุญาตของ checkpoint หรือ quantization ที่คุณดาวน์โหลดด้วย แม้การ์ดโมเดลต้นทางจะระบุ Apache 2.0
หากคุณจำสิ่งเดียวจากคู่มือนี้ ให้จำสิ่งนี้: โมเดล Qwen ที่ดีที่สุดสำหรับการเขียนโค้ดแบบโลคอลคือโมเดลที่จำบริบท repo ของคุณ ทำตามเอเจนต์ของคุณ และผ่านเทสต์ของคุณบนฮาร์ดแวร์ที่คุณใช้จริง
คำถามที่พบบ่อย
โมเดล Qwen ที่ดีที่สุดสำหรับการเขียนโค้ดแบบโลคอลตอนนี้คืออะไร
สำหรับนักพัฒนาส่วนใหญ่ Qwen3 Coder 30B A3B เป็นตัวเลือกโลคอลที่เหมาะใช้งานจริง มีส่วนผสมที่ดีที่สุดของขนาด คอนเท็กซ์ พฤติกรรม agentic coding และการรองรับรันไทม์โลคอล
Qwen3 Coder 30B รันบน VRAM 16GB ได้หรือไม่
มันใช้งานได้ในระดับหนึ่งด้วย quantization และ offload แต่คาดว่าจะมีการประนีประนอม GPU 24GB หรือหน่วยความจำระบบ 32GB ขึ้นไปจะให้การตั้งค่าที่สบายกว่า โดยเฉพาะเมื่อ KV cache และหน้าต่างคอนเท็กซ์โตขึ้น
Qwen3 Coder Next ดีกว่า Qwen3 Coder 30B สำหรับการเขียนโค้ดแบบโลคอลหรือไม่
มันอาจแข็งแกร่งกว่าสำหรับงานรีวิวและคอนเท็กซ์ยาวบางงาน แต่ใช้งานจริงบนเครื่องโลคอลทั่วไปได้น้อยกว่า มอง Qwen3 Coder Next เป็นตัวเลือกแบบโฮสต์หรือเวิร์กสเตชันหน่วยความจำสูง เว้นแต่คุณมีฮาร์ดแวร์ที่จะรันได้อย่างสบาย
ควรใช้ Ollama, LM Studio, llama.cpp, Cline, Continue หรือ Aider
ใช้ Ollama สำหรับเริ่มต้นบนบรรทัดคำสั่งที่เร็วที่สุด ใช้ LM Studio สำหรับ GUI ใช้ llama.cpp สำหรับการควบคุมที่ลึกขึ้น ใช้ Cline เมื่อต้องการเอเจนต์ VS Code, Continue สำหรับแชตและการเติมโค้ด และ Aider สำหรับลูปแพตช์ที่ขับด้วยเทสต์
ทำไมเอเจนต์เขียนโค้ด Qwen โลคอลของฉันจึงล้มเหลวแม้โมเดลจะดี
สาเหตุทั่วไปคือคอนเท็กซ์น้อยเกินไป อุณหภูมิสูงเกินไป ฮาร์เนส tool-use อ่อน โมเดลเล็กกว่าที่เอเจนต์คาดหวัง หรือพรอมป์ต์ที่ขอรีแฟกเตอร์กว้าง ๆ ก่อนที่โมเดลจะสำรวจ repo
ควรใช้ Atlas Cloud แทนการรัน Qwen โลคอลเมื่อไหร่
ใช้ Atlas Cloud เมื่อเครื่องโลคอลของคุณรับโมเดลไม่ได้ เมื่อคุณต้องการความเห็นที่สองจาก Qwen แบบโฮสต์ หรือเมื่อทีมต้องการเปรียบเทียบ 30B โลคอลกับ endpoint Qwen ที่ใหญ่กว่า เก็บโค้ดที่อ่อนไหวออกไว้ เว้นแต่นโยบายของคุณอนุญาต


