สองทีมอาจรายงานว่า DeepSeek V4.1 Flash ทำได้หลายร้อยโทเคนต่อวินาที และยังคงวัดสิ่งที่แตกต่างกันก็ได้ ทีมหนึ่งอาจหมายถึงความเร็วถอดรหัสสำหรับคำขอเดียว อีกทีมอาจหมายถึงผลผลิตรวมจากคำขอที่ทำงานพร้อมกันหลายสิบรายการ หากต้องการปรับปรุง การเพิ่มประสิทธิภาพปริมาณงานอนุมาน (inference throughput optimization) ของ DeepSeek V4.1 Flash ก่อนอื่นให้เลือกเมตริกที่บริการของคุณต้องการ จากนั้นวัดประสิทธิภาพ (benchmark) ชุดคำขอจริงของคุณ เปลี่ยนตัวแปรด้านการให้บริการทีละตัว และตรวจสอบความหน่วง คุณภาพ และค่าใช้จ่ายไปพร้อมกัน ตระกูลโมเดลนี้ขณะนี้รวมการอัปเดต Flash-1017 วันที่ 17 ตุลาคม ดังนั้นให้บันทึกเช็กพอยต์ที่แน่นอนก่อนเปรียบเทียบผลลัพธ์ รายงานสาธารณะแสดงเส้นทางการปรับปรุงที่มีประโยชน์ แต่ไม่มีสิ่งใดทดแทนการทดสอบที่จับคู่สภาวะบนฮาร์ดแวร์ของคุณได้
ประเด็นสำคัญ
- ปริมาณโทเคนเอาต์พุตแบบรวมต่อวินาทีวัดความจุข้ามคำขอ ส่วนความเร็วถอดรหัสต่อคำขอวัดประสบการณ์ของผู้ใช้แต่ละราย
- ทำซ้ำความยาวพรอมป์ต์ ขีดจำกัดเอาต์พุต ระดับการทำงานพร้อมกัน สถานะอุ่น และเป้าหมายความหน่วงของคุณก่อนปรับแต่ง
- KV cache แบบบีบอัดของ V4.1 Flash และ bounded replay ช่วยลดแรงกดดันด้านหน่วยความจำ แต่ไม่ได้รับประกันความเร็วปลายทางถึงปลายทางแบบคงที่
- เปรียบเทียบ vLLM และ SGLang เฉพาะภายใต้โมเดล ฮาร์ดแวร์ ปริมาณงาน และเงื่อนไขการวัดที่จับคู่กันเท่านั้น
ปริมาณงาน (Throughput) หมายถึงอะไรสำหรับ DeepSeek V4.1 Flash?
ปริมาณงานคืออัตรา แต่ตัวเศษและขอบเขตการทดสอบมีความสำคัญ สำหรับบริการอนุมาน ให้บันทึกอย่างน้อยห้าการวัด:
| เมตริก | สิ่งที่บอกคุณ | การใช้งานทั่วไป |
|---|---|---|
| โทเคนเอาต์พุตแบบรวมต่อวินาที | โทเคนเอาต์พุตที่คำขอที่ใช้งานอยู่ทั้งหมดสร้างขึ้นต่อวินาที | การวางแผนความจุและประสิทธิภาพของฟลีต |
| โทเคนถอดรหัสต่อคำขอต่อวินาที | ความเร็วการสร้างที่คำขอแต่ละรายการได้รับ | การตอบสนองแบบโต้ตอบระหว่างการสร้าง |
| โทเคนพรีฟิลล์ต่อวินาที | โทเคนอินพุตที่ประมวลผลต่อวินาที | พรอมป์ต์ยาวและปริมาณงานที่ใช้การดึงข้อมูลมาก |
| เวลาถึงโทเคนแรก (TTFT) | เวลาจากที่คำขอมาถึงจนถึงโทเคนเอาต์พุตแรก | ความล่าช้าในการเริ่มต้นที่ผู้ใช้รับรู้ |
| ความหน่วงปลายทางถึงปลายทาง, p50/p95 | ระยะเวลาคำขอทั้งหมดตามการกระจายทราฟฟิก | วัตถุประสงค์ระดับบริการและพฤติกรรมส่วนท้าย |
เซิร์ฟเวอร์สามารถเพิ่มปริมาณงานแบบรวมได้โดยการแบตช์ลำดับมากขึ้น ขณะที่ทำให้ผู้ใช้แต่ละรายรอนานขึ้นระหว่างโทเคน ในทางกลับกัน การตั้งค่าที่ปรับสำหรับการทำงานพร้อมกันต่ำอาจให้การตอบสนองรายรายการที่ฉับไว แต่ใช้ตัวเร่งความเร็วไม่เต็มที่ ไม่มีผลลัพธ์ใดดีกว่าเสมอไป เป้าหมายที่ถูกต้องคือจุดบนเส้นโค้งปริมาณงาน-ความหน่วงที่ตอบสนองวัตถุประสงค์ระดับบริการของผลิตภัณฑ์คุณ
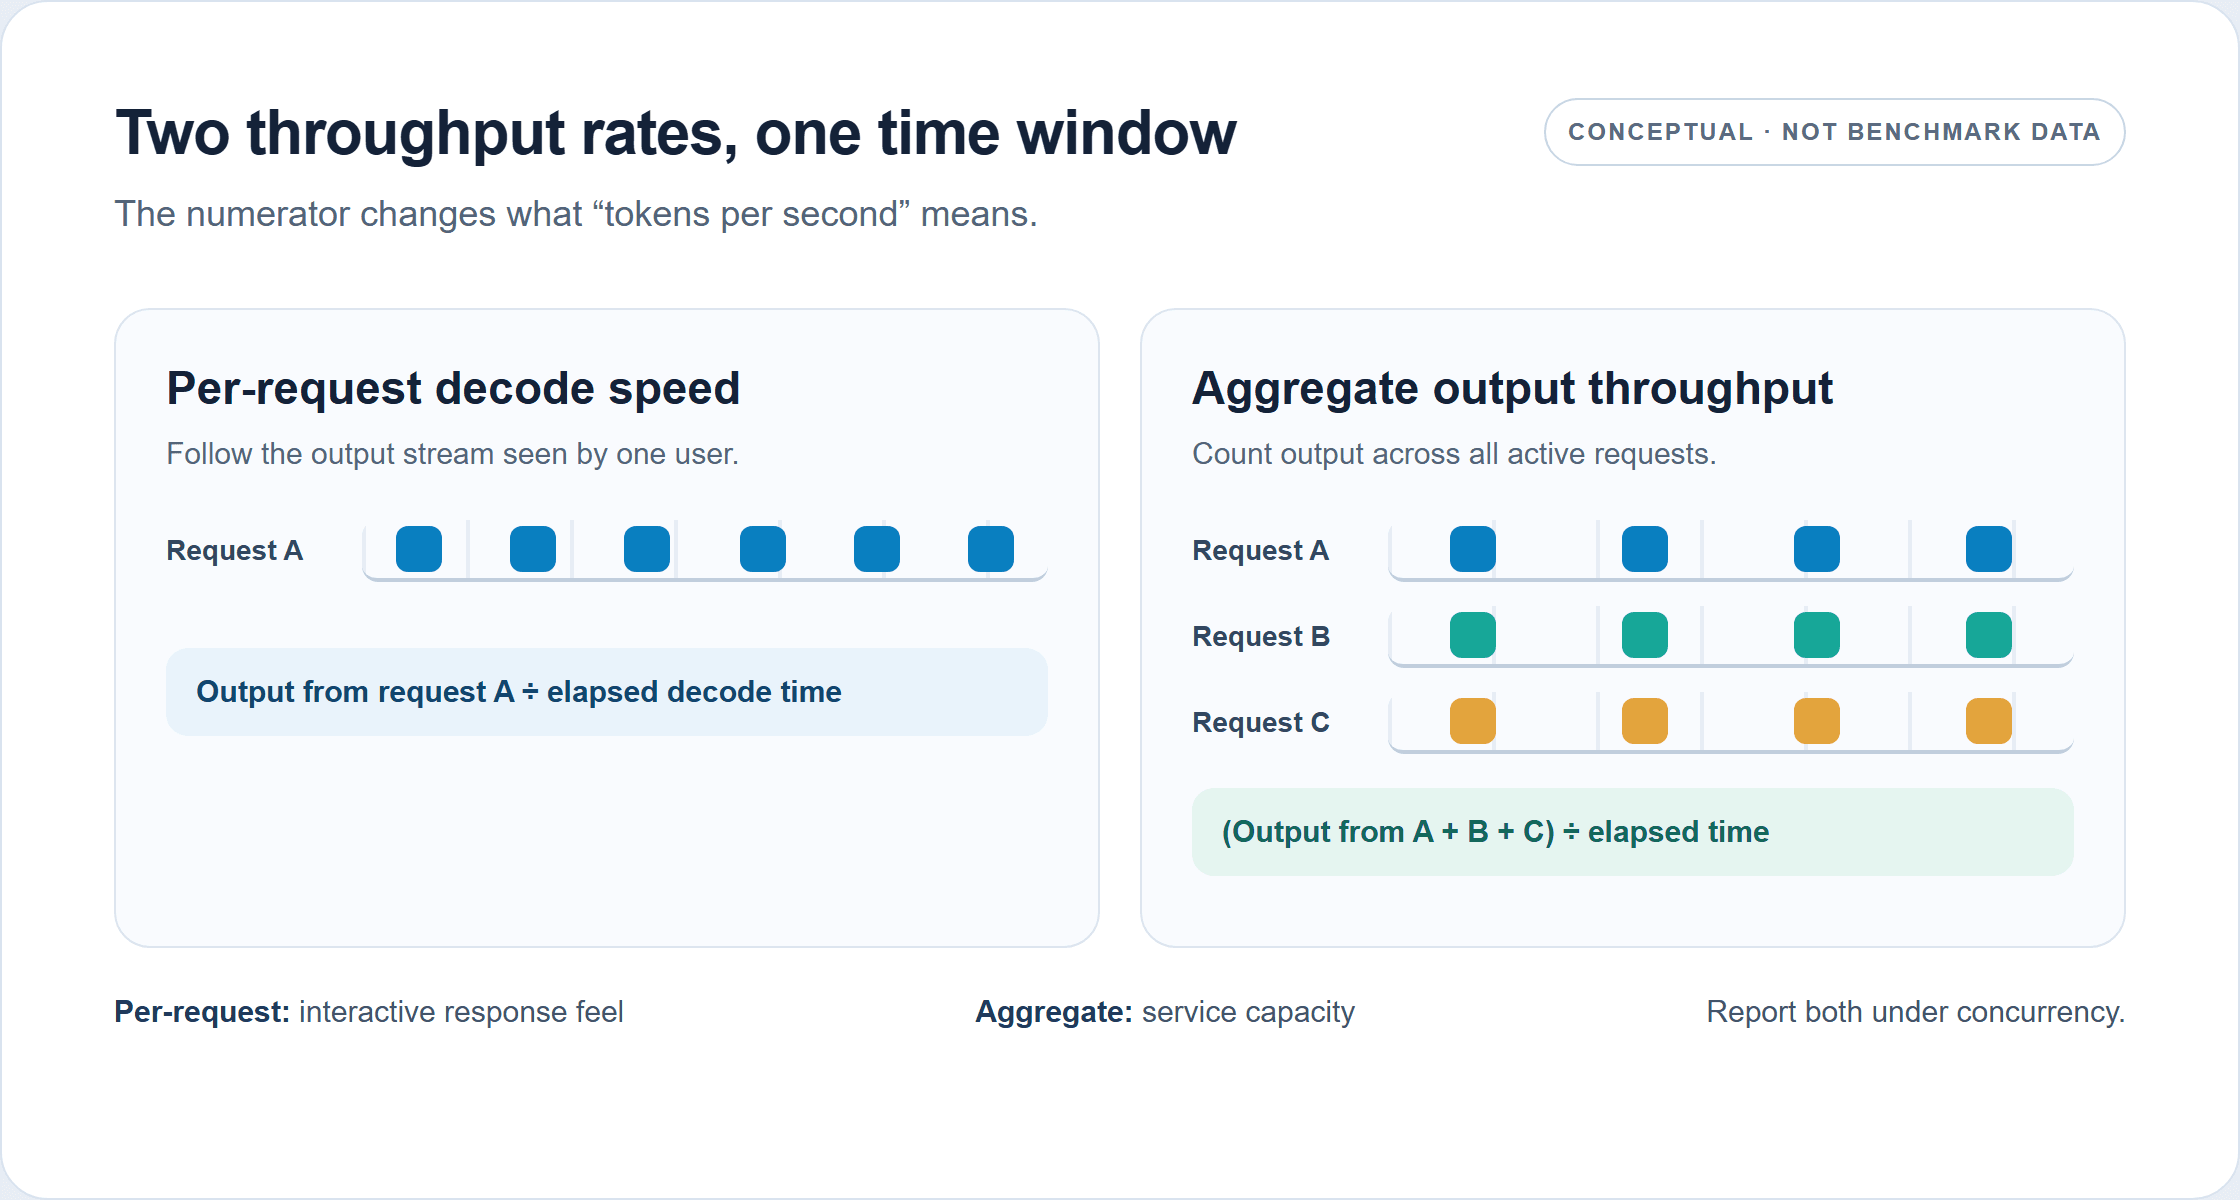
อัตราทั้งสองนับสตรีมเอาต์พุตที่ต่างกัน นี่เป็นแผนภาพเชิงแนวคิด ไม่ใช่ประสิทธิภาพ DeepSeek V4.1 Flash ที่วัดได้
ระบุว่าปริมาณงานรวมพรีฟิลล์ การถอดรหัส หรือทั้งสองอย่าง ระบุว่าคุณหารด้วยจำนวน GPU หรือไม่ รายงานโทเคนเอาต์พุตที่สำเร็จ แทนที่จะเป็นจำนวนโทเคนสูงสุดที่ร้องขอ และเปิดเผยการยกเลิกหรือข้อผิดพลาด หากไม่มีรายละเอียดเหล่านั้น ตัวเลข tokens/s ไม่สามารถบอกผู้ปฏิบัติงานได้ว่าจะทำนายแอปพลิเคชันของตนได้หรือไม่
สร้าง Baseline ที่ทำซ้ำได้สำหรับ DeepSeek V4.1 Flash
Baseline ที่มีประโยชน์จะคล้ายกับทราฟฟิกโปรดักชันมากพอที่จะเผยคอขวดของมัน พรอมป์ต์สั้นเพียงรายการเดียวเป็นตัวแทนที่ไม่ดีสำหรับเอเจนต์ที่ส่งประวัติบทสนทนาขนาดใหญ่ซ้ำๆ และเอาต์พุตคงที่ 1,024 โทเคนพลาดปริมาณงานที่หยุดก่อนกำหนดหรือแปรผันกว้าง
กำหนดปริมาณงานและหน้าต่างการวัดให้คงที่
สร้างกลุ่มคำขอจากทราฟฟิกที่สังเกตได้ สำหรับแต่ละกลุ่ม ให้รักษาความยาวอินพุตโดยประมาณ ความยาวเอาต์พุตที่คาดหวัง รูปแบบการมาถึง และคำนำหน้าที่ใช้ร่วมกัน (ถ้ามี) รวมเทิร์นของเครื่องมือหรือการให้เหตุผลหากเป็นส่วนหนึ่งของเส้นทางคำขอจริง รักษาพรอมป์ต์ การตั้งค่าการสุ่ม เงื่อนไขหยุด และขีดจำกัดเอาต์พุตให้คงที่ระหว่างการรัน
รันทั้งกรณีการทำงานพร้อมกันต่ำและระดับการทำงานพร้อมกันที่บริการของคุณคาดว่าจะพบที่จุดสูงสุด จากนั้นเพิ่มระดับการทำงานพร้อมกันระดับกลาง เพื่อเปิดเผยว่าปริมาณงานหยุดเพิ่มขึ้นหรือความหน่วงข้ามขีดจำกัดตรงไหน ใช้หน้าต่างการวัดที่คงที่หลังการอุ่นระบบ ทำซ้ำแต่ละจุด และรายงานค่ามัธยฐานพร้อมช่วง ช่วงโหลดพุ่งสั้นๆ อาจวัดพฤติกรรมการเริ่มต้นมากกว่าความจุบริการที่มั่นคง
แยกการวัดการเริ่มต้นแบบเย็นออกจากการให้บริการแบบอุ่น การรันแบบเย็นรวมการโหลดโมเดล การจับกราฟ หรือการเติมแคช ขึ้นอยู่กับสแต็ก การรันแบบอุ่นอธิบายระบบที่พร้อมให้บริการ สำหรับปริมาณงานที่ใช้แคชคำนำหน้า ให้วัดทราฟฟิกที่แคชฮิตและแคชมิสแยกกัน อย่ารวมเป็นค่าเฉลี่ยเดียว เว้นแต่ส่วนผสมตรงกับโปรดักชัน
เก็บบันทึกการวัดประสิทธิภาพ
บันทึกหนึ่งแถวสำหรับแต่ละการรันด้วยฟิลด์เหล่านี้: เช็กพอยต์หรือโมเดลรีวิชัน; รันไทม์และคอมมิต; รุ่น GPU และจำนวน; การเชื่อมต่อระหว่างกัน; ความแม่นยำและการควอนไทซ์; เลย์เอาต์แบบขนานเทนเซอร์ ผู้เชี่ยวชาญ หรือไปป์ไลน์; การกระจายโทเคนอินพุตและเอาต์พุต; ระดับการทำงานพร้อมกันและรูปแบบการมาถึงของคำขอ; สถานะอุ่นหรือเย็น; ระยะเวลารัน; อัตราความสำเร็จ; ปริมาณงานแบบรวม; ความเร็วถอดรหัสต่อคำขอ; TTFT; และความหน่วงปลายทางถึงปลายทาง p50/p95
บันทึกนี้มีประโยชน์มากกว่าตัวเลขบนลีดเดอร์บอร์ดเพราะทำให้การทดลองครั้งต่อไปทำซ้ำได้ ตรึงไว้ก่อนปรับแต่ง หากปริมาณงานหรือเช็กพอยต์เปลี่ยน ให้เริ่ม baseline ใหม่แทนที่จะถือว่าความแตกต่างเกิดจากแฟล็กการให้บริการ
วินิจฉัยพรีฟิลล์ การถอดรหัส KV Cache หรือการจัดตารางเวลา
ใช้อาการเพื่อเลือกการวัดถัดไป ไม่ใช่เพื่อเดาวิธีแก้ TTFT สูงพร้อมความเร็วถอดรหัสที่ยอมรับได้ชี้ไปที่การประมวลผลอินพุต การเข้าคิว แคชมิส หรือโอเวอร์เฮดตอนเริ่มต้น การถอดรหัสช้าที่การทำงานพร้อมกันต่ำบ่งชี้ให้ตรวจสอบเคอร์เนล แบนด์วิดท์หน่วยความจำ การสื่อสารแบบขนาน และเส้นทางการทำงานของโมเดล ปริมาณงานแบบรวมที่ทรงตัวเมื่อการทำงานพร้อมกันเพิ่มขึ้นอาจบ่งชี้ถึงแรงกดดันด้านหน่วยความจำ ขีดจำกัดของตัวจัดตารางเวลา โอเวอร์เฮดการสื่อสาร หรือเส้นทางการประมวลผลที่อิ่มตัว การเสื่อมลงของบริบทยาวเรียกร้องให้วัดการพำนักในแคช งานพรีฟิลล์ และการเคลื่อนย้ายจากโฮสต์ไปยังอุปกรณ์
| สิ่งที่สังเกตพบ | สิ่งที่ตรวจก่อน |
|---|---|
| TTFT เพิ่มขึ้นตามความยาวพรอมป์ต์ | อัตราพรีฟิลล์ เวลาเข้าคิว อัตราฮิตแคชคำนำหน้า การอุ่นกราฟหรือการคอมไพล์ |
| ความเร็วถอดรหัสต่ำแม้ที่การทำงานพร้อมกัน 1 | เส้นทางโมเดลของรันไทม์ การรองรับเคอร์เนล ความแม่นยำ การใช้ GPU โอเวอร์เฮดการสื่อสาร |
| โทเคน/วินาทีแบบรวมทรงตัวเมื่อการทำงานพร้อมกันเพิ่มขึ้น | ความจุ KV cache การแบตช์ของตัวจัดตาราง แบนด์วิดท์หน่วยความจำ โทโพโลยีแบบขนาน |
| ความหน่วง p95 เพิ่มขึ้นอย่างรวดเร็วขณะที่เอาต์พุตรวมดีขึ้น | ขนาดแบตช์ นโยบายการเข้าคิว ส่วนผสมความยาวคำขอ วัตถุประสงค์ระดับบริการ |
| พรอมป์ต์ยาวขับไล่คำขอที่ใช้งานอยู่ซึ่งมีประโยชน์ | การพำนักใน KV cache การจัดสรรแคช การกระจายบริบท ทราฟฟิกหน่วยความจำโฮสต์ |
V4.1 Flash มีคุณสมบัติทางสถาปัตยกรรมที่มุ่งลดแรงกดดันเหล่านี้บางส่วน รายงานของโมเดลอธิบาย CSA2 ที่มีการใช้แคชซ้ำข้ามเลเยอร์ (cross-layer cache reuse) และ FP4 global KV caching โดยรายงานว่ามี global KV footprint 890 ไบต์ต่อโทเคน ซึ่งประมาณหนึ่งในสี่ของ footprint ที่สอดคล้องกันของ V4-Flash SWA Bounded Replay จัดการกับข้อแลกเปลี่ยนด้านพื้นที่จัดเก็บอีกแบบหนึ่ง: แทนที่จะเก็บสถานะ sliding-window attention ทั้งหมด การติดตั้งใช้งานสามารถสร้างสถานะที่หายไปใหม่ได้โดยเล่นหน้าต่างล่าสุดซ้ำ DeepSeek รายงานว่า KV cache แบบถาวรอยู่ใกล้หนึ่งในแปดของ footprint ของ V4-Flash สำหรับการออกแบบนี้ โดยมีค่าใช้จ่ายในการคำนวณพรีฟิลล์ซ้ำเพิ่มขึ้นเล็กน้อย สิ่งเหล่านี้เป็นผลลัพธ์ด้านสถาปัตยกรรมและการติดตั้งใช้งาน ไม่ใช่คำสัญญาว่าปริมาณงานจะเพิ่มแปดเท่า (รายงานทางเทคนิคของ DeepSeek, กันยายน 2026)
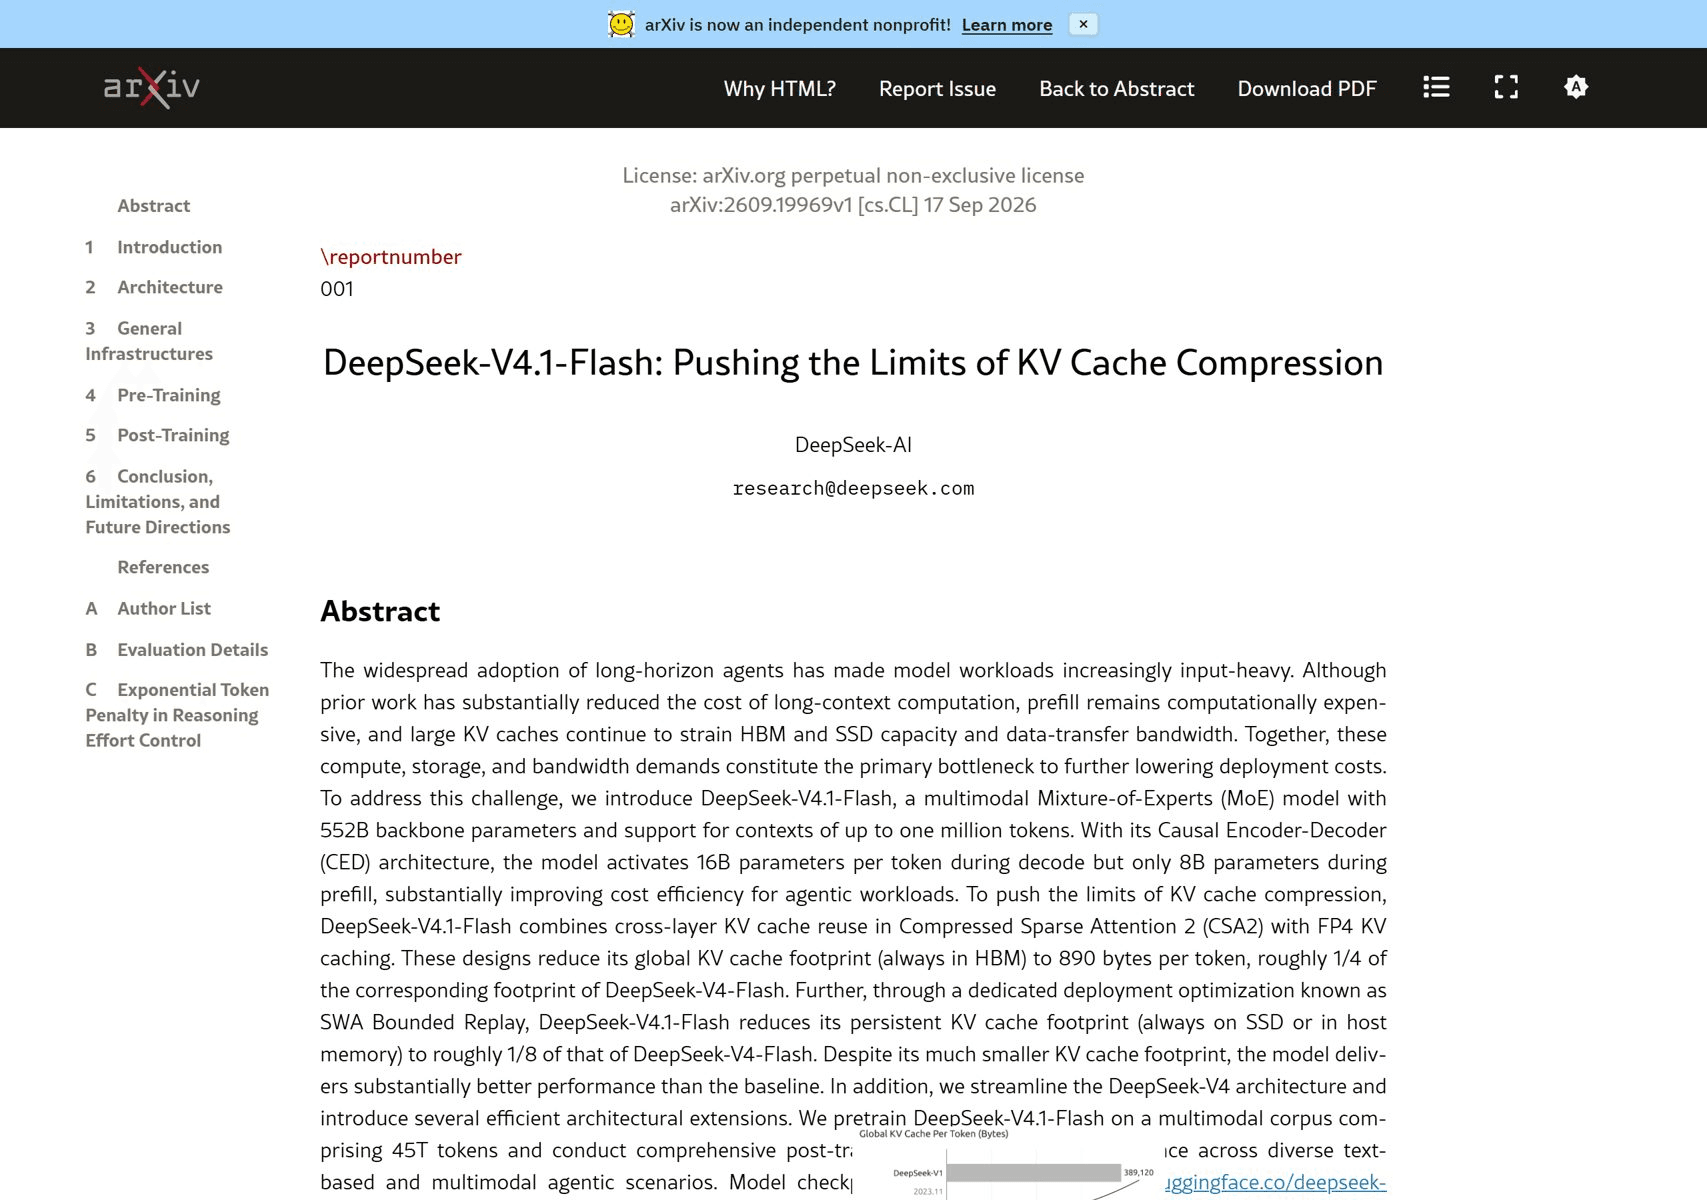
รูปต้นฉบับอธิบายความจุแคช ไม่ใช่ตัวคูณปริมาณงานปลายทางถึงปลายทางสำหรับทุกการติดตั้งใช้งาน
เมื่อการวินิจฉัยไม่ชัดเจน ให้โปรไฟล์การรันตัวแทนหนึ่งครั้งและตรวจสอบเวลาเข้าคิว การใช้ GPU การใช้หน่วยความจำ และเวลาต่อขั้นตอน เปลี่ยนตัวแปรหนึ่งตัว รันปริมาณงานเดิมซ้ำ และตรวจสอบความถูกต้องของเอาต์พุตหรือคุณภาพงาน วิธีนี้ป้องกันไม่ให้ความเร็วที่ดูเหมือนเพิ่มขึ้นบดบังการถดถอยของบริการหรือคำตอบ
ปรับแต่ง vLLM หรือ SGLang เทียบกับเป้าหมายเดียวกัน
เลือกรันไทม์ที่เส้นทางโมเดลปัจจุบันรองรับเช็กพอยต์และฮาร์ดแวร์ที่คุณตั้งใจจะติดตั้งใช้งาน ตรวจสอบรีลีส เคอร์เนล พฤติกรรมกราฟ และเลย์เอาต์แบบขนานให้แน่นอน การที่โมเดลถูกระบุว่ารองรับไม่ได้หมายความว่าทุกการควอนไทซ์หรือโทโพโลยีได้รับการปรับให้เหมาะเท่ากัน
vLLM: ตรวจสอบเส้นทางโมเดลเฉพาะรีลีส
รายงานเดือนตุลาคมของทีม vLLM อธิบายความก้าวหน้าบน AgentX benchmark ของตน: ผลลัพธ์ความหน่วงต่ำดีขึ้นประมาณ 1.9 เท่า และปริมาณงานภายใต้ข้อจำกัด 150 TPS ดีขึ้นประมาณ 5.3 เท่า เมื่อเทียบกับ baseline วันแรก งานนี้รวม SWA bounded replay กับ CUDA graphs และการผสานรวมเคอร์เนลเฉพาะโมเดล ให้ถือค่าดังกล่าวเป็นหลักฐานว่าสแต็กเปลี่ยนแปลงอย่างมีนัยสำคัญเมื่อเวลาผ่านไปภายใต้ benchmark นั้น ไม่ใช่ตัวคูณที่จะนำไปใช้กับคลัสเตอร์อื่น (รายงานวิศวกรรมของ vLLM, ตุลาคม 2026)
สำหรับการรันของคุณ ให้สร้างรีลีสที่รองรับและการกำหนดค่าที่รู้ว่าดีเสียก่อน จากนั้นวัดพฤติกรรมการจับหรือเล่นกราฟซ้ำ การแบตช์ และการทำงานแบบขนานแยกกัน รักษาข้อจำกัดความหน่วงที่ใช้เลือกจุดปริมาณงานสูงขึ้น หากการจับกราฟเปลี่ยนความต้องการตอนเริ่มต้นหรือหน่วยความจำ ให้รวมค่าใช้จ่ายเหล่านั้นในการตัดสินใจติดตั้งใช้งาน
SGLang: จับคู่โปรไฟล์การทำงานพร้อมกัน
รายงานของทีม SGLang ยกตัวอย่างที่ชัดเจนเป็นพิเศษว่าทำไมบริบทการทดสอบจึงสำคัญ บน GPU H200 8 ตัว การรันที่ปรับแล้วโดยไม่ใช้ speculative decoding เพิ่มจากประมาณ 76 เป็น 168 โทเคน/วินาทีต่อผู้ใช้ที่การทำงานพร้อมกัน 1 และจากประมาณ 96 เป็น 221 โทเคนเอาต์พุต/วินาทีต่อ GPU ที่การทำงานพร้อมกัน 64 โดยใช้อินพุตคงที่ 8,192 โทเคนและเอาต์พุต 1,024 โทเคน ผลลัพธ์ 4×GB300 แยกต่างหากใช้ความยาวพรอมป์ต์ การตั้งค่าแบบขนาน และ DSpark speculative decoding ที่ต่างกัน ดังนั้นรายงานนี้สนับสนุนการประเมินการปรับปรุงของ SGLang บนทราฟฟิกของคุณ ไม่ใช่การจัดอันดับโดยตรงเทียบกับตัวเลข AgentX ของ vLLM (รายงานการปรับปรุงประสิทธิภาพ LMSYS/SGLang, กันยายน 2026)
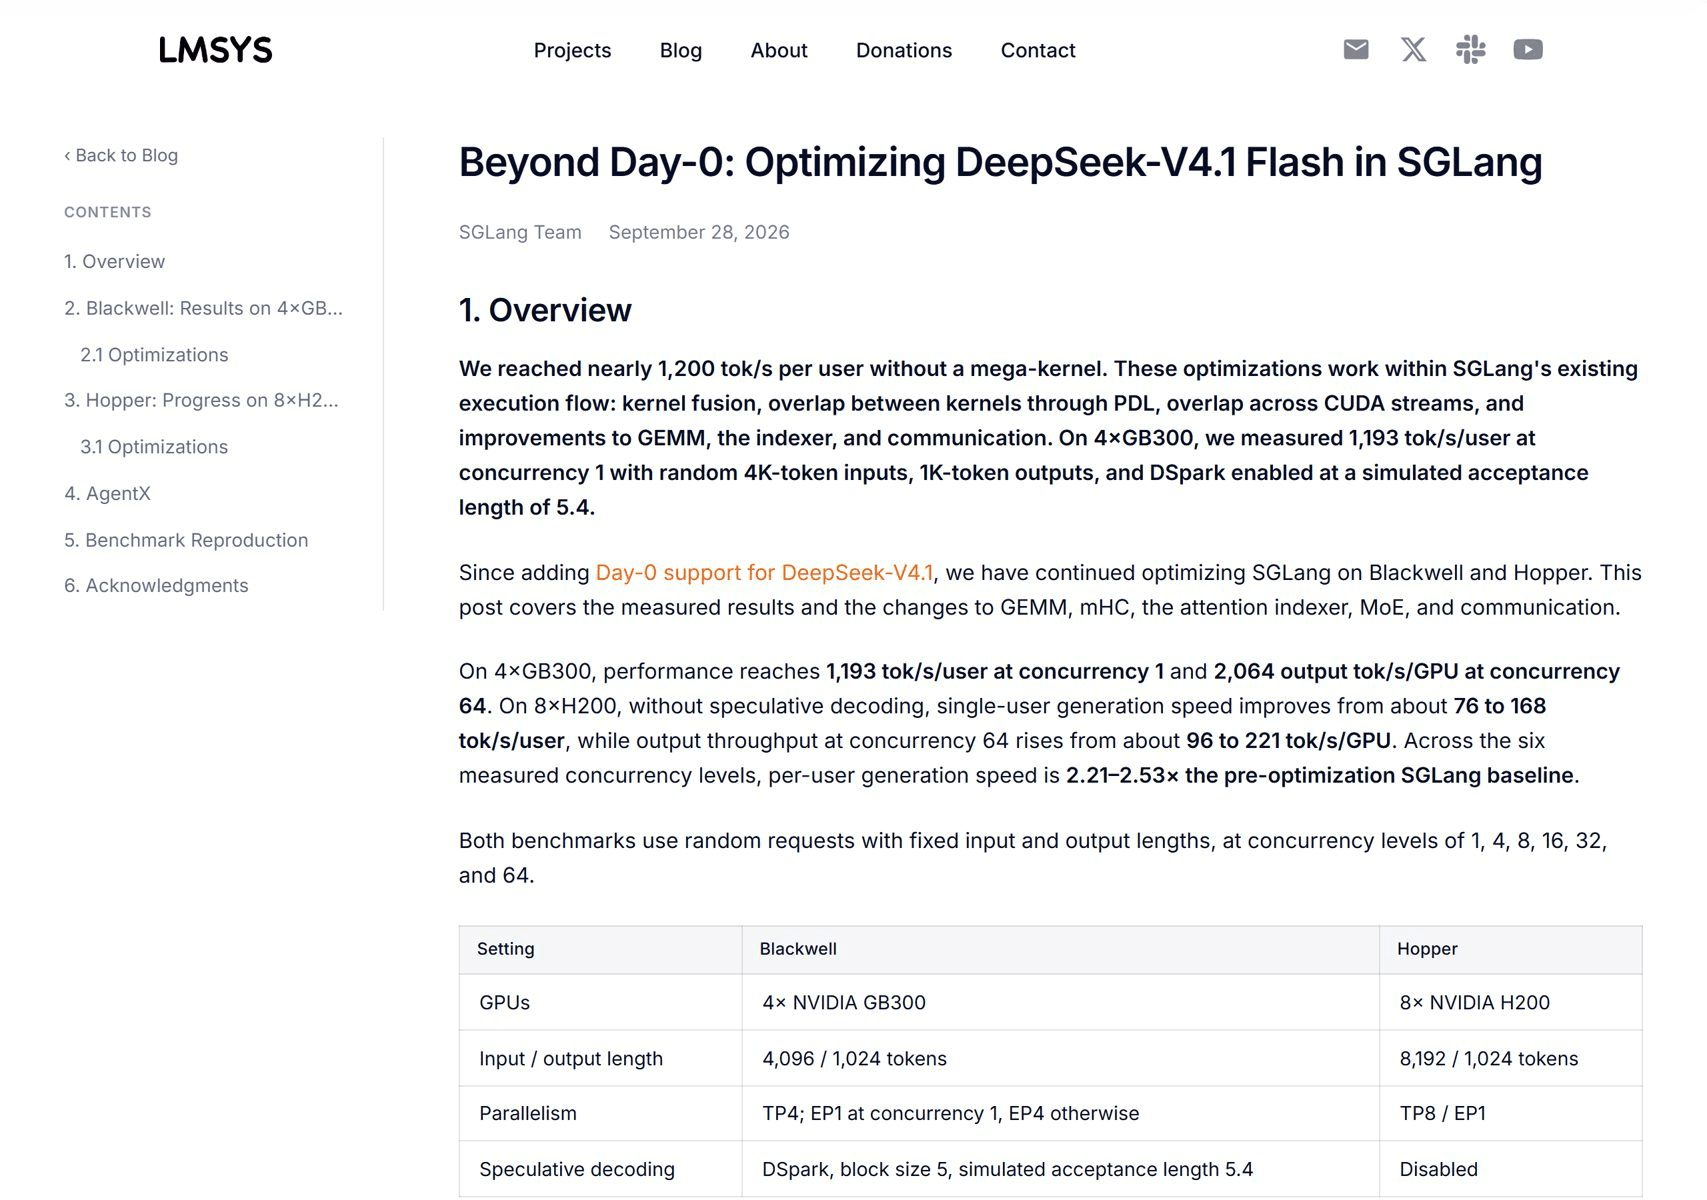
รายงานต้นฉบับใช้ปริมาณงานและฮาร์ดแวร์ที่ต่างกัน ตัวเลขของรายงานเหล่านั้นไม่ควรอ่านเป็นแผนภูมิเปรียบเทียบแบบตัวต่อตัว
เริ่มจากรันไทม์หนึ่งตัวและปรับแต่งเส้นทางที่รองรับให้เหมาะสม สร้างการเปรียบเทียบรันไทม์ตัวที่สองเฉพาะเมื่อคุณสามารถตรึงเช็กพอยต์ การจัดสรร GPU การกระจายพรอมป์ต์และเอาต์พุต การทำงานพร้อมกัน การอุ่นระบบ และวัตถุประสงค์ระดับบริการให้คงที่ได้ การเปรียบเทียบนั้นใช้เวลาทางวิศวกรรม ดังนั้นก่อนอื่นให้ยืนยันว่าสแต็กปัจจุบันเป็นปัจจัยจำกัดจริงหรือไม่
ปรับการทำงานพร้อมกันและบริบทยาวโดยไม่ทำให้ SLO แตก
เพิ่มการทำงานพร้อมกันเป็นขั้นๆ และบันทึกเอาต์พุตรวม ความเร็วถอดรหัสต่อคำขอ TTFT ความหน่วง p95 การใช้หน่วยความจำ และความล้มเหลวในทุกขั้น เก็บจุดที่ปริมาณงานสูงสุดเฉพาะเมื่อความหน่วงและอัตราข้อผิดพลาดยังตอบสนองวัตถุประสงค์ระดับบริการของคุณ หากคำขอเข้าคิวก่อนการสร้าง แบตช์ที่ใหญ่ขึ้นอาจปรับปรุงการใช้ประโยชน์อุปกรณ์ขณะทำให้ผลิตภัณฑ์รู้สึกช้าลง
สำหรับทราฟฟิกบริบทยาว ให้วัดการกระจายบริบทที่ใช้งานอยู่และอัตราแคชฮิต หน้าต่างบริบทสูงสุดที่ระบุไม่ได้หมายความว่าทุกคำขอสามารถให้บริการพร้อมกันที่ความยาวนั้นได้ KV cache แข่งขันด้านหน่วยความจำกับเวต แอ็กติเวชัน พูลกราฟ และบัฟเฟอร์รันไทม์ เผื่อ headroom สำหรับความยาวคำขอที่แปรผัน และวัดการขับไล่หรือการแทรกกลางภายใต้ทราฟฟิกที่สมจริง
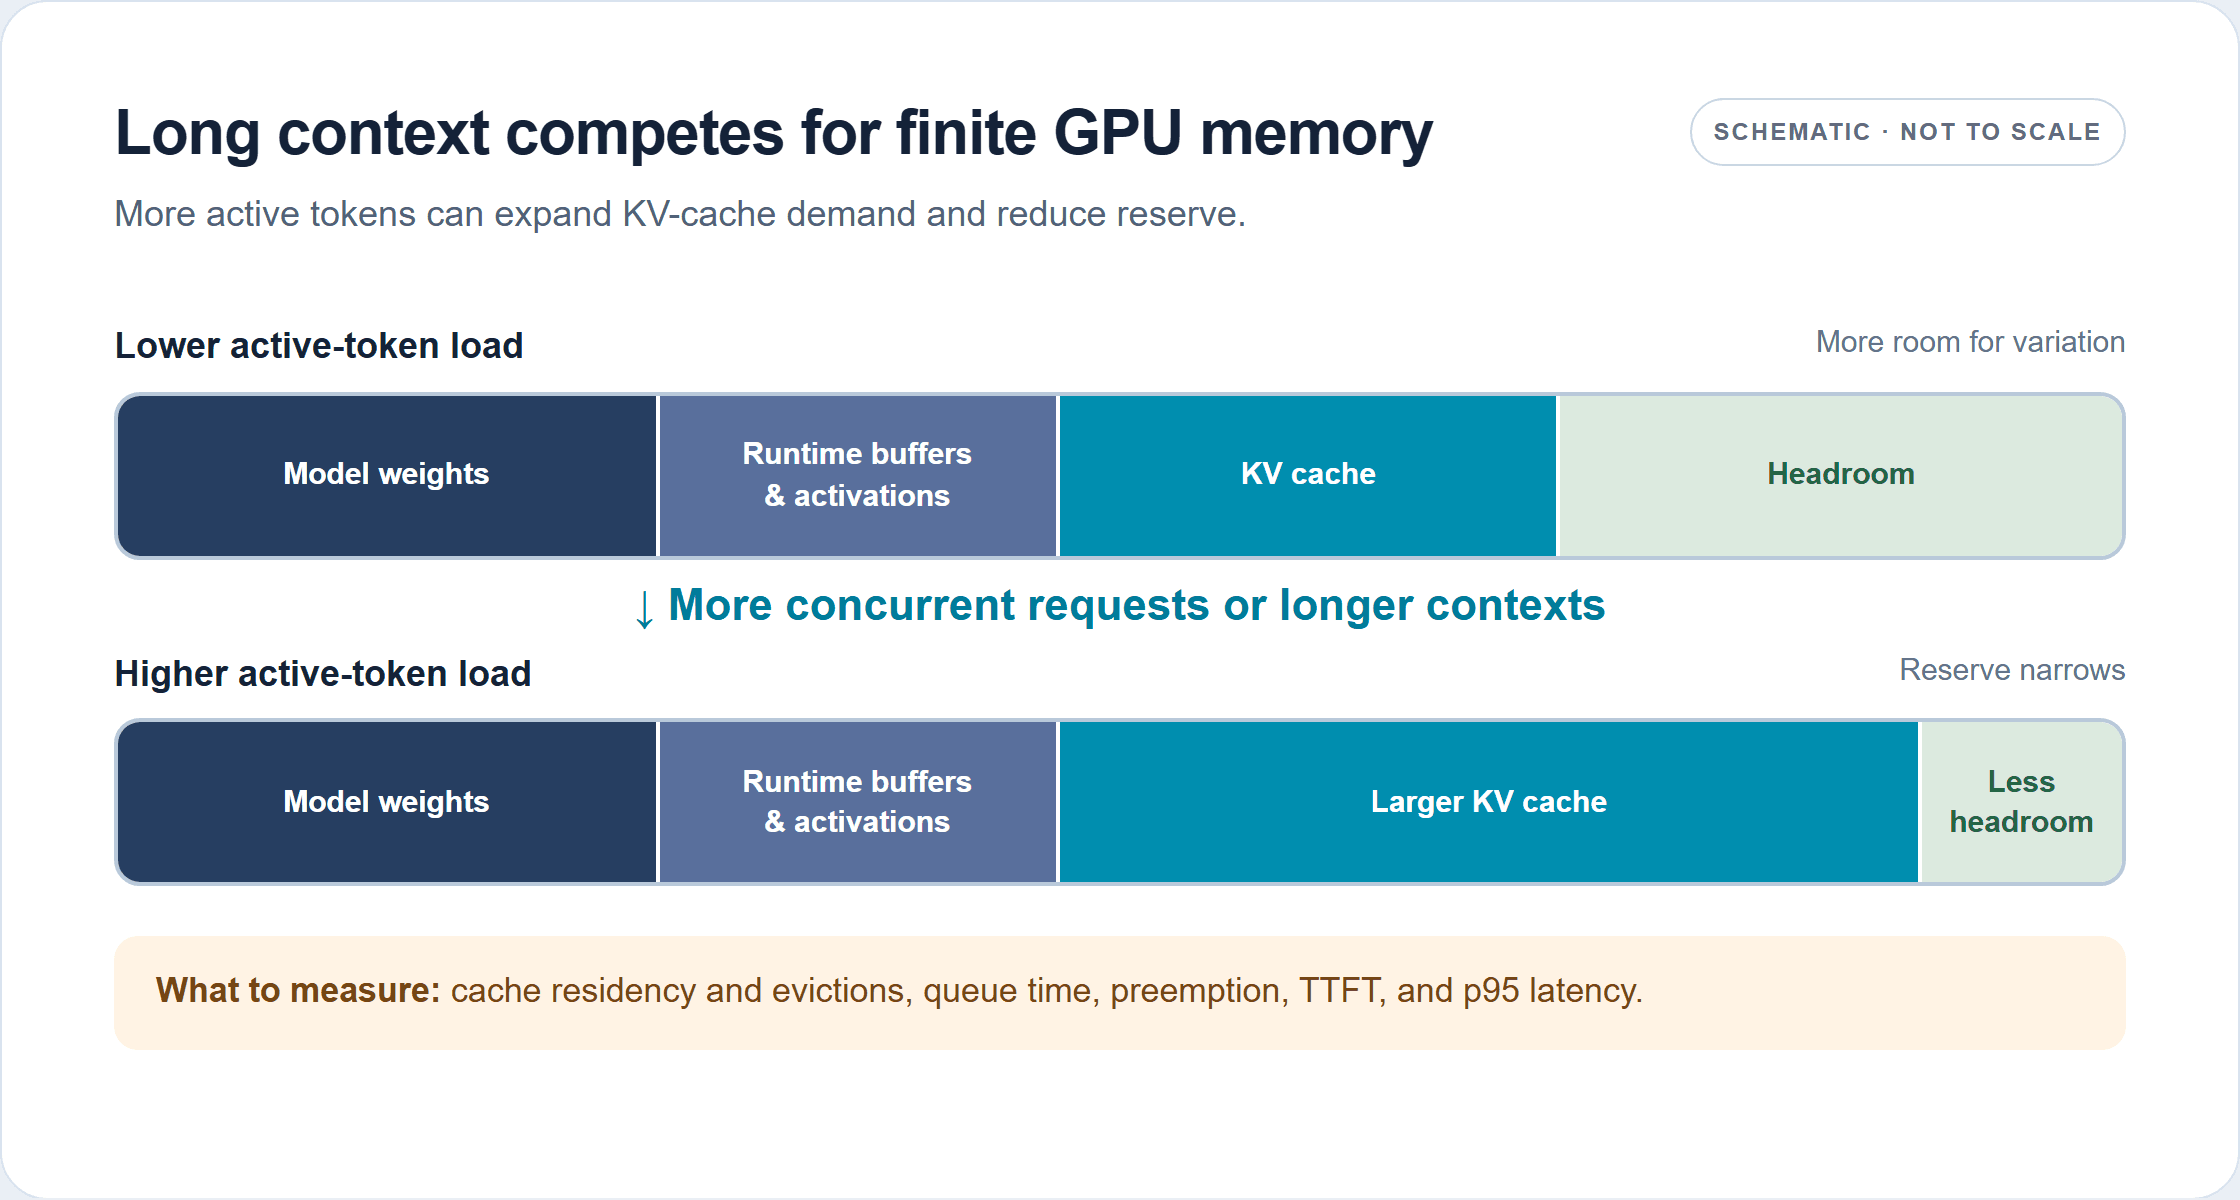
บริบทที่ยาวขึ้นหรือคำขอที่ทำงานพร้อมกันมากขึ้นสามารถเพิ่มความต้องการ KV cache บล็อกหน่วยความจำเป็นแผนผังและไม่เป็นไปตามสัดส่วน
ให้ถือว่าการควอนไทซ์ ความแม่นยำของ KV cache การขนานแบบเทนเซอร์ การขนานแบบผู้เชี่ยวชาญ และการแยกพรีฟิลล์/ถอดรหัสเป็น experiments แยกกัน สิ่งเหล่านี้สามารถเปลี่ยนการใช้หน่วยความจำ การสื่อสาร การเลือกเคอร์เนล คุณภาพเอาต์พุต และความหน่วง เลย์เอาต์ที่ดีที่สุดขึ้นอยู่กับประเภท GPU และการเชื่อมต่อระหว่างกัน การเพิ่ม GPU มากขึ้นอาจเพิ่มค่าใช้จ่ายในการสื่อสารหรือทำให้ทรัพยากรบางส่วนว่างเปล่า ตรวจสอบคุณภาพเอาต์พุตและโหมดความล้มเหลวให้แน่นอนหลังเปลี่ยนความแม่นยำหรือการทำงานของโมเดล
ลำดับในทางปฏิบัติเรียบง่าย: ทำซ้ำ baseline ระบุเมตริกที่ไม่บรรลุเป้าหมาย ตั้งสมมติฐานคอขวดหนึ่งข้อ เปลี่ยนการตั้งค่าหนึ่งอย่าง และทำซ้ำ หากการตั้งค่าปรับปรุงเมตริกหนึ่งขณะทำร้ายอีกเมตริก ให้ตัดสินใจอย่างชัดเจนว่าข้อแลกเปลี่ยนนั้นเหมาะกับผลิตภัณฑ์หรือไม่ วิธีนี้ทำให้การปรับแต่งเป็นการตัดสินใจที่ควบคุมได้แทนที่จะเป็นกองแฟล็ก
ตรวจสอบ Speculative Decoding และความเร็วที่อ้างว่าเพิ่มขึ้นทุกกรณี
Speculative decoding สามารถลดงานแบบอนุกรมของโมเดลเป้าหมายเมื่อโทเคนร่างได้รับการยอมรับอย่างมีประสิทธิภาพและรันไทม์ใช้การตรวจสอบได้ดี ประโยชน์ของมันขึ้นอยู่กับเส้นทางร่าง พฤติกรรมการยอมรับ รูปร่างแบตช์ ฮาร์ดแวร์ และส่วนผสมพรอมป์ต์/เอาต์พุต มันอาจช่วยทราฟฟิกที่จำกัดด้วยการถอดรหัส และมีคุณค่าน้อยเมื่อพรีฟิลล์ การเข้าคิว หรือการสื่อสารครอบงำ
รันการทดสอบ A/B โดยเปิดและปิด speculation ตรึงเช็กพอยต์โมเดล ชุดพรอมป์ต์ ขีดจำกัดโทเคน รูปแบบการมาถึง การทำงานพร้อมกัน การอุ่นระบบ และหน้าต่างการวัดให้คงที่ บันทึกจำนวนโทเคนที่ยอมรับต่อขั้นการตรวจสอบหากมี พร้อมกับปริมาณงานรวม ความเร็วต่อคำขอ TTFT ความหน่วง p95 การใช้ GPU ความล้มเหลว และคุณภาพงาน ความยาวการยอมรับที่จำลองใน benchmark ที่เผยแพร่เป็นเงื่อนไขการทดสอบ ไม่ใช่ค่าที่จะสมมติสำหรับพรอมป์ต์ของคุณ
ความเร็วที่อ้างว่าเพิ่มขึ้นจะมีประโยชน์เฉพาะเมื่อผ่านการตรวจสอบสามข้อ: วัตถุประสงค์ระดับบริการเดียวกัน คุณภาพคำตอบที่ยอมรับได้ และการเปรียบเทียบต้นทุนที่เป็นธรรม รายงานบริบทเต็มรูปแบบพร้อมกับตัวเลขใดๆ ที่คุณเผยแพร่ หลีกเลี่ยงการเปรียบเทียบจำนวน GPU ความยาวพรอมป์ต์ ความยาวเอาต์พุต โหมดความแม่นยำ โมเดลรีวิชัน หรือเมตริกที่ต่างกัน ราวกับว่าเป็น experiment แบบควบคุม
โฮสต์เองหรือใช้ Managed DeepSeek V4.1 Flash API?
การโฮสต์เองสมเหตุสมผลเมื่อทราฟฟิกมีเสถียรภาพพอที่จะทำให้ GPU มีประโยชน์ ทีมสามารถดำเนินการโครงสร้างพื้นฐานอนุมานได้ และการควบคุมฮาร์ดแวร์หรือการทำงานคุ้มกับงานปฏิบัติการ ให้รวมต้นทุนเต็มของตัวเร่งความเร็ว headroom ความจุ พลังงาน เครือข่าย พื้นที่จัดเก็บ การบำรุงรักษา และเวลาทางวิศวกรรม ผลลัพธ์ tokens/s สูงสุดที่สูงเพียงอย่างเดียวไม่ได้พิสูจน์ว่าต้นทุนต่องานที่สำเร็จต่ำกว่า
Managed API มีประโยชน์เมื่อทีมต้องการตรวจสอบความต้องการของผลิตภัณฑ์อย่างรวดเร็ว หลีกเลี่ยงการรันฟลีตให้บริการ หรือเปรียบเทียบ baseline ของ API กับการติดตั้งใช้งานของตนเอง Atlas Cloud แสดง DeepSeek V4.1 Flash ภายใต้ model ID deepseek-ai/deepseek-v4.1-flash พร้อม API ที่เข้ากันได้กับ OpenAI หน้าโมเดล DeepSeek V4.1 Flash ขณะนี้แสดง $0.30 ต่อล้านโทเคนอินพุต, $1.20 ต่อล้านโทเคนเอาต์พุต และ $0.03 ต่อล้านโทเคนที่อ่านจากแคช โดยไม่แสดงส่วนลด ณ ตุลาคม 2026 ตรวจสอบรายการราคาปัจจุบัน ก่อนประเมินค่าใช้จ่าย ปลายทางแบบ managed ไม่ได้ขจัดความจำเป็นในการวัดความหน่วงคำขอหรือเศรษฐศาสตร์ทราฟฟิกของคุณเอง
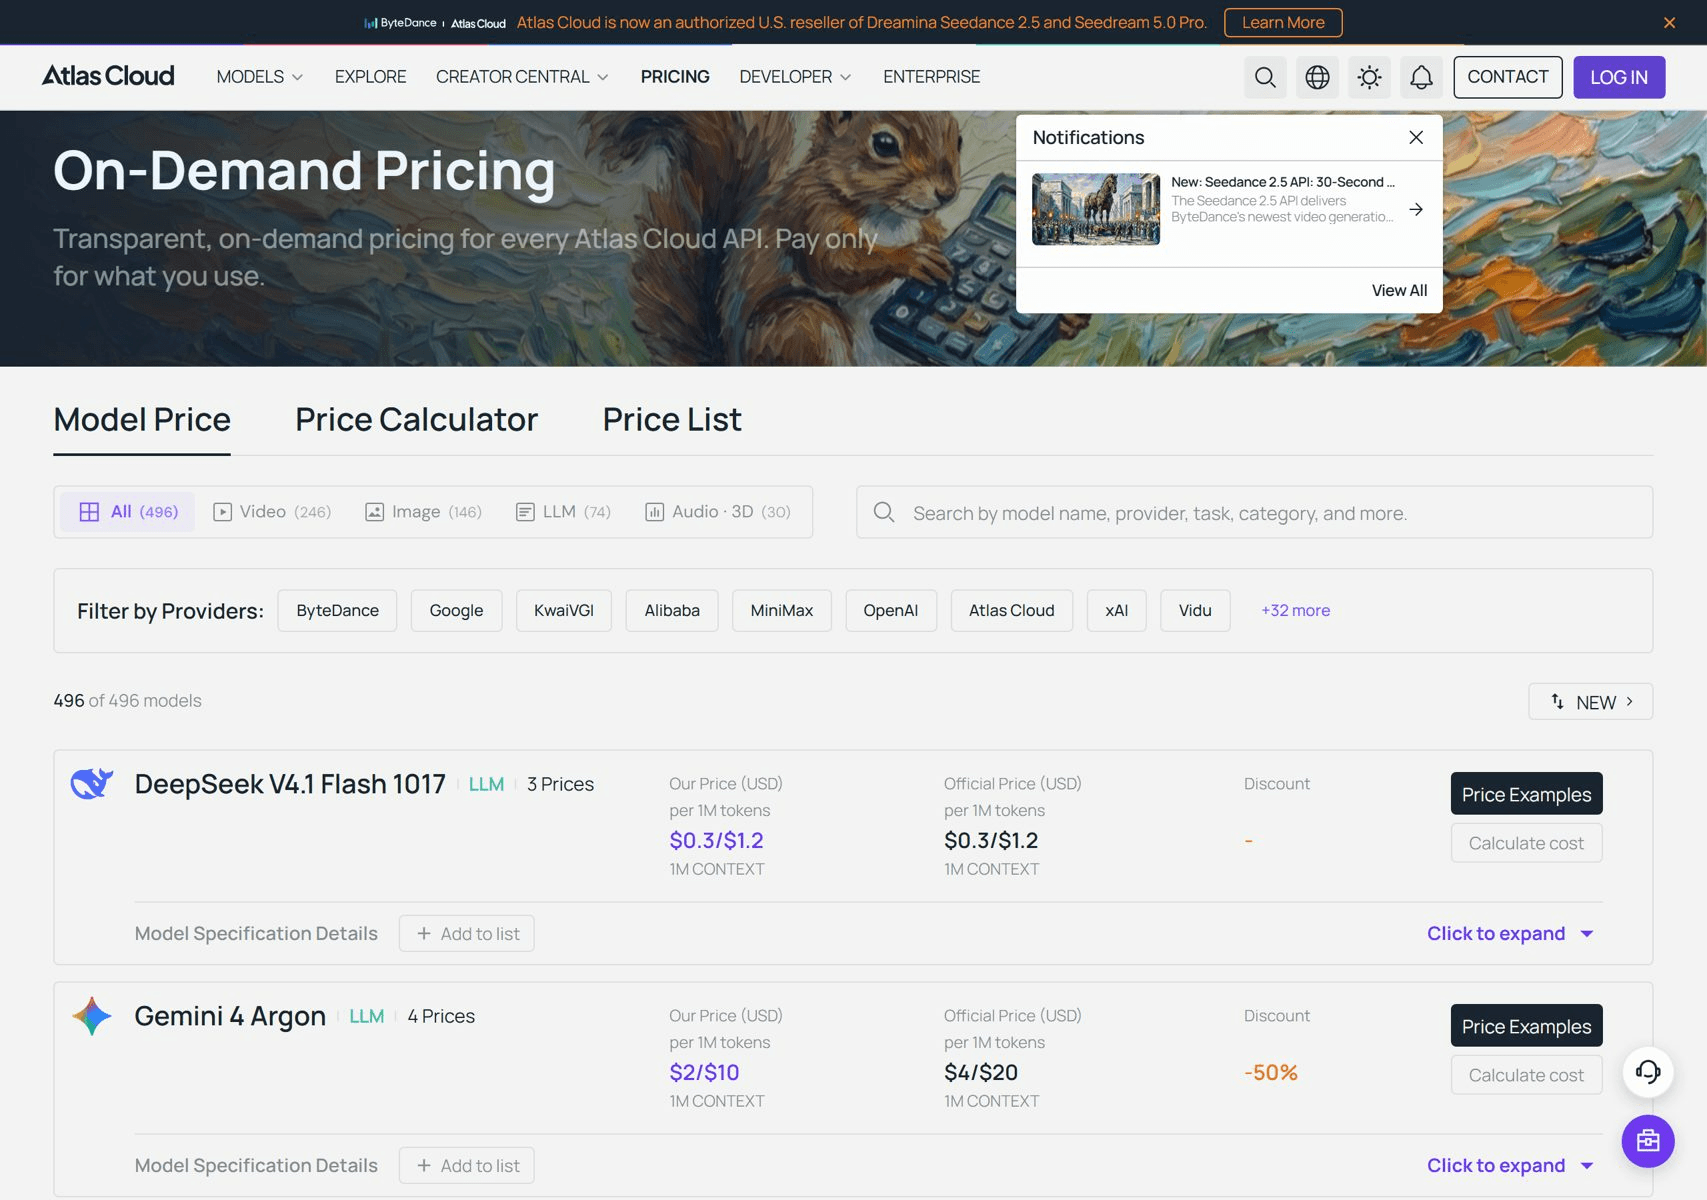
รายการนี้ระบุตัวเลือก managed API ไม่ใช่ benchmark การให้บริการ
สำหรับการตัดสินใจติดตั้งใช้งานอย่างเป็นธรรม ให้รันคำขอทางธุรกิจเดียวกันซ้ำกับบริการที่โฮสต์เองและปลายทาง managed เปรียบเทียบต้นทุนต่องานที่เสร็จสมบูรณ์ การกระจายความหน่วง ความน่าเชื่อถือ และเวลาของพนักงานที่จำเป็นในการดูแลแต่ละตัวเลือก หากเป้าหมายหลักของคุณคือการเพิ่มประสิทธิภาพปริมาณงานอนุมานของ DeepSeek V4.1 Flash ให้ใช้ปริมาณงานและเกณฑ์ความสำเร็จเดียวกันกับทั้งสองเส้นทาง
คำถามที่พบบ่อย
ปริมาณงานกับโทเคนต่อวินาทีต่อผู้ใช้ต่างกันอย่างไร?
ปริมาณงานแบบรวมนับเอาต์พุตข้ามคำขอที่ใช้งานอยู่ โทเคน/วินาทีต่อผู้ใช้วัดอัตราการถอดรหัสของคำขอเดียว การแบตช์สามารถเพิ่มค่าแรกขณะลดค่าที่สอง ดังนั้นให้รายงานทั้งสองสำหรับบริการแบบโต้ตอบ
การเพิ่มการทำงานพร้อมกันปรับปรุงปริมาณงานเสมอหรือไม่?
ไม่ใช่ เอาต์พุตรวมอาจเพิ่มขึ้นจนกว่าการประมวลผลหรือหน่วยความจำจะอิ่มตัว แล้วจึงทรงตัว การเข้าคิวและความหน่วงส่วนท้ายอาจแย่ลงอย่างต่อเนื่องหลังจากจุดนั้น หยุดเพิ่มการทำงานพร้อมกันเมื่อวัตถุประสงค์ระดับบริการไม่ผ่าน
ตัวเลข benchmark ของ vLLM และ SGLang เปรียบเทียบโดยตรงได้หรือไม่?
ได้เฉพาะเมื่อโมเดลรีวิชัน ฮาร์ดแวร์ ความยาวพรอมป์ต์และเอาต์พุต การทำงานพร้อมกัน สถานะอุ่น ขอบเขตการวัด และข้อจำกัดความหน่วงตรงกัน รายงานที่เผยแพร่ใช้การตั้งค่าต่างกัน ดังนั้นจึงแสดงเส้นทางการปรับปรุงมากกว่าจะเป็นผู้ชนะรันไทม์โดยตรง
ควรใช้ managed API แทนการโฮสต์เองเมื่อใด?
ใช้ managed API เมื่อความเร็วในการผสานรวมและงานโครงสร้างพื้นฐานที่ลดลงสำคัญกว่าการเป็นเจ้าของสแต็กให้บริการ โฮสต์เองเมื่อการใช้ประโยชน์ ความเชี่ยวชาญด้านปฏิบัติการ การควบคุม และกรณีต้นทุนรวมที่วัดได้คุ้มกับการรัน GPU





