หน้าต่างบริบทหนึ่งล้านโทเคนบอกว่าคุณรับข้อความได้มากเพียงใด ไม่ได้บอกว่าจะตีความทุกข้อความได้อย่างน่าเชื่อถือเพียงใด สำหรับ ความแม่นยำในการวิเคราะห์เอกสารยาวของ DeepSeek V4.1 Flash หลักฐานสาธารณะมีประโยชน์แต่ไม่ครบถ้วน: การ์ดโมเดลของ DeepSeek รายงาน exact match 45.2 บน LongBench-V2 สำหรับโมเดลฐาน V4.1 Flash ในการตั้งค่าแบบ 1-shot ขณะที่ API ได้ย้ายไปยังบิลด์ 1017 ที่ใหม่กว่าแล้ว เบนช์มาร์กนั้นเป็นสัญญาณเกี่ยวกับการตั้งค่าการประเมินแบบหนึ่ง ไม่ใช่อัตราการผ่านสำหรับสัญญา รายงานประจำปี หรือคลังวิจัยของคุณ
คำตอบในทางปฏิบัติคือใช้ Flash สำหรับการดึงข้อมูลที่รวดเร็วและการสังเคราะห์รอบแรก จากนั้นกำหนดให้มีหลักฐานระดับหน้าและการตรวจทานโดยมนุษย์สำหรับการตัดสินใจที่สำคัญ ไม่มีแหล่งสาธารณะใดที่อ้างถึงในที่นี้ให้การประเมินบิลด์ปัจจุบันที่ทำซ้ำได้ ครอบคลุมงานเอกสารทั้งห้าด้านด้านล่าง แผนการทดสอบนี้เป็นโปรโตคอลที่พร้อมรัน ไม่ใช่ข้ออ้างว่าการรันเหล่านั้นเกิดขึ้นแล้ว
ประเด็นสำคัญ
- ตระกูลโมเดลรองรับสูงสุด 1M โทเคน แต่ขีดจำกัดบริบทไม่ใช่การรับประกันความแม่นยำ
- คะแนน LongBench-V2 45.2 ที่เผยแพร่เป็นของโมเดลฐานและตั้งค่าเบนช์มาร์กแบบ 1-shot
- API ของ DeepSeek ตอนนี้ให้บริการ V4.1-Flash-1017; บันทึกการเปิดตัวไม่ได้เผยแพร่คะแนนเอกสารยาวใหม่
- ขอตำแหน่งหลักฐาน ตรวจสอบเทียบกับต้นฉบับ และวัดข้อผิดพลาดบนเอกสารของคุณเอง
หน้าต่าง 1M โทเคนหมายความว่าอย่างไรต่อการวิเคราะห์เอกสาร
การ์ดโมเดลของ DeepSeek อธิบายว่า V4.1 Flash รองรับบริบทสูงสุดหนึ่งล้านโทเคน เอกสาร API ปัจจุบันระบุโมเดลที่ให้บริการเป็น DeepSeek-V4.1-Flash-1017 และระบุความยาวบริบท 1M สิ่งเหล่านี้เป็นข้อกำหนดด้านความจุ ไม่ได้ยืนยันว่าโมเดลจะพบเชิงอรรถ แยกเวอร์ชันเอกสารสองฉบับออกจากกัน หรือยอมรับว่าข้อเท็จจริงที่ขอไม่มีอยู่ในเอกสารได้บ่อยเพียงใด (การ์ดโมเดล DeepSeek)
โทเคนไม่ใช่หน้า จำนวนหน้าแตกต่างกันไปตามตาราง เชิงอรรถ เลย์เอาต์ ภาษา และคุณภาพการสกัด PDF ที่สแกนอาจต้องใช้ OCR; ตารางอาจสูญเสียป้ายชื่อแถวเมื่อแปลงเป็นข้อความ; ส่วนหัวและองค์ประกอบประจำหน้าที่ซ้ำ ๆ อาจกินบริบทโดยไม่ช่วยตอบคำถาม พรอมป์ต์และคำตอบที่ขอใช้โทเคนด้วยเช่นกัน ดังนั้นเพดานหนึ่งล้านโทเคนตามชื่อไม่ได้หมายความว่าไฟล์หนึ่งล้านโทเคนทุกไฟล์จะมาถึงครบถ้วนผ่านทุกอินเทอร์เฟซแชตหรือไคลเอนต์ API
ก่อนการทดสอบ ให้บันทึกตัวระบุโมเดล ไคลเอนต์ และวิธีการป้อนข้อมูลให้ชัดเจน ตรวจสอบว่าได้ส่งข้อความที่สกัดครบถ้วนหรือไม่ ผู้ให้บริการตัดทอนหรือไม่ และคำขอไปถึงเวอร์ชันโมเดลที่คาดไว้หรือไม่ API ของ DeepSeek ปัจจุบันใช้ deepseek-flash สำหรับบิลด์ Flash ล่าสุด หากเกตเวย์หรือ SDK ของคุณใช้นามแฝงอื่น ให้บันทึกนามแฝงนั้นและตรวจสอบการกำหนดเส้นทาง ถ้าทีมกำลังตั้งค่าการเรียกแบบโฮสต์ที่ทำซ้ำได้ สามารถเริ่มจาก แพลตฟอร์มโมเดลของ Atlas Cloud แล้วเปิด รายการ API DeepSeek V4.1 Flash
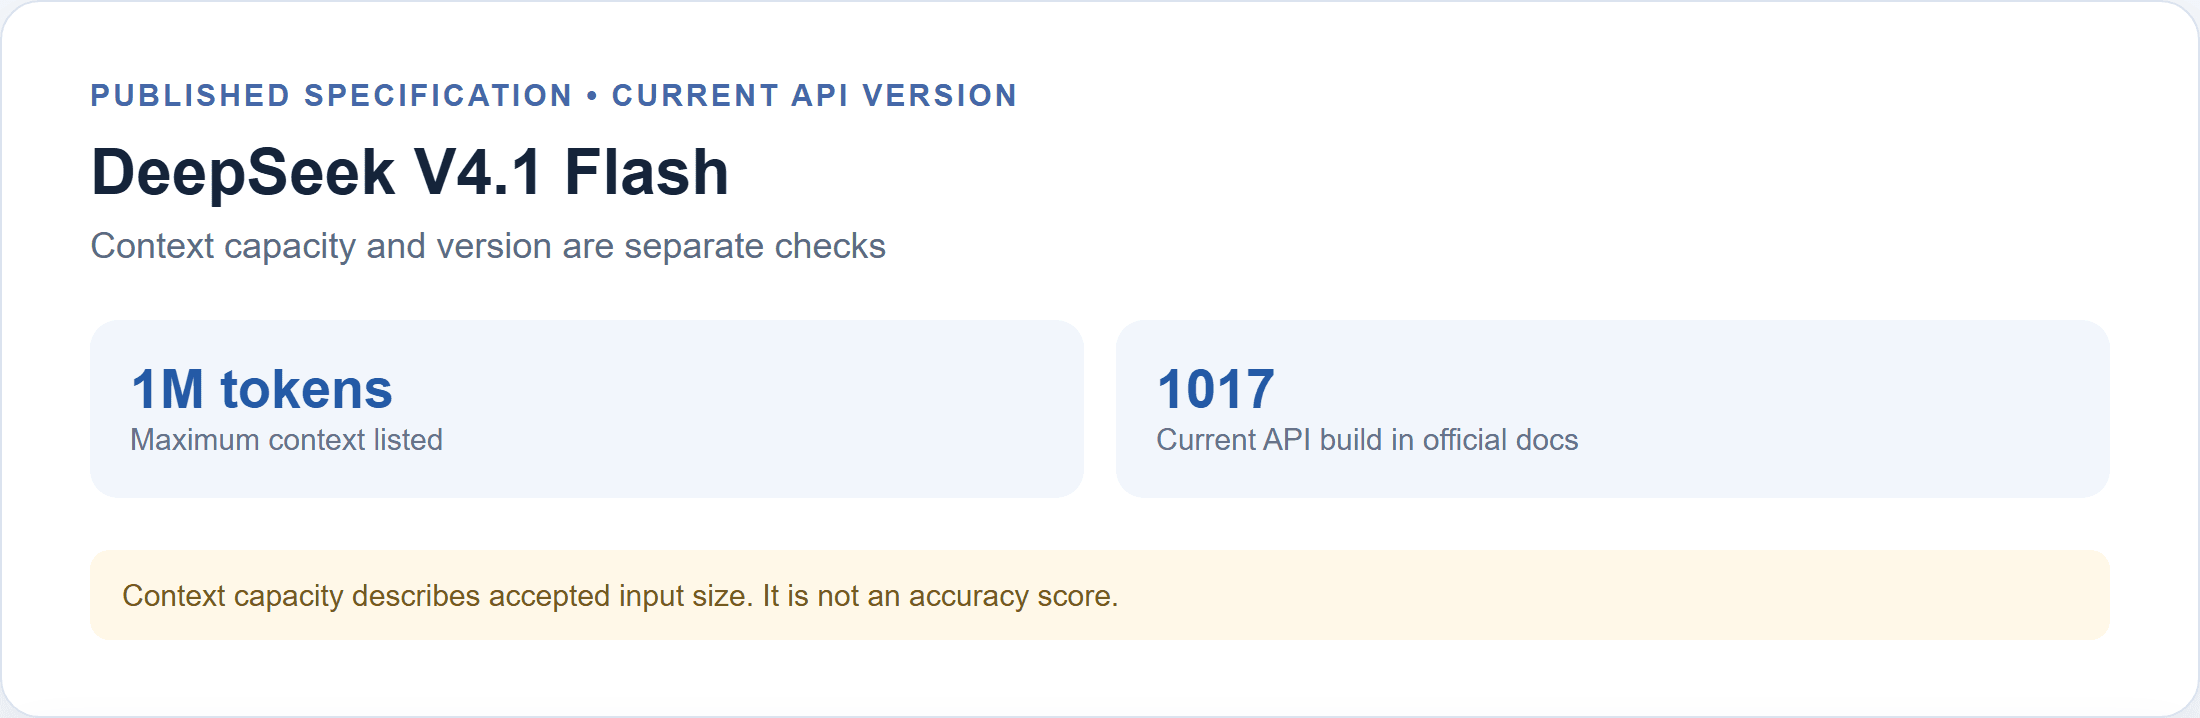
ข้อกำหนดที่เผยแพร่ให้ค่าสูงสุดของบริบท 1M; เอกสาร API ปัจจุบันระบุบิลด์ 1017
การอัปโหลดหรือคำขอที่สำเร็จเพียงแสดงว่าระบบรับอินพุตแล้ว หากต้องการยืนยันว่ารายละเอียดที่เกี่ยวข้องมีอิทธิพลต่อคำตอบ ให้ขอตำแหน่งที่แม่นยำ ดึงข้อความตอนนั้น และยืนยันว่าข้อความรอบข้างสนับสนุนข้อกล่าวอ้าง
คะแนน LongBench-V2 แสดงและไม่แสดงอะไรบ้าง
แถว LongBench-V2 ในการ์ดโมเดลรายงานคะแนน exact match ภายใต้การตั้งค่าแบบ 1-shot ตารางระบุผลลัพธ์เป็นผลการประเมินโมเดลฐาน และระบุว่าโมเดลฐานทั้งหมดใช้กรอบการประเมินภายในเดียวกัน นอกจากนี้ยังระบุว่าคะแนนที่ต่างกันภายใน 0.3 ถือว่าเทียบเท่ากัน ค่าต่าง ๆ คือ:
| โมเดลฐานในการ์ดโมเดล | LongBench-V2 (EM) | Shots |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44.7 | 1 |
| DeepSeek-V4-Pro-Base | 51.5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45.2 | 1 |
ช่องว่าง 0.5 คะแนนระหว่าง V4-Flash-Base และ V4.1-Flash-Base มากกว่าช่วงความเทียบเท่า 0.3 ที่การ์ดระบุ แต่ก็ยังเป็นการเปรียบเทียบเบนช์มาร์กที่แคบ ค่า 45.2 ไม่ใช่ “ความแม่นยำ 45.2% บนไฟล์ PDF ยาว” แต่เป็นคะแนน exact match สำหรับโมเดลฐานชุดเบนช์มาร์ก การตั้งค่าพรอมป์ต์ และผู้ประเมินหนึ่งชุดโดยเฉพาะ ไม่ได้ให้คะแนนโดยตรงกับโมเดล instruct/API แบบโฮสต์ที่ตอบคำถามของคุณด้วยพรอมป์ต์อื่น
LongBench-V2 มีคำถามแบบเลือกตอบ 503 ข้อในหกหมวดหมู่ รวมถึงการตอบคำถามจากเอกสารเดียวและหลายเอกสาร บทสนทนายาว ที่เก็บโค้ด และข้อมูลที่มีโครงสร้าง บริบทครอบคลุม 8,000 ถึง 2 ล้านคำ ผู้เขียนเบนช์มาร์กรายงานความแม่นยำเฉลี่ย 53.7% สำหรับผู้เชี่ยวชาญภายใต้ขีดจำกัด 15 นาที และ 50.1% สำหรับโมเดลตอบคำถามโดยตรงที่ดีที่สุดในการประเมินที่รายงาน ความกว้างของมันทำให้เป็นแบบทดสอบความเครียดที่มีประโยชน์ แต่ตัวเลขรวมไม่สามารถวินิจฉัยได้ว่าการดำเนินการกับเอกสารใดแข็งแกร่งหรืออ่อนแอ (บทความ LongBench-V2)
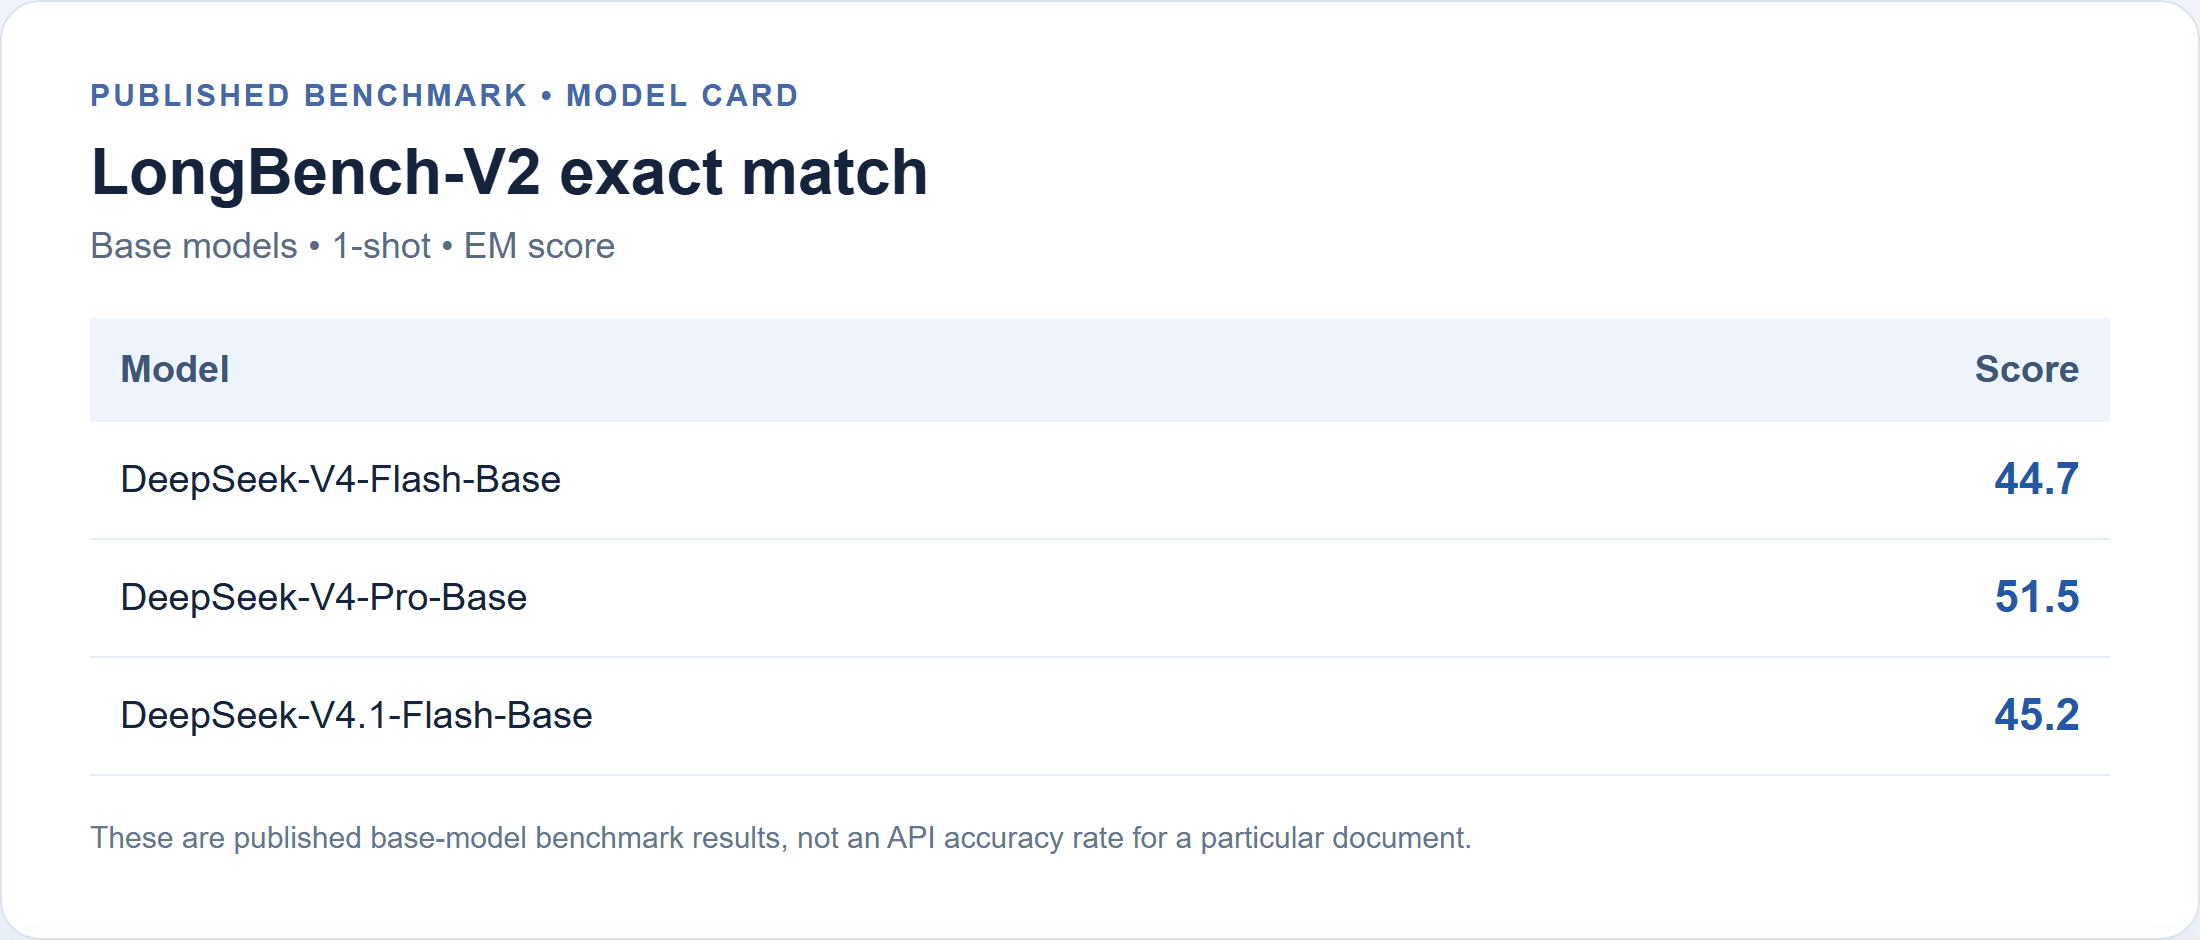
แถวที่เผยแพร่เป็นผลลัพธ์ของโมเดลฐานแบบ 1-shot ไม่ใช่อัตราการผ่านของ API ที่วัดจริง
มีข้อควรระวังเรื่องเวอร์ชัน บันทึกการเปิดตัววันที่ 17 ตุลาคมของ DeepSeek ระบุว่า API และเว็บแอปได้รับการอัปเกรดเป็น V4.1-Flash-1017 และชื่อโมเดล API ยังคงเป็น deepseek-flash บันทึกดังกล่าวแสดงเบนช์มาร์กเอเจนต์และการให้เหตุผลที่อัปเดต แต่ไม่ได้รายงานผล LongBench-V2 ใหม่ ดังนั้น 45.2 จึงยังเป็นข้อมูลอ้างอิงที่เผยแพร่และมีประโยชน์สำหรับโมเดลฐาน V4.1 Flash ขณะที่ความแม่นยำของบิลด์ API ปัจจุบันในคำถามเอกสารยาวยังไม่มีการวัดปริมาณในแหล่งเหล่านั้น อย่าโอนความก้าวหน้าจากเบนช์มาร์กที่ไม่เกี่ยวข้องมาสู่การตอบคำถามจากเอกสาร (อัปเดต DeepSeek V4.1-Flash-1017)
วิธีรันการทดสอบความแม่นยำเอกสารยาวที่เป็นธรรม
การประเมินที่มีประโยชน์ต้องมีแหล่งข้อมูลคงที่ เฉลย และกฎการให้คะแนน เริ่มจากรายงานประจำปีหรือรายงานทางเทคนิคสาธารณะที่สามารถแชร์เวอร์ชันและโครงสร้างหน้าได้ บันทึก PDF และข้อความที่สกัดไว้ บันทึก URL ต้นฉบับและวันที่ดึงข้อมูล และระบุว่าคุณใช้การสกัดข้อความแบบเนทีฟหรือ OCR หลีกเลี่ยงการเลือกเอกสารเพราะคุณรู้อยู่แล้วว่าโมเดลจัดการได้ดี
ก่อนพรอมป์ต์โมเดล ให้เขียนเฉลยด้วยตัวเองจากต้นฉบับ สำหรับแต่ละคำถาม ให้บันทึกคำตอบที่คาดไว้และหน้าหรือส่วนที่แน่นอน วิธีนี้ป้องกันไม่ให้คำตอบที่ดูน่าเชื่อถือกลายเป็นมาตรฐานการให้คะแนน ทำให้คำถามเจาะจงพอที่จะให้คะแนนได้ ขณะเดียวกันก็คงความกำกวมที่ผู้อ่านจะพบจริง
ใช้เอกสาร ชุดคำถาม ตัวระบุโมเดล พรอมป์ต์ การตั้งค่าการให้เหตุผล และรูปแบบเอาต์พุตเดียวกันสำหรับทุกครั้งที่รัน หาก API เปิดให้ตั้งค่า temperature หรือการควบคุมการให้เหตุผล ให้บันทึกไว้ รันชุดคำถามมากกว่าหนึ่งครั้งหากต้องการประเมินความแปรปรวน; การรันหนึ่งครั้งเป็นเพียงตัวอย่าง ไม่ใช่อัตราที่มั่นคง อย่าแก้ไขเอาต์พุตเงียบ ๆ ก่อนให้คะแนน
ชุดคำถามขนาดกะทัดรัดสามารถครอบคลุมโอกาสเกิดความล้มเหลวห้าแบบที่แตกต่างกัน:
| งาน | ตัวอย่างรูปแบบคำถาม | สิ่งที่ต้องตรวจสอบ |
|---|---|---|
| การค้นหาจุดเดียว | “รายงานระบุวันที่ใดสำหรับนโยบายที่แก้ไขแล้ว?” | ค่าที่แน่นอนและหน้าที่อ้างอิง |
| การเชื่อมโยงข้ามส่วน | “ความเสี่ยงในส่วนที่ 2 เกี่ยวข้องกับการควบคุมในส่วนที่ 7 อย่างไร?” | ข้อความทั้งสองตอน และการเชื่อมโยงนั้นระบุไว้หรืออนุมาน |
| การจัดการข้อยกเว้น | “ใครถูกยกเว้นจากความคุ้มครองที่ระบุไว้?” | เชิงอรรถ ขอบเขต และตัวกำหนดเงื่อนไข |
| ความขัดแย้งของเวอร์ชัน | “ค่าใดมีผลหลังการแก้ไข และค่าเดิมที่ถูกแทนคืออะไร?” | วันที่ ป้ายเวอร์ชัน และตำแหน่งทั้งสอง |
| ข้อมูลที่ขาดหาย | “รายงานระบุระยะเวลาการเก็บรักษาสำเนาของผู้ขายไว้เท่าใด?” | การยอมรับว่าไม่ระบุ หากเอกสารไม่ได้กล่าวถึง |
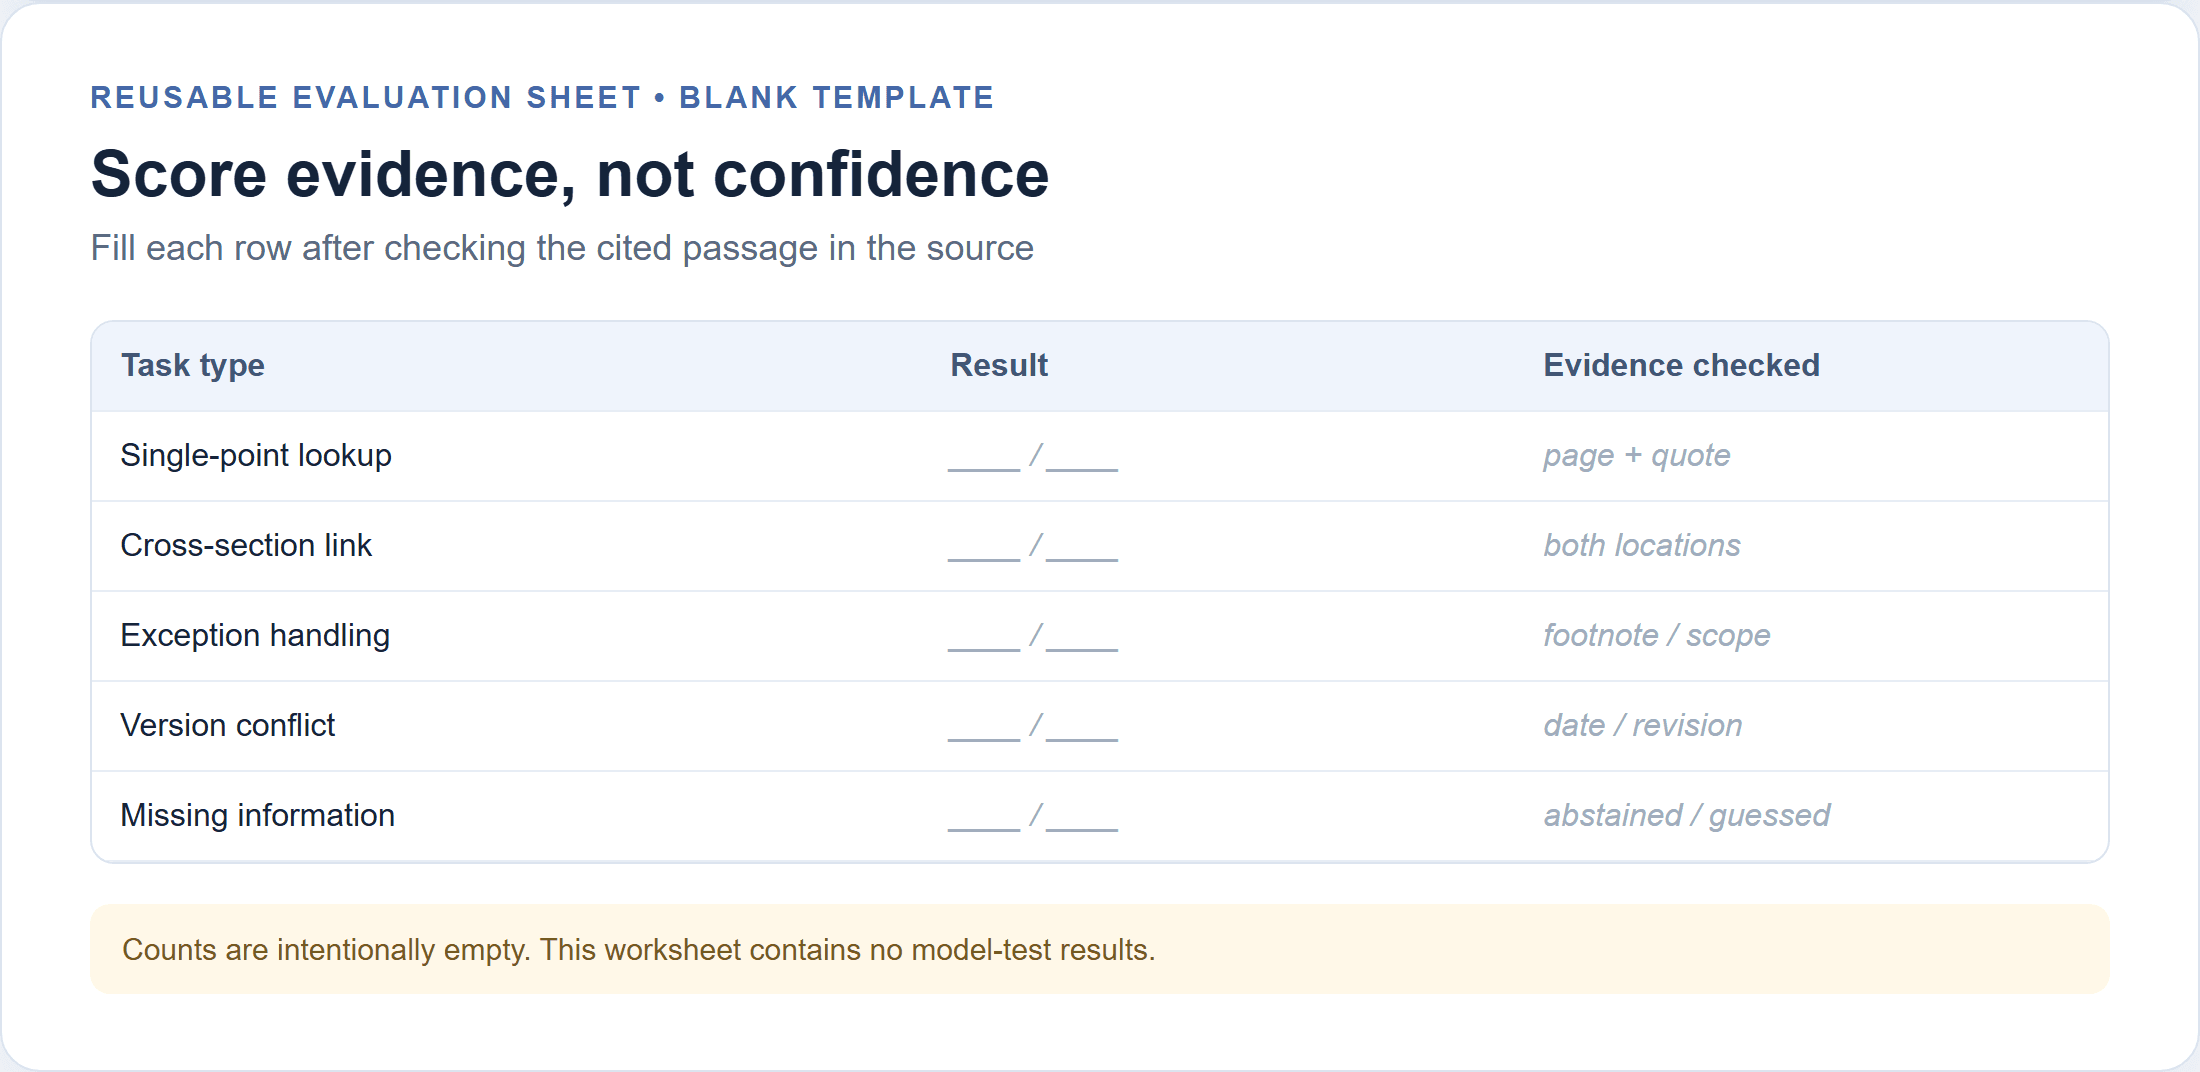
นี่คือใบงานให้คะแนนเปล่า ไม่ใช่ตารางผลลัพธ์ กรอกเฉพาะหลังจากตรวจแต่ละคำตอบเทียบกับเอกสารต้นฉบับ
ให้คะแนนแต่ละคำตอบเป็น ถูกต้อง บางส่วน ผิด ไม่มีหลักฐานสนับสนุน หรืองดตอบอย่างถูกต้อง นับข้อกล่าวอ้างที่ไม่มีหลักฐานสนับสนุนแยกจากคำตอบผิด เพราะคำตอบอาจให้คำตอบหลักที่ถูกต้องแต่แต่งรายละเอียดขึ้นมา ตรวจสอบว่าการอ้างอิงแต่ละรายการชี้ไปยังข้อความที่สนับสนุนข้อกล่าวอ้างหรือไม่ รายงานจำนวนคำถามและจำนวนตามหมวดหมู่ควบกัน เปอร์เซ็นต์รวมอาจซ่อนว่าโมเดลมองข้ามเชิงอรรถหรือมีปัญหาเฉพาะเมื่อข้อมูลกระจายอยู่หลายส่วน
เก็บไฟล์ต้นฉบับ ข้อมูลที่สกัด พรอมป์ต์ คำตอบดิบ และใบให้คะแนนไว้อย่างครบถ้วน เผยแพร่เฉพาะเนื้อหาที่คุณมีสิทธิ์แชร์ และปิดชื่อหรือรายละเอียดบัญชีที่เป็นความลับ ผู้ตรวจทานควรสามารถติดตามทุกคำตอบที่ให้คะแนนจากการส่งออกของโมเดลไปยังหน้าในแหล่งข้อมูลที่บันทึกไว้ได้
คำตอบเอกสารยาวมักล้มเหลวตรงไหน
หากไม่มีการรันบิลด์ปัจจุบันกับเอกสารที่ระบุไว้ การอ้างว่า V4.1 Flash มีอัตราข้อผิดพลาดหรือรูปแบบความล้มเหลวแบบใดแบบหนึ่งจะเป็นเรื่องผิด หมวดหมู่ด้านล่างเป็นสิ่งที่ควรตรวจสอบ ไม่ใช่ผลการวัดเกี่ยวกับโมเดลนี้
เริ่มจาก การสูญเสียขอบเขต ย่อหน้าหลักอาจระบุกฎ ขณะที่เชิงอรรถจำกัดกฎนั้นไว้เฉพาะภูมิภาค ช่วงวันที่ หรือกลุ่มลูกค้า ให้ถามถึงข้อยกเว้นอย่างชัดเจนและตรวจว่าข้อความที่อ้างถึงรวมข้อยกเว้นนั้นหรือไม่ การอ้างคำพูดจากย่อหน้าหลักเพียงอย่างเดียวอาจไม่เพียงพอ
ต่อไปตรวจความสับสนเรื่องเวอร์ชัน รายงานอาจมีค่าใกล้เคียงกันซ้ำในฉบับร่างและส่วนที่แก้ไข ให้ขอให้โมเดลระบุวันที่หรือเวอร์ชันที่ผูกกับแต่ละค่า แทนที่จะขอเพียง “ตัวเลขปัจจุบัน” หากโมเดลเลือกค่าใดค่าหนึ่งโดยไม่บอก ให้คะแนนคำตอบว่าไม่สมบูรณ์แม้จะบังเอิญเลือกถูกก็ตาม
คำถามข้ามส่วนชวนให้เกิดการอนุมาน โมเดลอาจนำข้อเท็จจริงที่ถูกต้องสองข้อมารวมเป็นคำอธิบายเชิงสาเหตุที่เอกสารไม่ได้ระบุไว้ กำหนดให้โมเดลแยกข้อความที่ระบุตรง ๆ ออกจากข้ออนุมาน จากนั้นเปรียบเทียบข้ออนุมานกับหลักฐานและตัดสินว่าสมเหตุสมผลกับงานหรือไม่
สุดท้าย ทดสอบการงดตอบ รวมคำถามที่ไม่มีคำตอบไว้ด้วย การเดาอย่างมั่นใจถือเป็นความล้มเหลวแม้จะฟังดูสมเหตุสมผล สำหรับสัญญา การปฏิบัติตามกฎระเบียบ เอกสารทางคลินิก หรือการวิเคราะห์ทางการเงินที่มีผลสำคัญ ให้ผู้เชี่ยวชาญที่มีคุณสมบัติตรวจข้อความต้นฉบับก่อนใช้ข้อสรุป
ขั้นตอนการตรวจสอบเพื่อคำตอบที่ปลอดภัยขึ้น
พรอมป์ต์นี้ทำให้คำตอบตรวจสอบได้ง่ายขึ้น ไม่สามารถรับประกันความถูกต้องหรือแทนการตรวจทานต้นฉบับได้ ใช้พรอมป์ต์นี้กับการสกัดที่คงป้ายหน้า จากนั้นถามคำถามที่เจาะจงแทนการขอสรุปภาพรวมของไฟล์ขนาดใหญ่
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
สำหรับรายงานยาว ให้แบ่งงานตามงาน ไม่ใช่แบ่งตามจำนวนหน้าโดยอัตโนมัติ ก่อนอื่นขอแผนผังแหล่งข้อมูล: ชื่อส่วน วันที่ คำนิยาม และตารางที่เกี่ยวข้อง จากนั้นสอบถามหัวข้อเฉพาะและขอข้อความที่สนับสนุน สำหรับข้อสรุปข้ามส่วน ให้จัดหาหรือดึงข้อความทั้งสองตอนในรอบเดียวกัน และขอให้โมเดลอธิบายความเชื่อมโยงพร้อมระบุข้ออนุมานใด ๆ
ใช้วงจรการตรวจสอบโดยมนุษย์:
- ตรวจหน้าและคำพูดที่อ้างถึงในไฟล์ต้นฉบับ
- ยืนยันว่าคำพูดนั้นรวมข้อยกเว้นข้างเคียงและหัวตาราง
- ทำเครื่องหมายแต่ละข้อกล่าวอ้างว่าเป็นแบบตรง อนุมาน ไม่มีหลักฐานสนับสนุน หรือขัดแย้ง
- แก้พรอมป์ต์หรือแบ่งงาน หากการสกัดละโครงสร้างสำคัญ
- เก็บคำขอและคำตอบดิบไว้ เพื่อให้ผู้ตรวจทานสามารถทำซ้ำการตัดสินใจได้
เมื่อใช้ปลายทางแบบโฮสต์ ให้รวมการใช้โทเคนไว้ในบันทึกการรัน หน้าราคาโมเดล ของ Atlas Cloud ปัจจุบันระบุ DeepSeek V4.1 Flash ที่ $0.30 ต่อ 1M โทเคนอินพุต, $1.20 ต่อ 1M โทเคนเอาต์พุต และ $0.03 ต่อ 1M โทเคนที่อ่านจากแคช โดยไม่มีส่วนลดที่ระบุ ตรวจสอบรายการปัจจุบันก่อนจัดงบ ข้อมูลราคานี้อ้างอิงสำหรับ Atlas Cloud ไม่ใช่ราคา DeepSeek API แบบสากล
ที่อัตราที่ระบุ 100,000 โทเคนอินพุตที่ไม่ได้แคชและ 3,000 โทเคนเอาต์พุตมีค่าใช้จ่ายประมาณ $0.033: $0.030 สำหรับอินพุตบวก $0.0036 สำหรับเอาต์พุต
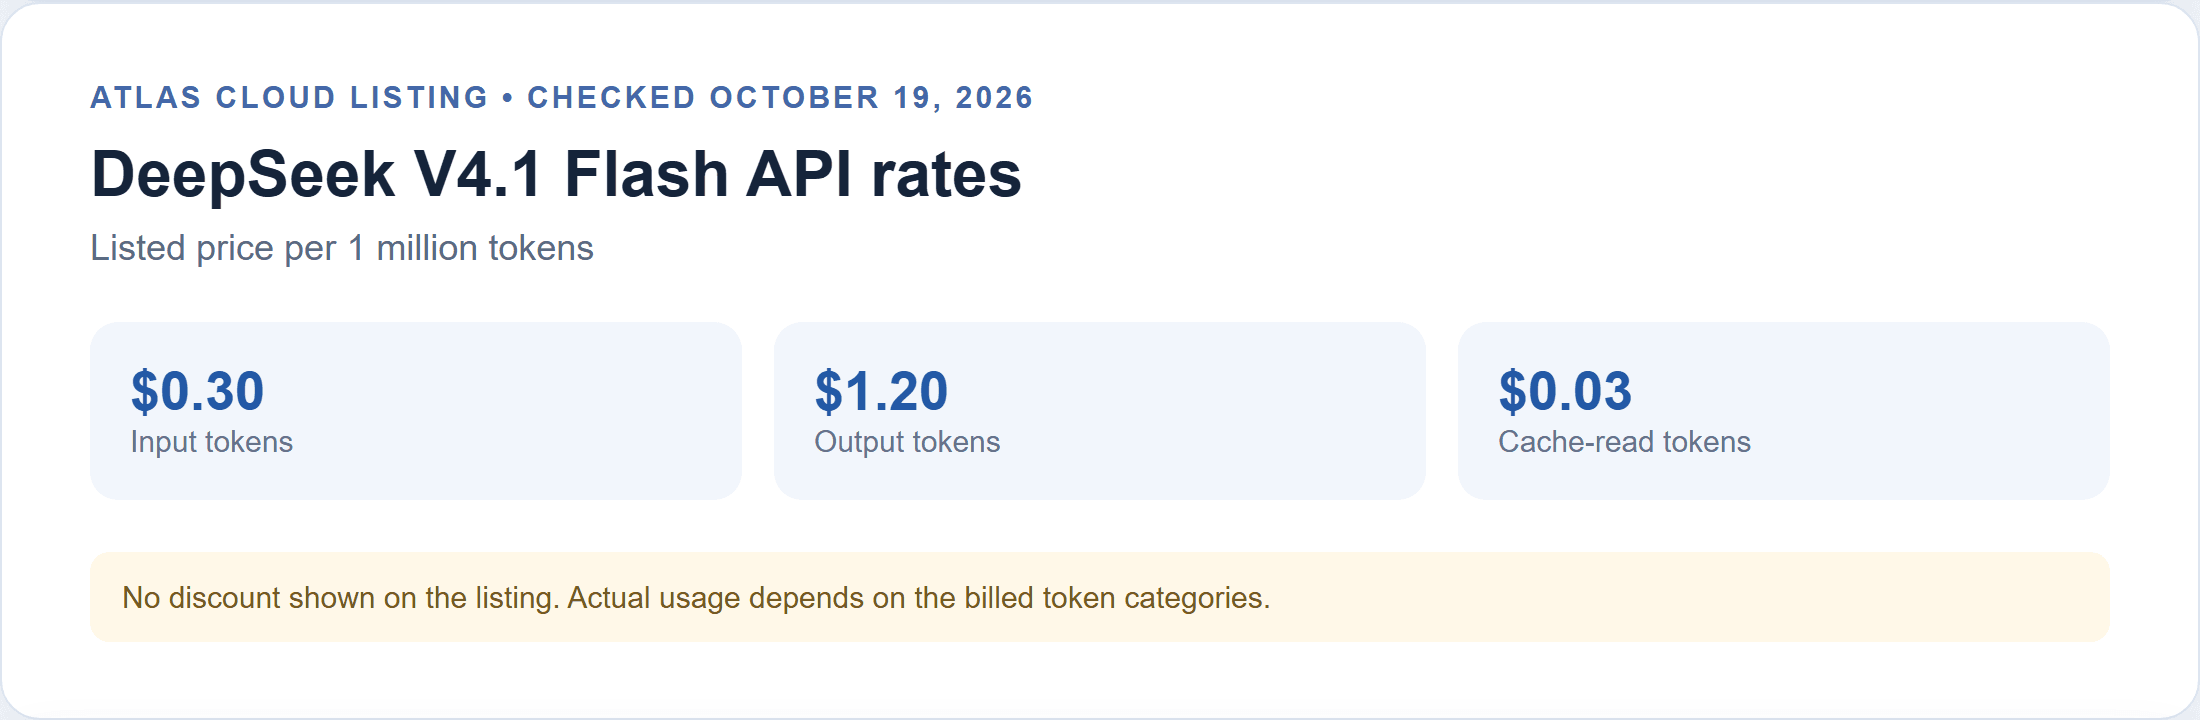
ตรวจสอบราคา Atlas Cloud เมื่อวันที่ 19 ตุลาคม 2026; รายการไม่แสดงส่วนลด อินพุต 1M โทเคนและคำตอบ 20,000 โทเคนจะมีค่าใช้จ่ายประมาณ $0.324 ที่อัตราเดียวกัน ก่อนการจัดการแคชหรือรายการที่คิดค่าบริการอื่น ๆ นี่เป็นตัวอย่างการคำนวณเลข ไม่ใช่ค่าใช้จ่ายจากการทดสอบเอกสารที่วัดจริง อินพุตจริงรวมพรอมป์ต์และข้อความที่สกัดได้; การเรียกซ้ำเพิ่มการใช้งาน ใช้จำนวนโทเคนที่ผู้ให้บริการส่งคืน แทนการประมาณจากจำนวนหน้า
เมื่อใดควรใช้ DeepSeek V4.1 Flash สำหรับเอกสารยาว
Flash เป็นตัวเลือกที่สมเหตุสมผลสำหรับรอบแรกเมื่อคุณต้องค้นหาคำนิยาม รวบรวมวันที่ สร้างแผนผังส่วน หรือร่างสรุปที่คนจะตรวจสอบ งานเหล่านี้มีร่องรอยหลักฐานที่มองเห็นได้และรันซ้ำได้ง่ายด้วยคำถามที่แคบลง สำหรับงานที่ทำซ้ำ ให้เก็บคำถามที่มีคำตอบที่รู้อยู่แล้วและรันซ้ำเมื่อเวอร์ชันโมเดล ไปป์ไลน์การสกัด หรือพรอมป์ต์เปลี่ยน
เพิ่มการควบคุมเมื่อคำถามต้องรวมส่วนที่อยู่ไกลกัน ขึ้นกับเชิงอรรถ หรือเปรียบเทียบการแก้ไข ใช้การอ้างอิงเป็นเครื่องมือนำทาง ไม่ใช่หลักฐานในตัวเอง หากคำตอบจะกระทบภาระผูกพันตามสัญญา สถานะการปฏิบัติตาม การเปิดเผยทางการเงิน หรือการตัดสินใจที่มีผลกระทบสูงอื่น ๆ ให้ผู้ตรวจทานที่มีคุณสมบัติตรวจสอบข้อกล่าวอ้างที่มีนัยสำคัญแต่ละรายการในต้นฉบับ
คำถามที่มีประโยชน์คือ โมเดลนี้ บนเวอร์ชันเอกสารและเวิร์กโฟลว์ที่แน่นอนของคุณ ให้คำตอบพร้อมหลักฐานที่ผ่านการตรวจสอบได้หรือไม่ นั่นคือการทดสอบที่สามารถยืนยัน ความแม่นยำในการวิเคราะห์เอกสารยาวของ DeepSeek V4.1 Flash สำหรับกรณีใช้งานของคุณเอง
คำถามที่พบบ่อย
หน้าต่างบริบท 1M โทเคนหมายความว่าโมเดลวิเคราะห์เอกสาร 1M โทเคนได้อย่างแม่นยำหรือไม่
ไม่ หน้าต่างบริบทอธิบายความจุบริบทที่รองรับ คำขอจริงยังรวมคำสั่งและงบประมาณเอาต์พุต ขณะที่การสกัด ขีดจำกัดของอินเทอร์เฟซ และความยากของคำถามมีผลว่าหลักฐานที่มีประโยชน์จะพร้อมใช้และถูกตีความอย่างถูกต้องหรือไม่
LongBench-V2 เหมือนกับความแม่นยำในการตอบคำถามจากเอกสารหรือไม่
ไม่ LongBench-V2 รวมหมวดงานบริบทยาวหลายประเภทและรายงานประสิทธิภาพภายใต้การตั้งค่าเฉพาะ เป็นสัญญาณเปรียบเทียบ ไม่ใช่การรับประกันสำหรับ PDF บิลด์ API พรอมป์ต์ หรือโดเมนใดโดเมนหนึ่งโดยเฉพาะ
ควรใช้พรอมป์ต์เดียวหรือแบ่งเอกสารยาวออกเป็นส่วน ๆ
ใช้แผนผังแหล่งข้อมูลและคำถามที่เจาะจงเมื่อโครงสร้างสำคัญ ให้ข้อความที่ต้องเปรียบเทียบพร้อมใช้ร่วมกันในขั้นตอนการสังเคราะห์ และคงป้ายหน้าไว้เพื่อให้คุณตรวจสอบคำตอบได้
ควรตรวจสอบการอ้างอิงจากสรุปที่สร้างโดย AI อย่างไร
เปิดแต่ละหน้าที่อ้างถึงในไฟล์ต้นฉบับ ตรวจคำพูดและข้อความรอบข้าง และยืนยันว่าข้อความตอนนั้นสนับสนุนข้อกล่าวอ้างเฉพาะนั้น ตรวจหัวตารางและเชิงอรรถรวมทั้งประโยคที่อ้างถึงด้วย
โทเคนอินพุตและเอาต์พุตมีผลต่อค่าใช้จ่ายอย่างไร
โทเคนอินพุตครอบคลุมเอกสาร คำสั่ง และคำถาม โทเคนเอาต์พุตครอบคลุมคำตอบ พรอมป์ต์ที่ยาวขึ้น การเรียกหลายครั้ง และข้อความที่ซ้ำกันเพิ่มการใช้งาน; ใช้จำนวนโทเคนที่คิดค่าบริการและตารางราคาปัจจุบันของผู้ให้บริการในการประมาณ


