

นักพัฒนามองเห็น "1M tokens" แล้วเตรียมส่งทั้งรีโพซิทอรี ประวัติ issue และรายงานการออกแบบยาว ๆ ในคำขอเดียว รายละเอียดสำคัญใน หน้าต่างบริบท 1M ของ Gemini 4 Argon คือ 1,048,576 โทเคนถูกใช้ร่วมกันโดยอินพุต การคิด และเอาต์พุต ไม่ใช่หนึ่งล้านโทเคนอินพุตบวกอีกหนึ่งล้านสำหรับคำตอบ Google ระบุเพดานเอาต์พุตแบบซิงโครนัสเริ่มต้นที่ 65,536 โทเคน ขณะที่ long decode สามารถขยายการสร้างได้ถึงความจุร่วมที่เหลืออยู่ ข้อกำหนดโมเดลของ Google ให้ขีดจำกัดไว้ คู่มือนี้เปลี่ยนสิ่งเหล่านั้นให้เป็นงบประมาณและการตัดสินใจเกี่ยวกับ long context, retrieval และ chunking
ประเด็นสำคัญ
- คอนเท็กซ์ 1,048,576 โทเคนเป็นงบประมาณรวมของอินพุต การคิด และเอาต์พุต
- เอาต์พุตแบบซิงโครนัสเริ่มต้นถูกจำกัดที่ 65,536 โทเคน; long decode ไม่ได้เพิ่ม context ให้มากขึ้น
- ใช้ long context เมื่อความสัมพันธ์ข้ามชุดต้นทางที่รู้จักมีความสำคัญ; ใช้ retrieval หรือ chunking เมื่อไม่จำเป็น
หน้าต่างบริบท 1M ของ Gemini 4 Argon หมายความว่าอะไร?
งบประมาณ 1,048,576 โทเคนถูกใช้ร่วมกัน
หน้าต่างบริบทคือขีดจำกัดโทเคนที่ใช้ได้สำหรับคำขอ สำหรับ Argon Google ระบุยอดรวมแบบรวมศูนย์ไว้ที่ 1,048,576 พรอมป์ต์ วัสดุต้นทางที่แนบ โทเคนการคิด และคำตอบที่สร้างขึ้นต่างใช้จากโควตานี้ มันอธิบายความจุ ไม่ใช่คำสัญญาว่าทุกรายละเอียดจะถูกเรียกคืนหรือให้เหตุผลได้ง่ายพอ ๆ กัน
ถ้าคำขอมีโทเคนต้นทาง 900,000 โทเคน จะเหลืออย่างมาก 148,576 โทเคนสำหรับการคิดและเอาต์พุต ก่อนข้อจำกัดเฉพาะอินเทอร์เฟซ แอปพลิเคชันที่สมมติว่าสามารถขอคำตอบ 200,000 โทเคนได้ก็ใช้เกินงบประมาณเดียวกันไปแล้ว
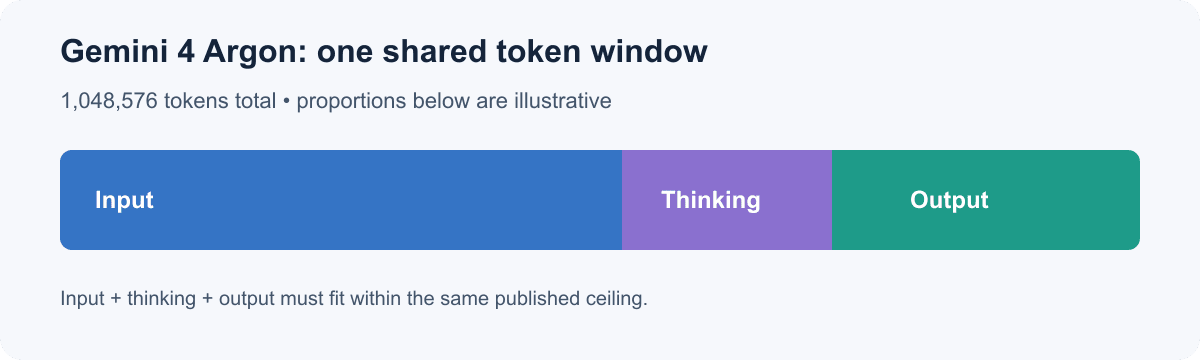
หน้าต่างที่ประกาศไว้เป็นเพดานร่วมเพียงหนึ่งเดียว ขนาดของแต่ละส่วนเป็นแนวคิด ไม่ใช่การจัดสรรแบบตายตัว
อินพุต การคิด และเอาต์พุตใช้หน้าต่างเดียวกัน
สมการวางแผนที่มีประโยชน์คือ:
input tokens + thinking tokens + output tokens <= 1,048,576
นี่คือการตรวจสอบงบประมาณ ไม่ใช่การอ้างว่านักพัฒนาสามารถกำหนดจำนวนโทเคนการคิดที่แน่นอนสำหรับทุกการเรียกได้ Google ระบุการตั้งค่าการคิดเป็น low, medium และ high; การใช้ภายในอาจแตกต่างกันตามงานและการตั้งค่า ควรสำรองพื้นที่สำหรับการให้เหตุผลแทนที่จะถือว่าส่วนที่เหลือตามทฤษฎีเป็นความจุคำตอบที่รับประกันได้
Argon รับอินพุตข้อความ รูปภาพ วิดีโอ เสียง และ PDF โดยเอาต์พุตเป็นข้อความ การนับสื่อไม่เทียบเท่าข้อความล้วน ดังนั้นจำนวนไฟล์หรือจำนวนหน้าจึงไม่อาจทำนายจำนวนโทเคนทั้งหมดได้อย่างน่าเชื่อถือ ตรวจสอบเมทาดาทาการใช้งานจากคำขอตัวอย่าง
หน้าต่างบริบท vs. ขีดจำกัดเอาต์พุต: ความแตกต่างสำคัญ
เพดานเอาต์พุตเริ่มต้น
หน้าโมเดลระบุเอาต์พุตสูงสุด 65,536 โทเคนสำหรับการสร้างแบบซิงโครนัสเริ่มต้น ประมาณหนึ่งในสิบหกของหน้าต่างทั้งหมด คำขออาจพอดีกับขีดจำกัด context โดยรวมแต่ยังเกินเพดานเอาต์พุตที่ใช้งานอยู่
สำหรับหลายแอปพลิเคชัน ค่าเริ่มต้นนี้เพียงพอ การรีวิวรีโพซิทอรีหรือการสังเคราะห์เอกสารมักต้องคำตอบที่โฟกัส ไม่ใช่คำตอบยาวเท่าชุดต้นทาง เอาต์พุตที่มีขอบเขตจำกัดตรวจสอบ จัดเก็บ และส่งต่อไปยังขั้นตอนอื่นได้ง่ายกว่า
long decode เปลี่ยนอะไร
long decode รองรับการสร้างที่ยาวขึ้นมาก สูงสุด 1,048,576 โทเคนตามข้อกำหนดโมเดล แต่ไม่ได้ขยายหน้าต่างทั้งหมด ถ้าพรอมป์ต์ใช้พื้นที่ส่วนใหญ่ไปแล้ว จะเหลือความจุสำหรับการคิดและเอาต์พุตน้อยลง เส้นทาง API, SDK, การตั้งค่าคำขอ และการจัดการการตอบกลับก็มีผลเช่นกัน ดังนั้นตรวจสอบคำแนะนำการผสานรวมปัจจุบันก่อนพึ่งพาการตอบกลับแบบยาวในโปรดักชัน
ใช้ long decode เฉพาะเมื่อผลลัพธ์ที่ส่งมอบจำเป็นต้องใช้เนื้อหาที่สร้างขึ้นอย่างมากจริง ๆ เช่น การแปลงโครงสร้างขนาดใหญ่ที่ส่งคืนในครั้งเดียว หากคำตอบสามารถแบ่งเป็นส่วนที่ตรวจสอบได้ การสร้างแบบเป็นขั้นตอนจะทำให้ตรวจพบและกู้คืนผลลัพธ์ที่ไม่สมบูรณ์ได้ง่ายขึ้น
วิธีจัดงบโทเคนอินพุต การคิด และเอาต์พุต
เริ่มจากผลลัพธ์ที่ต้องส่งมอบ จากนั้นประเมินโทเคนต้นทางโดยใช้เส้นทางการนับของโมเดลที่เลือกหากมี รวมการนับคำสั่ง ผลลัพธ์จากเครื่องมือ ข้อความสคีมา และประวัติการสนทนาด้วย สำรองส่วนเผื่อไว้สำหรับการคิดและความคลาดเคลื่อนจากการประเมิน แทนที่จะใช้ส่วนที่เหลือตามทฤษฎีจนหมด
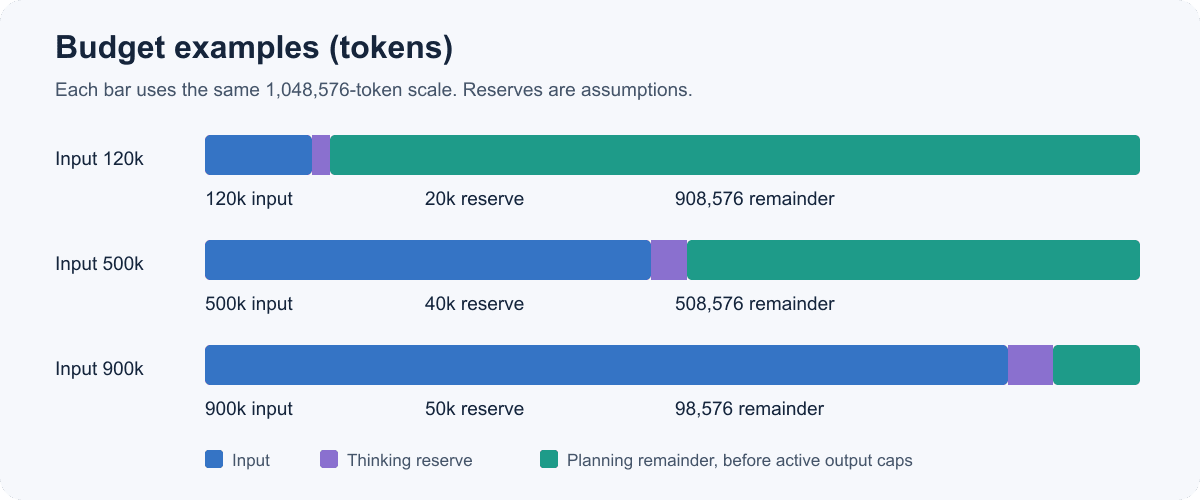
ตัวเลขด้านล่างเป็นตัวอย่างการคำนวณ ไม่ใช่การใช้เหตุผลคงที่ "Planning remainder" คือยอดรวมหลังหักอินพุตที่สมมติและโควตาการคิดที่สำรองไว้ ขีดจำกัดบริการจริงยังคงมีผล
| อินพุตที่สมมติ | การสำรองสำหรับการคิด | ส่วนที่เหลือสำหรับวางแผนเอาต์พุต | ตัวอย่าง |
|---|---|---|---|
| 120,000 | 20,000 | 908,576 | คู่มือหลายเล่ม การสังเคราะห์แบบกระชับ |
| 500,000 | 40,000 | 508,576 | รีวิวโค้ดเบสพร้อมการอ้างอิงไฟล์ |
| 900,000 | 50,000 | 98,576 | เปรียบเทียบเอกสารเก็บถาวรพร้อมคำตอบที่มีขอบเขต |
การคำนวณเชิงตัวอย่างจากเพดาน 1,048,576 โทเคน; การสำรองเป็นสมมติฐานสำหรับการวางแผน
ใช้เช็กลิสต์การวางแผนคำขอนี้:
- อินพุต: โทเคนต้นทางและพรอมป์ต์โดยประมาณ
- การคิด: สำรองความจุตามความซับซ้อนของงานและการตั้งค่าที่รองรับ
- เอาต์พุต: เลือกเพดานที่พอดีกับผลลัพธ์ที่ต้องส่งมอบ
- ตรวจสอบ: รวมสามจำนวนและเผื่อที่ว่างสำหรับความคลาดเคลื่อนจากการประเมิน
- เส้นทาง: ยืนยันว่า endpoint หรือ SDK ที่เลือก รองรับความยาวเอาต์พุตและพฤติกรรมการต่อเนื่อง
สำหรับการรีวิวโค้ดเบส 500,000 โทเคน ทีมอาจสำรอง 40,000 โทเคนสำหรับการคิดและตั้งเป้าคำตอบ 25,000 โทเคน แผนนั้นใช้ 565,000 โทเคนบนกระดาษ และเหลือพื้นที่เผื่อสำหรับการประเมินที่ไม่สมบูรณ์หรือคำสั่งเพิ่มเติม ทีมยังควรตรวจสอบการใช้งานจริงและขีดจำกัดการสร้างที่ตั้งค่าไว้ การสำรองเป็นเครื่องมือวางแผน ไม่ใช่การทำนายการให้เหตุผลภายใน
ก่อนรันแบบแบตช์ ให้สุ่มตัวอย่างคำขอมากกว่าหนึ่งประเภท หน้าเอกสารสั้น โมดูลที่เน้นโค้ด และ PDF ที่มีตารางอาจให้จำนวนโทเคนต่างกันแม้ขนาดไฟล์ดูใกล้เคียงกัน นับอินพุตที่เป็นตัวแทน แล้วเปรียบเทียบการประเมินกับการใช้งานที่ API ส่งคืน หากการรายงานการคิดหรือเอาต์พุตจริงของโมเดลแตกต่างจากสมมติฐานของคุณ ให้อัปเดตการสำรองและเพดานก่อนเพิ่มขนาดแบตช์ ขั้นตอนปรับเทียบเล็ก ๆ นี้ช่วยให้เวิร์กโฟลว์ long-context อยู่ในขอบเขตโทเคนและงบประมาณ
อะไรใส่ได้ในหนึ่งล้านโทเคน?
เอกสาร โค้ด และสื่อแบบหลายรูปแบบ
หนึ่งล้านโทเคนทำให้การวิเคราะห์แบบครั้งเดียวเป็นไปได้สำหรับชุดคู่มือ สัญญาหลายฉบับ ต้นไม้ซอร์สขนาดใหญ่ หรือบทถอดเสียงยาวพร้อมบันทึก Google เคยใช้ตัวอย่างคร่าว ๆ เช่น ข้อความประมาณ 1,500 หน้า หรือโค้ด 30,000 บรรทัด ให้ถือสิ่งเหล่านี้เป็นตัวอย่างขนาด ไม่ใช่การรับประกัน เลย์เอาต์ ความหนาแน่นของโค้ด ภาษา การจัดรูปแบบ และการแยกโทเคนล้วนมีผลต่อจำนวน
สำหรับงานรีโพซิทอรี ให้รวมไฟล์บิลด์ โค้ดที่สร้างขึ้น คอมเมนต์ เมทาดาทา dependency การทดสอบ และบริบท issue ที่เกี่ยวข้องไว้ในการประเมิน จากนั้นถามว่างานต้องการทั้งหมดหรือไม่ การรีวิวสถาปัตยกรรมข้ามโมดูลอาจได้ประโยชน์จากชุดต้นทางที่กว้าง ส่วนคำถามเกี่ยวกับข้อความ error หนึ่งข้อความอาจไม่จำเป็น
อินพุตแบบหลายรูปแบบก็ทำให้การประเมินซับซ้อนขึ้น ระยะเวลาวิดีโอ การสุ่มเฟรม เสียง ความละเอียด และการจัดการผ่าน API อาจส่งผลต่อการใช้งานและหลักฐานที่โมเดลเห็น สำหรับคำถามแคบ ๆ ให้รวมเฉพาะสื่อที่เกี่ยวข้อง และตรวจสอบการใช้งานจากคำขอตัวอย่างก่อนขยายขนาด
จำนวนโทเคนไม่ใช่จำนวนหน้า
โทเคนเป็นหน่วยประมวลผลของโมเดล ไม่ใช่คำ อักขระ หน้า หรือบรรทัด ตัวระบุ ตาราง โค้ดต้นทาง และงานเขียนที่ไม่ใช่ภาษาอังกฤษอาจแยกโทเคนต่างจากข้อความทั่วไป การประเมินเป็นหน้าจึงบอกไม่ได้ว่าคอลเลกชันเฉพาะของคุณพอดีหรือไม่
ความจุก็แตกต่างจากคุณภาพ การใส่ชุดต้นทางได้ไม่พิสูจน์ว่าโมเดลจะพบข้อยกเว้นที่ซ่อนอยู่ทุกจุด รักษา dependency ทุกอย่าง หรือแก้ไขข้อความที่ขัดแย้งกันได้อย่างถูกต้อง ข้อกำหนดกำหนดขีดจำกัด ไม่ใช่การเรียกคืนอย่างครบถ้วนหรือคะแนนความแม่นยำเฉพาะงาน สำหรับข้อสรุปที่มีผลสำคัญ ให้ขอตำแหน่งต้นทางและตรวจสอบข้อกล่าวอ้างสำคัญกับต้นฉบับ
เมื่อหน้าต่าง 1M ช่วย และเมื่อไม่ช่วย
long context มีประโยชน์ที่สุดเมื่อคำตอบขึ้นอยู่กับความสัมพันธ์ที่กระจายอยู่ทั่ววัสดุซึ่งคำค้นหาง่าย ๆ อาจเรียกคืนไม่ได้ มันน่าสนใจน้อยกว่าสำหรับคำถามแคบ ๆ ที่ถามซ้ำข้ามคลังข้อมูลที่เปลี่ยนแปลง ซึ่ง retrieval สามารถเลือกชุดหลักฐานที่เล็กกว่าได้ สิ่งเหล่านี้เป็นการแลกเปลี่ยนในเวิร์กโฟลว์ ไม่ใช่การจัดอันดับความแม่นยำสากล
| แนวทาง | พิจารณาใช้เมื่อ | ข้อแลกเปลี่ยน |
|---|---|---|
| คำขอแบบ long-context | การวิเคราะห์แบบครั้งเดียวต้องอาศัยความสัมพันธ์ข้ามชุดต้นทางที่รู้จัก | อินพุตขนาดใหญ่อาจเพิ่มต้นทุนและเวลาแฝง; ตรวจสอบความครอบคลุม |
| Retrieval | ผู้ใช้ถามคำถามซ้ำ ๆ ข้ามคลังข้อมูลที่เปลี่ยนแปลง | การทำดัชนีและ retrieval กำหนดว่าหลักฐานใดไปถึงโมเดล |
| Chunking | เอกสารสามารถประมวลผลเป็นหน่วยอิสระหรือเป็นขั้นตอนได้ | ความสัมพันธ์ข้ามชังก์ต้องได้รับการกระทบยอด |
| Hybrid | คุณต้องการภาพรวมกว้าง ๆ ตามด้วยการตรวจหลักฐานแบบเจาะจง | ต้องมีการจัดการ orchestration และสถานะมากขึ้น |
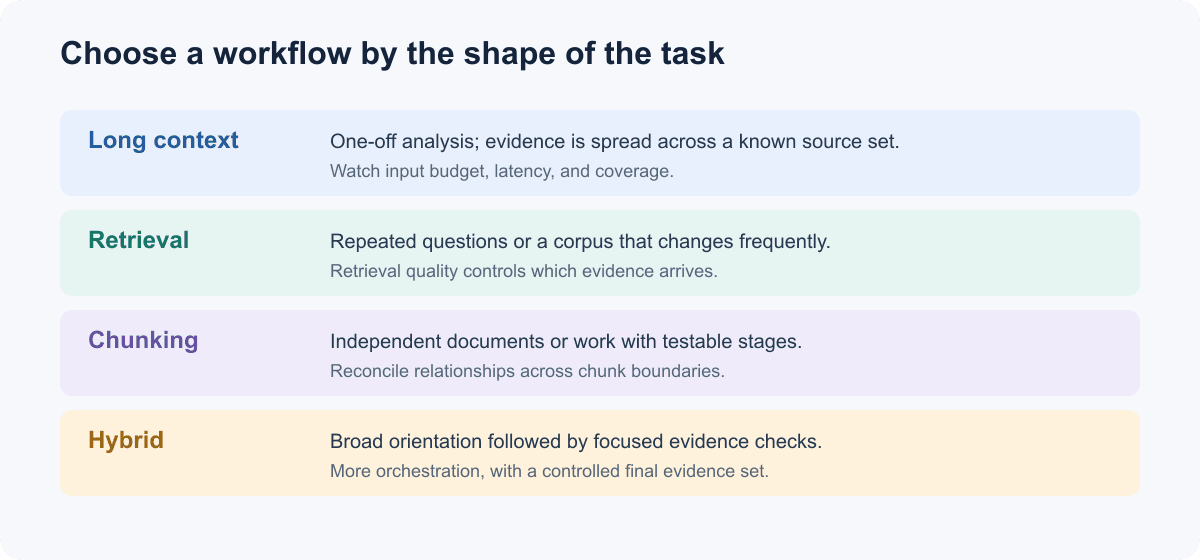 เลือกจากรูปร่างของงานและรูปแบบคำถาม จากนั้นตรวจสอบกับอินพุตที่เป็นตัวแทน
พิจารณา long context สำหรับการเปรียบเทียบนโยบายที่มีข้อกำหนดส่งผลต่อกัน รีวิวการเปลี่ยนแปลงข้ามโมดูลซอฟต์แวร์จำนวนมาก หรือสังเคราะห์เอกสารที่รายละเอียดในแหล่งหนึ่งเปลี่ยนการตีความของอีกแหล่ง Retrieval เหมาะกับคำถามสนับสนุนที่ถามซ้ำกับฐานความรู้ที่เติบโต Chunking ใช้ได้เมื่อหน่วยต้นทางเป็นอิสระหรือแต่ละขั้นตอนมีเอาต์พุตที่ทดสอบได้ เวิร์กโฟลว์แบบ hybrid สามารถทำแผนที่คอลเลกชันก่อน แล้วจึง retrieve และตรวจสอบข้อความสำหรับคำตอบสุดท้าย
ประเมินตัวเลือกกับคำถามตัวแทนชุดเดียวกัน ติดตามว่าหลักฐานที่จำเป็นถูกรวมไว้หรือไม่ การอ้างอิงชี้ไปยังข้อความที่ถูกต้องหรือไม่ การใช้โทเคน เวลาตอบสนอง และความพยายามกู้คืนหลังคำตอบที่ไม่สมบูรณ์ สิ่งนี้ให้หลักฐานแก่ทีมสำหรับภาระงานของตน แทนที่จะสมมติว่าหน้าต่างที่ใหญ่ขึ้นจะปรับปรุงโดยอัตโนมัติ
การใช้ Gemini 4 Argon สำหรับงาน long-context
ยืนยัน model ID และเส้นทางคำขอ
Google ระบุ Gemini API model ID เป็น gemini-4-argon ยืนยันว่าเปิดใช้งานสำหรับบัญชีของคุณและ API surface ที่แน่นอนรองรับฟีเจอร์ที่คุณต้องการ ชื่อโมเดลเดียวกันไม่ได้การันตีว่า proxy, SDK, คอนโซล หรือไคลเอนต์ทุกตัวจะเปิดเผยขีดจำกัดหรือพฤติกรรม long-decode เหมือนกัน
ก่อนโปรดักชัน ตรวจสอบ:
- model ID และความพร้อมใช้งานสำหรับบัญชีหรือภูมิภาคของคุณ
- เพดานเอาต์พุตแบบซิงโครนัส และวิธีที่ long decode ถูกขอหรือส่งคืน
- ว่า SDK จัดการการต่อเนื่องหรือไม่ และรายงานการตอบกลับบางส่วนหรือล้มเหลวอย่างไร
- การตั้งค่าการคิด เครื่องมือ แคชชิง และ modalities ที่รองรับสำหรับ API ที่เลือก
- ฟิลด์การใช้งานอินพุตและเอาต์พุตจริงของคำขอ
คู่มือ long-context ของ Google อธิบายงบประมาณแบบรวม คำแนะนำ SDK และ API ของอาจเปลี่ยนแปลงได้ ดังนั้นให้ปักหมุดเวอร์ชัน SDK ที่รองรับ ตรวจสอบตัวอย่างปัจจุบัน และทดสอบการผสานรวมการขนส่งและการจัดการการตอบกลับชุดเดียวกับที่วางแผนไว้สำหรับโปรดักชัน อย่าคัดลอกชื่อพารามิเตอร์จาก integration ของโมเดลรุ่นเก่าโดยไม่ตรวจสอบว่ายังใช้ได้
ทำให้สัญญาเอาต์พุตเล็กกว่าชุดต้นทาง
ให้โมเดลทำงานและรูปแบบการตอบกลับที่มีขอบเขต สำหรับการตรวจสอบรีโพซิทอรี ให้ขอผลการตรวจค้นจัดกลุ่มตามความรุนแรงพร้อมพาธไฟล์และการอ้างอิงบรรทัด และระบุว่าจะรวมสมมติฐานหรือเฉพาะข้อบกพร่องที่ยืนยันแล้ว สำหรับการเปรียบเทียบสัญญา ให้ระบุชื่อข้อกำหนดและขอตัวระบุส่วนหรือข้อความสนับสนุนสั้น ๆ วิธีนี้ตรวจสอบง่ายกว่า "วิเคราะห์ทุกอย่าง" สำหรับการตอบกลับขนาดใหญ่ ให้วางแผนสำหรับการต่อเนื่องและการทำงานให้เสร็จบางส่วน เก็บตัวระบุและชังก์การตอบกลับไว้เมื่อ SDK เปิดเผยสิ่งเหล่านั้น ตรวจสอบเอาต์พุตที่มีโครงสร้างก่อนใช้ปลายทาง และลองใหม่เฉพาะส่วนที่ล้มเหลวเมื่อทำได้ สิ่งเหล่านี้เป็นมาตรการป้องกันที่ต้องนำไปใช้และตรวจสอบ ไม่ใช่การอ้างว่า SDK ทุกตัวจัดการการขัดจังหวะเหมือนกัน
ราคาและการเข้าถึง: สิ่งที่ต้องตรวจสอบก่อนรัน
ประกาศของ Google ปัจจุบันระบุอัตราเริ่มต้นที่ $2 ต่อหนึ่งล้านโทเคนอินพุต และ $10 ต่อหนึ่งล้านโทเคนเอาต์พุต ถึงวันที่ 30 พฤศจิกายน 2026 ตามด้วยอัตราที่ระบุไว้ที่ $4 และ $20 ต่อหนึ่งล้าน ข้อมูลนี้มีความอ่อนไหวต่อเวลา: ตรวจสอบ ประกาศอย่างเป็นทางการของ Gemini 4 Argon อีกครั้งก่อนเผยแพร่หรือคาดการณ์ค่าใช้จ่าย ประเมินอินพุตและเอาต์พุตแยกกัน เพราะงานที่เน้นพรอมป์ต์และงานที่เน้นการสร้างมีโปรไฟล์ต้นทุนต่างกัน
ความพร้อมใช้งานของ Argon ผ่าน Atlas Cloud ไม่ได้รับการยืนยันในหน้าไดเรกทอรีที่ตรวจสอบสำหรับบทความนี้ แค็ตตาล็อกโมเดล Atlas Gemini แสดงโมเดล Gemini และรายละเอียดการเข้าถึงที่ระบุไว้ในขณะนี้; ไม่ได้ยืนยันว่า Argon พร้อมใช้งาน ตรวจสอบหน้ารายละเอียดเฉพาะโมเดล โปรโตคอล และราคาก่อนกำหนดเส้นทางคำขอหรือเปรียบเทียบต้นทุน
เริ่มด้วยคำขอที่เป็นตัวแทนและบันทึกเวอร์ชันโมเดลและ SDK การใช้โทเคน เวลาแฝง ข้อผิดพลาด และการตรวจสอบคุณภาพเฉพาะงาน ทบทวนงบประมาณและทางเลือก retrieval เมื่อชุดต้นทางหรือรูปแบบคำถามเปลี่ยน หน้าต่างบริบท 1M ของ Gemini 4 Argon มีประโยชน์เมื่อความกว้างของมันแก้ปัญหาข้ามแหล่งจริง และคำขอของคุณมีงบประมาณและแผนการตรวจสอบที่ชัดเจน
คำถามที่พบบ่อย
หน้าต่าง 1M ของ Gemini 4 Argon ใช้ร่วมกันโดยอินพุตและเอาต์พุตหรือไม่?
ใช่ Google กำหนดหน้าต่างเดียว 1,048,576 โทเคนที่ใช้ร่วมกันทั่วอินพุต การคิด และเอาต์พุต จำนวนที่เหลือสำหรับคำตอบขึ้นอยู่กับคำขอและขีดจำกัดอินเทอร์เฟซที่เกี่ยวข้อง
ขีดจำกัดเอาต์พุตเริ่มต้นของ Gemini 4 Argon คือเท่าไร?
ข้อกำหนดระบุ 65,536 โทเคนสำหรับเอาต์พุตแบบซิงโครนัสเริ่มต้น Long decode สามารถรองรับการสร้างที่ใหญ่ขึ้นได้ ขึ้นอยู่กับความจุร่วมที่เหลือและเส้นทาง API
Gemini 4 Argon สร้าง 1M โทเคนในหนึ่งการตอบกลับได้หรือไม่?
หน้าโมเดลระบุ long decode สูงสุด 1,048,576 โทเคนเอาต์พุต แต่นี่เป็นความสามารถสูงสุด ไม่ใช่การรับประกันว่าคำขอที่มีอินพุตจะส่งคืนหนึ่งล้านโทเคนได้ด้วย อินพุตและการคิดใช้หน้าต่างรวมเดียวกัน
หน้าต่างบริบท 1M หมายความว่าจะเรียกคืนทุกรายละเอียดได้อย่างแม่นยำหรือไม่?
ไม่ มันอธิบายงบประมาณโทเคนสูงสุด ไม่ใช่ retrieval หรือการให้เหตุผลที่สมบูรณ์แบบ กำหนดให้มีการอ้างอิงหลักฐานและทดสอบ edge case ที่รู้จักจากวัสดุของคุณเอง
ปัจจุบัน Gemini 4 Argon พร้อมใช้งานผ่าน Atlas Cloud หรือไม่?
ฉันไม่สามารถยืนยันรายการโมเดลหรือหน้ารายละเอียดเฉพาะ Argon ในแค็ตตาล็อก Atlas Cloud ที่ตรวจสอบสำหรับบทความนี้ได้ ตรวจสอบไดเรกทอรีปัจจุบันก่อนสมมติว่ามีการรองรับ; ลิงก์แค็ตตาล็อก Gemini ด้านบนไม่ได้ยืนยันความพร้อมใช้งานของ Argon ด้วยตัวเอง


