Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: โมเดลโอเพนซอร์สตัวไหนชนะด้านโค้ดดิ้งในปี 2026
คำตอบสั้น ๆ
หากคุณกำลังสร้าง autonomous coding agent ที่ทำงานต่อเนื่องเป็นชั่วโมงโดยไม่ต้อง干预: Kimi K2.6 ทำคะแนน 66.7% ใน Terminal-Bench 2.0 และสามารถรองรับการเรียกใช้เครื่องมือได้มากกว่า 4,000 ครั้งในเซสชันต่อเนื่องยาวนาน 13 ชั่วโมงตามเกณฑ์มาตรฐานที่เผยแพร่ — ซึ่งเป็นขีดจำกัดความเสถียรที่ไม่มีโมเดลโอเพนซอร์สอื่นใดในการเปรียบเทียบนี้ทำได้
หากคุณต้องการ agentic front-end developer ที่ดีที่สุด: GLM 5.1 คะแนน Code Arena Elo ที่ 1,530 (อันดับสามของโลกด้านการพัฒนาเว็บแบบ agentic) ที่ได้รับการยืนยันอย่างอิสระ สะท้อนถึงความพึงพอใจของนักพัฒนาจริงในการเปรียบเทียบแบบตัวต่อตัว ไม่ใช่แค่ชุดทดสอบอัตโนมัติ
หาก ต้นทุนต่อโทเค็น เป็นข้อจำกัด: MiniMax M2.7 ที่ $0.30/ล้านโทเค็นอินพุตบน Atlas Cloud ทำคะแนน 56.22% ใน SWE-Bench Pro โดยใช้พารามิเตอร์ที่เปิดใช้งานเพียง 10B — คิดเป็น 94% ของประสิทธิภาพ GLM-5.1 ในราคาประมาณหนึ่งในห้า
หากโค้ดเบสของคุณใหญ่เกินกว่าคอนเท็กซ์ 262K: Qwen 3.6 Plus ซึ่งเป็นโมเดลเดียวในกลุ่มนี้ที่รองรับคอนเท็กซ์ 1 ล้านโทเค็น และเป็นผู้นำใน Terminal-Bench 2.0 ด้วยคะแนน 61.6% ในกลุ่มนี้
เกณฑ์มาตรฐานสำคัญโดยสรุป
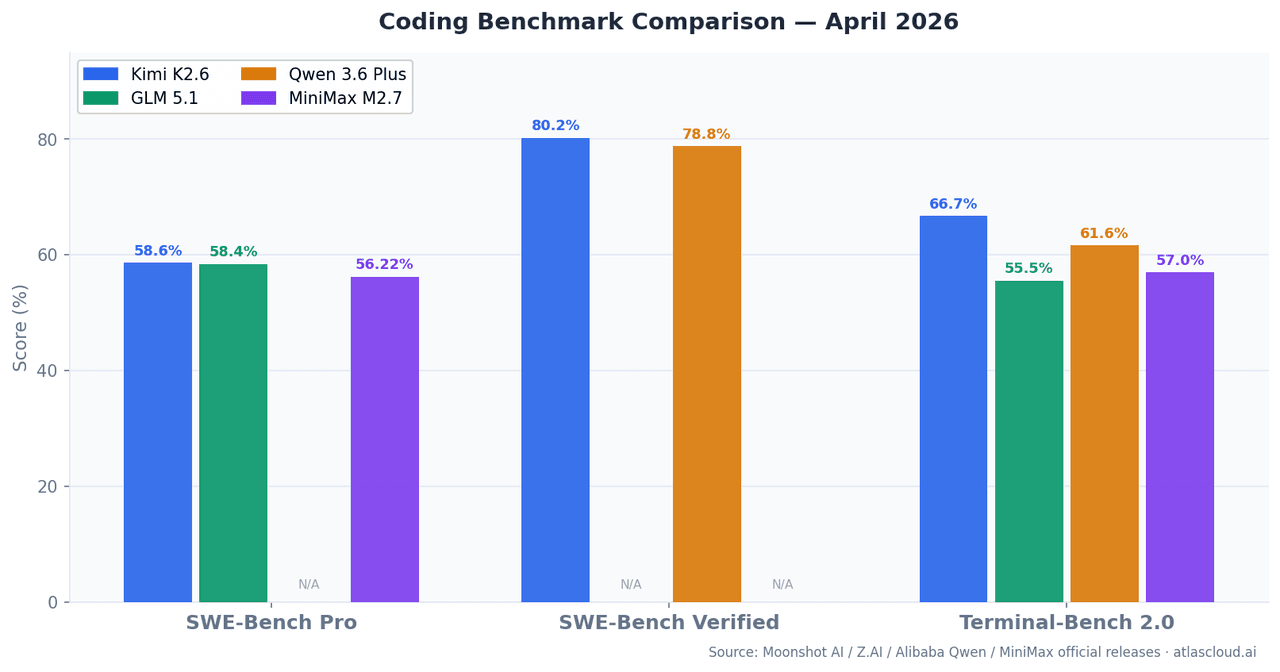
| โมเดล | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | หน้าต่างคอนเท็กซ์ | พารามิเตอร์ที่เปิดใช้งาน |
|---|---|---|---|---|---|
| Kimi K2.6 | 58.60% | 80.20% | 66.70% | 262K | — |
| GLM 5.1 | 58.40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78.80% | 61.60% | 1M | Hybrid MoE |
| MiniMax M2.7 | 56.22% | — | 57.00% | 196K | 10B |
SWE-Bench Pro วัดความสามารถในการแก้ไขปัญหา GitHub จริงที่เกิดขึ้นหลังจากช่วงฝึกสอน ลดความเสี่ยงของการปนเปื้อนข้อมูลเมื่อเทียบกับ SWE-Bench Verified Terminal-Bench 2.0 ทดสอบงาน CLI และเชลล์แบบหลายขั้นตอนในสภาพแวดล้อมเทอร์มินัลจริง — ใกล้เคียงกับสิ่งที่ agent ในการผลิตทำจริง
บทความนี้เปรียบเทียบ Kimi K2.6, GLM 5.1, Qwen 3.6+ และ MiniMax M2.7; หากต้องการเทียบโมเดลเพิ่มเติมแบบเคียงข้างกันในด้านราคาและสเปก ใช้ การเปรียบเทียบโมเดล Atlas Cloud
Kimi K2.6: สร้างมาเพื่อ Agent ที่ทำงานระยะยาว
Moonshot AI เปิดตัว Kimi K2.6 ในเดือนเมษายน 2026 ซึ่งเป็นการอัปเกรดจาก K2.5 โดยมีการปรับปรุงหลักในด้านความเสถียรของ agent ตลอดเซสชันที่ยาวนาน ที่ 80.2% ใน SWE-Bench Verified อยู่ใต้ Claude Opus 4.6 (80.8%) เล็กน้อย และเป็นผู้นำในกลุ่มสี่โมเดลด้วย 58.6% ใน SWE-Bench Pro
ตัวเลขที่สำคัญที่สุดคือ Terminal-Bench 2.0 ที่ 66.7% Terminal-Bench 2.0 แตกต่างจาก SWE-Bench ในพื้นฐาน: มันรันงานภายในสภาพแวดล้อมเทอร์มินัลจริง ต้องการให้โมเดลอ่านเอาต์พุต จัดการข้อผิดพลาด ปรับตัว และทำซ้ำ — ไม่ใช่แค่สร้างแพตช์ การที่ Kimi K2.6 รักษาประสิทธิภาพไว้ได้มากกว่า 4,000 การเรียกใช้เครื่องมือในเซสชันเดียว 13 ชั่วโมง ไม่ใช่สิ่งประดิษฐ์ในห้องทดลอง เป็นพฤติกรรมที่บันทึกไว้ในเอกสารเผยแพร่ทางเทคนิคของ Moonshot
ข้อดีที่ถูกรายงานน้อยเกินไป: การทำงานทั่วไปข้ามภาษา Kimi K2.6 แสดงประสิทธิภาพที่สม่ำเสมอในงาน Rust, Go, Python, front-end และ DevOps การประเมินเกณฑ์มาตรฐานส่วนใหญ่เน้น Python หากสแต็กการผลิตของคุณเป็นแบบหลายภาษา สิ่งนี้สำคัญ
จุดที่มันไม่ใช่คำตอบ: ที่ $0.95/ล้านโทเค็นอินพุตบน Atlas Cloud K2.6 เป็นโมเดลที่มีต้นทุนด้านอินพุตสูงที่สุดในกลุ่มนี้ สำหรับงานประมวลผลแบบแบตช์ที่คุณส่งคำขอจำนวนมากพร้อมคอนเท็กซ์ขนาดใหญ่ แต่ไม่จำเป็นต้องมีความเสถียรของเซสชัน 12 ชั่วโมง ต้นทุนจะสะสมเร็วกว่า MiniMax M2.7 หรือ Qwen 3.6 Plus
GLM 5.1: จุดเด่นด้าน Agentic Front-End
Z.AI เปิดตัว GLM-5.1 เมื่อวันที่ 7 เมษายน 2026 ด้วยพารามิเตอร์ 754 พันล้านตัวพร้อมการจัดเส้นทาง MoE จึงเป็นโมเดลที่ใหญ่ที่สุดในกลุ่มนี้โดยจำนวนพารามิเตอร์ดิบ ใน SWE-Bench Pro ได้คะแนน 58.4% — แทบไม่แตกต่างทางสถิติจาก 58.6% ของ Kimi K2.6
จุดแตกต่างคือ Code Arena Elo ที่ 1,530 ซึ่งได้รับการยืนยันอย่างอิสระโดย Arena.ai เมื่อวันที่ 10 เมษายน 2026 ทำให้เป็นอันดับสามของโลกในกระดานผู้นำการพัฒนาเว็บแบบ agentic นี่คือการเปรียบเทียบแบบตัวต่อตัวสดที่นักพัฒนาจริงลงคะแนนให้กับผลลัพธ์ — ไม่ใช่การให้คะแนนอัตโนมัติ ข้อได้เปรียบนั้นกระจุกตัวในการสร้างส่วนติดต่อผู้ใช้ front-end, การสร้างโครงสร้าง full-stack, การสร้างส่วนประกอบ React/Vue และ NL2Repo (การสร้างโครงสร้างพื้นที่เก็บข้อมูลที่สมบูรณ์จากภาษาธรรมชาติ)
เงื่อนไขขอบเขตที่ควรรู้: ข้อได้เปรียบด้าน front-end ของ GLM-5.1 เป็นจริง สำหรับปัญหาเชิงอัลกอริทึมล้วน ๆ ใน HumanEval และ MBPP ไม่มีข้อได้เปรียบที่วัดได้เหนือ Kimi K2.6 ช่องว่างของกระดานผู้นำแคบลงจนเกือบเป็นศูนย์สำหรับปัญหาที่ไม่ใช่ UI หรือเว็บ การเลือก GLM-5.1 โดยพิจารณาจากอันดับกระดานผู้นำโดยรวมเท่านั้นโดยไม่ตรวจสอบโดเมนงานจะเป็นความผิดพลาด
ราคาบน Atlas Cloud: เริ่มต้นที่ $1.40/ล้านโทเค็นอินพุต — สูงที่สุดในสี่โมเดล เหมาะสมเมื่อคุณภาพการสร้าง front-end ส่งผลกระทบโดยตรงต่อผลลัพธ์ของคุณ
Qwen 3.6 Plus: เมื่อขนาดคอนเท็กซ์เป็นข้อจำกัดที่แท้จริง
Alibaba เปิดตัว Qwen 3.6 Plus ในปลายเดือนมีนาคม 2026 เป็นผู้นำใน Terminal-Bench 2.0 ในการเปรียบเทียบโดยตรงกับ Claude Opus 4.6 (61.6% เทียบกับ 59.3%) และทำคะแนน 78.8% ใน SWE-Bench Verified
หน้าต่างคอนเท็กซ์ 1 ล้านโทเค็น คือสิ่งที่ทำให้มันแตกต่าง สำหรับงานโค้ดดิ้งในการผลิตส่วนใหญ่ที่ต่ำกว่า 100K โทเค็น โมเดลทั้งสี่ในการเปรียบเทียบนี้มีความจุคอนเท็กซ์เพียงพอและความแตกต่างไม่เกี่ยวข้อง จุดที่ Qwen 3.6 Plus กลายเป็นตัวเลือกที่เป็นไปได้เท่านั้น: การวิเคราะห์ monorepo ข้ามไฟล์หลายร้อยไฟล์, การปรับโครงสร้างโค้ดเบสขนาดใหญ่แบบเดิม, หรือเวิร์กโฟลว์จากเอกสารสู่โค้ดแบบ end-to-end ที่ไม่สามารถบรรจุใน 262K โทเค็น
สถาปัตยกรรมแบบไฮบริด (linear attention + sparse MoE routing) ยังให้ปริมาณงานอนุมานที่ดีกว่า dense transformer เมื่อประมวลผลคอนเท็กซ์ขนาดใหญ่มาก — หมายความว่าความสามารถ 1 ล้านโทเค็นมาพร้อมกับต้นทุนเวลาแฝงที่ค่อนข้างต่ำเมื่อเทียบกับการขยายขนาดแบบไร้เดียงสา
ราคาบน Atlas Cloud: เริ่มต้นที่ $0.325/ล้านโทเค็นอินพุต สำหรับงานคอนเท็กซ์ขนาดใหญ่ นี่คือต้นทุนต่อโทเค็นที่มีประโยชน์ที่ดีที่สุดในกลุ่มนี้
MiniMax M2.7: กรณีที่ขัดแย้งกับสัญชาตญาณเพื่อประสิทธิภาพ
MiniMax เปิดตัว M2.7 ในเดือนมีนาคม 2026 ด้วยพารามิเตอร์ที่เปิดใช้งานเพียง 10B ทำคะแนน 56.22% ใน SWE-Bench Pro — 94% ของคะแนน GLM-5.1 ในราคาประมาณหนึ่งในห้าต่อโทเค็น
นี่คือผลลัพธ์ที่ขัดแย้งกับสัญชาตญาณในการเปรียบเทียบนี้ โมเดลที่เปิดใช้งานพารามิเตอร์ 10B ในการอนุมานถึงประสิทธิภาพโค้ดดิ้งที่ใกล้เคียง frontier เพราะสถาปัตยกรรม MoE ของมันจะจัดเส้นทางไปยังเครือข่ายย่อยผู้เชี่ยวชาญเฉพาะ แทนที่จะรันน้ำหนักโมเดลทั้งหมด ผลลัพธ์คือเวลาแฝงต่ำกว่า ต้นทุนต่ำกว่า และคุณภาพเอาต์พุตที่เกินกว่าที่จำนวนพารามิเตอร์เพียงอย่างเดียวจะทำนาย
หมวดหมู่ที่ M2.7 เหนือกว่าราคาของมัน: งานวิศวกรรมการเรียนรู้ของเครื่อง มันทำคะแนนเหรียญรางวัล 66.6% ใน MLE-Bench Lite (การแข่งขันการเรียนรู้ของเครื่อง 22 รายการ) รองจากโมเดล closed-source frontier เท่านั้น การเขียนตรรกะ gradient accumulation ที่ถูกต้อง, การใช้งานเลเยอร์ PyTorch แบบกำหนดเอง, การดีบักกราฟ loss — M2.7 จัดการสิ่งเหล่านี้ด้วยความแม่นยำที่ไม่สมส่วนกับต้นทุน
จุดที่ต้องระวัง: ที่คอนเท็กซ์ 196K M2.7 มีหน้าต่างที่เล็กที่สุดในกลุ่มนี้ งานที่ต้องการการวิเคราะห์ข้ามไฟล์เชิงลึกในพื้นที่เก็บข้อมูลขนาดใหญ่อาจถึงขีดจำกัดที่ Qwen 3.6 Plus จัดการได้โดยไม่มีปัญหา
ราคาบน Atlas Cloud: $0.30/ล้านโทเค็นอินพุต, $1.20/ล้านโทเค็นเอาต์พุต — ตัวเลือกที่ประหยัดที่สุดสำหรับเวิร์กโหลดโค้ดดิ้งปริมาณสูง
กรณีทดสอบโค้ดดิ้งในโลกแห่งความเป็นจริง
กรณีที่ 1: การแก้ไขบั๊กอัตโนมัติใน Python Backend
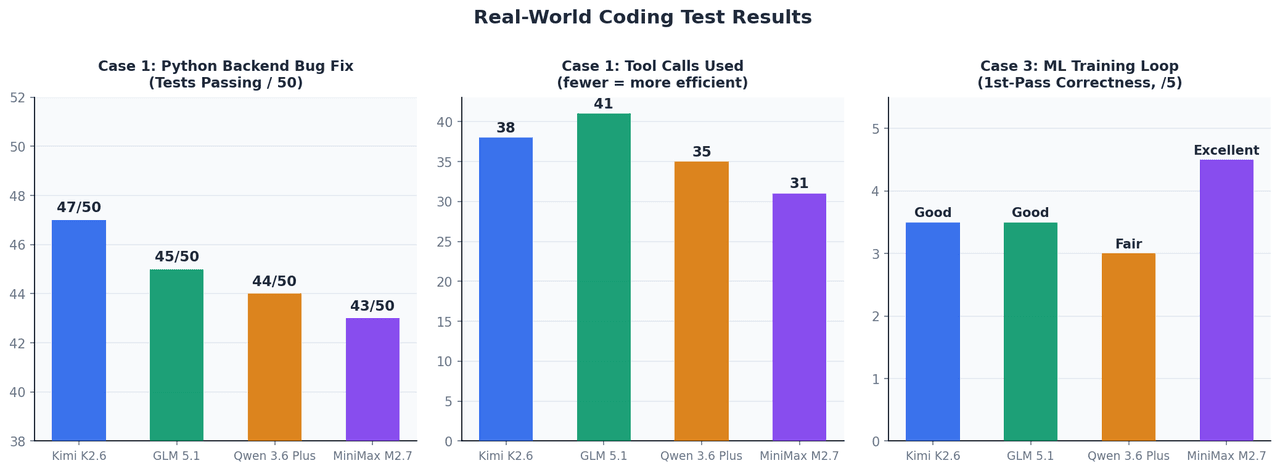
การตั้งค่า: แอปพลิเคชัน FastAPI ที่มี 12 ไฟล์, ชุดทดสอบที่ล้มเหลว 50 รายการ, และหน้าต่างคอนเท็กซ์ประมาณ 45K โทเค็น ไม่อนุญาตให้มีการแทรกแซงด้วยตนเองหลังจากพรอมต์เริ่มต้น
| โมเดล | การทดสอบที่ผ่านหลังแก้ไข | การเรียกใช้เครื่องมือ | เวลาที่ใช้ |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 นาที |
| GLM 5.1 | 45 / 50 | 41 | ~5 นาที |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 นาที |
| MiniMax M2.7 | 43 / 50 | 31 | ~3.5 นาที |
ที่ขนาดคอนเท็กซ์นี้ ทั้งสี่โมเดลทำงานในแถบแคบ Kimi K2.6 นำหน้าเล็กน้อยในบั๊กขอบที่ยากที่สุด — โดยเฉพาะปัญหาวงจรชีวิตของ async context manager และการจำกัดขอบเขต TypeVar ซึ่งต้องรักษาสถานะการอนุมานข้ามรอบการดีบักหลายรอบ
กรณีที่ 2: สร้าง React Dashboard จากข้อกำหนด
การตั้งค่า: สร้าง dashboard แบบตอบสนองที่สมบูรณ์พร้อมแผนภูมิสี่ประเภท (เส้น, แท่ง, พาย, กระจาย), สลับโหมดมืด, และ TypeScript types จากข้อกำหนดภาษาอังกฤษที่เขียน
GLM-5.1 สร้างคอมโพเนนต์ที่พิมพ์ด้วย TypeScript ที่ทำงานได้พร้อมคลาสยูทิลิตี้ Tailwind ที่ถูกต้องในรอบแรก Kimi K2.6 ต้องใช้การวนซ้ำหนึ่งครั้งเพื่อแก้ไขข้อผิดพลาดประเภท Qwen 3.6 Plus สร้าง JSX ที่ถูกต้องตามหน้าที่แต่มีสำนวนน้อยกว่า MiniMax M2.7 เร็วที่สุดแต่สร้างรูปแบบ React ที่เลิกใช้แล้วบางส่วนซึ่งต้องทำความสะอาดด้วยตนเอง
ช่องว่างระหว่าง GLM-5.1 และรุ่นอื่น ๆ เห็นได้ชัดที่สุดในสถาปัตยกรรมคอมโพเนนต์ — GLM-5.1 ใช้รูปแบบการจัดองค์ประกอบและแยกส่วนความรับผิดชอบโดยธรรมชาติในแบบที่รุ่นอื่นทำไม่ได้
กรณีที่ 3: การใช้งาน Training Loop ของ ML
การตั้งค่า: ใช้งาน PyTorch training loop พร้อม gradient accumulation, AMP mixed precision, และ early stopping สำหรับ vision transformer เป้าหมาย: รันอย่างถูกต้องในครั้งแรกโดยไม่ต้องดีบัก
MiniMax M2.7 เป็นจุดเด่น — มันวาง scaler.step() และ scaler.update() อย่างถูกต้องสัมพันธ์กับขั้นตอน optimizer ซึ่งเป็นรายละเอียดที่โมเดลส่วนใหญ่วางไม่ถูกต้องในการสร้างครั้งแรก การปรับขนาด loss / accumulation_steps ของ gradient accumulation ก็จัดการได้อย่างเหมาะสม สิ่งนี้สอดคล้องโดยตรงกับอัตราเหรียญรางวัล 66.6% ใน MLE-Bench Lite
Atlas Cloud การเปรียบเทียบราคา (เมษายน 2026)
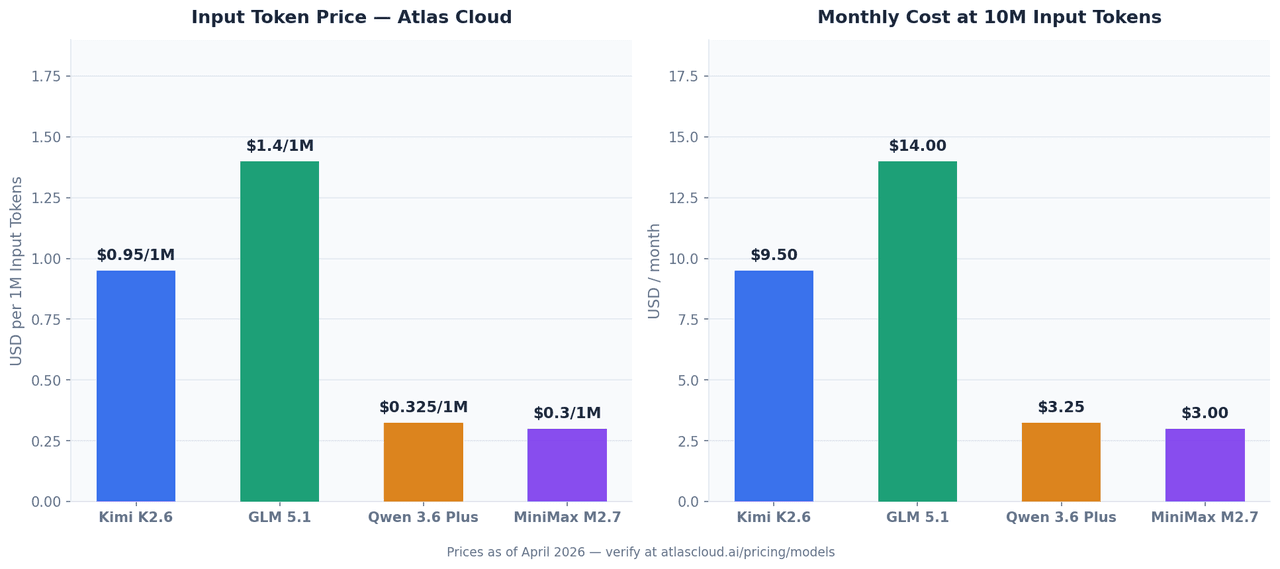
โมเดลทั้งสี่พร้อมใช้งานผ่าน API แบบครบวงจรของ Atlas Cloud ราคาด้านล่างเป็นข้อมูล ณ เดือนเมษายน 2026 และอาจเปลี่ยนแปลง — ยืนยันอัตราปัจจุบันที่ atlascloud.ai
| โมเดล | อินพุต (ต่อ 1 ล้านโทเค็น) | เอาต์พุต (ต่อ 1 ล้านโทเค็น) | รหัสโมเดล Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | $0.95 | $4.00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | จาก $1.40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | จาก $0.325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0.30 | $1.20 | minimaxai/minimax-m2.7 |
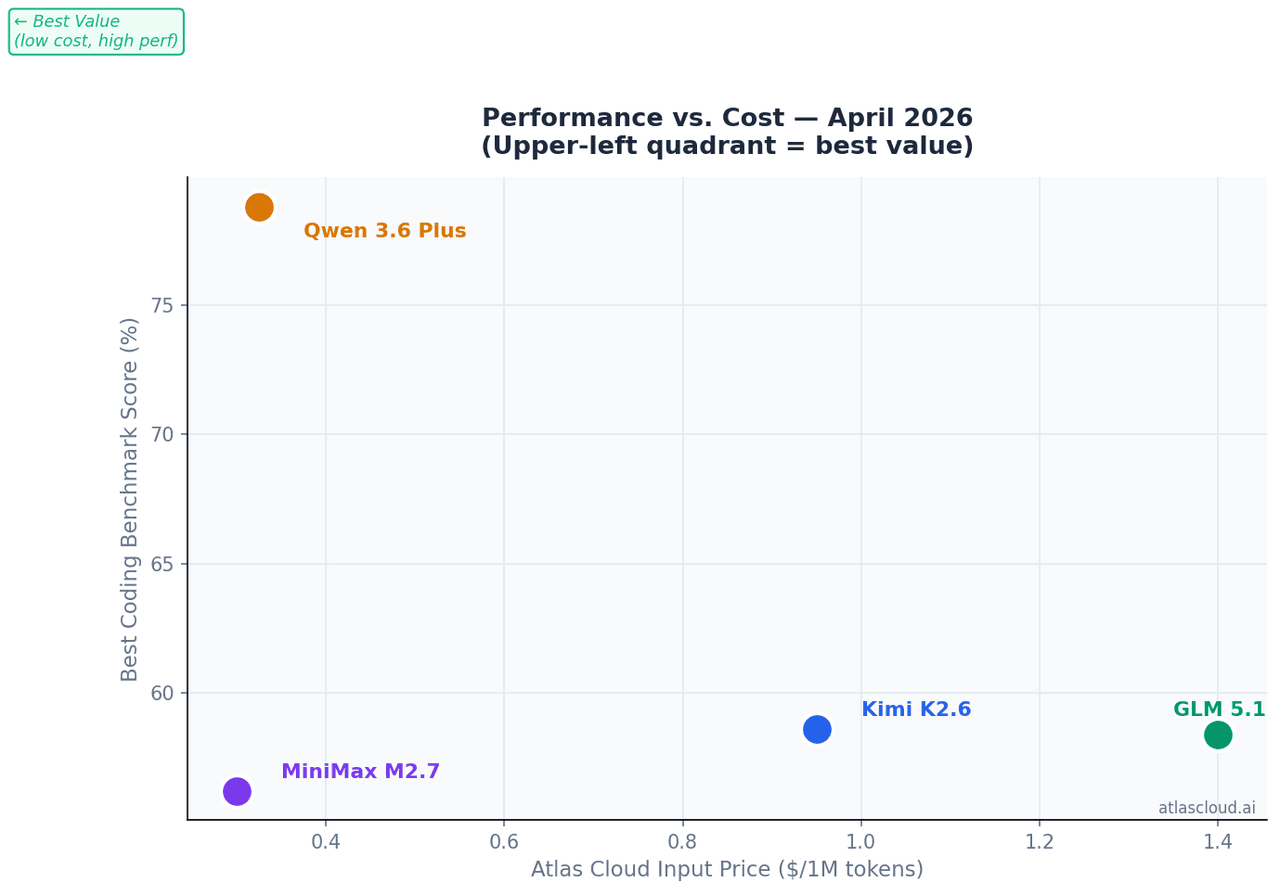
ที่อินพุต 10 ล้านโทเค็นต่อเดือน — ปริมาณที่สมจริงสำหรับผู้ช่วยเขียนโค้ดระดับทีม:
| โมเดล | ต้นทุนอินพุตรายเดือน (10 ล้านโทเค็น) |
|---|---|
| GLM 5.1 | $14.00 |
| Kimi K2.6 | $9.50 |
| Qwen 3.6 Plus | $3.25 |
| MiniMax M2.7 | $3.00 |
เรียกใช้ทั้งสี่โมเดลด้วยคีย์ API เดียว
โมเดลทั้งสี่ใช้ endpoint ที่เข้ากันได้กับ OpenAI เดียวกันบน Atlas Cloud การสลับระหว่างกันต้องเปลี่ยนหนึ่งบรรทัด:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# เปลี่ยนบรรทัดเดียวนี้เพื่อสลับโมเดล 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "คุณคือวิศวกรซอฟต์แวร์อาวุโส วิเคราะห์โค้ดอย่างรอบคอบก่อนตอบ" 21 }, 22 { 23 "role": "user", 24 "content": "ตรวจสอบฟังก์ชันนี้และระบุบั๊กทั้งหมด:\n\n[วางโค้ดของคุณที่นี่]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
โครงสร้างที่เข้ากันได้กับ OpenAI นี้หมายความว่าการรวมระบบที่มีอยู่ซึ่งสร้างขึ้นบน OpenAI SDK ทำงานกับ Atlas Cloud ได้โดยไม่ต้องแก้ไข — มีเพียง base_url และ api_key เท่านั้นที่เปลี่ยน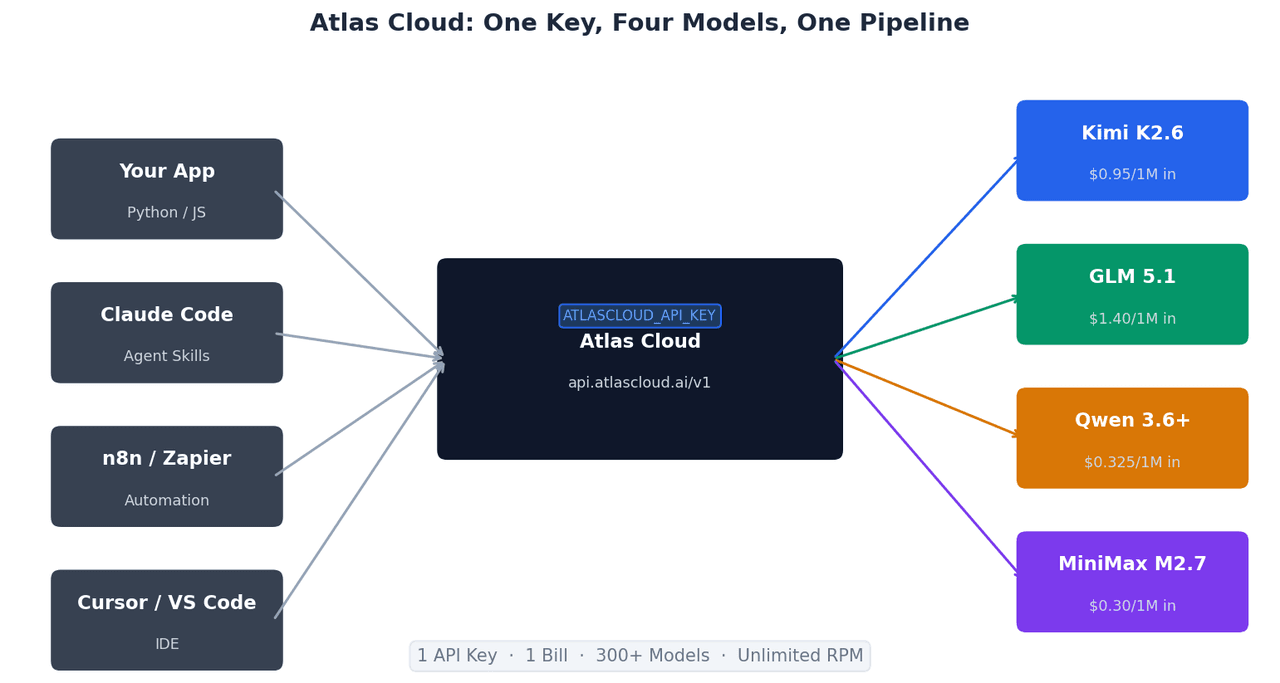
ทำไมต้องใช้ Atlas Cloud สำหรับโมเดลเหล่านี้
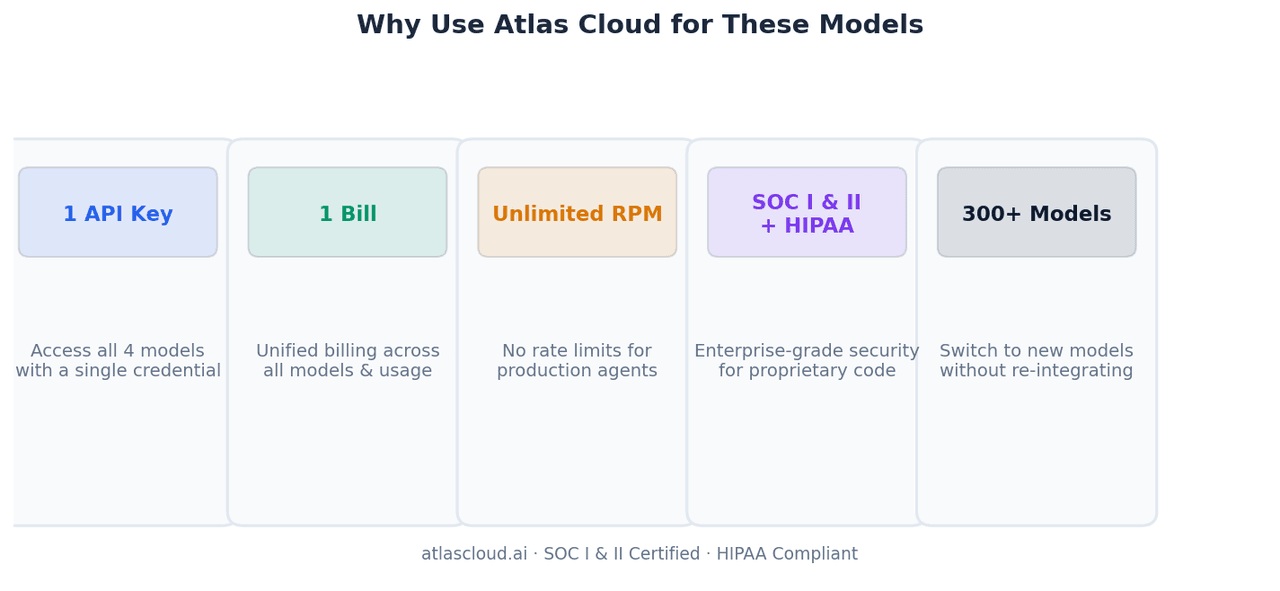
คีย์ API เดียว, สี่โมเดล, ใบแจ้งหนี้เดียว การเรียกใช้ตรรกะการจัดเส้นทางโมเดล — ส่งงาน front-end ไปยัง GLM-5.1, การวิเคราะห์แบบแบตช์ไปยัง MiniMax M2.7, และ agent ระยะยาวไปยัง Kimi K2.6 — ต้องจัดการข้อมูลประจำตัวเดียวแทนที่จะเป็นสี่รายการ การกระทบยอดรายเดือนเป็นใบแจ้งหนี้เดียว
RPM ไม่จำกัด agent เขียนโค้ดในการผลิตเรียกใช้เครื่องมือแบบขนาน ขีดจำกัดอัตราใน API ของผู้ให้บริการโดยตรงอาจทำให้ไปป์ไลน์หลาย agent ช้าลง Atlas Cloud ลบเพดานนั้นออก
รับรอง SOC I & II, เป็นไปตาม HIPAA ทีมที่ประมวลผลซอร์สโค้ดที่เป็นกรรมสิทธิ์ผ่านโมเดลเหล่านี้ต้องการโครงสร้างพื้นฐานที่ตรวจสอบได้ การรับรองการปฏิบัติตามของ Atlas Cloud หมายความว่าโค้ดของคุณไม่ได้ถูกส่งผ่าน endpoint ที่ไม่ผ่านการตรวจสอบ
โมเดลมากกว่า 300 รายการ, รูปแบบการรวมระบบเดียวกัน เมื่อเวอร์ชันถัดไปของโมเดลใด ๆ เหล่านี้เปิดตัว หรือโมเดลใหม่ทำงานได้ดีกว่าในเวิร์กโหลดเฉพาะของคุณ การเพิ่มเข้าไปในตรรกะการจัดเส้นทางของคุณต้องเปลี่ยนสตริงเดียว — ไม่ใช่การรวม SDK ใหม่
โมเดลใดสำหรับงานใด
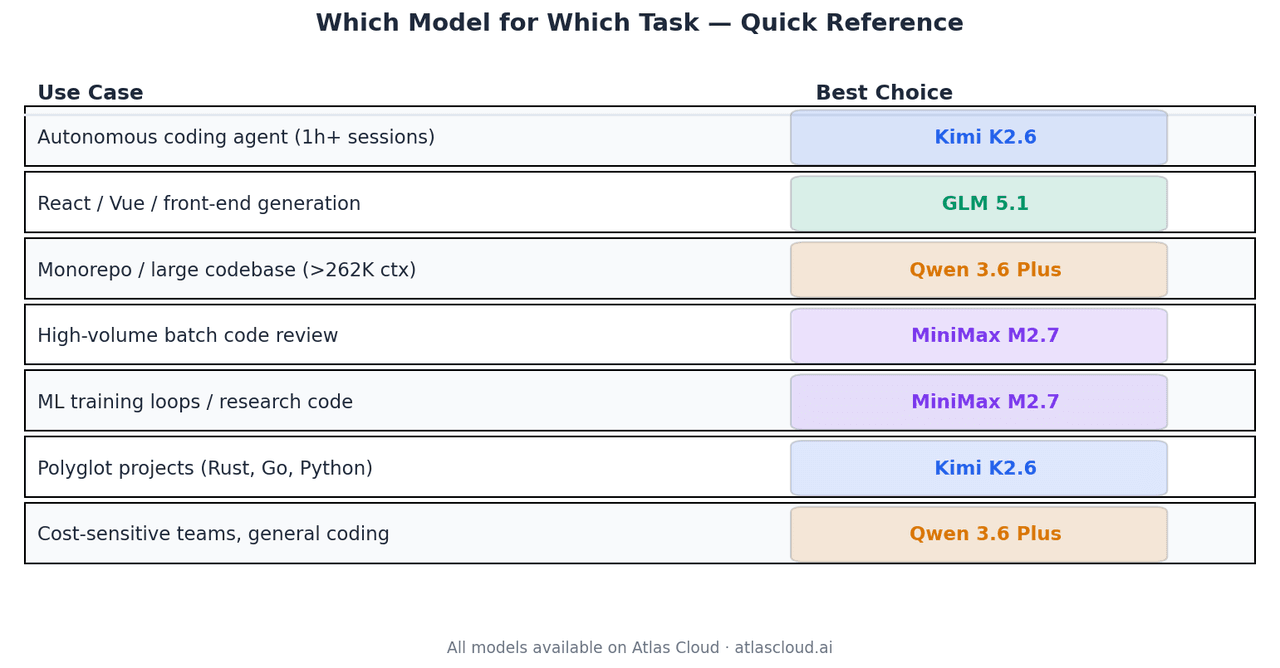
| กรณีการใช้งาน | ตัวเลือกที่ดีที่สุด | เหตุผล |
| agent เขียนโค้ดอัตโนมัติ, เซสชัน 1+ ชั่วโมง | Kimi K2.6 | 66.7% Terminal-Bench 2.0, ความเสถียรการเรียกใช้เครื่องมือ 4K+ |
| การสร้าง React / Vue / front-end | GLM 5.1 | Code Arena Elo 1,530, top-3 ด้านการพัฒนาเว็บแบบ agentic ทั่วโลก |
| การวิเคราะห์ monorepo หรือโค้ดเบสขนาดใหญ่ | Qwen 3.6 Plus | โมเดลเดียวในกลุ่มนี้ที่มีหน้าต่างคอนเท็กซ์ 1 ล้าน |
| การตรวจสอบโค้ดแบบแบตช์ปริมาณสูง | MiniMax M2.7 | $0.30/ล้านอินพุต, คุณภาพ 94% ของ GLM-5.1 |
| training loop ML, โค้ดวิจัย | MiniMax M2.7 | อัตราเหรียญรางวัล 66.6% ใน MLE-Bench Lite |
| โปรเจกต์หลายภาษา (Rust, Go, Python) | Kimi K2.6 | การทำงานทั่วไปข้ามภาษาที่ได้รับการบันทึกไว้ |
| ทีมที่คำนึงถึงต้นทุน, การเขียนโค้ดทั่วไป | Qwen 3.6 Plus | $0.325/ล้านอินพุต, แข็งแกร่งในทุกหมวดหมู่ |
สรุป
โมเดลทั้งสี่นี้แยกจากกันด้วยขอบเขตแคบ ๆ ในเกณฑ์มาตรฐานมาตรฐาน ความแตกต่างที่มีความหมายเกิดขึ้นในเงื่อนไขเฉพาะ
Kimi K2.6 เป็นคำตอบที่ถูกต้องสำหรับ agent ระยะยาวที่ทำงานอัตโนมัติ GLM 5.1 เป็นผู้นำสำหรับงาน front-end แบบ agentic Qwen 3.6 Plus เป็นตัวเลือกเดียวเมื่อคอนเท็กซ์เกิน 262K โทเค็น MiniMax M2.7 เป็นค่าเริ่มต้นที่คุ้มต้นทุนสำหรับทีมที่ใช้โมเดลเขียนโค้ดในระดับ規模
โมเดลทั้งสี่พร้อมใช้งานบน Atlas Cloud ที่ atlascloud.ai ภายใต้คีย์ API เดียว พร้อมราคาจ่ายต่อโทเค็นและไม่มีข้อผูกมัดขั้นต่ำ
ข้อมูลเกณฑ์มาตรฐานจากบล็อกเทคนิคของ Moonshot AI, เอกสารประกอบสำหรับนักพัฒนาของ Z.AI, โพสต์เปิดตัวของทีม Qwen Alibaba, หน้าโมเดลอย่างเป็นทางการของ MiniMax และการประเมินอิสระของ Arena.ai เกณฑ์มาตรฐานทั้งหมดเป็นข้อมูลเดือนเมษายน 2026 ราคา Atlas Cloud ณ วันที่เผยแพร่ — โปรดยืนยันอัตราปัจจุบันก่อนนำไปใช้ในการผลิต


