คนสองคนนั่งตรงข้ามกันที่โต๊ะ ประโยคหนึ่งเริ่มขึ้น แล้วปากของทั้งคู่ก็ขยับ รีเวิร์สช็อตมาถึง และเสียงก็ไม่รู้สึกผูกติดกับใบหน้าอีกต่อไป นั่นคือความล้มเหลวที่ครีเอเตอร์พยายามหลีกเลี่ยงเมื่อค้นหา kling 4 dialogue lip sync test
บทความนี้เริ่มจากการตรวจเวอร์ชัน จากนั้นทดลองบทสนทนาสั้น ๆ 3 แบบที่ทำซ้ำได้บนตระกูล Kling 3.0 ที่ตรวจสอบแล้ว: ผู้พูดหนึ่งคน, ผู้พูด 2 คนผลัดกันพูด และบทสนทนาแบบผสมอังกฤษ-สเปน แต่ละการทดสอบใช้เสียง native ตอนสร้าง บทความแสดงผลลัพธ์ภาพเป็น GIF ควบคู่กับสกอร์การ์ด 10 คะแนนชุดเดียวกัน สิ่งเหล่านี้เป็นการรันแต่ละครั้ง ไม่ใช่มาตรฐานสากล
ประเด็นสำคัญ
- Kuaishou ประกาศ Kling 3.0 อย่างเป็นทางการ ไม่ใช่โมเดลบทสนทนา Kling 4 ที่ระบุแยกต่างหาก
- บทพูดสั้น ๆ ที่มีชื่อและผลัดกันพูด ช่วยให้ผู้ตรวจมีพื้นฐานชัดเจนขึ้นในการตรวจการระบุผู้พูด
- GIF ทำให้การขยับใบหน้าและการส่งต่อผู้พูดดูง่าย ในขณะที่ยังต้องใช้ MP4 ต้นฉบับเพื่อตรวจจังหวะเสียง
- มองการรัน 10 วินาทีเป็นเช็กลิสต์สคริปต์ก่อนลงทุนกับเวอร์ชันโปรดักชันที่ต้องการรายละเอียดสูงขึ้น
- ตรวจผู้ฟังที่เงียบให้ละเอียดพอ ๆ กับคนที่พูด
การทดสอบ lip sync บทสนทนา Kling 4: เริ่มจากตรวจเวอร์ชันก่อน
คำว่า “Kling 4” ตอนนี้รวมหลายสิ่งไว้ในผลการค้นหา: เอาต์พุต 4K, Kling 3.0, Kling Video O3, ภาษาก่อนเปิดตัว และชื่อเรียกที่ยังไม่ได้รับการยืนยัน ผมหาข้อกำหนดอย่างเป็นทางการของ Kuaishou สำหรับโมเดลบทสนทนา “Kling 4” ที่เปิดตัวแล้วไม่พบในเวลาของการทดสอบนี้ การเรียกป้ายที่ยังไม่ยืนยันว่าเป็นผลิตภัณฑ์ที่เสร็จแล้วจะทำให้การทดสอบมีประโยชน์น้อยลง
จุดอ้างอิงปัจจุบันที่ตรวจสอบได้คือ Kling AI 3.0 Kuaishou ประกาศตระกูล Video 3.0, Video 3.0 Omni, Image 3.0 และ Image 3.0 Omni เมื่อวันที่ 5 กุมภาพันธ์ 2026 ประกาศดังกล่าวอธิบายถึงเสียง native ในหลายภาษา ถิ่น และสำเนียง; ฉากบทสนทนาที่ควบคุมลำดับการพูด; การกำกับหลายช็อต; และความยาววิดีโอสูงสุด 15 วินาที (Kuaishou Technology, กุมภาพันธ์ 2026)
คำกล่าวอ้างของผลิตภัณฑ์นั้นกำหนดเป้าหมายการทดสอบที่มีประโยชน์ แต่ไม่ได้ยืนยันว่าคลิปที่สร้างทุกคลิปจะเป็นไปตามนั้น เสียง native หมายถึงโมเดลสามารถสร้างเสียงเป็นส่วนหนึ่งของงานวิดีโอ ไม่ได้รับประกันว่าปากจะปิดในทุกเสียงพยัญชนะ ผู้ฟังจะนิ่ง หรือการตัดต่อจะรักษาอัตลักษณ์ของผู้พูด รายละเอียดเหล่านั้นคือสิ่งที่การทดสอบนี้ตรวจ
การรัน 3 ครั้งด้านล่างเก็บผลลัพธ์ภาพไว้พร้อมสกอร์การ์ด เพื่อให้ผู้อ่านประเมินหลักฐานชุดเดียวกับที่ใช้ประกอบบันทึกได้
สิ่งที่เราทดสอบ
โปรโตคอลนี้ตัดข้ออ้างออกโดยตั้งใจ ทุกฉากใช้เฟรม 16:9 ความยาว 10 วินาที เปิดเสียง native หรือตั้งเป็น Auto ในกรณีที่ playground มีการตั้งค่านั้น ไม่มีเพลง และไม่ทำ lip sync ใน post-production ผู้พูดที่มองเห็นแต่ละคนได้บทสั้น ๆ หนึ่งประโยค GIF ในบทความเก็บภาพการแสดงไว้ ควรตรวจไฟล์ MP4 ต้นฉบับแยกต่างหากเมื่อตัดสินจังหวะเสียง
| การทดสอบ | โมเดล | ความยาว | ตัวละครที่มองเห็น | ภาษา | บทพูด | เป้าหมายการประเมินหลัก |
|---|---|---|---|---|---|---|
| 1 | Kling V3.0 Standard T2V | 10 วินาที | 1 | อังกฤษ | 1 | พยางค์แรก เสียงที่ปิดริมฝีปาก การหยุดท้ายประโยค |
| 2 | Kling V3.0 Standard T2V | 10 วินาที | 2 | อังกฤษ | 2 | ผู้พูดถูกต้องและพฤติกรรมผู้ฟังที่เงียบ |
| 3 | Kling V3.0 Pro T2V | 10 วินาที | 2 | อังกฤษและสเปน | 2 | การส่งต่อภาษา การระบุผู้พูด และความต่อเนื่องของใบหน้า |
สกอร์การ์ดให้คะแนนแต่ละหมวด 0, 1 หรือ 2 คะแนน 2 หมายถึงพฤติกรรมชัดเจนพอสำหรับตัวอย่าง 10 วินาทีที่ตั้งใจ 1 หมายถึงโน้มน้าวได้บางส่วนแต่ต้องดูอีกครั้ง 0 หมายถึงผู้ชมเห็นปัญหาได้ชัดเจน คะแนนรวมเป็นบันทึกของผลลัพธ์ที่สร้างหนึ่งครั้งภายใต้พรอมป์ต์หนึ่ง ไม่ใช่คำกล่าวอ้างเกี่ยวกับเอาต์พุตทั้งหมดของโมเดล
| หมวด | 0 คะแนน | 1 คะแนน | 2 คะแนน |
|---|---|---|---|
| จังหวะปากกับคำ | ไม่ตรงกันชัดเจน | ส่วนใหญ่ตามทันแต่มีสะดุดให้เห็น | จังหวะดูเป็นธรรมชาติตลอด |
| การระบุผู้พูดถูกต้อง | ผู้พูดผิดหรือพูดร่วมกัน | มีหนึ่งจังหวะที่ไม่แน่ใจ | ทุกบทพูดเป็นของคนที่ระบุชื่อไว้ |
| พฤติกรรมผู้ฟังที่เงียบ | ผู้ฟังพูดหรือขยับปากเป็นคำ | มีการขยับปากเล็กน้อยหลุดมา | ผู้ฟังนิ่งฟังอย่างเป็นธรรมชาติ |
| ความต่อเนื่องของสีหน้า | ใบหน้าแตกหรือเปลี่ยนชัดเจน | มีความไม่นิ่งเล็กน้อย | สีหน้ายังสอดคล้องต่อเนื่อง |
| ความต่อเนื่องของเสียงข้ามการตัดต่อ | เสียงหลุดหรือเปลี่ยนกะทันหัน | การเปลี่ยนผ่านสังเกตเห็นได้ | การตัดต่อรองรับจังหวะบทสนทนาเดียวกัน |
การออกแบบการทดสอบยังตอบคำถามที่อาจแตกแขนงจากการค้นหานี้: Kling 4 เปิดตัวหรือยัง, โมเดลปัจจุบันตัวไหนสร้างบทสนทนาได้, คน 2 คนผลัดกันพูดได้ไหม, ครีเอเตอร์จะป้องกันไม่ให้ตัวละครทั้งคู่พูดพร้อมกันได้อย่างไร, บทสนทนาสองภาษาทำงานได้ไหม และงบประมาณทดสอบเล็ก ๆ ควรครอบคลุมอะไร
การทดสอบบทสนทนา Kling #1: ผู้พูดหนึ่งคน หนึ่งประโยคสั้น
คนเดียวพูดหนึ่งประโยคสั้นคือเส้นฐาน มันแยกการตรวจที่มีประโยชน์ช่วงแรกออกมา: การเปิดปากครั้งแรก การปิดปากในเสียง “p” หรือ “b” และจังหวะผ่อนคลายหลังพูดจบ ถ้าเส้นฐานดูผิด การเพิ่มตัวละครอื่น การตัดกล้อง หรือภาษาอื่นจะทำให้วินิจฉัยยากขึ้นเท่านั้น
การรันนี้ใช้พนักงานออฟฟิศสมมติชื่อ Maya ฉากมีการขยับมือเล็กน้อยและสายตาที่มองตรง แต่ไม่มีการเคลื่อนกล้องเร็ว จึงเหลือปากและเสียงเป็นหลักฐานหลัก
การตั้งค่าการรัน: 16:9, 10 วินาที, ความละเอียดสูงสุดที่มีใน playground ณ ตอนรัน, เปิดเสียง native หรือ Auto, ไม่มีเพลงประกอบ โมเดล: Kling V3.0 Standard Text-to-Video.
plaintext1A realistic 10-second medium close-up of Maya, a fictional woman in her early thirties wearing a navy blazer, seated at a bright office desk. She looks directly at her colleague just off camera and says exactly: “The report is ready. Please review the blue chart.” Natural conversational pacing, clear English speech, accurate mouth movements, subtle blinking, small hand gesture, quiet office room tone only. Maya is the only visible person and the only speaker. No subtitles, no background music, no narration.
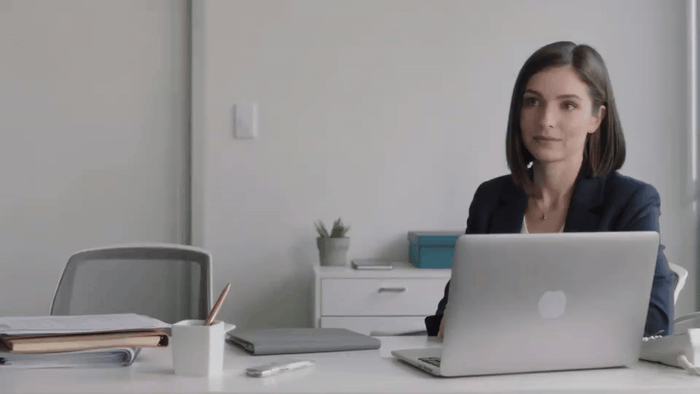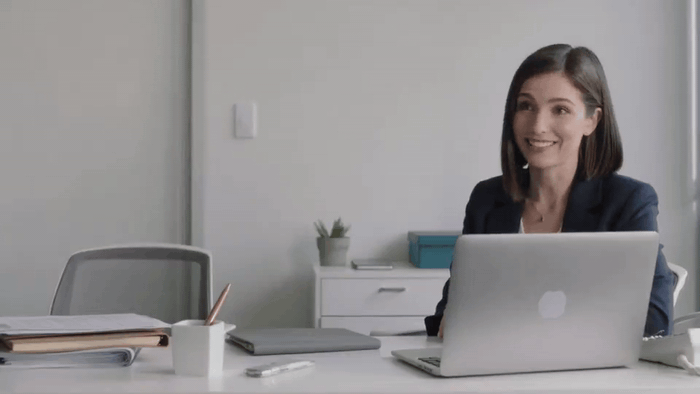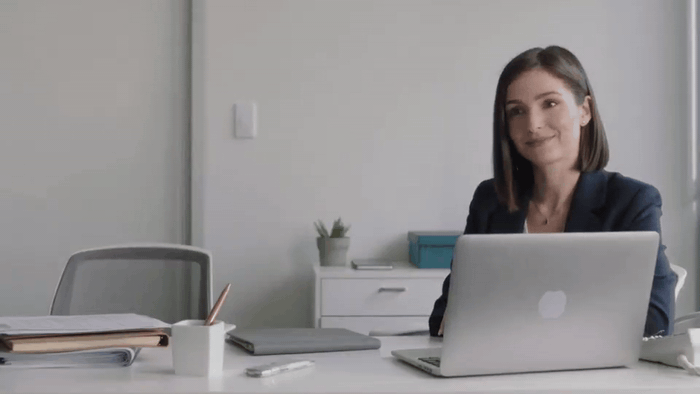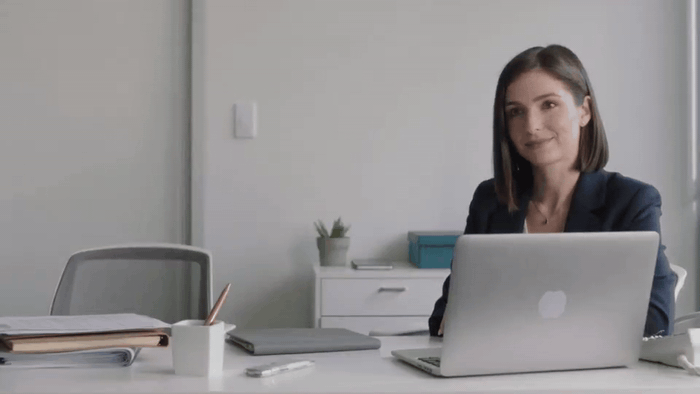
ผลลัพธ์ภาพของการทดสอบ 1: Maya พูดบทออฟฟิศหนึ่งประโยค
ผลลัพธ์ภาพของการทดสอบ 1. สังเกตการปิดปากของ Maya ตอนพูด “Please” และการหยุดหลังประโยค; ใช้ MP4 ต้นฉบับเพื่อตัดสินจังหวะเสียง
สถานะการรัน: เรนเดอร์ใน Atlas test playground แล้ว GIF ภาพถูกฝังไว้ด้านบน
| ผลลัพธ์ภาพของการทดสอบ 1 | สถานะ | สิ่งที่ GIF แสดง |
|---|---|---|
| เฟรมผู้พูดคนเดียว | ชัดเจน | Maya เป็นคนเดียวที่มองเห็นได้ตลอดฉากออฟฟิศ |
| การขยับปาก | มองเห็นได้ | เฟรมระยะใกล้ทำให้ดูการขยับตอนพูดได้ง่าย |
| ความต่อเนื่องของใบหน้า | นิ่ง | การกะพริบ ท่าทาง และแสงยังคงสม่ำเสมอตลอดคลิป |
| พฤติกรรมผู้ฟังและการตัดต่อ | ไม่เกี่ยวข้อง | ฉากเส้นฐานนี้ไม่มีผู้พูดคนที่สองหรือรีเวิร์สช็อต |
| จังหวะเสียง | ตรวจ MP4 ต้นฉบับ | GIF ที่ฝังไม่มีเสียง |
ถ้าบทพูดสูญเสียความชัดเจน ให้เปลี่ยนเพียง 1 ตัวแปรสำหรับการรันซ้ำที่ติดป้ายแยกต่างหาก อย่างแรก ทำให้ประโยคพูดสั้นลง อย่างที่สอง เอาการขยับมือหรือคำสั่งกล้องที่ไม่จำเป็นออก หลีกเลี่ยงการเปลี่ยนตัวละคร ความยาว และภาษาพร้อมกัน เพราะนั่นจะเปลี่ยนการวินิจฉัยให้กลายเป็นการทดลองใหม่
การทดสอบบทสนทนา Kling #2: สองคนผลัดกันพูด
นี่คือจุดที่การสร้างบทสนทนาต้องถูกตรวจสอบอย่างละเอียด ฉากที่ดูน่าเชื่อต้องมี 2 การกระทำแยกกัน: Maya ต้องพูดในขณะที่ Daniel ฟัง จากนั้น Daniel ต้องพูดในขณะที่ Maya ฟัง คนที่เงียบไม่ใช่พื้นที่ว่างเปล่า ปากที่ปิด การสบตา ปฏิกิริยาเล็ก ๆ และใบหน้าที่นิ่งของพวกเขาเป็นส่วนหนึ่งของหลักฐาน
พรอมป์ต์ใช้จุดยึด 3 อย่างสำหรับผู้พูดแต่ละคน: ชื่อ ตำแหน่งซ้ายหรือขวา และรายละเอียดเสื้อผ้าที่มองเห็นได้ พร้อมระบุพฤติกรรมที่คาดหวังของผู้ฟังด้วย สิ่งเหล่านี้ไม่ใช่คำวิเศษ พวกมันให้สัญญาฉากที่ชัดเจนขึ้นกับโมเดล และให้เงื่อนไขความล้มเหลวที่ชัดเจนกับผู้ตรวจ
plaintext1A realistic 10-second two-person office dialogue in a sunlit meeting room. Maya, wearing a navy blazer, sits on the left. Daniel, wearing a light gray shirt, sits on the right. Shot 1: medium two-shot. Maya looks at Daniel and says exactly: “The report is ready. Please review the blue chart.” Daniel remains silent and listens naturally with his mouth closed. Shot 2: reverse medium shot on Daniel. Daniel says exactly: “Great. I will check it before lunch.” Maya remains silent and listens naturally with her mouth closed. Clear English speech, precise lip sync, one speaker at a time, no overlapping dialogue, no subtitles, no background music, quiet office room tone.
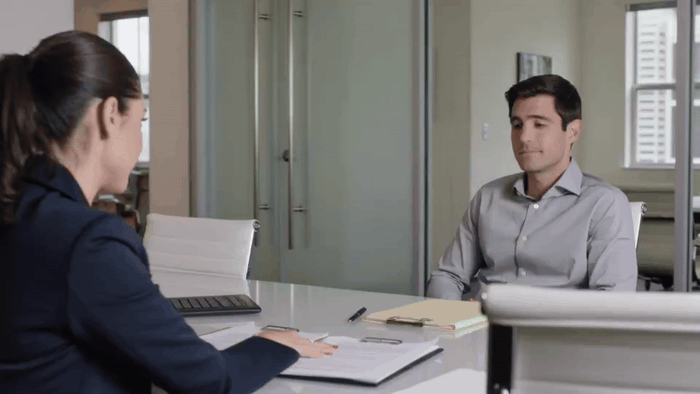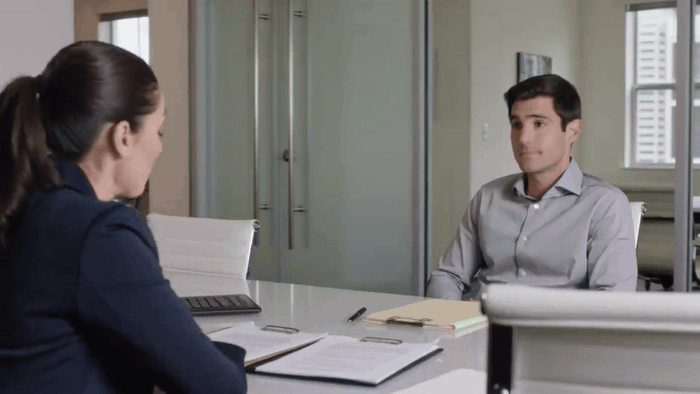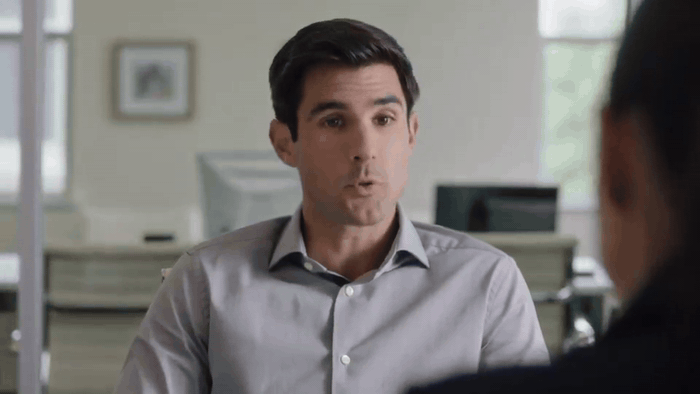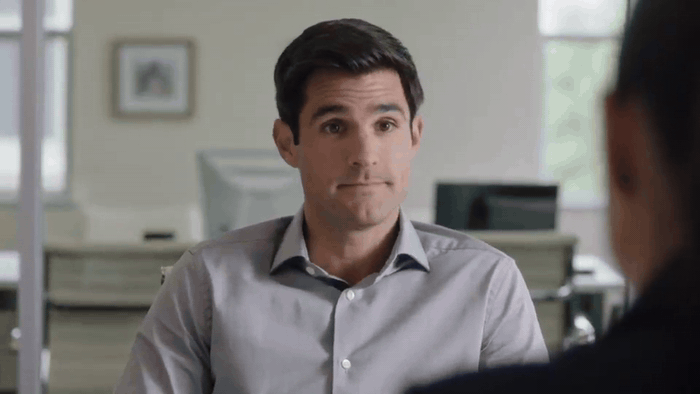
ผลลัพธ์ภาพของการทดสอบ 2: Maya และ Daniel ผลัดกันพูดในบทสนทนาออฟฟิศ
ผลลัพธ์ภาพของการทดสอบ 2. สังเกตปากของผู้ฟังระหว่างแต่ละบทพูด และการส่งต่อผู้พูดตอนรีเวิร์สช็อต; ใช้ MP4 ต้นฉบับเพื่อตัดสินจังหวะเสียง
ครีเอเตอร์มักเล่าปัญหาตรงข้ามในชุมชน: งาน lip sync ที่ตั้งใจไว้อาจหลุดซิงก์หรือทำให้คนที่ควรเงียบขยับปากโดยไม่ต้องการ นั่นเป็นประสบการณ์จากเรื่องเล่า ไม่ใช่ข้อกำหนดผลิตภัณฑ์ แต่เป็นเหตุผลดีที่จะตรวจผู้ฟังในทุกการรัน (r/KLING, กันยายน 2026)
สถานะการรัน: เรนเดอร์ใน Atlas test playground แล้ว GIF ภาพถูกฝังไว้ด้านบน
| ผลลัพธ์ภาพของการทดสอบ 2 | สถานะ | สิ่งที่ GIF แสดง |
|---|---|---|
| การตั้งค่าผู้พูดสองคน | ชัดเจน | Maya และ Daniel ปรากฏในบทสนทนาออฟฟิศเดียวกัน |
| การส่งต่อผู้พูด | มองเห็นได้ | ฉากเปลี่ยนจากตาของ Maya ไปเป็นรีเวิร์สช็อตของ Daniel |
| พฤติกรรมผู้ฟัง | ตรวจสอบได้ | GIF ยังทำให้คนที่ไม่พูดมองเห็นได้เพื่อตรวจภาพ |
| ความต่อเนื่องของใบหน้า | นิ่ง | ใบหน้าของ Daniel และฉากออฟฟิศยังคงสม่ำเสมอในรีเวิร์สช็อต |
| จังหวะเสียง | ตรวจ MP4 ต้นฉบับ | GIF ที่ฝังไม่มีเสียง |
ขอบเขตในทางปฏิบัติไม่สูงมาก: บทสนทนา 2 คน เรียงลำดับ 10 วินาทีทดสอบได้ ไม่ควรถือเป็นเทมเพลตสำเร็จรูปสำหรับฉากยาวที่มีการขัดจังหวะ ปฏิกิริยาของกลุ่ม การตัดต่อเร็ว และหลายภาษา ค่อย ๆ เพิ่มความยากทีละมิติ
การทดสอบบทสนทนา Kling #3: บทสนทนาสองภาษา
การรันที่สามทดสอบฟีเจอร์ที่ Kuaishou อธิบายในเวอร์ชันกระชับขึ้น: คนหนึ่งพูดอังกฤษ จากนั้นอีกคนตอบเป็นสเปน คุณค่าไม่ได้อยู่ที่ความแปลกใหม่ การสนทนาสองภาษาสามารถเปิดเผยข้อผิดพลาดในการระบุผู้พูดที่คลิปภาษาเดียวซ่อนไว้ โดยเฉพาะเมื่อการตัดต่อและรูปแบบเสียงที่ต่างกันมาพร้อมกัน
บทตอบภาษาสเปนตั้งใจให้สั้น แต่ละคนยังมีบทพูดหนึ่งประโยค ลำดับช็อตยังชัดเจน และผู้ฟังถูกสั่งให้เงียบ มีการใช้ระดับ Pro ที่นี่เป็นการทดสอบที่แยกออกมาและต้องการมากกว่า ไม่ใช่ใช้แทนพรอมป์ต์ที่ชัดเจน
การตั้งค่าการรัน: 16:9, 10 วินาที, ความละเอียดและคุณภาพสูงสุดที่มี ณ ตอนรัน, เปิดเสียง native หรือ Auto, ไม่มีเพลงประกอบ โมเดล: Kling V3.0 Pro Text-to-Video.
plaintext1A realistic 10-second two-person dialogue at a quiet outdoor café in late afternoon. Maya, wearing a navy blazer, is seated on the left. Daniel, wearing a light gray shirt, is seated on the right. Shot 1: Maya smiles and says exactly in English: “The product demo starts in five minutes.” Daniel remains silent and listens with his mouth closed. Shot 2: Daniel replies exactly in Spanish: “Perfecto, ya tengo las notas listas.” Maya remains silent and listens naturally with her mouth closed. One speaker at a time, accurate lip sync for each spoken language, natural pauses, stable faces, no subtitles, no background music, soft café ambience only.
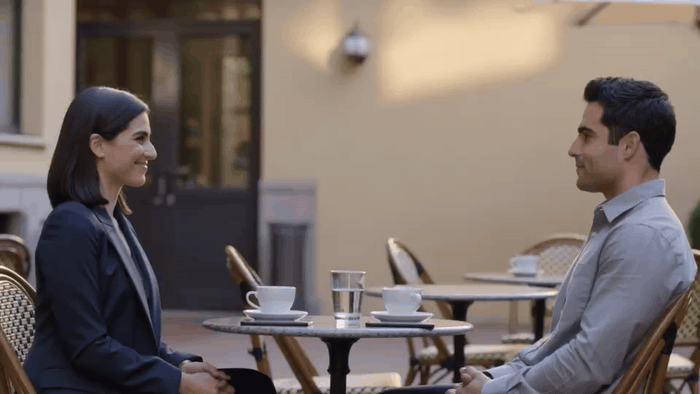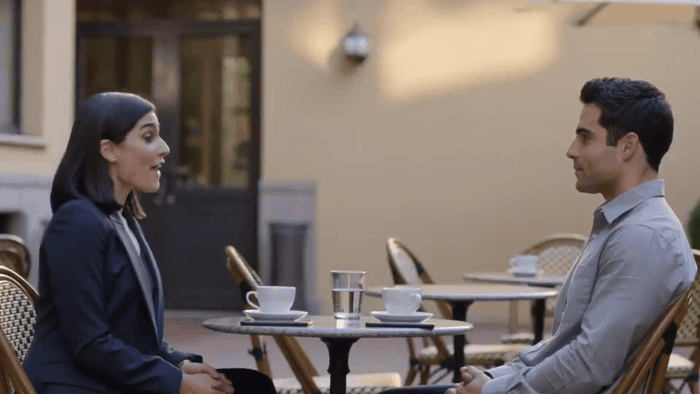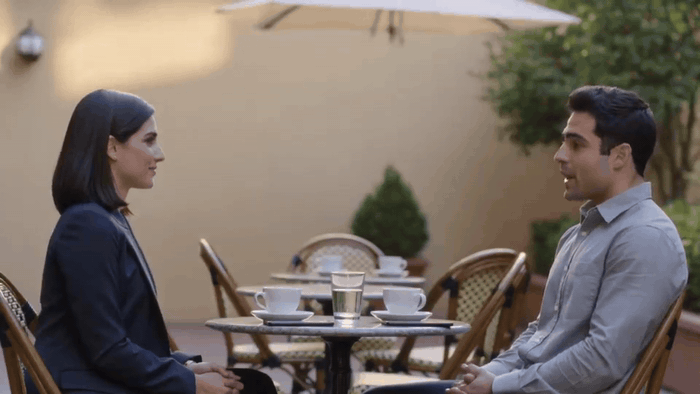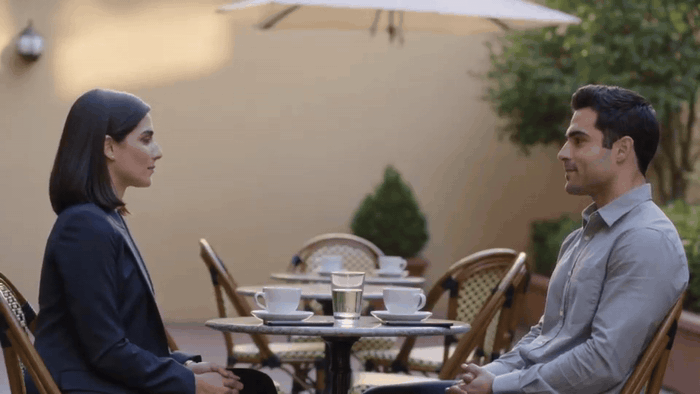
ผลลัพธ์ภาพของการทดสอบ 3: ผู้พูดสองคนสลับบทพูดกันที่คาเฟ่กลางแจ้ง
ผลลัพธ์ภาพของการทดสอบ 3. สังเกตว่าใบหน้าใดเป็นเจ้าของแต่ละบทพูดตลอดการส่งต่อจากอังกฤษเป็นสเปน; ใช้ MP4 ต้นฉบับเพื่อตัดสินจังหวะเสียง
สถานะการรัน: เรนเดอร์ใน Atlas test playground แล้ว GIF ภาพถูกฝังไว้ด้านบน
| ผลลัพธ์ภาพของการทดสอบ 3 | สถานะ | สิ่งที่ GIF แสดง |
|---|---|---|
| การตั้งค่าคาเฟ่สองคน | ชัดเจน | ทั้งสองคนยังอยู่ในตำแหน่งที่โต๊ะคาเฟ่กลางแจ้ง |
| การส่งต่อผู้พูด | มองเห็นได้ | เฟรมยังคงการสนทนาระหว่างตัวละครสองตัว |
| ความต่อเนื่องของใบหน้าและฉาก | นิ่ง | เครื่องแต่งกาย ที่นั่ง และแสงคาเฟ่ช่วงบ่ายแก่ ๆ ยังคงสม่ำเสมอ |
ผลลัพธ์ lip sync ของ Kling ที่ชัดเจนขึ้น
พรอมป์ต์ 3 ชุดมีโครงสร้างร่วมที่ทำให้ความล้มเหลวมองเห็นได้และการรันซ้ำอธิบายได้ ใช้เช็กลิสต์นี้ก่อนเพิ่มความประณีต
- ในการทดสอบบทสนทนาครั้งแรก ให้มีคนที่มองเห็นไม่เกิน 2 คน
- ให้แต่ละคนพูด 1 ประโยคต่อเทิร์น
- ถ้าเป็นไปได้ ให้บทพูดภาษาอังกฤษยาวประมาณ 8 ถึง 12 คำ
- ระบุผู้พูดด้วยตำแหน่ง ลักษณะที่มองเห็นได้ และชื่อ
- ระบุว่าตัวละครอีกคนฟังอย่างเป็นธรรมชาติโดยปิดปาก
- สร้างสคริปต์ด้วยตัวอย่าง 10 วินาทีก่อนเพิ่มการตั้งค่ารายละเอียดหรือความยาว
- ตรวจจังหวะริมฝีปาก การระบุผู้พูด พฤติกรรมผู้ฟัง ความต่อเนื่องของใบหน้า และการตัดต่อ เป็นการตรวจแยกกัน
- อย่ารวมบทพูดยาว ฉากกลุ่ม การตัดต่อเร็ว และการสลับภาษาไว้ในการรันครั้งแรก
| องค์ประกอบพรอมป์ต์ | ตัวอย่างในการทดสอบ | สิ่งที่ช่วยให้ผู้ตรวจแยกได้ |
|---|---|---|
| ตำแหน่ง | “Maya ... on the left” | คนไหนควรพูด |
| จุดยึดรูปลักษณ์ | “navy blazer” | อัตลักษณ์คงอยู่ข้ามการตัดต่อหรือไม่ |
| บทพูดที่แน่นอน | “Great. I will check it before lunch.” | เสียงและจังหวะปากที่คาดหวัง |
| คำสั่งบทเงียบ | “remains silent ... mouth closed” | การขยับปากของผู้ฟังที่ไม่ต้องการ |
| ลำดับช็อต | “Shot 1 ... Shot 2” | เสียงยังผูกติดหลังการตัดต่อหรือไม่ |
รูปแบบนี้ไม่ได้สัญญาว่าจะได้ผลลัพธ์สมบูรณ์แบบ แต่ให้วิธีกับทีมเล็ก ๆ ในการเก็บพรอมป์ต์ต้นฉบับ สื่อ และการตัดสินใจไว้ด้วยกัน ถ้าคลิปต้องรันซ้ำ ให้บันทึกว่าความล้มเหลวเกิดที่พยางค์แรก ระหว่างปฏิกิริยาของผู้ฟัง หรือที่การตัดต่อ “lip sync รู้สึกไม่ดี” กว้างเกินไปที่จะนำไปปรับปรุงสคริปต์โปรดักชัน
งบประมาณและการเลือกโมเดล
ใช้ระดับราคาต่ำกว่าปัจจุบันเพื่อตรวจสอบสคริปต์ จากนั้นเก็บการทดสอบระดับสูงกว่าไว้สำหรับเวอร์ชันที่คุณอาจนำไปเสนอจริง นั่นคือบทบาทของ Standard และ Pro ในบทความนี้ ครีเอเตอร์สามารถรันโครงสร้างพรอมป์ต์เดียวกันใน พื้นที่ทำงานโมเดล Atlas Cloud เดียว เก็บบันทึกการทดสอบ และเปรียบเทียบได้โดยไม่ต้องเขียนสคริปต์ใหม่สำหรับอินเทอร์เฟซอื่น
ตัวเลขด้านล่างเป็นบริบทด้านราคา ไม่ใช่คำกล่าวอ้างโปรโมชัน ตรวจสอบกับไดเรกทอรีโมเดลและหน้ารายละเอียดโมเดลของ Atlas Cloud เมื่อวันที่ 28 กันยายน 2026 ไดเรกทอรีแสดงส่วนลด 15% ณ เวลาที่ตรวจสอบ ราคาและพารามิเตอร์ของโมเดลเปลี่ยนแปลงได้ ควรตรวจหน้าอีกครั้งก่อนตั้งงบประมาณให้ลูกค้า
| โมเดลสำหรับการทดสอบนี้ | ราคาต่อวินาทีบนหน้าเว็บ ตรวจเมื่อ ก.ย. 2026 | ประมาณการสร้าง 10 วินาที | การใช้งานที่ดีที่สุดในโปรโตคอลนี้ |
|---|---|---|---|
| Kling V3.0 Standard T2V | $0.071, ลดจาก $0.084 | $0.71 | ตรวจสอบโครงสร้างพรอมป์ต์ผู้พูดคนเดียวและการผลัดกันพูด |
| Kling V3.0 Pro T2V | $0.095, ลดจาก $0.112 | $0.95 | รันบทสนทนาสองภาษาหรือตัวเลือกสำหรับการนำเสนอ |
ค่าใช้จ่ายรวมที่ระบุสำหรับการทดสอบ 10 วินาที 3 ครั้งคือ $2.37 ก่อนการรันซ้ำใด ๆ ให้ถือเป็นประมาณการวางแผนอย่างง่าย โดยสมมติว่าราคาต่อวินาทีที่แสดง ความยาวที่ขอถูกรับโดยฟอร์มจริง และราคาที่ใช้กับบัญชีตรงกับหน้าเว็บสาธารณะ สคีมาของ playground จริงเป็นสิ่งตัดสินสุดท้ายสำหรับอัตราส่วนภาพที่มี ตัวเลือกคุณภาพ และการควบคุมเสียง native
คำถามที่พบบ่อยเกี่ยวกับ lip sync บทสนทนา Kling
Kling 4 เปิดตัวอย่างเป็นทางการแล้วหรือยัง?
ผมตรวจสอบข้อกำหนดอย่างเป็นทางการของ Kuaishou สำหรับโมเดลบทสนทนา Kling 4 ที่เปิดตัวแล้วไม่พบ การเปิดตัวอย่างเป็นทางการที่ใช้ในบทความนี้คือ Kling 3.0 หน้าผลการค้นหาที่ผูก “4K” หรือป้ายที่ดูเหมือนอนาคตเข้ากับ Kling ไม่ควรถือเป็นการยืนยันว่ามีผลิตภัณฑ์ “Kling 4” แยกต่างหาก
วันนี้ควรใช้โมเดลใดสำหรับการทดสอบ lip sync บทสนทนา Kling?
สำหรับการตรวจสคริปต์สั้น ๆ ให้ใช้เส้นทาง Kling V3.0 Standard Text-to-Video ปัจจุบันที่ตรวจสอบแล้ว ใช้ Pro สำหรับการติดตามที่ต้องการมากกว่า เช่น ฉากสองภาษาในบทความนี้ รักษาการตั้งค่าให้นิ่งพอที่คุณจะบอกได้ว่าผลลัพธ์เปลี่ยนเพราะพรอมป์ต์หรือระดับโมเดล
Kling ทำให้คน 2 คนพูดทีละคนได้ไหม?
Kuaishou กล่าวว่า Video 3.0 สามารถสร้างบทสนทนาหลายตัวละครที่มีการควบคุมเนื้อหาและลำดับการพูดได้ ในทางปฏิบัติ ให้รันตัวอย่างผลัดกันพูดสั้น ๆ ก่อน ระบุชื่อผู้พูดแต่ละคน ยึดตำแหน่งและเสื้อผ้าของพวกเขา ระบุลำดับช็อต และสั่งผู้ฟังให้เงียบอย่างชัดเจน
ทำไมตัวละครทั้งคู่ขยับปากในวิดีโอ Kling ของฉัน?
ฉากอาจเปิดการระบุผู้พูดกว้างเกินไป หรือโมเดลอาจสร้างการขยับใบหน้าที่ไม่ต้องการในการรันนั้น จำกัดการทดสอบไว้ที่ 2 คนและคนละ 1 บทพูด จากนั้นใส่คำสั่งผู้ฟังเงียบโดยตรง และตรวจผลลัพธ์พร้อมเสียง ถ้าปัญหายังอยู่ ให้รายงานเป็นผลลัพธ์ที่ล้มเหลวและรันซ้ำโดยเปลี่ยนเพียง 1 ตัวแปร
Kling รองรับบทสนทนาอังกฤษและสเปนในคลิปเดียวไหม?
Kuaishou ระบุทั้งอังกฤษและสเปนในภาษาที่รองรับโดยเสียง native ของ Video 3.0 รายการภาษาที่รองรับไม่เหมือนกับการรับประกันสคริปต์บทสนทนาใด ๆ kling 4 dialogue lip sync test ครั้งที่สามด้านบนทำให้การสนทนาสั้น เพื่อให้คุณตัดสินการส่งต่อภาษา การขยับปาก และการระบุผู้พูดในไฟล์เดียวกัน
ควรใช้ GIF หรือวิดีโอเพื่อแสดงการทดสอบ lip sync?
ใช้ GIF เมื่อบทความต้องการมุมมองที่เบาและกวาดดูง่ายของการขยับใบหน้าและการส่งต่อผู้พูด ใช้ MP4 ต้นฉบับเมื่อตรวจคำและจังหวะเสียง ผลลัพธ์ที่ฝังไว้ 3 รายการที่นี่เป็น GIF ขณะที่ไฟล์ MP4 ต้นฉบับยังอยู่ในโฟลเดอร์แอสเซ็ตของบทความ





