

การทดสอบความจำที่มีประโยชน์ไม่ใช่การถามว่า “คุณจำอะไรเกี่ยวกับฉันได้บ้าง?” แต่เป็นการตรวจสอบแบบปิดหนังสือที่มีการแก้ไขหนึ่งครั้งและมีสิ่งรบกวนไม่กี่อย่างมากกว่า หากต้องการรัน muse wonder active memory test ให้รายละเอียดสมมติแก่ Muse Wonder ในบทสนทนาหนึ่ง แก้ไขรายละเอียดหนึ่งรายการ จากนั้นถามหาข้อเท็จจริงปัจจุบันที่เกี่ยวข้องในบทสนทนาใหม่ บันทึกว่ามันดึงอะไรได้ ดึงอะไรผิด และยอมรับความไม่แน่ใจหรือไม่
ลำดับด้านล่างใช้เวลาประมาณ 10 นาทีในการตั้งค่าและให้คะแนน นั่นไม่ใช่หลักฐานว่ามีความจำข้ามวัน ข้ามบัญชี หรือข้ามพื้นผิวผลิตภัณฑ์ Muse ทุกแบบ เป็นการตรวจสอบครั้งแรกที่ทำซ้ำได้ ใช้รายละเอียดที่กุขึ้นแทนข้อมูลส่วนตัว
ประเด็นสำคัญ
- ทดสอบการดึงข้อมูล การแก้ไข ความต้านทานสิ่งรบกวน ความไม่แน่ใจ และความสามารถตรวจสอบย้อนกลับ แยกจากกัน
- รันการทดสอบในพื้นผิวผลิตภัณฑ์ที่คุณตั้งใจจะใช้ โดยบันทึกการตั้งค่าหน่วยความจำของมัน
- คำขอ API ใหม่จะทดสอบหน่วยความจำแบบถาวรก็ต่อเมื่อแอปพลิเคชันหรือบริการเป็นผู้จัดหาให้
- MemoryBench ของ Meta เป็นการประเมินภายในที่ยาวนานกว่ามาก การตรวจสอบสั้น ๆ นี้ไม่ได้จำลองมันขึ้นมาใหม่
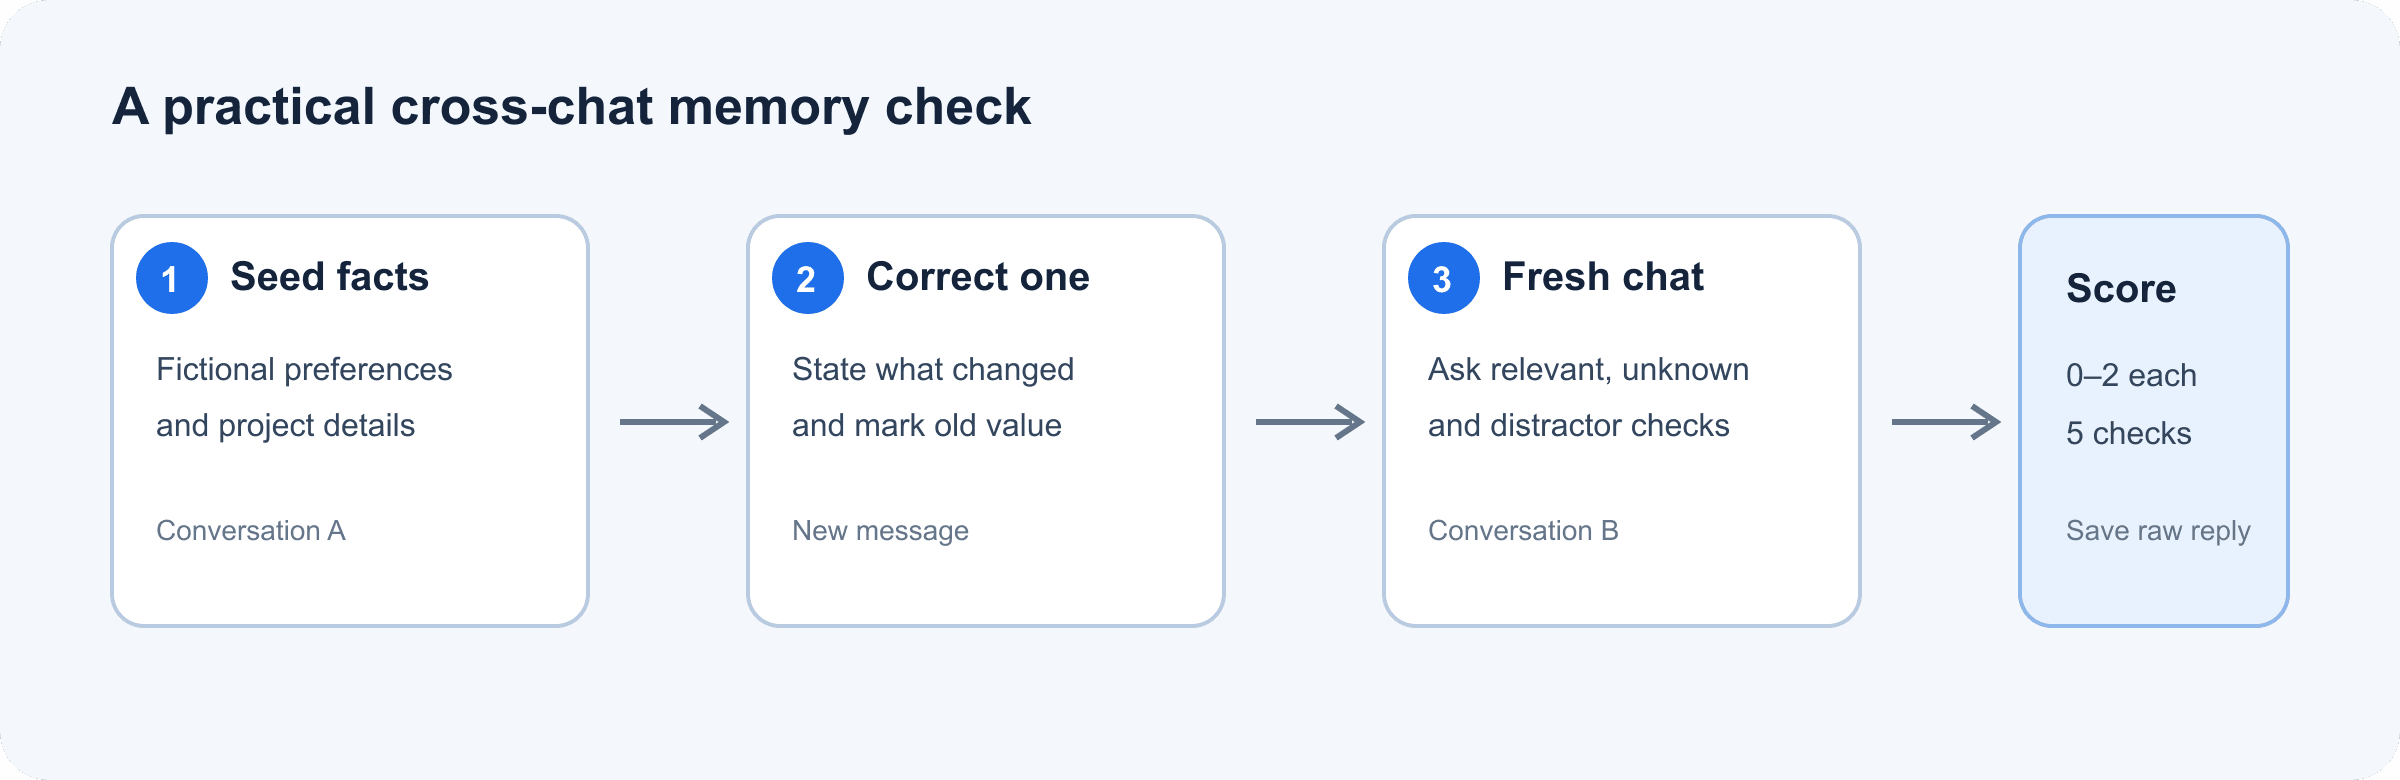
ขั้นตอนการทดสอบ Active Memory ของ Muse Wonder ตั้งแต่รายละเอียดสมมติ ผ่านการแก้ไข การดึงข้อมูลในแชตใหม่ ไปจนถึงการให้คะแนน
ขั้นตอนการทดสอบแยกข้อเท็จจริงเริ่มต้น การแก้ไขอย่างชัดเจน และการดึงข้อมูลในบทสนทนาใหม่ ออกจากกัน
Muse Wonder Active Memory ถูกออกแบบมาเพื่อทำอะไร
Meta อธิบายว่า Active Memory คือการพาบริบทสำคัญเกี่ยวกับบุคคลข้ามบทสนทนา และดึงรายละเอียดเมื่อรายละเอียดเหล่านั้นมีความสำคัญต่องานในภายหลัง Active Focus หมายถึงการทำงานต่อเนื่องไปสู่เป้าหมาย รวมถึงการลองทางเลือกอื่นเมื่อติดขัดและการปรับตัวเข้ากับข้อมูลใหม่ แนวคิดเหล่านี้เกี่ยวข้องกัน แต่ตอบคำถามต่างกัน: หน่วยความจำเกี่ยวกับบริบทใดที่ถูกดึงกลับมา ส่วน focus เกี่ยวกับว่างานดำเนินไปอย่างไร
คำอธิบายนั้นเป็นคำกล่าวอ้างความสามารถของผลิตภัณฑ์ ไม่ใช่การรับประกันว่าทุกอินเทอร์เฟซหรือทุกการเรียก API จะแชร์ประวัติของผู้ใช้โดยอัตโนมัติ Meta กล่าวว่า Muse Wonder ใช้งานได้ผ่าน Model API และ Muse Code เอกสารสำหรับนักพัฒนาของมันระบุหน้าต่างบริบทขนาด 1,048,576 โทเคนและการตั้งค่าการให้เหตุผลที่รองรับ แต่หน้าต่างบริบทคือปริมาณบริบทที่คำขอหนึ่งสามารถบรรจุได้ ไม่ใช่หลักฐานว่าคำขอก่อนหน้าจะคงอยู่ ตรวจสอบว่าผลิตภัณฑ์ที่คุณเลือกมีประวัติหรือหน่วยความจำอะไรจริง ๆ
วิธีรันการทดสอบหน่วยความจำ Muse Wonder
ใช้บัญชีเดียวและตัวแปรโมเดลเดียวกันตลอดการรันหนึ่งครั้ง สำหรับผลิตภัณฑ์แชต ให้เปิดฟีเจอร์หน่วยความจำที่คุณตั้งใจจะประเมินและบันทึกการตั้งค่าของมัน สำหรับการผสานรวม API ให้สังเกตว่าแอปพลิเคชันของคุณเองรวมเทิร์นก่อนหน้า โปรไฟล์ที่จัดเก็บไว้ หรือโน้ตที่ดึงมาไว้ในคำขอหรือไม่ หากไม่มีข้อมูลนั้น คุณไม่สามารถระบุว่าการจดจำนั้นมาจากโมเดลเพียงอย่างเดียว
1. ให้ข้อเท็จจริงที่เกี่ยวข้องกับมัน
ในบทสนทนาแรก ให้วางโปรไฟล์สมมติต่อไปนี้ ขอเพียงการรับทราบ เพื่อให้โมเดลไม่เปลี่ยนข้อเท็จจริงเป็นแผนทันที
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
เปิดบทสนทนาใหม่จริง ๆ ในผลิตภัณฑ์เดียวกัน จากนั้นถาม:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
คำตอบที่ดีจะใช้ความชอบกิจกรรมกลางแจ้งที่เงียบสงบ ไม่จำเป็นต้องกล่าวถึงงบประมาณหรืออาหารทะเล เพราะไม่มีรายละเอียดใดจำเป็นต่อการแนะนำกิจกรรม ระวังความชอบที่ถูกกุขึ้น หากผลิตภัณฑ์เข้าถึงแชตก่อนหน้าไม่ได้หรือหน่วยความจำปิดอยู่ ให้บันทึกว่า “หน่วยความจำไม่พร้อมใช้งานในพื้นผิวนี้” แทนที่จะให้คะแนนโมเดลราวกับว่ามันได้รับข้อเท็จจริงแล้ว
2. แก้ไขข้อเท็จจริงที่ล้าสมัย
ในเธรดทดสอบอื่น ให้แนะนำการนัดหมายหนึ่งรายการ จากนั้นแทนที่อย่างชัดเจน เก็บการแก้ไขไว้ในข้อความแยกต่างหาก เพื่อให้คุณบอกได้ว่าการอัปเดตครั้งหลังชนะหรือไม่
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
ถามเกี่ยวกับเรื่องนี้ในบทสนทนาใหม่:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
ผ่านหากมันตอบวันพฤหัสบดี เวลา 10 น. และถือว่าวันอังคารล้าสมัย คำตอบแบบผสมหรือการใช้วันอังคารอย่างมั่นใจถือเป็นความล้มเหลวที่มีนัยสำคัญ แม้ว่ามันจะจดจำรายละเอียดเดิมได้อย่างสมบูรณ์แบบก็ตาม
3. เพิ่มสิ่งรบกวนและทดสอบสิ่งที่ยังไม่รู้
เพิ่มข้อเท็จจริงสมมติที่ไม่เป็นอันตรายสองหรือสามรายการในบทสนทนาเริ่มต้น เช่น สีโปรเจกต์ที่กุขึ้นหรือเลขพัสดุสมมติ หลังจากเว้นช่วง ให้เริ่มบทสนทนาใหม่และถามหนึ่งคำถามเกี่ยวกับความชอบที่เกี่ยวข้อง บวกกับอีกหนึ่งคำถามเกี่ยวกับข้อเท็จจริงที่คุณไม่เคยให้ไว้ แยกคำถามออกจากกันเพื่อให้แต่ละคำตอบให้คะแนนได้ง่าย
ผลลัพธ์ที่แข็งแรงจะใช้ความชอบที่เกี่ยวข้อง ละเว้นรายละเอียดที่ไม่เกี่ยวข้อง และบอกว่าไม่รู้ข้อเท็จจริงที่ขาดหายไป สำหรับการทดสอบความล่าช้าที่เข้มงวดยิ่งขึ้น ให้ทำพรอมป์เดียวกันซ้ำในวันถัดไป สิบนาทีสามารถตรวจสอบขอบเขตของแชตใหม่ได้ แต่ไม่สามารถยืนยันการเก็บรักษาข้ามสัปดาห์ได้
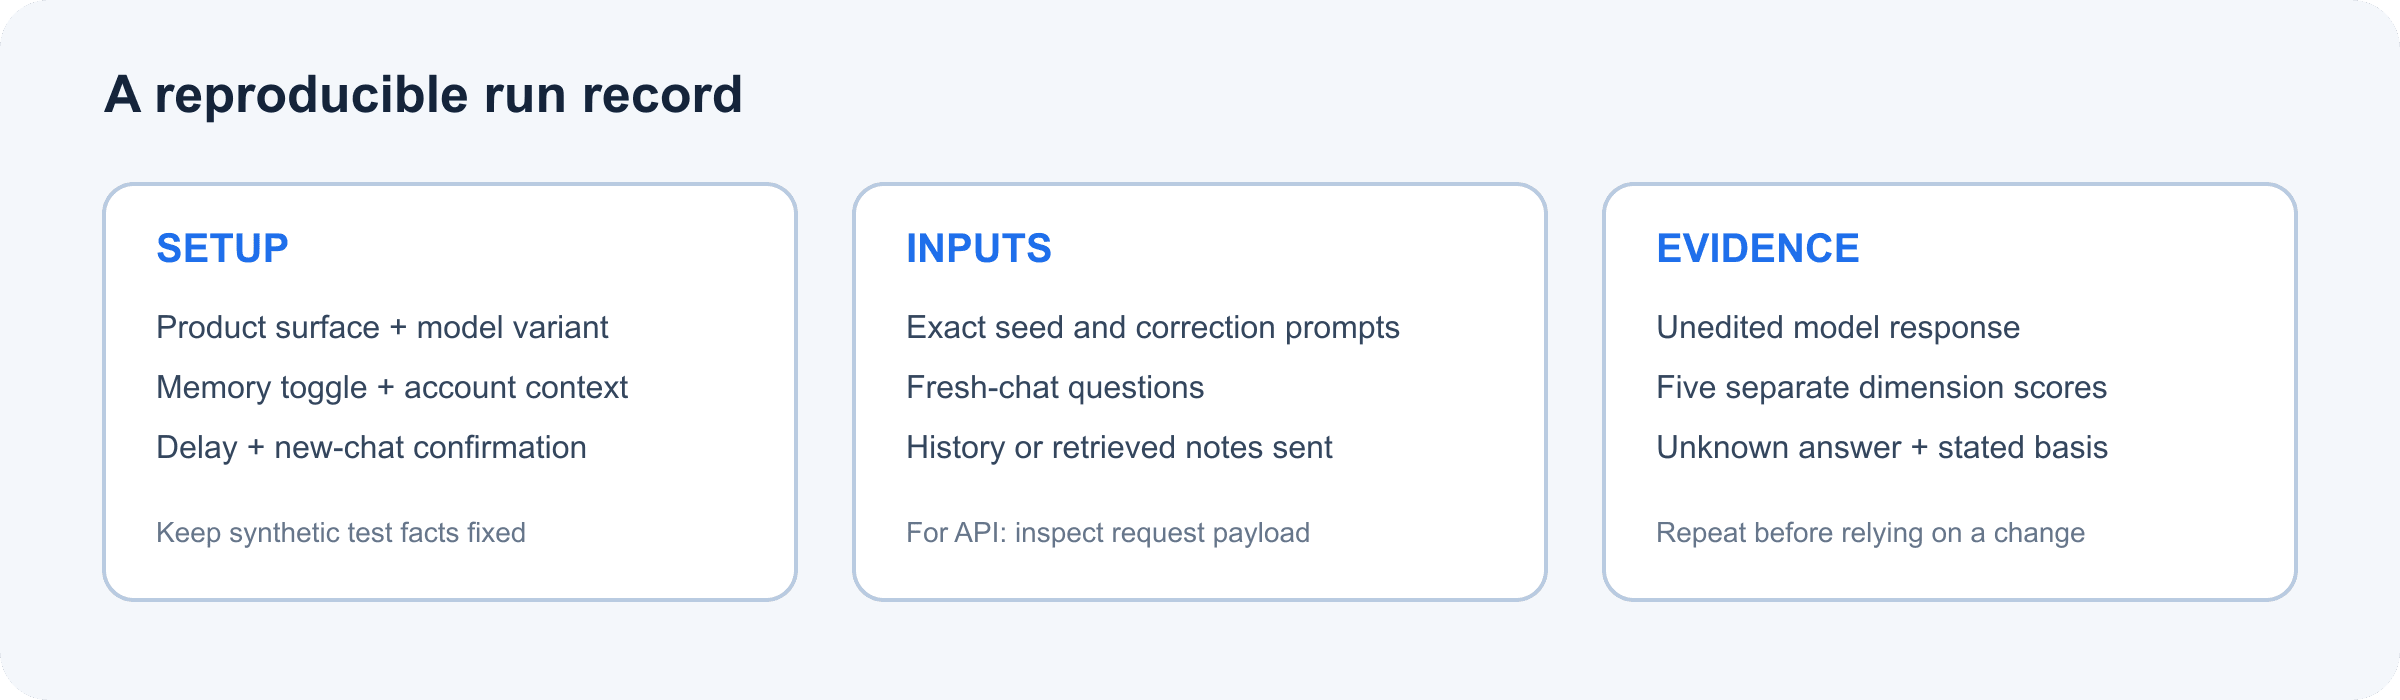
การ์ดทดสอบ Active Memory ของ Muse Wonder แสดงการตั้งค่า คำถามในแชตใหม่ และหลักฐานที่ต้องบันทึก
เก็บพรอมป์ พื้นผิวผลิตภัณฑ์ การตั้งค่าหน่วยความจำ ความล่าช้า และคำตอบดิบไว้ด้วยกัน เพื่อให้ผู้ตรวจสอบคนอื่นสามารถทำการตรวจสอบซ้ำได้
วิธีให้คะแนนการทดสอบ Active Memory
ให้คะแนนแต่ละพฤติกรรมตั้งแต่ 0 ถึง 2 ใช้ผลลัพธ์เพื่อเปรียบเทียบการรันในเวิร์กโฟลว์ของคุณเอง ไม่ใช่เพื่อจัดอันดับโมเดลโดยทั่วไป
| มิติ | 0 คะแนน | 1 คะแนน | 2 คะแนน |
|---|---|---|---|
| การดึงข้อเท็จจริงที่เกี่ยวข้อง | พลาดหรือกุข้อเท็จจริงที่จำเป็น | ถูกต้องบางส่วน | เลือกข้อเท็จจริงที่ถูกต้องอย่างแม่นยำ |
| การจัดการการแก้ไข | ใช้ค่าเก่า | คลุมเครือหรือผสมทั้งสอง | ใช้ค่าล่าสุดและระบุว่าค่าเก่าล้าสมัย |
| การควบคุมสิ่งรบกวน | ถูกดึงไปหาข้อเท็จจริงที่ไม่เกี่ยวข้อง | รวมรายละเอียดที่ไม่เกี่ยวข้องบางส่วน | ใช้เฉพาะบริบทที่เกี่ยวข้องกับคำถาม |
| ความไม่แน่ใจ | เดาอย่างมั่นใจ | อ้อมค้อมแต่ยังเดา | บอกชัดเจนว่าไม่ได้ให้ข้อมูลนั้นไว้ |
| ความสามารถตรวจสอบย้อนกลับ | ไม่ให้พื้นฐาน | ระบุพื้นฐานเพียงบางส่วน | แสดงรายการบริบทที่ใช้สั้น ๆ |
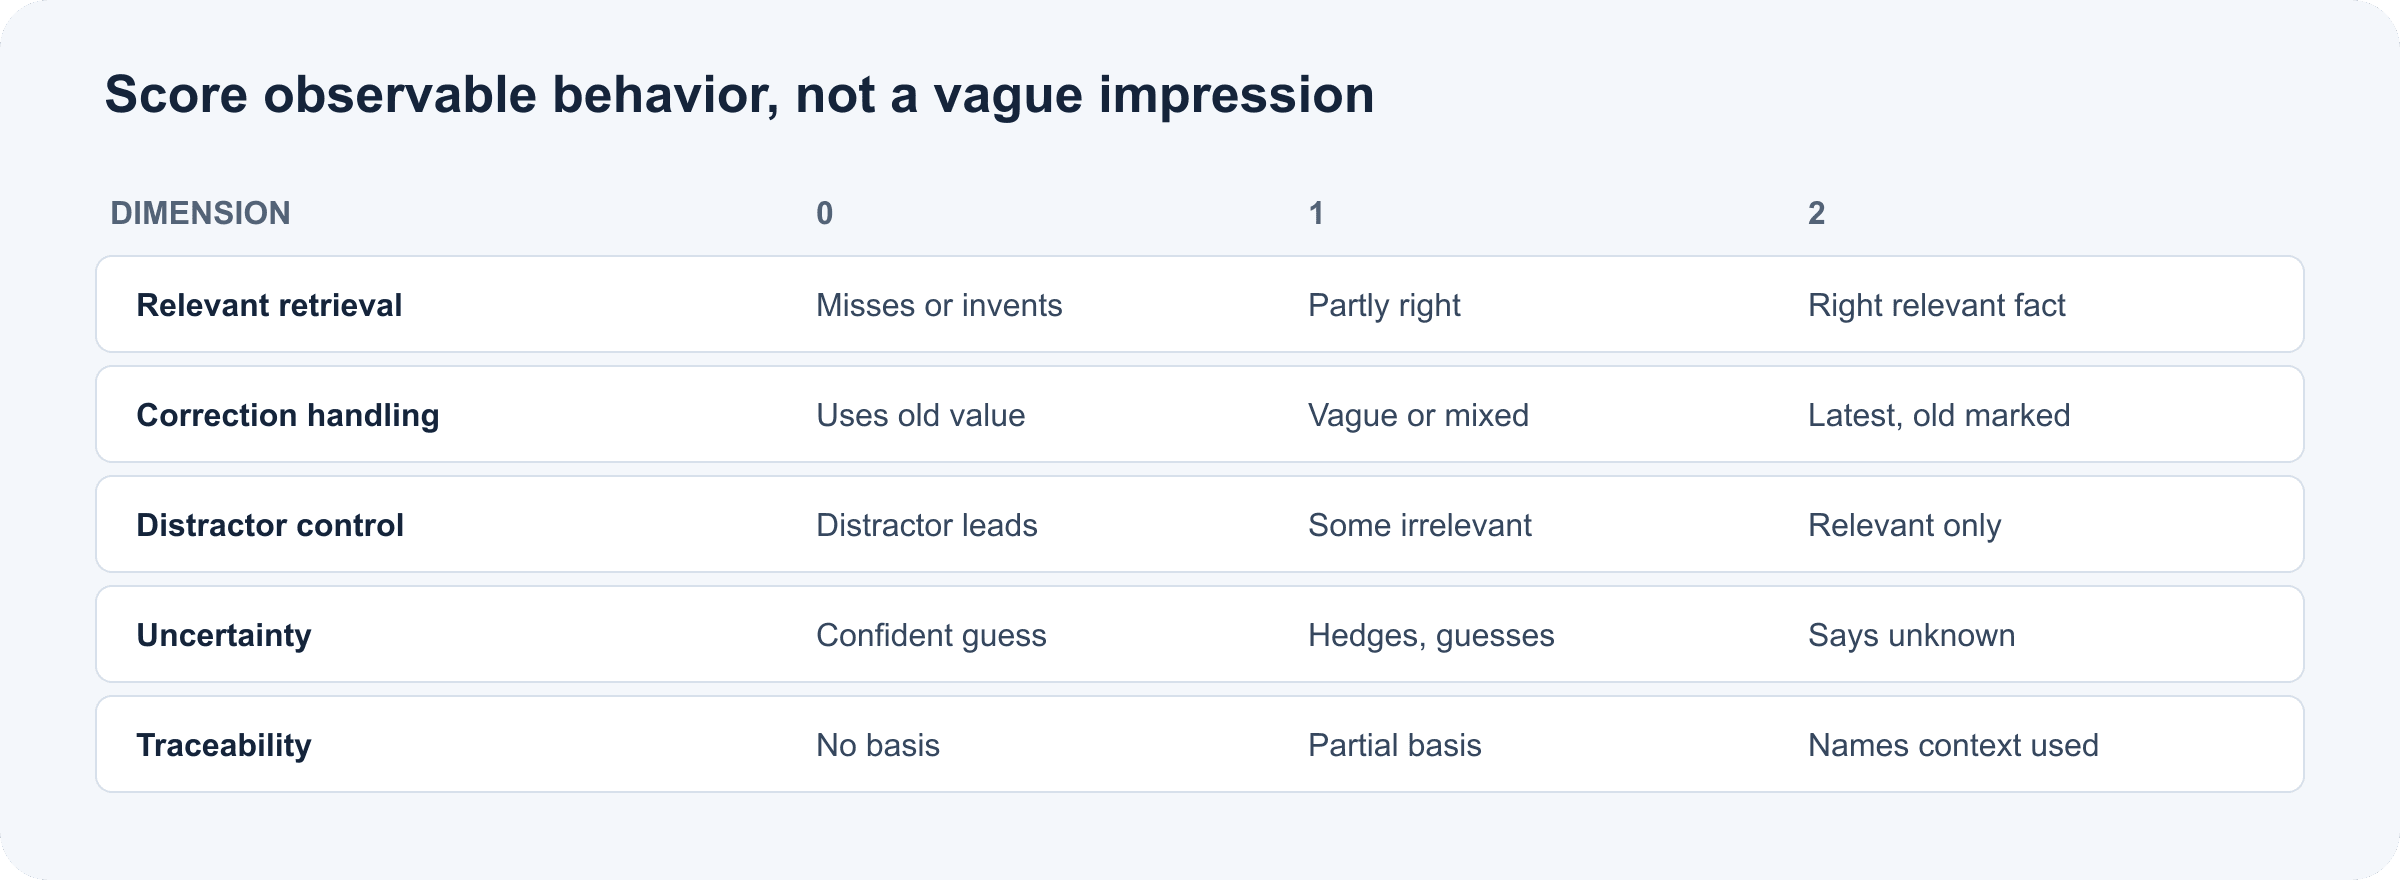
มิติการให้คะแนน Active Memory ห้ามิติตั้งแต่ศูนย์ถึงสองคะแนน พร้อมเกณฑ์ผ่านที่สังเกตได้
รูบริก 0–2 เปลี่ยนความประทับใจเชิงอัตวิสัยให้เป็นห้าการตรวจสอบที่สังเกตได้
สิบแต้มเป็นคะแนนภายในที่สะดวก ไม่ใช่เกณฑ์ที่ผ่านการตรวจสอบความใช้ได้ เก็บคะแนนแต่ละมิติไว้ เพราะคะแนนรวมอาจซ่อนความล้มเหลวร้ายแรงด้านการแก้ไขไว้เบื้องหลังการจดจำที่ดีในด้านอื่น บันทึกพรอมป์ที่ตรงตามจริงและเอาต์พุตที่ไม่ได้แก้ไข จากนั้นรันซ้ำก่อนเปลี่ยนการตัดสินใจเกี่ยวกับการดีพลอย
MemoryBench บอกอะไรคุณได้และบอกอะไรไม่ได้
การ์ดโมเดลของ Meta อธิบายว่า MemoryBench เป็นการประเมินภายในจากบทสนทนายาวและซับซ้อนขนาด 64K ถึง 100K โทเคน งานของมันรวมข้อเท็จจริงหลายรายการ บทสนทนาที่เป็นสิ่งรบกวน และเทิร์นที่ถูกแทรกซึ่งขัดแย้งกับหรืออัปเดตรายละเอียดเป้าหมายในภายหลัง ผู้ตัดสิน LLM ให้คะแนนคำตอบเทียบกับเกณฑ์ถ่วงน้ำหนักเฉพาะคำถาม นั่นเป็นบริบทที่มีประโยชน์สำหรับการเข้าใจขอบเขตของเบนช์มาร์ก แต่ไม่เหมือนกับการตั้งค่าหน่วยความจำส่วนบุคคลของผู้ใช้ที่ทำงานข้ามแชต
การ์ดโมเดลอธิบายการออกแบบงาน แต่มันไม่ได้เปลี่ยนแบบฝึกหัด 10 นาทีนี้ให้กลายเป็นการจำลอง คะแนนที่เผยแพร่ของ Meta เป็นหลักฐานเกี่ยวกับการตั้งค่าการประเมินที่รายงานไว้ การรันของคุณตอบคำถามเชิงปฏิบัติที่แคบกว่า: พื้นผิวผลิตภัณฑ์ การกำหนดค่า และบัญชีนี้โดยเฉพาะ ดึงข้อเท็จจริงที่เวิร์กโฟลว์ของคุณต้องการได้หรือไม่? ไม่มีสิ่งใดสิ่งหนึ่งเพียงลำพังที่ยืนยันหน่วยความจำที่เชื่อถือได้สำหรับผู้ใช้หรืองานทุกแบบ
Muse Wonder กับ Muse Wonder Full: ทดสอบที่ไหน
สองตัวแปรนี้มีเส้นทางการเข้าถึงที่ไม่เหมือนกัน เอกสารสำหรับนักพัฒนาปัจจุบันของ Meta กล่าวว่า Muse Wonder (muse-wonder-1.0) ใช้งานได้บน Model API และใน Muse Code Muse Wonder Full ใช้งานได้เฉพาะใน Muse Code บนแผน Power Usage และ Maximum Usage การตั้งค่า reasoning effort ของ Muse Wonder เป็น “max” ไม่ได้เปลี่ยนมันเป็น Wonder Full
| ตัวแปร | การเข้าถึงตามเอกสาร | สิ่งที่ต้องบันทึก |
|---|---|---|
| Muse Wonder | Model API และ Muse Code | API model ID หรือพื้นผิว Muse Code พร้อมทั้งระบุว่ามีการจัดหาบริบทก่อนหน้าหรือไม่ |
| Muse Wonder Full | Muse Code บนแผน Power Usage และ Maximum Usage | แผน ตัวแปรที่เลือก และการตั้งค่าหน่วยความจำที่มีในพื้นผิวนั้น |
รันโปรไฟล์สมมติเดียวกันแยกต่างหากในแต่ละพื้นผิวที่มีให้ใช้ อย่าเปรียบเทียบการทดสอบ Muse Code ที่สามารถดึงรายละเอียดโปรไฟล์ที่บันทึกไว้ได้ กับการเรียก API แบบไม่มีสถานะที่ได้รับเพียงพรอมป์ปัจจุบัน เพราะนั่นจะเป็นการเปรียบเทียบระบบที่ต่างกัน ไม่ใช่แค่โมเดลสองตัวแปร
ความเป็นส่วนตัวและการทดสอบที่ทำซ้ำได้
ใช้ความชอบ วันที่ และรายละเอียดโปรเจกต์ที่กุขึ้น ก่อนลองใช้ข้อมูลจริง ให้ตรวจสอบการควบคุมหน่วยความจำ เส้นทางการลบ ข้อมูลการเก็บรักษา และการตั้งค่าการใช้ข้อมูลของผลิตภัณฑ์ เอกสาร API ของ Meta กล่าวว่าเนื้อหาในโหมด Standard ไม่ถูกใช้เพื่อฝึกโมเดลของ Meta; Muse Code ยังมีโหมด Contributor ซึ่งเปิดเป็นค่าเริ่มต้นและอาจใช้เนื้อหาเพื่อการฝึก เว้นแต่จะปิด ตรวจสอบการตั้งค่าและข้อกำหนดปัจจุบันของผลิตภัณฑ์ที่คุณใช้ แทนที่จะสันนิษฐานว่าทุกพื้นผิวจัดการข้อมูลเหมือนกัน
สำหรับ API ให้แยกโมเดลออกจากชั้นหน่วยความจำของแอปพลิเคชันของคุณ ฐานข้อมูล ระบบดึงข้อมูล หรือประวัติพรอมป์ที่ซอฟต์แวร์ของคุณส่งไปอาจเป็นสิ่งที่ทำหน้าที่จดจำ บันทึกว่าแอปพลิเคชันดึงอะไรได้และส่งอะไรเข้าไปในแต่ละคำขอ โดยเก็บบันทึกการทดสอบเป็นข้อมูลสังเคราะห์
ทีมสามารถเปลี่ยนสามรอบให้เป็นชุดการประเมินที่มีเวอร์ชันขนาดเล็กได้ เก็บโปรไฟล์ข้อเท็จจริง การแก้ไข สิ่งรบกวน ตัวแปรโมเดล การตั้งค่าผลิตภัณฑ์ ความล่าช้า และคำตอบดิบให้คงที่ รันซ้ำหลังการเปลี่ยนแปลงการกำหนดค่าหรือโมเดล และทบทวนความล้มเหลวตามมิติ สำหรับทีมที่เปรียบเทียบโมเดลโฮสต์อยู่แล้วในฮาร์เนสที่ทำซ้ำได้ Atlas Cloud มีแค็ตตาล็อกและ คู่มือ unified LLM API คุณสามารถเรียกดู ไดเรกทอรีโมเดล เพื่อการเปรียบเทียบแยกต่างหากได้ ปัจจุบันไดเรกทอรีไม่ได้แสดง Muse Wonder และการใช้โมเดลอื่นที่นั่นจะทดสอบเฉพาะบริบทที่จัดหาให้โมเดลนั้นอย่างชัดเจนเท่านั้น เว้นแต่แอปพลิเคชันของคุณจะเพิ่มชั้นหน่วยความจำ
คำถามที่พบบ่อย
ฉันจะทดสอบ Active Memory ของ Muse Wonder ข้ามแชตได้อย่างไร?
ให้ข้อเท็จจริงสมมติในบทสนทนาหนึ่ง จากนั้นถามเกี่ยวกับรายละเอียดที่เกี่ยวข้องในบทสนทนาใหม่ รวมการแก้ไขและข้อเท็จจริงที่ขาดหายไป และบันทึกพื้นผิวผลิตภัณฑ์และการตั้งค่าหน่วยความจำ
Muse Wonder จดจำการแก้ไข หรือจดจำเฉพาะรายละเอียดก่อนหน้า?
คำอธิบาย MemoryBench ของ Meta รวมเทิร์นที่อัปเดตหรือขัดแย้งกับรายละเอียดก่อนหน้า การทดสอบการแก้ไขของคุณเองตรวจสอบว่าการตั้งค่าผลิตภัณฑ์ปัจจุบันทำตามการอัปเดตหรือไม่ ให้ทำซ้ำเพราะผลลัพธ์เพียงครั้งเดียวไม่ได้ยืนยันพฤติกรรมที่สม่ำเสมอ
การทดสอบประวัติแชตนี้เหมือนกับ MemoryBench ของ Meta หรือไม่?
ไม่ใช่ Meta อธิบายว่า MemoryBench เป็นเบนช์มาร์กบริบทยาวภายในที่ใช้บทสนทนาขนาด 64K ถึง 100K โทเคน สิ่งรบกวน ข้อเท็จจริงที่ขัดแย้งหรือถูกอัปเดต และผู้ตัดสิน LLM การตรวจสอบสั้น ๆ นี้เป็นการทดสอบแบบ smoke test ภาคปฏิบัติ ไม่ใช่การจำลอง
ฉันสามารถทดสอบ Muse Wonder Active Memory ผ่าน API ได้หรือไม่?
คุณสามารถทดสอบการจดจำบริบทของโมเดล API ที่ไปถึงคำขอได้ สำหรับความคงอยู่ข้ามคำขอ ให้ตรวจสอบว่า API หรือแอปพลิเคชันของคุณจัดเก็บและส่งอะไร การมีหน้าต่างบริบทขนาดใหญ่ไม่ได้แสดงในตัวเองว่าคำขอที่แยกจากกันแชร์หน่วยความจำกัน
ฉันจะแยกหน่วยความจำของโมเดลออกจากหน่วยความจำที่แอปจัดเก็บได้อย่างไร?
ตรวจสอบคำขอแบบครบถ้วนที่ส่งไปยังโมเดล หากแอปพลิเคชันของคุณแทรกโปรไฟล์ โน้ตที่ดึงมา หรือบทสนทนาก่อนหน้า ชั้นซอฟต์แวร์นั้นเป็นผู้จัดหาหน่วยความจำ เปรียบเทียบกับการรันแบบควบคุมที่ละเว้นสิ่งเหล่านั้น เมื่อเหมาะสม
การใช้ข้อมูลส่วนบุคคลในการทดสอบ Active Memory ปลอดภัยหรือไม่?
ใช้ข้อมูลสมมติสำหรับการทดสอบ หากภายหลังคุณประเมินข้อมูลจริง ให้ตรวจสอบการตั้งค่าหน่วยความจำ การลบ การเก็บรักษา และการใช้ข้อมูลของผลิตภัณฑ์นั้นก่อน
muse wonder active memory test จะมีประโยชน์ที่สุดเมื่อมันเปิดเผยว่าขั้นตอนใดล้มเหลว: การเข้าถึงบริบทก่อนหน้า การดึงข้อมูล การแก้ไข การกรอง หรือความไม่แน่ใจ บันทึกการรันดิบไว้ จากนั้นทำซ้ำภายใต้การตั้งค่าที่ตรงกับสิ่งที่คุณวางแผนจะเชื่อถือ
แหล่งที่มา: ประกาศ Muse Wonder ของ Meta (12 ตุลาคม 2026); เอกสารโมเดล Meta Model API (เข้าถึงเมื่อ 15 ตุลาคม 2026); การ์ดโมเดล Muse Wonder (ตุลาคม 2026).





