

คะแนนนำในการทดสอบ benchmark อาจดูเด็ดขาดจนกระทั่งโมเดลเดียวกันพลาดข้อกำหนดในการรันครั้งถัดไป การทดสอบความน่าเชื่อถือของ Muse Wonder ที่มีประโยชน์จะถามคำถามที่แคบกว่า: โมเดลทำงานของคุณให้เสร็จตามมาตรฐานของคุณ ซ้ำ ๆ ภายใต้เงื่อนไขเดียวกันหรือไม่?
หลักฐานช่วงแรกยังคละกัน เพราะการทดสอบวัดสิ่งต่างกัน ชุดงานวันเปิดตัวชุดหนึ่งให้คะแนน Muse Wonder มาตรฐานสูงมากหลังจากรันหนึ่งครั้งต่องาน การประเมินอีกรายการพบจุดแข็งในการวิเคราะห์งานวิจัย ควบคู่กับจุดอ่อนในการออกแบบแบบสำรวจ ข้อความด้านการขาย และเลย์เอาต์สไลด์ ไม่มีผลลัพธ์ใดพิสูจน์ว่าโมเดลจะจัดการ codebase หรือเวิร์กโฟลว์เอเจนต์ของคุณได้สม่ำเสมอเพียงใด
ประเด็นสำคัญ
- มอง benchmark วันเปิดตัวเป็นสัญญาณความสามารถ ไม่ใช่การรับประกันระดับโปรดักชัน
- Muse Wonder และ Muse Wonder Full เป็นตัวแปรแยกกัน ควรแยกผลลัพธ์ออกจากกัน
- วัดอัตราผ่าน ความสามารถทำซ้ำ ความสมบูรณ์ของงาน และการกู้คืน เป็นผลลัพธ์ที่แตกต่างกัน
- เริ่มจากงานจริง 10 ถึง 20 งาน ตรึงการตั้งค่า และทำซ้ำงานสำคัญอย่างน้อยสามครั้ง
- เลือกเกณฑ์ตัดสินจากต้นทุนของคำตอบที่ผิดและกระบวนการตรวจทานโดยมนุษย์ของคุณ
Muse Wonder เชื่อถือได้หรือไม่? คำตอบแบบสั้น
หลักฐานที่มี ณ วันที่ 15 ตุลาคม 2026 สนับสนุนการประเมินทีละงาน ไม่ใช่คำตัดสินความน่าเชื่อถือแบบสากล Muse Wonder ทำได้ดีในการตรวจสอบช่วงแรกบางรายการ ขณะที่การรันอื่นเผยให้เห็นข้อผิดพลาดหรืองานนำเสนอที่ยังต้องตรวจทาน งานศึกษาเหล่านี้ต่างกันทั้งพรอมป์ต์ การตั้งค่าการให้เหตุผล ผู้ให้คะแนน ขนาดตัวอย่าง และจำนวนครั้งที่ลอง
(Meta, 12 ตุลาคม 2026) กล่าวว่า Muse Wonder และ Muse Wonder Full ถูกสร้างขึ้นสำหรับงานเอเจนต์ทั้งระดับมืออาชีพและส่วนบุคคล โดยมีฟีเจอร์ที่เรียกว่า Active Memory และ Active Focus สิ่งเหล่านี้เป็นคำกล่าวอ้างของผลิตภัณฑ์เกี่ยวกับพฤติกรรมที่ตั้งใจไว้ คำกล่าวอ้างว่าโมเดลสามารถกู้คืนจากข้อผิดพลาดได้เป็นเหตุผลให้ทดสอบการกู้คืนในเวิร์กโฟลว์ของคุณเอง ไม่ใช่หลักฐานว่าจะกู้คืนได้อย่างน่าเชื่อถือ
แยก Wonder มาตรฐานออกจาก Wonder Full Meta ระบุ Muse Wonder มาตรฐานสำหรับ Model API และ Muse Code ส่วน Full มีให้ผ่านการสมัครสมาชิก Muse Code การรัน Wonder มาตรฐานด้วยการตั้งค่าการให้เหตุผลสูงขึ้นไม่ได้ทำให้กลายเป็น Full
สำหรับการตัดสินใจที่คุณสามารถปกป้องได้ ให้ทดสอบตัวแปรและเส้นทางที่คุณตั้งใจจะใช้งานจริง นับว่างานสำเร็จก็ต่อเมื่อเป็นไปตามเกณฑ์การยอมรับที่เขียนไว้ และสามารถตรวจสอบผลลัพธ์ได้
การทดสอบความน่าเชื่อถือของ Muse Wonder ควรวัดอะไร
ความแม่นยำและความสม่ำเสมอแตกต่างกัน
อัตราผ่านวัดว่ามีกี่ครั้งที่ผ่านเกณฑ์ที่กำหนด ความสม่ำเสมอวัดว่าการรันงานเดิมซ้ำ ๆ ให้ผลลัพธ์ที่ยอมรับได้ทุกครั้งหรือไม่ โมเดลอาจมีอัตราผ่านสูงแต่ยังแปรผันในแบบที่ส่งผลต่อเวิร์กโฟลว์ของคุณ
ติดตามสี่มิติแยกจากกัน:
| ตัววัด | สิ่งที่ต้องบันทึก | ตัวอย่างการตรวจสอบ |
|---|---|---|
| ความแม่นยำ | จำนวนครั้งที่ผ่านเกณฑ์ | ยอดรวมที่สกัดได้ตรงกับเอกสารต้นทางหรือไม่? |
| ความสม่ำเสมอ | การลองซ้ำผ่านและสอดคล้องกันหรือไม่ | การรันสามครั้งรักษาข้อจำกัดที่จำเป็นเหมือนเดิมหรือไม่? |
| คุณภาพความสมบูรณ์ | สิ่งส่งมอบที่ร้องขอมาครบทุกอย่างหรือไม่ | ไฟล์ การอ้างอิง และฟิลด์ที่ร้องขอถูกรวมครบหรือไม่? |
| การกู้คืน | การรันกลับมาทำต่ออย่างถูกต้องหลังเกิดข้อขัดข้องหรือไม่ | รายงานความล้มเหลวของเครื่องมือ ลองใหม่อย่างปลอดภัย แล้วตรวจสอบสถานะสุดท้ายหรือไม่? |
คำตอบที่ฟังดูสมบูรณ์ไม่จำเป็นต้องสมบูรณ์จริง การเปลี่ยนแปลงโค้ดต้องมีเทสต์ สรุปงานวิจัยต้องมีแหล่งที่ตรวจสอบย้อนกลับได้ และการรันเอเจนต์ต้องมีหลักฐานว่าการกระทำสุดท้ายเกิดขึ้นจริง
แยกความล้มเหลวของโมเดลออกจากความล้มเหลวของเวิร์กโฟลว์
บันทึกบริบทให้เพียงพอเพื่อแยกข้อผิดพลาดของโมเดลออกจากปัญหาการให้บริการหรือเครื่องมือ อย่างน้อยให้บันทึกตัวแปรและเวอร์ชันของโมเดล การตั้งค่าการให้เหตุผล พรอมป์ต์ การกำหนดค่าเครื่องมือ วันที่ เวลารัน ต้นทุนโทเคนหรืองาน และเอาต์พุตดิบ
จัดประเภทความล้มเหลวก่อนให้คะแนน:
- Model: ข้อเท็จจริงไม่ถูกต้อง การให้เหตุผลแย่ หรือพลาดข้อกำหนด
- Tool: การเรียก API ล้มเหลว อาร์กิวเมนต์เครื่องมือไม่ถูกต้อง หรือผลลัพธ์ผิดจากระบบภายนอก
- Serving: หมดเวลา ถูกขัดจังหวะ หรือปลายทางไม่พร้อมใช้งาน
- Evaluation: เกณฑ์ไม่ชัดเจน หรือการตรวจสอบที่ไม่สามารถแยกงานที่ยอมรับได้ออกจากงานที่ยอมรับไม่ได้
ถ้าคุณรวมทั้งสี่ประเภทเป็นอัตราความล้มเหลวเดียว คุณจะไม่รู้ว่าต้องแก้อะไร
การทดสอบ Muse Wonder ในปัจจุบันแสดงอะไร
การเปรียบเทียบ benchmark ที่ Meta เผยแพร่เป็นหลักฐานจากผู้ขายเกี่ยวกับประสิทธิภาพบน benchmark ไม่เหมือนกับการประเมินเวิร์กโฟลว์ที่รันโดยอิสระ การทดสอบอิสระก็มีข้อจำกัดเช่นกัน: ชุดงานสาธารณะขนาดเล็ก การลองหนึ่งครั้ง เส้นทางโมเดลเฉพาะ หรือคะแนนความชอบของมนุษย์ ตอบได้เพียงคำถามแคบ ๆ
ตารางด้านล่างแยกหลักฐานตามแหล่งที่มาและขอบเขต เป็นแนวทางว่าผลลัพธ์แต่ละรายการรองรับอะไรได้ ไม่ใช่คะแนนรวม
| แหล่งหลักฐาน | สิ่งที่ทดสอบ | วันที่และการตั้งค่า | สิ่งที่บอกคุณได้ | ข้อจำกัดหลัก |
|---|---|---|---|---|
| ประกาศของ Meta และเอกสารเกี่ยวกับโมเดล | benchmark ความสามารถและฟีเจอร์เอเจนต์ที่ตั้งใจไว้ | ประกาศเมื่อ 12 ตุลาคม 2026; การเปรียบเทียบที่ผู้ขายรายงาน | Meta เน้นความสามารถใดและเปิดตัวตัวแปรใด | การทดสอบของผู้ขายไม่ได้พิสูจน์ความสามารถทำซ้ำในเวิร์กโฟลว์ของคุณ |
| (Spring Prompt, 13 ตุลาคม 2026) | แบบสำรวจ รายการสินค้า สไลด์ การวางแผนโฆษณา หมากรุก และการค้นหาด้วยภาพ | 13 ตุลาคม; โมเดล API มาตรฐาน โดยทั่วไปใช้การให้เหตุผลระดับกลาง; งานสาธารณะ | ประสิทธิภาพแตกต่างตามงาน; การประเมินบางรายการมีการรันรายการสินค้าซ้ำ | งานส่วนใหญ่เป็นตัวอย่างขนาดเล็ก; ผลลัพธ์จำนวนมากมาจากการรันหนึ่งครั้งต่องาน; ไม่ใช่การทดสอบการเขียนโค้ดหรือ Muse Code |
| (Quantslant, 12 ตุลาคม 2026) | 23 งาน ครอบคลุมเอเจนต์ การเขียนโค้ด การเขียน การให้เหตุผล และเอกสารยาวหนึ่งชิ้น | 12 ตุลาคม; โมเดลมาตรฐานผ่าน OpenRouter การให้เหตุผลระดับต่ำ; หนึ่งครั้งต่อหนึ่งงาน | โมเดลผ่านชุดงานที่กำหนดนั้นในอัตราสูงภายใต้การตั้งค่านั้น | การรันครั้งเดียวไม่สามารถวัดความสม่ำเสมอระหว่างการรันได้; ผลลัพธ์ที่ใกล้ 100% ต้องตรวจสอบในระดับงาน |
| โพสต์ในชุมชน | ปฏิกิริยาต่อการเขียนโค้ด เอเจนต์ และ benchmark รายบุคคล | โพสต์ช่วงเปิดตัว; ผู้ใช้และงานที่เลือกเอง | เบาะแสที่มีประโยชน์สำหรับสิ่งที่จะทดสอบต่อไป | เกร็ดเล็กเกร็ดน้อยและคะแนนโหวตไม่ใช่อัตราผ่านที่วัดได้ |
ความต่างของแหล่งข้อมูลมีความสำคัญ Quantslant รายงาน 99.7% จากชุดงาน 23 งาน โดยรันหนึ่งครั้งต่องานและการตั้งค่าการให้เหตุผลระดับต่ำ ยังระบุว่า unit test หนึ่งรายการล้มเหลวในงานเขียนโค้ดแปลงตัวเลขเป็นคำ ผลลัพธ์นั้นเป็นหลักฐานเกี่ยวกับชุดทดสอบเฉพาะนั้น ไม่ใช่หลักฐานว่า 99.7% ของงานประจำวันจะผ่าน หรือการรันซ้ำจะสอดคล้องกัน
Spring Prompt รายงานภาพที่หลากหลายกว่าสำหรับ Wonder มาตรฐานที่ค่าเริ่มต้นของ API เมื่อวันที่ 13 ตุลาคม คะแนนการวิเคราะห์งานวิจัยอยู่ที่ 93.6/100 จากงานสาธารณะเก้างาน ขณะที่มีเพียงสามในเก้าแผนแบบสำรวจที่ผ่านการตรวจสอบทั้งหมด สำหรับรายการสินค้า สัดส่วนที่ถือว่าพร้อมเผยแพร่ได้อย่างน่าเชื่อถือจากการทำซ้ำสามครั้งคือ 66.1% สำหรับบรีฟเชิงข้อเท็จจริง และ 51.8% สำหรับบรีฟด้านการขาย สไลด์หกชุดมีห้าชุดที่ต้องแก้เลย์เอาต์ และหนึ่งชุดถูกตัดสินว่านำเสนอได้ สิ่งเหล่านี้เป็นตัววัดแยกกันโดยมีตัวหารแยกกัน ไม่ใช่ส่วนประกอบของคะแนนรวมเดียว
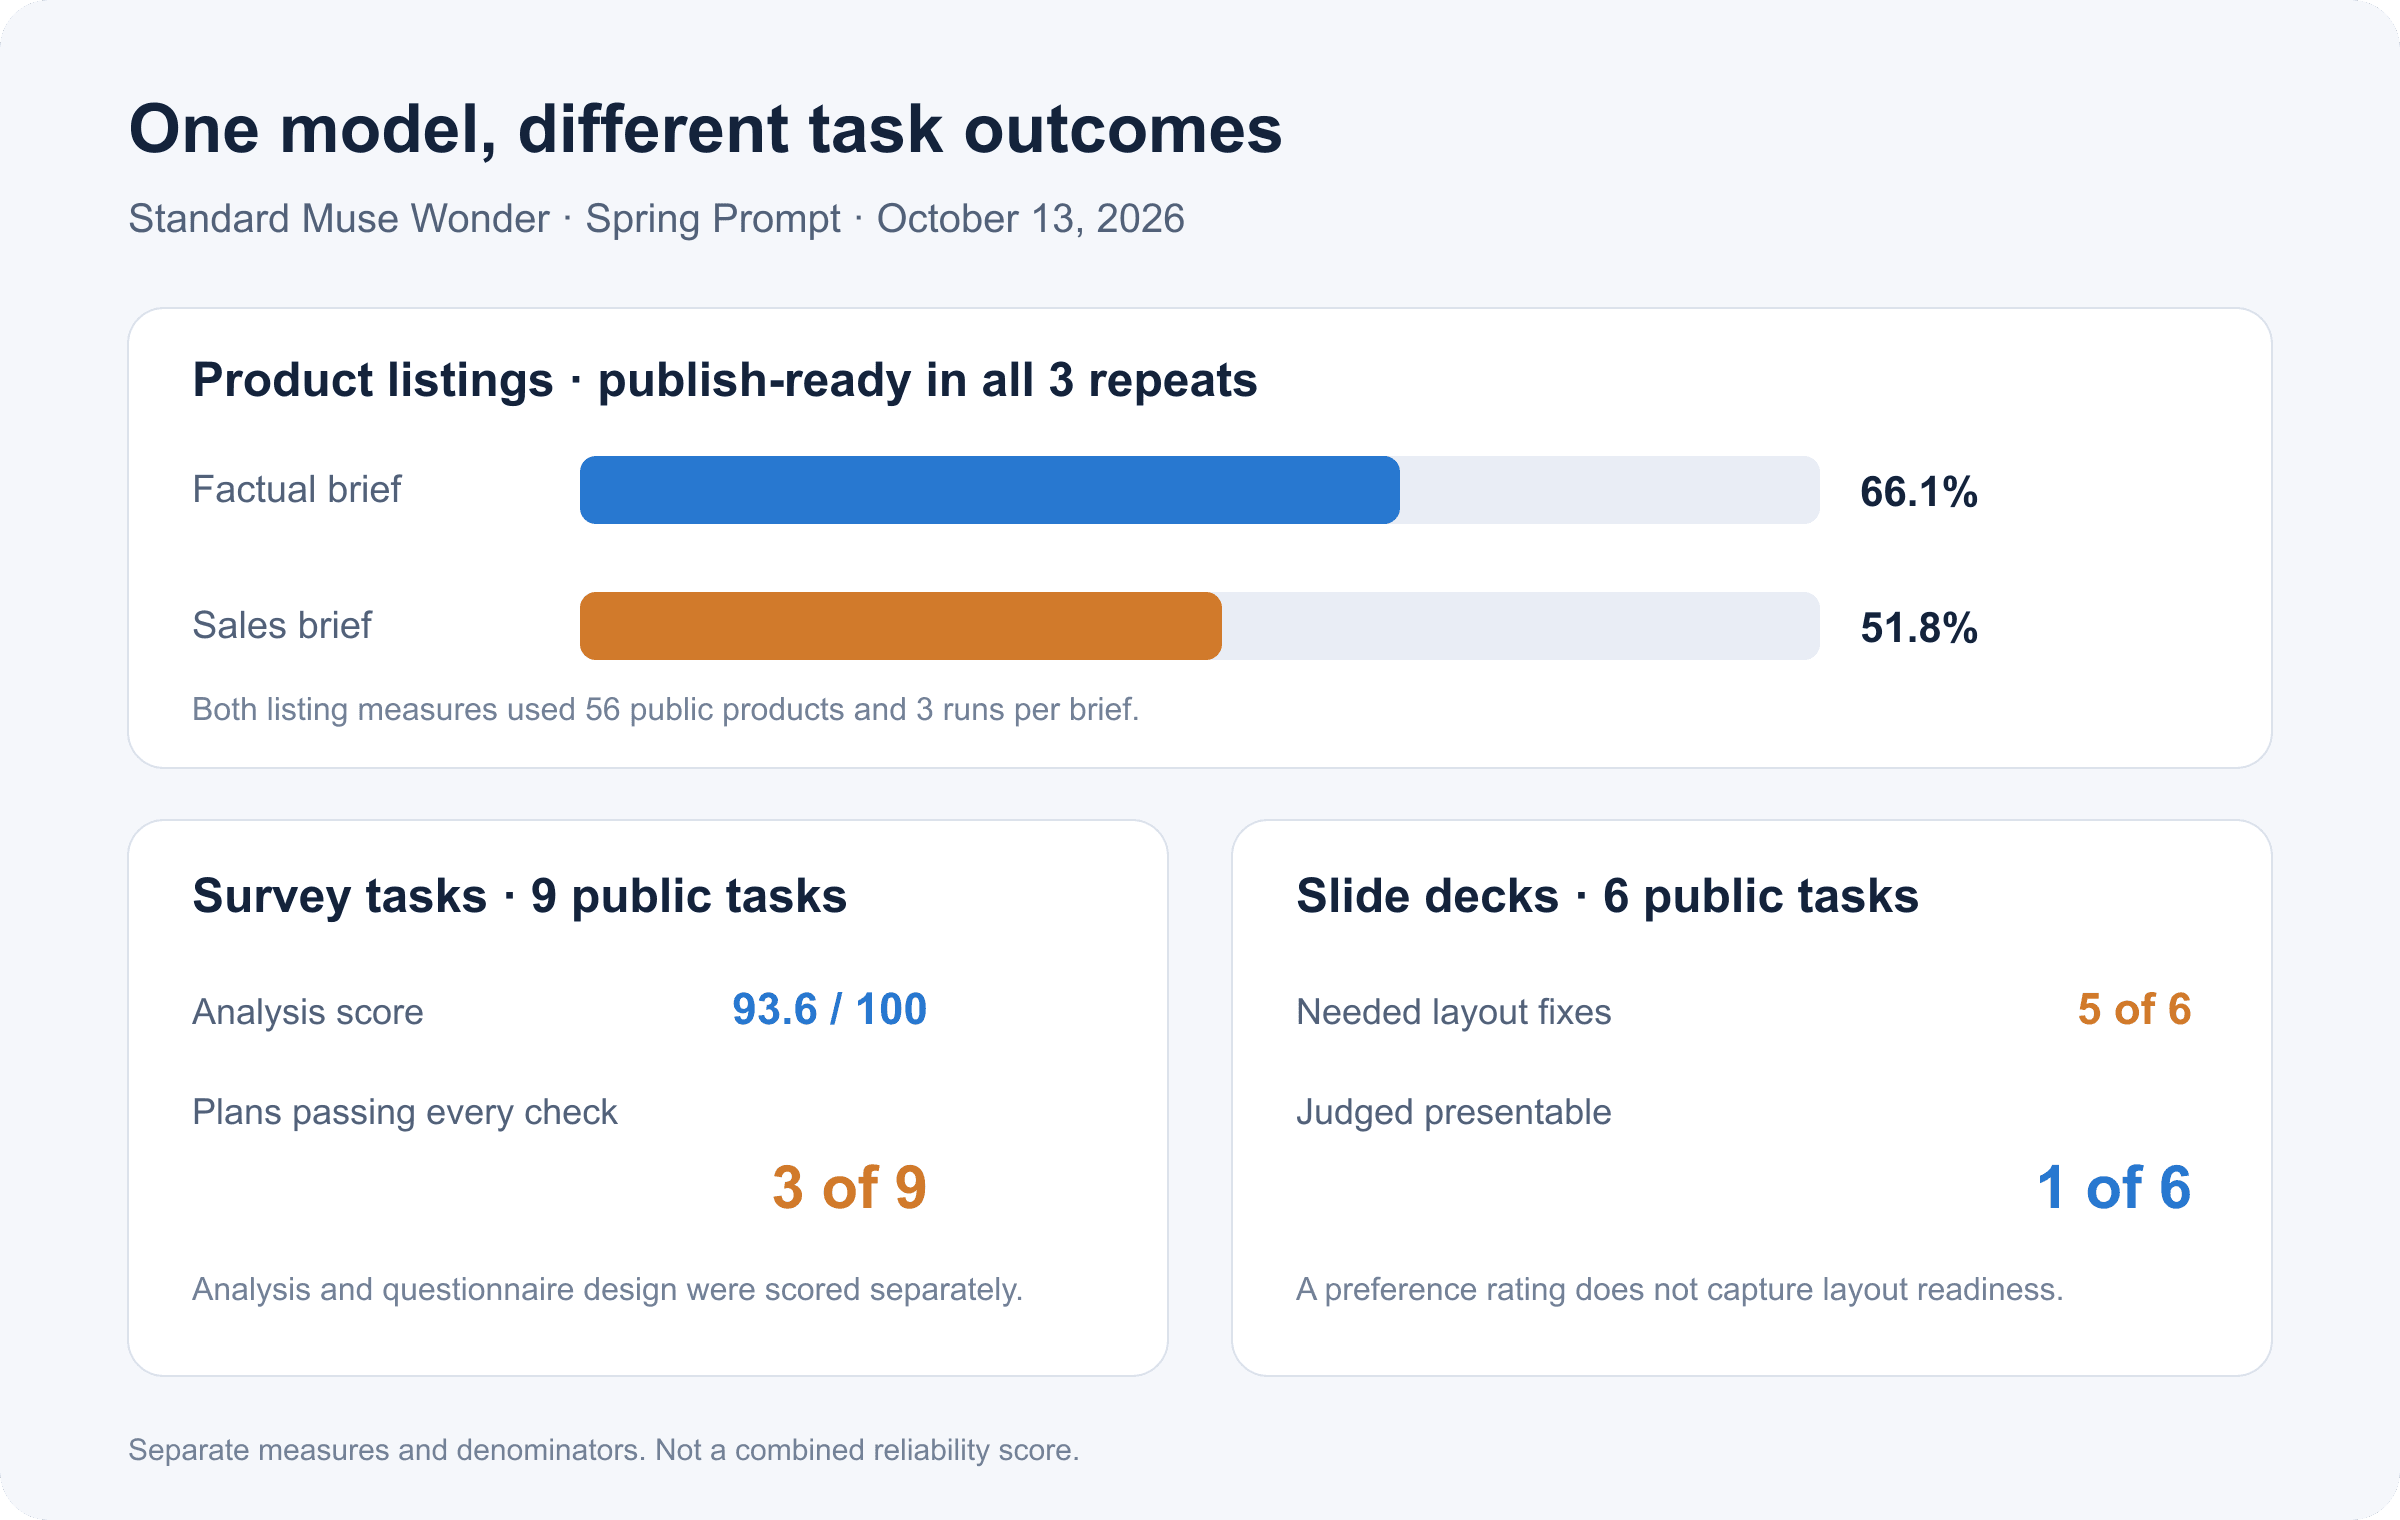
ผลลัพธ์ Muse Wonder มาตรฐานของ Spring Prompt วันที่ 13 ตุลาคม 2026: อัตราผ่านรายการสินค้าที่ทดสอบซ้ำ ผลการวิเคราะห์แบบสำรวจ และผลการตรวจสไลด์
ผลลัพธ์งานอิสระจากการประเมินหนึ่งครั้ง ตัววัดใช้ตัวหารต่างกันและแสดงแยกกัน ไม่ได้รวมเป็นคะแนนเดียว
การทดสอบของ Spring Prompt ไม่ได้วัดการเขียนโค้ด หน่วยความจำถาวร หรือ Muse Code ดังนั้นการเปรียบเทียบของจึงไม่สามารถตัดสินได้ว่า Wonder เชื่อถือได้สำหรับการเขียนโค้ดหรือ Full ทำงานได้ดีกว่า แต่แสดงให้เห็นว่าทำไมป้ายกำกับกว้าง ๆ เพียงหนึ่งป้ายจึงซ่อนความแตกต่างสำคัญระหว่างงาน
บทความเปิดตัวของ Meta กล่าวว่า Muse Wonder มาตรฐานพร้อมใช้งานผ่าน Meta Model API และ Muse Code ส่วน Wonder Full พร้อมใช้งานสำหรับผู้สมัครสมาชิก Muse Code อธิบาย Active Memory และ Active Focus ว่าเป็นฟีเจอร์สำหรับเก็บรายละเอียดที่มีประโยชน์และทำงานต่อผ่านข้อผิดพลาด คำอธิบายเหล่านั้นช่วยกำหนดกรณีทดสอบ แต่บทความเปิดตัวไม่ใช่การศึกษาแบบรันซ้ำโดยอิสระ
สำหรับคำกล่าวอ้างด้านการเขียนโค้ดและการสร้าง 3D ที่พูดถึงในเธรดชุมชนช่วงสัปดาห์เปิดตัว ให้ถือว่าโพสต์เป็นสมมติฐาน เปลี่ยนข้อร้องเรียนเฉพาะให้เป็นงานที่ทำซ้ำได้ และตรวจสอบเอาต์พุต อย่าแปลงคอมเมนต์หรือคะแนนโหวตให้เป็นอัตราความสำเร็จ
วิธีรันการทดสอบความน่าเชื่อถือของ Muse Wonder ให้ทำซ้ำได้
1. สร้างชุดงานเล็ก ๆ จากงานจริง
เลือก 10 ถึง 20 งานที่ทีมของคุณคาดหวังจริง ๆ ว่าโมเดลจะจัดการได้ แบ่งเป็นหมวดหมู่ เช่น การเขียนโค้ด การสกัดข้อเท็จจริง การทำตามคำสั่ง บริบทแบบยาว และการใช้เครื่องมือ เลือกงานที่มีการทดสอบเชิงวัตถุวิสัย คำตอบอ้างอิง หรือเกณฑ์ชัดเจน
รวมกรณีขอบแบบสมจริง: อินพุตขาดหาย ข้อกำหนดขัดแย้งกัน เครื่องมือไม่พร้อมใช้งาน และงานที่ควรกระตุ้นให้ถามเพื่อความชัดเจน อย่าใส่ข้อมูลอ่อนไหวหรือข้อมูลที่มีกฎกำกับ เว้นแต่กระบวนการที่ได้รับอนุมัติของคุณอนุญาต
2. ตรึงพรอมป์ต์ โมเดล และการตั้งค่า
จดพรอมป์ต์และคำสั่งระบบแบบตรงตามจริง บันทึกชื่อและเวอร์ชันของโมเดล ระดับการให้เหตุผล เครื่องมือ บริบทที่ให้ วันที่ และเวลาจำกัดใด ๆ อย่าเปรียบเทียบ Wonder มาตรฐานกับ Full ราวกับเป็นโมเดลเดียวกัน
พรอมป์ต์ทดสอบที่มีประโยชน์สามารถขอให้โมเดลแสดงหลักฐานและระบุข้อกำหนดที่ไม่สามารถทดสอบได้:
อ่านสเปกและ implementation ที่แนบมา ส่งคืนเฉพาะ: (1) ข้อกำหนดแต่ละข้อที่ทำเครื่องหมาย PASS, FAIL หรือ NOT TESTABLE; (2) หลักฐานแบบตรงตามจริงสำหรับแต่ละสถานะ; (3) ข้อกำหนดที่ขาดหายไป; (4) การทดสอบขั้นต่ำที่ทำซ้ำได้สำหรับทุก FAIL อย่ากล่าวอ้างว่าเทสต์ผ่าน เว้นแต่คุณชี้ไปที่เอาต์พุตของเทสต์นั้นได้
นี่คือข้อมูลนำเข้าสำหรับการประเมิน ไม่ใช่การรับประกันว่าโมเดลจะทำตาม ให้คะแนนคำตอบที่ได้ และตรวจสอบเอาต์พุตเทสต์ที่อ้างว่ามีอย่างอิสระ
3. ทำซ้ำงานและให้คะแนนทุกครั้งที่ลอง
รันงานที่ส่งผลกระทบสูงแต่ละงานอย่างน้อยสามครั้งด้วยการตั้งค่าเดิม ถ้างบประมาณอนุญาตให้ลองเพียงครั้งเดียว ให้ติดป้ายผลลัพธ์ว่าเป็นตัวอย่างเริ่มต้น ไม่ใช่ผลลัพธ์ด้านความสม่ำเสมอ เก็บคำตอบดิบแต่ละครั้งไว้ อย่ารายงานเฉพาะอันที่ดีที่สุด
ใช้หนึ่งแถวต่อการลองหนึ่งครั้ง รักษากฎการยอมรับให้คงที่ในทุกการรัน
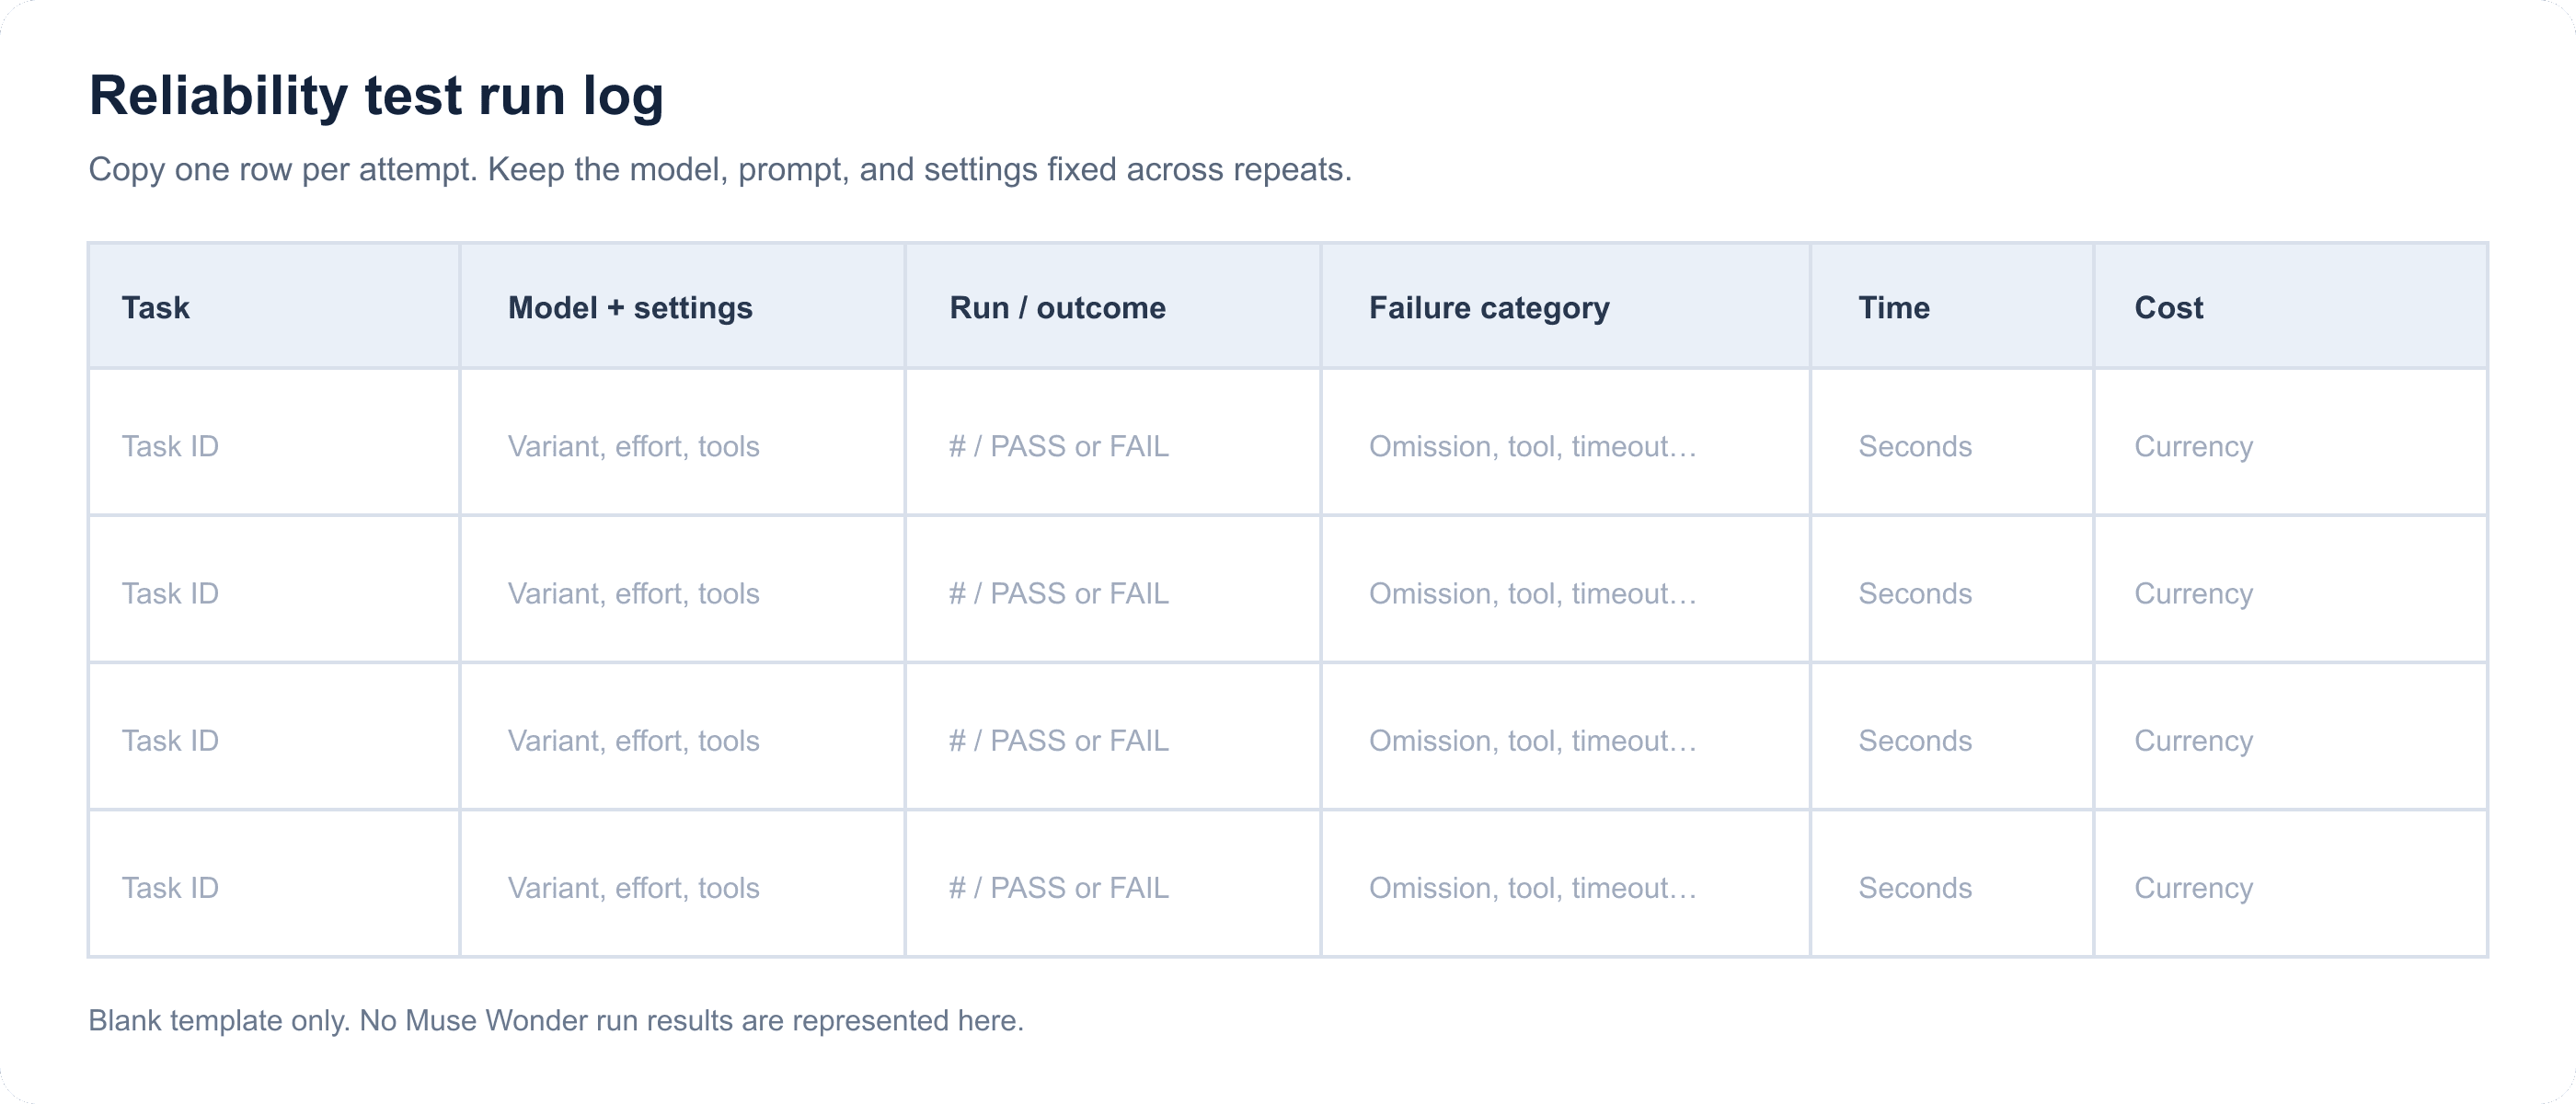
บันทึกการทดสอบความน่าเชื่อถือของ Muse Wonder แบบว่าง แสดงฟิลด์สำหรับงาน โมเดล การรัน ผลลัพธ์ ข้อผิดพลาด เวลา และค่าใช้จ่าย
เทมเพลตบันทึกว่างที่ใช้ซ้ำได้ กรอกหนึ่งแถวต่อการลองหนึ่งครั้ง; ไม่มีผลลัพธ์ Muse Wonder ที่วัดได้อยู่ในนั้น
4. เก็บบันทึกความล้มเหลวและตรวจสอบการกู้คืน
ใช้หมวดหมู่เฉพาะ: ข้อผิดพลาดด้านข้อเท็จจริง การละเว้น เทสต์โค้ดล้มเหลว ข้อผิดพลาดของเครื่องมือ หมดเวลา ข้อกล่าวอ้างว่าทำเสร็จโดยไม่มีหลักฐานรองรับ หรือรูปแบบไม่ตรงกัน สำหรับงานหลายขั้นตอน ให้บันทึกว่าการรันหยุดที่ใด และการลองใหม่ทำการกระทำที่เสร็จแล้วซ้ำหรือตรวจสอบสถานะสุดท้ายหรือไม่
เอเจนต์ที่พูดว่า “done” โดยไม่มีหลักฐานไม่ได้ผ่านการตรวจสอบความสมบูรณ์ กำหนดให้มีผลการทดสอบ ไฟล์ที่บันทึกไว้ การอ้างอิงแหล่งที่มา หรือสถานะที่ตรวจสอบแล้วซึ่งตรงกับงาน
5. ตั้งเกณฑ์การตัดสินจากต้นทุนของความล้มเหลว
ไม่มีจุดตัดอัตราผ่านแบบสากลที่มีประโยชน์ ฉบับร่างที่มนุษย์ตรวจทีละบรรทัดมีโปรไฟล์ความเสี่ยงต่างจากการ migrate ฐานข้อมูลหรือการชำระเงินอัตโนมัติ
ตั้งเกณฑ์จากสามปัจจัย:
- ผลลัพธ์ที่ผิดเป็นอันตรายหรือมีค่าใช้จ่ายสูงเพียงใด?
- มนุษย์สามารถจับข้อผิดพลาดได้ก่อนที่มันจะส่งผลกระทบต่อใครหรือไม่?
- เวิร์กโฟลว์ล้มเหลวอย่างปลอดภัย โดยมีจุดหยุดชัดเจนและร่องรอยการตรวจสอบหรือไม่?
สำหรับฉบับร่างความเสี่ยงต่ำ การตรวจทานอาจเพียงพอ สำหรับการเปลี่ยนแปลงโค้ด การเงิน กฎหมาย สุขภาพ หรือการกระทำที่ส่งผลต่อผู้ใช้ ให้ใช้การทดสอบที่แข็งแรงขึ้นและการตรวจสอบโดยอิสระ อย่าให้ค่าเฉลี่ยสูงบดบังโหมดความล้มเหลวร้ายแรงเพียงหนึ่งโหมด
ความน่าเชื่อถือของ Muse Wonder ตามประเภทงาน
การเขียนโค้ดและการสร้างหลายขั้นตอน
รันชุดทดสอบจริงของ repository และตรวจสอบพฤติกรรมที่ร้องขอ ให้คะแนนความครอบคลุมของข้อกำหนด ความล้มเหลวเชิงถดถอย และว่าการเปลี่ยนแปลงที่โมเดลอ้างว่าทำตรงกับไฟล์และเอาต์พุตเทสต์หรือไม่ การบันทึกหน้าจอหรือคำอธิบายที่โน้มน้าวใจไม่ใช่สิ่งทดแทนการตรวจสอบที่รันได้จริง
ชุดทดสอบ Quantslant ช่วงแรกมีงานเขียนโค้ดสี่งาน และรายงานว่า unit test 15 จาก 16 รายการผ่านในงานแปลงตัวเลขเป็นคำหนึ่งงาน นั่นเป็นสัญญาณเล็ก ๆ จากการรันครั้งเดียว Spring Prompt ระบุชัดว่าไม่ได้ทดสอบการเขียนโค้ด ดังนั้นไม่ควรนำผลการค้นพบไปสรุปทั่วไปเกี่ยวกับความน่าเชื่อถือของเอเจนต์เขียนโค้ด
การวิจัยและการสกัดข้อเท็จจริง
ใช้ชุดแหล่งข้อมูลหรือคำตอบอ้างอิงที่ผู้ตรวจทานของคุณสามารถตรวจสอบได้ ตรวจสอบข้อกล่าวอ้างเชิงข้อเท็จจริงแต่ละข้อกับแหล่งปฐมภูมิ และติดตามการอ้างอิงที่กุขึ้นและการระบุแหล่งที่มาผิด แยกจากคุณภาพคำตอบโดยทั่วไป
การวิเคราะห์แบบสำรวจของ Spring Prompt เป็นจุดแข็งเชิงสัมพัทธ์ในการประเมินขนาดเล็ก แต่การออกแบบคำถามแบบสำรวจอ่อนกว่า คะแนนการวิเคราะห์สูงไม่ควรรับรองเครื่องมือสำรวจหรือแหล่งข้อมูลเบื้องหลังงานวิจัยใหม่โดยปริยาย
เวิร์กโฟลว์บริบทยาวและเอเจนต์
ตรวจสอบว่าโมเดลรักษาข้อจำกัดทุกข้อ ใช้เครื่องมือแต่ละอย่างถูกต้อง และตรวจสอบสถานะสุดท้ายหรือไม่ ทดสอบการกู้คืนจากการขัดจังหวะอย่างจงใจ: หยุดการรันหลังขั้นตอนที่รู้แล้ว จากนั้นดูว่ามันกลับมาทำต่อจาก checkpoint หรือทำผลข้างเคียงซ้ำหรือไม่
ประกาศของ Meta อธิบายความสามารถด้านหน่วยความจำและการกู้คืน แต่การประเมินช่วงแรกสาธารณะที่อ้างถึงในที่นี้ไม่ได้พิสูจน์ความสม่ำเสมอระยะยาวสำหรับหน่วยความจำถาวรหรือการกู้คืนของเอเจนต์ วัดพฤติกรรมเหล่านั้นโดยตรงก่อนจะพึ่งพา
Muse Wonder vs. Muse Wonder Full: แยกหลักฐานออกจากกัน
Muse Wonder และ Muse Wonder Full เป็นตัวแปรที่แตกต่างกัน ข้อมูลเปิดตัวของ Meta ระบุเส้นทางการเข้าถึงแยกกัน และการทดสอบ API อิสระของ Wonder มาตรฐานไม่กลายเป็นผลลัพธ์ Full เพียงเพราะการตั้งค่าการให้เหตุผลเปลี่ยนไป
| คำถามเปรียบเทียบ | สิ่งที่หลักฐานที่มีอยู่รองรับ |
|---|---|
| Full เหมือนกับ Wonder มาตรฐานที่การให้เหตุผลสูงสุดหรือไม่? | ไม่ ควรถือเป็นตัวแปรที่แตกต่างกันและบันทึกชื่อให้ตรงตามจริง |
| การประเมิน API ของ Spring Prompt ที่อ้างถึงได้ทดสอบ Full หรือไม่? | ไม่ การทดสอบนั้นทดสอบ Wonder มาตรฐาน; Full อยู่นอกการเปรียบเทียบนั้น |
| ตัวเลข API มาตรฐานที่อ้างถึงสามารถจัดอันดับ Full ได้หรือไม่? | ไม่ได้ เพราะไม่ได้ทดสอบ Full |
| อะไรจะทำให้การเปรียบเทียบยุติธรรม? | ชุดงานเดียวกัน เกณฑ์ให้คะแนน ช่วงวันที่ การเข้าถึงเครื่องมือ และการตั้งค่าที่บันทึกไว้เหมือนกัน โดยทำซ้ำสำหรับทั้งสองตัวแปร |
การเปรียบเทียบที่ยุติธรรมเริ่มจากงานที่จับคู่กันและเงื่อนไขที่จับคู่กัน ถ้าเส้นทางการเข้าถึงบังคับให้ใช้พรอมป์ต์ เครื่องมือ หรือการเรียกเก็บเงินต่างกัน ให้บันทึกความแตกต่างเหล่านั้นและเรียกการเปรียบเทียบว่าเป็นการสำรวจ
ต้นทุน การเข้าถึง และสถานที่ทดสอบ Muse Wonder
เปรียบเทียบต้นทุนต่องานที่ยอมรับได้ ไม่ใช่แค่ราคาที่ระบุต่อโทเคน พรอมป์ต์ยาว การลองใหม่ โทเคนการให้เหตุผล การเรียกเครื่องมือ การหมดเวลา และการตรวจทานโดยมนุษย์ ล้วนเปลี่ยนต้นทุนของผลลัพธ์ที่ใช้งานได้ Quantslant รายงานอัตราโทเคนของ Wonder มาตรฐานเป็น $4 ต่ออินพุตหนึ่งล้านโทเคน และ $20 ต่อเอาต์พุตหนึ่งล้านโทเคน เมื่อวันที่ 12 ตุลาคม 2026 และการรัน 23 งานของตนมีค่าใช้จ่าย $0.64 นั่นเป็นเส้นทางและปริมาณงานที่รายงานหนึ่งรายการ ไม่ใช่ราคาต่องานแบบสากล
ประกาศเปิดตัวปัจจุบันของ Meta ระบุ Wonder มาตรฐานผ่าน Meta Model API และ Muse Code และ Full ผ่านการสมัครสมาชิก Muse Code ยืนยันการเข้าถึง สิทธิ์ใช้งานตามภูมิภาค และการเรียกเก็บเงินปัจจุบันในอินเทอร์เฟซอย่างเป็นทางการก่อนจัดงบประมาณ
เริ่มที่ Atlas Cloud เพื่อมุมมองที่กว้างขึ้นเกี่ยวกับแพลตฟอร์มสำหรับนักพัฒนาของ Atlas Cloud ณ วันที่ 15 ตุลาคม 2026 ฉันไม่สามารถยืนยัน Muse Wonder ใน แค็ตตาล็อกโมเดล ได้ ดังนั้นบทความนี้จึงไม่ได้นำเสนอ Atlas Cloud เป็นเส้นทางเรียกใช้สำหรับโมเดลนี้ หากทีมของคุณกำลังเปรียบเทียบโมเดลอื่นที่ระบุไว้ที่นั่นแล้ว ไลบรารีโมเดลของ Atlas Cloud สามารถช่วยคุณระบุตัวเลือกที่จะรันกับชุดงานเดียวกันได้
ผลลัพธ์ที่มีประโยชน์ของการทดสอบความน่าเชื่อถือของ Muse Wonder คือการตัดสินใจใช้งานที่ผูกกับหลักฐาน: งานใดผ่าน ผ่านบ่อยเพียงใด มีค่าใช้จ่ายเท่าใด และยังต้องตรวจทานอะไร
คำถามที่พบบ่อย
Muse Wonder เชื่อถือได้สำหรับการเขียนโค้ดหรือไม่?
การทดสอบเปิดตัวช่วงแรกมีเพียงตัวอย่างการเขียนโค้ดขนาดเล็ก Quantslant รายงานงานเขียนโค้ดสี่งาน โดยมี unit test พลาดในหนึ่งงาน ขณะที่ Spring Prompt ไม่ได้ทดสอบการเขียนโค้ด รันเทสต์ของ repository บนงานของคุณเอง และทำซ้ำงานสำคัญก่อนตัดสินใจเกี่ยวกับเวิร์กโฟลว์การเขียนโค้ด
ฉันจะทดสอบความน่าเชื่อถือของ Muse Wonder ด้วยตัวเองได้อย่างไร?
ใช้ชุดงานจริงที่คงที่ เก็บการตั้งค่าโมเดลและพรอมป์ต์ให้ตรงตามจริง กำหนดเกณฑ์ผ่านล่วงหน้า และเก็บเอาต์พุตทุกครั้ง ทำซ้ำงานสำคัญและตรวจสอบผลลัพธ์ด้วยเทสต์หรือเอกสารต้นทาง
ควรทำซ้ำแต่ละงานของ Muse Wonder กี่ครั้ง?
ใช้อย่างน้อยสามการรันสำหรับงานที่ส่งผลกระทบสูงเพื่อเป็นการตรวจสอบความสม่ำเสมอเบื้องต้น การลองสามครั้งยังเป็นตัวอย่างขนาดเล็ก ดังนั้นให้ขยายชุดเมื่อข้อผิดพลาดมีค่าใช้จ่ายสูงหรือเอาต์พุตแปรผัน
Muse Wonder กับ Muse Wonder Full ต่างกันอย่างไร?
เป็นตัวแปรโมเดลแยกกันโดยมีเส้นทางการใช้งานต่างกัน อย่าถือว่า Wonder มาตรฐานที่การให้เหตุผลสูงสุดเป็น Full หรือถ่ายโอนผลลัพธ์ระหว่างกันโดยไม่มีการทดสอบที่จับคู่กัน
ฉันเชื่อคะแนน benchmark Muse Wonder ของ Meta ได้หรือไม่?
ใช้เป็นหลักฐานความสามารถที่ผู้ขายรายงาน และอ่านการตั้งค่า benchmark ไม่ได้พิสูจน์ประสิทธิภาพที่สม่ำเสมอข้ามพรอมป์ต์ เครื่องมือ และการรันซ้ำของคุณ
Muse Wonder พร้อมใช้งานบน Atlas Cloud หรือไม่?
ฉันไม่สามารถยืนยันได้ในแค็ตตาล็อกโมเดลของ Atlas Cloud ณ วันที่ 15 ตุลาคม 2026 ตรวจสอบแค็ตตาล็อกสดก่อนเลือกผู้ให้บริการเรียกใช้





