

เสียงหนึ่งอาจฟังดูเหมือนมีคนกำลังกลั้นน้ำตาไว้ ในขณะที่ใบหน้าที่ถูกเคลื่อนไหวคงเรียบเฉย ด้วย การจับคู่เสียงที่สื่ออารมณ์และสีหน้าของ OmniHuman 2.0 การแก้ไขขั้นแรกมักคือการฟังให้ละเอียดขึ้น ไม่ใช่การเติมคำคุณศัพท์ให้มากขึ้น เสียงมีคำ จังหวะ และการเน้นเสียงอยู่แล้ว พรอมต์สั้น ๆ ควรกำกับท่าทางที่มองเห็นซึ่งสนับสนุนสัญญาณเหล่านั้น
คู่มือนี้ให้วิธีที่ทำซ้ำได้สำหรับครีเอเตอร์ในการเตรียมภาพบุคคลและแทร็กเสียง เขียนพรอมต์ที่มุ่งเป้า และตรวจสอบผลลัพธ์หาความไม่สอดคล้องที่มีนัยสำคัญ ครอบคลุมทั้งการพูดและการร้อง โดยแยกข้อมูลที่มีเอกสารยืนยันออกจากคำแนะนำของบุคคลที่สามและคำกล่าวอ้างเกี่ยวกับผลิตภัณฑ์ที่ยังไม่ได้รับการยืนยัน
ประเด็นสำคัญ
- มองเสียงเป็นพื้นฐานของการแสดง และกำกับเฉพาะการกระทำที่มองเห็น การจัดเฟรม และรายละเอียดฉาก
- ทำเครื่องหมายจังหวะทางอารมณ์ก่อนเขียนพรอมต์ จากนั้นตรวจช่วงเวลาเดิมซ้ำทั้งตอนปิดเสียงและเปิดเสียง
- เปลี่ยนตัวแปรครั้งละหนึ่งอย่างต่อการลองหนึ่งครั้ง; พรอมต์ไม่สามารถซ่อมทุกปัญหาจากเสียงต้นทางหรือการสร้างได้
OmniHuman 2.0 เชื่อมโยงเสียง สีหน้า และการเคลื่อนไหวอย่างไร
วิธีที่มีประโยชน์ในการคิดเกี่ยวกับโมเดลภาพบุคคลที่ขับเคลื่อนด้วยเสียงคือกำหนดหน้าที่ให้อินพุตแต่ละส่วน ภาพเป็นตัวยึดบุคคลที่มองเห็นได้ บันทึกเสียงให้คำพูดหรือเพลง รวมถึงจังหวะเวลาและการสื่อด้วยน้ำเสียง คำสั่งข้อความแบบไม่บังคับสามารถอธิบายการแสดงหรือฉากได้ พฤติกรรมและตัวควบคุมที่แน่นอนอาจแตกต่างกันไปตามการนำผลิตภัณฑ์ไปใช้ ดังนั้นอย่าถือว่างานวิจัย OmniHuman ทั่วไปหรือคำแนะนำของสตูดิโอบุคคลที่สามเป็นข้อกำหนดอย่างเป็นทางการของ OmniHuman 2.0
งานวิจัย OmniHuman-1 ต้นฉบับอธิบายการเคลื่อนไหวของมนุษย์ที่ปรับตามเงื่อนไขจากการผสมผสานของภาพ ข้อความ เสียง และท่าทาง เปเปอร์นั้นวางกรอบกว้าง ๆ ของตระกูลงานวิจัยนี้ ไม่ใช่อินเทอร์เฟซ ขีดจำกัด หรือคุณภาพที่แน่นอนของ OmniHuman 2.0 (ICCV 2025, เปเปอร์ OmniHuman-1)
| อินพุต | สิ่งที่อาจมีส่วนช่วย | สิ่งที่คุณเตรียมได้ |
|---|---|---|
| ภาพบุคคลอ้างอิง | รูปลักษณ์ของบุคคลและท่าทางเริ่มต้น | เลือกใบหน้าที่ชัดเจนและการจัดเฟรมที่เหมาะกับการเคลื่อนไหวที่ตั้งใจ |
| เสียงพูดหรือเสียงร้อง | คำ จังหวะการพูด ช่วงหยุด พลังของเสียง | ใช้แทร็กที่สะอาดที่มีการสื่อด้วยน้ำเสียงตามตั้งใจ และตัดความเงียบที่ไม่เกี่ยวข้องออก |
| พรอมต์กำหนดทิศทาง (ไม่บังคับ) | การกระทำที่มองเห็น การจัดเฟรม ฉาก หรือสัญญาณอารมณ์ | ให้คำสั่งที่ชัดเจนไม่กี่ข้อซึ่งสอดคล้องกับเสียง |
การซิงก์ริมฝีปากและการแสดงอารมณ์เกี่ยวข้องกัน แต่ไม่ใช่การตรวจสอบคุณภาพแบบเดียวกัน ปากสามารถขยับตามพยางค์ได้ในขณะที่ดวงตา ศีรษะ หรือท่าทางรู้สึกผิดกับบทพูด ในทำนองเดียวกัน ใบหน้าอาจดูแสดงอารมณ์ได้ดีในขณะที่จังหวะเวลาเหลื่อมจากเสียง ตรวจสอบทั้งสองอย่าง
คู่มือ OmniHuman 2.0 ของบุคคลที่สามอธิบายเวิร์กโฟลว์แบบภาพบวกเสียงพร้อมคำสั่งข้อความแบบไม่บังคับ แต่หน้าเหล่านั้นไม่ใช่เอกสารทางเทคนิคของ BytePlus เอกสาร Atlas ที่เข้าถึงได้สาธารณะครอบคลุมโมเดล Avatar Omni Human 1.5 ของตัวเอง ไม่ใช่ OmniHuman 2.0 ดังนั้นสมมติฐานการทำงานที่ปลอดภัยที่สุดจึงเป็นเชิงปฏิบัติมากกว่าเชิงabsolute: ให้เสียงบอกเป็นนัยว่าการแสดงต้องการอะไร และใช้พรอมต์เพื่อขอตัวเลือกที่มองเห็นซึ่งคุณตรวจสอบได้
เลือกภาพบุคคลและแทร็กเสียงที่ทำให้อ่านอารมณ์ได้
โมเดลไม่สามารถแสดงตามสัญญาณที่มองเห็นหรือได้ยินได้ยาก เริ่มจากอินพุตที่ให้งานที่ยุติธรรมและง่ายแก่โมเดล จากนั้นตรึงอินพุตไว้ขณะทดสอบถ้อยคำในพรอมต์
| อินพุตเริ่มต้น | เหตุผลที่ช่วยได้ | ข้อควรระวัง |
|---|---|---|
| ใบหน้าที่คมชัด ไม่มีสิ่งบัง และมีแสงสม่ำเสมอ | ทำให้อ่านลักษณะใบหน้าได้ง่าย | เงาที่แรง ผม มือ หรือพร็อพอาจบดบังพื้นที่สำคัญ |
| ท่าทางเริ่มต้นแบบเป็นกลางหรือแสดงอารมณ์เล็กน้อย | เปิดช่องให้การแสดงเปลี่ยนได้ | สีหน้าที่ชัดเจนและคงที่อาจขัดกับอารมณ์เสียงที่ต่างออกไป |
| เสียงพูดหลักหนึ่งเสียงที่ชัดเจน | ทำให้ติดตามคำพูดและช่วงหยุดได้ง่ายขึ้น | ดนตรี เสียงรบกวนในห้อง หรือเสียงผู้พูดที่ทับกันอาจกลบสัญญาณ |
| การเรียบเรียงถ้อยคำอย่างตั้งใจพร้อมช่วงหยุดที่ได้ยิน | ให้ช่วงเวลาแก่คุณในการจับคู่กับการกระทำที่มองเห็น | การสื่อที่ราบเรียบอาจให้การเปลี่ยนอารมณ์ที่ชัดเจนน้อยลง |
| เพลงที่เน้นเสียงร้องพร้อมท่อนที่ชัดเจน | ทำให้ระบุคำร้องและไดนามิกได้ง่ายขึ้น | ท่อนดนตรีให้สัญญาณเสียงร้องสำหรับการขยับปากน้อยลง |
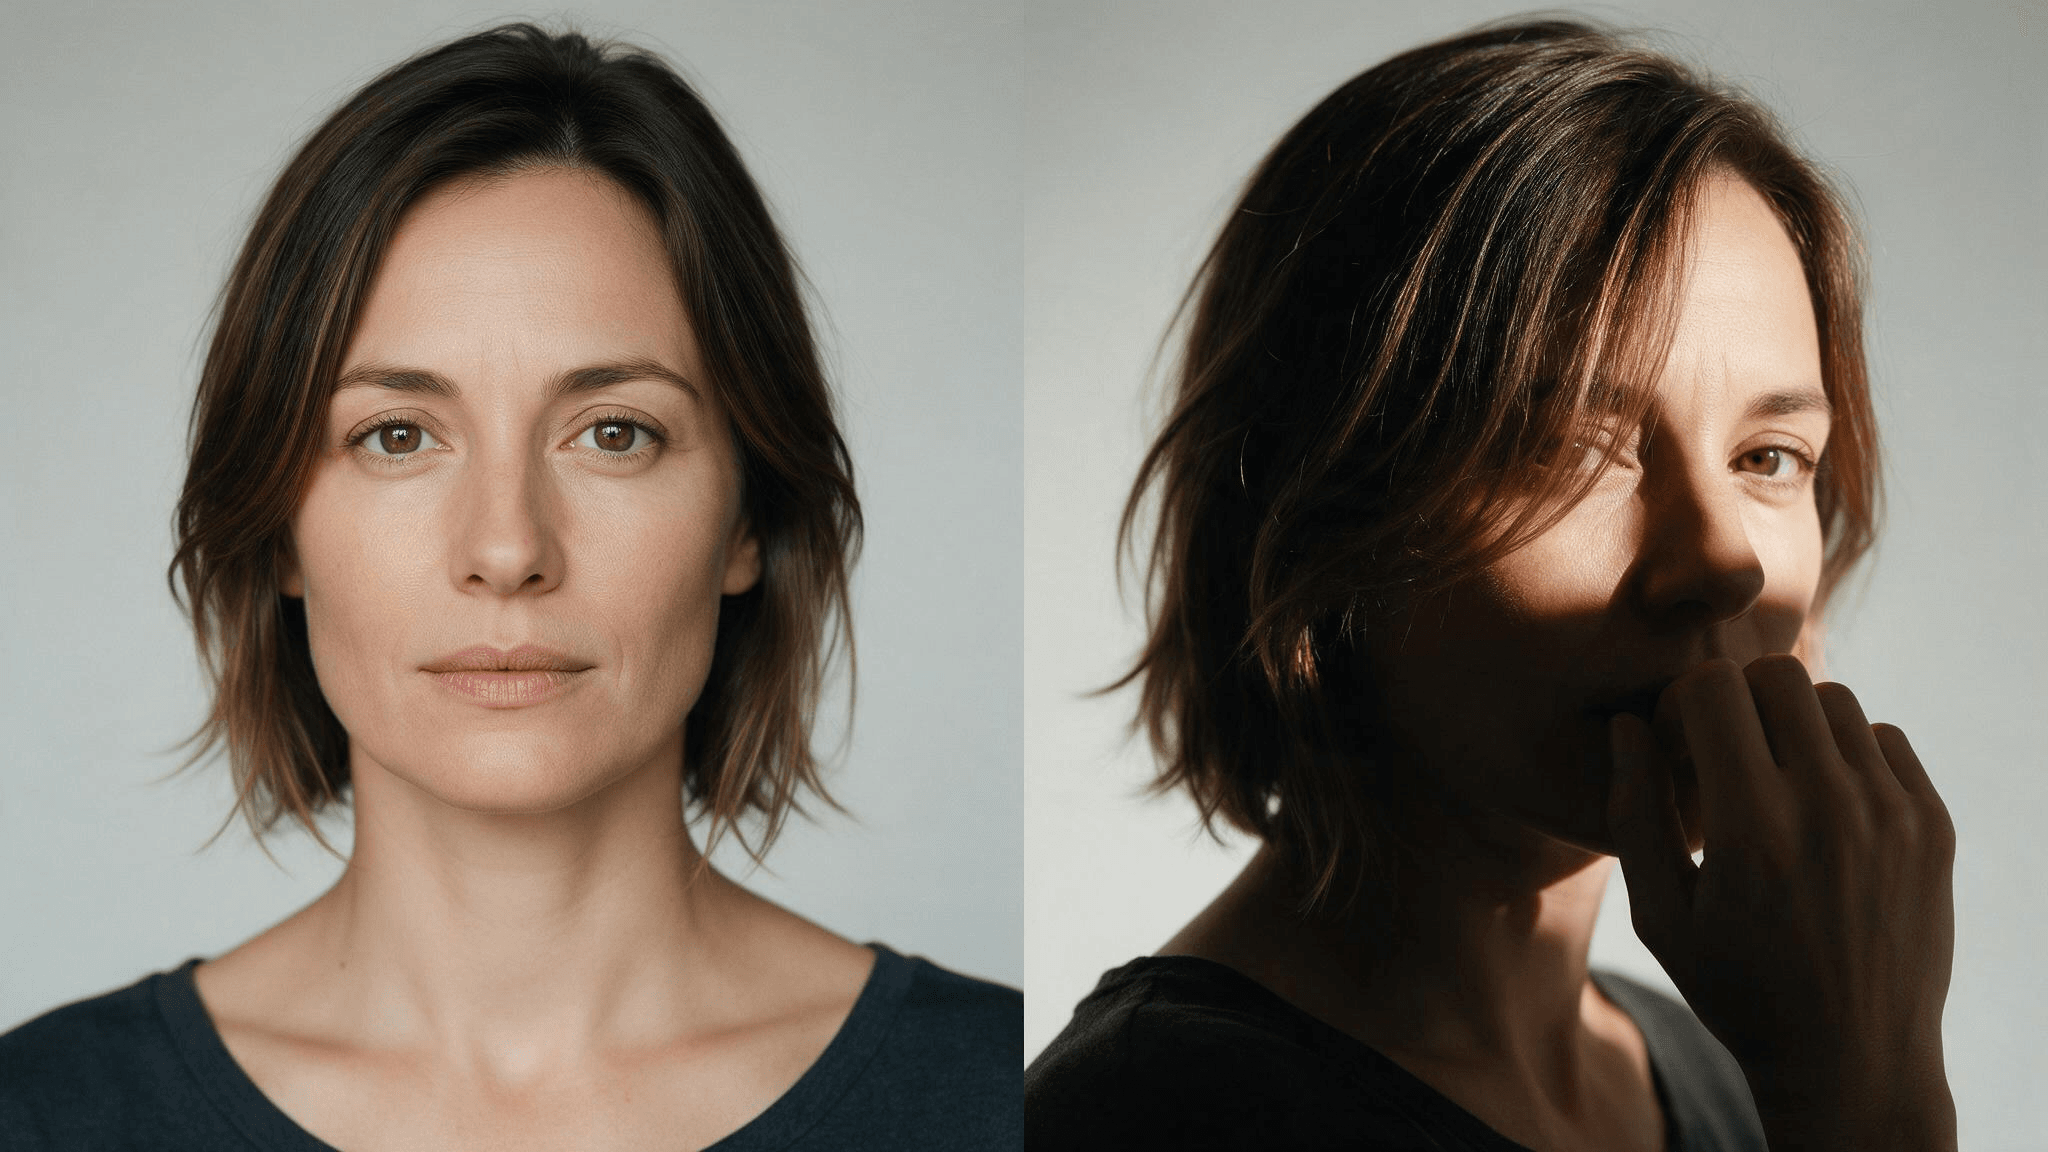 ภาพเปรียบเทียบภาพบุคคลเพื่อประกอบคำอธิบาย: มุมมองที่ชัดเจนและหันหน้าตรงทำให้ตรวจสอบสัญญาณบนใบหน้าได้ง่ายกว่ามุมที่ถูกเงาและถูกบดบังบางส่วน นี่ไม่ใช่การเปรียบเทียบเอาต์พุตของโมเดล
สิ่งเหล่านี้เป็นการตรวจสอบในงานผลิต ไม่ใช่การรับประกัน อินพุตที่ดีก็ยังสร้างเทกที่อ่อนได้ และภาพบุคคลที่ดูแสดงอารมณ์ไม่ได้ทำให้การเคลื่อนไหวสอดคล้องกันแน่นอน สำหรับการทดสอบครั้งแรก ให้ใช้ภาพบุคคลหนึ่งภาพ เสียงช่วงสั้นหนึ่งช่วง และพรอมต์เดียว หลีกเลี่ยงการเปลี่ยนการครอป บันทึกเสียง และคำสั่งพร้อมกัน; ไม่เช่นนั้นคุณจะไม่รู้ว่าการปรับใดช่วยได้
สำหรับการร้อง ให้ฟังตอนจบของท่อน โน้ตที่ถือไว้ และการเปลี่ยนความเข้ม พรอมต์สามารถกำกับการเอียงศีรษะหรือการขยับมือรอบจังหวะดนตรีได้ แต่ไม่ควรพูดเนื้อเพลงซ้ำที่มีอยู่ในบันทึกแล้ว สำหรับบทสนทนาพูด ให้ทำเครื่องหมายช่วงหยุดและคำที่เน้น พรอมต์ที่ขอให้อารมณ์เปลี่ยนมากในขณะที่ประโยคสงบต่อเนื่องอาจสร้างการแสดงที่รู้สึกถูกยัดเยียด
กรอบการเขียนพรอมต์สำหรับจับคู่เสียงและสีหน้า
ให้คำสั่งสั้นพอที่จะประเมินได้ โครงสร้างที่ใช้ได้จริงคือ:
การจัดเฟรม + ผู้พูดและการสื่อด้วยน้ำเสียง + อารมณ์ที่สอดคล้องกับแทร็ก + การกระทำที่มองเห็นหนึ่งหรือสองอย่าง + ทิศทางกล้อง (ไม่บังคับ)
ตัวอย่างเช่น หากผู้พูดฟังดูอบอุ่นและสุขุม คุณอาจเขียนว่า:
มีเดียมโคลสอัปแบบนิ่ง ผู้หญิงพูดกับกล้องอย่างอบอุ่น เริ่มด้วยท่าทีสุขุมและเผยรอยยิ้มเล็ก ๆ ในบรรทัดสุดท้าย เธอพยักหน้าเบา ๆ หนึ่งครั้งหลังช่วงหยุด รักษาการจัดเฟรมให้นิ่ง
นี่เป็นพรอมต์เพื่อประกอบคำอธิบาย ไม่ใช่การรัน OmniHuman 2.0 ที่มีการรายงาน คุณสมบัติที่มีประโยชน์คือคำสั่งแต่ละข้อจับคู่กับสิ่งที่มองเห็นได้: ช็อตนิ่ง สีหน้าเปลี่ยนใกล้ตอนจบ และการพยักหน้ามีสัญญาณกำกับ คุณสามารถเปรียบเทียบผลลัพธ์กับแทร็กได้ แทนที่จะตัดสินคำขอกว้าง ๆ อย่าง “แสดงอารมณ์ให้หน่อย”
คู่มือพรอมต์ของบุคคลที่สามแนะนำให้ใช้คำสั่งภาษาธรรมชาติที่กระชับและจับคู่อารมณ์ที่ขอให้ตรงกับเสียง มองสิ่งนั้นเป็นหลักปฏิบัติ ไม่ใช่การรับประกันหรือกฎผลิตภัณฑ์อย่างเป็นทางการ (คู่มือพรอมต์ KreatorFlow)
ก่อนใช้พรอมต์ ให้ตรวจเทียบกับเสียงบันทึก:
- หากเสียงเงียบและ restrained ให้ขอสีหน้าแบบละเอียดอ่อนมากกว่ารอยยิ้มกว้าง
- หากการสื่อด้วยน้ำเสียงมั่นใจขึ้น ให้วางการเปลี่ยนแปลงที่มองเห็นหลังการเปลี่ยนที่ได้ยิน
- หากบันทึกมีเสียงหัวเราะ ช่วงหยุด หรือเสียงถอนหายใจ ให้ตัดสินว่าใบหน้าควรนิ่ง ตอบสนอง หรือขยับ ณ จุดนั้น
- หากภาพบุคคลเริ่มต้นแสดงสีหน้าที่ต้องการอยู่แล้ว หลีกเลี่ยงการบรรยายซ้ำ เว้นแต่คุณต้องการให้สีหน้าเปลี่ยน
ใช้คำบอกเวลา เช่น “แรก” “จากนั้น” และ “สุดท้าย” เฉพาะเมื่อเสียงมีจังหวะชัดเจน หลีกเลี่ยงการซ้อนคำสั่งที่ขัดกัน เช่น “การจัดเฟรมนิ่ง” กับ “กล้องโคจร” หรือ “สงบ” กับ “เดือดดาล” พรอมต์คือคำกำกับสำหรับการแสดงที่มีอยู่ ไม่ใช่แทร็กเสียงแทน
สามรูปแบบพรอมต์สำหรับการพูด การเปลี่ยนอารมณ์ และการร้อง
เลือกแพตเทิร์นที่เล็กที่สุดซึ่งเข้ากับเสียงของคุณ ตัวอย่างเหล่านี้เป็นเทมเพลตให้ปรับใช้ ไม่ใช่คำกล่าวอ้างเกี่ยวกับเอาต์พุตที่ยืนยันแล้ว
คำอธิบายที่สงบ
มีเดียมโคลสอัปแบบนิ่ง ผู้พูดอธิบายประเด็นอย่างสงบ ด้วยสีหน้าสุขุมและท่าทางเน้นเล็ก ๆ หนึ่งครั้ง รักษากล้องให้นิ่ง
ใช้สิ่งนี้เมื่อแทร็กสุขุมและสม่ำเสมอ ท่าทางหนึ่งอย่างทำให้การเน้นมองเห็นได้ โดยไม่เปลี่ยนคำอธิบายตรงไปตรงมาให้กลายเป็นการแสดงแบบละคร
การเปลี่ยนอารมณ์
โคลสอัปแบบนิ่ง ผู้พูดเริ่มด้วยสีหน้าจริงจัง จากนั้นผ่อนลงเป็นรอยยิ้มเล็ก ๆ หลังช่วงหยุดก่อนประโยคสุดท้าย รักษาการเคลื่อนไหวให้เรียบง่าย
ใช้สิ่งนี้เฉพาะเมื่อบันทึกมีช่วงหยุดหรือการเปลี่ยนที่ได้ยินซึ่งสนับสนุนการเปลี่ยนนั้น หากไม่มีสัญญาณกำกับ การเปลี่ยนอาจดูตามอำเภอใจ
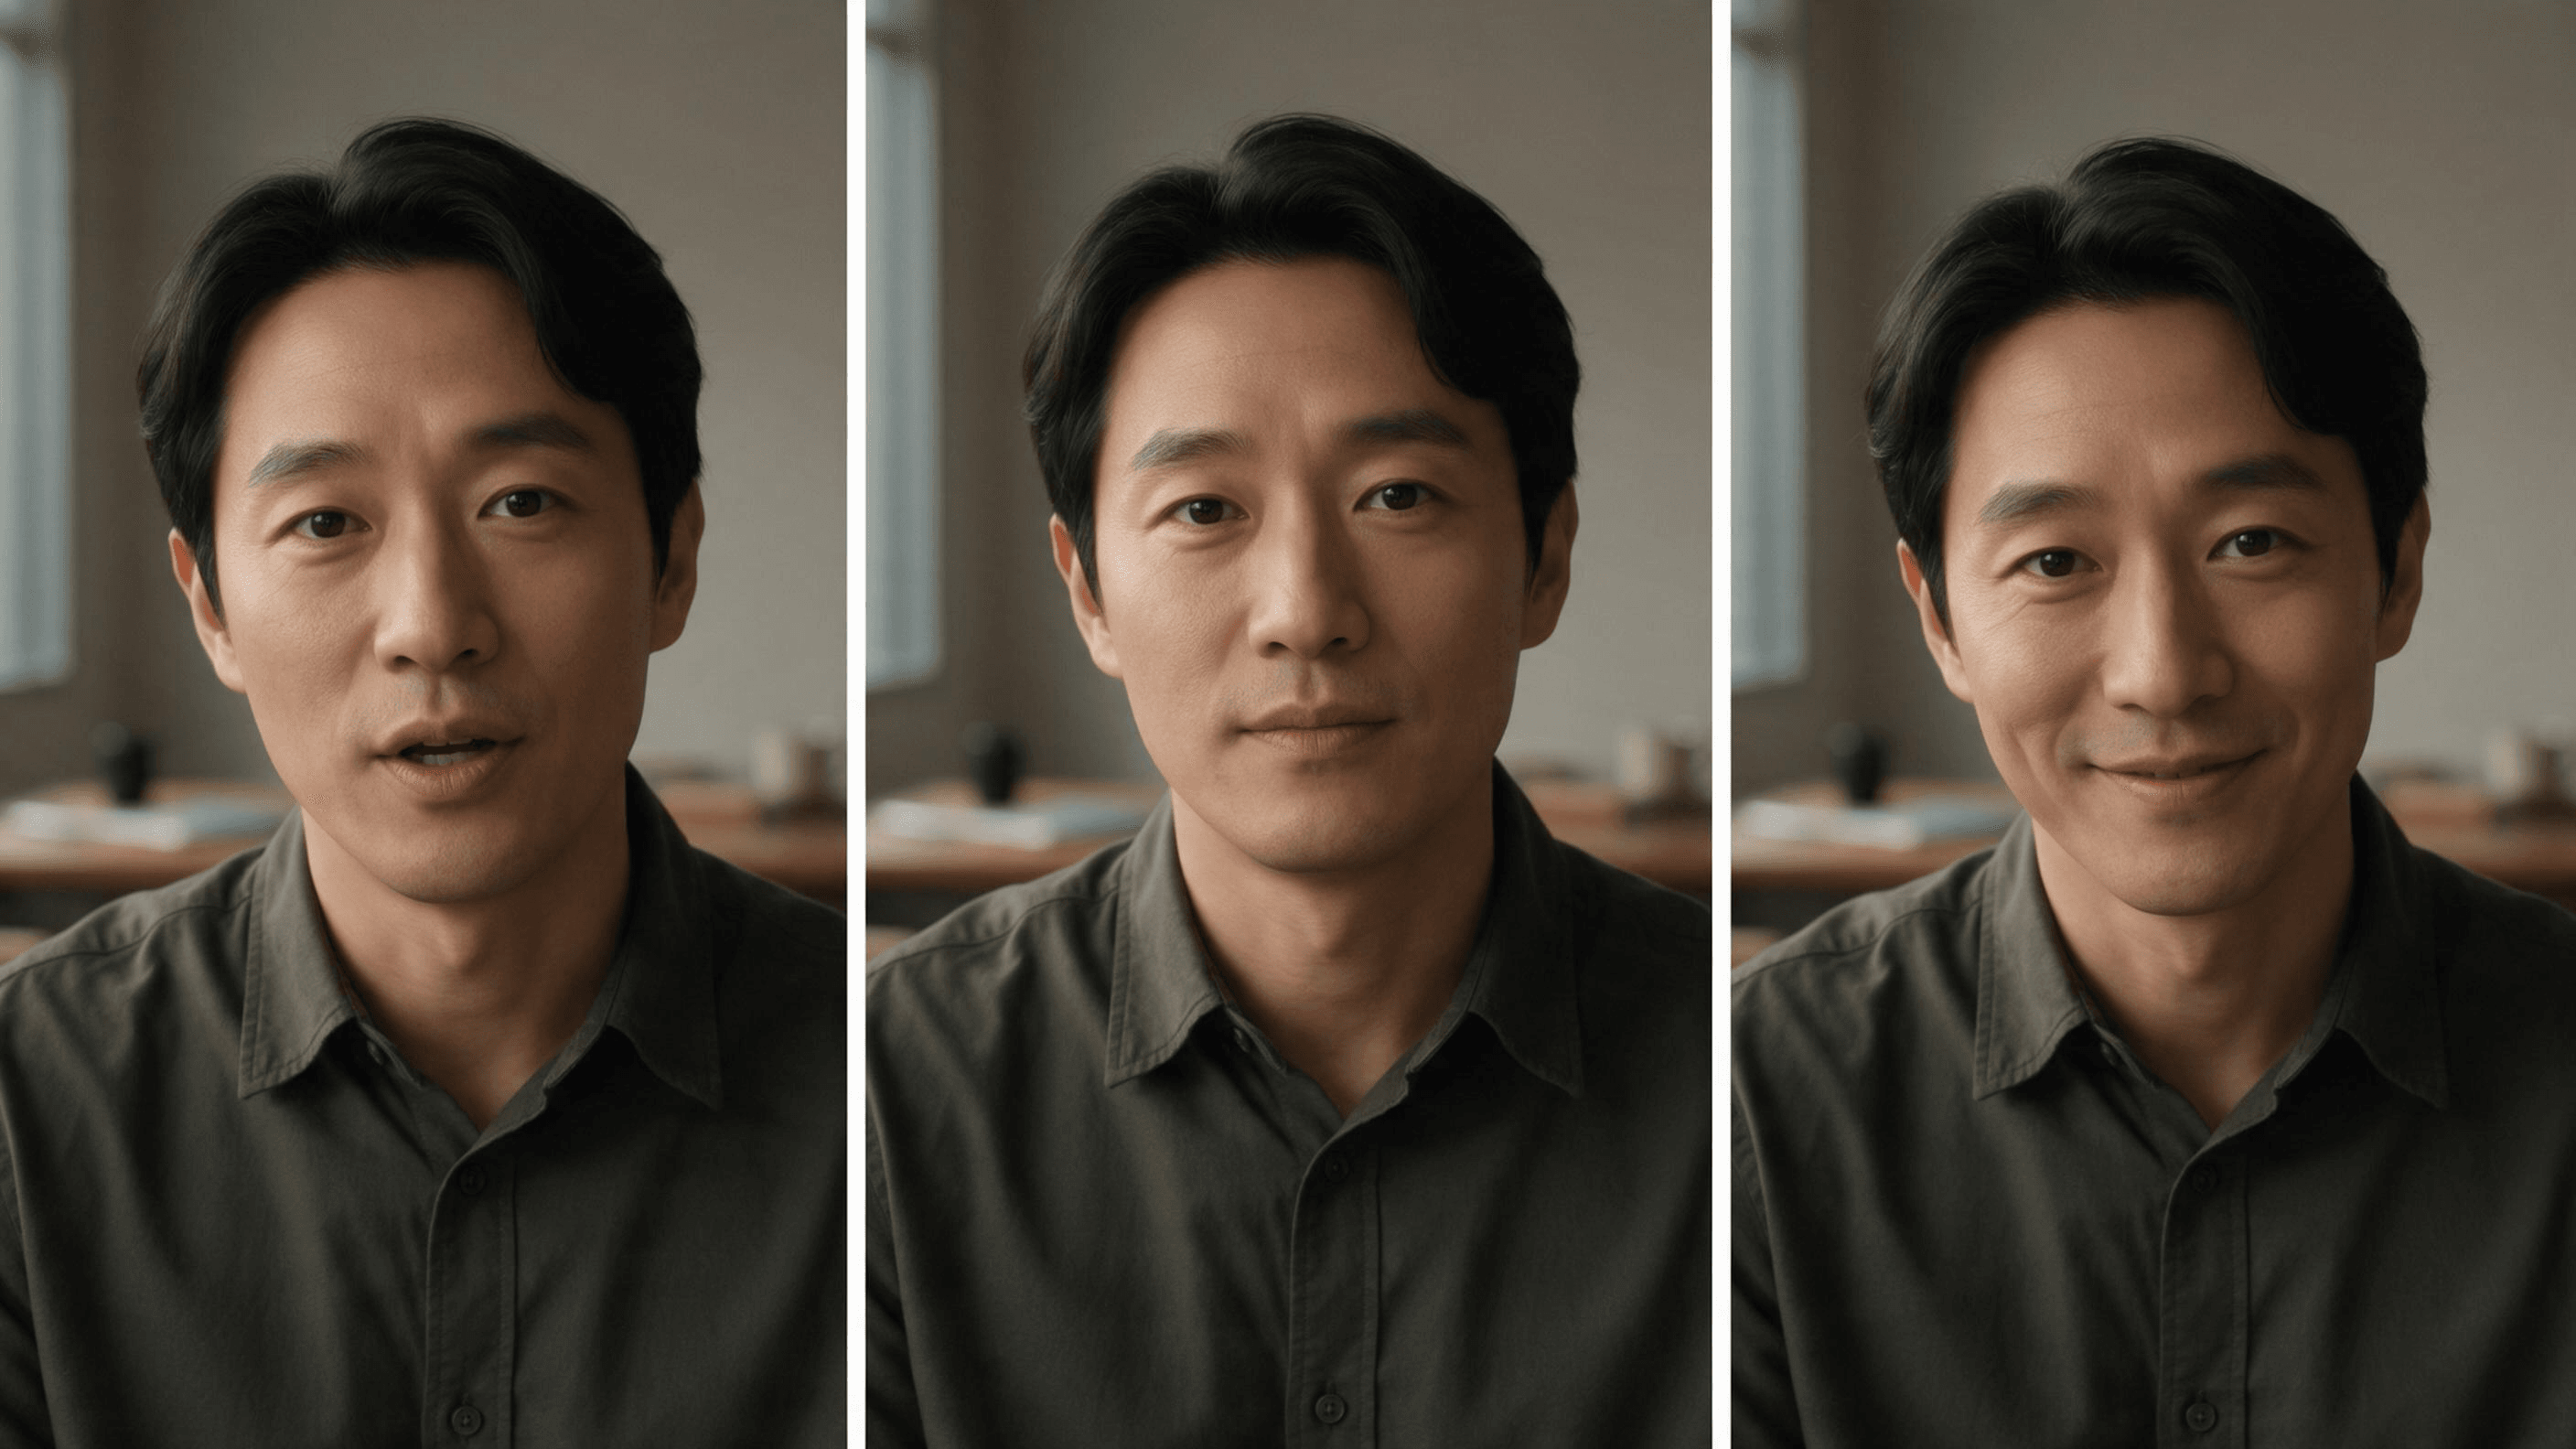 สตอรีบอร์ดเชิงแนวคิดสำหรับพรอมต์การพูด: การพูดจริงจัง ช่วงหยุด แล้วรอยยิ้มแบบจำกัด นี่คือจังหวะสีหน้าที่วางแผนไว้ ไม่ใช่เฟรมจากการสร้างของ OmniHuman 2.0
การร้อง
มีเดียมโคลสอัป นักร้องแสดงด้วยสีหน้าที่จดจ่อ หลับตาชั่วครู่ในโน้ตที่ลากยาว จากนั้นลดคางลงเมื่อท่อนจบ รักษาการจัดเฟรมให้นิ่ง
กำกับการแสดงรอบเหตุการณ์ทางดนตรี แทนการพูดเนื้อเพลงซ้ำ พรอมต์สามารถเสนอการกระทำที่มองเห็นได้; แทร็กที่ให้มายังคงเป็นแหล่งของคำร้องและจังหวะเวลา
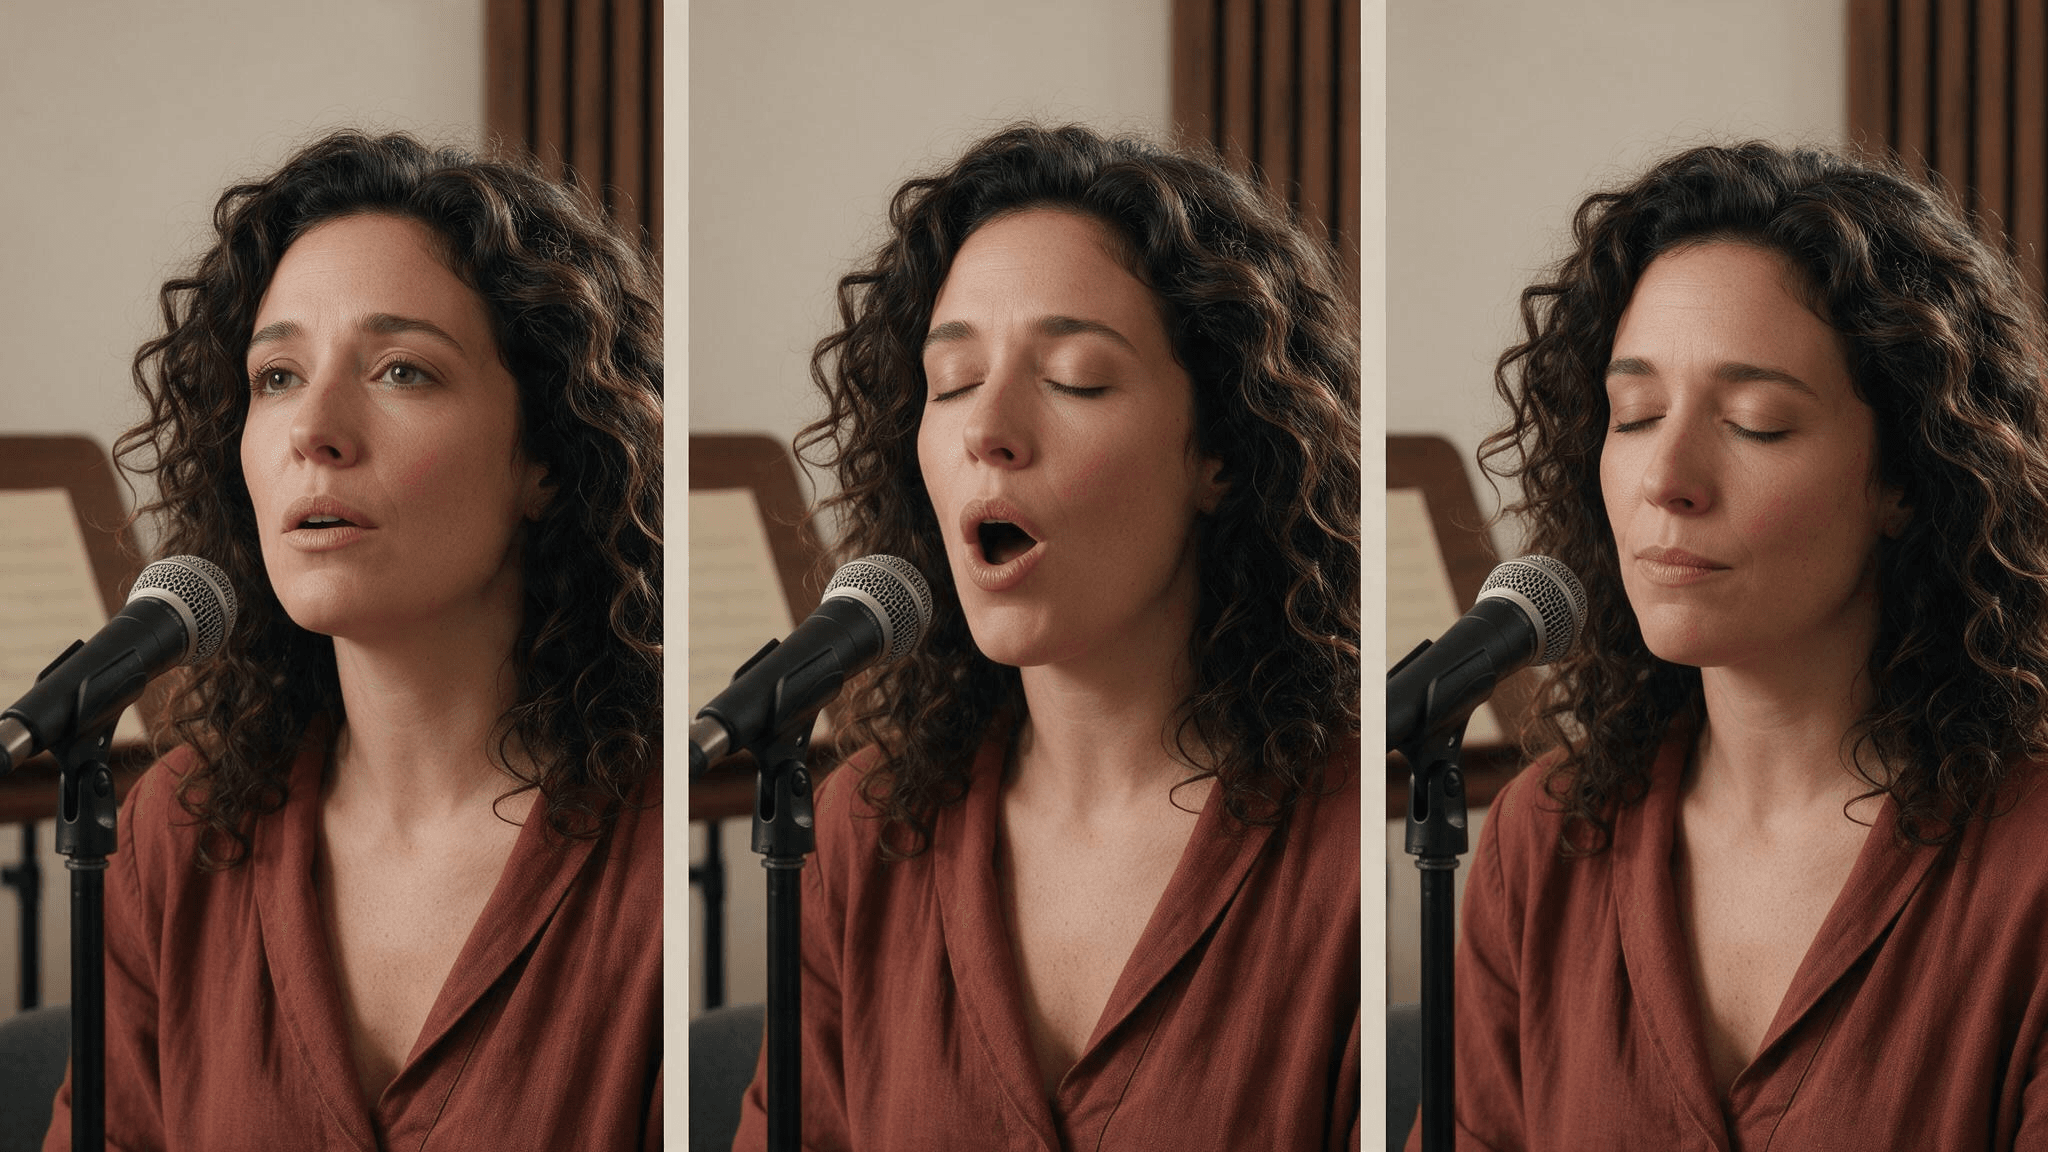 สตอรีบอร์ดเชิงแนวคิดสำหรับพรอมต์การร้อง: เริ่มท่อน ถือโน้ต แล้วผ่อนลงตอนจบ ภาพนิ่งไม่ได้แสดงให้เห็นการซิงก์เสียง
เปรียบเทียบ “แสดงอารมณ์และดูเป็นภาพยนตร์” กับ “พูดอย่างอบอุ่น จากนั้นยิ้มหลังช่วงหยุด” แบบแรกเปิดให้ตีความอารมณ์ จังหวะเวลา และการกระทำที่มองเห็นได้เอง แบบที่สองให้ช่วงเวลาที่เจาะจงหนึ่งจุดแก่คุณเพื่อตรวจสอบ หากผลลัพธ์พลาดช่วงเวลานั้น คุณมีการทดสอบถัดไปที่ตรงจุด: เลื่อนสัญญาณกำกับ ลดความเข้มของสีหน้า หรือเลือกการตัดต่อเสียงแบบอื่น
การตรวจสามรอบสำหรับการจัดตำแหน่งเสียงและใบหน้า
วิธีตรวจสอบอย่างรวดเร็วสามารถเผยว่าปัญหาอยู่ที่เสียง ทิศทางภาพ หรือเทกที่สร้างขึ้น ใช้เวลาเดียวกันในทั้งสามรอบ
ลูปแบบเงียบด้านล่างให้คุณตรวจส่วนที่มองเห็นของการแสดงพูด: การขยับปาก สายตา และการเปลี่ยนสีหน้า ใช้คลิปต้นฉบับที่มีเสียงสำหรับการตรวจเสียงกับใบหน้า
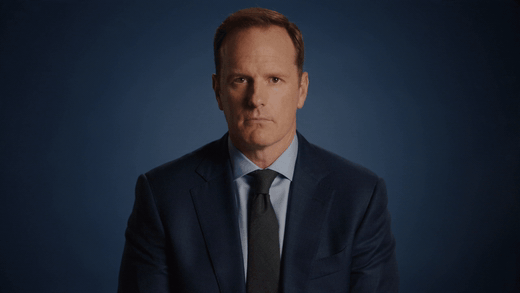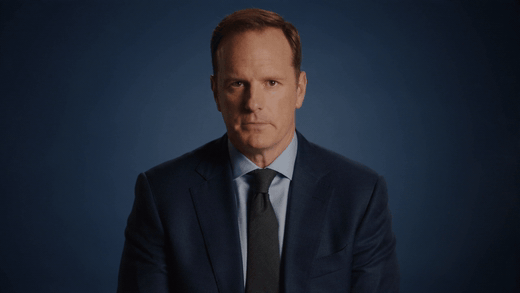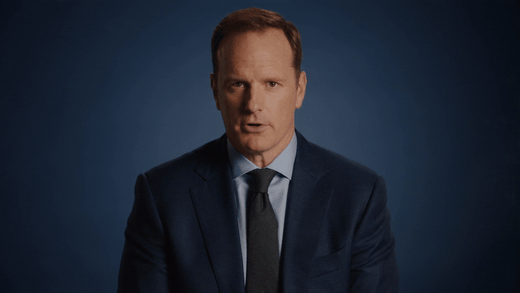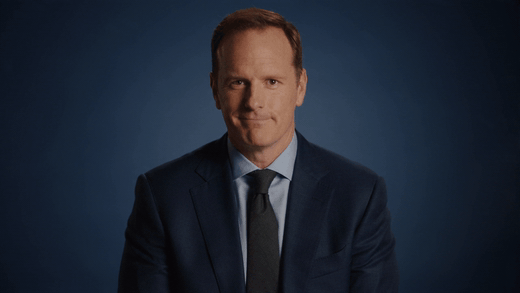 GIF เงียบที่แปลงจากวิดีโออวตารที่ให้มา มันแสดงการเคลื่อนไหวที่มองเห็นได้ แต่ไม่สามารถยืนยันการซิงก์เสียงหรือประสิทธิภาพของ OmniHuman 2.0 ได้ด้วยตัวเอง
- ฟังโดยไม่ดู ทำเครื่องหมายการเปลี่ยนอารมณ์ ช่วงหยุด การเน้น เสียงหัวเราะ เสียงกระซิบ และตอนจบของท่อน เขียนสิ่งที่ผู้ฟังอาจอนุมานได้จากเสียงเพียงอย่างเดียว
- ดูแบบปิดเสียง ณ เวลาเหล่านั้น ให้สังเกตใบหน้า สายตา การเคลื่อนไหวศีรษะ และท่าทาง บันทึกว่าการแสดงดูสื่ออะไรได้โดยไม่มีเสียง
- เล่นพร้อมกัน ทำเครื่องหมายเฉพาะความไม่สอดคล้องที่เปลี่ยนความหมายหรือรบกวนบทพูด รอยยิ้มเล็ก ๆ ใต้ประโยคที่ distressed อาจสำคัญ; การกะพริบเล็กน้อยมักไม่สำคัญ
ตารางตรวจสอบเปลี่ยนข้อสังเกตเหล่านั้นให้เป็นการดำเนินการถัดไปหนึ่งอย่าง:
| เวลา | สัญญาณเสียง | สัญญาณที่มองเห็น | สอดคล้องหรือไม่? | การทดสอบถัดไปที่เล็กที่สุด |
|---|---|---|---|---|
| 00:04 | วลีที่เงียบและตึงเครียด | รอยยิ้มกว้าง | ไม่ | ลดความเข้มของรอยยิ้มที่ขอไว้ |
| 00:09 | ช่วงหยุดก่อนประโยคที่ให้ความมั่นใจ | ใบหน้านิ่งอยู่ | อาจจะ | เพิ่มการพยักหน้าเบา ๆ หนึ่งครั้งหลังช่วงหยุด |
| 00:13 | เสียงหัวเราะในบันทึก | สีหน้ายังจริงจัง | ไม่ | ตรวจสอบว่าการตัดต่อเสียงยังคงเสียงหัวเราะไว้อย่างชัดเจนหรือไม่ |
รายการด้านบนเป็นตัวอย่างสมมติของวิธีใช้ตาราง ไม่ใช่ข้อสังเกตจากการรันโมเดล บันทึกการตรวจสอบของคุณควรอ้างอิงคลิปของคุณเอง เปลี่ยนครั้งละหนึ่งอย่าง: แก้พรอมต์ ปรับการตัดต่อเสียง หรือลองภาพบุคคลอื่น จากนั้นทำการตรวจเดิมซ้ำในเวลาเดิม
หากความไม่สอดคล้องยังคงอยู่แม้มีสัญญาณกำกับชัดเจนและคำสั่งที่มุ่งเป้า ให้ถือเป็นข้อจำกัดของการสร้างสำหรับเทกนั้น คำคุณศัพท์เพิ่มเติมอาจเพิ่มสัญญาณรบกวนโดยไม่แก้ปัญหาจังหวะเวลาหรือการแสดง ตัดสินใจว่าอินพุตหรือเวิร์กโฟลว์อื่นคุ้มค่าจะทดสอบ หรือเทกนั้นเหมาะกับบริบทที่ตั้งใจแล้ว
แก้ปัญหาสีหน้าเรียบหรือไม่สอดคล้อง
ใช้อาการเพื่อเลือกขั้นถัดไปแบบควบคุม สิ่งเหล่านี้เป็นสมมติฐานการแก้ปัญหาทั่วไป ไม่ใช่คำกล่าวอ้างข้อบกพร่องของ OmniHuman 2.0 ที่ยืนยันแล้ว
| สิ่งที่คุณสังเกต | สาเหตุที่เป็นไปได้ | การทดสอบถัดไปหนึ่งอย่าง |
|---|---|---|
| ใบหน้าดูเป็นกลางตลอดทั้งคลิป | เสียงมีความเปรียบต่างน้อย หรือคำสั่งไม่มีสัญญาณที่มองเห็น | ใช้ท่อนเสียงที่แสดงอารมณ์มากกว่าหรือขอการกระทำที่ชัดเจนหนึ่งอย่างในจังหวะที่ชัดเจน |
| ใบหน้าแสดงเกินจริงในบทที่ละเอียดอ่อน | พรอมต์ขออารมณ์ที่แรงกว่าแทร็กจะรองรับ | ลบการกระทำเกินจำเป็นและลดความเข้มของอารมณ์ |
| ปากดูเหมือนไม่ตรงจังหวะ | บันทึกมีเสียงรบกวน เสียงทับกัน ความเงียบยาว หรือการตัดต่อที่ยาก | ลองตัดต่อให้สะอาดขึ้นและจังหวะกระชับขึ้นก่อนเขียนพรอมต์ใหม่ |
| ผู้ฟังดูเหมือนพูดในภาพกลุ่ม | บทบาทผู้พูดและผู้ฟังอาจคลุมเครือในเวิร์กโฟลว์ที่ทดสอบ | ระบุแต่ละคนตามตำแหน่งและเจาะจงว่าใครพูด หากอินเทอร์เฟซรองรับ |
| ตัวตนหรือรายละเอียดเล็ก ๆ เปลี่ยนไประหว่างการเคลื่อนไหว | การจัดเฟรมต้นทางหรือการเคลื่อนไหวที่ขอไว้อาจทำให้ตัดสินความสม่ำเสมอได้ยากขึ้น | ทำให้การเคลื่อนไหวเรียบง่ายขึ้นและเปรียบเทียบเทกที่สั้นกว่าและนิ่งกว่า |
อย่าสมมติว่าปัญหาเสียงจะแก้ได้ด้วยพรอมต์เท่านั้น ก่อนอื่นให้ตรวจว่าคำชัดเจนหรือไม่ และความเงียบหรือการตัดต่อรบกวนจังหวะหรือไม่ หากสิ่งเหล่านั้นดีอยู่แล้ว ให้ทำให้ทิศทางภาพเรียบง่ายขึ้น การลองซ้ำที่มุ่งเป้าให้หลักฐานที่ดีกว่าการเขียนอินพุตใหม่ทั้งหมดพร้อมกัน
OmniHuman 2.0 มีให้ใช้บน Atlas Cloud หรือไม่?
หน้าโมเดลสาธารณะปัจจุบันของ Atlas Cloud แสดงรายการ Avatar Omni Human 1.5 และจัดทำเอกสารอินพุตภาพ เสียง และพรอมต์แบบไม่บังคับ ฉันไม่พบ OmniHuman 2.0 ในรายการโมเดลของ Atlas ระหว่างการตรวจสอบนี้ นั่นหมายความว่าโมเดล 2.0 เวอร์ชัน exact ไม่ควรถูกนำเสนอว่ารันได้ผ่าน Atlas Cloud
หากคุณต้องการสำรวจงานอวตารที่ขับเคลื่อนด้วยเสียงที่เกี่ยวข้องบน Atlas ให้ดู หน้าโมเดล Avatar Omni Human 1.5 และอินพุตที่มีเอกสารอธิบาย เอกสารระบุภาพอ้างอิง URL เสียง และพรอมต์แบบไม่บังคับ; อธิบายเสียงได้ถึง 60 วินาที และแนะนำ 15 วินาทีหรือน้อยกว่าเพื่อคุณภาพดีที่สุด นั่นเป็นรายละเอียดของ v1.5 ไม่ใช่ข้อกำหนดของ OmniHuman 2.0 ตรวจสอบ แค็ตตาล็อกโมเดล Atlas ปัจจุบัน สำหรับความพร้อมใช้งานจริงและราคาก่อนเลือกเวิร์กโฟลว์ ฉันไม่สามารถยืนยันราคาสาธารณะปัจจุบันของโมเดลนี้ได้ระหว่างการค้นคว้า ดังนั้นบทความนี้จึงไม่อ้างราคา
ตรวจสอบสิทธิ์และบริบทก่อนเผยแพร่
ก่อนแชร์บุคคลที่ถูกทำให้เคลื่อนไหว ให้ยืนยันว่าคุณมีสิทธิ์ใช้ภาพบุคคลและเสียงเพื่อวัตถุประสงค์ที่ตั้งใจ ตรวจสอบสิทธิ์ด้านดนตรี รูปลักษณ์ เสียง และการเผยแพร่สำหรับบริบทนั้นด้วย ข้อกำหนดอาจแตกต่างตามวัสดุต้นทางและการใช้งาน; เช็กลิสต์นี้เป็นคำแนะนำเชิงปฏิบัติ ไม่ใช่ข้อสรุปทางกฎหมาย
ติดป้ายสื่อสังเคราะห์หรือสื่อที่ตัดต่อเมื่อผู้ชมอาจเข้าใจผิดได้อย่างสมเหตุสมผลว่าเป็นฟุตเทจสารคดีหรือคำแถลงปัจจุบันของบุคคลจริง เก็บโน้ตโครงการเกี่ยวกับไฟล์ต้นทางและการตัดต่อ โดยเฉพาะงานลูกค้าหรือแคมเปญ การแสดงที่จัดตำแหน่งทางเทคนิคแล้วยังต้องมีบริบทการเผยแพร่ที่รับผิดชอบ
สำหรับ การจับคู่เสียงที่สื่ออารมณ์และสีหน้าของ OmniHuman 2.0 ขั้นถัดไปที่มีประโยชน์คือการทดสอบแบบควบคุม: เลือกภาพบุคคลที่ชัดเจน ทำเครื่องหมายจังหวะอารมณ์ของเสียง เขียนคำสั่งสั้นหนึ่งข้อ และตรวจเวลาเดียวกันซ้ำทั้งตอนปิดและเปิดเสียง หากคุณกำลังพิจารณาตัวเลือกที่โฮสต์บน Atlas ให้ยืนยันโมเดล exact และราคาปัจจุบันก่อน
คำถามที่พบบ่อย
OmniHuman 2.0 สร้างเสียงหรือไม่?
เวิร์กโฟลว์ที่อธิบายโดยคู่มือบุคคลที่สามเริ่มจากเสียงที่ให้มาและทำให้ภาพบุคคลเคลื่อนไหวตามเสียงนั้น อย่าสมมติว่าโมเดลสร้างเสียง เว้นแต่อินเทอร์เฟซผลิตภัณฑ์นั้นจัดทำเอกสารความสามารถดังกล่าว
OmniHuman 2.0 สามารถทำให้การร้องเคลื่อนไหวได้เช่นเดียวกับการพูดหรือไม่?
คู่มือ OmniHuman 2.0 ของบุคคลที่สามอธิบายการใช้ทั้งเสียงพูดและเสียงร้อง สำหรับการทดสอบการร้อง ให้ใช้ท่อนที่เน้นเสียงร้องซึ่งมีถ้อยคำชัดเจน จากนั้นกำกับการกระทำที่มองเห็นรอบโน้ตที่ถือไว้หรือตอนจบของท่อน
พรอมต์ควรพูดบทสนทนาหรือเนื้อเพลงซ้ำหรือไม่?
โดยปกติไม่ควร บันทึกเสียงให้คำอยู่แล้ว ใช้พรอมต์สำหรับทิศทางที่มองเห็น เช่น สีหน้า ท่าทาง การจัดเฟรม หรือสัญญาณฉาก และหลีกเลี่ยงการเพิ่มถ้อยคำที่ขัดกับแทร็ก
ควรเปลี่ยนอะไรก่อนหากสีหน้าดูผิด?
ใช้การตรวจสามรอบเพื่อระบุตำแหน่งความไม่สอดคล้อง หากตัวเสียงเองไม่ชัดหรืออารมณ์แบน ให้ทดสอบแก้ไขเสียงก่อน หากสัญญาณกำกับชัดเจนแต่ใบหน้าพลาด ให้ลดความซับซ้อนและปรับเวลาของคำสั่งในพรอมต์หนึ่งข้อ
OmniHuman 2.0 อยู่บน Atlas Cloud หรือไม่?
ฉันไม่พบ OmniHuman 2.0 ในแค็ตตาล็อกโมเดลสาธารณะของ Atlas Cloud ระหว่างการค้นคว้านี้ Atlas จัดทำเอกสาร Avatar Omni Human 1.5 เป็นตัวเลือกที่เกี่ยวข้อง; ยืนยันรายการปัจจุบันก่อนเลือกใช้





