

คุณขอให้ตัวละครแสดงท่าทางไปทั่วเฟรม แต่ซอร์สของคุณเป็นภาพโคลสอัปใบหน้า ไม่มีประโยคอัจฉริยะใดกู้คืนรายละเอียดไหล่ มือ หรือเสื้อผ้าที่หายไปได้อย่างแน่นอน การสร้างท่าทางเต็มตัวด้วย OmniHuman 2.0 จากภาพเดียว ได้ผลดีที่สุดเมื่อเป็นตัวเลือกที่ประสานกัน: ให้โมเดลมีเฟรมที่บรรจุส่วนของร่างกายที่คุณต้องการให้เคลื่อนไหว มีเสียงที่มีคิวการแสดงชัดเจน และพรอมป์ต์สั้น ๆ ที่อธิบายหนึ่งการกระทำ
OmniHuman เป็นระบบสร้างวิดีโอมนุษย์ที่ขับเคลื่อนด้วยเสียง เวิร์กโฟลว์ที่โฆษณาไว้นั้นผสมผสานภาพนิ่งและเสียง โดยมีคำสั่งข้อความแบบเลือกได้สำหรับการเคลื่อนไหวหรือพฤติกรรมกล้อง ให้มอง “เต็มตัว” เป็นประเภทของการแสดงที่คุณต้องการ ไม่ใช่การรับประกันว่าภาพพอร์ตเทรตทุกภาพจะสร้างร่างที่สมบูรณ์และนิ่งได้ ข้อมูลจำเพาะที่เปิดเผยต่อสาธารณะซึ่งอ้างถึงที่นี่เป็นของ OmniHuman 1.5 ดังนั้นไม่ควรสันนิษฐานว่าข้อมูลเหล่านี้อธิบายอินเทอร์เฟซหรือการติดตั้งใช้งาน OmniHuman 2.0 ทุกแบบ
ประเด็นสำคัญ
- ภาพต้นทางกำหนดพื้นที่ร่างกายที่มองเห็นและองค์ประกอบเริ่มต้น
- เสียงให้จังหวะการพูดหรือร้อง ส่วนพรอมป์ต์เพิ่มทิศทางด้านภาพ
- จับคู่การครอปกับท่าทาง และให้การกระทำที่ขออยู่ในเฟรมที่มองเห็น
- ตรวจสอบเวอร์ชัน ขีดจำกัดอินพุต และราคาบนหน้าผลิตภัณฑ์ทางการปัจจุบันก่อนตัดสินใจ
OmniHuman 2.0 ทำอะไรได้สำหรับท่าทางเต็มตัว
OmniHuman 2.0 ถูกนำเสนอเป็นวิธีสร้างวิดีโอการแสดงของมนุษย์ที่ขับเคลื่อนด้วยภาพและเสียง ภาพนิ่งกำหนดตัวแบบและมุมมองเริ่มต้น เสียงให้เสียงพูด จังหวะ และข้อมูลอ้างอิงด้านเวลาแก่การแสดง ข้อความแบบเลือกได้สามารถอธิบายฉาก การเคลื่อนไหว หรือทิศทางกล้อง คลิปที่สร้างขึ้นจะรวมคิวเหล่านี้เป็นผลลัพธ์ที่เคลื่อนไหว
นั่นทำให้ภารกิจกว้างกว่าการทำให้ปากนิ่งขยับ ผลลัพธ์ที่มีประโยชน์อาจเกี่ยวข้องกับการขยับริมฝีปาก สีหน้า การเคลื่อนไหวศีรษะ ท่าทาง และท่ามือ ส่วนเหล่านั้นต้องสอดคล้องกับการแสดงเดียวกัน สำหรับวิดีโออธิบายแบบพูด ท่ามือเปิดฝ่ามือเล็ก ๆ ในช่วงวลีสำคัญอาจดูเป็นธรรมชาติกว่าการขยับแขนต่อเนื่อง สำหรับการร้องเพลง ร่างกายสามารถตามการแบ่งวลีและพลังตลอดเพลงได้
โมเดลไม่ได้รับบันทึก 3D ที่สมบูรณ์ของบุคคลจากภาพถ่ายหนึ่งภาพ มันต้องอนุมานสิ่งที่อยู่นอกการครอปและพื้นผิวที่ซ่อนอยู่ควรมีลักษณะอย่างไรเมื่อตัวแบบเคลื่อนไหว คำขอให้ทำท่าทางเต็มตัวจึงมีความไม่แน่นอนมากขึ้นเมื่ออินพุตแสดงเฉพาะใบหน้า การควบคุมในทางปฏิบัติคือเลือกภาพอ้างอิงให้สอดคล้องกับการกระทำที่คุณต้องการ จากนั้นใช้ข้อความปรับแต่งสิ่งที่ได้รับการสนับสนุนทางภาพอยู่แล้ว
หน้าโครงการวิจัยของ OmniHuman 1.5 อธิบายแอนิเมชันที่ขับเคลื่อนด้วยเสียงจากภาพเดียว และพูดถึงการควบคุมการเคลื่อนไหวและพรอมป์ต์ นั่นเป็นพื้นฐานที่มีประโยชน์สำหรับตระกูลโมเดลนี้ แต่ไม่ใช่หลักฐานว่าพรอมป์ต์ OmniHuman 2.0 เฉพาะเจาะจงจะสร้างท่าทางที่ระบุได้ทุกครั้ง (หน้าโครงการ OmniHuman 1.5)
ก่อนเลือกอินพุต ให้กำหนดช็อตที่ต้องการในหนึ่งประโยค: “ผู้บรรยายครึ่งตัวเน้นจุดหนึ่ง” “นักแสดงเต็มตัวถ่ายน้ำหนักขณะร้องเพลง” หรือ “ผู้พูดโคลสอัปส่งบทพูดที่สงบ” จากนั้นเฟรมและเสียงสามารถรับใช้ภารกิจเดียวนั้นได้
เลือกภาพต้นทางที่เหลือพื้นที่ให้ท่าทาง
สำหรับท่าทางเต็มตัว เริ่มจากภาพต้นทางที่กว้างที่สุดซึ่งยังเหมาะกับองค์ประกอบสุดท้าย หากผลลัพธ์มีจุดประสงค์เป็นวิดีโอพูดคุยแบบโคลสอัป ภาพพอร์ตเทรตแบบแน่นอาจเหมาะสม หากผู้ชมต้องเห็นมือชี้ไปที่วัตถุหรือตัวแบบถ่ายน้ำหนัก ให้รวมส่วนเหล่านั้นไว้ในภาพต้นทาง
| ผลลัพธ์ที่ต้องการ | การครอปเริ่มต้นที่มีประโยชน์ | การเคลื่อนไหวที่สมเหตุสมผลในการขอ |
|---|---|---|
| การบรรยายแบบโคลสอัป | ศีรษะและไหล่ | สีหน้า การหันศีรษะ การเคลื่อนไหวไหล่เล็กน้อย |
| การอธิบายสินค้า | ครึ่งตัวโดยเห็นมือ | การชี้สั้น ๆ การนำเสนอ หรือการเน้นด้วยฝ่ามือเปิด |
| การแสดงแบบยืน | ทั้งตัวโดยมีพื้นที่รอบร่างกาย | การเปลี่ยนท่าทาง การถ่ายน้ำหนัก และท่าทางที่ใหญ่ขึ้น |
สิ่งเหล่านี้เป็นทางเลือกในการผลิต ไม่ใช่ข้อกำหนดของ BytePlus ที่เผยแพร่หรือการรับประกันความสำเร็จ สำหรับเฟรมเต็มตัว ให้เว้นพื้นที่หายใจรอบมือ ข้อศอก และเท้า มือที่ชิดขอบอยู่แล้วอาจถูกตัดทันทีที่ขยับ ทำให้ใบหน้าชัดพอที่จะอ่านได้ ใช้แสงสม่ำเสมอเท่าที่ทำได้ และหลีกเลี่ยงซอร์สที่มีบุคคลอื่นตัดผ่านตัวแบบ พื้นหลังที่สะอาดยังทำให้สังเกตการเคลื่อนไหวพื้นหลังที่ไม่ต้องการได้ง่ายขึ้น
ภาพควรคล้ายกับช็อตที่คุณวางแผนจะเผยแพร่ ซอร์สแนวตั้งที่ใส่ในเอาต์พุตแนวนอนอาจต้องสร้างพื้นหลังและพื้นที่ร่างกายขึ้นมาใหม่มากกว่า ซอร์สที่จัดเฟรมแนวตั้งมักตัดสินได้ง่ายกว่าสำหรับตัวละครยืนที่มุ่งไว้สำหรับโพสต์โซเชียลแนวตั้ง สิ่งเหล่านี้เป็นแนวทางองค์ประกอบ ตรวจสอบการควบคุมปัจจุบันของเครื่องมือเป้าหมายสำหรับขีดจำกัดอัตราส่วนภาพหรือความละเอียดจริง
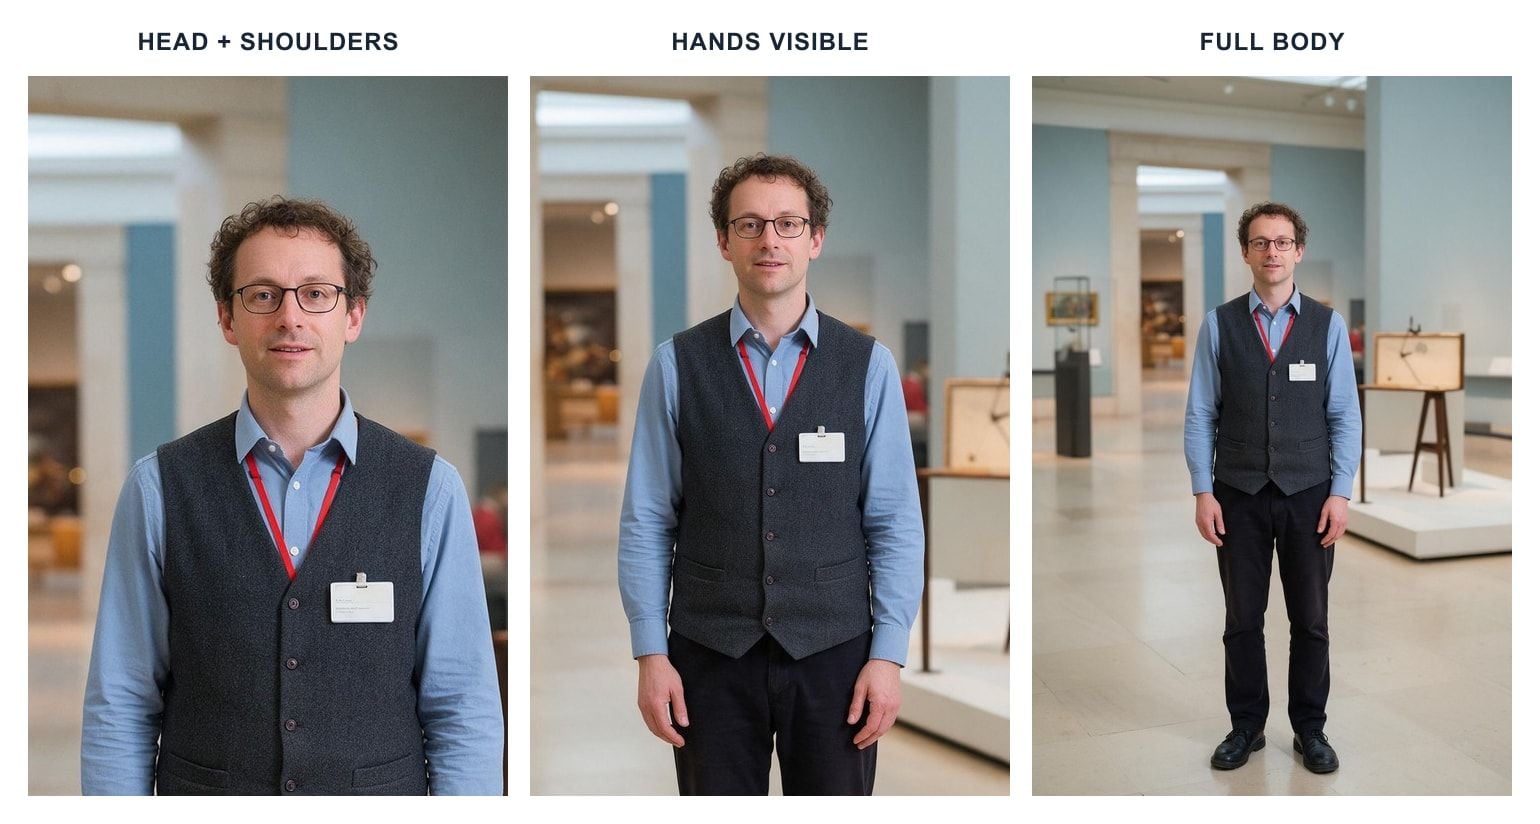
ภาพต้นทางตัวอย่างเดียวกันในสามการครอป: เฟรมโคลสอัปเหมาะกับสีหน้า มือที่มองเห็นให้พื้นที่ผู้บรรยายในการแสดงท่าทาง และทั้งตัวรองรับการแสดงแบบยืน
การทดสอบตัดสินใจง่าย ๆ ช่วยได้: ชี้ไปที่ส่วนของร่างกายที่ต้องเคลื่อนไหวในช็อตสุดท้าย หากไม่มีในซอร์ส ให้เปลี่ยนภาพหรือลดเป้าหมายการเคลื่อนไหว ตัวอย่างเช่น ใช้ภาพครึ่งตัวที่เห็นมือสำหรับผู้บรรยายที่จะเน้น “สามขั้นตอนที่นำไปใช้ได้จริง” ภาพพอร์ตเทรตเฉพาะใบหน้าเหมาะกว่าสำหรับการทักทายสั้น ๆ หรือการบรรยายโคลสอัป
สร้างการแสดงจากภาพเดียวด้วยเสียงและคำสั่ง
ให้คิดว่าอินพุตเป็นสามงานที่ต่างกัน ภาพตอบว่าใครอยู่บนหน้าจอและช็อตเริ่มอย่างไร เสียงนำคำพูดจริง การหยุด และพลังเสียง ข้อความคำสั่งขอพฤติกรรมทางภาพที่เข้ากับคิวเหล่านั้น ทำให้อินพุตสอดคล้องกัน เสียงสงบจับคู่กับ “การเต้นรัว ๆ ตลอดเวลา” ทำให้โมเดลได้ทิศทางที่ขัดแย้งกันและอาจสร้างการแสดงที่ดูประหลาด
เวิร์กโฟลว์รอบแรกที่มีประโยชน์คือ:
- เลือกช็อต ตัดสินว่าผู้ชมต้องเห็นใบหน้าแบบโคลสอัป มือที่มองเห็น หรือทั้งตัว เลือกซอร์สที่มีพื้นที่นั้นในเฟรม
- เตรียมเสียง代表性 ใช้ช่วงสั้น ๆ ของเสียงบรรยายหรือเพลงจริง รวมวลีที่ท่าทางควรเกิดขึ้น การทดสอบควรเป็นตัวแทนจังหวะและการส่งมอบสุดท้าย
- เพิ่มแนวคิดการเคลื่อนไหวหนึ่งอย่าง อธิบายท่าทางเดียวและตำแหน่งที่ควรอยู่ในงานแสดง จำกัดการกระทำและคำสั่งกล้องอื่น ๆ
- สร้างและตรวจสอบ ตรวจใบหน้า มือ ร่างกาย พื้นหลัง และการจัดเฟรมโดยรวม เปลี่ยนอินพุตครั้งละหนึ่งอย่างในการลองครั้งถัดไป
สำหรับวิดีโออธิบายสินค้า บรรทัดทดสอบต้นฉบับอาจเป็น: “เราจะครอบคลุมสามขั้นตอนที่นำไปใช้ได้จริง จากนั้นคุณสามารถเลือกขั้นตอนที่เหมาะกับทีมของคุณ” อัดเสียงโดยมีช่วงหยุดสั้น ๆ ก่อนวลี “สามขั้นตอนที่นำไปใช้ได้จริง” ใช้ภาพครึ่งตัวที่เห็นมือทั้งสองข้าง นั่นให้คิวเชิงความหมายที่ชัดเจนและช่วงการเคลื่อนไหวที่มองเห็นได้สำหรับท่าทางที่ต้องการ
เอกสารทางการของ BytePlus ที่ตรวจสอบได้ที่นี่อ้างถึง OmniHuman 1.5 ไม่ใช่ 2.0 สำหรับ 1.5 เอกสารระบุว่าภาพและเสียงเป็นอินพุตที่จำเป็น มีพรอมป์ต์แบบเลือกได้ ภาษาพรอมป์ต์ที่รองรับ และเอาต์พุต 720p หรือ 1080p ภาพรวมยังระบุขีดจำกัดเสียง 60 วินาที และแนะนำให้ใช้เสียงสั้นลงเพื่อคุณภาพ รายละเอียดเหล่านี้ช่วยแยกแยะผลิตภัณฑ์ 1.5 ที่มีเอกสารประกอบ ตรวจสอบอินเทอร์เฟซ 2.0 หรือเอกสารทางการก่อนนำรายละเอียดใด ๆ ไปใช้กับ 2.0 (เอกสารการสร้างวิดีโอ OmniHuman ของ BytePlus, อัปเดตตุลาคม 2026)
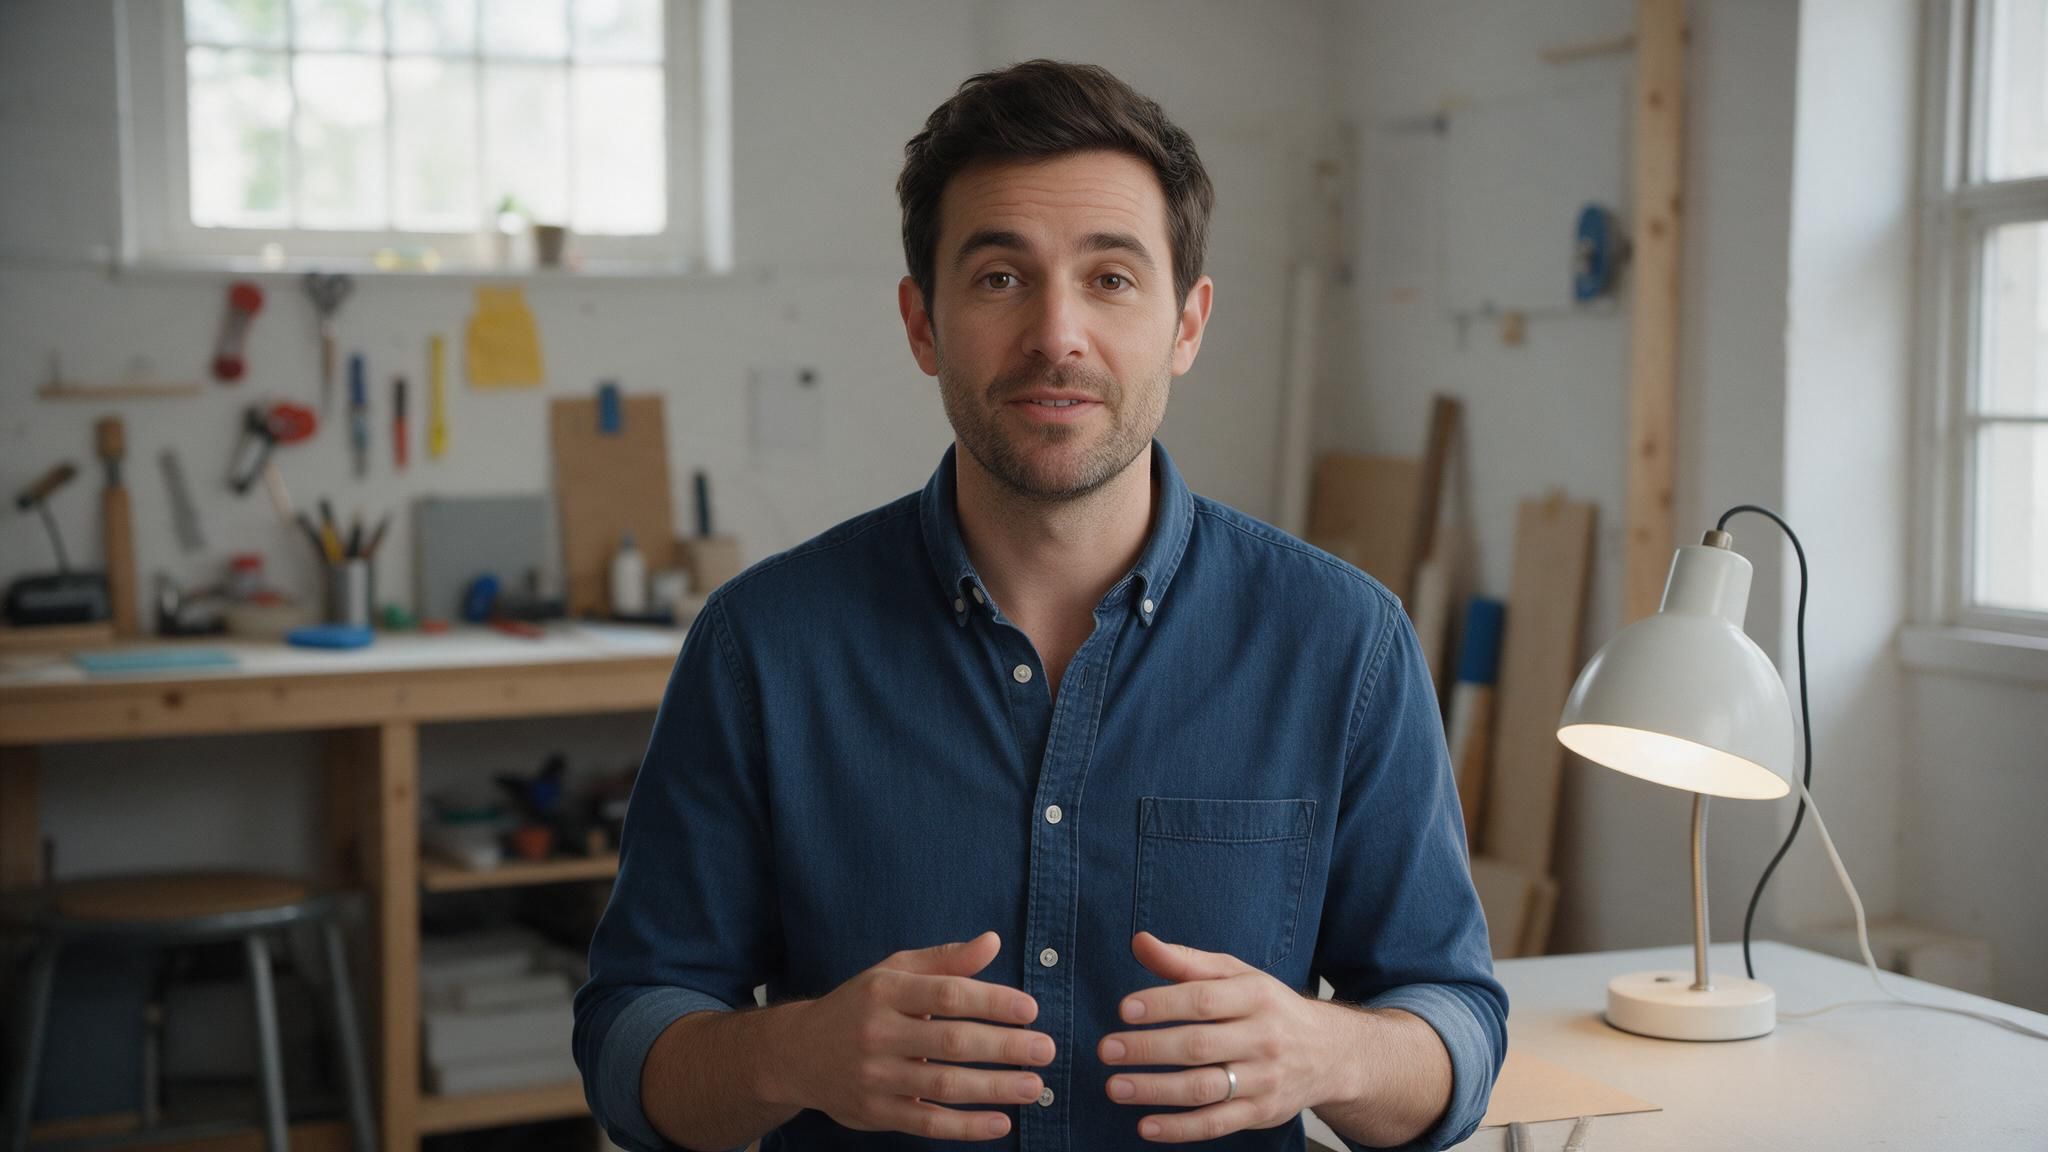
ภาพนิ่งต้นทางตัวอย่างสำหรับวิดีโออธิบายสินค้า: เห็นใบหน้า มือทั้งสองข้าง และโคมไฟของผู้บรรยาย ทำให้ประเมินท่ามือเล็ก ๆ ที่จับจังหวะได้ง่าย นี่คือภาพอินพุต ไม่ใช่เอาต์พุตของ OmniHuman
ใช้ตัวอย่างที่เป็นตัวแทนหนึ่งรายการก่อนเตรียมการอัดเสียงยาว การทดลองสั้น ๆ ทำให้สังเกตการครอปที่ไม่เข้าคู่ วลีที่ไม่มีคิวท่าทาง หรือพรอมป์ต์ที่ขอมากเกินไปได้เร็วขึ้น เป็นทางเลือกด้านการควบคุมคุณภาพ ไม่ใช่ข้ออ้างเกี่ยวกับขีดจำกัดระยะเวลาเฉพาะของ 2.0
เขียนพรอมป์ต์ท่าทางให้มีคิวที่ชัดเจน
พรอมป์ต์จะประเมินได้ง่ายขึ้นเมื่อระบุการกระทำ คิว ขนาดหรือจังหวะ และข้อจำกัดการจัดเฟรมใด ๆ คำสั่งกว้าง ๆ เช่น “ทำให้บุคคลดูเป็นธรรมชาติและแสดงออก” เปิดให้มีการตัดสินใจหลายอย่างค้างอยู่ คำสั่งที่โฟกัสจะบอกโมเดลว่าการกระทำที่มองเห็นได้ใดสำคัญและควรเกิดขึ้นเมื่อใด
ลองตัวอย่างนี้กับบรรทัดตัวอย่างด้านบน:
ผู้พูดส่งบทพูดด้วยโทนเสียงสงบและมั่นใจ รักษากล้องให้นิ่ง เมื่อผู้พูดกล่าวว่า “สามขั้นตอนที่นำไปใช้ได้จริง” ให้ยกมือหนึ่งข้างขึ้นชั่วครู่เพื่อเน้นประเด็น จากนั้นลดลงอย่างเป็นธรรมชาติ ใช้ท่าทางเล็ก ๆ ผ่อนคลายที่อยู่ในเฟรมที่มองเห็น
วลีที่ยกมาช่วยเชื่อมการกระทำกับช่วงเวลาหนึ่งในเสียง “ยกมือหนึ่งข้างขึ้นชั่วครู่” ให้ท่าทางที่มีขอบเขต และ “อยู่ในเฟรมที่มองเห็น” หลีกเลี่ยงการขอการเคลื่อนไหวเกินการครอป นี่คือ템เพลตการเขียนพรอมป์ต์ ไม่ใช่คำสั่ง OmniHuman 2.0 ที่ทดสอบหรือรับประกันแล้ว หากระบบไม่ทำตามคำหรือจังหวะที่แม่นยำอย่างสม่ำเสมอ ให้เก็บวลีเป็นคิวกว้าง ๆ และตัดสินการเคลื่อนไหวที่เรนเดอร์ แทนการสันนิษฐานว่ามีท่าเต้นที่แม่นยำระดับเฟรม
เปลี่ยนเพียงตัวแปรหลักหนึ่งอย่างระหว่างการลอง หากท่าทางปรากฏเร็วเกินไป ให้ปรับคิวหรือช่วงหยุดในเสียง หากการขยับมือใหญ่เกินไป ให้ลดแอมพลิจูดที่ขอ หากแขนไม่นิ่งหรือถูกสร้างขึ้นมาบางส่วน ให้เลือกซอร์สที่เห็นแขนอยู่แล้ว การเปลี่ยนภาพ เสียง การเคลื่อนไหว และทิศทางกล้องพร้อมกันทำให้ยากที่จะรู้ว่าการเปลี่ยนแปลงใดช่วยได้
หลีกเลี่ยงการซ้อนคำขอที่ไม่เกี่ยวข้องกัน: การโบกมือ การชี้ การหัน การเดิน การโคจรกล้อง และการเปลี่ยนอารมณ์ทั้งหมดในบรรทัดสั้น ๆ เดียว แต่ละอย่างเพิ่มความต้องการให้การแสดงเดียวกัน เริ่มจากหนึ่งการเคลื่อนไหวที่มีจุดประสงค์ เพิ่มอย่างที่สองเฉพาะเมื่อผลลัพธ์แรกยังอ่านได้ชัดและฉากต้องการ
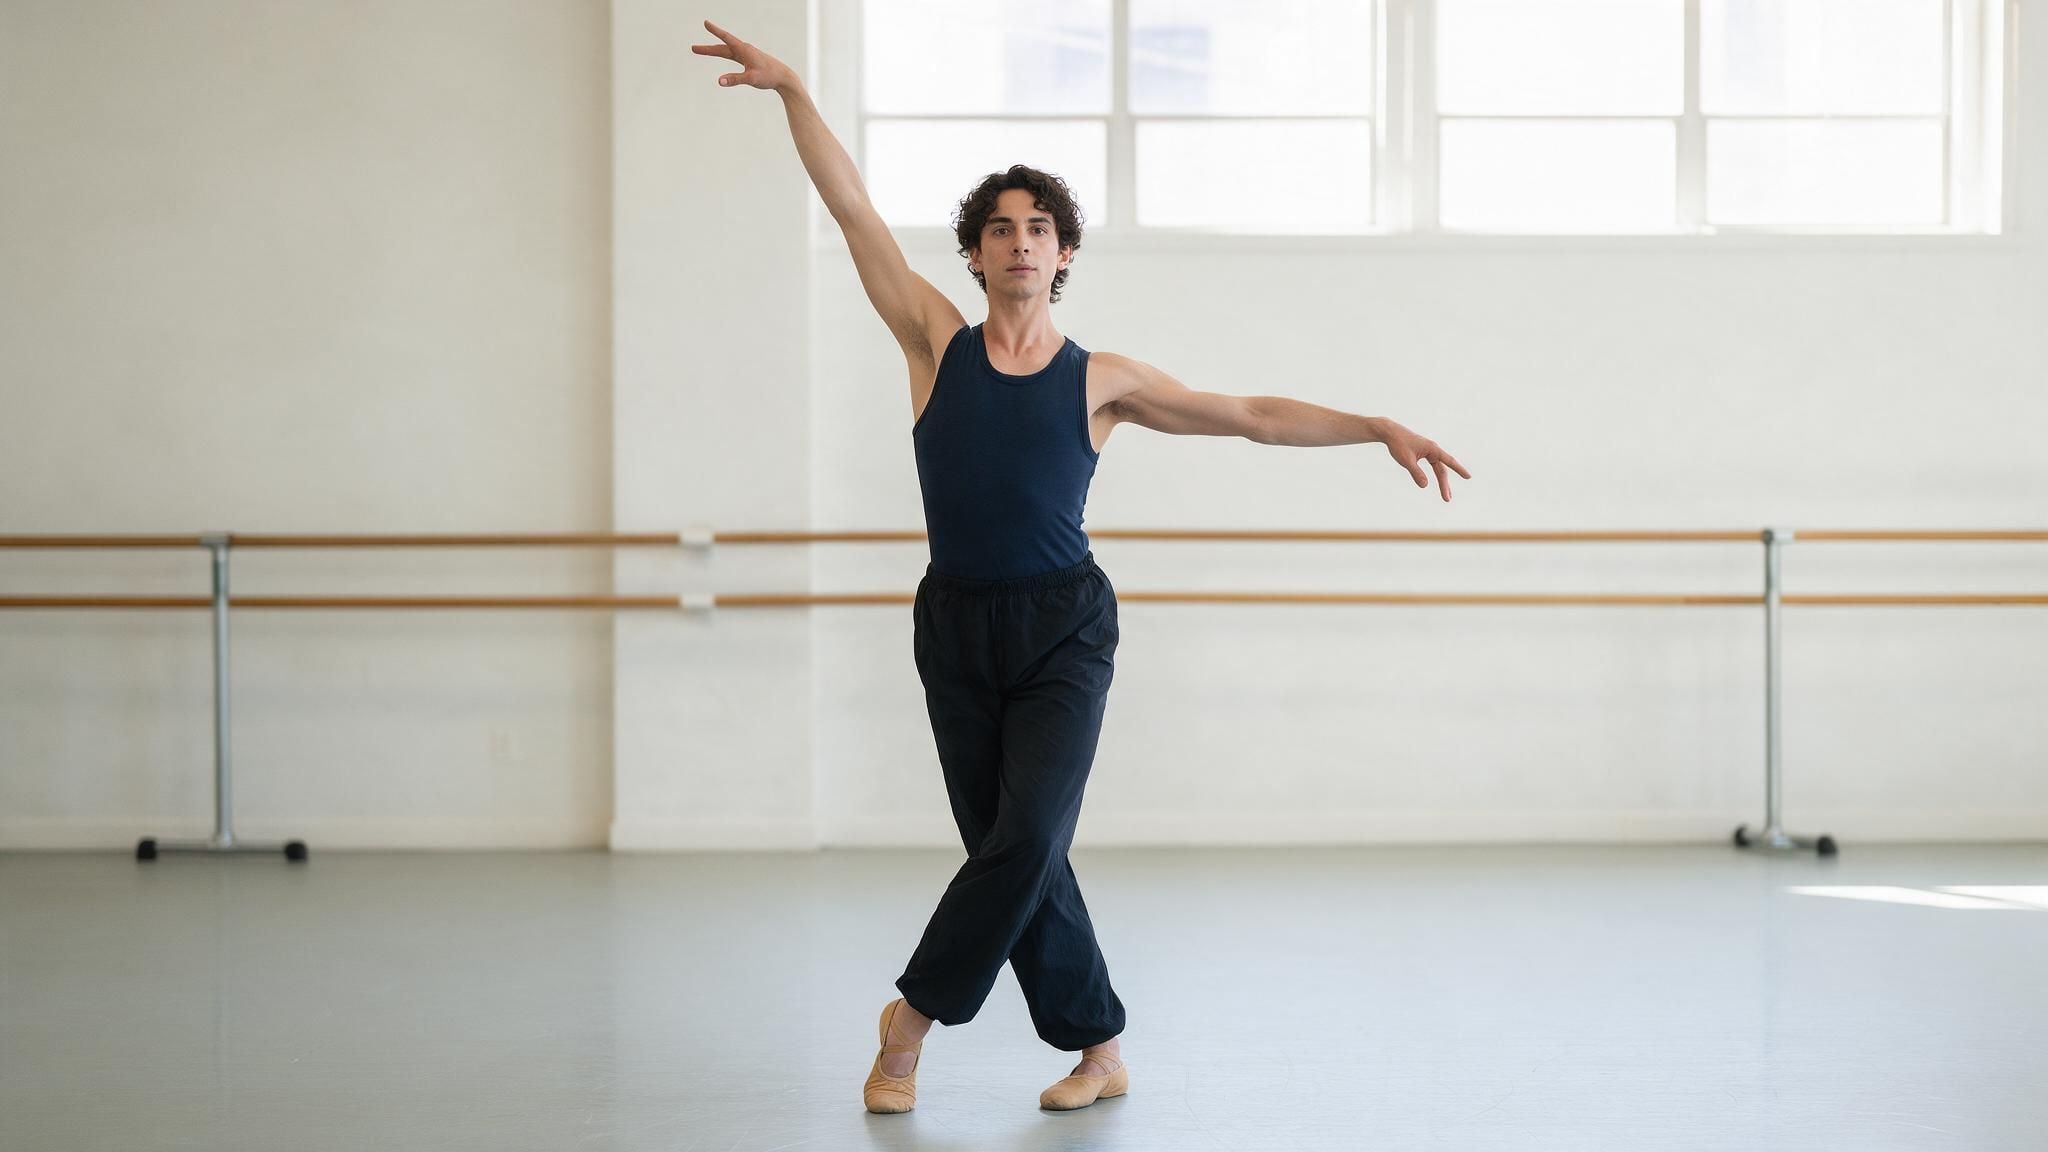
ภาพนิ่งต้นทางตัวอย่างสำหรับท่าเต็มตัวที่ประสานกัน: แขนที่ยกขึ้น แขนที่ยื่นออก และเท้าที่ก้าวยังอยู่ในเฟรม นี่คือภาพอ้างอิงสำหรับวางแผนท่าทาง ไม่ใช่เฟรมที่สร้างโดย OmniHuman
ตรวจสอบผลลัพธ์ก่อนเผยแพร่
ดูผลลัพธ์หนึ่งครั้งสำหรับการแสดงโดยรวม จากนั้นดูอีกครั้งสำหรับรายละเอียดเฉพาะ การดูครั้งที่สองมีประโยชน์เพราะคลิปอาจรู้สึกสมเหตุสมผลที่ความเร็วปกติ แต่เผยปัญหามือหรือพื้นหลังเมื่อตรวจใกล้ขึ้น
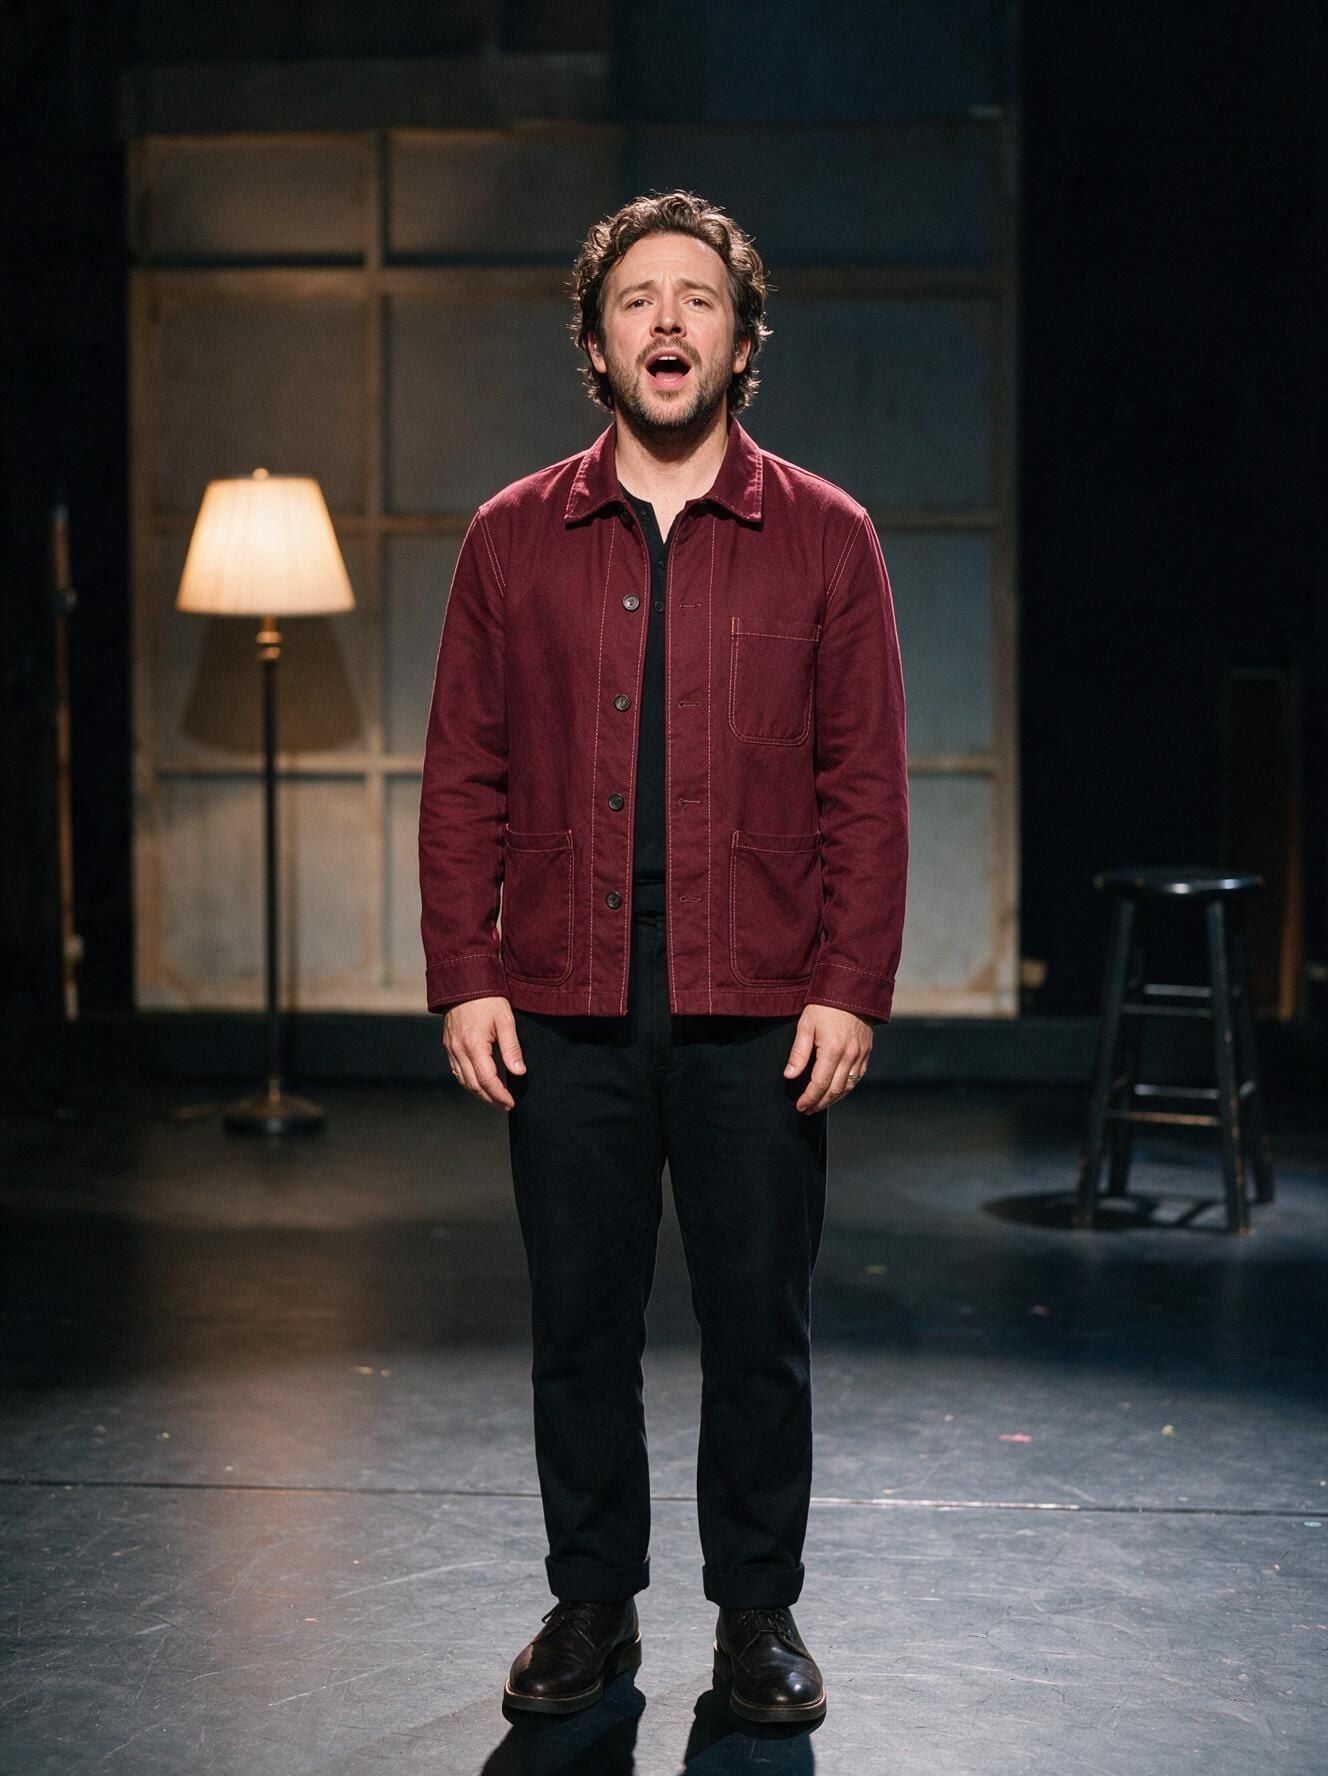
ภาพนิ่งต้นทางตัวอย่างสำหรับการแสดงแบบยืน: เปรียบเทียบเทคที่สร้างขึ้นใด ๆ กับใบหน้า มือ แจ็กเก็ต รองเท้า โคมไฟ และ stools ที่มองเห็นเมื่อตรวจสอบตัวตนและความสอดคล้องของฉาก นี่คือภาพอินพุต ไม่ใช่เฟรมที่สร้างขึ้น
ตรวจสอบห้าด้านเหล่านี้:
- คำพูดและสีหน้า: ปากกว้าง ๆ ตามวลีที่พูดหรือร้องหรือไม่? สีหน้าเข้ากับการส่งเสียงหรือไม่?
- จังหวะท่าทาง: การเคลื่อนไหวปรากฏใกล้แนวคิดหรือช่วงหยุดที่ต้องการหรือไม่? หยุดเมื่อการเน้นจบหรือไม่?
- มือและร่างกาย: มองหานิ้วที่หลอมรวมกันชั่วครู่ ข้อที่งอ แขนเสื้อที่เปลี่ยน หรือสัดส่วนร่างกายที่เปลี่ยนไประหว่างเฟรม
- ตัวตนและฉาก: ใบหน้ายังจำได้หรือไม่? เสื้อผ้า วัตถุพื้นหลัง และแสงยังสอดคล้องกันพอสมควรหรือไม่?
- การจัดเฟรมการแสดง: มือหรือเท้าถูกตัดออกหรือไม่? ตัวแบบยังชัดในอัตราส่วนภาพและการครอปที่คุณต้องการหรือไม่?
เมื่อบางอย่างล้มเหลว ให้ผูกการลองครั้งถัดไปกับสาเหตุที่สังเกตได้ เปลี่ยนภาพเมื่อพื้นที่ร่างกายที่จำเป็นหายไปหรือการครอปไม่เหลือพื้นที่เคลื่อนไหว เปลี่ยนหรือย่อเสียงเมื่อวลีสำคัญเร่ง รีบ ไม่ชัด หรืออารมณ์ไม่เข้าคู่ เขียนคำสั่งใหม่เมื่อการกระทำมาผิดจังหวะหรือกว้างเกินไป หากคลิปมีไว้สำหรับแคมเปญสาธารณะ ให้ยืนยันด้วยว่าคุณมีสิทธิ์ในการทำให้ภาพเคลื่อนไหวและใช้เสียงบันทึก และได้รับความยินยอมใด ๆ ที่จำเป็นสำหรับบุคคลที่ปรากฏ
ผลลัพธ์ที่มีประโยชน์ไม่จำเป็นต้องเป็นอันที่มีการเคลื่อนไหวมากที่สุด สำหรับบทนำคอร์สหรือการอธิบายสินค้า ท่าทางที่ restrained ซึ่งรักษาตัวตนและทำให้ตัวแบบอยู่ในเฟรมอาจสื่อสารได้ดีกว่าการกระทำ elaborate ที่ดึงความสนใจไปยังข้อผิดพลาดทางภาพ เก็บเทคที่สนับสนุนข้อความและตรงกับรูปแบบการเผยแพร่ จากนั้นเก็บภาพต้นทาง เสียง พรอมป์ต์ และเอาต์พุตที่เลือกไว้ด้วยกันสำหรับการแก้ไขภายหลัง
การเข้าถึง เวอร์ชัน และราคาของ OmniHuman 2.0
BytePlus ระบุ OmniHuman V2.0 ในเอกสารแผนประหยัดสำหรับโมเดลวิดีโอ นั่นยืนยันว่าชื่อเวอร์ชันปรากฏในสื่อของ BytePlus แต่ไม่ได้ยืนยันว่ามี playground 2.0 สาธารณะ ขีดจำกัดอินพุตโดยละเอียด หรือ endpoint ของ Atlas Cloud (BytePlus AI Savings Plans) ตรวจสอบเวอร์ชันโมเดลที่แน่นอนก่อนสร้างเวิร์กโฟลว์รอบ ๆ มัน ชื่อ “OmniHuman 2.0” ไม่ควรถูกมองว่าใช้แทนกันได้กับ “OmniHuman 1.5” เอกสาร BytePlus ที่ปรากฏสำหรับบทความนี้มีป้ายกำกับว่า OmniHuman 1.5 โดยเอกสารสคีมาอินพุตและข้อจำกัดบริการของตัวเอง ซึ่งไม่ควรนำไปใช้กับ 2.0 โดยไม่มีแหล่งทางการที่ตรงกัน
ในเวลาที่ตรวจสอบสำหรับบทความนี้ ไดเรกทอรีโมเดลสาธารณะของ Atlas Cloud แสดงแค็ตตาล็อกโมเดลที่กว้าง แต่ไม่พบหน้ารายละเอียด OmniHuman 2.0 ที่ตรวจสอบได้ที่นั่น หน้ารุ่น Avatar Omni Human ระบุข้อเสนอ 1.5 ที่อยู่ใกล้เคียง ราคาเริ่มต้นที่แสดงไว้ถูกรายงานว่า $0.12 ต่อวินาทีในสื่อทางการ แต่ราคาและส่วนลดอาจเปลี่ยนแปลงได้ ตรวจสอบหน้ารายละเอียดและ ไดเรกทอรีโมเดลของ Atlas Cloud อีกครั้งก่อนจัดงบหรือเผยแพร่ อย่าใช้ราคา 1.5 เป็นการประเมินสำหรับ 2.0
หากคุณต้องการ OmniHuman 2.0 โดยเฉพาะ ให้ยืนยันเส้นทางการเข้าถึงทางการ ข้อกำหนดอินพุตปัจจุบัน และราคากับ BytePlus ก่อนเตรียมสินทรัพย์สำหรับการผลิต หากคุณเปิดรับเวอร์ชันใกล้เคียง ไดเรกทอรีของ Atlas Cloud ช่วยตรวจสอบได้ว่าโมเดลวิดีโอและอวตารใดที่ระบุไว้ปัจจุบันพร้อมใช้งานจากแค็ตตาล็อกเดียว ให้ถือว่านั่นเป็นการเลือกผลิตภัณฑ์แยกต่างหาก: การรัน 1.5 ไม่สามารถตรวจสอบพรอมป์ต์หรือผลลัพธ์ 2.0 ได้
คำถามที่พบบ่อย
OmniHuman 2.0 สามารถสร้างวิดีโอเต็มตัวจากภาพที่มีเฉพาะใบหน้าได้หรือไม่
ภาพที่มีเฉพาะใบหน้าไม่แสดงรายละเอียดร่างกายที่จำเป็นในการชี้นำการแสดงเต็มตัว ระบบอาจอนุมานพื้นที่ที่หายไป แต่รูปลักษณ์และการเคลื่อนไหวของพื้นที่เหล่านั้นอ้างอิงจากซอร์สโดยตรงน้อยกว่า สำหรับท่ามือ ให้ใช้ซอร์สที่แสดงมือและแขนเพียงพอ สำหรับการกระทำแบบยืน ให้เริ่มจากภาพเต็มตัว
OmniHuman 2.0 ต้องใช้เสียงหรือไม่ หรือพรอมป์ต์ข้อความสามารถทำให้ภาพเคลื่อนไหวได้เพียงลำพัง
เวิร์กโฟลว์ OmniHuman ที่อธิบายไว้ขับเคลื่อนด้วยภาพและเสียง โดยมีคำสั่งข้อความแบบเลือกได้ อย่าสันนิษฐานว่าบริการ 2.0 ที่คุณวางแผนจะใช้รองรับการทำภาพเคลื่อนไหวด้วยข้อความเพียงอย่างเดียว ตรวจสอบหน้าผลิตภัณฑ์ปัจจุบันของบริการนั้นสำหรับอินพุตที่ยอมรับ
อินพุตเสียงของ OmniHuman 2.0 ยาวได้เท่าใด
ฉันไม่สามารถตรวจสอบขีดจำกัดระยะเวลาเสียง 2.0 ทางการปัจจุบันได้ ภาพรวม 1.5 ที่ BytePlus เผยแพร่ระบุขีดจำกัดต่ำกว่า 60 วินาที และแนะนำอินพุตสั้นลงเพื่อคุณภาพ แต่นั่นเป็นข้อมูลจำเพาะของ 1.5 ยืนยันขีดจำกัด 2.0 ที่จุดเข้าถึงทางการก่อนบันทึกหรืออัปโหลดแทร็กยาว
OmniHuman 2.0 พร้อมใช้งานบน Atlas Cloud แล้วหรือยัง
ไม่พบรายการ OmniHuman 2.0 สาธารณะที่ตรวจสอบได้ในไดเรกทอรี Atlas Cloud เมื่อตรวจสอบบทความนี้ หน้า OmniHuman ที่อยู่ใกล้เคียงของ Atlas Cloud เป็นของ 1.5 ตรวจสอบไดเรกทอรีอีกครั้งก่อนใช้ เนื่องจากความพร้อมของแค็ตตาล็อกอาจเปลี่ยนแปลงได้
ก่อนเริ่มความพยายาม การสร้างท่าทางเต็มตัวด้วย OmniHuman 2.0 จากภาพเดียว ครั้งถัดไป ให้ตัดสินใจหนึ่งอย่างก่อน: ระบุพื้นที่ร่างกายที่ช็อตสุดท้ายต้องแสดง จากนั้นเลือกซอร์สที่มีพื้นที่นั้นอยู่แล้ว ตรวจสอบเวอร์ชันที่แน่นอนและขีดจำกัดปัจจุบันที่บริการที่คุณจะใช้ และทดสอบข้อความเสียงสั้น ๆ ที่เป็นตัวแทนหนึ่งช่วงก่อนเตรียมเทคสำหรับการผลิตเต็มรูปแบบ





