ไปป์ไลน์แบบ agentic ในโปรดักชันมักล่มบ่อยครั้งจาก schema violation ที่ไม่คาดคิด แม้แต่ LLM แบบ autoregressive ระดับท็อปก็ยังล้มเหลวในการ parse JSON ระหว่างการเรียกใช้ tool ปริมาณมาก ทำให้ผู้พัฒนาต้องสร้าง retry loop ที่ซับซ้อนและ error handler แบบ custom
TypeSafe Jev แก้ปัญหาความบกพร่องเชิงโครงสร้างนี้ด้วยการทิ้งการสร้างแบบ sequential ทีละ token ทั้งหมด โดยทำงานเป็น decision model แบบ non-autoregressive Jev จะรับ application state และประเมินคำถาม schema ที่ประกาศไว้ล่วงหน้าใน parallel forward pass เพียงครั้งเดียว เนื่องจากตัวเลือกผลลัพธ์ที่เป็นไปได้ถูกจำกัดขอบเขตอย่างเคร่งครัดก่อนการ execute Jev จึงกำจัด JSON ที่ผิดรูปแบบ ชื่อ tool ที่ไม่ถูกต้อง และข้อความนอก schema ได้ในเชิงคณิตศาสตร์
สรุปสั้น: TypeSafe Jev AI คืออะไร? ประสิทธิภาพและ Benchmark ความเร็ว
TypeSafe Jev AI เป็น decision model แบบ non-autoregressive ที่สร้างขึ้นเพื่อการจำแนกประเภท การให้คะแนน intent และการ routing ไมโครเซอร์วิสแบบมีโครงสร้างภายในเสี้ยววินาที ต่างจาก LLM แบบ autoregressive ตรงที่ Jev ประเมินตัวเลือก schema ที่ประกาศไว้ล่วงหน้าใน forward pass เพียงครั้งเดียว
- Zero Hallucination ในระดับ Type: แทนที่ string decoding loop ด้วย state schema primitive ที่มีขอบเขตจำกัด ให้อัตราความผิดพลาดเชิง type 0%
- Execution ต่ำกว่า 500ms: การสุ่มแบบขนาน non-autoregressive ทำ latency P95 ที่ 70ms–500ms เร็วขึ้นสูงสุด 200 เท่าเมื่อเทียบกับ LLM มาตรฐาน
- Output Token ฟรี: ไม่มีการสร้าง sequential token เลย ทำให้ output token ฟรี completamente ที่ $0.042/1M input token
- เหมาะที่สุดสำหรับ: การ routing ไมโครเซอร์วิส, การ dispatch tool แบบ agentic, การ triage ticket และการ gating intent
ทบทวน AI Stack ใหม่: สัญชาตญาณ System 1 กับเหตุผล System 2
เมื่อออกแบบซอฟต์แวร์ backend ที่ขยายระบบได้ การบังคับให้การตรวจสอบเงื่อนไขง่ายๆ ต้องผ่าน chat completion endpoint ที่หนักหน่วงทำให้เกิด latency ของระบบอย่างรุนแรง ไมโครเซอร์วิสส่วนใหญ่ไม่ต้องการข้อความเชิงสร้างสรรค์หรือการสร้าง chain-of-thought หลายขั้นตอน แต่ต้องการการเลือกที่ทันทีและ deterministic จากตัวเลือกที่รู้อยู่แล้ว
การนำกรอบความคิดของ Kahneman มาใช้กับสถาปัตยกรรมซอฟต์แวร์
Diogo Almeida ผู้ร่วมก่อตั้ง TypeSafe ซึ่งเคยร่วมสร้าง Reinforcement Learning from Human Feedback ที่ OpenAI ได้นำเสนอการเปลี่ยนแปลงเชิงโครงสร้างด้วย TypeSafe Jev เพื่อแก้ปัญหาความไร้ประสิทธิภาพนี้ โดยดึงจากกรอบความคิดของ Kahneman โดยตรง แพลตฟอร์มนี้แบ่งการประมวลผลออกเป็นสองชั้นการทำงานที่แตกต่างกันภายในสถาปัตยกรรม AI stack สมัยใหม่:
- System 2 การคิดอย่างช้าและรอบคอบ: LLM แบบ autoregressive มาตรฐานที่ทำงานผ่านการสร้างแบบ sequential ทีละ token โมเดลเหล่านี้เก่งในการร่างเอกสารยาว จัดการเหตุผลที่คลุมเครือ และเขียนโค้ดซับซ้อน
- System 1 การตัดสินใจที่เร็วและใช้สัญชาตญาณ: System One AI model เฉพาะทางที่ฝึกผ่าน Reinforcement Learning for Calibrated Decisions แทน RLHF แบบดั้งเดิม ออกแบบมาเพื่อการจำแนกประเภท การให้คะแนน intent และการ routing execution ภายในเสี้ยววินาทีโดยไม่มี overhead ของการสนทนา
Jev vs LLM ด้านต้นทุนและสถาปัตยกรรม: Decision Model กับ Chat Model
การแทนที่ chat model อเนกประสงค์ด้วย typed decision model เฉพาะทางช่วยเพิ่มประสิทธิภาพ workflow ของไมโครเซอร์วิสโดยการแยกการประเมินที่รวดเร็วออกจากการสร้างเชิงลึก
| มิติทางสถาปัตยกรรม | LLM แบบ Autoregressive (System 2) | TypeSafe Jev (System 1) |
| งานหลัก | การสังเคราะห์ข้อความแบบเปิดกว้าง | การเลือกแบบไม่ต่อเนื่องและการประเมิน schema |
| Latency ในการ Execute | 3,000ms ถึง 30,000ms+ | 70ms ถึง 500ms |
| รูปแบบ Output | text stream ที่ไม่มีโครงสร้าง | schema primitive ที่มี type เคร่งครัด |
| Compute Loop | การ decode token แบบ sequential | การประเมินใน forward pass เพียงครั้งเดียว |
| วัตถุประสงค์การฝึก | ความชอบของมนุษย์ (RLHF) | ความมั่นใจในการตัดสินใจที่ปรับเทียบแล้ว (RLCD) |
การย้ายการ routing, safety guardrail และ function dispatch ออกจาก chat model มาตรฐานช่วยแก้ปัญหาคอขวดด้านประสิทธิภาพที่มีอยู่โดยธรรมชาติใน LLM แบบ autoregressive การนำ System One AI model มาใช้ช่วยให้ reasoning engine ระดับหนักทำงานเฉพาะเมื่อจำเป็นต้องสร้างข้อความแบบเปิดกว้างจริงๆ เท่านั้น
TypeSafe Jev Model สร้าง Zero Hallucination ในระดับ Type ได้อย่างไร
แม้จะเปิด JSON mode แบบเข้มงวด LLM ชั้นนำก็ยังคืนค่า key นอก schema หรือค่า enum ที่ hallucinate เป็นประจำระหว่างการรันในโปรดักชันที่มี concurrency สูง ทำให้ 0.5% ถึง 5% ของคำขอในไปป์ไลน์ล้มเหลว ไมโครเซอร์วิสในโปรดักชันต้องการ type determinism แบบสัมบูรณ์ แต่โมเดล autoregressive ยังคงเปราะบางต่อข้อผิดพลาดในการสร้างสตริงโดยธรรมชาติ
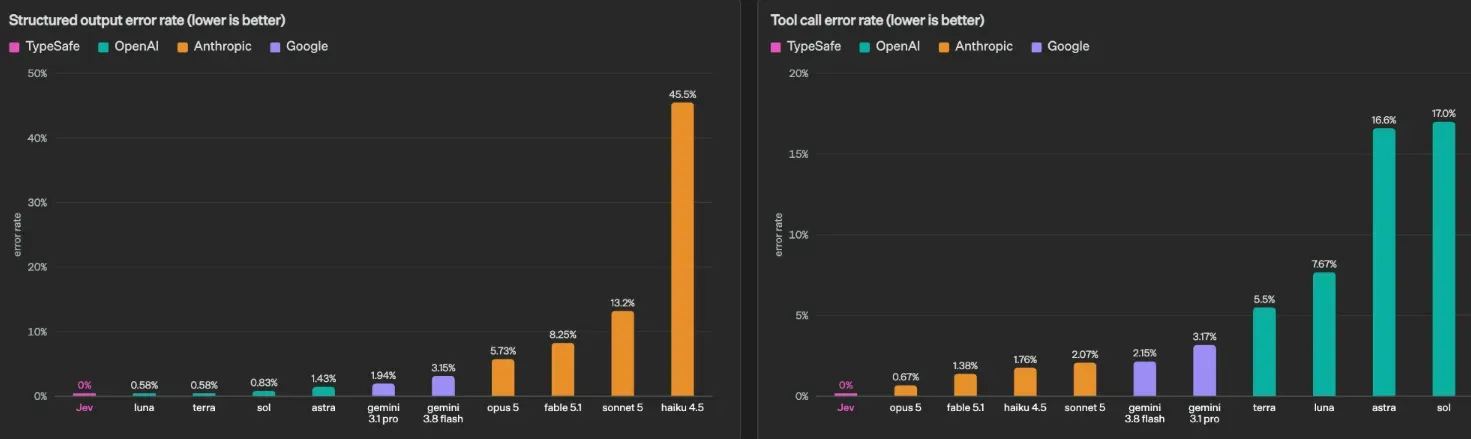
TypeSafe Jev แก้ปัญหานี้ด้วยการแทนที่ string decoding loop ด้วยสถาปัตยกรรม bounded state แทนที่จะสร้างข้อความอิสระแล้วพยายามบังคับให้เป็นรูปแบบ JSON Jev จะประเมินข้อมูลอินพุตเทียบกับข้อจำกัด schema ที่กำหนดไว้ล่วงหน้าใน pass เดียว การเปลี่ยนแปลงเชิงโครงสร้างนี้ให้ zero hallucination AI ที่แท้จริงในระดับ type ส่งผลให้อัตราความผิดพลาดเชิง type 0% ทั่วทั้ง workflow อัตโนมัติ
schema primitive หลักสามประการ
Jev ประมวลผลคำถามอินพุตทั้งหมดผ่าน primitive ที่ชัดเจนสามประการ:
- Choice Primitive: เลือกตัวเลือกเดียวจากรายการที่กำหนดไว้ล่วงหน้าสูงสุด 255 ตัวเลือกเชิงหมวดหมู่ คืนค่า label ที่ชนะพร้อมการแจกแจงความน่าจะเป็นแบบเต็ม
- Score Primitive: ประเมินอินพุตเทียบกับมาตราตัวเลขแบบเรียงลำดับหรือ rubric แบบพรรณนา ให้คะแนนพร้อมการกระจายความน่าจะเป็นในแต่ละระดับ
- Noul Primitive: คำนวณความน่าจะเป็นที่แน่นอนของเงื่อนไข yes หรือ no เป็น float ระหว่าง 0.0 และ 1.0 ขจัดเหตุผลเชิงข้อความที่เป็นตัวกลาง
เนื่องจากทุกคำถาม map เข้ากับ primitive ทั้งสามนี้อย่างเคร่งครัด execution engine จึงไม่สามารถส่ง key ที่ไม่ถูกต้อง ชื่อ tool ที่ไม่อยู่ในรายการ หรือ payload ที่ผิดรูปแบบได้
Type Safety ในการประเมิน Structured Output
chat model แบบดั้งเดิมสร้าง syntax ทีละตัวอักษร ทำให้เกิดความเสี่ยงในการ parse อย่างต่อเนื่องในไปป์ไลน์ backend
| ตัวชี้วัดการประเมิน | Autoregressive JSON Mode | TypeSafe Jev System One |
| การบังคับใช้ Output Type | การตรวจสอบสตริงหลังการสร้าง | primitive ที่มีขอบเขตทางคณิตศาสตร์โดยธรรมชาติ |
| ความถี่ของ Type Error | แปรผัน (อัตราล้มเหลว 0.5% ถึง 5%+) | type error 0% (จำกัดขอบเขตด้วย schema) |
| ความเสี่ยง Enum ไม่ถูกต้อง | สูงหากไม่มี retry loop แบบ custom | ศูนย์ (เป็นไปไม่ได้ตามการออกแบบ) |
การจำกัดการ execute ของโมเดลให้อยู่ใน bounded state อย่างเคร่งครัดรับประกันการประเมิน structured output ที่เชื่อถือได้ แอปพลิเคชันสามารถนำ output ของ Jev ไปใช้ได้โดยตรงโดยไม่ต้องเขียน exception handler สำหรับ schema JSON ที่เสียหาย
หมายเหตุเกี่ยวกับ Type Determinism กับความน่าจะเป็น: TypeSafe Jev รับประกัน type error 0% และการจับคู่ schema ตามการออกแบบ ขจัด syntax ที่ผิดรูปแบบ key ที่หายไป และค่า enum นอกリスト ได้ในเชิงคณิตศาสตร์ อย่างไรก็ตาม เช่นเดียวกับ decision model ทั้งหมด ตัวเลือก output ยังคงเป็นความน่าจะเป็น สำหรับอินพุตที่คลุมเครือโดยธรรมชาติ ควรใช้ confidence score เพื่อ gate การ execute แทนการสมมติความแน่นอนเชิงความหมายแบบสัมบูรณ์
Non-Autoregressive Parallel Sampling ขับเคลื่อน Latency ต่ำกว่า 500ms และ Output ฟรีได้อย่างไร
การใช้ chat endpoint มาตรฐานสำหรับ classification tag ง่ายๆ เช่น {"category": "billing"} ทำให้เกิด latency ที่ไม่จำเป็นในไมโครเซอร์วิสโปรดักชัน เนื่องจากโมเดล autoregressive พึ่งพาการ decode token แบบ sequential เธรด backend จึงถูกบล็อกรอ loop การสร้างทีละตัวอักษร
กลไกของการประเมินแบบ Single-Pass
transformer แบบดั้งเดิม execute autoregressive generation loop ซึ่งทุก token ใหม่ต้องผ่าน network stack แยกต่างหาก การพึ่งพาแบบ sequential นี้ทำให้เกิด latency สูงและพองต้นทุนโครงสร้างพื้นฐานตามปริมาณ token ที่สร้าง
TypeSafe Jev ขจัด sequential generation ด้วยการใช้ non-autoregressive parallel sampling ตามที่ระบุในประกาศเปิดตัว TypeSafe Jev จะรับ context state และประเมินตัวเลือก schema ที่ประกาศไว้ล่วงหน้าทั้งหมดพร้อมกันภายใน forward pass เพียงครั้งเดียว
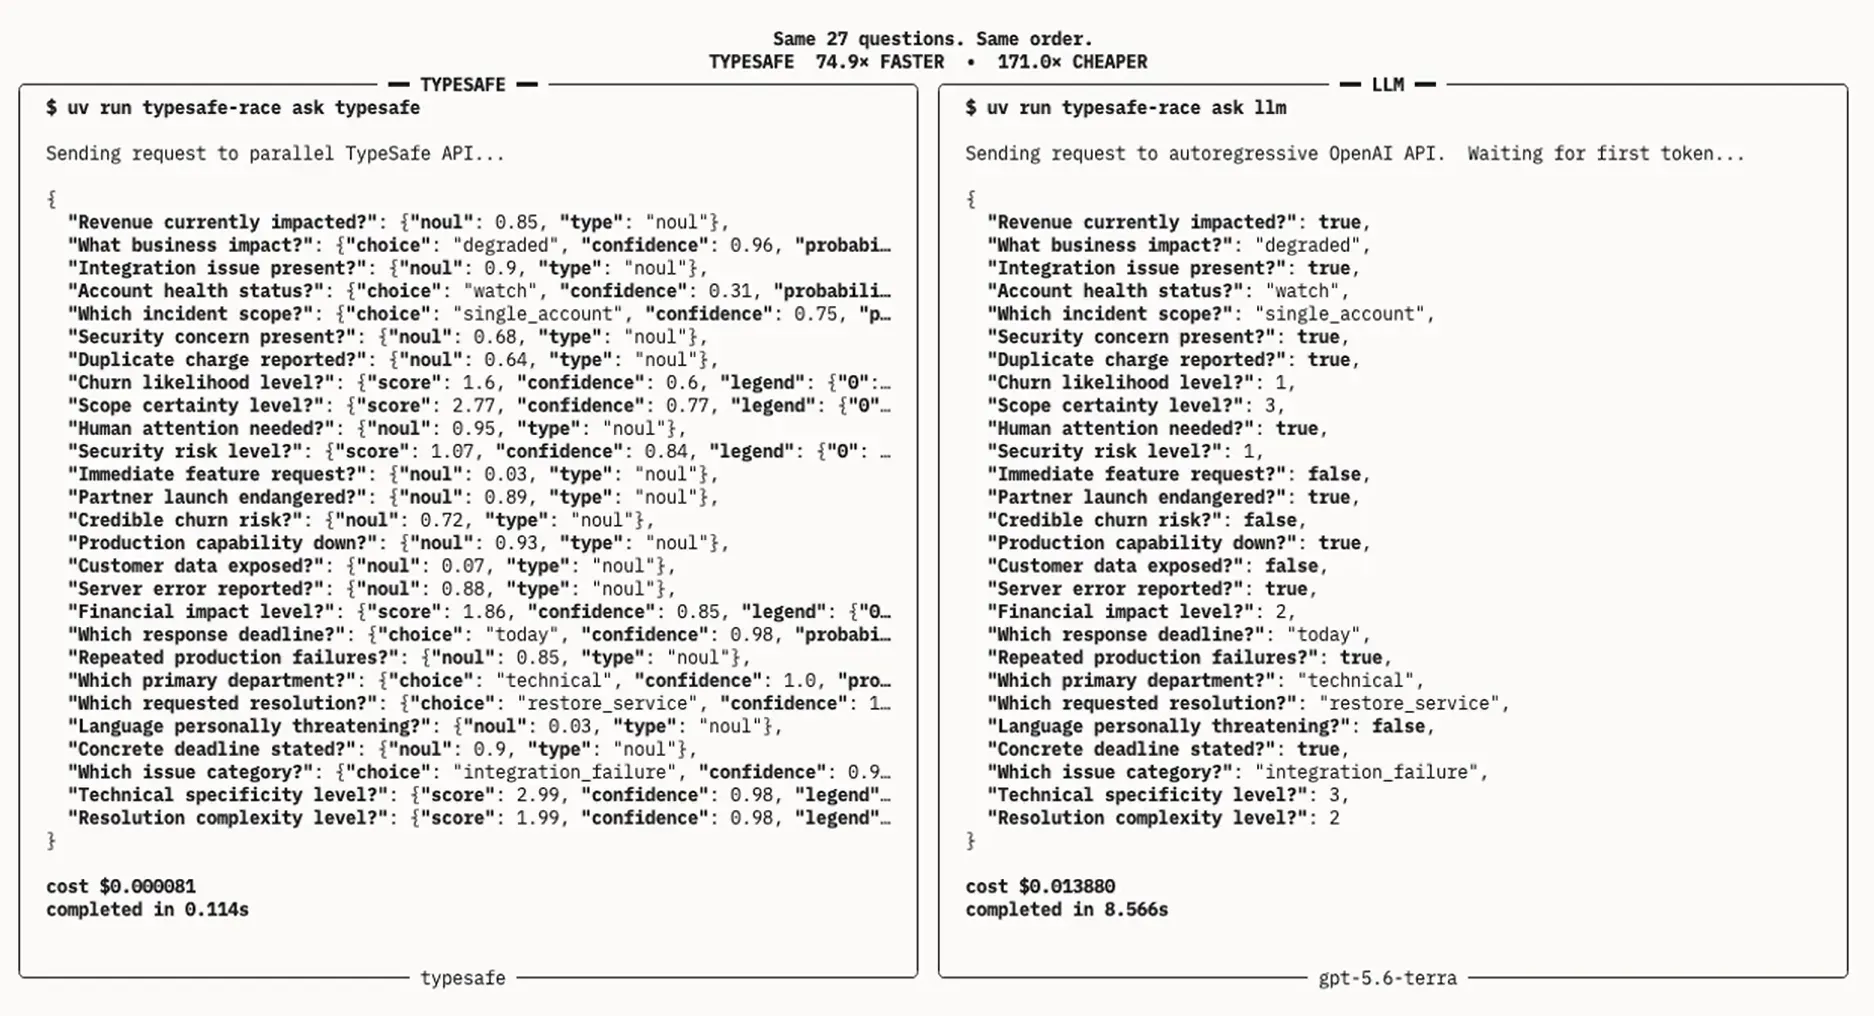
การเปรียบเทียบ benchmark บน terminal ที่รันคำถามประเมิน schema 27 ข้อพร้อมกันบน TypeSafe Jev เทียบกับ endpoint GPT 5.6 Terra
เนื่องจากโมเดลคำนวณการแจกแจงความน่าจะเป็นบน output ที่กำหนดไว้ล่วงหน้าแทนการสร้างข้อความอิสระ output decoding loop จึงหายไปทั้งหมด การเปลี่ยนแปลงเชิงโครงสร้างนี้ให้ผลลัพธ์ด้านประสิทธิภาพสามประการหลัก:
- Output Token ฟรี (ถูกเกินกว่าจะวัด): เนื่องจาก Jev ประเมินตัวเลือกใน forward pass เดียวโดยไม่สร้าง sequential token การประเมิน output จึงแทบไม่มี compute เพิ่มขึ้น ทำให้ output token ฟรีอย่างแท้จริง
- ราคาที่คาดเดาได้: การประมวลผล context มีค่าใช้จ่ายคงที่ $0.042 ต่อล้าน input token การประเมิน schema ของ prompt แบบคงที่ด้วย Jev ป้องกันการพองของบิล API แบบทวีคูณเมื่อเทียบกับ overhead ในการ execute แบบ long-context แบบดั้งเดิมที่มาพร้อมกับ chat endpoint หนักๆ
- Execution ต่ำกว่าหนึ่งวินาที: benchmark latency ที่เผยแพร่ของ TypeSafe Jev แสดงเวลา P95 ที่ 70ms ถึง 500ms อย่างสม่ำเสมอ เร็วกว่า chat model ชั้นนำสูงสุด 200 เท่า
รายละเอียดประสิทธิภาพเชิงสถาปัตยกรรม
| ตัวชี้วัด / มิติ | LLM แบบ Autoregressive ดั้งเดิม (System 2) | TypeSafe Jev System One Engine |
| Execution Loop | การ decode แบบ sequential ทีละ token | pass แบบขนานครั้งเดียวบน schema ที่ประกาศไว้ล่วงหน้า |
| ประเภท Output | สตริงข้อความ / สตริง JSON ที่ไม่มีโครงสร้าง | typed decision primitive (Choice, Score, Noul) |
| อัตราความผิดพลาด Schema | 0.58% ถึง 45%+ ขึ้นอยู่กับ model/prompt | อัตราความผิดพลาดเชิง type 0% (มีขอบเขตทางคณิตศาสตร์) |
| โปรไฟล์ P95 Latency | 3,000ms ถึง 30,000ms+ | 70ms ถึง 500ms |
| เศรษฐศาสตร์ของ Output | แปรผันต่อ token ($15 ถึง $60 / MTok) | ฟรี (ถูกเกินกว่าจะวัด) ไม่มีการสร้าง sequential output token |
| โดเมนหลัก | การใช้เหตุผล การร่างเอกสาร การสังเคราะห์แบบเปิด | การจำแนกประเภท การเลือก tool การ gating ความมั่นใจ |
ข้ามคอขวด Memory Bandwidth
ในการ inference ของ LLM มาตรฐาน memory bandwidth จะอิ่มตัวเมื่อ model weight ถูกโหลดกลับเข้าสู่ memory logic สำหรับทุก token ด้วยการประเมินการตัดสินใจให้เสร็จใน forward pass เดียว Jev จึงหลบเลี่ยงคอขวดหน่วยความจำนี้ได้ทั้งหมด รักษาความเร็วในการตอบสนองที่มั่นคงแม้ภายใต้ปริมาณการรับส่งข้อมูลที่ concurrent สูง
Reinforcement Learning for Calibrated Decisions และ Confidence Gate
chat model มาตรฐานมักส่งข้อความที่ไม่ถูกต้องพร้อมความมั่นใจที่รายงานตัวเอง 99% เนื่องจากการ fine-tune แบบเดิมให้รางวัลกับถ้อยคำที่โน้มน้าวใจมากกว่าความจริงเชิงสถิติ ในไมโครเซอร์วิสโปรดักชัน การตัดสินใจที่ผิดและมั่นใจเกินไปนำไปสู่ระเบียนฐานข้อมูลที่เสียหาย อาร์กิวเมนต์ของ tool ที่พัง และระบบล่มที่ไม่คาดคิดโดยตรง
จัดความมั่นใจของโมเดลให้สอดคล้องกับความแม่นยำเชิงประจักษ์
เพื่อแก้ปัญหาความมั่นใจเกินไปเชิงโครงสร้างนี้ TypeSafe ได้นำเสนอ Reinforcement Learning for Calibrated Decisions ต่างจากระเบียบวิธี RLHF แบบดั้งเดิมที่ปรับให้เหมาะกับความชอบเชิงอัตวิสัยของมนุษย์ RLCD ฝึก decision model โดยเฉพาะเพื่อสร้างความน่าจะเป็นที่ปรับเทียบแล้ว
ด้วยความมั่นใจที่สอดคล้องกับความแม่นยำ output ความน่าจะเป็น 0.90 จาก Jev หมายความว่าตัวเลือกที่เป็นตัวเลือกนั้นถูกต้องเชิงประจักษ์ 90% ของเวลาในชุดทดสอบ การปรับเทียบทางคณิตศาสตร์นี้ช่วยให้การตัดสินใจเชิงความน่าจะเป็นที่เชื่อถือได้โดยไม่ต้องให้นักพัฒนาเขียน prompt heuristic ที่ซับซ้อนเพื่อประเมินความแน่นอนของ output
การนำ Confidence-Gated Routing ไปใช้ในโปรดักชัน
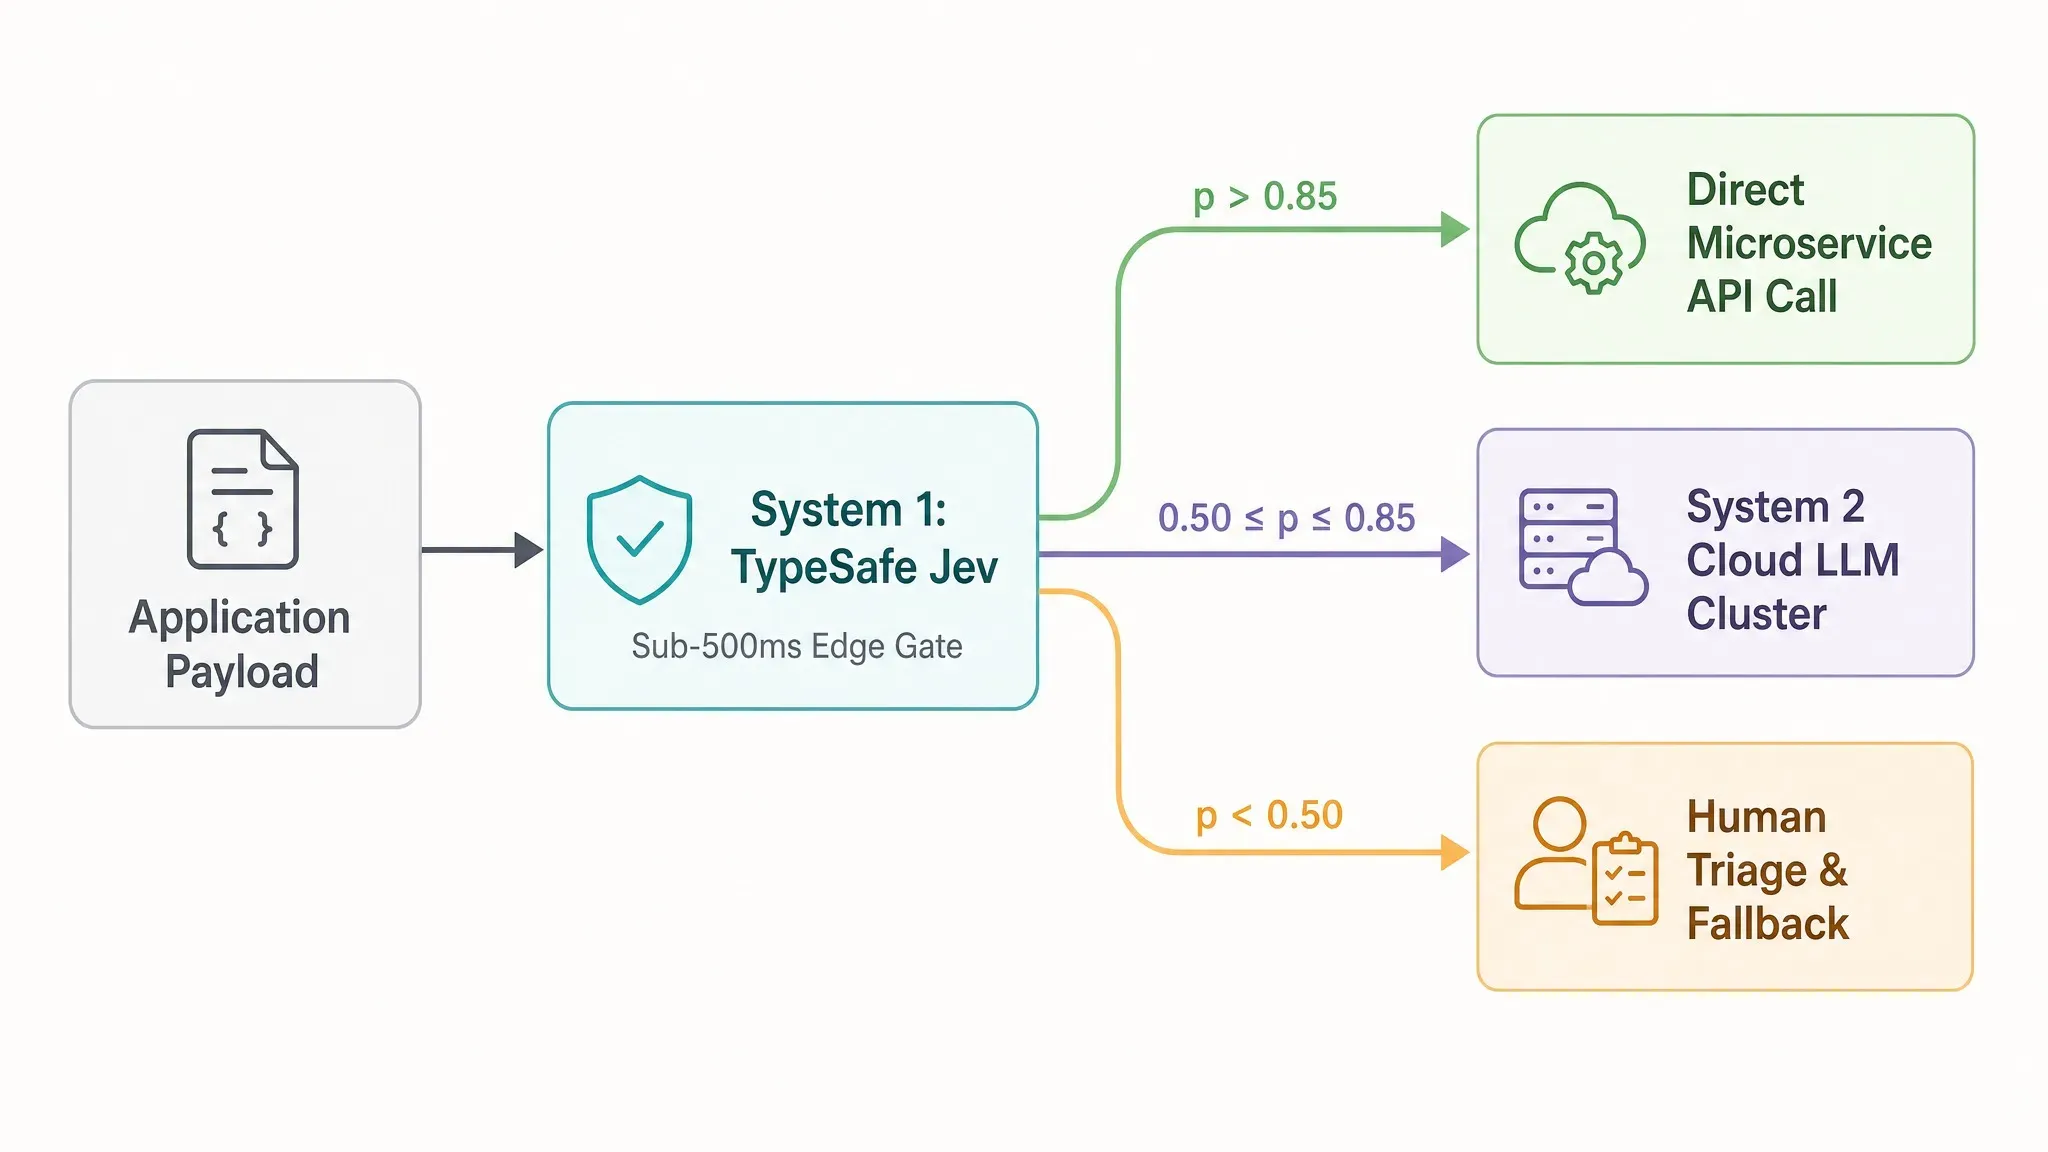
วิศวกรสามารถใช้การแจกแจงความน่าจะเป็นที่ปรับเทียบเหล่านี้เพื่อกำหนดค่า decision gate ตาม threshold เช่น ใน setup โปรดักชันทั่วไป:
p > 0.85(Fast-Path Execution): Execute ทันทีในเส้นทางความเร็วสูง ข้าม LLM endpoint ที่ช้าไปเลย0.50 ≤ p ≤ 0.85(System 2 Escalation): ส่ง output ที่ก้ำกึ่งไปยัง reasoning LLM เพื่อจัดการ edge case ที่คลุมเครือp < 0.50(Fallback Triage): กระตุ้นค่าเริ่มต้นด้านความปลอดภัยหรือส่งคำขอไปยังคิวตรวจสอบโดยมนุษย์
สำหรับ edge case ที่ก้ำกึ่ง 0.50≤ p ≤ 0.85 การ routing แบบ confidence-gated จะเปลี่ยนเส้นทาง payload ไปยัง reasoning tier ระดับองค์กร การใช้ GPT 5.6 Terra บน Atlas Cloud มอบเป้าหมาย fallback ที่เหมาะสมที่สุดสำหรับคำขอที่ escalate เหล่านี้ โดยใช้ประโยชน์จาก context window 1,050K และราคา token $2/$12 ที่คุ้มค่าเพื่อ execute การวิเคราะห์เชิงลึกโดยไม่ทำให้ต้นทุนโครงสร้างพื้นฐานของไมโครเซอร์วิสพองตัว
logprobs ดิบจาก LLM แบบ autoregressive ขึ้นชื่อเรื่องการไม่ปรับเทียบ และเปลี่ยนแปลงทุกครั้งที่ system prompt เปลี่ยน ด้วยการรวม RLCD เข้ากับกระบวนการฝึกหลักโดยตรง Jev ทำให้ confidence-gated routing พร้อมสำหรับโปรดักชัน ช่วยให้ทีมซอฟต์แวร์ automate ไปป์ไลน์ปริมาณมากได้อย่างปลอดภัยพร้อมแยก edge case ออกมา
Production Design Pattern: ไปป์ไลน์ AI ความเร็วสูงในทางปฏิบัติ
AI agent ในโปรดักชันมักล่มเมื่อ LLM คิดค้น function signature ที่ไม่มีอยู่จริงเช่น get_user_billing_v2() หรือส่ง parameter type ที่ไม่ถูกต้องไปยัง internal API endpoint การเชื่อมโยงการตรวจสอบเงื่อนไขหลายชั้นผ่าน chat completion endpoint มาตรฐานสะสม latency ของระบบรวม ทำให้ไมโครเซอร์วิสที่ลูกค้าเห็นเกิด timeout
Architecture Pattern หลักสำหรับไมโครเซอร์วิสปริมาณมาก
การรวม decision engine แบบเสี้ยววินาทีเข้ากับไปป์ไลน์ AI ในโปรดักชันช่วยให้ทีมซอฟต์แวร์แทนที่ prompt loop ที่คาดเดาไม่ได้ด้วย backend design pattern แบบ deterministic:
- Agentic Tool Selection: เมื่อเลือก tool ภายใน workflow ของ agent อัตโนมัติ Jev จะประเมิน function signature ที่มีอยู่เทียบกับ application state ปัจจุบัน เนื่องจาก candidate function ถูกส่งเป็นตัวเลือกที่ชัดเจนใน request schema Jev จึงไม่สามารถคืนชื่อ function ที่ไม่ได้กำหนดได้ ขจัดความล้มเหลวเชิง runtime แบบเงียบระหว่าง agentic tool selection การ pre-filter ที่รวดเร็วนี้รับประกัน payload schema ที่ถูกต้องก่อนส่งคำสั่งต่อไปยัง ไปป์ไลน์ LLM coding agent อัตโนมัติ
- Parallel Multi-Question Evaluation: chat endpoint มาตรฐานบังคับให้แอปพลิเคชันประเมินคำถามเงื่อนไขแบบ sequential ทำให้ latency รวมคูณด้วยจำนวนการตรวจสอบที่ทำ Jev ช่วยให้ประเมินหลายคำถามพร้อมกันโดยประเมินคำถาม schema หลายสิบข้อบน state payload เดียวใน parallel forward pass เดียว การรันการตรวจสอบการจำแนกประเภท 15 แบบแยกกันใช้เวลา 100ms เท่ากับการรันเพียงหนึ่ง
- Ticket Triage Automation: สำหรับไมโครเซอร์วิสปริมาณมากที่ประมวลผล ticket ขาเข้าจากลูกค้า Jev จะ parse sentiment ของลูกค้า route ลำดับความสำคัญทางเทคนิค และตรวจสอบสิทธิ์การคืนเงินพร้อมกัน การนำ ticket triage automation ไปใช้ด้วยเวลาตอบสนองระดับเสี้ยววินาทีป้องกันคิว backlog ในช่วง traffic spike ที่เกิดขึ้นกะทันหัน
การนำ System One Decision Node ไปใช้ผ่าน SDK
นักพัฒนาเริ่มต้น low-latency decision node ได้โดยการรวม typesafe-sdk อย่างเป็นทางการเข้ากับไมโครเซอร์วิสที่มีอยู่ execution payload จะส่ง application state พร้อม schema primitive ที่ประกาศไว้ล่วงหน้าไปยัง endpoint https://api.typesafe.ai/v1/systemone โดยตรง
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
setup การเรียก tool แบบดั้งเดิมจะ re-tokenize prompt context ทั้งหมดใหม่สำหรับการประเมิน function ทุกครั้ง ด้วยการแยก state representation ออกจากคำถามการตัดสินใจ Jev จึง execute ไปป์ไลน์การจำแนกประเภทหลายสาขาในระบบ backend ได้โดยไม่คูณ overhead ของ context token ไม่ทำให้บิล API พองตัว และไม่เสียสละการรับประกัน P95 latency
ข้อจำกัดที่รู้จักของ TypeSafe Jev และ Trade-Off เชิงสถาปัตยกรรม (สิ่งที่ Jev ทำไม่ได้)
การนำ non-autoregressive decision model ไปใช้โดยคาดหวังให้เขียนอีเมลตอบกลับอย่างสุภาพหรือสรุปรายการในใบแจ้งหนี้จะทำให้โค้ดโปรดักชันพังอย่างหลีกเลี่ยงไม่ได้ ทีมวิศวกรรมที่พยายามแทนที่ LLM อเนกประสงค์ทั้งหมดด้วย System One model จะพบกับขีดจำกัดทางสถาปัตยกรรมเชิงกายภาพอย่างรวดเร็ว
การวิเคราะห์ขอบเขตเชิงโครงสร้าง
การเข้าใจ failure mode เฉพาะของ Jev เป็นสิ่งสำคัญก่อนเชื่อม Jev เข้ากับ workflow ของไมโครเซอร์วิส การออกแบบ single forward-pass ของ Jev บังคับขอบเขตที่เข้มงวดในงานหลักหลายประการ:
- การสร้างข้อความแบบเปิดกว้าง: Jev ไม่สร้างข้อความสนทนาเลย ไม่สามารถเขียนเรียงความ สรุปเอกสาร หรือสร้างคำอธิบายภาษาธรรมชาติสำหรับตัวเลือกของตนได้
- ข้อจำกัดการให้เหตุผลแบบ multi-hop: สถาปัตยกรรมนี้ประเมิน state representation ทันที chain logic แบบ sequential ที่ซับซ้อนหรือข้อจำกัดการให้เหตุผลหลายขั้นตอนต้องมอบหมายงานกลับไปยัง LLM แบบ autoregressive ดั้งเดิม
- ข้อจำกัดทางคณิตศาสตร์: Jev ไม่สามารถคำนวณทางคณิตศาสตร์หรือนับรายการในสตริง context ได้อย่างน่าเชื่อถือ ข้อจำกัดทางคณิตศาสตร์ต้องเก็บการคำนวณทางการเงินและการดำเนินการกับ array ไว้ในโค้ด backend มาตรฐาน
- การตีความเกณฑ์ตามตัวอักษร: โมเดลปฏิบัติตามกฎใน prompt ตามตัวอักษรโดยไม่อนุมาน business logic ที่ไม่ได้ระบุ ตัวเลือก schema ที่คลุมเครือนำไปสู่การกระจายความน่าจะเป็นที่ไม่คาดคิด
- Context rot ภายใต้ payload หนัก: การส่ง log ขนาดใหญ่ที่ไม่มีโครงสร้างทำให้เกิด context rot ทำให้ความแม่นยำในการประเมินลดลง การกรองสัญญาณรบกวนออกจาก input state payload ก่อนส่งคำขอยังคงเป็นสิ่งจำเป็น
การ Map สถาปัตยกรรม: ความสามารถ System One vs System Two
| งานเชิงปฏิบัติการ | TypeSafe Jev System One | Autoregressive LLM System Two |
| การจำแนกประเภทเชิงหมวดหมู่ | โดยธรรมชาติ (ต่ำกว่า 500ms) | ช้า (ข้อความแบบ sequential) |
| การสังเคราะห์และร่างข้อความ | เป็นไปไม่ได้ (ไม่มี decoding loop) | โดยธรรมชาติ (การสร้างข้อความแบบเปิดกว้าง) |
| การคำนวณทางคณิตศาสตร์ | ไม่รองรับ (ข้อจำกัดทางคณิตศาสตร์) | แปรผัน (ต้อง execute โค้ด) |
| ความทนทานต่อสัญญาณรบกวน | เสี่ยงต่อ context rot ใน state ขนาดใหญ่ | ความทนทานของ context window สูงกว่า |
การมอง Jev เป็น decision node แบบเสี้ยววินาทีแทน reasoning engine สากลช่วยให้การออกแบบระบบถูกต้องทั่วทั้งไมโครเซอร์วิสโปรดักชัน
โครงสร้างพื้นฐานคลาวด์แห่งอนาคต: การ Orchestrate Decision Node ที่รวดเร็ว
การ route คำขอผู้ใช้ขาเข้าทุกคำขอไปยัง reasoning model ขนาด 70 พันล้าน parameter โดยตรงเผาผลาญ GPU cycle มูลค่าหลายพันดอลลาร์โดยเปล่าประโยชน์ พร้อมบังคับให้ผู้ใช้รอหลายวินาทีสำหรับการตรวจสอบความปลอดภัยพื้นฐานและการ routing payload microservice stack สมัยใหม่ไม่อาจจ่ายได้ที่จะมองทุก HTTP payload ขาเข้าเป็นปัญหา reasoning แบบเปิดกว้าง
การเปลี่ยนแปลงสู่ Hybrid AI Architecture
สภาพแวดล้อมคลาวด์กำลังเปลี่ยนจาก monolithic LLM endpoint ไปสู่ hybrid AI architecture แบบ decoupled ในกระบวนทัศน์ที่กำลังเกิดใหม่นี้ cloud orchestrator จะวาง fast decision node ไว้ที่ edge ของเครือข่ายเพื่อประเมิน payload ขาเข้าทันที
ด้วยการจัดการ edge AI routing การตรวจสอบ schema และการให้คะแนนความมั่นใจภายในหน้าต่าง execution ต่ำกว่า 500ms fast decision node จะกรอง traffic ก่อนถึง cluster ของโมเดลที่หนักกว่า topology นี้ปรับ resource allocation ให้เหมาะสมทั่วสามชั้นการทำงานของคลาวด์ที่แตกต่างกัน:
- Edge Guardrail และ Routing: fast decision node ประเมิน intent ของผู้ใช้ ทำให้อินพุตปลอดภัย และตรวจสอบความสอดคล้องกับ schema ใน forward pass เดียว
- State Handover และ Orchestration: cloud orchestrator วิเคราะห์ confidence score execute คำขอที่มีความแน่นอนสูงทันที และส่งต่องาน reasoning ที่ซับซ้อน
- Centralized System 2 Reasoning: cluster LLM หนักจะรับเฉพาะ payload ที่ผ่านการกรองล่วงหน้าและมีโครงสร้างเท่านั้น เมื่อจำเป็นต้องมีการสังเคราะห์หลายรอบหรือการสร้างแบบเปิดกว้างอย่างแท้จริง
การ Deploy System One Model ในระดับ Scale
เมื่อแพลตฟอร์มคลาวด์ขยายขีดความสามารถในการโฮสต์ การนำ TypeSafe Jev deployment มาไว้ใน AI infrastructure มอบ pattern ที่มีประสิทธิภาพสำหรับ edge microservice การรัน non-autoregressive decision model ใกล้ผู้ใช้ปลายทางช่วยลด round-trip time ได้อย่างมากและลด compute cost สำหรับแอปพลิเคชัน throughput สูง
การสร้างไปป์ไลน์ที่มี decision layer เฉพาะทางช่วยให้เครือข่าย backend ตอบสนองได้ดีภายใต้ภาระหนัก พร้อมKeeping frontier reasoning model ให้มุ่งเน้นเฉพาะงานที่ต้องใช้การคำนวณเชิงลึกเท่านั้น


