อัปเดตล่าสุด: Wan 3.0 เปิดให้ใช้งานแล้วตั้งแต่วันที่ 24 สิงหาคม 2026
คุณสร้างโฟลเดอร์สำหรับโฆษณาความยาว 15 วินาทีหนึ่งชิ้น ภาพนิ่งตัวละครสองภาพ วิดีโอแบรนด์ที่ลูกค้าส่งมา หนังสือแบรนด์ที่มีเฉพาะในรูปแบบ PDF ตัวอย่างเสียงจากนักแสดงที่คุณต้องการจริงๆ
จากนั้นคุณเปิดโมเดลวิดีโอของคุณ และมันขอแค่ภาพเดียว
คุณก็ทำสิ่งที่ทุกคนทำ คุณแปลโฟลเดอร์นั้นเป็นพรอมต์ 800 คำและอธิษฐาน ใบหน้าเปลี่ยนไปในช็อตที่สาม เสื้อแจ็คเก็ตเปลี่ยนสี เสียงเป็นคนอื่นไปเลย
Wan 3.0's omni-reference เป็นครั้งแรกที่โมเดลวิดีโอพูดว่า: ได้ ให้ฉันจัดการโฟลเดอร์นั้นเอง ทรัพย์สินสูงสุด 20 ชิ้นในการเรียกครั้งเดียว ครอบคลุมอินพุตห้าประเภท ถูกยึดเข้าด้วยกันตลอดเทคเดียวต่อเนื่อง 30 วินาที
บทความนี้ทำสามอย่างและข้ามส่วนที่เหลือ อธิบายว่าทรัพย์สิน 20 ชิ้นนั้นคืออะไร ใช้คลิปที่ Alibaba สร้างขึ้นเองเป็นหลักฐาน และให้เวิร์กโฟลว์ที่เทียบเท่าที่คุณสามารถใช้งานได้ในวันนี้ เพราะ Wan 3.0 ยังอยู่ในช่วงเบต้าสาธารณะบนคลาวด์ของ Alibaba เอง และยังไม่สามารถเรียกใช้จากแพลตฟอร์มของบุคคลที่สามได้
ประเด็นสำคัญ
- การอ้างอิงแบบมัลติโมดอลของ Wan 3.0 รองรับทรัพย์สินสูงสุด 20 ชิ้นในการเรียกครั้งเดียว ครอบคลุมรูปภาพ วิดีโอ เสียง เอกสาร และเว็บเพจสด และคงความสอดคล้องตลอดเทคเดียว 30 วินาที
- เป็นโมเดลวิดีโอหลักแรกที่ปฏิบัติต่อ PDF, สไลด์เด็ค หรือ URL เป็นอินพุตเชิงสร้างสรรค์ แทนที่จะเป็นสิ่งที่คุณต้องถอดความลงในพรอมต์
- Wan 3.0 เข้าสู่เบต้าสาธารณะเมื่อวันที่ 6 สิงหาคม 2026 บน Alibaba Cloud Model Studio และ Qwen Cloud ในชื่อ
wan3.0-videoเป็น closed weights ใครก็ตามที่บอกว่ามันเป็น Apache 2.0 อยู่แล้วกำลังเดา - หัวข้อ 20 ทรัพย์สินไม่ใช่จุดที่มันเหนือกว่าจริงๆ โมเดล reference-to-video ที่คุณเรียกใช้ได้ตอนนี้รองรับทรัพย์สินมากกว่า 20 อยู่แล้ว จุดต่างคือเอกสารและเว็บเพจ ไม่ใช่จำนวน
- คุณสามารถทดสอบรูปแบบสองตัวละคร อ้างอิงคงที่ พร้อมเสียงพูดเต็มรูปแบบได้ฟรีด้วยเครื่องสร้างสกิตโฆษณา AI ฟรีของ Atlas Cloud: ใส่รูปผลิตภัณฑ์สี่รูป รับสกิตพูดยาว 15 วินาที ไม่ต้องใช้บัตร
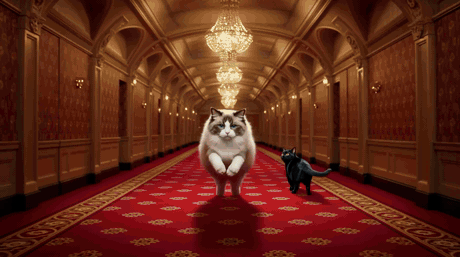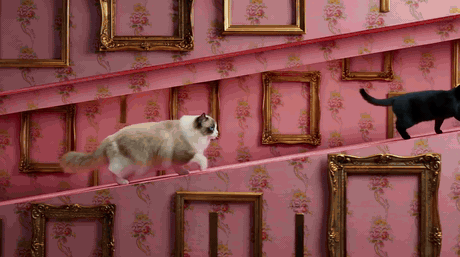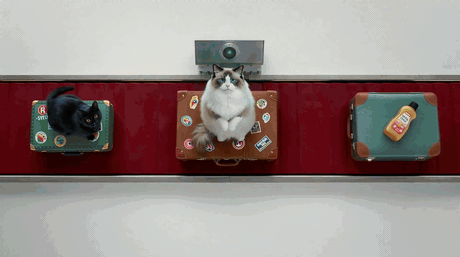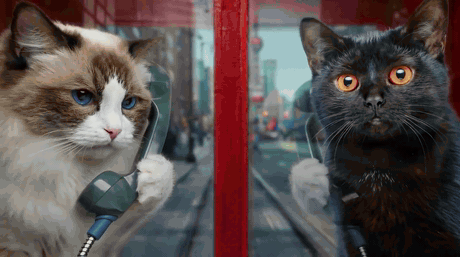
แมวสองตัวถูกไล่ตามผ่านห้าฉากที่แตกต่างกันโดย Wan 3.0 โดยไม่มีการเคลื่อนตัวของตัวละคร_ภาพอ้างอิงสองภาพ ห้าฉากที่แตกต่างกันโดยสิ้นเชิง ตั้งแต่ทางเดินโรงแรมไปจนถึงถังซักผ้าไปจนถึงตู้โทรศัพท์สีแดง ไม่มีเฟรมใดที่เคลื่อนตัว ที่มา: คู่มือผู้สร้าง Wan 3.0 อย่างเป็นทางการของ Alibaba_ Wan 3.0 creator handbook สิงหาคม 2026 ซึ่งเป็นที่มาของคลิป Wan 3.0 อื่นๆ ทั้งหมดในบทความนี้
เหตุใดวิดีโอแบบอ้างอิงหลายรายการจึงล้มเหลว และ Wan 3.0 Multimodal Reference เปลี่ยนแปลงอะไร
โมเดลวิดีโอไม่มีความทรงจำระหว่างคลิป ทุกการสร้างเริ่มจากศูนย์ นั่นคือปัญหาทั้งหมดในประโยคเดียว
ดังนั้นทันทีที่เรื่องราวของคุณต้องการมากกว่าหนึ่งช็อต คุณก็ต้องต่อช็อต ช็อตแรกให้ใบหน้าที่คุณชอบ ช็อตที่สองให้ลูกพี่ลูกน้องของใบหน้านั้น ช็อตที่สามเปลี่ยนแจ็คเก็ตจากสีบ๊วยเป็นสีเบอร์กันดีอย่างเงียบๆ และเมื่อคุณสังเกตเห็น คุณก็จ่ายค่าเรนเดอร์ไปสิบเอ็ดครั้งแล้ว
การอ้างอิงภาพเดียวช่วยได้ แต่มันล็อคได้เพียงสิ่งเดียว ใบหน้า ไม่สามารถยึดใบหน้า เสื้อผ้า อุปกรณ์ประกอบฉาก สถานที่ และเสียงพร้อมกันได้ เพราะมีช่องเดียวและห้าภารกิจ
มีสองทางออก ให้โมเดลมีช่องมากขึ้น หรือหยุดให้มันเริ่มใหม่ Wan 3.0 ทำทั้งสองอย่างพร้อมกัน และนั่นคือเหตุผลที่คุณสมบัติหลักสองอย่างเป็นคุณสมบัติเดียวจริงๆ เทค 30 วินาทีแบบเนทีฟหมายความว่าไม่มีคัตให้ตัวละครเคลื่อนตัวไป ทรัพย์สินอ้างอิงยี่สิบชิ้นหมายความว่าทุกองค์ประกอบที่ต้องคงที่ได้รับช่องเฉพาะของตัวเองแทนที่จะแย่งกัน
นี่คือสิ่งที่ดูเหมือนเมื่อไม่มีอะไรถูกต่อกัน สามสิบวินาที กล้องต่อเนื่องหนึ่งตัว เด็กในรถเข็นช็อปปิ้งที่ลงเอยด้วยการฝังอยู่ในป้ายโฆษณาแล้วเดินออกมาจากข้างใต้
30 วินาทีเต็มในครั้งเดียว ไม่มีการตัด มีซาวด์แทร็กที่สร้างขึ้นในรอบเดียวกัน ที่มา: คู่มือผู้สร้าง Wan 3.0 อย่างเป็นทางการของ Alibaba
"20 ทรัพย์สิน" หมายถึงอะไรจริงๆ ภายใน Wan 3.0 Multimodal Reference
ยี่สิบเป็นตัวเลขพาดหัว สิ่งที่สำคัญคือยี่สิบนั้นไม่ใช่สิ่งเดียวกันทั้งหมด การอ้างอิงแบบ omni-reference ของ Wan 3.0 ครอบคลุมอินพุตห้าประเภท และแต่ละประเภทควบคุมแกนที่แตกต่างกันของเอาต์พุต
รูปภาพควบคุมอัตลักษณ์ การ์ดตัวละคร ภาพผลิตภัณฑ์ แผ่นสถานที่ Wan 3.0 เรียกสิ่งนี้ว่าความสอดคล้องระดับพิกเซล และในตัวอย่างของ Alibaba เอง การล็อคขยายเกินใบหน้าไปถึงเครื่องแต่งกาย: เสื้อคลุมสีเทาหลายชั้น เสื้อหนังคาดเข็มขัด ผ้าคาดเอวสีเข้มทั้งหมดคงอยู่ตลอดการต่อสู้แบบประชิดตัว 16 วินาทีข้ามสามสถานที่
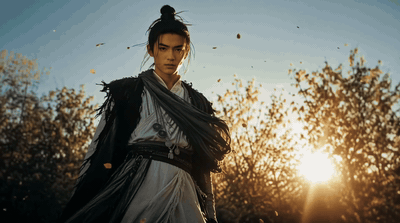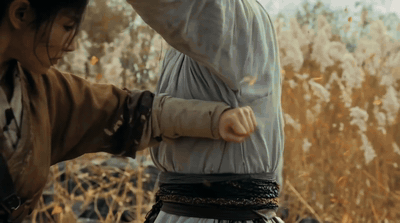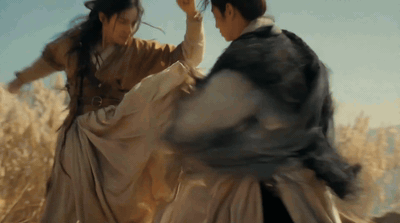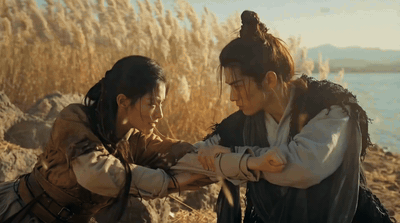
การ์ดตัวละครสองตัวขับเคลื่อนฉากต่อสู้หวู่เซี่ยโดยรายละเอียดเครื่องแต่งกายคงที่ในทุกเฟรม
การ์ดตัวละครสองตัวบวกแผ่นสถานที่หนึ่งแผ่นของตลิ่งกก เครื่องแต่งกายและฉากคงที่ตลอดทุกการทุ่ม แสดงเป็น GIF เงียบ; ไฟล์ที่ส่งมอบมีเสียงสเตอริโอ 44.1kHz ที่มา: คู่มือผู้สร้าง Wan 3.0 อย่างเป็นทางการของ Alibaba
เสียงควบคุมน้ำเสียง นี่คือส่วนที่ทำให้ "มัลติโมดอล" มีความหมายมากกว่าการตลาด คุณแนบตัวอย่างเสียงต่อตัวละคร เขียนบทสนทนาในพรอมต์ และบทสนทนาจะกลับมาในโทนเสียงนั้น พร้อมลิปซิงค์ ในรอบเดียวกับภาพ สองคน สองเสียงอ้างอิง โรงยิมหนึ่งแห่ง
ภาพตัวแบบสองภาพบวกคลิปเสียงอ้างอิงสองคลิปแยกกัน และบทสนทนากลับมาในสองเสียงนั้น ควรเปิดเสียงสำหรับอันนี้ ที่มา: คู่มือผู้สร้าง Wan 3.0 อย่างเป็นทางการของ Alibaba
วิดีโอควบคุมจังหวะเวลา วิดีโออ้างอิงไม่ได้มีไว้ให้คัดลอก มันมีไว้ให้จังหวะ: จังหวะที่บีทคงอยู่นานเท่าใด การเปลี่ยนผ่านเคลื่อนไหวอย่างไร ในตัวอย่างนี้ คีย์เฟรมห้าภาพให้ตัวแบบ และวิดีโออ้างอิงให้จังหวะการพลิกการ์ดแนวนอนระหว่างพวกมัน
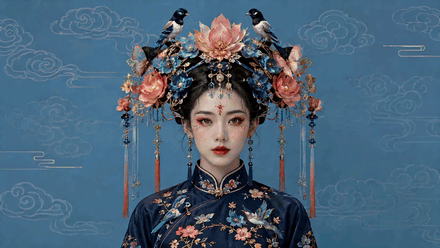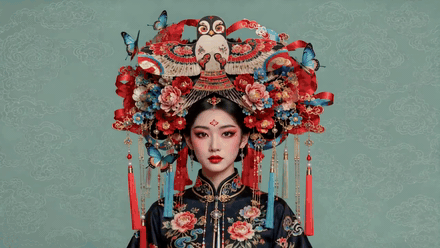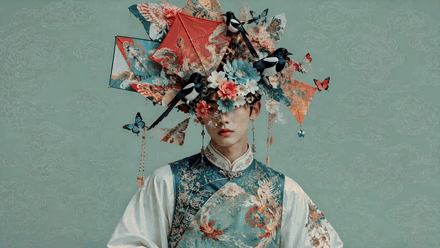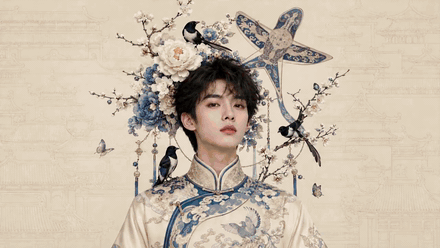
คีย์เฟรมห้าภาพถูกพลิกด้วยจังหวะจากวิดีโออ้างอิง_คีย์เฟรมห้าภาพสำหรับตัวแบบ หนึ่งวิดีโออ้างอิงสำหรับจังหวะการพลิก ที่มา: คู่มือผู้สร้าง Wan 3.0 อย่างเป็นทางการของ Alibaba_
เอกสารและเว็บเพจควบคุมโครงสร้าง นี่คือสิ่งใหม่จริงๆ Wan 3.0 ยอมรับไฟล์เอกสารและ URL สดเป็นอินพุตเชิงสร้างสรรค์ และรายงานเกี่ยวกับเบต้าระบุ .doc, .xls, .ppt, .pdf และ .txt ในรูปแบบที่ยอมรับ (AlphaSignal, สิงหาคม 2026) ตรรกะเดียวกันนี้ทำงานกับภาพสตอรีบอร์ดแล้ว: หนึ่งบอร์ดเข้า หกช็อตออก ในลำดับของบอร์ดเอง
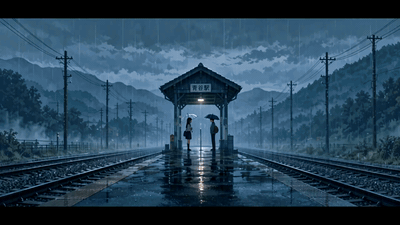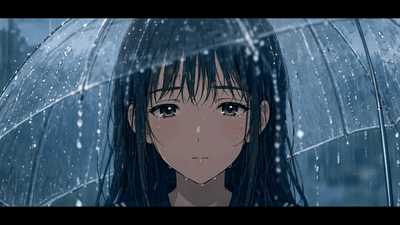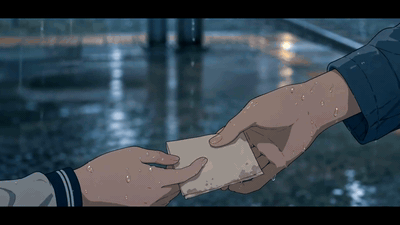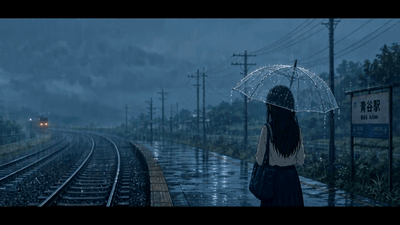
สตอรีบอร์ดแผ่นเดียวขยายเป็นหกช็อตต่อเนื่องที่ชานชาลาสถานีรถไฟฝนตก
สตอรีบอร์ดแผ่นเดียวเป็นข้อมูลอ้างอิง หกช็อตถูกสร้างในลำดับ ลงไปถึงการส่งโน้ตในช็อตที่ห้า ที่มา: คู่มือผู้สร้าง Wan 3.0 อย่างเป็นทางการของ Alibaba
เฟรมแรกและเฟรมสุดท้ายควบคุมจุดสิ้นสุด กลเม็ดที่เก่าที่สุด ยังคงรองรับ ยังคงเป็นวิธีที่เร็วที่สุดในการจำกัดช็อต
นี่คือวิธีการเทียบกับเวอร์ชันที่คนส่วนใหญ่ใช้จริงในปัจจุบัน
| Wan 2.7 Reference-to-Video | Wan 3.0 omni-reference | |
|---|---|---|
| ทรัพย์สินอ้างอิง | หนึ่งภาพต่อตัวแบบ, สูงสุด 3 วิดีโอ, 1 คลิปเสียง | สูงสุด 20 ทรัพย์สินรวม |
| รูปแบบ | ภาพ, วิดีโอ, เสียง | ภาพ, วิดีโอ, เสียง, เอกสาร, เว็บเพจ |
| ระยะเวลาสูงสุด ครั้งเดียว | 10 วินาที | 30 วินาทีแบบเนทีฟ, บวก smart duration |
| เสียงในรอบเดียวกัน | ใช่ | ใช่ |
| การตัดต่อและขยายวิดีโอ | ไม่เปิดเผย | การตัดต่อตามคำแนะนำและอ้างอิง, บวกการขยาย |
| ความพร้อมใช้งาน | ใช้งานได้บน API บุคคลที่สาม | Alibaba Cloud Model Studio และ Qwen Cloud เบต้า |
มีกฎหนึ่งข้อที่ไม่มีใครใส่ในเอกสารและทุกคนเรียนรู้ด้วยความยากลำบาก: หนึ่งอ้างอิง หนึ่งงาน Image1 ล็อคใบหน้าและเสื้อผ้า Video1 ให้การเคลื่อนไหวเท่านั้น Audio1 ให้โทนเสียงเท่านั้น ทันทีที่คุณมอบหมายงานสองอย่างที่ขัดแย้งกันให้ทรัพย์สินเดียว หรืออัปโหลดภาพอ้างอิงที่มีคนสองคน โมเดลต้องเดา และการเดาคือสิ่งที่คุณพยายามหยุดไว้ คู่มือของ Alibaba ก็ชัดเจนเช่นกัน: หนึ่งตัวแบบต่อภาพอ้างอิง
เวิร์กโฟลว์ Wan 3.0 Multimodal Reference ที่คุณใช้ได้วันนี้
คำตอบตรงๆ ก่อน Wan 3.0 อยู่ในเบต้าสาธารณะบนคลาวด์ของ Alibaba เอง ภายใต้รหัสโมเดล wan3.0-video (Alibaba Wan, สิงหาคม 2026) ยังไม่ลงจอดบนแพลตฟอร์ม API บุคคลที่สาม รวมถึง Atlas Cloud ใครก็ตามที่ขายการเข้าถึง API Wan 3.0 ตอนนี้กำลังขายอย่างอื่น
สิ่งที่ลงจอดแล้วคือรูปร่างของเวิร์กโฟลว์ แพ็กอ้างอิงเข้า เรียกครั้งเดียว คลิปเสร็จพร้อมเสียงออก สิ่งนี้ทำงานในวันนี้บนโมเดล reference-to-video ที่คุณเรียกใช้ในแท็บเบราว์เซอร์ได้ และเมื่อคุณจัดเรียงทั้งหมดแล้ว หัวข้อ 20 ทรัพย์สินก็ดูแตกต่างออกไป
| โมเดล | ทรัพย์สินอ้างอิง | รูปแบบ | ระยะเวลาสูงสุด | เสียงเนทีฟ | ราคาต่อวินาที |
|---|---|---|---|---|---|
| Wan 3.0 (Alibaba beta, ยังไม่มีบน Atlas) | 20 รวม | ภาพ, วิดีโอ, เสียง, เอกสาร, เว็บเพจ | 30 วินาที | ใช่ | รายงาน $0.05 ถึง $0.20 ตามความละเอียด |
| Wan 2.7 Reference-to-Video | 1 ภาพต่อตัวแบบ, 3 วิดีโอ, 1 คลิปเสียง | ภาพ, วิดีโอ, เสียง | 10 วินาที | ใช่ | $0.10 |
| Seedance 2.5 Reference-to-Video | 50 (30 ภาพ / 10 วิดีโอ / 10 เสียง) | ภาพ, วิดีโอ, เสียง | 30 วินาที | ใช่ | $0.13 |
| MiniMax H3 Reference-to-Video | ผสม, ไม่มีขีดจำกัดที่ระบุ | ภาพ, วิดีโอ, เสียง | 15 วินาที | ใช่ | $0.10 |
| Kling Video O3 Pro Reference-to-Video | 7 ภาพ, หรือ 4 ภาพ + 1 วิดีโอ | ภาพ, วิดีโอ | 15 วินาที | ใช่ | $0.10 |
| Vidu Q3-Mix Reference-to-Video | 4 ภาพ | ภาพ | 16 วินาที | ใช่ | $0.11 |
| Veo 3.1 Reference-to-Video | 3 ภาพ | ภาพ | 8 วินาที | ไม่บังคับ | $0.20 |
ราคาเป็นอัตราของ Atlas Cloud ณ สิงหาคม 2026 ตัวเลขของ Wan 3.0 เป็นตัวเลขที่รายงานสำหรับเบต้า Alibaba Cloud ไม่ใช่อัตราของ Atlas และ Alibaba ยังไม่ได้เผยแพร่หน้าราคาสาธารณะสำหรับโมเดล ดังนั้นให้ถือว่าแถวนั้นเป็นข้อมูลชั่วคราว
อ่านตารางนั้นสองครั้งแล้วเรื่องจริงจะปรากฏ หัวข้อ 20 ทรัพย์สินไม่ใช่จุดที่ Wan 3.0 เหนือกว่า เพราะ Seedance 2.5 รองรับ 50 แล้วและเท่ากับ 30 วินาที สิ่งที่ไม่มีอะไรในรายการนั้นรองรับคือ PDF
สำหรับการแนะนำด้านล่าง การสาธิตจะทำงานบน Wan 2.7 Reference-to-Video เพราะรูปร่างอินพุตของมันใกล้เคียงที่สุดกับ omni-reference ในปัจจุบัน: ภาพตัวแบบหลายภาพ, วิดีโออ้างอิงเสริม, และคลิปเสียง ทั้งหมดถูกแมปไปยังป้ายชื่อ character1 และ character2 ภายในพรอมต์ สามโมเดล หนึ่งแท็บเบราว์เซอร์ ไม่ต้องติดตั้งในเครื่อง
สำหรับการรันโฮสต์ปัจจุบัน เปิด Wan 3.0 on Atlas Cloud และทดสอบพรอมต์เช่นด้านล่างก่อนที่คุณจะเผยแพร่เวิร์กโฟลว์
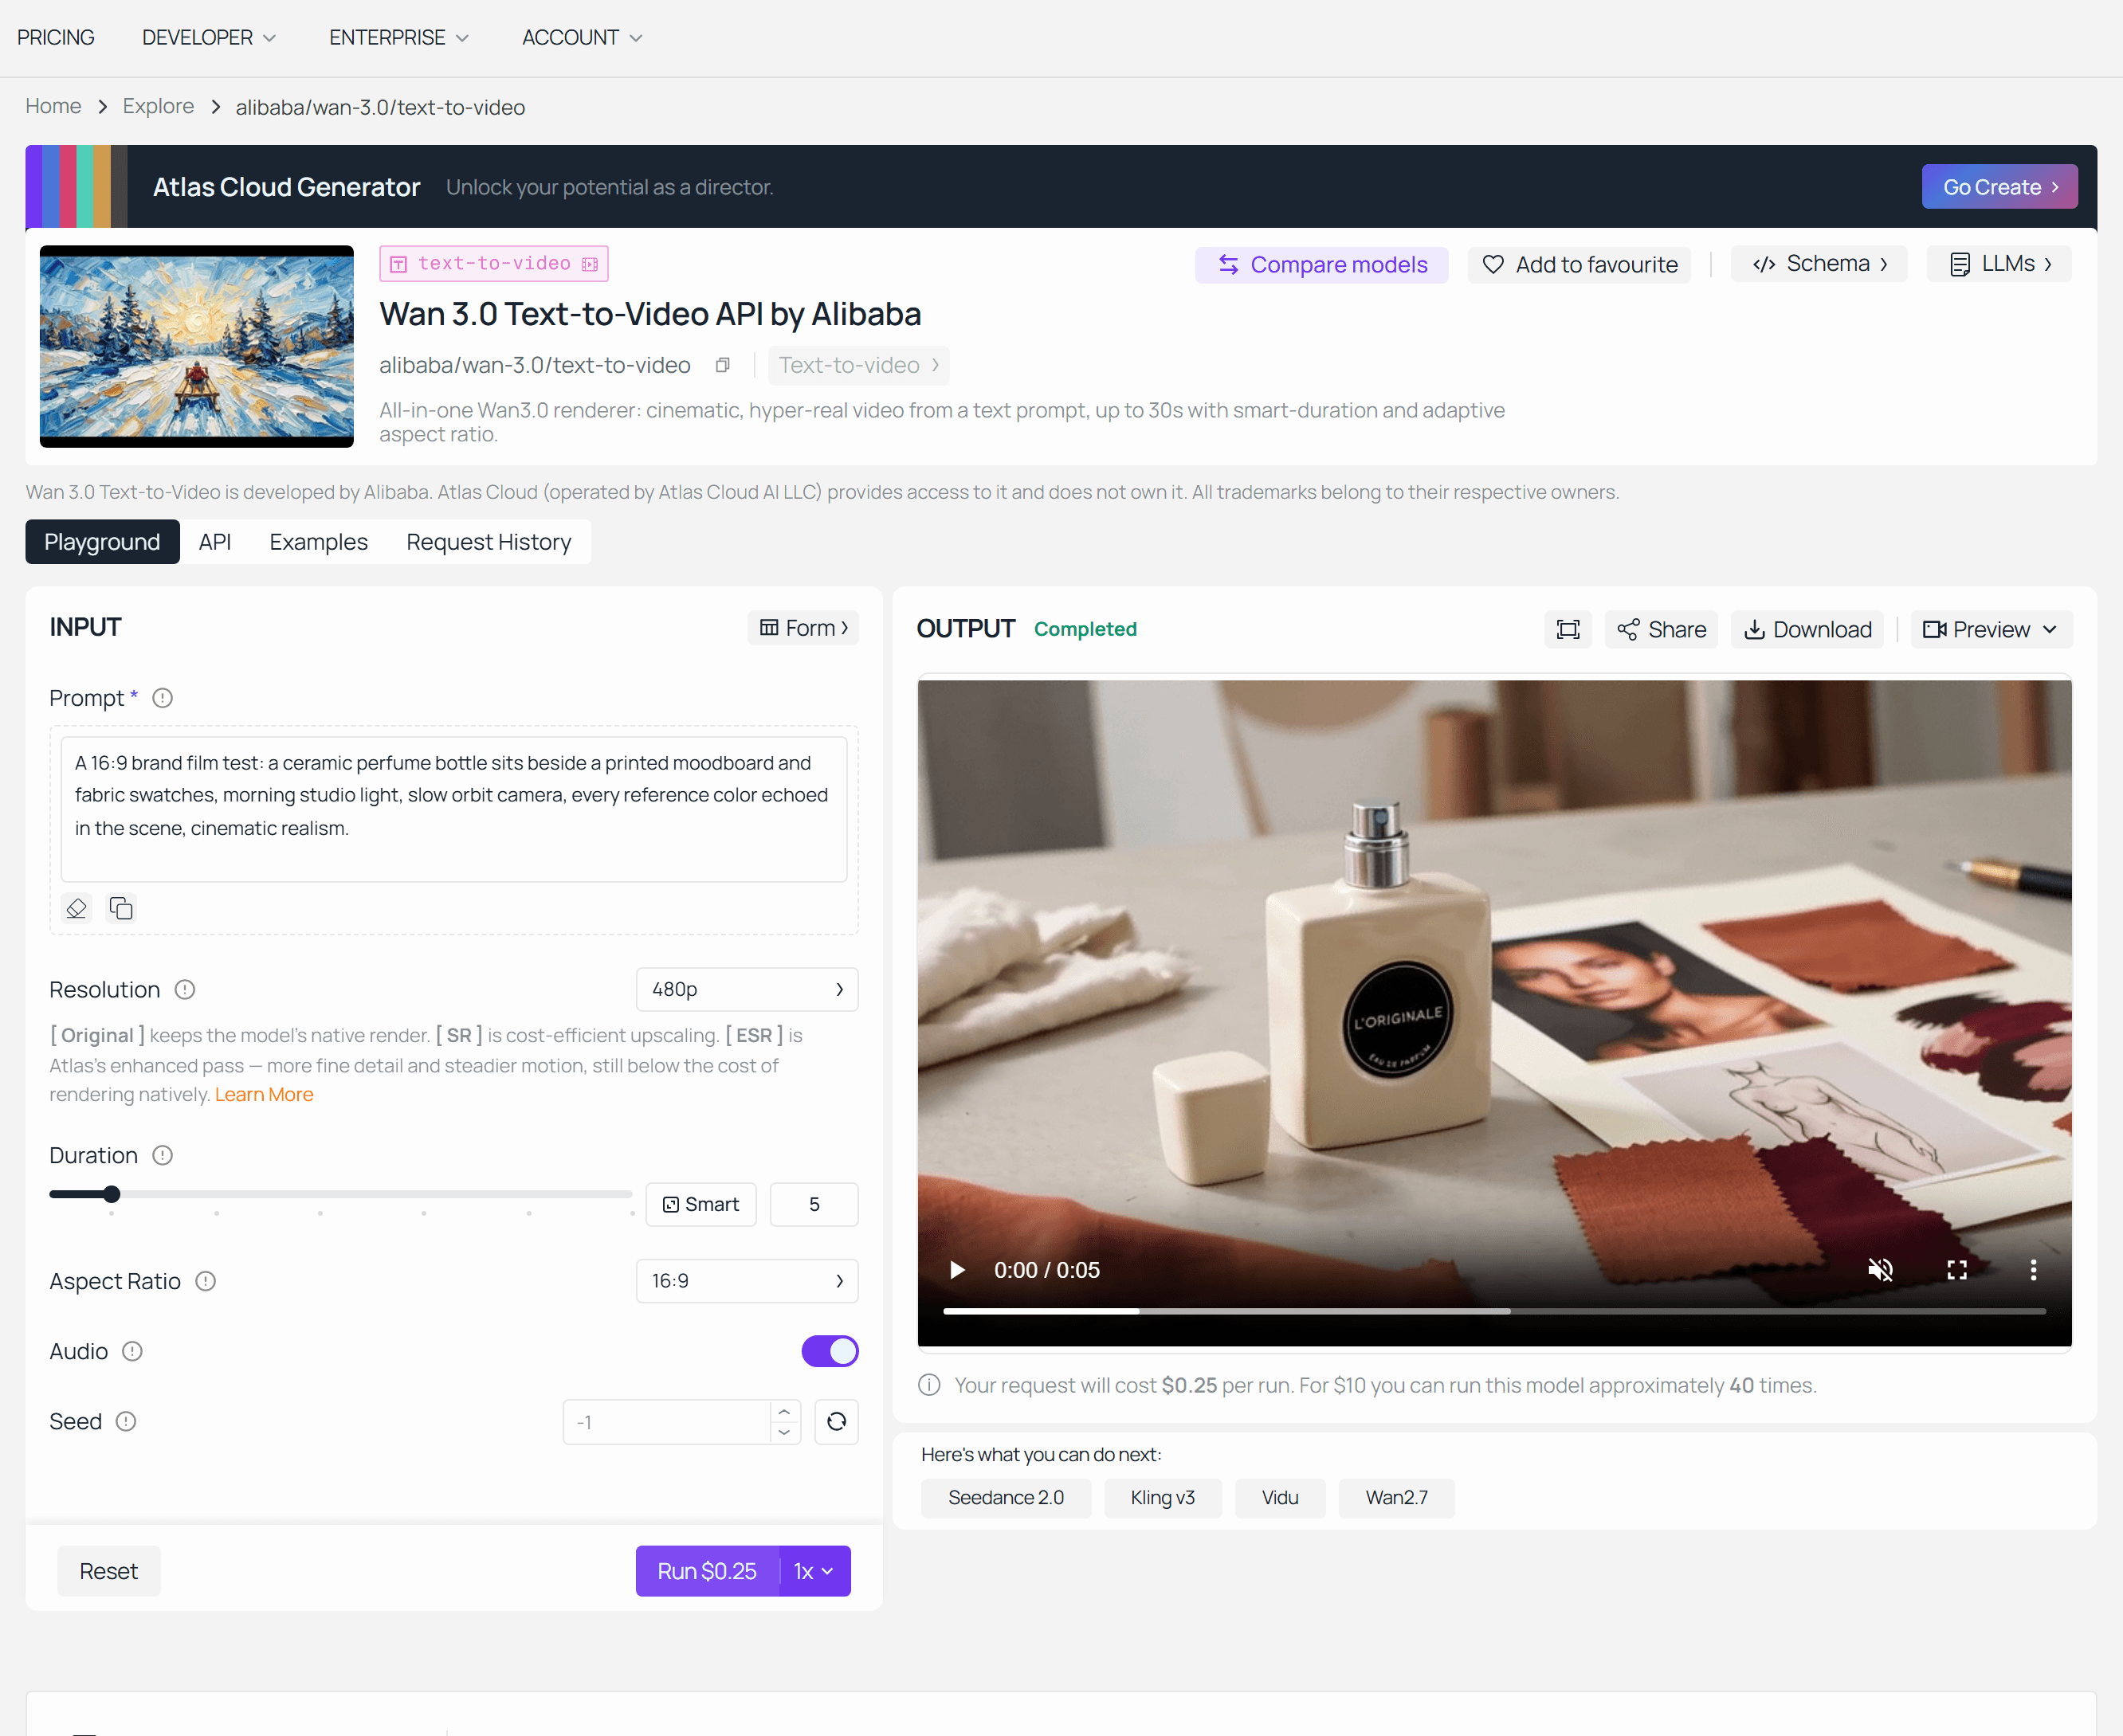
ภาพหน้าจอ Wan 3.0 prompt-to-result: การส่งมอบแบรนด์อ้างอิง 20 รายการ
สร้างด้วยตัวเอง: ฉากอ้างอิงแบบมัลติโมดอลในสี่ขั้นตอน
ฉาก: โต๊ะต้อนรับโรงแรมสีพาสเทล พนักงานต้อนรับหน้าตาย นักเดินทางถือแมวพันธุ์แร็กดอลล์ พนักงานต้อนรับมองตรงไปที่เลนส์แล้วพูดว่า "แมวมีห้องจองไว้แล้ว คุณไม่มี"
สองภาพบวกหนึ่งคลิปเสียง ซึ่งเป็นทรัพย์สินอ้างอิงสามรายการในสองรูปแบบ นั่นคือการสร้างที่เล็กที่สุดที่ซื่อสัตย์ว่ามัลติโมดอล แทนที่จะเป็นแค่หลายภาพ
ขั้นตอนที่ 1. สร้างภาพอ้างอิงที่ 1 ตัวแบบที่คุณต้องล็อค
ภาพอ้างอิงมีสามงานและมีเพียงสามงาน: หนึ่งตัวแบบ หันหน้ากล้อง พื้นหลังสะอาด ทุกอย่างอื่นเป็นของตกแต่ง ใช้ GPT Image 2 ด้วยคุณภาพ high, ขนาด 16:9, n=1.
Plain1ภาพเหมือนเต็มตัวในสตูดิโอของพนักงานต้อนรับโรงแรมวัยกลางคนที่มีสีหน้าตาย อยู่ตรงกลางภาพกับผนังสีชมพูฝุ่นเรียบ เขาสวมเครื่องแบบกระดุมสองแถวสีม่วงพลัมพร้อมเชือกทองและกระดุมทองเหลือง หมวกทรงกลมเล็ก และหนวดบาง การจัดเฟรมสมมาตรสมบูรณ์ แสงหน้าอ่อนนุ่ม ไม่มีเงาบนผนัง เกรนฟิล์ม 35 มม. จานสีพาสเทลอ่อน มีตัวแบบเดียวเท่านั้น ไม่มีคนอื่น ไม่มีข้อความ ไม่มีโลโก้ ไม่มีอุปกรณ์ประกอบฉากในเฟรม 2
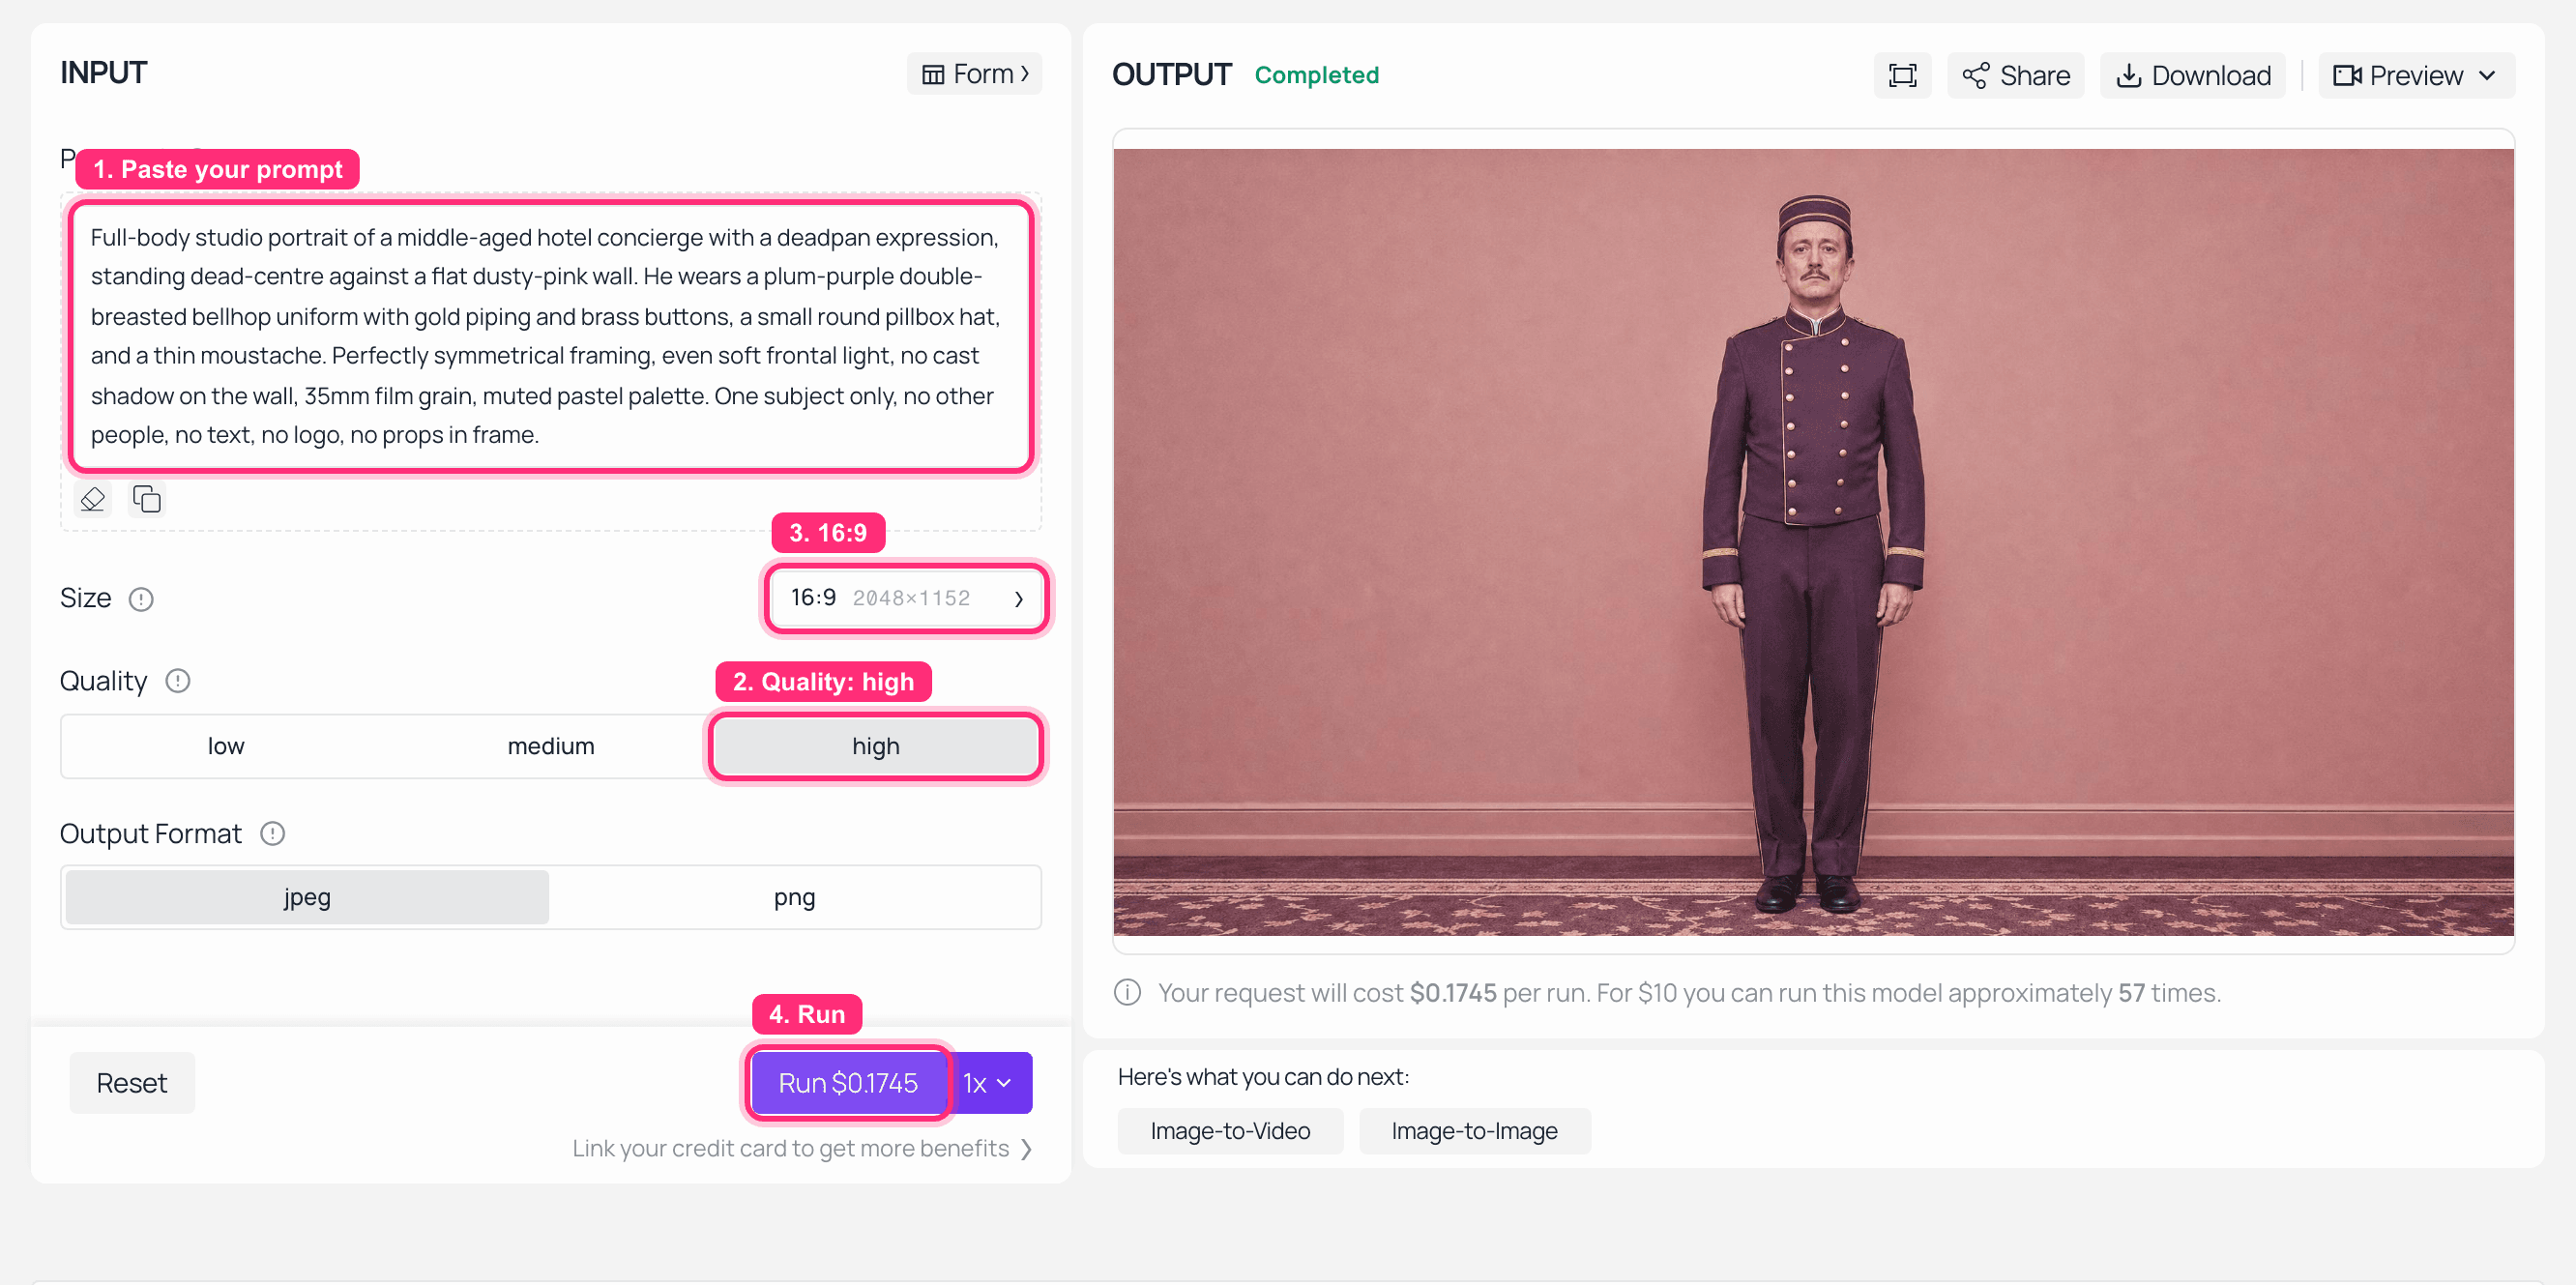
GPT Image 2 playground บน Atlas Cloud พร้อมภาพเหมือนอ้างอิงพนักงานต้อนรับที่แสดงในแผงเอาต์พุต
GPT Image 2 บน Atlas Cloud: คุณภาพสูง, 16:9, หนึ่งตัวแบบ, พื้นหลังเรียบ นี่คือไฟล์ที่จะกลายเป็น character1
ขั้นตอนที่ 2. สร้างภาพอ้างอิงที่ 2 ตัวแบบที่ล็อคตัวที่สอง
โมเดลเดียวกัน การตั้งค่าเดียวกัน ความแตกต่างของสีระหว่างตัวละครทั้งสองนั้นตั้งใจ เพราะมันทำให้โมเดลมีวิธีง่ายๆ ในการแยกพวกมันออกเมื่ออยู่ในเฟรมเดียวกัน
Plain1ภาพเหมือนเต็มตัวในสตูดิโอของหญิงสาวนักเดินทางถือแมวพันธุ์แร็กดอลล์ขนฟูแนบอก อยู่ตรงกลางภาพกับผนังสีเหลืองมัสตาร์ดเรียบ เธอสวมเสื้อโค้ทขนสัตว์สีมัสตาร์ด หมวกเบเร่ต์สีแดง และแว่นตากรอบกระดองเต่าทรงกลม ถือกระเป๋าเดินทางหนังขนาดเล็กในมือว่าง การจัดเฟรมสมมาตรสมบูรณ์ แสงหน้าอ่อนนุ่ม ไม่มีเงาบนผนัง เกรนฟิล์ม 35 มม. จานสีพาสเทลอ่อน มีตัวแบบเดียวเท่านั้น ไม่มีคนอื่น ไม่มีข้อความ ไม่มีโลโก้ 2
ขั้นตอนที่ 3. สร้างเสียงอ้างอิง ซึ่งเป็นส่วนที่มัลติโมดอลจริงๆ
คลิปเสียงคือสิ่งที่เปลี่ยนงานนี้จากงานหลายภาพเป็นงานมัลติโมดอล ช่องเสียงของ Wan 2.7 ต้องการตัวอย่างสั้น ประมาณ 1 ถึง 10 วินาที ดังนั้นให้เก็บบรรทัดให้สั้น ใช้ MiniMax Speech 2.6 HD และเลือกเสียงชายที่ต่ำ ราบเรียบ ไม่สะทกสะท้าน
Plain1สวัสดีตอนเย็น เช็คอินเหรอ? แน่นอน ทุกคนก็เช็คอิน 2
ขั้นตอนที่ 4. เรียกครั้งเดียว สามอ้างอิง หนึ่งคลิปเสร็จ
ตอนนี้ทั้งแพ็กจะถูกใส่เข้าไปด้วยกันบน Wan 2.7 Reference-to-Video การตั้งค่า: resolution: 1080P, ratio: 16:9, duration: 10 ซึ่งเป็นเพดานของโมเดลนี้, prompt_extend: false, seed: -1 โหลด images ตามลำดับ ขั้นตอนที่ 1 ก่อน เพื่อให้แมปเป็น character1 จากนั้นขั้นตอนที่ 2 เป็น character2 และแนบไฟล์ขั้นตอนที่ 3 ไปที่ audio
Plain1ภาพกว้างสมมาตร ตรงกลางของล็อบบี้โรงแรมพาสเทล โต๊ะต้อนรับด้านหน้า ผนังสีชมพูฝุ่นและชั้นวางกุญแจสีเหลืองมัสตาร์ดด้านหลัง character1 คือพนักงานต้อนรับที่ยืนอยู่หลังโต๊ะ character2 คือนักเดินทางที่ยืนอยู่หน้าโต๊ะ ยังคงอุ้มแมวแร็กดอลล์ของเธอ กล้องเคลื่อนเข้าไปช้าๆ ตามแนวแกนกลางที่สมบูรณ์แบบและไม่เอียง character1 มองตรงไปที่เลนส์แล้วพูดอย่างราบเรียบ: "แมวมีห้องจองไว้แล้ว คุณไม่มี" character2 กระพริบตาหนึ่งครั้ง ค่อยๆ หันหัวไปทางแมว แล้วกลับมาที่โต๊ะ แมวจ้องตรงไปที่กล้องโดยไม่ขยับ เกรนฟิล์ม 35 มม. แสงนุ่มนวลสม่ำเสมอ จานสีพาสเทลอ่อน ไม่มีการสั่นของกล้อง ไม่มีการตัด 2
Negative prompt:
Plain1การสั่นถือ, jump cuts, คำบรรยาย, ข้อความบนหน้าจอ, ลายน้ำ, คนพิเศษ, มือผิดรูป, การเปลี่ยนรูปใบหน้า, การเปลี่ยนสี, ภาพเบลอจากการเคลื่อนไหว 2
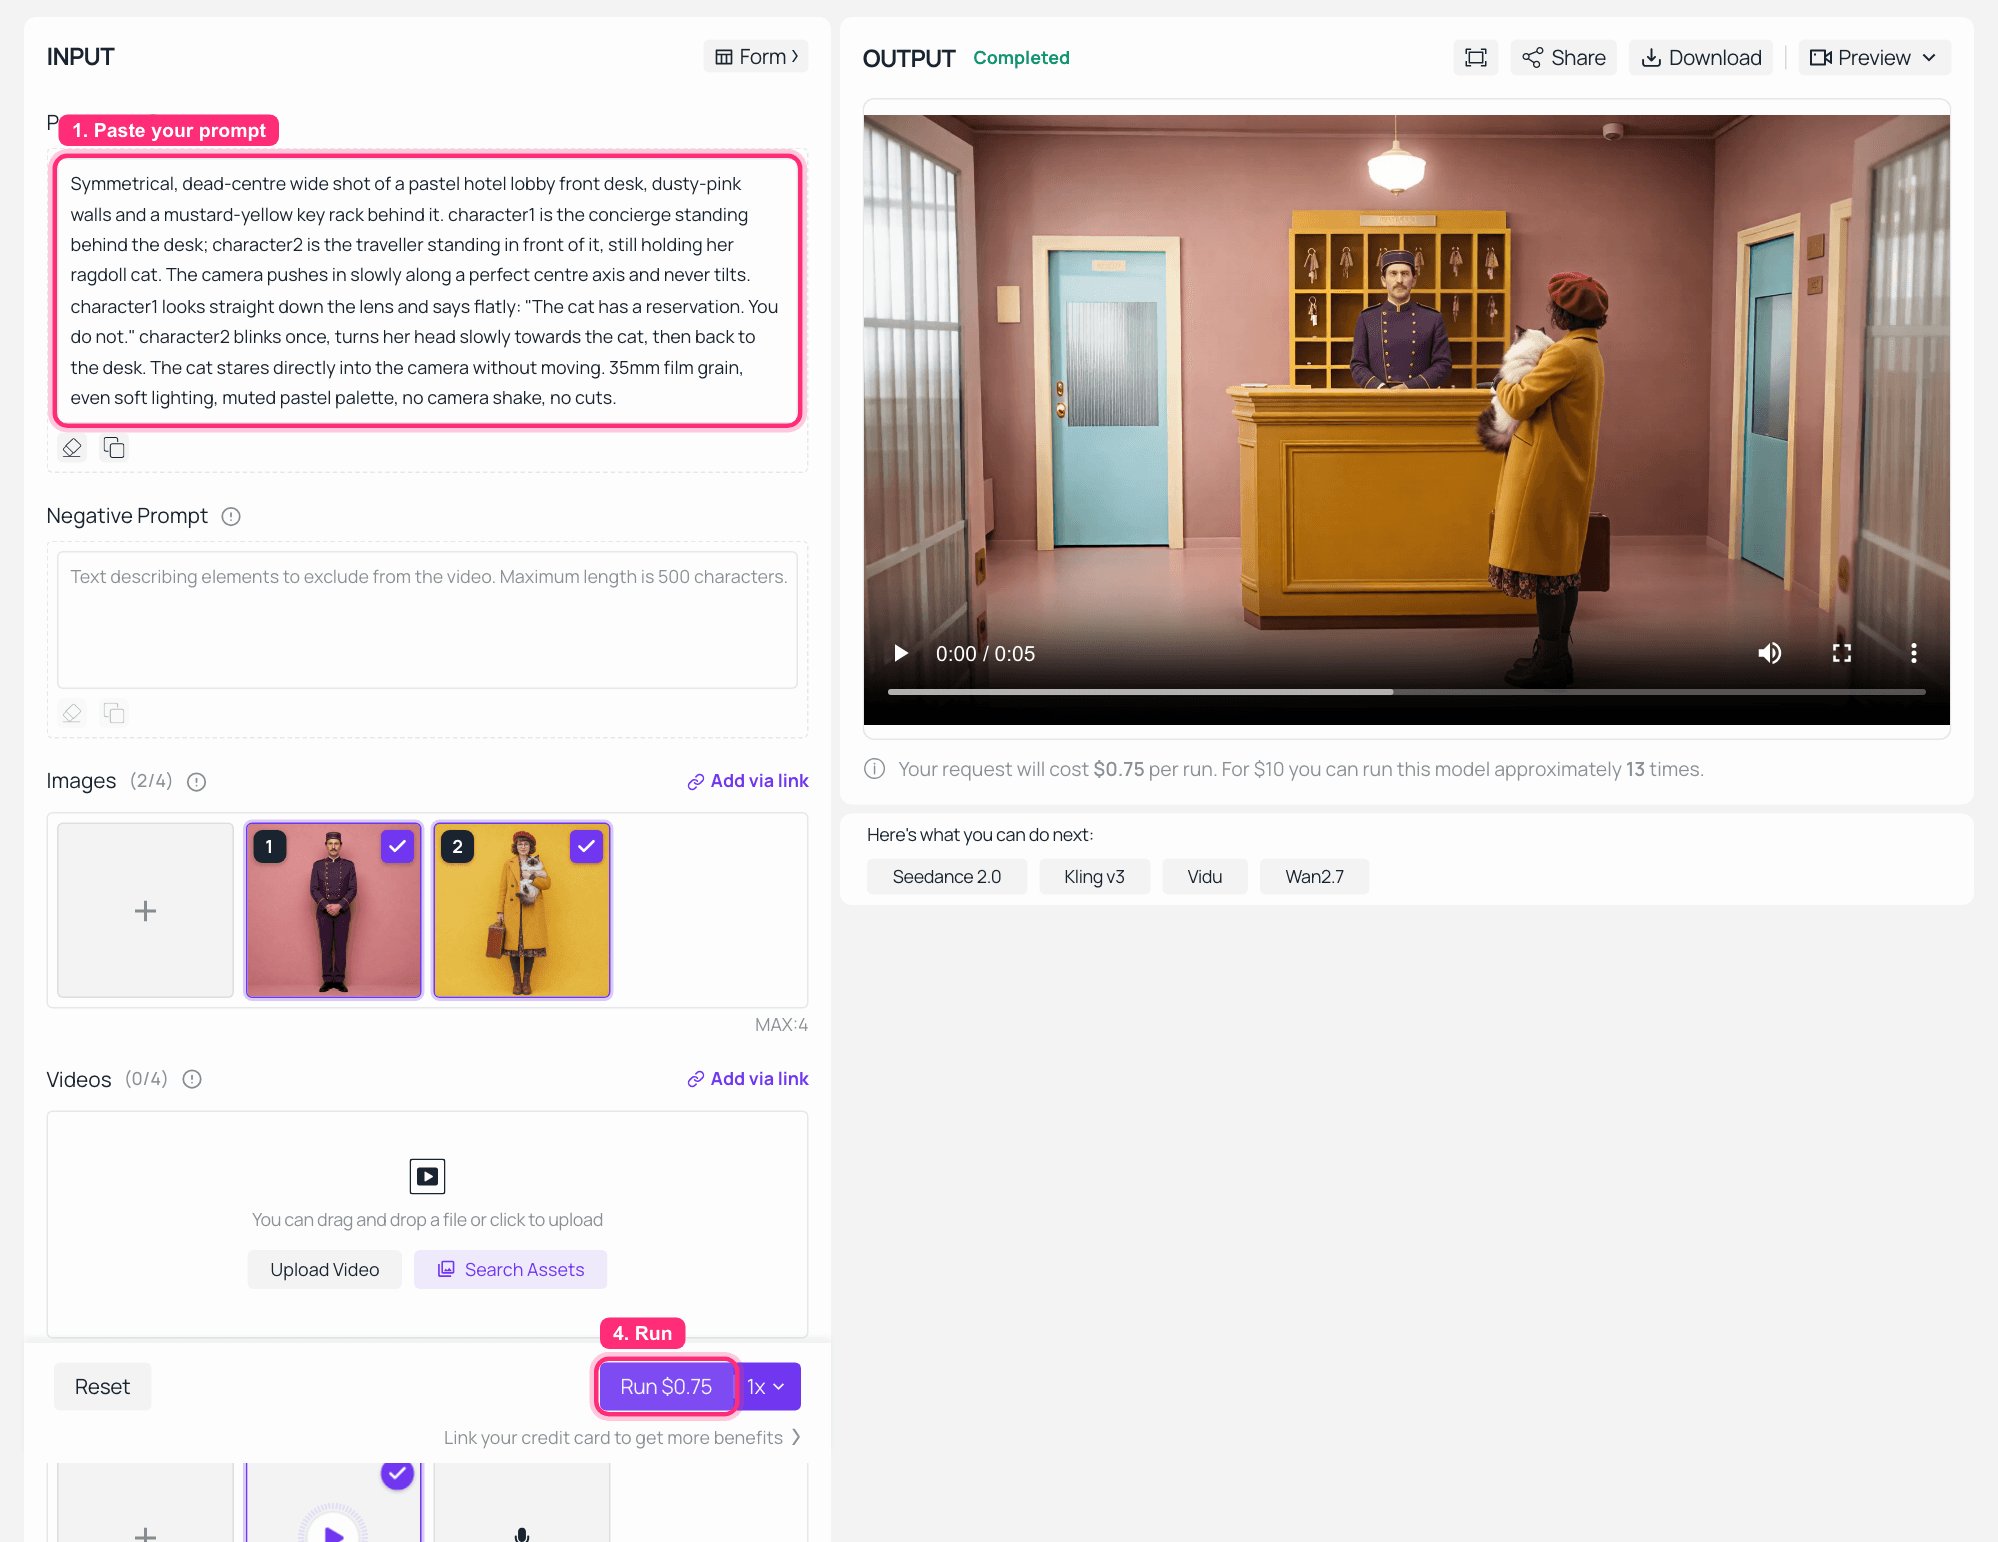
Wan 2.7 Reference-to-Video playground บน Atlas Cloud พร้อมภาพอ้างอิงสองภาพและไฟล์เสียงหนึ่งไฟล์ที่โหลด และคลิปที่เสร็จแล้วในแผงเอาต์พุต
Wan 2.7 Reference-to-Video บน Atlas Cloud: ภาพอ้างอิงสองภาพและคลิปเสียงหนึ่งอันแนบทางซ้าย เทคที่เสร็จแล้วเล่นทางขวาที่ 1080P และ 16:9 การจับภาพนี้รันที่ระยะเวลาค่าเริ่มต้นของโมเดล; ตั้งเป็น 10 สำหรับเวอร์ชันเต็มด้านล่าง
เทคที่เสร็จสมบูรณ์ ใบหน้าทั้งสองคงที่ เสื้อผ้าทั้งสองคงที่ และบรรทัดถูกส่งด้วยเสียงที่โคลนจากขั้นตอนที่ 3 ดังนั้นอันนี้คุ้มที่จะเล่นพร้อมเสียง
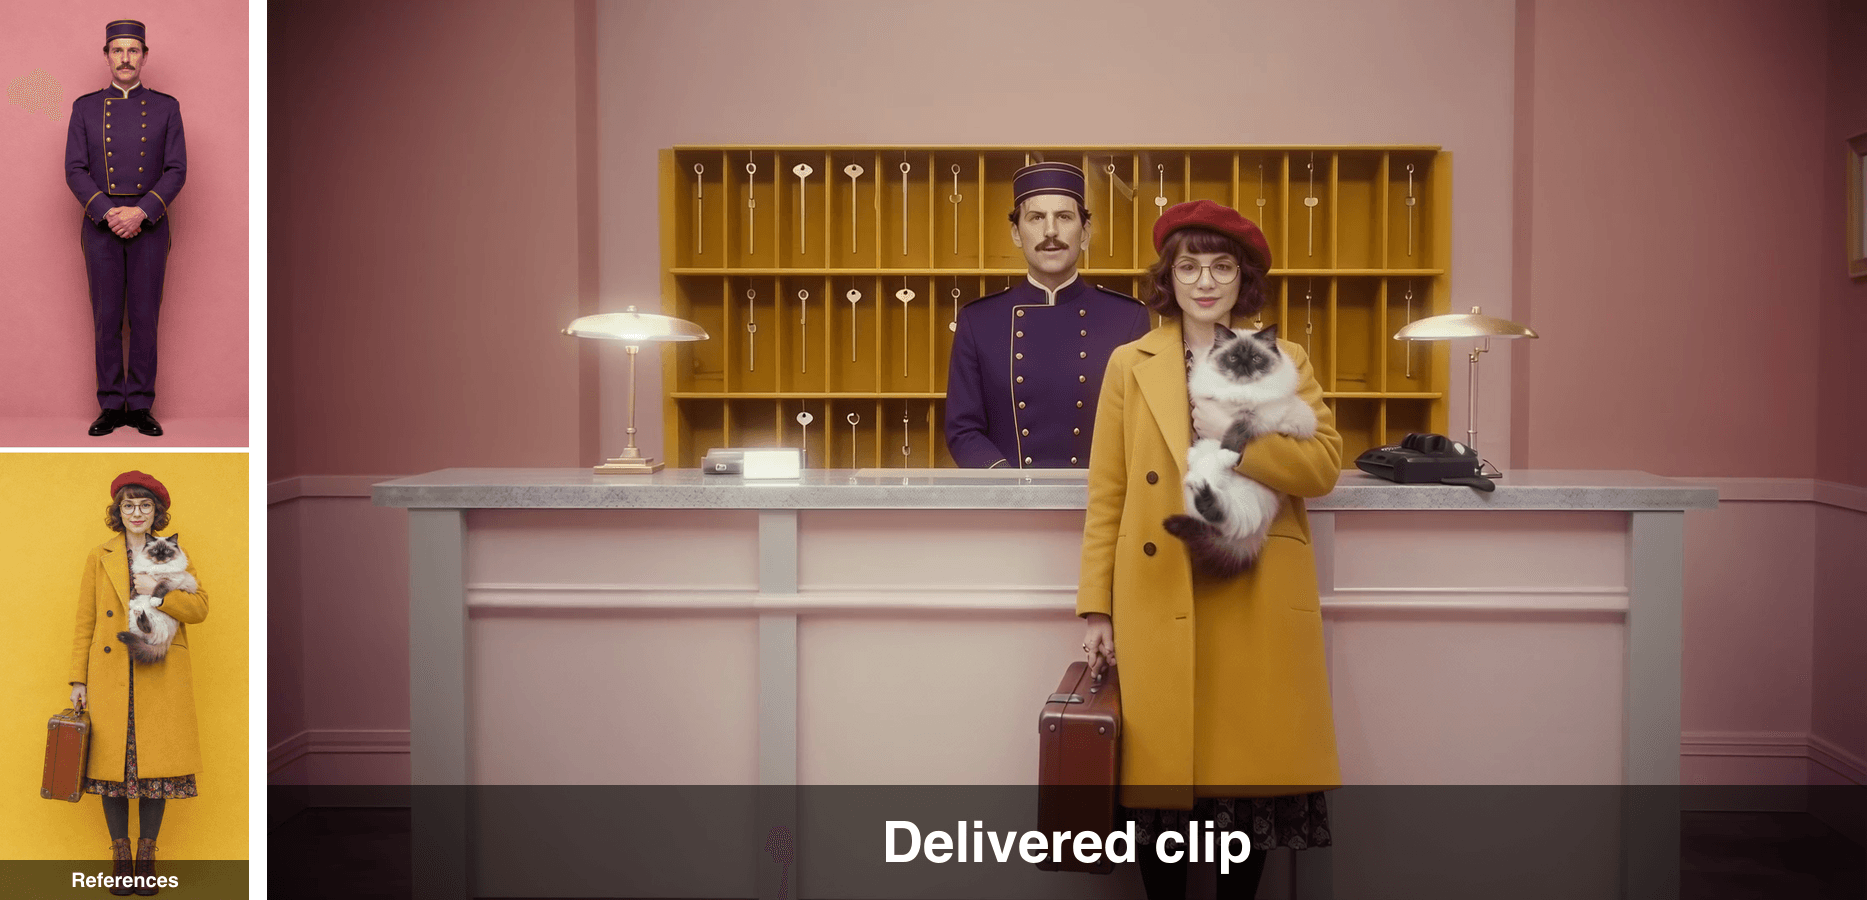
ภาพเหมือนอ้างอิงสองภาพถัดจากเฟรมจากคลิปที่เสร็จแล้ว แสดงใบหน้าและเสื้อผ้าชุดเดียวกัน
ภาพอ้างอิงทางซ้าย เฟรมจากคลิปที่ส่งมอบทางขวา ลายเครื่องแบบ หมวกเบเร่ต์ แว่นตา และแมวทั้งหมดคงอยู่ตลอดการเดินทาง
รูปแบบต่างๆ ของเวิร์กโฟลว์ Wan 3.0 Multimodal Reference
ขยายเป็น 30 วินาที แพ็กอ้างอิงเดียวกันรันบน Seedance 2.5 Reference-to-Video ด้วย duration: 30 ซึ่งให้ความยาวที่ Wan 3.0 สัญญาไว้โดยไม่ต้องรอเบต้า รองรับภาพอ้างอิงสูงสุด 30 ภาพ วิดีโอ 10 เรื่อง และคลิปเสียง 10 เรื่อง ดังนั้นแพ็กมีที่ว่างให้เติบโต เขียน 20 วินาทีพิเศษเป็นจังหวะในพรอมต์ ไม่ใช่เป็นบรรยากาศ มิฉะนั้นโมเดลจะยืดออก
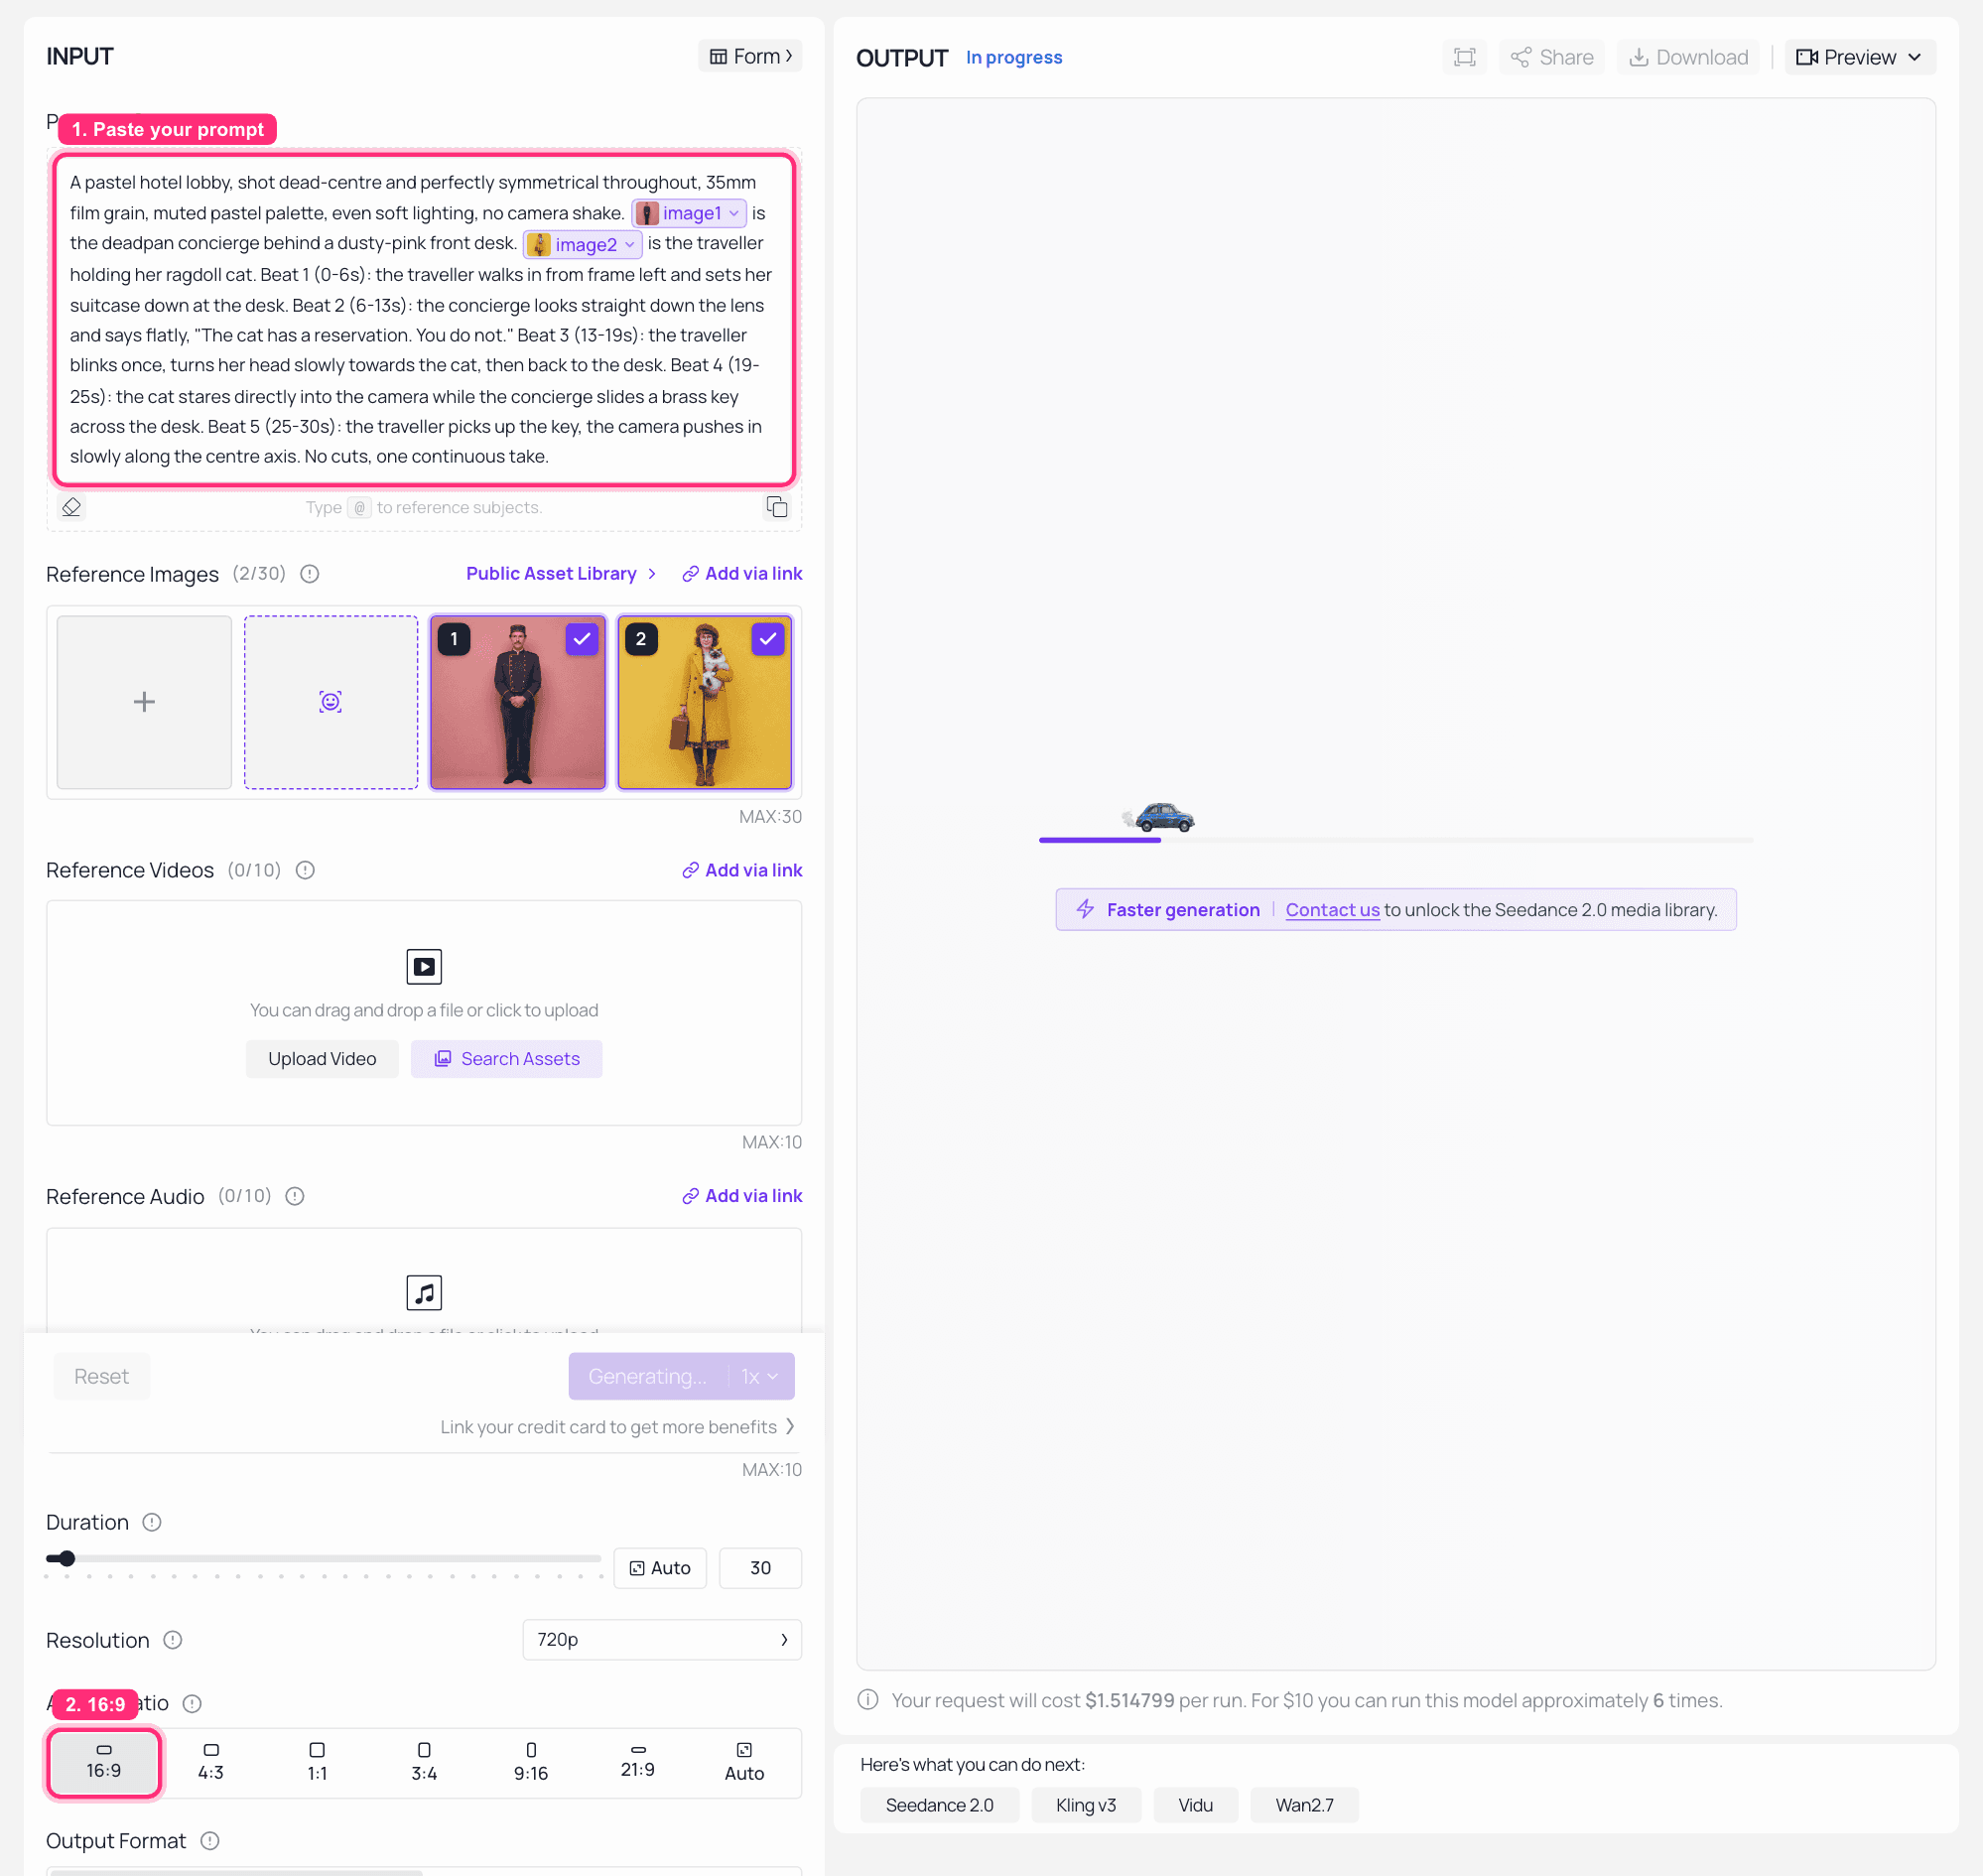
Seedance 2.5 Reference-to-Video playground บน Atlas Cloud โดยตั้งค่า duration เป็น 30 และเทคยาวถูกเรนเดอร์
Seedance 2.5 Reference-to-Video บน Atlas Cloud โดยตั้งค่า duration เป็น 30 และแนบภาพเหมือนอ้างอิงสองภาพเดียวกัน จับภาพระหว่างการสร้าง สังเกตชิป @image1 และ @image2 ในพรอมต์: นั่นคือวิธีบอก Seedance ว่าอ้างอิงใดเล่นบทใด ตรวจสอบราคาที่อ้างถึงบนปุ่ม Run ก่อนดำเนินการ เนื่องจากมันสะท้อนระยะเวลาที่งานจะส่งจริง
เวอร์ชัน 30 วินาทีของฉากเดียวกัน แพ็กอ้างอิงเดียวกัน จังหวะถูกเขียนออกมาทีละช็อต
เพิ่มวิดีโออ้างอิงสำหรับการเคลื่อนไหวเท่านั้น แนบคลิปที่มีจังหวะที่คุณชอบและพูดให้ชัดเจนในพรอมต์ เช่น "follow the reference video for cutting rhythm only, ignore its subjects and setting" นั่นคือเคล็ดลับเบื้องหลังตัวอย่างการพลิกการ์ดด้านบน
แก้ไขการเคลื่อนตัวด้วย negative prompt ก่อนที่จะแตะ positive prompt การเปลี่ยนรูปใบหน้า การเปลี่ยนสี และการสั่นถือเป็นสามสิ่งที่ทำลายช็อตที่อ้างอิงคงที่ และมักจะถูกกดได้ถูกกว่าและเร็วกว่าการอธิบายออก
ทดลองรูปแบบ Multimodal Reference ฟรี
หากคุณต้องการรูปร่างของสิ่งนี้ก่อนที่จะต้องการพารามิเตอร์ Atlas Cloud ได้เปิดตัว เครื่องสร้างสกิตโฆษณา AI ฟรี เมื่อสัปดาห์ที่แล้วที่รันเชนเดียวกันโดยไม่มีปุ่มปรับใดๆ
คุณเขียนหนึ่งบรรทัดเกี่ยวกับผลิตภัณฑ์และจุดขายของคุณ มันจะเขียนสคริปต์ตลกสองตัวละครให้คุณ อุทาน เปิดเรื่อง ความขัดแย้ง พลิกผัน จากนั้นเรนเดอร์วิดีโอ 15 วินาทีพร้อมบทสนทนาพูดและเอฟเฟกต์เสียงในตัว คุณสามารถแนบรูปผลิตภัณฑ์จริงสูงสุดสี่รูปเป็นข้อมูลอ้างอิง และโฆษณาจะคงรูปร่าง สี ฉลาก และโลโก้ของพวกมันตั้งแต่สคริปต์ไปจนถึงเฟรมสุดท้าย มีสไตล์หกแบบให้เลือก ตั้งแต่มีมตลก ไปจนถึงพลิกผันเรื่องราว ซิทคอม หรูหรา และขายตรง และบทสนทนาจะกลับมาในภาษาที่คุณเขียนคำอธิบาย
นั่นคือเชนสองตัวละครบวกภาพอ้างอิงบวกเสียงเดียวกันจากบทช่วยสอน ลบการเขียนพรอมต์และลบการเรียกเก็บเงิน ซึ่งทำให้เป็นวิธีที่ดีในการค้นหาว่ารูปแบบนี้เหมาะกับผลิตภัณฑ์ของคุณหรือไม่ก่อนที่คุณจะใช้จ่ายในการปรับแต่ง
สำหรับความรู้สึกว่ากองภาพนิ่งอ้างอิงทำอะไรกับชิ้นงานผลิตภัณฑ์ นี่คือเวอร์ชันของ Wan 3.0 เองของงาน: ห้าภาพเข้า หนึ่งรีลเปิดตัวออก แต่ละภาพยึดจังหวะหนึ่งของการตัดต่อ
ภาพนิ่งอ้างอิงห้าภาพขยายเป็นรีลเปิดตัวผลิตภัณฑ์สไตล์ Material Design_ภาพอ้างอิงห้าภาพขับเคลื่อนฟิล์มผลิตภัณฑ์เก้าวินาที แต่ละภาพยึดจังหวะและส่งต่อไปยังภาพถัดไป ที่มา: คู่มือผู้สร้าง Wan 3.0 อย่างเป็นทางการของ Alibaba_
ราคาของคลิป Wan 3.0 Multimodal Reference
| ขั้นตอน | โมเดล | ราคาต่อหน่วย | จำนวน | ต้นทุน |
|---|---|---|---|---|
| 1 และ 2, ภาพอ้างอิงสองภาพ | GPT Image 2 | $0.009 ต่อภาพ | 2 | $0.02 |
| 3, เสียงอ้างอิง | MiniMax Speech 2.6 HD | $0.08 ต่อ 1K ตัวอักษร | 49 ตัวอักษร | $0.00 |
| 4, เทค 10 วินาทีที่ 1080P | Wan 2.7 Reference-to-Video | $0.15 ต่อวินาทีที่ 1080P | 10 วินาที | $1.50 |
| รวมบทช่วยสอน | ประมาณ $1.52 | |||
| รูปแบบ 30 วินาที | Seedance 2.5 Reference-to-Video | $0.134 ต่อวินาทีที่ 480P | 30 วินาที | ประมาณ $4.02 |
| เส้นทางฟรี | เครื่องสร้างสกิตโฆษณา AI ฟรี | ฟรี | 1 คลิป, 15 วินาที | $0 |
นั่นคืออัตราของแพลตฟอร์มเอง ตรวจสอบในสิงหาคม 2026 และเรียกเก็บตามการใช้งานจริง สองสิ่งที่ทำให้ยอดรวมเคลื่อนไหวมากกว่าที่คนคาดหวัง ความละเอียดคืออย่างแรก: $0.10 ต่อวินาทีในตารางเปรียบเทียบเป็นอัตราพื้นฐานของ Wan 2.7 และ 1080P คิดที่ $0.15 ซึ่งเป็นที่มาของ $1.50 ด้านบน อย่างที่สองคือ Seedance กำหนดราคาตามจำนวนพิกเซล ดังนั้น $0.134 ต่อวินาทีที่ระบุคือตัวเลข 480P และเทค 720P มีราคาสูงกว่าการคูณตรงๆ สำหรับการอ้างอิง อัตราเบต้า Wan 3.0 ที่รายงานที่ $0.20 ต่อวินาทีที่ 1080p จะทำให้เทค 30 วินาทีเต็มอยู่ที่ประมาณ $6 ซึ่งมากกว่าเส้นทาง Seedance ที่ 480P ในวันนี้
หมายเหตุเกี่ยวกับการใช้สิ่งนี้ Wan 3.0 เป็นเบต้าและข้อกำหนดอาจเปลี่ยนแปลงได้ ดังนั้นอ่านอีกครั้งก่อนที่คุณจะสร้างไปป์ไลน์บนมัน หากภาพอ้างอิงของคุณเป็นคนจริง ให้ขออนุญาตก่อน เพราะ reference-to-video เป็นความสามารถที่ทำให้เรื่องนั้นสำคัญ ตัวอย่างคลิปในบทความนี้เป็นผลลัพธ์ที่ Alibaba สร้างขึ้นเองจากคู่มือผู้สร้างสาธารณะ แสดงซ้ำที่นี่เพื่อความคิดเห็น
คำถามที่พบบ่อย
Wan 3.0's multimodal reference สามารถรับทรัพย์สินได้กี่รายการจริงๆ?
สูงสุด 20 ทรัพย์สินในการเรียกครั้งเดียว จากรูปภาพ วิดีโอ เสียง เอกสาร และเว็บเพจ ขีดจำกัดในทางปฏิบัติต่ำกว่าทางเทคนิค กำหนดให้แต่ละทรัพย์สินมีหนึ่งงาน หนึ่งตัวแบบต่อภาพ แล้วคุณจะใช้น้อยกว่า 20 มากสำหรับฉากส่วนใหญ่
Wan 3.0 สามารถเปลี่ยน PDF หรือเว็บเพจเป็นวิดีโอได้จริงหรือ?
ใช่ นั่นคือส่วนที่ไม่เหมือนใครอย่างแท้จริง นอกจากข้อความ ภาพ เสียง และวิดีโอ มันยังยอมรับไฟล์เอกสารและ URL สด โดยรายงานเบต้าระบุ .doc, .xls, .ppt, .pdf และ .txt ไม่มีโมเดล reference-to-video อื่นในตารางเปรียบเทียบที่รับเอกสารเลย
Wan 3.0 เป็นโอเพนซอร์สหรือไม่? ฉันสามารถรันใน ComfyUI ได้หรือไม่?
ไม่ และไม่ใช่ตอนนี้ Wan 3.0 เป็นเบต้าแบบปิดที่ทำงานบนคลาวด์ของ Alibaba เอง Wan รุ่นก่อนหน้าถูกปล่อยเป็นโอเพนซอร์ส ซึ่งเป็นเหตุผลว่าทำไมความคาดหวังจึงมีอยู่ แต่ Alibaba ยังไม่ได้ยืนยัน weights สำหรับ 3.0 หน้าที่อ้างว่ามีการปล่อย Wan 3.0 เวอร์ชัน 1.3B หรือ 14B Apache 2.0 ไม่ได้รับการสนับสนุนจากสิ่งใดที่เป็นทางการ
Wan 3.0 พร้อมใช้งานผ่าน API บุคคลที่สามหรือยัง?
ยังไม่ รวมถึง Atlas Cloud สิ่งที่ใกล้เคียงที่สุดที่คุณเรียกใช้ได้ในวันนี้คือ Wan 2.7 Reference-to-Video ซึ่งรูปร่างอินพุตของมันตรงกับ omni-reference เกือบทั้งหมดยกเว้นรูปแบบเอกสารและเว็บเพจ หรือ Seedance 2.5 Reference-to-Video หากคุณต้องการ 30 วินาทีเต็ม
วิธีที่ถูกที่สุดในการทดสอบวิดีโอสองตัวละครแบบอ้างอิงคงที่คืออะไร?
เครื่องสร้างสกิตโฆษณา AI ฟรีที่เชื่อมโยงด้านบน ใส่รูปอ้างอิงสี่รูป รับคลิปสองตัวละครพูดยาว 15 วินาที ไม่มีพารามิเตอร์และไม่มีค่าใช้จ่าย ถ้ามันคงผลิตภัณฑ์และรูปแบบของคุณไว้ ก็ไปปรับแต่งเชนแบบเสียเงิน
ทำไมตัวละครของฉันยังเคลื่อนตัวแม้จะมีภาพอ้างอิง?
สามสาเหตุ ตามลำดับความถี่ หนึ่งอ้างอิงกำลังทำงานสองอย่าง ดังนั้นมันถูกขอให้แก้ไขทั้งใบหน้าและสถานที่ ภาพอ้างอิงมีมากกว่าหนึ่งคนหรือพื้นหลังที่ยุ่ง ดังนั้นโมเดลไม่รู้ว่าจะล็อคส่วนไหน หรือการเคลื่อนตัวเป็นสิ่งประดิษฐ์จากการเรนเดอร์มากกว่าความล้มเหลวของอ้างอิง ในกรณีนั้นให้ใส่ face morphing, colour shift ใน negative prompt ก่อนที่จะเขียนอะไรใหม่


